Stable Diffusion sur macOS : comparatif des outils d'images locaux

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Faire tourner des modèles d’images en local sur macOS commence par le choix d’un outil. Ce guide s’adresse aux utilisateurs de Mac qui veulent générer des images en local : vous verrez à quoi sert chacun des six outils, comment l’installer, ce dont un modèle a besoin en plus de son fichier, et comment tester un outil sur votre machine avant de vous engager.
Draw Things, DiffusionBee, ComfyUI, InvokeAI, AUTOMATIC1111 et Fooocus se recoupent, mais ils diffèrent par l’installation, les modèles pris en charge, le contrôle du workflow, les extensions, l’automatisation et la maintenance. Une application en glisser-déposer permet de démarrer vite ; un graphe de nœuds demande plus de temps d’apprentissage, mais expose davantage du pipeline. Sur Apple Silicon, l’application, la famille de modèles, la précision, la taille de l’image et le workflow déterminent tous si la génération tient en mémoire.
Ce qu’exécute une application d’images locale
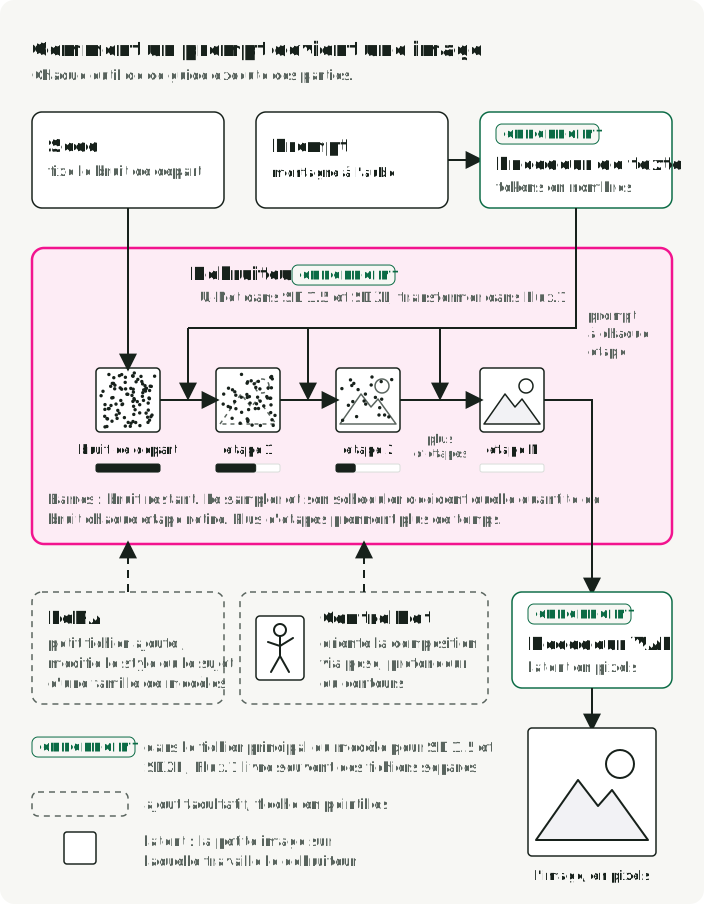
Tous les outils de ce guide exécutent le même type de pipeline. Au centre se trouve le débruiteur : un U-Net dans SD 1.5 et SDXL, un transformer dans Flux.1. Il part d’un bruit aléatoire et en retire un peu à chaque étape, guidé par le prompt. Les autres parties préparent ses entrées ou transforment sa sortie en image :
| Partie | Rôle |
|---|---|
| Checkpoint | Le fichier principal du modèle. Il contient le débruiteur et, pour SD 1.5 et SDXL, généralement aussi l’encodeur de texte et le VAE. Flux.1 livre souvent ces parties dans des fichiers séparés. |
| Encodeur de texte | Transforme le prompt en nombres que le débruiteur peut utiliser. Un tokenizer découpe d’abord le prompt en tokens. |
| VAE | Convertit entre les pixels et l’image « latente », plus petite, sur laquelle travaille le débruiteur. Son décodeur transforme le latent final en l’image que vous voyez. |
| Sampler et nombre d’étapes | La seed fixe le bruit de départ. Le sampler, avec son scheduler, décide quelle quantité de bruit chaque étape retire. Plus d’étapes prennent plus de temps. |
| LoRA | Un petit fichier complémentaire qui modifie le style ou le sujet de la famille de modèles pour laquelle il a été entraîné. Un embedding d’inversion textuelle est un complément plus petit qui apprend un mot nouveau à l’encodeur de texte. |
| ControlNet | Un modèle supplémentaire qui oriente la composition à partir d’une image de contrôle, comme une pose, une carte de profondeur ou une carte de contours. |
Sur la figure, suivez le latent depuis le bruit de départ jusqu’à l’étape N : le prompt atteint le débruiteur à chaque étape, les barres montrent la quantité de bruit restante, LoRA et ControlNet sont des entrées facultatives, et le décodeur du VAE transforme le petit latent en image. Les étiquettes CHECKPOINT marquent les parties que contient en général un seul fichier checkpoint.
Obtenir des modèles
La plupart des outils peuvent télécharger un modèle de départ pour vous. Pour le reste, deux sites couvrent l’essentiel des besoins :
- Hugging Face héberge les modèles de base officiels de Stability AI, Black Forest Labs et d’autres. Lisez la licence sur la fiche du modèle : les licences diffèrent même au sein d’une même famille, comme FLUX.1 [schnell] (Apache 2.0) et FLUX.1 [dev] (une licence non commerciale). Certains dépôts demandent d’accepter la licence avant le début du téléchargement.
- Civitai héberge des checkpoints, des LoRA et des embeddings de la communauté. Chaque page indique le modèle de base pour lequel le fichier a été entraîné.
Préférez les fichiers .safetensors. Un fichier .ckpt est un pickle Python, et charger un pickle peut exécuter du code arbitraire. Un fichier .safetensors ne stocke que des tenseurs. Ne chargez un .ckpt que depuis une source de confiance.
Avant de télécharger plusieurs gigaoctets, comparez la famille du modèle (SD 1.5, SDXL, Flux.1, etc.) à ce que votre outil prend en charge. Un LoRA entraîné pour SDXL ne fonctionne pas avec un checkpoint SD 1.5.
Un fichier de modèle n’est pas un workflow portable
Plusieurs applications savent charger des fichiers .safetensors, mais une extension de fichier identique ne garantit pas que le modèle fonctionnera. Un pipeline complet peut aussi exiger une architecture, un encodeur de texte, un VAE, un scheduler, un ControlNet, un LoRA ou une configuration propres à l’application.
Notez tout ce qui a produit une image :
- l’application et sa version
- le dépôt du modèle, sa révision et sa licence
- chaque composant du modèle et chaque adaptateur
- le prompt, le prompt négatif, la seed, le sampler, les étapes, la guidance et les dimensions
- le fichier de graphe ou de workflow quand l’application en expose un
Une même seed peut tout de même produire une autre image après un changement de backend, de modèle, de sampler ou de précision.
Mémoire, espace disque et logiciels sous chaque outil
Sur Apple Silicon, le CPU et le GPU partagent un seul pool de mémoire. Le GPU peut en utiliser la plus grande partie, de sorte qu’un Mac de 32 Go peut charger des modèles qui ne tiennent pas sur une carte graphique classique de 8 à 12 Go. Le même pool contient aussi macOS et toutes les applications ouvertes ; Moniteur d’activité affiche l’utilisation de la mémoire des applications, de la mémoire résidente, compressée et du swap.
Le pic de mémoire pendant la génération se compose de quatre parties : les composants du modèle, la mémoire de travail pour les activations et l’attention, les adaptateurs et modèles de contrôle chargés, et la mémoire déjà utilisée par macOS et vos applications. Le haut de la figure les représente comme des parties de la même mémoire, avec la mémoire qui reste libre ; ce n’est pas une formule de dimensionnement. Le bas compare des exemples de tailles de téléchargement sans quantification. Ces barres mesurent l’espace disque, pas la mémoire à l’exécution.
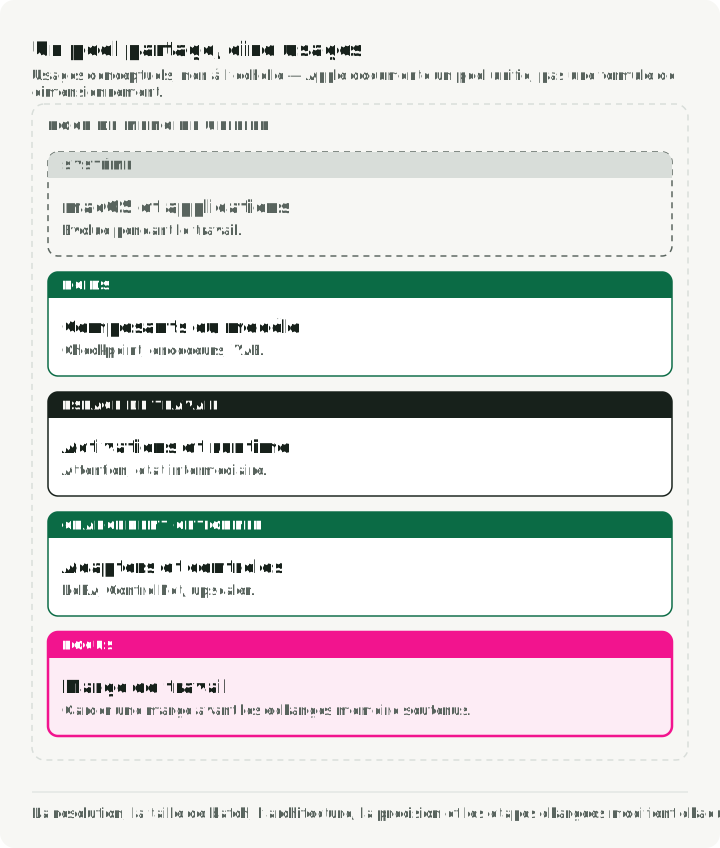
La résolution, la taille de lot, l’architecture du modèle, l’upscaling et ControlNet modifient la mémoire utilisée à l’exécution. La taille de téléchargement estime l’espace disque ; la mémoire à l’exécution dépend de la précision et de la quantification chargées par l’application, des composants qui restent chargés et des tenseurs temporaires créés pendant la génération. La quantification stocke les poids avec moins de bits, et Draw Things peut charger les poids FLUX.1 à la demande plutôt que de tous les garder en mémoire. Testez le workflow prévu, puis surveillez Pression mémoire et Swap utilisé ; un swap soutenu indique qu’il faut réduire la charge ou choisir plus de mémoire.
Planifiez l’espace disque séparément. Ces téléchargements sans quantification sur Hugging Face comprennent un checkpoint SD 1.5 d’environ 4 Go et un checkpoint de base SDXL d’environ 7 Go. Le transformer FLUX.1 [schnell] seul pèse environ 24 Go, et un encodeur de texte T5 en 16 bits ajoute environ 10 Go. FLUX nécessite aussi d’autres composants ; ces deux fichiers ne constituent donc pas son téléchargement complet. Si votre Mac manque de place, gardez les dossiers de modèles sur un SSD externe.
Les outils diffèrent aussi par le logiciel qui sépare l’application du GPU. ComfyUI, AUTOMATIC1111, Fooocus et InvokeAI sont des applications Python qui s’exécutent sur le backend Metal de PyTorch, appelé MPS (Metal Performance Shaders) ; leurs fonctionnalités et leur vitesse dépendent donc de la version de PyTorch installée. Draw Things utilise son propre moteur avec des kernels Metal FlashAttention. Tous aboutissent à Metal et au même pool de mémoire unifiée.
Comparatif de six outils
| Outil | Installation | Ce que vous pouvez contrôler | Compromis d’exploitation |
|---|---|---|---|
| Draw Things | Mac App Store | Interface Apple native avec modèles locaux, adaptateurs, ControlNet et scripts | Interface dense et propre au produit ; vérifiez la prise en charge de la famille de modèles exacte |
| DiffusionBee | Téléchargement du DMG | Application macOS packagée avec un workflow de génération intégré | Aucune version depuis la 2.5.3 en août 2024 ; aucune prise en charge des familles de modèles sorties après |
| ComfyUI | DMG Comfy Desktop ou brew install --cask comfy | Graphe de nœuds explicite, workflows JSON, API et nœuds personnalisés | Plus de composants ; les graphes et les nœuds tiers deviennent des dépendances |
| InvokeAI | DMG Invoke Launcher | Canevas avec inpainting et outpainting, plus un éditeur de workflow à nœuds | Nécessite macOS 14 ou version ultérieure ; la doc recommande 16 Go de mémoire ou plus |
| AUTOMATIC1111 | Paquets Homebrew, git clone et ./webui.sh | Interface Web à formulaires, scripts, API et un grand nombre d’extensions | Dernière version en février 2025 ; limitations documentées sur Apple Silicon ; les extensions exécutent du code tiers dans le même environnement |
| Fooocus | git clone et un environnement conda (non officiel sur Mac) | Workflow SDXL directif, centré sur le prompt | Corrections de bugs uniquement ; les consignes pour Mac sont non officielles et peu testées |
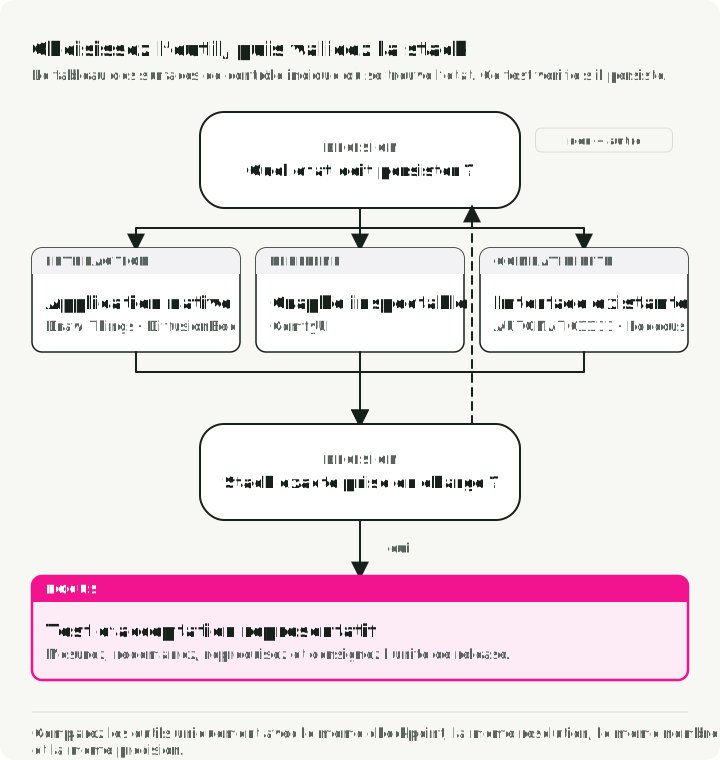
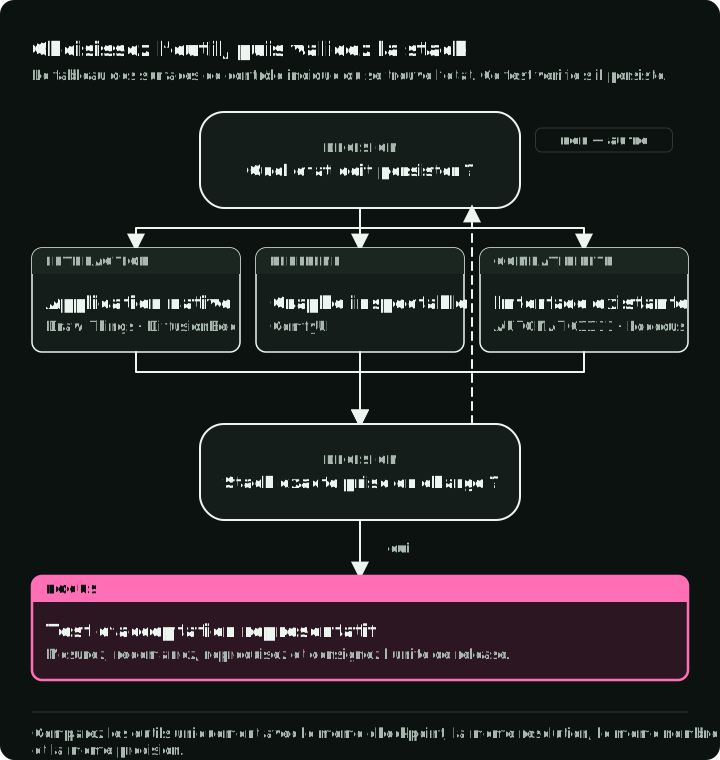
Le tableau montre où vos réglages sont enregistrés : dans l’application, dans un formulaire web ou dans un fichier de graphe que vous pouvez relire. La figure part d’une application native et montre quand passer à un autre outil, avec un aperçu de l’endroit où chacun conserve vos réglages. Exécutez le test d’acceptation de la fin de cet article avant de vous engager avec l’un d’eux.
Draw Things : interaction native et scripts
Draw Things est une application pour les plateformes Apple dédiée à la génération d’images en local. Installez-la depuis le Mac App Store ; elle n’a besoin ni de Python ni du terminal. Sa documentation actuelle couvre les modèles, les LoRA, ControlNet, l’inversion textuelle, Core ML et des scripts JavaScript versionnés.
Choisissez-la quand le travail doit rester dans une application native tout en demandant plus de contrôle qu’une simple zone de prompt. Avant d’en faire votre standard, importez les composants exacts de votre modèle et reproduisez une modification, un adaptateur ou un workflow de contrôle représentatif. « Natif » décrit l’interface et l’implémentation ; cela ne garantit ni la prise en charge ni la vitesse pour chaque nouvelle architecture.
DiffusionBee : un workflow macOS packagé
DiffusionBee regroupe le téléchargement des modèles et les tâches de génération courantes dans une application de bureau. Téléchargez le DMG et déplacez l’application dans Applications. Sa documentation de projet liste l’image vers image, l’inpainting, l’outpainting, ControlNet, LoRA et SDXL, et l’application inclut l’upscaling. Les notes de version de DiffusionBee 2.5.3 indiquent que Flux.1 n’est pris en charge que sur les Mac arm64 sous macOS 13 ou version ultérieure.
La dernière version de DiffusionBee, la 2.5.3, date d’août 2024, et la page de téléchargement de diffusionbee.com renvoie encore vers la 2.5.1 ; récupérez la 2.5.3 sur la page des versions GitHub. N’attendez pas de prise en charge des familles de modèles sorties après cette date. Choisissez-le quand l’installation et une interface intégrée comptent plus que l’export d’un graphe de pipeline, et quand le modèle dont vous avez besoin figure déjà dans sa liste. Une mention comme « prise en charge de Flux » ne signifie pas que chaque dérivé, quantification ou composant auxiliaire se chargera.
ComfyUI : un workflow enregistré dans un fichier
ComfyUI représente la génération sous forme de graphe de nœuds. Chaque étape est un nœud, et le graphe peut se ramifier : un même graphe peut générer une image, la mettre à l’échelle et la passer à un nœud de restauration de visages issu d’un pack de nœuds personnalisés. Un workflow peut être stocké en JSON indépendamment de sa sortie, ce qui rend le pipeline inspectable et versionnable. Son exécuteur peut aussi éviter de recalculer les sections du graphe dont les entrées n’ont pas changé.
Comfy Desktop est un gestionnaire multi-installations pour les instances locales de ComfyUI. La documentation actuelle pour macOS prend en charge Apple Silicon sous macOS 13 ou version ultérieure. L’installation utilise un .dmg téléchargé. Si vous préférez Homebrew, le cask actuel est comfy (et non comfyui) :
brew install --cask comfyChoisissez ComfyUI quand un pipeline comporte des branches, des composants réutilisables, plusieurs modèles ou de l’automatisation. Conservez ensemble le JSON, la version de l’application, les versions des nœuds du cœur, les révisions des nœuds personnalisés et le manifeste des modèles.
Comment exécuter le même graphe depuis un script avec une nouvelle seed ? Exportez le graphe avec File → Export Workflow (API). Le format API identifie chaque nœud par son ID numérique et ne garde que les entrées nécessaires à l’exécution. Envoyez-le ensuite au point d’accès /prompt du serveur local :
import json
import random
import urllib.request

COMFY_URL = "http://127.0.0.1:8188"  # check the port first, see below
SAMPLER_NODE = "3"  # the KSampler node ID in your exported file

with open("workflow_api.json") as f:
    workflow = json.load(f)

workflow[SAMPLER_NODE]["inputs"]["seed"] = random.randint(0, 2**32 - 1)

request = urllib.request.Request(
    f"{COMFY_URL}/prompt",
    data=json.dumps({"prompt": workflow}).encode("utf-8"),
    headers={"Content-Type": "application/json"},
)
with urllib.request.urlopen(request) as response:
    print(json.load(response))  # includes the prompt_id of the queued run
Regardez deux choses dans le fichier exporté : l’ID du nœud sampler ("3" dans l’exemple d’API de ComfyUI) et son champ inputs, qui contient la seed, les étapes et le nom du sampler. Vérifiez le port avant d’exécuter le script : une installation manuelle écoute par défaut sur 8188, et Comfy Desktop peut utiliser un autre port, indiqué dans ses paramètres de serveur.
Les nœuds personnalisés sont des dépendances exécutables. Relisez leur code source et leurs scripts d’installation, épinglez les révisions et isolez l’environnement. Un graphe d’un auteur inconnu peut faire référence à du code et à des modèles que vous n’avez pas audités.
InvokeAI : un canevas pour l’inpainting et l’outpainting
InvokeAI repose sur un canevas : vous sélectionnez la zone à modifier avec un masque et continuez à générer dans la même vue. L’inpainting régénère une zone masquée à l’intérieur de l’image ; l’outpainting étend l’image au-delà de ses bords existants. Il propose aussi un éditeur de workflow à nœuds pour les pipelines que vous voulez enregistrer et partager. Le projet publie toujours des versions régulières ; la v6.14.2 est sortie en septembre 2026.
Installez-le avec l’Invoke Launcher : ouvrez le DMG, glissez le launcher dans Applications et lancez-le. Le launcher installe Python et Invoke pour vous. La configuration requise indique macOS 14 ou version ultérieure, précise que tous les Mac Apple Silicon conviennent, et recommande 16 Go de mémoire ou plus.
Choisissez-le quand l’essentiel de votre travail consiste à retoucher des parties d’une image plutôt qu’à générer des images entières à partir d’un prompt.
AUTOMATIC1111 : la compatibilité avec une interface Web établie
AUTOMATIC1111 Stable Diffusion WebUI expose les réglages de génération dans une interface de navigateur et prend en charge les scripts, les extensions et une API. Choisissez-le quand un tutoriel, une automatisation ou une extension précis font déjà partie du besoin. La dernière version, la v1.10.1, date de février 2025 ; vérifiez donc la prise en charge de toute famille de modèles sortie après avant de le choisir.
Sur Mac, il s’exécute sur le backend MPS de PyTorch. Le guide officiel pour Apple Silicon l’installe depuis le terminal ; ./webui.sh crée un environnement Python et installe les dépendances restantes au premier lancement :
brew install cmake protobuf rust python@3.10 git wget
git clone https://github.com/AUTOMATIC1111/stable-diffusion-webui
cd stable-diffusion-webui
./webui.sh
Le même guide documente des exceptions et des limitations de performances, notamment de faibles performances d’entraînement. Confirmez que la fonctionnalité voulue marche sur vos versions de macOS et de PyTorch avant d’adopter une configuration riche en extensions.
Les extensions exécutent du code dans l’environnement de l’application. Épinglez-les, relisez les mises à jour et gardez le service sur la boucle locale, sauf si un accès distant est voulu et protégé.
Fooocus : SDXL uniquement, corrections de bugs uniquement
Fooocus masque volontairement de nombreux choix techniques derrière un workflow directif centré sur le prompt. Cela peut être utile quand ses valeurs par défaut correspondent à la tâche.
Le README actuel du projet indique que Fooocus est construit autour de SDXL et qu’il est en support à long terme limité, avec uniquement des corrections de bugs. Il précise aussi que Mac n’est pas testé de façon intensive et décrit l’installation sur Mac comme non officielle : un environnement conda, un git clone et python entry_with_update.py, qui télécharge les modèles SDXL au premier lancement. Fooocus convient donc à un workflow Fooocus existant, pas comme voie par défaut pour les nouvelles architectures ni pour une configuration macOS que vous comptez maintenir.
Exécuter un test d’acceptation représentatif
Utilisez un petit jeu de tests d’acceptation avant de vous engager sur un outil :
- Reproduisez un résultat texte vers image de référence à partir d’une seed et de réglages enregistrés.
- Exécutez l’opération requise la plus difficile : inpainting, ControlNet, LoRA, upscaling ou graphe à plusieurs étapes.
- Redémarrez l’application et reproduisez le workflow à partir des fichiers enregistrés.
- Mesurez le démarrage à froid, le temps de génération, la pression mémoire maximale et les dimensions de sortie.
- Déplacez le workflow vers un compte utilisateur ou une machine propre et listez chaque dépendance manquante.
- Vérifiez l’écoute sur le réseau local, les téléchargements, les réglages d’analytique, les licences et la provenance des modèles.
Ne comparez pas des outils avec des checkpoints, des résolutions, des nombres d’étapes ou des précisions différents pour ensuite présenter le résultat comme un benchmark d’exécution.
Un choix par défaut pratique
Pour un travail exploratoire, commencez par une application native et un modèle qu’elle documente. Passez à ComfyUI quand le workflow lui-même prend de la valeur : quand il doit être relu, répété, automatisé ou transmis à quelqu’un d’autre. Passez à InvokeAI quand le travail consiste surtout à retoucher des zones sur un canevas. Gardez AUTOMATIC1111 ou Fooocus quand une dépendance existante rend leur interface utile.
Références
- Documentation de Draw Things et Metal FlashAttention dans Draw Things
- Projet DiffusionBee
- Documentation ComfyUI Desktop pour macOS, cask Homebrew de Comfy Desktop, format API des workflows et métadonnées de workflow dans les fichiers de sortie
- Installation d’InvokeAI et configuration requise
- Notes d’installation d’AUTOMATIC1111 sur Apple Silicon
- État du projet Fooocus et notes sur macOS
- Notes de sécurité de Hugging Face sur les pickles
- Documentation Apple Metal sur la mémoire unifiée,
recommendedMaxWorkingSetSizeet documentation Moniteur d’activité sur la pression mémoire