Stable Diffusion en macOS: comparación de herramientas locales de imagen

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Para ejecutar modelos de imagen en local en macOS, lo primero es elegir una herramienta. Esta guía es para usuarios de Mac que quieren generar imágenes en local: verás para qué sirve cada una de las seis herramientas, cómo se instala, qué necesita un modelo además de su archivo y cómo probar una herramienta en tu equipo antes de comprometerte con ella.
Draw Things, DiffusionBee, ComfyUI, InvokeAI, AUTOMATIC1111 y Fooocus se solapan, pero difieren en instalación, compatibilidad con modelos, control del workflow, extensiones, automatización y mantenimiento. Una aplicación de arrastrar y soltar permite empezar rápido; un grafo de nodos requiere más tiempo de aprendizaje, pero expone más partes del pipeline. En Apple Silicon, la aplicación, la familia de modelos, la precisión, el tamaño de la imagen y el workflow influyen en que la generación quepa en memoria.
Qué ejecuta una aplicación local de imágenes
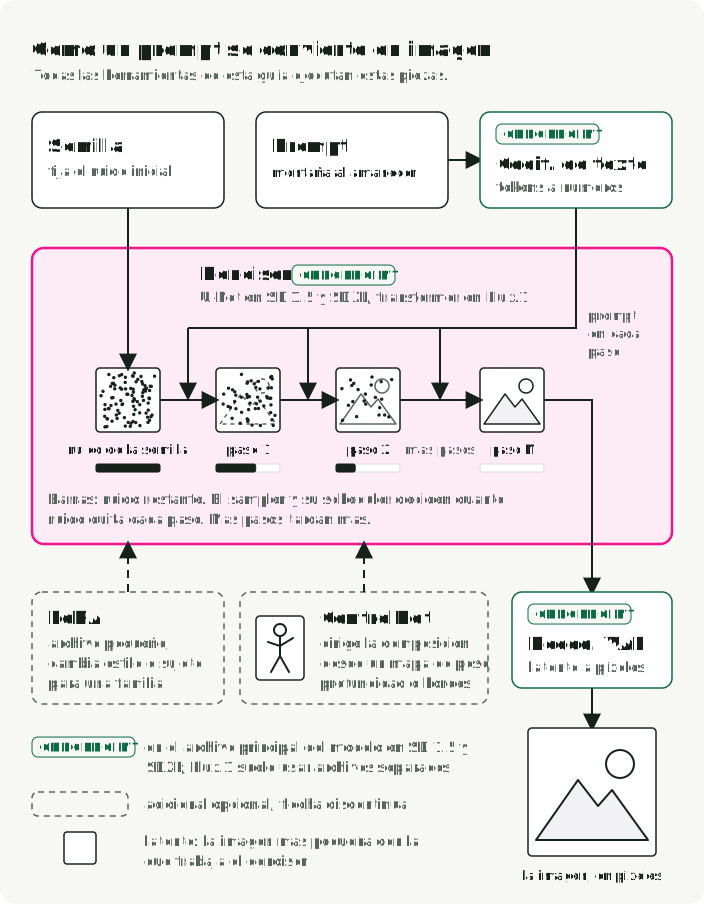
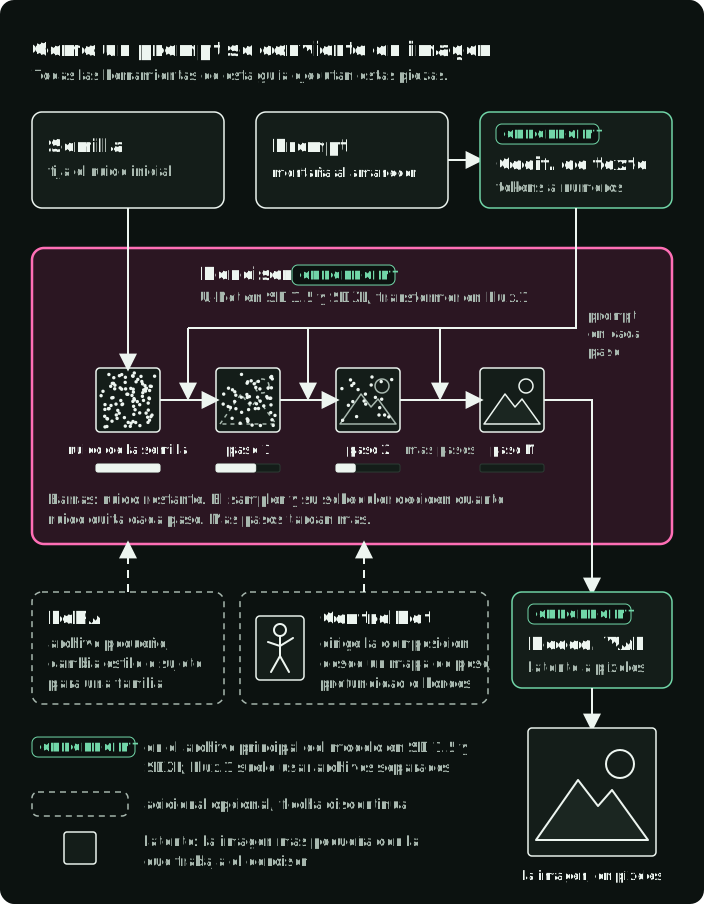
Todas las herramientas de esta guía ejecutan el mismo tipo de pipeline. En su centro está el denoiser: una U-Net en SD 1.5 y SDXL, un transformer en Flux.1. Parte de ruido aleatorio y elimina un poco en cada paso, guiado por el prompt. Las demás piezas preparan sus entradas o convierten su salida en una imagen:
| Pieza | Qué hace |
|---|---|
| Checkpoint | El archivo principal del modelo. Contiene el denoiser y, en SD 1.5 y SDXL, normalmente también el codificador de texto y el VAE. Flux.1 suele distribuir estas piezas como archivos separados. |
| Codificador de texto | Convierte el prompt en números que el denoiser puede usar. Antes, un tokenizador divide el prompt en tokens. |
| VAE | Convierte entre píxeles y la imagen “latente”, más pequeña, con la que trabaja el denoiser. Su decodificador convierte el latente final en la imagen que ves. |
| Sampler y pasos | La semilla fija el ruido inicial. El sampler, junto con su scheduler, decide cuánto ruido elimina cada paso. Más pasos tardan más. |
| LoRA | Un pequeño archivo complementario que cambia el estilo o el tema de la familia de modelos para la que se entrenó. Un embedding de textual inversion es un complemento más pequeño que enseña al codificador de texto una palabra nueva. |
| ControlNet | Un modelo adicional que dirige la composición a partir de una imagen de control, como una pose, un mapa de profundidad o un mapa de bordes. |
En la figura, sigue el latente desde el ruido de la semilla hasta el paso N: el prompt llega al denoiser en cada paso, las barras muestran cuánto ruido queda, LoRA y ControlNet son entradas opcionales y el decodificador del VAE convierte el latente pequeño en la imagen. Las etiquetas CHECKPOINT marcan las piezas que suele contener un solo archivo de checkpoint.
Cómo conseguir modelos
La mayoría de las herramientas pueden descargar un modelo inicial por ti. Para todo lo demás, dos sitios cubren casi todas las necesidades:
- Hugging Face aloja los modelos base oficiales de Stability AI, Black Forest Labs y otros. Lee la licencia en la ficha del modelo: las licencias difieren incluso dentro de una misma familia, como FLUX.1 [schnell] (Apache 2.0) y FLUX.1 [dev] (una licencia no comercial). Algunos repositorios piden que aceptes la licencia antes de empezar la descarga.
- Civitai aloja checkpoints, LoRAs y embeddings de la comunidad. Cada página indica el modelo base para el que se entrenó el archivo.
Prefiere archivos .safetensors. Un archivo .ckpt es un pickle de Python, y cargar un pickle puede ejecutar código arbitrario. Un archivo .safetensors almacena solo tensores. Carga un .ckpt únicamente si procede de una fuente de confianza.
Antes de descargar varios gigabytes, comprueba la familia del modelo (SD 1.5, SDXL, Flux.1, etc.) con lo que admite tu herramienta. Un LoRA entrenado para SDXL no funciona con un checkpoint de SD 1.5.
Un archivo de modelo no es un workflow portable
Varias aplicaciones pueden cargar archivos .safetensors, pero que la extensión coincida no significa que el modelo vaya a funcionar. Un pipeline completo puede requerir además una arquitectura, un codificador de texto, un VAE, un scheduler, un ControlNet, un LoRA o una configuración propia de la aplicación.
Registra todo lo que produjo una imagen:
- aplicación y versión
- repositorio del modelo, revisión y licencia
- todos los componentes y adaptadores del modelo
- prompt, prompt negativo, semilla, sampler, pasos, guidance y dimensiones
- archivo del grafo o del workflow cuando la aplicación lo ofrezca
La misma semilla puede producir una imagen distinta tras cambiar el backend, el modelo, el sampler o la precisión.
Memoria, espacio en disco y el software bajo cada herramienta
En Apple Silicon, la CPU y la GPU comparten un único conjunto de memoria. La GPU puede usar la mayor parte, así que un Mac con 32 GB puede cargar modelos que no caben en una tarjeta gráfica típica de 8 a 12 GB. Ese mismo conjunto también aloja macOS y todas las aplicaciones abiertas; el Monitor de Actividad muestra el uso de memoria de apps, reservada, comprimida y de intercambio.
El pico de memoria durante la generación tiene cuatro partes: los componentes del modelo, la memoria de trabajo para activaciones y atención, los adaptadores y modelos de control cargados, y la memoria que ya usan macOS y tus aplicaciones. La parte superior de la figura las representa como partes de la misma memoria, junto con la memoria que queda libre; no es una fórmula de dimensionamiento. La parte inferior compara ejemplos de tamaños de descarga sin cuantización. Estas barras miden el uso de disco, no la memoria durante la ejecución.
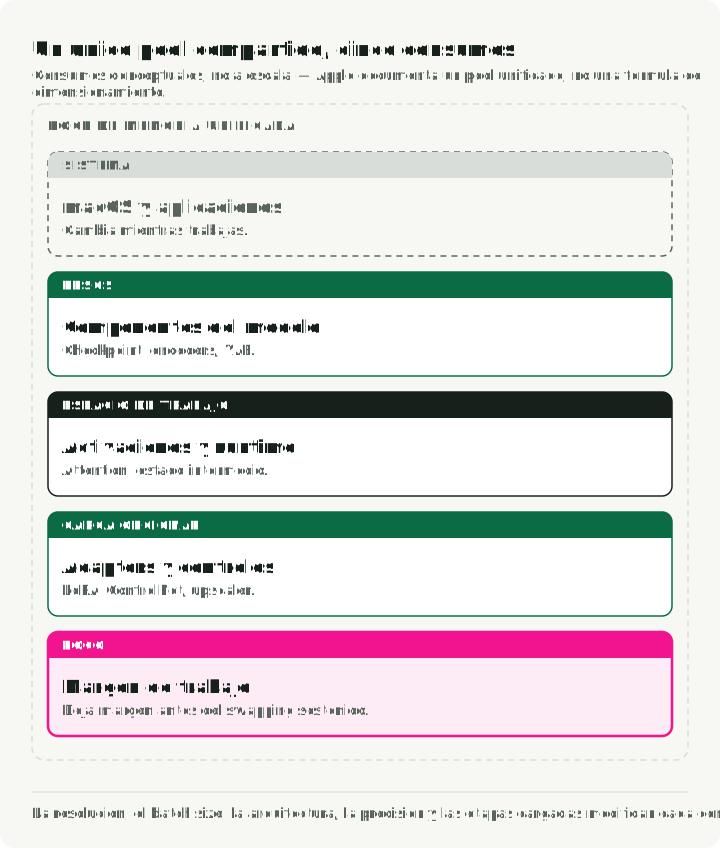
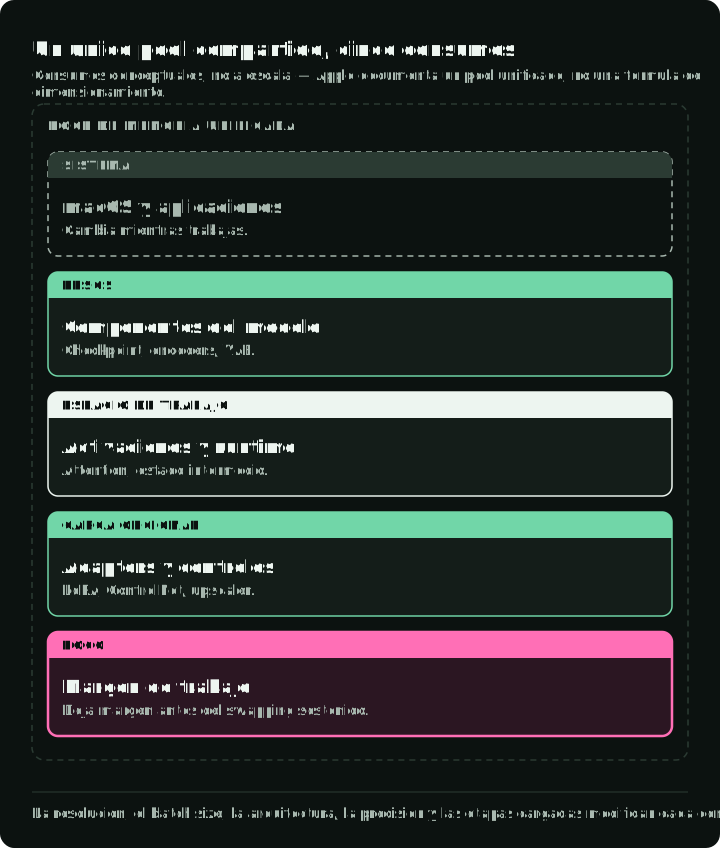
La resolución, el tamaño del lote, la arquitectura del modelo, el escalado y ControlNet cambian el uso de memoria durante la ejecución. El tamaño de descarga estima el uso de disco; la memoria durante la ejecución depende de la precisión y la cuantización que carga la aplicación, de los componentes que siguen cargados y de los tensores temporales creados durante la generación. La cuantización almacena los pesos con menos bits, y Draw Things puede cargar los pesos de FLUX.1 bajo demanda en vez de mantenerlos todos en memoria. Prueba el workflow previsto y observa la presión de memoria y el intercambio usado; un intercambio sostenido es motivo para reducir la carga o elegir más memoria.
Planifica el espacio en disco por separado. Estas descargas sin cuantización en Hugging Face incluyen un checkpoint de SD 1.5 de unos 4 GB y un checkpoint base de SDXL de unos 7 GB. Solo el transformer de FLUX.1 [schnell] ocupa unos 24 GB, y un codificador de texto T5 de 16 bits añade unos 10 GB. FLUX necesita otros componentes, así que estos dos archivos no constituyen su descarga completa. Si tu Mac tiene poco espacio, guarda las carpetas de modelos en un SSD externo.
Las herramientas también difieren en el software que hay entre ellas y la GPU. ComfyUI, AUTOMATIC1111, Fooocus e InvokeAI son aplicaciones de Python que se ejecutan sobre el backend Metal de PyTorch, llamado MPS (Metal Performance Shaders), así que sus funciones y su velocidad dependen de la versión de PyTorch instalada. Draw Things usa su propio motor con kernels de Metal FlashAttention. Todas terminan en Metal y en el mismo conjunto de memoria unificada.
Seis herramientas comparadas
| Herramienta | Instalación | Qué puedes controlar | Contrapartida operativa |
|---|---|---|---|
| Draw Things | Mac App Store | Interfaz nativa de Apple con modelos locales, adaptadores, ControlNet y scripts | Interfaz densa y propia del producto; comprueba la compatibilidad con la familia de modelos exacta |
| DiffusionBee | Descarga de DMG | Aplicación de macOS empaquetada con un workflow de generación integrado | Sin versiones desde la 2.5.3, de agosto de 2024; sin compatibilidad con las familias de modelos publicadas después |
| ComfyUI | DMG de Comfy Desktop o brew install --cask comfy | Grafo de nodos explícito, workflows en JSON, API y nodos personalizados | Más componentes; los grafos y los nodos de terceros se convierten en dependencias |
| InvokeAI | DMG de Invoke Launcher | Lienzo con inpainting y outpainting, además de un editor de workflows de nodos | Requiere macOS 14 o posterior; la documentación recomienda 16 GB de memoria o más |
| AUTOMATIC1111 | Paquetes de Homebrew, git clone y ./webui.sh | Interfaz web basada en formularios, scripts, API y un gran conjunto de extensiones | Última versión en febrero de 2025; limitaciones documentadas en Apple Silicon; las extensiones ejecutan código de terceros en el mismo entorno |
| Fooocus | git clone y un entorno conda (no oficial en Mac) | Workflow SDXL con criterio propio, centrado en el prompt | Solo correcciones de errores; la guía para Mac no es oficial y está poco probada |
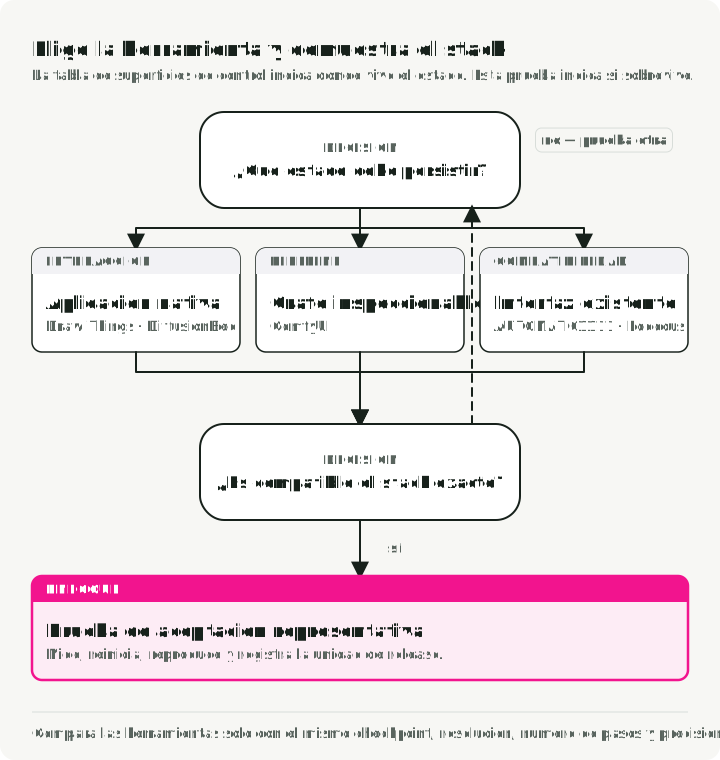
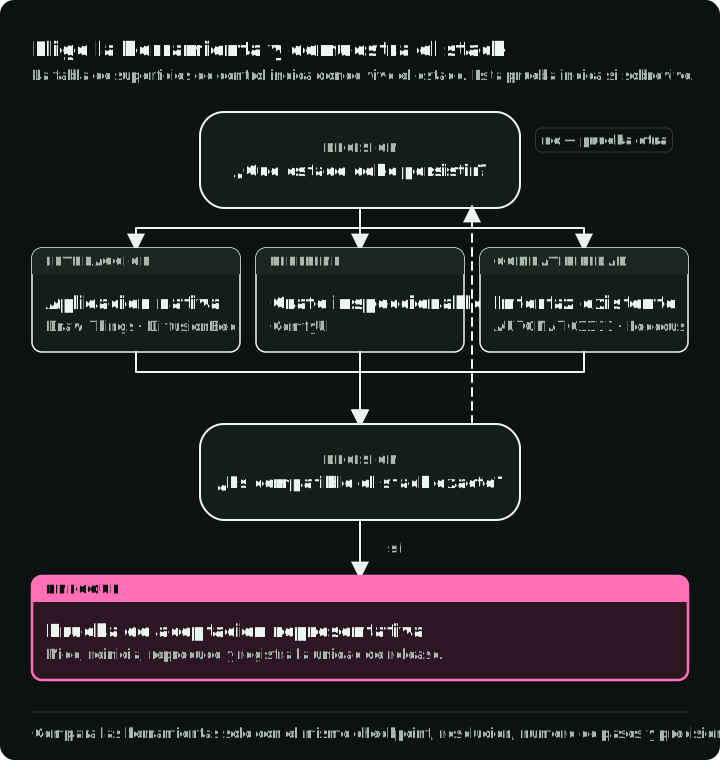
La tabla muestra dónde se guardan tus ajustes: dentro de la aplicación, en un formulario web o en un archivo de grafo que puedes revisar. La figura parte de una aplicación nativa y muestra cuándo pasar a otra herramienta, con un esquema de dónde guarda cada una tus ajustes. Ejecuta la prueba de aceptación del final de este artículo antes de comprometerte con cualquiera de ellas.
Draw Things: interacción nativa y scripting
Draw Things es una aplicación para plataformas Apple que genera imágenes en local. Instálala desde la Mac App Store; no necesita Python ni terminal. Su documentación actual cubre modelos, LoRAs, ControlNet, textual inversion, Core ML y scripting en JavaScript con versiones.
Elígela cuando el trabajo deba quedarse dentro de una aplicación nativa pero necesite más control que un cuadro de prompt. Antes de estandarizarla, importa los componentes exactos del modelo y reproduce una edición, un adaptador o un workflow de control representativos. “Nativa” describe la interfaz y la implementación; no garantiza compatibilidad ni velocidad con cada arquitectura nueva.
DiffusionBee: workflow empaquetado para macOS
DiffusionBee empaqueta la descarga de modelos y las tareas de generación habituales en una aplicación de escritorio. Descarga el DMG y mueve la aplicación a Aplicaciones. La documentación del proyecto menciona image-to-image, inpainting, outpainting, ControlNet, LoRA y SDXL, y la aplicación incluye escalado. Las notas de la versión 2.5.3 de DiffusionBee indican compatibilidad con Flux.1 solo en Mac arm64 con macOS 13 o posterior.
La última versión de DiffusionBee, la 2.5.3, salió en agosto de 2024, y la página de descarga de diffusionbee.com sigue enlazando la 2.5.1; consigue la 2.5.3 en la página de versiones de GitHub. No esperes compatibilidad con familias de modelos publicadas después. Elígela cuando importen más la instalación y una interfaz integrada que exportar un grafo del pipeline, y cuando el modelo que necesitas sea uno de los que ya enumera. Una etiqueta como “compatibilidad con Flux” no significa que se cargue cualquier derivado, cuantización o componente auxiliar.
ComfyUI: un workflow guardado como archivo
ComfyUI representa la generación como un grafo de nodos. Cada paso es un nodo y el grafo puede ramificarse: un mismo grafo puede generar una imagen, escalarla y pasarla a un nodo de restauración de rostros de un paquete de nodos personalizados. Un workflow puede guardarse como JSON independientemente de su resultado, lo que hace que el pipeline se pueda inspeccionar y versionar. Su ejecutor también puede evitar recalcular las secciones del grafo cuyas entradas no han cambiado.
Comfy Desktop es un gestor de varias instalaciones para instancias locales de ComfyUI. La documentación actual de macOS admite Apple Silicon con macOS 13 o posterior. La instalación utiliza un .dmg descargado. Si prefieres Homebrew, el cask actual es comfy (no comfyui):
brew install --cask comfyElige ComfyUI cuando un pipeline tenga ramas, componentes reutilizables, varios modelos o automatización. Guarda juntos el JSON, la versión de la aplicación, las versiones de los nodos del núcleo, las revisiones de los nodos personalizados y el manifiesto de modelos.
¿Cómo ejecutas el mismo grafo desde un script con una semilla nueva? Exporta el grafo con File → Export Workflow (API). El formato de API identifica cada nodo por su ID numérico y conserva solo las entradas necesarias para ejecutarlo. Después, envíalo al endpoint /prompt del servidor local:
import json
import random
import urllib.request

COMFY_URL = "http://127.0.0.1:8188"  # check the port first, see below
SAMPLER_NODE = "3"  # the KSampler node ID in your exported file

with open("workflow_api.json") as f:
    workflow = json.load(f)

workflow[SAMPLER_NODE]["inputs"]["seed"] = random.randint(0, 2**32 - 1)

request = urllib.request.Request(
    f"{COMFY_URL}/prompt",
    data=json.dumps({"prompt": workflow}).encode("utf-8"),
    headers={"Content-Type": "application/json"},
)
with urllib.request.urlopen(request) as response:
    print(json.load(response))  # includes the prompt_id of the queued run
Fíjate en dos cosas del archivo exportado: el ID del nodo sampler ("3" en el ejemplo de API del propio ComfyUI) y su campo inputs, que contiene la semilla, los pasos y el nombre del sampler. Comprueba el puerto antes de ejecutar el script: una instalación manual escucha por defecto en el 8188, y Comfy Desktop puede usar otro puerto, que aparece en los ajustes de su servidor.
Los nodos personalizados son dependencias ejecutables. Revisa su código fuente y sus scripts de instalación, fija las revisiones y aísla el entorno. Un grafo de un autor desconocido puede hacer referencia a código y modelos que no has auditado.
InvokeAI: un lienzo para inpainting y outpainting
InvokeAI gira en torno a un lienzo: seleccionas con una máscara el área que quieres cambiar y sigues generando en la misma vista. El inpainting regenera una zona enmascarada dentro de la imagen; el outpainting la extiende más allá de sus bordes actuales. También tiene un editor de workflows basado en nodos para los pipelines que quieras guardar y compartir. El proyecto sigue publicando versiones con regularidad; la v6.14.2 salió en septiembre de 2026.
Instálalo con el Invoke Launcher: abre el DMG, arrastra el launcher a Aplicaciones y ejecútalo. El launcher instala Python e Invoke por ti. Los requisitos del sistema indican macOS 14 o posterior, afirman que funcionan todos los Mac con Apple Silicon y recomiendan 16 GB de memoria o más.
Elígelo cuando la mayor parte de tu trabajo consista en editar partes de una imagen en lugar de generar imágenes completas a partir de un prompt.
AUTOMATIC1111: compatibilidad con una interfaz web consolidada
AUTOMATIC1111 Stable Diffusion WebUI expone los ajustes de generación mediante una interfaz de navegador y admite scripts, extensiones y una API. Elígelo cuando un tutorial, una automatización o una extensión concretos ya formen parte del requisito. La última versión, la v1.10.1, salió en febrero de 2025, así que comprueba la compatibilidad con cualquier familia de modelos publicada después antes de elegirlo.
En un Mac se ejecuta sobre el backend MPS de PyTorch. La guía oficial para Apple Silicon lo instala desde el terminal; ./webui.sh crea un entorno de Python e instala el resto de las dependencias en la primera ejecución:
brew install cmake protobuf rust python@3.10 git wget
git clone https://github.com/AUTOMATIC1111/stable-diffusion-webui
cd stable-diffusion-webui
./webui.sh
La misma guía documenta excepciones y limitaciones de rendimiento, entre ellas un rendimiento de entrenamiento débil. Confirma que la función necesaria funciona en las versiones de macOS y PyTorch de destino antes de adoptar una configuración con muchas extensiones.
Las extensiones ejecutan código dentro del entorno de la aplicación. Fíjalas a una versión, revisa las actualizaciones y mantén el servicio en loopback salvo que el acceso remoto sea deliberado y esté protegido.
Fooocus: solo SDXL, solo correcciones de errores
Fooocus oculta deliberadamente muchas decisiones técnicas tras un workflow con criterio propio y centrado en el prompt. Eso puede ser útil cuando sus valores por defecto encajan con la tarea.
El README actual del proyecto dice que Fooocus está construido en torno a SDXL y se encuentra en soporte limitado a largo plazo, con solo correcciones de errores. También dice que Mac no se prueba de forma intensiva y describe la instalación en Mac como no oficial: un entorno conda, un git clone y python entry_with_update.py, que descarga los modelos SDXL en la primera ejecución. Por eso Fooocus es una opción para un workflow de Fooocus ya existente, no el camino por defecto para arquitecturas nuevas ni para una instalación en macOS que vayas a mantener.
Ejecuta una prueba de aceptación representativa
Usa un pequeño conjunto de pruebas de aceptación antes de comprometerte con una herramienta:
- Reproduce un resultado base de texto a imagen a partir de una semilla y unos ajustes registrados.
- Ejecuta la operación más exigente que necesites: inpainting, ControlNet, LoRA, escalado o un grafo de varias etapas.
- Reinicia la aplicación y reproduce el workflow a partir de los archivos guardados.
- Mide el arranque en frío, el tiempo de generación, la presión de memoria máxima y las dimensiones de salida.
- Lleva el workflow a una cuenta de usuario o a un equipo limpios y enumera todas las dependencias que falten.
- Verifica el enlace a la red local, las descargas, los ajustes de analítica, las licencias y la procedencia de los modelos.
No compares herramientas con checkpoints, resoluciones, números de pasos o precisión distintos para llamar después al resultado un benchmark de ejecución.
Una opción por defecto práctica
Para el trabajo exploratorio, empieza con una aplicación nativa y un modelo que esta documente. Pasa a ComfyUI cuando el propio workflow se vuelva valioso: cuando haya que revisarlo, repetirlo, automatizarlo o entregarlo a otra persona. Pasa a InvokeAI cuando el trabajo consista sobre todo en editar regiones sobre un lienzo. Conserva AUTOMATIC1111 o Fooocus cuando una dependencia existente haga útil su interfaz concreta.
Referencias
- Documentación de Draw Things y Metal FlashAttention en Draw Things
- Proyecto DiffusionBee
- Documentación de ComfyUI Desktop para macOS, cask de Homebrew de Comfy Desktop, formato de API de workflows y metadatos de workflow en los archivos de salida
- Instalación de InvokeAI y requisitos del sistema
- Notas de instalación de AUTOMATIC1111 en Apple Silicon
- Estado del proyecto Fooocus y notas sobre macOS
- Notas de seguridad de Hugging Face sobre pickle
- Documentación de memoria unificada de Apple Metal,
recommendedMaxWorkingSetSizey la documentación de presión de memoria del Monitor de Actividad