TypeScript für Python-ML-Engineers: einen Agent-Service bauen

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Leitfaden richtet sich an erfahrene Python-ML- und Backend-Engineers, die einen AI-Service in TypeScript und Node bauen müssen. Er geht von Python-Service-Konzepten aus, nicht von Programmiergrundlagen oder Browser-Code. Am Ende kannst du einen Python-Service-Stack auf TypeScript abbilden, die Python-Gewohnheiten erkennen, die in JavaScript zu Bugs führen, und einen Streaming-Agent-Service ausführen und ändern.
Der Beispiel-Service verfolgt eine Anfrage durch Validierung, Tool-Ausführung, HTTP-Streaming und Persistenz. Er beantwortet drei Fragen: Was passiert, wenn Tool-Argumente in Fragmenten ankommen, ein Stream nach HTTP 200 fehlschlägt oder ein Worker denselben Job zweimal übernimmt? Der Umfang beschränkt sich auf Backend- und AI-Arbeit: kein React und kein Browser-Bundler.
Der Code liegt in slavadubrov/typescript-agent-service. Er enthält zwei Agent-Loop-Implementierungen, Postgres-Run-History, einen Worker und einen MCP-Server. Du kannst die Offline-Demo ohne API-Schlüssel ausführen und dann mit der Python-zu-TypeScript-Übersicht unten den Service lesen und ändern. Rechenintensive Numerik bleibt in Python; dieser Leitfaden behandelt Orchestration, HTTP und Streaming.
Zuerst das Begleit-Repository ausführen
Installiere Node 24 und pnpm gemäß der offiziellen pnpm-Installationsanleitung. Klone dann das Begleit-Repository und führe aus:
pnpm install
pnpm demo
pnpm check
pnpm demo testet den HTTP-Handler, den Agent Loop und den SSE-Stream mit einem
geskripteten Model. Es ruft auch die runSweep-Berechnung des Workers auf. Es
startet weder den Worker-Prozess noch dessen Datenbank-Queue. Die Demo braucht
keinen API-Schlüssel, keine Datenbank und kein Docker. pnpm check führt den
Type Checker, den Linter, die Formatierungsprüfung und die Tests aus.
Die Demo gibt die SSE-Frames einer Chat-Anfrage aus, danach den Sweep des Workers. Gekürzt:
event: tool_call
data: {"type":"tool_call","callId":"call_1","toolName":"estimate_kv_cache","args":{"model":"llama-3.1-8b","seqLen":32768,"batchSize":16}}

event: tool_result
data: {"type":"tool_result","callId":"call_1","toolName":"estimate_kv_cache","ok":true,"result":{"model":"llama-3.1-8b","seqLen":32768,"batchSize":16,"kvCacheGiB":64},"durationMs":0}

event: done
data: {"type":"done","stopReason":"stop","steps":2,"text":"Llama-3.1-8B at 32k context and batch 16 needs 64 GiB of KV cache."}

--- worker: capacity sweep ---
batch=  1  kv_cache=4.0 GiB
batch= 16  kv_cache=64.0 GiB
Jeder event:/data:-Block ist ein SSE-Frame: Das Model fordert ein Tool an,
das Tool liefert sein Ergebnis, und der Run endet mit done. Der letzte Teil
ist der Batch-Size-Sweep des Workers.
So startest du die echte API und den Worker:
cp .env.example .env          # add OPENAI_API_KEY or an OpenAI-compatible URL
pnpm db:up                    # start Postgres in Docker
pnpm db:push                  # create the database schema
pnpm dev:api                  # API at http://localhost:8080
pnpm dev:worker               # run this in a second terminal
Streame einen Agent-Run. Die Antwort besteht aus einer Reihe von SSE-Frames wie in der Demo-Ausgabe oben:
curl -N -X POST localhost:8080/v1/chat \
  -H 'content-type: application/json' \
  -d '{"message":"How much KV cache for llama-3.1-70b at 32k context, batch 8?"}'
Stelle einen langen Job in die Queue und frage ihn dann ab. Der erste Aufruf
liefert 202 mit {"id":"...","status":"queued"}. Der zweite liefert die
gespeicherte Zeile, mit dem Ergebnis, sobald der Worker fertig ist:
curl -X POST localhost:8080/v1/sweeps \
  -H 'content-type: application/json' \
  -d '{"model":"llama-3.1-70b","seqLen":32768,"batchSizes":[1,4,16]}'

curl localhost:8080/v1/runs/<id>
Die obigen pnpm-Skripte sind die Befehle, die ich im Rest des Artikels
verwende. Das Repository legt die systemnäheren Node- und TypeScript-Befehle
hinter benannte pnpm-Skripte, ähnlich wie ein Python-Projekt uv run-Befehle
hinter make-Targets legen kann. Mische kein npm install in dieses
pnpm-Repository. Nutze pnpm install, damit pnpm-lock.yaml die einzige
Lockfile bleibt.
Was Node, npm, pnpm, TypeScript und tsx tun
Die ähnlichen Namen verbergen getrennte Aufgaben:
- JavaScript ist die Sprache.
- Node.js ist die Runtime, grob CPython für JavaScript. Installiere für dieses Projekt Node 24.
- Die npm-Registry ist der Paketindex, grob PyPI. Der Befehl
npmwird mit Node installiert und kann Pakete aus dieser Registry installieren. - pnpm ist der Paketmanager, den dieses Repository gewählt hat. Er
installiert aus der npm-Registry, verwaltet den Monorepo-Workspace und führt
die in
package.jsondeklarierten Befehle aus. package.jsonist das Projektmanifest, am ehesten vergleichbar mitpyproject.toml. Der Abschnittscriptsgibt längeren Befehlen Namen wiedemo,checkunddev:api.- TypeScript ist JavaScript mit statischen Typen. Der Befehl
tscprüft diese Typen. Das Repository führt ihn überpnpm checkoderpnpm typecheckaus. - tsx führt
.ts-Dateien ohne separaten Build aus. Die Entwicklungsskripte nutzen seinenwatch-Modus, um API oder Worker nach einer Änderung im Quellcode neu zu starten. In diesem Leitfaden rufst du ihn nicht direkt auf.
Führe in diesem Repository die pnpm-Skripte aus. Node ist die Runtime in
diesen Skripten, und das mitgelieferte Dockerfile übernimmt die Produktion.
Was jedes Skript ausführt:
pnpm demoführttsx scripts/demo.tsaus.pnpm dev:apiführttsx watchaus.pnpm checkführttsc, Biome (den Linter) und Vitest (den Test Runner) aus.- Das Docker-
CMDführtnode --import tsx/esmaus.
Alle laufen auf Node 24. In pnpm check lesen tsc und Biome nur Dateien;
Vitest führt die Tests auf Node aus.
Der Stack, abgebildet von Python
Zod, Hono, Drizzle, Vitest und Biome decken einen großen Teil dessen ab, was pydantic, FastAPI, SQLAlchemy, pytest und Ruff abdecken.
Die meisten Paare sind direkte Ersetzungen. Drei sind es nicht:
| Aspekt | Python | TypeScript | Warum es kein einfacher Austausch ist |
|---|---|---|---|
| Validierung | pydantic | zod | Das Schema ist die Quelle. Der Typ wird daraus erzeugt, nicht umgekehrt |
| Typprüfung | mypy | TypeScript (pnpm typecheck) | Typen werden entfernt, bevor der Code läuft. Keine Bibliothek kann sie lesen, daher braucht die Validierung zur Laufzeit ein separates Schema (Zod) |
| Job-Queue | celery + Redis | bullmq (Redis-basierte Queue) oder SQL | Postgres kann eine At-least-once-Queue umsetzen. Möglicherweise brauchst du keinen Broker |
Der Begleit-Service nutzt vier Bibliotheken, die eine Erklärung verdienen.
Hono für die HTTP-Schicht
Express und Fastify sind auf Node ausgerichtete Alternativen. Hono nutzt die
Web-Standard-APIs Request und Response
und bietet Adapter für Node und Serverless-Runtimes. Diese Portabilität ist für
diese kleine Streaming-API nützlich, deshalb habe ich Hono gewählt. Wähle
Fastify, wenn der Service nur auf Node läuft und du sein Plugin-Angebot und die
schemabasierte Serialisierung von Antworten willst.
Drizzle für SQL
Drizzle hält das Schema in TypeScript und braucht keinen Schritt zur Client-Generierung. Außerdem steht rohes SQL zur Verfügung, wenn der Query Builder eine Postgres-Klausel nicht sauber ausdrücken kann. Ich würde stattdessen Prisma wählen, wenn sein generierter Client und das umgebende Tooling besser zum Team passen.
Biome für Linting und Formatierung
Biome übernimmt Linting, Formatierung und Import-Sortierung mit einer Binärdatei und einer Konfigurationsdatei. Behalte ESLint, wenn das Projekt von eigenen Regeln abhängt, die Biome nicht bietet.
Vitest für Tests
Vitest führt die .ts-Tests des Begleit-Repositorys
ohne separate Transform-Konfiguration aus. Behalte Jest in einem Repository, das
bereits eine Jest-Konfiguration und eigene Matcher hat.
Die verwendete TypeScript-Syntax lesen
Lege diese Tabelle als Referenz neben die Service-Beispiele.
| TypeScript | Python / Hinweis |
|---|---|
(x) => expression | anonyme Funktion mit Ausdruck als Rumpf, ähnlich lambda x: expression |
(x) => { statements } | anonyme Funktion mit Anweisungen als Rumpf |
async (x) => { statements } | asynchrone anonyme Funktion |
const { model, seqLen } = request | liest die Eigenschaften model und seqLen aus request |
const [first] = xs | first = xs[0]. Bei einem leeren Array ergibt es undefined, keinen IndexError |
{ type: "error", message } | {"type": "error", "message": message}. Ein bloßer Name wird zu diesem Feld |
`text ${x}` | f-String |
cond ? a : b | a if cond else b |
const / let | Beide binden einen Namen. const verbietet Neubindung, let erlaubt sie |
export | macht einen Namen importierbar |
switch / case | match, nur dass Fälle durchfallen, sofern sie nicht mit break oder return enden |
for await | Iteration über einen asynchronen Generator |
i++ | erhöht und gibt den alten Wert zurück |
/^https?$/ | ein Regex-Literal, kein re.compile nötig |
T[], Map<K, V> | list[T], dict[K, V] |
Nutze const, solange sich die Bindung nicht ändern muss. Nutze let für einen
Zähler, einen Akkumulator oder eine andere Bindung, die du neu zuweist.
Eine kurze Enum-Übersetzung
Für Zustände mit String-Werten nutzt dieses Repository ein Objekt plus einen abgeleiteten String-Union-Typ:
const Status = { Queued: "queued", Running: "running" } as const;
type Status = (typeof Status)[keyof typeof Status]; // "queued" | "running"
Das Objekt liefert Status.Queued, während das Programm läuft. Die type-Zeile
erlaubt bei der Typprüfung nur "queued" oder "running". Zusammen erfüllen
sie die zwei Rollen dieser Python-Deklaration:
from enum import Enum

class Status(str, Enum):
    QUEUED = "queued"
    RUNNING = "running"
Du musst das Muster nur wiedererkennen. as const behält die Werte des Objekts
als exakte Strings, statt sie zu einem beliebigen string zu erweitern.
Die sieben semantischen Unterschiede, die Zeit kosten
Die Syntax-Tabelle bringt dich durch die Beispiele. An diesen semantischen Unterschieden führen Python-Gewohnheiten zu Bugs.
1. Leere Arrays und Objekte sind truthy
Pythons Regel “ein leerer Container ist falsy” ist die Gewohnheit, die sich am
schlechtesten übertragen lässt. if (results) ist für ein leeres Array wahr.
Schreibe if (results.length).
2. null und undefined sind verschieden
null markiert meist ein bewusstes Fehlen. undefined bedeutet meist, dass ein
Wert fehlt oder nicht zugewiesen ist, auch wenn Code es ausdrücklich zuweisen
kann. Bibliothekscode gibt ständig undefined zurück. Der Unterschied zeigt sich,
wenn du einen Default schreibst. || setzt die rechte Seite ein, sobald die
linke falsy ist. Das schließt 0, "" und false ein. ?? setzt sie nur für
null und undefined ein. So ist 0 || 10 gleich 10, während 0 ?? 10
gleich 0 ist. Auf diese Weise wird aus einer Batch Size von null stillschweigend zehn.
3. Ein catch-Block erhält unknown
Es gibt kein except ValueError:. Ein einziger catch-Block bekommt alles.
Weil JavaScript erlaubt, einen String, eine Zahl oder null zu werfen, typisiert
TypeScript den gefangenen Wert unter strict als unknown, seinen Typ für
“kann buchstäblich alles sein”. Das Begleit-Repository aktiviert strict, und
neue Projekte sollten das im Allgemeinen auch tun. Um den Fehler zu untersuchen,
grenze den Wert zuerst ein:
try {
    await risky();
} catch (error) {
    // `error` is `unknown` until you prove otherwise. This line is the
    // TypeScript equivalent of `except Exception as e:` and it is not
    // optional.
    const message = error instanceof Error ? error.message : String(error);
}
4. Promises starten sofort
Der Aufruf einer async-Funktion führt ihren Rumpf sofort aus und gibt ein
Promise zurück. Ein Python-Coroutine-Objekt tut nichts, bis du es mit await abwartest oder
einplanst. Promise.all entspricht ungefähr asyncio.gather.
Promise.allSettled entspricht ungefähr gather(..., return_exceptions=True),
nur dass jedes Ergebnis als { status, value } oder { status, reason }
verpackt wird.
Node übernimmt das Scheduling zur Laufzeit. Es hält den Prozess am Leben, solange
aktive Handles oder Anfragen wie Timer und Sockets existieren. Ein gewöhnliches
ausstehendes Promise allein hält Node nicht am Leben. Du verpackst das Programm
nicht in asyncio.run. In einem ES-Modul kannst du auf oberster Ebene await
verwenden, wenn der Start auf eine asynchrone Operation warten muss.
5. JavaScript hat einen gewöhnlichen numerischen Typ
Der Typ number in JavaScript speichert Werte als 64-Bit-Gleitkommazahlen, etwa
wie Pythons float. Der technische Standard für dieses Format heißt IEEE 754.
Dezimalwerte sind Näherungen, daher ist 0.1 + 0.2 nicht exakt 0.3, und
ganze Zahlen bleiben nur bis 2**53 - 1 exakt, also 9,007,199,254,740,991.
Halte 64-Bit-IDs an Service-Grenzen als Strings. Wird ein Postgres-bigint in
ein JavaScript-number umgewandelt, kann er gerundet werden. Für größere exakte
ganze Zahlen bietet JavaScript den separaten Typ BigInt, der sich nicht mit
gewöhnlichen Zahlen mischen lässt.
6. Nutze Map, wenn du ein Dictionary im Python-Stil brauchst
In JavaScript erzeugt {} ein Objekt. Objekte stellen meist Records mit
benannten Feldern dar:
const request = { model: "gpt-5", seqLen: 4096 };
console.log(request.model);
Ein Objekt ist keine saubere Key-Value-Tabelle wie ein Python-dict. Es erbt
einige Namen von JavaScript selbst. Das kann ein überraschendes Ergebnis liefern:
const tools: Record<string, unknown> = {};

tools["constructor"]; // a built-in function, not a missing value
Object.hasOwn(tools, "constructor"); // false
Wenn ein externer String ein Feld eines Objekts auswählt, rufe Object.hasOwn
auf, bevor du es liest. Wenn du ein allgemeines Dictionary brauchst, nutze Map.
Map kommt Pythons dict näher: Ein Schlüssel existiert nur, wenn dein Code ihn
hinzufügt.
const tools = new Map<string, unknown>();
tools.get("constructor"); // undefined
7. Die Dateiendung in relativen Imports angeben
Eine JavaScript-Quelldatei, die Code mit anderen Dateien teilt, heißt Modul.
Dieses Projekt nutzt das moderne Modulformat, ES-Module, meist ESM
abgekürzt. ES steht für ECMAScript, den formalen Namen der Sprache JavaScript.
In der Praxis ist ESM die Syntax mit import und export, die dieses Projekt
durchgehend verwendet.
Bei einem relativen Import verlangt Node den exakten Dateinamen. Es rät nicht,
ob ./env für ./env.ts oder ./env.js steht:
import { loadEnv } from "./env.ts";Imports aus installierten Paketen oder Workspace-Paketen verwenden weiterhin den Paketnamen, ohne Dateiendung:
import { z } from "zod";
import { runAgent } from "@agent/core";
Zod: Schema deklarieren, Typ ableiten
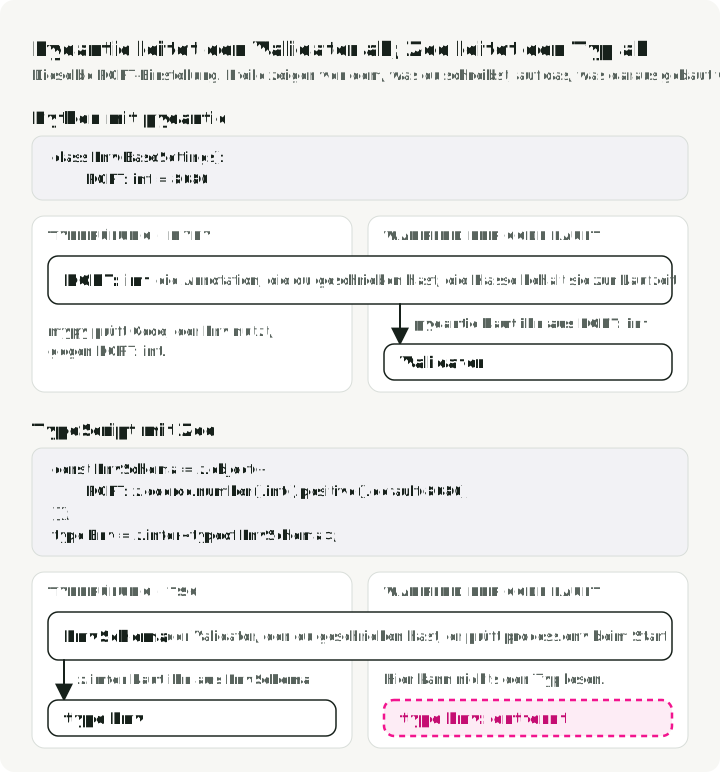
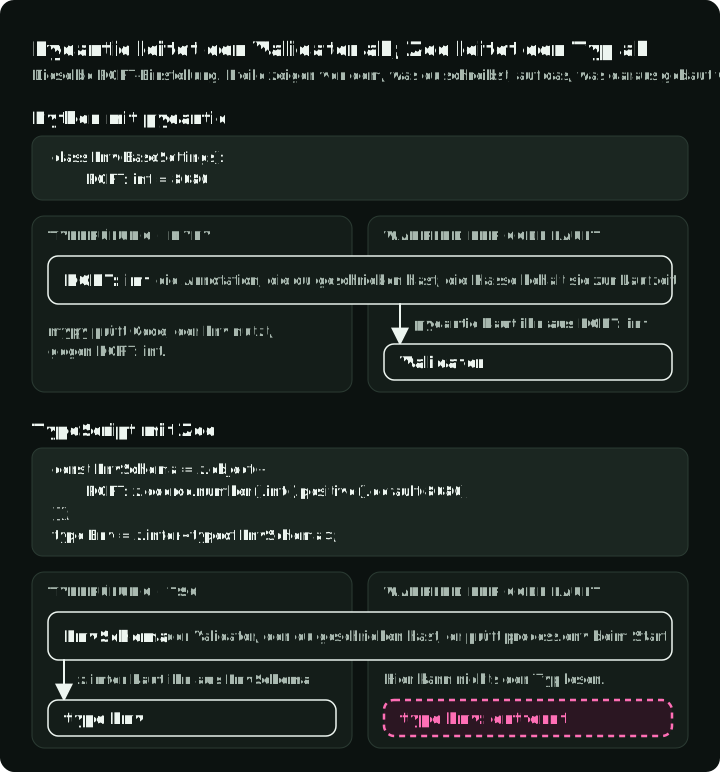
In pydantic deklarierst du eine Klasse und bekommst einen Validator. In Zod deklarierst du einen Validator und leitest den Typ daraus ab. Dieselbe Single Source of Truth, nur in die entgegengesetzte Richtung.
Die Abbildung zeigt dieselbe Einstellung PORT in beiden Varianten und was von
jeder Deklaration übrig bleibt, während der Code läuft.
Aus packages/schemas/src/env.ts:
import { z } from "zod"; // `z` is Zod's whole API, the way `pd` is pandas

const EnvSchema = z.object({
    PORT: z.coerce.number().int().positive().default(8080),
    // See the note below: a bare z.url() would accept "localhost:8000".
    OPENAI_BASE_URL: z
        .url({ protocol: /^https?$/ })
        .default("https://api.openai.com/v1"),
    DATABASE_URL: z.string().optional(),
});

export type Env = z.infer<typeof EnvSchema>;
z.infer<typeof EnvSchema> liest einen statischen Typ aus dem Laufzeit-Schema
zurück. z.coerce.number() löst das Problem, dass jeder definierte Wert in
process.env (Nodes os.environ) ein String ist. Es erfüllt dieselbe Rolle wie
die Umwandlung numerischer Einstellungen in pydantic, auch wenn sich die exakten
Strings unterscheiden, die beide akzeptieren. Das folgt dem Muster von
pydantic-settings und läuft einmal beim Start. Eine ungültige Umgebung führt
dann zu einem lesbaren Startfehler statt zu einem TypeError in einem Handler.
Ein bloßes z.url() akzeptiert localhost:8000. Der URL-Standard behandelt alles
vor dem ersten Doppelpunkt als Schema. Er liest localhost: daher als Protokoll
namens “localhost” und akzeptiert den String. Der Wert erreicht dann den
HTTP-Client und schlägt dort mit weniger Kontext fehl. Schema-Validierung
verlagert Fehler nach vorn, setzt aber auch ein zu lockeres Schema durch, wenn du
ein solches geschrieben hast.
Zod 4 liefert außerdem z.toJSONSchema mit, sodass dieses Projekt die in
älteren Tutorials verbreitete Abhängigkeit zod-to-json-schema nicht braucht.
Das zählt, sobald ein Schema drei Verbraucher bedienen muss, worum es im
Abschnitt “Ein Tool, drei Verbraucher” unten geht.
Der Service
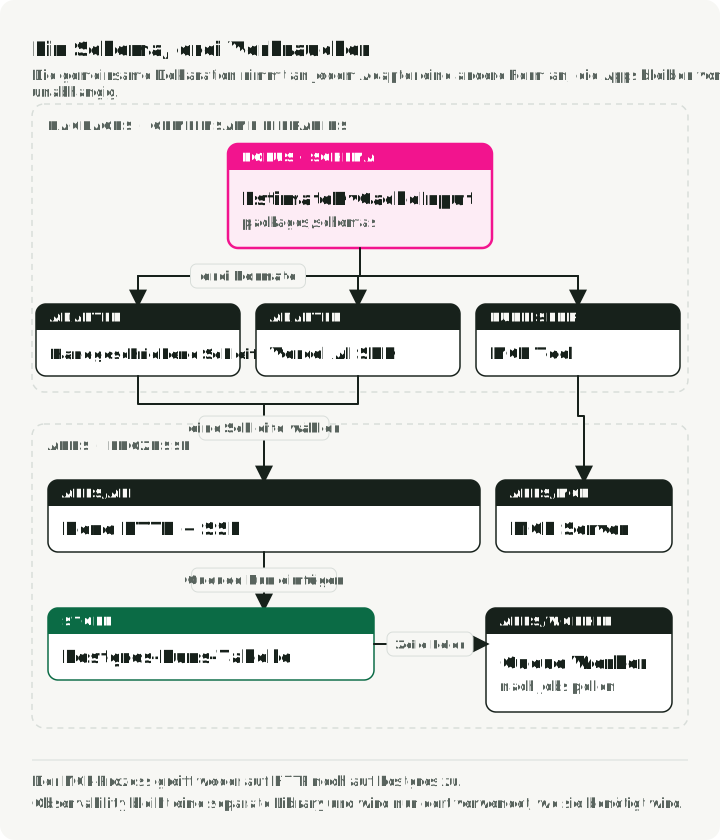
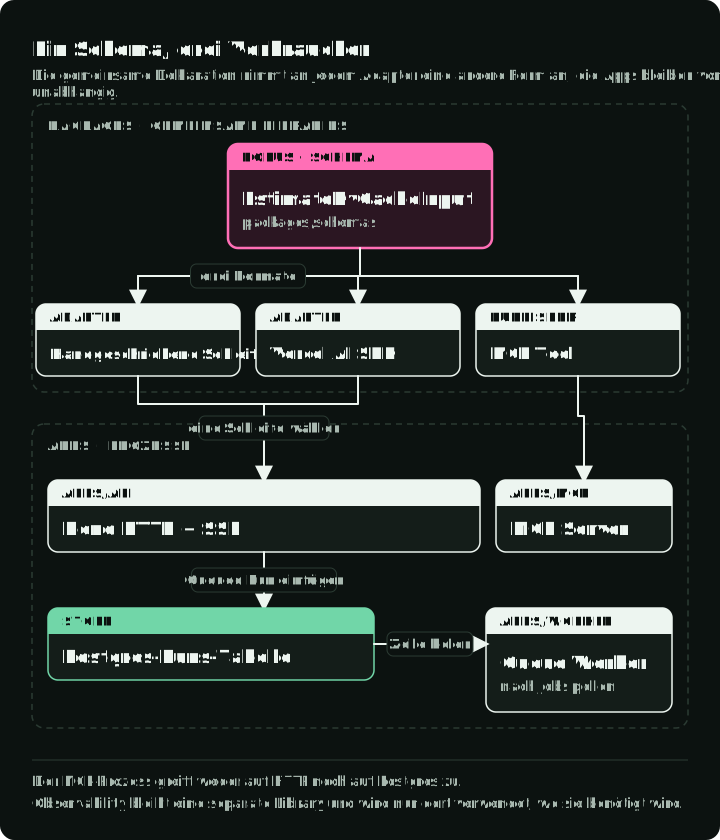
Die obere Zeile ist gemeinsamer Code in packages/. Darunter ist jede App in
apps/ ein eigener Prozess. Nur die API und der Worker greifen auf Postgres zu,
und der MCP-Server spricht mit seinem Client über stdin und stdout.
Der Demo-Service dimensioniert LLM-Deployments. Ein Tool schlägt die Architekturkonstanten für ein Model nach. Das andere schätzt dessen Speicherbedarf für KV cache: den GPU-Speicher, der Attention Keys und Values für laufende Anfragen hält. Beide Tools sind bewusst schlichte Arithmetik. Sie brauchen kein Netzwerk und liefern jedes Mal dieselbe Antwort. Dadurch lässt sich der Service ohne API-Schlüssel testen. Der Schätzer für KV cache wird außerdem über das Model Context Protocol (MCP) veröffentlicht, sodass andere AI-Clients ihn aufrufen können.
typescript-agent-service/
├── apps/
│   ├── api/           @agent/api: Hono API, streams Server-Sent Events (below)
│   ├── worker/        polls Postgres for long-running jobs
│   └── mcp/           MCP server: exposes one tool to outside AI clients
├── packages/
│   ├── schemas/       package name @agent/schemas: env, API, and tool schemas
│   ├── agent-core/    package name @agent/core: the loop (twice), tools, storage
│   └── observability/ Pino logging, OpenTelemetry tracing
├── pnpm-workspace.yaml
└── package.json
pnpm-workspace.yaml ist die Datei, die den Workspace deklariert. Interne Pakete
erhalten einen Scoped-Namen wie @agent/core, wobei das Präfix @agent/ eine
Namenskonvention ist, kein Sprachmerkmal. Jedes Paket deklariert seinen
öffentlichen Einstiegspunkt in package.json. Diese Paketgrenze hängt nicht
davon ab, welcher Befehl die Anwendung startet.
Dieser private Workspace lässt diese Einstiegspunkte auf .ts-Quellcode zeigen,
weil jeder Verbraucher Teil desselben Repositorys ist. Öffentliche npm-Pakete
veröffentlichen üblicherweise JavaScript plus .d.ts-Typdeklarationen, damit
gewöhnliche Node-Verbraucher weder den TypeScript-Runner noch das Build-Setup des
Paketautors brauchen.
Den Tool-Loop einmal von Hand schreiben
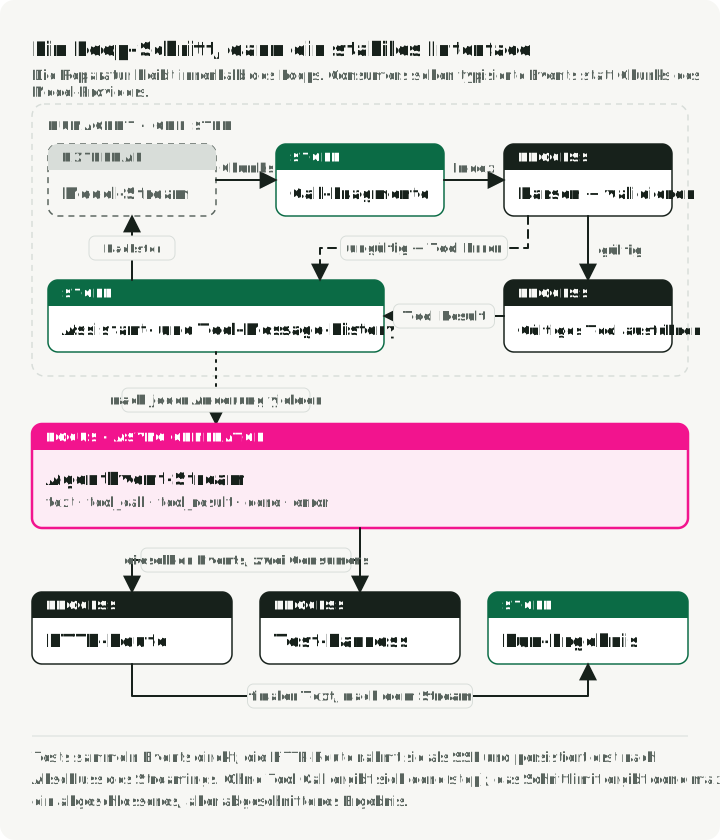
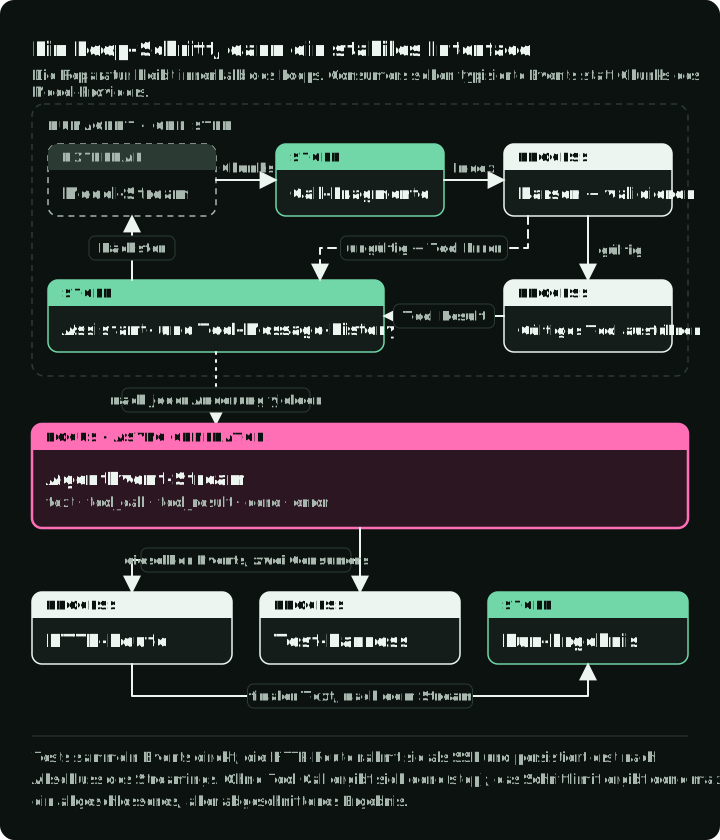
Die linke Spalte ist ein Model-Schritt. Die rechte Spalte zeigt, was der Loop liefert: Abgesehen von einer Exception, die den Loop verlässt, sind diese Events alles, was die HTTP-Route und die Tests sehen.
Agent-Frameworks mit Tool Calling umhüllen denselben Grundloop:
- Das Model mit Tool-Definitionen aufrufen.
- Die angeforderten Tools validieren und ausführen.
- Die Ergebnisse an die Nachrichten anhängen.
- Das Model erneut aufrufen.
Wer den Loop einmal selbst schreibt, macht seine verborgenen Fehlerpfade sichtbar.
Der Loop ist eine async function*, ein asynchroner Generator, exakt die Form
von Pythons async def mit yield. Die HTTP-Route iteriert über diesen
Generator, macht aus jedem Event einen Server-Sent-Events-Frame und sammelt den
Text. Nach dem Ende des Streams ruft die Route einmal storage.createRun mit dem
finalen Text auf. Tests rufen den Loop separat auf und sammeln seine Events in
einem Array. Ein SSE-Frame ist ein Abschnitt einer langlebigen HTTP-Antwort. Der
Abschnitt unten erklärt das Format.
Der Loop hat zwei normale Ausgänge. Eine Antwort ohne Tool Calls liefert done
mit stopReason: "stop". Fordert das Model bis maxSteps weiter Tools an,
endet der Generator trotzdem und liefert done mit stopReason: "max_steps".
Behandle dieses Ergebnis als abgeschlossen, aber abgeschnitten: Der gesammelte
Text kann unvollständig sein.
Jeder Wert, den der Loop liefert, ist ein AgentEvent, eine getaggte Union.
Gekürzt aus
packages/schemas/src/events.ts:
export const AgentEventSchema = z.discriminatedUnion("type", [
    z.object({ type: z.literal("text"), delta: z.string() }),
    z.object({
        type: z.literal("tool_call"),
        callId: z.string(),
        toolName: z.string(),
        args: z.unknown(),
    }),
    z.object({
        type: z.literal("tool_result"),
        callId: z.string(),
        ok: z.boolean(),
        result: z.unknown() /* ... */,
    }),
    z.object({
        type: z.literal("done"),
        stopReason: z.enum(["stop", "max_steps"]),
        steps: z.number(),
        text: z.string(),
    }),
    z.object({ type: z.literal("error"), message: z.string() }),
]);

export type AgentEvent = z.infer<typeof AgentEventSchema>;
z.discriminatedUnion wählt die Variante über das Feld type, wie ein match auf markierten Dataclasses. In if (event.type === "text") weiß der Compiler, dass event.delta existiert. Eine zusätzliche Variante führt nicht automatisch dazu, dass ein unvollständiger switch fehlschlägt. Für einen Compilerfehler bei einer fehlenden Variante prüfst du den verbleibenden Wert in einem default-Zweig gegen never. Eine Lint-Regel für vollständige Fallbehandlung kann fehlende Fälle ebenfalls melden. Die HTTP-Route und die AI SDK-Version unten nutzen beide die eingegrenzten Event-Typen.
Der Loop-Rumpf streamt Text-Events und setzt Tool Calls aus Fragmenten
zusammen. Aus
packages/agent-core/src/loop.ts:
let text = ""; // the assistant text produced during this model step
// Keyed by the `index` field, because a streamed response interleaves
// fragments of several parallel tool calls and only `index` is present
// on every fragment. `id` and `name` arrive once, `arguments` arrives
// in pieces. `a?.b` below reads `b` only if `a` exists, and gives back
// `undefined` instead of throwing if it doesn't.
const partial = new Map<number, PartialToolCall>();

for await (const chunk of stream) {
    const choice = chunk.choices[0];
    if (!choice) continue;

    if (choice.delta.content) {
        text += choice.delta.content;
        yield { type: "text", delta: choice.delta.content };
    }

    for (const fragment of choice.delta.tool_calls ?? []) {
        const slot = partial.get(fragment.index) ?? { id: "", name: "", args: "" };
        if (fragment.id) slot.id = fragment.id;
        if (fragment.function?.name) slot.name = fragment.function.name;
        if (fragment.function?.arguments) slot.args += fragment.function.arguments;
        partial.set(fragment.index, slot);
    }
}
Die loop-lokale Variable text hält einen Model-Schritt. Der Loop nutzt sie in
der Assistant-Nachricht für den nächsten Schritt oder im finalen done-Event. Es
ist nicht der Akkumulator auf Routen-Ebene, der später persistiert wird.
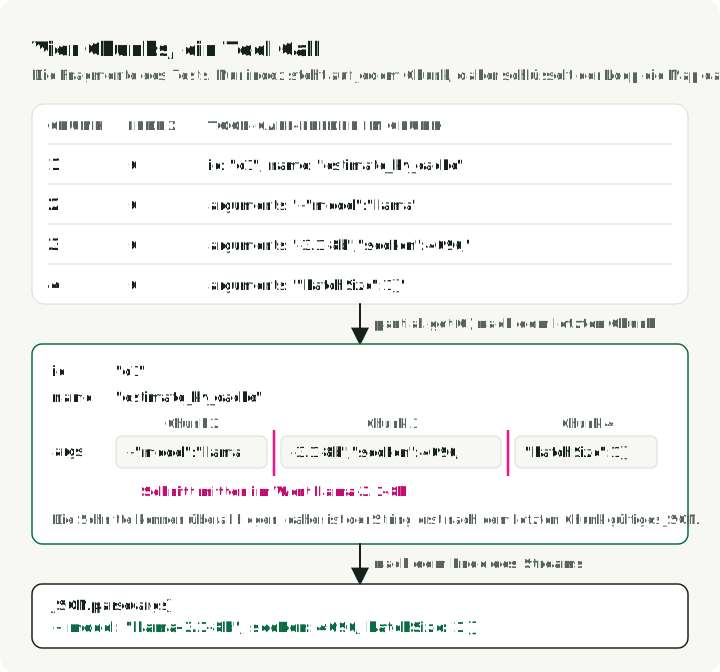
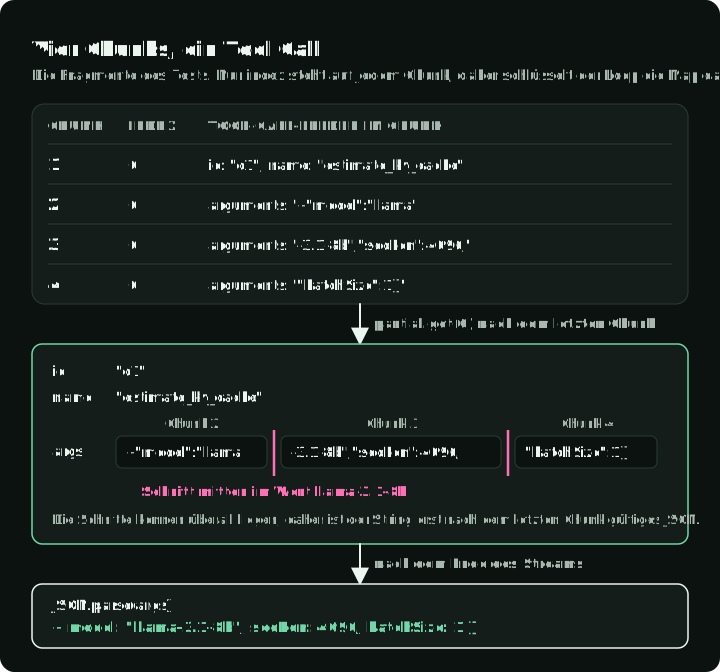
Die Map partial ist der Teil, den Frameworks verbergen. Das SDK liefert
String-Fragmente der Funktionsargumente, und diese können das serialisierte JSON
an beliebigen Stellen teilen. Mehrere parallele Aufrufe können sich außerdem
verschränken. Das Repository hat einen Test, der
{"model":"llama-3.1-8b",...} auf vier Chunks aufteilt.
Die Abbildung folgt diesen vier Chunks bis zum Map-Eintrag für Index 0.
Das Zweite, das du selbst schreiben solltest, ist, was bei fehlgeschlagener Validierung passiert:
// `tool.parse` is this repo's wrapper, not Zod's. Zod's own `.parse` throws and
// `.safeParse` returns `{ success, data, error }`; this returns
// `{ ok: true, value }` on success and `{ ok: false, error }` on failure, so no
// caller has to catch.
const parsed = tool.parse(raw);
if (!parsed.ok) {
    return {
        ok: false,
        value: { error: `Invalid arguments: ${parsed.error}` },
        parsedArgs: raw,
    };
}
Vor der Ausführung kann der Lookup das Tool nicht finden, JSON.parse kann die
Argumente ablehnen oder Zod kann ihre Form ablehnen. Jeder dieser Fehler wird zu
einer Nachricht, die das Model liest. Auch während der Ausführung wird ein
erwarteter ToolError zu einem Tool Result, damit das Model seinen Aufruf
korrigieren kann. Eine unerwartete Exception wird an den HTTP-Fehlerpfad
weitergereicht, statt als fachlicher Fehler dargestellt zu werden.
z.prettifyError macht aus Zods Issue-Baum eine Nachricht, mit der das Model
etwas anfangen kann, statt eines Stack Traces.
strict: true in einer OpenAI-Funktionsdefinition
bittet den Provider, Constrained Decoding anhand des Schemas anzuwenden. Es hat
nichts mit dem tsconfig-Flag strict von TypeScript zu tun. Das ähnelt dem
Guided Decoding von vLLM, auch wenn unterstützte Schemas und Details der
Durchsetzung abweichen. Es beseitigt eine Fehlerart, aber ein selbst gehosteter
Endpoint kann das Flag ignorieren. Die Argumente müssen außerdem JSON.parse
überstehen.
Der Loop ruft /chat/completions auf, weil das Begleit-Repository
OpenAI-kompatible Server anspricht.
vLLM,
SGLang und
Ollama dokumentieren diesen
Endpoint, sodass OPENAI_BASE_URL denselben Client auf jeden von ihnen richten
kann. Ihre Abdeckung der Responses API unterscheidet sich und ändert sich je
nach Release. Wenn du beide Seiten kontrollierst, prüfe die aktuelle
Kompatibilitätsseite des Servers, bevor du dich zwischen den beiden APIs
entscheidest.
Dann auf das AI SDK wechseln und wissen, was du eintauschst
Das Begleit-Repository implementiert denselben Agent auch mit dem Vercel AI SDK, damit du beide vergleichen kannst. Beide Versionen liefern AgentEvent-Werte, aber ihr Verhalten bei abschließenden Fehlern unterscheidet sich derzeit. Der optionale SDK-Adapter liefert ein error-Event mit String(part.error) und kehrt ohne done zurück. Die aktuelle HTTP-Route leitet diese Details weiter und speichert den Run als succeeded, weil der Generator ohne Exception beendet wurde. Bevor du den standardmäßigen rohen Loop durch diesen Adapter ersetzt, behandle error oder einen Stream, der ohne done endet, als fehlgeschlagenen Run. Bereinige Fehlermeldungen für Clients und teste den gespeicherten Status zusammen mit dem abschließenden Event.
Das Begleit-Repository nutzt AI SDK 7. Die Framework-Implementierung liegt in
packages/agent-core/src/loop-ai-sdk.ts:
const result = streamText({
    model: provider.chatModel(options.model),
    prompt: options.message,
    tools: aiSdkTools,          // Zod schemas passed straight through
    stopWhen: stepCountIs(options.maxSteps ?? 6),
});

for await (const part of result.fullStream) {
    switch (part.type) {
        case "text-delta": yield { type: "text", delta: part.text }; break;
        case "tool-call":  yield { type: "tool_call", callId: part.toolCallId, /* ... */ }; break;
        // ...
    }
}
Das SDK nimmt dir fünf Teile Anwendungscode ab:
- den Fragment-Akkumulator
JSON.parseund seinen Fehlerpfad- den Aufruf, der Zod über die geparsten Argumente laufen lässt
- die providerspezifische Zusammensetzung der Nachrichten
- den Schrittzähler
stopWhen akzeptiert mehrere Bedingungen, darunter ein Schrittlimit oder einen
bestimmten Tool Call. Die for await-Schleife ändert sich nicht, wenn sich die
Stopp-Regel ändert.
Was du aufgibst, ist die direkte Kontrolle über Validierungsfehler. Der
handgeschriebene Loop entscheidet, was das Model nach einem abgelehnten Aufruf
sieht. Das Begleit-Repository setzt die Option
repairToolCall
des SDK nicht und nutzt daher den Default: Sind mehr als ein Schritt erlaubt,
schickt AI SDK 7 den fehlgeschlagenen Aufruf im nächsten Schritt an das Model
zurück. Übergib einen repairToolCall-Callback, um den Aufruf selbst zu
reparieren, zum Beispiel mit einem zweiten Model-Aufruf.
Der Tausch gilt auch in die andere Richtung. In der SDK-Version bleibt ein Providerwechsel auf den Provider-Adapter beschränkt. Er erfordert trotzdem das passende Provider-Paket, Zugangsdaten, Konfiguration und Integrationstests. Im rohen Loop ist die providerspezifische Behandlung von Anfragen und Streams dein eigener Code, den du ändern musst.
Für einen neuen Service fang mit dem SDK an, sofern du diese Fehlerpfade nicht kontrollieren musst. Die handgeschriebene Version gibt dir eine kleine Implementierung zum Untersuchen und zum Vergleich mit dieser Wahl.
Streaming über HTTP: Hono und SSE
Hono-Routen lesen sich wie FastAPI-Routen. Die einzige Ergänzung ist
zValidator, das die Aufgabe übernimmt, die FastAPI durch die Typannotationen
der Handler-Signatur gratis erhält. Das c im Handler unten ist Honos
Request-Kontext, das Objekt, das FastAPI auf deine Parameter verteilt. deps ist
ein Bündel von Abhängigkeiten, mit dem die App konstruiert wird, statt sie direkt
zu importieren. runAgent ist eine davon, und der Abschnitt zum Testen zeigt, was
dir das bringt.
Gekürzt aus apps/api/src/app.ts:
app.post("/v1/chat", zValidator("json", ChatRequestSchema), (c) => {
    const body = c.req.valid("json");
    const log = deps.logger.child({ route: "chat" });

    return streamSSE(c, async (stream) => {
        let text = "";
        let done: Extract<AgentEvent, { type: "done" }> | undefined;
        try {
            // The full route wraps this loop in a `withSpan` tracing span.
            for await (const event of deps.runAgent({
                message: body.message,
                maxSteps: body.maxSteps,
            })) {
                if (event.type === "text") text += event.delta;
                if (event.type === "done") done = event;

                await stream.writeSSE({
                    event: event.type,
                    data: JSON.stringify(event),
                });
            }
        } catch (error) {
            log.error({ err: error }, "agent run failed");
            await stream.writeSSE({
                event: "error",
                data: JSON.stringify({
                    type: "error",
                    message: "Agent run failed",
                }),
            });
            return;
        }

        await deps.storage.createRun({
            kind: "chat",
            status:
                done?.stopReason === "max_steps" ? "truncated" : "succeeded",
            input: { message: body.message },
            output: { text },
        });
    });
});
Die Route behält das finale done-Event. Ein Loop, der bei max_steps stoppt,
endet normal, daher speichert die Route ihn als truncated, nicht als
succeeded.
zValidator validiert den Body und gibt c.req.valid("json") den Typ, den das
Schema erzeugt. Ohne es ist der Body als any typisiert, TypeScripts Ausstieg,
bei dem jeder Property-Zugriff kompiliert und nichts geprüft wird. Das hebt den
Typsicherheitsgewinn des Schemas auf.
Diese Route nutzt Server-Sent Events statt WebSockets. Der Server hält eine
HTTP-Antwort offen, während er Frames der Form event: <name> und
data: <json> schreibt, und schließt sie nach dem letzten Event. Der Verkehr
fließt vom Server zum Client, was zu diesem Agent-Stream passt. Ein WebSocket
würde bidirektionale Nachrichten und ein Protokoll-Upgrade hinzufügen, die diese
Route nicht braucht.
Beim standardmäßigen rohen Loop ändert eine Exception während des Streams die HTTP-Fehlermeldung. Sobald der erste Frame mit Status 200 gesendet wurde, kann der Server diese Antwort nicht durch einen 500 ersetzen. Der catch-Block protokolliert den abgefangenen Fehler, sendet ein konstantes Fehler-Event an den Client und kehrt zurück. Dadurch wird storage.createRun übersprungen: Ein geworfener Generatorfehler hinterlässt keine Zeile. Dieser catch läuft nicht, wenn der optionale SDK-Adapter ein error-Event liefert und zurückkehrt. Wenn du fehlgeschlagene Runs für Debugging oder evals brauchst, schreibe im catch-Block eine failed-Zeile mit dem Teiltext.
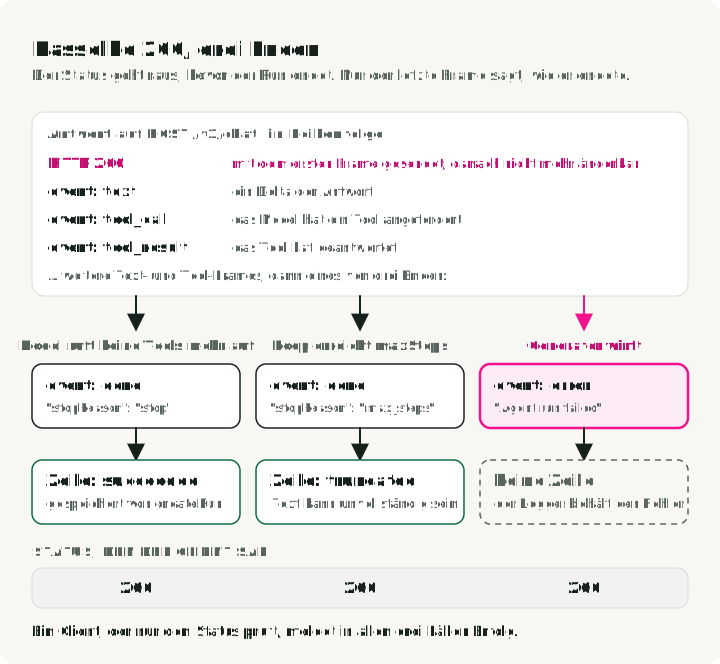
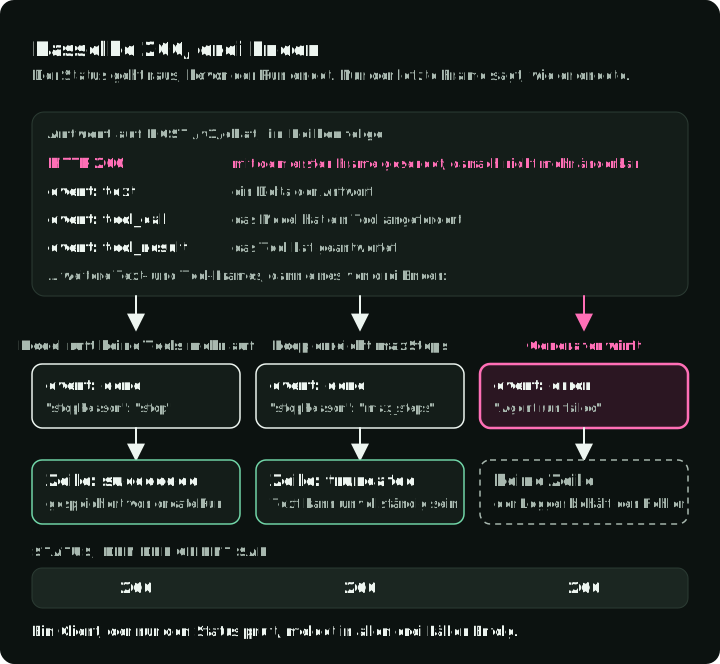
Die Abbildung verfolgt eine Anfrage bis zu ihren drei Enden. Der Statuscode ist in allen drei Fällen derselbe, nur der letzte Frame unterscheidet sie.
Ein Test deckt diesen Pfad ab. Ein Generator liefert ein Text-Delta und wirft
dann eine Exception. Die Antwort bleibt 200, und ihr letzter Frame ist ein
error-Event mit der konstanten Meldung Agent run failed. Der Logger behält
den gefangenen Fehler für die Diagnose auf dem Server. Jeder Client, der nur den
Statuscode prüft, meldet bei einem fehlgeschlagenen Run Erfolg.
app.ts trifft zwei kleinere Entscheidungen, die eine Erklärung verdienen. Es
behandelt /healthz als Liveness-Endpoint, daher greift diese Route bewusst
nicht auf Postgres zu. Ein Liveness-Fehler bei einem Datenbankausfall könnte
jedes Replica neu starten, ohne die Abhängigkeit zu reparieren. Füge eine
separate Readiness-Prüfung hinzu, wenn der Orchestrator keinen Verkehr mehr an
eine Instanz leiten soll, die Postgres nicht erreicht. Die Fehlerpfade
protokollieren den gefangenen Fehler, geben aber einen konstanten String zurück.
error.message in einen Response-Body zu schreiben, ist der Weg, auf dem
Connection Strings im Browser eines Fremden landen.
Der Celery-förmige Teil, ohne Celery
Lange Jobs gehören nicht in einen Request-Handler. POST /v1/sweeps validiert
ein Model, eine Sequenzlänge und eine Liste von Batch Sizes, fügt eine Zeile mit
queued ein und gibt 202 mit der Run-ID zurück. Der Worker übernimmt die Zeile,
berechnet die Größe von KV cache für jede Batch Size und speichert das Ergebnis.
GET /v1/runs/:id liest es.
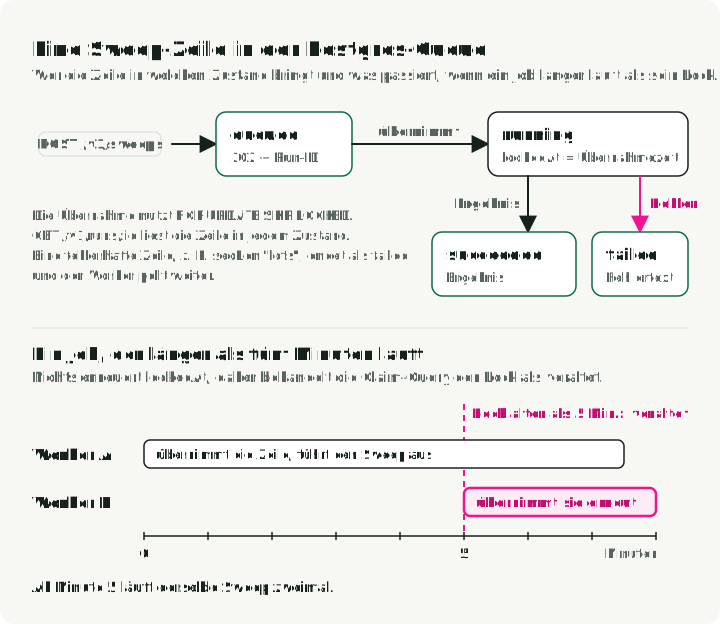
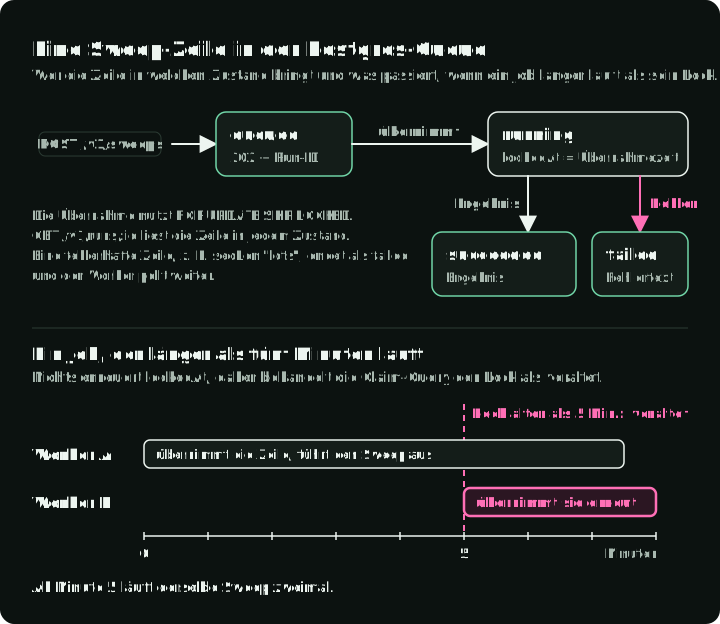
Die obere Hälfte zeigt die Zustände, die eine Sweep-Zeile durchläuft. Die Zeitleiste zeigt die unten erklärte Übernahme eines veralteten Locks: Nach fünf Minuten übernimmt ein zweiter Worker einen Job, der noch läuft.
Hier gibt es kein Redis und kein BullMQ. PostgreSQL dokumentiert SKIP LOCKED
für mehrere Verbraucher einer queue-artigen Tabelle.
Die Klausel gibt diesem kleinen Service eine At-least-once-Queue in einer
Tabelle. Sie ist transaktional mit deinen übrigen Schreibvorgängen, und es ist
ein Service weniger in docker-compose.yml.
Die Claim-Query in
packages/agent-core/src/db/storage.ts
lautet:
const [candidate] = await tx
    .select({ id: runs.id })
    .from(runs)
    // The real query also picks up rows whose lock went stale; trimmed here.
    .where(and(eq(runs.kind, kind), eq(runs.status, "queued")))
    .orderBy(runs.createdAt)
    .limit(1)
    // `.for()` adds a locking clause; `{ skipLocked: true }` adds SKIP LOCKED.
    .for("update", { skipLocked: true });
Die Zeile ist für die Transaktion gesperrt, und jeder gleichzeitige Worker, der
dieselbe Query ausführt, überspringt sie, statt zu blockieren. Zwei gleichzeitige
Claims erhalten daher nicht dieselbe nicht veraltete Zeile. Ein
Integrationstest feuert zwei Claims gleichzeitig über Promise.all ab und prüft,
dass sie verschiedene Zeilen liefern. Die naive Version, SELECT ... LIMIT 1
gefolgt von UPDATE, fällt bei diesem Test durch: Beide Transaktionen lesen
dieselbe Zeile, bevor eine von ihnen schreibt, daher starten beide denselben Job.
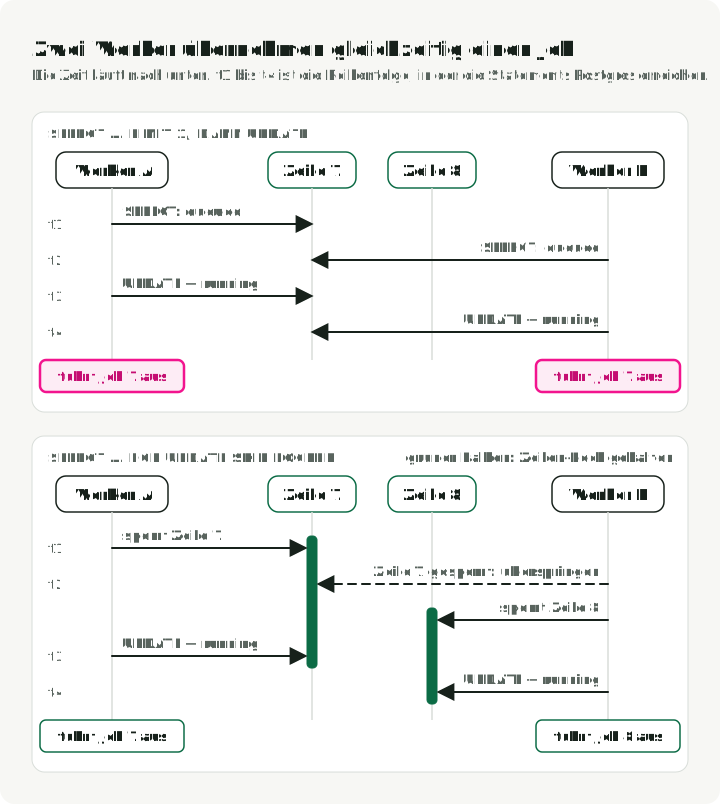
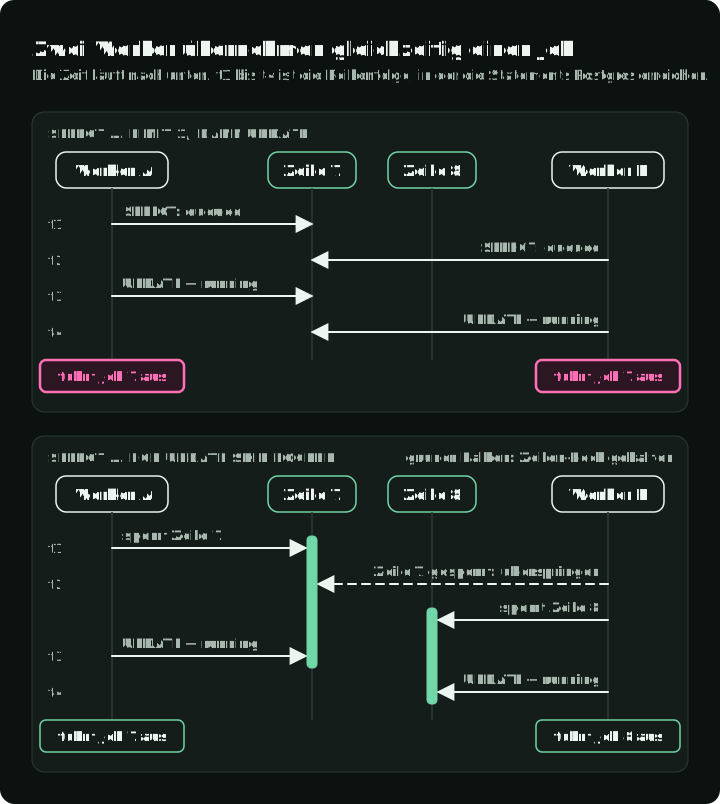
Das obere Feld ist die Race Condition, die der Test findet; das untere Feld ist die Claim-Query oben.
Das ist At-least-once-Ausführung: Ein Job kann mehr als einmal laufen. Die
vollständige Query übernimmt außerdem eine running-Zeile erneut, wenn ihr Lock
älter als fünf Minuten ist, und nichts verlängert diese Lease. Ein laufender Job,
der länger als fünf Minuten läuft, kann daher zweimal übernommen werden. Mache
Jobs idempotent. Bei lang laufender Arbeit füge einen Lease-Heartbeat hinzu oder
setze die Schwelle für veraltete Locks über die maximale Laufzeit.
Füge BullMQ hinzu, wenn du verzögerte Jobs, wiederkehrende Zeitpläne, Prioritäten, Rate Limits oder ein Dashboard brauchst. Der entsprechende Schritt in Python ist der von einer Datenbanktabelle zu Celery. Davor ist Redis ein weiterer Service, den du betreiben und überwachen musst.
Der Worker validiert, was er aus jsonb liest, erneut:
// The row was validated on the way in, but it has been through a database.
// A stored row can outlive the schema version that accepted it.
// The job is a batch-size sweep. Zod's own `.parse` throws; the poll loop
// catches that and marks the run failed.
const input = SweepRequestSchema.parse(run.input);
Die Test-Suite übergibt dem Worker außerdem eine Sweep-Zeile, deren seqLen
der String "lots" ist. Der Worker lässt den Run fehlschlagen und pollt weiter,
statt abzustürzen und dieselbe ungültige Zeile endlos erneut zu versuchen.
CPU-Arbeit zeigt eine weitere Node-Einschränkung. Ein synchroner Callback läuft
auf dem Thread der Event Loop und wird nicht unterbrochen. Eine for-Schleife,
die zwei Sekunden lang rechnet, blockiert jede Anfrage, jeden Timer und jede
Liveness-Prüfung dieses Prozesses für zwei Sekunden. Eine enge Schleife in einer
async def blockiert asyncio auf dieselbe Weise. Beide Runtimes verlangen, dass
du CPU-Arbeit ausdrücklich auslagerst.
await setTimeout(0) aus node:timers/promises (das Präfix node: steht für
die Standardbibliothek, also verhält sich node:timers zu Node wie os zu
Python) entspricht await asyncio.sleep(0). Der Sweep gibt nach jeder Batch Size
die Kontrolle ab, damit der Worker-Prozess Timer und andere Callbacks bedienen
kann. Das Abgeben der Kontrolle macht CPU-Arbeit nicht parallel. Node
worker_threads können JavaScript
parallel ausführen. Für reine Python-CPU-Arbeit unter dem üblichen
CPython-Build mit GIL nutze einen Process Pool statt eines Thread Pools. Dieser
Service nutzt keines von beiden. Behalte rechenintensive Numerik in Python, wo
die unterstützenden Bibliotheken schon liegen, und verlagere sie weg von der
Event Loop der API.
Ein Tool, drei Verbraucher
EstimateKvCacheInput hat drei Verbraucher:
- Der handgeschriebene Loop wandelt es mit
z.toJSONSchemaum. - Das AI SDK erhält es unverändert.
- Der MCP-Server veröffentlicht seine Form.
Diese Wiederverwendung ist der Grund, warum es packages/schemas gibt.
server.registerTool(
    "estimate_kv_cache",
    {
        description: "Estimate KV-cache VRAM in GiB for a served model...",
        // A Zod object schema keeps the map of fields you passed in on
        // `.shape`. This SDK wants that map, not the schema wrapped around it.
        inputSchema: EstimateKvCacheInput.shape,
    },
    async ({ model, seqLen, batchSize }) => {
        /* ... */
    },
);

await server.connect(new StdioServerTransport());
Zwei Details zählen, bevor du einen Client verbindest. Erstens: Ein so
gestarteter Server nutzt sein eigenes stdin und stdout, um mit dem Client zu
kommunizieren. Jede Zeile ist
eine JSON-RPC-Nachricht.
Ein verirrtes console.log, das JavaScript-Äquivalent von print, beschädigt
dann eine Nachricht. Der Client trennt die Verbindung mit einem Parse-Fehler, der
keine Datei nennt. Sende stattdessen alle Diagnosen an stderr.
Zweitens: Ein fachlicher Fehler sollte isError: true mit einer Nachricht
zurückgeben. Das aufrufende Model kann den Aufruf dann korrigieren, genau wie
nach ungültigen Tool-Argumenten im Agent Loop.
Du kannst den Server mit printf und einer Pipe ansteuern, was sich einmal
lohnt, bevor du einen echten Client darauf richtest:
printf '%s\n' \
  '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-06-18","capabilities":{},"clientInfo":{"name":"probe","version":"1"}}}' \
  '{"jsonrpc":"2.0","method":"notifications/initialized"}' \
  '{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"estimate_kv_cache","arguments":{"model":"llama-3.1-70b","seqLen":8192,"batchSize":4}}}' \
  | pnpm -s mcp   # -s suppresses pnpm's own output so only JSON-RPC comes back
Die Probe nutzt dieselbe Protokollversion wie die README des Begleit-Repositorys. Nutze für einen echten Client das SDK, statt JSON-RPC-Nachrichten von Hand zu pflegen.
Einen Agent ohne API-Schlüssel testen
Vitest übernimmt die Rolle von pytest, aber die Struktur ist anders. describe
gruppiert zusammengehörige Tests. it und test definieren jeweils einen
Testfall. test.each entspricht ungefähr parametrize, beforeEach liefert das
Setup pro Test, vi.fn() erzeugt eine Mock-Funktion, und describe.skipIf
überspringt eine Gruppe unter einer Bedingung.
Agent-Tests hängen an einer Entscheidung: runAgent nimmt einen OpenAI-Client
als Parameter, statt selbst einen zu konstruieren. Der Fake ist ein Objekt mit
einer Methode chat.completions.create, die ein geskriptetes asynchrones
Iterable zurückgibt:
function fakeClient(scripts: Chunk[][]): OpenAI {
    let call = 0;
    return {
        chat: {
            completions: {
                create: async () => {
                    const script = scripts[call++] ?? [];
                    // Defines an async generator and calls it on the same
                    // line, so `create` hands back something you can
                    // `for await` over, which is the shape a real streaming
                    // response has.
                    return (async function* () {
                        for (const chunk of script) yield chunk;
                    })();
                },
            },
        },
        // TypeScript refuses a direct cast between unrelated shapes, so you
        // cast through `unknown` first. This disables type checking for that
        // value, so keep it to test code.
    } as unknown as OpenAI;
}
Die Tests teilen einen JSON-Argument-String auf mehrere Chunks auf und behandeln
zwei Tool Calls in einer Antwort. Sie decken außerdem ein ungültiges batchSize,
fehlerhaftes JSON, unbekannte Tool-Namen und ein Model ab, das so lange Tools
aufruft, bis maxSteps es stoppt. Die Testdatei läuft in deutlich unter einer
Sekunde, ohne Netzwerk und ohne Schlüssel.
Integrationstests gegen Postgres nutzen
describe.skipIf(!process.env.DATABASE_URL), sodass pnpm test auf einem
frischen Clone ohne laufendes Postgres funktioniert und die CI sie durch das
Setzen der Variable einschaltet. Das Repository hat 42 Tests. Achtunddreißig
laufen ohne Postgres oder API-Schlüssel.
Strukturierte Events mit Pino protokollieren
Pino erfüllt dieselbe Rolle wie structlog: ein JSON-Objekt pro Zeile,
Child-Logger mit gebundenen Feldern und explizite Schwärzung. Das
Begleit-Repository konfiguriert es in
packages/observability/src/logger.ts:
const log = pino({
    redact: {
        paths: [
            "req.headers.authorization",
            "apiKey",
            "OPENAI_API_KEY",
            "*.apiKey",
        ],
        censor: "[redacted]",
    },
});
Ohne Schwärzung kann log.info({ req }, "...") einen Authorization-Header in das
Log-Backend kopieren.
Anwendungsarbeit mit manuellen Spans tracen
Das Begleit-Repository nutzt OpenTelemetry für drei Spans auf Anwendungsebene:
agent.run, agent.tool und worker.sweep. Es installiert keine automatische
HTTP- oder Postgres-Instrumentierung. startTracing() in
packages/observability/src/tracing.ts
erzeugt ein NodeSDK mit einem OTLP-Trace-Exporter. Fehlt
OTEL_EXPORTER_OTLP_ENDPOINT, bleibt Tracing ausgeschaltet.
Die eigentliche Arbeit wird von withSpan() aus derselben Datei umhüllt:
return tracer.startActiveSpan(name, { attributes }, async (span) => {
    try {
        return await fn(span);
    } finally {
        span.end();
    }
});
JavaScript hat keine Context-Manager-Syntax im Python-Stil. Hier ist der Callback der Block, den ein Python-Context-Manager umschließen würde. Der vollständige Helper zeichnet außerdem Exceptions auf und setzt den Span-Status, bevor er sie erneut wirft.
Automatische HTTP- und Datenbank-Spans sind ein eigenes Feature. Sie erfordern die passenden Instrumentierungspakete und eine Initialisierung, bevor die instrumentierten Module geladen werden. Füge das nur hinzu, wenn diese Spans nützlich sind, und folge dann dem Setup des OpenTelemetry Node SDK für die exakten Paketversionen, die du auslieferst.
Das Monorepo in Docker ausliefern
Nutze das mitgelieferte
Dockerfile.
Der Container startet die API mit dem tsx-Loader. Du musst beim Deployment
keinen TypeScript-Runner auswählen oder aufrufen.
Der Build nutzt pnpm fetch, damit Dependency-Downloads bis zur nächsten
Änderung der Lockfile im Cache bleiben. Danach kopiert pnpm deploy die API und
ihre Produktionsabhängigkeiten in ein eigenständiges Verzeichnis. Die
Runtime-Stage läuft als Nicht-Root-Nutzer node, und ihr CMD in Exec-Form
lässt die API SIGTERM direkt für ein sauberes Herunterfahren empfangen.
Warum das Dockerfile tsx lädt
Node 24 kann eine begrenzte TypeScript-Teilmenge ausführen, indem es
Typannotationen entfernt. Es prüft den Code nicht auf Typen und führt die
Transformationen nicht aus, die ein vollständiger TypeScript-Runner unterstützt.
Die Paketskripte des Repositorys verbergen dieses Detail. pnpm check führt die
separate statische Prüfung aus.
Der Container zeigt eine weitere Grenze. pnpm deploy kopiert die
Workspace-Pakete unter node_modules, und Node weigert sich dort bewusst,
TypeScript zu entfernen (Node-TypeScript-Dokumentation).
Ohne Loader schlägt der Container beim Start mit
ERR_UNSUPPORTED_NODE_MODULES_TYPE_STRIPPING fehl.
Das Dockerfile lädt tsx, das diese .ts-Dateien verarbeitet, bevor Node sie
ausführt. Ein Team, das nur .js-Dateien in seinem Runtime-Image will, kann
stattdessen einen Compile-Schritt hinzufügen. Das ist ein alternatives
Produktionsdesign, kein zusätzlicher Schritt, der nötig wäre, um dieses
Begleit-Repository auszuführen.
Ein Drei-Wochen-Plan
Erfahrene Python-Engineers können Material überspringen, das Variablen und Schleifen lehrt. Diese Abfolge konzentriert sich auf die Teile, die sich von Python unterscheiden. Erledige in jeder Zeile die Bauaufgabe; die Lektüre unterstützt sie.
| Woche | Lesen | Bauen |
|---|---|---|
| 1 | javascript.info: nur Module, Promises und Objekte. Behalte den MDN JS Guide als Referenz. | Schreibe ein Python-CLI in TypeScript neu. Füge ein package.json-Skript hinzu. Führe das Skript und pnpm typecheck aus. |
| 1-2 | Lies die tsconfig-Referenz von TypeScript, die kostenlosen Total-TypeScript-Tutorials und die Zod-Dokumentation. | Baue ein Zod-validiertes Konfigurationsmodul und eine getaggte Union. Nach der Prüfung des Tags weiß der Compiler, welche Variante der Block enthält. |
| 2 | Lies die Dokumentation von Hono, Drizzle, Vitest und Biome. | Baue einen Streaming-Proxy zu einem OpenAI-kompatiblen Endpoint mit einem Log auf Drizzle-Basis. |
| 3 | Lies die Dokumentation des AI SDK und des MCP TypeScript SDK. | Baue einen Agent mit Tool Calling. Baue dann einen MCP-Server, der eines seiner Tools bereitstellt. |
Beginne mit den kostenlosen Total-TypeScript-Tutorials. Zahle für das fortgeschrittene Material nur, wenn du mit Generics und Conditional Types auf Bibliotheksniveau arbeitest. Überspringe jeden “Einführung in JavaScript”-Kurs und alles, was nach React aussieht, sofern das Produkt es nicht verlangt.
Für einen Überblick über Produktionskonventionen ist goldbergyoni/nodebestpractices eine breite, von der Community gepflegte Checkliste. Prüfe Ratschläge, die Laufzeitverhalten oder Sicherheit betreffen, gegen die aktuelle Node-Dokumentation.
Bevor du den Service anpasst
Die Offline-Tests prüfen den Kontrollfluss des Service mit geskripteten Model-Antworten. Sie sagen nichts darüber aus, wie zuverlässig ein Live-Model deine Aufgaben erledigt. Behalte diese Unterscheidung im Blick, wenn du die Demo-Tools durch echte ersetzt.
Validiere jeden Wert, der von außen hereinkommt: die Umgebung, den HTTP-Body,
Tool-Argumente vom Model und aus jsonb gelesene Zeilen.
| Wert | Geprüft von | Bei einem Fehler |
|---|---|---|
process.env | EnvSchema, in loadEnv() beim Start | Startfehler; der Prozess stoppt |
| HTTP-Body | ChatRequestSchema, über zValidator | 400; der Handler läuft nie |
| Tool-Argumente | tool.parse, nach JSON.parse | Tool-Fehler, der an das Model gesendet wird |
runs.input | SweepRequestSchema, im Worker bei jeder Übernahme | Run als failed markiert; der Worker pollt weiter |
Lege als Nächstes die Abschlussregel fest: Entscheide, ob deine Anwendung
truncated-Runs akzeptiert, wiederholt oder prüft, und teste das Event und den
gespeicherten Status gemeinsam. Wenn Jobs länger laufen können als die Schwelle
für veraltete Locks, füge einen Lease-Heartbeat hinzu, bevor du Seiteneffekte
einbaust.
Sobald diese Verhaltensweisen explizit sind, füge die im Streaming-Abschnitt
beschriebene failed-Zeile hinzu und nutze fehlgeschlagene und abgeschnittene
Runs, um eine eigene
Agent-Evaluierungs-Suite
aufzubauen. Dort testest du den Aufgabenabschluss; die Offline-Suite bleibt die
schnellere Prüfung auf kaputtes Streaming, kaputte Validierung und kaputte
Persistenz.
Referenzen
Demo-Repository
- slavadubrov/typescript-agent-service - das Monorepo, das in diesem Artikel durchgehend verwendet wird: Hono-API mit SSE, zwei Agent-Loop-Implementierungen, Drizzle-Storage, Worker, MCP-Server und 42 Tests
Runtime und Sprache
- TypeScript nativ in Node.js ausführen - Nodes begrenzte TypeScript-Unterstützung und ihre Einschränkung für
node_modules - Compileroptionen von TypeScript -
strictund die anderen Prüfungen, die das Begleit-Repository konfiguriert - JavaScript-Leitfaden von MDN - die Sprachreferenz, die man offen halten sollte
- javascript.info - modernes JavaScript-Tutorial. Lies die Kapitel zu Modulen und Promises.
Tooling
- pnpm und Installation von pnpm - Paketmanager, Workspaces und Setup
- Biome - Lint, Format und Import-Sortierung in einer Binärdatei
- Vitest - Test Runner, der keine Transform-Konfiguration braucht
- Total TypeScript - kostenlose Tutorials plus ein kostenpflichtiger Track für fortgeschrittene Typen
Bibliotheken
- Zod - Schema-Validierung und Typinferenz. Version 4 enthält
z.toJSONSchema. - Hono - HTTP-Framework auf Web-Standards
- Drizzle ORM - SQL-first-TypeScript-ORM mit
drizzle-kit-Migrationen - SELECT-Dokumentation von PostgreSQL - die Locking-Klausel
FOR UPDATE ... SKIP LOCKED - BullMQ - Redis-basierte Queue für den Fall, dass die Datenbanktabelle nicht ausreicht
AI und Agents
- Vercel AI SDK -
streamText,tool,stopWhenund Provider-Adapter - openai/openai-node - der offizielle TypeScript-Client
- MCP TypeScript SDK und die MCP-Spezifikation - Server und Clients bauen
Konventionen
- goldbergyoni/nodebestpractices - von der Community gepflegte Checkliste für Produktionskonventionen