TypeScript para ingenieros de ML de Python: crea un servicio de agentes

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta guía es para ingenieros de ML y de backend con experiencia en Python que necesitan crear un servicio de AI en TypeScript y Node. Parte de los conceptos de un servicio de Python, no de la programación básica ni del código de navegador. Al terminar, sabrás relacionar un stack de servicio de Python con TypeScript, reconocerás los hábitos de Python que provocan errores en JavaScript y podrás ejecutar y modificar un servicio de agentes con streaming.
El servicio de ejemplo sigue una petición a través de la validación, la ejecución de herramientas, el streaming HTTP y la persistencia. Responde a tres preguntas: ¿qué ocurre cuando los argumentos de una herramienta llegan fragmentados, cuando un stream falla después de un HTTP 200 o cuando un worker reclama el mismo trabajo dos veces? El alcance es solo backend y AI: sin React ni bundler de navegador.
El código está en slavadubrov/typescript-agent-service. Incluye dos implementaciones del agent loop, el historial de ejecuciones en Postgres, un worker y un servidor MCP. Puedes ejecutar su demo sin conexión y sin clave de API, y luego usar el mapa de Python a TypeScript de más abajo para leer y modificar el servicio. El cálculo numérico pesado se queda en Python; esta guía cubre la orquestación, HTTP y el streaming.
Ejecuta primero el repositorio complementario
Instala Node 24 y pnpm siguiendo las instrucciones oficiales de instalación de pnpm. Después clona el repositorio complementario y ejecuta:
pnpm install
pnpm demo
pnpm check
pnpm demo ejercita el handler HTTP, el agent loop y el stream SSE con un
modelo con respuestas predefinidas. También llama al cálculo runSweep del
worker. No arranca el proceso del worker ni su cola en la base de datos. La demo
no necesita clave de API, base de datos ni Docker. pnpm check ejecuta el
comprobador de tipos, el linter, la comprobación del formato y los tests.
La demo imprime los frames SSE de una petición de chat y después el barrido del worker. Abreviado:
event: tool_call
data: {"type":"tool_call","callId":"call_1","toolName":"estimate_kv_cache","args":{"model":"llama-3.1-8b","seqLen":32768,"batchSize":16}}

event: tool_result
data: {"type":"tool_result","callId":"call_1","toolName":"estimate_kv_cache","ok":true,"result":{"model":"llama-3.1-8b","seqLen":32768,"batchSize":16,"kvCacheGiB":64},"durationMs":0}

event: done
data: {"type":"done","stopReason":"stop","steps":2,"text":"Llama-3.1-8B at 32k context and batch 16 needs 64 GiB of KV cache."}

--- worker: capacity sweep ---
batch=  1  kv_cache=4.0 GiB
batch= 16  kv_cache=64.0 GiB
Cada bloque event:/data: es un frame SSE: el modelo pide una herramienta, la
herramienta devuelve su resultado y la ejecución termina con done. La última
parte es el barrido de tamaños de batch del worker.
Para ejecutar la API y el worker reales:
cp .env.example .env          # add OPENAI_API_KEY or an OpenAI-compatible URL
pnpm db:up                    # start Postgres in Docker
pnpm db:push                  # create the database schema
pnpm dev:api                  # API at http://localhost:8080
pnpm dev:worker               # run this in a second terminal
Lanza una ejecución del agente en streaming. La respuesta es una serie de frames SSE como la salida de la demo anterior:
curl -N -X POST localhost:8080/v1/chat \
  -H 'content-type: application/json' \
  -d '{"message":"How much KV cache for llama-3.1-70b at 32k context, batch 8?"}'
Encola un trabajo largo y luego consúltalo. La primera llamada devuelve 202 con
{"id":"...","status":"queued"}. La segunda devuelve la fila almacenada, con el
resultado cuando el worker haya terminado:
curl -X POST localhost:8080/v1/sweeps \
  -H 'content-type: application/json' \
  -d '{"model":"llama-3.1-70b","seqLen":32768,"batchSizes":[1,4,16]}'

curl localhost:8080/v1/runs/<id>
Los scripts de pnpm anteriores son los comandos que uso en el resto del
artículo. El repositorio esconde los comandos de más bajo nivel de Node y
TypeScript detrás de scripts de pnpm con nombre, igual que un proyecto de
Python puede esconder comandos uv run detrás de objetivos de make. No
mezcles npm install en este repositorio de pnpm. Usa pnpm install para que
pnpm-lock.yaml siga siendo el único lockfile.
Qué hacen Node, npm, pnpm, TypeScript y tsx
Los nombres parecidos esconden tareas distintas:
- JavaScript es el lenguaje.
- Node.js es el runtime, más o menos el CPython de JavaScript. Instala Node 24 para este proyecto.
- El registro de npm es el índice de paquetes, más o menos PyPI. El comando
npmviene con Node y puede instalar paquetes de ese registro. - pnpm es el gestor de paquetes que eligió este repositorio. Instala desde el
registro de npm, gestiona el workspace del monorepo y ejecuta los comandos
declarados en
package.json. package.jsones el manifiesto del proyecto, lo más parecido apyproject.toml. Su secciónscriptsda nombres comodemo,checkydev:apia comandos más largos.- TypeScript es JavaScript con tipos estáticos. Su comando
tsccomprueba esos tipos. El repositorio lo ejecuta mediantepnpm checkopnpm typecheck. - tsx ejecuta archivos
.tssin un paso de compilación aparte. Los scripts de desarrollo usan su modowatchpara reiniciar la API o el worker tras un cambio en el código. En esta guía no lo invocas directamente.
En este repositorio, ejecuta los scripts de pnpm. Node es el runtime dentro de
esos scripts, y el Dockerfile incluido se encarga de producción.
Qué ejecuta cada script:
pnpm demoejecutatsx scripts/demo.ts.pnpm dev:apiejecutatsx watch.pnpm checkejecutatsc, Biome (el linter) y Vitest (el ejecutor de tests).- El
CMDde Docker ejecutanode --import tsx/esm.
Todo esto se ejecuta en Node 24. En pnpm check, tsc y Biome solo leen
archivos; Vitest ejecuta los tests en Node.
El stack, relacionado con Python
Zod, Hono, Drizzle, Vitest y Biome cubren buena parte del mismo terreno que pydantic, FastAPI, SQLAlchemy, pytest y Ruff.
La mayoría de los pares son sustituciones directas. Tres no lo son:
| Necesidad | Python | TypeScript | Por qué no es un simple cambio |
|---|---|---|---|
| Validación | pydantic | zod | El esquema es la fuente. El tipo se genera a partir de él, no al revés |
| Comprobación de tipos | mypy | TypeScript (pnpm typecheck) | Los tipos se eliminan antes de ejecutar el código. Ninguna biblioteca puede leerlos, así que la validación en runtime necesita un esquema aparte (Zod) |
| Cola de trabajos | celery + Redis | bullmq (cola respaldada por Redis) o SQL | Postgres puede implementar una cola at-least-once. Quizá no necesites un broker |
El repositorio complementario usa cuatro bibliotecas que merece la pena explicar.
Hono para la capa HTTP
Express y Fastify son alternativas centradas en Node. Hono usa las APIs
estándar de la Web Request y Response
y ofrece adaptadores para Node y para runtimes serverless. Esa portabilidad es
útil para esta pequeña API de streaming, así que elegí Hono. Elige Fastify
cuando el servicio se ejecute solo en Node y quieras su conjunto de plugins y su
serialización de respuestas basada en esquemas.
Drizzle para SQL
Drizzle mantiene el esquema en TypeScript y no requiere un paso de generación del cliente. También permite usar SQL directo cuando el constructor de consultas no puede expresar con claridad una cláusula de Postgres. Elegiría Prisma en su lugar cuando su cliente generado y las herramientas que lo rodean encajen mejor con el equipo.
Biome para linting y formateo
Biome se encarga del linting, el formateo y la ordenación de imports con un solo binario y un único archivo de configuración. Conserva ESLint cuando el proyecto dependa de reglas personalizadas que Biome no ofrece.
Vitest para los tests
Vitest ejecuta los tests .ts del repositorio
complementario sin una configuración de transformación aparte. Conserva Jest en
un repositorio que ya tenga una configuración de Jest y matchers personalizados.
Lee la sintaxis de TypeScript utilizada a continuación
Ten esta tabla a mano junto a los ejemplos del servicio.
| TypeScript | Python / nota |
|---|---|
(x) => expression | función anónima con cuerpo de expresión, similar a lambda x: expression |
(x) => { statements } | función anónima con cuerpo de sentencias |
async (x) => { statements } | función anónima asíncrona |
const { model, seqLen } = request | extrae las propiedades model y seqLen de request |
const [first] = xs | first = xs[0]. Da undefined, no IndexError, cuando está vacío |
{ type: "error", message } | {"type": "error", "message": message}. Un nombre solo se convierte en ese campo |
`text ${x}` | f-string |
cond ? a : b | a if cond else b |
const / let | Ambos enlazan un nombre. const prohíbe reasignarlo, mientras que let lo permite |
export | hace que un nombre se pueda importar |
switch / case | match, salvo que los casos continúan en el siguiente si no terminan en break o return |
for await | iterar sobre un generador asíncrono |
i++ | incrementa y devuelve el valor anterior |
/^https?$/ | un literal de expresión regular, sin necesidad de re.compile |
T[], Map<K, V> | list[T], dict[K, V] |
Usa const salvo que el enlace deba cambiar. Usa let para un contador, un
acumulador u otro enlace que vayas a reasignar.
Una traducción breve de enum
Para los estados con valores de cadena, este repositorio usa un objeto más un tipo unión de cadenas inferido:
const Status = { Queued: "queued", Running: "running" } as const;
type Status = (typeof Status)[keyof typeof Status]; // "queued" | "running"
El objeto proporciona Status.Queued mientras el programa se ejecuta. La línea
type solo permite "queued" o "running" durante la comprobación de tipos.
Juntos cumplen los dos papeles de esta declaración de Python:
from enum import Enum

class Status(str, Enum):
    QUEUED = "queued"
    RUNNING = "running"
Solo necesitas reconocer el patrón. as const mantiene los valores del objeto
como las cadenas exactas en lugar de ampliarlos a cualquier string.
Las siete diferencias semánticas que hacen perder tiempo
La tabla de sintaxis te lleva hasta el final de los ejemplos. Estas diferencias semánticas son donde los hábitos de Python causan errores.
1. Los arrays y objetos vacíos son truthy
Que un contenedor vacío sea falsy en Python es el hábito que peor se traslada.
if (results) es verdadero para un array vacío. Escribe if (results.length).
2. null y undefined son diferentes
null suele marcar una ausencia deliberada. undefined suele significar que un
valor falta o no está asignado, aunque el código puede asignarlo
explícitamente. El código de las bibliotecas devuelve undefined constantemente.
La diferencia se nota al escribir un valor por defecto. || sustituye cuando el
lado izquierdo es falsy. Eso incluye 0, "" y false. ?? sustituye solo
para null y undefined. Así, 0 || 10 es 10, mientras que 0 ?? 10 es
0. Así es como un tamaño de batch de cero se convierte en silencio en diez.
3. Un bloque catch recibe unknown
No existe except ValueError:. Un único bloque catch recibe todo. Como
JavaScript permite lanzar una cadena, un número o null, TypeScript tipa el
valor capturado como unknown, su tipo de “podría ser literalmente cualquier
cosa” bajo strict. El repositorio complementario activa strict, y los
proyectos nuevos en general deberían hacerlo. Para inspeccionar el error,
primero acota el valor:
try {
    await risky();
} catch (error) {
    // `error` is `unknown` until you prove otherwise. This line is the
    // TypeScript equivalent of `except Exception as e:` and it is not
    // optional.
    const message = error instanceof Error ? error.message : String(error);
}
4. Las promises empiezan inmediatamente
Llamar a una función async empieza a ejecutar su cuerpo y devuelve una
promise. Un objeto corrutina de Python no hace nada hasta que lo esperas con
await o lo programas. Promise.all se parece a asyncio.gather.
Promise.allSettled se parece a gather(..., return_exceptions=True), salvo
que cada resultado se envuelve como { status, value } o
{ status, reason }.
Node se encarga de la planificación en runtime. Mantiene vivo el proceso mientras
existan handles o peticiones activos, como temporizadores y sockets. Una promise
pendiente corriente no mantiene Node vivo por sí sola. No envuelves el programa
en asyncio.run. En un módulo ES, puedes usar await en el nivel superior
cuando el arranque deba esperar a una operación asíncrona.
5. JavaScript tiene un único tipo numérico ordinario
El tipo number de JavaScript almacena los valores como números de coma
flotante de 64 bits, más o menos igual que el float de Python. El estándar
técnico de este formato se llama IEEE 754. Los valores decimales son
aproximados, así que 0.1 + 0.2 no es exactamente 0.3, y los enteros solo son
exactos hasta 2**53 - 1, es decir, 9,007,199,254,740,991.
Mantén los IDs de 64 bits como cadenas en las fronteras del servicio. Convertir
un bigint de Postgres a un number de JavaScript puede redondearlo. Para
enteros exactos mayores, JavaScript ofrece el tipo BigInt, aparte, que no se
mezcla con los números ordinarios.
6. Usa Map cuando necesites un diccionario al estilo de Python
En JavaScript, {} crea un objeto. Los objetos suelen representar registros
con campos con nombre:
const request = { model: "gpt-5", seqLen: 4096 };
console.log(request.model);
Un objeto no es una tabla clave-valor limpia como un dict de Python. Hereda
algunos nombres del propio JavaScript. Esto puede producir un resultado
sorprendente:
const tools: Record<string, unknown> = {};

tools["constructor"]; // a built-in function, not a missing value
Object.hasOwn(tools, "constructor"); // false
Si una cadena externa selecciona un campo de un objeto, llama a Object.hasOwn
antes de leerlo. Si necesitas un diccionario de propósito general, usa Map.
Map se parece más al dict de Python: una clave existe solo cuando tu código
la añade.
const tools = new Map<string, unknown>();
tools.get("constructor"); // undefined
7. Incluye la extensión en los imports relativos
Un archivo fuente de JavaScript que comparte código con otros archivos se llama
módulo. Este proyecto usa el formato de módulos moderno, los módulos ES,
que suele abreviarse como ESM. ES significa ECMAScript, el nombre formal del
lenguaje JavaScript. En la práctica, ESM es la sintaxis import y export que
se usa en todo este proyecto.
En un import relativo, Node exige el nombre de archivo exacto. No adivinará si
./env significa ./env.ts o ./env.js:
import { loadEnv } from "./env.ts";Los imports de paquetes instalados o del workspace siguen usando el nombre del paquete, sin extensión de archivo:
import { z } from "zod";
import { runAgent } from "@agent/core";
Zod: declara el esquema, deriva el tipo
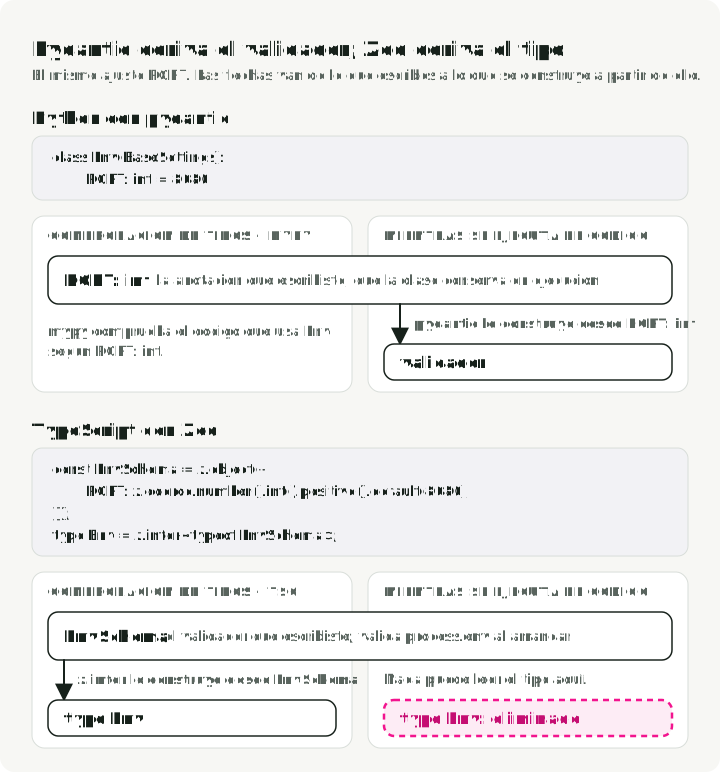
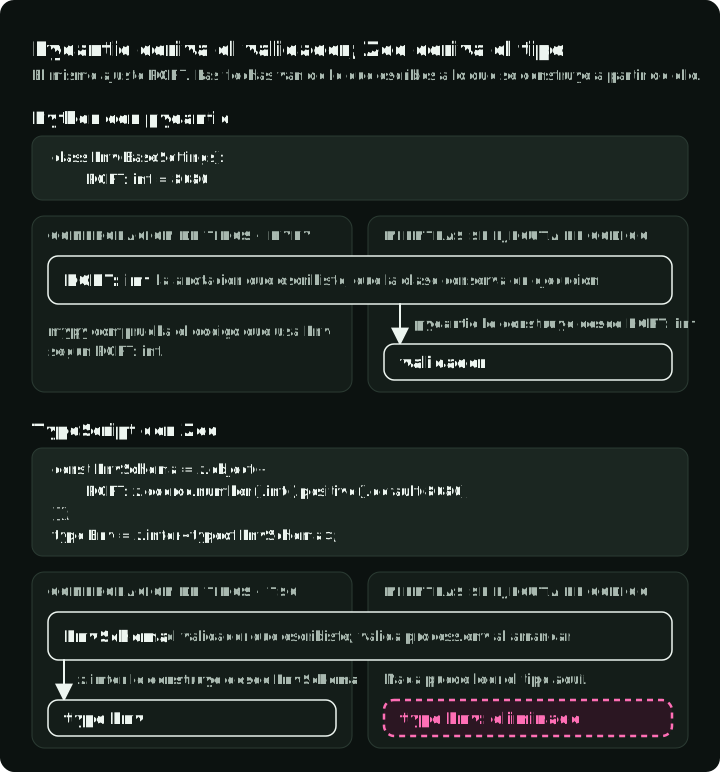
En pydantic declaras una clase y obtienes un validador. En Zod declaras un validador y derivas el tipo a partir de él. Misma fuente única de verdad, en dirección opuesta.
La figura muestra el mismo ajuste PORT en ambos sentidos y qué queda de cada
declaración mientras el código se ejecuta.
De packages/schemas/src/env.ts:
import { z } from "zod"; // `z` is Zod's whole API, the way `pd` is pandas

const EnvSchema = z.object({
    PORT: z.coerce.number().int().positive().default(8080),
    // See the note below: a bare z.url() would accept "localhost:8000".
    OPENAI_BASE_URL: z
        .url({ protocol: /^https?$/ })
        .default("https://api.openai.com/v1"),
    DATABASE_URL: z.string().optional(),
});

export type Env = z.infer<typeof EnvSchema>;
z.infer<typeof EnvSchema> lee un tipo estático a partir del esquema de runtime.
z.coerce.number() resuelve el hecho de que cada valor definido de
process.env (el os.environ de Node) es una cadena. Cumple el mismo papel que
la coerción numérica de los ajustes en pydantic, aunque las cadenas exactas que
acepta cada uno difieren. Sigue el patrón de pydantic-settings y se ejecuta una
vez al arrancar. Un entorno no válido produce entonces un error de arranque
legible en lugar de un TypeError dentro de un handler.
Un z.url() sin más acepta localhost:8000. El estándar de URL trata todo lo
que hay antes de los primeros dos puntos como el esquema. Por eso lee
localhost: como un protocolo llamado “localhost” y acepta la cadena. El valor
llega entonces al cliente HTTP y falla con menos contexto. La validación del
esquema adelanta los fallos, pero aplicará un esquema permisivo si eso es lo que
escribiste.
Zod 4 también incluye z.toJSONSchema, así que este proyecto no necesita la
dependencia zod-to-json-schema habitual en los tutoriales más antiguos. Eso
importa cuando un solo esquema tiene que alimentar a tres consumidores, de lo que
trata la sección “Una herramienta, tres consumidores” más abajo.
El servicio
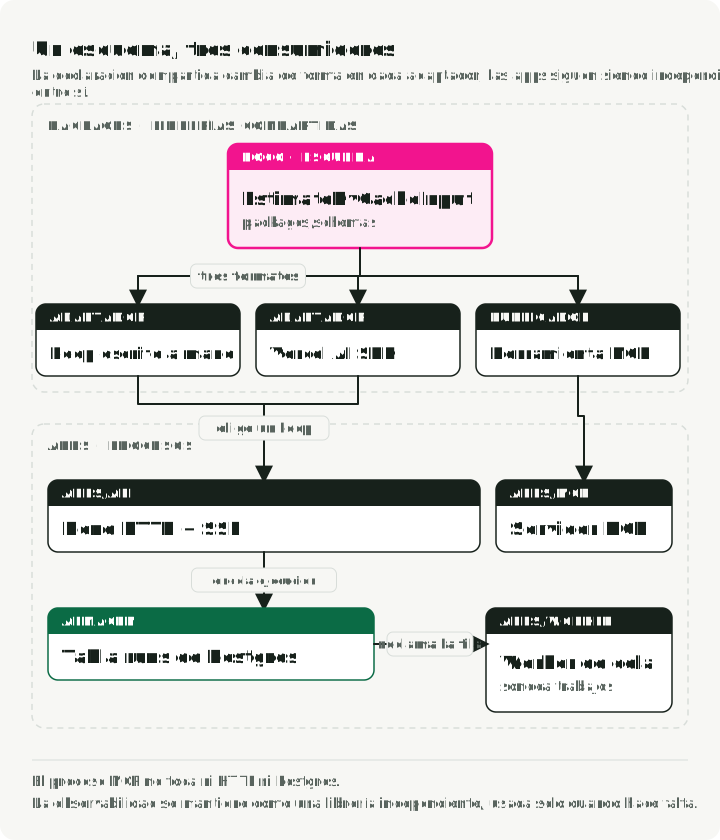
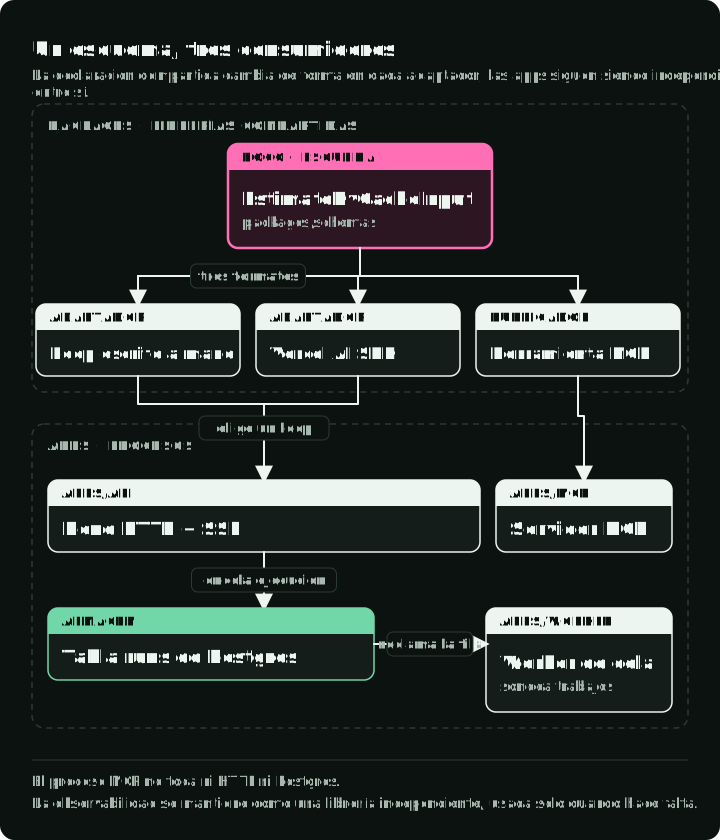
La fila superior es el código compartido en packages/. Debajo, cada app de
apps/ es un proceso independiente. Solo la API y el worker acceden a Postgres,
y el servidor MCP habla con su cliente por stdin y stdout.
El servicio de demostración dimensiona despliegues de LLM. Una herramienta consulta las constantes de arquitectura de un modelo. La otra estima su huella de KV cache: la memoria de GPU que se usa para guardar las claves y los valores de atención de las peticiones en curso. Ambas herramientas son deliberadamente aritmética aburrida. No necesitan red y dan siempre la misma respuesta. Eso hace que el servicio se pueda probar sin clave de API. El estimador de KV cache también se publica mediante el Model Context Protocol (MCP), para que otros clientes de AI puedan llamarlo.
typescript-agent-service/
├── apps/
│   ├── api/           @agent/api: Hono API, streams Server-Sent Events (below)
│   ├── worker/        polls Postgres for long-running jobs
│   └── mcp/           MCP server: exposes one tool to outside AI clients
├── packages/
│   ├── schemas/       package name @agent/schemas: env, API, and tool schemas
│   ├── agent-core/    package name @agent/core: the loop (twice), tools, storage
│   └── observability/ Pino logging, OpenTelemetry tracing
├── pnpm-workspace.yaml
└── package.json
pnpm-workspace.yaml es el archivo que declara el workspace. Los paquetes
internos reciben un nombre con ámbito como @agent/core, donde el prefijo
@agent/ es una convención de nombres, no una característica del lenguaje. Cada
paquete declara su punto de entrada público en package.json. Esa frontera del
paquete no depende del comando que arranque la aplicación.
Este workspace privado apunta esas entradas al código fuente .ts porque todos
los consumidores forman parte del mismo repositorio. Los paquetes públicos de npm
suelen publicar JavaScript más declaraciones de tipos .d.ts, para que los
consumidores normales de Node no necesiten el ejecutor de TypeScript ni la
configuración de compilación del autor del paquete.
Escribe el tool loop a mano, una vez
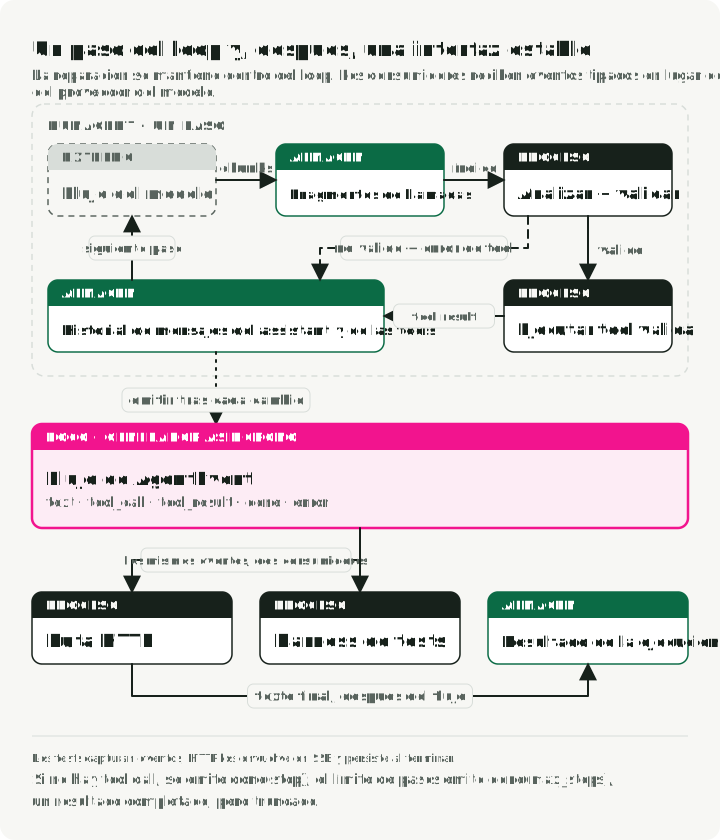
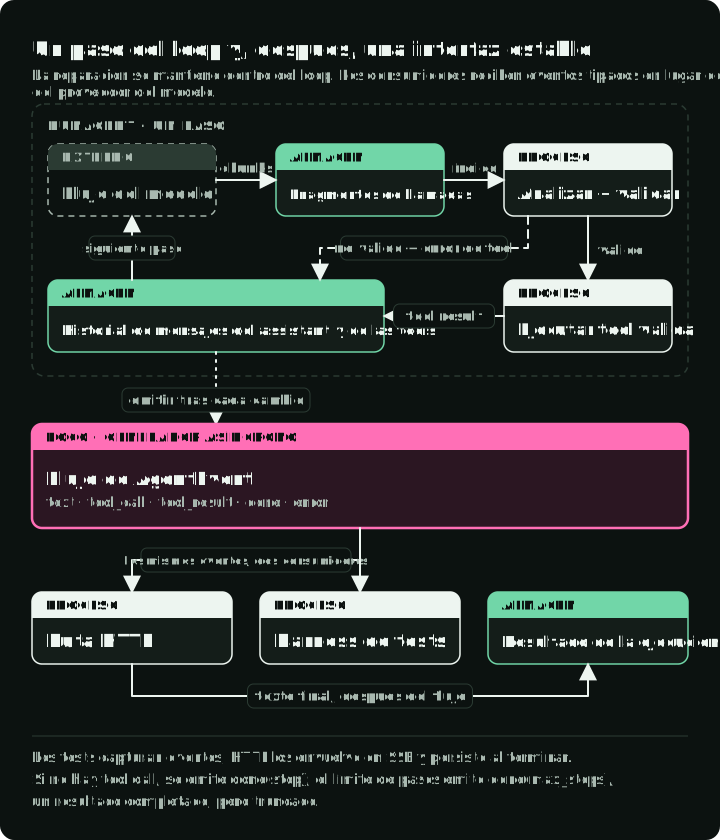
La columna izquierda es un paso del modelo. La columna derecha es lo que emite el loop: salvo una excepción que sale del loop, esos eventos son todo lo que ven la ruta HTTP y los tests.
Los frameworks de agentes con tool calling envuelven el mismo loop básico:
- Llamar al modelo con las definiciones de herramientas.
- Validar y ejecutar las herramientas solicitadas.
- Añadir los resultados a los mensajes.
- Llamar de nuevo al modelo.
Escribir el loop una vez hace visibles sus rutas de fallo ocultas.
El loop es un async function*, un generador asíncrono, exactamente la forma de
async def con yield en Python. La ruta HTTP itera ese generador, convierte
cada evento en un frame de Server-Sent Events y acumula el texto. Cuando termina
el stream, la ruta llama una vez a storage.createRun con el texto final. Los
tests invocan el loop por separado y recogen sus eventos en un array. Un frame
SSE es un fragmento de una respuesta HTTP de larga duración. La sección siguiente
explica el formato.
El loop tiene dos salidas normales. Una respuesta sin tool calls emite done con
stopReason: "stop". Si el modelo sigue pidiendo herramientas hasta maxSteps,
el generador igualmente se completa y emite done con
stopReason: "max_steps". Trata ese resultado como completado pero truncado: el
texto acumulado puede ser parcial.
Cada valor que emite el loop es un AgentEvent, una unión etiquetada. Abreviado
de packages/schemas/src/events.ts:
export const AgentEventSchema = z.discriminatedUnion("type", [
    z.object({ type: z.literal("text"), delta: z.string() }),
    z.object({
        type: z.literal("tool_call"),
        callId: z.string(),
        toolName: z.string(),
        args: z.unknown(),
    }),
    z.object({
        type: z.literal("tool_result"),
        callId: z.string(),
        ok: z.boolean(),
        result: z.unknown() /* ... */,
    }),
    z.object({
        type: z.literal("done"),
        stopReason: z.enum(["stop", "max_steps"]),
        steps: z.number(),
        text: z.string(),
    }),
    z.object({ type: z.literal("error"), message: z.string() }),
]);

export type AgentEvent = z.infer<typeof AgentEventSchema>;
z.discriminatedUnion elige la variante según el campo type, como un match sobre dataclasses etiquetadas. Dentro de if (event.type === "text"), el compilador sabe que existe event.delta. Añadir una variante no hace que un switch incompleto falle automáticamente. Para obtener un error de compilación por una variante ausente, comprueba el valor restante contra never en una rama default. Una regla de lint para comprobar todos los casos también puede detectar los que faltan. La ruta HTTP y la versión con el AI SDK que aparece más abajo utilizan los tipos de evento acotados.
El cuerpo del loop emite eventos de texto y ensambla las tool calls a partir de
fragmentos. De packages/agent-core/src/loop.ts:
let text = ""; // the assistant text produced during this model step
// Keyed by the `index` field, because a streamed response interleaves
// fragments of several parallel tool calls and only `index` is present
// on every fragment. `id` and `name` arrive once, `arguments` arrives
// in pieces. `a?.b` below reads `b` only if `a` exists, and gives back
// `undefined` instead of throwing if it doesn't.
const partial = new Map<number, PartialToolCall>();

for await (const chunk of stream) {
    const choice = chunk.choices[0];
    if (!choice) continue;

    if (choice.delta.content) {
        text += choice.delta.content;
        yield { type: "text", delta: choice.delta.content };
    }

    for (const fragment of choice.delta.tool_calls ?? []) {
        const slot = partial.get(fragment.index) ?? { id: "", name: "", args: "" };
        if (fragment.id) slot.id = fragment.id;
        if (fragment.function?.name) slot.name = fragment.function.name;
        if (fragment.function?.arguments) slot.args += fragment.function.arguments;
        partial.set(fragment.index, slot);
    }
}
La variable local text del loop contiene un paso del modelo. El loop la usa en
el mensaje del asistente del paso siguiente o en el evento done final. No es el
acumulador a nivel de ruta que se persiste después.
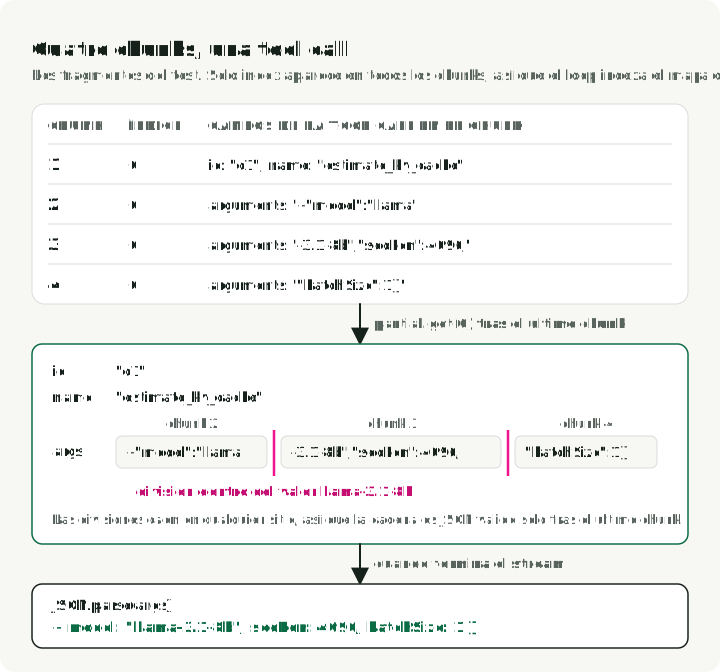
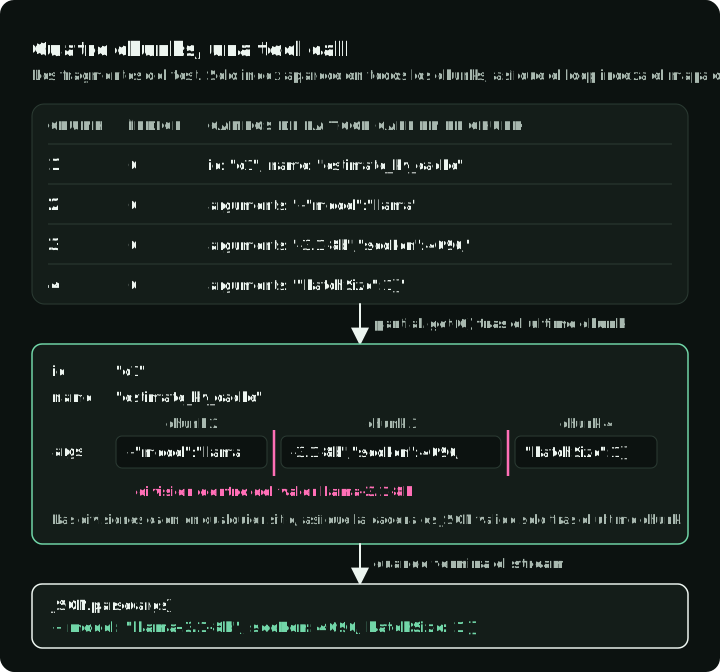
El mapa partial es la parte que ocultan los frameworks. El SDK expone
fragmentos de cadena de los argumentos de la función, y pueden cortar el JSON
serializado en posiciones arbitrarias. Varias llamadas en paralelo también
pueden entrelazarse. El repositorio tiene un test que reparte
{"model":"llama-3.1-8b",...} en cuatro chunks.
La figura sigue esos cuatro chunks hasta la entrada del mapa para el índice 0.
Lo segundo que merece la pena escribir tú mismo es qué ocurre cuando falla la validación:
// `tool.parse` is this repo's wrapper, not Zod's. Zod's own `.parse` throws and
// `.safeParse` returns `{ success, data, error }`; this returns
// `{ ok: true, value }` on success and `{ ok: false, error }` on failure, so no
// caller has to catch.
const parsed = tool.parse(raw);
if (!parsed.ok) {
    return {
        ok: false,
        value: { error: `Invalid arguments: ${parsed.error}` },
        parsedArgs: raw,
    };
}
Antes de la ejecución, la búsqueda puede no encontrar la herramienta,
JSON.parse puede rechazar los argumentos o Zod puede rechazar su forma. Cada
fallo se convierte en un mensaje que lee el modelo. Durante la ejecución, un
ToolError esperado también se convierte en un tool result para que el modelo
pueda corregir su llamada. Una excepción inesperada se propaga a la ruta de
error HTTP en lugar de presentarse como un fallo del dominio.
z.prettifyError convierte el árbol de incidencias de Zod en un mensaje sobre el
que el modelo puede actuar, en lugar de un stack trace.
strict: true en la definición de una función de
OpenAI pide al
proveedor que restrinja la decodificación al esquema. No tiene relación con la
opción strict del tsconfig de TypeScript. Se parece a la guided decoding de
vLLM, aunque los esquemas admitidos y los detalles de aplicación difieren.
Elimina un modo de fallo, pero un endpoint autoalojado puede ignorar la opción.
Además, los argumentos deben superar JSON.parse.
El loop llama a /chat/completions porque el repositorio complementario apunta a
servidores compatibles con OpenAI.
vLLM,
SGLang y
Ollama documentan ese
endpoint, así que OPENAI_BASE_URL puede apuntar el mismo cliente a cualquiera
de ellos. Su cobertura de la Responses API difiere y cambia con cada versión. Si
controlas ambos lados, consulta la página de compatibilidad vigente del servidor
antes de elegir entre las dos APIs.
Después cambia al AI SDK y entiende qué has intercambiado
El repositorio complementario también implementa el mismo agente con el Vercel AI SDK, para que puedas comparar las dos versiones. Ambas emiten valores AgentEvent, pero actualmente difieren en su comportamiento ante errores terminales. El adaptador opcional del SDK emite un evento error con String(part.error) y termina sin done. La ruta HTTP actual reenvía ese detalle y guarda la ejecución como succeeded porque el generador termina sin lanzar una excepción. Antes de sustituir el loop directo predeterminado por este adaptador, trata error o un stream que se cierre sin done como una ejecución fallida, sanitiza los mensajes de error para el cliente y prueba el estado almacenado junto con el evento terminal.
El repositorio usa AI SDK 7. Su implementación con el framework está en
packages/agent-core/src/loop-ai-sdk.ts:
const result = streamText({
    model: provider.chatModel(options.model),
    prompt: options.message,
    tools: aiSdkTools,          // Zod schemas passed straight through
    stopWhen: stepCountIs(options.maxSteps ?? 6),
});

for await (const part of result.fullStream) {
    switch (part.type) {
        case "text-delta": yield { type: "text", delta: part.text }; break;
        case "tool-call":  yield { type: "tool_call", callId: part.toolCallId, /* ... */ }; break;
        // ...
    }
}
El SDK elimina cinco piezas de código de la aplicación:
- el acumulador de fragmentos
JSON.parsey su ruta de error- la llamada que ejecuta Zod sobre los argumentos analizados
- el ensamblado de mensajes específico de cada proveedor
- el contador de pasos
stopWhen acepta varias condiciones, entre ellas un límite de pasos o una
tool call concreta. El bucle for await no cambia cuando cambia la política de
parada.
Lo que pierdes es el control directo sobre los fallos de validación. El loop
escrito a mano decide qué ve el modelo tras una llamada rechazada. El repositorio
complementario no configura la opción
repairToolCall
del SDK, así que usa el comportamiento por defecto: si se permite más de un paso,
AI SDK 7 devuelve la llamada fallida al modelo en el paso siguiente. Pasa un
callback repairToolCall para corregir tú mismo la llamada, por ejemplo con una
segunda llamada al modelo.
El intercambio funciona también en sentido contrario. En la versión con el SDK, un cambio de proveedor queda localizado en el adaptador del proveedor. Aun así requiere el paquete del proveedor correspondiente, las credenciales, la configuración y tests de integración. En el loop sin framework, el tratamiento de peticiones y streams específico de cada proveedor es código tuyo que tendrás que cambiar.
Para un servicio nuevo, empieza con el SDK salvo que necesites controlar esas rutas de fallo. La versión escrita a mano te da una implementación pequeña que inspeccionar y con la que comparar esa elección.
Streaming sobre HTTP: Hono y SSE
Las rutas de Hono se leen como las de FastAPI. La única adición es zValidator,
que hace el trabajo que FastAPI obtiene gratis de las anotaciones de tipo en la
firma de un handler. La c del handler siguiente es el contexto de petición de
Hono, el objeto que FastAPI reparte entre tus parámetros. deps es un conjunto
de dependencias con las que se construye la aplicación en lugar de importarlas
directamente. runAgent es una de ellas, y la sección de tests muestra qué
ganas con eso.
Abreviado de apps/api/src/app.ts:
app.post("/v1/chat", zValidator("json", ChatRequestSchema), (c) => {
    const body = c.req.valid("json");
    const log = deps.logger.child({ route: "chat" });

    return streamSSE(c, async (stream) => {
        let text = "";
        let done: Extract<AgentEvent, { type: "done" }> | undefined;
        try {
            // The full route wraps this loop in a `withSpan` tracing span.
            for await (const event of deps.runAgent({
                message: body.message,
                maxSteps: body.maxSteps,
            })) {
                if (event.type === "text") text += event.delta;
                if (event.type === "done") done = event;

                await stream.writeSSE({
                    event: event.type,
                    data: JSON.stringify(event),
                });
            }
        } catch (error) {
            log.error({ err: error }, "agent run failed");
            await stream.writeSSE({
                event: "error",
                data: JSON.stringify({
                    type: "error",
                    message: "Agent run failed",
                }),
            });
            return;
        }

        await deps.storage.createRun({
            kind: "chat",
            status:
                done?.stopReason === "max_steps" ? "truncated" : "succeeded",
            input: { message: body.message },
            output: { text },
        });
    });
});
La ruta conserva el evento done final. Un loop que se detiene en max_steps
se completa con normalidad, así que la ruta lo guarda como truncated, no como
succeeded.
zValidator valida el cuerpo y da a c.req.valid("json") el tipo que produce el
esquema. Si lo omites, el cuerpo se tipa como any, la vía de escape de
TypeScript, donde cualquier acceso a una propiedad compila y no se comprueba
nada. Eso anula el beneficio de seguridad de tipos del esquema.
Esta ruta usa Server-Sent Events en lugar de WebSockets. El servidor mantiene
abierta una respuesta HTTP mientras escribe frames event: <name> y
data: <json>, y la cierra después del evento final. El tráfico fluye del
servidor al cliente, que es lo que encaja con este stream del agente. Un
WebSocket añadiría mensajería bidireccional y un cambio de protocolo que esta
ruta no necesita.
Con el loop directo predeterminado, una excepción a mitad del stream cambia cómo se informa de los errores HTTP. Una vez enviado el primer frame con estado 200, el servidor no puede sustituir esa respuesta por un 500. El bloque catch registra el error capturado, envía al cliente un evento de error constante y termina. Ese retorno omite storage.createRun, por lo que un error lanzado por el generador no deja ninguna fila. Este catch no se ejecuta cuando el adaptador opcional del SDK emite un evento error y termina. Si quieres guardar ejecuciones fallidas para depurar o evaluar, escribe una fila failed en el bloque catch con el texto parcial.
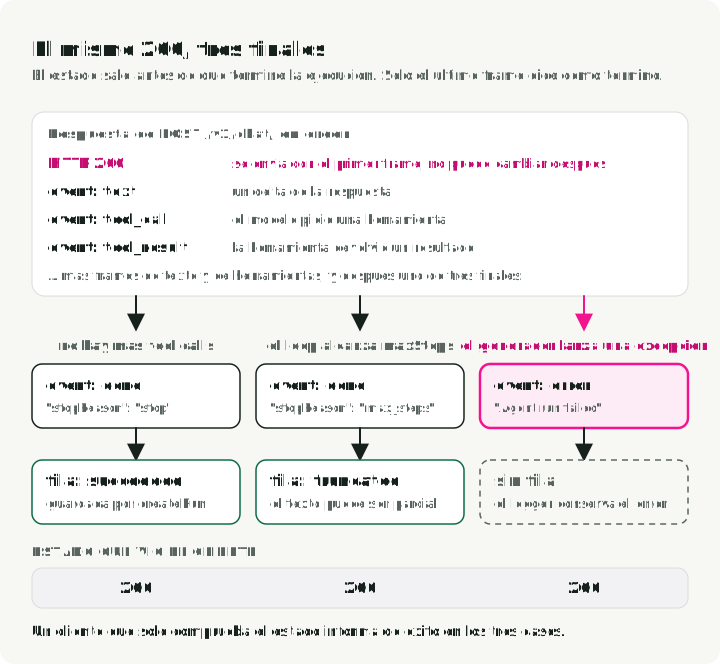
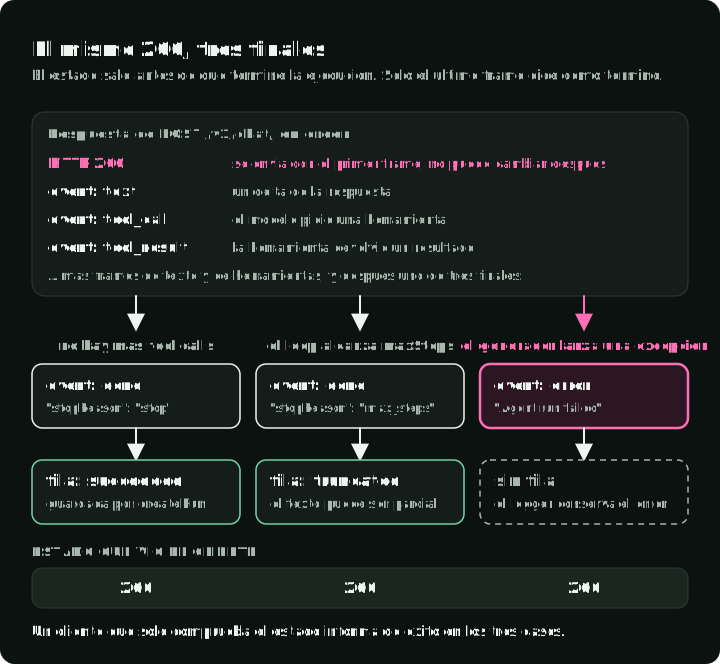
La figura sigue una petición hasta sus tres finales. El código de estado es el mismo en los tres, así que solo el último frame los distingue.
Un test cubre esta ruta. Un generador emite un delta de texto y después lanza una
excepción. La respuesta sigue siendo 200, y su último frame es un evento error
con el mensaje constante Agent run failed. El logger conserva el error
capturado para diagnosticarlo en el servidor. Cualquier cliente que solo
compruebe el código de estado informa de éxito en una ejecución fallida.
app.ts toma otras dos decisiones menores que merece la pena explicar. Trata
/healthz como un endpoint de liveness, así que esa ruta deliberadamente no toca
Postgres. Un fallo de liveness durante una caída de la base de datos podría
reiniciar todas las réplicas sin reparar la dependencia. Añade una comprobación
de readiness aparte cuando el orquestador deba dejar de enrutar tráfico a una
instancia que no alcanza Postgres. Las rutas de error registran el error
capturado pero devuelven una cadena constante. Devolver error.message en el
cuerpo de una respuesta es la forma en que las cadenas de conexión acaban en el
navegador de otra persona.
La parte con forma de Celery, sin Celery
Los trabajos largos no pertenecen a un handler de petición. POST /v1/sweeps
valida un modelo, una longitud de secuencia y una lista de tamaños de batch,
inserta una fila queued y devuelve 202 con el id de la ejecución. El worker
reclama la fila, calcula el tamaño de KV cache para cada tamaño de batch y
guarda el resultado. GET /v1/runs/:id lo lee.
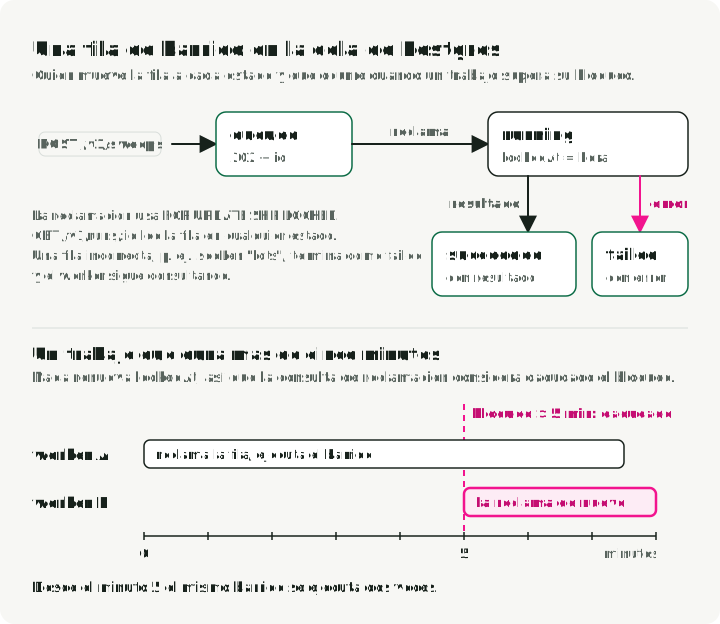
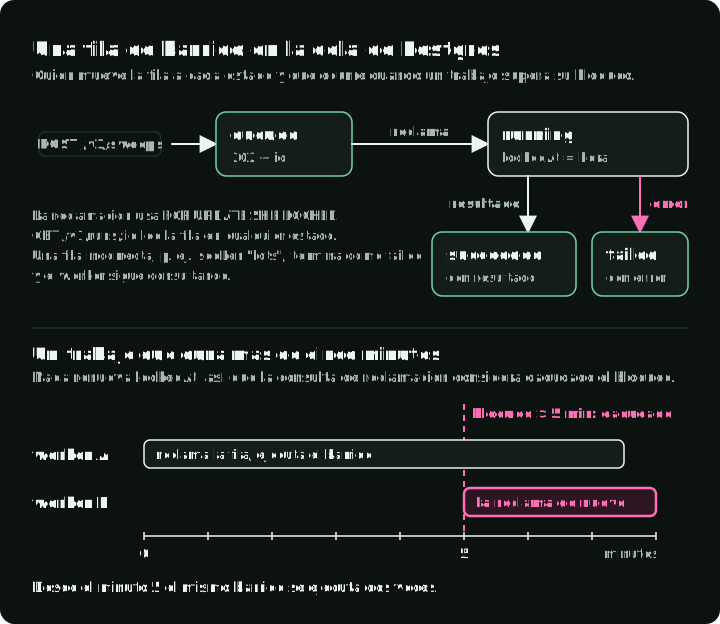
La mitad superior muestra los estados por los que pasa una fila de barrido. La línea de tiempo muestra la recuperación de un bloqueo caducado que se explica más abajo: pasados cinco minutos, un segundo worker reclama un trabajo que sigue en ejecución.
Aquí no hay Redis ni BullMQ. PostgreSQL documenta SKIP LOCKED para
varios consumidores de una tabla con forma de cola.
La cláusula da a este pequeño servicio una cola at-least-once en una sola tabla.
Es transaccional con el resto de tus escrituras, y es un servicio menos en
docker-compose.yml.
La consulta de reclamación en
packages/agent-core/src/db/storage.ts
es:
const [candidate] = await tx
    .select({ id: runs.id })
    .from(runs)
    // The real query also picks up rows whose lock went stale; trimmed here.
    .where(and(eq(runs.kind, kind), eq(runs.status, "queued")))
    .orderBy(runs.createdAt)
    .limit(1)
    // `.for()` adds a locking clause; `{ skipLocked: true }` adds SKIP LOCKED.
    .for("update", { skipLocked: true });
La fila queda bloqueada durante la transacción, y cualquier worker concurrente
que ejecute la misma consulta la omite en lugar de quedarse esperando. Dos
reclamaciones simultáneas no reciben, por tanto, la misma fila no caducada. Un
test de integración lanza dos reclamaciones a la vez con Promise.all y comprueba
que devuelven filas distintas. La versión ingenua, SELECT ... LIMIT 1 seguido de
UPDATE, no pasa ese test: ambas transacciones leen la misma fila antes de que
ninguna escriba, así que las dos inician el mismo trabajo.
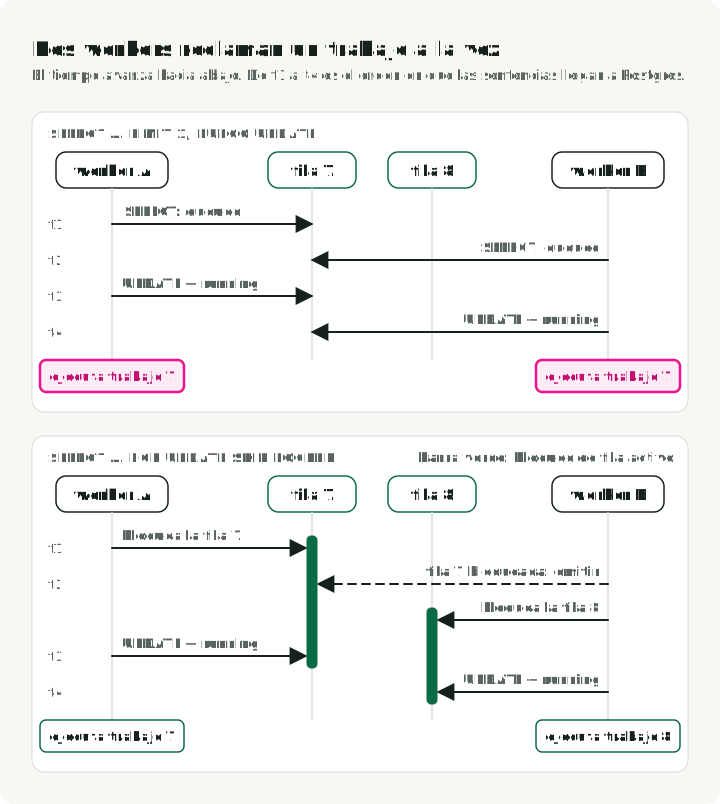
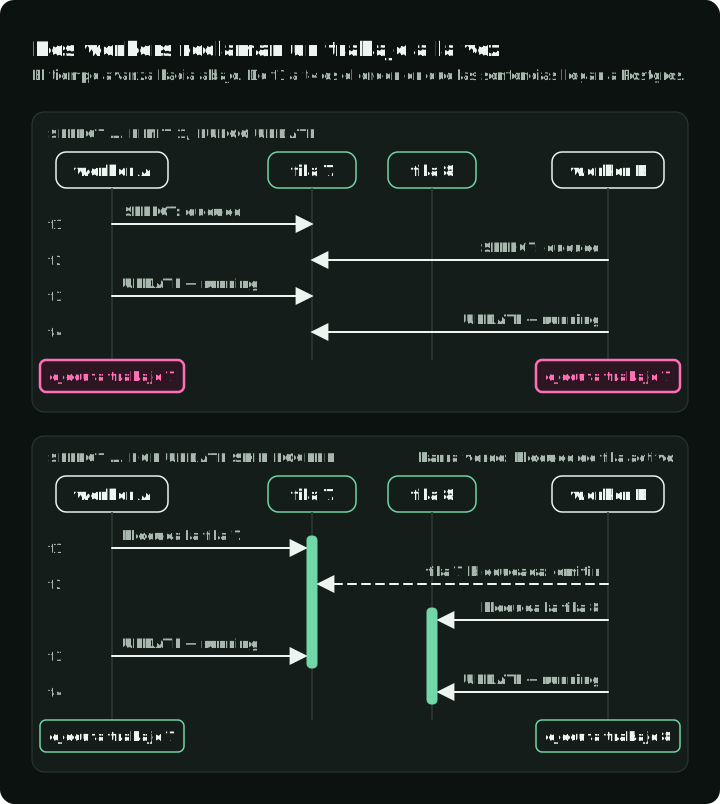
El panel superior es la condición de carrera que detecta el test; el panel inferior es la consulta de reclamación anterior.
Esto es ejecución at-least-once: un trabajo puede ejecutarse más de una vez. La
consulta completa también reclama una fila running cuando su bloqueo tiene más
de cinco minutos, y nada renueva ese arrendamiento. Un trabajo en ejecución que dure más
de cinco minutos puede, por tanto, reclamarse dos veces. Haz los trabajos
idempotentes. Para trabajos de larga duración, añade un heartbeat del
arrendamiento o fija el umbral de bloqueo caducado por encima del tiempo máximo
de ejecución.
Añade BullMQ cuando necesites trabajos diferidos, programaciones repetibles, prioridades, límites de frecuencia o un panel de control. El movimiento equivalente en Python es pasar de una tabla de base de datos a Celery. Antes de eso, Redis es un servicio más que ejecutar y monitorizar.
El worker vuelve a validar lo que lee de jsonb:
// The row was validated on the way in, but it has been through a database.
// A stored row can outlive the schema version that accepted it.
// The job is a batch-size sweep. Zod's own `.parse` throws; the poll loop
// catches that and marks the run failed.
const input = SweepRequestSchema.parse(run.input);
La batería de tests también alimenta al worker con una fila de barrido cuyo
seqLen es la cadena "lots". El worker marca la ejecución como fallida y sigue
sondeando, en lugar de caerse y reintentar para siempre la misma fila
incorrecta.
El trabajo de CPU expone otra restricción de Node. Un callback síncrono se
ejecuta en el hilo del event loop y no se interrumpe. Un bucle for que haga
aritmética durante dos segundos bloquea todas las peticiones, temporizadores y
comprobaciones de liveness de ese proceso durante dos segundos. Un bucle cerrado
dentro de un async def bloquea asyncio de la misma manera. Ambos runtimes
exigen descargar explícitamente el trabajo de CPU.
await setTimeout(0) de node:timers/promises (el prefijo node: indica la
biblioteca estándar, así que node:timers es para Node lo que os es para
Python) equivale a await asyncio.sleep(0). El barrido cede el control después
de cada tamaño de batch para que el proceso del worker pueda atender
temporizadores y otros callbacks. Ceder el control no hace paralelo el trabajo de
CPU. Los
worker_threads de Node pueden
ejecutar JavaScript en paralelo. Para trabajo de CPU en Python puro con la
compilación habitual de CPython con GIL, usa un pool de procesos en lugar de un
pool de hilos. Este servicio no usa ninguno de los dos. Mantén el cálculo
numérico pesado en Python, donde ya viven las bibliotecas que lo respaldan, y
sácalo del event loop de la API.
Una herramienta, tres consumidores
EstimateKvCacheInput tiene tres consumidores:
- El loop escrito a mano lo convierte con
z.toJSONSchema. - El AI SDK lo recibe sin cambios.
- El servidor MCP publica su forma.
Esa reutilización es la razón de que exista packages/schemas.
server.registerTool(
    "estimate_kv_cache",
    {
        description: "Estimate KV-cache VRAM in GiB for a served model...",
        // A Zod object schema keeps the map of fields you passed in on
        // `.shape`. This SDK wants that map, not the schema wrapped around it.
        inputSchema: EstimateKvCacheInput.shape,
    },
    async ({ model, seqLen, batchSize }) => {
        /* ... */
    },
);

await server.connect(new StdioServerTransport());
Dos detalles importan antes de conectar un cliente. Primero, un servidor
iniciado de esta manera usa su propio stdin y stdout para comunicarse con el
cliente. Cada línea es
un mensaje JSON-RPC.
Un console.log perdido, el equivalente en JavaScript de print, corrompe
entonces un mensaje. El cliente se desconecta con un error de análisis que no
menciona ningún archivo. Envía todos los diagnósticos a stderr.
Segundo, un fallo del dominio debe devolver isError: true con un mensaje. El
modelo que llama puede entonces corregir la llamada, igual que puede hacerlo
tras argumentos de herramienta no válidos en el agent loop.
Puedes manejar el servidor con printf y una tubería, algo que merece la pena
hacer una vez antes de apuntar un cliente real hacia él:
printf '%s\n' \
  '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-06-18","capabilities":{},"clientInfo":{"name":"probe","version":"1"}}}' \
  '{"jsonrpc":"2.0","method":"notifications/initialized"}' \
  '{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"estimate_kv_cache","arguments":{"model":"llama-3.1-70b","seqLen":8192,"batchSize":4}}}' \
  | pnpm -s mcp   # -s suppresses pnpm's own output so only JSON-RPC comes back
La sonda usa la misma versión del protocolo que el README del repositorio complementario. Para un cliente real, usa el SDK en lugar de mantener a mano los mensajes JSON-RPC.
Prueba un agente sin clave de API
Vitest cumple el papel de pytest, pero la estructura es distinta. describe
agrupa tests relacionados. it y test definen cada uno un caso de prueba.
test.each se parece a parametrize, beforeEach proporciona la preparación de
cada test, vi.fn() crea una función mock y describe.skipIf omite un grupo
según una condición.
Los tests del agente dependen de una decisión: runAgent recibe un cliente de
OpenAI como parámetro en lugar de construir uno. El doble de prueba es un objeto
con un método chat.completions.create que devuelve un iterable asíncrono con
respuestas predefinidas:
function fakeClient(scripts: Chunk[][]): OpenAI {
    let call = 0;
    return {
        chat: {
            completions: {
                create: async () => {
                    const script = scripts[call++] ?? [];
                    // Defines an async generator and calls it on the same
                    // line, so `create` hands back something you can
                    // `for await` over, which is the shape a real streaming
                    // response has.
                    return (async function* () {
                        for (const chunk of script) yield chunk;
                    })();
                },
            },
        },
        // TypeScript refuses a direct cast between unrelated shapes, so you
        // cast through `unknown` first. This disables type checking for that
        // value, so keep it to test code.
    } as unknown as OpenAI;
}
Los tests reparten una cadena de argumentos JSON en varios chunks y manejan dos
tool calls en una misma respuesta. También cubren un batchSize no válido, JSON
mal formado, nombres de herramienta desconocidos y un modelo que sigue llamando
a herramientas hasta que maxSteps lo detiene. El archivo de tests se ejecuta en
bastante menos de un segundo, sin red y sin clave.
Los tests de integración contra Postgres usan
describe.skipIf(!process.env.DATABASE_URL), así que pnpm test funciona en un
clon recién hecho sin Postgres en marcha, y la CI los activa al proporcionar la
variable. El repositorio tiene 42 tests. Treinta y ocho se ejecutan sin Postgres
ni clave de API.
Registra eventos estructurados con Pino
Pino cumple el mismo papel que structlog: un objeto JSON por línea, loggers
hijos con campos enlazados y redacción explícita de datos sensibles. El
repositorio complementario lo configura en
packages/observability/src/logger.ts:
const log = pino({
    redact: {
        paths: [
            "req.headers.authorization",
            "apiKey",
            "OPENAI_API_KEY",
            "*.apiKey",
        ],
        censor: "[redacted]",
    },
});
Sin esa redacción, log.info({ req }, "...") puede copiar una cabecera
Authorization al backend de logs.
Traza el trabajo de la aplicación con spans manuales
El repositorio complementario usa OpenTelemetry para tres spans a nivel de
aplicación: agent.run, agent.tool y worker.sweep. No instala
instrumentación automática de HTTP ni de Postgres. startTracing() en
packages/observability/src/tracing.ts
crea un NodeSDK con un exportador de trazas OTLP. Si falta
OTEL_EXPORTER_OTLP_ENDPOINT, deja el tracing desactivado.
withSpan(), del mismo archivo, envuelve el trabajo en sí:
return tracer.startActiveSpan(name, { attributes }, async (span) => {
    try {
        return await fn(span);
    } finally {
        span.end();
    }
});
JavaScript no tiene una sintaxis de gestor de contexto como la de Python. Aquí, el callback es el bloque que rodearía un gestor de contexto de Python. El helper completo también registra las excepciones y fija el estado del span antes de volver a lanzarlas.
Los spans automáticos de HTTP y de base de datos son una función aparte. Exigen los paquetes de instrumentación correspondientes y una inicialización antes de que se carguen los módulos instrumentados. Añádelos solo cuando esos spans sean útiles, y sigue entonces la configuración del SDK de OpenTelemetry para Node para las versiones exactas de los paquetes que despliegues.
Despliega el monorepo en Docker
Usa el
Dockerfile
incluido. El contenedor arranca la API con el loader de tsx. No necesitas
elegir ni invocar un ejecutor de TypeScript cuando lo despliegas.
La compilación usa pnpm fetch para que las descargas de dependencias sigan en
caché hasta que cambie el lockfile. Después usa pnpm deploy para copiar la API
y sus dependencias de producción a un directorio autocontenido. La etapa de
runtime se ejecuta como el usuario node, sin privilegios de root, y su CMD en
forma exec permite que la API reciba SIGTERM directamente para un apagado
ordenado.
Por qué el Dockerfile carga tsx
Node 24 puede ejecutar un subconjunto limitado de TypeScript eliminando las
anotaciones de tipo. No comprueba los tipos del código ni realiza las
transformaciones que admite un ejecutor completo de TypeScript. Los scripts de
paquete del repositorio ocultan ese detalle. pnpm check realiza la
comprobación estática por separado.
El contenedor expone otro límite. pnpm deploy copia los paquetes del workspace
bajo node_modules, y Node se niega deliberadamente a eliminar tipos de
TypeScript ahí (documentación de TypeScript en
Node). Sin un loader, el contenedor
falla al arrancar con ERR_UNSUPPORTED_NODE_MODULES_TYPE_STRIPPING.
El Dockerfile carga tsx, que procesa esos archivos .ts antes de que Node los
ejecute. Un equipo que quiera solo archivos .js en su imagen de runtime puede
añadir en su lugar un paso de compilación. Es un diseño de producción
alternativo, no un paso adicional necesario para ejecutar este repositorio
complementario.
Un itinerario de tres semanas
Los ingenieros de Python con experiencia pueden saltarse el material que enseña variables y bucles. Esta secuencia se centra en las partes que difieren de Python. Haz el ejercicio de construcción de cada fila; la lectura sirve de apoyo.
| Semana | Lee | Construye |
|---|---|---|
| 1 | javascript.info: solo módulos, promises y objetos. Conserva la guía de JS de MDN como referencia. | Reescribe una CLI de Python en TypeScript. Añade un script en package.json. Ejecuta el script y pnpm typecheck. |
| 1-2 | Lee la referencia de tsconfig de TypeScript, los tutoriales gratuitos de Total TypeScript y la documentación de Zod. | Construye un módulo de configuración validado con Zod y una unión etiquetada. Tras comprobar la etiqueta, el compilador sabe qué variante contiene el bloque. |
| 2 | Lee la documentación de Hono, Drizzle, Vitest y Biome. | Construye un proxy con streaming hacia un endpoint compatible con OpenAI, con un log respaldado por Drizzle. |
| 3 | Lee la documentación del AI SDK y del SDK de TypeScript de MCP. | Construye un agente con tool calling. Después construye un servidor MCP que exponga una de sus herramientas. |
Empieza con los tutoriales gratuitos de Total TypeScript. Paga por el material avanzado solo cuando trabajes con genéricos y tipos condicionales de nivel de biblioteca. Sáltate todos los cursos de “introducción a JavaScript”, y sáltate cualquier material sobre React salvo que el producto lo requiera.
Para un panorama de las convenciones de producción, goldbergyoni/nodebestpractices es una amplia lista de comprobación mantenida por la comunidad. Verifica con la documentación vigente de Node los consejos que afecten al comportamiento en runtime o a la seguridad.
Antes de adaptar el servicio
Los tests sin conexión ejercitan el flujo de control del servicio con respuestas de modelo predefinidas. No establecen con qué fiabilidad completará un modelo real tus tareas. Mantén esa distinción cuando sustituyas las herramientas de la demo por las reales.
Valida cada valor que entra desde fuera: el entorno, el cuerpo HTTP, los
argumentos de las tool calls del modelo y las filas leídas de jsonb.
| Valor | Lo comprueba | Si falla |
|---|---|---|
process.env | EnvSchema, en loadEnv() al arrancar | error de arranque; el proceso se detiene |
| Cuerpo HTTP | ChatRequestSchema, mediante zValidator | 400; el handler nunca se ejecuta |
| Argumentos de tool | tool.parse, después de JSON.parse | error de tool enviado al modelo |
runs.input | SweepRequestSchema, en el worker en cada reclamo | ejecución marcada como failed; el worker sigue sondeando |
Define a continuación la política de finalización: decide si tu aplicación
acepta, reintenta o revisa las ejecuciones truncated, y prueba juntos el
evento y el estado almacenado. Si los trabajos pueden durar más que el umbral de
bloqueo caducado, añade un heartbeat del arrendamiento antes de añadir efectos
secundarios.
Cuando esos comportamientos sean explícitos, añade la fila failed descrita en
la sección de streaming y usa las ejecuciones fallidas y truncadas para construir
una suite de evaluación de agentes
aparte. Ahí es donde se prueba la finalización de tareas; la suite sin conexión
sigue siendo la comprobación más rápida para detectar fallos de streaming,
validación y persistencia.
Referencias
Repositorio de demostración
- slavadubrov/typescript-agent-service - el monorepo usado a lo largo de este artículo: API de Hono con SSE, dos implementaciones del agent loop, almacenamiento con Drizzle, worker, servidor MCP y 42 tests
Runtime y lenguaje
- Ejecutar TypeScript directamente en Node.js - el soporte limitado de TypeScript en Node y su restricción en
node_modules - Opciones del compilador TypeScript -
stricty el resto de comprobaciones que configura el repositorio complementario - Guía de JavaScript de MDN - la referencia del lenguaje que conviene tener abierta
- javascript.info - tutorial de JavaScript moderno. Lee los capítulos de módulos y promises.
Herramientas
- pnpm y Instalación de pnpm - gestor de paquetes, workspaces y puesta en marcha
- Biome - lint, formateo y ordenación de imports en un solo binario
- Vitest - ejecutor de tests que no necesita configuración de transformación
- Total TypeScript - tutoriales gratuitos más un curso de pago para tipos avanzados
Bibliotecas
- Zod - validación de esquemas e inferencia de tipos. La versión 4 incluye
z.toJSONSchema. - Hono - framework HTTP basado en estándares de la Web
- Drizzle ORM - ORM de TypeScript centrado en SQL con migraciones de
drizzle-kit - Documentación de SELECT en PostgreSQL - la cláusula de bloqueo
FOR UPDATE ... SKIP LOCKED - BullMQ - cola respaldada por Redis para cuando la tabla de la base de datos no basta
AI y agentes
- Vercel AI SDK -
streamText,tool,stopWheny adaptadores de proveedores - openai/openai-node - el cliente oficial de TypeScript
- MCP TypeScript SDK y la especificación de MCP - para crear servidores y clientes
Convenciones
- goldbergyoni/nodebestpractices - lista de comprobación mantenida por la comunidad sobre convenciones de producción