TypeScript pour les ingénieurs ML Python : créer un service d’agent

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Ce guide s’adresse aux ingénieurs ML et backend Python expérimentés qui doivent construire un service d’AI en TypeScript et Node. Il part des concepts d’un service Python, pas des bases de la programmation ni du code navigateur. À la fin, vous saurez faire correspondre une stack de service Python à TypeScript, reconnaître les habitudes Python qui causent des bugs en JavaScript, puis exécuter et modifier un service d’agent en streaming.
L’exemple suit une requête à travers la validation, l’exécution des outils, le streaming HTTP et la persistance. Il répond à trois questions : que se passe-t-il lorsque les arguments d’un outil arrivent en fragments, qu’un flux échoue après un HTTP 200 ou qu’un worker récupère deux fois le même job ? Le périmètre se limite au backend et à l’AI : pas de React, pas de bundler pour navigateur.
Le code se trouve dans slavadubrov/typescript-agent-service. Il contient deux implémentations de l’agent loop, l’historique des exécutions dans Postgres, un worker et un serveur MCP. Vous pouvez exécuter sa démo hors ligne sans clé d’API, puis vous appuyer sur la correspondance Python-TypeScript ci-dessous pour lire et modifier le service. Les calculs numériques lourds restent en Python ; ce guide couvre l’orchestration, HTTP et le streaming.
Commencez par exécuter le dépôt compagnon
Installez Node 24 et pnpm en suivant les instructions d’installation officielles de pnpm. Clonez ensuite le dépôt compagnon et exécutez :
pnpm install
pnpm demo
pnpm check
pnpm demo exerce le gestionnaire HTTP, l’agent loop et le flux SSE avec un
modèle scripté. Il appelle aussi le calcul runSweep du worker, mais ne démarre
ni le processus du worker ni sa file d’attente en base de données. La démo ne
demande ni clé d’API, ni base de données, ni Docker. pnpm check lance le
vérificateur de types, le linter, la vérification du formatage et les tests.
La démo affiche les frames SSE d’une requête de chat, puis le balayage du worker. Version abrégée :
event: tool_call
data: {"type":"tool_call","callId":"call_1","toolName":"estimate_kv_cache","args":{"model":"llama-3.1-8b","seqLen":32768,"batchSize":16}}

event: tool_result
data: {"type":"tool_result","callId":"call_1","toolName":"estimate_kv_cache","ok":true,"result":{"model":"llama-3.1-8b","seqLen":32768,"batchSize":16,"kvCacheGiB":64},"durationMs":0}

event: done
data: {"type":"done","stopReason":"stop","steps":2,"text":"Llama-3.1-8B at 32k context and batch 16 needs 64 GiB of KV cache."}

--- worker: capacity sweep ---
batch=  1  kv_cache=4.0 GiB
batch= 16  kv_cache=64.0 GiB
Chaque bloc event:/data: est une frame SSE : le modèle demande un outil,
l’outil répond, puis l’exécution se termine par done. La dernière partie est
le balayage des tailles de batch par le worker.
Pour exécuter la vraie API et le worker :
cp .env.example .env          # add OPENAI_API_KEY or an OpenAI-compatible URL
pnpm db:up                    # start Postgres in Docker
pnpm db:push                  # create the database schema
pnpm dev:api                  # API at http://localhost:8080
pnpm dev:worker               # run this in a second terminal
Diffusez une exécution d’agent. La réponse est une série de frames SSE comme dans la sortie de la démo ci-dessus :
curl -N -X POST localhost:8080/v1/chat \
  -H 'content-type: application/json' \
  -d '{"message":"How much KV cache for llama-3.1-70b at 32k context, batch 8?"}'
Mettez un long job en file, puis interrogez-le. Le premier appel renvoie 202
avec {"id":"...","status":"queued"}. Le second renvoie la ligne stockée, avec
le résultat une fois que le worker a terminé :
curl -X POST localhost:8080/v1/sweeps \
  -H 'content-type: application/json' \
  -d '{"model":"llama-3.1-70b","seqLen":32768,"batchSizes":[1,4,16]}'

curl localhost:8080/v1/runs/<id>
Les scripts pnpm ci-dessus sont les commandes que j’utilise dans la suite de
cet article. Le dépôt place les commandes Node et TypeScript de plus bas niveau
derrière des scripts pnpm nommés, un peu comme un projet Python peut placer
des commandes uv run derrière des cibles make. Ne mélangez pas npm install
dans ce dépôt pnpm. Utilisez pnpm install pour que pnpm-lock.yaml reste
l’unique lockfile.
Rôle de Node, npm, pnpm, TypeScript et tsx
Des noms proches cachent des rôles distincts :
- JavaScript est le langage.
- Node.js est le runtime, à peu près le CPython de JavaScript. Installez Node 24 pour ce projet.
- Le registre npm est l’index de paquets, à peu près PyPI. La commande
npmest fournie avec Node et peut installer des paquets depuis ce registre. - pnpm est le gestionnaire de paquets choisi par ce dépôt. Il installe
depuis le registre npm, gère l’espace de travail du monorepo et exécute les
commandes déclarées dans
package.json. package.jsonest le manifeste du projet, ce qui se rapproche le plus depyproject.toml. Sa sectionscriptsdonne des noms tels quedemo,checketdev:apià des commandes plus longues.- TypeScript est du JavaScript avec des types statiques. Sa commande
tscvérifie ces types. Le dépôt la lance viapnpm checkoupnpm typecheck. - tsx exécute des fichiers
.tssans étape de build séparée. Les scripts de développement utilisent son modewatchpour redémarrer l’API ou le worker après une modification du code source. Ce guide ne l’invoque jamais directement.
Pour ce dépôt, lancez les scripts pnpm. Node est le runtime à l’intérieur de
ces scripts, et le Dockerfile fourni s’occupe de la production.
Ce que lance chaque script :
pnpm demolancetsx scripts/demo.ts.pnpm dev:apilancetsx watch.pnpm checklancetsc, Biome (le linter) et Vitest (le lanceur de tests).- Le
CMDDocker lancenode --import tsx/esm.
Tous s’exécutent sur Node 24. Dans pnpm check, tsc et Biome ne font que lire
les fichiers ; Vitest exécute les tests sur Node.
La stack, transposée depuis Python
Zod, Hono, Drizzle, Vitest et Biome couvrent en grande partie le même terrain que pydantic, FastAPI, SQLAlchemy, pytest et Ruff.
La plupart des paires sont des remplacements directs. Trois ne le sont pas :
| Besoin | Python | TypeScript | Pourquoi ce n’est pas un simple échange |
|---|---|---|---|
| Validation | pydantic | zod | Le schéma est la source. Le type en est généré, et non l’inverse |
| Types | mypy | TypeScript (pnpm typecheck) | Les types sont supprimés avant l’exécution du code. Aucune bibliothèque ne peut les lire, donc la validation à l’exécution exige un schéma distinct (Zod) |
| File de jobs | celery + Redis | bullmq (file adossée à Redis) ou SQL | Postgres peut implémenter une file at-least-once. Vous pouvez vous passer de broker |
Le dépôt compagnon utilise quatre bibliothèques qui méritent une explication.
Hono pour la couche HTTP
Express et Fastify sont des alternatives centrées sur Node. Hono s’appuie sur
les API Web standard Request et Response
et fournit des adaptateurs pour Node et les runtimes serverless. Cette
portabilité est utile pour cette petite API de streaming, d’où mon choix de
Hono. Choisissez Fastify lorsque le service ne tourne que sur Node et que vous
voulez son jeu de plugins et sa sérialisation des réponses fondée sur des
schémas.
Drizzle pour SQL
Drizzle garde le schéma en TypeScript et ne demande aucune étape de génération de client. Il permet aussi d’écrire du SQL brut lorsque le query builder ne sait pas exprimer proprement une clause Postgres. Je choisirais plutôt Prisma si son client généré et l’outillage qui l’entoure conviennent mieux à l’équipe.
Biome pour le linting et le formatage
Biome prend en charge le linting, le formatage et le tri des imports avec un seul binaire et un seul fichier de configuration. Gardez ESLint si le projet dépend de règles personnalisées que Biome ne fournit pas.
Vitest pour les tests
Vitest exécute les tests .ts du dépôt compagnon
sans configuration de transformation séparée. Gardez Jest dans un dépôt qui
possède déjà une configuration Jest et des matchers personnalisés.
Lire la syntaxe TypeScript utilisée ci-dessous
Gardez ce tableau à côté des exemples de service pour vous y référer.
| TypeScript | Python / remarque |
|---|---|
(x) => expression | fonction anonyme à corps d’expression, comparable à lambda x: expression |
(x) => { statements } | fonction anonyme à corps d’instructions |
async (x) => { statements } | fonction anonyme asynchrone |
const { model, seqLen } = request | extrait les propriétés model et seqLen de request |
const [first] = xs | first = xs[0]. Renvoie undefined, et non IndexError, si la liste est vide |
{ type: "error", message } | {"type": "error", "message": message}. Un nom seul devient ce champ |
`text ${x}` | f-string |
cond ? a : b | a if cond else b |
const / let | Les deux lient un nom. const interdit de le relier, tandis que let l’autorise |
export | rend un nom importable |
switch / case | match, sauf que les cas se poursuivent sur le suivant s’ils ne finissent pas par break ou return |
for await | itération sur un générateur asynchrone |
i++ | incrémente et renvoie l’ancienne valeur |
/^https?$/ | un littéral d’expression régulière, sans re.compile |
T[], Map<K, V> | list[T], dict[K, V] |
Utilisez const sauf si la liaison doit changer. Utilisez let pour un
compteur, un accumulateur ou toute autre liaison que vous réaffecterez.
Une brève traduction des enums
Pour les états à valeur de chaîne, ce dépôt utilise un objet plus un type union de chaînes inféré :
const Status = { Queued: "queued", Running: "running" } as const;
type Status = (typeof Status)[keyof typeof Status]; // "queued" | "running"
L’objet fournit Status.Queued pendant l’exécution du programme. La ligne
type n’autorise que "queued" ou "running" pendant la vérification des
types. Ensemble, ils remplissent les deux rôles de cette déclaration Python :
from enum import Enum

class Status(str, Enum):
    QUEUED = "queued"
    RUNNING = "running"
Il suffit de reconnaître ce motif. as const conserve les valeurs de l’objet
sous forme de chaînes exactes au lieu de les élargir à un string quelconque.
Les sept différences sémantiques qui font perdre du temps
Le tableau de syntaxe suffit pour suivre les exemples. Ces différences sémantiques sont celles où les habitudes Python provoquent des bugs.
1. Les tableaux et objets vides sont truthy
« Un conteneur vide est falsy » est l’habitude Python qui se transpose le plus
mal. if (results) est vrai pour un tableau vide. Écrivez
if (results.length).
2. null et undefined sont différents
null marque en général une absence délibérée. undefined signifie en général
qu’une valeur est manquante ou non affectée, bien que le code puisse l’affecter
explicitement. Le code des bibliothèques renvoie constamment undefined. La
différence apparaît lorsque vous écrivez une valeur par défaut. || substitue
le côté droit dès que le côté gauche est falsy, ce qui inclut 0, "" et
false. ?? ne substitue que pour null et undefined. Ainsi, 0 || 10
vaut 10, alors que 0 ?? 10 vaut 0. C’est ainsi qu’une taille de batch de
zéro devient silencieusement dix.
3. Un bloc catch reçoit unknown
Il n’existe pas de except ValueError:. Un seul bloc catch reçoit tout.
Comme JavaScript permet de lever une chaîne, un nombre ou null, TypeScript
type la valeur capturée comme unknown, son type « cela pourrait être
n’importe quoi » sous strict. Le dépôt compagnon active strict, et les
nouveaux projets devraient généralement le faire. Pour inspecter l’erreur,
affinez d’abord la valeur :
try {
    await risky();
} catch (error) {
    // `error` is `unknown` until you prove otherwise. This line is the
    // TypeScript equivalent of `except Exception as e:` and it is not
    // optional.
    const message = error instanceof Error ? error.message : String(error);
}
4. Les promises démarrent immédiatement
Appeler une fonction async exécute son corps et renvoie une promise. Un objet
coroutine Python ne fait rien tant que vous ne l’attendez pas ou ne le
planifiez pas. Promise.all est proche de asyncio.gather.
Promise.allSettled est proche de gather(..., return_exceptions=True), sauf
que chaque résultat est enveloppé sous la forme { status, value } ou
{ status, reason }.
Node gère lui-même la planification au runtime. Il maintient le processus en vie
tant que des handles ou des requêtes actifs, comme des timers et des sockets,
existent encore. Une promise simplement en attente ne suffit pas à garder Node
en vie. Vous n’enveloppez pas le programme dans asyncio.run. Dans un module
ES, vous pouvez utiliser await au niveau supérieur lorsque le démarrage doit
attendre une opération asynchrone.
5. JavaScript n’a qu’un seul type numérique ordinaire
Le type number de JavaScript stocke les valeurs sous forme de nombres à
virgule flottante sur 64 bits, à peu près comme le float de Python. La norme
technique de ce format s’appelle IEEE 754. Les valeurs décimales sont
approximatives, donc 0.1 + 0.2 n’est pas exactement 0.3, et les entiers ne
restent exacts que jusqu’à 2**53 - 1, soit 9,007,199,254,740,991.
Gardez les identifiants 64 bits sous forme de chaînes aux frontières du
service. Convertir un bigint Postgres en number JavaScript peut l’arrondir.
Pour des entiers exacts plus grands, JavaScript fournit le type distinct
BigInt, qui ne se mélange pas avec les nombres ordinaires.
6. Utilisez Map lorsque vous avez besoin d’un dictionnaire à la Python
En JavaScript, {} crée un objet. Les objets représentent généralement des
enregistrements à champs nommés :
const request = { model: "gpt-5", seqLen: 4096 };
console.log(request.model);
Un objet n’est pas une table clé-valeur propre comme un dict Python. Il hérite
de certains noms de JavaScript lui-même. Cela peut produire un résultat
surprenant :
const tools: Record<string, unknown> = {};

tools["constructor"]; // a built-in function, not a missing value
Object.hasOwn(tools, "constructor"); // false
Si une chaîne externe sélectionne un champ d’un objet, appelez Object.hasOwn
avant de le lire. Si vous avez besoin d’un dictionnaire généraliste, utilisez
Map. Map est plus proche du dict de Python : une clé n’existe que si votre
code l’ajoute.
const tools = new Map<string, unknown>();
tools.get("constructor"); // undefined
7. Incluez l’extension dans les imports relatifs
Un fichier source JavaScript qui partage du code avec d’autres fichiers est
appelé un module. Ce projet utilise le format de module moderne, les
modules ES, généralement abrégés en ESM. ES signifie ECMAScript, le nom
formel du langage JavaScript. En pratique, ESM désigne la syntaxe import et
export utilisée dans tout ce projet.
Pour un import relatif, Node exige le nom de fichier exact. Il ne devine pas si
./env désigne ./env.ts ou ./env.js :
import { loadEnv } from "./env.ts";Les imports de paquets installés ou de paquets du workspace utilisent toujours le nom du paquet, sans extension de fichier :
import { z } from "zod";
import { runAgent } from "@agent/core";
Zod : déclarer le schéma, dériver le type
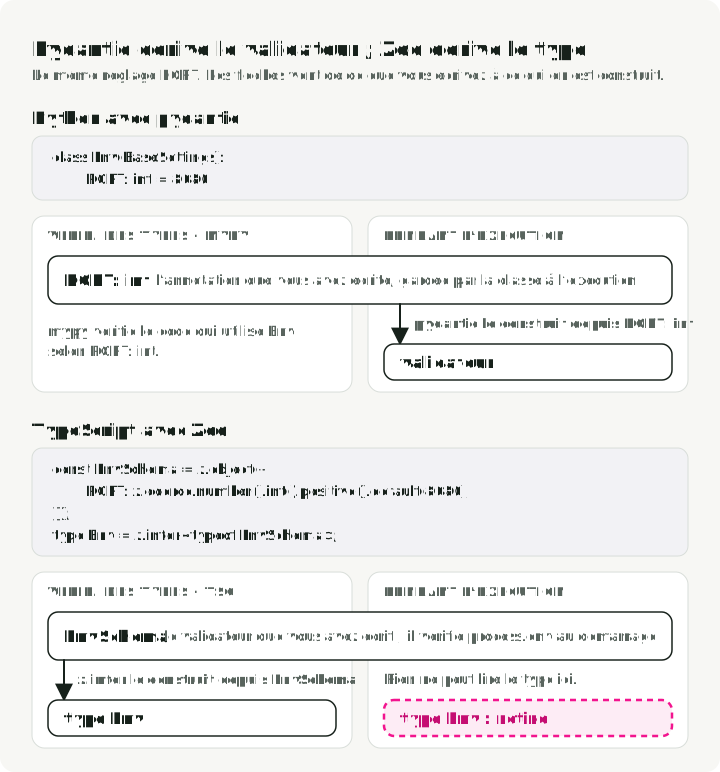
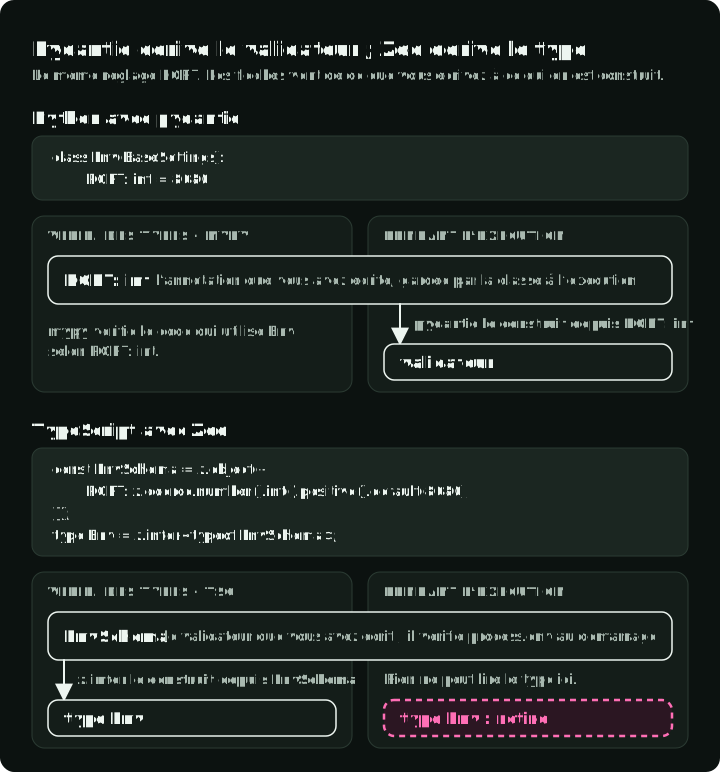
Avec pydantic, vous déclarez une classe et obtenez un validateur. Avec Zod, vous déclarez un validateur et en dérivez le type. Même source de vérité unique, sens opposé.
La figure montre le même réglage PORT dans les deux sens, et ce qui reste de
chaque déclaration pendant l’exécution du code.
Extrait de packages/schemas/src/env.ts :
import { z } from "zod"; // `z` is Zod's whole API, the way `pd` is pandas

const EnvSchema = z.object({
    PORT: z.coerce.number().int().positive().default(8080),
    // See the note below: a bare z.url() would accept "localhost:8000".
    OPENAI_BASE_URL: z
        .url({ protocol: /^https?$/ })
        .default("https://api.openai.com/v1"),
    DATABASE_URL: z.string().optional(),
});

export type Env = z.infer<typeof EnvSchema>;
z.infer<typeof EnvSchema> relit un type statique à partir du schéma
d’exécution. z.coerce.number() gère le fait que chaque valeur définie dans
process.env (l’équivalent Node de os.environ) est une chaîne. Il joue le
même rôle que la coercition numérique des réglages de pydantic, même si les
chaînes exactes acceptées par chacun diffèrent. Cela suit le motif de
pydantic-settings et s’exécute une seule fois au démarrage. Un environnement
invalide produit alors une erreur de démarrage lisible au lieu d’un TypeError
dans un handler.
Un simple z.url() accepte localhost:8000. Le standard URL traite tout ce qui
précède le premier deux-points comme le schéma. Il lit donc localhost: comme un
protocole nommé « localhost » et accepte la chaîne. La valeur atteint ensuite le
client HTTP et échoue avec moins de contexte. La validation de schéma déplace
les échecs plus tôt, mais elle appliquera un schéma permissif si c’est ce que
vous avez écrit.
Zod 4 fournit aussi z.toJSONSchema, donc ce projet n’a pas besoin de la
dépendance zod-to-json-schema courante dans les anciens tutoriels. Cela
compte dès qu’un même schéma doit alimenter trois consommateurs, ce dont traite
la section « Un outil, trois consommateurs » plus bas.
Le service
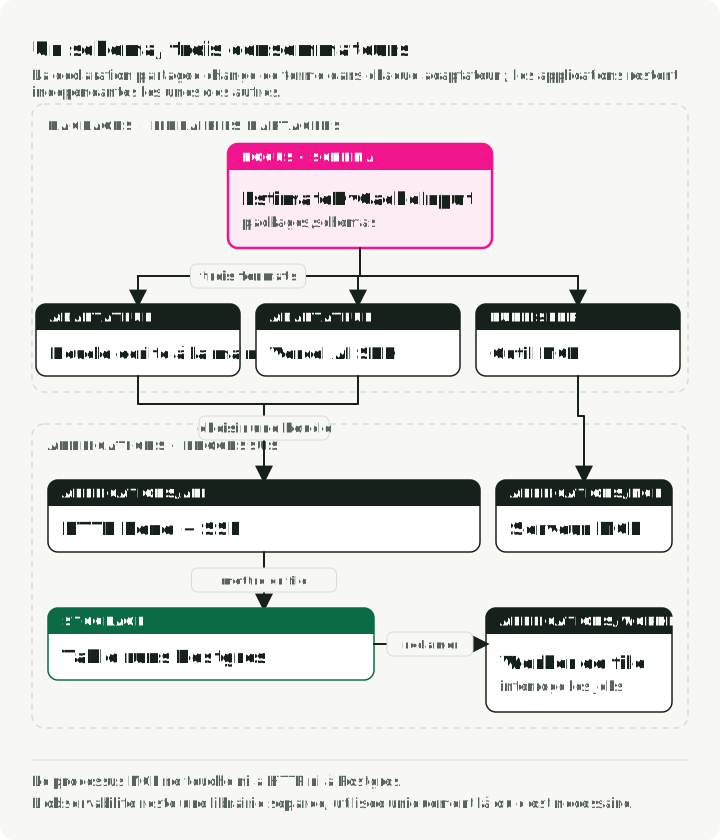
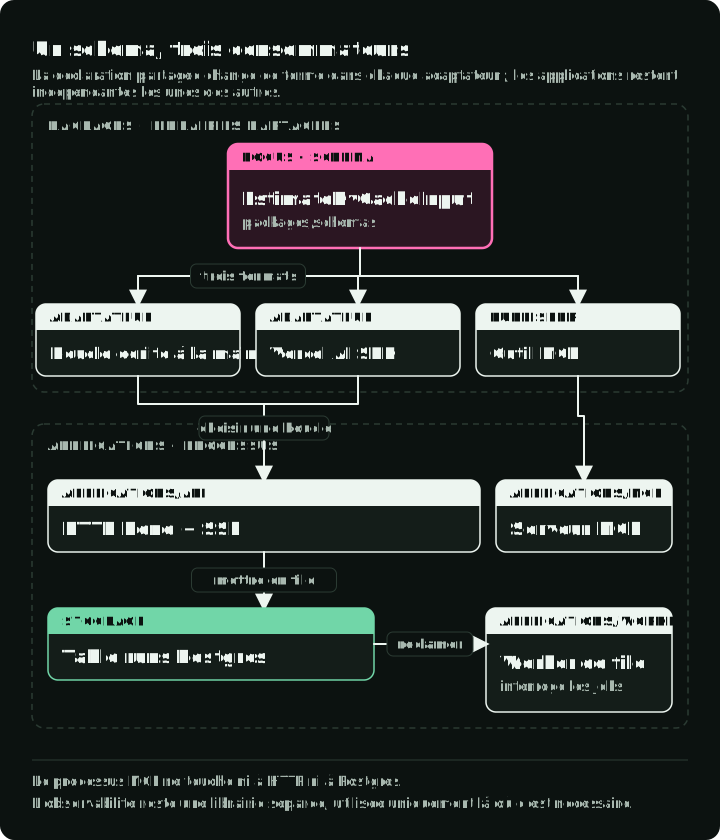
La rangée du haut est le code partagé dans packages/. En dessous, chaque
application de apps/ est un processus distinct. Seuls l’API et le worker
accèdent à Postgres, et le serveur MCP échange avec son client sur stdin et
stdout.
Le service de démonstration dimensionne des déploiements de LLM. Un outil retrouve les constantes d’architecture d’un modèle. L’autre estime son empreinte de KV cache : la mémoire GPU utilisée pour conserver les clés et les valeurs d’attention des requêtes en cours. Ces deux outils sont volontairement de l’arithmétique sans relief. Ils n’ont besoin d’aucun réseau et donnent toujours la même réponse. Le service est ainsi testable sans clé d’API. L’estimateur de KV cache est aussi publié via le Model Context Protocol (MCP), afin que d’autres clients AI puissent l’appeler.
typescript-agent-service/
├── apps/
│   ├── api/           @agent/api: Hono API, streams Server-Sent Events (below)
│   ├── worker/        polls Postgres for long-running jobs
│   └── mcp/           MCP server: exposes one tool to outside AI clients
├── packages/
│   ├── schemas/       package name @agent/schemas: env, API, and tool schemas
│   ├── agent-core/    package name @agent/core: the loop (twice), tools, storage
│   └── observability/ Pino logging, OpenTelemetry tracing
├── pnpm-workspace.yaml
└── package.json
pnpm-workspace.yaml est le fichier qui déclare le workspace. Les paquets
internes reçoivent un nom à portée comme @agent/core, où le préfixe @agent/
est une convention de nommage, non une fonctionnalité du langage. Chaque paquet
déclare son point d’entrée public dans package.json. Cette frontière de paquet
ne dépend pas de la commande qui démarre l’application.
Ce workspace privé fait pointer ces entrées vers des sources .ts, car chaque
consommateur fait partie du même dépôt. Les paquets npm publics publient
normalement du JavaScript accompagné de déclarations de types .d.ts, afin que
les consommateurs Node ordinaires n’aient pas besoin du lanceur TypeScript ni de
la configuration de build de l’auteur du paquet.
Écrire la boucle d’outils à la main, une seule fois
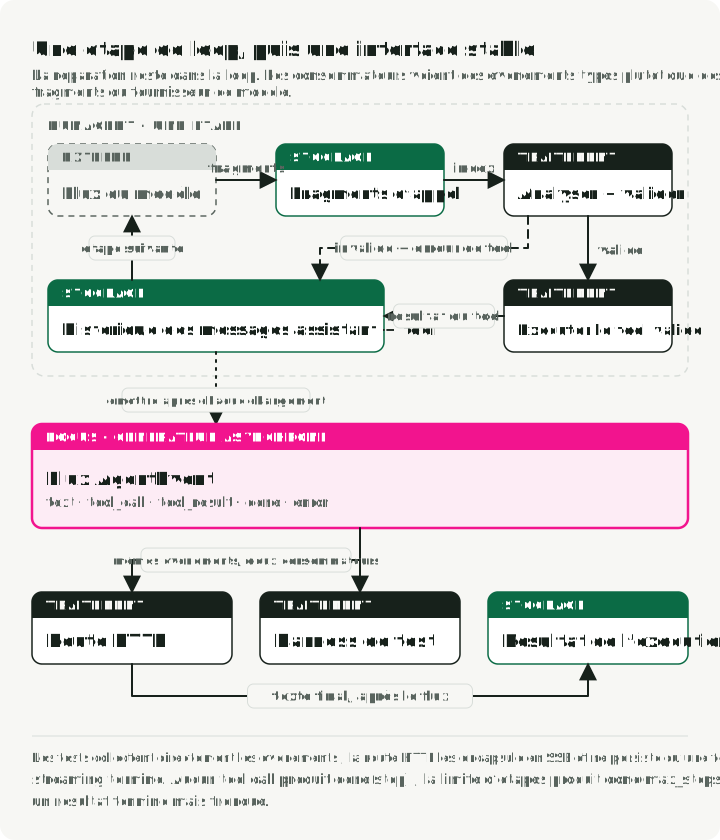
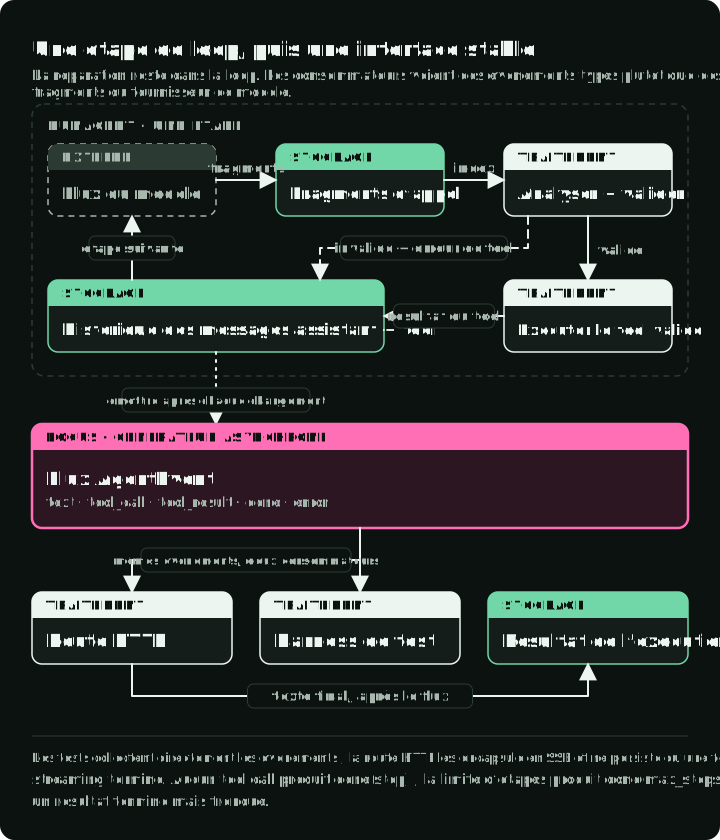
La colonne de gauche est une étape du modèle. La colonne de droite montre ce que la boucle émet : hormis une exception qui quitte la boucle, ces événements sont tout ce que voient la route HTTP et les tests.
Les frameworks d’agents à tool calling enveloppent la même boucle de base :
- Appeler le modèle avec les définitions d’outils.
- Valider et exécuter les outils demandés.
- Ajouter les résultats aux messages.
- Rappeler le modèle.
Écrire la boucle une fois rend visibles ses chemins d’échec cachés.
La boucle est une async function*, un générateur asynchrone, exactement la
forme d’un async def Python avec yield. La route HTTP itère sur ce
générateur, transforme chaque événement en frame Server-Sent Events et
accumule le texte. Une fois le flux terminé, la route appelle une seule fois
storage.createRun avec le texte final. Les tests invoquent la boucle
séparément et collectent ses événements dans un tableau. Une frame SSE est un
fragment d’une réponse HTTP de longue durée. La section suivante explique le
format.
La boucle a deux sorties normales. Une réponse sans tool call émet done avec
stopReason: "stop". Si le modèle continue de demander des outils jusqu’à
maxSteps, le générateur se termine tout de même et émet done avec
stopReason: "max_steps". Considérez ce résultat comme terminé mais tronqué : le
texte accumulé peut être partiel.
Chaque valeur émise par la boucle est un AgentEvent, une union étiquetée.
Extrait abrégé de
packages/schemas/src/events.ts :
export const AgentEventSchema = z.discriminatedUnion("type", [
    z.object({ type: z.literal("text"), delta: z.string() }),
    z.object({
        type: z.literal("tool_call"),
        callId: z.string(),
        toolName: z.string(),
        args: z.unknown(),
    }),
    z.object({
        type: z.literal("tool_result"),
        callId: z.string(),
        ok: z.boolean(),
        result: z.unknown() /* ... */,
    }),
    z.object({
        type: z.literal("done"),
        stopReason: z.enum(["stop", "max_steps"]),
        steps: z.number(),
        text: z.string(),
    }),
    z.object({ type: z.literal("error"), message: z.string() }),
]);

export type AgentEvent = z.infer<typeof AgentEventSchema>;
z.discriminatedUnion choisit la variante selon le champ type, comme un match sur des dataclasses étiquetées. Dans if (event.type === "text"), le compilateur sait que event.delta existe. Ajouter une variante ne fait pas automatiquement échouer un switch incomplet. Pour obtenir une erreur de compilation lorsqu’une variante manque, vérifiez la valeur restante contre never dans une branche default. Une règle de lint vérifiant l’exhaustivité peut aussi signaler les cas manquants. La route HTTP et la version avec l’AI SDK ci-dessous utilisent toutes deux ces types d’événement affinés.
Le corps de la boucle émet les événements de texte et assemble les tool calls à
partir des fragments. Extrait de
packages/agent-core/src/loop.ts :
let text = ""; // the assistant text produced during this model step
// Keyed by the `index` field, because a streamed response interleaves
// fragments of several parallel tool calls and only `index` is present
// on every fragment. `id` and `name` arrive once, `arguments` arrives
// in pieces. `a?.b` below reads `b` only if `a` exists, and gives back
// `undefined` instead of throwing if it doesn't.
const partial = new Map<number, PartialToolCall>();

for await (const chunk of stream) {
    const choice = chunk.choices[0];
    if (!choice) continue;

    if (choice.delta.content) {
        text += choice.delta.content;
        yield { type: "text", delta: choice.delta.content };
    }

    for (const fragment of choice.delta.tool_calls ?? []) {
        const slot = partial.get(fragment.index) ?? { id: "", name: "", args: "" };
        if (fragment.id) slot.id = fragment.id;
        if (fragment.function?.name) slot.name = fragment.function.name;
        if (fragment.function?.arguments) slot.args += fragment.function.arguments;
        partial.set(fragment.index, slot);
    }
}
La variable locale text de la boucle contient une étape du modèle. La boucle
l’utilise dans le message de l’assistant pour l’étape suivante ou dans
l’événement done final. Ce n’est pas l’accumulateur au niveau de la route qui
est persisté ensuite.
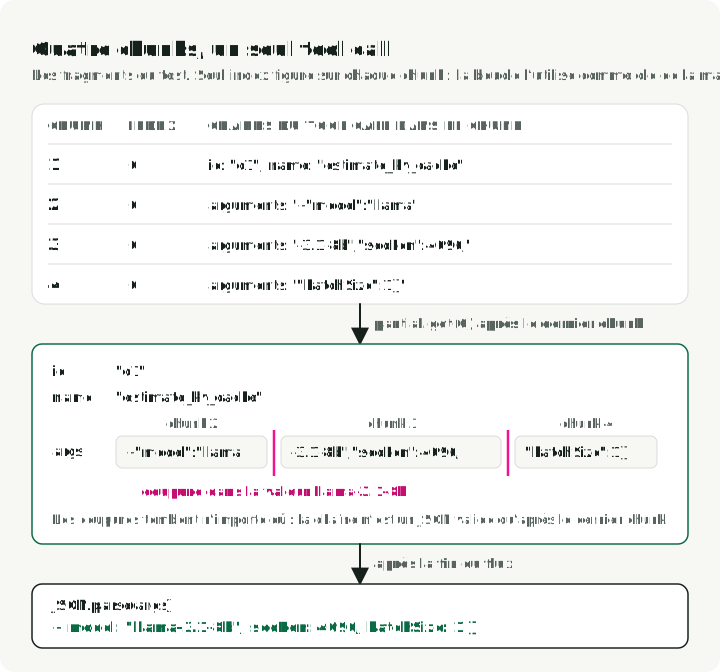
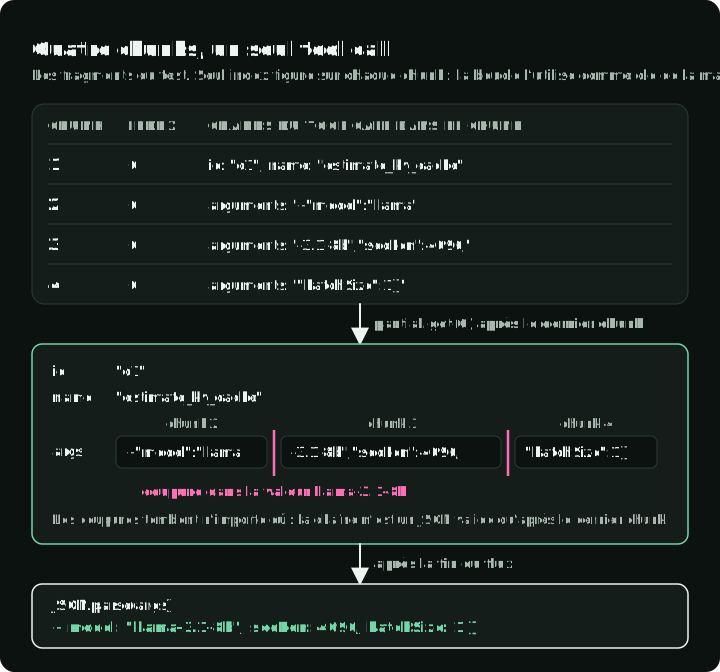
La map partial est la partie que les frameworks cachent. Le SDK expose des
fragments de chaîne des arguments de la fonction, et ils peuvent couper le JSON
sérialisé à des positions arbitraires. Plusieurs appels parallèles peuvent
aussi s’entrelacer. Le dépôt contient un test qui répartit
{"model":"llama-3.1-8b",...} sur quatre chunks.
La figure suit ces quatre chunks jusqu’à l’entrée de la map pour l’index 0.
La deuxième chose qui vaut la peine d’être écrite soi-même est ce qui se passe lorsque la validation échoue :
// `tool.parse` is this repo's wrapper, not Zod's. Zod's own `.parse` throws and
// `.safeParse` returns `{ success, data, error }`; this returns
// `{ ok: true, value }` on success and `{ ok: false, error }` on failure, so no
// caller has to catch.
const parsed = tool.parse(raw);
if (!parsed.ok) {
    return {
        ok: false,
        value: { error: `Invalid arguments: ${parsed.error}` },
        parsedArgs: raw,
    };
}
Avant l’exécution, la recherche peut ne pas trouver l’outil, JSON.parse peut
rejeter les arguments, ou Zod peut rejeter leur forme. Chaque échec devient un
message que lit le modèle. Pendant l’exécution, un ToolError attendu devient
lui aussi un tool result, afin que le modèle puisse corriger son appel. Une
exception inattendue remonte jusqu’au chemin d’erreur HTTP au lieu d’être
présentée comme un échec du domaine. z.prettifyError transforme l’arbre
d’erreurs de Zod en un message exploitable par le modèle, plutôt qu’en trace
d’appels.
strict: true sur une définition de fonction
OpenAI
demande au fournisseur de contraindre le décodage au schéma. Cela n’a aucun
rapport avec l’option strict de tsconfig dans TypeScript. C’est comparable au
guided decoding de vLLM, même si les schémas pris en charge et les détails
d’application diffèrent. Cela supprime un mode d’échec, mais un endpoint
auto-hébergé peut ignorer l’option. Les arguments doivent en outre passer par
JSON.parse.
La boucle appelle /chat/completions parce que le dépôt compagnon cible des
serveurs compatibles OpenAI. vLLM,
SGLang et
Ollama documentent cet
endpoint, donc OPENAI_BASE_URL peut pointer le même client vers n’importe
lequel d’entre eux. Leur couverture de la Responses API diffère et change selon
les versions. Si vous maîtrisez les deux côtés, consultez la page de
compatibilité actuelle du serveur avant de choisir entre les deux API.
Passez ensuite à l’AI SDK, en sachant ce que vous échangez
Le dépôt compagnon implémente aussi le même agent avec le Vercel AI SDK, pour comparer les deux versions. Elles produisent toutes deux des valeurs AgentEvent, mais leur comportement lors d’une erreur terminale diffère actuellement. L’adaptateur SDK optionnel produit un événement error avec String(part.error) et se termine sans done. La route HTTP actuelle transmet ce détail et enregistre l’exécution comme succeeded, car le générateur s’est terminé sans lever d’exception. Avant de remplacer la boucle directe par défaut par cet adaptateur, traitez error ou un flux qui se ferme sans done comme une exécution en échec, assainissez les messages d’erreur destinés au client et testez le statut enregistré avec l’événement terminal.
Le dépôt compagnon utilise l’AI SDK 7. Son implémentation avec le framework se
trouve dans
packages/agent-core/src/loop-ai-sdk.ts :
const result = streamText({
    model: provider.chatModel(options.model),
    prompt: options.message,
    tools: aiSdkTools,          // Zod schemas passed straight through
    stopWhen: stepCountIs(options.maxSteps ?? 6),
});

for await (const part of result.fullStream) {
    switch (part.type) {
        case "text-delta": yield { type: "text", delta: part.text }; break;
        case "tool-call":  yield { type: "tool_call", callId: part.toolCallId, /* ... */ }; break;
        // ...
    }
}
Le SDK supprime cinq éléments de code applicatif :
- l’accumulateur de fragments
JSON.parseet son chemin d’erreur- l’appel qui exécute Zod sur les arguments analysés
- l’assemblage des messages propre à chaque fournisseur
- le compteur d’étapes
stopWhen accepte plusieurs conditions, dont une limite d’étapes ou un tool call
précis. La boucle for await ne change pas lorsque la politique d’arrêt change.
Ce que vous perdez, c’est le contrôle direct de l’échec de validation. La boucle
écrite à la main décide de ce que le modèle voit après un appel rejeté. Le dépôt
compagnon ne définit pas l’option
repairToolCall
du SDK ; il utilise donc le comportement par défaut : si plus d’une étape est
autorisée, l’AI SDK 7 renvoie l’appel en échec au modèle à l’étape suivante.
Passez un callback repairToolCall pour corriger l’appel vous-même, par exemple
avec un second appel au modèle.
L’échange joue aussi dans l’autre sens. Dans la version SDK, un changement de fournisseur reste localisé dans l’adaptateur du fournisseur. Il exige toujours le paquet du fournisseur correspondant, les identifiants, la configuration et des tests d’intégration. Dans la boucle brute, la gestion des requêtes et des flux propre à chaque fournisseur est du code que vous devez modifier.
Pour un nouveau service, commencez par le SDK, sauf si vous devez contrôler ces chemins d’échec. La version écrite à la main vous donne une petite implémentation à inspecter et à comparer avec ce choix.
Streaming HTTP : Hono et SSE
Les routes Hono se lisent comme des routes FastAPI. Le seul ajout est
zValidator, qui fait ce que FastAPI obtient gratuitement grâce aux annotations
de type de la signature d’un handler. Le c du handler ci-dessous est le
contexte de requête de Hono, l’objet que FastAPI répartit entre vos paramètres.
deps est un ensemble de dépendances avec lequel l’application est construite au
lieu de les importer directement. runAgent en fait partie, et la section sur
les tests montre ce que cela apporte.
Extrait abrégé de apps/api/src/app.ts :
app.post("/v1/chat", zValidator("json", ChatRequestSchema), (c) => {
    const body = c.req.valid("json");
    const log = deps.logger.child({ route: "chat" });

    return streamSSE(c, async (stream) => {
        let text = "";
        let done: Extract<AgentEvent, { type: "done" }> | undefined;
        try {
            // The full route wraps this loop in a `withSpan` tracing span.
            for await (const event of deps.runAgent({
                message: body.message,
                maxSteps: body.maxSteps,
            })) {
                if (event.type === "text") text += event.delta;
                if (event.type === "done") done = event;

                await stream.writeSSE({
                    event: event.type,
                    data: JSON.stringify(event),
                });
            }
        } catch (error) {
            log.error({ err: error }, "agent run failed");
            await stream.writeSSE({
                event: "error",
                data: JSON.stringify({
                    type: "error",
                    message: "Agent run failed",
                }),
            });
            return;
        }

        await deps.storage.createRun({
            kind: "chat",
            status:
                done?.stopReason === "max_steps" ? "truncated" : "succeeded",
            input: { message: body.message },
            output: { text },
        });
    });
});
La route conserve l’événement done final. Une boucle qui s’arrête à
max_steps se termine normalement ; la route la stocke donc comme truncated,
et non succeeded.
zValidator valide le corps et donne à c.req.valid("json") le type que produit
le schéma. Sans lui, le corps est typé any, l’échappatoire de TypeScript, où
chaque accès à une propriété compile et où rien n’est vérifié. Cela annule
l’intérêt du schéma pour la sûreté des types.
Cette route utilise Server-Sent Events plutôt que des WebSockets. Le serveur
garde une réponse HTTP ouverte pendant qu’il écrit des frames event: <name> et
data: <json>, puis la ferme après l’événement final. Le trafic va du serveur
vers le client, ce qui correspond à ce flux d’agent. Un WebSocket ajouterait une
messagerie bidirectionnelle et une montée de protocole dont cette route n’a pas
besoin.
Avec la boucle directe par défaut, une exception en cours de flux modifie le signalement des erreurs HTTP. Une fois la première trame envoyée avec le statut 200, le serveur ne peut plus remplacer cette réponse par un 500. Le bloc catch journalise l’erreur interceptée, envoie au client un événement d’erreur constant et se termine. Ce retour saute storage.createRun : une erreur levée par le générateur ne laisse donc aucune ligne. Ce catch ne s’exécute pas lorsque l’adaptateur SDK optionnel produit un événement error et se termine. Pour conserver les exécutions en échec à des fins de débogage ou d’évaluation, écrivez une ligne failed dans le bloc catch avec le texte partiel.
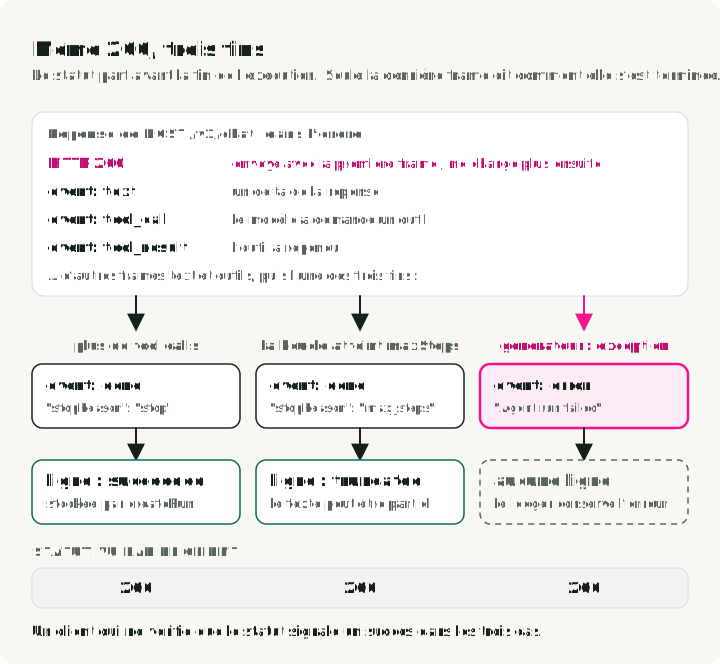
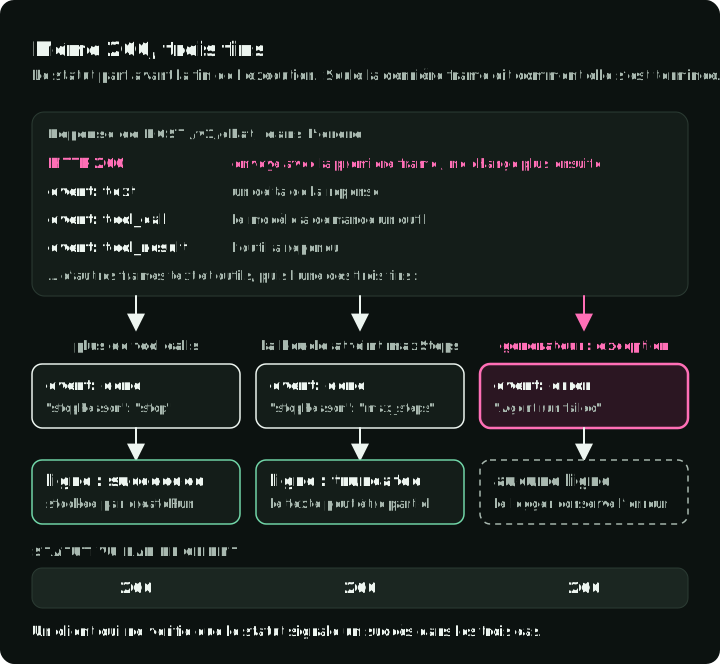
La figure suit une requête jusqu’à ses trois fins. Le code de statut est le même dans les trois cas : seule la dernière frame les distingue.
Un test couvre ce chemin. Un générateur émet un delta de texte, puis lève une
exception. La réponse reste 200, et sa dernière frame est un événement error
avec le message constant Agent run failed. Le logger conserve l’erreur
capturée pour le diagnostic côté serveur. Tout client qui ne vérifie que le code
de statut signale un succès sur une exécution en échec.
app.ts prend deux décisions plus modestes qui méritent une explication. Il
traite /healthz comme un endpoint de liveness, donc cette route ne touche
volontairement pas à Postgres. Un échec de liveness pendant une panne de base de
données pourrait redémarrer toutes les instances sans réparer la dépendance.
Ajoutez un contrôle de readiness distinct lorsque l’orchestrateur doit cesser
d’acheminer du trafic vers une instance qui ne peut pas joindre Postgres. Les
chemins d’erreur journalisent l’erreur capturée mais renvoient une chaîne
constante. Renvoyer error.message dans le corps d’une réponse est la façon
dont des chaînes de connexion finissent dans le navigateur de quelqu’un d’autre.
La partie façon Celery, sans Celery
Les longs jobs n’ont pas leur place dans un handler de requête.
POST /v1/sweeps valide un modèle, une longueur de séquence et une liste de
tailles de batch, insère une ligne queued et renvoie 202 avec l’identifiant de
l’exécution. Le worker récupère la ligne, calcule la taille du KV cache pour
chaque taille de batch et stocke le résultat. GET /v1/runs/:id le lit.
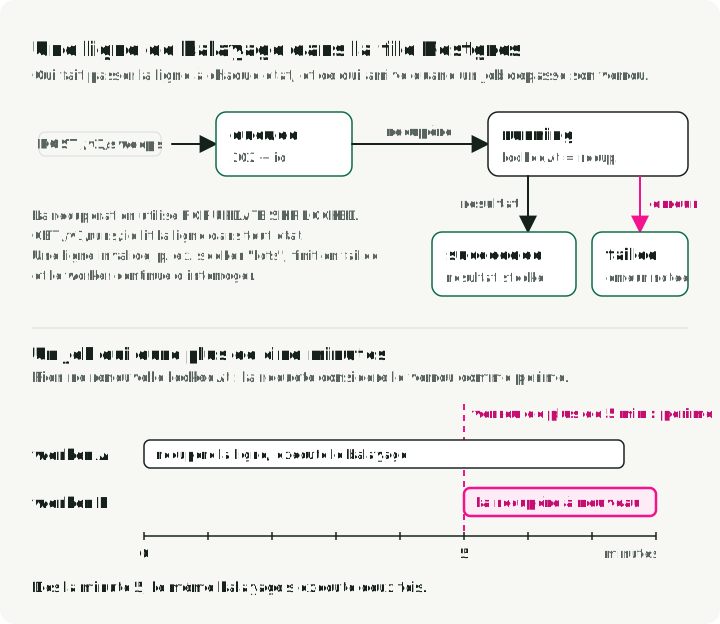
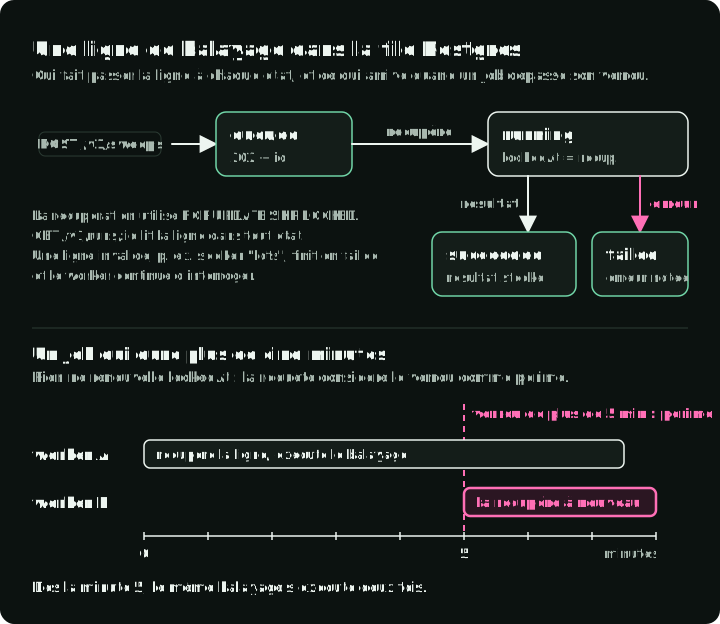
La moitié haute montre les états par lesquels passe une ligne de balayage. La frise montre la reprise d’un verrou périmé, expliquée plus bas : après cinq minutes, un second worker récupère un job qui est encore en cours.
Il n’y a ici ni Redis ni BullMQ. PostgreSQL documente SKIP LOCKED pour les
consommateurs multiples d’une table de type file d’attente.
Cette clause offre à ce petit service une file at-least-once dans une seule
table. Elle est transactionnelle avec le reste de vos écritures, et c’est un
service de moins dans docker-compose.yml.
La requête de récupération dans
packages/agent-core/src/db/storage.ts
est la suivante :
const [candidate] = await tx
    .select({ id: runs.id })
    .from(runs)
    // The real query also picks up rows whose lock went stale; trimmed here.
    .where(and(eq(runs.kind, kind), eq(runs.status, "queued")))
    .orderBy(runs.createdAt)
    .limit(1)
    // `.for()` adds a locking clause; `{ skipLocked: true }` adds SKIP LOCKED.
    .for("update", { skipLocked: true });
La ligne est verrouillée pour la durée de la transaction, et tout worker
concurrent qui exécute la même requête la saute au lieu de se bloquer. Deux
récupérations simultanées ne reçoivent donc pas la même ligne non périmée. Un
test d’intégration lance deux récupérations en même temps avec Promise.all et
vérifie qu’elles renvoient des lignes différentes. La version naïve,
SELECT ... LIMIT 1 suivi d’un UPDATE, échoue à ce test : les deux
transactions lisent la même ligne avant que l’une n’écrive, et les deux
démarrent donc le même job.
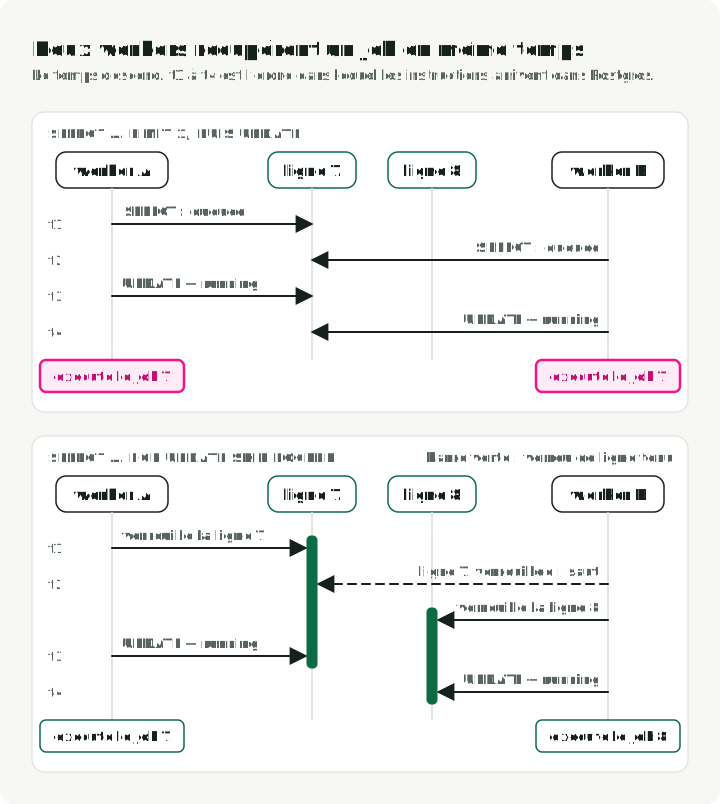
Le panneau du haut est la situation de concurrence (race condition) que détecte le test ; celui du bas est la requête de récupération ci-dessus.
Il s’agit d’une exécution at-least-once : un job peut s’exécuter plus d’une
fois. La requête complète récupère aussi une ligne running lorsque son verrou
date de plus de cinq minutes, et rien ne renouvelle ce bail. Un job en cours qui
dure plus de cinq minutes peut donc être récupéré deux fois. Rendez les jobs
idempotents. Pour un travail long, ajoutez un heartbeat de bail ou fixez le
seuil de verrou périmé au-dessus de la durée d’exécution maximale.
Ajoutez BullMQ lorsque vous avez besoin de jobs différés, de planifications répétées, de priorités, de limites de débit ou d’un tableau de bord. En Python, le passage équivalent va d’une table de base de données à Celery. Avant cela, Redis est un service de plus à exploiter et à surveiller.
Le worker revalide ce qu’il lit dans jsonb :
// The row was validated on the way in, but it has been through a database.
// A stored row can outlive the schema version that accepted it.
// The job is a batch-size sweep. Zod's own `.parse` throws; the poll loop
// catches that and marks the run failed.
const input = SweepRequestSchema.parse(run.input);
La suite de tests fournit aussi au worker une ligne de balayage dont seqLen
est la chaîne "lots". Le worker fait échouer l’exécution et continue
d’interroger la base, au lieu de planter et de retenter indéfiniment la même
ligne invalide.
Le travail CPU révèle une autre contrainte de Node. Un callback synchrone
s’exécute sur le thread de la boucle d’événements et n’est pas préempté. Une
boucle for qui fait de l’arithmétique pendant deux secondes bloque pendant
deux secondes chaque requête, chaque timer et chaque contrôle de liveness de ce
processus. Une boucle serrée dans un async def bloque asyncio de la même
façon. Les deux runtimes exigent de déporter explicitement le travail CPU.
await setTimeout(0) depuis node:timers/promises (le préfixe node:
désigne la bibliothèque standard, donc node:timers est à Node ce que os est
à Python) équivaut à await asyncio.sleep(0). Le balayage rend la main après
chaque taille de batch, afin que le processus du worker puisse traiter les
timers et les autres callbacks. Rendre la main ne rend pas le travail CPU
parallèle. Les
worker_threads de Node peuvent
exécuter du JavaScript en parallèle. Pour du travail CPU Python pur sous le
CPython habituel avec GIL activé, utilisez un pool de processus plutôt qu’un
pool de threads. Ce service n’utilise ni l’un ni l’autre. Gardez les calculs
numériques lourds en Python, là où vivent déjà les bibliothèques qui les
soutiennent, et sortez-les de la boucle d’événements de l’API.
Un outil, trois consommateurs
EstimateKvCacheInput a trois consommateurs :
- La boucle écrite à la main le convertit avec
z.toJSONSchema. - L’AI SDK le reçoit tel quel.
- Le serveur MCP publie sa forme.
Cette réutilisation explique l’existence de packages/schemas.
Extrait de apps/mcp/src/index.ts :
server.registerTool(
    "estimate_kv_cache",
    {
        description: "Estimate KV-cache VRAM in GiB for a served model...",
        // A Zod object schema keeps the map of fields you passed in on
        // `.shape`. This SDK wants that map, not the schema wrapped around it.
        inputSchema: EstimateKvCacheInput.shape,
    },
    async ({ model, seqLen, batchSize }) => {
        /* ... */
    },
);

await server.connect(new StdioServerTransport());
Deux détails comptent avant de connecter un client. Premièrement, un serveur
démarré de cette façon utilise ses propres stdin et stdout pour communiquer avec
le client. Chaque ligne est
un message JSON-RPC.
Un console.log égaré, l’équivalent JavaScript de print, corrompt alors un
message. Le client se déconnecte avec une erreur d’analyse qui ne nomme aucun
fichier. Envoyez plutôt tous les diagnostics vers stderr.
Deuxièmement, un échec du domaine doit renvoyer isError: true avec un message.
Le modèle appelant peut alors corriger son appel, comme il le peut après des
arguments d’outil invalides dans l’agent loop.
Vous pouvez piloter le serveur avec printf et un tube, ce qui vaut la peine
d’être fait une fois avant de pointer un vrai client dessus :
printf '%s\n' \
  '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-06-18","capabilities":{},"clientInfo":{"name":"probe","version":"1"}}}' \
  '{"jsonrpc":"2.0","method":"notifications/initialized"}' \
  '{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"estimate_kv_cache","arguments":{"model":"llama-3.1-70b","seqLen":8192,"batchSize":4}}}' \
  | pnpm -s mcp   # -s suppresses pnpm's own output so only JSON-RPC comes back
Cette sonde utilise la même version de protocole que le README du dépôt compagnon. Pour un vrai client, utilisez le SDK plutôt que de maintenir des messages JSON-RPC à la main.
Tester un agent sans clé d’API
Vitest joue le rôle de pytest, mais la structure est différente. describe
regroupe des tests liés. it et test définissent chacun un cas de test.
test.each est proche de parametrize, beforeEach fournit la préparation de
chaque test, vi.fn() crée une fonction mock et describe.skipIf saute un
groupe sous condition.
Les tests d’agent reposent sur une décision : runAgent reçoit un client OpenAI
en paramètre au lieu d’en construire un. Le faux client est un objet doté d’une
méthode chat.completions.create qui renvoie un itérable asynchrone scripté :
function fakeClient(scripts: Chunk[][]): OpenAI {
    let call = 0;
    return {
        chat: {
            completions: {
                create: async () => {
                    const script = scripts[call++] ?? [];
                    // Defines an async generator and calls it on the same
                    // line, so `create` hands back something you can
                    // `for await` over, which is the shape a real streaming
                    // response has.
                    return (async function* () {
                        for (const chunk of script) yield chunk;
                    })();
                },
            },
        },
        // TypeScript refuses a direct cast between unrelated shapes, so you
        // cast through `unknown` first. This disables type checking for that
        // value, so keep it to test code.
    } as unknown as OpenAI;
}
Les tests répartissent une chaîne d’arguments JSON sur plusieurs chunks et
gèrent deux tool calls dans une même réponse. Ils couvrent aussi un
batchSize invalide, du JSON malformé, des noms d’outils inconnus et un modèle
qui continue d’appeler des outils jusqu’à ce que maxSteps l’arrête. Le
fichier de tests s’exécute en bien moins d’une seconde, sans réseau et sans
clé.
Les tests d’intégration contre Postgres utilisent
describe.skipIf(!process.env.DATABASE_URL), si bien que pnpm test
fonctionne sur un clone neuf sans Postgres, et que la CI les active en fournissant
la variable. Le dépôt compte 42 tests. Trente-huit s’exécutent sans Postgres ni
clé d’API.
Journaliser des événements structurés avec Pino
Pino joue le même rôle que structlog : un objet JSON par ligne, des loggers
enfants avec des champs liés et un masquage explicite des données sensibles. Le dépôt
compagnon le configure dans
packages/observability/src/logger.ts :
const log = pino({
    redact: {
        paths: [
            "req.headers.authorization",
            "apiKey",
            "OPENAI_API_KEY",
            "*.apiKey",
        ],
        censor: "[redacted]",
    },
});
Sans ce masquage, log.info({ req }, "...") peut copier un en-tête Authorization
dans le backend de logs.
Tracer le travail applicatif avec des spans manuels
Le dépôt compagnon utilise OpenTelemetry pour trois spans au niveau applicatif :
agent.run, agent.tool et worker.sweep. Il n’installe aucune
instrumentation automatique de HTTP ni de Postgres. startTracing() dans
packages/observability/src/tracing.ts
crée un NodeSDK avec un exportateur de traces OTLP. Si
OTEL_EXPORTER_OTLP_ENDPOINT est absent, le traçage reste désactivé.
Le travail lui-même est enveloppé par withSpan(), du même fichier :
return tracer.startActiveSpan(name, { attributes }, async (span) => {
    try {
        return await fn(span);
    } finally {
        span.end();
    }
});
JavaScript n’a pas de syntaxe de gestionnaire de contexte à la Python. Ici, le callback est le bloc qu’entourerait un gestionnaire de contexte Python. Le helper complet enregistre aussi les exceptions et définit le statut du span avant de relancer l’erreur.
Les spans automatiques HTTP et base de données sont une fonctionnalité à part. Ils exigent les paquets d’instrumentation correspondants et une initialisation avant le chargement des modules instrumentés. N’ajoutez cela que lorsque ces spans sont utiles, puis suivez la configuration du SDK Node d’OpenTelemetry pour connaître les versions exactes des paquets que vous déployez.
Livrer le monorepo dans Docker
Utilisez le
Dockerfile
fourni. Le conteneur démarre l’API avec le loader tsx. Vous n’avez pas à
choisir ni à invoquer un lanceur TypeScript lorsque vous le déployez.
Le build utilise pnpm fetch pour que les téléchargements de dépendances
restent en cache jusqu’à un changement du lockfile. Il utilise ensuite
pnpm deploy pour copier l’API et ses dépendances de production dans un
répertoire autonome. L’étape runtime s’exécute avec l’utilisateur node, sans
privilèges root, et son CMD en forme exec permet à l’API de recevoir
directement SIGTERM pour un arrêt propre.
Pourquoi le Dockerfile charge tsx
Node 24 peut exécuter un sous-ensemble limité de TypeScript en supprimant les
annotations de type. Il ne vérifie pas les types du code et n’effectue pas les
transformations que prend en charge un lanceur TypeScript complet. Les scripts
du dépôt cachent ce détail. pnpm check effectue la vérification statique
séparée.
Le conteneur révèle une autre limite. pnpm deploy copie les paquets du
workspace sous node_modules, et Node refuse délibérément d’y supprimer le
TypeScript (documentation TypeScript de
Node). Sans loader, le conteneur
échoue au démarrage avec ERR_UNSUPPORTED_NODE_MODULES_TYPE_STRIPPING.
Le Dockerfile charge tsx, qui traite ces fichiers .ts avant que Node ne les
exécute. Une équipe qui ne veut que des fichiers .js dans son image runtime
peut ajouter une étape de compilation à la place. C’est une autre conception
possible pour la production, pas une étape supplémentaire nécessaire pour
exécuter ce dépôt compagnon.
Un parcours sur trois semaines
Les ingénieurs Python expérimentés peuvent sauter le contenu qui enseigne les variables et les boucles. Cette séquence se concentre sur ce qui diffère de Python. Faites l’exercice de construction de chaque ligne ; la lecture lui sert de support.
| Semaine | Lire | Construire |
|---|---|---|
| 1 | javascript.info : uniquement les modules, les promises et les objets. Gardez le guide JS de MDN comme référence. | Réécrivez un CLI Python en TypeScript. Ajoutez un script package.json. Exécutez le script et pnpm typecheck. |
| 1-2 | Lisez la référence tsconfig de TypeScript, les tutoriels gratuits de Total TypeScript et la documentation de Zod. | Construisez un module de configuration validé par Zod et une union étiquetée. Après vérification de l’étiquette, le compilateur sait quelle variante contient le bloc. |
| 2 | Lisez la documentation de Hono, Drizzle, Vitest et Biome. | Construisez un proxy de streaming vers un endpoint compatible OpenAI, avec un journal adossé à Drizzle. |
| 3 | Lisez la documentation de l’AI SDK et du SDK TypeScript de MCP. | Construisez un agent à tool calling. Puis construisez un serveur MCP qui expose l’un de ses outils. |
Commencez par les tutoriels gratuits de Total TypeScript. Ne payez pour le contenu avancé que si vous travaillez avec des génériques et des types conditionnels de niveau bibliothèque. Sautez tous les cours d’« introduction à JavaScript », et sautez tout ce qui est orienté React, sauf si le produit l’exige.
Pour un tour d’horizon des conventions de production, goldbergyoni/nodebestpractices est une large liste de contrôle maintenue par la communauté. Vérifiez les conseils qui touchent au comportement à l’exécution ou à la sécurité dans la documentation actuelle de Node.
Avant d’adapter le service
Les tests hors ligne exercent le flux de contrôle du service avec des réponses de modèle scriptées. Ils n’établissent pas avec quelle fiabilité un modèle réel mènera vos tâches à terme. Gardez cette distinction en tête lorsque vous remplacez les outils de démonstration par de vrais outils.
Validez chaque valeur qui entre de l’extérieur : l’environnement, le corps HTTP,
les arguments d’outil produits par le modèle et les lignes lues dans jsonb.
| Valeur | Vérifiée par | En cas d’échec |
|---|---|---|
process.env | EnvSchema, dans loadEnv() au démarrage | erreur de démarrage ; le processus s’arrête |
| Corps HTTP | ChatRequestSchema, via zValidator | 400 ; le gestionnaire ne s’exécute jamais |
| Arguments d’outil | tool.parse, après JSON.parse | erreur d’outil renvoyée au modèle |
runs.input | SweepRequestSchema, dans le worker à chaque récupération | exécution marquée failed ; le worker continue d’interroger |
Définissez ensuite la politique d’achèvement : décidez si votre application
accepte, retente ou fait relire les exécutions truncated, et testez ensemble
l’événement et le statut stocké. Si des jobs peuvent durer plus longtemps que le
seuil de verrou périmé, ajoutez un heartbeat de bail avant d’ajouter des effets
de bord.
Une fois ces comportements explicites, ajoutez la ligne failed décrite dans la
section sur le streaming, puis utilisez les exécutions en échec et tronquées
pour construire une
suite d’évaluation d’agent
distincte. C’est là qu’il faut tester l’achèvement des tâches ; la suite hors
ligne reste le contrôle le plus rapide pour détecter une panne du streaming, de
la validation et de la persistance.
Références
Dépôt de démonstration
- slavadubrov/typescript-agent-service - le monorepo utilisé tout au long de cet article : API Hono avec SSE, deux implémentations de l’agent loop, stockage Drizzle, worker, serveur MCP et 42 tests
Runtime et langage
- Exécuter TypeScript directement dans Node.js - la prise en charge limitée de TypeScript par Node et sa restriction sur
node_modules - Options du compilateur TypeScript -
strictet les autres vérifications configurées par le dépôt compagnon - Guide JavaScript de MDN - la référence du langage à garder ouverte
- javascript.info - tutoriel JavaScript moderne. Lisez les chapitres sur les modules et les promises.
Outillage
- pnpm et installation de pnpm - gestionnaire de paquets, workspaces et mise en place
- Biome - lint, formatage et tri des imports dans un seul binaire
- Vitest - lanceur de tests sans configuration de transformation
- Total TypeScript - tutoriels gratuits et parcours payant pour les types avancés
Bibliothèques
- Zod - validation de schémas et inférence de types. La version 4 inclut
z.toJSONSchema. - Hono - framework HTTP fondé sur les standards du Web
- Drizzle ORM - ORM TypeScript orienté SQL avec migrations
drizzle-kit - Documentation SELECT de PostgreSQL - la clause de verrouillage
FOR UPDATE ... SKIP LOCKED - BullMQ - file adossée à Redis pour le cas où la table de base de données ne suffit plus
AI et agents
- Vercel AI SDK -
streamText,tool,stopWhenet adaptateurs de fournisseurs - openai/openai-node - le client TypeScript officiel
- MCP TypeScript SDK et la spécification MCP - construire des serveurs et des clients
Conventions
- goldbergyoni/nodebestpractices - liste de contrôle maintenue par la communauté pour les conventions de production