Évaluer les AI agents en production : des traces aux suites de tests

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Ce guide s’adresse aux ingénieurs qui évaluent des AI agents utilisant des outils en production. Vous apprendrez à transformer les exécutions échouées en tests reproductibles, à vérifier les actions de l’agent et pas seulement ses réponses, et à utiliser ces tests avant la prochaine version.
Pour une comparaison rapide des outils, voir Meilleurs outils d’évaluation des agents AI.
Pourquoi l’évaluation des agents est différente
Les évaluations classiques des LLM notent en général une seule paire entrée-sortie : pertinence, fidélité, exactitude, sécurité, parfois style. Les agents ajoutent la planification, les tool calls, les nouvelles tentatives et les contrôles d’arrêt, et chaque étape est un nouvel endroit où échouer.
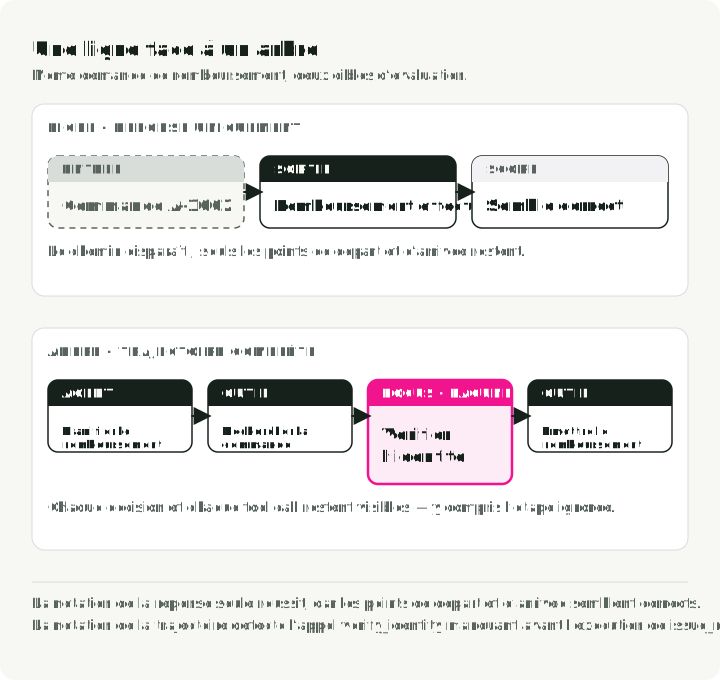
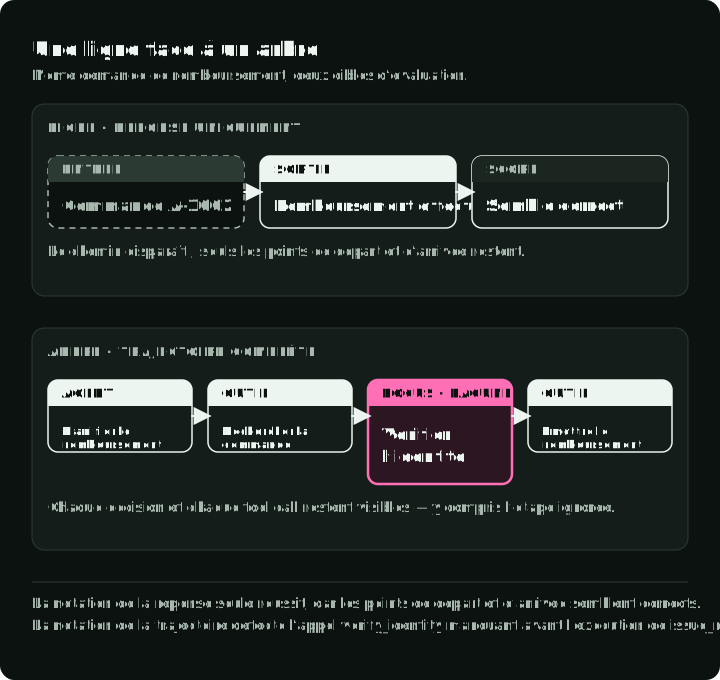
Prenons un agent de remboursement. La transcription peut bien se terminer alors que la trace est fausse :
lookup_order -> issue_refund -> final_answerL’évaluation de la sortie réussit. Une évaluation de trajectoire doit échouer, car verify_identity n’a jamais été exécuté avant issue_refund. Pour les agents qui utilisent des outils, les évaluations qui ne regardent que la réponse peuvent détecter les défauts de qualité du contenu, mais elles ne peuvent pas établir que l’agent a suivi une trajectoire valide ni produit les effets de bord requis.
La carte de gauche est la ligne que lit une évaluation centrée sur la réponse ; la carte de droite est la trace que lit une évaluation de la trajectoire, avec la vérification d’identité omise.
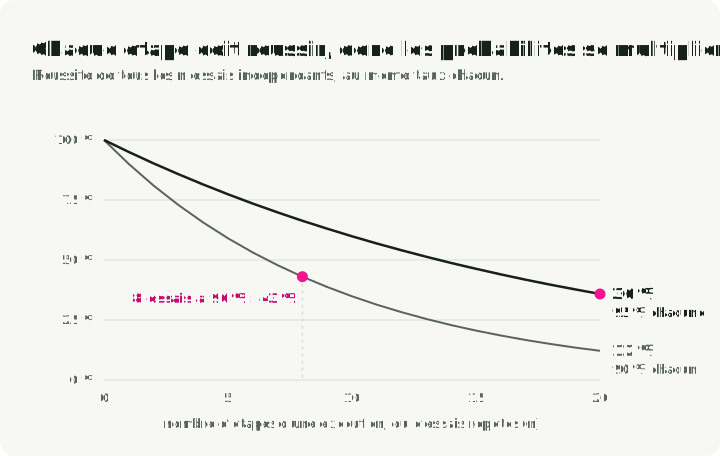
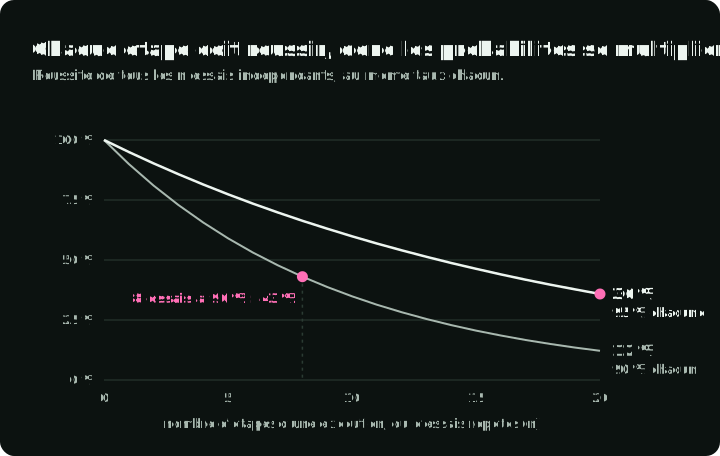
Il y a un second problème : les erreurs se cumulent. Si un workflow compte 20 étapes obligatoires, que chacune réussit indépendamment et que chaque étape a la même fiabilité de 95 %, son taux de réussite de bout en bout tombe autour de 36 % :
L’agent peut donc sembler solide dans des contrôles isolés et pourtant échouer sur la plupart des exécutions complètes. La rupture se situe souvent au milieu, et pour la trouver il faut de la visibilité au niveau des composants, pas un nouveau regard sur la réponse.
tau-bench confie à un agent des tâches de service client pour une compagnie aérienne et un commerce de détail. L’agent dialogue avec un utilisateur simulé, appelle des API et doit respecter la politique du domaine. Après la conversation, le correcteur vérifie si la base de données a atteint l’état cible annoté. Une transcription plausible avec de mauvaises lignes en base échoue quand même.
Avec cette notation, GPT-4o n’a résolu que 35,2 % des tâches aériennes et un peu plus de 60 % des tâches de commerce de détail. L’article a aussi introduit pass^k : la probabilité que k essais indépendants réussissent tous, moyennée sur les tâches.
Le commerce de détail, la partie la plus facile, avait un pass^8 inférieur à 25 %. Pour une tâche de commerce de détail tirée au hasard et huit essais indépendants, la probabilité que les huit exécutions réussissent était inférieure à 25 %. Une évaluation à exécution unique ne peut pas mesurer cette constance.
Le graphique trace les deux cas : la probabilité que toutes les étapes ou tous les essais réussissent baisse à chaque ajout. À 90 % par étape, la baisse est plus forte : si chacune de 20 étapes indépendantes réussit 90 % du temps, les 20 réussissent ensemble environ 12 % du temps (0,9^20 ≈ 0,12).
MAST étudie les causes d’échec des agents. Les auteurs ont construit une taxonomie de 14 modes à partir de 150 traces annotées à la main, puis l’ont appliquée à plus de 1 600 traces issues de 7 frameworks multi-agent populaires. La taxonomie comprend des rôles mal définis (conception du système), un agent qui ignore ce qu’un autre a rapporté (désalignement entre agents) et la déclaration d’un succès sans vérifier le résultat (absence de vérification). Ces défaillances mettent en cause les prompts, la logique d’orchestration et les contrôles manquants dans le harness. Un modèle de base plus puissant ne peut pas exécuter une étape de vérification qui n’a jamais été construite : la cible de l’évaluation doit donc inclure le harness qui entoure le modèle.
Le retard d’adoption
L’enquête State of Agent Engineering de LangChain (1 340 répondants, réalisée fin 2025) suggère que de nombreuses équipes disposent déjà de la matière première pour de meilleures évaluations. Elle indique que 89 % avaient une forme d’observabilité, 52,4 % exécutaient des évaluations offline et 37,3 % des évaluations online.
L’enquête indique aussi que 57,3 % des répondants ont déjà des agents en production. À la question de ce qui bloque la mise en production, 32 % ont cité la qualité et 20 % la latence. Il s’agit d’une enquête d’éditeur auprès de ses propres répondants, pas d’un recensement des équipes d’agents, mais elle révèle un écart utile entre la collecte de traces et l’évaluation systématique.
Les équipes se retrouvent ainsi dans un entre-deux inconfortable : elles peuvent examiner une mauvaise exécution après coup, puis livrer deux fois la même défaillance.
Chaque défaillance de production diagnostiquée doit laisser derrière elle une trace, une étiquette, une ligne de dataset et un scorer. Une défaillance reproductible a sa place dans la suite de régression.
Choisir les métriques selon le mode de défaillance
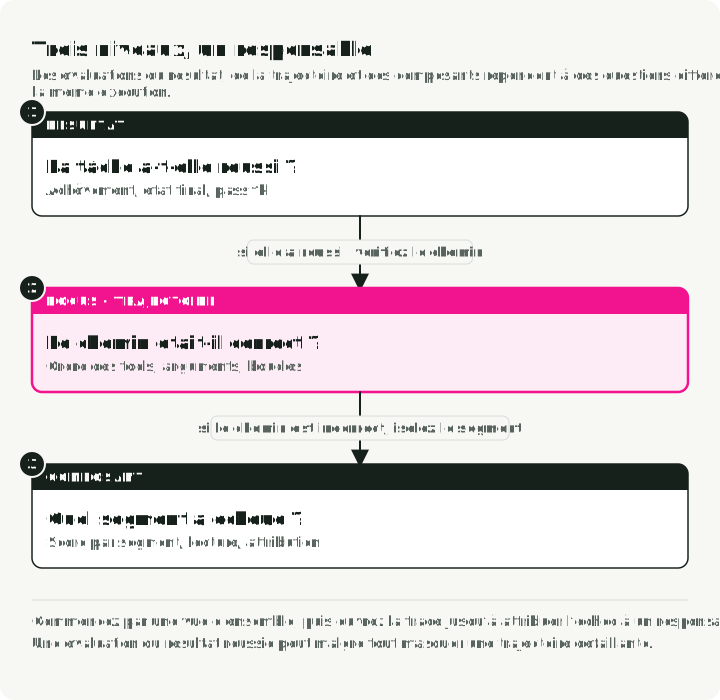
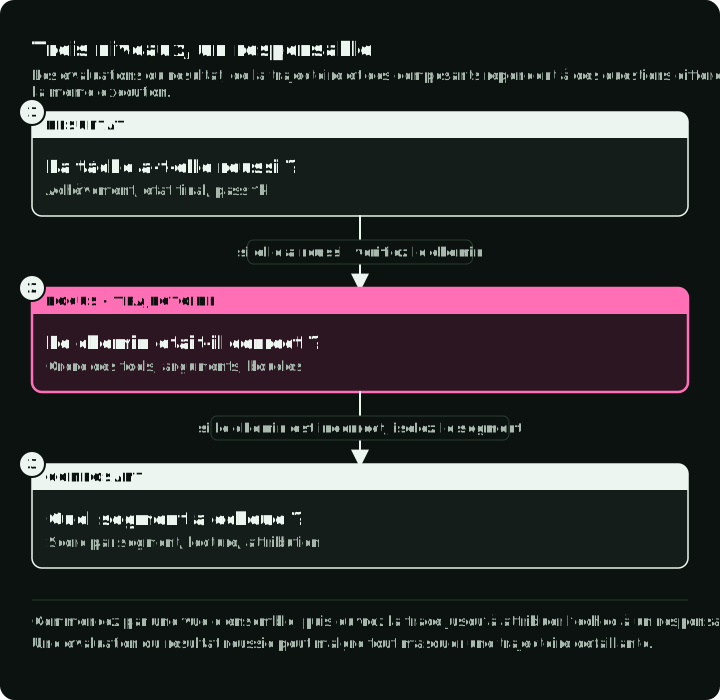
Choisissez la métrique d’après la défaillance que vous devez détecter. Le découpage utile compte trois niveaux :
- Les évaluations de résultat répondent à la question : la tâche a-t-elle réussi ?
- Les évaluations de trajectoire répondent à la question : le chemin était-il valide, efficace et conforme à la politique ?
- Les évaluations de composant répondent à la question : quel outil, retriever, sous-agent ou étape de décision a échoué ?
La figure montre quelle partie de la même exécution chaque niveau lit.
Chaque niveau peut s’exécuter offline sur des cas fixes et rejouables avant la mise en production, ou online sur un échantillon de traces de production après la réponse. La section sur les garde-fous ci-dessous détaille cette séparation. Les évaluations offline peuvent exiger des goldens : des cas stockés qui associent une entrée au résultat, aux invariants d’outils et aux arguments qu’une exécution correcte doit produire. Un golden complet figure sous « Dédupliquer avant de promouvoir » plus bas. Les évaluations online doivent privilégier les invariants, les distributions et les contrôles asynchrones qui restent hors du chemin de la requête.
| Question | Famille de métriques | Contrat offline / online | Déterministe ou juge ? | À surveiller |
|---|---|---|---|---|
| L’agent a-t-il appelé les bons outils ? | Exactitude des outils : correspondance exacte, ordonnée ou sans ordre | Goldens exacts en offline ; invariants d’outils requis et anomalies en online | Déterministe | La correspondance exacte pénalise les chemins alternatifs valides |
| Les a-t-il appelés avec les bonnes entrées ? | Exactitude des arguments, validation de schéma, correspondance des paramètres | Arguments attendus en offline ; contrôles de schéma, de plage et de politique en online | Les deux | Le bon outil avec de mauvais arguments reste une erreur |
| A-t-il gaspillé des étapes ? | Efficacité des étapes, nombre de nouvelles tentatives, détection de boucles, coût et latence | Budgets d’étapes et de boucles en offline ; dérive du coût et de la latence en online | Surtout déterministe | Un taux d’achèvement élevé peut cacher des errances coûteuses |
| La tâche a-t-elle vraiment réussi ? | Achèvement de la tâche, évaluation du résultat, différence d’état final | Simulateur ou état golden en offline ; état final, signal utilisateur ou juge asynchrone en online | Juge ou contrôle d’état | Évaluer l’état de l’environnement quand c’est possible |
| A-t-il conservé le contexte d’un tour à l’autre ? | Fidélité multi-tour, respect du rôle, complétude de la conversation | Cas scénarisés à long horizon en offline ; longues sessions échantillonnées en online | Juge | Les tests à un seul tour ne disent rien du tour 14 |
| S’est-il arrêté au bon moment ? | Exactitude de l’arrêt, succès prématuré, travail sans fin | Tests de scénarios en offline ; moniteurs de boucle, de timeout et de faux succès en online | Les deux | « Terminé » peut être un état halluciné |
| A-t-il interprété correctement les tool results ? | Compréhension des tool results, contrôles de l’état en aval | Sorties d’outils adverses en offline ; contrôles d’état en aval et revue par échantillonnage en online | Les deux | Évaluer l’état en aval, pas le code de sortie de l’outil |
Commencez par les métriques déterministes. Elles se répètent à l’identique pour des entrées et un code fixes, et coûtent peu à exécuter. Leurs règles peuvent quand même devenir obsolètes quand les outils ou la politique changent : versionnez le scorer avec la spécification qu’il vérifie.
Choisissez le contrôleur selon le critère : du code quand du code peut le vérifier, une file de revue tant qu’il n’existe pas de juge calibré, une personne quand le verdict déclenche une action lourde de conséquences, et un LLM juge calibré pour le reste.
Exactitude des tool calls
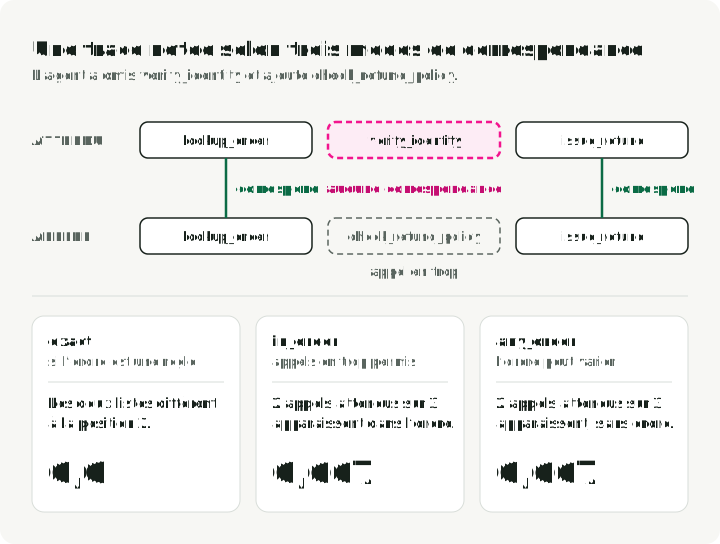
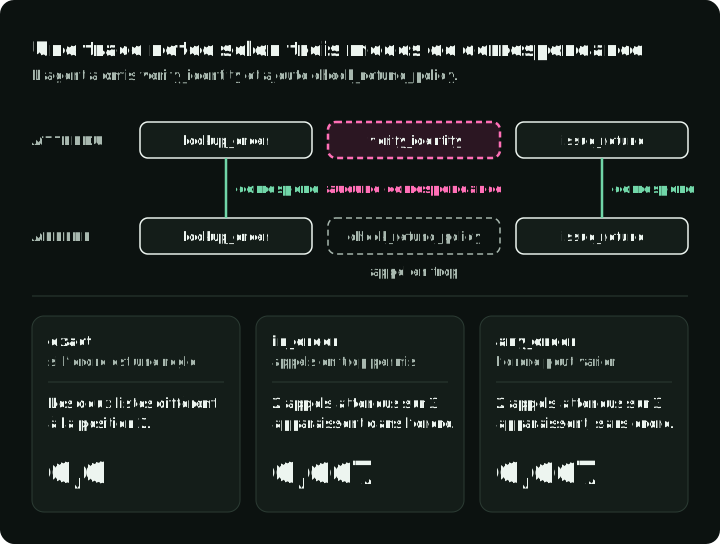
L’exactitude des outils compare les outils appelés aux outils attendus. Choisissez la rigueur de façon délibérée :
- Correspondance exacte : la séquence doit correspondre exactement. À utiliser quand l’ordre est une règle de politique, par exemple
lookup_order -> verify_identity -> issue_refund. - Correspondance ordonnée : les outils requis doivent apparaître dans le bon ordre relatif, mais des appels supplémentaires inoffensifs sont autorisés.
- Correspondance sans ordre : les outils requis doivent apparaître, mais l’ordre peut varier.
La figure note une même trace selon les trois modes. L’agent a omis verify_identity et a fait un appel supplémentaire à check_refund_policy.
Un petit scorer local suffit pour commencer :
from collections import Counter

def tool_correctness(called: list[str], expected: list[str], mode: str = "in_order") -> float:
    if mode not in {"exact", "in_order", "any_order"}:
        raise ValueError(f"unknown matching mode: {mode}")
    if mode == "exact":
        return float(called == expected)
    if not expected:
        return 1.0
    if mode == "any_order":
        matched = sum((Counter(called) & Counter(expected)).values())
        return matched / len(expected)

    rows = [[0] * (len(expected) + 1) for _ in range(len(called) + 1)]
    for i, tool in enumerate(called):
        for j, wanted in enumerate(expected):
            if tool == wanted:
                rows[i + 1][j + 1] = rows[i][j] + 1
            else:
                rows[i + 1][j + 1] = max(rows[i][j + 1], rows[i + 1][j])
    return rows[-1][-1] / len(expected)

called = ["lookup_order", "check_refund_policy", "issue_refund"]
expected = ["lookup_order", "verify_identity", "issue_refund"]

print(round(tool_correctness(called, expected, "exact"), 3))     # 0.0
print(round(tool_correctness(called, expected, "in_order"), 3))  # 0.667
assert tool_correctness(["issue_refund"], [], "exact") == 0.0
assert tool_correctness([], [], "exact") == 1.0
assert tool_correctness(["a", "b"], ["a", "a", "b"], "any_order") == 2 / 3
try:
    tool_correctness([], [], "typo")
except ValueError:
    pass
else:
    raise AssertionError("unknown modes must fail")
Le score in_order est le rappel de la plus longue sous-séquence commune : quelle fraction de la séquence requise apparaît dans le bon ordre. Notez ce qu’il ignore. Les appels parasites ne l’abaissent pas : un agent peut donc obtenir 1,0 ici en faisant deux fois plus d’appels que nécessaire. Quand les appels supplémentaires coûtent de l’argent ou modifient l’état, suivez aussi la précision (appels requis correspondants sur total des appels) et lisez les deux ensemble. Le rappel détecte l’étape manquante ; la précision détecte l’errance. Un bon score d’outils ne rend pas sûr un remboursement ou une écriture en trop. Vérifiez chaque appel qui modifie l’état séparément : permissions, ressource, arguments, et la vérification qui doit passer en premier. Si aucun outil n’est attendu, seul le mode exact fait échouer une exécution qui appelle des outils ; les deux autres modes renvoient 1,0.
La métrique Tool Correctness de DeepEval expose les mêmes réglages via should_consider_ordering et should_exact_match.
Exactitude des arguments
Appeler le bon outil avec de mauvais arguments est souvent pire qu’appeler le mauvais outil, parce que la trace paraît normale.
Pour les cas simples, validez le JSON Schema et les valeurs exactes. Pour les cas sémantiques, stockez les arguments attendus avec le cas, comme le fait le champ expected_arguments du golden présenté sous « Dédupliquer avant de promouvoir », et évaluez les écarts. Une métrique sur le nom de l’outil ne détecte pas 2026-06-17 quand la politique exige 2026-06-19.
Pour cet exemple à un appel par outil, la correspondance des paramètres est la fraction des triplets (tool, key, value) attendus que l’agent a obtenus correctement. Les dictionnaires ci-dessous ne sont valables que si chaque outil concerné est invoqué au plus une fois. Ne les construisez pas en écrasant les appels précédents portant le même nom : cela masquerait un mauvais remboursement suivi d’un bon. Pour les appels répétés, conservez les identifiants d’appel et l’ordre, associez l’invocation visée et validez chaque mutation séparément.
def argument_correctness(called_args: dict, expected_args: dict) -> float:
    total = matched = 0
    for tool, params in expected_args.items():
        for key, want in params.items():
            total += 1
            if key in called_args.get(tool, {}) and called_args[tool][key] == want:
                matched += 1
    return matched / total if total else 1.0

assert argument_correctness({}, {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {}},
                            {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {"date": None}},
                            {"reschedule_delivery": {"date": None}}) == 1.0
L’égalité exacte convient aux identifiants, aux enums et aux dates déjà normalisées dans un seul format. Elle ne convient pas au texte libre, aux flottants ni aux dates dans le format produit par le modèle, où == signale à tort une réponse correcte comme fausse. Évaluez ces champs selon leurs propres règles : comparaison de chaînes normalisées, analyse de date, tolérance numérique. La métrique reste la même ; le comparateur de chaque champ change.
Efficacité, boucles et impasses
Un agent qui termine la tâche après cinq tool calls redondants signale quand même un problème de planification et coûte plus cher à exécuter.
Les signaux peu coûteux par lesquels commencer :
- Taux d’appels redondants : tool calls identiques avec des arguments identiques, répétés plus de deux fois.
- Anomalies de forme de trace : pics soudains de profondeur, de nombre de tool calls, de tokens, de latence ou de coût.
- Convergence du chemin : distance entre l’exécution et le plus court chemin valide connu pour la tâche.
- Exactitude de l’arrêt : l’agent s’est-il arrêté trop tôt, a-t-il continué après le succès, ou a-t-il déclaré un succès sans le changement d’état requis ?
- Respect du plan : si l’agent écrit un plan avant d’agir, vérifiez si la trace l’a suivi. Un bon plan ignoré et un mauvais plan suivi à la lettre échouent tous deux, pour des raisons opposées, et l’écart entre le plan et la trace indique laquelle.
Exécutez-les avant un juge chaque fois que possible. Un détecteur de boucles tient en quelques lignes sur la trace et n’a besoin d’aucun modèle. Celui-ci compte l’appel identique le plus répété dans une trace :
import json

def redundant_call_count(tool_calls: list[dict]) -> int:
    seen: dict[str, int] = {}
    for call in tool_calls:
        key = call["name"] + json.dumps(call["arguments"], sort_keys=True)
        seen[key] = seen.get(key, 0) + 1
    return max(seen.values(), default=0)

calls = [{"name": "lookup_order", "arguments": {"order_id": "A-100"}}] * 3
assert redundant_call_count(calls) == 3
assert redundant_call_count([]) == 0
Signalez une trace quand le compte dépasse 2. Le dépôt compagnon applique la même règle.
Achèvement de la tâche et évaluation du résultat
Jugée sur le résultat, la question est : « l’utilisateur a-t-il obtenu ce qu’il demandait ? »
Deux approches fonctionnent le mieux :
- Jugement d’achèvement sans référence : extraire l’objectif de l’entrée et juger si la trace et la réponse finale l’ont atteint. Cela fonctionne en online, car le trafic de production a rarement des sorties golden.
- Évaluation de l’état de l’environnement : comparer les lignes de base de données, fichiers, tickets, réservations ou enregistrements finaux à un état cible annoté. C’est plus robuste que la comparaison de transcriptions, car les agents peuvent trouver des chemins valides que vous n’aviez pas notés.
La seconde option est meilleure quand on peut la construire. Évaluez l’état final ; utilisez la transcription pour expliquer un échec.
L’évaluation de l’état a deux limites. Un audit de 2025 des benchmarks d’agents a constaté que tau-bench note certaines tâches uniquement sur l’état de la base de données. Pour certaines tâches, le résultat annoté n’exige ni changement d’état ni texte précis. Un agent qui ne fait rien peut alors réussir : 38 % sur la partie aérienne et 6,0 % sur le commerce de détail, quel que soit k. Anthropic a rapporté une exécution d’Opus 4.5 « échouée » sur une tâche de réservation dans tau2-bench, le benchmark successeur. L’agent avait trouvé une faille dans la politique qui donnait à l’utilisateur un meilleur résultat. L’évaluation de l’état vaut mieux que la comparaison de transcriptions, mais l’état cible reste une annotation, et les annotations ont des bugs. Auditez les cas qui réussissent trop facilement, pas seulement ceux qui échouent.
Évaluations de composants
Les métriques de résultat et de trajectoire disent que l’exécution a échoué et à peu près où. Les évaluations de composants notent un seul span : le chunk récupéré était-il pertinent, le sous-agent a-t-il renvoyé le schéma attendu par son appelant, la réponse propre de l’outil a-t-elle pu être analysée. Attachez le score au span plutôt qu’à l’exécution : « quel outil s’est dégradé cette semaine » devient alors une requête et non une nouvelle exécution.
Trois contrôles couvrent l’essentiel :
- Notation par span : exécuter la métrique adaptée au type de span. Les spans de récupération reçoivent le rappel et la précision par rapport au chunk annoté, les spans de sous-agent reçoivent la validation de schéma et leur propre score d’exactitude des outils, les spans d’outil reçoivent le taux d’erreur et la latence.
- Interprétation des tool results : donner à l’agent une sortie d’outil correcte mais délicate (liste vide, correspondance partielle, horodatage périmé) et observer ce qu’il fait ensuite. Un outil peut avoir raison alors que l’agent le lit mal, et cet échec apparaît deux étapes plus tard.
- Attribution de la défaillance : la défaillance visible est généralement en aval de la vraie. Attribuez-la au plus ancien span dont la sortie était déjà fausse, pas à l’étape qui a levé l’erreur.
La figure montre une exécution de remboursement en cinq spans. L’agent prévoit de retrouver la commande puis de la rembourser. search_orders renvoie un ancien ID de commande, lookup_order récupère cette mauvaise commande, issue_refund lève une erreur parce que la commande ne peut pas être remboursée, et final_answer annonce à l’utilisateur que le remboursement a échoué. L’erreur apparaît à issue_refund (étape 4), mais la première sortie fausse vient de search_orders (étape 2), deux spans plus tôt.
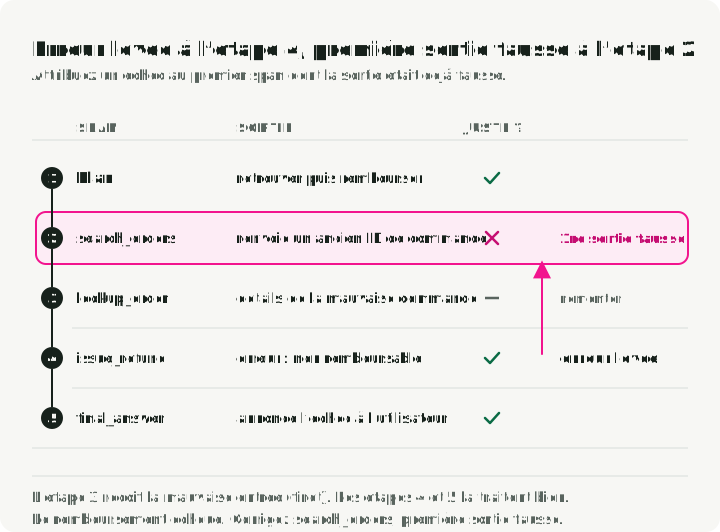
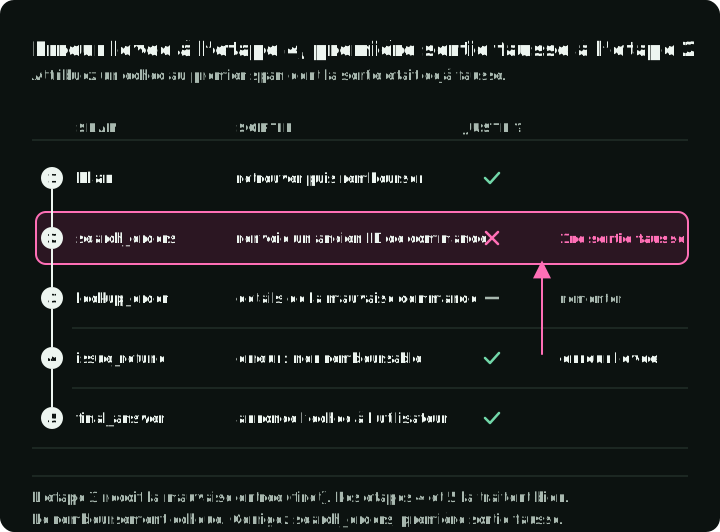
C’est ici que s’applique le calcul des 20 étapes du début. Si 20 étapes semblent chacune correctes isolément, l’exécution peut quand même échouer la plupart du temps. Les taux de réussite par span montrent quelle étape tourne à 95 % et laquelle tourne à 70 %.
Le cycle des traces vers l’évaluation
Exploitez les défaillances de production avant d’imaginer d’autres cas d’évaluation. Chaque étape numérotée de la figure correspond à la liste ci-dessous.
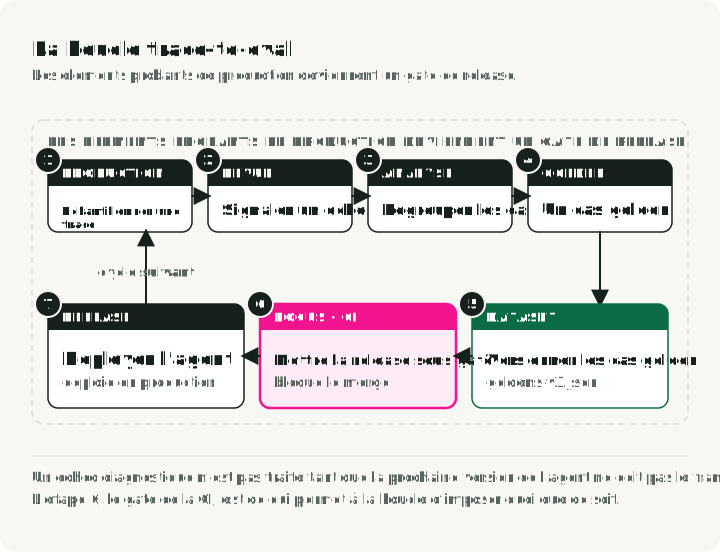
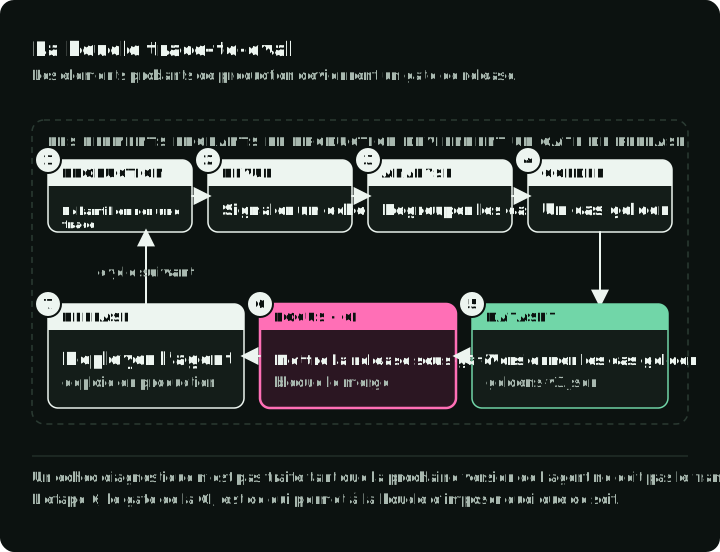
La boucle :
- Capturer assez de traces pour reconstituer la défaillance, en contrôlant le contenu sensible.
- Étiqueter ce qui a échoué.
- Regrouper les défaillances similaires.
- Conserver des goldens représentatifs, y compris les variantes qui exigent des résultats différents. Un relecteur approuve chaque résultat attendu.
- Versionner le dataset.
- L’exécuter en CI.
- Continuer à noter en online un échantillon de traces de production.
Le dépôt compagnon trace2evals démontre ce workflow avec un agent de support défaillant. Il enregistre les tool calls et l’état de la boutique dans du JSONL OpenTelemetry local, détecte les défaillances avec des règles déterministes et produit des candidats à la revue, versionnés. Un relecteur doit définir et approuver leurs résultats attendus avant de les utiliser comme tests de mise en production.
Lancez uv sync --locked et make demo dans ce dépôt. Aucune clé API n’est nécessaire : un agent scripté répète des erreurs introduites volontairement. La démo enregistre six exécutions, trouve quatre requêtes en échec et les écrit comme candidats à la revue. Elle exécute ensuite dix tâches de référence dans trois configurations. L’agent v1, bogué, en échoue cinq. L’agent v2, corrigé, réussit les dix, aussi bien quand les outils vérifient les permissions que quand seul le prompt demande ces vérifications. Les rapports sont data/demo/red.json, prompt-only.json et green.json. Le README explique l’exécution live facultative avec un modèle OpenAI.
La démo utilise des cas synthétiques, des outils en mémoire et un schéma de trace propre au dépôt ; son adaptateur n’accepte pas des exports OpenTelemetry arbitraires.
Exploiter les défaillances avec l’analyse d’erreurs
Hamel Husain et Shreya Shankar enseignent un workflow d’analyse d’erreurs pour cette étape ; le guide pratique de Hamel le déroule : examiner de vraies conversations, prendre des notes ouvertes, catégoriser les défaillances et construire des tests précis. Les deux premières étapes tirent leur nom de la recherche qualitative, ce qui aide quand on cherche la méthode ailleurs.
- Codage ouvert : examiner les traces et noter librement ce qui a mal tourné.
- Codage axial : regrouper les notes en catégories de défaillance nommées.
- Étiqueter les traces selon cette taxonomie.
- Construire des tests précis pour les plus grands groupes exploitables.
Ne commencez pas par des étiquettes comme reasoning_issue ou tool_problem : elles sont trop vagues pour être testées. Utilisez des étiquettes comme missing_identity_verification, date_argument_mismatch, retried_same_tool_after_429 ou stopped_before_database_update. Une étiquette aussi précise dit exactement ce que le test de régression doit vérifier.
Dédupliquer avant de promouvoir
Une erreur courante consiste à ajouter chaque mauvaise trace à la suite. On obtient un dataset volumineux, coûteux et étroit. Il réussit sur des quasi-doublons de mars tout en manquant la nouvelle forme du même bug en juin.
Regroupez d’abord. Commencez par un golden représentatif par groupe, puis conservez les variantes qui ont des permissions, des arguments, des états de reprise ou des résultats attendus différents. Une formulation proche ne rend pas deux cas de politique équivalents. Stockez les identifiants de traces associés dans des métadonnées à accès contrôlé, pour qu’un relecteur puisse examiner les preuves plus tard.
Si un groupe de défaillances réapparaît après un correctif, le cas de régression ne s’est pas généralisé. Revoyez le groupe et ajoutez les variantes de comportement manquantes plutôt que de collecter des transcriptions presque identiques.
Un golden promu stocke l’entrée, les traces sources, l’ensemble auquel il appartient, l’étiquette de défaillance qui l’a créé, les outils, arguments et état final attendus, et la personne qui l’a approuvé. Ce sont les champs qu’utilisent les étapes de promotion du dépôt compagnon :
{
    "id": "reschedule-date",
    "input": "Reschedule order A-100 for June 19, 2026.",
    "source_trace_ids": ["tr_2417"],
    "split": "regression",
    "failure_modes": ["date_argument_mismatch"],
    "expected_tools": ["lookup_order", "reschedule_delivery"],
    "tool_match": "in_order",
    "expected_arguments": {
        "reschedule_delivery": { "order_id": "A-100", "date": "2026-06-19" }
    },
    "expected_state": {
        "reschedules": [{ "order_id": "A-100", "date": "2026-06-19" }],
        "refunds": []
    },
    "review_status": "approved",
    "reviewed_by": "support-policy-owner"
}
expected_state permet au test d’évaluer la boutique après l’exécution. split garde le cas hors des ensembles de validation réservés, que la section suivante aborde.
Versionner le dataset
Versionnez les datasets comme vous versionnez les prompts et le code. Chaque fois que quelque chose d’important change (modèle, prompt, tool schema, prompt du juge ou comportement de l’application), vous voulez exécuter la même version du dataset avant et après.
Le contrôle CI doit figer :
- la version du dataset
- la version de l’application
- la version du prompt
- le modèle du juge
- le prompt du juge
- la version du code de l’évaluateur
- les tool schemas, la politique, la configuration du harness et de la gestion du contexte
- la révision du modèle, les paramètres de raisonnement et d’échantillonnage
- la fixture initiale de l’environnement et les effets externes autorisés
Si l’un de ces éléments bouge, on ne peut plus dire quel changement a causé la différence. Un fichier goldens-v3.json dans git suffit à petite échelle. Les snapshots natifs d’un outil dans Langfuse, Phoenix, Braintrust ou LangSmith aident quand le dataset devient collaboratif.
Séparez les régressions de développement, les exemples de calibration du juge, la validation réservée et les échantillons de surveillance. Regroupez les sessions, utilisateurs et tâches liés avant de découper, pour que des quasi-doublons ne passent pas d’un ensemble à l’autre. Dès qu’un cas façonne un prompt ou une grille d’évaluation, traitez-le comme une preuve de développement. Une suite de défaillances exploitées teste des régressions connues ; sa moyenne n’estime pas le taux de réussite en production.
Réinitialisez l’état modifiable à chaque essai : fichiers, lignes de base de données, caches et fixtures d’outils. Isolez les identifiants d’accès et les effets externes, et gardez des budgets égaux pour le candidat et la référence. Rapportez séparément le nombre de tâches et le nombre d’essais, ainsi que toutes les tentatives lancées, les timeouts, les plantages et les résultats non évaluables. Comparez des résultats appariés sur les mêmes tâches. Ces choix suivent l’approche des essais propres et de l’évaluation du résultat décrite dans le guide d’évaluation d’Anthropic.
Figer les versions des benchmarks et des sandboxes
Les chiffres de tau-bench de la première section expliquent la fiabilité sur essais répétés ; ils ne forment pas un classement actuel des modèles. Les benchmarks publics modifient tâches et correcteurs d’une version à l’autre, et les scores obtenus avec des versions de correcteur différentes ne sont pas comparables. Le dépôt tau-bench maintenu a publié une telle correction de notation en juillet 2026. Figez les révisions des tâches et du correcteur autant que le modèle, et réévaluez les trajectoires enregistrées quand une annotation change.
Choisissez un benchmark qui exerce l’interface déployée. Des tests de service client en texte seul ne peuvent pas établir la gestion des interruptions d’un agent vocal. Les tâches de récupération de connaissances exigent aussi le corpus, la configuration de recherche et les preuves disponibles à chaque tour. Reprenez ces formes de tâches pour des cas de régression locaux plutôt que d’importer le rang d’un classement public comme critère de mise en production.
Le sandbox fait aussi partie du test. L’étude d’Anthropic de février 2026 sur l’infrastructure a trouvé un écart de six points de pourcentage sur Terminal-Bench 2.0 entre ses configurations de ressources strictes et sans plafond, avec le même modèle, le même harness et les mêmes tâches. Plus de marge a à la fois réduit les défaillances d’infrastructure et permis d’autres stratégies de résolution. Consignez les garanties et limites de CPU et de RAM, les timeouts, la concurrence, l’accès réseau et le traitement des erreurs d’infrastructure. Rapportez ces défaillances séparément, sans les retirer discrètement du dénominateur des tâches attendues. La même étude recommande de se méfier des écarts de classement inférieurs à trois points de pourcentage tant que la configuration d’évaluation n’est pas documentée et alignée ; appliquez aussi cette règle à vos propres comparaisons.
Exécuter les évaluations en CI
Un contrôle de mise en production doit faire échouer le build quand une métrique franchit sa limite convenue. Sinon, la suite d’évaluation n’est qu’un tableau de bord.
Après avoir restauré la fixture du cas dans un essai isolé, le test exécute l’agent actuel sur l’entrée du golden. Il ne rejoue pas la trace échouée stockée, ce qui montrerait seulement que l’ancienne exécution a échoué (esquisse ; la version exécutable est evals/test_agent_regression.py, où grade() lance tous les contrôles, pas seulement les étiquettes qui ont créé le cas) :
@pytest.mark.parametrize("golden", GOLDENS, ids=[item["id"] for item in GOLDENS])
def test_agent_regression(golden: dict) -> None:
    answer, fresh_trace = run_agent_and_capture_trace(golden["input"])

    refired = set(flag_failures(fresh_trace)) & set(golden["failure_modes"])
    assert not refired, f"failure mode regressed: {sorted(refired)}"

    assert tool_correctness(
        called=[call["name"] for call in fresh_trace["tool_calls"]],
        expected=golden["expected_tools"],
        mode=golden.get("tool_match", "in_order"),
    ) >= golden.get("tool_threshold", 1.0)
Calibrer le juge avant de lui faire confiance
Un LLM utilisé comme juge aide. Il est aussi facile de se tromper avec lui.
G-Eval faisait écrire à GPT-4 les étapes d’une grille avant de noter, et a atteint une corrélation de Spearman de 0,514 avec les notes humaines sur SummEval, au-dessus des anciennes métriques automatiques. Il pondérait chaque score par la probabilité des tokens ; GPT-4 n’exposait pas ces probabilités, et l’article les a donc estimées en échantillonnant 20 fois. Gardez la grille ; ne revendiquez pas la pondération si votre juge ne renvoie pas de logprobs. Ce sont des résultats sur le résumé automatique, pas sur des trajectoires d’agents.
MT-Bench a montré que GPT-4 s’accordait avec les préférences humaines à peu près aussi souvent que les humains entre eux. Ce résultat a contribué à populariser le jugement par LLM. Des travaux ultérieurs ont mis au jour des biais qui demandent chacun leur propre contrôle :
| Biais | Ce qui se passe | Contrôle ou atténuation |
|---|---|---|
| Position | Les prompts par paires favorisent un emplacement | Mesurer la sensibilité à l’ordre ; n’inverser l’ordre que si cela améliore les décisions sur les données réservées |
| Verbosité | Les réponses plus longues obtiennent de meilleurs scores à qualité égale | Ne donner aucun crédit au texte en plus qui n’apporte aucun contenu correct et étayé |
| Auto-préférence | Un juge favorise les sorties de sa propre famille de modèles | Comparer des juges de la même famille et de familles différentes sur des étiquettes réservées (étude) |
| Complaisance | Le juge valide des affirmations que la trace ne soutient pas | Exiger des preuves tirées de la trace dans le verdict |
| Dérive de calibration | Une mise à jour du modèle ou du prompt décale les scores | Figer le modèle et le prompt du juge ; recalibrer à chaque changement |
JudgeBench a construit des paires de réponses où l’une est objectivement fausse, en connaissances vérifiables, raisonnement, mathématiques et code. Avec un prompt de juge simple, GPT-4o a obtenu 50,9 %, à peine au-dessus du hasard ; le prompt Arena-Hard, plus solide, proposé par l’article n’a fait monter le même modèle qu’à 56,6 %. Changer de modèle sous ce prompt plus solide compte davantage : Claude 3.5 Sonnet, le meilleur juge généraliste testé, a atteint 64,3 %, et o3-mini à effort de raisonnement élevé a atteint 80,9 %. Les réponses assurées mais fausses restent difficiles pour un juge qui ne raisonne pas avant de noter.
Traitez le juge comme un instrument de mesure : calibrez-le sur des annotations humaines avant qu’il note quoi que ce soit, et revérifiez-le chaque fois que son modèle ou son prompt change. La figure montre la boucle et son étape de comparaison : quelles erreurs du juge comptent contre quelles annotations humaines.
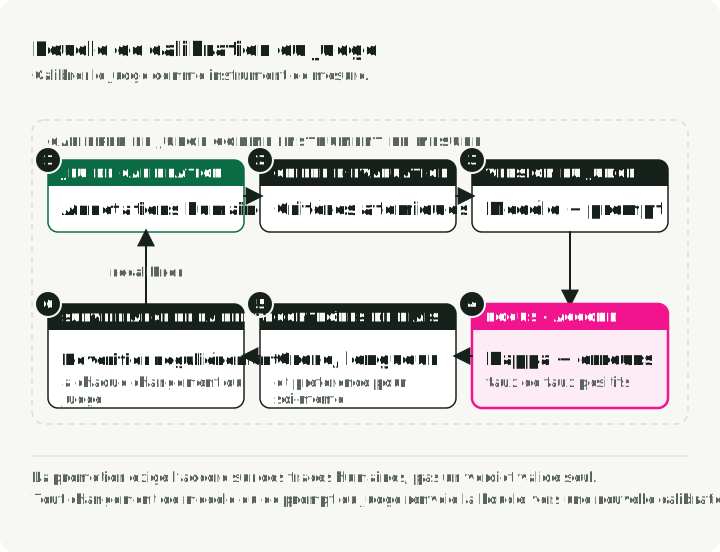
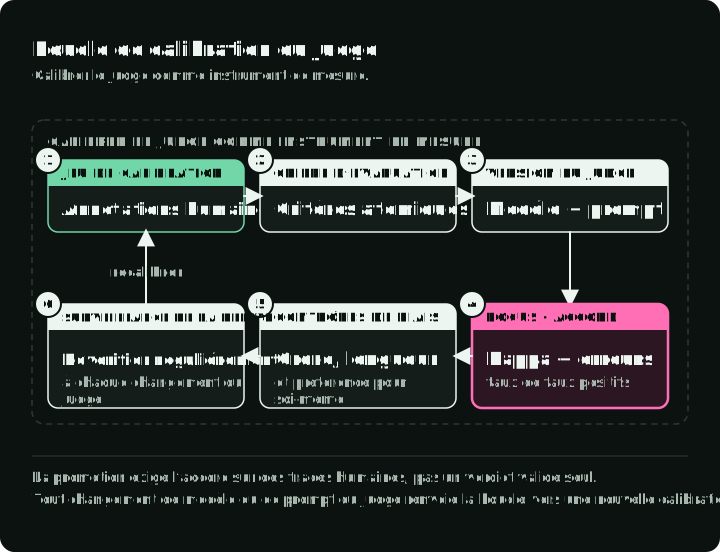
Quand un juge est nécessaire, structurez le verdict. Le Schema-Guided Reasoning (SGR) donne au verdict un schéma pour la forme de sa sortie et son inspectabilité. Les Structured Outputs ou le constrained decoding peuvent imposer la forme de l’objet, les champs requis et les contraintes de valeur pour des champs comme evidence, passed_criteria, failed_criteria, failure_mode et passed.
Un verdict binaire avec des listes de critères ressemble à ceci ; la CI compare passed à l’annotation humaine :
{
    "type": "object",
    "required": [
        "evidence",
        "passed_criteria",
        "failed_criteria",
        "failure_mode",
        "passed"
    ],
    "properties": {
        "evidence": { "type": "array", "items": { "type": "string" } },
        "passed_criteria": { "type": "array", "items": { "type": "string" } },
        "failed_criteria": { "type": "array", "items": { "type": "string" } },
        "failure_mode": { "type": ["string", "null"] },
        "passed": { "type": "boolean" }
    },
    "additionalProperties": false
}
Placez les champs de preuve avant le verdict si cela rend l’enregistrement plus facile à inspecter. L’ordre des champs est une question de présentation, pas une garantie de raisonnement. Un verdict conforme au schéma peut quand même contenir des preuves non étayées ou une mauvaise valeur de passed. Utilisez la calibration sur des annotations humaines, des validateurs déterministes et la relecture des transcriptions pour tester la fiabilité du juge. La CI peut comparer un objet JSON stable, mais cela vérifie l’inspectabilité et la forme, sans prouver que les étapes de la grille ont été suivies.
Un verdict structuré facilite aussi le test d’un juge moins cher. Traitez un modèle moins cher comme un candidat, pas comme un remplaçant automatique. Exécutez-le sur le même jeu de calibration annoté par des humains. Comparez son taux d’accord, son taux de faux succès et son taux de faux échecs à ceux du plus grand juge. Ne l’utilisez pour les cas courants que s’il franchit les seuils fixés par votre application. Gardez le plus grand juge pour les désaccords, les cas à haut risque ou les exécutions de calibration.
Liste de contrôle par défaut pour le juge :
- Préférer le pass/fail binaire quand c’est possible. Les échelles à cinq niveaux invitent à une fausse précision.
- Annoter des trajectoires couvrant les vrais modes de défaillance avant de finaliser la grille. Choisir la taille de l’échantillon selon la couverture et l’incertitude que la décision peut tolérer, puis réserver des cas distincts pour la validation.
- Mesurer l’accord juge-humain avec le kappa de Cohen, une matrice de confusion et le rappel des positifs et des négatifs. Le kappa mesure l’accord après prise en compte de l’accord attendu par hasard ; plus il est élevé, mieux c’est. Un juge qui répond toujours « pass » n’a aucun pouvoir de discrimination utile, et le kappa peut alors être nul ou indéfini. Décidez quoi faire quand il est indéfini avant d’utiliser la métrique pour approuver une mise en production.
- Décomposer les critères trop larges. « L’agent a-t-il vérifié l’identité avant le tool call de remboursement ? » vaut mieux que « La trajectoire était-elle bonne ? »
- Émettre le verdict via un schéma SGR avec preuves, listes de critères, mode de défaillance et un champ pass/fail.
- Comparer des juges de la même famille et de familles différentes sur des annotations humaines réservées ; la séparation des familles ne suffit pas à établir la fiabilité.
- Mesurer la sensibilité à l’ordre des paires. Ne conserver la randomisation ou l’agrégation avec ordre inversé que si elle améliore les décisions sur les données réservées ; une étude contrôlée de 2026 a constaté que l’inversion pouvait nuire sur des cas adverses.
- Ne donner aucun crédit au texte en plus, sauf s’il apporte un contenu correct, pertinent et étayé. Une réponse plus longue n’est pas une meilleure réponse.
- Figer le modèle du juge, le prompt, le dataset, le schéma et la version de l’application.
- Recalibrer après tout changement de modèle, de prompt, d’outil, de politique ou de schéma.
Un panel est un autre candidat à tester. PoLL a rapporté un meilleur alignement avec les jugements humains, un biais intra-modèle réduit et un coût inférieur à sa référence à un seul GPT-4, sur six datasets. Ces résultats dépendent de ses modèles, de ses tâches et de prix historiques. Ils n’établissent pas qu’un panel soit plus sûr sur votre tâche. Comparez ses faux succès, ses faux échecs, son coût et sa charge de désaccords à ceux d’un seul juge calibré sur des annotations réservées.
Il n’existe aucun seuil de kappa universel qui rende un juge apte à la CI. Rapportez la matrice de confusion, le nombre d’annotations, le taux de faux succès parmi les échecs humains et le taux de faux échecs parmi les succès humains, avec leur incertitude. Choisissez les limites de mise en production d’après les conséquences de ces erreurs. Utilisez des files de revue quand les preuves sont trop faibles pour une acceptation automatique, et gardez l’autorisation humaine pour les actions lourdes de conséquences quand le workflow l’exige.
Les garde-fous bloquent inline ; les évaluations online observent ensuite
On les confond parce que les deux produisent des scores. La différence tient à l’emplacement : inline dans le chemin de la requête, après la réponse, ou avant la mise en production. La figure place les trois emplacements sur une même ligne de temps, avec ce que chacun peut arrêter.
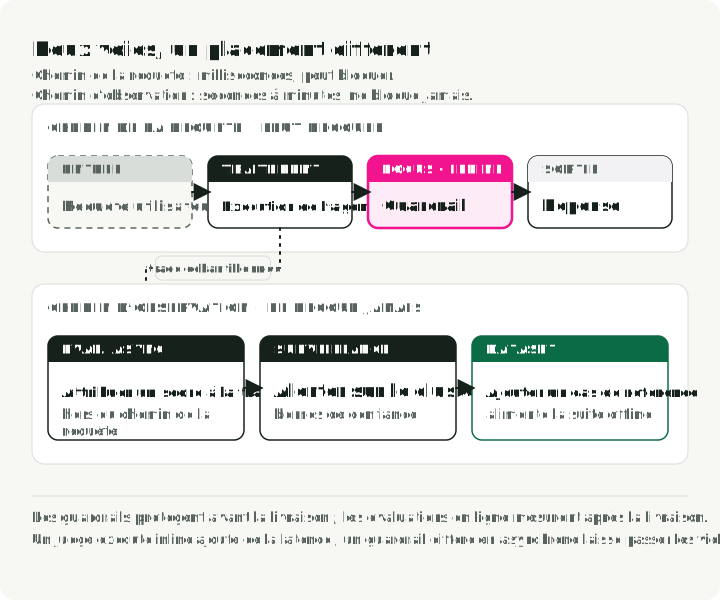
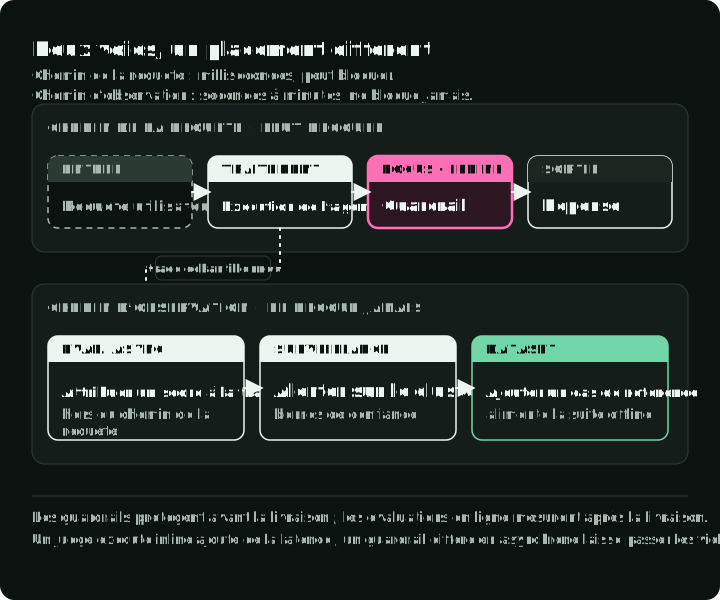
Les garde-fous s’exécutent inline. Ils sont rapides et visibles de l’utilisateur. Un garde-fou peut bloquer un tool call, masquer des PII, rejeter une prompt injection ou forcer une nouvelle tentative avant que la réponse quitte votre système. Un faux positif est un bug de production. Un faux négatif est plus discret et pire, car rien dans le chemin de la requête ne le signale. Les contrôles de schéma, de plage et de politique sont déterministes. La détection d’injection et de PII repose sur des classifieurs : considérez donc les ratés comme normaux et gardez une évaluation asynchrone qui surveille ce qu’ils laissent passer.
Les évaluations online s’exécutent après la réponse, en général sur un échantillon du trafic. Elles peuvent utiliser des LLM juges plus lents, car elles ne sont pas dans le chemin de la latence. Leur rôle est de détecter la dérive, de trouver de nouveaux groupes de défaillances et d’alimenter le prochain dataset offline.
Les évaluations offline s’exécutent avant la mise en production. Elles sont reproductibles. Elles vérifient prompts, modèles, outils, retrievers et politiques sur un dataset fixe.
Chaque mauvais emplacement a un coût :
- Un juge dans le chemin de la requête ajoute de la latence et une nouvelle source d’instabilité.
- Un garde-fou relégué à une notation asynchrone laisse des violations de politique atteindre les utilisateurs.
Pour les tests de sécurité, distinguez la détection d’une attaque, une action interdite tentée et un effet nuisible qui réussit réellement. Rapportez les effets nuisibles réussis par essai d’attaque, avec le modèle de menace et le budget de tentatives, à côté du taux de réussite des tâches légitimes et des faux blocages par essai bénin. Un score de détecteur seul ne peut pas établir que les données sont restées privées ni qu’une écriture a été empêchée. Utilisez des cibles isolées ; le rapport d’incident d’Anthropic sur les évaluations de cybersécurité montre pourquoi les effets des évaluations doivent être contenus.
Pour les systèmes à fort volume, notez un petit échantillon avec un juge plus solide et un échantillon plus large avec des classifieurs moins chers. Déclenchez des alertes sur des groupes et des bornes de confiance, pas sur une seule estimation bruitée.
Choix des outils
Aucun outil ne couvre toute la boucle. Comparez séparément un magasin de traces et de datasets et un exécuteur CI/évaluation ; un même produit peut couvrir les deux, mais il n’est pas nécessaire d’acheter les deux chez un seul éditeur. La colonne « Couvre » indique quels rôles chaque outil remplit.
| Outil | Couvre | Choisissez-le quand… | Limite ou poste de coût |
|---|---|---|---|
| DeepEval | Exécuteur | Vous exécutez vos contrôles en Python et pytest ; deepeval test run fait échouer le build sur une métrique en échec. | Exécuteur seulement. Les appels au modèle juge coûtent des tokens ; la plateforme hébergée Confident AI facture les données de traces stockées. |
| Inspect AI | Exécuteur | Vous avez besoin de tâches d’agents de sécurité, de pointe ou en sandbox. | Exécuteur seulement, open source. Vous configurez les sandboxes et l’accès aux modèles ; ce n’est pas un magasin de traces de production. |
| Phoenix | Magasin de traces, datasets, exécuteur | Vous exigez un traçage et des évaluations auto-hébergés, avec des données conservées dans votre infrastructure. | Gratuit à auto-héberger ; vous exploitez le déploiement. Arize AX, hébergé, facture les spans, le stockage et la rétention. |
| Langfuse | Magasin de traces, datasets, exécuteur | Vous voulez un workflow open source de traces, datasets et expériences, avec une action CI qui fige une version de dataset et échoue en cas de régression. | Vous exploitez sa pile de stockage en auto-hébergement ; certaines fonctions exigent une licence. Le cloud facture traces, observations et scores. |
| LangSmith | Magasin de traces, datasets, exécuteur | Vous utilisez déjà LangChain/LangGraph et acceptez les limites de sa plateforme. | L’auto-hébergement et l’hébergement hybride exigent Enterprise. Le cloud facture sièges, traces et rétention. |
| Braintrust | Magasin de traces, datasets, exécuteur | Les retours gérés sur les PR et des snapshots d’expériences comparables comptent plus que l’auto-hébergement. | Service géré ; l’auto-hébergement exige Enterprise. Facturation selon les données traitées, les scores et la rétention. |
| Promptfoo | Exécuteur, red team | Les régressions de prompts ou de red teaming doivent s’exécuter avant le déploiement. | Exécuteur et tests de red teaming ; pas de magasin de traces. Open source ; les offres payantes ajoutent des sondes de red teaming et des fonctions d’équipe. |
Les éditeurs facturent selon des unités différentes (traces, spans, scores, sièges, rétention ou données traitées) : comparez donc les tarifs en vigueur sur votre propre volume de traces. Les postes de coût ci-dessus ont été vérifiés sur les pages de tarifs en octobre 2026.
Le choix de l’outil est secondaire. Si les défaillances de production ne deviennent pas des cas de test, vous payez surtout du stockage de traces.
Une checklist pratique de déploiement
Construisez le pipeline de preuves avant d’étendre la pile de métriques. Commencez par décider d’où viendront les exemples.
-
Collectez d’abord les exécutions passées. Si l’agent existe déjà, récupérez les traces, tickets de support, rapports de bugs, sessions avec pouce vers le bas, transcriptions de QA manuelle et notes de dogfooding avant de modifier l’implémentation. Si l’agent n’existe pas encore, journalisez chaque exécution de prototype et de test manuel dès le premier jour.
-
Instrumentez la forme de la trace. Capturez les messages, tool calls, arguments, sorties d’outils, erreurs, nombres de tokens, latence, coût, retours utilisateurs, version de l’application, version du prompt, version du modèle, version du tool schema et état final de l’environnement. Utilisez les conventions OpenTelemetry GenAI ou des spans de type OpenInference si vous voulez de la portabilité, et figez la version de la convention et l’adaptateur. Capturez le contenu de façon sélective : masquez les secrets et les données personnelles, restreignez l’accès et fixez la rétention avant de promouvoir des traces en datasets. Utilisez Langfuse, LangSmith, Phoenix ou Braintrust si vous voulez tout de suite une interface de traces et un workflow de datasets.
-
Transformez les vraies défaillances en cas initiaux. Lisez les traces avant de les résumer avec un modèle. Pour chaque défaillance utile, stockez l’entrée, l’identifiant de la trace source, l’état attendu, les invariants d’outils attendus, le mode de défaillance, la gravité et la note du relecteur. Langfuse peut relier les éléments d’un dataset aux traces de production ; LangSmith peut créer des datasets à partir d’exécutions tracées. Conservez le lien vers la source pour que le cas reste auditable.
-
S’il n’y a pas d’historique, générez des cas de démarrage à froid. Demandez à un LLM de rédiger des tâches à partir des exigences produit, des politiques, des tool schemas, des machines à états et des macros de support. Couvrez les cas nominaux et les défaillances telles que permissions erronées, vérifications d’identité manquantes, tool results périmés, dates ambiguës, nouvelles tentatives après une limite de débit et sorties d’outils contradictoires.
-
Ne faites pas confiance aux cas synthétiques tant qu’un humain ne les a pas relus. Les exemples synthétiques servent la couverture, pas la vérité. Marquez-les avec
source: syntheticet exigez qu’un relecteur approuve le résultat attendu. Exécutez un chemin de référence connu comme correct quand c’est possible, et validez indépendamment les attentes générées ; utiliser une autre famille de modèles ne remplace pas ce contrôle. -
Construisez un petit dataset équilibré. Incluez des succès, des échecs, des refus, des cas limites, des cas à nombreux tours, des cas sensibles à la politique et des chemins alternatifs valides. Ne faites pas du golden « l’ancienne transcription exacte ». Stockez les champs de l’exemple golden présenté sous « Dédupliquer avant de promouvoir », y compris le mode de défaillance qui a fait entrer le cas dans la suite.
-
Ajoutez d’abord des contrôles déterministes. L’ordre des outils requis quand l’ordre est une politique, les arguments requis, la validation de schéma, les différences d’état final, les limites de boucles, les plafonds de tokens et de latence et les invariants propres à la tâche doivent s’exécuter avant tout juge.
-
Ajoutez un juge de forme SGR. Utilisez-le uniquement pour la partie qui demande de l’interprétation. Calibrez-le sur des annotations humaines et testez la grille choisie sur des cas de validation intacts. S’il ne sépare pas les bons et les mauvais exemples sur le jeu de calibration, corrigez la grille avant de le brancher à la CI.
-
Branchez la boucle. Exécutez la petite suite offline en CI, la suite plus large avant la mise en production, notez le trafic de production échantillonné en online et reversez dans le dataset offline les groupes de défaillances online récurrents.
Votre première suite d’évaluation manquera des cas. Exécutez-la quand même, puis ajoutez les défaillances récurrentes comme cas. Une suite qui s’exécute chaque jour vous donne des preuves pour l’améliorer.
Références
- trace2evals companion demo repository
- LangChain - State of Agent Engineering
- Anthropic - Demystifying Evals for AI Agents
- Hamel Husain - A Field Guide to Rapidly Improving AI Products
- OpenTelemetry semantic conventions for generative AI systems
- DeepEval Tool Correctness
- DeepEval Task Completion
- DeepEval unit testing in CI/CD
- Inspect running evals
- OpenAI Structured model outputs
- Schema-Guided Reasoning: vLLM, xgrammar, and Pydantic
- Phoenix self-hosting
- Langfuse datasets and versioning
- Langfuse experiments in CI/CD
- LangSmith platform setup
- LangSmith - Create and manage datasets programmatically
- Braintrust - Create experiments
- Phoenix LLM evals
- Promptfoo GitHub Action integration
- tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- Why Do Multi-Agent LLM Systems Fail?
- Establishing Best Practices for Building Rigorous Agentic Benchmarks
- G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
- Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models
- JudgeBench: A Benchmark for Evaluating LLM-based Judges
- Self-Preference Bias in LLM-as-a-Judge