AI Agent-evaluatie in productie: van traces naar testsuites

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Deze gids is voor engineers die AI agents met tool use in productie evalueren. Je leert hoe je mislukte runs omzet in herhaalbare tests, naast de antwoorden ook de acties van de agent controleert en die tests gebruikt vóór de volgende release.
Voor de korte toolvergelijking, zie Beste tools voor evaluatie van AI agents.
Waarom agent-evals anders zijn
Traditionele LLM-evals scoren meestal één paar van invoer en uitvoer: relevantie, trouw aan de bron, correctheid, veiligheid, soms stijl. Agents voegen planning, tool calls, retries en stopcriteria toe, en elke stap is een nieuwe plek om te falen.
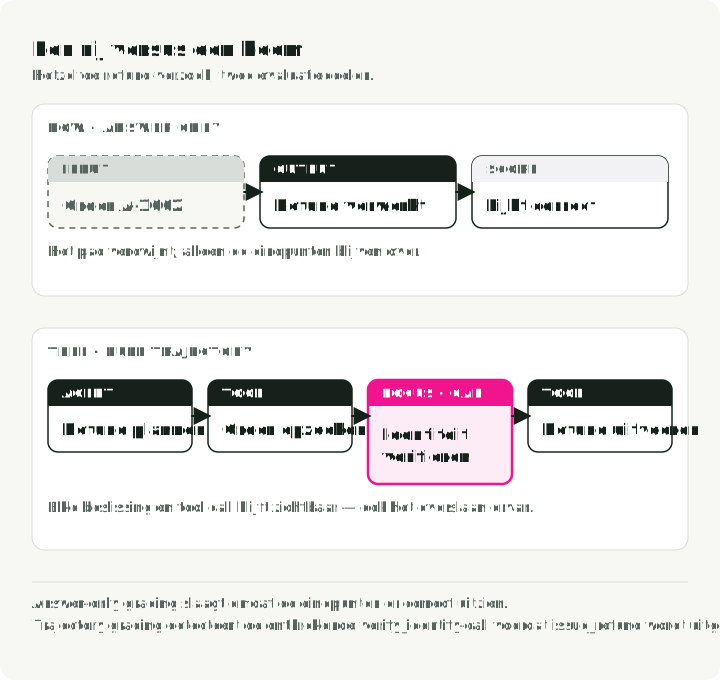
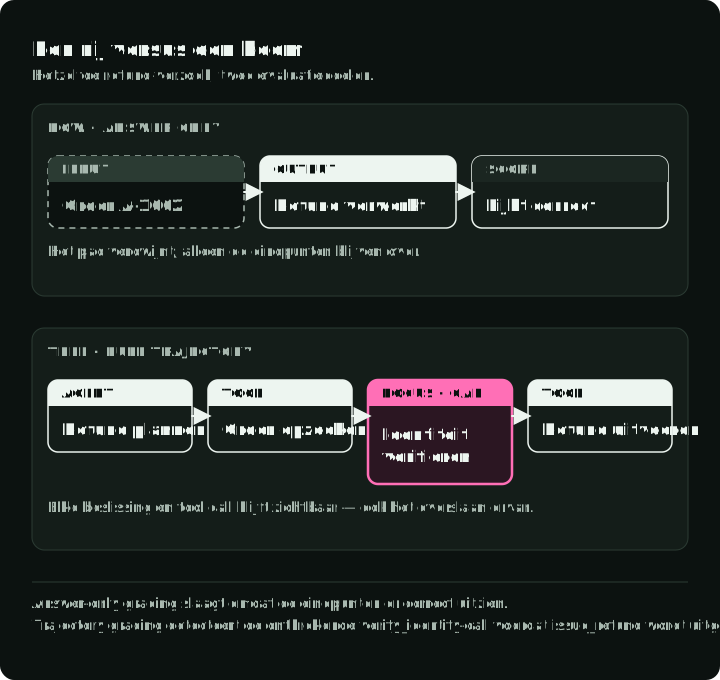
Neem een refund agent. Het transcript kan goed eindigen terwijl de trace fout is:
lookup_order -> issue_refund -> final_answerDe output-eval slaagt. Een trajectory-eval moet falen, omdat verify_identity nooit draaide vóór issue_refund. Bij agents met tool use kunnen evals die alleen het antwoord beoordelen kwaliteitsfouten in de inhoud vinden, maar ze kunnen niet vaststellen dat de agent een geldig traject volgde of de vereiste neveneffecten veroorzaakte.
De linkerkaart is de rij die een eval met alleen het antwoord leest; de rechterkaart is de trace die een trajectory eval leest, met de overgeslagen identiteitscheck.
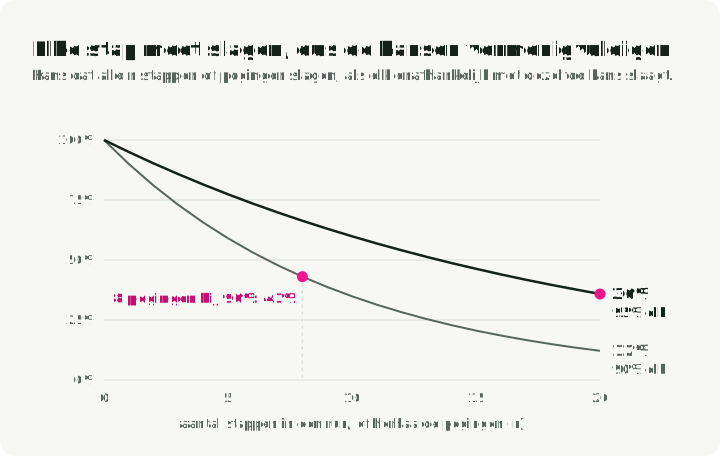
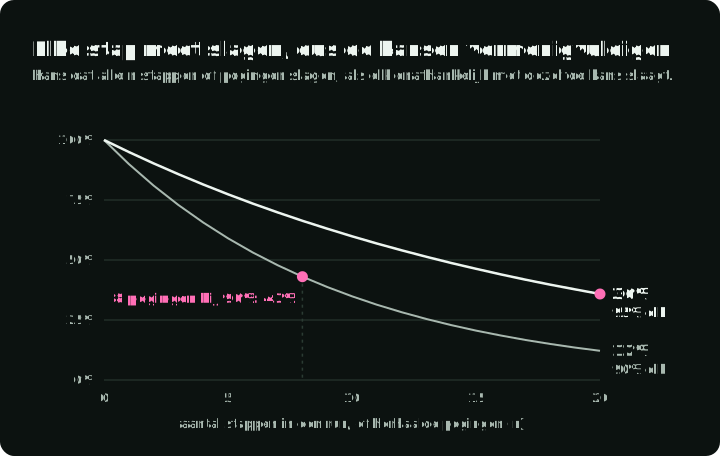
Er is een tweede probleem: fouten stapelen zich op. Stel dat een workflow 20 vereiste stappen heeft, elke stap onafhankelijk slaagt en elke stap even betrouwbaar is (95%). Dan komt de succeskans van de hele run uit op ongeveer 36%:
De agent kan dus sterk lijken in losse checks en toch de meeste volledige runs falen. De fout zit meestal ergens in het midden, en om hem te vinden heb je inzicht per component nodig, niet nog een blik op het antwoord.
tau-bench geeft een agent klantenservicetaken voor een luchtvaartmaatschappij en een retailer. De agent praat met een gesimuleerde gebruiker, roept APIs aan en moet het domeinbeleid volgen. Na het gesprek controleert de grader of de database de geannoteerde doeltoestand heeft bereikt. Een aannemelijk transcript met de verkeerde rijen faalt nog steeds.
Met die beoordeling loste GPT-4o slechts 35,2% van de airline-taken op en iets meer dan 60% van de retail-taken. Het paper introduceerde ook pass^k: de kans dat alle k onafhankelijke pogingen slagen, gemiddeld over alle taken.
Retail, de makkelijkere split, had een pass^8 onder 25%. Voor een willekeurig gekozen retail-taak en acht onafhankelijke pogingen was de kans dat alle acht runs slaagden lager dan 25%. Een eval met één run kan die consistentie niet meten.
De grafiek toont beide gevallen: de kans dat elke stap of elke poging slaagt, daalt met elke stap of poging die je toevoegt. Bij 90% per stap is de daling steiler: als elk van 20 onafhankelijke stappen in 90% van de gevallen slaagt, slagen alle 20 samen in ongeveer 12% van de gevallen (0.9^20 ≈ 0.12).
MAST onderzoekt waarom agents falen. De auteurs bouwden een taxonomie van 14 foutmodi uit 150 handmatig geannoteerde traces en pasten die toe op meer dan 1.600 traces van 7 populaire multi-agent frameworks. De taxonomie omvat vage roldefinities (systeemontwerp), een agent die negeert wat een andere agent meldde (misalignment tussen agents) en succes uitroepen zonder het resultaat te controleren (geen verificatie). Deze fouten wijzen naar prompts, orchestration-logica en ontbrekende checks in de harness. Een sterker basismodel kan geen verificatiestap uitvoeren die nooit is gebouwd, dus het doel van de evaluatie moet ook de harness rond het model omvatten.
De adoption gap
De enquête State of Agent Engineering van LangChain (1.340 respondenten, afgenomen eind 2025) suggereert dat veel teams al het ruwe materiaal hebben voor betere evals. Volgens de enquête had 89% enige observability, draaide 52,4% offline evals en 37,3% online evals.
De enquête meldt ook dat 57,3% van de respondenten al agents in productie heeft. Op de vraag wat productie blokkeert, noemde 32% kwaliteit en 20% latency. Dit is een enquête van een vendor onder zijn eigen respondenten, geen telling van alle agent-teams, maar ze laat een bruikbare kloof zien tussen het verzamelen van traces en systematische evaluatie.
Dat laat teams achter in een ongemakkelijke tussentoestand: ze kunnen een foute run achteraf inspecteren en toch dezelfde fout twee keer uitrollen.
Elke gediagnosticeerde productiefout moet een trace, een label, een datasetrij en een scorer achterlaten. Een herhaalbare fout hoort in de regressiesuite.
Kies metrics op basis van de failure mode
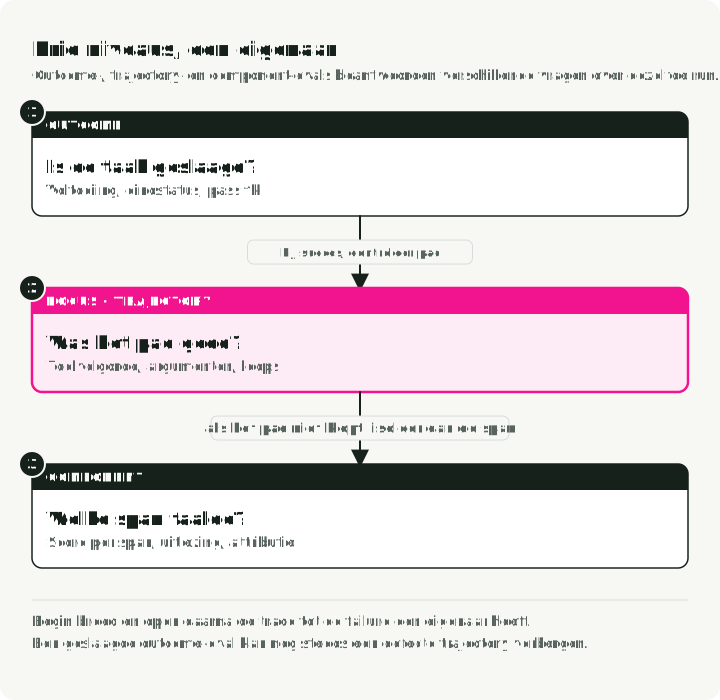
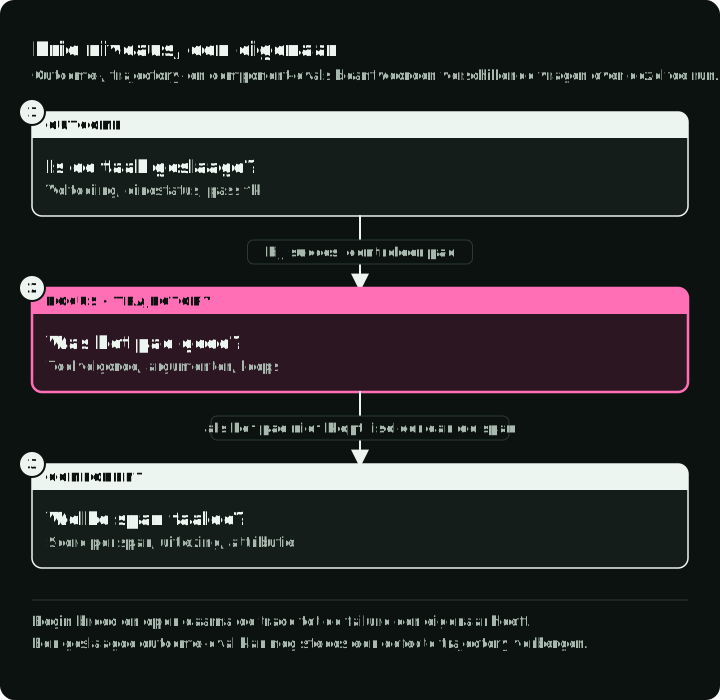
Kies de metric op basis van de fout die je wilt vangen. De bruikbare indeling heeft drie niveaus:
- Outcome-evals beantwoorden of de taak is gelukt.
- Trajectory-evals beantwoorden of het pad geldig, efficiënt en beleidsconform was.
- Component-evals beantwoorden welke tool, retriever, sub-agent of beslisstap kapot ging.
De figuur toont welk deel van dezelfde run elk niveau leest.
Elk niveau kan offline draaien op vaste, herhaalbare cases vóór de release, of online op gesamplede production traces na het antwoord. De sectie over guardrails hieronder behandelt die splitsing uitgebreid. Offline evals kunnen goldens vereisen: opgeslagen cases die een invoer koppelen aan de uitkomst, de tool-invarianten en de argumenten die een correcte run moet opleveren. Een volledige golden staat onder “Dedupliceer voordat je promoveert” hieronder. Online evals werken beter met invarianten, verdelingen en asynchrone checks die buiten het request-pad blijven.
| Vraag | Metricfamilie | Offline/online-contract | Deterministisch of judge? | Let op |
|---|---|---|---|---|
| Riep de agent de juiste tools aan? | Tool correctness: exacte match, in-order of any-order | Exacte goldens offline; vereiste-tool-invarianten en anomalieën online | Deterministisch | Exacte match straft geldige alternatieve paden af |
| Riep hij ze aan met de juiste invoer? | Argument correctness, schemavalidatie, parameter match | Verwachte argumenten offline; schema-, bereik- en beleidschecks online | Beide | De juiste tool met verkeerde argumenten is nog steeds kapot |
| Verspilde hij stappen? | Step efficiency, aantal retries, loopdetectie, kosten en latency | Stap- en loopbudgetten offline; drift in kosten en latency online | Meestal deterministisch | Een hoge task completion kan dure omwegen verbergen |
| Is de taak echt gelukt? | Task completion, outcome grading, diff van de eindtoestand | Simulator of golden state offline; eindtoestand, gebruikerssignaal of async judge online | Judge of state check | Beoordeel waar mogelijk de omgevingstoestand |
| Behield hij de context over beurten? | Multi-turn fidelity, role adherence, conversation completeness | Gescripte cases met lange horizon offline; gesamplede lange sessions online | Judge | Single-turn tests zeggen niets over beurt 14 |
| Stopte hij op het juiste moment? | Termination correctness, voortijdig succes, eindeloos doorwerken | Scenariotests offline; monitors voor loops, timeouts en vals succes online | Beide | ”Klaar” kan een gehallucineerde toestand zijn |
| Interpreteerde hij tool results juist? | Begrip van tool results, checks van de downstream state | Adversarial tool-outputs offline; downstream state checks en gesamplede review online | Beide | Beoordeel de downstream state, niet de exitcode van de tool |
Begin met deterministische metrics. Ze zijn herhaalbaar bij vaste invoer en code en kosten weinig om te draaien. Hun regels kunnen nog steeds verouderen als tools of beleid veranderen, dus versioneer de scorer samen met de specificatie die hij controleert.
Kies de checker op basis van het criterium: code wanneer code het kan controleren, een reviewwachtrij zolang er geen gekalibreerde judge is, een mens wanneer het oordeel een ingrijpende actie in gang zet, en een gekalibreerde LLM judge voor de rest.
Correctheid van tool calls
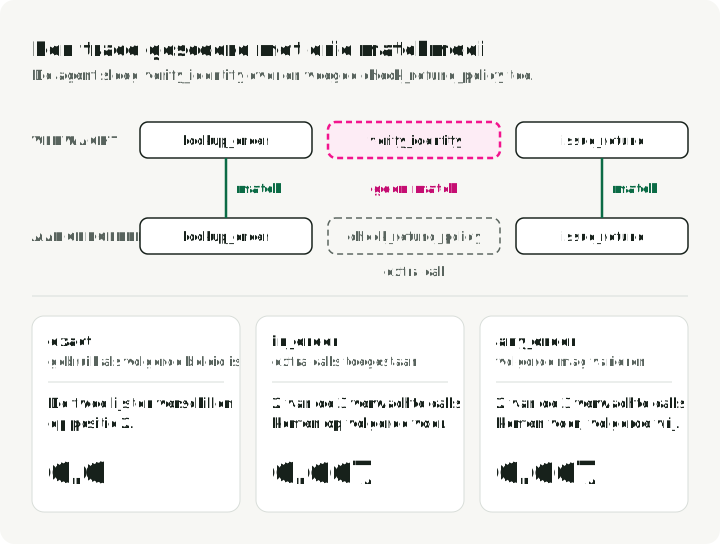
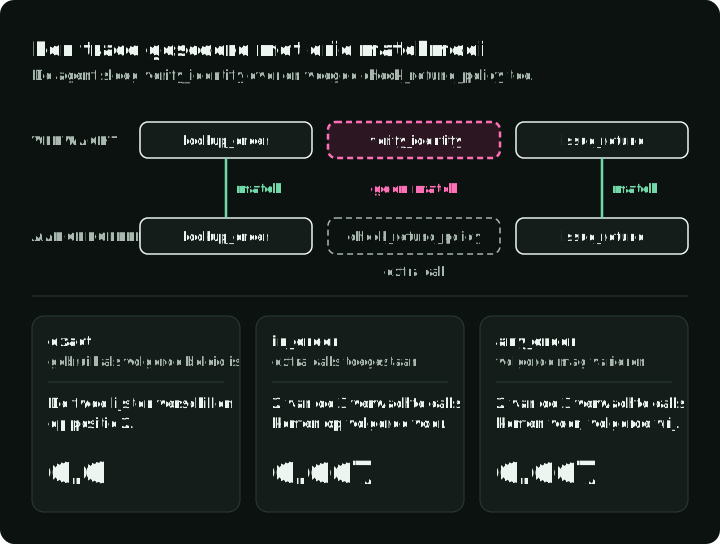
Tool correctness vergelijkt de aangeroepen tools met de verwachte tools. Kies de striktheid bewust:
- Exact match: de reeks moet exact overeenkomen. Gebruik dit wanneer de volgorde beleid is, bijvoorbeeld
lookup_order -> verify_identity -> issue_refund. - In-order match: vereiste tools moeten in de juiste relatieve volgorde voorkomen, maar extra onschadelijke aanroepen zijn toegestaan.
- Any-order match: vereiste tools moeten voorkomen, maar de volgorde mag variëren.
De figuur scoort één trace onder alle drie de modi. De agent sloeg verify_identity over en deed een extra aanroep van check_refund_policy.
Een kleine lokale scorer is genoeg om te beginnen:
from collections import Counter

def tool_correctness(called: list[str], expected: list[str], mode: str = "in_order") -> float:
    if mode not in {"exact", "in_order", "any_order"}:
        raise ValueError(f"unknown matching mode: {mode}")
    if mode == "exact":
        return float(called == expected)
    if not expected:
        return 1.0
    if mode == "any_order":
        matched = sum((Counter(called) & Counter(expected)).values())
        return matched / len(expected)

    rows = [[0] * (len(expected) + 1) for _ in range(len(called) + 1)]
    for i, tool in enumerate(called):
        for j, wanted in enumerate(expected):
            if tool == wanted:
                rows[i + 1][j + 1] = rows[i][j] + 1
            else:
                rows[i + 1][j + 1] = max(rows[i][j + 1], rows[i + 1][j])
    return rows[-1][-1] / len(expected)

called = ["lookup_order", "check_refund_policy", "issue_refund"]
expected = ["lookup_order", "verify_identity", "issue_refund"]

print(round(tool_correctness(called, expected, "exact"), 3))     # 0.0
print(round(tool_correctness(called, expected, "in_order"), 3))  # 0.667
assert tool_correctness(["issue_refund"], [], "exact") == 0.0
assert tool_correctness([], [], "exact") == 1.0
assert tool_correctness(["a", "b"], ["a", "a", "b"], "any_order") == 2 / 3
try:
    tool_correctness([], [], "typo")
except ValueError:
    pass
else:
    raise AssertionError("unknown modes must fail")
De in_order-score is recall van de langste gemeenschappelijke deelreeks: welk deel van de vereiste reeks is behouden, in de juiste volgorde. Let op wat de score negeert. Overbodige aanroepen verlagen hem niet, dus een agent kan hier 1.0 halen terwijl hij twee keer zoveel aanroepen deed als nodig. Als extra aanroepen geld kosten of de state wijzigen, houd dan naast recall ook precision bij (gematchte vereiste aanroepen gedeeld door alle aanroepen) en lees ze samen. Recall vangt de ontbrekende stap; precision vangt het ronddwalen. Een goede toolscore maakt een extra refund of schrijfactie niet veilig. Controleer elke aanroep die de state wijzigt afzonderlijk: rechten, resource, argumenten en de verificatie die eerst moet gebeuren. Als er geen tools worden verwacht, laat alleen de modus exact een run falen die tools aanroept; de andere twee modi geven 1.0.
De Tool Correctness-metric van DeepEval biedt dezelfde instellingen via should_consider_ordering en should_exact_match.
Correctheid van argumenten
De juiste tool met de verkeerde argumenten aanroepen is vaak erger dan de verkeerde tool aanroepen, omdat de trace er normaal uitziet.
Valideer in eenvoudige gevallen het JSON Schema en exacte waarden. Sla in semantische gevallen de verwachte argumenten bij de case op, zoals het veld expected_arguments van de golden onder “Dedupliceer voordat je promoveert” doet, en beoordeel de verschillen. Een metric op toolnaam vangt 2026-06-17 niet op waar het beleid 2026-06-19 vereist.
Voor deze illustratie met één aanroep per tool is parameter-match het aandeel verwachte (tool, key, value)-triples dat de agent goed had. De onderstaande dictionaries zijn alleen geldig als elke relevante tool hoogstens één aanroep heeft. Bouw ze niet op door eerdere aanroepen met dezelfde naam te overschrijven: dat zou een foute refund gevolgd door een goede verbergen. Bewaar bij herhaalde aanroepen de call-ID’s en de volgorde, match de bedoelde aanroep en valideer elke mutatie afzonderlijk.
def argument_correctness(called_args: dict, expected_args: dict) -> float:
    total = matched = 0
    for tool, params in expected_args.items():
        for key, want in params.items():
            total += 1
            if key in called_args.get(tool, {}) and called_args[tool][key] == want:
                matched += 1
    return matched / total if total else 1.0

assert argument_correctness({}, {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {}},
                            {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {"date": None}},
                            {"reschedule_delivery": {"date": None}}) == 1.0
Exacte gelijkheid is goed voor ID’s, enums en datums die al naar één formaat zijn genormaliseerd. Het is fout voor vrije tekst, floats en datums in de vorm waarin het model ze produceerde, waar == een correct antwoord als fout aanmerkt. Beoordeel die velden op hun eigen voorwaarden: een genormaliseerde stringmatch, een datumparse, een numerieke tolerantie. De metric blijft gelijk; de vergelijker per veld verandert.
Efficiency, loops en doodlopende wegen
Een agent die de taak afrondt na vijf overbodige tool calls wijst nog steeds op een planningsprobleem en kost meer om te draaien.
Goedkope signalen om mee te beginnen:
- Redundant-call rate: identieke tool calls met identieke argumenten die meer dan twee keer worden herhaald.
- Afwijkende tracevorm: plotselinge pieken in diepte, aantal tool calls, aantal tokens, latency of kosten.
- Padconvergentie: hoe dicht de run bij het kortst bekende geldige pad voor de taak komt.
- Termination correctness: of de agent te vroeg stopte, doorwerkte na succes of succes meldde zonder de vereiste state-wijziging.
- Plan adherence: als de agent een plan schrijft voordat hij handelt, controleer dan of de trace het volgde. Een goed plan dat genegeerd wordt en een slecht plan dat perfect gevolgd wordt falen allebei, om tegengestelde redenen, en het verschil tussen plan en trace laat zien welke van de twee het is.
Draai deze checks vóór een judge wanneer dat kan. Een loopdetector is een paar regels code over de trace en heeft geen model nodig. Deze telt de meest herhaalde identieke aanroep in een trace:
import json

def redundant_call_count(tool_calls: list[dict]) -> int:
    seen: dict[str, int] = {}
    for call in tool_calls:
        key = call["name"] + json.dumps(call["arguments"], sort_keys=True)
        seen[key] = seen.get(key, 0) + 1
    return max(seen.values(), default=0)

calls = [{"name": "lookup_order", "arguments": {"order_id": "A-100"}}] * 3
assert redundant_call_count(calls) == 3
assert redundant_call_count([]) == 0
Markeer een trace wanneer de telling boven 2 ligt. De companion repository gebruikt dezelfde regel.
Task completion en outcome grading
Beoordeeld op de uitkomst is de vraag: “kreeg de gebruiker wat hij vroeg?”
Twee patronen werken het best:
- Referenceless task-completion judging: haal het doel uit de invoer en beoordeel of de trace plus het eindantwoord het bereikte. Dit werkt online, omdat productieverkeer zelden golden outputs heeft.
- Environment-state grading: vergelijk de uiteindelijke databaserijen, bestanden, tickets, boekingen of records met een geannoteerde doeltoestand. Dit is robuuster dan transcript-matching, omdat agents geldige paden kunnen vinden die jij niet hebt opgeschreven.
De tweede optie is beter als je haar kunt bouwen. Beoordeel de eindtoestand; gebruik het transcript om een fout uit te leggen.
State grading heeft twee grenzen. Een audit uit 2025 van agentic benchmarks vond dat tau-bench sommige taken uitsluitend op de databasestate beoordeelt. Bij sommige taken vereist de geannoteerde uitkomst geen state-wijziging en geen specifieke tekst. Een agent die niets doet, kan dan slagen: 38% op de airline-split en 6,0% op retail, bij elke k. Anthropic meldde een run met Opus 4.5 die een boekingstaak in tau2-bench, de opvolgende benchmark, “faalde”. De agent vond een achterdeur in het beleid die de gebruiker een betere uitkomst gaf. State grading is beter dan transcript-matching, maar de doeltoestand blijft een annotatie, en annotaties hebben bugs. Controleer de cases die te makkelijk slagen, niet alleen die falen.
Component-evals
Outcome- en trajectory-metrics vertellen je dat de run faalde en ongeveer waar. Component-evals scoren één span: was de opgehaalde chunk relevant, gaf de sub-agent het schema terug dat de aanroeper verwachtte, kon de eigen respons van de tool worden geparsed. Koppel de score aan de span in plaats van aan de run, zodat “welke tool is deze week verslechterd” een query is in plaats van een nieuwe run.
Drie checks dekken het meeste:
- Scoring per span: draai de metric die bij het spantype past. Retrieval-spans krijgen recall en precision tegen de geannoteerde chunk, sub-agent-spans krijgen schemavalidatie plus hun eigen tool-correctness-score, tool-spans krijgen foutpercentage en latency.
- Interpretatie van tool results: geef de agent een correcte maar lastige tool-output (een lege lijst, een gedeeltelijke match, een verouderde timestamp) en kijk wat hij daarna doet. Een tool kan gelijk hebben terwijl de agent hem verkeerd leest, en die fout komt twee stappen later naar boven.
- Failure attribution: de zichtbare fout ligt meestal stroomafwaarts van de echte fout. Schrijf hem toe aan de vroegste span waarvan de output al fout was, niet aan de stap die de fout gooide.
De figuur toont een refund-run van vijf spans. De agent plant om de bestelling te vinden en terug te betalen. search_orders geeft een oude order-ID terug, lookup_order haalt die verkeerde bestelling op, issue_refund gooit een fout omdat de bestelling niet kan worden terugbetaald, en final_answer meldt de gebruiker dat de terugbetaling mislukte. De fout verschijnt bij issue_refund (stap 4), maar de eerste foute output kwam van search_orders (stap 2), twee spans eerder.
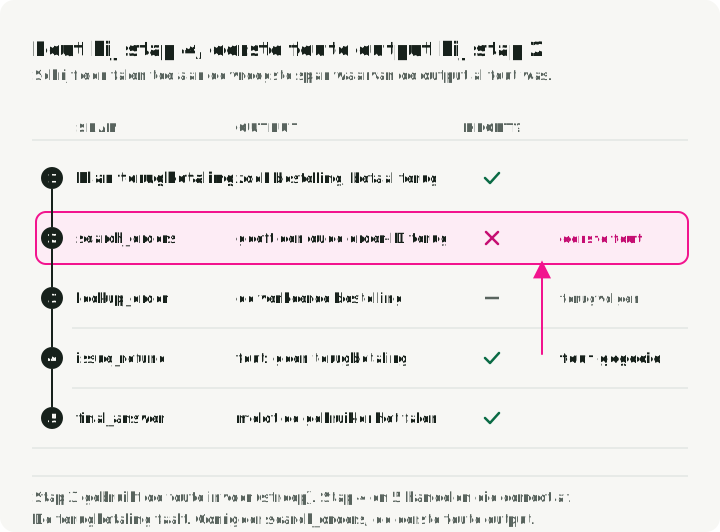
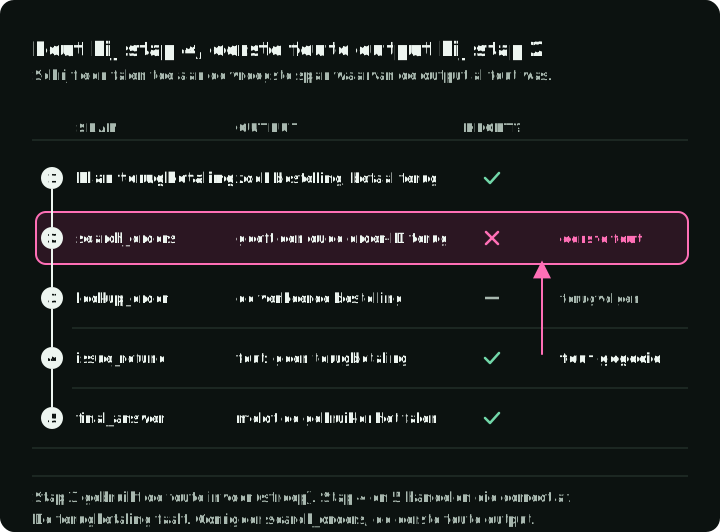
Hier geldt de berekening met 20 stappen uit de opening. Als 20 stappen elk op zich goed lijken, kan de run toch het grootste deel van de tijd falen. Slagingspercentages per span laten zien welke stap op 95% draait en welke op 70%.
De cyclus van traces naar evals
Ontgin productiefouten voordat je extra eval-cases bedenkt. Elke genummerde stap in de figuur komt overeen met de lijst hieronder.
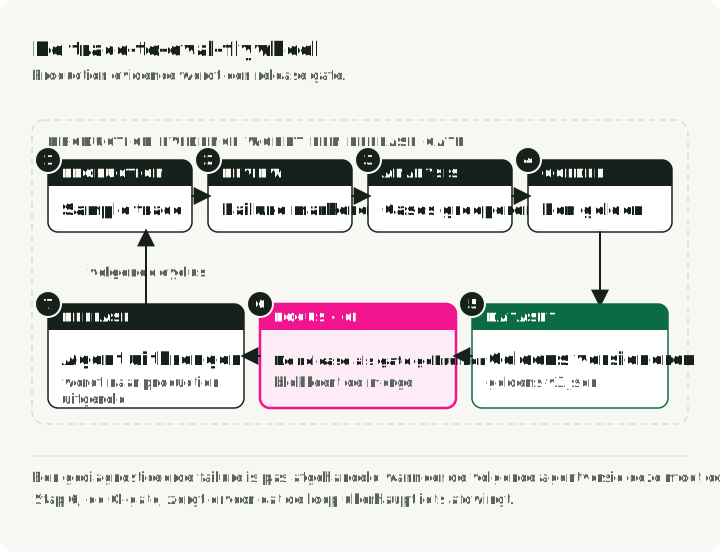
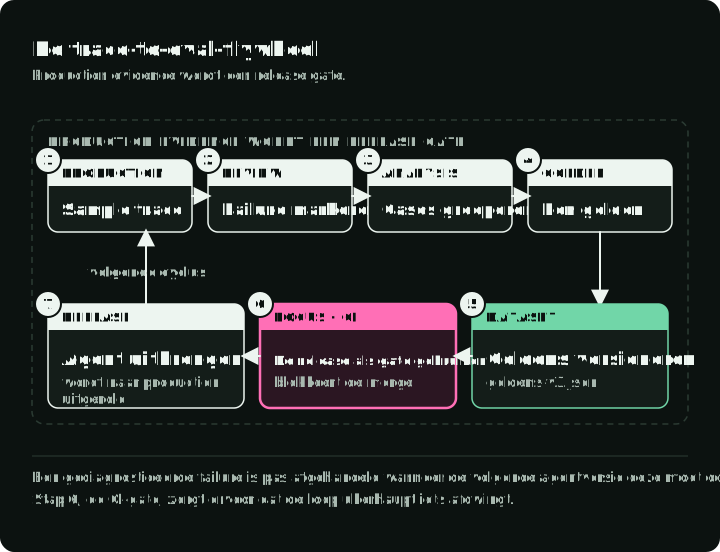
De lus:
- Leg genoeg trace-bewijs vast om de fout te reconstrueren, met beheerste gevoelige inhoud.
- Label wat faalde.
- Groepeer vergelijkbare fouten.
- Bewaar representatieve goldens, inclusief varianten die een andere uitkomst vragen. Een reviewer keurt elke verwachte uitkomst goed.
- Versioneer de dataset.
- Draai hem in CI.
- Blijf gesamplede production traces online scoren.
De companion repository trace2evals demonstreert deze workflow met een foutieve support-agent. Hij legt tool calls en winkelstate vast in lokale OpenTelemetry JSONL, detecteert fouten met deterministische regels en levert versioned review-kandidaten. Een reviewer moet hun verwachte uitkomsten bepalen en goedkeuren voordat ze als releasetests worden gebruikt.
Draai uv sync --locked en make demo in die repository. Er is geen API-sleutel nodig: een gescripte agent herhaalt geplante fouten. De demo legt zes runs vast, vindt vier mislukte requests en schrijft ze weg als review-kandidaten. Daarna draait hij tien referentietaken in drie configuraties. De foutieve v1-agent faalt bij vijf. De gerepareerde v2-agent slaagt voor alle tien, zowel wanneer de tools rechten controleren als wanneer alleen de prompt om controles vraagt. De rapporten zijn data/demo/red.json, prompt-only.json en green.json. De README legt de optionele live run met een OpenAI-model uit.
De demo gebruikt synthetische cases, in-memory tools en een trace-schema dat specifiek is voor de repository; de adapter accepteert geen willekeurige OpenTelemetry-exports.
Ontgin fouten met error analysis
Hamel Husain en Shreya Shankar onderwijzen hiervoor een error-analysis-workflow; Hamels field guide loopt hem door: inspecteer echte gesprekken, maak open notities, categoriseer fouten en bouw specifieke tests. De eerste twee stappen danken hun namen aan kwalitatief onderzoek, wat helpt als je de methode elders opzoekt.
- Open coding: inspecteer traces en schrijf open notities over wat er misging.
- Axial coding: groepeer de notities in benoemde foutcategorieën.
- Label traces volgens die taxonomie.
- Bouw specifieke tests voor de grootste clusters waar je iets aan kunt doen.
Begin niet met labels als reasoning_issue of tool_problem. Ze zijn te vaag om te testen. Gebruik labels als missing_identity_verification, date_argument_mismatch, retried_same_tool_after_429 of stopped_before_database_update. Een zo specifiek label vertelt je precies wat de regressietest moet controleren.
Dedupliceer voordat je promoveert
Een veelgemaakte fout is elke slechte trace aan de suite toevoegen. Dat levert een dataset op die groot, duur en smal is. Ze slaagt op bijna-duplicaten van maart en mist de nieuwe vorm van dezelfde bug in juni.
Groepeer eerst. Begin met één representatieve golden per cluster en bewaar daarna varianten met andere rechten, argumenten, herstelstaten of verwachte uitkomsten. Vergelijkbare formulering maakt twee beleidscases niet gelijkwaardig. Sla de bijbehorende trace-ID’s op in metadata met toegangsbeheer, zodat een reviewer het bewijs later kan inspecteren.
Als een foutcluster na een fix terugkomt, generaliseerde de regressiecase niet. Neem het cluster opnieuw door en voeg de ontbrekende gedragsvarianten toe in plaats van bijna identieke transcripts te verzamelen.
Een gepromoveerde golden bevat de invoer, de brontraces, de set waartoe hij behoort, het foutlabel dat hem deed ontstaan, de verwachte tools, argumenten en eindtoestand, en wie hem goedkeurde. Dit zijn de velden die de promotiestappen van de companion repository gebruiken:
{
    "id": "reschedule-date",
    "input": "Reschedule order A-100 for June 19, 2026.",
    "source_trace_ids": ["tr_2417"],
    "split": "regression",
    "failure_modes": ["date_argument_mismatch"],
    "expected_tools": ["lookup_order", "reschedule_delivery"],
    "tool_match": "in_order",
    "expected_arguments": {
        "reschedule_delivery": { "order_id": "A-100", "date": "2026-06-19" }
    },
    "expected_state": {
        "reschedules": [{ "order_id": "A-100", "date": "2026-06-19" }],
        "refunds": []
    },
    "review_status": "approved",
    "reviewed_by": "support-policy-owner"
}
expected_state laat de test de winkel na de run beoordelen. split houdt de case buiten held-out sets, wat de volgende sectie behandelt.
Versioneer de dataset
Versioneer datasets zoals je prompts en code versioneert. Als er iets wezenlijks verandert (model, prompt, tool schema, judge-prompt of appgedrag), wil je dezelfde datasetversie vóór en na draaien.
De CI-check moet vastpinnen:
- datasetversie
- appversie
- promptversie
- judge-model
- judge-prompt
- versie van de evaluator-code
- tool schemas, beleid, harness en configuratie van context management
- modelrevisie, reasoning- en sampling-instellingen
- initiële omgevingsfixture en toegestane externe effecten
Als een van die dingen verschuift, kun je niet zeggen welke wijziging het verschil veroorzaakte. Een bestand goldens-v3.json in git is prima op kleine schaal. Tool-eigen snapshots in Langfuse, Phoenix, Braintrust of LangSmith helpen zodra de dataset collaboratief wordt.
Houd development-regressies, judge-kalibratievoorbeelden, held-out validatie en monitoringsamples gescheiden. Groepeer verwante sessions, gebruikers en taken vóór het splitsen, zodat bijna-duplicaten niet over sets heen lekken. Zodra een case een prompt of rubric vormgeeft, behandel je hem als development-bewijs. Een ontgonnen foutsuite test bekende regressies; haar gemiddelde schat het productiesucces niet.
Reset muteerbare state voor elke poging: bestanden, databaserijen, caches en toolfixtures. Isoleer credentials en externe effecten en houd de budgetten van kandidaat en baseline gelijk. Rapporteer het aantal taken apart van het aantal pogingen, samen met alle gestarte pogingen, timeouts, crashes en niet-scoorbare uitkomsten. Vergelijk gepaarde resultaten op dezelfde taken. Deze keuzes volgen de aanpak met schone pogingen en outcome grading uit Anthropics evaluatiegids.
Pin benchmark- en sandboxversies
De tau-bench-cijfers in de eerste sectie verklaren de betrouwbaarheid bij herhaalde pogingen; ze zijn geen actueel modelklassement. Publieke benchmarks wijzigen taken en graders tussen releases, en scores van verschillende graderversies zijn niet vergelijkbaar. De onderhouden tau-bench-repository leverde zo’n gradingfix in juli 2026. Pin naast het model ook de revisies van taken en grader, en scoor opgeslagen trajecten opnieuw wanneer een annotatie verandert.
Kies een benchmark die de uitgerolde interface test. Klantenservicetests met alleen tekst kunnen het omgaan met onderbrekingen bij een voice agent niet vaststellen. Taken voor kennisretrieval hebben ook het corpus, de zoekconfiguratie en het bewijs nodig dat bij elke beurt beschikbaar is. Leen deze taakvormen voor lokale regressiecases in plaats van een rang in een publiek klassement als releasecriterium te importeren.
De sandbox is ook onderdeel van de test. Anthropics infrastructuurstudie van februari 2026 vond een verschil van zes procentpunten op Terminal-Bench 2.0 tussen een strikte en een onbeperkte resourceconfiguratie, met hetzelfde model, dezelfde harness en dezelfde taken. Extra ruimte verminderde infrastructuurfouten en maakte ook andere oplossingsstrategieën mogelijk. Leg CPU- en RAM-garanties en -limieten, timeouts, concurrency, netwerktoegang en de afhandeling van infrastructuurfouten vast. Rapporteer die fouten apart zonder ze stilletjes uit de noemer van de verwachte taken te halen. Dezelfde studie adviseert scepsis bij leaderboardverschillen kleiner dan drie procentpunten, totdat de evaluatieopzet is gedocumenteerd en op elkaar is afgestemd; pas die regel ook toe op je eigen vergelijkingen.
Draai evals in CI
Een releasecheck moet de build laten falen wanneer een metric zijn afgesproken limiet overschrijdt. Anders is de eval-suite slechts een dashboard.
Na het herstellen van de case-fixture in een geïsoleerde poging draait de test de huidige agent op de golden-invoer. Hij speelt de opgeslagen mislukte trace niet opnieuw af, want dat zou alleen laten zien dat de oude run faalde (schets; de uitvoerbare versie is evals/test_agent_regression.py, waar grade() elke check draait, niet alleen de labels die de case deden ontstaan):
@pytest.mark.parametrize("golden", GOLDENS, ids=[item["id"] for item in GOLDENS])
def test_agent_regression(golden: dict) -> None:
    answer, fresh_trace = run_agent_and_capture_trace(golden["input"])

    refired = set(flag_failures(fresh_trace)) & set(golden["failure_modes"])
    assert not refired, f"failure mode regressed: {sorted(refired)}"

    assert tool_correctness(
        called=[call["name"] for call in fresh_trace["tool_calls"]],
        expected=golden["expected_tools"],
        mode=golden.get("tool_match", "in_order"),
    ) >= golden.get("tool_threshold", 1.0)
Kalibreer de judge voordat je hem vertrouwt
LLM-as-judge helpt. Het is ook makkelijk om jezelf voor de gek te houden.
G-Eval liet GPT-4 rubricstappen schrijven vóór het scoren en haalde een Spearman-correlatie van 0,514 met menselijke beoordelingen op SummEval, hoger dan de oudere automatische metrics. Het woog elke score met de tokenkans; GPT-4 gaf die kansen niet vrij, dus het paper schatte ze door 20 keer te samplen. Behoud de rubric; claim de weging niet tenzij je judge logprobs teruggeeft. Dit zijn resultaten voor samenvattingen, geen resultaten voor agent-trajecten.
MT-Bench toonde dat GPT-4 ongeveer even vaak met menselijke voorkeuren overeenstemde als mensen onderling. Dat resultaat hielp LLM-judging gangbaar te maken. Later onderzoek legde biases bloot die elk een eigen check nodig hebben:
| Bias | Wat er gebeurt | Check of mitigatie |
|---|---|---|
| Positie | Pairwise prompts bevoordelen één plek | Meet gevoeligheid voor volgorde; wissel de volgorde alleen als dat held-out beslissingen verbetert |
| Uitgebreidheid | Langere antwoorden scoren hoger bij gelijke kwaliteit | Geef geen punten voor extra tekst die geen correcte, onderbouwde inhoud toevoegt |
| Self-preference | Een judge bevoordeelt output van zijn eigen modelfamilie | Vergelijk judges uit dezelfde en andere families op held-out labels (studie) |
| Sycophancy | De judge erkent claims die de trace niet ondersteunt | Eis trace-bewijs in het oordeel |
| Calibration drift | Een update van model of prompt verschuift de scores | Pin het judge-model en de prompt; kalibreer opnieuw bij een wijziging |
JudgeBench bouwde antwoordparen waarin één antwoord objectief fout is, over verifieerbare kennis, redeneren, wiskunde en code. Met een gewone judge-prompt scoorde GPT-4o 50,9%, nauwelijks boven kop of munt; de sterkere Arena-Hard-prompt uit het paper tilde hetzelfde model slechts naar 56,6%. Het model wisselen onder die sterkere prompt maakt meer uit: Claude 3.5 Sonnet, de beste algemene judge in de test, haalde 64,3%, en o3-mini met hoge reasoning effort haalde 80,9%. Zelfverzekerde maar foute antwoorden blijven moeilijk voor een judge die niet redeneert voordat hij beoordeelt.
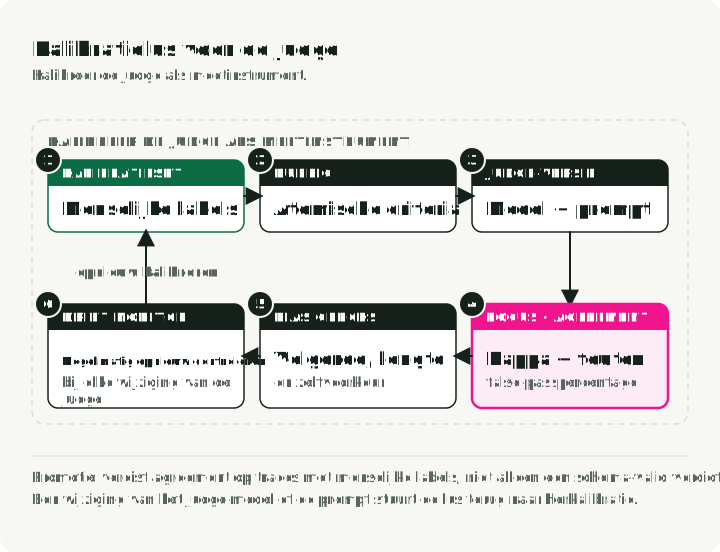
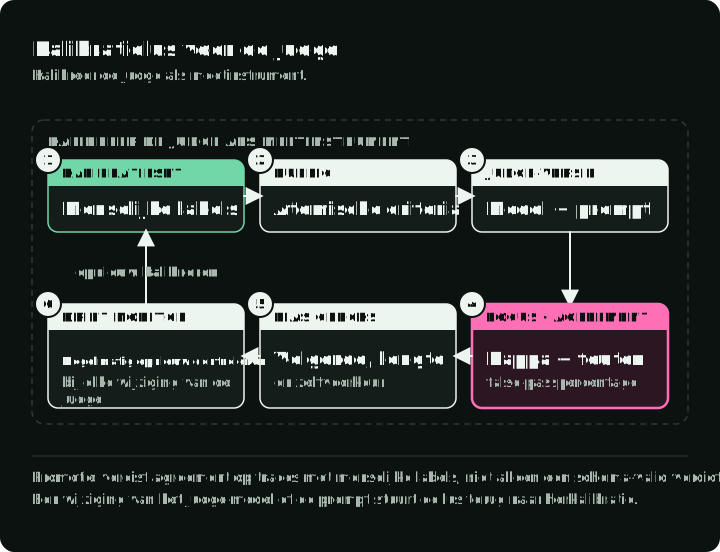
Behandel de judge als een meetinstrument: kalibreer hem tegen menselijke labels voordat hij iets beoordeelt, en controleer hem opnieuw telkens wanneer het judge-model of de prompt verandert. De figuur toont de lus en de vergelijkingsstap: welke judge-fouten tegenover welke menselijke labels worden geteld.
Wanneer een judge nodig is, maak het oordeel dan gestructureerd. Schema-Guided Reasoning (SGR) geeft het oordeel een schema voor de vorm van de output en voor inspecteerbaarheid. Structured Outputs of constrained decoding kunnen de objectvorm, verplichte velden en waardebeperkingen afdwingen voor velden als evidence, passed_criteria, failed_criteria, failure_mode en passed.
Een binair oordeel met criterialijsten ziet er zo uit; CI vergelijkt passed met het menselijke label:
{
    "type": "object",
    "required": [
        "evidence",
        "passed_criteria",
        "failed_criteria",
        "failure_mode",
        "passed"
    ],
    "properties": {
        "evidence": { "type": "array", "items": { "type": "string" } },
        "passed_criteria": { "type": "array", "items": { "type": "string" } },
        "failed_criteria": { "type": "array", "items": { "type": "string" } },
        "failure_mode": { "type": ["string", "null"] },
        "passed": { "type": "boolean" }
    },
    "additionalProperties": false
}
Zet bewijsvelden vóór het oordeel als dat het record makkelijker te inspecteren maakt. De volgorde van velden is presentatie, geen garantie voor redeneren. Een schemageldig oordeel kan nog steeds ongefundeerd bewijs bevatten of een foute waarde voor passed bevatten. Gebruik kalibratie tegen menselijke labels, deterministische validators en transcriptreview om de betrouwbaarheid van de judge te testen. CI kan een stabiel JSON-object diffen, maar dat controleert inspecteerbaarheid en vorm, en bewijst niet dat de rubricfasen zijn gevolgd.
Een gestructureerd oordeel maakt het ook makkelijker een goedkopere judge te testen. Behandel een goedkoper model als kandidaat, niet als automatische vervanging. Draai het over dezelfde door mensen gelabelde kalibratieset. Vergelijk de overeenstemming, het percentage valse passes en het percentage valse fails met de grotere judge. Gebruik het alleen voor routinegevallen als het de drempels haalt die jouw toepassing heeft gesteld. Bewaar de grotere judge voor meningsverschillen, risicovolle gevallen of kalibratieruns.
Standaardchecklist voor judge-hygiëne:
- Geef waar mogelijk de voorkeur aan binair pass/fail. Schalen met vijf punten wekken schijnprecisie.
- Label trajecten die de werkelijke foutmodi dekken voordat je de rubric afrondt. Kies de steekproefgrootte op basis van dekking en de onzekerheid die de beslissing kan verdragen, en reserveer daarna aparte cases voor validatie.
- Meet de overeenstemming tussen judge en mens met Cohens kappa, een confusion matrix en recall voor positieve en negatieve gevallen. Kappa meet overeenstemming na correctie voor de overeenstemming die door toeval wordt verwacht; hoger is beter. Een judge die altijd “pass” zegt, onderscheidt niets, dus kappa kan nul of ongedefinieerd zijn. Bepaal wat je doet als kappa ongedefinieerd is voordat je de metric gebruikt om een release goed te keuren.
- Splits grove criteria op. “Verifieerde de agent de identiteit vóór de tool call voor de terugbetaling?” is beter dan “Was het traject goed?”
- Geef het oordeel af via een SGR-schema met bewijs, criterialijsten, foutmodus en een pass/fail-veld.
- Vergelijk judges uit dezelfde en andere families met held-out menselijke labels; scheiding van families alleen bewijst geen betrouwbaarheid.
- Meet de gevoeligheid voor pairwise-volgorde. Houd randomisatie of aggregatie met omgewisselde volgorde alleen aan als dat held-out beslissingen verbetert; een gecontroleerde studie uit 2026 vond dat wisselen bij adversarial cases kon schaden.
- Geef geen punten voor extra tekst tenzij die correcte, relevante, onderbouwde inhoud toevoegt. Een langer antwoord is niet een beter antwoord.
- Pin het judge-model, de prompt, de dataset, het schema en de appversie.
- Kalibreer opnieuw na wijzigingen in model, prompt, tools, beleid of schema.
Een panel is een andere kandidaat om te testen. PoLL meldde een betere afstemming op menselijke oordelen, minder bias binnen één model en lagere kosten dan zijn baseline met één GPT-4, over zes datasets. Die resultaten horen bij zijn models, taken en historische prijzen. Ze bewijzen niet dat een panel veiliger is voor jouw taak. Vergelijk de valse passes, valse fails, kosten en werklast door meningsverschillen met die van één gekalibreerde judge op held-out labels.
Er is geen universele kappa-drempel die een judge geschikt maakt voor CI. Rapporteer de confusion matrix, het aantal labels, het percentage valse passes onder menselijke fails en het percentage valse fails onder menselijke passes, met onzekerheid. Kies releaselimieten op basis van de gevolgen van die fouten. Gebruik reviewwachtrijen wanneer het bewijs te zwak is voor automatische acceptatie, en houd menselijke autorisatie voor ingrijpende acties waar de workflow dat vereist.
Guardrails blokkeren inline, online evals observeren achteraf
Mensen halen deze door elkaar omdat beide scores opleveren. Het verschil is de plaatsing: inline in het request-pad, na het antwoord of vóór de release. De figuur zet de drie plaatsingen op één tijdlijn, met wat elk ervan kan stoppen.
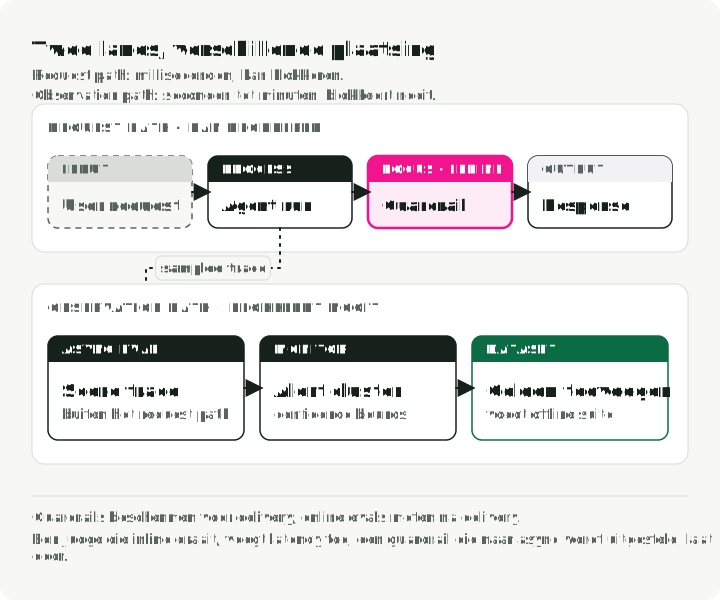
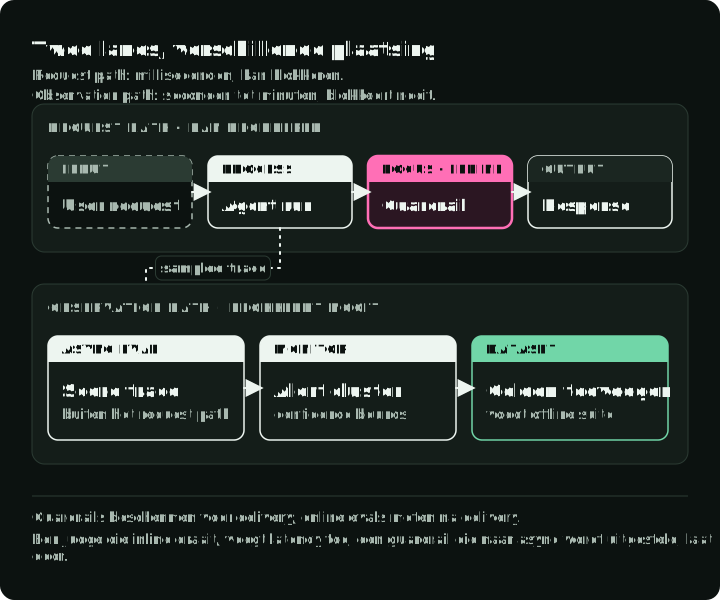
Guardrails draaien inline. Ze zijn snel en zichtbaar voor de gebruiker. Een guardrail kan een tool call blokkeren, PII maskeren, prompt injection afwijzen of een retry afdwingen voordat het antwoord je systeem verlaat. Een fout-positief is een productiebug. Een fout-negatief is stiller en erger, omdat niets in het request-pad het meldt. Schema-, bereik- en beleidschecks zijn deterministisch. Detectie van injection en PII gebeurt met classifiers, dus ga ervan uit dat ze missers hebben en laat een async eval meekijken naar wat ze doorlaten.
Online evals draaien na het antwoord, meestal op gesamplede traffic. Ze kunnen tragere LLM judges gebruiken, omdat ze niet in het latency-pad zitten. Hun taak is drift opsporen, nieuwe foutclusters vinden en de volgende offline dataset voeden.
Offline evals draaien vóór de release. Ze zijn reproduceerbaar. Ze controleren prompts, models, tools, retrievers en beleid tegen een vaste dataset.
Elke verkeerde plaatsing heeft een prijs:
- Een judge in het request-pad voegt latency toe en een nieuwe bron van flakiness.
- Een guardrail die naar async scoring is verschoven, laat beleidsovertredingen bij gebruikers komen.
Maak bij beveiligingstests onderscheid tussen aanvalsdetectie, een verboden actie die wordt geprobeerd en een schadelijk effect dat daadwerkelijk slaagt. Rapporteer geslaagde schadelijke effecten per aanvalspoging, met het threat model en het budget voor pogingen, naast succes bij legitieme taken en onterechte blokkades per goedaardige poging. Een detectorscore alleen kan niet vaststellen dat data privé bleef of dat een schrijfactie werd voorkomen. Gebruik geïsoleerde doelen; Anthropics incidentrapport over cybersecurity-evaluaties beschrijft waarom effecten van evaluaties ingeperkt moeten worden.
Score bij systemen met hoog volume een kleine steekproef met een sterkere judge en een bredere steekproef met goedkopere classifiers. Geef alerts op clusters en betrouwbaarheidsgrenzen, niet op één ruisige puntschatting.
Toolingkeuzes
Geen enkele tool bezit de hele lus. Vergelijk een trace-/datasetopslag en een CI-/eval-runner apart; één product kan beide dekken, maar je hoeft niet beide bij dezelfde vendor te kopen. De kolom Dekt toont welke rollen elke tool vervult.
| Tool | Dekt | Kies hem wanneer… | Limiet of kostenpost |
|---|---|---|---|
| DeepEval | Runner | Je checks in Python en pytest draait; deepeval test run laat de build falen bij een falende metric. | Alleen runner. Aanroepen van het judge-model kosten tokens; het gehoste Confident AI-platform rekent af op opgeslagen tracedata. |
| Inspect AI | Runner | Je safety-, frontier- of sandboxed agenttaken nodig hebt. | Alleen runner, open source. Je configureert sandboxes en modeltoegang zelf; het is geen productie-tracestore. |
| Phoenix | Trace store, datasets, runner | Je self-hosted tracing en evals nodig hebt, met data in je eigen infrastructuur. | Gratis om zelf te hosten; je beheert de deployment. Het gehoste Arize AX rekent af op spans, opslag en retentie. |
| Langfuse | Trace store, datasets, runner | Je een open-source workflow voor traces, datasets en experimenten wilt, met een CI-action die een datasetversie pint en faalt bij regressie. | Bij self-hosting beheer je de opslagstack zelf; sommige functies vragen een licentie. Cloud rekent af op traces, observations en scores. |
| LangSmith | Trace store, datasets, runner | Je al LangChain/LangGraph gebruikt en de grenzen van het platform accepteert. | Self-hosting en hybride hosting vragen Enterprise. Cloud rekent af op seats, traces en retentie. |
| Braintrust | Trace store, datasets, runner | Beheerde PR-feedback en vergelijkbare experiment-snapshots belangrijker zijn dan self-hosting. | Beheerde dienst; self-hosting vraagt Enterprise. Rekent af op verwerkte data, scores en retentie. |
| Promptfoo | Runner, red team | Regressies in prompts of red-team-tests vóór deployment moeten draaien. | Runner en red-team-tests; geen tracestore. Open source; betaalde plannen voegen red-team-probes en teamfuncties toe. |
Vendors rekenen af in verschillende eenheden (traces, spans, scores, seats, retentie of verwerkte data), dus vergelijk actuele prijzen op je eigen tracevolume. De kostenposten hierboven zijn in oktober 2026 gecontroleerd op de prijspagina’s.
De toolkeuze is secundair. Als productiefouten geen testcases worden, betaal je vooral voor opslag van traces.
Een praktische rollout-checklist
Bouw de pipeline voor bewijs voordat je de metric-stack uitbreidt. Begin met bepalen waar de voorbeelden vandaan komen.
-
Verzamel eerst historische runs. Als de agent al bestaat, haal dan traces, supporttickets, bugrapporten, thumbs-down-sessions, handmatige QA-transcripts en dogfooding-notities op voordat je de implementatie wijzigt. Als de agent nog niet bestaat, log dan vanaf dag één elke prototype- en handmatige testrun.
-
Instrumenteer de tracevorm. Leg berichten, tool calls, argumenten, tool-outputs, fouten, tokenaantallen, latency, kosten, gebruikersfeedback, appversie, promptversie, modelversie, versie van het tool schema en de uiteindelijke omgevingstoestand vast. Gebruik de OpenTelemetry GenAI-conventies of spans in OpenInference-stijl als je portabiliteit wilt, en pin de conventieversie en de adapter. Leg inhoud selectief vast: maskeer secrets en persoonsgegevens, beperk de toegang en stel de retentie in voordat je traces naar datasets promoveert. Gebruik Langfuse, LangSmith, Phoenix of Braintrust als je meteen een trace-UI en een datasetworkflow wilt.
-
Zet echte fouten om in seed-cases. Lees de traces voordat je ze met een model samenvat. Sla voor elke bruikbare fout de invoer, de bron-trace-ID, de verwachte state, de verwachte tool-invarianten, de foutmodus, de ernst en een reviewernotitie op. Langfuse kan datasetitems terugkoppelen naar production traces; LangSmith kan datasets maken uit getracete runs. Bewaar de bronlink, zodat de case controleerbaar blijft.
-
Genereer cold-start-cases als er geen historie is. Laat een LLM taken opstellen uit productvereisten, beleid, tool schemas, state machines en supportmacro’s. Dek happy paths en fouten zoals verkeerde rechten, ontbrekende identiteitschecks, verouderde tool results, dubbelzinnige datums, retries na rate limits en tegenstrijdige tool-output.
-
Vertrouw synthetische cases pas nadat een mens ze heeft beoordeeld. Synthetische voorbeelden zijn nuttig voor dekking, niet voor waarheid. Markeer ze met
source: syntheticen eis dat een reviewer de verwachte uitkomst goedkeurt. Draai waar mogelijk een bekend goed referentiepad en valideer gegenereerde verwachtingen onafhankelijk; een andere modelfamilie gebruiken vervangt die check niet. -
Bouw een kleine, gebalanceerde dataset. Neem successen, fouten, weigeringen, grensgevallen, cases met veel beurten, beleidsgevoelige cases en geldige alternatieve paden op. Maak van de golden niet “het exacte oude transcript”. Sla de velden uit het golden-voorbeeld onder “Dedupliceer voordat je promoveert” op, inclusief de foutmodus die de case in de suite bracht.
-
Voeg eerst deterministische checks toe. De vereiste volgorde van tools waar volgorde beleid is, vereiste argumenten, schemavalidatie, diffs van de eindtoestand, loopgrenzen, plafonds voor tokens en latency en taakspecifieke invarianten moeten vóór elke judge draaien.
-
Voeg één judge in SGR-vorm toe. Gebruik hem alleen voor het deel dat interpretatie vraagt. Kalibreer hem tegen menselijke labels en test de gekozen rubric op onaangeroerde validatiecases. Als hij op de kalibratieset goede en slechte voorbeelden niet kan scheiden, repareer dan de rubric voordat je hem in CI aansluit.
-
Sluit de lus. Draai de kleine offline suite in CI, draai de grotere suite vóór de release, score gesamplede productietraffic online en promoveer terugkerende online foutclusters terug naar de offline dataset.
Je eerste eval-suite zal cases missen. Draai haar toch, en voeg terugkerende fouten daarna toe als cases. Een suite die elke dag draait, geeft je bewijs om haar te verbeteren.
Referenties
- trace2evals companion demo repository
- LangChain - State of Agent Engineering
- Anthropic - Demystifying Evals for AI Agents
- Hamel Husain - A Field Guide to Rapidly Improving AI Products
- OpenTelemetry semantic conventions for generative AI systems
- DeepEval Tool Correctness
- DeepEval Task Completion
- DeepEval unit testing in CI/CD
- Inspect running evals
- OpenAI Structured model outputs
- Schema-Guided Reasoning: vLLM, xgrammar, and Pydantic
- Phoenix self-hosting
- Langfuse datasets and versioning
- Langfuse experiments in CI/CD
- LangSmith platform setup
- LangSmith - Create and manage datasets programmatically
- Braintrust - Create experiments
- Phoenix LLM evals
- Promptfoo GitHub Action integration
- tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- Why Do Multi-Agent LLM Systems Fail?
- Establishing Best Practices for Building Rigorous Agentic Benchmarks
- G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
- Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models
- JudgeBench: A Benchmark for Evaluating LLM-based Judges
- Self-Preference Bias in LLM-as-a-Judge