Schema-Guided Reasoning: vLLM, XGrammar en Pydantic

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Dit artikel is voor Python-engineers die modeluitvoer nodig hebben die code verderop kan valideren. Schema-Guided Reasoning (SGR) geeft het model een vaste lijst velden om in te vullen, eerst de analyse en als laatste de beslissing, zodat code elke stap kan controleren. Je leert hoe je een Pydantic-schema definieert, structured output opvraagt bij vLLM en applicatiechecks toevoegt voor betekenis en beleid.
Pydantic beschrijft de velden van het antwoord, vLLM serveert het model en XGrammar beperkt welke tokens het model mag genereren. Die beperking heet constrained decoding. Een tokenlimiet kan nog steeds een onvolledig JSON-prefix achterlaten, dus applicatiecode moet controleren of de uitvoer compleet is en het resultaat valideren.
Wat is Schema-Guided Reasoning?
Schema-Guided Reasoning is een techniek die Rinat Abdullin in juli 2025 beschreef. In plaats van het model vrij tekst te laten aanvullen (wat inconsistent of dubbelzinnig kan zijn), geef je het een strikt sjabloon dat vastlegt:
- welke stappen het antwoord moet weergeven
- de bedoelde volgorde van die stappen, zodat een reviewer het pad van data naar beslissing kan nalopen
- waar het zijn aandacht op moet richten
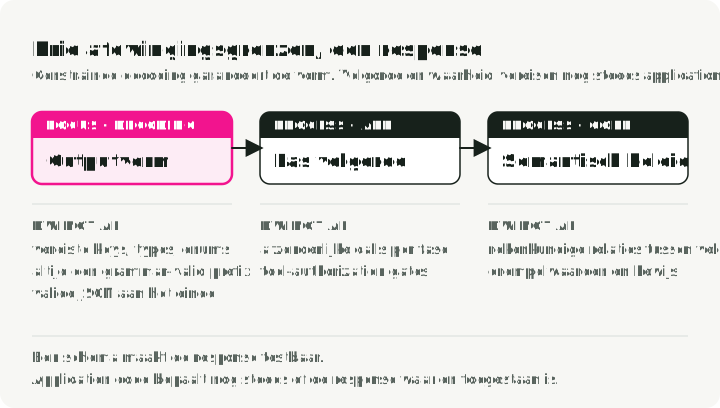
Zie het als een checklist van uitvoer die je kunt inspecteren, en niet als bewijs van het interne reasoning van het model. De decoder controleert de structuur van de uitvoer; applicatiecode bepaalt wanneer elke fase draait en of een resultaat gebruikt mag worden.
Het diagram volgt één prijsantwoord langs de drie onderdelen die het controleren: de decoder dwingt de vorm af, de applicatie dwingt de volgorde van de fasen en de volledigheid af en beleidscode dwingt de betekenis af.
Wat het schema bepaalt
Het lopende voorbeeld stelt een korting voor om een klant te behouden die kan opzeggen. De churn-kans schat de kans op vertrek; de winkelwagenwaarde is het totaal vóór de korting. De marge is de brutowinst als fractie van dat totaal: een winkelwagen van $200 met een marge van 0.20 heeft $40 brutowinst. Kortingen gebruiken procentpunten, dus een voorstel van 15 betekent 15%.
Een prijsmodel kan geldige JSON teruggeven en toch 25% korting voorstellen terwijl de marge maar 20% is. Het schema legt het voorstel vast; applicatiecode moet controleren of de korting is toegestaan.
Velden als churn_analysis, margin_math en max_discount_percent maken de bedoelde tussenresultaten expliciet. Een schema beperkt de vorm van het antwoord. Het laat op zichzelf geen enkel veld van een ander afhangen en bewijst niet dat de beslissing juist is.
Dat levert je:
- vergelijkbare uitvoerstructuur over herhaalde runs
- vastgelegde tussenresultaten die reviewers kunnen inspecteren
- tussenvelden die je kunt beoordelen aan de hand van een testdataset
- kleinere models volgen het formaat mogelijk vaker; meet de taaknauwkeurigheid voordat je erop vertrouwt
- Abdullin schrijft dat een nauwkeurigheidswinst van 5-10% “niet ongewoon” is in gevallen die hij heeft gezien; dat is een observatie van een practitioner en geen benchmarkresultaat, dus meet het op je eigen workload
Gebruik SGR wanneer code verderop van de structuur afhangt. Als een mens het antwoord als proza leest, is een vrij antwoord eenvoudiger.
Promptbegeleiding en decoderbeperkingen
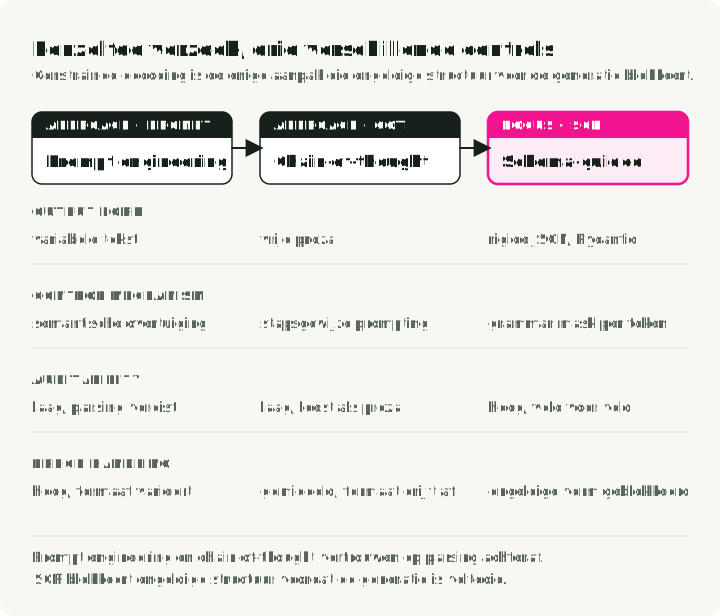
Promptbegeleiding en constrained decoding zijn te combineren. Deze vergelijking laat zien wanneer elk pad het gevraagde formaat controleert: alleen na de generatie, of ook bij elk token.
Prompt engineering: om het formaat vragen
Deze prompt vraagt het model het kortingsvoorstel als JSON op te maken:
Please analyze the customer data and output your response as valid JSON
with the following structure: {"discount": <number>, "reason": <string>}
Be careful with the formatting!
Je hoopt dat het begrip van het model voor “output JSON” zwaarder weegt dan zijn neiging om conversationeel te antwoorden. Een modelupdate, een andere temperatuur of een ander few-shot-voorbeeld kan je parser laten falen.
Chain of Thought: nuttige reasoningtrace, zelfde structuurprobleem
Een chain-of-thought-prompt (CoT) vraagt om tussenanalyse. Het antwoord kan er zo uitzien:
Let's think step by step:
1. First, I'll analyze the customer's churn risk...
2. Then I'll calculate the margin...
3. Therefore, I recommend a 15% discount.
CoT kan de taaknauwkeurigheid verbeteren als de prompt, het model, de taak en de evaluatie dat ondersteunen, maar het laat het resultaat achter als proza dat moeilijk betrouwbaar te parsen is. Je kunt eindigen met een tweede LLM-call alleen om gestructureerde data te extraheren.
SGR: gestructureerde chain of thought
SGR maakt van de chain-of-thought-stappen benoemde velden die je kunt inspecteren en beoordelen:
class PricingLogic(BaseModel):
    # 1. Recorded analysis
    churn_analysis: str = Field(..., description="Analyze churn_probability")
    financial_analysis: str = Field(..., description="Analyze cart_value and margin")

    # 2. Proposed calculation, checked by application code
    margin_math: str = Field(..., description="Calculate: 'Cart $X * Y% = $Z'")

    # 3. Proposed decision, not bounded by the analysis fields
    max_discount_percent: float = Field(..., description="Max allowed discount")
Het schema noemt deze velden in die volgorde. Gebruik aparte calls als een later veld moet afhangen van een gecontroleerd eerder resultaat.
De tabel zet de drie benaderingen naast elkaar:
| Kenmerk | Prompt engineering | Chain of Thought | Schema-Guided Reasoning |
|---|---|---|---|
| Uitvoerstructuur | Variabele tekst | Vrij proza | JSON die overeenkomt met een Pydantic-schema |
| Controlemechanisme | Instructie (“output JSON”) | Instructie (“think step by step”) | Prompt plus constrained decoding |
| Wie de stappen bepaalt | De ontwikkelaar kan ze in de prompt noemen | De ontwikkelaar kan stappen of voorbeelden geven | De ontwikkelaar definieert schemavelden |
| Inspectie | Eerst de tekst parsen | Het proza lezen | Elk veld lezen |
| Integratie | JSON/Pydantic-parsing als JSON geldig is | JSON/Pydantic-parsing als JSON geldig is; anders proza extraheren | model_validate_json, daarna applicatiechecks |
SGR-patronen
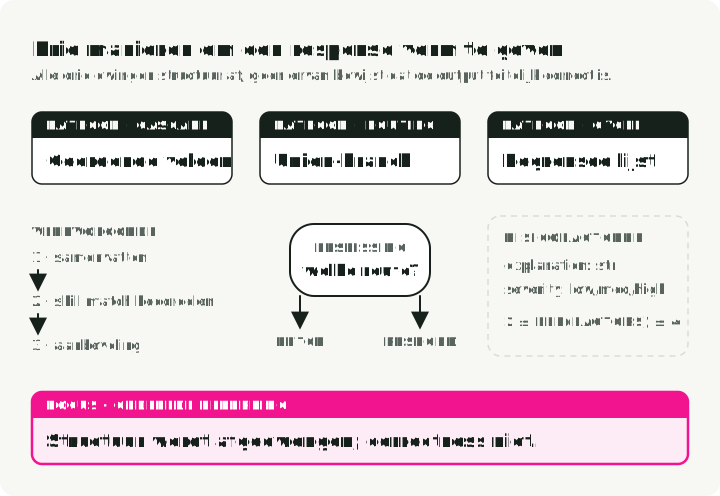
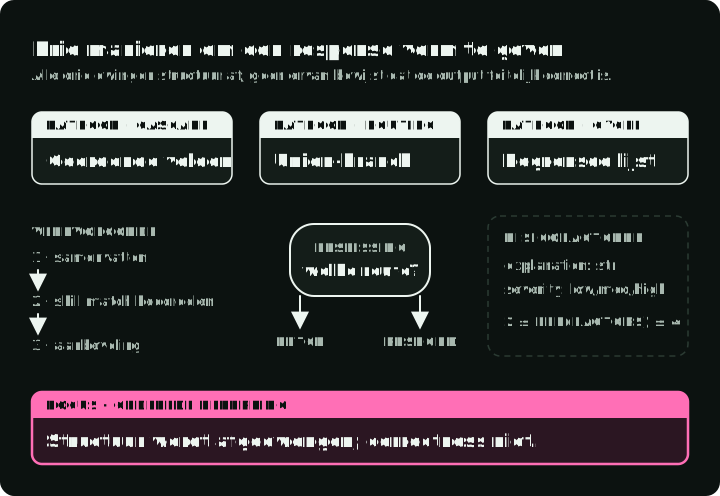
SGR kent drie kernpatronen die samen grotere workflows vormen. Het diagram toont de vorm die elk aan een antwoord geeft, met de veldnamen uit de voorbeelden hieronder, en markeert de grens die elk schema stelt.
1. Cascade: opeenvolgende reasoningstappen
Cascade legt een reasoningvolgorde vast in één gestructureerd antwoord. Hier registreert een documentclassifier een samenvatting, een score voor onderwerpmatch en een voorgestelde categorie.
from pydantic import BaseModel
from typing import Literal, Annotated
from annotated_types import Ge, Le

class DocumentEvaluation(BaseModel):
    """Record a document summary, score, and proposed category."""

    # Step 1: Record a summary
    brief_document_summary: str

    # Step 2: Rate (bounded integer)
    rate_topic_match: Annotated[int, Ge(1), Le(10)]

    # Step 3: Decide (constrained choices)
    final_recommendation: Literal["relevant", "irrelevant", "review"]
Voorbeelden van gebruik: documentclassificatie en triage van supporttickets.
Het model moet brief_document_summary, rate_topic_match en final_recommendation in die volgorde teruggeven.
2. Routing: een semantische switch-statement
Routing laat het model één pad kiezen uit een set opties, geïmplementeerd met Union-types. Deze router kiest tussen het ophalen van klantdata voor een prijsverzoek en het geven van een algemeen antwoord.
from pydantic import BaseModel
from typing import Literal, Union

class FeatureLookup(BaseModel):
    """Route to database lookup."""
    rationale: str
    tool_name: Literal["fetch_user_features"] = "fetch_user_features"
    user_id: str

class GeneralResponse(BaseModel):
    """Standard response for non-pricing queries."""
    tool_name: Literal["respond"] = "respond"
    content: str

class RouterSchema(BaseModel):
    """The model must pick exactly ONE branch."""
    action: Union[FeatureLookup, GeneralResponse]
Goede toepassingen: intentieclassificatie, toolselectie, supporttriage, multi-agent dispatch.
De Literal-waarden die per tak verschillen, laten Pydantic de leden van de union uit elkaar houden. Wil je dat Pydantic de tak direct op tool_name kiest, declareer dan een discriminated union: action: Union[FeatureLookup, GeneralResponse] = Field(discriminator="tool_name"). Test of je backend het geëxporteerde schema accepteert.
3. Cycle: herhaald reasoning met lijsten
Cycle beschrijft meerdere items, met grenzen aan het aantal. Dit voorbeeld van risicobeoordeling vraagt om twee tot vier factoren, elk met een toelichting en een ernst.
from pydantic import BaseModel
from typing import List, Literal, Annotated
from annotated_types import MinLen, MaxLen

class RiskFactor(BaseModel):
    explanation: str
    severity: Literal["low", "medium", "high"]

class RiskAssessment(BaseModel):
    """Generate 2-4 risk factors."""
    factors: Annotated[List[RiskFactor], MinLen(2), MaxLen(4)]
Goede toepassingen: risicobeoordeling, issue-extractie, parallelle tool calls, meerstaps planning.
De lijstgrenzen beschrijven een variabele batch van 2-4 items. Een decoder die dit ondersteunt kan die lengte afdwingen; applicatievalidatie controleert haar nogmaals. In combinatie met Routing kan de lijst voorgestelde tool calls beschrijven, die applicatiecode nog moet autoriseren.
SGR werkend maken: constrained decoding
De patronen hierboven zijn gewoon Pydantic-schema’s. Constrained decoding kan de ondersteunde beperkingen afdwingen die in hun JSON Schema zijn geëxporteerd. Welke features als ondersteund gelden, hangt af van de decoding-backend. Willekeurige Python-validators worden geen decoderbeperkingen; ze draaien na de generatie nog steeds in Pydantic.
Constrained decoding past de generatiestap van tokens aan. In plaats van het model vrij uit zijn vocabulaire te laten samplen, past de engine een grammatica-masker toe dat tokens blokkeert die het schema zouden schenden. Dat gebeurt in de inference-engine, niet in je applicatiecode.
SGR vereist geen reasoning-model. Ook instruction-tuned models geven schemabeperkte antwoorden; vergelijk de taaknauwkeurigheid op de models die je wilt serveren.
Engines en backends
Constrained decoding vraagt om een API of serving-engine die het ondersteunt. Roep je een gehost model aan, gebruik dan de structured-output-API van de aanbieder: OpenAI Structured Outputs, Gemini structured output en Mistral custom structured output accepteren elk een JSON Schema. De ondersteunde schemafeatures en het gedrag bij fouten verschillen per aanbieder, dus test het schema dat je wilt versturen.
Voor een zelf gehost model heeft elke grote engine een backend voor constrained decoding:
| Engine | Structured-output-backends | Gebruik wanneer |
|---|---|---|
| vLLM | auto (default), xgrammar, guidance, outlines, lm-format-enforcer; instellen met --structured-outputs-config.backend | Je een OpenAI-compatibele server en keuze uit backends wilt; het voorbeeld van dit artikel |
| SGLang | XGrammar (default), Outlines, llguidance; instellen met --grammar-backend | Je al met SGLang serveert; XGrammar werkt zonder flag |
| TensorRT-LLM | XGrammar of LLGuidance; instellen met guided_decoding_backend | Je deployt op NVIDIA GPUs met TensorRT-LLM |
| Ollama | JSON Schema in het format-veld van het verzoek | Je lokaal test op een laptop zonder GPU-server |
Twee vragen bepalen de keuze: of code het resultaat leest en wie het model draait. Elk gestructureerd pad eindigt met dezelfde applicatiechecks.
Dit artikel gebruikt vLLM met XGrammar. De structured-output-API van vLLM accepteert JSON Schema via een OpenAI-compatibele client. Zo behoudt het voorbeeld de vertrouwde code voor requests, terwijl de decoding-backend op de server wordt geconfigureerd.
XGrammar levert de grammaticacompiler en de machinerie voor het tokenmasker. Het technische overzicht legt de CPU/GPU-verdeling hieronder uit; de benchmarkresultaten gelden voor de geteste workloads, niet voor elke deployment.
Hoe XGrammar schema’s afdwingt
Waar het maskeren gebeurt
Logits zijn de ongenormaliseerde scores van het model voor mogelijke volgende tokens. XGrammar past die scores aan na de forward pass van het model en vóór het samplen. Het verandert het model zelf niet. Het filtert welke tokens geselecteerd kunnen worden.
Een standaard inference-loop draait de forward pass, sampelt het volgende token uit de logits en herhaalt dat. XGrammar voegt stap 2 toe:
1. Input tokens → GPU Forward Pass → Raw Logits
2. Raw Logits → XGrammar Logits Processor → Masked Logits
3. Masked Logits → Sampling → Next Token (continues the grammar-valid prefix)
4. Repeat until done
Het diagram toont één stap met een vocabulaire van acht tokens: de scores van de GPU en de bitmask van de CPU komen samen voordat een token wordt gekozen. Elk geaccepteerd token werkt ook de grammaticastatus bij voor de volgende stap.
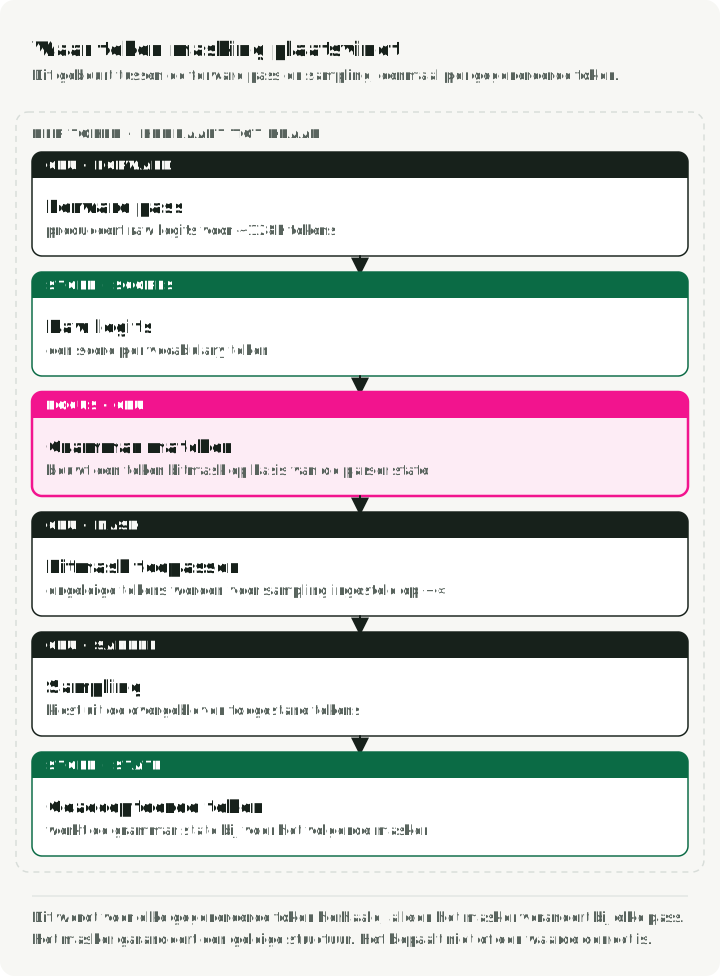
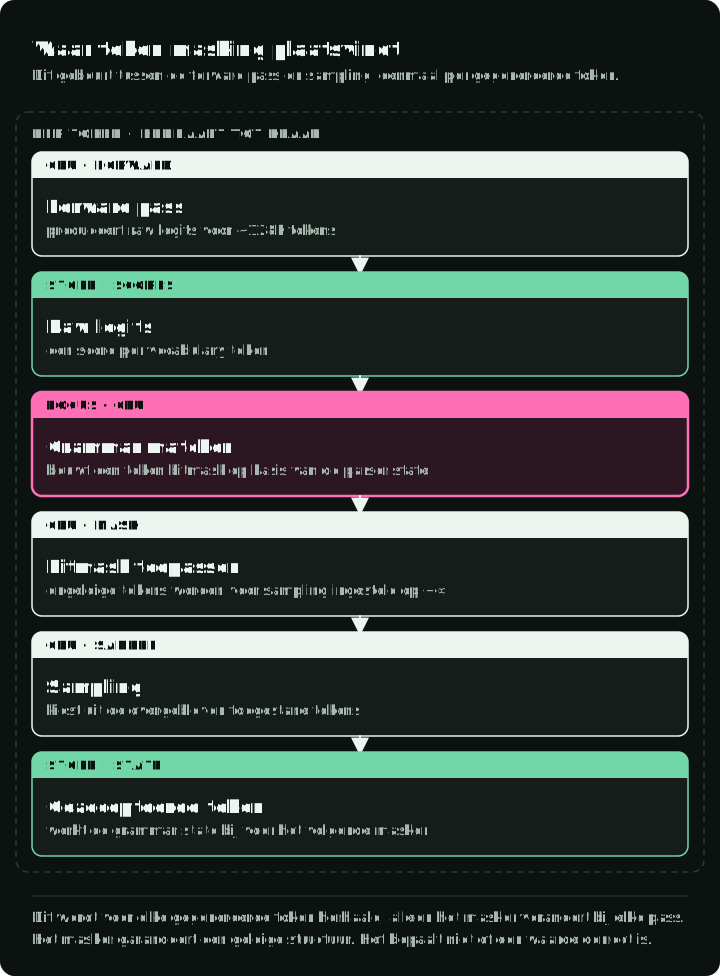
Het model berekent zijn volledige kansverdeling nog steeds op de GPU. De GrammarMatcher van XGrammar genereert de bitmask op de CPU, waarna de serving-engine die bitmask naar het device van de logits verplaatst en vóór het samplen ter plekke toepast. Voor GPU-logits gebruikt XGrammar daarvoor een GPU-kernel. Ongeldige tokens krijgen logits van -∞, waardoor hun kans na softmax exact 0 is.
Twee fasen
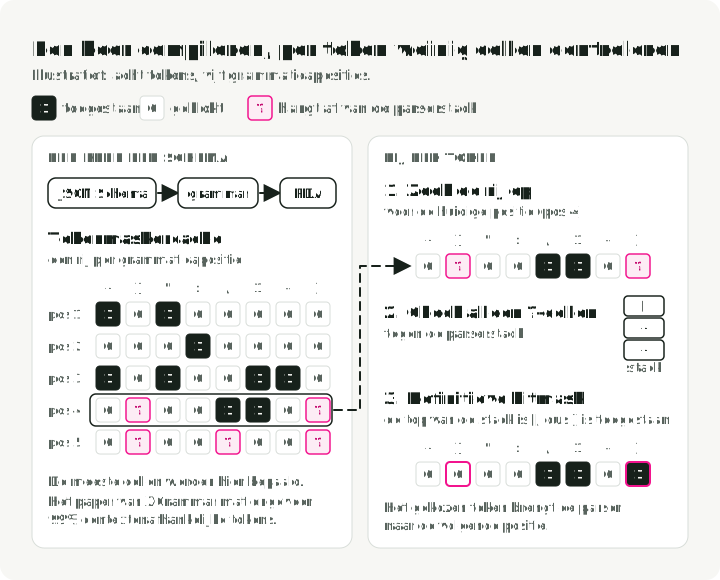
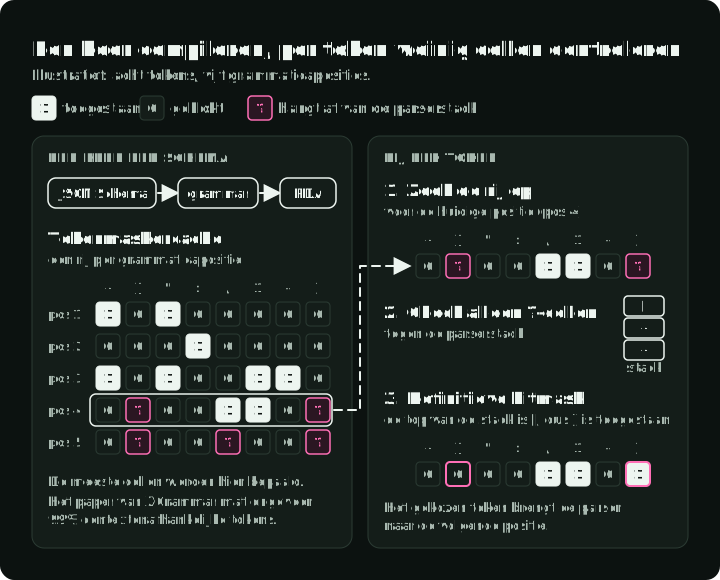
XGrammar splitst het werk in compileertijd en runtime. Dit ontwerp beperkt herhaald grammaticawerk. Het diagram toont een illustratieve cache die één keer per schema is gebouwd (links) en het werk dat bij elk gegenereerd token gebeurt (rechts): de meeste cellen zijn al toegestaan of geblokkeerd, en alleen de enkele met ? gemarkeerde cellen worden tegen de parserstack gecontroleerd. De gestippelde pijl markeert de koppeling: de cache die één keer is gebouwd, wordt bij elke stap gelezen.
Fase 1: grammaticacompilatie, één keer per schema
Dit fragment bouwt een grammatica voor het schema met de tokenizer van het model. Het gecompileerde resultaat is te hergebruiken bij het genereren van antwoorden met dat schema.
# This happens once per schema
tokenizer_info = xgr.TokenizerInfo.from_huggingface(tokenizer)
grammar_compiler = xgr.GrammarCompiler(tokenizer_info)
compiled_grammar = grammar_compiler.compile_json_schema(schema_json)
Tijdens het compileren doet XGrammar het volgende:
- Het zet het JSON Schema om in een Context-Free Grammar.
- Het bouwt een Pushdown Automaton (PDA): een state machine met een stack, zodat hij geneste structuren als
{"a": {"b": {"c": ...}}}aankan. - Het berekent vooraf welke tokens op elke grammaticapositie geldig zijn. Het resultaat is de “adaptive token mask cache”.
- Het categoriseert tokens als “context-independent” (cachebaar) of “context-dependent” (moet tijdens runtime worden gecontroleerd tegen de stackstatus).
Het XGrammar-paper meldt dat in zijn metingen ongeveer 99% van de tokens context-independent was (paper). Behandel dat getal als benchmarkspecifiek, niet als universele verhouding.
Fase 2: maskergeneratie tijdens runtime, bij elk token
Bij elke generatiestap:
- De
GrammarMatcherhoudt de huidige positie in de grammatica bij. - Hij zoekt het vooraf berekende masker op voor context-independent tokens.
- Hij draait de PDA om de overige context-dependent tokens te controleren.
- Hij combineert ze tot een definitieve bitmask, verplaatst die naar het device van de logits en past hem daar toe.
Waarom pushdown-automaten en geen regex?
Vanwege nesting. Een reguliere expressie (een finite state machine) kan structuren als deze niet betrouwbaar matchen:
{ "user": { "profile": { "settings": { "theme": "dark" } } } }Het lastige zijn de sluitende accolades }}}: je moet onthouden hoeveel je er hebt geopend. Een Pushdown Automaton heeft een stack die dat bijhoudt, dus hij kan willekeurige nestdiepte aan. Daarom kan XGrammar ook Union-types, geneste objecten en recursieve schema’s afdwingen, waar regex-gebaseerde aanpakken tekortschieten.
Een concreet voorbeeld: een float-veld genereren
Wanneer het model "max_discount_percent": genereert, weet XGrammar uit het schema dat er een float volgt. De set geldige tokens hangt af van de parserstatus en de tokenizer. Aan het begin van het getal kan het masker een cijfer of een minteken toelaten; na een cijfer kan het vervolgen toelaten zoals nog een cijfer, een decimaalteken of een exponentmarkering.
- Een aanhalingsteken,
{,[,true,falseofnullkan dit getal niet beginnen, dus het masker blokkeert hun tokens in die toestand. - De forward pass kan een hoge kans hebben toegekend aan het token voor
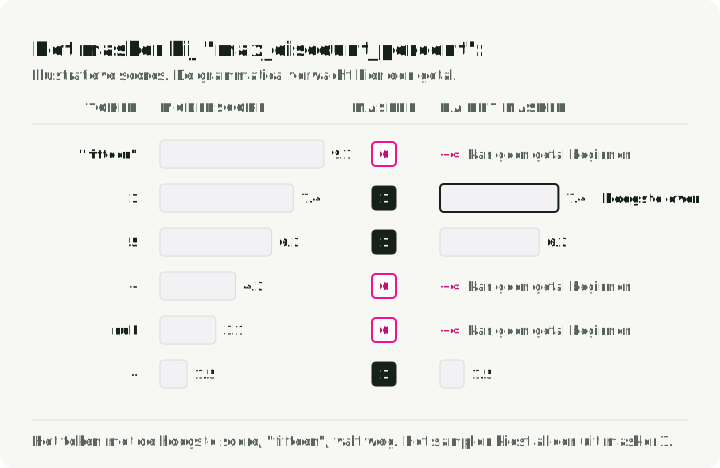
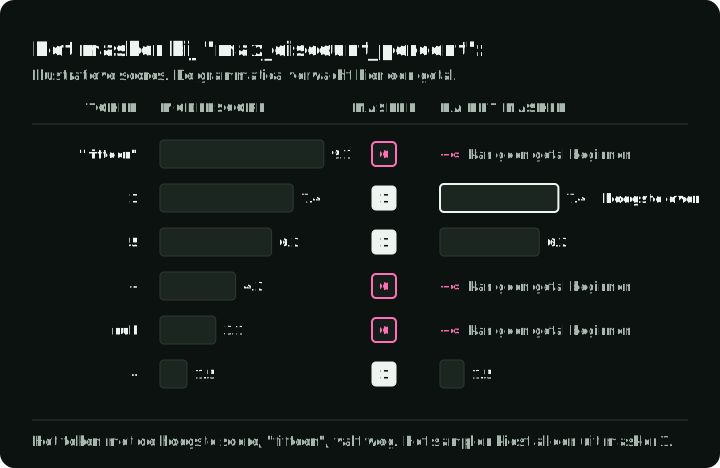
"fifteen". Omdat dat token dit numerieke veld niet kan voortzetten, verwijdert het masker het en moet het model een geldige numerieke voortzetting kiezen.
Het diagram toont illustratieve scores voor zes kandidaattokens op deze positie, het maskerbit van elk token en de scores na het masker.
Wat de overhead bepaalt
Drie dingen bepalen de overhead:
- Maskergeneratie en overdracht. Maskergeneratie op de CPU en de overdracht naar het device van de logits; in hoeverre dit overlapt met de forward pass hangt af van de serving-engine.
- Caching. Het meeste validiteitswerk gebeurt tijdens het compileren. Runtime bestaat grotendeels uit cache-lookups.
- C++-implementatie. Het hot path is C++, geen Python, en het masker wordt ter plekke op de logits toegepast.
De aangehaalde benchmarks melden een lage overhead voor hun geteste grammatica’s, tokenizers, hardware en workloads. Die resultaten bewijzen geen algemene garantie voor latency of throughput.
Praktische implementatie met vLLM
De companion-repository bevat deze code. uv run pytest test de beleids- en volledigheidschecks zonder model; de stappen aan het eind van deze sectie draaien de volledige agent tegen een vLLM-server.
De fragmenten hieronder zijn ingekort uit de repositorybestanden die op hun eerste regel staan. Ze tonen routing → contextophaling → voorstel → goedkeuring, en gebruiken Pydantic 2 en de OpenAI Python-client.
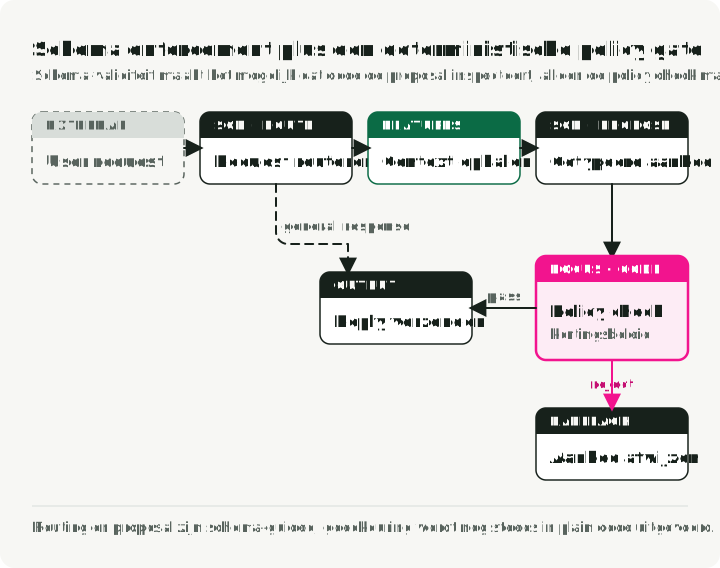
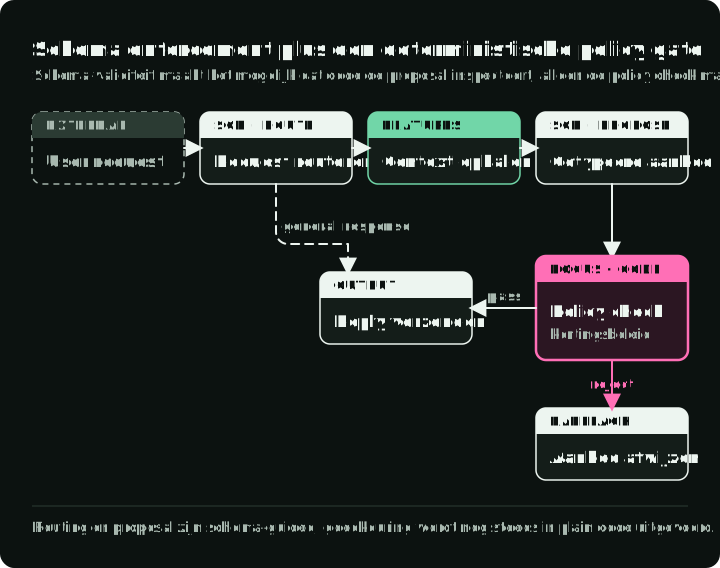
Een algemeen verzoek kan direct een antwoord opleveren. Een prijsverzoek heeft klantdata en een modelvoorstel nodig, gevolgd door een beleidscheck in de applicatie voordat de korting gemeld mag worden. Stopt een van beide modelcalls vóór een compleet antwoord, dan eindigt het verzoek met een fout; stap 2 toont die check. Het diagram toont elk pad door de agent en het antwoord dat elk pad teruggeeft.
Stap 1: definieer de schema’s
sgr/models/schemas.py bevat de twee eerder getoonde schema’s. RouterSchema is de router uit de sectie over Routing: vraag klantdata op met FeatureLookup, of geef tekst terug met GeneralResponse. PricingLogic heeft de vier velden uit de SGR-sectie. De beschrijving van margin_math geeft het model een uitgewerkt voorbeeld van het formaat: 'Cart $200 * 0.20 Margin = $40'.
De router en het prijsschema zijn aparte calls. Zo kan de applicatie de klantdata ophalen voordat ze om een voorstel vraagt.
Stap 2: vraag een gestructureerd antwoord op en valideer het
De client exporteert het Pydantic-model als JSON Schema, voegt het toe aan een bestaand systeembericht als promptbegeleiding en stuurt het mee als structured-output-beperking. XGrammar wordt op de server geconfigureerd; de client levert het schema bij elk verzoek.
completed_content weigert onvolledige, geweigerde of lege antwoorden voordat Pydantic de JSON en de velden valideert. Het weigert ook stops door de tokenlimiet, zelfs als de teruggegeven tekst toevallig te parsen is. Deze fouten worden doorgegeven aan de aanroeper, die een foutantwoord of retrybeleid moet leveren; op deze paden wordt geen korting goedgekeurd.
# sgr/utils/llm_client.py
import json
from typing import TypeVar

from openai import OpenAI
from pydantic import BaseModel

T = TypeVar("T", bound=BaseModel)

def completed_content(completion) -> str:
    """Reject incomplete, refused, or empty results before JSON validation."""
    if not completion.choices:
        raise ValueError("No completion returned")
    choice = completion.choices[0]
    if choice.finish_reason != "stop" or getattr(choice.message, "refusal", None):
        raise ValueError("Completion was not successful")
    content = choice.message.content
    if not isinstance(content, str) or not content.strip():
        raise ValueError("Completion has no content")
    return content

class LLMClient:
    """Wrapper for vLLM with XGrammar-enforced structured generation."""

    def __init__(self, base_url: str = "http://localhost:8000/v1"):
        # Local vLLM commonly has no authentication. EMPTY is not authentication.
        self.client = OpenAI(base_url=base_url, api_key="EMPTY")
        self.model = self._get_available_model()

    def _get_available_model(self) -> str:
        """Auto-detect the model running on vLLM server."""
        models = self.client.models.list()
        if not models.data:
            raise RuntimeError("vLLM reported no available models")
        return models.data[0].id

    def run_sgr(self, messages: list[dict], schema_class: type[T]) -> T:
        """Run inference with Schema-Guided Reasoning constraints.

        Uses vLLM structured outputs to constrain the JSON shape at generation time.
        """
        schema_dict = schema_class.model_json_schema()

        # Enhance system message with schema for model guidance
        enhanced_messages = messages.copy()
        if enhanced_messages and enhanced_messages[0]["role"] == "system":
            schema_json = json.dumps(schema_dict, indent=2)
            enhanced_messages[0] = {
                "role": "system",
                "content": (
                    enhanced_messages[0]["content"]
                    + f"\n\nRespond with JSON matching this schema:\n{schema_json}"
                ),
            }

        # vLLM v0.12+ structured outputs. Configure the backend on the server.
        completion = self.client.chat.completions.create(
            model=self.model,
            messages=enhanced_messages,
            temperature=0.1,  # Reduces sampling variation; it is not deterministic.
            extra_body={"structured_outputs": {"json": schema_dict}},
        )

        return schema_class.model_validate_json(completed_content(completion))
In vLLM v0.12 en later vraagt structured_outputs: {"json": schema_dict} om JSON die aan het schema voldoet. De oudere requestvelden guided_json en guided_decoding_backend zijn verwijderd in v0.12.0, en de backend wordt nu op de server ingesteld.
Stap 3: orkestreer de agent
De applicatie routeert het verzoek, haalt data op voor de geauthenticeerde aanroeper, vraagt om een voorstel, controleert het en geeft het resultaat terug. De feature store gebruikt de geauthenticeerde user_id, nooit de ID die het model voorstelt. De prompt ontvangt ook user_ltv, de geschatte klantlevensduurwaarde; die schatting geeft het model context maar bepaalt de kortingslimiet niet.
Het schema garandeert dat max_discount_percent een getal is. Het garandeert niet dat dat getal is toegestaan; approve_discount beslist dat. approve_discount controleert eerst of de invoer eindig is, de winkelwagenwaarde positief is en de marge een fractie tussen 0 en 1 is. Het demonstratiebeleid weigert daarna voorgestelde percentages buiten 0-20, rondt naar beneden af op honderdsten van een procentpunt en weigert een uiteindelijke korting die meer kost dan de brutowinst van de winkelwagen.
# sgr/agent.py
from decimal import Decimal, ROUND_DOWN

from .models.schemas import PricingLogic, RouterSchema
from .prompts.routing import build_routing_prompt
from .prompts.pricing import build_pricing_context_prompt, ASSISTANT_FETCH_MESSAGE
from .store.hybrid_store import HybridFeatureStore
from .utils.llm_client import LLMClient

def approve_discount(offer: PricingLogic, context: dict) -> Decimal:
    """Enforce the pricing policy independently of the model's explanation."""
    cart_value = Decimal(str(context["current_cart_value"]))
    margin = Decimal(str(context["cart_profit_margin"]))
    proposed = Decimal(str(offer.max_discount_percent))

    if not all(value.is_finite() for value in (cart_value, margin, proposed)):
        raise ValueError("Pricing values must be finite")
    if cart_value <= 0 or not Decimal("0") <= margin <= Decimal("1"):
        raise ValueError("Invalid pricing context")

    if not Decimal("0") <= proposed <= Decimal("20"):
        raise ValueError("Proposed discount violates pricing policy")
    # Policy rounds down to hundredths of a percentage point before approval.
    approved = proposed.quantize(Decimal("0.01"), rounding=ROUND_DOWN)
    gross_profit = cart_value * margin
    discount_cost = cart_value * approved / Decimal("100")
    policy_cap = min(margin * Decimal("100"), Decimal("20"))
    if not Decimal("0") <= approved <= policy_cap or discount_cost > gross_profit:
        raise ValueError("Proposed discount violates pricing policy")

    return approved

def pricing_agent(user_query: str, user_id: str) -> str:
    """Integrate routing, context, and pricing; user_id is caller-authenticated."""

    llm = LLMClient()
    feature_store = HybridFeatureStore()

    # Build conversation history
    history = [
        {"role": "system", "content": build_routing_prompt(user_id)},
        {"role": "user", "content": user_query},
    ]

    # --- Phase 1: Routing (Uses RouterSchema) ---
    print(f"🤖 Processing: '{user_query}' for {user_id}")
    decision = llm.run_sgr(history, RouterSchema)
    print(f"📍 Routing decision: {decision.action.tool_name}")

    if decision.action.tool_name == "respond":
        return decision.action.content

    # --- Phase 2: Context Retrieval ---
    if decision.action.tool_name == "fetch_user_features":
        print(f"🔍 Fetching features for {user_id}...")
        context = feature_store.get_user_context(user_id)

        if not context:
            return "Error: User profile not found."

        print(f"   [Data] LTV: ${context.get('user_ltv')} | "
              f"Margin: {context.get('cart_profit_margin', 0) * 100}%")

        # Inject context into conversation
        history.append({"role": "assistant", "content": ASSISTANT_FETCH_MESSAGE})
        history.append({
            "role": "user",
            "content": build_pricing_context_prompt(
                churn_prob=context.get("churn_probability", 0.5),
                cart_val=context.get("current_cart_value", 100),
                margin=context.get("cart_profit_margin", 0.2),
                user_ltv=context.get("user_ltv", 0),
            ),
        })

        # --- Phase 3: model proposal, then deterministic policy enforcement ---
        print("🧠 Proposing Offer (Schema Enforced)...")
        offer = llm.run_sgr(history, PricingLogic)
        try:
            approved_discount = approve_discount(offer, context)
        except ValueError:
            return "No discount approved: the proposal failed the pricing policy."

        # Audit log: reasoning is inspectable; pricing is application-enforced.
        print(f"   [Audit] Math: {offer.margin_math}")
        print(f"   [Audit] Approved Discount: {approved_discount}%")

        return (
            f"Illustrative approved discount: {approved_discount}%. "
            "No coupon has been issued."
        )

    return "I'm sorry, I couldn't process your request."

if __name__ == "__main__":
    response = pricing_agent("I want a discount or I'm leaving!", "user_102")
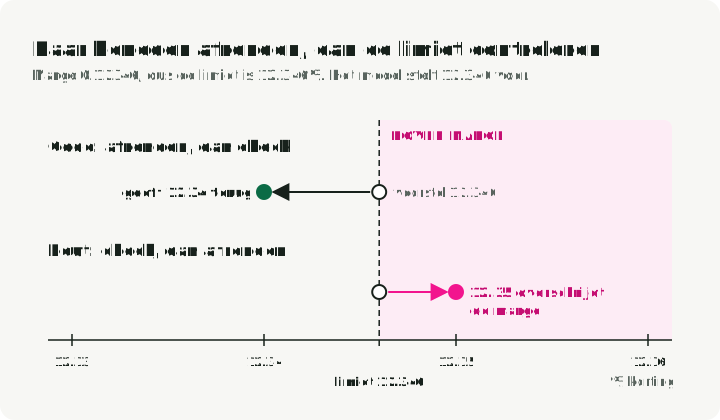
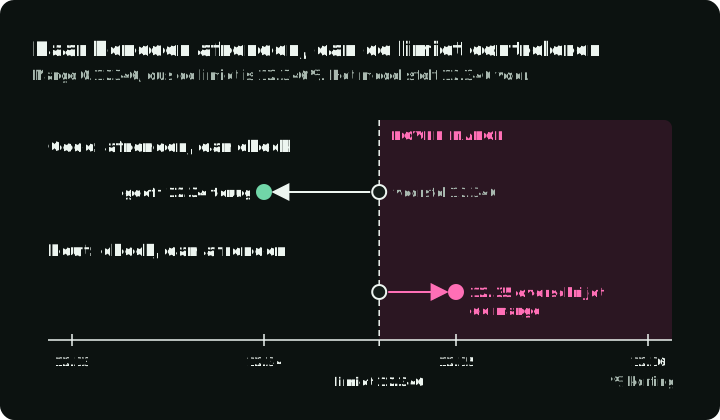
print(f"\n💬 Final Reply: {response}")Een voorstel van 15% op een winkelwagen van $200 met 20% marge geeft 15.00 terug uit de beleidsfunctie. De applicatie meldt dat percentage zonder te doen alsof er een coupon is uitgegeven. Een grenstest gebruikt een marge van 0.12346, oftewel 12,346%. Een voorstel van 12.346 wordt naar beneden afgerond op 12.34 voordat de eindwaarde wordt gecontroleerd. Afronden naar 12.35 na goedkeuring zou de marge overschrijden.
De getallenlijn toont die grenstest: waar elke volgorde van afronden en controleren de teruggegeven waarde ten opzichte van de limiet plaatst.
approve_discount voert vier checks uit, in deze volgorde:
- De invoer is geldig: winkelwagenwaarde boven 0, marge tussen 0 en 1, geen NaN of oneindig.
- Het voorgestelde percentage ligt tussen 0 en 20.
- Rond het voorstel naar beneden af op 0.01 (12.346 wordt 12.34, niet 12.35).
- De afgeronde waarde is hooguit het margepercentage (en hooguit 20), en de kosten ervan zijn hooguit de brutowinst.
Elke mislukte check geeft ValueError en het voorstel krijgt geen korting. Afronden komt vóór de limiet, zodat de limiet de waarde controleert die wordt teruggegeven.
De demo draaien
De repository draait de hele flow. De demo vereist Python 3.13 en uv. De vLLM-server heeft een eigen omgeving nodig, een ondersteunde accelerator en genoeg geheugen voor het model (installatiegids); de README van de repository behandelt de installatie en een CPU-Docker-optie om te testen.
Installeer de demo, draai de offline tests en maak de synthetische klantdata aan:
git clone https://github.com/slavadubrov/sgr-discount-manager
cd sgr-discount-manager
uv sync
uv run pytest
uv run python -m scripts.setup_data
Start de server met XGrammar als structured-output-backend:
vllm serve Qwen/Qwen2.5-7B-Instruct \
    --port 8000 \
    --structured-outputs-config.backend xgrammar
Het positionele modelargument en de backend-optie volgen de vLLM serve-referentie. De client verbindt met http://localhost:8000/v1; voor een server op een andere host wijzig je DEFAULT_API_BASE_URL in sgr/config/constants.py.
Draai de agent:
uv run python -m sgr.agentDe uitvoer heeft deze vorm. De waarden zijn illustratief; ze hangen af van de willekeurige demodata en het model:
🤖 Processing: 'I want a discount or I'm leaving!' for user_102
📍 Routing decision: fetch_user_features
🔍 Fetching features for user_102...
   [Data] LTV: $1500.0 | Margin: 20.0%
🧠 Proposing Offer (Schema Enforced)...
   [Audit] Math: Cart $200 * 0.20 Margin = $40
   [Audit] Approved Discount: 15.00%

💬 Final Reply: Illustrative approved discount: 15.00%. No coupon has been issued.
De regel [Audit] Math is de vastgelegde berekening van het model. De regel Approved Discount en het eindantwoord komen van approve_discount en applicatiecode, niet van het model.
Checks vóór een live integratie
Schemaontwerp
- Orden velden op het bedoelde reasoningverloop.
- Schrijf een
Field-beschrijving voor elk veld. Pydantic exporteert die naar het JSON Schema, en de client hierboven voegt dat schema toe aan de prompt. - Beperk met
LiteralenAnnotated. GebruikLiteral["a", "b"]voor enums enAnnotated[int, Ge(1), Le(10)]voor grenzen. - Houd schema’s gefocust. Eén schema per reasoningfase, en combineer ze daarna met meerdere calls.
vLLM-configuratie
- Gebruik een lage temperatuur (0.1-0.3) om samplingvariatie te beperken. Voor herhaalbare tests zet je het model en de serveconfiguratie vast, gebruik je de deterministische modus van de server als die er is en verifieer je het resultaat.
- Leg de taak en de schemavelden in de prompt uit, zoals de client hierboven doet. De prompt vertelt het model wat elk veld betekent; de decoder blokkeert alleen ongeldige tokens.
- Meet het tokenverbruik tegen dezelfde prompt, hetzelfde model, schema en dezelfde taak. SGR kan meer of minder tokens uitgeven dan een vrij CoT-antwoord.
Overwegingen voor productie
- Geef je schema’s versies, op dezelfde manier als je API’s versioneert.
- Leg het voorstel en de beleidsbeslissing apart vast voor debugging, met inachtneming van je regels voor dataretentie en afscherming.
- Bereken prijzen, limieten, rechten en andere semantische regels in applicatiecode opnieuw voordat je ze gebruikt; test grenswaarden die het schema alleen niet kan afwijzen.
De volgende test
Begin met de kortingslimiet en een onvolledige completion. De offline tests van de repository dekken beide, maar ze kunnen je niet vertellen of een model een echte klant correct routeert of de marge nauwkeurig toelicht. Houd voor een live evaluatie het model, de prompts, het schema en de serve-instellingen constant. Tel onvolledige resultaten, schemafouten, routingfouten en beleidsafwijzingen apart voordat je kosten of taaknauwkeurigheid vergelijkt.
Referenties
SGR Framework
- Schema-Guided Reasoning (SGR) — het oorspronkelijke framework van Rinat Abdullin
- SGR Patterns — de patronen Cascade, Routing en Cycle
xgrammar
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models — Yixin Dong et al., arXiv:2411.15100 (technisch paper met benchmarks)
- xgrammar GitHub — snelle, flexibele bibliotheek voor gestructureerde generatie
- xgrammar Documentation — officiële docs met een quick-startgids
- xgrammar Quick Start — aan de slag met xgrammar
- Achieving Efficient Structured Generation with XGrammar — MLC-blogpost over de internals van xgrammar
vLLM
- vLLM Structured Outputs — officiële documentatie
Demoproject
- sgr-discount-manager — companiondemo: de code uit dit artikel, offline tests en uitvoerstappen