Schema-Guided Reasoning: vLLM, XGrammar и Pydantic

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Статья для Python-инженеров, которым нужен вывод модели, пригодный для проверки в downstream-коде. Schema-Guided Reasoning (SGR) задаёт модели фиксированный список полей: сначала анализ, в конце решение. Так код может проверить каждый шаг. Вы узнаете, как описать схему Pydantic, запросить у vLLM structured output и добавить проверки смысла и политики в приложении.
Pydantic описывает поля ответа, vLLM обслуживает модель, а XGrammar ограничивает набор токенов, которые модель может сгенерировать. Это ограничение называется constrained decoding. Лимит токенов всё равно может оставить неполный префикс JSON, поэтому код приложения должен проверять завершённость ответа и валидировать результат.
Что такое Schema-Guided Reasoning?
Schema-Guided Reasoning — это техника, которую Ринат Абдуллин описал в июле 2025 года. Вместо того чтобы позволять модели свободно продолжать текст (результат может получиться непоследовательным или двусмысленным), вы даёте ей жёсткий шаблон, который определяет:
- какие шаги должен отражать ответ
- предполагаемый порядок этих шагов, чтобы ревьюер мог проследить путь от данных к решению
- на чём модели стоит сосредоточить внимание
Относитесь к схеме как к списку выводов для проверки, а не как к доказательству внутреннего ризонинга модели. Декодер проверяет структуру вывода; код приложения решает, когда запускается каждый этап и можно ли использовать результат.
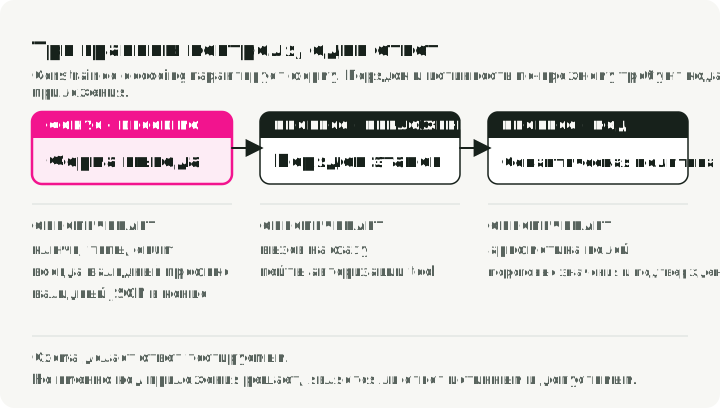
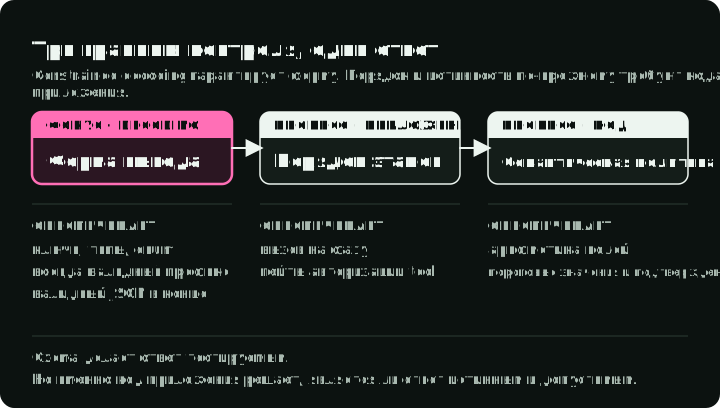
Диаграмма прослеживает один ответ о цене через три части, которые его проверяют: декодер обеспечивает форму, приложение обеспечивает порядок этапов и завершённость, а код политики обеспечивает смысл.
Что контролирует схема
В сквозном примере модель предлагает скидку, чтобы удержать клиента, который может уйти. Churn probability — это оценка вероятности ухода; cart value — сумма корзины до скидки. Маржа — это валовая прибыль как доля от этой суммы: у корзины на $200 с маржой 0.20 валовая прибыль составляет $40. Скидки выражаются в процентных пунктах, поэтому предложение 15 означает 15%.
Модель ценообразования может вернуть валидный JSON и всё равно предложить скидку 25% при марже всего 20%. Схема фиксирует предложение; допустима ли скидка, должен проверить код приложения.
Поля churn_analysis, margin_math и max_discount_percent делают предполагаемые промежуточные выводы явными. Схема ограничивает форму ответа. Сама по себе она не связывает одно поле с другим и не доказывает, что решение верно.
Это даёт:
- сопоставимую структуру вывода при повторных запусках
- записанные промежуточные выводы, которые ревьюеры могут просмотреть
- промежуточные поля, которые можно оценивать на тестовом датасете
- небольшие модели могут чаще следовать формату; измерьте точность на задаче, прежде чем на это полагаться
- Абдуллин пишет, что прирост точности на 5–10% «нередок» в случаях, которые он наблюдал; это наблюдение практика, а не результат бенчмарка, поэтому измерьте эффект на своей нагрузке
Используйте SGR, когда downstream-код зависит от структуры. Если ответ читает человек в виде прозы, проще свободный формат.
Подсказки в промпте и ограничения декодера
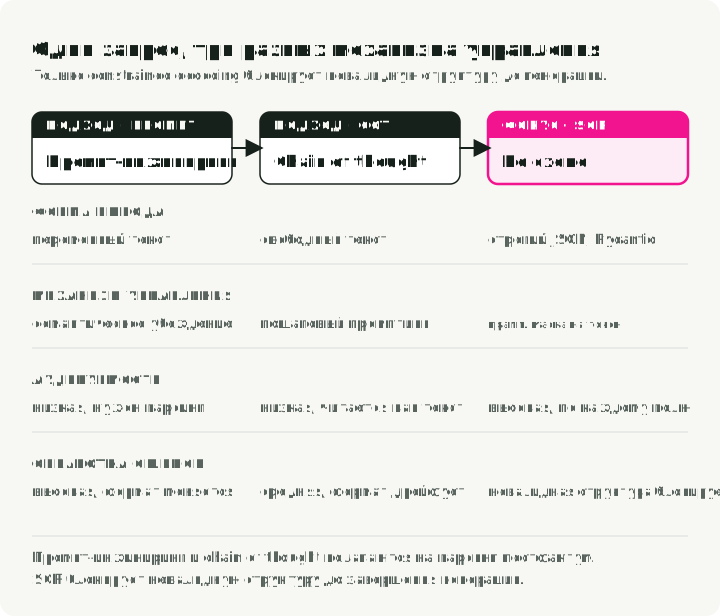
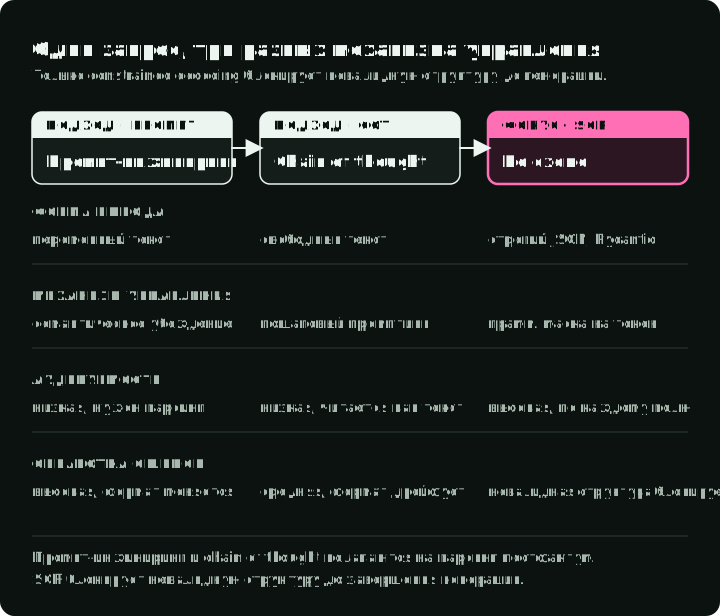
Подсказки в промпте и constrained decoding можно сочетать. Это сравнение показывает, когда каждый путь проверяет запрошенный формат: только после генерации или ещё и на каждом токене.
Промпт-инжиниринг: просьба о формате
Этот промпт просит модель оформить предложение скидки в JSON:
Please analyze the customer data and output your response as valid JSON
with the following structure: {"discount": <number>, "reason": <string>}
Be careful with the formatting!
Вы надеетесь, что понимание модели фразы «выведи JSON» перевесит её склонность к разговорному стилю. Обновление модели, смена температуры или другой few-shot пример могут сломать ваш парсер.
Chain of Thought: полезный след ризонинга, та же проблема со структурой
Промпт chain-of-thought (CoT) просит промежуточный анализ. Ответ может выглядеть так:
Let's think step by step:
1. First, I'll analyze the customer's churn risk...
2. Then I'll calculate the margin...
3. Therefore, I recommend a 15% discount.
CoT может повысить точность на задаче, если промпт, модель, задача и оценка это поддерживают, но результат остаётся прозой, которую трудно надёжно разобрать. Возможно, вам придётся сделать второй вызов LLM только ради извлечения структурированных данных.
SGR: структурированный chain of thought
SGR превращает шаги chain-of-thought в именованные поля, которые можно просмотреть и оценить:
class PricingLogic(BaseModel):
    # 1. Recorded analysis
    churn_analysis: str = Field(..., description="Analyze churn_probability")
    financial_analysis: str = Field(..., description="Analyze cart_value and margin")

    # 2. Proposed calculation, checked by application code
    margin_math: str = Field(..., description="Calculate: 'Cart $X * Y% = $Z'")

    # 3. Proposed decision, not bounded by the analysis fields
    max_discount_percent: float = Field(..., description="Max allowed discount")
Схема перечисляет эти поля именно в таком порядке. Если последующее поле должно зависеть от проверенного предыдущего результата, используйте отдельные вызовы.
В таблице три подхода сравниваются рядом:
| Свойство | Промпт-инжиниринг | Chain of Thought | Schema-Guided Reasoning |
|---|---|---|---|
| Структура вывода | Произвольный текст | Свободная проза | JSON, соответствующий схеме Pydantic |
| Механизм контроля | Инструкция («выведи JSON») | Инструкция («думай шаг за шагом») | Промпт плюс constrained decoding |
| Кто задаёт шаги | Разработчик может назвать их в промпте | Разработчик может указать шаги или примеры | Разработчик определяет поля схемы |
| Проверка | Сначала разобрать текст | Прочитать прозу | Прочитать каждое поле |
| Интеграция | Парсинг JSON/Pydantic, если JSON корректен | Парсинг JSON/Pydantic, если JSON корректен; иначе извлечение данных из текста | model_validate_json, затем проверки приложения |
Паттерны SGR
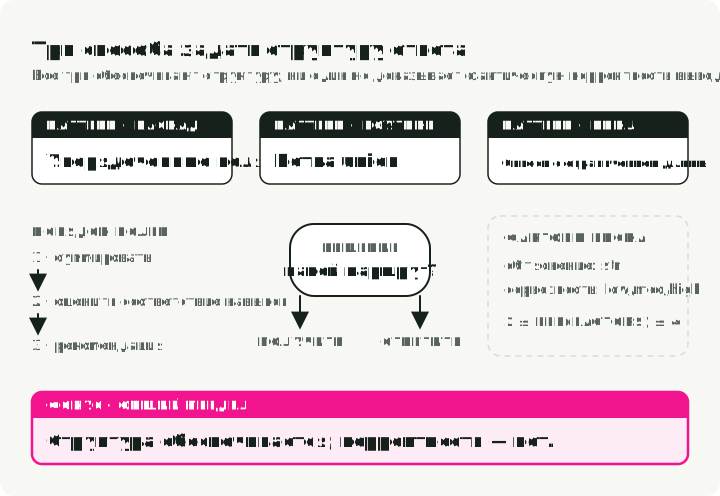
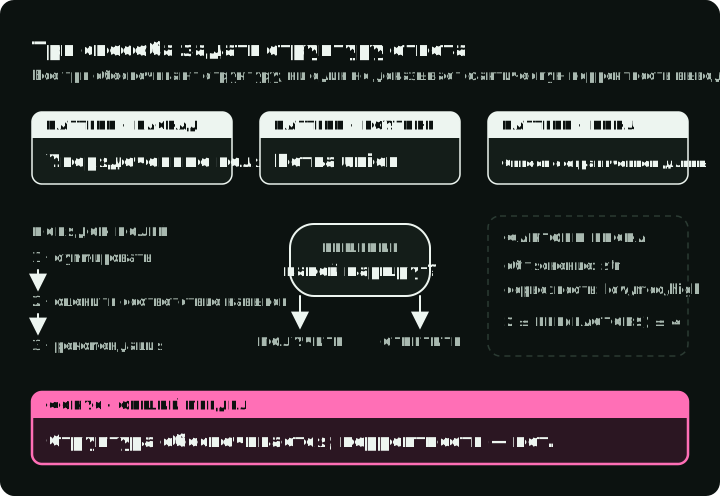
В SGR три базовых паттерна, из которых собираются более крупные воркфлоу. Диаграмма показывает, какую форму каждый из них придаёт ответу, на примере имён полей из примеров ниже, и отмечает предел, который задаёт каждая схема.
1. Каскад: последовательные шаги ризонинга
Каскад задаёт порядок ризонинга в одном структурированном ответе. Здесь классификатор документов записывает краткое содержание, оценку соответствия теме и предлагаемую категорию.
from pydantic import BaseModel
from typing import Literal, Annotated
from annotated_types import Ge, Le

class DocumentEvaluation(BaseModel):
    """Record a document summary, score, and proposed category."""

    # Step 1: Record a summary
    brief_document_summary: str

    # Step 2: Rate (bounded integer)
    rate_topic_match: Annotated[int, Ge(1), Le(10)]

    # Step 3: Decide (constrained choices)
    final_recommendation: Literal["relevant", "irrelevant", "review"]
Иллюстративные применения: классификация документов и триаж тикетов поддержки.
Модель должна вернуть brief_document_summary, rate_topic_match и final_recommendation именно в таком порядке.
2. Роутинг: семантический switch
Роутинг просит модель выбрать один путь из набора вариантов; он реализуется через типы Union. Этот роутер выбирает между получением данных клиента для запроса о цене и общим ответом.
from pydantic import BaseModel
from typing import Literal, Union

class FeatureLookup(BaseModel):
    """Route to database lookup."""
    rationale: str
    tool_name: Literal["fetch_user_features"] = "fetch_user_features"
    user_id: str

class GeneralResponse(BaseModel):
    """Standard response for non-pricing queries."""
    tool_name: Literal["respond"] = "respond"
    content: str

class RouterSchema(BaseModel):
    """The model must pick exactly ONE branch."""
    action: Union[FeatureLookup, GeneralResponse]
Подходит для: классификации намерений, выбора инструмента, триажа поддержки, диспетчеризации в мультиагентных системах.
Значения Literal, специфичные для каждой ветки, позволяют Pydantic отличать члены union друг от друга. Чтобы Pydantic выбирал ветку напрямую по tool_name, объявите дискриминированный union: action: Union[FeatureLookup, GeneralResponse] = Field(discriminator="tool_name"). Проверьте, что ваш бэкенд принимает экспортированную схему.
3. Цикл: повторяющийся ризонинг со списками
Цикл описывает несколько элементов с ограничением на их число. Этот пример оценки рисков запрашивает от двух до четырёх факторов, у каждого из которых есть объяснение и серьёзность.
from pydantic import BaseModel
from typing import List, Literal, Annotated
from annotated_types import MinLen, MaxLen

class RiskFactor(BaseModel):
    explanation: str
    severity: Literal["low", "medium", "high"]

class RiskAssessment(BaseModel):
    """Generate 2-4 risk factors."""
    factors: Annotated[List[RiskFactor], MinLen(2), MaxLen(4)]
Подходит для: оценки рисков, извлечения проблем, параллельных tool calls, многошагового планирования.
Границы списка описывают переменный пакет из 2–4 элементов. Поддерживаемый декодер может ограничить эту длину; валидация в приложении проверяет её повторно. В сочетании с роутингом список может описывать предлагаемые tool calls, которые код приложения всё равно должен авторизовать.
Как заставить SGR работать: constrained decoding
Описанные выше паттерны — это просто схемы Pydantic. Constrained decoding может обеспечивать поддерживаемые ограничения, экспортированные в их JSON Schema. Какие возможности считаются поддерживаемыми, зависит от бэкенда декодирования. Произвольные Python-валидаторы не превращаются в ограничения декодера; они по-прежнему выполняются в Pydantic после генерации.
Constrained decoding изменяет шаг генерации токенов. Вместо того чтобы позволять модели свободно семплировать из своего словаря, движок применяет грамматическую маску, которая блокирует токены, нарушающие схему. Это происходит в инференс-движке, а не в коде вашего приложения.
SGR не требует ризонинг-модели. Instruction-tuned модели тоже выдают ответы, ограниченные схемой; сравните точность на задаче на тех моделях, которые вы планируете сервить.
Движки и бэкенды
Для constrained decoding нужен API или движок сервинга, который его поддерживает. Если вы вызываете размещённую модель, используйте structured-output API провайдера: OpenAI Structured Outputs, Gemini structured output и Mistral custom structured output принимают JSON Schema. Поддерживаемые возможности схемы и поведение при сбоях у провайдеров различаются, поэтому проверьте ту схему, которую собираетесь отправлять.
Для самостоятельно развёрнутой модели у основных движков есть бэкенд constrained decoding:
| Движок | Бэкенды structured output | Когда использовать |
|---|---|---|
| vLLM | auto (по умолчанию), xgrammar, guidance, outlines, lm-format-enforcer; задаётся через --structured-outputs-config.backend | Нужен OpenAI-совместимый сервер и выбор бэкенда; пример этой статьи |
| SGLang | XGrammar (по умолчанию), Outlines, llguidance; задаётся через --grammar-backend | Вы уже сервите на SGLang; XGrammar работает без флага |
| TensorRT-LLM | XGrammar или LLGuidance; задаётся через guided_decoding_backend | Вы деплоите на GPU NVIDIA с TensorRT-LLM |
| Ollama | JSON Schema в поле format запроса | Вы тестируете локально на ноутбуке без GPU-сервера |
Выбор определяют два вопроса: читает ли результат код и кто запускает модель. Каждый структурированный путь заканчивается одними и теми же проверками в приложении.
В этой статье используется vLLM с XGrammar. Structured-output API vLLM принимает JSON Schema через OpenAI-совместимый клиент. Поэтому в примере остаётся привычный код запросов, а бэкенд декодирования настраивается на сервере.
XGrammar предоставляет компилятор грамматик и механизм масок токенов. Его технический обзор объясняет разделение работы между CPU и GPU, описанное ниже; результаты его бенчмарков относятся к протестированным нагрузкам, а не к любому деплою.
Как XGrammar обеспечивает соблюдение схем
Где применяется маска
Логиты — это ненормализованные оценки модели для возможных следующих токенов. XGrammar изменяет эти оценки после прямого прохода модели и до семплирования. Саму модель он не меняет. Он фильтрует, какие токены можно выбрать.
Стандартный цикл инференса выполняет прямой проход, семплирует следующий токен из логитов и повторяет. XGrammar добавляет шаг 2:
1. Input tokens → GPU Forward Pass → Raw Logits
2. Raw Logits → XGrammar Logits Processor → Masked Logits
3. Masked Logits → Sampling → Next Token (continues the grammar-valid prefix)
4. Repeat until done
Диаграмма показывает один шаг на словаре из восьми токенов: оценки GPU и битовая маска CPU встречаются до выбора токена. Каждый принятый токен также обновляет состояние грамматики для следующего шага.
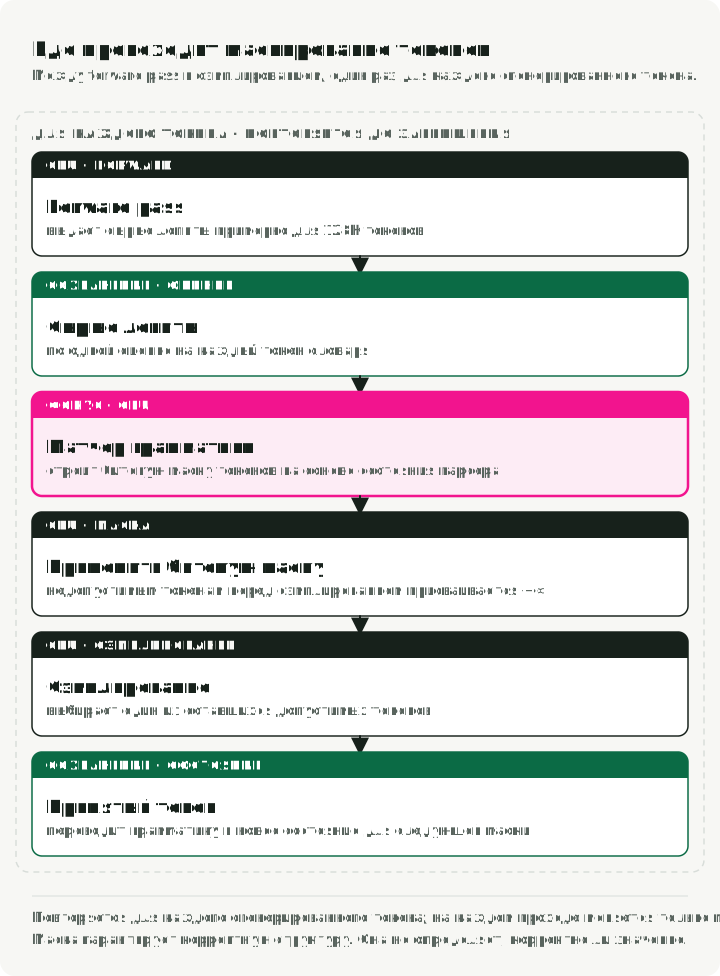
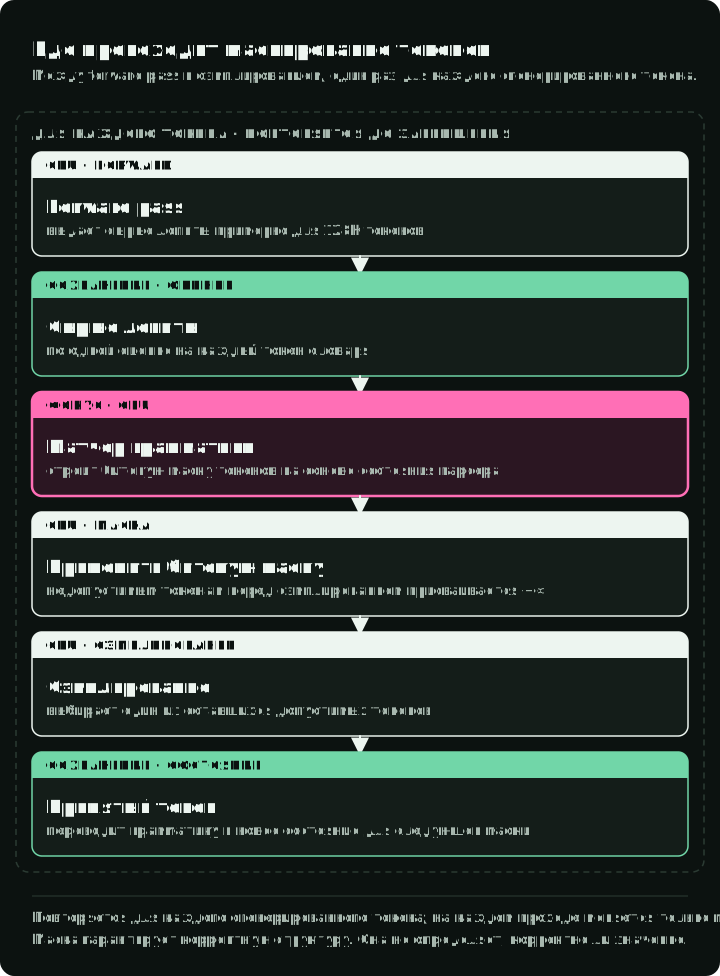
Модель по-прежнему вычисляет полное распределение вероятностей на GPU. GrammarMatcher из XGrammar генерирует битовую маску на CPU, затем движок сервинга переносит её на устройство, где лежат логиты, и применяет на месте до семплирования. Для логитов на GPU XGrammar использует для этого GPU-кернел. Логитам недопустимых токенов присваивается -∞, из-за чего их вероятность после softmax ровно 0.
Две фазы
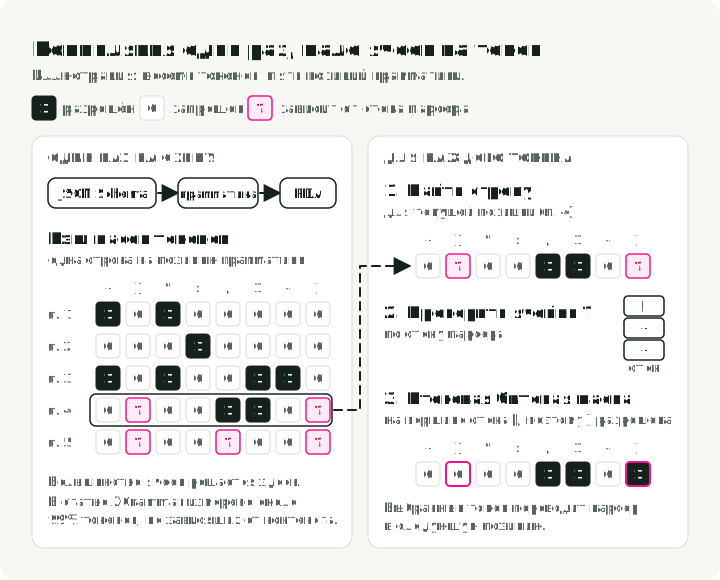
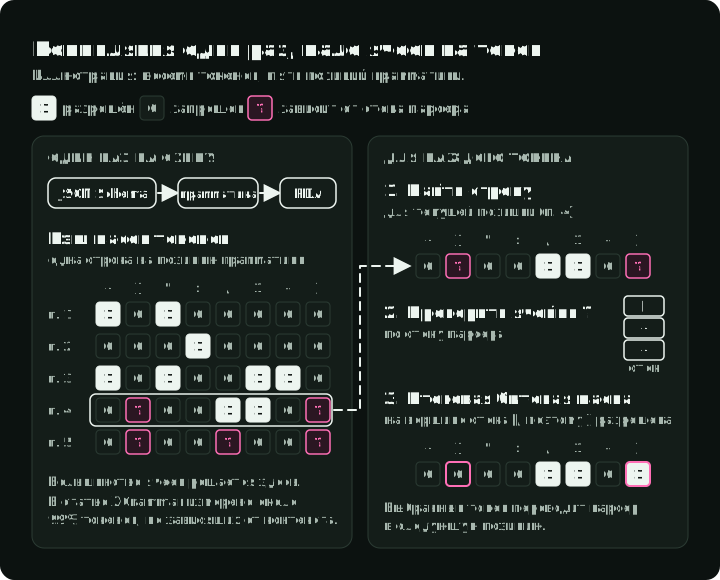
XGrammar делит работу на время компиляции и время выполнения. Такая конструкция сокращает повторную работу с грамматикой. Диаграмма показывает иллюстративный кэш, построенный один раз на схему (слева), и работу, которая выполняется для каждого токена (справа): большинство ячеек уже разрешены или заблокированы, и только немногие с пометкой ? проверяются по стеку парсера. Пунктирная стрелка показывает связь: кэш, построенный один раз, читается на каждом шаге.
Фаза 1: компиляция грамматики, один раз на схему
Этот фрагмент строит грамматику для схемы с помощью токенизатора модели. Скомпилированный результат можно переиспользовать при генерации ответов с этой схемой.
# This happens once per schema
tokenizer_info = xgr.TokenizerInfo.from_huggingface(tokenizer)
grammar_compiler = xgr.GrammarCompiler(tokenizer_info)
compiled_grammar = grammar_compiler.compile_json_schema(schema_json)
Во время компиляции XGrammar:
- Преобразует JSON Schema в контекстно-свободную грамматику.
- Строит магазинный автомат (Pushdown Automaton, PDA) — машину состояний со стеком, которая умеет обрабатывать вложенные структуры вроде
{"a": {"b": {"c": ...}}}. - Заранее вычисляет, какие токены допустимы в каждой позиции грамматики. Результат — «адаптивный кэш масок токенов».
- Делит токены на «контекстно-независимые» (их можно кэшировать) и «контекстно-зависимые» (их нужно проверять во время выполнения по состоянию стека).
В статье про XGrammar сообщается, что в её измерениях около 99% токенов были контекстно-независимыми (статья). Считайте это число специфичным для бенчмарка, а не универсальной долей.
Фаза 2: генерация маски во время выполнения, для каждого токена
На каждом шаге генерации:
GrammarMatcherотслеживает текущую позицию в грамматике.- Он берёт предвычисленную маску для контекстно-независимых токенов.
- Он запускает PDA, чтобы проверить оставшиеся контекстно-зависимые токены.
- Он объединяет их в итоговую битовую маску, переносит её на устройство с логитами и применяет там.
Почему магазинные автоматы, а не regex?
Из-за вложенности. Регулярное выражение (конечный автомат) не может надёжно сопоставить структуры вроде:
{ "user": { "profile": { "settings": { "theme": "dark" } } } }Сложность в закрывающих скобках }}}: нужно помнить, сколько их было открыто. У магазинного автомата есть стек, который это отслеживает, поэтому он справляется с произвольной глубиной вложенности. Поэтому XGrammar может обеспечивать типы Union, вложенные объекты и рекурсивные схемы, где подходы на основе regex не справляются.
Конкретный пример: генерация поля float
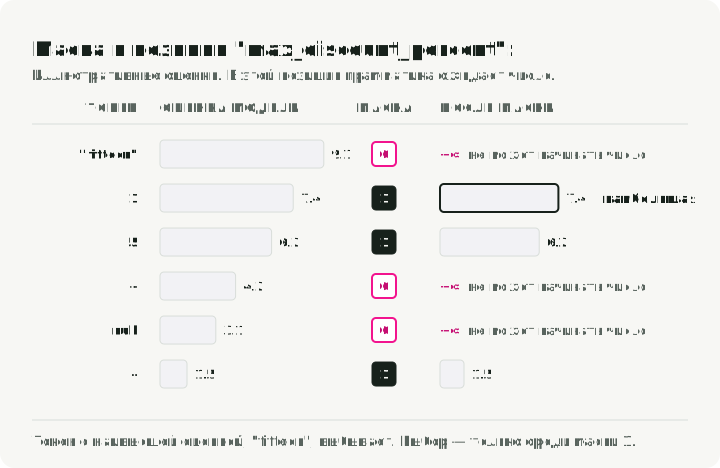
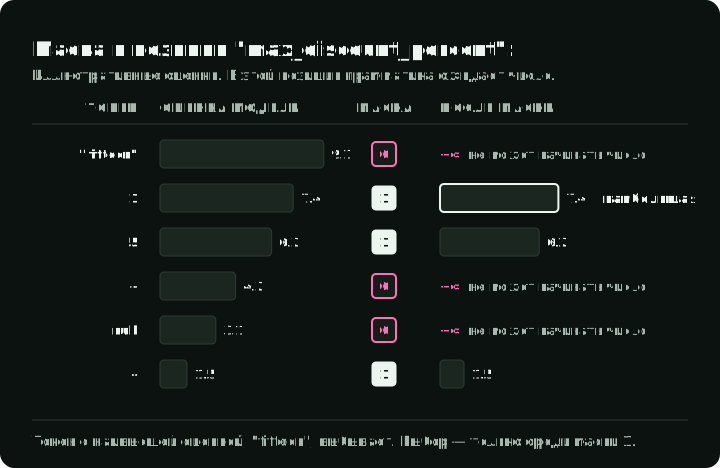
Когда модель генерирует "max_discount_percent":, XGrammar знает из схемы, что дальше идёт float. Набор допустимых токенов зависит от состояния парсера и токенизатора. В начале числа маска может допускать цифру или минус; после цифры она может допускать продолжения вроде ещё одной цифры, десятичной точки или маркера экспоненты.
- Кавычка,
{,[,true,falseилиnullне могут начинать это число, поэтому маска блокирует их токены в этом состоянии. - Прямой проход мог назначить высокую вероятность токену для
"fifteen". Поскольку этот токен не может продолжить числовое поле, маска убирает его, и модель должна выбрать допустимое числовое продолжение.
Диаграмма показывает иллюстративные оценки шести токенов-кандидатов в этой позиции, бит маски для каждого и оценки после применения маски.
Что влияет на накладные расходы
Накладные расходы определяют три фактора:
- Генерация и передача маски. Генерация маски на CPU и её передача на устройство с логитами; насколько это перекрывается с прямым проходом, зависит от движка сервинга.
- Кэширование. Основная часть работы по проверке допустимости выполняется во время компиляции. Во время выполнения это в основном обращения к кэшу.
- Реализация на C++. Горячий путь написан на C++, а не на Python, и маска применяется к логитам на месте.
Приведённые бенчмарки показывают низкие накладные расходы для протестированных грамматик, токенизаторов, железа и нагрузок. Эти результаты не дают общей гарантии по латентности или throughput.
Практическая реализация на vLLM
Этот код есть в репозитории-компаньоне. uv run pytest проверяет политику и проверки завершённости без модели; шаги в конце раздела запускают полного агента на сервере vLLM.
Фрагменты ниже сокращены из файлов репозитория, названных в их первой строке. Они показывают цепочку роутинг → получение контекста → предложение → одобрение и используют Pydantic 2 и клиент OpenAI для Python.
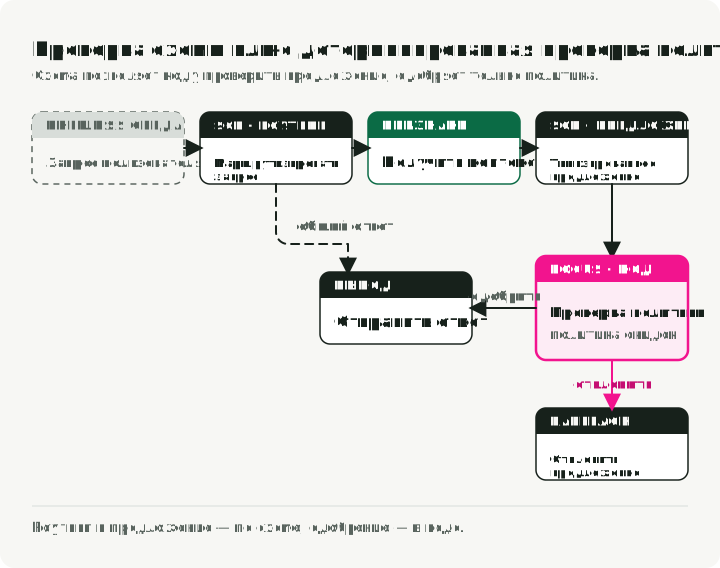
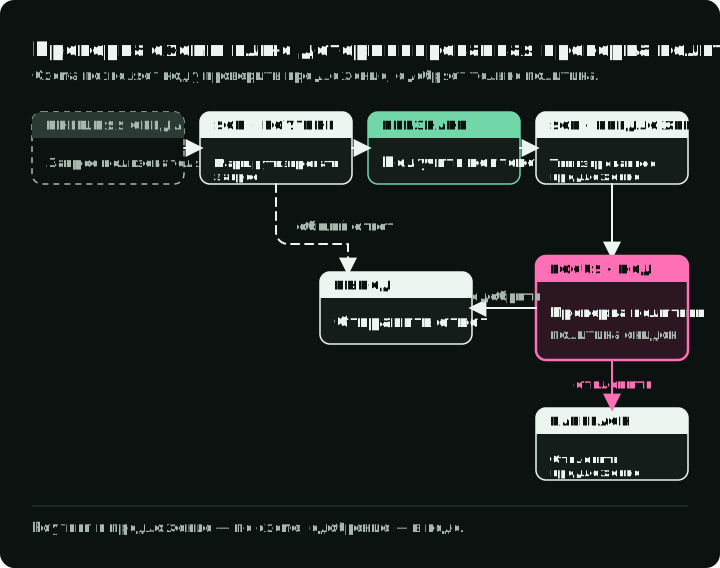
Общий запрос может сразу вернуть ответ. Запросу о цене нужны данные клиента и предложение модели, после чего приложение проверяет политику, и только затем можно сообщить скидку. Если любой из двух вызовов модели остановится до полного ответа, запрос завершится ошибкой; эту проверку показывает шаг 2. Диаграмма показывает все пути через агента и ответ, который возвращает каждый из них.
Шаг 1: определите схемы
sgr/models/schemas.py содержит две схемы, показанные выше. RouterSchema — это роутер из раздела о роутинге: запросить данные клиента через FeatureLookup или вернуть текст через GeneralResponse. PricingLogic содержит четыре поля из раздела про SGR. Описание её поля margin_math даёт модели рабочий пример формата: 'Cart $200 * 0.20 Margin = $40'.
Роутер и схема ценообразования — это отдельные вызовы. Поэтому приложение может получить данные клиента до того, как запросит предложение.
Шаг 2: запросите структурированный ответ и провалидируйте его
Клиент экспортирует модель Pydantic как JSON Schema, добавляет её в существующее системное сообщение как подсказку для модели и отправляет как ограничение structured output. XGrammar настраивается на сервере; схему для каждого запроса передаёт клиент.
completed_content отклоняет неполные, отказные и пустые ответы до того, как Pydantic валидирует JSON и его поля. Он отклоняет остановку по лимиту токенов, даже если возвращённый текст случайно разбирается. Эти ошибки передаются вызывающему коду, который должен вернуть ответ об ошибке или применить политику повторов; на этих путях ни одно предложение не одобряется.
# sgr/utils/llm_client.py
import json
from typing import TypeVar

from openai import OpenAI
from pydantic import BaseModel

T = TypeVar("T", bound=BaseModel)

def completed_content(completion) -> str:
    """Reject incomplete, refused, or empty results before JSON validation."""
    if not completion.choices:
        raise ValueError("No completion returned")
    choice = completion.choices[0]
    if choice.finish_reason != "stop" or getattr(choice.message, "refusal", None):
        raise ValueError("Completion was not successful")
    content = choice.message.content
    if not isinstance(content, str) or not content.strip():
        raise ValueError("Completion has no content")
    return content

class LLMClient:
    """Wrapper for vLLM with XGrammar-enforced structured generation."""

    def __init__(self, base_url: str = "http://localhost:8000/v1"):
        # Local vLLM commonly has no authentication. EMPTY is not authentication.
        self.client = OpenAI(base_url=base_url, api_key="EMPTY")
        self.model = self._get_available_model()

    def _get_available_model(self) -> str:
        """Auto-detect the model running on vLLM server."""
        models = self.client.models.list()
        if not models.data:
            raise RuntimeError("vLLM reported no available models")
        return models.data[0].id

    def run_sgr(self, messages: list[dict], schema_class: type[T]) -> T:
        """Run inference with Schema-Guided Reasoning constraints.

        Uses vLLM structured outputs to constrain the JSON shape at generation time.
        """
        schema_dict = schema_class.model_json_schema()

        # Enhance system message with schema for model guidance
        enhanced_messages = messages.copy()
        if enhanced_messages and enhanced_messages[0]["role"] == "system":
            schema_json = json.dumps(schema_dict, indent=2)
            enhanced_messages[0] = {
                "role": "system",
                "content": (
                    enhanced_messages[0]["content"]
                    + f"\n\nRespond with JSON matching this schema:\n{schema_json}"
                ),
            }

        # vLLM v0.12+ structured outputs. Configure the backend on the server.
        completion = self.client.chat.completions.create(
            model=self.model,
            messages=enhanced_messages,
            temperature=0.1,  # Reduces sampling variation; it is not deterministic.
            extra_body={"structured_outputs": {"json": schema_dict}},
        )

        return schema_class.model_validate_json(completed_content(completion))
В vLLM v0.12 и новее structured_outputs: {"json": schema_dict} запрашивает JSON, соответствующий схеме. Старые поля запроса guided_json и guided_decoding_backend удалены в v0.12.0, а бэкенд теперь задаётся на сервере.
Шаг 3: оркестрация агента
Приложение маршрутизирует запрос, получает данные для аутентифицированного вызывающего, запрашивает предложение, проверяет его и возвращает результат. Feature store использует аутентифицированный user_id, а не ID, предложенный моделью. Промпт также получает user_ltv — оценку пожизненной ценности клиента; эта оценка даёт модели контекст, но не задаёт предел скидки.
Схема гарантирует, что max_discount_percent — число. Она не гарантирует, что это число допустимо; это решает approve_discount. Сначала approve_discount проверяет, что входные значения конечны, сумма корзины положительна, а маржа — доля от 0 до 1. Затем демонстрационная политика отклоняет предложенные проценты вне диапазона 0–20, округляет вниз до сотых процентного пункта и отклоняет итоговую скидку, которая стоит больше валовой прибыли с корзины.
# sgr/agent.py
from decimal import Decimal, ROUND_DOWN

from .models.schemas import PricingLogic, RouterSchema
from .prompts.routing import build_routing_prompt
from .prompts.pricing import build_pricing_context_prompt, ASSISTANT_FETCH_MESSAGE
from .store.hybrid_store import HybridFeatureStore
from .utils.llm_client import LLMClient

def approve_discount(offer: PricingLogic, context: dict) -> Decimal:
    """Enforce the pricing policy independently of the model's explanation."""
    cart_value = Decimal(str(context["current_cart_value"]))
    margin = Decimal(str(context["cart_profit_margin"]))
    proposed = Decimal(str(offer.max_discount_percent))

    if not all(value.is_finite() for value in (cart_value, margin, proposed)):
        raise ValueError("Pricing values must be finite")
    if cart_value <= 0 or not Decimal("0") <= margin <= Decimal("1"):
        raise ValueError("Invalid pricing context")

    if not Decimal("0") <= proposed <= Decimal("20"):
        raise ValueError("Proposed discount violates pricing policy")
    # Policy rounds down to hundredths of a percentage point before approval.
    approved = proposed.quantize(Decimal("0.01"), rounding=ROUND_DOWN)
    gross_profit = cart_value * margin
    discount_cost = cart_value * approved / Decimal("100")
    policy_cap = min(margin * Decimal("100"), Decimal("20"))
    if not Decimal("0") <= approved <= policy_cap or discount_cost > gross_profit:
        raise ValueError("Proposed discount violates pricing policy")

    return approved

def pricing_agent(user_query: str, user_id: str) -> str:
    """Integrate routing, context, and pricing; user_id is caller-authenticated."""

    llm = LLMClient()
    feature_store = HybridFeatureStore()

    # Build conversation history
    history = [
        {"role": "system", "content": build_routing_prompt(user_id)},
        {"role": "user", "content": user_query},
    ]

    # --- Phase 1: Routing (Uses RouterSchema) ---
    print(f"🤖 Processing: '{user_query}' for {user_id}")
    decision = llm.run_sgr(history, RouterSchema)
    print(f"📍 Routing decision: {decision.action.tool_name}")

    if decision.action.tool_name == "respond":
        return decision.action.content

    # --- Phase 2: Context Retrieval ---
    if decision.action.tool_name == "fetch_user_features":
        print(f"🔍 Fetching features for {user_id}...")
        context = feature_store.get_user_context(user_id)

        if not context:
            return "Error: User profile not found."

        print(f"   [Data] LTV: ${context.get('user_ltv')} | "
              f"Margin: {context.get('cart_profit_margin', 0) * 100}%")

        # Inject context into conversation
        history.append({"role": "assistant", "content": ASSISTANT_FETCH_MESSAGE})
        history.append({
            "role": "user",
            "content": build_pricing_context_prompt(
                churn_prob=context.get("churn_probability", 0.5),
                cart_val=context.get("current_cart_value", 100),
                margin=context.get("cart_profit_margin", 0.2),
                user_ltv=context.get("user_ltv", 0),
            ),
        })

        # --- Phase 3: model proposal, then deterministic policy enforcement ---
        print("🧠 Proposing Offer (Schema Enforced)...")
        offer = llm.run_sgr(history, PricingLogic)
        try:
            approved_discount = approve_discount(offer, context)
        except ValueError:
            return "No discount approved: the proposal failed the pricing policy."

        # Audit log: reasoning is inspectable; pricing is application-enforced.
        print(f"   [Audit] Math: {offer.margin_math}")
        print(f"   [Audit] Approved Discount: {approved_discount}%")

        return (
            f"Illustrative approved discount: {approved_discount}%. "
            "No coupon has been issued."
        )

    return "I'm sorry, I couldn't process your request."

if __name__ == "__main__":
    response = pricing_agent("I want a discount or I'm leaving!", "user_102")
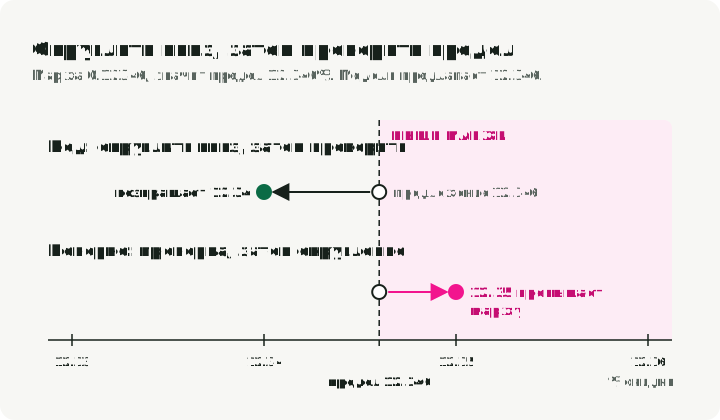
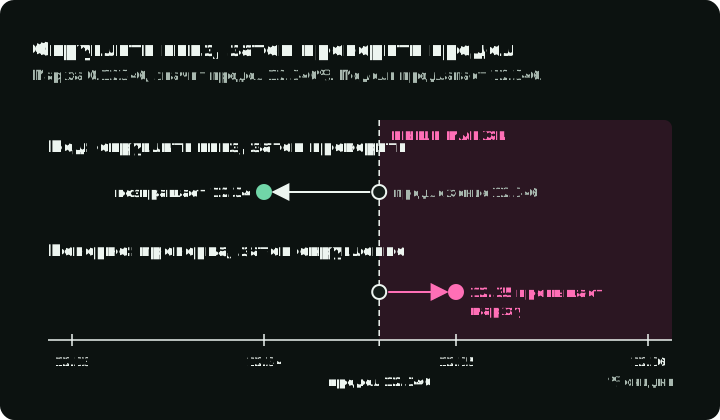
print(f"\n💬 Final Reply: {response}")Предложение 15% для корзины на $200 с маржой 20% возвращает из функции политики 15.00. Приложение сообщает этот процент и не делает вид, что выпускает купон. Граничный тест использует маржу 0.12346, то есть 12,346%. Предложение 12.346 округляется вниз до 12.34, и только потом проверяется итоговое значение. Округление до 12.35 после одобрения превысило бы маржу.
Числовая прямая показывает этот граничный тест: куда попадает возвращаемое значение при каждом порядке округления и проверки.
approve_discount выполняет четыре проверки по порядку:
- Входные значения корректны: стоимость корзины больше 0, маржа от 0 до 1, нет NaN и бесконечности.
- Предложенная скидка лежит между 0 и 20.
- Предложение округляется вниз до 0.01 (12.346 становится 12.34, а не 12.35).
- Округлённое значение не больше процента маржи (и не больше 20), а его стоимость не больше валовой прибыли.
Любая неудачная проверка вызывает ValueError, и предложение не получает скидку. Округление идёт раньше проверки предела, поэтому предел проверяет то значение, которое возвращается.
Запустите демо
Репозиторий запускает весь процесс. Для демо нужны Python 3.13 и uv. Серверу vLLM нужно собственное окружение, поддерживаемый ускоритель и достаточно памяти для модели (руководство по установке); README репозитория описывает установку и вариант с CPU в Docker для тестов.
Установите демо, запустите офлайн-тесты и создайте синтетические данные клиентов:
git clone https://github.com/slavadubrov/sgr-discount-manager
cd sgr-discount-manager
uv sync
uv run pytest
uv run python -m scripts.setup_data
Запустите сервер с XGrammar в качестве бэкенда structured output:
vllm serve Qwen/Qwen2.5-7B-Instruct \
    --port 8000 \
    --structured-outputs-config.backend xgrammar
Позиционный аргумент модели и опция бэкенда соответствуют справочнику по vLLM serve. Клиент подключается к http://localhost:8000/v1; для сервера на другом хосте измените DEFAULT_API_BASE_URL в sgr/config/constants.py.
Запустите агента:
uv run python -m sgr.agentВывод выглядит так. Значения иллюстративные; они зависят от случайных демо-данных и модели:
🤖 Processing: 'I want a discount or I'm leaving!' for user_102
📍 Routing decision: fetch_user_features
🔍 Fetching features for user_102...
   [Data] LTV: $1500.0 | Margin: 20.0%
🧠 Proposing Offer (Schema Enforced)...
   [Audit] Math: Cart $200 * 0.20 Margin = $40
   [Audit] Approved Discount: 15.00%

💬 Final Reply: Illustrative approved discount: 15.00%. No coupon has been issued.
Строка [Audit] Math — это записанный моделью расчёт. Строка Approved Discount и итоговый ответ приходят из approve_discount и кода приложения, а не от модели.
Проверки перед живой интеграцией
Дизайн схемы
- Упорядочивайте поля по предполагаемому ходу ризонинга.
- Пишите описание
Fieldдля каждого поля. Pydantic экспортирует его в JSON Schema, а клиент выше добавляет эту схему в промпт. - Ограничивайте через
LiteralиAnnotated. ИспользуйтеLiteral["a", "b"]для перечислений иAnnotated[int, Ge(1), Le(10)]для границ. - Держите схемы узкими. Одна схема на одну фазу ризонинга, затем композиция через несколько вызовов.
Конфигурация vLLM
- Используйте низкую температуру (0.1–0.3), чтобы уменьшить разброс семплирования. Для воспроизводимых тестов зафиксируйте модель и конфигурацию сервинга, включите детерминированный режим сервера, если он есть, и проверьте результат.
- Объясните в промпте задачу и поля схемы, как это делает клиент выше. Промпт объясняет модели, что означает каждое поле; декодер лишь блокирует недопустимые токены.
- Измеряйте расход токенов на том же промпте, модели, схеме и задаче. SGR может выдавать больше или меньше токенов, чем свободный ответ с CoT.
Соображения для продакшена
- Версионируйте схемы так же, как версионируете API.
- Записывайте предложение и решение по политике отдельно для отладки, с учётом ваших правил хранения и маскирования данных.
- Пересчитывайте цены, лимиты, права доступа и другие семантические правила в коде приложения перед использованием; тестируйте граничные значения, которые одна схема отклонить не может.
Следующий тест
Начните с предела скидки и неполного ответа. Офлайн-тесты репозитория покрывают оба случая, но они не скажут, правильно ли модель направляет реального клиента и точно ли объясняет маржу. Для живой оценки зафиксируйте модель, промпты, схему и настройки сервинга. Посчитайте отдельно неполные результаты, сбои схемы, ошибки роутинга и отказы по политике, прежде чем сравнивать стоимость или точность на задаче.
Ссылки
Фреймворк SGR
- Schema-Guided Reasoning (SGR) — оригинальный фреймворк Рината Абдуллина
- SGR Patterns — паттерны Cascade, Routing, Cycle
xgrammar
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models — Yixin Dong et al., arXiv:2411.15100 (техническая статья с бенчмарками)
- xgrammar GitHub — быстрая и гибкая библиотека структурированной генерации
- xgrammar Documentation — официальная документация с кратким руководством
- xgrammar Quick Start — начало работы с xgrammar
- Achieving Efficient Structured Generation with XGrammar — пост в блоге MLC о внутреннем устройстве xgrammar
vLLM
- vLLM Structured Outputs — официальная документация
Демо-проект
- sgr-discount-manager — демо-компаньон: код из этой статьи, офлайн-тесты и шаги запуска