Schema-Guided Reasoning: vLLM, XGrammar e Pydantic

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este artigo destina-se a engenheiros de Python que precisam de uma resposta do modelo que o código a jusante consiga validar. O Schema-Guided Reasoning (SGR) dá ao modelo uma lista fixa de campos a preencher, com a análise primeiro e a decisão no fim, para que o código possa verificar cada passo. Vai aprender a definir um schema Pydantic, a pedir structured output ao vLLM e a acrescentar verificações na aplicação para o significado e as políticas.
O Pydantic descreve os campos da resposta, o vLLM serve o modelo e o XGrammar restringe os tokens que o modelo pode gerar. Esta restrição chama-se constrained decoding. Um limite de tokens ainda pode deixar um prefixo de JSON incompleto, por isso o código da aplicação tem de verificar se a resposta está completa e validar o resultado.
O que é o Schema-Guided Reasoning?
O Schema-Guided Reasoning é uma técnica que Rinat Abdullin descreveu em julho de 2025. Em vez de deixar o modelo completar texto livremente (o que pode dar resultados inconsistentes ou ambíguos), dá-se-lhe um esquema rígido que define:
- que passos a resposta deve representar
- a ordem pretendida desses passos, para que um revisor possa inspecionar o caminho desde os dados até à decisão
- onde deve concentrar a atenção
Pense nisto como uma lista de verificação de saídas a inspecionar, e não como prova do raciocínio interno do modelo. O decoder verifica a estrutura da saída; o código da aplicação controla quando cada fase corre e se um resultado pode ser usado.
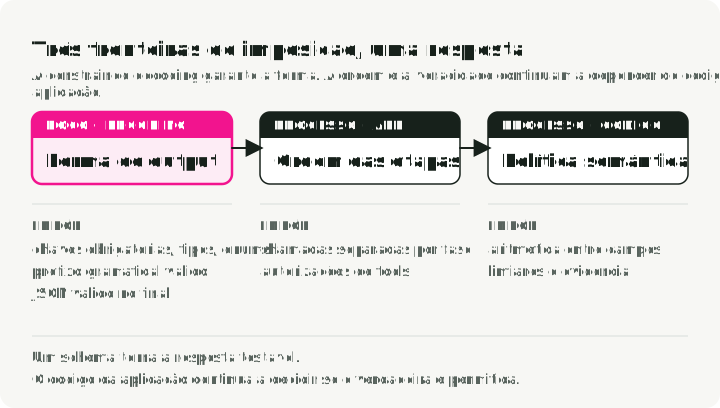
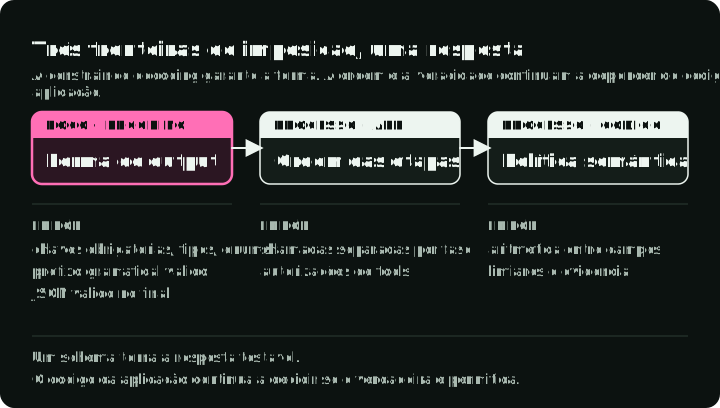
O diagrama acompanha uma resposta de preços pelas três partes que a verificam: o decoder impõe a forma, a aplicação impõe a ordem das fases e a conclusão, e o código de políticas impõe o significado.
O que o schema controla
O exemplo usado ao longo do artigo propõe um desconto para reter um cliente que pode sair. A probabilidade de churn estima essa possibilidade de saída; o valor do carrinho é o total antes do desconto. A margem é o lucro bruto como fração desse total: um carrinho de $200 com uma margem de 0.20 tem $40 de lucro bruto. Os descontos usam pontos percentuais, por isso uma proposta de 15 significa 15%.
Um modelo de preços pode devolver JSON válido e, mesmo assim, propor um desconto de 25% quando a margem é de apenas 20%. O schema regista a proposta; o código da aplicação tem de verificar se o desconto é permitido.
Campos como churn_analysis, margin_math e max_discount_percent tornam explícitas as saídas intermédias pretendidas. Um schema restringe a forma do que é devolvido. Por si só, não faz um campo depender de outro nem prova que a decisão está correta.
Isto dá-lhe:
- uma estrutura de saída comparável entre execuções repetidas
- saídas intermédias registadas que os revisores podem inspecionar
- campos intermédios que pode avaliar com um dataset de teste
- modelos mais pequenos podem seguir o formato com mais frequência; meça a exatidão da tarefa antes de depender disso
- Abdullin escreve que um ganho de 5–10% na exatidão “não é invulgar” nos casos que observou; é uma observação de um profissional, não um resultado de benchmark, por isso meça-o na sua própria carga de trabalho
Use o SGR quando o código a jusante depende da estrutura. Quando uma pessoa lê a resposta como prosa, uma resposta livre é mais simples.
Orientação por prompt e restrições do decoder
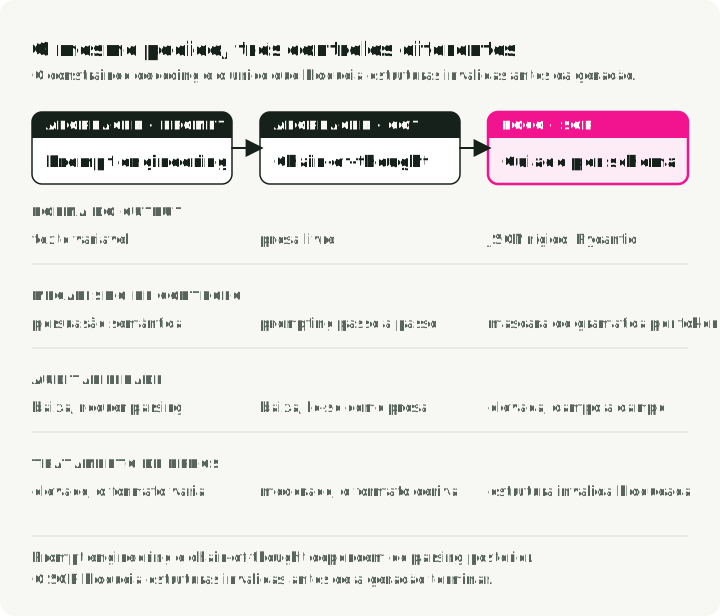
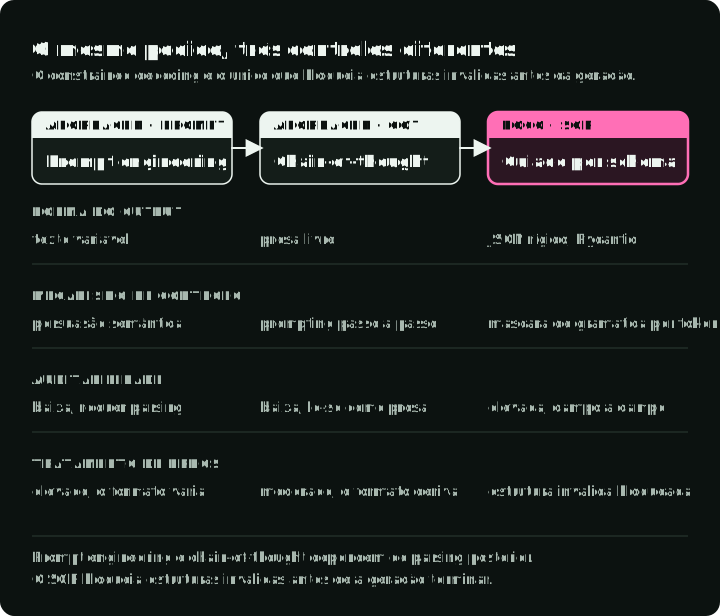
A orientação por prompt e o constrained decoding podem ser combinados. Esta comparação mostra quando cada caminho verifica o formato pedido: só depois da geração, ou também a cada token.
Prompt engineering: pedir o formato
Este prompt pede ao modelo que formate a proposta de desconto como JSON:
Please analyze the customer data and output your response as valid JSON
with the following structure: {"discount": <number>, "reason": <string>}
Be careful with the formatting!
Está a contar que a compreensão que o modelo tem de “output JSON” pese mais do que a sua tendência para conversar. Uma atualização do modelo, uma alteração da temperatura ou um exemplo few-shot diferente pode quebrar o seu parser.
Chain of Thought: um bom registo de raciocínio, o mesmo problema de estrutura
Um prompt de chain-of-thought (CoT) pede uma análise intermédia. A resposta pode ter este aspeto:
Let's think step by step:
1. First, I'll analyze the customer's churn risk...
2. Then I'll calculate the margin...
3. Therefore, I recommend a 15% discount.
O CoT pode melhorar a exatidão da tarefa quando o prompt, o modelo, a tarefa e a avaliação o suportam, mas deixa o resultado em prosa, difícil de analisar com fiabilidade. Pode acabar por fazer uma segunda chamada ao LLM só para extrair dados estruturados.
SGR: chain of thought estruturado
O SGR transforma os passos do chain-of-thought em campos com nome que pode inspecionar e avaliar:
class PricingLogic(BaseModel):
    # 1. Recorded analysis
    churn_analysis: str = Field(..., description="Analyze churn_probability")
    financial_analysis: str = Field(..., description="Analyze cart_value and margin")

    # 2. Proposed calculation, checked by application code
    margin_math: str = Field(..., description="Calculate: 'Cart $X * Y% = $Z'")

    # 3. Proposed decision, not bounded by the analysis fields
    max_discount_percent: float = Field(..., description="Max allowed discount")
O schema lista estes campos por essa ordem. Use chamadas separadas quando um campo posterior tiver de depender de um resultado anterior já verificado.
A tabela compara as três abordagens lado a lado:
| Característica | Prompt engineering | Chain of Thought | Schema-Guided Reasoning |
|---|---|---|---|
| Estrutura da saída | Texto variável | Prosa livre | JSON que corresponde a um schema Pydantic |
| Mecanismo de controlo | Instrução (“output JSON”) | Instrução (“think step by step”) | Prompt mais constrained decoding |
| Quem define os passos | O programador pode indicá-los no prompt | O programador pode fornecer passos ou exemplos | O programador define os campos do esquema |
| Inspeção | Primeiro analisar o texto | Ler a prosa | Ler cada campo |
| Integração | Análise com JSON/Pydantic se o JSON for válido | Análise com JSON/Pydantic se o JSON for válido; caso contrário, extrair a prosa | model_validate_json, depois verificações da aplicação |
Padrões de SGR
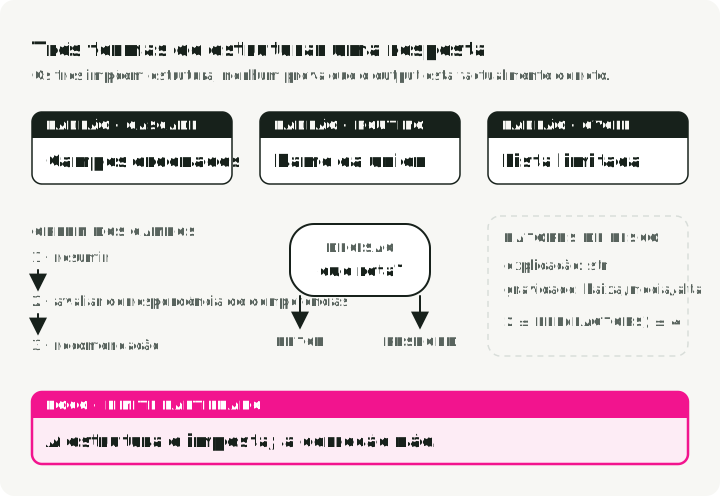
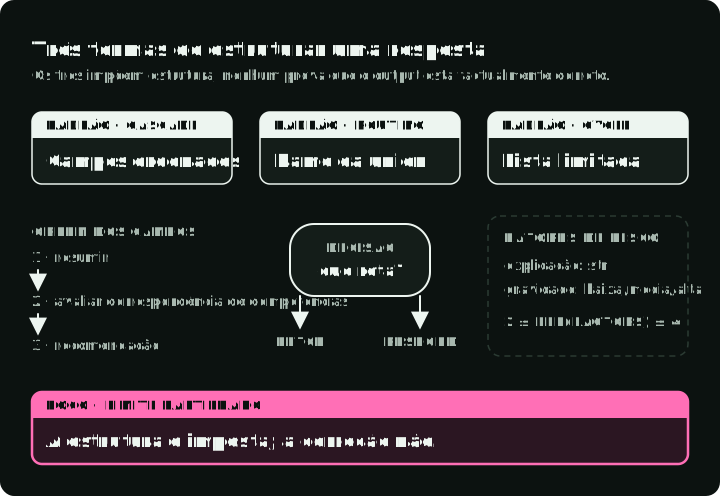
O SGR tem três padrões de base que se combinam em fluxos maiores. O diagrama mostra a forma que cada um dá a uma resposta, com os nomes de campos dos exemplos abaixo, e assinala o limite que cada schema define.
1. Cascade: passos de raciocínio sequenciais
O Cascade representa uma ordem de raciocínio numa única resposta estruturada. Aqui, um classificador de documentos regista um resumo, uma pontuação de correspondência com o tema e uma categoria proposta.
from pydantic import BaseModel
from typing import Literal, Annotated
from annotated_types import Ge, Le

class DocumentEvaluation(BaseModel):
    """Record a document summary, score, and proposed category."""

    # Step 1: Record a summary
    brief_document_summary: str

    # Step 2: Rate (bounded integer)
    rate_topic_match: Annotated[int, Ge(1), Le(10)]

    # Step 3: Decide (constrained choices)
    final_recommendation: Literal["relevant", "irrelevant", "review"]
Usos ilustrativos: classificação de documentos e triagem de tickets de suporte.
Pede-se ao modelo que devolva brief_document_summary, rate_topic_match e final_recommendation por essa ordem.
2. Routing: um switch semântico
O Routing pede ao modelo que selecione um caminho de entre um conjunto de opções, implementado com tipos Union. Este router escolhe entre obter dados do cliente para um pedido de preços e devolver uma resposta geral.
from pydantic import BaseModel
from typing import Literal, Union

class FeatureLookup(BaseModel):
    """Route to database lookup."""
    rationale: str
    tool_name: Literal["fetch_user_features"] = "fetch_user_features"
    user_id: str

class GeneralResponse(BaseModel):
    """Standard response for non-pricing queries."""
    tool_name: Literal["respond"] = "respond"
    content: str

class RouterSchema(BaseModel):
    """The model must pick exactly ONE branch."""
    action: Union[FeatureLookup, GeneralResponse]
Bons casos de uso: classificação de intenções, seleção de ferramentas, triagem de suporte, despacho multi-agent.
Os valores Literal próprios de cada ramo permitem ao Pydantic distinguir os membros da união. Para que o Pydantic escolha o ramo diretamente por tool_name, declare uma união discriminada: action: Union[FeatureLookup, GeneralResponse] = Field(discriminator="tool_name"). Teste se o seu backend aceita o schema exportado.
3. Cycle: raciocínio repetido com listas
O Cycle descreve vários itens, com limites para a sua quantidade. Este exemplo de avaliação de risco pede entre dois e quatro fatores, cada um com uma explicação e uma gravidade.
from pydantic import BaseModel
from typing import List, Literal, Annotated
from annotated_types import MinLen, MaxLen

class RiskFactor(BaseModel):
    explanation: str
    severity: Literal["low", "medium", "high"]

class RiskAssessment(BaseModel):
    """Generate 2-4 risk factors."""
    factors: Annotated[List[RiskFactor], MinLen(2), MaxLen(4)]
Bons casos de uso: avaliação de risco, extração de problemas, tool calls em paralelo, planeamento em vários passos.
Os limites da lista descrevem um lote variável de 2 a 4 itens. Um decoder com suporte pode restringir esse tamanho; a validação da aplicação volta a verificá-lo. Combinada com o Routing, a lista pode descrever tool calls propostas, que o código da aplicação continua a ter de autorizar.
Fazer o SGR funcionar: constrained decoding
Os padrões acima são apenas schemas Pydantic. O constrained decoding consegue impor as restrições suportadas que estão exportadas no respetivo JSON Schema. As funcionalidades que contam como suportadas dependem do backend de decoding. Os validadores arbitrários de Python não se tornam restrições do decoder; continuam a correr no Pydantic depois da geração.
O constrained decoding modifica o passo de geração de tokens. Em vez de deixar o modelo amostrar livremente do seu vocabulário, o motor aplica uma máscara de gramática que bloqueia os tokens que violariam o schema. Isto acontece no motor de inferência, não no código da sua aplicação.
O SGR não exige um modelo de raciocínio. Os modelos ajustados para instruções também produzem respostas restringidas por schema; compare a exatidão da tarefa nos modelos que pretende servir.
Motores e backends
O constrained decoding precisa de uma API ou de um motor de serving que o suporte. Se chamar um modelo alojado por um fornecedor, use a API de structured output do fornecedor: OpenAI Structured Outputs, Gemini structured output e Mistral custom structured output aceitam todos um JSON Schema. As funcionalidades de schema suportadas e o comportamento em caso de falha variam consoante o fornecedor, por isso teste o schema que pretende enviar.
Para um modelo alojado por si, os principais motores têm todos um backend de constrained decoding:
| Motor | Backends de structured output | Use quando |
|---|---|---|
| vLLM | auto (predefinido), xgrammar, guidance, outlines, lm-format-enforcer; defina com --structured-outputs-config.backend | Quer um servidor compatível com a OpenAI e uma escolha de backend; o exemplo deste artigo |
| SGLang | XGrammar (predefinido), Outlines, llguidance; defina com --grammar-backend | Já serve com o SGLang; o XGrammar funciona sem nenhuma opção |
| TensorRT-LLM | XGrammar ou LLGuidance; defina com guided_decoding_backend | Faz deploy em GPUs NVIDIA com o TensorRT-LLM |
| Ollama | JSON Schema no campo format do pedido | Testa localmente num portátil, sem um servidor com GPU |
Duas perguntas decidem a escolha: se o código lê o resultado e quem executa o modelo. Todos os caminhos estruturados terminam nas mesmas verificações da aplicação.
Este artigo usa o vLLM com o XGrammar. A API de structured output do vLLM aceita JSON Schema através de um cliente compatível com a OpenAI. Assim, o exemplo mantém o código habitual dos pedidos e configura o backend de decoding no servidor.
O XGrammar fornece o compilador de gramáticas e o mecanismo de máscaras de tokens. A sua visão geral técnica explica a divisão entre CPU e GPU descrita abaixo; os resultados dos seus benchmarks aplicam-se às cargas de trabalho testadas, não a todos os deployments.
Como o XGrammar impõe schemas
Onde a máscara é aplicada
Os logits são as pontuações não normalizadas que o modelo atribui aos possíveis tokens seguintes. O XGrammar modifica essas pontuações depois do forward pass do modelo e antes da amostragem. Não altera o próprio modelo. Filtra os tokens que podem ser selecionados.
Um ciclo de inferência normal executa o forward pass, amostra o token seguinte a partir dos logits e repete. O XGrammar acrescenta o passo 2:
1. Input tokens → GPU Forward Pass → Raw Logits
2. Raw Logits → XGrammar Logits Processor → Masked Logits
3. Masked Logits → Sampling → Next Token (continues the grammar-valid prefix)
4. Repeat until done
O diagrama mostra um passo com um vocabulário de oito tokens: as pontuações da GPU e o bitmask da CPU encontram-se antes de um token ser selecionado. Cada token aceite também atualiza o estado da gramática para o passo seguinte.
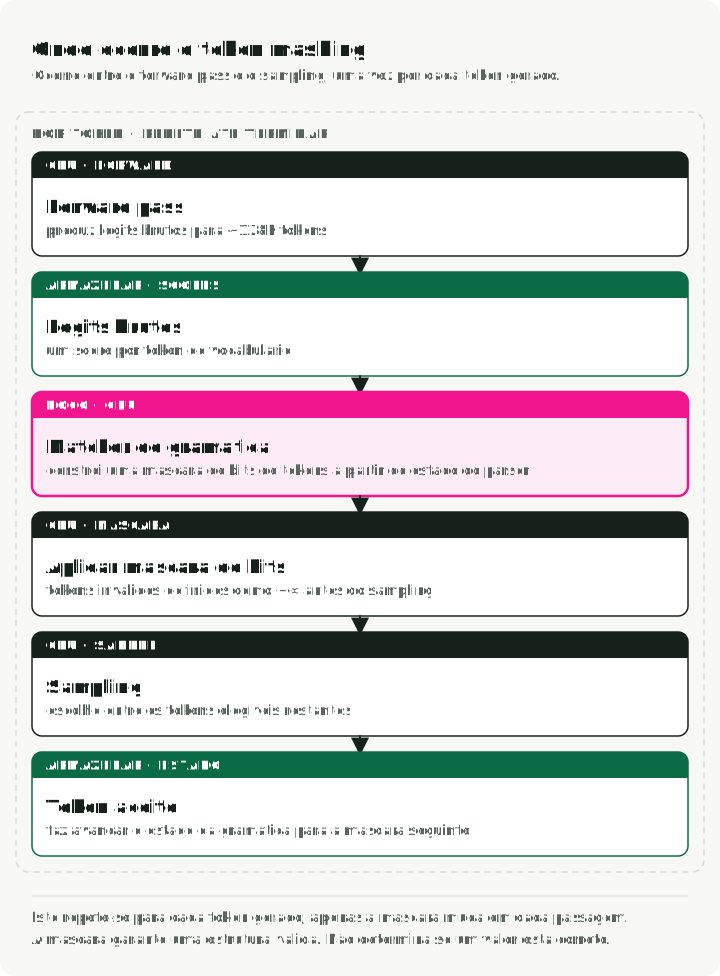
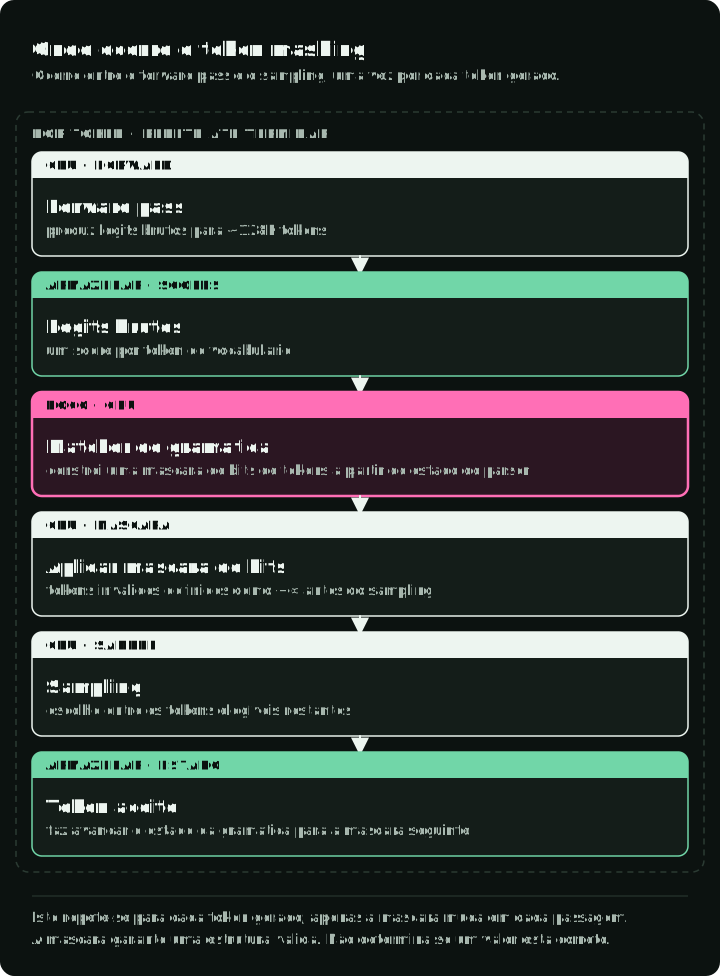
O modelo continua a calcular toda a sua distribuição de probabilidade na GPU. O GrammarMatcher do XGrammar gera o bitmask na CPU; depois, o motor de serving move esse bitmask para o dispositivo dos logits e aplica-o no próprio sítio antes da amostragem. Para logits em GPU, o XGrammar usa um kernel de GPU para essa aplicação. Os tokens inválidos ficam com o logit em -∞, o que torna a sua probabilidade exatamente 0 depois do softmax.
Duas fases
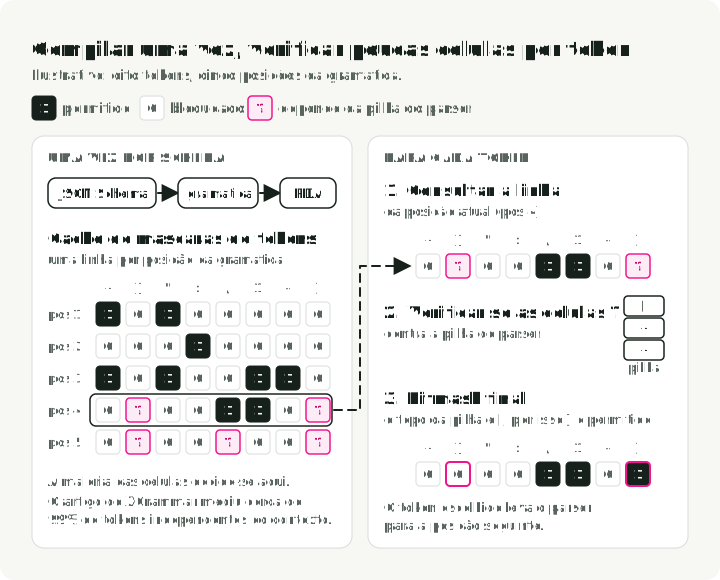
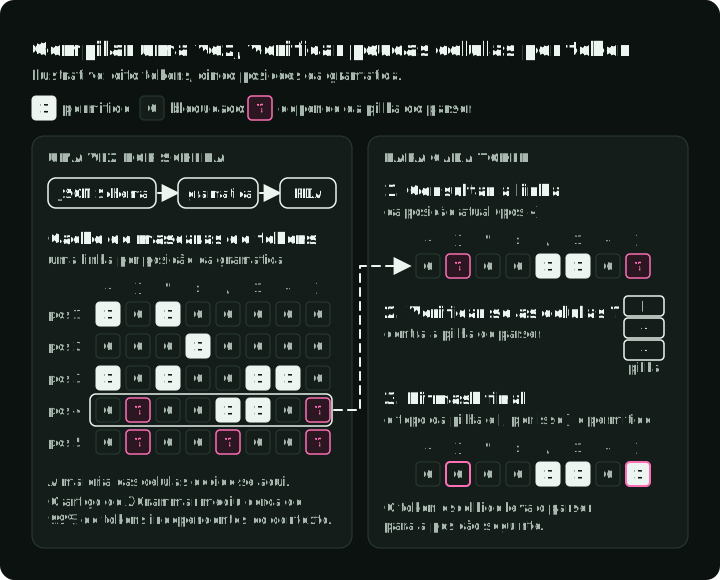
O XGrammar divide o trabalho em tempo de compilação e tempo de execução. Este desenho reduz o trabalho repetido sobre a gramática. O diagrama mostra uma cache ilustrativa construída uma vez por schema (à esquerda) e o trabalho feito para cada token gerado (à direita): a maioria das células já está permitida ou bloqueada, e só as poucas marcadas com ? são verificadas contra a pilha do parser. A seta tracejada marca a ligação: a cache construída uma vez é lida em cada passo.
Fase 1: compilação da gramática, uma vez por schema
Este excerto constrói uma gramática para o schema usando o tokenizer do modelo. O resultado compilado pode ser reutilizado ao gerar respostas com esse schema.
# This happens once per schema
tokenizer_info = xgr.TokenizerInfo.from_huggingface(tokenizer)
grammar_compiler = xgr.GrammarCompiler(tokenizer_info)
compiled_grammar = grammar_compiler.compile_json_schema(schema_json)
Durante a compilação, o XGrammar:
- Converte o JSON Schema numa gramática livre de contexto.
- Constrói um autómato de pilha (Pushdown Automaton, PDA), que é uma máquina de estados com uma pilha, de modo a tratar estruturas aninhadas como
{"a": {"b": {"c": ...}}}. - Pré-calcula que tokens são válidos em cada posição da gramática. O resultado é a “cache adaptativa de máscaras de tokens”.
- Classifica os tokens como “independentes do contexto” (podem ficar em cache) ou “dependentes do contexto” (têm de ser verificados em tempo de execução contra o estado da pilha).
O artigo do XGrammar indica que cerca de 99% dos tokens eram independentes do contexto nas suas medições (artigo). Trate esse número como específico do benchmark, não como uma proporção universal.
Fase 2: geração da máscara em tempo de execução, a cada token
Em cada passo de geração:
- O
GrammarMatcheracompanha a posição atual na gramática. - Consulta a máscara pré-calculada para os tokens independentes do contexto.
- Executa o PDA para verificar os restantes tokens dependentes do contexto.
- Combina-os num bitmask final, move-o para o dispositivo dos logits e aplica-o lá.
Porquê autómatos de pilha e não regex?
Por causa do aninhamento. Uma expressão regular (uma máquina de estados finita) não consegue reconhecer com fiabilidade estruturas como:
{ "user": { "profile": { "settings": { "theme": "dark" } } } }A parte difícil são as chavetas de fecho }}}: é preciso lembrar quantas foram abertas. Um autómato de pilha tem uma pilha que regista isso, por isso consegue tratar qualquer profundidade de aninhamento. É também por isso que o XGrammar consegue impor tipos Union, objetos aninhados e schemas recursivos, onde as abordagens baseadas em regex ficam aquém.
Um exemplo concreto: gerar um campo float
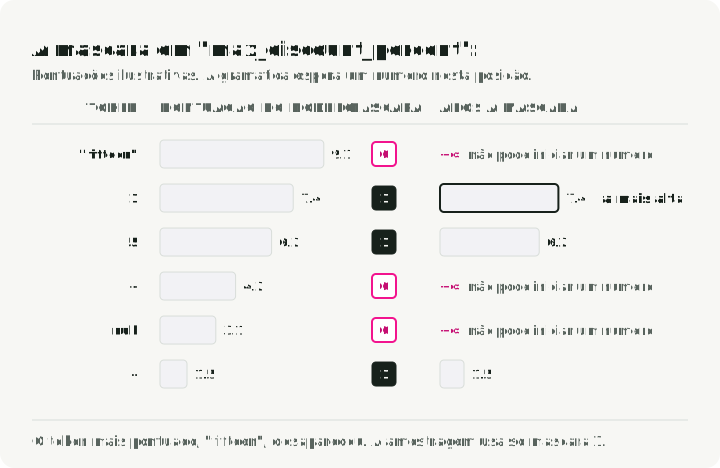
Quando o modelo está a gerar "max_discount_percent":, o XGrammar sabe, pelo schema, que se segue um float. O conjunto de tokens válidos depende do estado do parser e do tokenizer. No início do número, a máscara pode admitir um dígito ou um sinal de menos; depois de um dígito, pode admitir continuações como outro dígito, um ponto decimal ou um marcador de expoente.
- Umas aspas,
{,[,true,falseounullnão podem iniciar este número, por isso a máscara bloqueia os respetivos tokens neste estado. - O forward pass pode ter atribuído uma probabilidade alta ao token de
"fifteen". Como esse token não pode continuar este campo numérico, a máscara remove-o e o modelo tem de escolher uma continuação numérica válida.
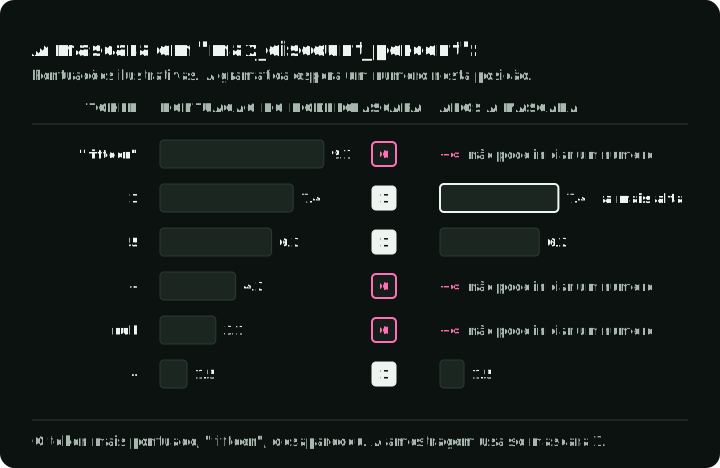
O diagrama mostra pontuações ilustrativas de seis tokens candidatos nesta posição, o bit de máscara de cada um e as pontuações depois da máscara.
O que afeta o overhead
Três fatores determinam o overhead:
- Geração e transferência da máscara. A geração da máscara na CPU e a sua transferência para o dispositivo dos logits; a medida em que isto se sobrepõe ao forward pass depende do motor de serving.
- Cache. A maior parte do trabalho de validade é feita em tempo de compilação. Em tempo de execução, são sobretudo consultas à cache.
- Implementação em C++. O caminho crítico é em C++, não em Python, e a máscara é aplicada aos logits no próprio sítio.
Os benchmarks citados indicam um overhead baixo para as gramáticas, os tokenizers, o hardware e as cargas de trabalho testados. Esses resultados não estabelecem uma garantia geral de latência ou de débito.
Implementação prática com o vLLM
O repositório de acompanhamento contém este código. O comando uv run pytest testa as verificações de política e de completude sem um modelo; os passos no fim desta secção executam o agente completo contra um servidor vLLM.
Os excertos abaixo foram encurtados a partir dos ficheiros do repositório indicados na primeira linha de cada um. Mostram routing → obtenção de contexto → proposta → aprovação, e usam o Pydantic 2 e o cliente Python da OpenAI.
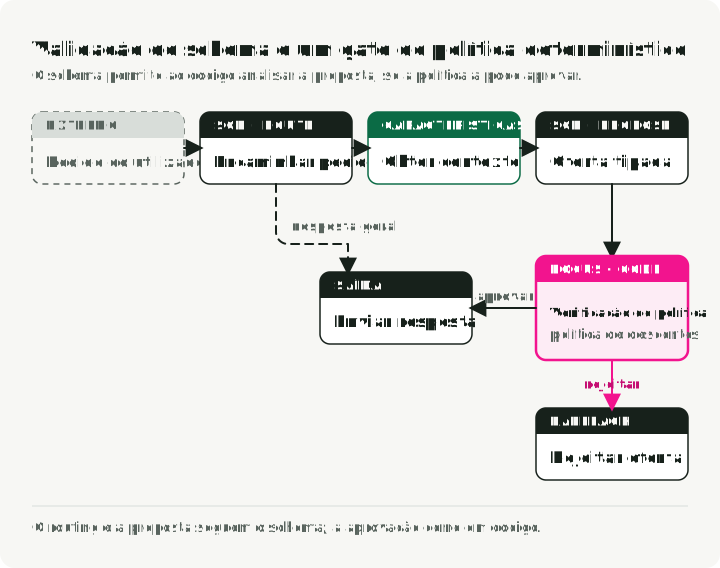
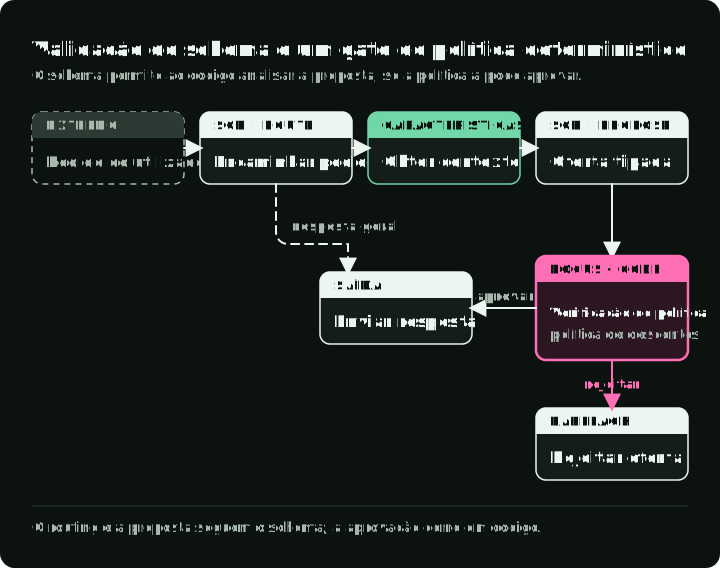
Um pedido geral pode devolver uma resposta de imediato. Um pedido de preços precisa dos dados do cliente e de uma proposta do modelo, seguidas de uma verificação de política da aplicação antes de o desconto poder ser comunicado. Se qualquer das chamadas ao modelo parar antes de uma resposta completa, o pedido termina com um erro; o Passo 2 mostra essa verificação. O diagrama mostra todos os caminhos pelo agente e a resposta que cada um devolve.
Passo 1: definir os schemas
sgr/models/schemas.py contém os dois schemas apresentados antes. O RouterSchema é o router da secção sobre Routing: pede dados do cliente com FeatureLookup ou devolve texto com GeneralResponse. O PricingLogic tem os quatro campos da secção sobre SGR. A descrição do seu margin_math dá ao modelo um exemplo resolvido do formato: 'Cart $200 * 0.20 Margin = $40'.
O router e o schema de preços são chamadas separadas. Isto permite que a aplicação obtenha os dados do cliente antes de pedir uma proposta.
Passo 2: pedir e validar uma resposta estruturada
O cliente exporta o modelo Pydantic como JSON Schema, junta-o a uma mensagem de sistema existente como orientação para o prompt e envia-o como restrição de structured output. O XGrammar é configurado no servidor; o cliente fornece o schema em cada pedido.
O completed_content rejeita respostas incompletas, recusadas ou vazias antes de o Pydantic validar o JSON e os respetivos campos. Rejeita paragens por limite de tokens mesmo que o texto devolvido, por acaso, seja analisável. Estes erros propagam-se até quem chamou, que tem de fornecer uma resposta de erro ou uma política de repetição; nenhuma oferta é aprovada nestes caminhos.
# sgr/utils/llm_client.py
import json
from typing import TypeVar

from openai import OpenAI
from pydantic import BaseModel

T = TypeVar("T", bound=BaseModel)

def completed_content(completion) -> str:
    """Reject incomplete, refused, or empty results before JSON validation."""
    if not completion.choices:
        raise ValueError("No completion returned")
    choice = completion.choices[0]
    if choice.finish_reason != "stop" or getattr(choice.message, "refusal", None):
        raise ValueError("Completion was not successful")
    content = choice.message.content
    if not isinstance(content, str) or not content.strip():
        raise ValueError("Completion has no content")
    return content

class LLMClient:
    """Wrapper for vLLM with XGrammar-enforced structured generation."""

    def __init__(self, base_url: str = "http://localhost:8000/v1"):
        # Local vLLM commonly has no authentication. EMPTY is not authentication.
        self.client = OpenAI(base_url=base_url, api_key="EMPTY")
        self.model = self._get_available_model()

    def _get_available_model(self) -> str:
        """Auto-detect the model running on vLLM server."""
        models = self.client.models.list()
        if not models.data:
            raise RuntimeError("vLLM reported no available models")
        return models.data[0].id

    def run_sgr(self, messages: list[dict], schema_class: type[T]) -> T:
        """Run inference with Schema-Guided Reasoning constraints.

        Uses vLLM structured outputs to constrain the JSON shape at generation time.
        """
        schema_dict = schema_class.model_json_schema()

        # Enhance system message with schema for model guidance
        enhanced_messages = messages.copy()
        if enhanced_messages and enhanced_messages[0]["role"] == "system":
            schema_json = json.dumps(schema_dict, indent=2)
            enhanced_messages[0] = {
                "role": "system",
                "content": (
                    enhanced_messages[0]["content"]
                    + f"\n\nRespond with JSON matching this schema:\n{schema_json}"
                ),
            }

        # vLLM v0.12+ structured outputs. Configure the backend on the server.
        completion = self.client.chat.completions.create(
            model=self.model,
            messages=enhanced_messages,
            temperature=0.1,  # Reduces sampling variation; it is not deterministic.
            extra_body={"structured_outputs": {"json": schema_dict}},
        )

        return schema_class.model_validate_json(completed_content(completion))
No vLLM v0.12 e posteriores, structured_outputs: {"json": schema_dict} pede JSON que corresponda ao schema. Os campos de pedido mais antigos guided_json e guided_decoding_backend foram removidos na v0.12.0, e o backend passou a ser definido no servidor.
Passo 3: orquestrar o agente
A aplicação encaminha o pedido, obtém os dados do chamador autenticado, pede uma proposta, verifica-a e devolve o resultado. O feature store usa o user_id autenticado, nunca o ID proposto pelo modelo. O prompt recebe também user_ltv, o valor estimado do cliente ao longo da vida (lifetime value); essa estimativa dá contexto ao modelo, mas não define o limite do desconto.
O schema garante que max_discount_percent é um número. Não garante que o número seja permitido; é o approve_discount que decide isso. O approve_discount verifica primeiro que as entradas são finitas, que o valor do carrinho é positivo e que a margem é uma fração entre 0 e 1. A política de demonstração rejeita depois as percentagens propostas fora do intervalo 0–20, arredonda por defeito às centésimas de ponto percentual e rejeita um desconto final que custe mais do que o lucro bruto do carrinho.
# sgr/agent.py
from decimal import Decimal, ROUND_DOWN

from .models.schemas import PricingLogic, RouterSchema
from .prompts.routing import build_routing_prompt
from .prompts.pricing import build_pricing_context_prompt, ASSISTANT_FETCH_MESSAGE
from .store.hybrid_store import HybridFeatureStore
from .utils.llm_client import LLMClient

def approve_discount(offer: PricingLogic, context: dict) -> Decimal:
    """Enforce the pricing policy independently of the model's explanation."""
    cart_value = Decimal(str(context["current_cart_value"]))
    margin = Decimal(str(context["cart_profit_margin"]))
    proposed = Decimal(str(offer.max_discount_percent))

    if not all(value.is_finite() for value in (cart_value, margin, proposed)):
        raise ValueError("Pricing values must be finite")
    if cart_value <= 0 or not Decimal("0") <= margin <= Decimal("1"):
        raise ValueError("Invalid pricing context")

    if not Decimal("0") <= proposed <= Decimal("20"):
        raise ValueError("Proposed discount violates pricing policy")
    # Policy rounds down to hundredths of a percentage point before approval.
    approved = proposed.quantize(Decimal("0.01"), rounding=ROUND_DOWN)
    gross_profit = cart_value * margin
    discount_cost = cart_value * approved / Decimal("100")
    policy_cap = min(margin * Decimal("100"), Decimal("20"))
    if not Decimal("0") <= approved <= policy_cap or discount_cost > gross_profit:
        raise ValueError("Proposed discount violates pricing policy")

    return approved

def pricing_agent(user_query: str, user_id: str) -> str:
    """Integrate routing, context, and pricing; user_id is caller-authenticated."""

    llm = LLMClient()
    feature_store = HybridFeatureStore()

    # Build conversation history
    history = [
        {"role": "system", "content": build_routing_prompt(user_id)},
        {"role": "user", "content": user_query},
    ]

    # --- Phase 1: Routing (Uses RouterSchema) ---
    print(f"🤖 Processing: '{user_query}' for {user_id}")
    decision = llm.run_sgr(history, RouterSchema)
    print(f"📍 Routing decision: {decision.action.tool_name}")

    if decision.action.tool_name == "respond":
        return decision.action.content

    # --- Phase 2: Context Retrieval ---
    if decision.action.tool_name == "fetch_user_features":
        print(f"🔍 Fetching features for {user_id}...")
        context = feature_store.get_user_context(user_id)

        if not context:
            return "Error: User profile not found."

        print(f"   [Data] LTV: ${context.get('user_ltv')} | "
              f"Margin: {context.get('cart_profit_margin', 0) * 100}%")

        # Inject context into conversation
        history.append({"role": "assistant", "content": ASSISTANT_FETCH_MESSAGE})
        history.append({
            "role": "user",
            "content": build_pricing_context_prompt(
                churn_prob=context.get("churn_probability", 0.5),
                cart_val=context.get("current_cart_value", 100),
                margin=context.get("cart_profit_margin", 0.2),
                user_ltv=context.get("user_ltv", 0),
            ),
        })

        # --- Phase 3: model proposal, then deterministic policy enforcement ---
        print("🧠 Proposing Offer (Schema Enforced)...")
        offer = llm.run_sgr(history, PricingLogic)
        try:
            approved_discount = approve_discount(offer, context)
        except ValueError:
            return "No discount approved: the proposal failed the pricing policy."

        # Audit log: reasoning is inspectable; pricing is application-enforced.
        print(f"   [Audit] Math: {offer.margin_math}")
        print(f"   [Audit] Approved Discount: {approved_discount}%")

        return (
            f"Illustrative approved discount: {approved_discount}%. "
            "No coupon has been issued."
        )

    return "I'm sorry, I couldn't process your request."

if __name__ == "__main__":
    response = pricing_agent("I want a discount or I'm leaving!", "user_102")
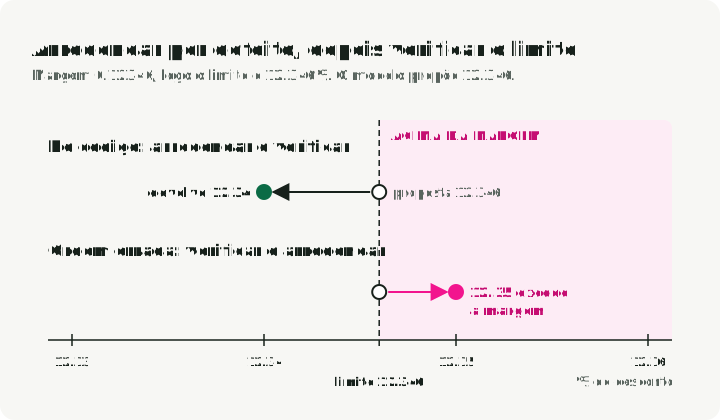
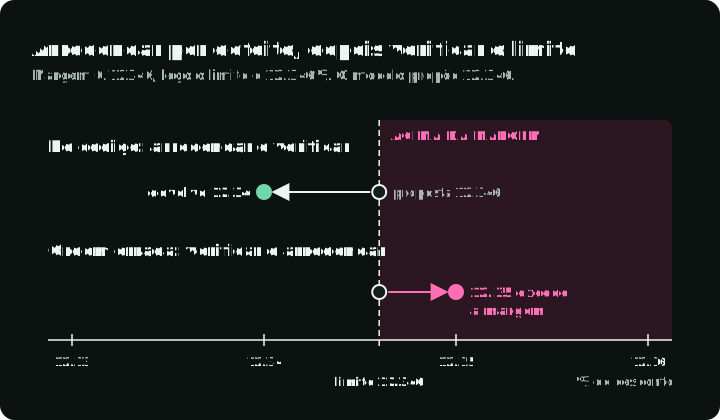
print(f"\n💬 Final Reply: {response}")Uma proposta de 15% num carrinho de $200 com 20% de margem devolve 15.00 na função de política. A aplicação comunica essa percentagem sem fingir que emite um cupão. Um teste de fronteira usa uma margem de 0.12346, ou seja, 12,346%. Uma proposta de 12.346 é arredondada por defeito para 12.34 antes de se verificar o valor final. Arredondar para 12.35 depois da aprovação excederia a margem.
A reta numérica mostra esse teste de fronteira: onde cada ordem de arredondamento e verificação coloca o valor devolvido em relação ao limite.
O approve_discount executa quatro verificações por ordem:
- As entradas são válidas: valor do carrinho acima de 0, margem entre 0 e 1, sem NaN nem infinito.
- O desconto proposto está entre 0 e 20.
- Arredondar a proposta por defeito a 0.01 (12.346 passa a 12.34, não a 12.35).
- O valor arredondado é, no máximo, a percentagem da margem (e no máximo 20), e o seu custo é, no máximo, o lucro bruto.
Qualquer verificação que falhe lança ValueError e a proposta fica sem desconto. O arredondamento vem antes do limite, por isso o limite verifica o valor que é devolvido.
Executar a demonstração
O repositório executa o fluxo completo. A demonstração precisa de Python 3.13 e do uv. O servidor vLLM precisa do seu próprio ambiente, de um acelerador suportado e de memória suficiente para o modelo (guia de instalação); o README do repositório cobre a instalação e uma opção Docker em CPU para testes.
Instale a demonstração, execute os testes offline e crie os dados sintéticos de clientes:
git clone https://github.com/slavadubrov/sgr-discount-manager
cd sgr-discount-manager
uv sync
uv run pytest
uv run python -m scripts.setup_data
Arranque o servidor com o XGrammar como backend de structured output:
vllm serve Qwen/Qwen2.5-7B-Instruct \
    --port 8000 \
    --structured-outputs-config.backend xgrammar
O argumento posicional do modelo e a opção do backend seguem a referência do vLLM serve. O cliente liga-se a http://localhost:8000/v1; para um servidor noutra máquina, altere DEFAULT_API_BASE_URL em sgr/config/constants.py.
Execute o agente:
uv run python -m sgr.agentO output tem esta forma. Os valores são ilustrativos; dependem dos dados de demonstração aleatórios e do modelo:
🤖 Processing: 'I want a discount or I'm leaving!' for user_102
📍 Routing decision: fetch_user_features
🔍 Fetching features for user_102...
   [Data] LTV: $1500.0 | Margin: 20.0%
🧠 Proposing Offer (Schema Enforced)...
   [Audit] Math: Cart $200 * 0.20 Margin = $40
   [Audit] Approved Discount: 15.00%

💬 Final Reply: Illustrative approved discount: 15.00%. No coupon has been issued.
A linha [Audit] Math é o cálculo registado pelo modelo. A linha Approved Discount e a resposta final vêm do approve_discount e do código da aplicação, não do modelo.
Verificações antes de uma integração real
Desenho do schema
- Ordene os campos pelo fluxo de raciocínio pretendido.
- Escreva uma descrição
Fieldpara cada campo. O Pydantic exporta-a para o JSON Schema, e o cliente acima junta esse schema ao prompt. - Restrinja com
LiteraleAnnotated. UseLiteral["a", "b"]para enums eAnnotated[int, Ge(1), Le(10)]para limites. - Mantenha os schemas focados. Um schema por fase de raciocínio e depois componha com várias chamadas.
Configuração do vLLM
- Use uma temperatura baixa (0.1-0.3) para reduzir a variação da amostragem. Para testes repetíveis, fixe o modelo e a configuração de serving, use o modo determinístico do servidor se existir e verifique o resultado.
- Explique a tarefa e os campos do schema no prompt, como o cliente acima faz. O prompt diz ao modelo o que significa cada campo; o decoder apenas bloqueia tokens inválidos.
- Meça o uso de tokens com o mesmo prompt, modelo, schema e tarefa. O SGR pode emitir mais ou menos tokens do que uma resposta de CoT livre.
Considerações para produção
- Versione os seus schemas da mesma forma que versiona as APIs.
- Registe a proposta e a decisão de política em separado para depuração, sujeito às suas regras de conservação e ocultação de dados.
- Volte a calcular preços, limites, permissões e outras regras semânticas no código da aplicação antes de os usar; teste os valores-limite que o schema, por si só, não consegue rejeitar.
O teste seguinte
Comece pelo limite do desconto e por uma resposta incompleta. Os testes offline do repositório cobrem ambos, mas não dizem se um modelo encaminha corretamente um cliente real nem se explica a margem com exatidão. Numa avaliação com o modelo em execução, mantenha fixos o modelo, os prompts, o schema e as definições de serving. Conte separadamente os resultados incompletos, as falhas de schema, os erros de routing e as rejeições de política antes de comparar o custo ou a exatidão da tarefa.
Referências
Framework SGR
- Schema-Guided Reasoning (SGR) — o framework original de Rinat Abdullin
- SGR Patterns — padrões Cascade, Routing e Cycle
xgrammar
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models — Yixin Dong et al., arXiv:2411.15100 (artigo técnico com benchmarks)
- xgrammar GitHub — biblioteca rápida e flexível de geração estruturada
- xgrammar Documentation — documentação oficial com guia de início rápido
- xgrammar Quick Start — primeiros passos com o xgrammar
- Achieving Efficient Structured Generation with XGrammar — publicação do blogue da MLC sobre o funcionamento interno do xgrammar
vLLM
- vLLM Structured Outputs — documentação oficial
Projeto de demonstração
- sgr-discount-manager — projeto de demonstração: o código deste artigo, testes offline e passos de execução