Schema-Guided Reasoning: vLLM, XGrammar i Pydantic

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten artykuł jest przeznaczony dla inżynierów Pythona, którzy potrzebują wyników modelu, które kod dalej w systemie może zwalidować. Schema-Guided Reasoning (SGR) daje modelowi stałą listę pól do wypełnienia, najpierw analiza, na końcu decyzja, dzięki czemu kod może sprawdzić każdy krok. Dowiesz się, jak zdefiniować schemat Pydantic, zażądać od vLLM ustrukturyzowanych danych wyjściowych i dodać kontrole aplikacji dotyczące znaczenia i polityki.
Pydantic opisuje pola odpowiedzi, vLLM udostępnia model, a XGrammar ogranicza, jaki token model może wygenerować. To ograniczenie nazywa się constrained decoding. Limit liczby jednostek token nadal może zostawić niepełny początek JSON, dlatego kod aplikacji musi sprawdzić kompletność i zwalidować wynik.
Czym jest Schema-Guided Reasoning?
Schema-Guided Reasoning to technika, którą Rinat Abdullin opisał w lipcu 2025 roku. Zamiast pozwalać modelowi swobodnie dopisywać tekst (co może być niespójne lub niejednoznaczne), dajesz mu ścisły szablon, który określa:
- jakie kroki ma przedstawiać odpowiedź
- zamierzoną kolejność tych kroków, tak aby recenzent mógł sprawdzić drogę od danych do decyzji
- na czym model ma skupić uwagę
Potraktuj to jak listę kontrolną wyników, które można sprawdzić, a nie dowód na wewnętrzne rozumowanie modelu. Dekoder sprawdza strukturę wyniku; kod aplikacji decyduje, kiedy uruchamia się każdy etap i czy wynik wolno wykorzystać.
Diagram śledzi jedną odpowiedź cenową przez trzy części, które ją sprawdzają: dekoder wymusza kształt, aplikacja wymusza kolejność etapów i zakończenie, a kod polityki wymusza znaczenie.
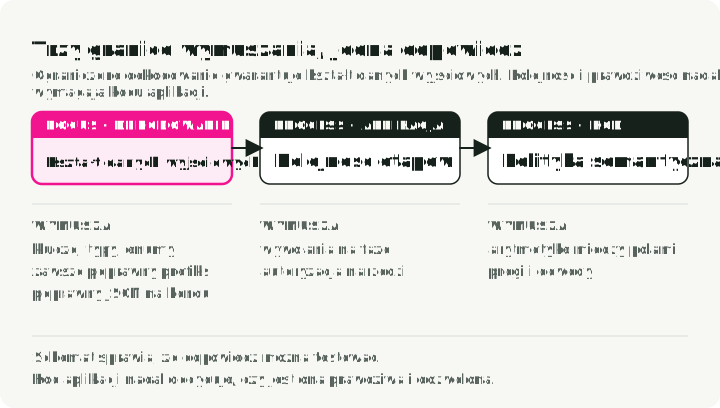
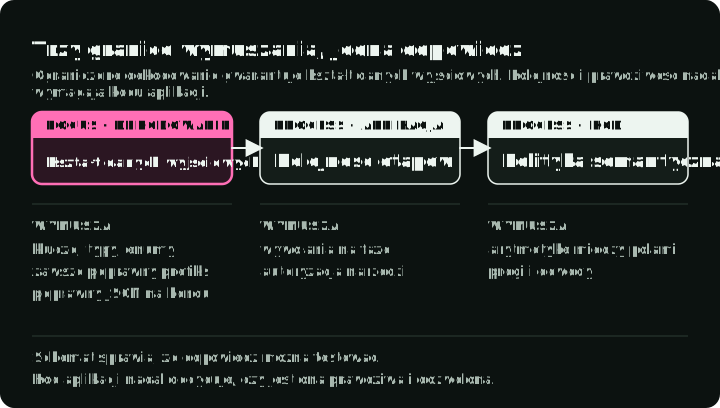
Co kontroluje schemat
Przykład przewodni proponuje rabat, który ma zatrzymać klienta mogącego odejść. Prawdopodobieństwo odejścia (churn) szacuje tę szansę; wartość koszyka to suma przed rabatem. Marża to zysk brutto jako ułamek tej sumy: koszyk za $200 z marżą 0.20 daje $40 zysku brutto. Rabaty wyrażamy w punktach procentowych, więc propozycja 15 oznacza 15%.
Model wyceny może zwrócić poprawny JSON i mimo to zaproponować rabat 25%, gdy marża wynosi tylko 20%. Schemat zapisuje propozycję; kod aplikacji musi sprawdzić, czy rabat jest dozwolony.
Pola takie jak churn_analysis, margin_math i max_discount_percent jawnie określają zamierzone wyniki pośrednie. Schemat ogranicza kształt zwracanych danych. Sam z siebie nie sprawia, że jedno pole zależy od drugiego, ani nie dowodzi, że decyzja jest poprawna.
Dzięki temu dostajesz:
- porównywalną strukturę wyniku w kolejnych uruchomieniach
- zapisane wyniki pośrednie, które recenzenci mogą sprawdzić
- pola pośrednie, które możesz oceniać na zbiorze testowym
- mniejsze modele mogą częściej trzymać się formatu; zmierz trafność zadania, zanim na tym polegasz
- Abdullin pisze, że wzrost trafności o 5–10% jest “nierzadki” w przypadkach, które obserwował; to obserwacja praktyka, a nie wynik benchmarku, więc zmierz to na własnym obciążeniu
Używaj SGR, gdy kod w dalszej części systemu zależy od struktury. Gdy odpowiedź czyta człowiek jako tekst, prostsza jest odpowiedź w wolnej formie.
Wskazówki zawarte w tekście prompt i ograniczenia dekodera
Wskazówki zawarte w tekście prompt i constrained decoding można łączyć. To porównanie pokazuje, kiedy każda ścieżka sprawdza żądany format: tylko po generowaniu czy także dla każdej jednostki token.
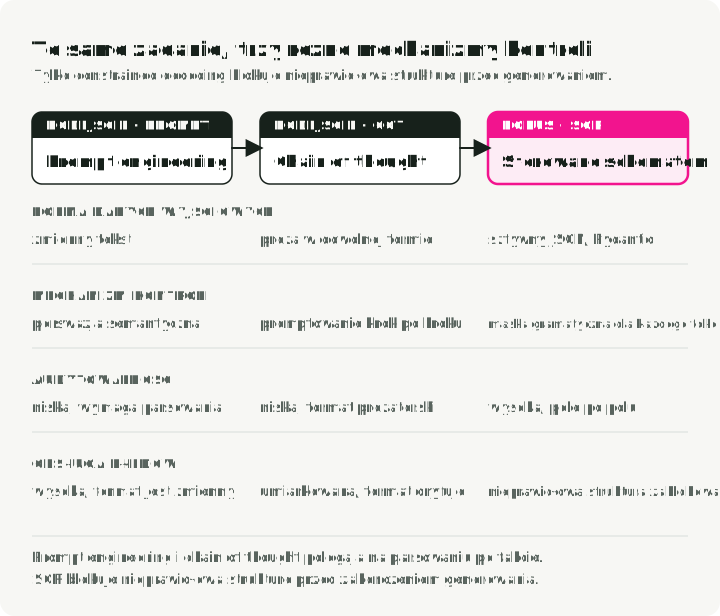
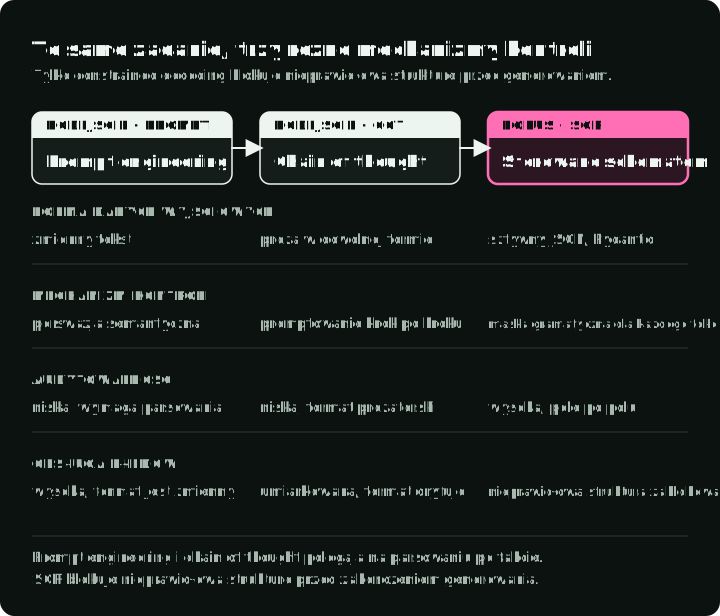
Prompt engineering: prośba o format
Ten prompt prosi model o sformatowanie propozycji rabatu jako JSON:
Please analyze the customer data and output your response as valid JSON
with the following structure: {"discount": <number>, "reason": <string>}
Be careful with the formatting!
Liczysz na to, że rozumienie “output JSON” przeważy nad skłonnością modelu do konwersacyjnego stylu. Aktualizacja modelu, zmiana temperatury lub inny przykład few-shot może zepsuć twój parser.
Chain of Thought: użyteczny ślad rozumowania, ten sam problem ze strukturą
Prompt chain-of-thought (CoT) prosi o analizę pośrednią. Odpowiedź może wyglądać tak:
Let's think step by step:
1. First, I'll analyze the customer's churn risk...
2. Then I'll calculate the margin...
3. Therefore, I recommend a 15% discount.
CoT może poprawić trafność zadania, gdy wspierają to prompt, model, zadanie i ewaluacja, ale zostawia wynik jako tekst, który trudno niezawodnie sparsować. Możesz skończyć na drugim wywołaniu LLM tylko po to, by wyciągnąć ustrukturyzowane dane.
SGR: ustrukturyzowany chain of thought
SGR zamienia kroki chain-of-thought w nazwane pola, które możesz sprawdzać i oceniać:
class PricingLogic(BaseModel):
    # 1. Recorded analysis
    churn_analysis: str = Field(..., description="Analyze churn_probability")
    financial_analysis: str = Field(..., description="Analyze cart_value and margin")

    # 2. Proposed calculation, checked by application code
    margin_math: str = Field(..., description="Calculate: 'Cart $X * Y% = $Z'")

    # 3. Proposed decision, not bounded by the analysis fields
    max_discount_percent: float = Field(..., description="Max allowed discount")
Schemat wymienia te pola w tej kolejności. Używaj osobnych wywołań, gdy późniejsze pole musi zależeć od sprawdzonego wcześniejszego wyniku.
Tabela porównuje te trzy podejścia obok siebie:
| Cecha | Prompt engineering | Chain of Thought | Schema-Guided Reasoning |
|---|---|---|---|
| Struktura wyniku | Zmienny tekst | Proza w wolnej formie | JSON zgodny ze schematem Pydantic |
| Mechanizm kontroli | Instrukcja (“output JSON”) | Instrukcja (“think step by step”) | Prompt plus constrained decoding |
| Kto określa kroki | Programista może je nazwać w tekście prompt | Programista może podać kroki lub przykłady | Programista definiuje pola schematu |
| Inspekcja | Najpierw sparsuj tekst | Przeczytaj prozę | Przeczytaj każde pole |
| Integracja | Parsowanie JSON/Pydantic, jeśli JSON jest poprawny | Parsowanie JSON/Pydantic, jeśli JSON jest poprawny; w przeciwnym razie ekstrakcja prozy | model_validate_json, potem kontrole aplikacji |
Wzorce SGR
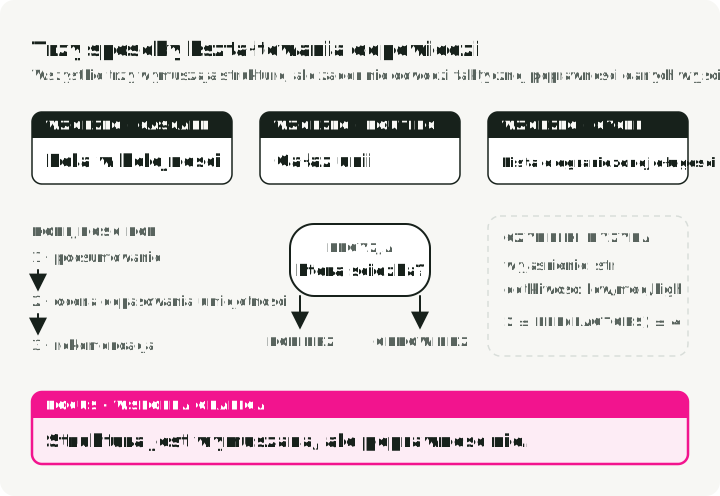
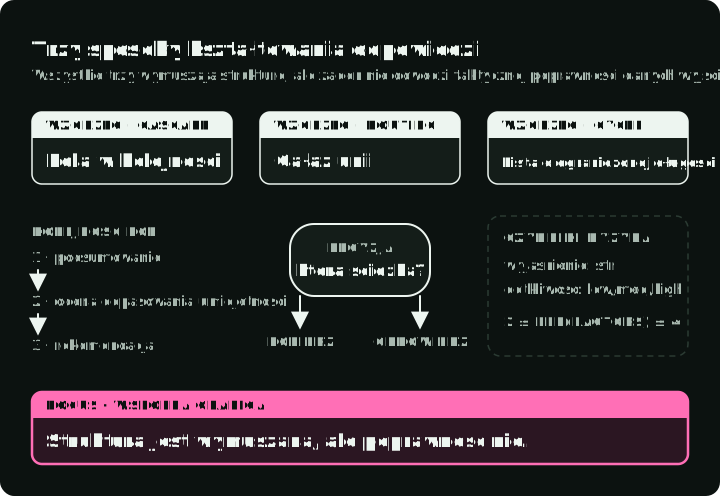
SGR ma trzy podstawowe wzorce, które składają się w większe przepływy. Diagram pokazuje kształt, jaki każdy z nich nadaje odpowiedzi, na polach z przykładów poniżej, i zaznacza limit, który ustala każdy schemat.
1. Cascade: kolejne kroki rozumowania
Cascade wyraża kolejność rozumowania w jednej ustrukturyzowanej odpowiedzi. Tutaj klasyfikator dokumentów zapisuje streszczenie, wynik dopasowania do tematu i proponowaną kategorię.
from pydantic import BaseModel
from typing import Literal, Annotated
from annotated_types import Ge, Le

class DocumentEvaluation(BaseModel):
    """Record a document summary, score, and proposed category."""

    # Step 1: Record a summary
    brief_document_summary: str

    # Step 2: Rate (bounded integer)
    rate_topic_match: Annotated[int, Ge(1), Le(10)]

    # Step 3: Decide (constrained choices)
    final_recommendation: Literal["relevant", "irrelevant", "review"]
Przykładowe zastosowania: klasyfikacja dokumentów i triaż zgłoszeń do wsparcia.
Model ma zwrócić brief_document_summary, rate_topic_match i final_recommendation w tej kolejności.
2. Routing: semantyczna instrukcja switch
Routing prosi model o wybór jednej ścieżki z zestawu opcji, zaimplementowany za pomocą typów Union. Ten router wybiera między pobraniem danych klienta dla żądania dotyczącego ceny a zwróceniem ogólnej odpowiedzi.
from pydantic import BaseModel
from typing import Literal, Union

class FeatureLookup(BaseModel):
    """Route to database lookup."""
    rationale: str
    tool_name: Literal["fetch_user_features"] = "fetch_user_features"
    user_id: str

class GeneralResponse(BaseModel):
    """Standard response for non-pricing queries."""
    tool_name: Literal["respond"] = "respond"
    content: str

class RouterSchema(BaseModel):
    """The model must pick exactly ONE branch."""
    action: Union[FeatureLookup, GeneralResponse]
Dobrze pasuje do: klasyfikacji intencji, wyboru narzędzia, triażu zgłoszeń do wsparcia, dyspozytury wielu agentów.
Wartości Literal specyficzne dla gałęzi pozwalają Pydantic odróżnić członków unii. Aby Pydantic wybierał gałąź bezpośrednio po tool_name, zadeklaruj unię z dyskryminatorem: action: Union[FeatureLookup, GeneralResponse] = Field(discriminator="tool_name"). Sprawdź, czy twój backend akceptuje wyeksportowany schemat.
3. Cycle: powtarzane rozumowanie z listami
Cycle opisuje wiele elementów z ograniczeniem ich liczby. Ten przykład oceny ryzyka żąda od dwóch do czterech czynników, każdy z wyjaśnieniem i poziomem istotności.
from pydantic import BaseModel
from typing import List, Literal, Annotated
from annotated_types import MinLen, MaxLen

class RiskFactor(BaseModel):
    explanation: str
    severity: Literal["low", "medium", "high"]

class RiskAssessment(BaseModel):
    """Generate 2-4 risk factors."""
    factors: Annotated[List[RiskFactor], MinLen(2), MaxLen(4)]
Dobrze pasuje do: oceny ryzyka, wyodrębniania problemów, równoległych wywołań narzędzi, wieloetapowego planowania.
Granice listy opisują zmienną partię 2–4 elementów. Obsługiwany dekoder może ograniczyć tę długość; walidacja w aplikacji sprawdza ją ponownie. W połączeniu z Routingiem lista może opisywać proponowane wywołania narzędzi, które kod aplikacji nadal autoryzuje.
Jak działa SGR: constrained decoding
Powyższe wzorce to po prostu schematy Pydantic. Constrained decoding może wymusić obsługiwane ograniczenia wyeksportowane do ich JSON Schema. To, które funkcje są obsługiwane, zależy od backendu dekodowania. Dowolne walidatory Pythona nie stają się ograniczeniami dekodera; nadal działają w Pydantic po wygenerowaniu.
Constrained decoding zmienia krok generowania jednostek token. Zamiast pozwalać modelowi swobodnie losować ze swojego słownika, silnik stosuje maskę gramatyki, która blokuje każdy token naruszający schemat. Dzieje się to w silniku inferencji, a nie w kodzie aplikacji.
SGR nie wymaga modelu rozumującego. Modele dostrojone do instrukcji również tworzą odpowiedzi ograniczone schematem; porównaj trafność zadania na modelach, które planujesz udostępniać.
Silniki i backendy
Constrained decoding wymaga API albo silnika inferencji, który to obsługuje. Jeśli wywołujesz model hostowany, użyj API ustrukturyzowanych danych wyjściowych dostawcy: OpenAI Structured Outputs, Gemini structured output i Mistral custom structured output akceptują JSON Schema. Obsługiwane funkcje schematu i zachowanie przy błędach różnią się między dostawcami, więc przetestuj schemat, który planujesz wysłać.
Dla modelu hostowanego samodzielnie główne silniki mają backend constrained decoding:
| Silnik | Backendy ustrukturyzowanych danych wyjściowych | Kiedy używać |
|---|---|---|
| vLLM | auto (domyślny), xgrammar, guidance, outlines, lm-format-enforcer; ustawiany przez --structured-outputs-config.backend | Chcesz serwera zgodnego z OpenAI i wyboru backendu; przykład z tego artykułu |
| SGLang | XGrammar (domyślny), Outlines, llguidance; ustawiany przez --grammar-backend | Już serwujesz modele przez SGLang; XGrammar działa bez flagi |
| TensorRT-LLM | XGrammar lub LLGuidance; ustawiany przez guided_decoding_backend | Wdrażasz na GPU NVIDIA z TensorRT-LLM |
| Ollama | JSON Schema w polu format żądania | Testujesz lokalnie na laptopie bez serwera z GPU |
O wyborze decydują dwa pytania: czy kod czyta wynik i kto uruchamia model. Każda ścieżka ustrukturyzowana kończy się tymi samymi kontrolami aplikacji.
Ten artykuł używa vLLM z XGrammar. API ustrukturyzowanych danych wyjściowych vLLM akceptuje JSON Schema przez klienta zgodnego z OpenAI. Dzięki temu przykład zachowuje znajomy kod obsługi żądań, a backend dekodowania konfiguruje się na serwerze.
XGrammar dostarcza kompilator gramatyki i mechanizm masek token. Jego przegląd techniczny wyjaśnia podział CPU/GPU opisany niżej; wyniki benchmarków dotyczą testowanych obciążeń, a nie każdego wdrożenia.
Jak XGrammar wymusza schematy
Gdzie odbywa się maskowanie
Logity to nieznormalizowane wyniki modelu dla kandydatów na następny token. XGrammar modyfikuje te wyniki po przejściu w przód modelu i przed próbkowaniem. Nie zmienia samego modelu. Filtruje zbiór, z którego można wybrać token.
Standardowa pętla inferencji wykonuje przejście w przód, próbkuje następny token z logitów i powtarza. XGrammar dodaje krok 2:
1. Input tokens → GPU Forward Pass → Raw Logits
2. Raw Logits → XGrammar Logits Processor → Masked Logits
3. Masked Logits → Sampling → Next Token (continues the grammar-valid prefix)
4. Repeat until done
Diagram pokazuje jeden krok na słowniku z ośmioma jednostkami token: wyniki z GPU i bitmaska z CPU spotykają się przed wyborem jednostki token. Każdy zaakceptowany token aktualizuje też stan gramatyki dla następnego kroku.
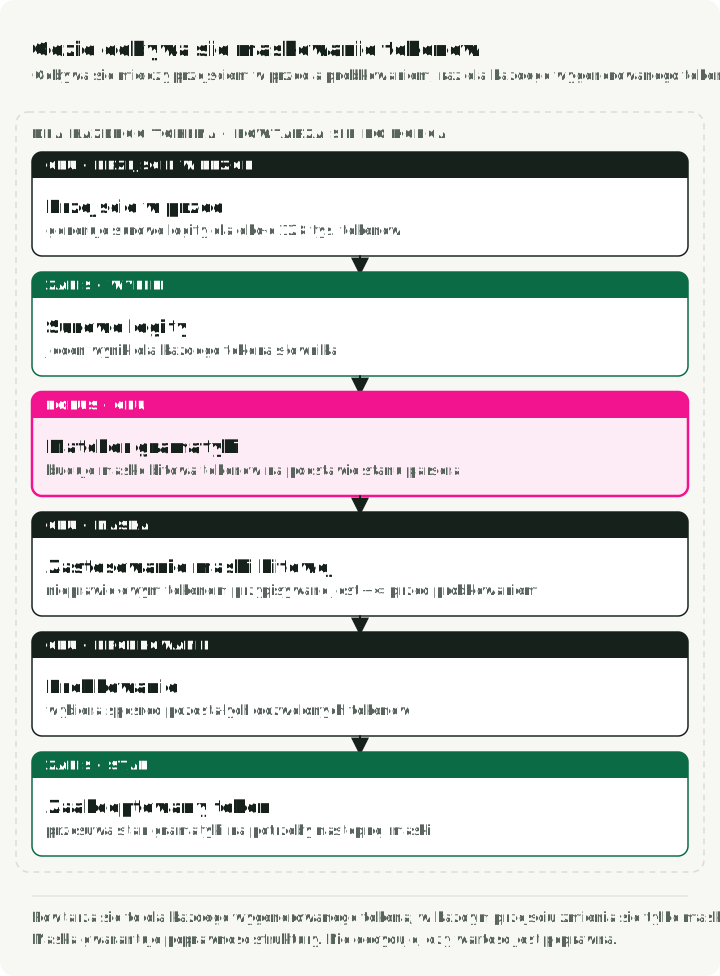
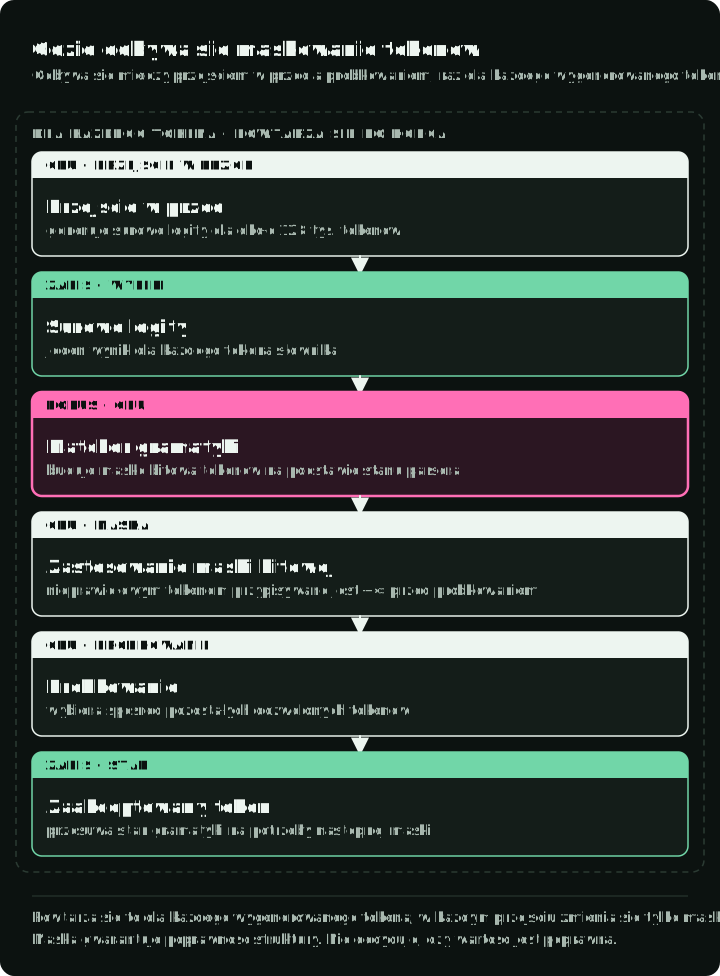
Model nadal oblicza pełny rozkład prawdopodobieństwa na GPU. GrammarMatcher z XGrammar generuje bitmaskę na CPU, a następnie silnik serwujący przenosi ją na urządzenie logitów i stosuje w miejscu przed próbkowaniem. Dla logitów na GPU XGrammar używa do tego kernela GPU. Dla każdej niepoprawnej jednostki token logit ustawia się na -∞, co po softmaksie daje jej prawdopodobieństwo dokładnie 0.
Dwie fazy
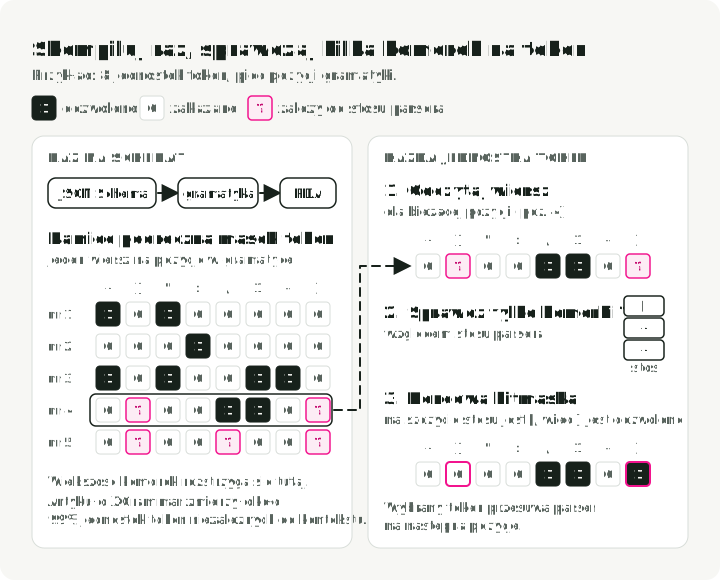
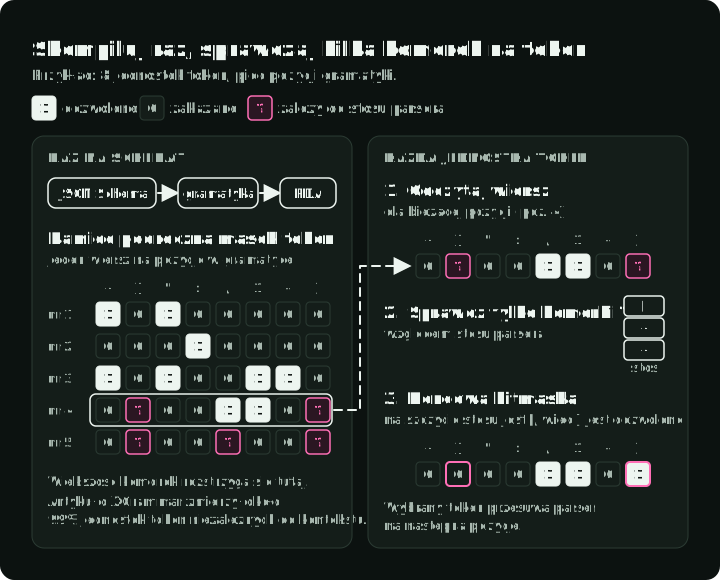
XGrammar dzieli pracę na czas kompilacji i czas działania. Ten projekt ogranicza powtarzanie pracy nad gramatyką. Diagram pokazuje przykładową pamięć podręczną zbudowaną raz na schemat (po lewej) oraz pracę wykonywaną dla każdej wygenerowanej jednostki token (po prawej): większość komórek jest już dozwolona lub zablokowana, a tylko nieliczne oznaczone ? są sprawdzane względem stosu parsera. Przerywana strzałka oznacza powiązanie: pamięć podręczna zbudowana raz jest odczytywana w każdym kroku.
Faza 1: kompilacja gramatyki, raz na schemat
Ten fragment buduje gramatykę dla schematu, używając tokenizera modelu. Skompilowany wynik można ponownie wykorzystać przy generowaniu odpowiedzi z tym schematem.
# This happens once per schema
tokenizer_info = xgr.TokenizerInfo.from_huggingface(tokenizer)
grammar_compiler = xgr.GrammarCompiler(tokenizer_info)
compiled_grammar = grammar_compiler.compile_json_schema(schema_json)
Podczas kompilacji XGrammar:
- Konwertuje JSON Schema na gramatykę bezkontekstową.
- Buduje automat ze stosem (Pushdown Automaton, PDA), czyli maszynę stanów ze stosem, dzięki czemu radzi sobie z zagnieżdżonymi strukturami, takimi jak
{"a": {"b": {"c": ...}}}. - Z góry oblicza, które jednostki token są poprawne w każdym miejscu gramatyki. Wynikiem jest “adaptacyjna pamięć podręczna masek token”.
- Dzieli jednostki token na “niezależne od kontekstu” (można je buforować) i “zależne od kontekstu” (trzeba je sprawdzić w czasie działania względem stanu stosu).
Artykuł o XGrammar podaje, że w jego pomiarach około 99% jednostek token było niezależnych od kontekstu (artykuł). Traktuj tę liczbę jako specyficzną dla benchmarku, a nie uniwersalną proporcję.
Faza 2: generowanie maski w czasie działania, dla każdej jednostki token
W każdym kroku generowania:
GrammarMatcherśledzi bieżącą pozycję w gramatyce.- Odczytuje wstępnie obliczoną maskę dla jednostek token niezależnych od kontekstu.
- Uruchamia PDA, aby sprawdzić pozostałe jednostki token zależne od kontekstu.
- Łączy je w końcową bitmaskę, przenosi ją na urządzenie logitów i tam stosuje.
Dlaczego automaty ze stosem, a nie regex?
Z powodu zagnieżdżenia. Wyrażenie regularne (automat skończony) nie potrafi niezawodnie dopasować struktur takich jak:
{ "user": { "profile": { "settings": { "theme": "dark" } } } }Trudność leży w zamykających nawiasach }}}: trzeba pamiętać, ile otwarto. Automat ze stosem ma stos, który to śledzi, więc obsługuje dowolną głębokość zagnieżdżenia. Dlatego XGrammar może wymuszać typy Union, zagnieżdżone obiekty i schematy rekurencyjne, w których podejścia oparte na regex zawodzą.
Konkretny przykład: generowanie pola float
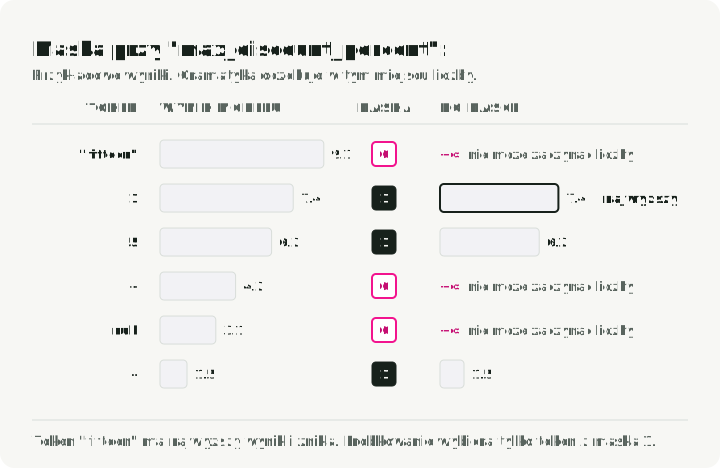
Gdy model generuje "max_discount_percent":, XGrammar wie ze schematu, że dalej pojawi się float. Zbiór poprawnych jednostek token zależy od stanu parsera i tokenizera. Na początku liczby maska może dopuszczać cyfrę albo znak minus; po cyfrze może dopuszczać kontynuacje takie jak kolejna cyfra, kropka dziesiętna lub znacznik wykładnika.
- Cudzysłów,
{,[,true,falseaninullnie mogą zacząć tej liczby, więc maska blokuje odpowiadające im jednostki token w tym stanie. - Przejście w przód mogło przypisać wysokie prawdopodobieństwo dla jednostki token odpowiadającej
"fifteen". Ponieważ ten token nie może kontynuować tego pola liczbowego, maska go usuwa i model musi wybrać poprawną kontynuację liczbową.
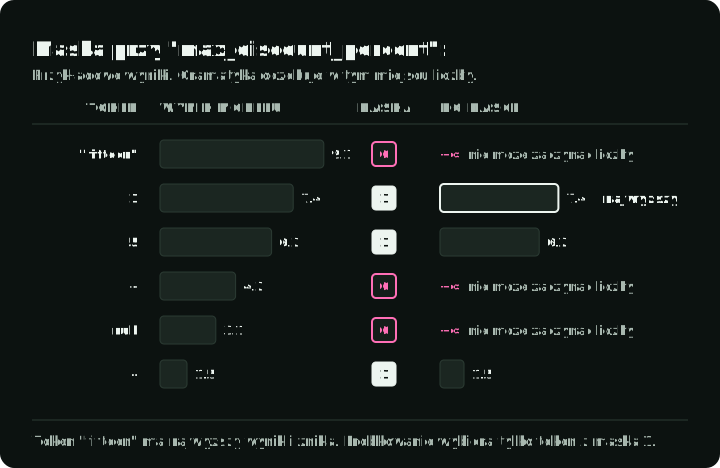
Diagram pokazuje przykładowe wyniki dla sześciu kandydatów typu token w tym miejscu, bit maski dla każdego z nich oraz wyniki po zastosowaniu maski.
Co wpływa na narzut
Narzut wyznaczają trzy rzeczy:
- Generowanie maski i transfer. Generowanie maski na CPU i jej transfer na urządzenie logitów; to, jak bardzo nakłada się to na przejście w przód, zależy od silnika serwującego.
- Buforowanie. Większość pracy nad poprawnością jest wykonywana w czasie kompilacji. W czasie działania to głównie odczyty z pamięci podręcznej.
- Implementacja w C++. Gorąca ścieżka jest w C++, a nie w Pythonie, a maska jest stosowana do logitów w miejscu.
Przytaczane benchmarki podają niski narzut dla testowanych gramatyk, tokenizerów, sprzętu i obciążeń. Wyniki te nie dają ogólnej gwarancji opóźnienia ani przepustowości.
Praktyczna implementacja z vLLM
Repozytorium towarzyszące zawiera ten kod. uv run pytest testuje kontrole polityki i kompletności bez modelu; kroki na końcu tej sekcji uruchamiają pełnego agenta na serwerze vLLM.
Poniższe fragmenty są skrócone z plików repozytorium wskazanych w ich pierwszej linii. Pokazują routing → pobranie kontekstu → propozycja → zatwierdzenie i używają Pydantic 2 oraz klienta OpenAI dla Pythona.
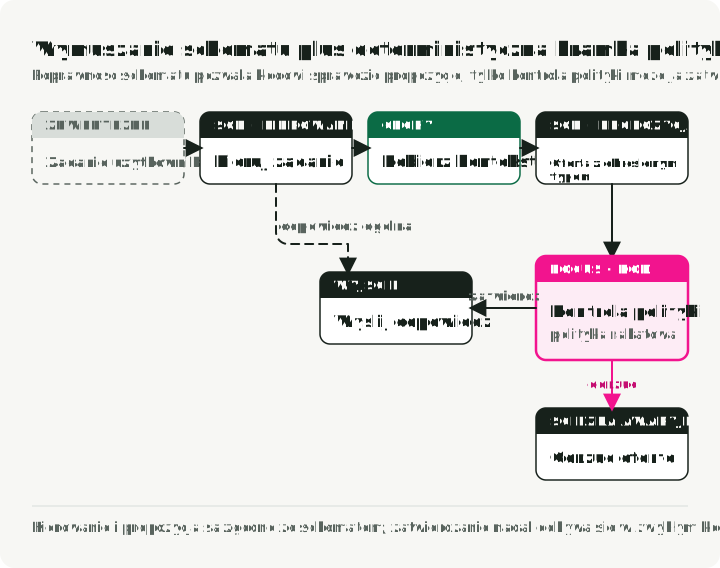
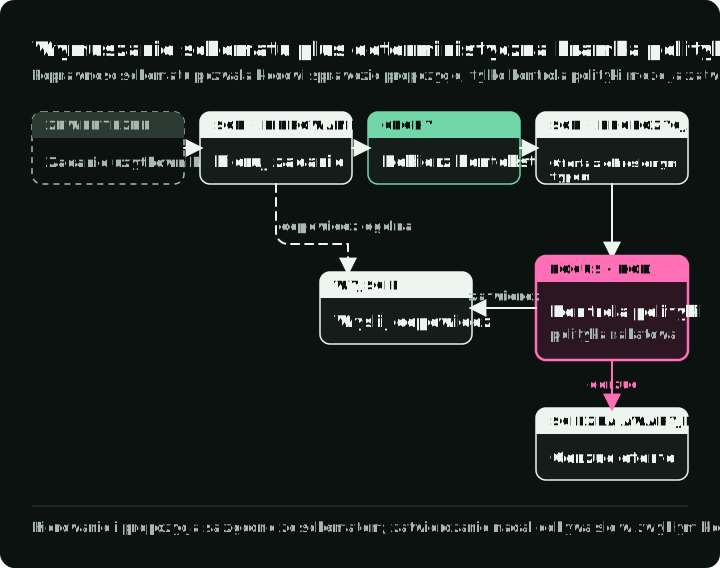
Ogólne żądanie może od razu zwrócić odpowiedź. Żądanie dotyczące ceny potrzebuje danych klienta i propozycji modelu, a potem kontroli polityki w aplikacji, zanim rabat będzie można zgłosić. Jeśli którekolwiek wywołanie modelu zatrzyma się przed pełną odpowiedzią, żądanie kończy się błędem; pokazuje to kontrola w kroku 2. Diagram pokazuje każdą ścieżkę przez agenta i odpowiedź, jaką każda z nich zwraca.
Krok 1: zdefiniuj schematy
sgr/models/schemas.py zawiera dwa schematy pokazane wcześniej. RouterSchema to router z sekcji o Routingu: żąda danych klienta przez FeatureLookup albo zwraca tekst przez GeneralResponse. PricingLogic ma cztery pola z sekcji o SGR. Opis jego pola margin_math daje modelowi przykład formatu: 'Cart $200 * 0.20 Margin = $40'.
Router i schemat wyceny to osobne wywołania. Dzięki temu aplikacja może pobrać dane klienta, zanim poprosi o propozycję.
Krok 2: zażądaj ustrukturyzowanej odpowiedzi i zwaliduj ją
Klient eksportuje model Pydantic jako JSON Schema, dodaje go do istniejącego komunikatu systemowego jako wskazówkę w tekście prompt i wysyła jako ograniczenie ustrukturyzowanych danych wyjściowych. XGrammar konfiguruje się na serwerze; klient podaje schemat w każdym żądaniu.
completed_content odrzuca niepełne, odrzucone przez model lub puste odpowiedzi, zanim Pydantic zwaliduje JSON i jego pola. Odrzuca zatrzymanie z powodu limitu liczby jednostek token, nawet jeśli zwrócony tekst akurat da się sparsować. Te błędy trafiają do wywołującego, który musi zapewnić odpowiedź błędu lub politykę ponawiania; na tych ścieżkach żadna oferta nie jest zatwierdzana.
# sgr/utils/llm_client.py
import json
from typing import TypeVar

from openai import OpenAI
from pydantic import BaseModel

T = TypeVar("T", bound=BaseModel)

def completed_content(completion) -> str:
    """Reject incomplete, refused, or empty results before JSON validation."""
    if not completion.choices:
        raise ValueError("No completion returned")
    choice = completion.choices[0]
    if choice.finish_reason != "stop" or getattr(choice.message, "refusal", None):
        raise ValueError("Completion was not successful")
    content = choice.message.content
    if not isinstance(content, str) or not content.strip():
        raise ValueError("Completion has no content")
    return content

class LLMClient:
    """Wrapper for vLLM with XGrammar-enforced structured generation."""

    def __init__(self, base_url: str = "http://localhost:8000/v1"):
        # Local vLLM commonly has no authentication. EMPTY is not authentication.
        self.client = OpenAI(base_url=base_url, api_key="EMPTY")
        self.model = self._get_available_model()

    def _get_available_model(self) -> str:
        """Auto-detect the model running on vLLM server."""
        models = self.client.models.list()
        if not models.data:
            raise RuntimeError("vLLM reported no available models")
        return models.data[0].id

    def run_sgr(self, messages: list[dict], schema_class: type[T]) -> T:
        """Run inference with Schema-Guided Reasoning constraints.

        Uses vLLM structured outputs to constrain the JSON shape at generation time.
        """
        schema_dict = schema_class.model_json_schema()

        # Enhance system message with schema for model guidance
        enhanced_messages = messages.copy()
        if enhanced_messages and enhanced_messages[0]["role"] == "system":
            schema_json = json.dumps(schema_dict, indent=2)
            enhanced_messages[0] = {
                "role": "system",
                "content": (
                    enhanced_messages[0]["content"]
                    + f"\n\nRespond with JSON matching this schema:\n{schema_json}"
                ),
            }

        # vLLM v0.12+ structured outputs. Configure the backend on the server.
        completion = self.client.chat.completions.create(
            model=self.model,
            messages=enhanced_messages,
            temperature=0.1,  # Reduces sampling variation; it is not deterministic.
            extra_body={"structured_outputs": {"json": schema_dict}},
        )

        return schema_class.model_validate_json(completed_content(completion))
W vLLM v0.12 i nowszych structured_outputs: {"json": schema_dict} żąda JSON zgodnego ze schematem. Starsze pola żądania guided_json i guided_decoding_backend usunięto w v0.12.0, a backend ustawia się teraz na serwerze.
Krok 3: zorkiestruj agenta
Aplikacja kieruje żądanie, pobiera dane dla uwierzytelnionego wywołującego, prosi o propozycję, sprawdza ją i zwraca wynik. Magazyn cech używa uwierzytelnionego user_id, nigdy identyfikatora zaproponowanego przez model. Prompt dostaje też user_ltv, szacowaną wartość klienta w całym okresie współpracy; to oszacowanie daje modelowi kontekst, ale nie ustala limitu rabatu.
Schemat gwarantuje, że max_discount_percent jest liczbą. Nie gwarantuje, że ta liczba jest dozwolona; decyduje o tym approve_discount. approve_discount najpierw sprawdza, czy dane wejściowe są skończone, wartość koszyka jest dodatnia, a marża jest ułamkiem między 0 a 1. Polityka demonstracyjna odrzuca następnie proponowane procenty spoza zakresu 0–20, zaokrągla w dół do setnych części punktu procentowego i odrzuca końcowy rabat, który kosztuje więcej niż zysk brutto koszyka.
# sgr/agent.py
from decimal import Decimal, ROUND_DOWN

from .models.schemas import PricingLogic, RouterSchema
from .prompts.routing import build_routing_prompt
from .prompts.pricing import build_pricing_context_prompt, ASSISTANT_FETCH_MESSAGE
from .store.hybrid_store import HybridFeatureStore
from .utils.llm_client import LLMClient

def approve_discount(offer: PricingLogic, context: dict) -> Decimal:
    """Enforce the pricing policy independently of the model's explanation."""
    cart_value = Decimal(str(context["current_cart_value"]))
    margin = Decimal(str(context["cart_profit_margin"]))
    proposed = Decimal(str(offer.max_discount_percent))

    if not all(value.is_finite() for value in (cart_value, margin, proposed)):
        raise ValueError("Pricing values must be finite")
    if cart_value <= 0 or not Decimal("0") <= margin <= Decimal("1"):
        raise ValueError("Invalid pricing context")

    if not Decimal("0") <= proposed <= Decimal("20"):
        raise ValueError("Proposed discount violates pricing policy")
    # Policy rounds down to hundredths of a percentage point before approval.
    approved = proposed.quantize(Decimal("0.01"), rounding=ROUND_DOWN)
    gross_profit = cart_value * margin
    discount_cost = cart_value * approved / Decimal("100")
    policy_cap = min(margin * Decimal("100"), Decimal("20"))
    if not Decimal("0") <= approved <= policy_cap or discount_cost > gross_profit:
        raise ValueError("Proposed discount violates pricing policy")

    return approved

def pricing_agent(user_query: str, user_id: str) -> str:
    """Integrate routing, context, and pricing; user_id is caller-authenticated."""

    llm = LLMClient()
    feature_store = HybridFeatureStore()

    # Build conversation history
    history = [
        {"role": "system", "content": build_routing_prompt(user_id)},
        {"role": "user", "content": user_query},
    ]

    # --- Phase 1: Routing (Uses RouterSchema) ---
    print(f"🤖 Processing: '{user_query}' for {user_id}")
    decision = llm.run_sgr(history, RouterSchema)
    print(f"📍 Routing decision: {decision.action.tool_name}")

    if decision.action.tool_name == "respond":
        return decision.action.content

    # --- Phase 2: Context Retrieval ---
    if decision.action.tool_name == "fetch_user_features":
        print(f"🔍 Fetching features for {user_id}...")
        context = feature_store.get_user_context(user_id)

        if not context:
            return "Error: User profile not found."

        print(f"   [Data] LTV: ${context.get('user_ltv')} | "
              f"Margin: {context.get('cart_profit_margin', 0) * 100}%")

        # Inject context into conversation
        history.append({"role": "assistant", "content": ASSISTANT_FETCH_MESSAGE})
        history.append({
            "role": "user",
            "content": build_pricing_context_prompt(
                churn_prob=context.get("churn_probability", 0.5),
                cart_val=context.get("current_cart_value", 100),
                margin=context.get("cart_profit_margin", 0.2),
                user_ltv=context.get("user_ltv", 0),
            ),
        })

        # --- Phase 3: model proposal, then deterministic policy enforcement ---
        print("🧠 Proposing Offer (Schema Enforced)...")
        offer = llm.run_sgr(history, PricingLogic)
        try:
            approved_discount = approve_discount(offer, context)
        except ValueError:
            return "No discount approved: the proposal failed the pricing policy."

        # Audit log: reasoning is inspectable; pricing is application-enforced.
        print(f"   [Audit] Math: {offer.margin_math}")
        print(f"   [Audit] Approved Discount: {approved_discount}%")

        return (
            f"Illustrative approved discount: {approved_discount}%. "
            "No coupon has been issued."
        )

    return "I'm sorry, I couldn't process your request."

if __name__ == "__main__":
    response = pricing_agent("I want a discount or I'm leaving!", "user_102")
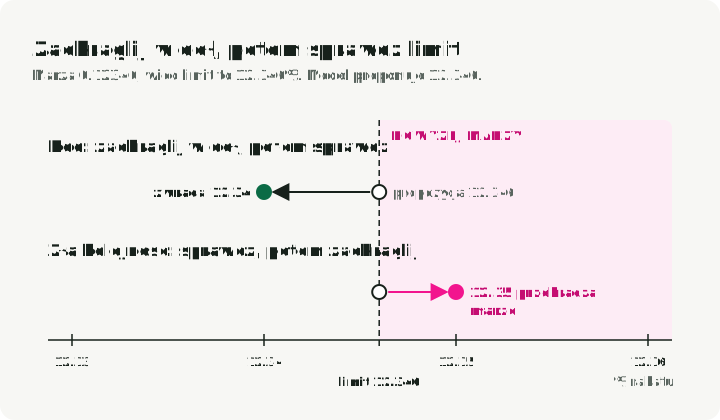
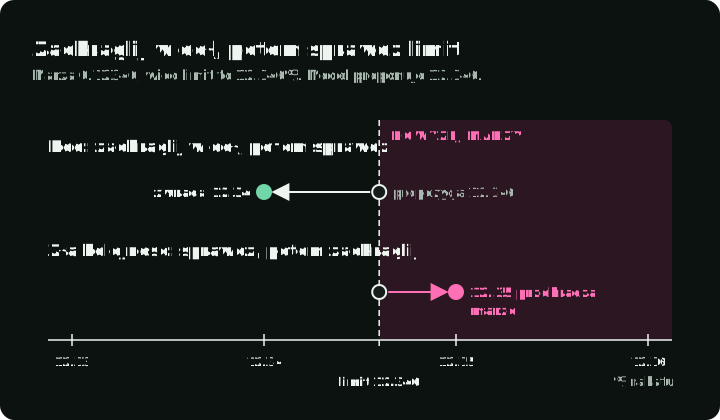
print(f"\n💬 Final Reply: {response}")Propozycja 15% dla koszyka za $200 z marżą 20% zwraca z funkcji polityki 15.00. Aplikacja zgłasza ten procent, nie udając, że wydaje kupon. Test graniczny używa marży 0.12346, czyli 12,346%. Propozycja 12.346 jest zaokrąglana w dół do 12.34 przed sprawdzeniem końcowej wartości. Zaokrąglenie do 12.35 po zatwierdzeniu przekroczyłoby marżę.
Linia liczbowa pokazuje ten test graniczny: gdzie każda kolejność zaokrąglania i sprawdzania umieszcza zwróconą wartość względem limitu.
approve_discount wykonuje cztery kontrole po kolei:
- Dane wejściowe są poprawne: wartość koszyka powyżej 0, marża między 0 a 1, brak NaN i nieskończoności.
- Proponowany rabat mieści się między 0 a 20.
- Zaokrąglij propozycję w dół do 0.01 (12.346 daje 12.34, nie 12.35).
- Zaokrąglona wartość nie przekracza procentu marży (i 20), a jej koszt nie przekracza zysku brutto.
Każda nieudana kontrola zgłasza ValueError, a propozycja nie dostaje rabatu. Zaokrąglanie następuje przed sprawdzeniem limitu, więc limit sprawdza zwracaną wartość.
Uruchom demo
Repozytorium uruchamia cały przepływ. Demo wymaga Pythona 3.13 i uv. Serwer vLLM wymaga własnego środowiska, obsługiwanego akceleratora i wystarczającej pamięci na model (instrukcja instalacji); README repozytorium opisuje instalację i opcję Dockera na CPU do testów.
Zainstaluj demo, uruchom testy offline i utwórz syntetyczne dane klientów:
git clone https://github.com/slavadubrov/sgr-discount-manager
cd sgr-discount-manager
uv sync
uv run pytest
uv run python -m scripts.setup_data
Uruchom serwer z XGrammar jako backendem ustrukturyzowanych danych wyjściowych:
vllm serve Qwen/Qwen2.5-7B-Instruct \
    --port 8000 \
    --structured-outputs-config.backend xgrammar
Pozycyjny argument modelu i opcja backendu pochodzą z dokumentacji vLLM serve. Klient łączy się z http://localhost:8000/v1; dla serwera na innym hoście zmień DEFAULT_API_BASE_URL w sgr/config/constants.py.
Uruchom agenta:
uv run python -m sgr.agentWynik ma taki kształt. Wartości są przykładowe; zależą od losowych danych demo i od modelu:
🤖 Processing: 'I want a discount or I'm leaving!' for user_102
📍 Routing decision: fetch_user_features
🔍 Fetching features for user_102...
   [Data] LTV: $1500.0 | Margin: 20.0%
🧠 Proposing Offer (Schema Enforced)...
   [Audit] Math: Cart $200 * 0.20 Margin = $40
   [Audit] Approved Discount: 15.00%

💬 Final Reply: Illustrative approved discount: 15.00%. No coupon has been issued.
Linia [Audit] Math to zapisane obliczenie modelu. Linia Approved Discount i końcowa odpowiedź pochodzą z approve_discount i kodu aplikacji, a nie od modelu.
Kontrole przed integracją na żywo
Projekt schematu
- Uporządkuj pola według zamierzonego przepływu rozumowania.
- Napisz opis
Fielddla każdego pola. Pydantic eksportuje go do JSON Schema, a powyższy klient dodaje ten schemat do tekstu prompt. - Ograniczaj za pomocą
LiteraliAnnotated. UżywajLiteral["a", "b"]dla enumów iAnnotated[int, Ge(1), Le(10)]dla granic. - Utrzymuj schematy skupione. Jeden schemat na fazę rozumowania, potem składaj je wieloma wywołaniami.
Konfiguracja vLLM
- Użyj niskiej temperatury (0.1-0.3), aby ograniczyć zmienność próbkowania. Dla powtarzalnych testów ustal model i konfigurację serwowania, użyj trybu deterministycznego serwera, jeśli go ma, i zweryfikuj wynik.
- Wyjaśnij w tekście prompt zadanie i pola schematu, tak jak robi to powyższy klient. Prompt mówi modelowi, co znaczy każde pole; dekoder tylko blokuje każdą niepoprawną jednostkę token.
- Zmierz zużycie jednostek token, zachowując ten sam prompt, model, schemat i zadanie. SGR może emitować więcej lub mniej jednostek token niż odpowiedź CoT w wolnej formie.
Uwagi produkcyjne
- Wersjonuj schematy tak samo, jak wersjonujesz API.
- Zapisuj osobno propozycję i decyzję polityki na potrzeby debugowania, z uwzględnieniem zasad retencji i maskowania danych.
- Przelicz ceny, limity, uprawnienia i inne reguły semantyczne w kodzie aplikacji przed użyciem; przetestuj wartości graniczne, których sam schemat nie może odrzucić.
Następny test
Zacznij od limitu rabatu i niepełnego zakończenia. Testy offline repozytorium obejmują oba, ale nie powiedzą ci, czy model poprawnie kieruje prawdziwego klienta ani czy trafnie wyjaśnia marżę. W ewaluacji na żywo ustal model, zestaw tekstów prompt, schemat i ustawienia serwowania. Zliczaj osobno niepełne wyniki, błędy schematu, błędy routingu i odrzucenia przez politykę, zanim porównasz koszt lub trafność zadania.
Źródła
Framework SGR
- Schema-Guided Reasoning (SGR) — oryginalny framework Rinata Abdullina
- SGR Patterns — wzorce Cascade, Routing, Cycle
xgrammar
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models — Yixin Dong i in., arXiv:2411.15100 (artykuł techniczny z benchmarkami)
- xgrammar GitHub — szybka, elastyczna biblioteka do ustrukturyzowanego generowania
- xgrammar Documentation — oficjalna dokumentacja z przewodnikiem szybkiego startu
- xgrammar Quick Start — pierwsze kroki z xgrammar
- Achieving Efficient Structured Generation with XGrammar — wpis na blogu MLC o wnętrzu xgrammar
vLLM
- vLLM Structured Outputs — oficjalna dokumentacja
Projekt demo
- sgr-discount-manager — projekt towarzyszący: kod z tego artykułu, testy offline i kroki uruchomienia