Schema-Guided Reasoning : vLLM, XGrammar et Pydantic

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Cet article s’adresse aux ingénieurs Python qui ont besoin d’une sortie de modèle que le code en aval peut valider. Le Schema-Guided Reasoning (SGR) donne au modèle une liste fixe de champs à remplir, l’analyse d’abord et la décision en dernier, pour que le code puisse vérifier chaque étape. Vous apprendrez à définir un schéma Pydantic, à demander une structured output à vLLM et à ajouter des vérifications applicatives du sens et de la politique métier.
Pydantic décrit les champs de la réponse, vLLM sert le modèle et XGrammar restreint les tokens que le modèle peut générer. Cette restriction s’appelle le constrained decoding. Une limite de tokens peut tout de même laisser un préfixe JSON incomplet : le code applicatif doit donc vérifier que la réponse est complète et valider le résultat.
Qu’est-ce que le Schema-Guided Reasoning ?
Le Schema-Guided Reasoning est une technique que Rinat Abdullin a décrite en juillet 2025. Au lieu de laisser le modèle compléter librement du texte (ce qui peut être incohérent ou ambigu), vous lui donnez un gabarit strict qui définit :
- les étapes que la réponse doit représenter
- l’ordre prévu de ces étapes, pour qu’un relecteur puisse inspecter le chemin des données jusqu’à la décision
- les points sur lesquels il doit concentrer son attention
Voyez-le comme une liste de sorties à inspecter, et non comme une preuve du raisonnement interne du modèle. Le décodeur vérifie la structure de la sortie ; le code applicatif contrôle quand chaque étape s’exécute et si un résultat peut être utilisé.
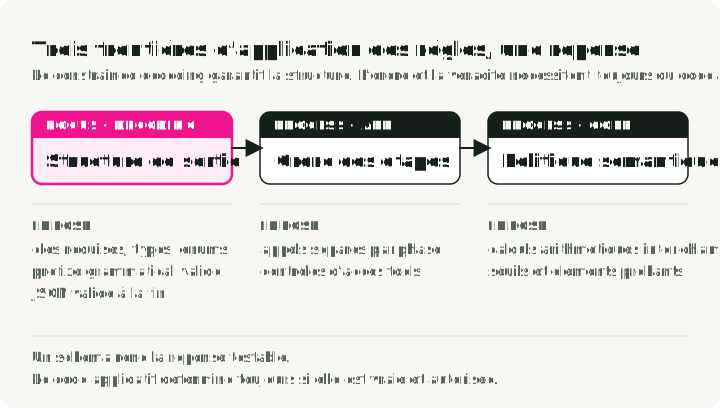
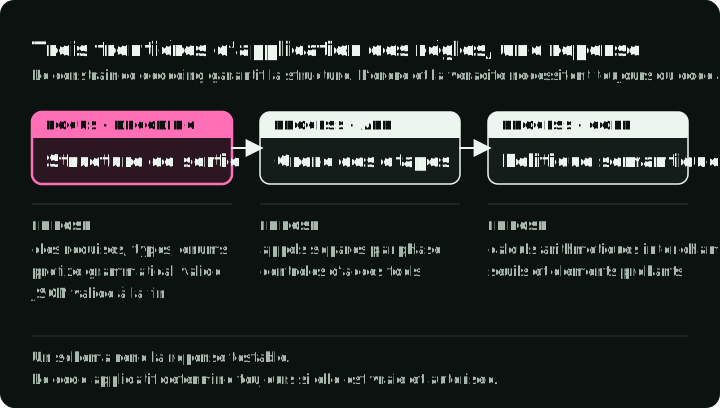
Le diagramme suit une réponse de tarification à travers les trois parties qui la vérifient : le décodeur impose la forme, l’application impose l’ordre des étapes et la complétude, et le code de politique impose le sens.
Ce que contrôle le schéma
L’exemple suivi dans l’article propose une remise pour retenir un client qui risque de partir. La probabilité de churn estime ce risque de départ ; la valeur du panier est le total avant remise. La marge est le bénéfice brut exprimé en fraction de ce total : un panier de $200 avec une marge de 0.20 dégage $40 de bénéfice brut. Les remises s’expriment en points de pourcentage : une proposition de 15 signifie 15 %.
Un modèle de tarification peut renvoyer un JSON valide et proposer tout de même 25 % de remise alors que la marge n’est que de 20 %. Le schéma enregistre la proposition ; le code applicatif doit vérifier si la remise est autorisée.
Des champs comme churn_analysis, margin_math et max_discount_percent rendent explicites les sorties intermédiaires attendues. Un schéma contraint la forme de ce qui est renvoyé. Il ne fait pas, à lui seul, dépendre un champ d’un autre, et il ne prouve pas que la décision est correcte.
Vous obtenez ainsi :
- une structure de sortie comparable d’une exécution à l’autre
- des sorties intermédiaires enregistrées, que les relecteurs peuvent inspecter
- des champs intermédiaires que vous pouvez évaluer sur un dataset de test
- des modèles plus petits qui peuvent suivre le format plus souvent ; mesurez la précision sur la tâche avant de vous y fier
- Abdullin écrit qu’un gain de précision de 5 à 10 % n’est « pas rare » dans les cas qu’il a observés ; c’est une observation de praticien, pas un résultat de benchmark, donc mesurez-le sur votre propre charge de travail
Utilisez SGR quand le code en aval dépend de la structure. Quand une personne lit la réponse comme du texte, une réponse libre est plus simple.
Conseils de prompt et contraintes du décodeur
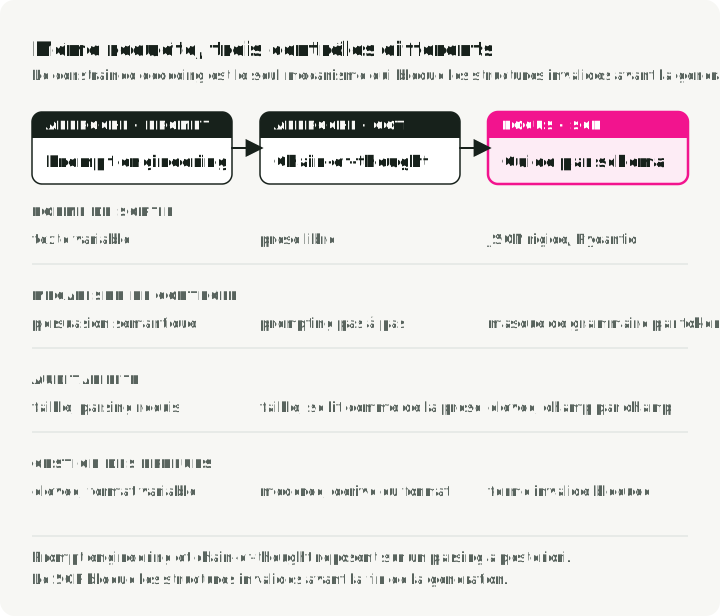
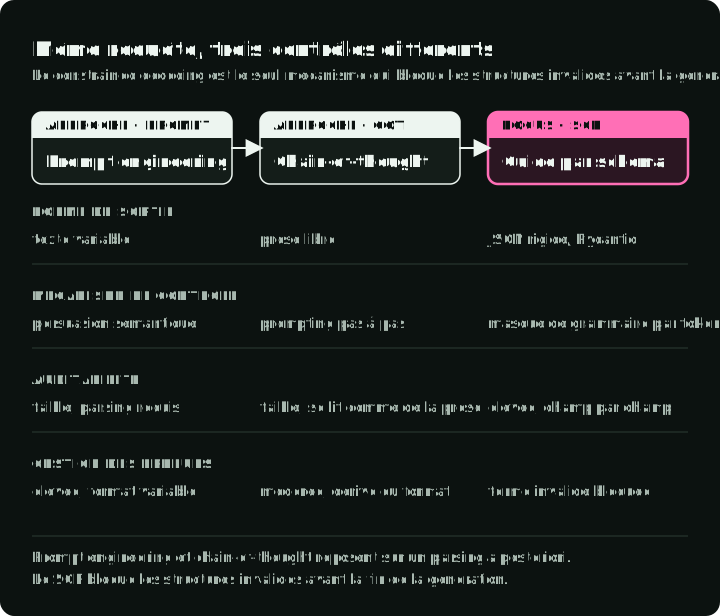
On peut combiner les conseils de prompt et le constrained decoding. Cette comparaison montre quand chaque chemin vérifie le format demandé : seulement après la génération, ou aussi à chaque token.
Prompt engineering : demander le format
Ce prompt demande au modèle de formater la proposition de remise en JSON :
Please analyze the customer data and output your response as valid JSON
with the following structure: {"discount": <number>, "reason": <string>}
Be careful with the formatting!
Vous espérez que la compréhension de « output JSON » par le modèle l’emporte sur sa tendance à être bavard. Une mise à jour du modèle, un changement de température ou un autre exemple few-shot peut casser votre parseur.
Chain of Thought : une trace de raisonnement utile, mais le même problème de structure
Un prompt de chain-of-thought (CoT) demande une analyse intermédiaire. La réponse peut ressembler à ceci :
Let's think step by step:
1. First, I'll analyze the customer's churn risk...
2. Then I'll calculate the margin...
3. Therefore, I recommend a 15% discount.
Le CoT peut améliorer la précision sur la tâche quand le prompt, le modèle, la tâche et l’évaluation s’y prêtent, mais il laisse le résultat sous forme de texte difficile à parser de façon fiable. Vous risquez de devoir faire un second appel LLM rien que pour extraire des données structurées.
SGR : chain-of-thought structurée
SGR transforme les étapes de la chain-of-thought en champs nommés que vous pouvez inspecter et évaluer :
class PricingLogic(BaseModel):
    # 1. Recorded analysis
    churn_analysis: str = Field(..., description="Analyze churn_probability")
    financial_analysis: str = Field(..., description="Analyze cart_value and margin")

    # 2. Proposed calculation, checked by application code
    margin_math: str = Field(..., description="Calculate: 'Cart $X * Y% = $Z'")

    # 3. Proposed decision, not bounded by the analysis fields
    max_discount_percent: float = Field(..., description="Max allowed discount")
Le schéma liste ces champs dans cet ordre. Utilisez des appels séparés quand un champ ultérieur doit dépendre d’un résultat antérieur déjà vérifié.
Le tableau compare les trois approches côte à côte :
| Caractéristique | Prompt engineering | Chain of Thought | Schema-Guided Reasoning |
|---|---|---|---|
| Structure de sortie | Texte variable | Texte libre | JSON conforme à un schéma Pydantic |
| Mécanisme de contrôle | Instruction (« output JSON ») | Instruction (« think step by step ») | Prompt plus constrained decoding |
| Qui définit les étapes | Le développeur peut les nommer dans le prompt | Le développeur peut fournir des étapes ou des exemples | Le développeur définit les champs du schéma |
| Inspection | Parser d’abord le texte | Lire le texte | Lire chaque champ |
| Intégration | Analyse JSON/Pydantic si le JSON est valide | Analyse JSON/Pydantic si le JSON est valide ; sinon, extraire la prose | model_validate_json, puis vérifications applicatives |
Patterns SGR
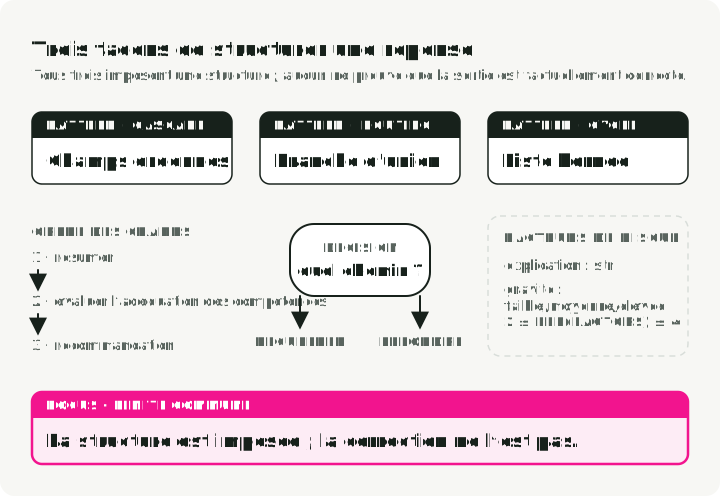
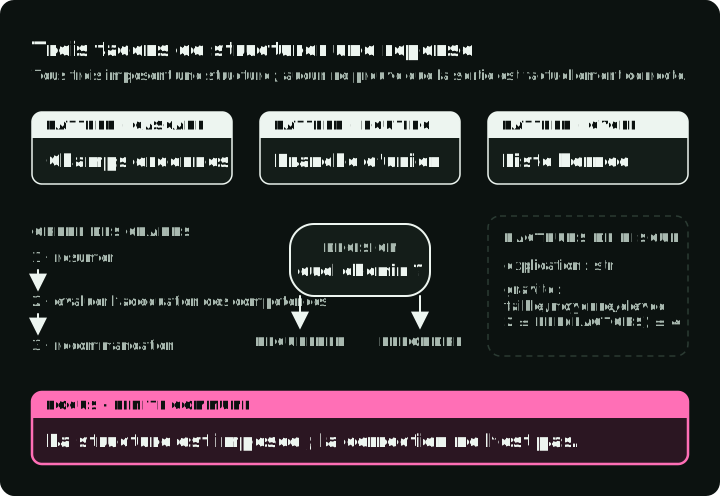
SGR repose sur trois patterns de base qui se composent en workflows plus grands. Le diagramme montre la forme que chacun donne à une réponse, avec les noms de champs des exemples ci-dessous, et indique la limite que chaque schéma fixe.
1. Cascade : étapes de raisonnement séquentielles
Cascade représente un ordre de raisonnement dans une seule réponse structurée. Ici, un classifieur de documents enregistre un résumé, un score de correspondance au sujet et une catégorie proposée.
from pydantic import BaseModel
from typing import Literal, Annotated
from annotated_types import Ge, Le

class DocumentEvaluation(BaseModel):
    """Record a document summary, score, and proposed category."""

    # Step 1: Record a summary
    brief_document_summary: str

    # Step 2: Rate (bounded integer)
    rate_topic_match: Annotated[int, Ge(1), Le(10)]

    # Step 3: Decide (constrained choices)
    final_recommendation: Literal["relevant", "irrelevant", "review"]
Usages illustratifs : classification de documents et tri de tickets de support.
On demande au modèle de renvoyer brief_document_summary, rate_topic_match et final_recommendation dans cet ordre.
2. Routing : une instruction switch sémantique
Routing demande au modèle de choisir un chemin parmi plusieurs options, implémentées avec des types Union. Ce routeur choisit entre récupérer les données d’un client pour une demande de tarification et renvoyer une réponse générale.
from pydantic import BaseModel
from typing import Literal, Union

class FeatureLookup(BaseModel):
    """Route to database lookup."""
    rationale: str
    tool_name: Literal["fetch_user_features"] = "fetch_user_features"
    user_id: str

class GeneralResponse(BaseModel):
    """Standard response for non-pricing queries."""
    tool_name: Literal["respond"] = "respond"
    content: str

class RouterSchema(BaseModel):
    """The model must pick exactly ONE branch."""
    action: Union[FeatureLookup, GeneralResponse]
Bons cas d’usage : classification d’intention, sélection d’outil, tri de support, dispatch multi-agent.
Les valeurs Literal propres à chaque branche permettent à Pydantic de distinguer les membres de l’union. Pour que Pydantic choisisse la branche directement par tool_name, déclarez une union discriminée : action: Union[FeatureLookup, GeneralResponse] = Field(discriminator="tool_name"). Vérifiez que votre backend accepte le schéma exporté.
3. Cycle : raisonnement répété avec des listes
Cycle décrit plusieurs éléments, avec des bornes sur leur nombre. Cet exemple d’évaluation des risques demande de deux à quatre facteurs, chacun avec une explication et une gravité.
from pydantic import BaseModel
from typing import List, Literal, Annotated
from annotated_types import MinLen, MaxLen

class RiskFactor(BaseModel):
    explanation: str
    severity: Literal["low", "medium", "high"]

class RiskAssessment(BaseModel):
    """Generate 2-4 risk factors."""
    factors: Annotated[List[RiskFactor], MinLen(2), MaxLen(4)]
Bons cas d’usage : évaluation des risques, extraction de problèmes, tool calls parallèles, planification en plusieurs étapes.
Les bornes de la liste décrivent un lot variable de 2 à 4 éléments. Un décodeur compatible peut contraindre cette longueur ; la validation applicative la vérifie à nouveau. Combinée à Routing, la liste peut décrire des tool calls proposés, que le code applicatif doit encore autoriser.
Faire fonctionner SGR : constrained decoding
Les patterns ci-dessus ne sont que des schémas Pydantic. Le constrained decoding peut imposer les contraintes prises en charge qui sont exportées dans leur JSON Schema. Les fonctionnalités prises en charge dépendent du backend de décodage. Les validateurs Python arbitraires ne deviennent pas des contraintes du décodeur ; ils s’exécutent toujours dans Pydantic après la génération.
Le constrained decoding modifie l’étape de génération des tokens. Au lieu de laisser le modèle échantillonner librement dans son vocabulaire, le moteur applique un masque de grammaire qui bloque les tokens qui violeraient le schéma. Cela se passe dans le moteur d’inférence, pas dans votre code applicatif.
SGR n’exige pas un modèle de raisonnement. Les modèles instruction-tuned produisent aussi des réponses contraintes par schéma ; comparez la précision sur la tâche avec les modèles que vous prévoyez de servir.
Moteurs et backends
Le constrained decoding nécessite une API ou un moteur de serving qui le prend en charge. Si vous appelez un modèle hébergé, utilisez l’API de structured output du fournisseur : OpenAI Structured Outputs, Gemini structured output et Mistral custom structured output acceptent chacun un JSON Schema. Les fonctionnalités de schéma prises en charge et le comportement en cas d’échec varient selon le fournisseur ; testez donc le schéma que vous comptez envoyer.
Pour un modèle auto-hébergé, les principaux moteurs ont chacun un backend de constrained decoding :
| Moteur | Backends de structured output | À utiliser quand |
|---|---|---|
| vLLM | auto (par défaut), xgrammar, guidance, outlines, lm-format-enforcer ; se règle avec --structured-outputs-config.backend | Vous voulez un serveur compatible OpenAI et le choix du backend ; c’est l’exemple de cet article |
| SGLang | XGrammar (par défaut), Outlines, llguidance ; se règle avec --grammar-backend | Vous servez déjà avec SGLang ; XGrammar fonctionne sans option |
| TensorRT-LLM | XGrammar ou LLGuidance ; se règle avec guided_decoding_backend | Vous déployez sur des GPU NVIDIA avec TensorRT-LLM |
| Ollama | JSON Schema dans le champ format de la requête | Vous testez en local sur un portable, sans serveur GPU |
Deux questions décident du choix : si du code lit le résultat, et qui exécute le modèle. Chaque chemin structuré se termine par les mêmes vérifications applicatives.
Cet article utilise vLLM avec XGrammar. L’API de structured output de vLLM accepte un JSON Schema via un client compatible OpenAI. L’exemple garde ainsi le code habituel des requêtes, tout en configurant le backend de décodage sur le serveur.
XGrammar fournit le compilateur de grammaire et la mécanique de masque de tokens. Son aperçu technique explique la répartition CPU/GPU décrite plus bas ; ses résultats de benchmark valent pour les charges testées, pas pour tous les déploiements.
Comment XGrammar impose les schémas
Où le masquage se produit
Les logits sont les scores non normalisés du modèle pour les tokens suivants possibles. XGrammar modifie ces scores après la passe avant du modèle et avant l’échantillonnage. Il ne modifie pas le modèle lui-même. Il filtre les tokens qui peuvent être sélectionnés.
Une boucle d’inférence standard exécute la passe avant, échantillonne le token suivant à partir des logits, puis recommence. XGrammar ajoute l’étape 2 :
1. Input tokens → GPU Forward Pass → Raw Logits
2. Raw Logits → XGrammar Logits Processor → Masked Logits
3. Masked Logits → Sampling → Next Token (continues the grammar-valid prefix)
4. Repeat until done
Le diagramme montre une étape sur un vocabulaire de huit tokens : les scores du GPU et le bitmask du CPU se rejoignent avant qu’un token soit sélectionné. Chaque token accepté met aussi à jour l’état de la grammaire pour l’étape suivante.
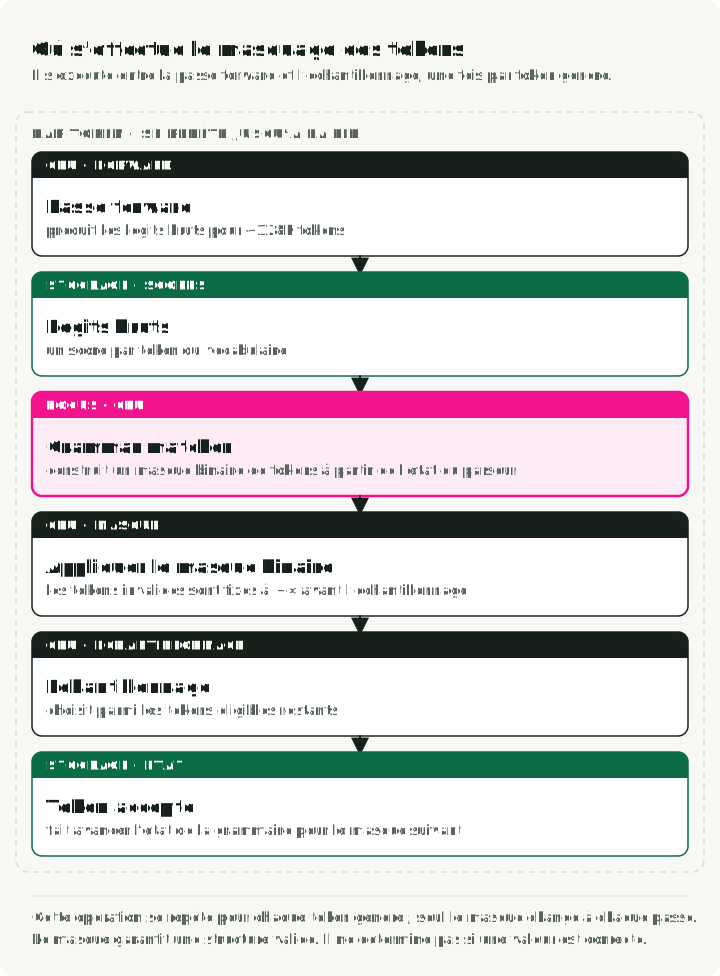
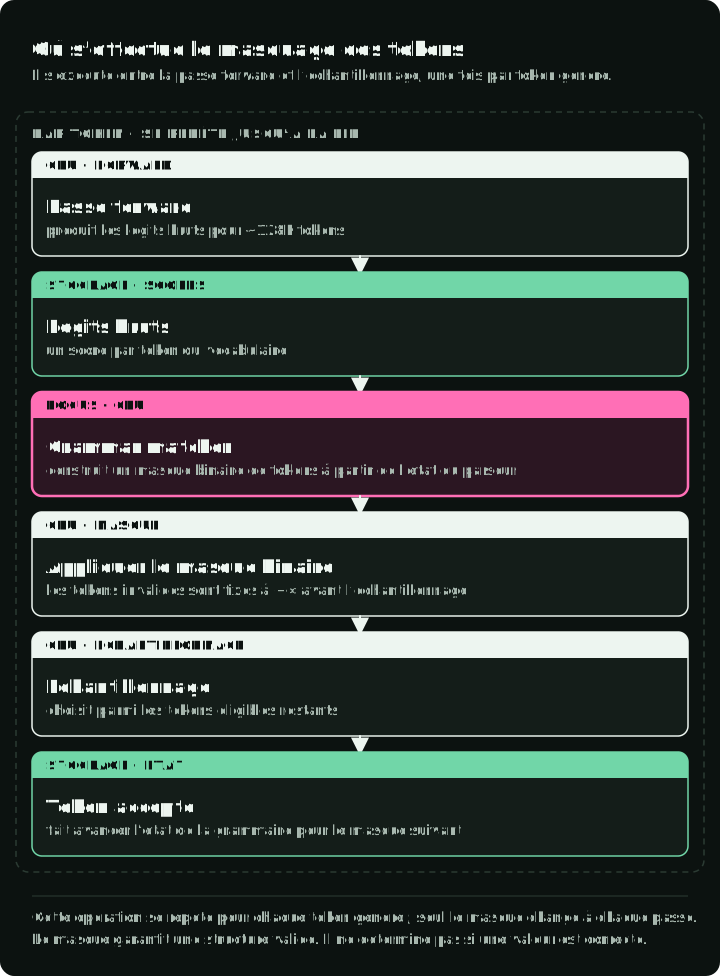
Le modèle calcule toujours sa distribution de probabilité complète sur le GPU. Le GrammarMatcher de XGrammar génère le bitmask sur le CPU, puis le moteur de serving déplace ce bitmask vers le périphérique des logits et l’applique sur place avant l’échantillonnage. Pour des logits sur GPU, XGrammar utilise un kernel GPU pour cette application. Les tokens invalides voient leurs logits fixés à -∞, ce qui rend leur probabilité exactement égale à 0 après le softmax.
Deux phases
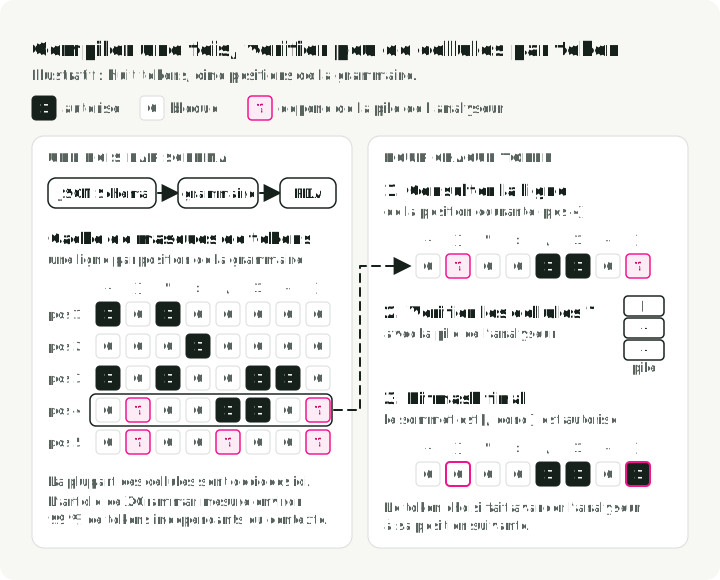
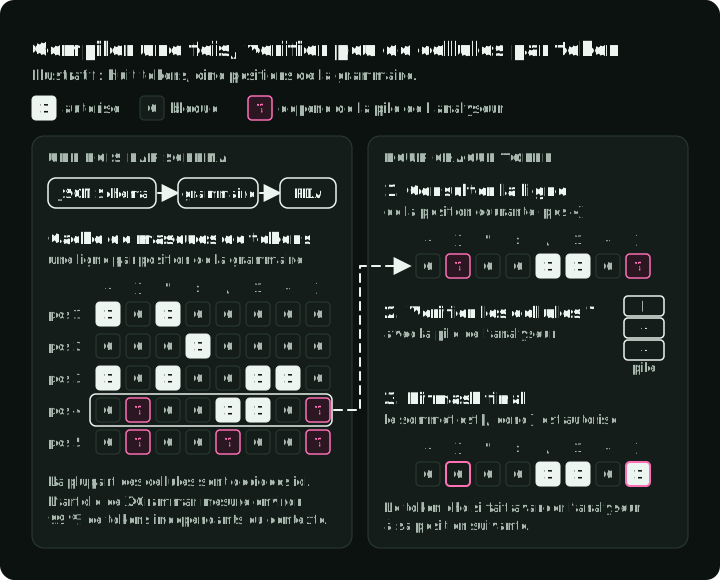
XGrammar sépare le travail entre la compilation et le runtime. Cette conception réduit le travail répété sur la grammaire. Le diagramme montre un cache illustratif construit une fois par schéma (à gauche) et le travail effectué pour chaque token généré (à droite) : la plupart des cellules sont déjà autorisées ou bloquées, et seules les quelques cellules marquées ? sont vérifiées avec la pile de l’analyseur. La flèche en pointillés marque le lien : le cache construit une fois est lu à chaque étape.
Phase 1 : compilation de la grammaire, une fois par schéma
Cet extrait construit une grammaire pour le schéma à partir du tokenizer du modèle. Le résultat compilé peut être réutilisé pour générer des réponses avec ce schéma.
# This happens once per schema
tokenizer_info = xgr.TokenizerInfo.from_huggingface(tokenizer)
grammar_compiler = xgr.GrammarCompiler(tokenizer_info)
compiled_grammar = grammar_compiler.compile_json_schema(schema_json)
Pendant la compilation, XGrammar :
- Convertit le JSON Schema en grammaire non contextuelle (Context-Free Grammar).
- Construit un automate à pile (Pushdown Automaton, PDA), c’est-à-dire une machine à états dotée d’une pile, qui sait donc gérer des structures imbriquées comme
{"a": {"b": {"c": ...}}}. - Précalcule quels tokens sont valides à chaque position de la grammaire. Le résultat est le « cache de masques de tokens adaptatif ».
- Classe les tokens en « indépendants du contexte » (pouvant être mis en cache) ou « dépendants du contexte » (à vérifier au runtime par rapport à l’état de la pile).
L’article de XGrammar indique qu’environ 99 % des tokens étaient indépendants du contexte dans ses mesures (article). Considérez ce chiffre comme propre à ce benchmark, pas comme un ratio universel.
Phase 2 : génération du masque au runtime, à chaque token
À chaque étape de génération :
- Le
GrammarMatchersuit la position courante dans la grammaire. - Il consulte le masque précalculé pour les tokens indépendants du contexte.
- Il exécute le PDA pour vérifier les tokens dépendants du contexte restants.
- Il les combine en un bitmask final, le déplace vers le périphérique des logits et l’y applique.
Pourquoi des automates à pile plutôt que des regex ?
À cause de l’imbrication. Une expression régulière (un automate fini) ne peut pas reconnaître de façon fiable des structures comme :
{ "user": { "profile": { "settings": { "theme": "dark" } } } }La difficulté tient aux accolades fermantes }}} : il faut se souvenir du nombre d’accolades ouvertes. Un automate à pile possède une pile qui le suit, et gère donc une profondeur d’imbrication arbitraire. C’est aussi pourquoi XGrammar peut imposer des types Union, des objets imbriqués et des schémas récursifs, là où les approches à base de regex échouent.
Un exemple concret : générer un champ float
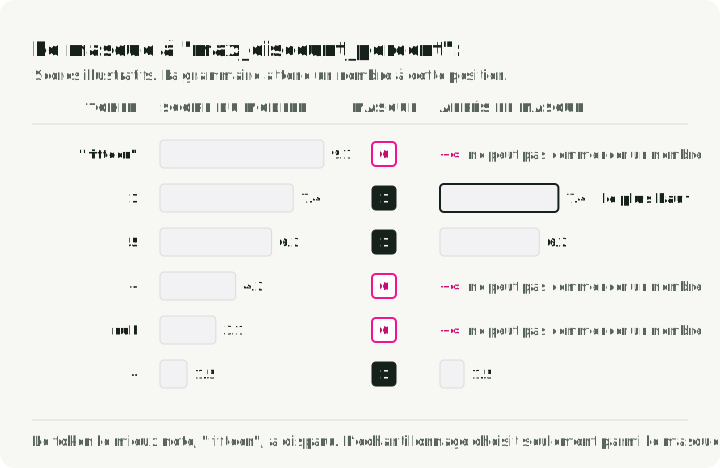
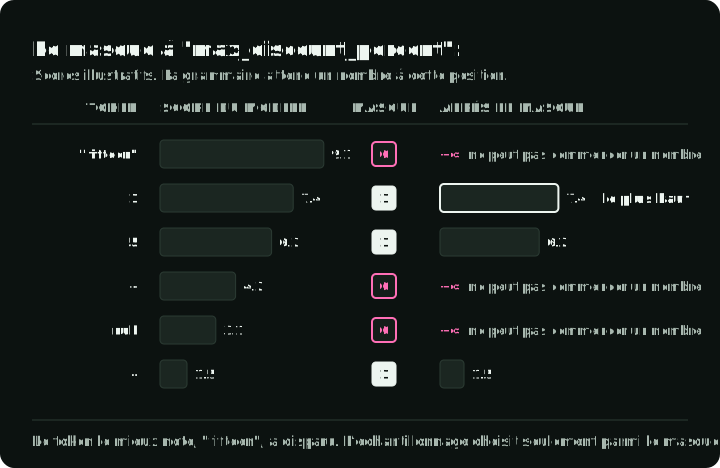
Quand le modèle génère "max_discount_percent":, XGrammar sait d’après le schéma qu’un float suit. L’ensemble des tokens valides dépend de l’état du parseur et du tokenizer. Au début du nombre, le masque peut admettre un chiffre ou un signe moins ; après un chiffre, il peut admettre des continuations comme un autre chiffre, un point décimal ou un marqueur d’exposant.
- Un guillemet,
{,[,true,falseounullne peut pas commencer ce nombre ; le masque bloque donc leurs tokens dans cet état. - La passe avant a peut-être attribué une forte probabilité au token de
"fifteen". Comme ce token ne peut pas prolonger ce champ numérique, le masque le retire et le modèle doit choisir une continuation numérique valide.
Le diagramme montre des scores illustratifs pour six tokens candidats à cette position, le bit de masque de chacun et les scores après le masque.
Ce qui influence le surcoût
Trois facteurs déterminent le surcoût :
- Génération et transfert du masque. La génération du masque sur le CPU et son transfert vers le périphérique des logits ; le degré de recouvrement avec la passe avant dépend du moteur de serving.
- Cache. L’essentiel du travail de validité est fait à la compilation. Le runtime se résume surtout à des lectures dans le cache.
- Implémentation en C++. Le chemin critique est en C++, pas en Python, et le masque est appliqué aux logits sur place.
Les benchmarks cités rapportent un faible surcoût pour les grammaires, tokenizers, matériels et charges de travail testés. Ces résultats n’établissent pas de garantie générale de latence ou de débit.
Implémentation pratique avec vLLM
Le dépôt compagnon contient ce code. uv run pytest teste les vérifications de politique et de complétude sans modèle ; les étapes à la fin de cette section exécutent l’agent complet contre un serveur vLLM.
Les extraits ci-dessous sont raccourcis à partir des fichiers du dépôt nommés sur leur première ligne. Ils montrent le routage → la récupération du contexte → la proposition → l’approbation, et utilisent Pydantic 2 et le client Python OpenAI.
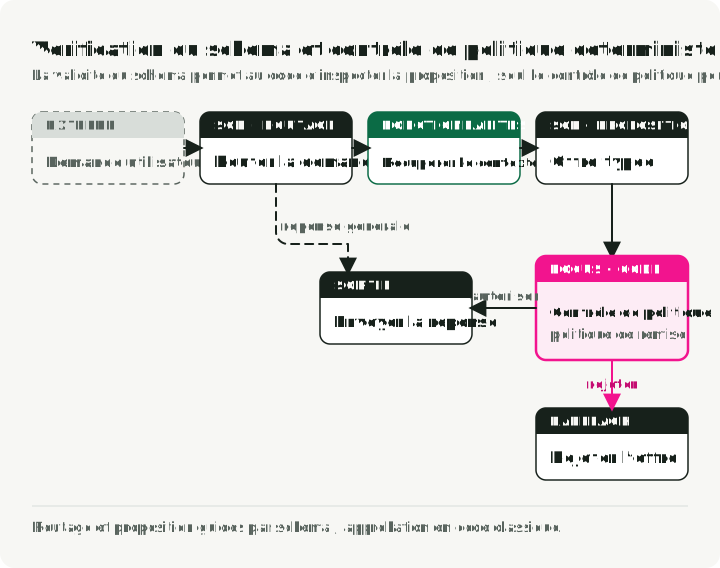
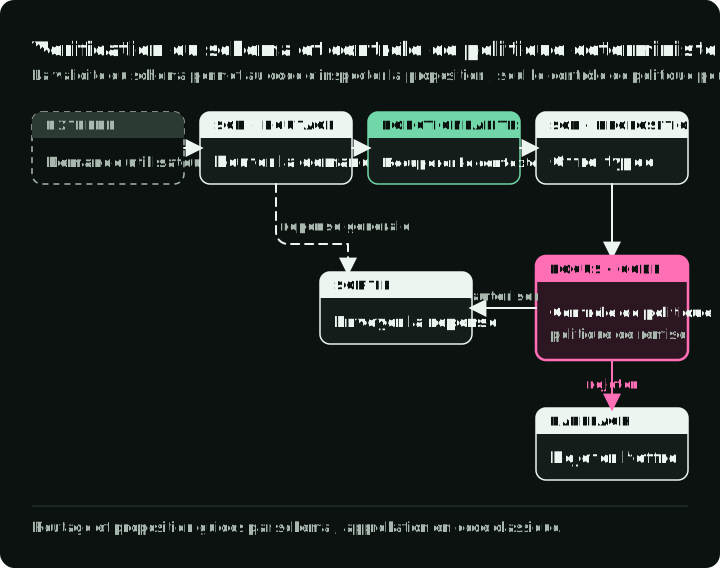
Une demande générale peut renvoyer une réponse immédiatement. Une demande de tarification nécessite les données du client et une proposition du modèle, suivies d’une vérification de politique par l’application avant que la remise puisse être annoncée. Si l’un des deux appels au modèle s’arrête avant une réponse complète, la demande se termine par une erreur ; l’étape 2 montre cette vérification. Le diagramme montre tous les chemins que peut suivre l’agent et la réponse que chacun renvoie.
Étape 1 : définir les schémas
sgr/models/schemas.py contient les deux schémas présentés plus haut. RouterSchema est le routeur de la section Routing : demander les données du client avec FeatureLookup, ou renvoyer du texte avec GeneralResponse. PricingLogic a les quatre champs de la section SGR. La description de son champ margin_math donne au modèle un exemple concret du format : 'Cart $200 * 0.20 Margin = $40'.
Le routeur et le schéma de tarification sont deux appels distincts. L’application peut ainsi récupérer les données du client avant de demander une proposition.
Étape 2 : demander et valider une réponse structurée
Le client exporte le modèle Pydantic en JSON Schema, l’ajoute à un system prompt existant pour guider le modèle, puis l’envoie comme contrainte de structured output. XGrammar est configuré sur le serveur ; le client fournit le schéma à chaque requête.
completed_content rejette les réponses incomplètes, refusées ou vides avant que Pydantic valide le JSON et ses champs. Il rejette les arrêts dus à la limite de tokens, même si le texte renvoyé se parse par hasard. Ces erreurs remontent à l’appelant, qui doit fournir une réponse d’erreur ou une politique de nouvelle tentative ; aucune offre n’est approuvée sur ces chemins.
# sgr/utils/llm_client.py
import json
from typing import TypeVar

from openai import OpenAI
from pydantic import BaseModel

T = TypeVar("T", bound=BaseModel)

def completed_content(completion) -> str:
    """Reject incomplete, refused, or empty results before JSON validation."""
    if not completion.choices:
        raise ValueError("No completion returned")
    choice = completion.choices[0]
    if choice.finish_reason != "stop" or getattr(choice.message, "refusal", None):
        raise ValueError("Completion was not successful")
    content = choice.message.content
    if not isinstance(content, str) or not content.strip():
        raise ValueError("Completion has no content")
    return content

class LLMClient:
    """Wrapper for vLLM with XGrammar-enforced structured generation."""

    def __init__(self, base_url: str = "http://localhost:8000/v1"):
        # Local vLLM commonly has no authentication. EMPTY is not authentication.
        self.client = OpenAI(base_url=base_url, api_key="EMPTY")
        self.model = self._get_available_model()

    def _get_available_model(self) -> str:
        """Auto-detect the model running on vLLM server."""
        models = self.client.models.list()
        if not models.data:
            raise RuntimeError("vLLM reported no available models")
        return models.data[0].id

    def run_sgr(self, messages: list[dict], schema_class: type[T]) -> T:
        """Run inference with Schema-Guided Reasoning constraints.

        Uses vLLM structured outputs to constrain the JSON shape at generation time.
        """
        schema_dict = schema_class.model_json_schema()

        # Enhance system message with schema for model guidance
        enhanced_messages = messages.copy()
        if enhanced_messages and enhanced_messages[0]["role"] == "system":
            schema_json = json.dumps(schema_dict, indent=2)
            enhanced_messages[0] = {
                "role": "system",
                "content": (
                    enhanced_messages[0]["content"]
                    + f"\n\nRespond with JSON matching this schema:\n{schema_json}"
                ),
            }

        # vLLM v0.12+ structured outputs. Configure the backend on the server.
        completion = self.client.chat.completions.create(
            model=self.model,
            messages=enhanced_messages,
            temperature=0.1,  # Reduces sampling variation; it is not deterministic.
            extra_body={"structured_outputs": {"json": schema_dict}},
        )

        return schema_class.model_validate_json(completed_content(completion))
Dans vLLM v0.12 et ultérieur, structured_outputs: {"json": schema_dict} demande un JSON conforme au schéma. Les anciens champs de requête guided_json et guided_decoding_backend ont été supprimés dans la v0.12.0, et le backend se règle désormais sur le serveur.
Étape 3 : orchestrer l’agent
L’application route la demande, récupère les données de l’appelant authentifié, demande une proposition, la vérifie et renvoie le résultat. Le feature store utilise le user_id authentifié, jamais l’identifiant proposé par le modèle. Le prompt reçoit aussi user_ltv, la valeur vie client estimée ; cette estimation donne du contexte au modèle mais ne fixe pas la limite de remise.
Le schéma garantit que max_discount_percent est un nombre. Il ne garantit pas que ce nombre est autorisé ; c’est approve_discount qui en décide. approve_discount vérifie d’abord que les entrées sont finies, que la valeur du panier est positive et que la marge est une fraction comprise entre 0 et 1. La politique de démonstration rejette ensuite les pourcentages proposés hors de 0–20, arrondit vers le bas au centième de point de pourcentage, et rejette une remise finale qui coûte plus que le bénéfice brut du panier.
# sgr/agent.py
from decimal import Decimal, ROUND_DOWN

from .models.schemas import PricingLogic, RouterSchema
from .prompts.routing import build_routing_prompt
from .prompts.pricing import build_pricing_context_prompt, ASSISTANT_FETCH_MESSAGE
from .store.hybrid_store import HybridFeatureStore
from .utils.llm_client import LLMClient

def approve_discount(offer: PricingLogic, context: dict) -> Decimal:
    """Enforce the pricing policy independently of the model's explanation."""
    cart_value = Decimal(str(context["current_cart_value"]))
    margin = Decimal(str(context["cart_profit_margin"]))
    proposed = Decimal(str(offer.max_discount_percent))

    if not all(value.is_finite() for value in (cart_value, margin, proposed)):
        raise ValueError("Pricing values must be finite")
    if cart_value <= 0 or not Decimal("0") <= margin <= Decimal("1"):
        raise ValueError("Invalid pricing context")

    if not Decimal("0") <= proposed <= Decimal("20"):
        raise ValueError("Proposed discount violates pricing policy")
    # Policy rounds down to hundredths of a percentage point before approval.
    approved = proposed.quantize(Decimal("0.01"), rounding=ROUND_DOWN)
    gross_profit = cart_value * margin
    discount_cost = cart_value * approved / Decimal("100")
    policy_cap = min(margin * Decimal("100"), Decimal("20"))
    if not Decimal("0") <= approved <= policy_cap or discount_cost > gross_profit:
        raise ValueError("Proposed discount violates pricing policy")

    return approved

def pricing_agent(user_query: str, user_id: str) -> str:
    """Integrate routing, context, and pricing; user_id is caller-authenticated."""

    llm = LLMClient()
    feature_store = HybridFeatureStore()

    # Build conversation history
    history = [
        {"role": "system", "content": build_routing_prompt(user_id)},
        {"role": "user", "content": user_query},
    ]

    # --- Phase 1: Routing (Uses RouterSchema) ---
    print(f"🤖 Processing: '{user_query}' for {user_id}")
    decision = llm.run_sgr(history, RouterSchema)
    print(f"📍 Routing decision: {decision.action.tool_name}")

    if decision.action.tool_name == "respond":
        return decision.action.content

    # --- Phase 2: Context Retrieval ---
    if decision.action.tool_name == "fetch_user_features":
        print(f"🔍 Fetching features for {user_id}...")
        context = feature_store.get_user_context(user_id)

        if not context:
            return "Error: User profile not found."

        print(f"   [Data] LTV: ${context.get('user_ltv')} | "
              f"Margin: {context.get('cart_profit_margin', 0) * 100}%")

        # Inject context into conversation
        history.append({"role": "assistant", "content": ASSISTANT_FETCH_MESSAGE})
        history.append({
            "role": "user",
            "content": build_pricing_context_prompt(
                churn_prob=context.get("churn_probability", 0.5),
                cart_val=context.get("current_cart_value", 100),
                margin=context.get("cart_profit_margin", 0.2),
                user_ltv=context.get("user_ltv", 0),
            ),
        })

        # --- Phase 3: model proposal, then deterministic policy enforcement ---
        print("🧠 Proposing Offer (Schema Enforced)...")
        offer = llm.run_sgr(history, PricingLogic)
        try:
            approved_discount = approve_discount(offer, context)
        except ValueError:
            return "No discount approved: the proposal failed the pricing policy."

        # Audit log: reasoning is inspectable; pricing is application-enforced.
        print(f"   [Audit] Math: {offer.margin_math}")
        print(f"   [Audit] Approved Discount: {approved_discount}%")

        return (
            f"Illustrative approved discount: {approved_discount}%. "
            "No coupon has been issued."
        )

    return "I'm sorry, I couldn't process your request."

if __name__ == "__main__":
    response = pricing_agent("I want a discount or I'm leaving!", "user_102")
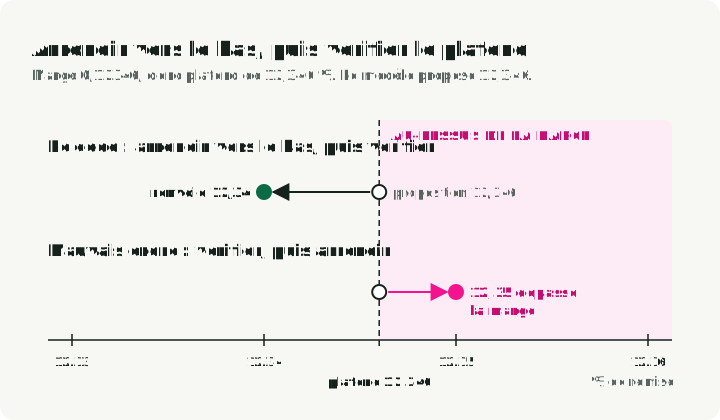
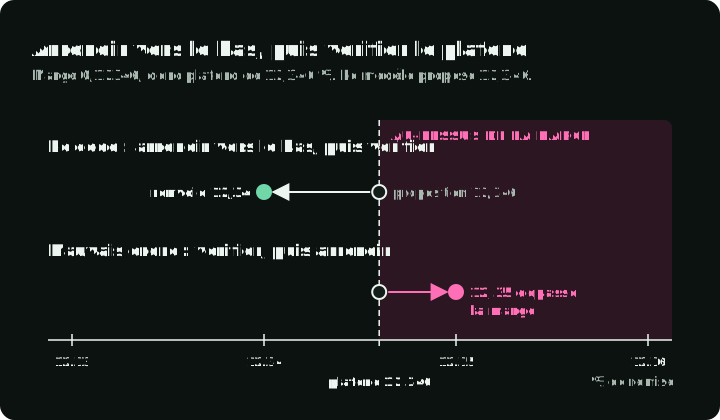
print(f"\n💬 Final Reply: {response}")Une proposition de 15 % sur un panier de $200 avec 20 % de marge renvoie 15.00 depuis la fonction de politique. L’application annonce ce pourcentage sans prétendre émettre un coupon. Un test aux limites utilise une marge de 0.12346, soit 12,346 %. Une proposition de 12.346 est arrondie vers le bas à 12.34 avant la vérification de la valeur finale. Arrondir à 12.35 après l’approbation dépasserait la marge.
La droite graduée montre ce test aux limites : où chaque ordre d’arrondi et de vérification place la valeur renvoyée par rapport au plafond.
approve_discount exécute quatre vérifications dans l’ordre :
- Les entrées sont valides : valeur du panier supérieure à 0, marge comprise entre 0 et 1, ni NaN ni infini.
- La remise proposée est comprise entre 0 et 20.
- La proposition est arrondie vers le bas à 0.01 (12.346 devient 12.34, pas 12.35).
- La valeur arrondie est au plus égale au pourcentage de marge (et à 20), et son coût est au plus égal au bénéfice brut.
Toute vérification échouée lève ValueError, et la proposition n’obtient aucune remise. L’arrondi vient avant le plafond, donc le plafond vérifie la valeur renvoyée.
Lancer la démo
Le dépôt exécute tout le flux. La démo nécessite Python 3.13 et uv. Le serveur vLLM nécessite son propre environnement, un accélérateur pris en charge et assez de mémoire pour le modèle (guide d’installation) ; le README du dépôt décrit l’installation et une option Docker sur CPU pour les tests.
Installez la démo, lancez les tests hors ligne et créez les données clients synthétiques :
git clone https://github.com/slavadubrov/sgr-discount-manager
cd sgr-discount-manager
uv sync
uv run pytest
uv run python -m scripts.setup_data
Démarrez le serveur avec XGrammar comme backend de structured output :
vllm serve Qwen/Qwen2.5-7B-Instruct \
    --port 8000 \
    --structured-outputs-config.backend xgrammar
L’argument positionnel du modèle et l’option du backend suivent la référence de vLLM serve. Le client se connecte à http://localhost:8000/v1 ; pour un serveur sur une autre machine, modifiez DEFAULT_API_BASE_URL dans sgr/config/constants.py.
Lancez l’agent :
uv run python -m sgr.agentLa sortie a cette forme. Les valeurs sont illustratives ; elles dépendent des données de démo aléatoires et du modèle :
🤖 Processing: 'I want a discount or I'm leaving!' for user_102
📍 Routing decision: fetch_user_features
🔍 Fetching features for user_102...
   [Data] LTV: $1500.0 | Margin: 20.0%
🧠 Proposing Offer (Schema Enforced)...
   [Audit] Math: Cart $200 * 0.20 Margin = $40
   [Audit] Approved Discount: 15.00%

💬 Final Reply: Illustrative approved discount: 15.00%. No coupon has been issued.
La ligne [Audit] Math est le calcul enregistré par le modèle. La ligne Approved Discount et la réponse finale viennent de approve_discount et du code applicatif, pas du modèle.
Vérifications avant une intégration réelle
Conception du schéma
- Ordonnez les champs selon le flux de raisonnement prévu.
- Écrivez une description
Fieldpour chaque champ. Pydantic l’exporte dans le JSON Schema, et le client ci-dessus ajoute ce schéma au prompt. - Contraignez avec
LiteraletAnnotated. UtilisezLiteral["a", "b"]pour les énumérations etAnnotated[int, Ge(1), Le(10)]pour les bornes. - Gardez des schémas ciblés. Un schéma par phase de raisonnement, puis composez avec plusieurs appels.
Configuration de vLLM
- Utilisez une température basse (0.1-0.3) pour réduire la variation d’échantillonnage. Pour des tests reproductibles, fixez le modèle et la configuration de serving, utilisez le mode déterministe du serveur s’il en propose un, et vérifiez le résultat.
- Expliquez la tâche et les champs du schéma dans le prompt, comme le fait le client ci-dessus. Le prompt dit au modèle ce que signifie chaque champ ; le décodeur ne fait que bloquer les tokens invalides.
- Mesurez l’usage de tokens avec le même prompt, le même modèle, le même schéma et la même tâche. SGR peut émettre plus ou moins de tokens qu’une réponse CoT libre.
Considérations de production
- Versionnez vos schémas comme vous versionnez vos API.
- Enregistrez séparément la proposition et la décision de politique pour le débogage, dans le respect de vos règles de rétention et de masquage des données.
- Recalculez les prix, les limites, les permissions et les autres règles sémantiques dans le code applicatif avant usage ; testez les valeurs aux limites que le schéma seul ne peut pas rejeter.
Le prochain test
Commencez par la limite de remise et par une complétion incomplète. Les tests hors ligne du dépôt couvrent les deux, mais ils ne peuvent pas dire si un modèle route correctement un vrai client ou explique la marge avec exactitude. Pour une évaluation en conditions réelles, fixez le modèle, les prompts, le schéma et les paramètres de serving. Comptez séparément les résultats incomplets, les échecs de schéma, les erreurs de routage et les rejets de politique avant de comparer le coût ou la précision sur la tâche.
Références
Framework SGR
- Schema-Guided Reasoning (SGR) — le framework original de Rinat Abdullin
- SGR Patterns — patterns Cascade, Routing, Cycle
xgrammar
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models — Yixin Dong et al., arXiv:2411.15100 (article technique avec benchmarks)
- xgrammar GitHub — bibliothèque de génération structurée rapide et flexible
- xgrammar Documentation — documentation officielle avec guide de démarrage
- xgrammar Quick Start — premiers pas avec xgrammar
- Achieving Efficient Structured Generation with XGrammar — article de blog MLC sur les internes de xgrammar
vLLM
- vLLM Structured Outputs — documentation officielle
Projet de démonstration
- sgr-discount-manager — démo compagnon : le code de cet article, des tests hors ligne et les étapes d’exécution