Schema-Guided Reasoning: vLLM, XGrammar und Pydantic

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Artikel richtet sich an Python Engineers, die Model-Ausgaben brauchen, die nachgelagerter Code validieren kann. Schema-Guided Reasoning (SGR) gibt dem Model eine feste Liste von Feldern vor, die es ausfüllen muss: zuerst die Analyse, zuletzt die Entscheidung, damit der Code jeden Schritt prüfen kann. Sie lernen, wie Sie ein Pydantic-Schema definieren, Structured Output von vLLM anfordern und Anwendungschecks für Bedeutung und Policy ergänzen.
Pydantic beschreibt die Felder der Response, vLLM stellt das Model bereit, und XGrammar schränkt ein, welche Tokens das Model generieren darf. Diese Einschränkung heißt Constrained Decoding. Ein Token-Limit kann trotzdem ein unvollständiges JSON-Präfix hinterlassen, deshalb muss der Anwendungscode die Vollständigkeit prüfen und das Ergebnis validieren.
Was ist Schema-Guided Reasoning?
Schema-Guided Reasoning ist eine Technik, die Rinat Abdullin im Juli 2025 beschrieben hat. Statt das Model Text frei vervollständigen zu lassen (was inkonsistent oder mehrdeutig sein kann), geben Sie ihm eine strikte Vorlage vor, die festlegt:
- welche Schritte die Response abbilden soll
- die vorgesehene Reihenfolge dieser Schritte, damit ein Reviewer den Weg von den Daten zur Entscheidung nachvollziehen kann
- worauf es seine Aufmerksamkeit richten soll
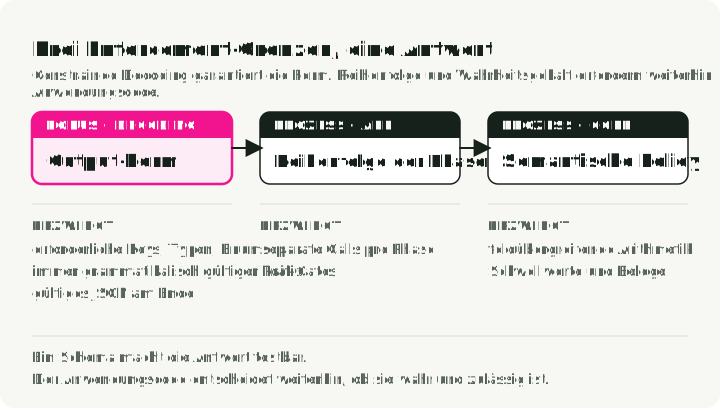
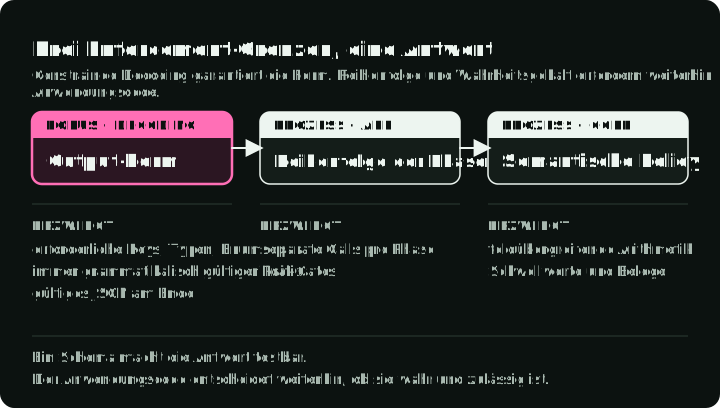
Sehen Sie das Schema als Checkliste von Ausgaben, die Sie prüfen, und nicht als Beweis für das interne Reasoning des Models. Der Decoder prüft die Struktur der Ausgabe; der Anwendungscode steuert, wann jede Stufe läuft und ob ein Ergebnis verwendet werden darf.
Das Diagramm folgt einer Pricing-Response durch die drei Teile, die sie prüfen: Der Decoder erzwingt die Form, die Anwendung die Reihenfolge der Stufen und die Vollständigkeit und der Policy-Code die Bedeutung.
Was das Schema steuert
Das durchgehende Beispiel schlägt einen Rabatt vor, um einen Kunden zu halten, der abspringen könnte. Die Churn-Wahrscheinlichkeit schätzt diese Abwanderung; der Warenkorbwert ist die Summe vor dem Rabatt. Die Marge ist der Rohgewinn als Anteil dieser Summe: Ein Warenkorb von $200 mit einer Marge von 0.20 hat $40 Rohgewinn. Rabatte werden in Prozentpunkten angegeben, ein Vorschlag von 15 bedeutet also 15 %.
Ein Pricing-Model kann gültiges JSON liefern und trotzdem 25 % Rabatt vorschlagen, obwohl die Marge nur 20 % beträgt. Das Schema hält den Vorschlag fest; der Anwendungscode muss prüfen, ob der Rabatt erlaubt ist.
Felder wie churn_analysis, margin_math und max_discount_percent machen die vorgesehenen Zwischenausgaben explizit. Ein Schema beschränkt die Form der Response. Es macht für sich genommen weder ein Feld von einem anderen abhängig noch beweist es, dass die Entscheidung richtig ist.
Das ergibt:
- vergleichbare Ausgabestruktur über wiederholte Läufe hinweg
- festgehaltene Zwischenausgaben, die Reviewer einsehen können
- Zwischenfelder, die Sie gegen ein Test-Dataset bewerten können
- kleinere Models halten das Format möglicherweise häufiger ein; messen Sie die Genauigkeit der Aufgabe, bevor Sie sich darauf verlassen
- Abdullin schreibt, dass ein Genauigkeitsgewinn von 5–10 % in den Fällen, die er beobachtet hat, „nicht ungewöhnlich“ sei; das ist die Beobachtung eines Praktikers, kein Benchmark-Ergebnis, messen Sie es also an Ihrer eigenen Workload
Setzen Sie SGR ein, wenn nachgelagerter Code auf Struktur angewiesen ist. Wenn ein Mensch die Antwort als Fließtext liest, ist eine freie Response einfacher.
Prompt-Guidance und Decoder-Constraints
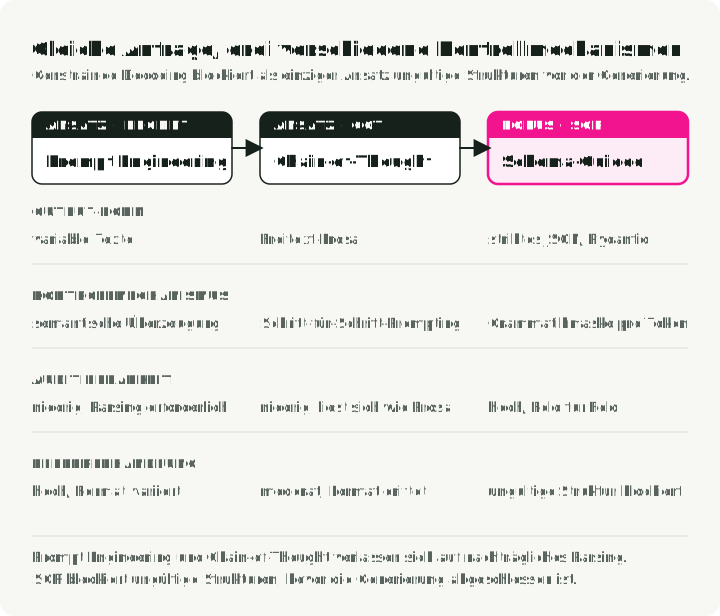
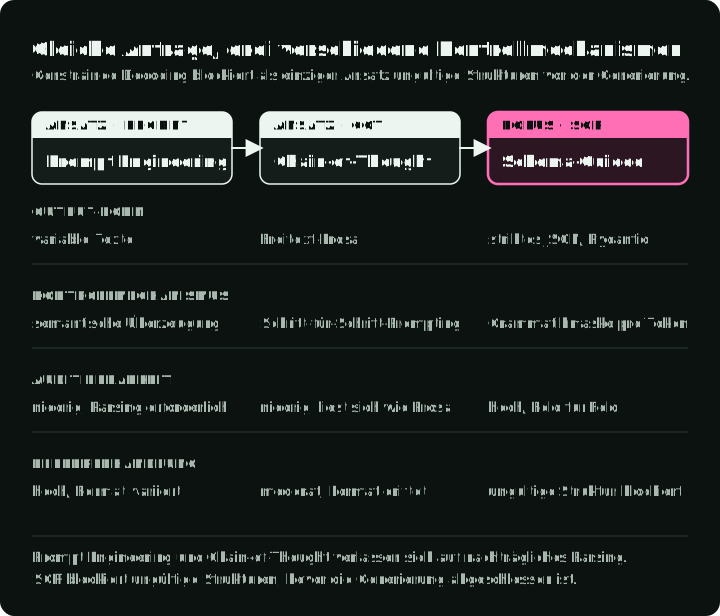
Prompt-Guidance und Constrained Decoding lassen sich kombinieren. Dieser Vergleich zeigt, wann jeder Pfad das angeforderte Format prüft: erst nach der Generierung oder zusätzlich bei jedem Token.
Prompt Engineering: das Format anfordern
Dieser Prompt bittet das Model, den Rabattvorschlag als JSON zu formatieren:
Please analyze the customer data and output your response as valid JSON
with the following structure: {"discount": <number>, "reason": <string>}
Be careful with the formatting!
Sie hoffen, dass das Verständnis des Models für „output JSON“ schwerer wiegt als seine Neigung zu Gesprächston. Ein Model-Update, eine geänderte Temperatur oder ein anderes Few-Shot-Beispiel kann Ihren Parser brechen.
Chain-of-Thought: nützlicher Reasoning-Trace, dasselbe Strukturproblem
Ein Chain-of-Thought-Prompt (CoT) verlangt eine Zwischenanalyse. Die Response kann so aussehen:
Let's think step by step:
1. First, I'll analyze the customer's churn risk...
2. Then I'll calculate the margin...
3. Therefore, I recommend a 15% discount.
CoT kann die Genauigkeit der Aufgabe verbessern, wenn Prompt, Model, Aufgabe und Evaluation dazu passen. Das Ergebnis bleibt aber Fließtext, der sich schwer zuverlässig parsen lässt. Eventuell brauchen Sie einen zweiten LLM-Aufruf, nur um strukturierte Daten zu extrahieren.
SGR: strukturierter Chain-of-Thought
SGR macht aus den Chain-of-Thought-Schritten benannte Felder, die Sie einsehen und bewerten können:
class PricingLogic(BaseModel):
    # 1. Recorded analysis
    churn_analysis: str = Field(..., description="Analyze churn_probability")
    financial_analysis: str = Field(..., description="Analyze cart_value and margin")

    # 2. Proposed calculation, checked by application code
    margin_math: str = Field(..., description="Calculate: 'Cart $X * Y% = $Z'")

    # 3. Proposed decision, not bounded by the analysis fields
    max_discount_percent: float = Field(..., description="Max allowed discount")
Das Schema listet die Felder in dieser Reihenfolge auf. Verwenden Sie getrennte Aufrufe, wenn ein späteres Feld von einem geprüften früheren Ergebnis abhängen muss.
Die Tabelle stellt die drei Ansätze nebeneinander:
| Merkmal | Prompt Engineering | Chain-of-Thought | Schema-Guided Reasoning |
|---|---|---|---|
| Ausgabestruktur | Variabler Text | Freier Fließtext | JSON, das zu einem Pydantic-Schema passt |
| Steuerung | Anweisung („output JSON“) | Anweisung („think step by step”) | Prompt plus Constrained Decoding |
| Wer die Schritte festlegt | Der Entwickler kann sie im Prompt benennen | Der Entwickler kann Schritte oder Beispiele vorgeben | Der Entwickler definiert die Schema-Felder |
| Einsicht | Zuerst den Text parsen | Den Fließtext lesen | Jedes Feld lesen |
| Integration | JSON/Pydantic-Parsing, wenn JSON gültig ist | JSON/Pydantic-Parsing, wenn JSON gültig ist; sonst Fließtext extrahieren | model_validate_json, dann Anwendungschecks |
SGR-Patterns
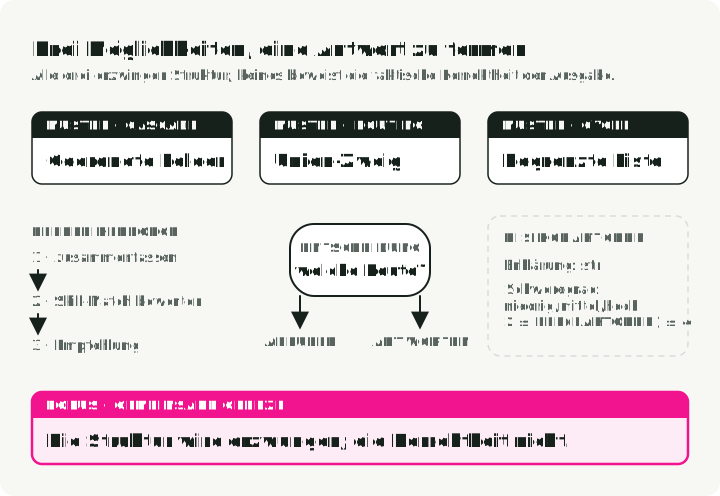
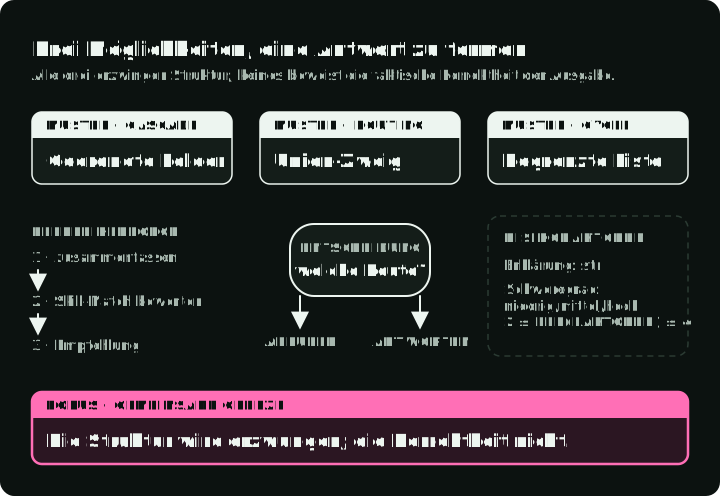
SGR hat drei Kernmuster, die sich zu größeren Workflows zusammensetzen lassen. Das Diagramm zeigt die Form, die jedes Muster einer Response gibt, mit den Feldnamen aus den folgenden Beispielen, und markiert die Grenze, die das jeweilige Schema setzt.
1. Cascade: sequenzielle Reasoning-Schritte
Cascade bildet eine Reasoning-Reihenfolge in einer strukturierten Response ab. Hier hält ein Dokumentklassifikator eine Zusammenfassung, einen Score für die Themenübereinstimmung und eine vorgeschlagene Kategorie fest.
from pydantic import BaseModel
from typing import Literal, Annotated
from annotated_types import Ge, Le

class DocumentEvaluation(BaseModel):
    """Record a document summary, score, and proposed category."""

    # Step 1: Record a summary
    brief_document_summary: str

    # Step 2: Rate (bounded integer)
    rate_topic_match: Annotated[int, Ge(1), Le(10)]

    # Step 3: Decide (constrained choices)
    final_recommendation: Literal["relevant", "irrelevant", "review"]
Beispielhafte Einsatzfälle: Dokumentklassifikation und Triage von Support-Tickets.
Das Model soll brief_document_summary, rate_topic_match und final_recommendation in genau dieser Reihenfolge zurückgeben.
2. Routing: ein semantisches Switch-Statement
Routing lässt das Model einen Pfad aus mehreren Optionen wählen, umgesetzt mit Union-Typen. Dieser Router wählt bei einer Pricing-Anfrage zwischen dem Abruf von Kundendaten und einer allgemeinen Antwort.
from pydantic import BaseModel
from typing import Literal, Union

class FeatureLookup(BaseModel):
    """Route to database lookup."""
    rationale: str
    tool_name: Literal["fetch_user_features"] = "fetch_user_features"
    user_id: str

class GeneralResponse(BaseModel):
    """Standard response for non-pricing queries."""
    tool_name: Literal["respond"] = "respond"
    content: str

class RouterSchema(BaseModel):
    """The model must pick exactly ONE branch."""
    action: Union[FeatureLookup, GeneralResponse]
Gute Einsatzfälle: Intent-Klassifikation, Tool-Auswahl, Support-Triage, Multi-Agent-Dispatch.
Die zweigspezifischen Literal-Werte lassen Pydantic die Mitglieder der Union unterscheiden. Damit Pydantic den Zweig direkt über tool_name wählt, deklarieren Sie eine Discriminated Union: action: Union[FeatureLookup, GeneralResponse] = Field(discriminator="tool_name"). Testen Sie, ob Ihr Backend das exportierte Schema akzeptiert.
3. Cycle: wiederholtes Reasoning mit Listen
Cycle beschreibt mehrere Elemente, mit Grenzen für ihre Anzahl. Dieses Beispiel zur Risikobewertung verlangt zwei bis vier Faktoren, jeweils mit Erklärung und Schweregrad.
from pydantic import BaseModel
from typing import List, Literal, Annotated
from annotated_types import MinLen, MaxLen

class RiskFactor(BaseModel):
    explanation: str
    severity: Literal["low", "medium", "high"]

class RiskAssessment(BaseModel):
    """Generate 2-4 risk factors."""
    factors: Annotated[List[RiskFactor], MinLen(2), MaxLen(4)]
Gute Einsatzfälle: Risikobewertung, Extraktion von Problemen, parallele Tool Calls, mehrstufige Planung.
Die Listengrenzen beschreiben einen variablen Batch von 2–4 Elementen. Ein unterstützter Decoder kann diese Länge beschränken; die Validierung in der Anwendung prüft sie erneut. In Kombination mit Routing kann die Liste vorgeschlagene Tool Calls beschreiben, die der Anwendungscode weiterhin autorisieren muss.
SGR funktionsfähig machen: Constrained Decoding
Die obigen Patterns sind nur Pydantic-Schemas. Constrained Decoding kann die unterstützten Constraints durchsetzen, die im exportierten JSON Schema stehen. Welche Features als unterstützt gelten, hängt vom Decoding-Backend ab. Beliebige Python-Validatoren werden nicht zu Decoder-Constraints; sie laufen nach der Generierung weiterhin in Pydantic.
Constrained Decoding verändert den Schritt der Token-Generierung. Statt das Model frei aus seinem Vokabular samplen zu lassen, wendet die Engine eine Grammar Mask an, die Tokens blockiert, die das Schema verletzen würden. Das geschieht in der Inference-Engine, nicht in Ihrem Anwendungscode.
SGR setzt kein Reasoning Model voraus. Auch instruction-tuned Models erzeugen schemabeschränkte Responses; vergleichen Sie die Genauigkeit der Aufgabe auf den Models, die Sie bereitstellen wollen.
Engines und Backends
Constrained Decoding braucht eine API oder eine Serving-Engine, die es unterstützt. Wenn Sie ein gehostetes Model aufrufen, nutzen Sie die Structured-Output-API des Anbieters: OpenAI Structured Outputs, Gemini structured output und Mistral custom structured output akzeptieren jeweils ein JSON Schema. Die unterstützten Schema-Features und das Verhalten bei Fehlern unterscheiden sich je nach Anbieter, testen Sie also das Schema, das Sie senden wollen.
Für ein selbst gehostetes Model hat jede der wichtigsten Engines ein Backend für Constrained Decoding:
| Engine | Structured-Output-Backends | Einsatz, wenn |
|---|---|---|
| vLLM | auto (default), xgrammar, guidance, outlines, lm-format-enforcer; gesetzt mit --structured-outputs-config.backend | Sie einen OpenAI-kompatiblen Server und die Wahl des Backends wollen; das Beispiel dieses Artikels |
| SGLang | XGrammar (default), Outlines, llguidance; gesetzt mit --grammar-backend | Sie bereits mit SGLang bereitstellen; XGrammar läuft ohne Flag |
| TensorRT-LLM | XGrammar oder LLGuidance; gesetzt mit guided_decoding_backend | Sie auf NVIDIA GPUs mit TensorRT-LLM deployen |
| Ollama | JSON Schema im Feld format der Anfrage | Sie lokal auf einem Laptop ohne GPU-Server testen |
Zwei Fragen entscheiden die Wahl: ob Code das Ergebnis liest und wer das Model betreibt. Jeder strukturierte Pfad endet mit denselben Anwendungschecks.
Dieser Artikel nutzt vLLM mit XGrammar. Die Structured-Output-API von vLLM akzeptiert JSON Schema über einen OpenAI-kompatiblen Client. So behält das Beispiel die vertraute Request-Mechanik, während das Decoding-Backend auf dem Server konfiguriert wird.
XGrammar liefert den Grammar-Compiler und die Token-Mask-Mechanik. Seine technische Übersicht erklärt die unten beschriebene Aufteilung zwischen CPU und GPU; die Benchmark-Ergebnisse gelten für die getesteten Workloads, nicht für jedes Deployment.
Wie XGrammar Schemas erzwingt
Wo das Masking stattfindet
Logits sind die nicht normalisierten Scores des Models für mögliche nächste Tokens. XGrammar verändert diese Scores nach dem Forward Pass des Models und vor dem Sampling. Es verändert das Model selbst nicht. Es filtert, welche Tokens ausgewählt werden können.
Eine übliche Inference-Schleife führt den Forward Pass aus, samplet das nächste Token aus den Logits und wiederholt das. XGrammar fügt Schritt 2 hinzu:
1. Input tokens → GPU Forward Pass → Raw Logits
2. Raw Logits → XGrammar Logits Processor → Masked Logits
3. Masked Logits → Sampling → Next Token (continues the grammar-valid prefix)
4. Repeat until done
Das Diagramm zeigt einen Schritt mit einem Vokabular aus acht Tokens: Die Scores der GPU und die Bitmask der CPU treffen zusammen, bevor ein Token ausgewählt wird. Jedes akzeptierte Token aktualisiert außerdem den Grammatikzustand für den nächsten Schritt.
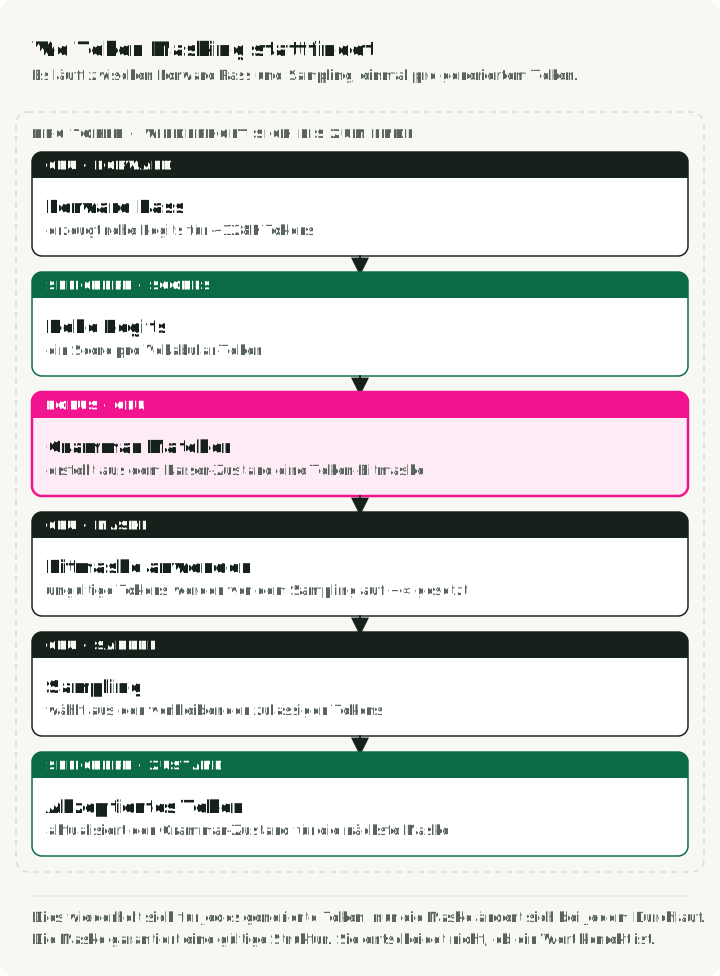
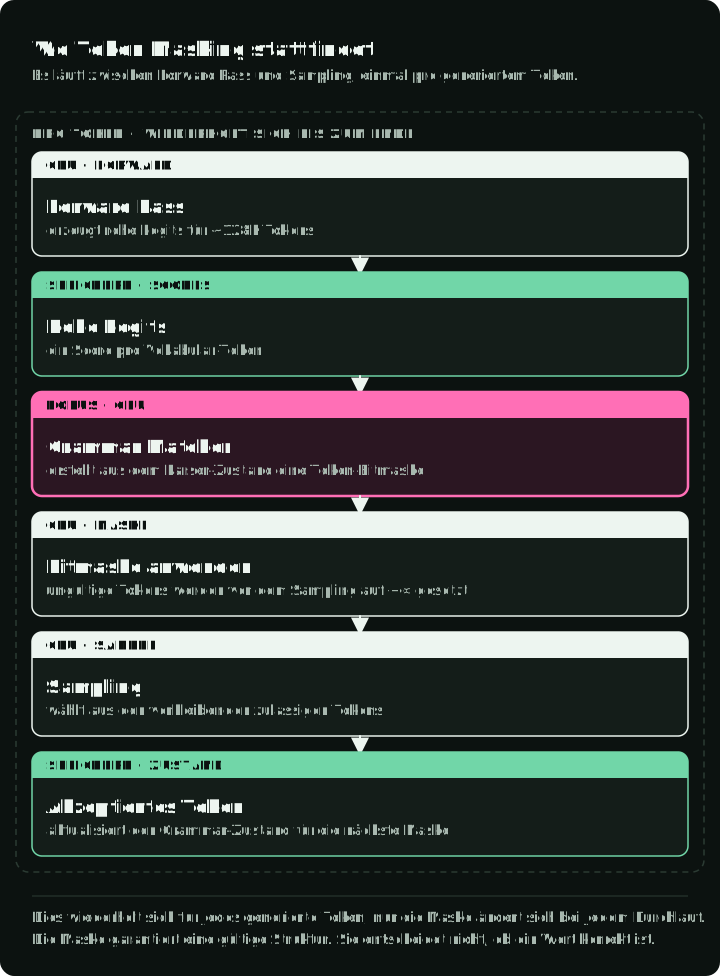
Das Model berechnet seine vollständige Wahrscheinlichkeitsverteilung weiterhin auf der GPU. Der GrammarMatcher von XGrammar erzeugt die Bitmask auf der CPU, dann verschiebt die Serving-Engine diese Bitmask auf das Gerät der Logits und wendet sie vor dem Sampling direkt an. Für GPU-Logits nutzt XGrammar dafür einen GPU-Kernel. Ungültige Tokens erhalten den Logit -∞, was ihre Wahrscheinlichkeit nach dem Softmax exakt auf 0 setzt.
Zwei Phasen
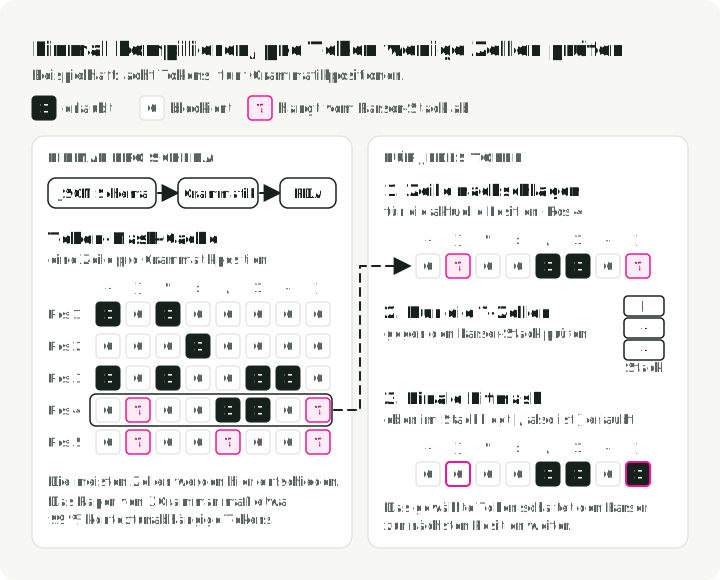
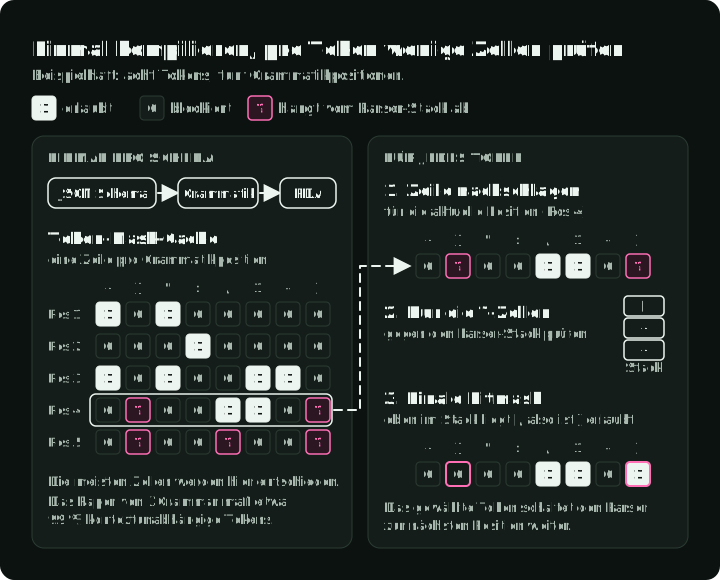
XGrammar teilt die Arbeit in Compile-Time und Runtime auf. Dieses Design reduziert wiederholte Arbeit an der Grammatik. Das Diagramm zeigt einen beispielhaften Cache, der einmal pro Schema aufgebaut wird (links), und die Arbeit für jedes generierte Token (rechts): Die meisten Zellen sind bereits erlaubt oder blockiert, und nur die wenigen mit ? markierten werden gegen den Parser-Stack geprüft. Der gestrichelte Pfeil markiert die Verbindung: Der einmal aufgebaute Cache wird bei jedem Schritt gelesen.
Phase 1: Grammar Compilation, einmal pro Schema
Dieser Ausschnitt baut mit dem Tokenizer des Models eine Grammatik für das Schema. Das kompilierte Ergebnis lässt sich wiederverwenden, wenn Responses mit diesem Schema generiert werden.
# This happens once per schema
tokenizer_info = xgr.TokenizerInfo.from_huggingface(tokenizer)
grammar_compiler = xgr.GrammarCompiler(tokenizer_info)
compiled_grammar = grammar_compiler.compile_json_schema(schema_json)
Bei der Kompilierung macht XGrammar Folgendes:
- Es wandelt das JSON Schema in eine kontextfreie Grammatik um.
- Es baut einen Pushdown-Automaten (PDA), also eine State Machine mit einem Stack, damit sie verschachtelte Strukturen wie
{"a": {"b": {"c": ...}}}verarbeiten kann. - Es berechnet vorab, welche Tokens an jeder Position der Grammatik gültig sind. Das Ergebnis ist der „adaptive Token-Mask-Cache“.
- Es teilt Tokens in „kontextunabhängige” (cachebar) und „kontextabhängige” (müssen zur Runtime gegen den Stack-Zustand geprüft werden) ein.
Das XGrammar-Paper berichtet, dass in seinen Messungen etwa 99 % der Tokens kontextunabhängig waren (Paper). Betrachten Sie diese Zahl als benchmark-spezifisch, nicht als allgemeines Verhältnis.
Phase 2: Mask-Generation zur Runtime, für jedes Token
In jedem Generierungsschritt:
- Der
GrammarMatcherverfolgt die aktuelle Position in der Grammatik. - Er schlägt die vorab berechnete Mask für kontextunabhängige Tokens nach.
- Er lässt den PDA laufen, um die übrigen kontextabhängigen Tokens zu prüfen.
- Er kombiniert beides zu einer finalen Bitmask, verschiebt sie auf das Gerät der Logits und wendet sie dort an.
Warum Pushdown-Automaten und nicht Regex?
Wegen der Verschachtelung. Ein regulärer Ausdruck (ein endlicher Automat) kann Strukturen wie diese nicht zuverlässig abgleichen:
{ "user": { "profile": { "settings": { "theme": "dark" } } } }Schwierig sind die schließenden Klammern }}}: Man muss sich merken, wie viele man geöffnet hat. Ein Pushdown-Automat hat dafür einen Stack und kommt deshalb mit beliebiger Verschachtelungstiefe zurecht. Deshalb kann XGrammar auch Union-Typen, verschachtelte Objekte und rekursive Schemas erzwingen, bei denen Regex-basierte Ansätze scheitern.
Ein konkretes Beispiel: ein Float-Feld generieren
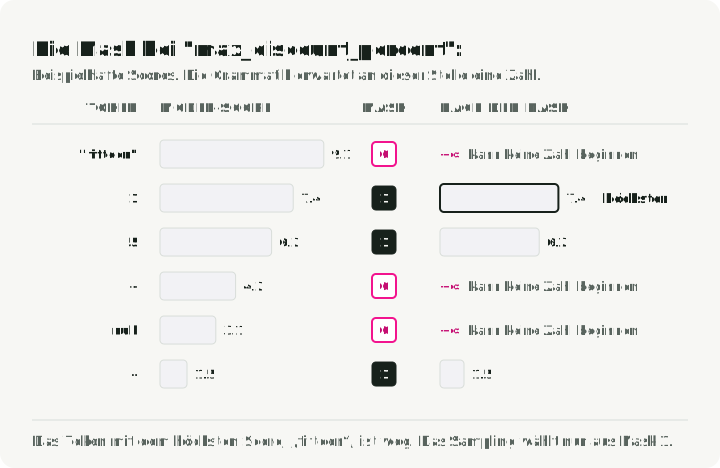
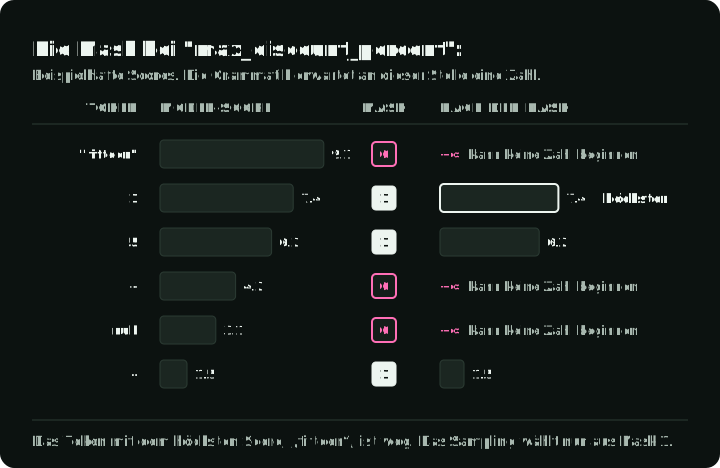
Wenn das Model "max_discount_percent": generiert, weiß XGrammar aus dem Schema, dass als Nächstes ein float kommt. Welche Tokens gültig sind, hängt vom Parser-Zustand und vom Tokenizer ab. Am Anfang der Zahl kann die Mask eine Ziffer oder ein Minuszeichen zulassen; nach einer Ziffer kann sie Fortsetzungen wie eine weitere Ziffer, einen Dezimalpunkt oder ein Exponentenzeichen zulassen.
- Ein Anführungszeichen,
{,[,true,falseodernullkann diese Zahl nicht beginnen, also blockiert die Mask ihre Tokens in diesem Zustand. - Der Forward Pass hat dem Token für
"fifteen"möglicherweise eine hohe Wahrscheinlichkeit gegeben. Weil dieses Token dieses numerische Feld nicht fortsetzen kann, entfernt die Mask es, und das Model muss eine gültige numerische Fortsetzung wählen.
Das Diagramm zeigt beispielhafte Scores für sechs Kandidaten-Tokens an dieser Position, das Mask-Bit jedes Tokens und die Scores nach der Mask.
Was den Overhead beeinflusst
Drei Dinge bestimmen den Overhead:
- Mask-Generation und Transfer. Die Mask-Generation auf der CPU und ihr Transfer auf das Gerät der Logits; wie stark sich das mit dem Forward Pass überlappt, hängt von der Serving-Engine ab.
- Caching. Der Großteil der Gültigkeitsprüfung geschieht zur Compile-Time. Die Runtime besteht überwiegend aus Cache-Lookups.
- C++-Implementierung. Der Hot Path ist C++, nicht Python, und die Mask wird direkt auf die Logits angewendet.
Die zitierten Benchmarks berichten geringen Overhead für ihre getesteten Grammatiken, Tokenizer, Hardware und Workloads. Diese Ergebnisse begründen keine allgemeine Garantie für Latency oder Throughput.
Praktische Implementierung mit vLLM
Das Begleit-Repository enthält diesen Code. uv run pytest testet die Policy- und Vollständigkeitschecks ohne Model; die Schritte am Ende dieses Abschnitts führen den vollständigen Agent gegen einen vLLM-Server aus.
Die folgenden Ausschnitte sind aus den Repository-Dateien gekürzt, die jeweils in ihrer ersten Zeile genannt werden. Sie zeigen Routing → Kontextabruf → Vorschlag → Freigabe und nutzen Pydantic 2 und den OpenAI-Python-Client.
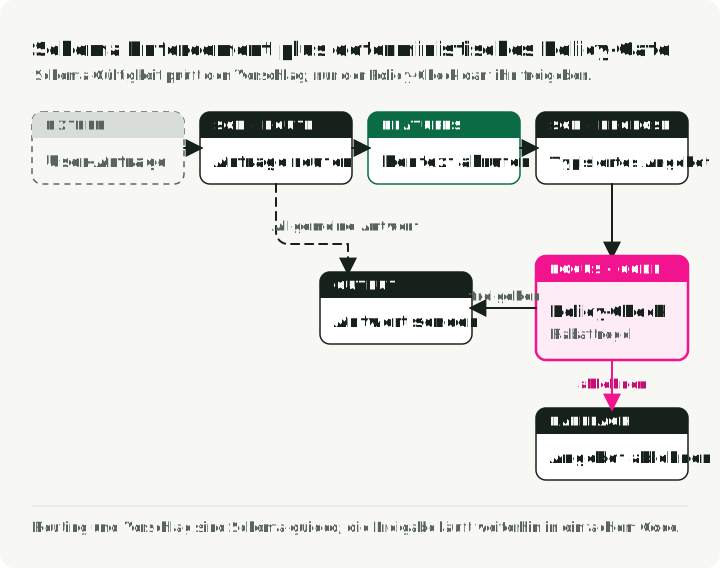
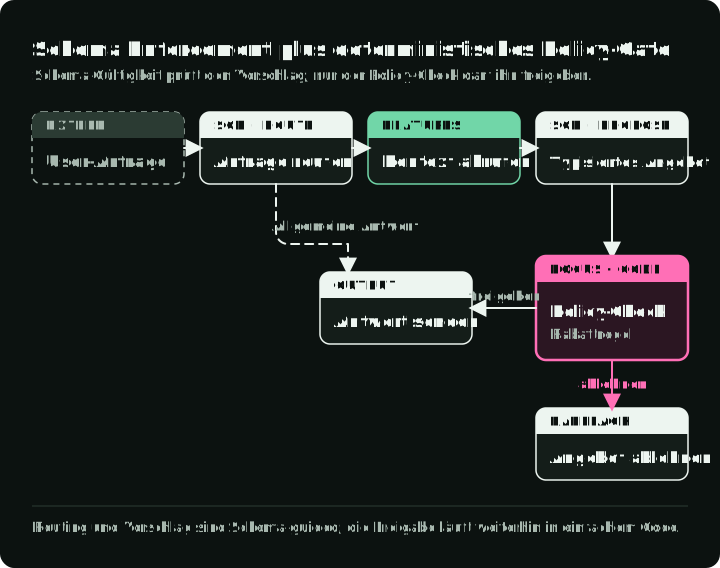
Eine allgemeine Anfrage kann sofort eine Response zurückgeben. Eine Pricing-Anfrage braucht Kundendaten und einen Vorschlag des Models, gefolgt von einer Policy-Prüfung in der Anwendung, bevor der Rabatt gemeldet werden kann. Wenn einer der beiden Model-Aufrufe vor einer vollständigen Antwort stoppt, endet die Anfrage mit einem Fehler; Schritt 2 zeigt diese Prüfung. Das Diagramm zeigt jeden Pfad durch den Agent und die Antwort, die jeder zurückgibt.
Schritt 1: Schemas definieren
sgr/models/schemas.py enthält die beiden zuvor gezeigten Schemas. RouterSchema ist der Router aus dem Abschnitt zu Routing: Kundendaten mit FeatureLookup anfordern oder Text mit GeneralResponse zurückgeben. PricingLogic hat die vier Felder aus dem SGR-Abschnitt. Die Beschreibung von margin_math gibt dem Model ein durchgerechnetes Beispiel für das Format: 'Cart $200 * 0.20 Margin = $40'.
Der Router und das Pricing-Schema sind getrennte Aufrufe. So kann die Anwendung die Kundendaten abrufen, bevor sie einen Vorschlag anfordert.
Schritt 2: Eine strukturierte Response anfordern und validieren
Der Client exportiert das Pydantic-Model als JSON Schema, hängt es zur Orientierung des Models an eine vorhandene System Message an und sendet es als Structured-Output-Constraint. XGrammar wird auf dem Server konfiguriert; der Client liefert das Schema für jede Anfrage.
completed_content weist unvollständige, verweigerte oder leere Responses zurück, bevor Pydantic das JSON und seine Felder validiert. Es weist Stopps wegen des Token-Limits auch dann zurück, wenn der zurückgegebene Text zufällig parsebar ist. Diese Fehler werden an den Aufrufer weitergereicht, der eine Fehlerantwort oder eine Retry-Policy liefern muss; auf diesen Pfaden wird kein Angebot freigegeben.
# sgr/utils/llm_client.py
import json
from typing import TypeVar

from openai import OpenAI
from pydantic import BaseModel

T = TypeVar("T", bound=BaseModel)

def completed_content(completion) -> str:
    """Reject incomplete, refused, or empty results before JSON validation."""
    if not completion.choices:
        raise ValueError("No completion returned")
    choice = completion.choices[0]
    if choice.finish_reason != "stop" or getattr(choice.message, "refusal", None):
        raise ValueError("Completion was not successful")
    content = choice.message.content
    if not isinstance(content, str) or not content.strip():
        raise ValueError("Completion has no content")
    return content

class LLMClient:
    """Wrapper for vLLM with XGrammar-enforced structured generation."""

    def __init__(self, base_url: str = "http://localhost:8000/v1"):
        # Local vLLM commonly has no authentication. EMPTY is not authentication.
        self.client = OpenAI(base_url=base_url, api_key="EMPTY")
        self.model = self._get_available_model()

    def _get_available_model(self) -> str:
        """Auto-detect the model running on vLLM server."""
        models = self.client.models.list()
        if not models.data:
            raise RuntimeError("vLLM reported no available models")
        return models.data[0].id

    def run_sgr(self, messages: list[dict], schema_class: type[T]) -> T:
        """Run inference with Schema-Guided Reasoning constraints.

        Uses vLLM structured outputs to constrain the JSON shape at generation time.
        """
        schema_dict = schema_class.model_json_schema()

        # Enhance system message with schema for model guidance
        enhanced_messages = messages.copy()
        if enhanced_messages and enhanced_messages[0]["role"] == "system":
            schema_json = json.dumps(schema_dict, indent=2)
            enhanced_messages[0] = {
                "role": "system",
                "content": (
                    enhanced_messages[0]["content"]
                    + f"\n\nRespond with JSON matching this schema:\n{schema_json}"
                ),
            }

        # vLLM v0.12+ structured outputs. Configure the backend on the server.
        completion = self.client.chat.completions.create(
            model=self.model,
            messages=enhanced_messages,
            temperature=0.1,  # Reduces sampling variation; it is not deterministic.
            extra_body={"structured_outputs": {"json": schema_dict}},
        )

        return schema_class.model_validate_json(completed_content(completion))
In vLLM ab v0.12 fordert structured_outputs: {"json": schema_dict} JSON an, das zum Schema passt. Die älteren Request-Felder guided_json und guided_decoding_backend wurden in v0.12.0 entfernt, und das Backend wird jetzt auf dem Server gesetzt.
Schritt 3: Den Agent orchestrieren
Die Anwendung routet die Anfrage, ruft Daten für den authentifizierten Aufrufer ab, fordert einen Vorschlag an, prüft ihn und gibt das Ergebnis zurück. Der Feature Store verwendet die authentifizierte user_id, niemals die vom Model vorgeschlagene ID. Der Prompt erhält außerdem user_ltv, den geschätzten Customer Lifetime Value; diese Schätzung gibt dem Model Kontext, legt aber die Rabattgrenze nicht fest.
Das Schema garantiert, dass max_discount_percent eine Zahl ist. Es garantiert nicht, dass die Zahl erlaubt ist; das entscheidet approve_discount. approve_discount prüft zuerst, dass die Eingaben endlich sind, der Warenkorbwert positiv ist und die Marge ein Anteil zwischen 0 und 1 ist. Die Demo-Policy weist dann vorgeschlagene Prozentwerte außerhalb von 0–20 zurück, rundet auf Hundertstel eines Prozentpunkts ab und weist einen finalen Rabatt zurück, der mehr kostet als der Rohgewinn des Warenkorbs.
# sgr/agent.py
from decimal import Decimal, ROUND_DOWN

from .models.schemas import PricingLogic, RouterSchema
from .prompts.routing import build_routing_prompt
from .prompts.pricing import build_pricing_context_prompt, ASSISTANT_FETCH_MESSAGE
from .store.hybrid_store import HybridFeatureStore
from .utils.llm_client import LLMClient

def approve_discount(offer: PricingLogic, context: dict) -> Decimal:
    """Enforce the pricing policy independently of the model's explanation."""
    cart_value = Decimal(str(context["current_cart_value"]))
    margin = Decimal(str(context["cart_profit_margin"]))
    proposed = Decimal(str(offer.max_discount_percent))

    if not all(value.is_finite() for value in (cart_value, margin, proposed)):
        raise ValueError("Pricing values must be finite")
    if cart_value <= 0 or not Decimal("0") <= margin <= Decimal("1"):
        raise ValueError("Invalid pricing context")

    if not Decimal("0") <= proposed <= Decimal("20"):
        raise ValueError("Proposed discount violates pricing policy")
    # Policy rounds down to hundredths of a percentage point before approval.
    approved = proposed.quantize(Decimal("0.01"), rounding=ROUND_DOWN)
    gross_profit = cart_value * margin
    discount_cost = cart_value * approved / Decimal("100")
    policy_cap = min(margin * Decimal("100"), Decimal("20"))
    if not Decimal("0") <= approved <= policy_cap or discount_cost > gross_profit:
        raise ValueError("Proposed discount violates pricing policy")

    return approved

def pricing_agent(user_query: str, user_id: str) -> str:
    """Integrate routing, context, and pricing; user_id is caller-authenticated."""

    llm = LLMClient()
    feature_store = HybridFeatureStore()

    # Build conversation history
    history = [
        {"role": "system", "content": build_routing_prompt(user_id)},
        {"role": "user", "content": user_query},
    ]

    # --- Phase 1: Routing (Uses RouterSchema) ---
    print(f"🤖 Processing: '{user_query}' for {user_id}")
    decision = llm.run_sgr(history, RouterSchema)
    print(f"📍 Routing decision: {decision.action.tool_name}")

    if decision.action.tool_name == "respond":
        return decision.action.content

    # --- Phase 2: Context Retrieval ---
    if decision.action.tool_name == "fetch_user_features":
        print(f"🔍 Fetching features for {user_id}...")
        context = feature_store.get_user_context(user_id)

        if not context:
            return "Error: User profile not found."

        print(f"   [Data] LTV: ${context.get('user_ltv')} | "
              f"Margin: {context.get('cart_profit_margin', 0) * 100}%")

        # Inject context into conversation
        history.append({"role": "assistant", "content": ASSISTANT_FETCH_MESSAGE})
        history.append({
            "role": "user",
            "content": build_pricing_context_prompt(
                churn_prob=context.get("churn_probability", 0.5),
                cart_val=context.get("current_cart_value", 100),
                margin=context.get("cart_profit_margin", 0.2),
                user_ltv=context.get("user_ltv", 0),
            ),
        })

        # --- Phase 3: model proposal, then deterministic policy enforcement ---
        print("🧠 Proposing Offer (Schema Enforced)...")
        offer = llm.run_sgr(history, PricingLogic)
        try:
            approved_discount = approve_discount(offer, context)
        except ValueError:
            return "No discount approved: the proposal failed the pricing policy."

        # Audit log: reasoning is inspectable; pricing is application-enforced.
        print(f"   [Audit] Math: {offer.margin_math}")
        print(f"   [Audit] Approved Discount: {approved_discount}%")

        return (
            f"Illustrative approved discount: {approved_discount}%. "
            "No coupon has been issued."
        )

    return "I'm sorry, I couldn't process your request."

if __name__ == "__main__":
    response = pricing_agent("I want a discount or I'm leaving!", "user_102")
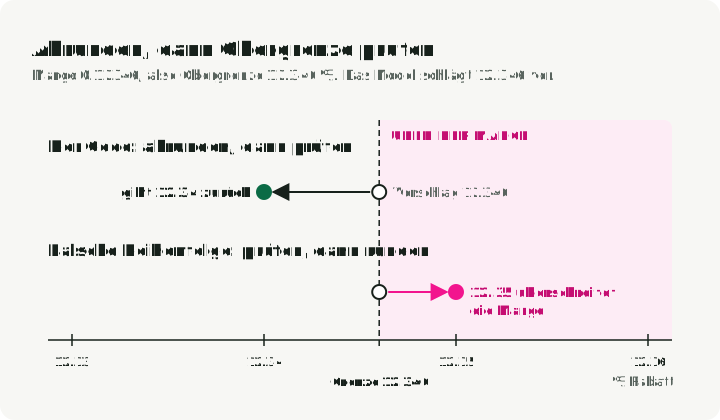
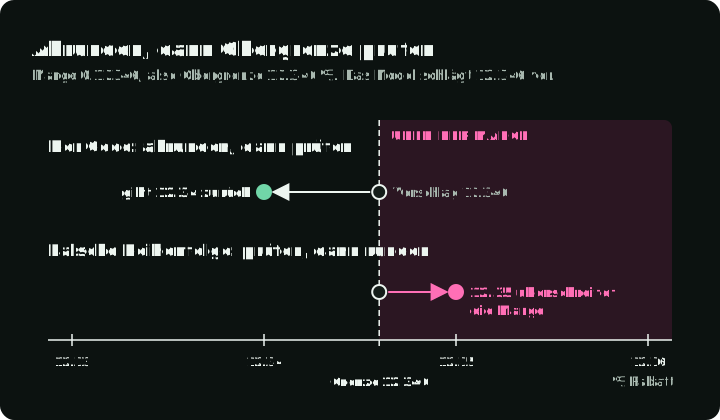
print(f"\n💬 Final Reply: {response}")Ein Vorschlag von 15 % für einen Warenkorb von $200 mit 20 % Marge liefert von der Policy-Funktion 15.00 zurück. Die Anwendung meldet diesen Prozentsatz, ohne so zu tun, als stelle sie einen Coupon aus. Ein Grenztest verwendet eine Marge von 0.12346, also 12,346 %. Ein Vorschlag von 12.346 wird vor der Prüfung des Endwerts auf 12.34 abgerundet. Ein Runden auf 12.35 nach der Freigabe würde die Marge überschreiten.
Die Zahlengerade zeigt diesen Grenztest: wo der zurückgegebene Wert bei jeder Reihenfolge von Runden und Prüfen relativ zur Obergrenze liegt.
approve_discount führt vier Prüfungen der Reihe nach aus:
- Die Eingaben sind gültig: Warenkorbwert größer als 0, Marge zwischen 0 und 1, kein NaN und keine Unendlichkeit.
- Der vorgeschlagene Rabatt liegt zwischen 0 und 20.
- Der Vorschlag wird auf 0.01 abgerundet (12.346 wird zu 12.34, nicht zu 12.35).
- Der gerundete Wert liegt höchstens bei der Marge in Prozent (und höchstens bei 20), und seine Kosten liegen höchstens beim Rohgewinn.
Jede fehlgeschlagene Prüfung löst ValueError aus, und der Vorschlag erhält keinen Rabatt. Das Runden kommt vor der Obergrenze, damit die Obergrenze den Wert prüft, der zurückgegeben wird.
Demo ausführen
Das Repository führt den gesamten Ablauf aus. Die Demo braucht Python 3.13 und uv. Der vLLM-Server braucht eine eigene Umgebung, einen unterstützten Beschleuniger und genug Speicher für das Model (Installationsanleitung); das README des Repositorys beschreibt die Installation und eine Docker-Option für die CPU zum Testen.
Installieren Sie die Demo, führen Sie die Offline-Tests aus und erzeugen Sie die synthetischen Kundendaten:
git clone https://github.com/slavadubrov/sgr-discount-manager
cd sgr-discount-manager
uv sync
uv run pytest
uv run python -m scripts.setup_data
Starten Sie den Server mit XGrammar als Structured-Output-Backend:
vllm serve Qwen/Qwen2.5-7B-Instruct \
    --port 8000 \
    --structured-outputs-config.backend xgrammar
Das positionale Model-Argument und die Backend-Option folgen der Referenz zu vLLM serve. Der Client verbindet sich mit http://localhost:8000/v1; für einen Server auf einem anderen Host ändern Sie DEFAULT_API_BASE_URL in sgr/config/constants.py.
Starten Sie den Agent:
uv run python -m sgr.agentDie Ausgabe sieht so aus. Die Werte sind beispielhaft; sie hängen von den zufälligen Demo-Daten und vom Model ab:
🤖 Processing: 'I want a discount or I'm leaving!' for user_102
📍 Routing decision: fetch_user_features
🔍 Fetching features for user_102...
   [Data] LTV: $1500.0 | Margin: 20.0%
🧠 Proposing Offer (Schema Enforced)...
   [Audit] Math: Cart $200 * 0.20 Margin = $40
   [Audit] Approved Discount: 15.00%

💬 Final Reply: Illustrative approved discount: 15.00%. No coupon has been issued.
Die Zeile [Audit] Math ist die vom Model festgehaltene Berechnung. Die Zeile Approved Discount und die finale Antwort stammen von approve_discount und dem Anwendungscode, nicht vom Model.
Checks vor einer Live-Integration
Schema-Design
- Ordnen Sie die Felder nach dem vorgesehenen Reasoning-Ablauf.
- Schreiben Sie für jedes Feld eine
Field-Beschreibung. Pydantic exportiert sie ins JSON Schema, und der Client oben fügt dieses Schema dem Prompt hinzu. - Beschränken Sie mit
LiteralundAnnotated. Verwenden SieLiteral["a", "b"]für Enums undAnnotated[int, Ge(1), Le(10)]für Grenzen. - Halten Sie Schemas fokussiert. Ein Schema pro Reasoning-Phase, dann mit mehreren Aufrufen zusammensetzen.
vLLM-Konfiguration
- Verwenden Sie eine niedrige Temperatur (0.1-0.3), um die Streuung beim Sampling zu verringern. Für reproduzierbare Tests fixieren Sie Model und Serving-Konfiguration, nutzen den deterministischen Modus des Servers, falls er einen bietet, und verifizieren das Ergebnis.
- Erklären Sie die Aufgabe und die Schema-Felder im Prompt, wie es der Client oben tut. Der Prompt sagt dem Model, was jedes Feld bedeutet; der Decoder blockiert nur ungültige Tokens.
- Messen Sie den Token-Verbrauch bei demselben Prompt, Model, Schema und derselben Aufgabe. SGR kann mehr oder weniger Tokens erzeugen als eine freie CoT-Response.
Überlegungen für die Production
- Versionieren Sie Ihre Schemas so, wie Sie APIs versionieren.
- Halten Sie Vorschlag und Policy-Entscheidung zum Debuggen getrennt fest, vorbehaltlich Ihrer Regeln zu Datenaufbewahrung und Schwärzung.
- Berechnen Sie Preise, Grenzen, Berechtigungen und andere semantische Regeln vor der Verwendung im Anwendungscode neu; testen Sie Grenzwerte, die das Schema allein nicht zurückweisen kann.
Der nächste Test
Beginnen Sie mit der Rabattgrenze und einer unvollständigen Completion. Die Offline-Tests des Repositorys decken beides ab, können Ihnen aber nicht sagen, ob ein Model einen echten Kunden richtig routet oder die Marge genau erklärt. Halten Sie für eine Live-Evaluation Model, Prompts, Schema und Serving-Einstellungen fest. Zählen Sie unvollständige Ergebnisse, Schemafehler, Routing-Fehler und Policy-Ablehnungen getrennt, bevor Sie Kosten oder Genauigkeit der Aufgabe vergleichen.
Referenzen
SGR Framework
- Schema-Guided Reasoning (SGR) — Rinat Abdullins ursprüngliches Framework
- SGR Patterns — die Patterns Cascade, Routing, Cycle
xgrammar
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models — Yixin Dong et al., arXiv:2411.15100 (technisches Paper mit Benchmarks)
- xgrammar GitHub — schnelle, flexible Bibliothek für strukturierte Generierung
- xgrammar Documentation — offizielle Dokumentation mit Quick Start
- xgrammar Quick Start — Einstieg in xgrammar
- Achieving Efficient Structured Generation with XGrammar — MLC-Blogbeitrag zu den Interna von xgrammar
vLLM
- vLLM Structured Outputs — offizielle Dokumentation
Demo Project
- sgr-discount-manager — Begleit-Demo: der Code aus diesem Artikel, Offline-Tests und Ausführungsschritte