Schema-Guided Reasoning: vLLM, XGrammar y Pydantic

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Este artículo está dirigido a ingenieros de Python que necesitan una salida del modelo que el código posterior pueda validar. Schema-Guided Reasoning (SGR) da al modelo una lista fija de campos que rellenar, con el análisis primero y la decisión al final, de modo que el código pueda comprobar cada paso. Aprenderás a definir un esquema de Pydantic, a solicitar structured output a vLLM y a añadir comprobaciones de aplicación para el significado y la política.
Pydantic describe los campos de la respuesta, vLLM sirve el modelo y XGrammar restringe qué tokens puede generar el modelo. Esta restricción se llama constrained decoding. Un límite de tokens aún puede dejar un prefijo JSON incompleto, así que el código de la aplicación debe comprobar que la generación terminó y validar el resultado.
¿Qué es Schema-Guided Reasoning?
Schema-Guided Reasoning es una técnica que Rinat Abdullin describió en julio de 2025. En lugar de dejar que el modelo complete texto libremente (lo que puede resultar incoherente o ambiguo), se le da una plantilla estricta que define:
- qué pasos debe representar la respuesta
- el orden previsto de esos pasos, para que un revisor pueda inspeccionar el camino de los datos a la decisión
- dónde debe centrar la atención
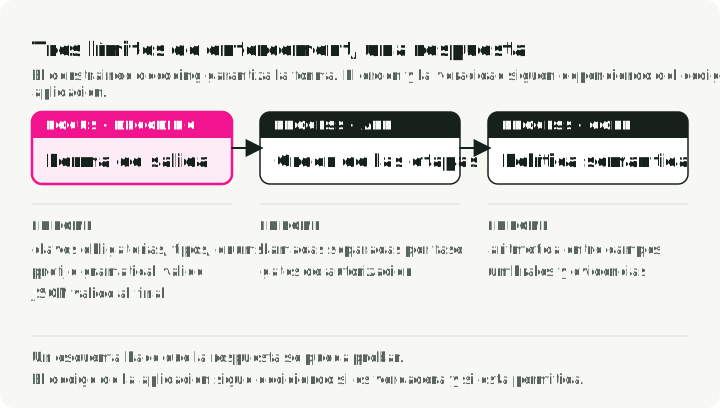
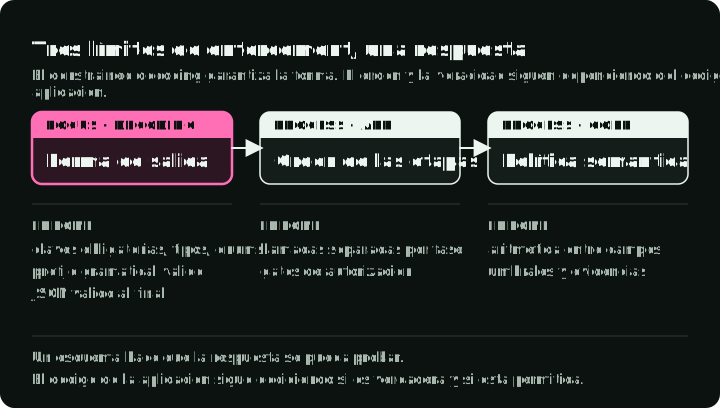
Piensa en ello como una lista de salidas que inspeccionar, no como una prueba del razonamiento interno del modelo. El decoder comprueba la estructura de la salida; el código de la aplicación controla cuándo se ejecuta cada etapa y si se permite usar un resultado.
El diagrama sigue una respuesta de precios por las tres partes que la comprueban: el decoder impone la forma, la aplicación impone el orden de las etapas y que la generación termine, y el código de políticas impone el significado.
Qué controla el esquema
El ejemplo que seguiremos propone un descuento para retener a un cliente que podría marcharse. La probabilidad de abandono estima esa posibilidad; el valor del carrito es el total antes del descuento. El margen es el beneficio bruto como fracción de ese total: un carrito de $200 con un margen de 0.20 tiene $40 de beneficio bruto. Los descuentos usan puntos porcentuales, así que una propuesta de 15 significa un 15 %.
Un modelo de precios puede devolver un JSON válido y aun así proponer un descuento del 25 % cuando el margen es solo del 20 %. El esquema registra la propuesta; el código de la aplicación debe comprobar si el descuento está permitido.
Campos como churn_analysis, margin_math y max_discount_percent hacen explícitas las salidas intermedias previstas. Un esquema restringe la forma de lo que se devuelve. Por sí solo, no hace que un campo dependa de otro ni demuestra que la decisión sea correcta.
Esto te da:
- una estructura de salida comparable entre ejecuciones repetidas
- salidas intermedias registradas que los revisores pueden inspeccionar
- campos intermedios que puedes evaluar con un dataset de prueba
- los modelos más pequeños pueden seguir el formato con más frecuencia; mide la precisión de la tarea antes de confiar en ello
- Abdullin escribe que una mejora de precisión del 5–10 % «no es infrecuente» en los casos que ha observado; es una observación de un profesional, no un resultado de benchmark, así que mídelo con tu propia carga de trabajo
Usa SGR cuando el código posterior dependa de la estructura. Si una persona lee la respuesta como prosa, una respuesta libre es más sencilla.
Guía en el prompt y restricciones del decoder
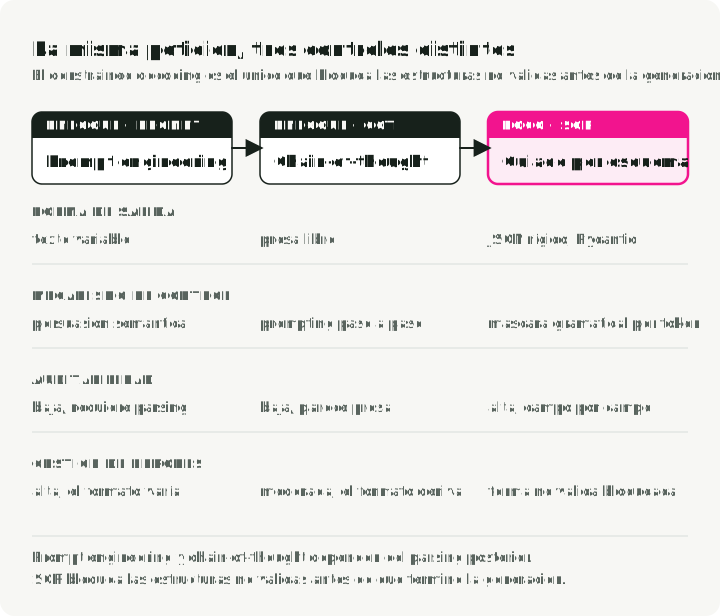
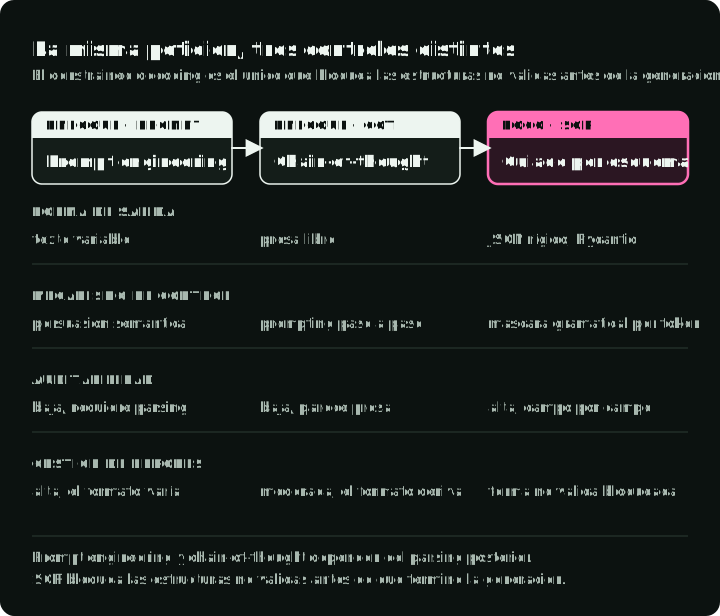
La guía en el prompt y el constrained decoding se pueden combinar. Esta comparación muestra cuándo comprueba cada camino el formato solicitado: solo después de la generación, o también en cada token.
Prompt engineering: pedir el formato
Este prompt pide al modelo que dé formato JSON a la propuesta de descuento:
Please analyze the customer data and output your response as valid JSON
with the following structure: {"discount": <number>, "reason": <string>}
Be careful with the formatting!
Esperas que la comprensión que tiene el modelo de «output JSON» pese más que su tendencia a conversar. Una actualización del modelo, un cambio de temperatura o un ejemplo few-shot distinto pueden romper tu parser.
Chain of Thought: un rastro de razonamiento útil, el mismo problema de estructura
Un prompt de chain-of-thought (CoT) pide un análisis intermedio. La respuesta podría verse así:
Let's think step by step:
1. First, I'll analyze the customer's churn risk...
2. Then I'll calculate the margin...
3. Therefore, I recommend a 15% discount.
CoT puede mejorar la precisión de la tarea cuando el prompt, el modelo, la tarea y la evaluación lo respaldan, pero deja el resultado como prosa difícil de analizar de forma fiable. Puede que acabes haciendo una segunda llamada a un LLM solo para extraer datos estructurados.
SGR: chain of thought estructurado
SGR convierte los pasos del chain-of-thought en campos con nombre que puedes inspeccionar y evaluar:
class PricingLogic(BaseModel):
    # 1. Recorded analysis
    churn_analysis: str = Field(..., description="Analyze churn_probability")
    financial_analysis: str = Field(..., description="Analyze cart_value and margin")

    # 2. Proposed calculation, checked by application code
    margin_math: str = Field(..., description="Calculate: 'Cart $X * Y% = $Z'")

    # 3. Proposed decision, not bounded by the analysis fields
    max_discount_percent: float = Field(..., description="Max allowed discount")
El esquema lista estos campos en ese orden. Usa llamadas separadas cuando un campo posterior deba depender de un resultado anterior ya comprobado.
La tabla compara los tres enfoques:
| Característica | Prompt engineering | Chain of Thought | Schema-Guided Reasoning |
|---|---|---|---|
| Estructura de salida | Texto variable | Prosa libre | JSON que coincide con un esquema de Pydantic |
| Mecanismo de control | Instrucción («output JSON») | Instrucción («think step by step») | Prompt más constrained decoding |
| Quién fija los pasos | El desarrollador puede nombrarlos en el prompt | El desarrollador puede dar pasos o ejemplos | El desarrollador define los campos del esquema |
| Inspección | Primero hay que analizar el texto | Leer la prosa | Leer cada campo |
| Integración | Análisis con JSON/Pydantic si el JSON es válido | Análisis con JSON/Pydantic si el JSON es válido; si no, extraer la prosa | model_validate_json, y después comprobaciones de aplicación |
Patrones de SGR
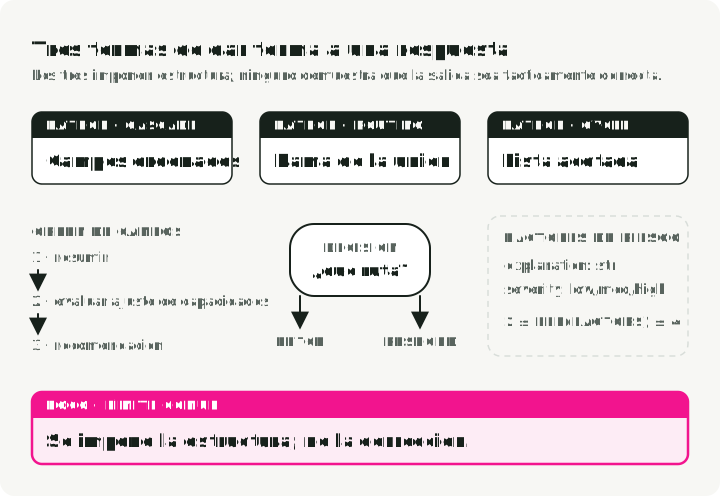
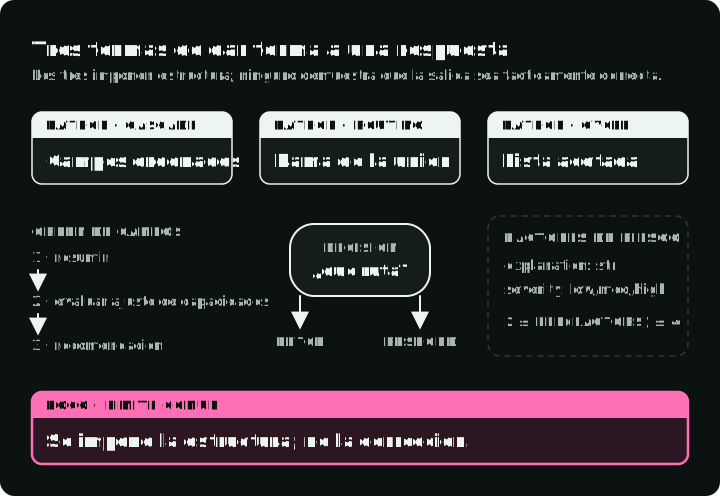
SGR tiene tres patrones básicos que se combinan en flujos de trabajo mayores. El diagrama muestra la forma que cada uno da a una respuesta, con los nombres de campo de los ejemplos siguientes, y marca el límite que fija cada esquema.
1. Cascade: pasos de razonamiento secuenciales
Cascade representa un orden de razonamiento en una sola respuesta estructurada. Aquí, un clasificador de documentos registra un resumen, una puntuación de coincidencia temática y una categoría propuesta.
from pydantic import BaseModel
from typing import Literal, Annotated
from annotated_types import Ge, Le

class DocumentEvaluation(BaseModel):
    """Record a document summary, score, and proposed category."""

    # Step 1: Record a summary
    brief_document_summary: str

    # Step 2: Rate (bounded integer)
    rate_topic_match: Annotated[int, Ge(1), Le(10)]

    # Step 3: Decide (constrained choices)
    final_recommendation: Literal["relevant", "irrelevant", "review"]
Usos ilustrativos: clasificación de documentos y triaje de tickets de soporte.
Se pide al modelo que devuelva brief_document_summary, rate_topic_match y final_recommendation en ese orden.
2. Routing: un switch semántico
Routing pide al modelo que elija un camino entre un conjunto de opciones, implementado con tipos Union. Este router elige entre obtener los datos del cliente para una solicitud de precios y devolver una respuesta general.
from pydantic import BaseModel
from typing import Literal, Union

class FeatureLookup(BaseModel):
    """Route to database lookup."""
    rationale: str
    tool_name: Literal["fetch_user_features"] = "fetch_user_features"
    user_id: str

class GeneralResponse(BaseModel):
    """Standard response for non-pricing queries."""
    tool_name: Literal["respond"] = "respond"
    content: str

class RouterSchema(BaseModel):
    """The model must pick exactly ONE branch."""
    action: Union[FeatureLookup, GeneralResponse]
Buenos casos de uso: clasificación de intenciones, selección de herramientas, triaje de soporte, despacho multi-agent.
Los valores Literal propios de cada rama permiten a Pydantic distinguir los miembros de la unión. Para que Pydantic elija la rama directamente por tool_name, declara una unión discriminada: action: Union[FeatureLookup, GeneralResponse] = Field(discriminator="tool_name"). Comprueba que tu backend acepta el esquema exportado.
3. Cycle: razonamiento repetido con listas
Cycle describe varios elementos, con límites sobre cuántos. Este ejemplo de evaluación de riesgos pide de dos a cuatro factores, cada uno con una explicación y una gravedad.
from pydantic import BaseModel
from typing import List, Literal, Annotated
from annotated_types import MinLen, MaxLen

class RiskFactor(BaseModel):
    explanation: str
    severity: Literal["low", "medium", "high"]

class RiskAssessment(BaseModel):
    """Generate 2-4 risk factors."""
    factors: Annotated[List[RiskFactor], MinLen(2), MaxLen(4)]
Buenos casos de uso: evaluación de riesgos, extracción de incidencias, tool calls en paralelo, planificación de varios pasos.
Los límites de la lista describen un lote variable de 2 a 4 elementos. Un decoder compatible puede restringir esa longitud; la validación de la aplicación la comprueba de nuevo. Combinada con Routing, la lista puede describir tool calls propuestas, que el código de la aplicación sigue teniendo que autorizar.
Hacer que SGR funcione: constrained decoding
Los patrones anteriores son solo esquemas de Pydantic. El constrained decoding puede imponer las restricciones compatibles que se exportan en su JSON Schema. Qué características cuentan como compatibles depende del backend de decodificación. Los validadores arbitrarios de Python no se convierten en restricciones del decoder; siguen ejecutándose en Pydantic después de la generación.
El constrained decoding modifica el paso de generación de tokens. En lugar de dejar que el modelo muestree libremente de su vocabulario, el motor aplica una máscara de gramática que bloquea los tokens que violarían el esquema. Esto ocurre en el motor de inferencia, no en el código de tu aplicación.
SGR no requiere un modelo de razonamiento. Los modelos ajustados con instrucciones también producen respuestas restringidas por esquema; compara la precisión de la tarea en los modelos que pienses servir.
Motores y backends
El constrained decoding necesita una API o un motor de serving que lo admita. Si llamas a un modelo alojado, usa la API de structured output del proveedor: OpenAI Structured Outputs, Gemini structured output y Mistral custom structured output aceptan un JSON Schema. Las características de esquema admitidas y el comportamiento ante fallos varían según el proveedor, así que prueba el esquema que pienses enviar.
Para un modelo autoalojado, los principales motores tienen cada uno un backend de constrained decoding:
| Motor | Backends de structured output | Úsalo cuando |
|---|---|---|
| vLLM | auto (por defecto), xgrammar, guidance, outlines, lm-format-enforcer; se configura con --structured-outputs-config.backend | Quieres un servidor compatible con OpenAI y poder elegir backend; es el ejemplo de este artículo |
| SGLang | XGrammar (por defecto), Outlines, llguidance; se configura con --grammar-backend | Ya sirves con SGLang; XGrammar funciona sin ningún flag |
| TensorRT-LLM | XGrammar o LLGuidance; se configura con guided_decoding_backend | Despliegas en GPUs de NVIDIA con TensorRT-LLM |
| Ollama | JSON Schema en el campo format de la solicitud | Pruebas en local en un portátil sin servidor con GPU |
Dos preguntas deciden la elección: si el código lee el resultado y quién ejecuta el modelo. Todos los caminos estructurados terminan con las mismas comprobaciones de aplicación.
Este artículo usa vLLM con XGrammar. La API de structured output de vLLM acepta JSON Schema a través de un cliente compatible con OpenAI. Así, el ejemplo conserva el código habitual de las solicitudes mientras el backend de decodificación se configura en el servidor.
XGrammar aporta el compilador de gramáticas y la maquinaria de máscaras de tokens. Su visión técnica general explica el reparto entre CPU y GPU que aparece más abajo; sus resultados de benchmark se aplican a las cargas de trabajo probadas, no a todos los despliegues.
Cómo impone XGrammar los esquemas
Dónde ocurre el enmascarado
Los logits son las puntuaciones sin normalizar que da el modelo a los posibles tokens siguientes. XGrammar modifica esas puntuaciones después de la pasada hacia delante del modelo y antes del muestreo. No cambia el modelo en sí. Filtra qué tokens se pueden seleccionar.
Un bucle de inferencia estándar ejecuta la pasada hacia delante, muestrea el siguiente token a partir de los logits y repite. XGrammar añade el paso 2:
1. Input tokens → GPU Forward Pass → Raw Logits
2. Raw Logits → XGrammar Logits Processor → Masked Logits
3. Masked Logits → Sampling → Next Token (continues the grammar-valid prefix)
4. Repeat until done
El diagrama muestra un paso con un vocabulario de ocho tokens: las puntuaciones de la GPU y el bitmask de la CPU se encuentran antes de seleccionar un token. Cada token aceptado también actualiza el estado de la gramática para el paso siguiente.
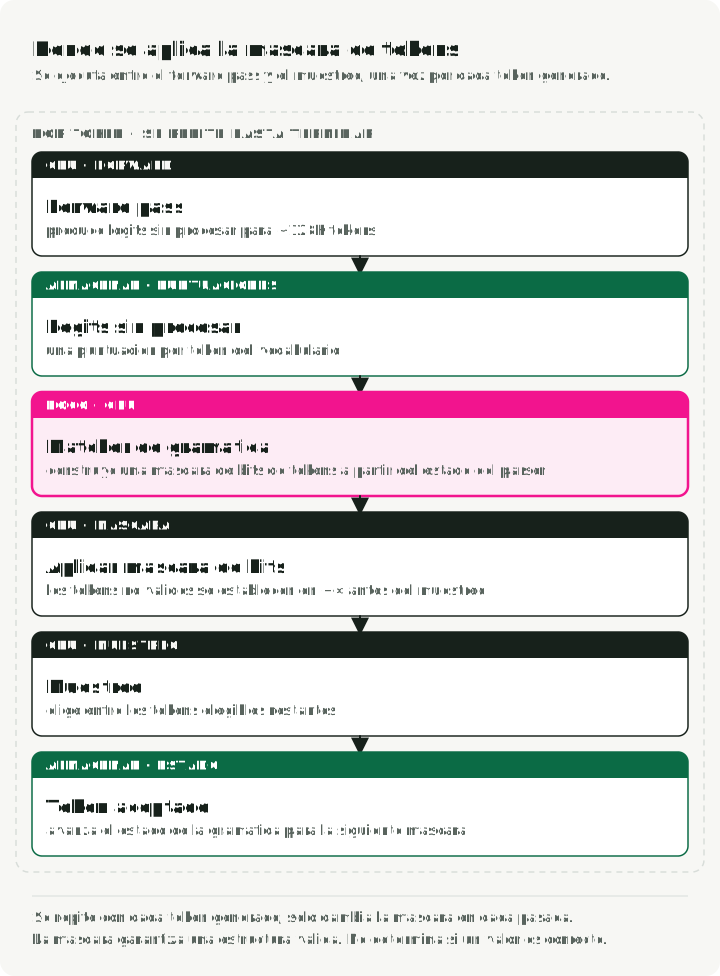
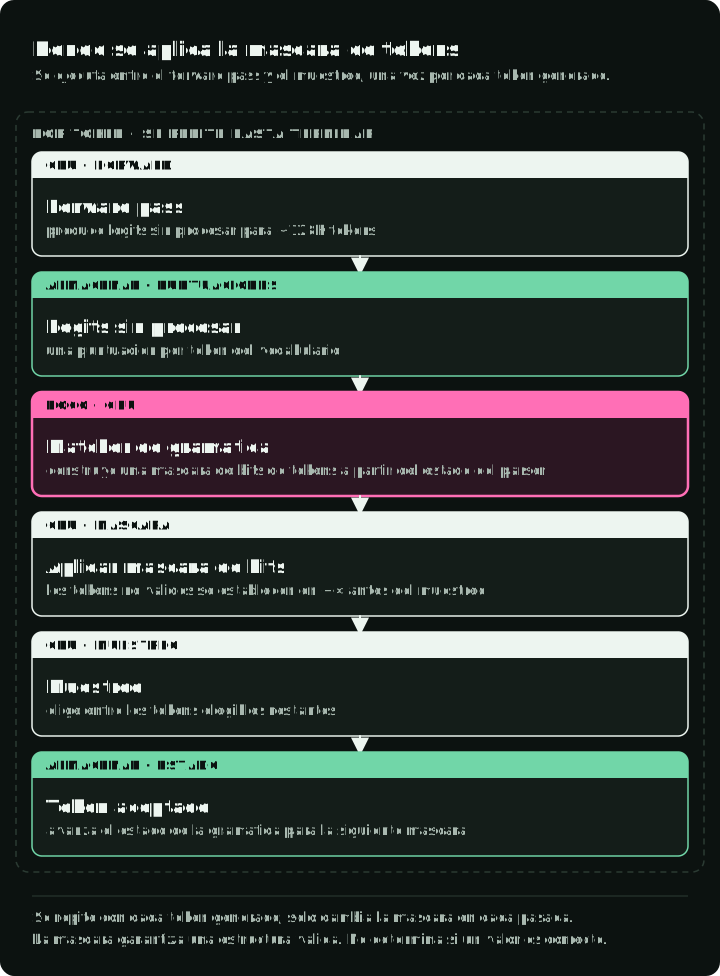
El modelo sigue calculando su distribución de probabilidad completa en la GPU. El GrammarMatcher de XGrammar genera el bitmask en la CPU; después, el motor de serving mueve ese bitmask al dispositivo de los logits y lo aplica in situ antes del muestreo. Para logits en GPU, XGrammar usa un kernel de GPU para esa aplicación. Los tokens no válidos reciben un logit de -∞, lo que hace que su probabilidad sea exactamente 0 tras el softmax.
Dos fases
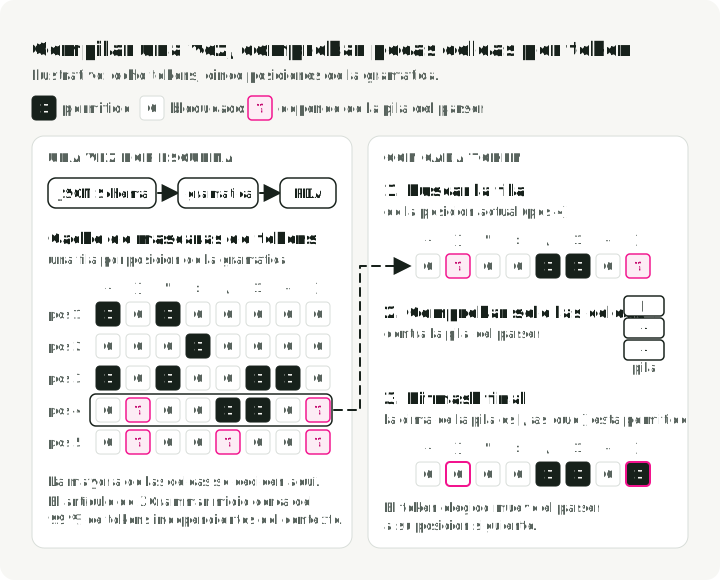
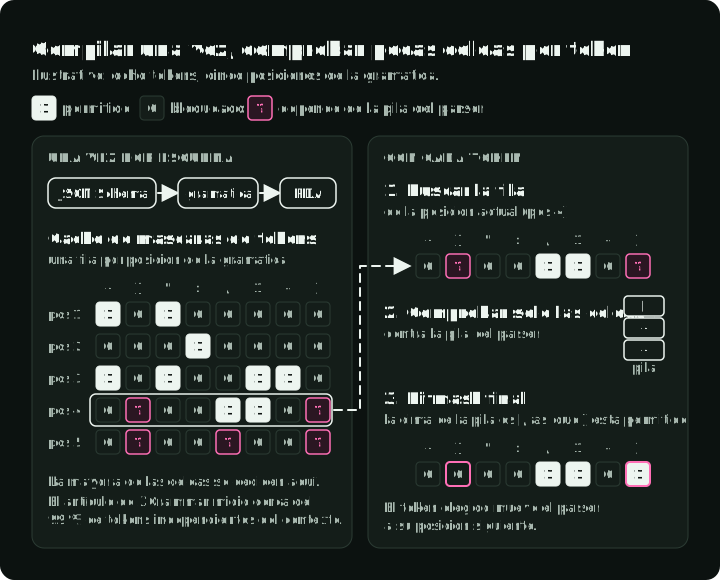
XGrammar divide el trabajo entre tiempo de compilación y tiempo de ejecución. Este diseño reduce el trabajo repetido sobre la gramática. El diagrama muestra una caché ilustrativa construida una vez por esquema (izquierda) y el trabajo que se hace con cada token generado (derecha): la mayoría de las celdas ya están permitidas o bloqueadas, y solo las pocas marcadas con ? se comprueban contra la pila del parser. La flecha discontinua marca el enlace: la caché construida una vez se lee en cada paso.
Fase 1: compilación de la gramática, una vez por esquema
Este fragmento construye una gramática para el esquema usando el tokenizer del modelo. El resultado compilado se puede reutilizar al generar respuestas con ese esquema.
# This happens once per schema
tokenizer_info = xgr.TokenizerInfo.from_huggingface(tokenizer)
grammar_compiler = xgr.GrammarCompiler(tokenizer_info)
compiled_grammar = grammar_compiler.compile_json_schema(schema_json)
Durante la compilación, XGrammar:
- Convierte el JSON Schema en una gramática libre de contexto.
- Construye un autómata de pila (Pushdown Automaton, PDA), que es una máquina de estados con una pila para poder manejar estructuras anidadas como
{"a": {"b": {"c": ...}}}. - Precalcula qué tokens son válidos en cada posición de la gramática. El resultado es la «caché adaptativa de máscaras de tokens».
- Clasifica los tokens como «independientes del contexto» (se pueden guardar en caché) o «dependientes del contexto» (hay que comprobarlos en tiempo de ejecución contra el estado de la pila).
El artículo de XGrammar indica que cerca del 99 % de los tokens eran independientes del contexto en sus mediciones (artículo). Trata esa cifra como propia de ese benchmark, no como una proporción universal.
Fase 2: generación de la máscara en ejecución, con cada token
En cada paso de generación:
- El
GrammarMatcherregistra la posición actual en la gramática. - Consulta la máscara precalculada para los tokens independientes del contexto.
- Ejecuta el PDA para comprobar los tokens dependientes del contexto que quedan.
- Los combina en un bitmask final, lo mueve al dispositivo de los logits y lo aplica allí.
¿Por qué autómatas de pila y no regex?
Por el anidamiento. Una expresión regular (una máquina de estados finita) no puede reconocer de forma fiable estructuras como:
{ "user": { "profile": { "settings": { "theme": "dark" } } } }Lo difícil son las llaves de cierre }}}: hay que recordar cuántas se abrieron. Un autómata de pila tiene una pila que lo registra, así que puede manejar cualquier profundidad de anidamiento. Por eso XGrammar puede imponer tipos Union, objetos anidados y esquemas recursivos, donde los enfoques basados en regex se quedan cortos.
Un ejemplo concreto: generar un campo float
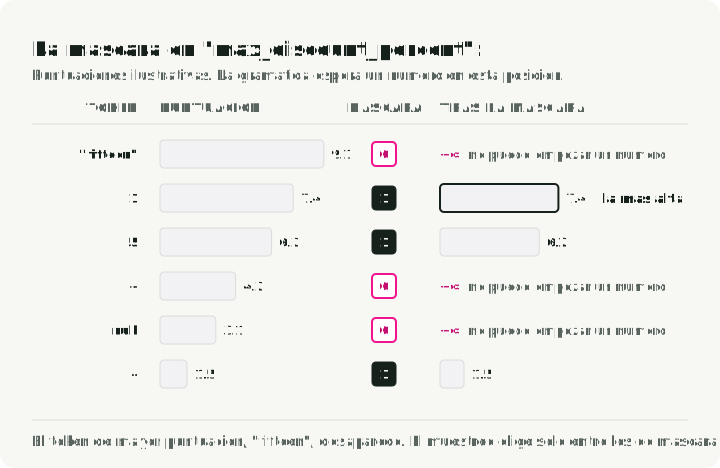
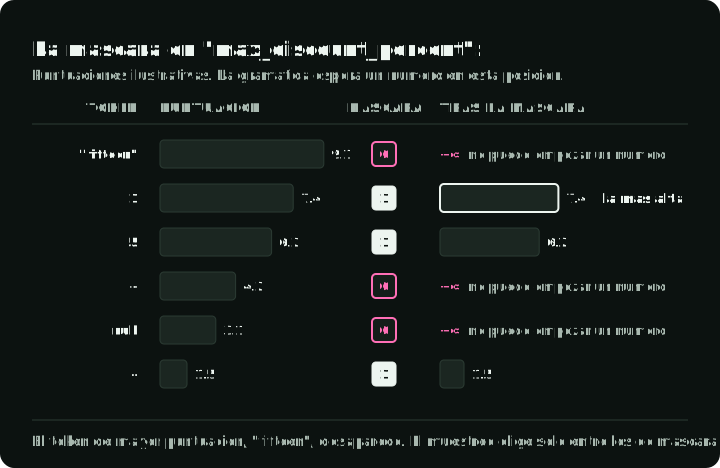
Cuando el modelo está generando "max_discount_percent":, XGrammar sabe por el esquema que viene un float. El conjunto de tokens válidos depende del estado del parser y del tokenizer. Al comienzo del número, la máscara puede admitir un dígito o un signo menos; tras un dígito, puede admitir continuaciones como otro dígito, un punto decimal o un marcador de exponente.
- Unas comillas,
{,[,true,falseonullno pueden iniciar este número, así que la máscara bloquea sus tokens en ese estado. - La pasada hacia delante pudo haber asignado una probabilidad alta al token de
"fifteen". Como ese token no puede continuar este campo numérico, la máscara lo elimina y el modelo debe elegir una continuación numérica válida.
El diagrama muestra puntuaciones ilustrativas de seis tokens candidatos en esta posición, el bit de máscara de cada uno y las puntuaciones tras la máscara.
Qué afecta a la sobrecarga
Tres cosas determinan la sobrecarga:
- Generación y transferencia de la máscara. La CPU genera la máscara y se transfiere al dispositivo de los logits; cuánto se solapa esto con la pasada hacia delante depende del motor de serving.
- Caché. La mayor parte del trabajo de validez se hace en tiempo de compilación. En ejecución, casi todo son consultas a la caché.
- Implementación en C++. La ruta crítica está en C++, no en Python, y la máscara se aplica a los logits in situ.
Los benchmarks citados indican una sobrecarga baja para sus gramáticas, tokenizers, hardware y cargas de trabajo probados. Esos resultados no establecen una garantía general de latencia ni de throughput.
Implementación práctica con vLLM
El repositorio complementario contiene este código. uv run pytest prueba las comprobaciones de política y de finalización sin un modelo; los pasos del final de esta sección ejecutan el agente completo contra un servidor vLLM.
Los fragmentos siguientes están abreviados a partir de los archivos del repositorio que se nombran en su primera línea. Muestran routing → obtención de contexto → propuesta → aprobación, y usan Pydantic 2 y el cliente Python de OpenAI.
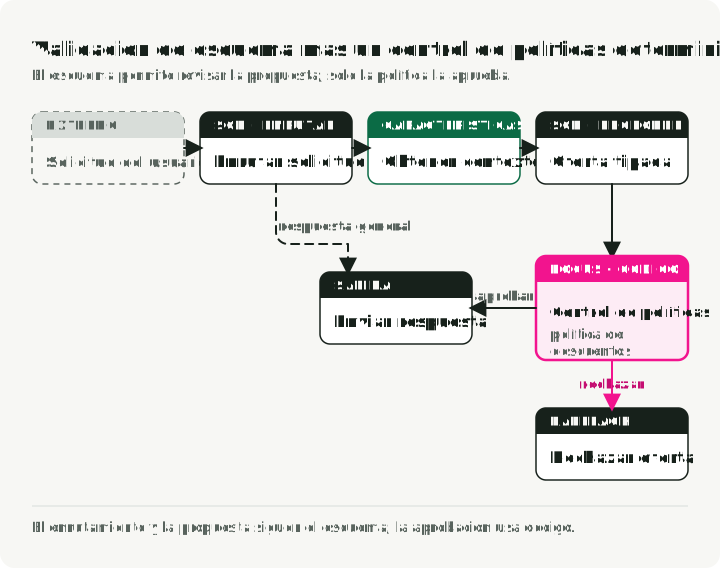
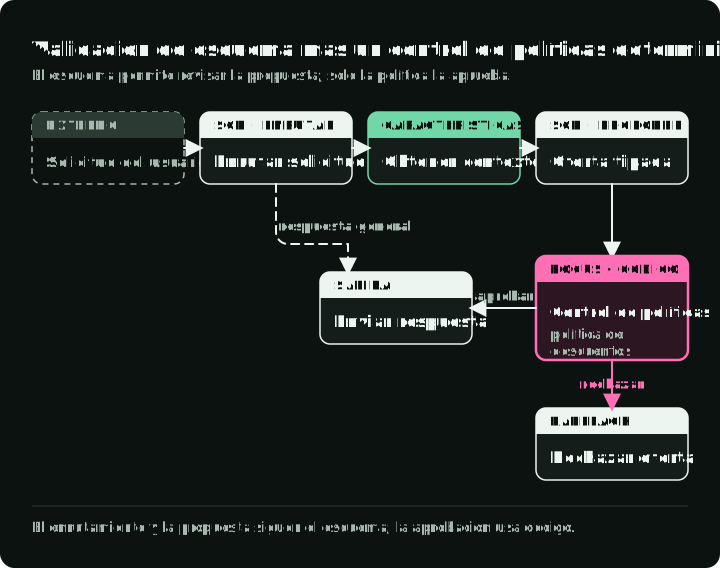
Una solicitud general puede devolver una respuesta de inmediato. Una solicitud de precios necesita los datos del cliente y una propuesta del modelo, seguidas de una comprobación de política de la aplicación antes de poder informar del descuento. Si cualquiera de las dos llamadas al modelo se detiene antes de dar una respuesta completa, la solicitud termina con un error; el paso 2 muestra esa comprobación. El diagrama muestra cada camino posible del agente y la respuesta que devuelve cada uno.
Paso 1: definir los esquemas
sgr/models/schemas.py contiene los dos esquemas mostrados antes. RouterSchema es el router de la sección de Routing: solicita los datos del cliente con FeatureLookup o devuelve texto con GeneralResponse. PricingLogic tiene los cuatro campos de la sección de SGR. La descripción de su campo margin_math da al modelo un ejemplo resuelto del formato: 'Cart $200 * 0.20 Margin = $40'.
El router y el esquema de precios son llamadas separadas. Así, la aplicación puede obtener los datos del cliente antes de pedir una propuesta.
Paso 2: solicitar y validar una respuesta estructurada
El cliente exporta el modelo de Pydantic como JSON Schema, lo añade a un mensaje de sistema existente como guía en el prompt y lo envía como restricción de structured output. XGrammar se configura en el servidor; el cliente aporta el esquema en cada solicitud.
completed_content rechaza las respuestas incompletas, rechazadas o vacías antes de que Pydantic valide el JSON y sus campos. Rechaza las paradas por límite de tokens aunque el texto devuelto se pueda analizar. Estos errores se propagan al llamador, que debe aportar una respuesta de error o una política de reintentos; en esos caminos no se aprueba ninguna oferta.
# sgr/utils/llm_client.py
import json
from typing import TypeVar

from openai import OpenAI
from pydantic import BaseModel

T = TypeVar("T", bound=BaseModel)

def completed_content(completion) -> str:
    """Reject incomplete, refused, or empty results before JSON validation."""
    if not completion.choices:
        raise ValueError("No completion returned")
    choice = completion.choices[0]
    if choice.finish_reason != "stop" or getattr(choice.message, "refusal", None):
        raise ValueError("Completion was not successful")
    content = choice.message.content
    if not isinstance(content, str) or not content.strip():
        raise ValueError("Completion has no content")
    return content

class LLMClient:
    """Wrapper for vLLM with XGrammar-enforced structured generation."""

    def __init__(self, base_url: str = "http://localhost:8000/v1"):
        # Local vLLM commonly has no authentication. EMPTY is not authentication.
        self.client = OpenAI(base_url=base_url, api_key="EMPTY")
        self.model = self._get_available_model()

    def _get_available_model(self) -> str:
        """Auto-detect the model running on vLLM server."""
        models = self.client.models.list()
        if not models.data:
            raise RuntimeError("vLLM reported no available models")
        return models.data[0].id

    def run_sgr(self, messages: list[dict], schema_class: type[T]) -> T:
        """Run inference with Schema-Guided Reasoning constraints.

        Uses vLLM structured outputs to constrain the JSON shape at generation time.
        """
        schema_dict = schema_class.model_json_schema()

        # Enhance system message with schema for model guidance
        enhanced_messages = messages.copy()
        if enhanced_messages and enhanced_messages[0]["role"] == "system":
            schema_json = json.dumps(schema_dict, indent=2)
            enhanced_messages[0] = {
                "role": "system",
                "content": (
                    enhanced_messages[0]["content"]
                    + f"\n\nRespond with JSON matching this schema:\n{schema_json}"
                ),
            }

        # vLLM v0.12+ structured outputs. Configure the backend on the server.
        completion = self.client.chat.completions.create(
            model=self.model,
            messages=enhanced_messages,
            temperature=0.1,  # Reduces sampling variation; it is not deterministic.
            extra_body={"structured_outputs": {"json": schema_dict}},
        )

        return schema_class.model_validate_json(completed_content(completion))
En vLLM v0.12 y posteriores, structured_outputs: {"json": schema_dict} solicita un JSON que coincida con el esquema. Los campos de solicitud anteriores guided_json y guided_decoding_backend se eliminaron en v0.12.0, y ahora el backend se configura en el servidor.
Paso 3: orquestar el agente
La aplicación enruta la solicitud, obtiene los datos del llamador autenticado, pide una propuesta, la comprueba y devuelve el resultado. El feature store usa el user_id autenticado, nunca el ID propuesto por el modelo. El prompt también recibe user_ltv, el valor de vida estimado del cliente; esa estimación da contexto al modelo, pero no fija el límite del descuento.
El esquema garantiza que max_discount_percent es un número. No garantiza que el número esté permitido; eso lo decide approve_discount. approve_discount comprueba primero que las entradas son finitas, que el valor del carrito es positivo y que el margen es una fracción entre 0 y 1. Después, la política de demostración rechaza los porcentajes propuestos fuera del rango 0–20, redondea hacia abajo a centésimas de punto porcentual y rechaza un descuento final que cueste más que el beneficio bruto del carrito.
# sgr/agent.py
from decimal import Decimal, ROUND_DOWN

from .models.schemas import PricingLogic, RouterSchema
from .prompts.routing import build_routing_prompt
from .prompts.pricing import build_pricing_context_prompt, ASSISTANT_FETCH_MESSAGE
from .store.hybrid_store import HybridFeatureStore
from .utils.llm_client import LLMClient

def approve_discount(offer: PricingLogic, context: dict) -> Decimal:
    """Enforce the pricing policy independently of the model's explanation."""
    cart_value = Decimal(str(context["current_cart_value"]))
    margin = Decimal(str(context["cart_profit_margin"]))
    proposed = Decimal(str(offer.max_discount_percent))

    if not all(value.is_finite() for value in (cart_value, margin, proposed)):
        raise ValueError("Pricing values must be finite")
    if cart_value <= 0 or not Decimal("0") <= margin <= Decimal("1"):
        raise ValueError("Invalid pricing context")

    if not Decimal("0") <= proposed <= Decimal("20"):
        raise ValueError("Proposed discount violates pricing policy")
    # Policy rounds down to hundredths of a percentage point before approval.
    approved = proposed.quantize(Decimal("0.01"), rounding=ROUND_DOWN)
    gross_profit = cart_value * margin
    discount_cost = cart_value * approved / Decimal("100")
    policy_cap = min(margin * Decimal("100"), Decimal("20"))
    if not Decimal("0") <= approved <= policy_cap or discount_cost > gross_profit:
        raise ValueError("Proposed discount violates pricing policy")

    return approved

def pricing_agent(user_query: str, user_id: str) -> str:
    """Integrate routing, context, and pricing; user_id is caller-authenticated."""

    llm = LLMClient()
    feature_store = HybridFeatureStore()

    # Build conversation history
    history = [
        {"role": "system", "content": build_routing_prompt(user_id)},
        {"role": "user", "content": user_query},
    ]

    # --- Phase 1: Routing (Uses RouterSchema) ---
    print(f"🤖 Processing: '{user_query}' for {user_id}")
    decision = llm.run_sgr(history, RouterSchema)
    print(f"📍 Routing decision: {decision.action.tool_name}")

    if decision.action.tool_name == "respond":
        return decision.action.content

    # --- Phase 2: Context Retrieval ---
    if decision.action.tool_name == "fetch_user_features":
        print(f"🔍 Fetching features for {user_id}...")
        context = feature_store.get_user_context(user_id)

        if not context:
            return "Error: User profile not found."

        print(f"   [Data] LTV: ${context.get('user_ltv')} | "
              f"Margin: {context.get('cart_profit_margin', 0) * 100}%")

        # Inject context into conversation
        history.append({"role": "assistant", "content": ASSISTANT_FETCH_MESSAGE})
        history.append({
            "role": "user",
            "content": build_pricing_context_prompt(
                churn_prob=context.get("churn_probability", 0.5),
                cart_val=context.get("current_cart_value", 100),
                margin=context.get("cart_profit_margin", 0.2),
                user_ltv=context.get("user_ltv", 0),
            ),
        })

        # --- Phase 3: model proposal, then deterministic policy enforcement ---
        print("🧠 Proposing Offer (Schema Enforced)...")
        offer = llm.run_sgr(history, PricingLogic)
        try:
            approved_discount = approve_discount(offer, context)
        except ValueError:
            return "No discount approved: the proposal failed the pricing policy."

        # Audit log: reasoning is inspectable; pricing is application-enforced.
        print(f"   [Audit] Math: {offer.margin_math}")
        print(f"   [Audit] Approved Discount: {approved_discount}%")

        return (
            f"Illustrative approved discount: {approved_discount}%. "
            "No coupon has been issued."
        )

    return "I'm sorry, I couldn't process your request."

if __name__ == "__main__":
    response = pricing_agent("I want a discount or I'm leaving!", "user_102")
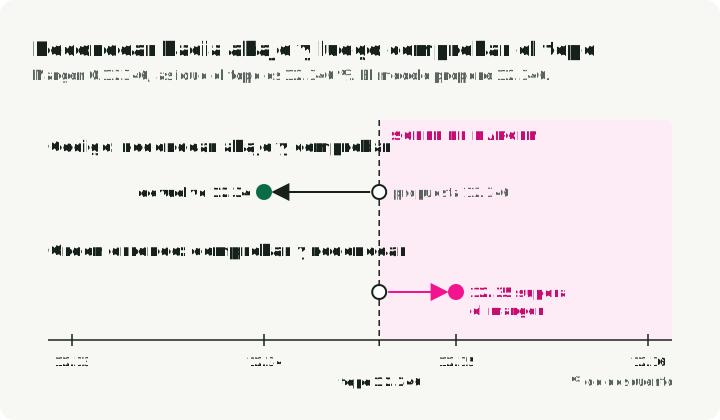
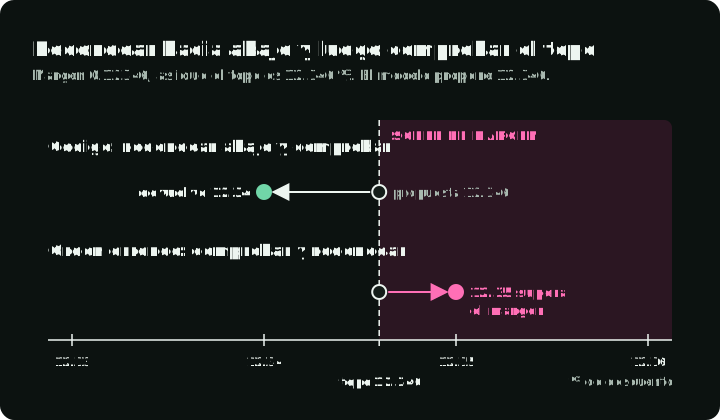
print(f"\n💬 Final Reply: {response}")Una propuesta del 15 % sobre un carrito de $200 con un margen del 20 % devuelve 15.00 desde la función de política. La aplicación informa de ese porcentaje sin fingir que emite un cupón. Una prueba de límite usa un margen de 0.12346, es decir, 12,346 %. Una propuesta de 12.346 se redondea hacia abajo a 12.34 antes de comprobar el valor final. Redondear a 12.35 después de la aprobación superaría el margen.
La recta numérica muestra esa prueba de límite: dónde deja cada orden de redondeo y comprobación el valor devuelto respecto al tope.
approve_discount ejecuta cuatro comprobaciones en orden:
- Las entradas son válidas: valor del carrito mayor que 0, margen entre 0 y 1, sin NaN ni infinito.
- El descuento propuesto está entre 0 y 20.
- Se redondea la propuesta hacia abajo a 0.01 (12.346 pasa a 12.34, no a 12.35).
- El valor redondeado es como máximo el porcentaje de margen (y como máximo 20), y su coste es como máximo el beneficio bruto.
Cualquier comprobación fallida lanza ValueError y la propuesta no recibe descuento. El redondeo va antes del tope, así que el tope comprueba el valor que se devuelve.
Ejecutar la demo
El repositorio ejecuta todo el flujo. La demo necesita Python 3.13 y uv. El servidor vLLM necesita su propio entorno, un acelerador compatible y memoria suficiente para el modelo (guía de instalación); el README del repositorio cubre la instalación y una opción de Docker en CPU para pruebas.
Instala la demo, ejecuta las pruebas sin conexión y crea los datos sintéticos de clientes:
git clone https://github.com/slavadubrov/sgr-discount-manager
cd sgr-discount-manager
uv sync
uv run pytest
uv run python -m scripts.setup_data
Inicia el servidor con XGrammar como backend de structured output:
vllm serve Qwen/Qwen2.5-7B-Instruct \
    --port 8000 \
    --structured-outputs-config.backend xgrammar
El argumento posicional del modelo y la opción del backend siguen la referencia de vllm serve. El cliente se conecta a http://localhost:8000/v1; para un servidor en otro host, cambia DEFAULT_API_BASE_URL en sgr/config/constants.py.
Ejecuta el agente:
uv run python -m sgr.agentLa salida tiene esta forma. Los valores son ilustrativos; dependen de los datos aleatorios de la demo y del modelo:
🤖 Processing: 'I want a discount or I'm leaving!' for user_102
📍 Routing decision: fetch_user_features
🔍 Fetching features for user_102...
   [Data] LTV: $1500.0 | Margin: 20.0%
🧠 Proposing Offer (Schema Enforced)...
   [Audit] Math: Cart $200 * 0.20 Margin = $40
   [Audit] Approved Discount: 15.00%

💬 Final Reply: Illustrative approved discount: 15.00%. No coupon has been issued.
La línea [Audit] Math es el cálculo registrado por el modelo. La línea Approved Discount y la respuesta final proceden de approve_discount y del código de la aplicación, no del modelo.
Comprobaciones antes de una integración real
Diseño del esquema
- Ordena los campos según el flujo de razonamiento previsto.
- Escribe una descripción
Fieldpara cada campo. Pydantic la exporta al JSON Schema, y el cliente anterior añade ese esquema al prompt. - Restringe con
LiteralyAnnotated. UsaLiteral["a", "b"]para enumeraciones yAnnotated[int, Ge(1), Le(10)]para límites. - Mantén los esquemas acotados. Un esquema por fase de razonamiento y, después, compón con varias llamadas.
Configuración de vLLM
- Usa una temperatura baja (0.1-0.3) para reducir la variación del muestreo. Para pruebas repetibles, fija el modelo y la configuración de serving, usa el modo determinista del servidor si lo ofrece y verifica el resultado.
- Explica la tarea y los campos del esquema en el prompt, como hace el cliente anterior. El prompt dice al modelo qué significa cada campo; el decoder solo bloquea los tokens no válidos.
- Mide el uso de tokens con el mismo prompt, modelo, esquema y tarea. SGR puede emitir más o menos tokens que una respuesta CoT libre.
Consideraciones para producción
- Versiona tus esquemas igual que versionas tus APIs.
- Registra por separado la propuesta y la decisión de política para la depuración, sujeto a tus reglas de conservación y ocultación de datos.
- Recalcula precios, límites, permisos y otras reglas semánticas en el código de la aplicación antes de usarlos; prueba los valores límite que el esquema por sí solo no puede rechazar.
La siguiente prueba
Empieza por el límite del descuento y una finalización incompleta. Las pruebas sin conexión del repositorio cubren ambos casos, pero no pueden decirte si un modelo enruta correctamente a un cliente real ni si explica el margen con precisión. Para una evaluación real, mantén fijos el modelo, los prompts, el esquema y la configuración de serving. Cuenta por separado los resultados incompletos, los fallos de esquema, los errores de routing y los rechazos de política antes de comparar costes o precisión de la tarea.
Referencias
Framework de SGR
- Schema-Guided Reasoning (SGR) — el framework original de Rinat Abdullin
- SGR Patterns — patrones Cascade, Routing y Cycle
xgrammar
- XGrammar: Flexible and Efficient Structured Generation Engine for Large Language Models — Yixin Dong et al., arXiv:2411.15100 (artículo técnico con benchmarks)
- xgrammar GitHub — biblioteca rápida y flexible de generación estructurada
- xgrammar Documentation — documentación oficial con guía de inicio rápido
- xgrammar Quick Start — primeros pasos con xgrammar
- Achieving Efficient Structured Generation with XGrammar — entrada del blog de MLC sobre el funcionamiento interno de xgrammar
vLLM
- vLLM Structured Outputs — documentación oficial
Proyecto de demostración
- sgr-discount-manager — demo complementaria: el código de este artículo, pruebas sin conexión y pasos de ejecución