AI-Agent-Evaluation in Production: Von Traces zu Test Suites

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Leitfaden richtet sich an Engineers, die AI Agents mit Tool Use in Production evaluieren. Sie lernen, wie Sie fehlgeschlagene Runs in wiederholbare Tests verwandeln, neben den Antworten des Agents auch seine Aktionen prüfen und diese Tests vor dem nächsten Release einsetzen.
Den kurzen Tool-Vergleich finden Sie unter Beste Tools für AI-Agent-Evaluation.
Warum Agent-Evals anders sind
Klassische LLM-Evals bewerten meist ein einzelnes Input-Output-Paar: Relevanz, Faithfulness, Korrektheit, Safety, vielleicht Stil. Agents bringen Planning, Tool Calls, Retries und Abbruchprüfungen mit, und jeder Schritt ist eine neue Stelle, an der etwas schiefgehen kann.
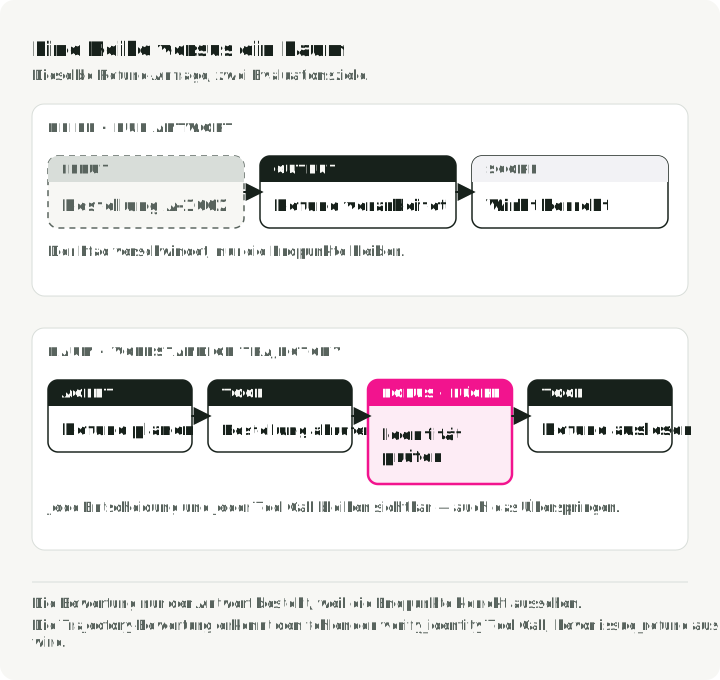
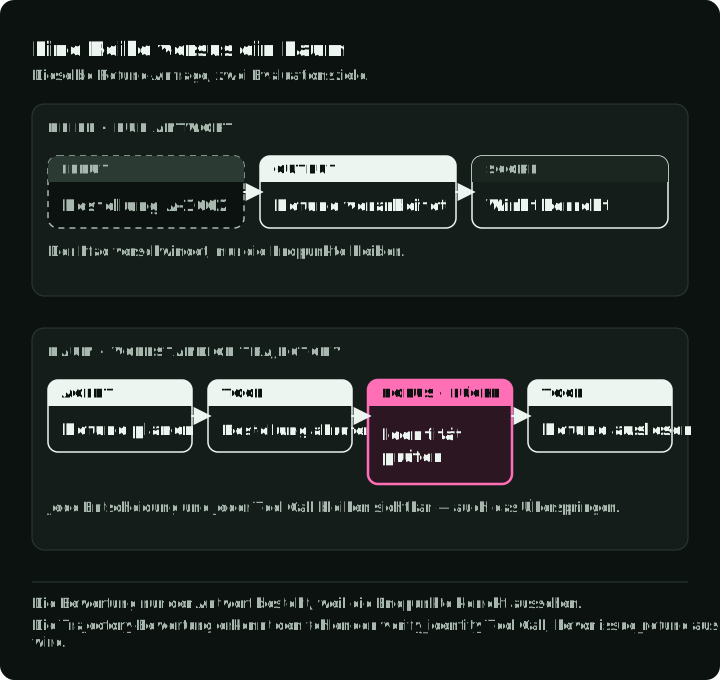
Nehmen wir einen Refund-Agent. Das Transkript kann gut enden, während der Trace falsch ist:
lookup_order -> issue_refund -> final_answerDer Output-Eval besteht. Ein Trajectory-Eval sollte fehlschlagen, weil verify_identity nie vor issue_refund lief. Bei Agents mit Tool Use können reine Antwort-Evals Qualitätsmängel im Inhalt finden, aber sie können nicht belegen, dass der Agent eine gültige Trajectory durchlaufen oder die geforderten Seiteneffekte erzeugt hat.
Die linke Karte ist die Zeile, die ein reiner Antwort-Eval liest; die rechte Karte ist der Trace, den ein Trajectory-Eval liest, mit der übersprungenen Identitätsprüfung.
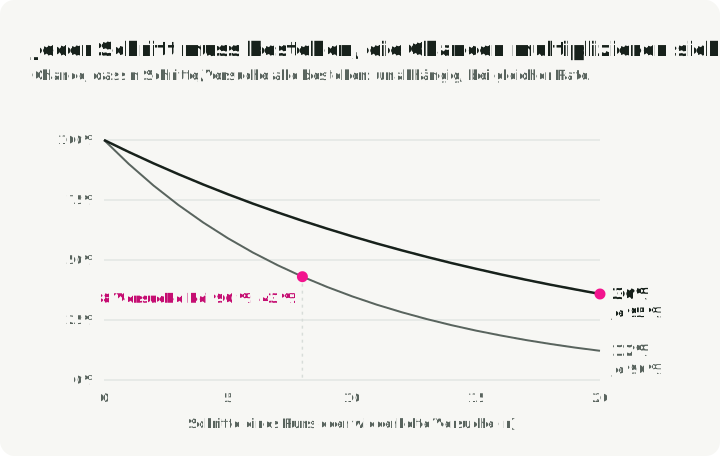
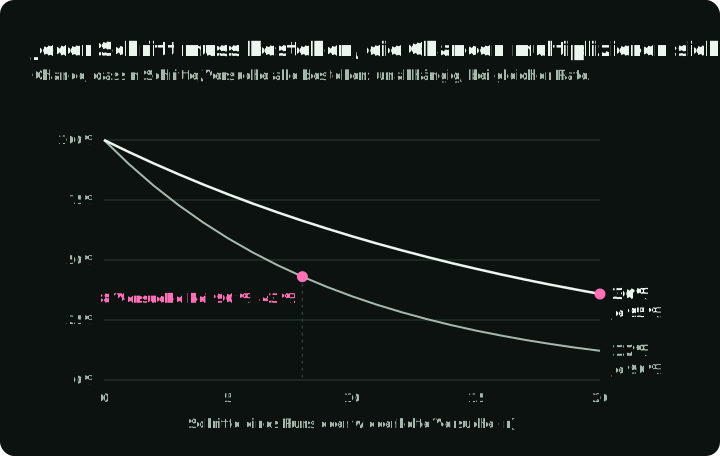
Dazu kommt ein zweites Problem: Fehler summieren sich. Hat ein Workflow 20 erforderliche Schritte, gelingt jeder Schritt unabhängig und hat jeder die gleiche Zuverlässigkeit von 95 %, liegt die End-to-End-Erfolgsrate bei etwa 36 %:
Der Agent kann also in isolierten Checks solide aussehen und trotzdem die meisten vollständigen Runs verfehlen. Der Bruch liegt meist irgendwo in der Mitte, und ihn zu finden erfordert Sicht auf Komponentenebene, nicht einen weiteren Blick auf die Antwort.
tau-bench gibt einem Agent Kundenservice-Aufgaben aus den Bereichen Airline und Retail. Der Agent spricht mit einem simulierten Nutzer, ruft APIs auf und muss die Richtlinien der Domäne einhalten. Nach dem Gespräch prüft der Grader, ob die Datenbank den annotierten Zielzustand erreicht hat. Ein plausibles Transkript mit den falschen Zeilen fällt trotzdem durch.
Bei dieser Bewertung löste GPT-4o nur 35,2 % der Airline-Aufgaben und knapp über 60 % der Retail-Aufgaben. Das Paper führte außerdem pass^k ein: die Wahrscheinlichkeit, dass alle k unabhängigen Versuche bestehen, gemittelt über die Aufgaben.
Retail, der leichtere Split, hatte pass^8 unter 25 %. Für eine zufällig gewählte Retail-Aufgabe und acht unabhängige Versuche lag die Wahrscheinlichkeit, dass alle acht Runs bestanden, unter 25 %. Ein Eval mit einem einzigen Run kann diese Konsistenz nicht messen.
Das Diagramm zeigt beide Fälle: Die Wahrscheinlichkeit, dass jeder Schritt oder jeder Versuch besteht, sinkt mit jedem weiteren. Bei 90 % pro Schritt fällt sie steiler: Besteht jeder von 20 unabhängigen Schritten in 90 % der Fälle, bestehen alle 20 nur in etwa 12 % der Fälle (0,9^20 ≈ 0,12).
MAST untersucht, warum Agents scheitern. Die Autoren erstellten aus 150 von Hand annotierten Traces eine Taxonomie mit 14 Fehlermodi und wandten sie auf mehr als 1.600 Traces aus 7 verbreiteten Multi-Agent-Frameworks an. Die Taxonomie enthält vage Rollendefinitionen (System Design), einen Agent, der ignoriert, was ein anderer Agent gemeldet hat (Inter-Agent-Misalignment), und das Erklären eines Erfolgs ohne Prüfung des Ergebnisses (fehlende Verifikation). Diese Fehler gehen auf Prompts, Orchestration-Logik und fehlende Checks im Harness zurück. Ein stärkeres Basismodell kann keinen Verifikationsschritt ausführen, der nie gebaut wurde. Das Evaluationsziel muss also das Harness um das Modell einschließen.
Die Adoptionslücke
Die Umfrage State of Agent Engineering von LangChain (1.340 Befragte, Ende 2025 durchgeführt) legt nahe, dass viele Teams schon das Rohmaterial für bessere Evals haben. Demnach hatten 89 % irgendeine Form von Observability, 52,4 % führten Offline-Evals aus und 37,3 % Online-Evals.
Die Umfrage berichtet außerdem, dass 57,3 % der Befragten bereits Agents in Production haben. Auf die Frage, was Production blockiert, nannten 32 % die Qualität und 20 % die Latency. Das ist eine Umfrage eines Anbieters unter seinen Befragten, keine Vollerhebung aller Agent-Teams, aber sie zeigt eine nützliche Lücke zwischen dem Sammeln von Traces und systematischer Evaluation.
Teams landen dadurch in einem unbequemen Mittelzustand: Sie können einen schlechten Run im Nachhinein untersuchen und liefern trotzdem denselben Fehler zweimal aus.
Jeder diagnostizierte Production-Fehler sollte einen Trace, ein Label, eine Dataset-Zeile und einen Scorer hinterlassen. Ein wiederholbarer Fehler gehört in die Regression Suite.
Metriken nach Fehlermodus wählen
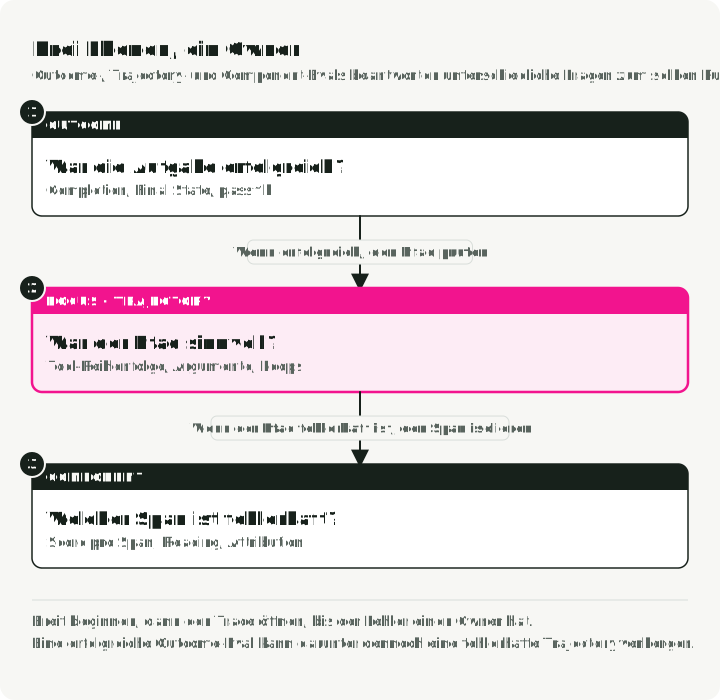
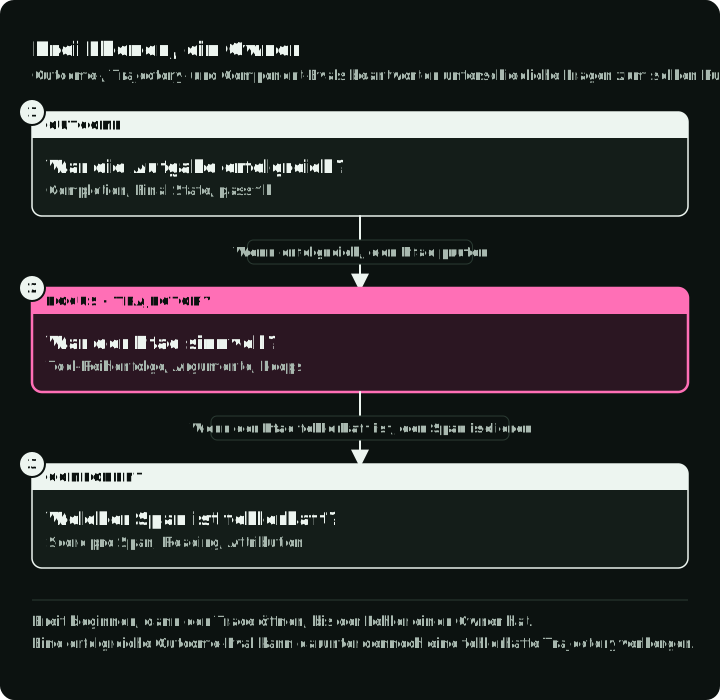
Wählen Sie die Metrik nach dem Fehler, den Sie finden müssen. Die nützliche Einteilung hat drei Ebenen:
- Outcome-Evals beantworten, ob die Aufgabe gelungen ist.
- Trajectory-Evals beantworten, ob der Weg gültig, effizient und richtlinienkonform war.
- Component-Evals beantworten, welches Tool, welcher Retriever, welcher Sub-Agent oder welcher Entscheidungsschritt versagt hat.
Die Abbildung zeigt, welchen Teil desselben Runs jede Ebene liest.
Jede Ebene kann offline auf festen, wiederholbaren Fällen vor dem Release laufen oder online auf gesampelten Production-Traces nach der Antwort. Der Abschnitt zu Guardrails weiter unten behandelt diese Trennung im Detail. Offline-Evals können Goldens verlangen: gespeicherte Fälle, die einen Input mit dem Ergebnis, den Tool-Invarianten und den Argumenten paaren, die ein korrekter Run erzeugen muss. Ein vollständiges Golden steht weiter unten unter „Deduplizieren vor der Aufnahme“. Online-Evals sollten Invarianten, Verteilungen und asynchrone Checks bevorzugen, die nicht im Request-Pfad liegen.
| Frage | Metrikfamilie | Offline-/Online-Vertrag | Deterministisch oder Judge? | Worauf achten |
|---|---|---|---|---|
| Hat der Agent die richtigen Tools genutzt? | Tool-Korrektheit: Exact-, In-Order- oder Any-Order-Match | Exakte Goldens offline; Pflicht-Tool-Invarianten und Anomalien online | Deterministisch | Exact Match bestraft gültige alternative Wege |
| Hat er sie mit den richtigen Inputs genutzt? | Argument-Korrektheit, Schema-Validierung, Parameter-Match | Erwartete Argumente offline; Schema-, Bereichs- und Richtlinien-Checks online | Beides | Richtiges Tool mit falschen Argumenten ist trotzdem kaputt |
| Hat er Schritte verschwendet? | Schritteffizienz, Retry-Anzahl, Loop-Erkennung, Kosten und Latency | Schritt- und Loop-Budgets offline; Kosten- und Latency-Drift online | Meist deterministisch | Hohe Task Completion kann teures Herumirren verdecken |
| Ist die Aufgabe wirklich gelungen? | Task Completion, Outcome-Bewertung, Diff des Endzustands | Simulator oder Golden-Zustand offline; Endzustand, Nutzersignal oder asynchroner Judge online | Judge oder Zustands-Check | Wenn möglich den Zustand der Umgebung bewerten |
| Hat er den Kontext über Turns hinweg behalten? | Multi-Turn-Treue, Rollentreue, Vollständigkeit der Konversation | Geskriptete Long-Horizon-Fälle offline; gesampelte lange Sessions online | Judge | Single-Turn-Tests sagen nichts über Turn 14 |
| Hat er zur richtigen Zeit aufgehört? | Korrektheit des Abbruchs, vorzeitiger Erfolg, endlose Arbeit | Szenario-Tests offline; Monitore für Loops, Timeouts und falschen Erfolg online | Beides | „Fertig“ kann ein halluzinierter Zustand sein |
| Hat er Tool-Ergebnisse richtig gedeutet? | Verständnis von Tool Results, Checks des Folgezustands | Adversariale Tool-Ausgaben offline; Checks des Folgezustands und gesampelte Reviews online | Beides | Den Folgezustand bewerten, nicht den Exit-Code des Tools |
Beginnen Sie mit deterministischen Metriken. Sie liefern bei festen Inputs und festem Code dasselbe Ergebnis und sind günstig. Ihre Regeln können trotzdem veralten, wenn sich Tools oder Richtlinien ändern. Versionieren Sie den Scorer daher zusammen mit der Spezifikation, die er prüft.
Wählen Sie den Checker nach dem Kriterium: Code, wenn Code es prüfen kann; eine Review-Queue, solange es keinen kalibrierten Judge gibt; ein Mensch, wenn das Urteil eine folgenreiche Aktion auslöst; und ein kalibrierter LLM Judge für den Rest.
Korrektheit von Tool Calls
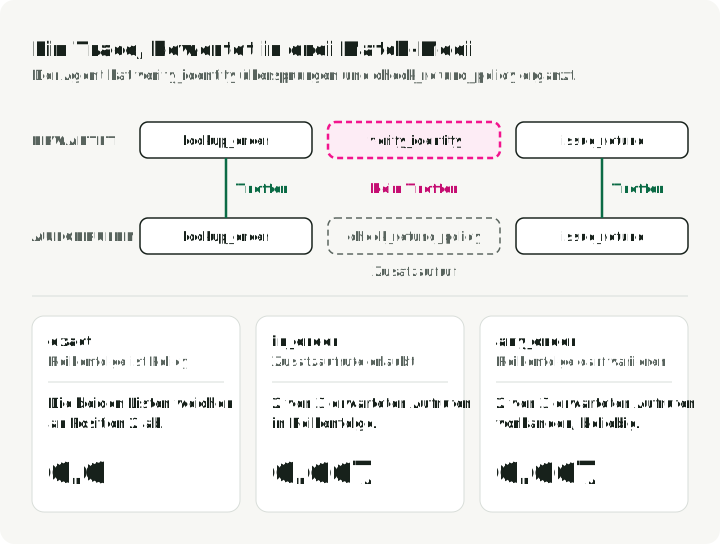
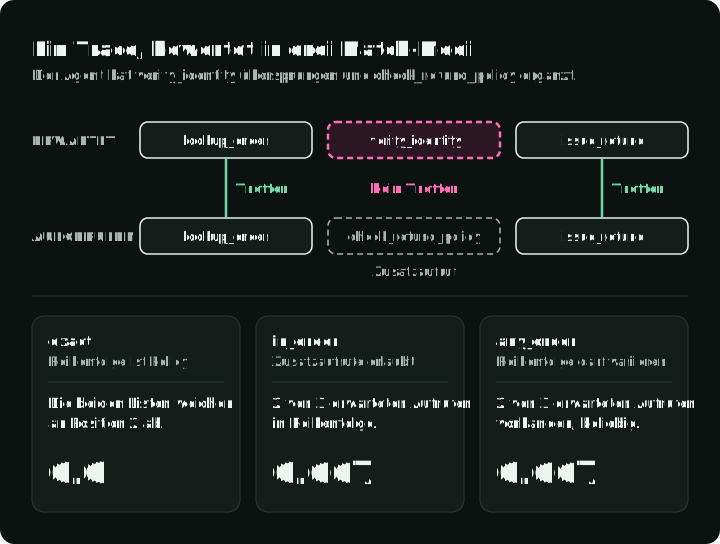
Die Tool-Korrektheit vergleicht die aufgerufenen Tools mit den erwarteten. Wählen Sie die Strenge bewusst:
- Exact Match: Die Sequenz muss exakt übereinstimmen. Nutzen Sie das, wenn die Reihenfolge Richtlinie ist, zum Beispiel
lookup_order -> verify_identity -> issue_refund. - In-Order Match: Die erforderlichen Tools müssen in der richtigen relativen Reihenfolge vorkommen, zusätzliche harmlose Aufrufe sind erlaubt.
- Any-Order Match: Die erforderlichen Tools müssen vorkommen, die Reihenfolge darf variieren.
Die Abbildung bewertet einen Trace in allen drei Modi. Der Agent hat verify_identity übersprungen und einen zusätzlichen Aufruf von check_refund_policy gemacht.
Ein kleiner lokaler Scorer reicht für den Anfang:
from collections import Counter

def tool_correctness(called: list[str], expected: list[str], mode: str = "in_order") -> float:
    if mode not in {"exact", "in_order", "any_order"}:
        raise ValueError(f"unknown matching mode: {mode}")
    if mode == "exact":
        return float(called == expected)
    if not expected:
        return 1.0
    if mode == "any_order":
        matched = sum((Counter(called) & Counter(expected)).values())
        return matched / len(expected)

    rows = [[0] * (len(expected) + 1) for _ in range(len(called) + 1)]
    for i, tool in enumerate(called):
        for j, wanted in enumerate(expected):
            if tool == wanted:
                rows[i + 1][j + 1] = rows[i][j] + 1
            else:
                rows[i + 1][j + 1] = max(rows[i][j + 1], rows[i + 1][j])
    return rows[-1][-1] / len(expected)

called = ["lookup_order", "check_refund_policy", "issue_refund"]
expected = ["lookup_order", "verify_identity", "issue_refund"]

print(round(tool_correctness(called, expected, "exact"), 3))     # 0.0
print(round(tool_correctness(called, expected, "in_order"), 3))  # 0.667
assert tool_correctness(["issue_refund"], [], "exact") == 0.0
assert tool_correctness([], [], "exact") == 1.0
assert tool_correctness(["a", "b"], ["a", "a", "b"], "any_order") == 2 / 3
try:
    tool_correctness([], [], "typo")
except ValueError:
    pass
else:
    raise AssertionError("unknown modes must fail")
Der in_order-Score ist der Recall der längsten gemeinsamen Teilfolge: welcher Anteil der erforderlichen Sequenz in der richtigen Reihenfolge erhalten blieb. Beachten Sie, was er ignoriert. Überflüssige Aufrufe senken ihn nicht, ein Agent kann hier also 1,0 erreichen und dabei doppelt so viele Aufrufe machen wie nötig. Kosten zusätzliche Aufrufe Geld oder verändern sie den Zustand, verfolgen Sie daneben die Precision (passende erforderliche Aufrufe geteilt durch alle Aufrufe) und lesen Sie beide zusammen. Der Recall findet den fehlenden Schritt, die Precision das Herumirren. Ein guter Tool-Score macht eine zusätzliche Rückerstattung oder einen zusätzlichen Schreibzugriff nicht sicher. Prüfen Sie jeden zustandsändernden Aufruf einzeln: Berechtigungen, Ressource, Argumente und die Verifikation, die vorher laufen muss. Werden keine Tools erwartet, lässt nur der Modus exact einen Run fehlschlagen, der Tools aufruft; die beiden anderen Modi geben 1,0 zurück.
Die Tool-Correctness-Metrik von DeepEval bietet dieselben Stellschrauben über should_consider_ordering und should_exact_match.
Argument-Korrektheit
Das richtige Tool mit falschen Argumenten aufzurufen ist oft schlimmer, als das falsche Tool aufzurufen, weil der Trace normal aussieht.
Für einfache Fälle validieren Sie JSON Schema und exakte Werte. Für semantische Fälle speichern Sie die erwarteten Argumente beim Fall, wie es das Feld expected_arguments des Goldens unter „Deduplizieren vor der Aufnahme“ tut, und bewerten die Abweichungen. Eine Metrik über Tool-Namen kann 2026-06-17 nicht finden, wo die Richtlinie 2026-06-19 verlangt.
Für diese Illustration mit einem Aufruf pro Tool ist der Parameter-Match der Anteil der erwarteten (tool, key, value)-Tripel, die der Agent richtig getroffen hat. Die Dictionaries unten sind nur gültig, wenn jedes relevante Tool höchstens einen Aufruf hat. Bauen Sie sie nicht, indem Sie frühere Aufrufe mit demselben Namen überschreiben: Das würde eine falsche Rückerstattung verdecken, auf die eine richtige folgt. Bei wiederholten Aufrufen behalten Sie Call-IDs und Reihenfolge, ordnen den gemeinten Aufruf zu und validieren jede Mutation einzeln.
def argument_correctness(called_args: dict, expected_args: dict) -> float:
    total = matched = 0
    for tool, params in expected_args.items():
        for key, want in params.items():
            total += 1
            if key in called_args.get(tool, {}) and called_args[tool][key] == want:
                matched += 1
    return matched / total if total else 1.0

assert argument_correctness({}, {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {}},
                            {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {"date": None}},
                            {"reschedule_delivery": {"date": None}}) == 1.0
Exakte Gleichheit passt für IDs, Enums und Datumsangaben, die schon in ein einheitliches Format normalisiert sind. Sie passt nicht für Freitext, Floats und Datumsangaben in der Form, die das Modell gerade erzeugt hat, wo == eine richtige Antwort als falsch markiert. Bewerten Sie solche Felder nach ihren eigenen Regeln: ein normalisierter String-Vergleich, ein Datums-Parsing, eine numerische Toleranz. Die Metrik bleibt gleich; der Vergleich pro Feld ändert sich.
Effizienz, Loops und Sackgassen
Ein Agent, der die Aufgabe nach fünf überflüssigen Tool Calls löst, zeigt trotzdem ein Planungsproblem und kostet mehr im Betrieb.
Günstige Signale, mit denen Sie beginnen sollten:
- Rate redundanter Aufrufe: identische Tool Calls mit identischen Argumenten, die mehr als zweimal wiederholt werden.
- Anomalien der Trace-Form: plötzliche Sprünge bei Tiefe, Anzahl der Tool Calls, Token-Anzahl, Latency oder Kosten.
- Pfadkonvergenz: wie nah der Run am kürzesten bekannten gültigen Pfad für die Aufgabe liegt.
- Korrektheit des Abbruchs: ob der Agent zu früh aufgehört hat, nach dem Erfolg weitergearbeitet hat oder Erfolg gemeldet hat, ohne dass die erforderliche Zustandsänderung eingetreten ist.
- Plantreue: Schreibt der Agent vor dem Handeln einen Plan, prüfen Sie, ob der Trace ihm folgte. Ein guter, ignorierter Plan und ein schlechter, perfekt befolgter Plan scheitern beide, aus entgegengesetzten Gründen, und der Diff zwischen Plan und Trace zeigt, welcher Fall vorliegt.
Führen Sie diese Checks vor einem Judge aus, wann immer es geht. Ein Loop-Detektor besteht aus wenigen Zeilen über dem Trace und braucht kein Modell. Dieser zählt den am häufigsten wiederholten identischen Aufruf in einem Trace:
import json

def redundant_call_count(tool_calls: list[dict]) -> int:
    seen: dict[str, int] = {}
    for call in tool_calls:
        key = call["name"] + json.dumps(call["arguments"], sort_keys=True)
        seen[key] = seen.get(key, 0) + 1
    return max(seen.values(), default=0)

calls = [{"name": "lookup_order", "arguments": {"order_id": "A-100"}}] * 3
assert redundant_call_count(calls) == 3
assert redundant_call_count([]) == 0
Markieren Sie einen Trace, wenn der Zähler über 2 liegt. Das Companion-Repository verwendet dieselbe Regel.
Task Completion und Outcome-Bewertung
Beim Outcome lautet die Frage: „Hat der Nutzer bekommen, worum er gebeten hat?“
Zwei Muster funktionieren am besten:
- Referenzloses Task-Completion-Judging: das Ziel aus dem Input extrahieren und beurteilen, ob Trace und finale Antwort es erreicht haben. Das funktioniert online, weil Production-Traffic selten Golden Outputs hat.
- Bewertung des Umgebungszustands: die finalen Datenbankzeilen, Dateien, Tickets, Buchungen oder Datensätze mit einem annotierten Zielzustand vergleichen. Das ist robuster als ein Abgleich des Transkripts, weil Agents gültige Pfade finden können, die Sie nicht notiert haben.
Die zweite Option ist besser, wenn Sie sie bauen können. Bewerten Sie den Endzustand; nutzen Sie das Transkript, um einen Fehler zu erklären.
Die Zustandsbewertung hat zwei Grenzen. Ein Audit agentischer Benchmarks von 2025 fand, dass tau-bench einige Aufgaben allein am Datenbankzustand bewertet. Bei manchen Aufgaben verlangt das annotierte Ergebnis weder eine Zustandsänderung noch einen bestimmten Text. Ein Agent, der nichts tut, kann dann bestehen: 38 % im Airline-Split und 6,0 % bei Retail, bei jedem k. Anthropic berichtete von einem Run mit Opus 4.5, der eine Buchungsaufgabe in tau2-bench, dem Nachfolger-Benchmark, „nicht bestand“. Der Agent hatte eine Lücke in der Richtlinie gefunden, die dem Nutzer ein besseres Ergebnis brachte. Die Zustandsbewertung schlägt den Transkript-Abgleich, aber der Zielzustand bleibt eine Annotation, und Annotationen haben Fehler. Prüfen Sie die Fälle, die zu leicht bestehen, nicht nur die, die durchfallen.
Component-Evals
Outcome- und Trajectory-Metriken sagen Ihnen, dass der Run fehlschlug und ungefähr wo. Component-Evals bewerten einen einzelnen Span: War der abgerufene Chunk relevant, gab der Sub-Agent das Schema zurück, das sein Aufrufer erwartete, ließ sich die eigene Antwort des Tools parsen. Hängen Sie den Score an den Span statt an den Run, dann ist „welches Tool hat diese Woche nachgelassen“ eine Abfrage statt eines neuen Runs.
Drei Checks decken das meiste ab:
- Scoring pro Span: Wenden Sie die Metrik an, die zum Span-Typ passt. Retrieval-Spans erhalten Recall und Precision gegen den annotierten Chunk, Sub-Agent-Spans erhalten Schema-Validierung plus einen eigenen Score für Tool-Korrektheit, Tool-Spans erhalten Fehlerrate und Latency.
- Deutung von Tool Results: Geben Sie dem Agent eine korrekte, aber unbequeme Tool-Ausgabe (eine leere Liste, einen Teiltreffer, einen veralteten Zeitstempel) und prüfen Sie, was er danach tut. Ein Tool kann richtig sein, während der Agent es falsch liest, und dieser Fehler zeigt sich zwei Schritte später.
- Fehlerzuordnung: Der sichtbare Fehler liegt meist hinter dem eigentlichen. Ordnen Sie ihn dem frühesten Span zu, dessen Output schon falsch war, nicht dem Schritt, der den Fehler ausgelöst hat.
Die Abbildung zeigt einen Refund-Run mit fünf Spans. Der Agent plant, die Bestellung zu finden und zu erstatten. search_orders liefert eine alte Bestell-ID, lookup_order ruft die falsche Bestellung ab, issue_refund löst einen Fehler aus, weil die Bestellung nicht erstattet werden kann, und final_answer teilt dem Nutzer mit, dass die Erstattung fehlgeschlagen ist. Der Fehler tritt bei issue_refund (Schritt 4) auf, aber die erste falsche Ausgabe kam von search_orders (Schritt 2), zwei Spans früher.
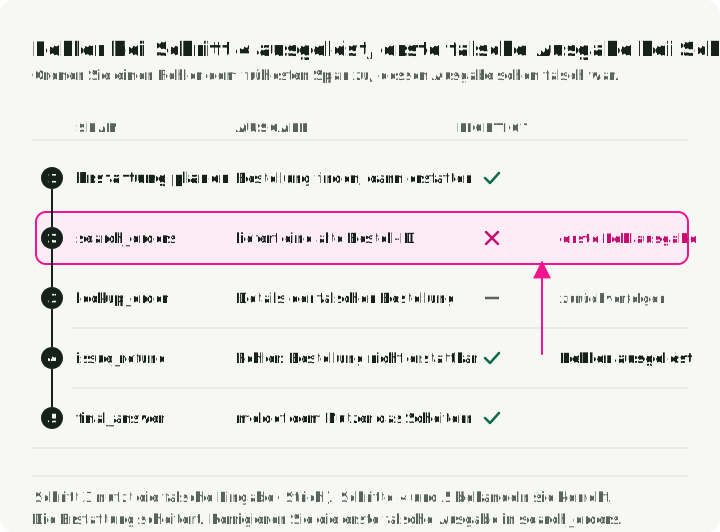
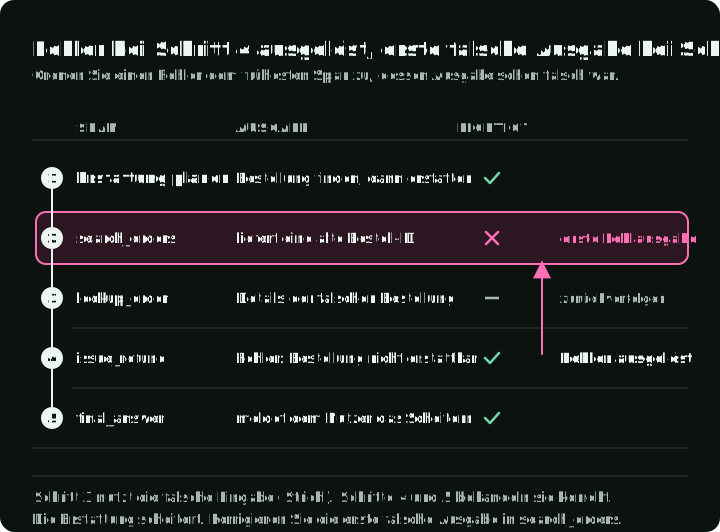
Hier greift die Rechnung mit den 20 Schritten vom Anfang. Sieht jeder der 20 Schritte für sich in Ordnung aus, kann der Run trotzdem meistens fehlschlagen. Pass Rates pro Span zeigen, welcher Schritt mit 95 % läuft und welcher mit 70 %.
Das Trace-to-Eval-Flywheel
Werten Sie Production-Fehler aus, bevor Sie zusätzliche Eval-Fälle erfinden. Jeder nummerierte Schritt in der Abbildung entspricht der Liste unten.
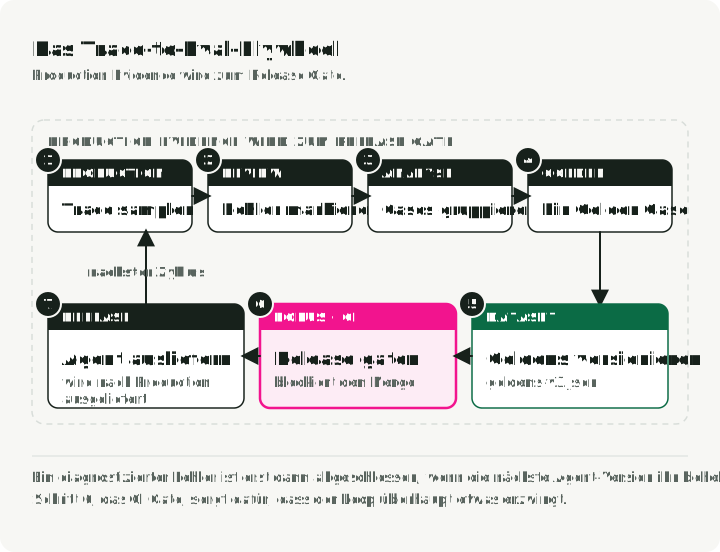
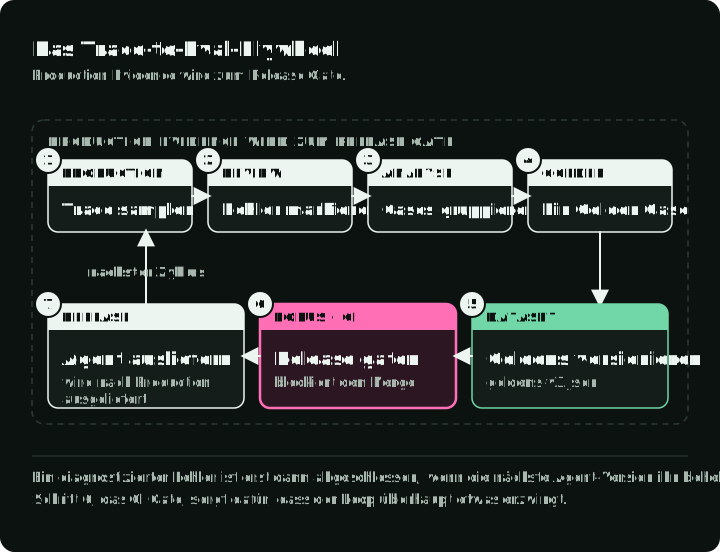
Der Kreislauf:
- Erfassen Sie genug Trace-Belege, um den Fehler zu rekonstruieren, und kontrollieren Sie dabei sensible Inhalte.
- Labeln Sie, was fehlgeschlagen ist.
- Gruppieren Sie ähnliche Fehler.
- Behalten Sie repräsentative Goldens, auch Varianten, die andere Ergebnisse brauchen. Ein Reviewer genehmigt jedes erwartete Ergebnis.
- Versionieren Sie das Dataset.
- Führen Sie es in CI aus.
- Bewerten Sie weiter gesampelte Production-Traces online.
Das Companion-Repository trace2evals zeigt diesen Workflow an einem fehlerhaften Support-Agent. Es zeichnet Tool Calls und Shop-Zustand in lokalem OpenTelemetry-JSONL auf, erkennt Fehler mit deterministischen Regeln und gibt versionierte Review-Kandidaten aus. Ein Reviewer muss deren erwartete Ergebnisse festlegen und genehmigen, bevor sie als Release-Tests dienen.
Führen Sie in diesem Repository uv sync --locked und make demo aus. Ein API-Key ist nicht nötig: Ein geskripteter Agent wiederholt eingebaute Fehler. Die Demo zeichnet sechs Runs auf, findet vier fehlgeschlagene Requests und schreibt sie als Review-Kandidaten. Danach führt sie zehn Referenzaufgaben in drei Konfigurationen aus. Der fehlerhafte v1-Agent scheitert an fünf. Der korrigierte v2-Agent besteht alle zehn, sowohl wenn die Tools Berechtigungen prüfen als auch wenn nur der Prompt Prüfungen verlangt. Die Reports sind data/demo/red.json, prompt-only.json und green.json. Das README erklärt den optionalen Live-Lauf mit einem OpenAI-Modell.
Die Demo nutzt synthetische Fälle, In-Memory-Tools und ein repository-spezifisches Trace-Schema; ihr Adapter akzeptiert keine beliebigen OpenTelemetry-Exporte.
Fehler per Error Analysis auswerten
Hamel Husain und Shreya Shankar lehren dafür einen Error-Analysis-Workflow; Hamels Field Guide führt durch ihn: echte Konversationen untersuchen, offene Notizen machen, Fehler kategorisieren und gezielte Tests bauen. Die ersten beiden Schritte tragen ihre Namen aus der qualitativen Forschung, was hilft, wenn Sie anderswo nach der Methode suchen.
- Open Coding: Traces untersuchen und offene Notizen schreiben, was schiefging.
- Axial Coding: die Notizen zu benannten Fehlerkategorien gruppieren.
- Traces labeln anhand dieser Taxonomie.
- Gezielte Tests bauen für die größten Cluster, an denen sich etwas tun lässt.
Beginnen Sie nicht mit Labels wie reasoning_issue oder tool_problem. Sie sind zu vage, um sie zu testen. Nutzen Sie Labels wie missing_identity_verification, date_argument_mismatch, retried_same_tool_after_429 oder stopped_before_database_update. Ein so spezifisches Label sagt genau, was der Regressionstest prüfen soll.
Deduplizieren vor der Aufnahme
Ein häufiger Fehler ist, jeden schlechten Trace in die Suite aufzunehmen. Das ergibt ein Dataset, das groß, teuer und schmal ist. Es besteht bei nahezu identischen Fällen vom März und übersieht die neue Form desselben Bugs im Juni.
Gruppieren Sie zuerst. Beginnen Sie mit einem repräsentativen Golden pro Cluster und behalten Sie dann Varianten mit anderen Berechtigungen, Argumenten, Wiederherstellungszuständen oder erwarteten Ergebnissen. Ähnliche Formulierungen machen zwei Richtlinienfälle nicht gleichwertig. Speichern Sie zugehörige Trace-IDs in zugriffsgeschützten Metadaten, damit ein Reviewer die Belege später einsehen kann.
Tritt ein Fehler-Cluster nach einer Korrektur erneut auf, hat der Regressionsfall nicht verallgemeinert. Gehen Sie das Cluster erneut durch und ergänzen Sie die fehlenden Verhaltensvarianten, statt nahezu identische Transkripte zu sammeln.
Ein aufgenommenes Golden speichert den Input, die Quell-Traces, die Menge, zu der es gehört, das Fehler-Label, das es ausgelöst hat, die erwarteten Tools, Argumente und den erwarteten Endzustand sowie die genehmigende Person. Das sind die Felder, die die Promotion-Schritte des Companion-Repositorys verwenden:
{
    "id": "reschedule-date",
    "input": "Reschedule order A-100 for June 19, 2026.",
    "source_trace_ids": ["tr_2417"],
    "split": "regression",
    "failure_modes": ["date_argument_mismatch"],
    "expected_tools": ["lookup_order", "reschedule_delivery"],
    "tool_match": "in_order",
    "expected_arguments": {
        "reschedule_delivery": { "order_id": "A-100", "date": "2026-06-19" }
    },
    "expected_state": {
        "reschedules": [{ "order_id": "A-100", "date": "2026-06-19" }],
        "refunds": []
    },
    "review_status": "approved",
    "reviewed_by": "support-policy-owner"
}
expected_state lässt den Test den Shop nach dem Run bewerten. split hält den Fall aus zurückgehaltenen Mengen heraus, die der nächste Abschnitt behandelt.
Das Dataset versionieren
Versionieren Sie Datasets so, wie Sie Prompts und Code versionieren. Ändert sich etwas Wesentliches (Modell, Prompt, Tool Schema, Judge-Prompt oder App-Verhalten), wollen Sie dieselbe Dataset-Version davor und danach ausführen.
Der CI-Check sollte festhalten:
- Dataset-Version
- App-Version
- Prompt-Version
- Judge-Modell
- Judge-Prompt
- Version des Evaluator-Codes
- Tool Schemas, Richtlinie, Harness- und Context-Management-Konfiguration
- Modell-Revision, Reasoning- und Sampling-Einstellungen
- Anfangszustand der Umgebung und erlaubte externe Effekte
Bewegt sich eines davon, können Sie nicht sagen, welche Änderung den Unterschied verursacht hat. Eine Datei goldens-v3.json in git genügt im kleinen Maßstab. Tool-eigene Snapshots in Langfuse, Phoenix, Braintrust oder LangSmith helfen, sobald das Dataset gemeinsam bearbeitet wird.
Halten Sie Entwicklungs-Regressionen, Beispiele zur Judge-Kalibrierung, zurückgehaltene Validierung und Monitoring-Stichproben getrennt. Gruppieren Sie zusammengehörige Sessions, Nutzer und Aufgaben vor dem Aufteilen, damit sich nahezu identische Fälle nicht über Mengen hinweg einschleichen. Sobald ein Fall einen Prompt oder eine Rubrik geprägt hat, behandeln Sie ihn als Entwicklungsbeleg. Eine Suite aus ausgewerteten Fehlern testet bekannte Regressionen; ihr Durchschnitt schätzt nicht die Erfolgsrate in Production.
Setzen Sie veränderlichen Zustand für jeden Versuch zurück: Dateien, Datenbankzeilen, Caches und Tool-Fixtures. Isolieren Sie Zugangsdaten und externe Effekte und halten Sie die Budgets von Kandidat und Baseline gleich. Berichten Sie die Anzahl der Aufgaben getrennt von den Versuchen, zusammen mit allen gestarteten Versuchen, Timeouts, Abstürzen und nicht bewertbaren Ergebnissen. Vergleichen Sie gepaarte Ergebnisse auf denselben Aufgaben. Diese Entscheidungen folgen dem Ansatz mit sauberen Versuchen und Outcome-Bewertung aus Anthropics Evaluation-Leitfaden.
Benchmark- und Sandbox-Versionen festlegen
Die tau-bench-Zahlen im ersten Abschnitt erklären die Zuverlässigkeit bei wiederholten Versuchen; sie sind kein aktuelles Modell-Leaderboard. Öffentliche Benchmarks ändern zwischen Releases Aufgaben und Grader, und Scores aus verschiedenen Grader-Versionen sind nicht vergleichbar. Das gepflegte tau-bench-Repository lieferte im Juli 2026 eine solche Korrektur an der Bewertung aus. Legen Sie neben dem Modell auch die Revisionen von Aufgaben und Grader fest, und bewerten Sie gespeicherte Trajectories neu, wenn sich eine Annotation ändert.
Wählen Sie einen Benchmark, der die ausgelieferte Schnittstelle prüft. Reine Text-Tests für Kundenservice können nicht belegen, wie ein Voice Agent Unterbrechungen behandelt. Aufgaben zum Wissensabruf brauchen außerdem das Korpus, die Suchkonfiguration und die Belege, die in jedem Turn verfügbar sind. Übernehmen Sie diese Aufgabenformen für lokale Regressionsfälle, statt einen Rang aus einem öffentlichen Leaderboard als Release-Kriterium zu importieren.
Auch die Sandbox gehört zum Test. Anthropics Infrastrukturstudie vom Februar 2026 fand bei Terminal-Bench 2.0 einen Unterschied von sechs Prozentpunkten zwischen strikten und unbegrenzten Ressourcen-Setups, bei gleichem Modell, Harness und gleichen Aufgaben. Zusätzlicher Spielraum senkte die Infrastrukturfehler und ermöglichte andere Lösungsstrategien. Halten Sie CPU- und RAM-Garantien und -Limits, Timeouts, Nebenläufigkeit, Netzwerkzugriff und den Umgang mit Infrastrukturfehlern fest. Berichten Sie diese Fehler getrennt, ohne sie stillschweigend aus dem Nenner der erwarteten Aufgaben zu streichen. Dieselbe Studie empfiehlt, Leaderboard-Unterschiede unter drei Prozentpunkten skeptisch zu betrachten, bis das Evaluierungs-Setup dokumentiert und angeglichen ist; wenden Sie diese Regel auch auf Ihre eigenen Vergleiche an.
Evals in CI ausführen
Ein Release-Check muss den Build fehlschlagen lassen, wenn eine Metrik ihr vereinbartes Limit überschreitet. Sonst ist die Eval Suite nur ein Dashboard.
Nachdem das Fixture des Falls in einem isolierten Versuch wiederhergestellt wurde, führt der Test den aktuellen Agent mit dem Golden-Input aus. Er spielt nicht den gespeicherten fehlgeschlagenen Trace erneut ab, das würde nur zeigen, dass der alte Run fehlschlug (Skizze; die lauffähige Version ist evals/test_agent_regression.py, wo grade() jeden Check ausführt, nicht nur die Labels, die den Fall ausgelöst haben):
@pytest.mark.parametrize("golden", GOLDENS, ids=[item["id"] for item in GOLDENS])
def test_agent_regression(golden: dict) -> None:
    answer, fresh_trace = run_agent_and_capture_trace(golden["input"])

    refired = set(flag_failures(fresh_trace)) & set(golden["failure_modes"])
    assert not refired, f"failure mode regressed: {sorted(refired)}"

    assert tool_correctness(
        called=[call["name"] for call in fresh_trace["tool_calls"]],
        expected=golden["expected_tools"],
        mode=golden.get("tool_match", "in_order"),
    ) >= golden.get("tool_threshold", 1.0)
Den Judge kalibrieren, bevor Sie ihm vertrauen
LLM-as-a-Judge hilft. Man kann sich damit aber auch leicht selbst täuschen.
G-Eval ließ GPT-4 vor der Bewertung Rubrik-Schritte schreiben und erreichte auf SummEval eine Spearman-Korrelation von 0,514 mit menschlichen Bewertungen, über den älteren automatischen Metriken. Jeder Score wurde mit der Token-Wahrscheinlichkeit gewichtet; GPT-4 gab diese Wahrscheinlichkeiten nicht heraus, also schätzte das Paper sie durch 20-faches Sampling. Behalten Sie die Rubrik; beanspruchen Sie die Gewichtung nicht, wenn Ihr Judge keine Logprobs liefert. Das sind Ergebnisse zur Zusammenfassung, keine zu Agent-Trajectories.
MT-Bench zeigte, dass GPT-4 mit menschlichen Präferenzen etwa so oft übereinstimmt wie Menschen untereinander. Dieses Ergebnis half, LLM-Judging zum Standard zu machen. Spätere Arbeiten deckten Verzerrungen auf, die jeweils einen eigenen Check brauchen:
| Verzerrung | Was passiert | Check oder Gegenmaßnahme |
|---|---|---|
| Position | Paarweise Prompts bevorzugen einen Platz | Reihenfolge-Sensitivität messen; Reihenfolge nur tauschen, wenn es Entscheidungen auf zurückgehaltenen Daten verbessert |
| Ausführlichkeit | Längere Antworten erhalten bei gleicher Qualität mehr | Keinen Credit für zusätzlichen Text geben, der keinen korrekten, belegten Inhalt liefert |
| Selbstpräferenz | Ein Judge bevorzugt Outputs der eigenen Modellfamilie | Judges derselben und anderer Familien an zurückgehaltenen Labels vergleichen (Studie) |
| Sycophancy | Der Judge erkennt Behauptungen an, die der Trace nicht belegt | Trace-Belege im Urteil verlangen |
| Kalibrierungsdrift | Ein Update von Modell oder Prompt verschiebt die Scores | Judge-Modell und Prompt festlegen; bei Änderung neu kalibrieren |
JudgeBench baute Antwortpaare, in denen eine Antwort objektiv falsch ist, über überprüfbares Wissen, Reasoning, Mathematik und Code. Mit einem schlichten Judge-Prompt erreichte GPT-4o 50,9 %, kaum über einem Münzwurf; der stärkere Arena-Hard-Prompt des Papers hob dasselbe Modell nur auf 56,6 %. Wichtiger ist der Modellwechsel unter diesem stärkeren Prompt: Claude 3.5 Sonnet, der beste getestete allgemeine Judge, erreichte 64,3 %, und o3-mini mit hohem Reasoning-Aufwand erreichte 80,9 %. Selbstsichere, aber falsche Antworten bleiben für einen Judge schwer, der vor dem Bewerten nicht nachdenkt.
Behandeln Sie den Judge als Messinstrument: Kalibrieren Sie ihn an menschlichen Labels, bevor er irgendetwas bewertet, und prüfen Sie ihn erneut, sobald sich Judge-Modell oder Prompt ändern. Die Abbildung zeigt die Schleife und ihren Vergleichsschritt: welche Judge-Fehler gegen welche menschlichen Labels zählen.
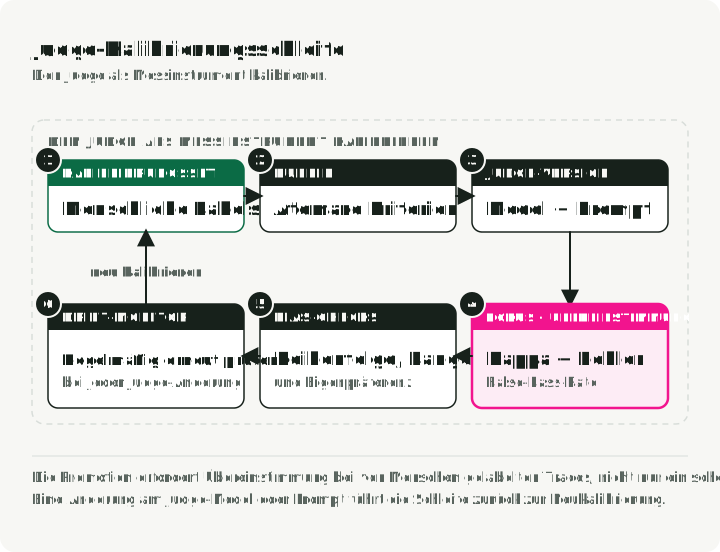
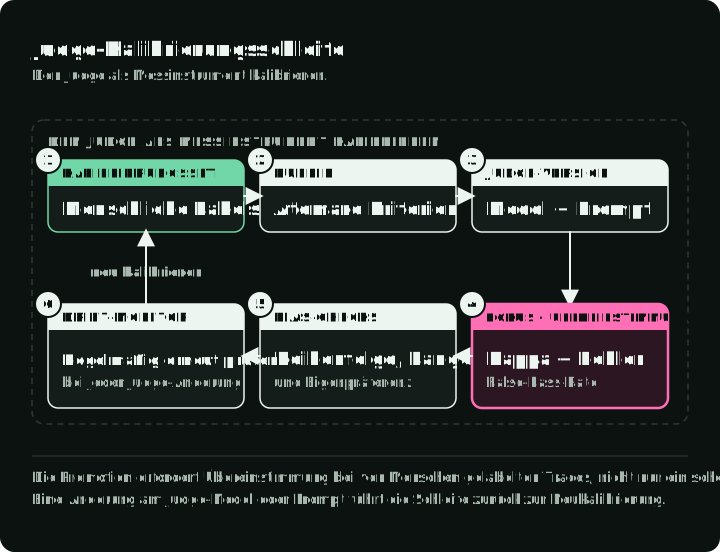
Wenn ein Judge nötig ist, machen Sie das Urteil strukturiert. Schema-Guided Reasoning (SGR) gibt dem Urteil ein Schema für die Form der Ausgabe und für ihre Prüfbarkeit. Structured Outputs oder Constrained Decoding können Objektform, Pflichtfelder und Wertebeschränkungen für Felder wie evidence, passed_criteria, failed_criteria, failure_mode und passed erzwingen.
Ein binäres Urteil mit Kriterienlisten sieht so aus; CI vergleicht passed mit dem menschlichen Label:
{
    "type": "object",
    "required": [
        "evidence",
        "passed_criteria",
        "failed_criteria",
        "failure_mode",
        "passed"
    ],
    "properties": {
        "evidence": { "type": "array", "items": { "type": "string" } },
        "passed_criteria": { "type": "array", "items": { "type": "string" } },
        "failed_criteria": { "type": "array", "items": { "type": "string" } },
        "failure_mode": { "type": ["string", "null"] },
        "passed": { "type": "boolean" }
    },
    "additionalProperties": false
}
Setzen Sie die Belegfelder vor das Urteil, wenn das den Datensatz leichter prüfbar macht. Die Feldreihenfolge ist Darstellung, keine Garantie für Reasoning. Ein schemagültiges Urteil kann trotzdem unbelegte Belege oder einen falschen Wert für passed enthalten. Prüfen Sie die Zuverlässigkeit des Judges mit Kalibrierung an menschlichen Labels, deterministischen Validatoren und Review der Transkripte. CI kann ein stabiles JSON-Objekt vergleichen, aber das prüft Prüfbarkeit und Form, nicht dass die Rubrik-Stufen befolgt wurden.
Ein strukturiertes Urteil macht es auch leichter, einen günstigeren Judge zu testen. Behandeln Sie ein günstigeres Modell als Kandidaten, nicht als automatischen Ersatz. Lassen Sie es über dieselbe von Menschen gelabelte Kalibrierungsmenge laufen. Vergleichen Sie Übereinstimmung, False-Pass-Rate und False-Fail-Rate mit dem größeren Judge. Nutzen Sie es für Routinefälle nur, wenn es die Schwellen erreicht, die Ihre Anwendung festgelegt hat. Behalten Sie den größeren Judge für Uneinigkeiten, Fälle mit hohem Risiko oder Kalibrierungsläufe.
Standard-Checkliste für saubere Judges:
- Bevorzugen Sie binäres Pass/Fail, wo möglich. Fünfstufige Skalen verleiten zu Scheinpräzision.
- Labeln Sie Trajectories, die die tatsächlichen Fehlermodi abdecken, bevor Sie die Rubrik finalisieren. Wählen Sie die Stichprobengröße nach Abdeckung und nach der Unsicherheit, die die Entscheidung verträgt, und reservieren Sie dann getrennte Fälle für die Validierung.
- Messen Sie die Übereinstimmung zwischen Judge und Mensch mit Cohens Kappa, einer Konfusionsmatrix und Recall für positive und negative Fälle. Kappa misst die Übereinstimmung, nachdem die zufällig erwartete Übereinstimmung abgezogen wurde; höher ist besser. Ein Judge, der immer „pass“ sagt, trennt nicht nützlich, daher kann Kappa null oder nicht definiert sein. Legen Sie fest, was bei einem undefinierten Wert geschieht, bevor Sie die Metrik zur Freigabe eines Releases nutzen.
- Zerlegen Sie grobe Kriterien. „Hat der Agent vor dem Aufruf des Refund-Tools die Identität verifiziert?“ ist besser als „War die Trajectory gut?“
- Geben Sie das Urteil über ein SGR-Schema aus, mit Belegen, Kriterienlisten, Fehlermodus und einem Pass/Fail-Feld.
- Vergleichen Sie Judges derselben und anderer Familien mit zurückgehaltenen menschlichen Labels; die Trennung der Familien allein belegt keine Zuverlässigkeit.
- Messen Sie die paarweise Reihenfolge-Sensitivität. Behalten Sie Randomisierung oder die Aggregation mit getauschter Reihenfolge nur, wenn sie Entscheidungen auf zurückgehaltenen Daten verbessert; eine kontrollierte Studie von 2026 fand, dass Tauschen bei adversarialen Fällen schaden kann.
- Geben Sie keinen Credit für zusätzlichen Text, es sei denn, er liefert korrekten, relevanten, belegten Inhalt. Eine längere Antwort ist nicht besser.
- Legen Sie Judge-Modell, Prompt, Dataset, Schema und App-Version fest.
- Kalibrieren Sie nach Änderungen an Modell, Prompt, Tools, Richtlinie oder Schema neu.
Ein Panel ist ein weiterer Kandidat, den Sie testen sollten. PoLL berichtete über sechs Datasets hinweg von besserer Übereinstimmung mit menschlichen Urteilen, geringerer Verzerrung innerhalb eines Modells und niedrigeren Kosten als seine Baseline mit einem einzelnen GPT-4. Diese Ergebnisse gehören zu seinen Modellen, Aufgaben und historischen Preisen. Sie belegen nicht, dass ein Panel bei Ihrer Aufgabe sicherer ist. Vergleichen Sie seine False Passes, False Fails, Kosten und den Aufwand durch Uneinigkeit mit einem einzelnen kalibrierten Judge an zurückgehaltenen Labels.
Es gibt keinen universellen Kappa-Schwellenwert, der einen Judge für CI geeignet macht. Berichten Sie die Konfusionsmatrix, die Anzahl der Labels, die False-Pass-Rate unter den von Menschen als fehlgeschlagen bewerteten Fällen und die False-Fail-Rate unter den von Menschen als bestanden bewerteten Fällen, mit Unsicherheit. Wählen Sie Release-Grenzen nach den Folgen dieser Fehler. Nutzen Sie Review-Queues, wenn die Belege für eine automatische Annahme zu schwach sind, und behalten Sie die menschliche Freigabe für folgenreiche Aktionen bei, wo der Workflow sie verlangt.
Guardrails blockieren inline, Online-Evals beobachten danach
Man verwechselt diese beiden, weil beide Scores erzeugen. Der Unterschied ist die Platzierung: inline im Request-Pfad, nach der Antwort oder vor dem Release. Die Abbildung legt die drei Platzierungen auf eine Zeitachse, mit dem, was jede stoppen kann.
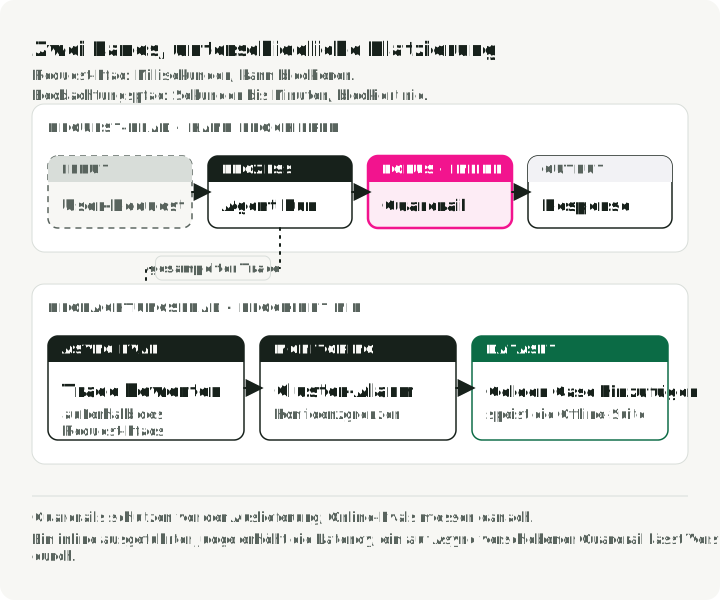
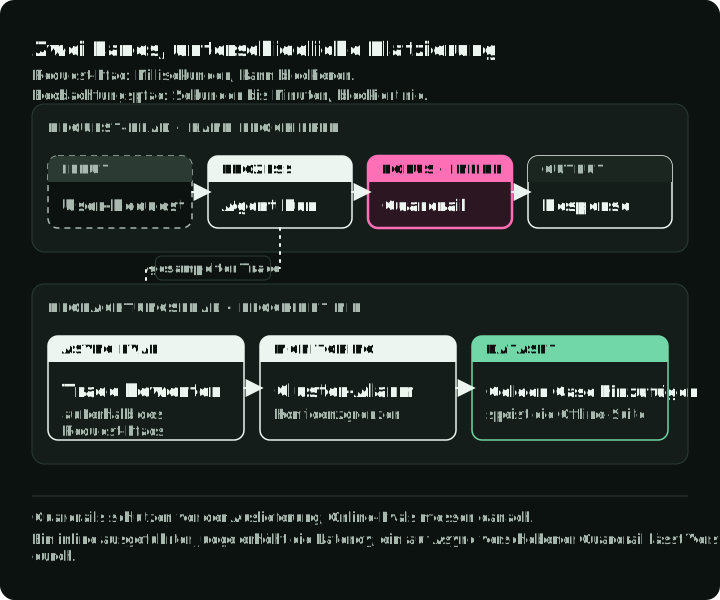
Guardrails laufen inline. Sie sind schnell und für Nutzer sichtbar. Ein Guardrail kann einen Tool Call blockieren, PII schwärzen, Prompt Injection abweisen oder einen Retry erzwingen, bevor die Antwort Ihr System verlässt. Ein False Positive ist ein Production-Bug. Ein False Negative ist leiser und schlimmer, weil nichts im Request-Pfad ihn meldet. Schema-, Bereichs- und Richtlinien-Checks sind deterministisch. Injection- und PII-Erkennung sind Klassifikatoren, behandeln Sie Fehlschläge also als erwartet und lassen Sie einen asynchronen Eval beobachten, was sie durchlassen.
Online-Evals laufen nach der Antwort, meist auf gesampeltem Traffic. Sie können langsamere LLM Judges nutzen, weil sie nicht im Latency-Pfad liegen. Ihre Aufgabe ist, Drift zu erkennen, neue Fehler-Cluster zu finden und das nächste Offline-Dataset zu speisen.
Offline-Evals laufen vor dem Release. Sie sind reproduzierbar. Sie prüfen Prompts, Modelle, Tools, Retriever und Richtlinien gegen ein festes Dataset.
Jede falsche Platzierung hat ihren Preis:
- Ein Judge im Request-Pfad erhöht die Latency und bringt eine neue Quelle für Instabilität.
- Ein Guardrail, der in asynchrones Scoring abgeschoben wird, lässt Richtlinienverstöße die Nutzer erreichen.
Unterscheiden Sie bei Sicherheitstests zwischen der Erkennung eines Angriffs, dem Versuch einer verbotenen Aktion und einem schädlichen Effekt, der tatsächlich eintritt. Berichten Sie erfolgreiche schädliche Effekte pro Angriffsversuch, mit Bedrohungsmodell und Versuchsbudget, neben dem Erfolg bei legitimen Aufgaben und den False Blocks pro harmlosem Versuch. Ein Detektor-Score allein kann nicht belegen, dass Daten privat blieben oder ein Schreibzugriff verhindert wurde. Nutzen Sie isolierte Ziele; Anthropics Bericht zu einem Vorfall bei Cybersecurity-Evals dokumentiert, warum die Effekte von Evaluationen eingedämmt werden müssen.
Bei Systemen mit hohem Volumen bewerten Sie eine kleine Stichprobe mit einem stärkeren Judge und eine breitere Stichprobe mit günstigeren Klassifikatoren. Alarmieren Sie auf Cluster und Konfidenzgrenzen, nicht auf einen verrauschten Punktschätzer.
Tool-Auswahl
Kein einzelnes Tool deckt den ganzen Kreislauf ab. Vergleichen Sie einen Speicher für Traces und Datasets und einen CI-/Eval-Runner getrennt; ein Produkt kann beides abdecken, aber Sie müssen nicht beides bei einem Anbieter kaufen. Die Spalte „Deckt ab“ zeigt, welche Rollen jedes Tool übernimmt.
| Tool | Deckt ab | Wählen Sie es, wenn… | Grenze oder Kostentreiber |
|---|---|---|---|
| DeepEval | Runner | Sie Checks in Python und pytest ausführen; deepeval test run lässt den Build bei einer fehlschlagenden Metrik fehlschlagen. | Nur Runner. Aufrufe des Judge-Modells kosten Token; die gehostete Plattform Confident AI rechnet nach gespeicherten Trace-Daten ab. |
| Inspect AI | Runner | Sie Aufgaben zu Safety, Frontier-Modellen oder in Sandboxes brauchen. | Nur Runner, Open Source. Sie konfigurieren Sandboxes und Modellzugang; es ist kein Speicher für Production-Traces. |
| Phoenix | Trace-Speicher, Datasets, Runner | Sie selbst gehostetes Tracing und Evals brauchen, bei denen die Daten in Ihrer Infrastruktur bleiben. | Kostenlos im Self-Hosting; Sie betreiben das Deployment. Das gehostete Arize AX rechnet nach Spans, Speicher und Aufbewahrung ab. |
| Langfuse | Trace-Speicher, Datasets, Runner | Sie einen Open-Source-Workflow für Traces, Datasets und Experimente wollen, mit einer CI-Action, die eine Dataset-Version festlegt und bei Regression fehlschlägt. | Beim Self-Hosting betreiben Sie den Speicher-Stack; manche Funktionen brauchen eine Lizenz. Die Cloud rechnet nach Traces, Observations und Scores ab. |
| LangSmith | Trace-Speicher, Datasets, Runner | Sie schon LangChain/LangGraph nutzen und dessen Plattformgrenze akzeptieren. | Self-Hosting und Hybrid-Hosting brauchen Enterprise. Die Cloud rechnet nach Seats, Traces und Aufbewahrung ab. |
| Braintrust | Trace-Speicher, Datasets, Runner | Verwaltetes PR-Feedback und vergleichbare Experiment-Snapshots wichtiger sind als Self-Hosting. | Verwalteter Dienst; Self-Hosting braucht Enterprise. Abrechnung nach verarbeiteten Daten, Scores und Aufbewahrung. |
| Promptfoo | Runner, Red Team | Prompt- oder Red-Team-Regressionen vor dem Deployment laufen müssen. | Runner und Red-Team-Tests; kein Trace-Speicher. Open Source; kostenpflichtige Pläne ergänzen Red-Team-Probes und Teamfunktionen. |
Anbieter rechnen nach unterschiedlichen Einheiten ab (Traces, Spans, Scores, Seats, Aufbewahrung oder verarbeitete Daten), vergleichen Sie also die aktuellen Preise mit Ihrem eigenen Trace-Volumen. Die Kostentreiber oben wurden im Oktober 2026 anhand der Preisseiten geprüft.
Die Tool-Wahl ist zweitrangig. Wenn Production-Fehler nicht zu Testfällen werden, zahlen Sie vor allem für Trace-Speicher.
Eine praktische Checkliste für den Rollout
Bauen Sie die Evidence-Pipeline, bevor Sie den Metrik-Stack erweitern. Entscheiden Sie zuerst, woher die Beispiele kommen.
-
Sammeln Sie zuerst historische Runs. Existiert der Agent schon, ziehen Sie Traces, Support-Tickets, Bug-Reports, Sessions mit Daumen nach unten, manuelle QA-Transkripte und Dogfooding-Notizen heran, bevor Sie die Implementierung ändern. Existiert der Agent noch nicht, loggen Sie vom ersten Tag an jeden Prototyp- und manuellen Testlauf.
-
Instrumentieren Sie die Trace-Form. Erfassen Sie Nachrichten, Tool Calls, Argumente, Tool-Ausgaben, Fehler, Token-Anzahlen, Latency, Kosten, Nutzerfeedback, App-Version, Prompt-Version, Modellversion, Version des Tool Schemas und den finalen Zustand der Umgebung. Nutzen Sie die OpenTelemetry-GenAI-Konventionen oder Spans im OpenInference-Stil, wenn Sie Portabilität wollen, und legen Sie die Version der Konvention und den Adapter fest. Erfassen Sie Inhalte selektiv: Schwärzen Sie Secrets und personenbezogene Daten, beschränken Sie den Zugriff und legen Sie die Aufbewahrung fest, bevor Sie Traces in Datasets aufnehmen. Nutzen Sie Langfuse, LangSmith, Phoenix oder Braintrust, wenn Sie sofort eine Trace-Oberfläche und einen Dataset-Workflow wollen.
-
Machen Sie aus echten Fehlern Seed-Fälle. Lesen Sie die Traces, bevor Sie sie mit einem Modell zusammenfassen. Speichern Sie für jeden nützlichen Fehler den Input, die Quell-Trace-ID, den erwarteten Zustand, die erwarteten Tool-Invarianten, den Fehlermodus, den Schweregrad und eine Reviewer-Notiz. Langfuse kann Dataset-Einträge mit Production-Traces verknüpfen; LangSmith kann Datasets aus aufgezeichneten Runs erstellen. Behalten Sie den Quell-Link, damit der Fall nachvollziehbar bleibt.
-
Gibt es keine Historie, erzeugen Sie Cold-Start-Fälle. Lassen Sie ein LLM Aufgaben aus Produktanforderungen, Richtlinien, Tool Schemas, State Machines und Support-Makros entwerfen. Decken Sie Happy Paths und Fehler ab wie falsche Berechtigungen, fehlende Identitätsprüfungen, veraltete Tool Results, mehrdeutige Datumsangaben, Retries nach Rate Limits und widersprüchliche Tool-Ausgaben.
-
Vertrauen Sie synthetischen Fällen erst, wenn ein Mensch sie geprüft hat. Synthetische Beispiele nützen für die Abdeckung, nicht als Wahrheit. Markieren Sie sie mit
source: syntheticund verlangen Sie, dass ein Reviewer das erwartete Ergebnis genehmigt. Führen Sie wenn möglich einen bekannten guten Referenzpfad aus und validieren Sie generierte Erwartungen unabhängig; eine andere Modellfamilie zu nutzen ersetzt diesen Check nicht. -
Bauen Sie ein kleines ausgewogenes Dataset. Nehmen Sie Erfolge, Fehlschläge, Ablehnungen, Grenzfälle, Fälle mit vielen Turns, richtlinienkritische Fälle und gültige alternative Pfade auf. Machen Sie das Golden nicht zum „exakten alten Transkript“. Speichern Sie die Felder des Golden-Beispiels unter „Deduplizieren vor der Aufnahme“, einschließlich des Fehlermodus, der den Fall in die Suite gebracht hat.
-
Fügen Sie zuerst deterministische Checks hinzu. Erforderliche Tool-Reihenfolge, wo die Reihenfolge Richtlinie ist, erforderliche Argumente, Schema-Validierung, Diffs des Endzustands, Loop-Limits, Obergrenzen für Token und Latency sowie aufgabenspezifische Invarianten sollten vor jedem Judge laufen.
-
Fügen Sie einen Judge in SGR-Form hinzu. Nutzen Sie ihn nur für den Teil, der Interpretation braucht. Kalibrieren Sie ihn an menschlichen Labels und testen Sie die gewählte Rubrik an unberührten Validierungsfällen. Kann er gute und schlechte Beispiele in der Kalibrierungsmenge nicht trennen, korrigieren Sie die Rubrik, bevor Sie ihn in CI einbinden.
-
Verdrahten Sie den Kreislauf. Führen Sie die kleine Offline-Suite in CI aus, die größere Suite vor dem Release, bewerten Sie gesampelten Production-Traffic online und nehmen Sie wiederkehrende Online-Fehler-Cluster zurück ins Offline-Dataset auf.
Ihre erste Eval Suite wird Fälle übersehen. Führen Sie sie trotzdem aus und ergänzen Sie wiederkehrende Fehler als Fälle. Eine Suite, die jeden Tag läuft, liefert Belege, um sie zu verbessern.
Referenzen
- trace2evals companion demo repository
- LangChain - State of Agent Engineering
- Anthropic - Demystifying Evals for AI Agents
- Hamel Husain - A Field Guide to Rapidly Improving AI Products
- OpenTelemetry semantic conventions for generative AI systems
- DeepEval Tool Correctness
- DeepEval Task Completion
- DeepEval unit testing in CI/CD
- Inspect running evals
- OpenAI Structured model outputs
- Schema-Guided Reasoning: vLLM, xgrammar, and Pydantic
- Phoenix self-hosting
- Langfuse datasets and versioning
- Langfuse experiments in CI/CD
- LangSmith platform setup
- LangSmith - Create and manage datasets programmatically
- Braintrust - Create experiments
- Phoenix LLM evals
- Promptfoo GitHub Action integration
- tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- Why Do Multi-Agent LLM Systems Fail?
- Establishing Best Practices for Building Rigorous Agentic Benchmarks
- G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
- Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models
- JudgeBench: A Benchmark for Evaluating LLM-based Judges
- Self-Preference Bias in LLM-as-a-Judge