Avaliação de agentes de AI em produção: de traces a suites de testes

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este guia destina-se a engenheiros que avaliam agentes de AI com tool use em produção. Vai aprender a transformar execuções falhadas em testes repetíveis, a verificar tanto as ações do agente como as suas respostas e a usar esses testes antes da próxima release.
Para uma comparação curta de ferramentas, veja Melhores ferramentas para avaliação de agentes de AI.
Porque é que as avaliações de agentes são diferentes
As avaliações tradicionais de LLMs costumam pontuar um único par input-output: relevância, fidelidade, correção, segurança e, talvez, estilo. Os agentes acrescentam planeamento, tool calls, novas tentativas e verificações de terminação, e cada passo é mais um sítio onde pode falhar.
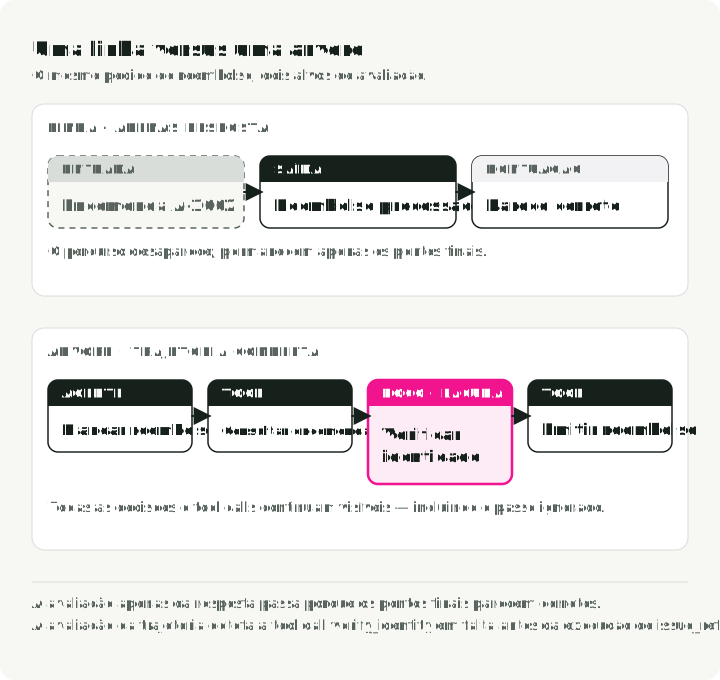
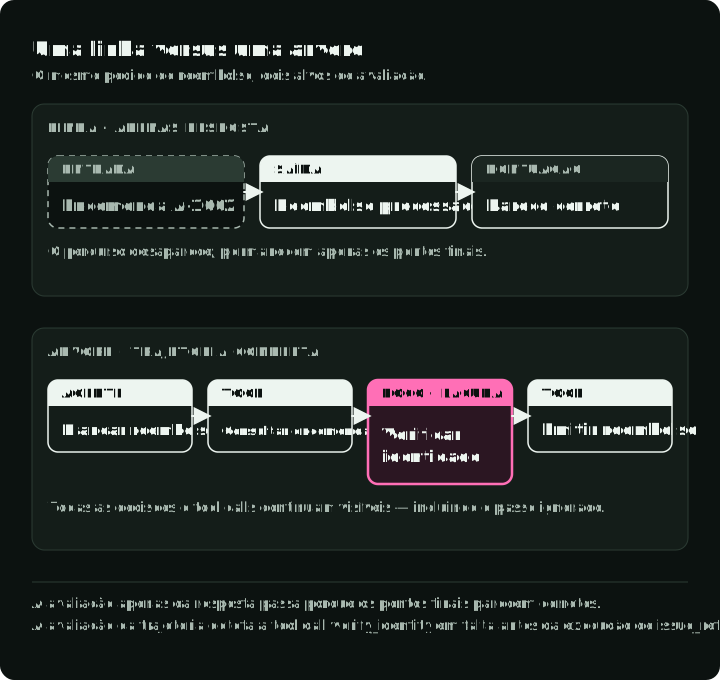
Pense num agente de reembolsos. A conversa pode terminar bem enquanto o trace está errado:
lookup_order -> issue_refund -> final_answerA avaliação do output passa. Uma avaliação de trajetória deve falhar, porque verify_identity nunca foi executada antes de issue_refund. Para agentes com tool use, as avaliações que só olham para a resposta apanham falhas de qualidade do conteúdo, mas não conseguem estabelecer que o agente seguiu uma trajetória válida nem que produziu os efeitos secundários exigidos.
O cartão da esquerda é a linha que uma avaliação só da resposta lê; o cartão da direita é o trace que uma avaliação da trajetória lê, com a verificação de identidade saltada.
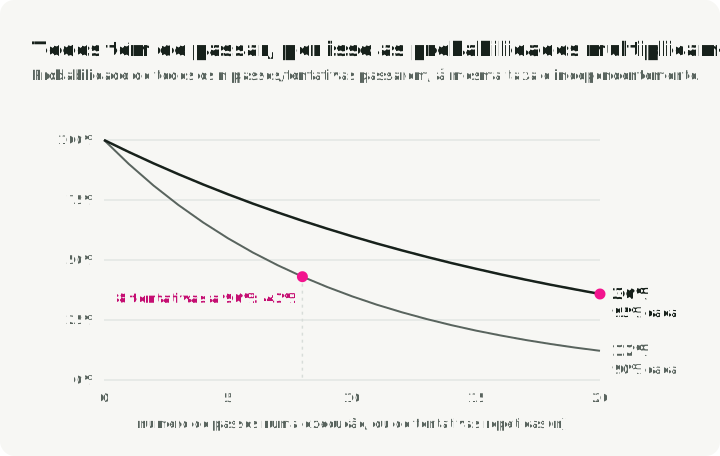
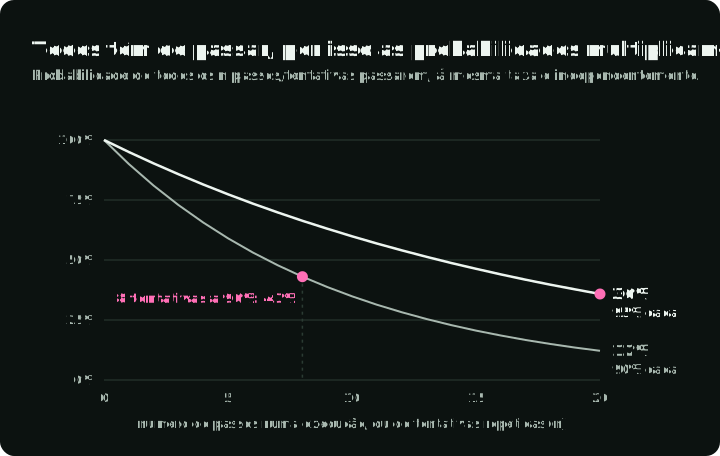
Há um segundo problema: os erros acumulam-se. Se um workflow tiver 20 passos obrigatórios, cada um tiver sucesso de forma independente e todos tiverem a mesma fiabilidade de 95%, a taxa de sucesso de ponta a ponta fica à volta de 36%:
Assim, o agente pode parecer sólido em verificações isoladas e, mesmo assim, falhar na maioria das execuções completas. A falha costuma estar algures a meio, e encontrá-la exige visibilidade ao nível dos componentes, não outra leitura da resposta.
O tau-bench dá a um agente tarefas de apoio ao cliente de companhias aéreas e de comércio a retalho. O agente fala com um utilizador simulado, chama APIs e tem de cumprir a política do domínio. Depois da conversa, o avaliador verifica se a base de dados chegou ao estado final anotado. Uma conversa plausível com as linhas erradas continua a falhar.
Com essa avaliação, o GPT-4o resolveu apenas 35,2% das tarefas de aviação e pouco mais de 60% das de retalho. O artigo introduziu também o pass^k: a probabilidade de todas as k tentativas independentes passarem, em média sobre as tarefas.
No retalho, a divisão mais fácil, o pass^8 ficou abaixo de 25%. Para uma tarefa de retalho escolhida ao acaso e oito tentativas independentes, a probabilidade de as oito execuções passarem foi inferior a 25%. Uma avaliação com uma única execução não consegue medir esta consistência.
O gráfico mostra os dois casos: a probabilidade de todos os passos ou de todas as tentativas passarem diminui a cada um que se acrescenta. Com 90% por passo a queda é mais acentuada: se cada um de 20 passos independentes passa 90% das vezes, os 20 passam cerca de 12% das vezes (0,9^20 ≈ 0,12).
O MAST estuda porque falham os agentes. Os autores construíram uma taxonomia de 14 modos a partir de 150 traces anotados à mão e aplicaram-na depois a mais de 1600 traces de 7 frameworks multi-agent populares. A taxonomia inclui definições de papéis vagas (design do sistema), um agente que ignora o que outro agente reportou (desalinhamento entre agentes) e declarar sucesso sem verificar o resultado (ausência de verificação). Estas falhas envolvem prompts, lógica de orquestração e verificações em falta no harness. Um modelo base mais forte não consegue executar um passo de verificação que nunca foi construído, por isso o alvo da avaliação tem de incluir o harness em torno do modelo.
O défice de adoção
O inquérito State of Agent Engineering da LangChain (1340 inquiridos, realizado no final de 2025) sugere que muitas equipas já têm a matéria-prima para melhores avaliações. Indica que 89% tinham alguma observabilidade, 52,4% executavam avaliações offline e 37,3% executavam avaliações online.
O inquérito indica ainda que 57,3% dos inquiridos já têm agentes em produção. Quando lhes perguntaram o que bloqueia a produção, 32% apontaram a qualidade e 20% a latência. É um inquérito de um fornecedor aos seus inquiridos, não um censo das equipas que trabalham com agentes, mas mostra um défice útil entre a recolha de traces e a avaliação sistemática.
Isto deixa as equipas num meio-termo incómodo: conseguem inspecionar uma má execução depois do facto e, mesmo assim, entregar a mesma falha duas vezes.
Cada falha de produção diagnosticada deve deixar um trace, um rótulo, uma linha de dataset e um scorer. Uma falha repetível pertence à suite de regressão.
Escolha as métricas de acordo com o modo de falha
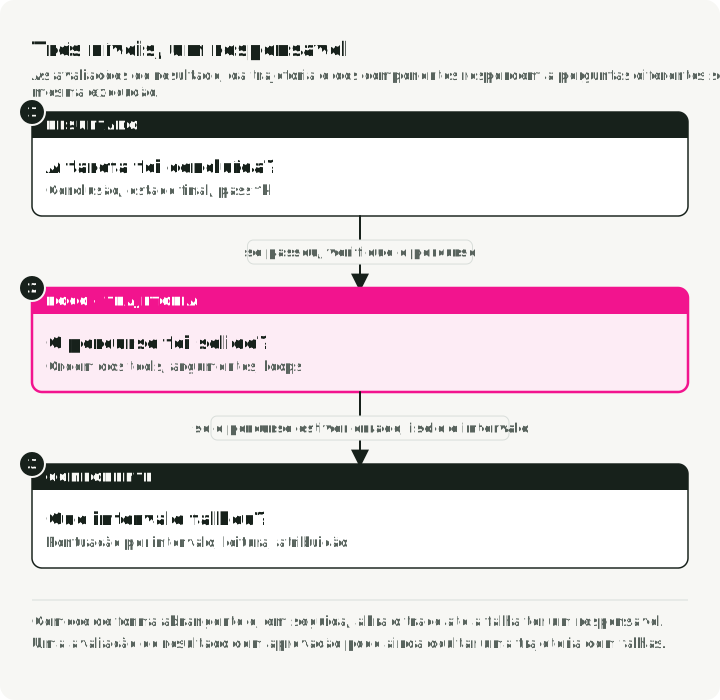
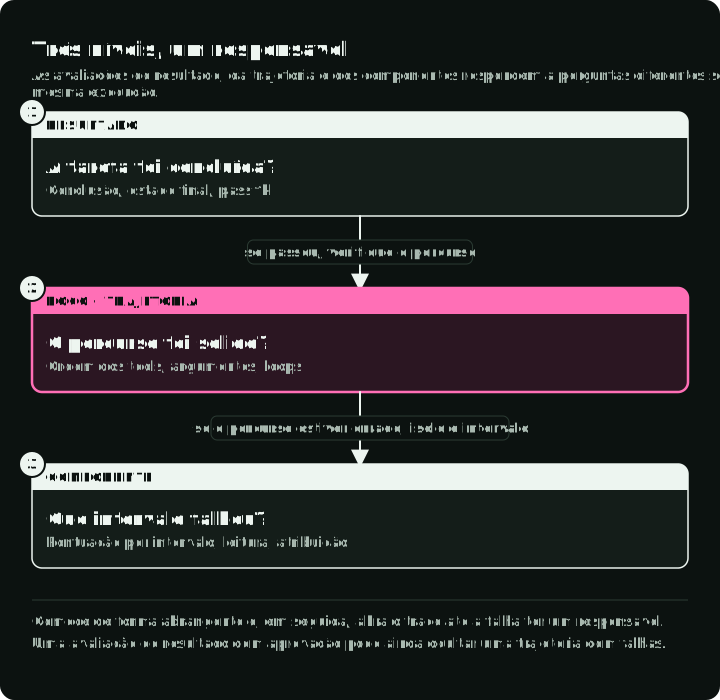
Escolha a métrica pela falha que precisa de apanhar. A divisão útil tem três níveis:
- As avaliações de resultado respondem se a tarefa foi concluída com sucesso.
- As avaliações de trajetória respondem se o caminho foi válido, eficiente e conforme com a política.
- As avaliações de componentes respondem qual ferramenta, retriever, sub-agente ou passo de decisão falhou.
A figura mostra que parte da mesma execução cada nível lê.
Cada nível pode ser executado offline sobre casos fixos e reproduzíveis antes da release ou online sobre traces de produção amostrados depois da resposta. A secção sobre guardrails abaixo aborda esta divisão em detalhe. As avaliações offline podem exigir goldens: casos armazenados que associam um input ao resultado, aos invariantes das ferramentas e aos argumentos que uma execução correta deve produzir. Um golden completo aparece em “Elimine duplicados antes de promover”, mais abaixo. As avaliações online devem privilegiar invariantes, distribuições e verificações assíncronas que fiquem fora do request path.
| Pergunta | Família de métricas | Contrato offline / online | Determinística ou juiz? | Atenção a |
|---|---|---|---|---|
| O agente chamou as ferramentas certas? | Correção das ferramentas: correspondência exata, por ordem ou em qualquer ordem | Goldens exatos offline; invariantes de ferramentas obrigatórias e anomalias online | Determinística | A correspondência exata penaliza caminhos alternativos válidos |
| Chamou-as com os inputs certos? | Correção dos argumentos, validação de schema, correspondência de parâmetros | Argumentos esperados offline; verificações de schema, intervalo e política online | Ambas | A ferramenta certa com argumentos errados continua a ser uma falha |
| Desperdiçou passos? | Eficiência de passos, número de novas tentativas, deteção de loops, custo e latência | Orçamentos de passos e de loops offline; deriva de custo e de latência online | Sobretudo determinística | Uma conclusão elevada pode esconder deambulação cara |
| A tarefa foi realmente concluída? | Conclusão da tarefa, avaliação do resultado, diff do estado final | Simulador ou estado golden offline; estado final, sinal do utilizador ou juiz assíncrono online | Juiz ou verificação de estado | Avalie o estado do ambiente sempre que possível |
| Preservou o contexto ao longo dos turnos? | Fidelidade multi-turno, adesão ao papel, completude da conversa | Casos de longo horizonte com guião offline; sessões longas amostradas online | Juiz | Testes de um só turno nada dizem sobre o turno 14 |
| Parou no momento certo? | Correção da terminação, sucesso prematuro, trabalho sem fim | Testes de cenário offline; monitores de loops, timeouts e falso sucesso online | Ambas | ”Concluído” pode ser um estado alucinado |
| Interpretou corretamente os tool results? | Compreensão dos tool results, verificações do estado a jusante | Outputs adversariais de ferramentas offline; verificações do estado a jusante e revisão amostrada online | Ambas | Avalie o estado a jusante, não o código de saída da ferramenta |
Comece pelas métricas determinísticas. Repetem-se para inputs e código fixos e custam pouco a executar. As suas regras podem tornar-se obsoletas quando as ferramentas ou a política mudam, por isso versione o scorer em conjunto com a especificação que verifica.
Escolha o verificador pelo critério: código quando o código consegue verificar, uma fila de revisão enquanto não existir juiz calibrado, uma pessoa quando o veredicto desencadeia uma ação com consequências, e um LLM juiz calibrado para o resto.
Correção das tool calls
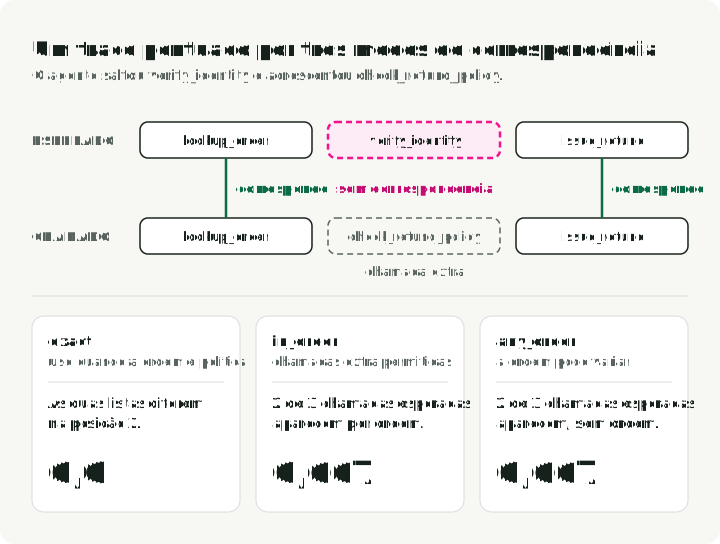
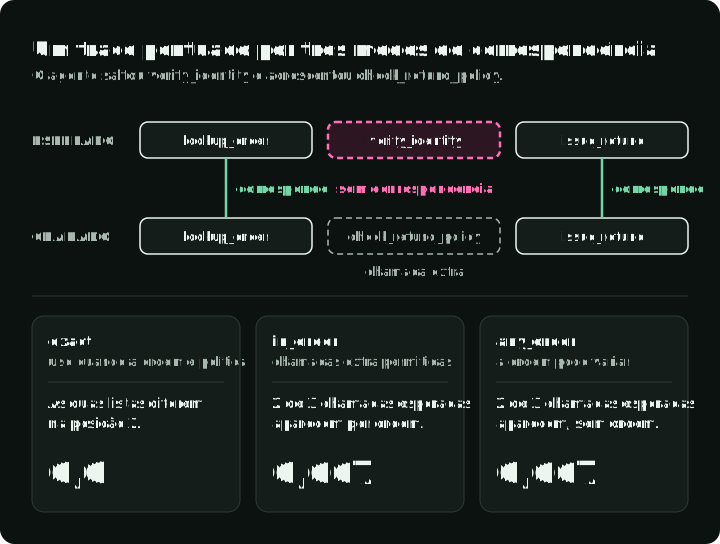
A correção das ferramentas compara as ferramentas chamadas com as ferramentas esperadas. Escolha o rigor de forma deliberada:
- Correspondência exata: a sequência tem de coincidir exatamente. Use-a quando a ordem é política, por exemplo
lookup_order -> verify_identity -> issue_refund. - Correspondência por ordem: as ferramentas obrigatórias têm de aparecer na ordem relativa correta, mas são permitidas chamadas extra inofensivas.
- Correspondência em qualquer ordem: as ferramentas obrigatórias têm de aparecer, mas a ordem pode variar.
A figura pontua um trace nos três modos. O agente saltou verify_identity e fez uma chamada extra a check_refund_policy.
Um scorer local pequeno chega para começar:
from collections import Counter

def tool_correctness(called: list[str], expected: list[str], mode: str = "in_order") -> float:
    if mode not in {"exact", "in_order", "any_order"}:
        raise ValueError(f"unknown matching mode: {mode}")
    if mode == "exact":
        return float(called == expected)
    if not expected:
        return 1.0
    if mode == "any_order":
        matched = sum((Counter(called) & Counter(expected)).values())
        return matched / len(expected)

    rows = [[0] * (len(expected) + 1) for _ in range(len(called) + 1)]
    for i, tool in enumerate(called):
        for j, wanted in enumerate(expected):
            if tool == wanted:
                rows[i + 1][j + 1] = rows[i][j] + 1
            else:
                rows[i + 1][j + 1] = max(rows[i][j + 1], rows[i + 1][j])
    return rows[-1][-1] / len(expected)

called = ["lookup_order", "check_refund_policy", "issue_refund"]
expected = ["lookup_order", "verify_identity", "issue_refund"]

print(round(tool_correctness(called, expected, "exact"), 3))     # 0.0
print(round(tool_correctness(called, expected, "in_order"), 3))  # 0.667
assert tool_correctness(["issue_refund"], [], "exact") == 0.0
assert tool_correctness([], [], "exact") == 1.0
assert tool_correctness(["a", "b"], ["a", "a", "b"], "any_order") == 2 / 3
try:
    tool_correctness([], [], "typo")
except ValueError:
    pass
else:
    raise AssertionError("unknown modes must fail")
A pontuação in_order é o recall da maior subsequência comum: que fração da sequência obrigatória sobreviveu, na ordem certa. Repare no que ela ignora. As chamadas inúteis não a baixam, por isso um agente pode ter 1,0 aqui e fazer o dobro das chamadas necessárias. Quando as chamadas extra custam dinheiro ou alteram estado, acompanhe também a precisão (chamadas obrigatórias correspondidas a dividir pelo total de chamadas) e leia as duas em conjunto. O recall apanha o passo em falta; a precisão apanha a deambulação. Uma boa pontuação de ferramentas não torna seguro um reembolso ou uma escrita a mais. Verifique cada chamada que altera estado por si: permissões, recurso, argumentos e a verificação que tem de vir antes. Se não se esperarem ferramentas, só o modo exact reprova uma execução que chame ferramentas; os outros dois modos devolvem 1,0.
A métrica Tool Correctness do DeepEval expõe os mesmos parâmetros através de should_consider_ordering e should_exact_match.
Correção dos argumentos
Chamar a ferramenta certa com os argumentos errados é muitas vezes pior do que chamar a ferramenta errada, porque o trace parece normal.
Nos casos simples, valide o JSON Schema e os valores exatos. Nos casos semânticos, guarde os argumentos esperados com o caso, como faz o campo expected_arguments do golden em “Elimine duplicados antes de promover”, e avalie as diferenças. Uma métrica sobre o nome da ferramenta não apanha 2026-06-17 quando a política exige 2026-06-19.
Nesta ilustração de uma chamada por ferramenta, a correspondência de parâmetros é a fração dos triplos (tool, key, value) esperados que o agente acertou. Os dicionários abaixo só são válidos quando cada ferramenta relevante tem no máximo uma invocação. Não os construa sobrescrevendo chamadas anteriores com o mesmo nome: isso esconderia um reembolso errado seguido de um correto. Para chamadas repetidas, guarde os IDs e a ordem das chamadas, associe a invocação pretendida e valide cada mutação em separado.
def argument_correctness(called_args: dict, expected_args: dict) -> float:
    total = matched = 0
    for tool, params in expected_args.items():
        for key, want in params.items():
            total += 1
            if key in called_args.get(tool, {}) and called_args[tool][key] == want:
                matched += 1
    return matched / total if total else 1.0

assert argument_correctness({}, {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {}},
                            {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {"date": None}},
                            {"reschedule_delivery": {"date": None}}) == 1.0
A igualdade exata serve para IDs, enums e datas já normalizadas num único formato. Não serve para texto livre, floats e datas na forma em que o modelo as produziu, onde == marca como errada uma resposta correta. Avalie esses campos nos seus próprios termos: uma correspondência de string normalizada, um parse de data, uma tolerância numérica. A métrica mantém-se; muda o comparador de cada campo.
Eficiência, loops e becos sem saída
Um agente que conclui a tarefa depois de cinco tool calls redundantes continua a sinalizar um problema de planeamento e custa mais a executar.
Sinais baratos por onde deve começar:
- Taxa de chamadas redundantes: tool calls idênticas com os mesmos argumentos, repetidas mais de duas vezes.
- Anomalias na forma do trace: subidas bruscas de profundidade, número de tool calls, número de tokens, latência ou custo.
- Convergência do caminho: quão perto a execução está do caminho válido mais curto conhecido para a tarefa.
- Correção da terminação: se o agente parou cedo, continuou a trabalhar depois do sucesso ou declarou sucesso sem a alteração de estado exigida.
- Aderência ao plano: se o agente escreve um plano antes de agir, verifique se o trace o seguiu. Um bom plano ignorado e um mau plano seguido na perfeição falham, por razões opostas, e a diferença entre o plano e o trace indica qual dos casos é.
Execute estas verificações antes de um juiz sempre que possível. Um detetor de loops ocupa poucas linhas sobre o trace e não precisa de modelo. Este conta a chamada idêntica mais repetida num trace:
import json

def redundant_call_count(tool_calls: list[dict]) -> int:
    seen: dict[str, int] = {}
    for call in tool_calls:
        key = call["name"] + json.dumps(call["arguments"], sort_keys=True)
        seen[key] = seen.get(key, 0) + 1
    return max(seen.values(), default=0)

calls = [{"name": "lookup_order", "arguments": {"order_id": "A-100"}}] * 3
assert redundant_call_count(calls) == 3
assert redundant_call_count([]) == 0
Sinalize um trace quando a contagem for superior a 2. O repositório complementar usa a mesma regra.
Conclusão da tarefa e avaliação do resultado
Avaliada pelo resultado, a pergunta é “o utilizador obteve o que pediu?”
Dois padrões funcionam melhor:
- Avaliação sem referência da conclusão da tarefa: extraia o objetivo do input e avalie se o trace e a resposta final o alcançaram. Funciona online porque o tráfego de produção raramente tem outputs golden.
- Avaliação do estado do ambiente: compare as linhas finais da base de dados, os ficheiros, tickets, reservas ou registos com um estado final anotado. É mais robusta do que a comparação de transcrições, porque os agentes podem encontrar caminhos válidos que o autor do teste não previu.
A segunda opção é melhor quando a consegue construir. Avalie o estado final; use a transcrição para explicar uma falha.
A avaliação do estado tem dois limites. Uma auditoria de 2025 a benchmarks de agentes concluiu que o tau-bench avalia algumas tarefas apenas pelo estado da base de dados. Em algumas tarefas, o resultado anotado não exige nenhuma alteração de estado nem texto específico. Um agente que não faz nada pode então passar: 38% na divisão de aviação e 6,0% na de retalho, para qualquer k. A Anthropic reportou uma execução do Opus 4.5 que “falhou” uma tarefa de reserva no tau2-bench, o benchmark sucessor. O agente encontrou uma brecha na política que deu ao utilizador um resultado melhor. A avaliação do estado é melhor do que a comparação de transcrições, mas o estado final continua a ser uma anotação, e as anotações têm bugs. Audite os casos que passam com demasiada facilidade, não apenas os que falham.
Avaliações de componentes
As métricas de resultado e de trajetória dizem-lhe que a execução falhou e, aproximadamente, onde. As avaliações de componentes pontuam um único span: o chunk recuperado era relevante, o sub-agente devolveu o schema que quem o chamou esperava, foi possível analisar sintaticamente a resposta da própria ferramenta. Associe a pontuação ao span e não à execução, para que “que ferramenta se degradou esta semana” seja uma consulta e não uma nova execução.
Três verificações cobrem a maior parte do caso:
- Pontuação por span: execute a métrica adequada ao tipo de span. Os spans de recuperação recebem recall e precisão face ao chunk anotado, os spans de sub-agentes recebem validação de schema e a sua própria pontuação de correção das ferramentas, e os spans de ferramentas recebem taxa de erro e latência.
- Interpretação dos tool results: dê ao agente um output de ferramenta correto mas incómodo (uma lista vazia, uma correspondência parcial, um timestamp desatualizado) e veja o que ele faz a seguir. Uma ferramenta pode estar certa enquanto o agente a lê mal, e essa falha só aparece dois passos mais tarde.
- Atribuição da falha: a falha visível costuma estar a jusante da verdadeira. Atribua-a ao primeiro span cujo output já estava errado, não ao passo que levantou o erro.
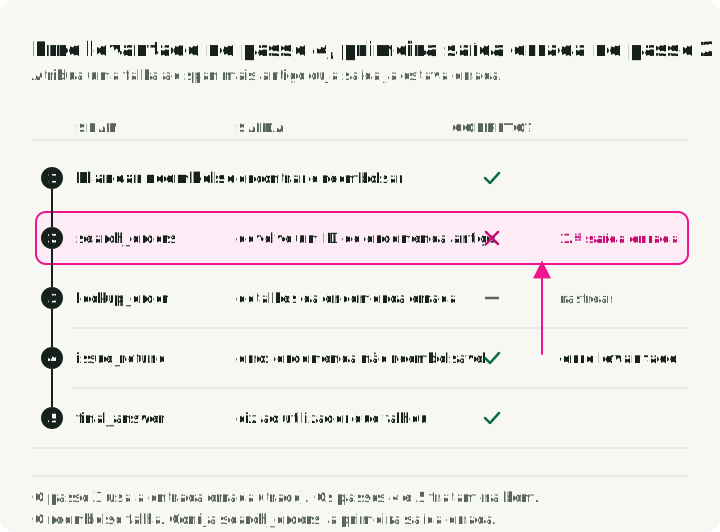
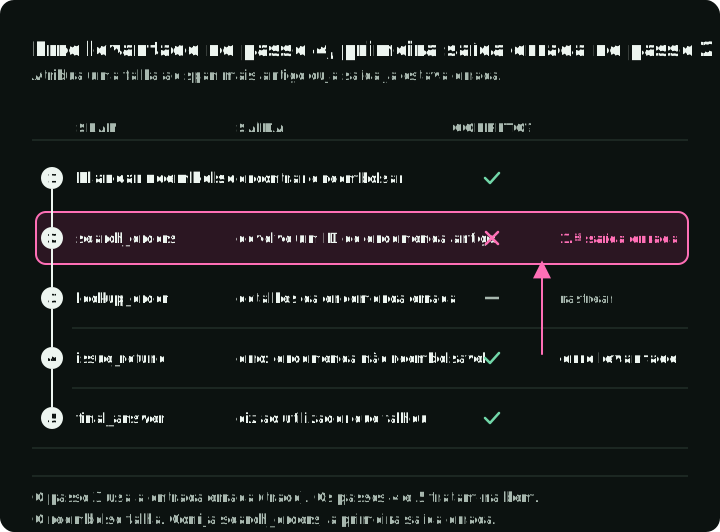
A figura mostra uma execução de reembolso com cinco spans. O agente planeia encontrar a encomenda e reembolsá-la. search_orders devolve um ID de encomenda antigo, lookup_order obtém essa encomenda errada, issue_refund levanta um erro porque a encomenda não pode ser reembolsada, e final_answer diz ao utilizador que o reembolso falhou. O erro aparece em issue_refund (passo 4), mas o primeiro output errado veio de search_orders (passo 2), dois spans antes.
É aqui que se aplica o cálculo dos 20 passos do início. Se 20 passos parecerem bem isoladamente, a execução pode mesmo assim falhar na maioria das vezes. As taxas de sucesso por span mostram que passo corre a 95% e qual corre a 70%.
O ciclo de trace para avaliação
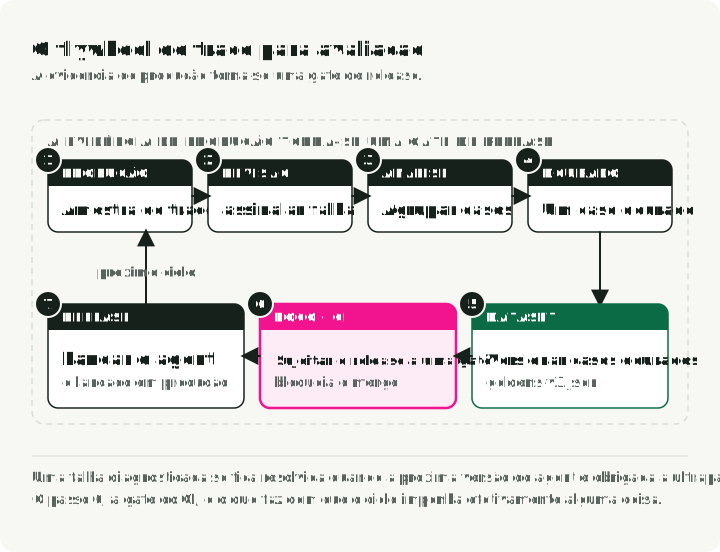
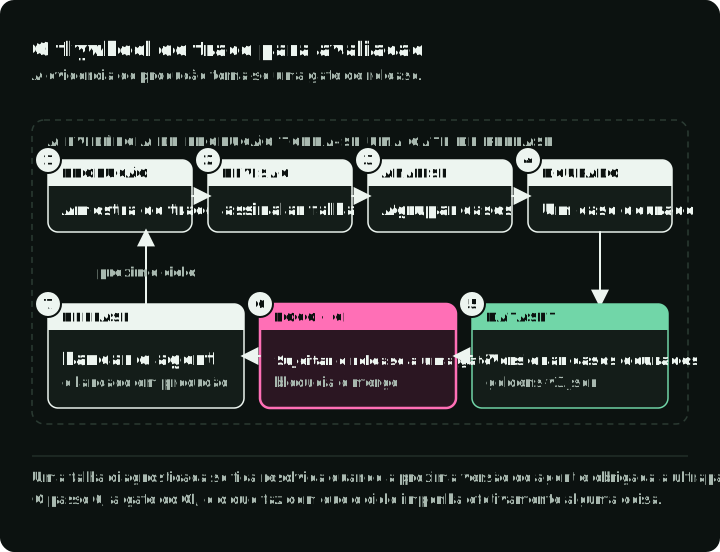
Recolha falhas de produção antes de imaginar mais casos de avaliação. Cada passo numerado da figura corresponde à lista abaixo.
O ciclo:
- Capture evidência de trace suficiente para reconstruir a falha, com o conteúdo sensível controlado.
- Atribua um rótulo ao que falhou.
- Agrupe falhas semelhantes.
- Mantenha goldens representativos, incluindo variantes que exigem resultados diferentes. Um revisor aprova cada resultado esperado.
- Versione o dataset.
- Execute-o em CI.
- Continue a pontuar online traces de produção amostrados.
O repositório complementar trace2evals demonstra este workflow com um agente de apoio defeituoso. Regista as tool calls e o estado da loja em JSONL local de OpenTelemetry, deteta falhas com regras determinísticas e emite candidatos a revisão versionados. Um revisor tem de definir e aprovar os resultados esperados antes de os usar como testes de release.
Execute uv sync --locked e make demo nesse repositório. Não é preciso nenhuma API key: um agente com guião repete erros plantados. A demo regista seis execuções, encontra quatro pedidos falhados e escreve-os como candidatos a revisão. Depois executa dez tarefas de referência em três configurações. O agente v1, com bugs, falha cinco. O agente v2, corrigido, passa as dez, tanto quando as ferramentas verificam permissões como quando só o prompt pede verificações. Os relatórios são data/demo/red.json, prompt-only.json e green.json. O README explica a execução real opcional com um modelo da OpenAI.
A demo usa casos sintéticos, ferramentas em memória e um schema de traces específico do repositório; o seu adaptador não aceita exportações arbitrárias de OpenTelemetry.
Recolha falhas com análise de erros
Hamel Husain e Shreya Shankar ensinam um workflow de análise de erros para este passo; o guia prático do Hamel percorre-o: inspecionar conversas reais, tirar notas abertas, categorizar as falhas e construir testes específicos. Os dois primeiros passos têm o nome da investigação qualitativa, o que ajuda quando procura o método noutros sítios.
- Open coding: inspecione traces e escreva notas abertas sobre o que correu mal.
- Axial coding: agrupe as notas em categorias de falha com nome.
- Atribua rótulos aos traces de acordo com essa taxonomia.
- Construa testes específicos para os maiores clusters acionáveis.
Não comece com rótulos como reasoning_issue ou tool_problem. São vagos demais para testar. Use rótulos como missing_identity_verification, date_argument_mismatch, retried_same_tool_after_429 ou stopped_before_database_update. Um rótulo tão específico diz-lhe exatamente o que o teste de regressão deve verificar.
Elimine duplicados antes de promover
Um erro comum é adicionar cada trace mau à suite. Isso cria um dataset grande, caro e estreito. Passa em quase-duplicados de março e deixa escapar a nova forma do mesmo bug em junho.
Agrupe primeiro. Comece com um golden representativo por cluster e depois mantenha variantes com permissões, argumentos, estados de recuperação ou resultados esperados diferentes. Uma formulação semelhante não torna dois casos de política equivalentes. Guarde os IDs dos traces relacionados em metadata com acesso controlado, para que um revisor possa consultar a evidência mais tarde.
Se um cluster de falhas voltar a ocorrer depois de uma correção, o caso de regressão não generalizou. Reveja o cluster e acrescente as variantes de comportamento em falta, em vez de recolher transcrições quase idênticas.
Um golden promovido guarda o input, os traces de origem, o conjunto a que pertence, o rótulo de falha que o criou, as ferramentas, os argumentos e o estado final esperados, e quem o aprovou. Estes são os campos que os passos de promoção do repositório complementar usam:
{
    "id": "reschedule-date",
    "input": "Reschedule order A-100 for June 19, 2026.",
    "source_trace_ids": ["tr_2417"],
    "split": "regression",
    "failure_modes": ["date_argument_mismatch"],
    "expected_tools": ["lookup_order", "reschedule_delivery"],
    "tool_match": "in_order",
    "expected_arguments": {
        "reschedule_delivery": { "order_id": "A-100", "date": "2026-06-19" }
    },
    "expected_state": {
        "reschedules": [{ "order_id": "A-100", "date": "2026-06-19" }],
        "refunds": []
    },
    "review_status": "approved",
    "reviewed_by": "support-policy-owner"
}
O expected_state permite ao teste avaliar a loja depois da execução. O split mantém o caso fora dos conjuntos hold-out, que a secção seguinte aborda.
Versione o dataset
Versione os datasets da mesma forma que versiona prompts e código. Sempre que algo significativo mudar (modelo, prompt, tool schema, prompt do juiz ou comportamento da aplicação), deve executar a mesma versão do dataset antes e depois.
A verificação de CI deve fixar:
- versão do dataset
- versão da aplicação
- versão do prompt
- modelo do juiz
- prompt do juiz
- versão do código do avaliador
- tool schemas, política, harness e configuração da gestão de contexto
- revisão do modelo, definições de raciocínio e de amostragem
- fixture inicial do ambiente e efeitos externos permitidos
Se algum destes elementos mudar, não consegue dizer qual alteração causou a diferença. Um ficheiro goldens-v3.json em git é suficiente numa escala pequena. Snapshots nativos de ferramentas em Langfuse, Phoenix, Braintrust ou LangSmith ajudam quando o dataset se torna colaborativo.
Mantenha separadas as regressões de desenvolvimento, os exemplos de calibração do juiz, a validação hold-out e as amostras de monitorização. Agrupe sessões, utilizadores e tarefas relacionados antes de fazer o split, para que quase-duplicados não passem de um conjunto para outro. Assim que um caso influenciar um prompt ou uma rubrica, trate-o como evidência de desenvolvimento. Uma suite de falhas recolhidas testa regressões conhecidas; a sua média não estima a taxa de sucesso em produção.
Reponha o estado mutável em cada tentativa: ficheiros, linhas da base de dados, caches e fixtures das ferramentas. Isole as credenciais e os efeitos externos e mantenha iguais os orçamentos do candidato e da baseline. Reporte o número de tarefas em separado do número de tentativas, juntamente com todas as tentativas iniciadas, timeouts, crashes e resultados que não puderam ser pontuados. Compare resultados emparelhados nas mesmas tarefas. Estas escolhas seguem a abordagem de tentativas limpas e de avaliação do resultado descrita no guia de avaliação da Anthropic.
Fixe as versões de benchmarks e de sandboxes
Os números do tau-bench da primeira secção explicam a fiabilidade com tentativas repetidas; não são um leaderboard atual de modelos. Os benchmarks públicos mudam tarefas e avaliadores entre releases, e as pontuações de versões diferentes do avaliador não são comparáveis. O repositório mantido do tau-bench publicou uma correção desse tipo ao avaliador em julho de 2026. Fixe as revisões das tarefas e do avaliador, tal como o modelo, e volte a pontuar as trajetórias guardadas quando uma anotação mudar.
Escolha um benchmark que exercite a interface em produção. Testes de apoio ao cliente só com texto não conseguem estabelecer o tratamento de interrupções num agente de voz. As tarefas de recuperação de conhecimento precisam também do corpus, da configuração de pesquisa e da evidência disponível em cada turno. Aproveite estas formas de tarefa para casos de regressão locais, em vez de importar a posição num leaderboard público como critério de release.
A sandbox também faz parte do teste. O estudo de infraestrutura da Anthropic de fevereiro de 2026 encontrou uma diferença de seis pontos percentuais no Terminal-Bench 2.0 entre as configurações de recursos estrita e sem limite, com o mesmo modelo, harness e tarefas. A folga extra reduziu as falhas de infraestrutura e permitiu estratégias de solução diferentes. Registe as garantias e os limites de CPU e RAM, os timeouts, a concorrência, o acesso à rede e o tratamento dos erros de infraestrutura. Reporte essas falhas em separado, sem as retirar discretamente do denominador de tarefas esperadas. O mesmo estudo recomenda ceticismo perante diferenças de classificação inferiores a três pontos percentuais até que a configuração da avaliação esteja documentada e alinhada; aplique essa regra também às suas próprias comparações.
Execute avaliações em CI
Uma verificação de release tem de falhar a build quando uma métrica ultrapassa o limite acordado. Caso contrário, a suite de avaliação é apenas um dashboard.
Depois de restaurar a fixture do caso numa tentativa isolada, o teste volta a executar o agente atual sobre o input golden. Não reproduz o trace falhado guardado, o que só mostraria que a execução antiga falhou (esboço; a versão executável é evals/test_agent_regression.py, onde grade() executa todas as verificações, e não apenas os rótulos que criaram o caso):
@pytest.mark.parametrize("golden", GOLDENS, ids=[item["id"] for item in GOLDENS])
def test_agent_regression(golden: dict) -> None:
    answer, fresh_trace = run_agent_and_capture_trace(golden["input"])

    refired = set(flag_failures(fresh_trace)) & set(golden["failure_modes"])
    assert not refired, f"failure mode regressed: {sorted(refired)}"

    assert tool_correctness(
        called=[call["name"] for call in fresh_trace["tool_calls"]],
        expected=golden["expected_tools"],
        mode=golden.get("tool_match", "in_order"),
    ) >= golden.get("tool_threshold", 1.0)
Calibre o juiz antes de confiar nele
Um LLM usado como juiz ajuda. Também é fácil enganarmo-nos com ele.
O G-Eval fez o GPT-4 escrever passos de rubrica antes de pontuar e alcançou uma correlação de Spearman de 0,514 com as avaliações humanas no SummEval, acima das métricas automáticas anteriores. Ponderava cada pontuação pela probabilidade dos tokens; o GPT-4 não expunha essas probabilidades, por isso o artigo estimou-as por amostragem, com 20 amostras. Mantenha a rubrica; não reivindique a ponderação a menos que o seu juiz devolva logprobs. Estes são resultados de sumarização, não de trajetórias de agentes.
O MT-Bench mostrou o GPT-4 a concordar com as preferências humanas aproximadamente tantas vezes quanto os humanos concordam entre si. Esse resultado ajudou a tornar corrente a avaliação com LLMs. Trabalhos posteriores expuseram vieses que exigem, cada um, a sua própria verificação:
| Viés | O que acontece | Verificação ou mitigação |
|---|---|---|
| Posição | Os prompts pairwise favorecem uma das posições | Meça a sensibilidade à ordem; troque a ordem só se isso melhorar as decisões em dados hold-out |
| Verbosidade | Respostas mais longas pontuam mais com a mesma qualidade | Não dê crédito a texto extra que não acrescente conteúdo correto e fundamentado |
| Autopreferência | Um juiz favorece outputs da sua própria família de modelos | Compare juízes da mesma família e de famílias diferentes em rótulos hold-out (estudo) |
| Sicofância | O juiz credita afirmações que o trace não sustenta | Exija evidência do trace no veredicto |
| Deriva de calibração | Uma atualização do modelo ou do prompt desloca as pontuações | Fixe o modelo e o prompt do juiz; recalibre quando mudarem |
O JudgeBench construiu pares de respostas em que uma é objetivamente errada, em conhecimento verificável, raciocínio, matemática e código. Com um prompt de juiz simples, o GPT-4o obteve 50,9%, pouco acima de uma moeda ao ar; o prompt Arena-Hard mais forte do artigo elevou o mesmo modelo apenas a 56,6%. Trocar o modelo sob esse prompt mais forte pesa mais: o Claude 3.5 Sonnet, o melhor juiz generalista testado, chegou a 64,3%, e o o3-mini com esforço de raciocínio elevado chegou a 80,9%. As respostas confiantes mas erradas continuam difíceis para um juiz que não raciocina antes de avaliar.
Trate o juiz como um instrumento de medição: calibre-o com rótulos humanos antes de ele avaliar o que quer que seja e volte a verificá-lo sempre que o modelo ou o prompt do juiz mudar. A figura mostra o ciclo e o seu passo de comparação: que erros do juiz contam contra que rótulos humanos.
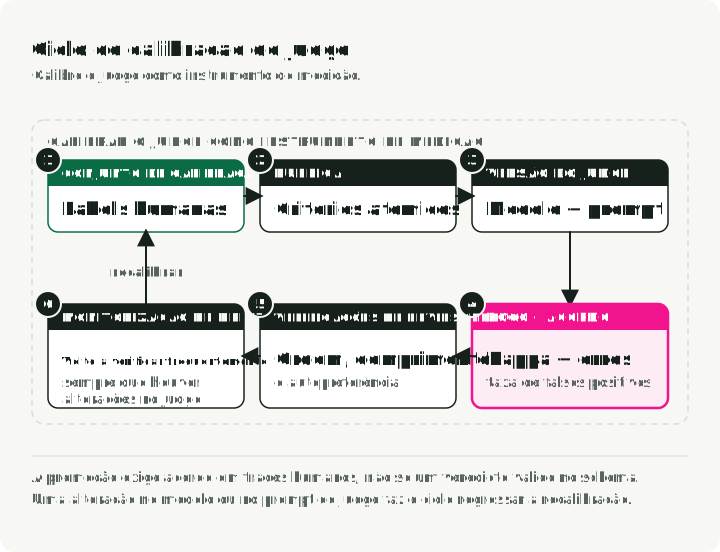
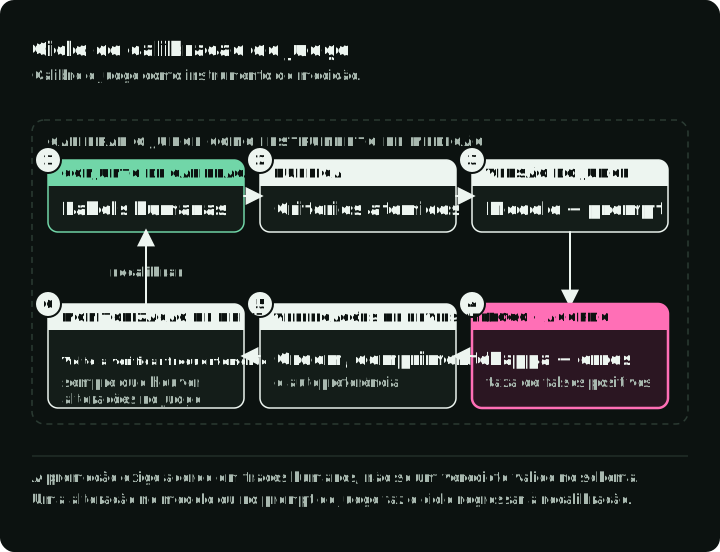
Quando é necessário um juiz, torne o veredicto estruturado. O Schema-Guided Reasoning (SGR) dá ao veredicto um schema para a forma do output e para a inspecionabilidade. Os Structured Outputs ou o constrained decoding podem impor a forma do objeto, os campos obrigatórios e as restrições de valores em campos como evidence, passed_criteria, failed_criteria, failure_mode e passed.
Um veredicto binário com listas de critérios tem este aspeto; o CI compara passed com o rótulo humano:
{
    "type": "object",
    "required": [
        "evidence",
        "passed_criteria",
        "failed_criteria",
        "failure_mode",
        "passed"
    ],
    "properties": {
        "evidence": { "type": "array", "items": { "type": "string" } },
        "passed_criteria": { "type": "array", "items": { "type": "string" } },
        "failed_criteria": { "type": "array", "items": { "type": "string" } },
        "failure_mode": { "type": ["string", "null"] },
        "passed": { "type": "boolean" }
    },
    "additionalProperties": false
}
Coloque os campos de evidência antes do veredicto se isso tornar o registo mais fácil de inspecionar. A ordem dos campos é apresentação, não uma garantia de raciocínio. Um veredicto válido segundo o schema ainda pode conter evidência sem suporte ou um valor passed errado. Use a calibração com rótulos humanos, validadores determinísticos e a revisão de transcrições para testar a fiabilidade do juiz. O CI consegue comparar um objeto JSON estável, mas isso verifica a inspecionabilidade e a forma, não prova que as etapas da rubrica foram seguidas.
Um veredicto estruturado também facilita o teste de um juiz mais barato. Trate um modelo mais barato como candidato, não como substituto automático. Execute-o sobre o mesmo conjunto de calibração com rótulos humanos. Compare a sua concordância, a taxa de falsos passes e a taxa de falsas falhas com as do juiz maior. Use-o em casos de rotina apenas se cumprir os limiares que a sua aplicação definiu. Reserve o juiz maior para desacordos, casos de risco elevado ou execuções de calibração.
Checklist de higiene por omissão para o juiz:
- Prefira pass/fail binário sempre que possível. Escalas de cinco pontos convidam a uma falsa precisão.
- Atribua rótulos a trajetórias que cubram os modos de falha reais antes de finalizar a rubrica. Escolha o tamanho da amostra pela cobertura e pela incerteza que a decisão consegue tolerar e reserve depois casos separados para validação.
- Meça a concordância juiz-humano com o kappa de Cohen, uma matriz de confusão e o recall positivo/negativo. O kappa mede a concordância depois de descontar a concordância esperada por acaso; quanto maior, melhor. Um juiz que diz sempre “pass” não tem discriminação útil, pelo que o kappa pode ser zero ou indefinido. Decida o que fazer quando for indefinido antes de usar a métrica para aprovar uma release.
- Decomponha critérios grosseiros. “O agente verificou a identidade antes da tool call de reembolso?” é melhor do que “A trajetória foi boa?”
- Emita o veredicto através de um schema SGR com evidência, listas de critérios, modo de falha e um campo pass/fail.
- Compare juízes da mesma família e de famílias diferentes com rótulos humanos hold-out; a separação de famílias, por si só, não estabelece fiabilidade.
- Meça a sensibilidade à ordem nos pares. Mantenha a aleatorização ou a agregação com ordem trocada apenas se melhorar as decisões em dados hold-out; um estudo controlado de 2026 concluiu que a troca podia prejudicar em casos adversariais.
- Não dê crédito a texto extra, a menos que acrescente conteúdo correto, relevante e fundamentado. Uma resposta mais longa não é uma resposta melhor.
- Fixe o modelo do juiz, o prompt, o dataset, o schema e a versão da aplicação.
- Recalibre depois de alterações ao modelo, ao prompt, às ferramentas, à política ou ao schema.
Um painel é outro candidato a testar. O PoLL reportou melhor alinhamento com os juízos humanos, menos viés intra-modelo e menor custo do que a sua baseline com um único GPT-4, em seis datasets. Esses resultados pertencem aos seus modelos, tarefas e preços históricos. Não estabelecem que um painel seja mais seguro na sua tarefa. Compare os falsos passes, as falsas falhas, o custo e a carga de trabalho dos desacordos com um único juiz calibrado em rótulos hold-out.
Não existe um limiar de kappa universal que torne um juiz adequado para CI. Reporte a matriz de confusão, o número de rótulos, a taxa de falsos passes entre as falhas humanas e a taxa de falsas falhas entre os passes humanos, com a incerteza. Escolha os limites de release a partir das consequências desses erros. Use filas de revisão quando a evidência for fraca demais para aceitação automática e mantenha a autorização humana para ações com consequências quando o workflow a exigir.
Os guardrails bloqueiam inline, as avaliações online observam depois
As pessoas confundem-nos porque ambos produzem pontuações. A diferença está na colocação: inline no request path, depois da resposta ou antes da release. A figura põe as três colocações numa só linha temporal, com o que cada uma consegue travar.
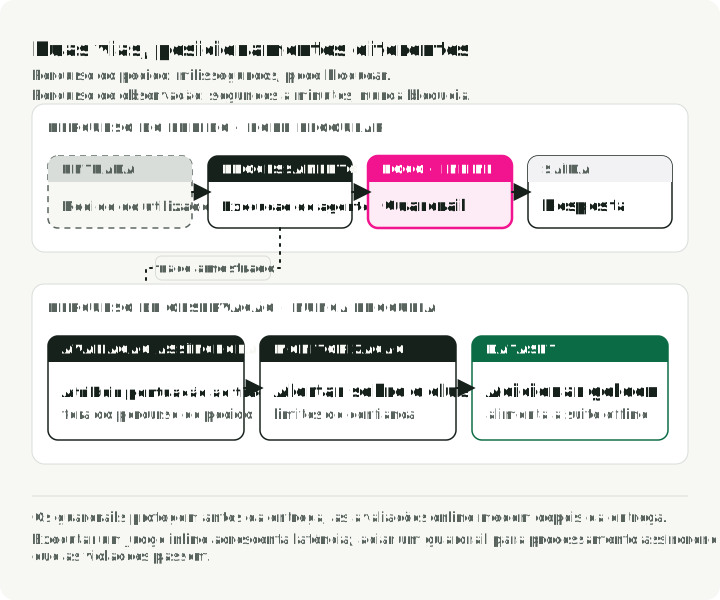
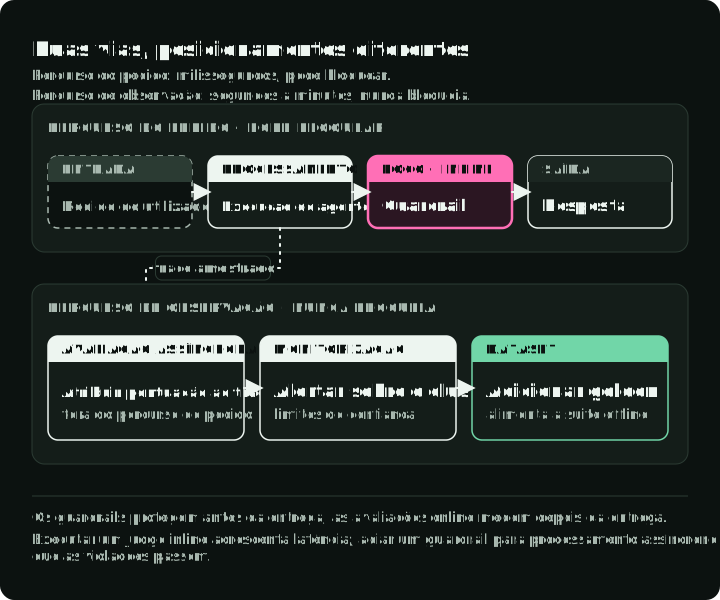
Os guardrails executam-se inline. São rápidos e visíveis para o utilizador. Um guardrail pode bloquear uma tool call, ocultar PII, rejeitar prompt injection ou forçar uma nova tentativa antes de a resposta sair do seu sistema. Um falso positivo é um bug de produção. Um falso negativo é mais silencioso e pior, porque nada no request path o reporta. As verificações de schema, intervalo e política são determinísticas. A deteção de injection e de PII é feita por classificadores, por isso trate as falhas como esperadas e mantenha uma avaliação assíncrona a observar o que deixam passar.
As avaliações online executam-se depois da resposta, normalmente sobre tráfego amostrado. Podem usar LLM juízes mais lentos, porque não estão no caminho da latência. A sua função é detetar deriva, encontrar novos clusters de falhas e alimentar o próximo dataset offline.
As avaliações offline executam-se antes da release. São reproduzíveis. Verificam prompts, modelos, ferramentas, retrievers e políticas contra um dataset fixo.
Cada colocação errada tem um custo:
- Um juiz no request path acrescenta latência e uma nova fonte de instabilidade.
- Um guardrail relegado para pontuação assíncrona deixa as violações de política chegar aos utilizadores.
Nos testes de segurança, distinga a deteção de um ataque, uma ação proibida ser tentada e um efeito nocivo ter realmente sucesso. Reporte os efeitos nocivos bem-sucedidos por tentativa de ataque, com o modelo de ameaça e o orçamento de tentativas, juntamente com o sucesso das tarefas legítimas e os bloqueios indevidos por tentativa benigna. A pontuação de um detetor, por si só, não consegue estabelecer que os dados permaneceram privados nem que uma escrita foi impedida. Use alvos isolados; o relatório de incidente da Anthropic sobre avaliações de cibersegurança documenta por que razão os efeitos de uma avaliação precisam de contenção.
Em sistemas de grande volume, pontue uma amostra pequena com um juiz mais forte e uma amostra maior com classificadores mais baratos. Alerte sobre clusters e limites de confiança, não sobre uma estimativa pontual ruidosa.
Escolhas de tooling
Nenhuma ferramenta isolada cobre todo o ciclo. Compare em separado um armazenamento de traces/datasets e um runner de CI/avaliação; um produto pode cobrir ambos, mas não precisa de comprar os dois ao mesmo fornecedor. A coluna Cobre mostra que papéis cada ferramenta preenche.
| Ferramenta | Cobre | Escolha-a quando… | Limite ou fator de custo |
|---|---|---|---|
| DeepEval | Runner | Executa verificações em Python e pytest; deepeval test run falha a build quando uma métrica falha. | Apenas runner. As chamadas ao modelo juiz custam tokens; a plataforma alojada Confident AI cobra pelos dados de traces armazenados. |
| Inspect AI | Runner | Precisa de tarefas de segurança, de fronteira ou de agentes em sandbox. | Apenas runner, open source. Configura as sandboxes e o acesso aos modelos; não é um armazenamento de traces de produção. |
| Phoenix | Armazenamento de traces, datasets, runner | Exige tracing e avaliações em self-hosting, com os dados na sua infraestrutura. | Gratuito em self-hosting; opera o deployment. O Arize AX alojado cobra por spans, armazenamento e retenção. |
| Langfuse | Armazenamento de traces, datasets, runner | Quer um workflow open source de traces, datasets e experiências, com uma CI action que fixa uma versão do dataset e falha em caso de regressão. | Em self-hosting, opera a sua stack de armazenamento; algumas funcionalidades exigem licença. A cloud cobra por traces, observações e pontuações. |
| LangSmith | Armazenamento de traces, datasets, runner | Já usa LangChain/LangGraph e aceita o limite da sua plataforma. | O self-hosting e o hosting híbrido exigem Enterprise. A cloud cobra por lugares, traces e retenção. |
| Braintrust | Armazenamento de traces, datasets, runner | O feedback gerido em PRs e snapshots de experiências comparáveis importam mais do que o self-hosting. | Serviço gerido; o self-hosting exige Enterprise. Cobra por dados processados, pontuações e retenção. |
| Promptfoo | Runner, red team | Regressões de prompts ou de red team têm de correr antes do deployment. | Runner e testes de red team; sem armazenamento de traces. Open source; os planos pagos acrescentam sondas de red team e funcionalidades de equipa. |
Os fornecedores cobram por unidades diferentes (traces, spans, pontuações, lugares, retenção ou dados processados), por isso compare os preços atuais com o seu próprio volume de traces. Os fatores de custo acima foram verificados nas páginas de preços em outubro de 2026.
A escolha da ferramenta é secundária. Se as falhas de produção não se tornarem casos de teste, está sobretudo a pagar o armazenamento de traces.
Checklist prático de rollout
Construa o pipeline de evidência antes de expandir a pilha de métricas. Comece por decidir de onde vão vir os exemplos.
-
Recolha primeiro as execuções históricas. Se o agente já existe, extraia traces, tickets de apoio, relatórios de bugs, sessões com thumbs-down, transcrições de QA manual e notas de dogfooding antes de alterar a implementação. Se o agente ainda não existe, registe todas as execuções de protótipo e de teste manual desde o primeiro dia.
-
Instrumente a forma do trace. Capture mensagens, tool calls, argumentos, outputs das ferramentas, erros, contagens de tokens, latência, custo, feedback do utilizador, versão da aplicação, versão do prompt, versão do modelo, versão do tool schema e estado final do ambiente. Use as convenções GenAI do OpenTelemetry ou spans ao estilo OpenInference se quiser portabilidade, e fixe a versão da convenção e o adaptador. Capture o conteúdo de forma seletiva: oculte segredos e dados pessoais, restrinja o acesso e defina a retenção antes de promover traces a datasets. Use Langfuse, LangSmith, Phoenix ou Braintrust se quiser desde logo uma UI de traces e um workflow de datasets.
-
Transforme falhas reais em casos semente. Leia os traces antes de os resumir com um modelo. Para cada falha útil, guarde o input, o ID do trace de origem, o estado esperado, os invariantes de ferramentas esperados, o modo de falha, a gravidade e uma nota do revisor. O Langfuse consegue ligar os itens do dataset aos traces de produção; o LangSmith consegue criar datasets a partir de execuções com trace. Mantenha a ligação à origem para que o caso continue auditável.
-
Se não houver histórico, gere casos de arranque a frio. Peça a um LLM que redija tarefas a partir de requisitos do produto, políticas, tool schemas, máquinas de estados e macros de apoio. Cubra os caminhos felizes e falhas como permissões erradas, verificações de identidade em falta, tool results desatualizados, datas ambíguas, novas tentativas depois de limites de taxa e outputs de ferramentas contraditórios.
-
Não confie em casos sintéticos até um humano os rever. Os exemplos sintéticos servem para cobertura, não para verdade. Marque-os com
source: synthetice exija que um revisor aprove o resultado esperado. Execute um caminho de referência sabidamente correto quando possível e valide as expectativas geradas de forma independente; usar outra família de modelos não substitui essa verificação. -
Construa um dataset pequeno e equilibrado. Inclua sucessos, falhas, recusas, casos-limite, casos de muitos turnos, casos sensíveis à política e caminhos alternativos válidos. Não faça do golden “a transcrição antiga exata”. Guarde os campos do exemplo de golden em “Elimine duplicados antes de promover”, incluindo o modo de falha que colocou o caso na suite.
-
Adicione primeiro verificações determinísticas. A ordem obrigatória das ferramentas quando a ordem é política, os argumentos obrigatórios, a validação de schema, os diffs do estado final, os limites de loops, os tetos de tokens e de latência e os invariantes específicos da tarefa devem correr antes de qualquer juiz.
-
Adicione um juiz com forma SGR. Use-o apenas para a parte que precisa de interpretação. Calibre-o com rótulos humanos e teste a rubrica escolhida em casos de validação intocados. Se ele não conseguir separar bons e maus exemplos no conjunto de calibração, corrija a rubrica antes de o ligar ao CI.
-
Ligue o ciclo. Execute a suite offline pequena em CI, execute a suite maior antes da release, pontue online o tráfego de produção amostrado e promova os clusters de falhas online recorrentes de volta ao dataset offline.
A sua primeira suite de avaliação vai falhar casos. Execute-a na mesma e depois adicione as falhas recorrentes como casos. Uma suite que corre todos os dias dá-lhe evidência para a melhorar.
Referências
- trace2evals companion demo repository
- LangChain - State of Agent Engineering
- Anthropic - Demystifying Evals for AI Agents
- Hamel Husain - A Field Guide to Rapidly Improving AI Products
- OpenTelemetry semantic conventions for generative AI systems
- DeepEval Tool Correctness
- DeepEval Task Completion
- DeepEval unit testing in CI/CD
- Inspect running evals
- OpenAI Structured model outputs
- Schema-Guided Reasoning: vLLM, xgrammar, and Pydantic
- Phoenix self-hosting
- Langfuse datasets and versioning
- Langfuse experiments in CI/CD
- LangSmith platform setup
- LangSmith - Create and manage datasets programmatically
- Braintrust - Create experiments
- Phoenix LLM evals
- Promptfoo GitHub Action integration
- tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- Why Do Multi-Agent LLM Systems Fail?
- Establishing Best Practices for Building Rigorous Agentic Benchmarks
- G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
- Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models
- JudgeBench: A Benchmark for Evaluating LLM-based Judges
- Self-Preference Bias in LLM-as-a-Judge