Evaluación de agentes de AI en producción: de las trazas a las suites de tests

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta guía es para ingenieros que evalúan agentes de AI que usan herramientas en producción. Aprenderás a convertir ejecuciones fallidas en tests repetibles, a comprobar tanto las acciones del agente como sus respuestas y a usar esos tests antes de la siguiente release.
Para una comparación breve de herramientas, consulta Mejores herramientas de evaluación de agentes de AI.
Por qué los evals de agentes son diferentes
Los evals tradicionales de LLM suelen puntuar un único par entrada-salida: relevancia, fidelidad, corrección, seguridad y quizá estilo. Los agentes añaden planificación, tool calls, reintentos y comprobaciones de finalización, y cada paso es un nuevo lugar donde fallar.
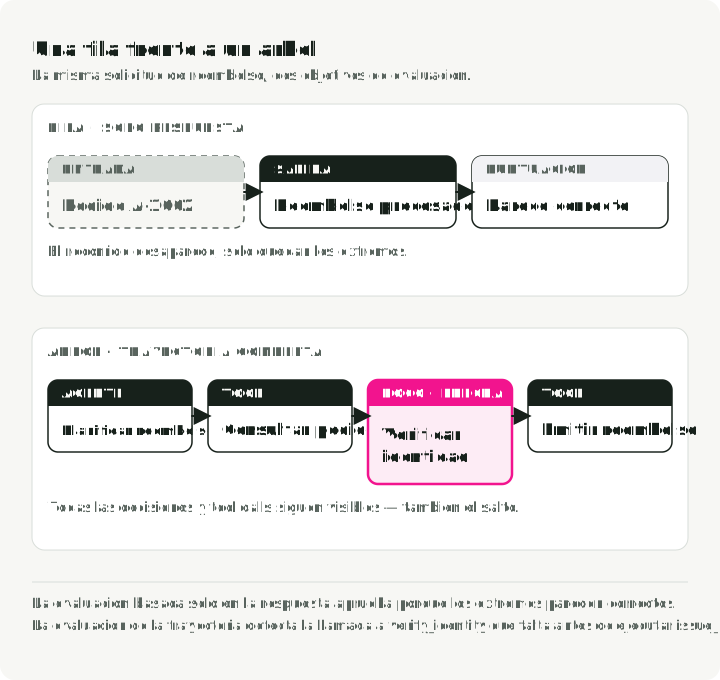
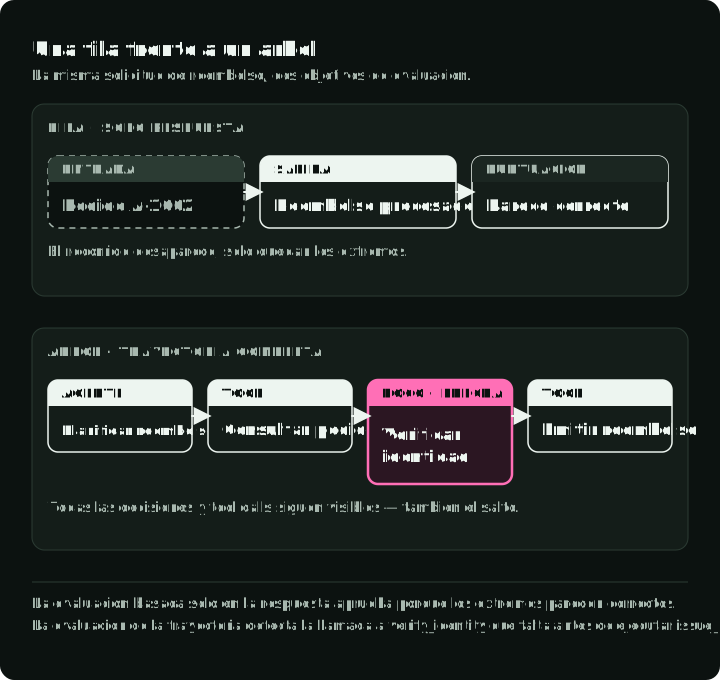
Piensa en un agente de reembolsos. La transcripción puede terminar bien mientras la traza es incorrecta:
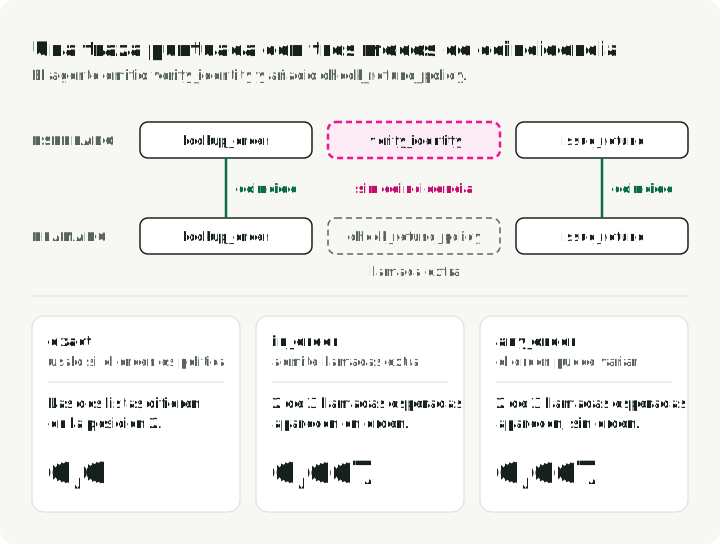
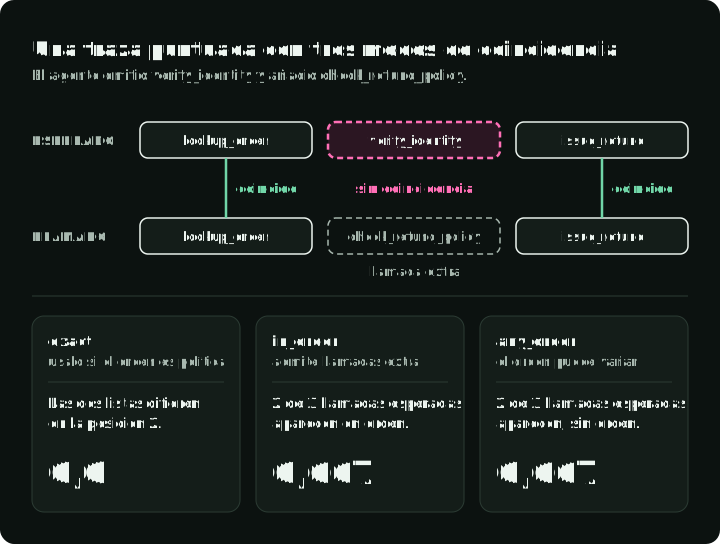
lookup_order -> issue_refund -> final_answerEl eval de la salida pasa. Un eval de trayectoria debería fallar porque verify_identity no se ejecutó nunca antes de issue_refund. En los agentes que usan herramientas, los evals que solo miran la respuesta pueden detectar fallos de calidad del contenido, pero no pueden establecer que el agente siguiera una trayectoria válida ni que produjera los efectos secundarios requeridos.
La tarjeta izquierda es la fila que lee un eval que solo mira la respuesta; la tarjeta derecha es la traza que lee un eval de trayectoria, con la comprobación de identidad omitida.
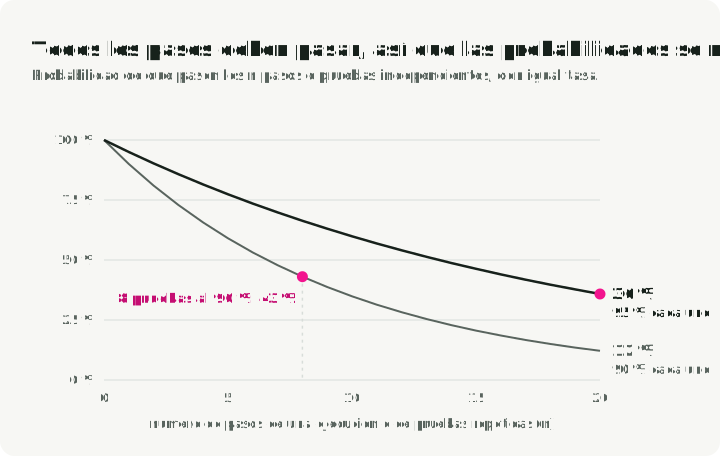
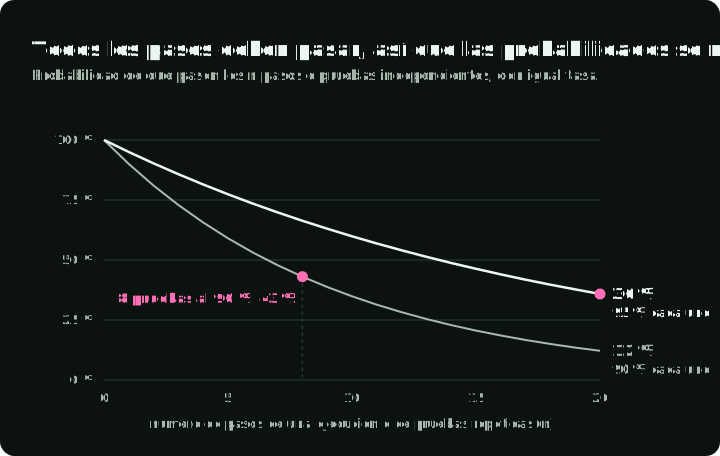
Hay un segundo problema: los errores se acumulan. Si un workflow tiene 20 pasos obligatorios, cada paso tiene éxito de forma independiente y todos tienen la misma fiabilidad del 95 %, su tasa de éxito de extremo a extremo ronda el 36 %:
Así, el agente puede parecer sólido en comprobaciones aisladas y aun así fallar la mayoría de las ejecuciones completas. El fallo suele estar en algún punto intermedio, y encontrarlo requiere visibilidad a nivel de componente, no mirar otra vez la respuesta.
tau-bench plantea al agente tareas de atención al cliente de aerolíneas y de comercio minorista. El agente conversa con un usuario simulado, llama a APIs y debe respetar la política del dominio. Tras la conversación, el evaluador comprueba si la base de datos alcanzó el estado objetivo anotado. Una transcripción verosímil con las filas equivocadas sigue fallando.
Con esa evaluación, GPT-4o resolvió solo el 35,2 % de las tareas de aerolíneas y algo más del 60 % de las de comercio minorista. El artículo también introdujo pass^k: la probabilidad de que pasen todas las k pruebas independientes, promediada entre tareas.
El comercio minorista, la división más fácil, tenía un pass^8 inferior al 25 %. Para una tarea de comercio minorista elegida al azar y ocho pruebas independientes, la probabilidad de que pasaran las ocho ejecuciones era inferior al 25 %. Un eval de una sola ejecución no puede medir esa consistencia.
El gráfico muestra ambos casos: la probabilidad de que pasen todos los pasos o todas las pruebas baja con cada uno que añades. Con un 90 % por paso la caída es más pronunciada: si cada uno de 20 pasos independientes pasa el 90 % de las veces, los 20 pasan aproximadamente el 12 % de las veces (0,9^20 ≈ 0,12).
MAST estudia por qué fallan los agentes. Los autores construyeron una taxonomía de 14 modos de fallo a partir de 150 trazas anotadas a mano y la aplicaron después a más de 1600 trazas de 7 frameworks multi-agent populares. La taxonomía incluye definiciones de rol vagas (diseño del sistema), un agente que ignora lo que otro agente ha comunicado (desalineación entre agentes) y dar por buena una ejecución sin comprobar el resultado (falta de verificación). Estos fallos apuntan a los prompts, a la lógica de orquestación y a las comprobaciones que faltan en el harness. Un modelo base más potente no puede ejecutar un paso de verificación que nunca se construyó, así que el objetivo de la evaluación debe incluir el harness que rodea al modelo.
La brecha de adopción
La encuesta State of Agent Engineering de LangChain (1340 encuestados, realizada a finales de 2025) sugiere que muchos equipos ya tienen la materia prima para mejores evals. Indica que el 89 % tenía algún tipo de observabilidad, el 52,4 % ejecutaba evals offline y el 37,3 % ejecutaba evals online.
La encuesta también indica que el 57,3 % de los encuestados ya tiene agentes en producción. Al preguntarles qué bloquea la producción, el 32 % citó la calidad y el 20 % la latencia. Es una encuesta de un proveedor sobre sus propios encuestados, no un censo de equipos de agentes, pero deja ver una brecha útil entre recoger trazas y evaluar de forma sistemática.
Eso deja a los equipos en un punto intermedio incómodo: pueden inspeccionar una mala ejecución a posteriori y aun así lanzar el mismo fallo dos veces.
Cada fallo de producción diagnosticado debería dejar una traza, una etiqueta, una fila de dataset y un scorer. Un fallo repetible pertenece a la suite de regresión.
Elige las métricas según el modo de fallo
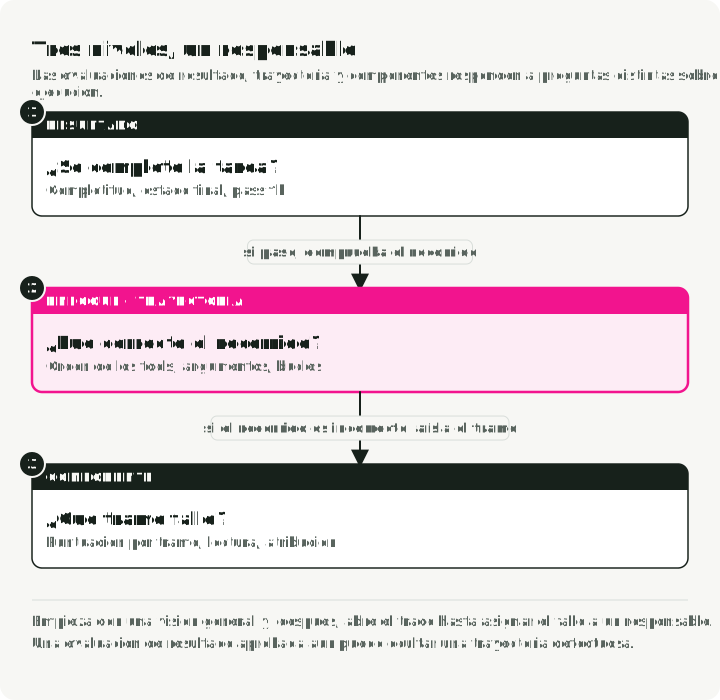
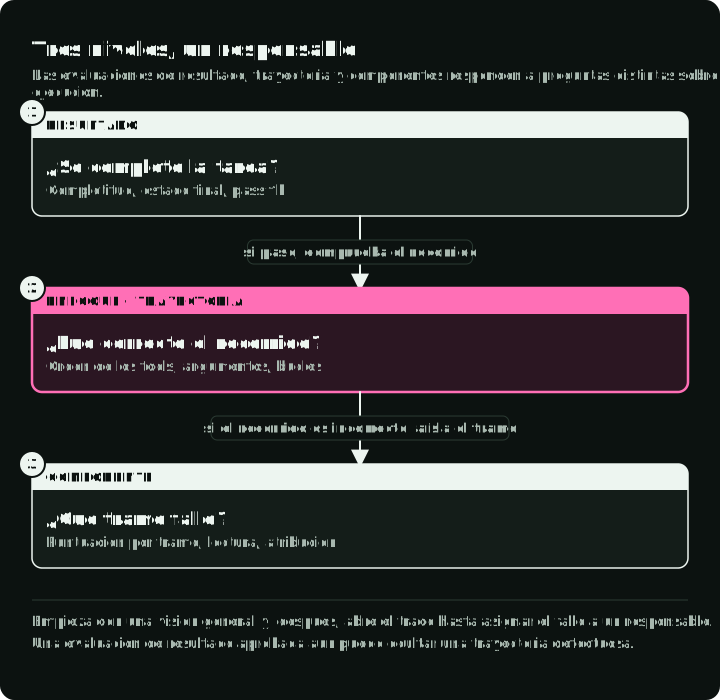
Elige la métrica según el fallo que necesitas detectar. La división útil tiene tres niveles:
- Los evals de resultado responden si la tarea tuvo éxito.
- Los evals de trayectoria responden si el camino fue válido, eficiente y conforme a la política.
- Los evals de componente responden qué herramienta, retriever, sub-agente o paso de decisión falló.
La figura muestra qué parte de la misma ejecución lee cada nivel.
Cada nivel puede ejecutarse offline sobre casos fijos y reproducibles antes de la release, o online sobre trazas de producción muestreadas después de la respuesta. La sección sobre guardrails más abajo detalla esa división. Los evals offline pueden exigir goldens: casos almacenados que emparejan una entrada con el resultado, las invariantes de herramientas y los argumentos que debe producir una ejecución correcta. Un golden completo aparece más abajo, en «Deduplica antes de promocionar». Los evals online deberían preferir invariantes, distribuciones y comprobaciones asíncronas que se queden fuera de la ruta de la petición.
| Pregunta | Familia de métricas | Contrato offline / online | ¿Determinista o juez? | Ten cuidado con |
|---|---|---|---|---|
| ¿Llamó el agente a las herramientas correctas? | Corrección de herramientas: coincidencia exacta, en orden o sin orden | Goldens exactos offline; invariantes de herramientas obligatorias y anomalías online | Determinista | La coincidencia exacta penaliza caminos alternativos válidos |
| ¿Las llamó con las entradas correctas? | Corrección de argumentos, validación de esquema, coincidencia de parámetros | Argumentos esperados offline; comprobaciones de esquema, rango y política online | Ambos | La herramienta correcta con argumentos erróneos sigue rota |
| ¿Desperdició pasos? | Eficiencia de pasos, número de reintentos, detección de bucles, coste y latencia | Presupuestos de pasos y bucles offline; deriva de coste y latencia online | Sobre todo determinista | Una alta finalización de tareas puede ocultar un deambular caro |
| ¿Tuvo éxito de verdad la tarea? | Finalización de tareas, evaluación del resultado, diff del estado final | Simulador o estado golden offline; estado final, señal del usuario o juez asíncrono online | Juez o comprobación de estado | Evalúa el estado del entorno siempre que sea posible |
| ¿Conservó el contexto a lo largo de los turnos? | Fidelidad multi-turno, adherencia al rol, completitud de la conversación | Casos de largo horizonte con guion offline; sesiones largas muestreadas online | Juez | Los tests de un solo turno no dicen nada del turno 14 |
| ¿Se detuvo en el momento correcto? | Corrección de la terminación, éxito prematuro, trabajo sin fin | Tests de escenarios offline; monitores de bucles, timeouts y falsos éxitos online | Ambos | «Hecho» puede ser un estado alucinado |
| ¿Interpretó bien los tool results? | Comprensión de tool results, comprobaciones del estado posterior | Salidas adversarias de herramientas offline; comprobaciones del estado posterior y revisión muestreada online | Ambos | Evalúa el estado posterior, no el código de salida de la herramienta |
Empieza por las métricas deterministas. Se repiten con entradas y código fijos y cuesta poco ejecutarlas. Sus reglas pueden quedar obsoletas cuando cambian las herramientas o la política, así que versiona el scorer junto con la especificación que comprueba.
Elige el comprobador según el criterio: código cuando el código puede comprobarlo, una cola de revisión mientras no exista un juez calibrado, una persona cuando el veredicto inicia una acción con consecuencias y un juez LLM calibrado para el resto.
Corrección de los tool calls
La corrección de herramientas compara las herramientas llamadas con las esperadas. Elige el grado de rigor de forma deliberada:
- Coincidencia exacta: la secuencia debe coincidir exactamente. Úsala cuando el orden sea política, por ejemplo
lookup_order -> verify_identity -> issue_refund. - Coincidencia en orden: las herramientas requeridas deben aparecer en el orden relativo correcto, pero se permiten llamadas extra inofensivas.
- Coincidencia sin orden: las herramientas requeridas deben aparecer, pero el orden puede variar.
La figura puntúa una traza con los tres modos. El agente omitió verify_identity e hizo una llamada extra a check_refund_policy.
Un scorer local pequeño basta para empezar:
from collections import Counter

def tool_correctness(called: list[str], expected: list[str], mode: str = "in_order") -> float:
    if mode not in {"exact", "in_order", "any_order"}:
        raise ValueError(f"unknown matching mode: {mode}")
    if mode == "exact":
        return float(called == expected)
    if not expected:
        return 1.0
    if mode == "any_order":
        matched = sum((Counter(called) & Counter(expected)).values())
        return matched / len(expected)

    rows = [[0] * (len(expected) + 1) for _ in range(len(called) + 1)]
    for i, tool in enumerate(called):
        for j, wanted in enumerate(expected):
            if tool == wanted:
                rows[i + 1][j + 1] = rows[i][j] + 1
            else:
                rows[i + 1][j + 1] = max(rows[i][j + 1], rows[i + 1][j])
    return rows[-1][-1] / len(expected)

called = ["lookup_order", "check_refund_policy", "issue_refund"]
expected = ["lookup_order", "verify_identity", "issue_refund"]

print(round(tool_correctness(called, expected, "exact"), 3))     # 0.0
print(round(tool_correctness(called, expected, "in_order"), 3))  # 0.667
assert tool_correctness(["issue_refund"], [], "exact") == 0.0
assert tool_correctness([], [], "exact") == 1.0
assert tool_correctness(["a", "b"], ["a", "a", "b"], "any_order") == 2 / 3
try:
    tool_correctness([], [], "typo")
except ValueError:
    pass
else:
    raise AssertionError("unknown modes must fail")
La puntuación in_order es el recall de la subsecuencia común más larga: qué fracción de la secuencia requerida sobrevivió, en el orden correcto. Fíjate en lo que ignora. Las llamadas inútiles no la reducen, así que un agente puede obtener 1,0 aquí haciendo el doble de llamadas de las necesarias. Cuando las llamadas extra cuestan dinero o modifican el estado, sigue también la precisión (llamadas requeridas coincidentes entre el total de llamadas) y lee ambas juntas. El recall detecta el paso que falta; la precisión detecta el deambular. Una buena puntuación de herramientas no hace segura una devolución o una escritura extra. Comprueba cada llamada que cambia el estado por separado: permisos, recurso, argumentos y la verificación que debe ir antes. Si no se espera ninguna herramienta, solo el modo exact falla una ejecución que llama a herramientas; los otros dos modos devuelven 1,0.
La métrica Tool Correctness de DeepEval expone las mismas opciones mediante should_consider_ordering y should_exact_match.
Corrección de los argumentos
Llamar a la herramienta correcta con los argumentos equivocados suele ser peor que llamar a la herramienta equivocada, porque la traza parece normal.
En los casos simples, valida el JSON Schema y los valores exactos. En los casos semánticos, guarda los argumentos esperados junto al caso, como hace el campo expected_arguments del golden de «Deduplica antes de promocionar», y evalúa las diferencias. Una métrica sobre el nombre de la herramienta no detecta 2026-06-17 cuando la política exige 2026-06-19.
Para esta ilustración de una llamada por herramienta, la coincidencia de parámetros es la fracción de tripletas (tool, key, value) esperadas que el agente acertó. Los diccionarios de abajo solo son válidos cuando cada herramienta relevante tiene como máximo una invocación. No los construyas sobrescribiendo llamadas anteriores con el mismo nombre: eso ocultaría un reembolso erróneo seguido de uno correcto. Para llamadas repetidas, conserva los ID de llamada y el orden, empareja la invocación prevista y valida cada mutación por separado.
def argument_correctness(called_args: dict, expected_args: dict) -> float:
    total = matched = 0
    for tool, params in expected_args.items():
        for key, want in params.items():
            total += 1
            if key in called_args.get(tool, {}) and called_args[tool][key] == want:
                matched += 1
    return matched / total if total else 1.0

assert argument_correctness({}, {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {}},
                            {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {"date": None}},
                            {"reschedule_delivery": {"date": None}}) == 1.0
La igualdad exacta es adecuada para ID, enums y fechas ya normalizadas a un solo formato. Es inadecuada para texto libre, floats y fechas en la forma que haya producido el modelo, donde == marca como incorrecta una respuesta correcta. Evalúa esos campos con sus propios criterios: coincidencia de cadenas normalizadas, análisis de fechas, tolerancia numérica. La métrica sigue siendo la misma; cambia el comparador de cada campo.
Eficiencia, bucles y callejones sin salida
Un agente que completa la tarea tras cinco tool calls redundantes sigue mostrando un problema de planificación y cuesta más de ejecutar.
Señales baratas con las que empezar:
- Tasa de llamadas redundantes: tool calls idénticas con argumentos idénticos repetidas más de dos veces.
- Anomalías en la forma de la traza: picos repentinos de profundidad, número de tool calls, número de tokens, latencia o coste.
- Convergencia del camino: cuánto se acerca la ejecución al camino válido más corto conocido para la tarea.
- Corrección de la terminación: si el agente se detuvo pronto, siguió trabajando tras el éxito o declaró el éxito sin el cambio de estado requerido.
- Adherencia al plan: si el agente escribe un plan antes de actuar, comprueba si la traza lo siguió. Un buen plan ignorado y un mal plan seguido a la perfección fallan ambos, por razones opuestas, y la diferencia entre el plan y la traza te dice cuál es el caso.
Ejecuta estas comprobaciones antes que un juez siempre que puedas. Un detector de bucles son unas pocas líneas sobre la traza y no necesita ningún modelo. Este cuenta la llamada idéntica más repetida de una traza:
import json

def redundant_call_count(tool_calls: list[dict]) -> int:
    seen: dict[str, int] = {}
    for call in tool_calls:
        key = call["name"] + json.dumps(call["arguments"], sort_keys=True)
        seen[key] = seen.get(key, 0) + 1
    return max(seen.values(), default=0)

calls = [{"name": "lookup_order", "arguments": {"order_id": "A-100"}}] * 3
assert redundant_call_count(calls) == 3
assert redundant_call_count([]) == 0
Marca una traza cuando el recuento sea superior a 2. El repositorio complementario usa la misma regla.
Finalización de tareas y evaluación del resultado
Juzgada por el resultado, la pregunta es «¿obtuvo el usuario lo que pidió?»
Dos patrones funcionan mejor:
- Juicio de finalización de tareas sin referencia: extrae el objetivo de la entrada y juzga si la traza más la respuesta final lo lograron. Funciona online porque el tráfico de producción rara vez tiene salidas golden.
- Evaluación del estado del entorno: compara las filas de la base de datos, los archivos, los tickets, las reservas o los registros finales con un estado objetivo anotado. Es más robusto que comparar transcripciones, porque los agentes pueden encontrar caminos válidos que tú no anotaste.
La segunda opción es mejor cuando puedes construirla. Evalúa el estado final; usa la transcripción para explicar un fallo.
La evaluación del estado tiene dos límites. Una auditoría de 2025 de benchmarks agentic descubrió que tau-bench evalúa algunas tareas únicamente por el estado de la base de datos. En algunas tareas, el resultado anotado no exige ningún cambio de estado ni un texto concreto. Un agente que no hace nada puede entonces aprobar: el 38 % en la división de aerolíneas y el 6,0 % en la de comercio minorista, para cualquier k. Anthropic informó de una ejecución de Opus 4.5 que «falló» una tarea de reserva en tau2-bench, el benchmark sucesor. El agente encontró un resquicio en la política que daba al usuario un mejor resultado. Evaluar el estado es mejor que comparar transcripciones, pero el estado objetivo sigue siendo una anotación, y las anotaciones tienen errores. Audita los casos que pasan con demasiada facilidad, no solo los que fallan.
Evals de componentes
Las métricas de resultado y de trayectoria te dicen que la ejecución falló y, más o menos, dónde. Los evals de componentes puntúan un solo span: si el chunk recuperado era relevante, si el sub-agente devolvió el esquema que esperaba quien lo llamó, si la propia respuesta de la herramienta se pudo analizar. Asocia la puntuación al span y no a la ejecución, de modo que «qué herramienta se degradó esta semana» sea una consulta y no una nueva ejecución.
Tres comprobaciones cubren la mayor parte:
- Puntuación por span: ejecuta la métrica que encaje con el tipo de span. A los spans de recuperación se les aplican recall y precisión frente al chunk anotado, a los spans de sub-agente la validación de esquema más su propia puntuación de corrección de herramientas, y a los spans de herramienta la tasa de errores y la latencia.
- Interpretación de los tool results: dale al agente una salida de herramienta correcta pero incómoda (una lista vacía, una coincidencia parcial, una marca de tiempo obsoleta) y comprueba qué hace después. Una herramienta puede ser correcta mientras el agente la lee mal, y ese fallo aflora dos pasos más tarde.
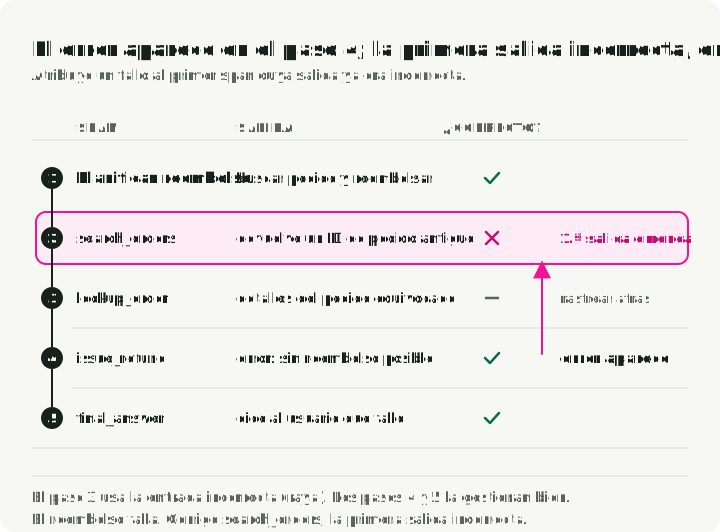
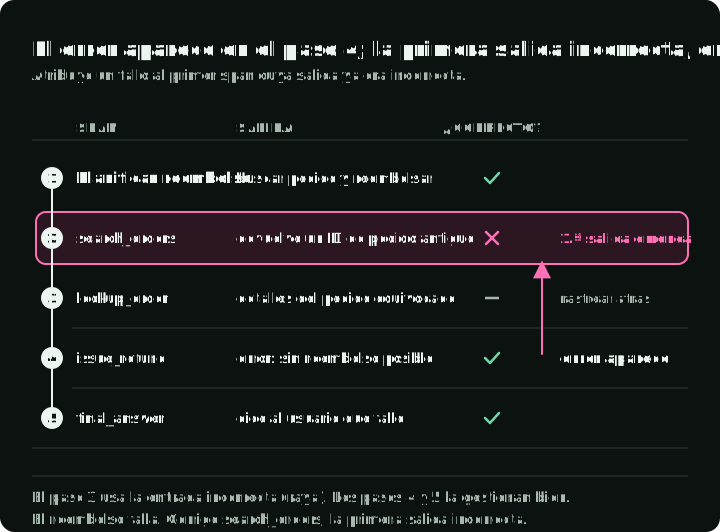
- Atribución del fallo: el fallo visible suele estar aguas abajo del real. Atribúyelo al primer span cuya salida ya era incorrecta, no al paso que lanzó el error.
La figura muestra una ejecución de reembolso de cinco spans. El agente planea encontrar el pedido y reembolsarlo. search_orders devuelve un ID de pedido antiguo, lookup_order recupera ese pedido equivocado, issue_refund lanza un error porque el pedido no se puede reembolsar y final_answer le dice al usuario que el reembolso falló. El error aparece en issue_refund (paso 4), pero la primera salida incorrecta vino de search_orders (paso 2), dos spans antes.
Aquí es donde se aplica el cálculo de los 20 pasos del inicio. Si 20 pasos parecen correctos por separado, la ejecución aún puede fallar la mayor parte del tiempo. Las tasas de acierto por span muestran qué paso va al 95 % y cuál va al 70 %.
El ciclo de las trazas a los evals
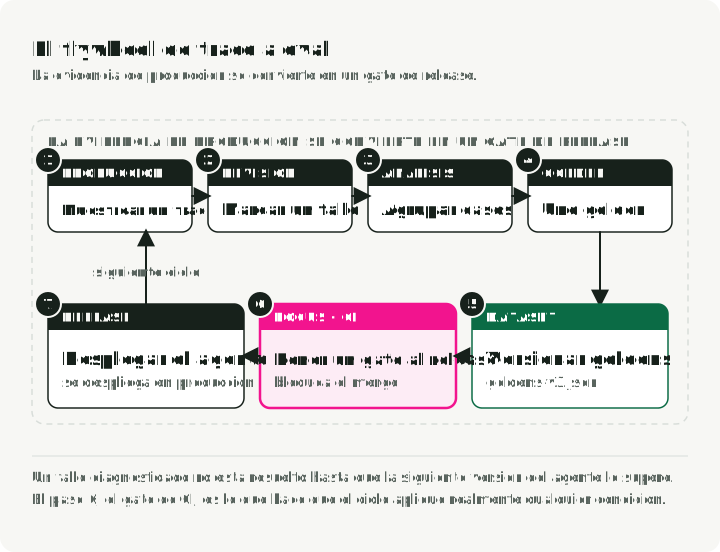
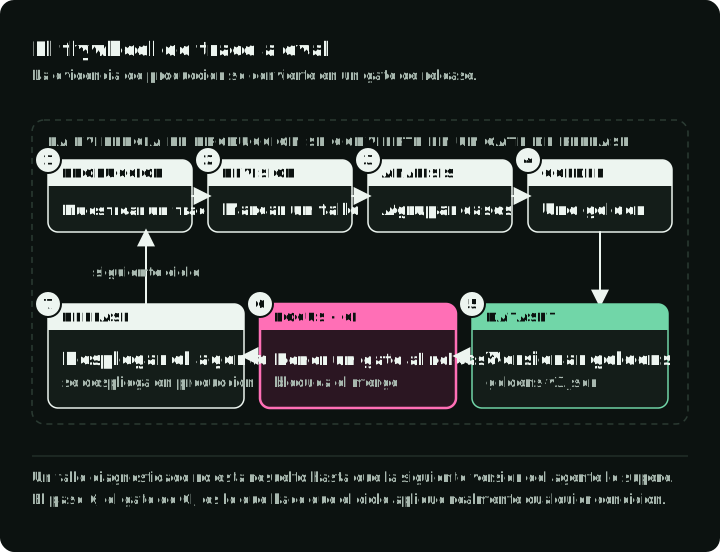
Extrae los fallos de producción antes de inventar más casos de eval. Cada paso numerado de la figura se corresponde con la lista de abajo.
El bucle:
- Captura suficiente evidencia de la traza para reconstruir el fallo, con el contenido sensible bajo control.
- Etiqueta qué falló.
- Agrupa los fallos similares.
- Conserva goldens representativos, incluidas las variantes que necesitan resultados distintos. Un revisor aprueba cada resultado esperado.
- Versiona el dataset.
- Ejecútalo en CI.
- Sigue puntuando online trazas de producción muestreadas.
El repositorio complementario trace2evals demuestra este workflow con un agente de soporte defectuoso. Registra las tool calls y el estado de la tienda en JSONL local de OpenTelemetry, detecta fallos con reglas deterministas y emite candidatos de revisión versionados. Un revisor debe definir y aprobar sus resultados esperados antes de usarlos como tests de release.
Ejecuta uv sync --locked y make demo en ese repositorio. No hace falta ninguna clave de API: un agente con guion repite errores plantados. La demo registra seis ejecuciones, encuentra cuatro peticiones fallidas y las escribe como candidatos de revisión. Después ejecuta diez tareas de referencia en tres configuraciones. El agente v1 con errores falla cinco. El agente v2 corregido pasa las diez, tanto cuando las herramientas comprueban los permisos como cuando solo el prompt pide las comprobaciones. Los informes son data/demo/red.json, prompt-only.json y green.json. El README explica la ejecución en vivo opcional con un modelo de OpenAI.
La demo usa casos sintéticos, herramientas en memoria y un esquema de trazas propio del repositorio; su adaptador no acepta exportaciones arbitrarias de OpenTelemetry.
Extrae fallos mediante análisis de errores
Hamel Husain y Shreya Shankar enseñan un workflow de análisis de errores para este paso; la guía práctica de Hamel lo recorre: inspecciona conversaciones reales, toma notas abiertas, categoriza los fallos y construye tests específicos. Los dos primeros pasos toman sus nombres de la investigación cualitativa, lo que ayuda si buscas el método en otras fuentes.
- Codificación abierta (open coding): inspecciona las trazas y escribe notas abiertas sobre lo que salió mal.
- Codificación axial (axial coding): agrupa las notas en categorías de fallo con nombre.
- Etiqueta las trazas según esa taxonomía.
- Construye tests específicos para los clústeres accionables más grandes.
No empieces con etiquetas como reasoning_issue o tool_problem. Son demasiado vagas para convertirlas en un test. Usa etiquetas como missing_identity_verification, date_argument_mismatch, retried_same_tool_after_429 o stopped_before_database_update. Una etiqueta tan específica te dice exactamente qué debe afirmar el test de regresión.
Deduplica antes de promocionar
Un error habitual es añadir a la suite cada traza mala. Eso crea un dataset grande, caro y estrecho. Pasa con los casi duplicados de marzo y no detecta la nueva forma del mismo bug en junio.
Agrupa primero. Empieza con un golden representativo por clúster y conserva después las variantes con distintos permisos, argumentos, estados de recuperación o resultados esperados. Que dos casos de política se parezcan en la redacción no los hace equivalentes. Guarda los ID de las trazas relacionadas en metadatos con acceso controlado, para que un revisor pueda inspeccionar la evidencia más tarde.
Si un clúster de fallos reaparece tras una corrección, el caso de regresión no generalizó. Revisa el clúster y añade las variantes de comportamiento que faltan en lugar de acumular transcripciones casi idénticas.
Un golden promocionado guarda la entrada, las trazas de origen, el conjunto al que pertenece, la etiqueta de fallo que lo creó, las herramientas, los argumentos y el estado final esperados, y quién lo aprobó. Estos son los campos que usan los pasos de promoción del repositorio complementario:
{
    "id": "reschedule-date",
    "input": "Reschedule order A-100 for June 19, 2026.",
    "source_trace_ids": ["tr_2417"],
    "split": "regression",
    "failure_modes": ["date_argument_mismatch"],
    "expected_tools": ["lookup_order", "reschedule_delivery"],
    "tool_match": "in_order",
    "expected_arguments": {
        "reschedule_delivery": { "order_id": "A-100", "date": "2026-06-19" }
    },
    "expected_state": {
        "reschedules": [{ "order_id": "A-100", "date": "2026-06-19" }],
        "refunds": []
    },
    "review_status": "approved",
    "reviewed_by": "support-policy-owner"
}
expected_state permite que el test evalúe la tienda tras la ejecución. split mantiene el caso fuera de los conjuntos reservados, que trata la siguiente sección.
Versiona el dataset
Versiona los datasets igual que versionas los prompts y el código. Cuando cambie algo relevante (modelo, prompt, tool schema, prompt del juez o comportamiento de la aplicación), conviene ejecutar la misma versión del dataset antes y después.
La comprobación de CI debería fijar:
- versión del dataset
- versión de la aplicación
- versión del prompt
- modelo del juez
- prompt del juez
- versión del código del evaluador
- tool schemas, política y configuración del harness y de la gestión del contexto
- revisión del modelo y ajustes de razonamiento y muestreo
- fixture inicial del entorno y efectos externos permitidos
Si cualquiera de ellos cambia, no puedes saber qué cambio causó la diferencia. Un archivo goldens-v3.json en git es suficiente a pequeña escala. Los snapshots nativos de herramientas como Langfuse, Phoenix, Braintrust o LangSmith ayudan cuando el dataset pasa a ser colaborativo.
Mantén separadas las regresiones de desarrollo, los ejemplos de calibración del juez, la validación reservada y las muestras de monitorización. Agrupa las sesiones, los usuarios y las tareas relacionados antes de dividir, para que los casi duplicados no se filtren entre conjuntos. Cuando un caso moldea un prompt o una rúbrica, trátalo como evidencia de desarrollo. Una suite de fallos extraídos prueba regresiones conocidas; su media no estima la tasa de éxito en producción.
Restablece el estado mutable en cada prueba: archivos, filas de la base de datos, cachés y fixtures de herramientas. Aísla las credenciales y los efectos externos, y mantén iguales los presupuestos del candidato y de la línea base. Informa del número de tareas por separado del de pruebas, junto con todos los intentos iniciados, los timeouts, los fallos y los resultados no puntuables. Compara resultados emparejados sobre las mismas tareas. Estas decisiones siguen el enfoque de pruebas limpias y evaluación del resultado descrito en la guía de evaluación de Anthropic.
Fija las versiones de benchmarks y sandboxes
Las cifras de tau-bench de la primera sección explican la fiabilidad con pruebas repetidas; no son una clasificación actual de modelos. Los benchmarks públicos cambian tareas y evaluadores entre versiones, y las puntuaciones de distintas versiones del evaluador no son comparables. El repositorio mantenido de tau-bench publicó una corrección de este tipo en julio de 2026. Fija las revisiones de las tareas y del evaluador además del modelo, y vuelve a puntuar las trayectorias guardadas cuando cambie una anotación.
Elige un benchmark que ejercite la interfaz desplegada. Los tests de atención al cliente solo de texto no pueden establecer cómo gestiona las interrupciones un agente de voz. Las tareas de recuperación de conocimiento también necesitan el corpus, la configuración de búsqueda y la evidencia disponible en cada turno. Toma prestadas estas formas de tarea para casos de regresión locales en lugar de importar la posición de una clasificación pública como criterio de release.
El sandbox también forma parte del test. El estudio de infraestructura de Anthropic de febrero de 2026 encontró una diferencia de seis puntos porcentuales en Terminal-Bench 2.0 entre sus configuraciones de recursos estricta y sin límite, con el mismo modelo, harness y tareas. El margen extra redujo los fallos de infraestructura y además permitió estrategias de solución distintas. Registra las garantías y los límites de CPU y RAM, los timeouts, la concurrencia, el acceso a la red y la gestión de errores de infraestructura. Informa de esos fallos por separado, sin excluirlos en silencio del denominador de tareas esperadas. El mismo estudio recomienda ser escéptico con las diferencias de menos de tres puntos porcentuales en las clasificaciones hasta que la configuración de la evaluación esté documentada y alineada; aplica esa regla también a tus propias comparaciones.
Ejecuta evals en CI
Una comprobación de release debe hacer fallar la build cuando una métrica cruza el límite acordado. De lo contrario, la suite de evals es solo un dashboard.
Tras restaurar el fixture del caso en una prueba aislada, el test ejecuta el agente actual con la entrada del golden. No reproduce la traza fallida almacenada, lo que solo demostraría que la ejecución antigua falló (esbozo; la versión ejecutable es evals/test_agent_regression.py, donde grade() ejecuta todas las comprobaciones, no solo las etiquetas que crearon el caso):
@pytest.mark.parametrize("golden", GOLDENS, ids=[item["id"] for item in GOLDENS])
def test_agent_regression(golden: dict) -> None:
    answer, fresh_trace = run_agent_and_capture_trace(golden["input"])

    refired = set(flag_failures(fresh_trace)) & set(golden["failure_modes"])
    assert not refired, f"failure mode regressed: {sorted(refired)}"

    assert tool_correctness(
        called=[call["name"] for call in fresh_trace["tool_calls"]],
        expected=golden["expected_tools"],
        mode=golden.get("tool_match", "in_order"),
    ) >= golden.get("tool_threshold", 1.0)
Calibra el juez antes de confiar en él
Usar un LLM como juez ayuda. También es fácil engañarse con él.
G-Eval hizo que GPT-4 escribiera los pasos de la rúbrica antes de puntuar y alcanzó una correlación de Spearman de 0,514 con las valoraciones humanas en SummEval, por encima de las métricas automáticas anteriores. Ponderaba cada puntuación por la probabilidad de los tokens; GPT-4 no exponía esas probabilidades, así que el artículo las estimó muestreando 20 veces. Conserva la rúbrica; no afirmes la ponderación a menos que tu juez devuelva logprobs. Son resultados de resumen de textos, no de trayectorias de agentes.
MT-Bench mostró que GPT-4 coincidía con las preferencias humanas casi tanto como los humanos coinciden entre sí. Ese resultado ayudó a popularizar el uso de LLM como jueces. Trabajos posteriores sacaron a la luz sesgos que requieren cada uno su propia comprobación:
| Sesgo | Qué ocurre | Comprobación o mitigación |
|---|---|---|
| Posición | Los prompts por pares favorecen una de las posiciones | Mide la sensibilidad al orden; intercambia el orden solo si mejora las decisiones en el conjunto reservado |
| Verbosidad | Las respuestas más largas puntúan más con la misma calidad | No des crédito al texto extra que no aporta contenido correcto y respaldado |
| Autopreferencia | Un juez favorece las salidas de su propia familia de modelos | Compara jueces de la misma familia y de otras sobre etiquetas reservadas (estudio) |
| Complacencia | El juez da crédito a afirmaciones que la traza no respalda | Exige evidencia de la traza en el veredicto |
| Deriva de la calibración | Una actualización del modelo o del prompt desplaza las puntuaciones | Fija el modelo y el prompt del juez; recalibra cuando cambien |
JudgeBench construyó pares de respuestas en los que una es objetivamente incorrecta, en conocimiento verificable, razonamiento, matemáticas y código. Con un prompt de juez simple, GPT-4o obtuvo un 50,9 %, apenas por encima del azar; el prompt Arena-Hard más fuerte del artículo subió el mismo modelo solo al 56,6 %. Cambiar el modelo bajo ese prompt más fuerte importa más: Claude 3.5 Sonnet, el mejor juez de propósito general probado, alcanzó el 64,3 %, y o3-mini con esfuerzo de razonamiento alto alcanzó el 80,9 %. Las respuestas seguras de sí mismas pero incorrectas siguen siendo difíciles para un juez que no razona antes de puntuar.
Trata al juez como un instrumento de medida: calíbralo con etiquetas humanas antes de que evalúe nada y vuelve a comprobarlo cada vez que cambie el modelo o el prompt del juez. La figura muestra el bucle y su paso de comparación: qué errores del juez cuentan frente a qué etiquetas humanas.
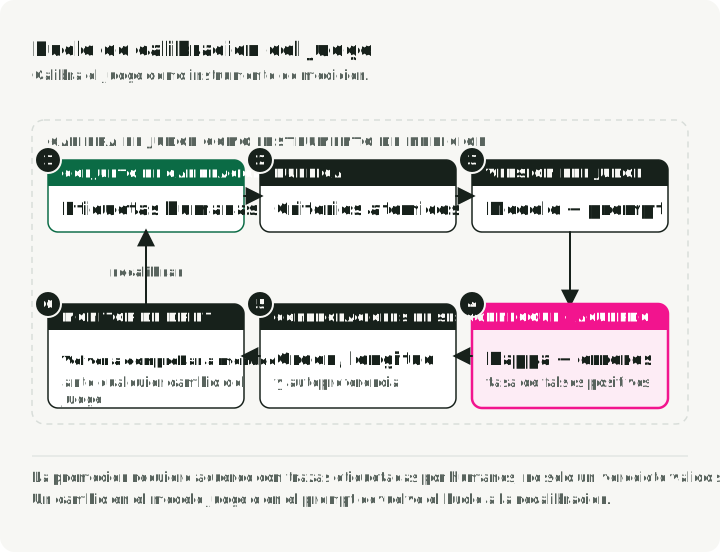
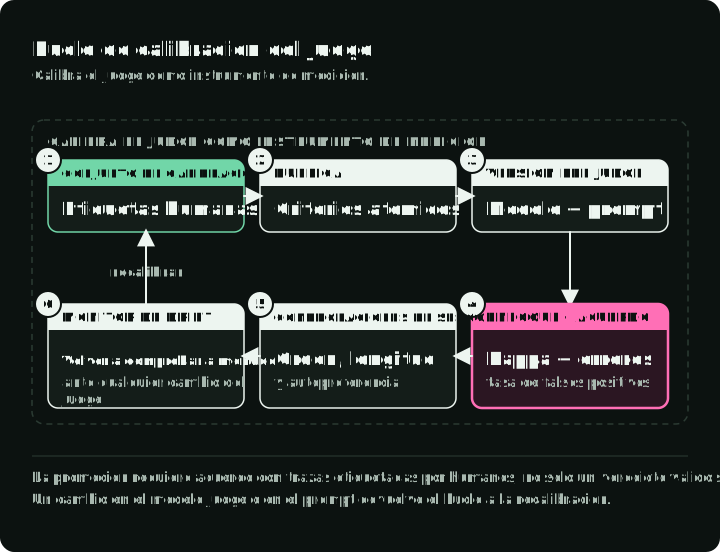
Cuando se necesita un juez, haz que el veredicto sea estructurado. Schema-Guided Reasoning (SGR) da al veredicto un esquema para la forma de su salida y para que se pueda inspeccionar. Los structured outputs o el constrained decoding pueden imponer la forma del objeto, los campos obligatorios y las restricciones de valor para campos como evidence, passed_criteria, failed_criteria, failure_mode y passed.
Un veredicto binario con listas de criterios tiene este aspecto; CI compara passed con la etiqueta humana:
{
    "type": "object",
    "required": [
        "evidence",
        "passed_criteria",
        "failed_criteria",
        "failure_mode",
        "passed"
    ],
    "properties": {
        "evidence": { "type": "array", "items": { "type": "string" } },
        "passed_criteria": { "type": "array", "items": { "type": "string" } },
        "failed_criteria": { "type": "array", "items": { "type": "string" } },
        "failure_mode": { "type": ["string", "null"] },
        "passed": { "type": "boolean" }
    },
    "additionalProperties": false
}
Pon los campos de evidencia antes del veredicto si eso facilita inspeccionar el registro. El orden de los campos es presentación, no una garantía de razonamiento. Un veredicto válido según el esquema aún puede contener evidencia sin respaldo o un valor passed erróneo. Usa la calibración con etiquetas humanas, validadores deterministas y la revisión de transcripciones para comprobar la fiabilidad del juez. CI puede comparar un objeto JSON estable, pero eso comprueba la inspeccionabilidad y la forma, no demuestra que se siguieran las etapas de la rúbrica.
Un veredicto estructurado también facilita probar un juez más barato. Trata un modelo más barato como candidato, no como sustituto automático. Ejecútalo sobre el mismo conjunto de calibración etiquetado por humanos. Compara su concordancia, su tasa de falsos aprobados y su tasa de falsos suspensos con las del juez más grande. Úsalo para los casos rutinarios solo si supera los umbrales que fijó tu aplicación. Reserva el juez más grande para los desacuerdos, los casos de alto riesgo o las ejecuciones de calibración.
Lista de comprobación básica de higiene del juez:
- Prefiere el aprobado/suspenso binario siempre que sea posible. Las escalas de cinco puntos invitan a una falsa precisión.
- Etiqueta trayectorias que cubran los modos de fallo reales antes de dar por cerrada la rúbrica. Elige el tamaño de la muestra según la cobertura y la incertidumbre que tolere la decisión, y reserva después casos separados para la validación.
- Mide la concordancia entre juez y humanos con la kappa de Cohen, una matriz de confusión y el recall de positivos y negativos. Kappa mide la concordancia tras descontar la que cabría esperar por azar; cuanto más alta, mejor. Un juez que siempre dice «pasa» no discrimina de forma útil, así que kappa puede ser cero o quedar indefinida. Decide qué hacer cuando quede indefinida antes de usar la métrica para aprobar una release.
- Descompón los criterios gruesos. «¿Verificó el agente la identidad antes de la tool call de reembolso?» es mejor que «¿Fue buena la trayectoria?»
- Emite el veredicto mediante un esquema SGR con evidencia, listas de criterios, modo de fallo y un campo de aprobado/suspenso.
- Compara jueces de la misma familia y de otras con etiquetas humanas reservadas; separar las familias no basta para establecer la fiabilidad.
- Mide la sensibilidad al orden en las comparaciones por pares. Conserva la aleatorización o la agregación con orden intercambiado solo si mejora las decisiones en el conjunto reservado; un estudio controlado de 2026 encontró que intercambiar podía perjudicar en casos adversarios.
- No des crédito al texto extra salvo que aporte contenido correcto, relevante y respaldado. Una respuesta más larga no es una respuesta mejor.
- Fija el modelo del juez, el prompt, el dataset, el esquema y la versión de la aplicación.
- Recalibra tras cambios en el modelo, el prompt, las herramientas, la política o el esquema.
Un panel es otro candidato que probar. PoLL informó de una mejor alineación con los juicios humanos, menor sesgo intra-modelo y menor coste que su línea base de un único GPT-4 en seis datasets. Esos resultados corresponden a sus modelos, tareas y precios históricos. No establecen que un panel sea más seguro en tu tarea. Compara sus falsos aprobados, falsos suspensos, coste y carga de trabajo por desacuerdos con los de un único juez calibrado sobre etiquetas reservadas.
No existe un umbral universal de kappa que haga a un juez adecuado para CI. Informa de la matriz de confusión, del número de etiquetas, de la tasa de falsos aprobados entre los fallos humanos y de la tasa de falsos suspensos entre los aprobados humanos, con su incertidumbre. Elige los límites de release según las consecuencias de esos errores. Usa colas de revisión cuando la evidencia sea demasiado débil para una aceptación automática, y mantén la autorización humana para las acciones con consecuencias cuando el workflow lo exija.
Los guardrails bloquean inline; los evals online observan después
La gente los confunde porque ambos producen puntuaciones. La diferencia es dónde se colocan: inline en la ruta de la petición, después de la respuesta o antes de la release. La figura pone las tres ubicaciones en una misma línea de tiempo, con lo que puede detener cada una.
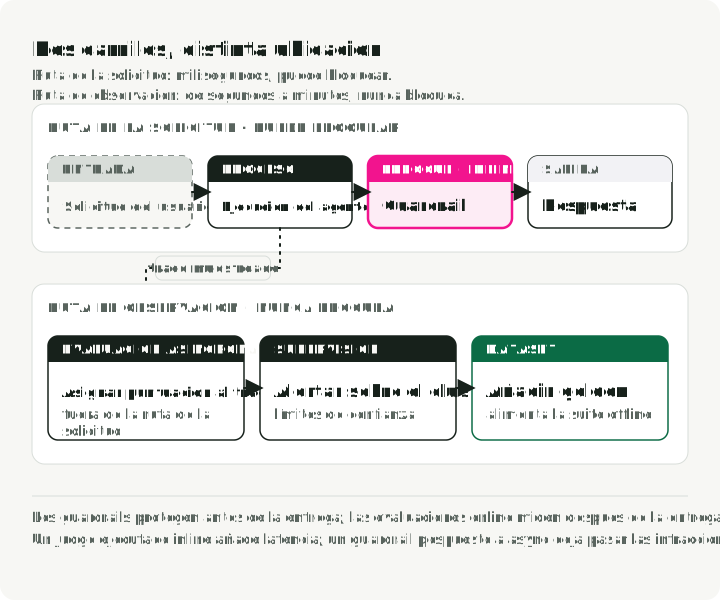
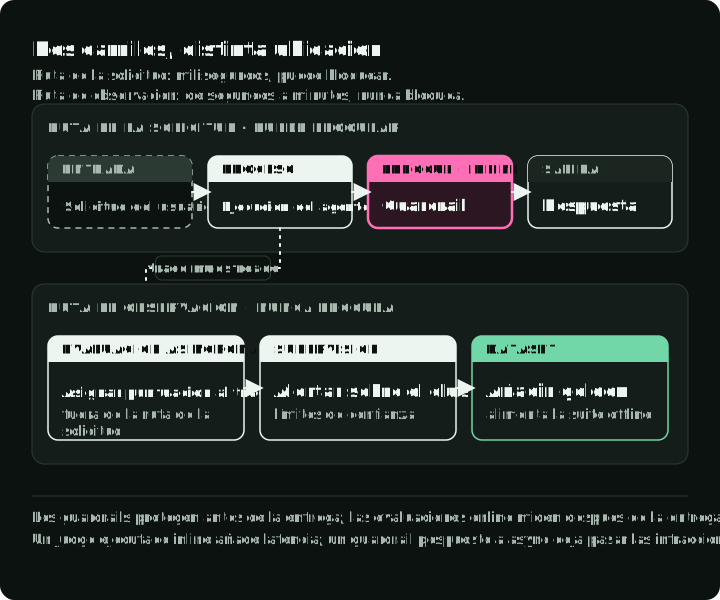
Los guardrails se ejecutan inline. Son rápidos y visibles para el usuario. Un guardrail puede bloquear una tool call, ocultar datos personales (PII), rechazar una prompt injection o forzar un reintento antes de que la respuesta salga de tu sistema. Un falso positivo es un bug de producción. Un falso negativo es más silencioso y peor, porque nada en la ruta de la petición lo notifica. Las comprobaciones de esquema, rango y política son deterministas. La detección de injection y de PII usa clasificadores, así que trata los fallos como esperables y mantén un eval asíncrono vigilando lo que dejan pasar.
Los evals online se ejecutan después de la respuesta, normalmente sobre tráfico muestreado. Pueden usar jueces LLM más lentos porque no están en la ruta de la latencia. Su trabajo es detectar la deriva, encontrar nuevos clústeres de fallos y alimentar el siguiente dataset offline.
Los evals offline se ejecutan antes de la release. Son reproducibles. Comprueban prompts, modelos, herramientas, retrievers y políticas con un dataset fijo.
Cada ubicación equivocada tiene un coste:
- Un juez en la ruta de la petición añade latencia y una nueva fuente de inestabilidad.
- Un guardrail relegado a una puntuación asíncrona deja que las infracciones de política lleguen a los usuarios.
En los tests de seguridad, distingue entre detectar un ataque, intentar una acción prohibida y que un efecto dañino se produzca de verdad. Informa de los efectos dañinos conseguidos por prueba de ataque, con el modelo de amenazas y el presupuesto de intentos, junto con el éxito de las tareas legítimas y los bloqueos falsos por prueba benigna. La puntuación de un detector por sí sola no puede establecer que los datos siguieran siendo privados ni que se impidiera una escritura. Usa objetivos aislados; el informe de Anthropic sobre un incidente en evaluaciones de ciberseguridad documenta por qué los efectos de una evaluación necesitan contención.
En sistemas de alto volumen, puntúa una muestra pequeña con un juez más fuerte y una muestra más amplia con clasificadores más baratos. Alerta sobre clústeres y límites de confianza, no sobre una única estimación puntual ruidosa.
Elección de herramientas
Ninguna herramienta cubre por sí sola todo el bucle. Compara por separado un almacén de trazas y datasets y un runner de CI/evals; un producto puede cubrir ambos, pero no necesitas comprar los dos al mismo proveedor. La columna Cubre muestra qué roles cubre cada herramienta.
| Herramienta | Cubre | Elígela cuando… | Límite o factor de coste |
|---|---|---|---|
| DeepEval | Runner | Ejecutas comprobaciones en Python y pytest; deepeval test run hace fallar la build cuando falla una métrica. | Solo runner. Las llamadas al modelo juez cuestan tokens; la plataforma alojada Confident AI factura por datos de trazas almacenados. |
| Inspect AI | Runner | Necesitas tareas de seguridad, de frontera o de agentes en sandbox. | Solo runner, de código abierto. Tú configuras los sandboxes y el acceso a los modelos; no es un almacén de trazas de producción. |
| Phoenix | Almacén de trazas, datasets, runner | Necesitas tracing y evals autoalojados, con los datos en tu infraestructura. | Gratis para autoalojar; tú operas el despliegue. La versión alojada, Arize AX, factura por spans, almacenamiento y retención. |
| Langfuse | Almacén de trazas, datasets, runner | Quieres un workflow de código abierto de trazas, datasets y experimentos, con una acción de CI que fija una versión del dataset y falla ante una regresión. | Si lo autoalojas, operas su stack de almacenamiento; algunas funciones requieren licencia. La nube factura por trazas, observaciones y puntuaciones. |
| LangSmith | Almacén de trazas, datasets, runner | Ya usas LangChain/LangGraph y aceptas los límites de su plataforma. | El autoalojamiento y el alojamiento híbrido requieren Enterprise. La nube factura por puestos, trazas y retención. |
| Braintrust | Almacén de trazas, datasets, runner | El feedback gestionado en los PR y los snapshots de experimentos comparables importan más que el autoalojamiento. | Servicio gestionado; el autoalojamiento requiere Enterprise. Factura por datos procesados, puntuaciones y retención. |
| Promptfoo | Runner, red-team | Las regresiones de prompts o de red-team deben ejecutarse antes del despliegue. | Runner y tests de red-team; sin almacén de trazas. Código abierto; los planes de pago añaden sondas de red-team y funciones de equipo. |
Los proveedores facturan por unidades distintas (trazas, spans, puntuaciones, puestos, retención o datos procesados), así que compara los precios vigentes con tu propio volumen de trazas. Los factores de coste anteriores se comprobaron en las páginas de precios en octubre de 2026.
La elección de la herramienta es secundaria. Si los fallos de producción no se convierten en casos de test, sobre todo estás pagando por almacenar trazas.
Lista de comprobación práctica de despliegue
Construye la pipeline de evidencia antes de ampliar la pila de métricas. Empieza decidiendo de dónde saldrán los ejemplos.
-
Recoge primero las ejecuciones históricas. Si el agente ya existe, extrae trazas, tickets de soporte, informes de bugs, sesiones con pulgar abajo, transcripciones de QA manual y notas de dogfooding antes de cambiar la implementación. Si el agente aún no existe, registra desde el primer día cada ejecución de prototipo y de prueba manual.
-
Instrumenta la forma de la traza. Captura mensajes, tool calls, argumentos, salidas de herramientas, errores, número de tokens, latencia, coste, feedback del usuario, versión de la aplicación, versión del prompt, versión del modelo, versión del tool schema y el estado final del entorno. Usa las convenciones GenAI de OpenTelemetry o spans al estilo de OpenInference si quieres portabilidad, y fija la versión de la convención y el adaptador. Captura el contenido de forma selectiva: oculta secretos y datos personales, restringe el acceso y define la retención antes de promocionar trazas a datasets. Usa Langfuse, LangSmith, Phoenix o Braintrust si quieres una interfaz de trazas y un workflow de datasets desde el primer momento.
-
Convierte los fallos reales en casos semilla. Lee las trazas antes de resumirlas con un modelo. Para cada fallo útil, guarda la entrada, el ID de la traza de origen, el estado esperado, las invariantes de herramientas esperadas, el modo de fallo, la gravedad y la nota del revisor. Langfuse puede enlazar los elementos del dataset con trazas de producción; LangSmith puede crear datasets a partir de ejecuciones trazadas. Conserva el enlace al origen para que el caso siga siendo auditable.
-
Si no hay historial, genera casos de arranque en frío. Pide a un LLM que redacte tareas a partir de los requisitos del producto, las políticas, los tool schemas, las máquinas de estados y las macros de soporte. Cubre los caminos felices y fallos como permisos incorrectos, comprobaciones de identidad ausentes, tool results obsoletos, fechas ambiguas, reintentos tras límites de frecuencia y salidas de herramientas contradictorias.
-
No te fíes de los casos sintéticos hasta que los revise una persona. Los ejemplos sintéticos sirven para la cobertura, no son la verdad. Márcalos con
source: syntheticy exige que un revisor apruebe el resultado esperado. Ejecuta un camino de referencia conocido como correcto cuando sea posible y valida las expectativas generadas de forma independiente; usar otra familia de modelos no sustituye esa comprobación. -
Construye un dataset pequeño y equilibrado. Incluye éxitos, fallos, rechazos, casos límite, casos de muchos turnos, casos sensibles a la política y caminos alternativos válidos. No conviertas el golden en «la transcripción antigua exacta». Guarda los campos del ejemplo de golden de «Deduplica antes de promocionar», incluido el modo de fallo que llevó el caso a la suite.
-
Añade primero comprobaciones deterministas. El orden obligatorio de herramientas cuando el orden sea política, los argumentos obligatorios, la validación de esquemas, los diffs del estado final, los límites de bucles, los techos de tokens y latencia y las invariantes propias de cada tarea deben ejecutarse antes que cualquier juez.
-
Añade un juez con forma SGR. Úsalo solo para la parte que necesita interpretación. Calíbralo con etiquetas humanas y prueba la rúbrica elegida con casos de validación sin tocar. Si no logra separar los ejemplos buenos de los malos en el conjunto de calibración, corrige la rúbrica antes de conectarlo a CI.
-
Conecta el bucle. Ejecuta la suite offline pequeña en CI, ejecuta la suite más grande antes de la release, puntúa online el tráfico de producción muestreado y promociona al dataset offline los clústeres de fallos online que se repitan.
Tu primera suite de evals pasará por alto casos. Ejecútala igualmente y añade los fallos recurrentes como casos. Una suite que se ejecuta cada día te da evidencia para mejorarla.
Referencias
- Repositorio de demo complementario trace2evals
- LangChain - State of Agent Engineering
- Anthropic - Demystifying Evals for AI Agents
- Hamel Husain - A Field Guide to Rapidly Improving AI Products
- Convenciones semánticas de OpenTelemetry para sistemas de IA generativa
- DeepEval Tool Correctness
- DeepEval Task Completion
- DeepEval unit testing in CI/CD
- Inspect running evals
- OpenAI Structured model outputs
- Schema-Guided Reasoning: vLLM, xgrammar y Pydantic
- Phoenix self-hosting
- Langfuse datasets and versioning
- Langfuse experiments in CI/CD
- LangSmith platform setup
- LangSmith - Create and manage datasets programmatically
- Braintrust - Create experiments
- Phoenix LLM evals
- Promptfoo GitHub Action integration
- tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- Why Do Multi-Agent LLM Systems Fail?
- Establishing Best Practices for Building Rigorous Agentic Benchmarks
- G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
- Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models
- JudgeBench: A Benchmark for Evaluating LLM-based Judges
- Self-Preference Bias in LLM-as-a-Judge