Оценка ИИ-агентов в продакшене: от трейсов к тестовым наборам

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Это руководство для инженеров, которые оценивают ИИ-агентов с tool use в продакшене. Вы узнаете, как превращать неудачные запуски в повторяемые тесты, проверять не только ответы агента, но и его действия, и прогонять эти тесты перед следующим релизом.
Краткое сравнение инструментов смотрите в статье Лучшие инструменты для оценки ИИ-агентов.
Чем эвалы агентов отличаются
Обычные эвалы LLM чаще всего оценивают одну пару «вход — выход»: релевантность, достоверность, корректность, безопасность, иногда стиль. У агентов добавляются планирование, tool calls, повторные попытки и проверки завершения, и каждый шаг становится новым местом для сбоя.
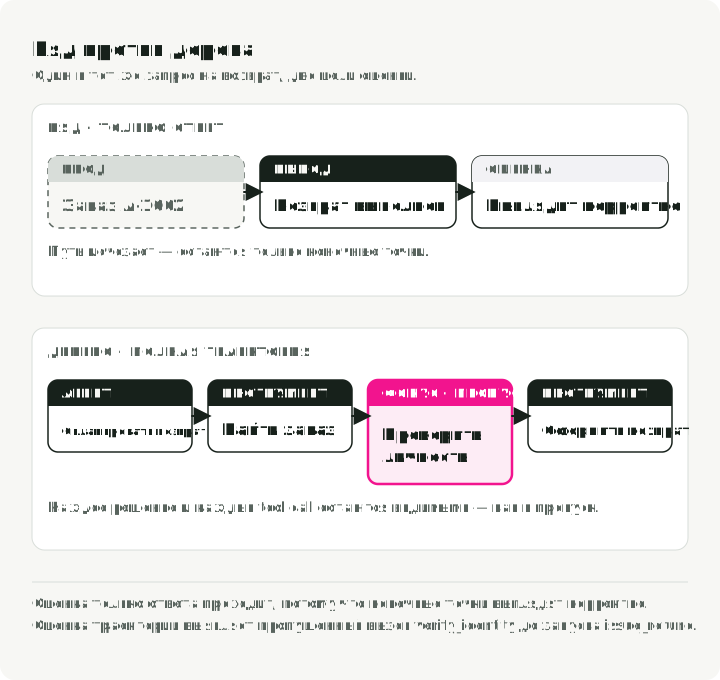
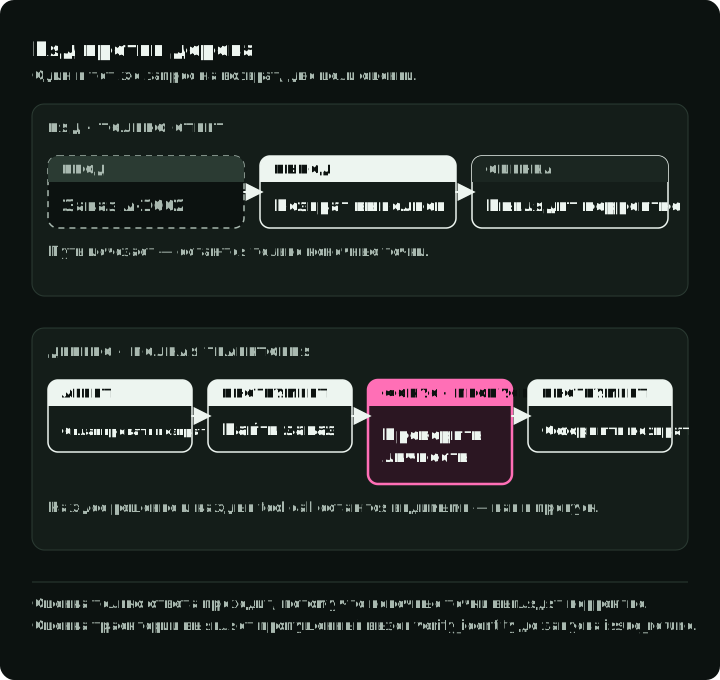
Возьмём агента по возвратам. Транскрипт может закончиться хорошо, хотя трейс неверный:
lookup_order -> issue_refund -> final_answerЭвал результата проходит. Эвал траектории должен упасть, потому что verify_identity не запускался перед issue_refund. Для агентов с tool use эвалы только по ответу ловят проблемы качества содержимого, но не доказывают, что агент прошёл допустимую траекторию и произвёл нужные побочные эффекты.
Левая карточка — это строка, которую читает эвал только по ответу; правая — трейс, который читает эвал траектории, с пропущенной проверкой личности.
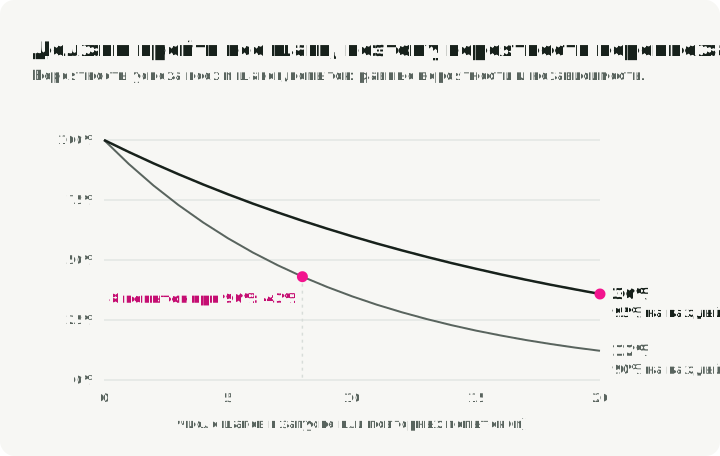
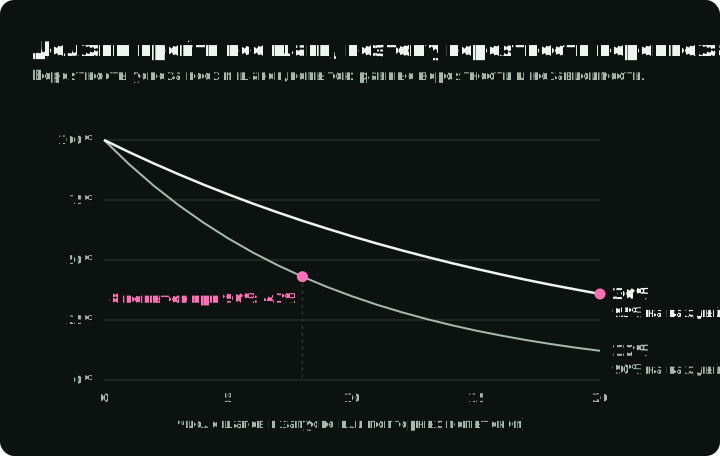
Есть и вторая проблема: ошибки накапливаются. Допустим, в воркфлоу 20 обязательных шагов, каждый срабатывает независимо, и у каждого одинаковая надёжность 95%. Тогда сквозной успех составит около 36%:
Агент может выглядеть надёжно в изолированных проверках и всё равно проваливать большинство полных запусков. Сбой обычно где-то посередине, и чтобы его найти, нужна видимость на уровне компонентов, а не ещё один взгляд на ответ.
tau-bench даёт агенту задачи клиентской поддержки авиакомпании и розничного магазина. Агент разговаривает с симулированным пользователем, вызывает API и обязан следовать правилам домена. После разговора грейдер проверяет, дошла ли база данных до размеченного целевого состояния. Правдоподобный транскрипт с неверными строками в базе всё равно проваливает проверку.
При таком грейдинге GPT-4o решила только 35,2% задач авиакомпании и чуть больше 60% розничных. Статья также ввела pass^k: вероятность того, что все k независимых попыток пройдут, усреднённая по задачам.
В розничной части, более лёгкой, pass^8 был ниже 25%. Для случайно выбранной розничной задачи и восьми независимых попыток вероятность, что пройдут все восемь запусков, была ниже 25%. Эвал с одним запуском такую стабильность измерить не может.
График показывает оба случая: вероятность того, что пройдут все шаги или все попытки, падает с каждым добавленным. При 90% на шаг падение круче: если каждый из 20 независимых шагов проходит в 90% случаев, все 20 проходят примерно в 12% случаев (0.9^20 ≈ 0.12).
MAST изучает, почему агенты проваливаются. Авторы построили таксономию из 14 видов сбоев по 150 размеченным вручную трейсам, а затем применили её к более чем 1600 трейсам из 7 популярных multi-agent фреймворков. В таксономию входят нечёткие определения ролей (системный дизайн), ситуация, когда один агент игнорирует то, что сообщил другой (рассогласование между агентами), и объявление успеха без проверки результата (нет верификации). Эти сбои указывают на промпты, логику оркестрации и отсутствующие проверки в харнессе. Более сильная базовая модель не выполнит шаг верификации, который никто не построил, поэтому объект оценки должен включать харнесс вокруг модели.
Разрыв во внедрении
Опрос LangChain State of Agent Engineering (1340 респондентов, конец 2025 года) позволяет предположить, что у многих команд уже есть сырьё для более сильных эвалов. По его данным, у 89% была хоть какая-то observability, 52,4% запускали офлайн-эвалы, а 37,3% запускали онлайн-эвалы.
Опрос также сообщает, что у 57,3% респондентов агенты уже работают в продакшене. На вопрос, что блокирует продакшен, 32% назвали качество, а 20% назвали латентность. Это опрос вендора среди его респондентов, а не перепись команд, работающих с агентами, но он показывает полезный разрыв между сбором трейсов и систематической оценкой.
В итоге команды оказываются в неудобном промежуточном состоянии: они могут разобрать плохой запуск постфактум и всё равно выкатить тот же сбой дважды.
Каждый разобранный продакшен-сбой должен оставлять после себя трейс, метку, строку датасета и скорер. Повторяемому сбою место в регрессионном наборе.
Выбирайте метрики по виду сбоя
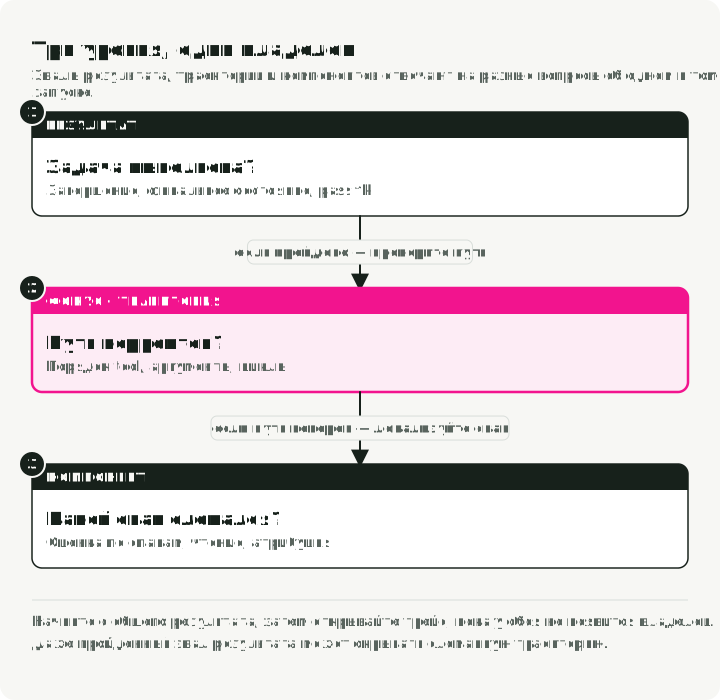
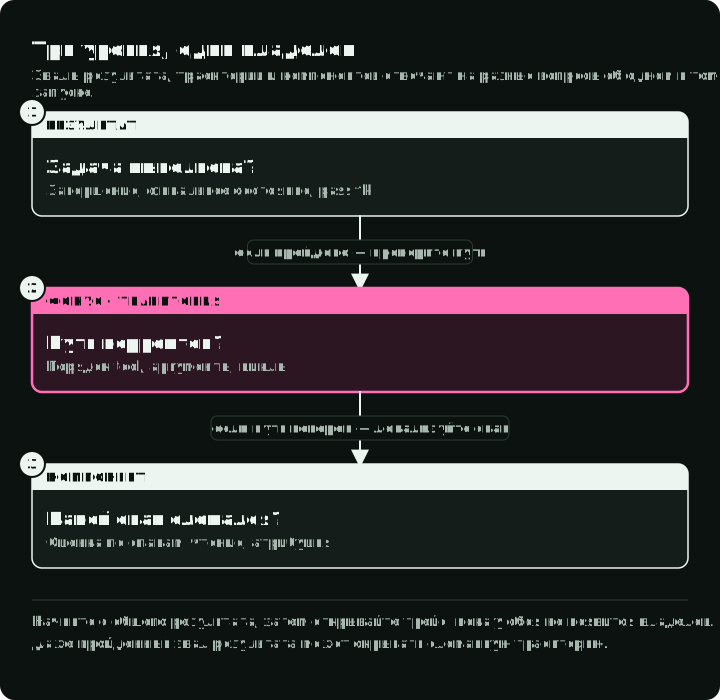
Выбирайте метрику по сбою, который нужно поймать. Полезное деление состоит из трёх уровней:
- Эвалы результата отвечают, выполнена ли задача.
- Эвалы траектории отвечают, был ли путь допустимым, эффективным и соответствующим политикам.
- Эвалы компонентов отвечают, какой инструмент, ретривер, суб-агент или шаг решения сломался.
На рисунке видно, какую часть одного и того же запуска читает каждый уровень.
Каждый уровень можно запускать офлайн на фиксированных воспроизводимых кейсах до релиза или онлайн на выборке продакшен-трейсов после ответа. Раздел про гардрейлы ниже разбирает это деление подробно. Офлайн-эвалы могут требовать голдены: сохранённые кейсы, где вход сопоставлен с результатом, инвариантами инструментов и аргументами, которые должен выдать корректный запуск. Полный голден приведён ниже, в разделе «Дедуплицируйте перед продвижением». Онлайн-эвалам лучше опираться на инварианты, распределения и асинхронные проверки, которые не стоят на пути запроса.
| Вопрос | Семейство метрик | Контракт офлайн / онлайн | Детерминированная проверка или джадж? | На что обратить внимание |
|---|---|---|---|---|
| Вызвал ли агент нужные инструменты? | Корректность инструментов: точное, упорядоченное или любое совпадение | Точные голдены офлайн; инварианты обязательных инструментов и аномалии онлайн | Детерминированная | Точное совпадение наказывает за допустимые альтернативные пути |
| Передал ли он им правильные входные данные? | Корректность аргументов, валидация схемы, совпадение параметров | Ожидаемые аргументы офлайн; проверки схемы, диапазонов и политик онлайн | Обе | Правильный инструмент с неверными аргументами всё равно сломан |
| Не тратил ли он шаги впустую? | Эффективность шагов, число повторов, детекция циклов, стоимость и латентность | Бюджеты шагов и циклов офлайн; дрейф стоимости и латентности онлайн | В основном детерминированная | Высокий процент выполнения задач может скрывать дорогое блуждание |
| Выполнена ли задача на самом деле? | Выполнение задачи, оценка результата, дифф итогового состояния | Симулятор или эталонное состояние офлайн; итоговое состояние, сигнал пользователя или асинхронный джадж онлайн | Джадж или проверка состояния | По возможности оценивайте состояние окружения |
| Сохранил ли он контекст между репликами? | Согласованность в многоходовых диалогах, следование роли, полнота диалога | Сценарные длинные кейсы офлайн; выборка длинных сессий онлайн | Джадж | Одноходовые тесты ничего не говорят о четырнадцатой реплике |
| Остановился ли он вовремя? | Корректность завершения, преждевременный успех, бесконечная работа | Сценарные тесты офлайн; мониторы циклов, таймаутов и ложного успеха онлайн | Обе | «Готово» может быть галлюцинированным состоянием |
| Правильно ли он истолковал результаты инструментов? | Понимание результатов инструментов, проверки состояния downstream | Состязательные выходы инструментов офлайн; проверки downstream-состояния и выборочный разбор онлайн | Обе | Оценивайте downstream-состояние, а не код выхода инструмента |
Начинайте с детерминированных метрик. Они повторяются при фиксированных входах и коде и стоят дёшево. Их правила всё же могут устареть, когда меняются инструменты или политики, поэтому версионируйте скорер вместе со спецификацией, которую он проверяет.
Выбирайте проверяющего по критерию: код, когда критерий проверяется кодом; очередь на ревью, пока откалиброванного джаджа нет; человек, когда вердикт запускает значимое действие; и откалиброванный LLM-джадж для всего остального.
Корректность tool calls
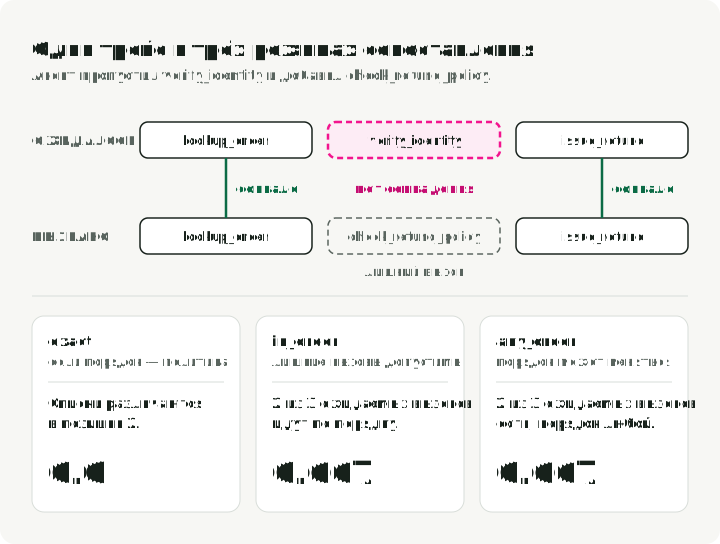
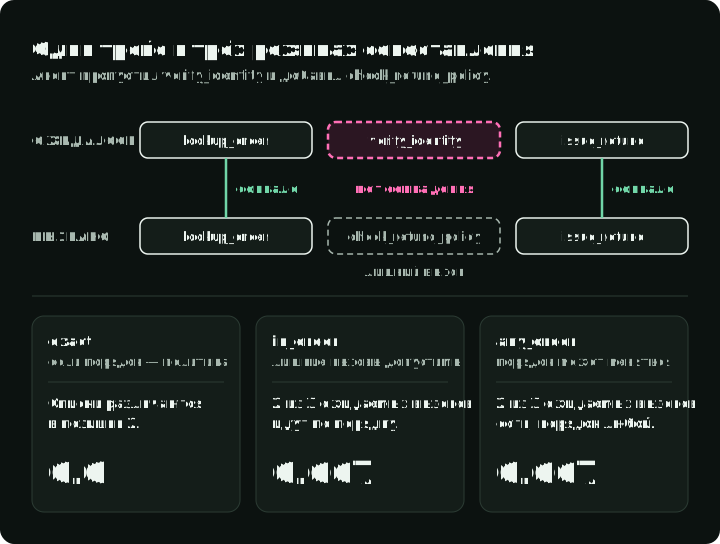
Корректность инструментов сравнивает вызванные инструменты с ожидаемыми. Выбирайте строгость осознанно:
- Точное совпадение: последовательность должна совпасть полностью. Берите его, когда порядок является политикой, например
lookup_order -> verify_identity -> issue_refund. - Совпадение с сохранением порядка: обязательные инструменты должны идти в правильном относительном порядке, но безвредные лишние вызовы допустимы.
- Совпадение в любом порядке: обязательные инструменты должны присутствовать, порядок может быть любым.
На рисунке один трейс оценивается во всех трёх режимах. Агент пропустил verify_identity и сделал лишний вызов check_refund_policy.
Для начала хватит небольшого локального скорера:
from collections import Counter

def tool_correctness(called: list[str], expected: list[str], mode: str = "in_order") -> float:
    if mode not in {"exact", "in_order", "any_order"}:
        raise ValueError(f"unknown matching mode: {mode}")
    if mode == "exact":
        return float(called == expected)
    if not expected:
        return 1.0
    if mode == "any_order":
        matched = sum((Counter(called) & Counter(expected)).values())
        return matched / len(expected)

    rows = [[0] * (len(expected) + 1) for _ in range(len(called) + 1)]
    for i, tool in enumerate(called):
        for j, wanted in enumerate(expected):
            if tool == wanted:
                rows[i + 1][j + 1] = rows[i][j] + 1
            else:
                rows[i + 1][j + 1] = max(rows[i][j + 1], rows[i + 1][j])
    return rows[-1][-1] / len(expected)

called = ["lookup_order", "check_refund_policy", "issue_refund"]
expected = ["lookup_order", "verify_identity", "issue_refund"]

print(round(tool_correctness(called, expected, "exact"), 3))     # 0.0
print(round(tool_correctness(called, expected, "in_order"), 3))  # 0.667
assert tool_correctness(["issue_refund"], [], "exact") == 0.0
assert tool_correctness([], [], "exact") == 1.0
assert tool_correctness(["a", "b"], ["a", "a", "b"], "any_order") == 2 / 3
try:
    tool_correctness([], [], "typo")
except ValueError:
    pass
else:
    raise AssertionError("unknown modes must fail")
Оценка in_order — это recall по наибольшей общей подпоследовательности: какая доля требуемой последовательности уцелела в правильном порядке. Обратите внимание, что она игнорирует. Лишние вызовы её не снижают, поэтому агент может получить здесь 1.0, сделав вдвое больше вызовов, чем нужно. Если лишние вызовы стоят денег или меняют состояние, отслеживайте рядом precision (совпавшие обязательные вызовы к общему числу вызовов) и читайте обе метрики вместе. Recall ловит пропущенный шаг, precision ловит блуждание. Хорошая оценка инструментов не делает безопасным лишний возврат или запись. Проверяйте каждый вызов, меняющий состояние, отдельно: права, ресурс, аргументы и верификацию, которая должна идти первой. Если инструменты не ожидаются, запуск с вызовами инструментов проваливает только режим exact; два других режима возвращают 1.0.
Метрика Tool Correctness в DeepEval предоставляет те же настройки через should_consider_ordering и should_exact_match.
Корректность аргументов
Вызвать правильный инструмент с неверными аргументами часто хуже, чем вызвать не тот инструмент, потому что трейс выглядит нормально.
В простых случаях валидируйте JSON Schema и точные значения. В семантических случаях храните ожидаемые аргументы вместе с кейсом, как это делает поле expected_arguments голдена из раздела «Дедуплицируйте перед продвижением», и оценивайте расхождения. Метрика по именам инструментов не поймает 2026-06-17 там, где политика требует 2026-06-19.
В этом примере с одним вызовом на инструмент parameter-match — это доля ожидаемых троек (tool, key, value), которые агент передал верно. Словари ниже корректны, только если у каждого нужного инструмента не больше одного вызова. Не собирайте их, перезаписывая прежние вызовы с тем же именем: так неверный возврат, за которым следует верный, окажется скрыт. Для повторных вызовов сохраняйте ID вызовов и порядок, сопоставляйте нужный вызов и валидируйте каждую мутацию отдельно.
def argument_correctness(called_args: dict, expected_args: dict) -> float:
    total = matched = 0
    for tool, params in expected_args.items():
        for key, want in params.items():
            total += 1
            if key in called_args.get(tool, {}) and called_args[tool][key] == want:
                matched += 1
    return matched / total if total else 1.0

assert argument_correctness({}, {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {}},
                            {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {"date": None}},
                            {"reschedule_delivery": {"date": None}}) == 1.0
Точное равенство подходит для ID, enum и дат, уже приведённых к одному формату. Оно не подходит для свободного текста, чисел с плавающей точкой и дат в том виде, в каком их выдала модель: там == помечает верный ответ как неверный. Оценивайте такие поля по их собственным правилам: нормализованное сравнение строк, разбор даты, числовой допуск. Метрика остаётся той же; меняется компаратор для каждого поля.
Эффективность, циклы и тупики
Агент, который выполняет задачу после пяти лишних tool calls, всё равно сигнализирует о проблеме планирования и стоит дороже.
Дешёвые сигналы, с которых стоит начать:
- Доля избыточных вызовов: одинаковые tool calls с одинаковыми аргументами, повторённые больше двух раз.
- Аномалии формы трейса: резкие скачки глубины, числа tool calls, числа токенов, латентности или стоимости.
- Сходимость пути: насколько запуск близок к кратчайшему известному допустимому пути для задачи.
- Корректность завершения: остановился ли агент слишком рано, продолжал ли работать после успеха или объявил успех без нужного изменения состояния.
- Следование плану: если агент пишет план перед действиями, проверьте, следовал ли ему трейс. Хороший план, который проигнорировали, и плохой план, которому следовали идеально, оба проваливаются, но по противоположным причинам, и дифф между планом и трейсом показывает, какая из них ваша.
Запускайте эти проверки до джаджа, когда это возможно. Детектор циклов — несколько строк поверх трейса, и модель ему не нужна. Этот считает самый частый повторяющийся одинаковый вызов в трейсе:
import json

def redundant_call_count(tool_calls: list[dict]) -> int:
    seen: dict[str, int] = {}
    for call in tool_calls:
        key = call["name"] + json.dumps(call["arguments"], sort_keys=True)
        seen[key] = seen.get(key, 0) + 1
    return max(seen.values(), default=0)

calls = [{"name": "lookup_order", "arguments": {"order_id": "A-100"}}] * 3
assert redundant_call_count(calls) == 3
assert redundant_call_count([]) == 0
Помечайте трейс, когда счётчик больше 2. Репозиторий-компаньон использует то же правило.
Выполнение задачи и оценка результата
Если судить по результату, вопрос звучит так: «получил ли пользователь то, о чём просил?»
Лучше всего работают два подхода:
- Безэталонный джадж выполнения задачи: извлеките цель из входа и оцените, достигли ли её трейс и итоговый ответ. Это работает онлайн, потому что у продакшен-трафика редко есть эталонные выходы.
- Оценка состояния окружения: сравните итоговые строки базы данных, файлы, тикеты, бронирования или записи с размеченным целевым состоянием. Это надёжнее сопоставления транскрипта, потому что агенты находят допустимые пути, которые вы не записали.
Второй вариант лучше, если вы можете его построить. Оценивайте итоговое состояние; транскрипт используйте, чтобы объяснить сбой.
У оценки состояния есть два ограничения. Аудит агентных бенчмарков 2025 года показал, что tau-bench оценивает часть задач только по состоянию базы данных. В некоторых задачах размеченный результат не требует ни изменения состояния, ни конкретного текста. Тогда агент, который ничего не делает, может получить зачёт: 38% на авиационной части и 6,0% на розничной при любом k. Anthropic сообщала о запуске Opus 4.5, который «провалил» задачу на бронирование в tau2-bench, бенчмарке-преемнике. Агент нашёл лазейку в политике, которая дала пользователю лучший исход. Оценка состояния лучше сопоставления транскрипта, но целевое состояние всё равно остаётся разметкой, а в разметке бывают ошибки. Проверяйте кейсы, которые проходят слишком легко, а не только те, что падают.
Эвалы компонентов
Метрики результата и траектории говорят, что запуск провалился и примерно где. Эвалы компонентов оценивают один спан: был ли найденный чанк релевантным, вернул ли суб-агент схему, которую ждал вызывающий, удалось ли разобрать ответ самого инструмента. Привязывайте оценку к спану, а не к запуску, тогда вопрос «какой инструмент деградировал на этой неделе» становится запросом, а не повторным прогоном.
Большую часть покрывают три проверки:
- Оценка по спанам: запускайте метрику, подходящую типу спана. Для retrieval-спанов считайте recall и precision относительно размеченного чанка, для спанов суб-агентов — валидацию схемы плюс собственную оценку корректности инструментов, для спанов инструментов — долю ошибок и латентность.
- Интерпретация результата инструмента: подайте агенту корректный, но неудобный выход инструмента (пустой список, частичное совпадение, устаревшую метку времени) и проверьте, что он сделает дальше. Инструмент может быть прав, а агент прочтёт его неверно, и такой сбой всплывает двумя шагами позже.
- Атрибуция сбоя: видимый сбой обычно расположен ниже по цепочке, чем настоящий. Приписывайте его самому раннему спану, чей выход уже был неверным, а не шагу, который выбросил ошибку.
На рисунке показан запуск возврата из пяти спанов. Агент планирует найти заказ и вернуть деньги. search_orders возвращает старый ID заказа, lookup_order загружает не тот заказ, issue_refund выдаёт ошибку, потому что по заказу нельзя сделать возврат, а final_answer сообщает пользователю, что возврат не удался. Ошибка появляется в issue_refund (шаг 4), но первый неверный выход дал search_orders (шаг 2), двумя спанами раньше.
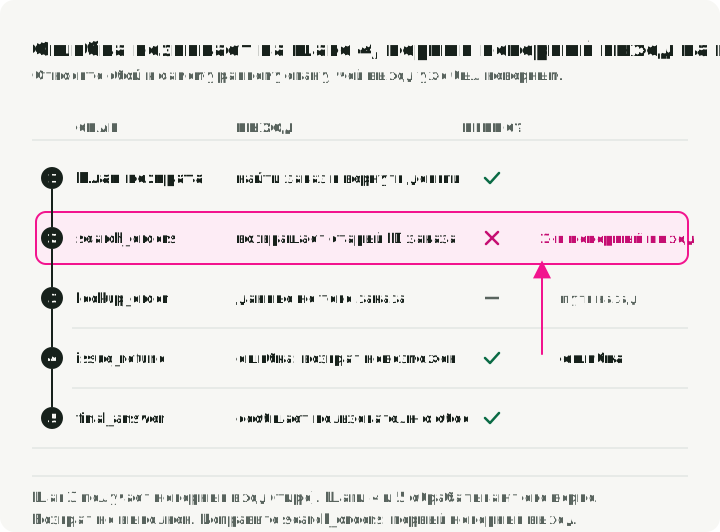
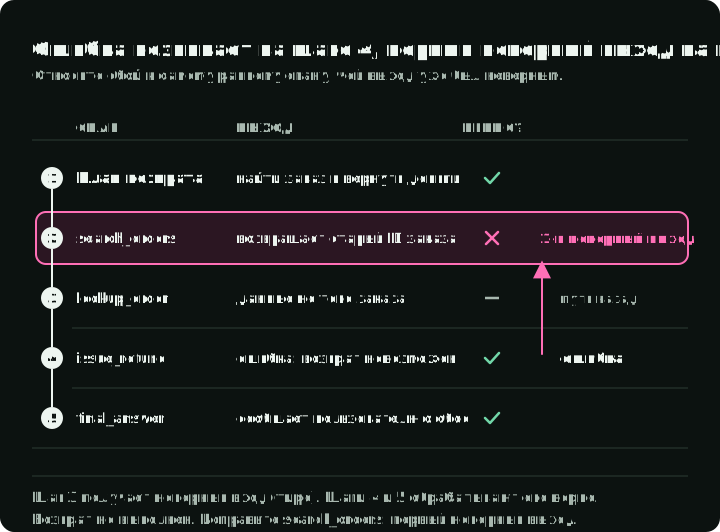
Здесь применим расчёт с 20 шагами из начала статьи. Если каждый из 20 шагов по отдельности выглядит нормально, запуск всё равно может проваливаться большую часть времени. Доли успеха по спанам показывают, какой шаг работает на 95%, а какой на 70%.
Цикл от трейсов к эвалам
Добывайте продакшен-сбои, прежде чем придумывать дополнительные кейсы для эвалов. Каждый пронумерованный шаг на рисунке соответствует пункту списка ниже.
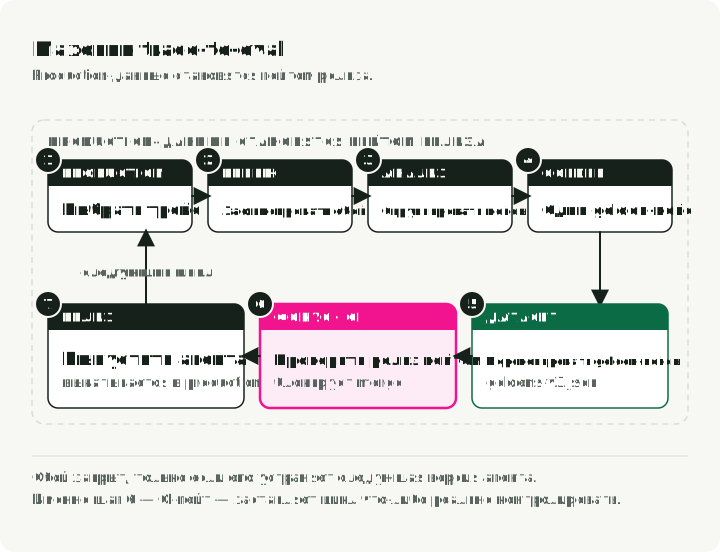
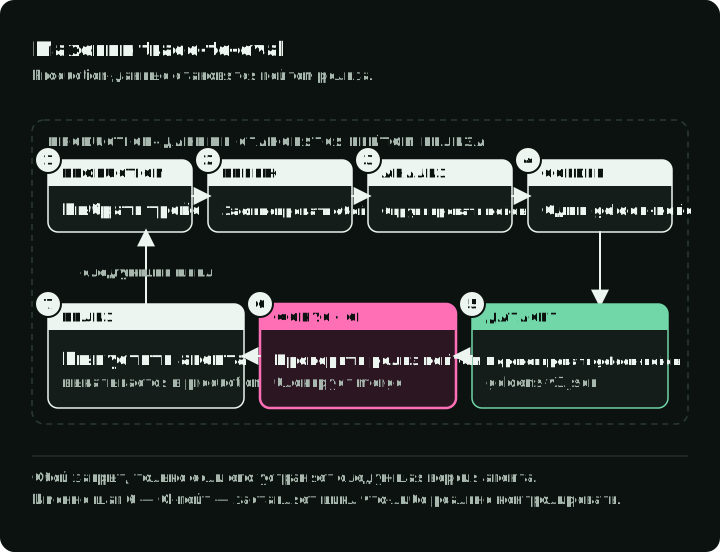
Цикл:
- Соберите достаточно свидетельств в трейсе, чтобы восстановить сбой, контролируя чувствительное содержимое.
- Разметьте, что именно сломалось.
- Сгруппируйте похожие сбои.
- Оставьте репрезентативные голдены, включая варианты, которым нужны другие исходы. Ревьюер утверждает каждый ожидаемый исход.
- Версионируйте датасет.
- Запускайте его в CI.
- Продолжайте оценивать выборку продакшен-трейсов онлайн.
Репозиторий-компаньон trace2evals демонстрирует этот воркфлоу на неисправном агенте поддержки. Он записывает tool calls и состояние магазина в локальный OpenTelemetry JSONL, находит сбои детерминированными правилами и выдаёт версионируемые кандидаты на ревью. Ревьюер должен определить и утвердить их ожидаемые исходы, прежде чем их можно использовать как релизные тесты.
Выполните в этом репозитории uv sync --locked и make demo. API-ключ не нужен: скриптовый агент воспроизводит заложенные ошибки. Демо записывает шесть запусков, находит четыре неудачных запроса и записывает их как кандидаты на ревью. Затем оно прогоняет десять эталонных задач в трёх конфигурациях. Агент v1 с ошибками проваливает пять. Исправленный агент v2 проходит все десять, и когда инструменты проверяют права, и когда проверки просит только промпт. Отчёты лежат в data/demo/red.json, prompt-only.json и green.json. В README описан необязательный живой запуск с моделью OpenAI.
Демо использует синтетические кейсы, инструменты в памяти и схему трейса, специфичную для репозитория; его адаптер не принимает произвольные экспорты OpenTelemetry.
Добывайте сбои через анализ ошибок
Hamel Husain и Shreya Shankar преподают воркфлоу анализа ошибок для этого шага; полевое руководство Hamel описывает его: изучайте реальные диалоги, делайте свободные заметки, категоризируйте сбои и стройте конкретные тесты. Названия первых двух шагов взяты из качественных исследований, что поможет, если вы будете искать метод в других источниках.
- Открытое кодирование: изучайте трейсы и записывайте свободные заметки о том, что пошло не так.
- Осевое кодирование: сгруппируйте заметки в именованные категории сбоев.
- Разметьте трейсы по этой таксономии.
- Постройте конкретные тесты для самых крупных кластеров, с которыми можно что-то сделать.
Не начинайте с меток вроде reasoning_issue или tool_problem. Они слишком расплывчаты для тестирования. Берите метки вроде missing_identity_verification, date_argument_mismatch, retried_same_tool_after_429 или stopped_before_database_update. Такая конкретная метка точно подсказывает, что должен проверять регрессионный тест.
Дедуплицируйте перед продвижением
Частая ошибка — добавлять в набор каждый плохой трейс. Так получается датасет большой, дорогой и узкий. Он проходит на почти-дубликатах из марта и пропускает новую форму того же бага в июне.
Сначала группируйте. Начните с одного репрезентативного голдена на кластер, затем оставляйте варианты с разными правами, аргументами, состояниями восстановления или ожидаемыми исходами. Похожая формулировка не делает два кейса с разными политиками эквивалентными. Храните ID связанных трейсов в метаданных с контролем доступа, чтобы ревьюер мог позже изучить свидетельства.
Если кластер сбоев повторяется после исправления, регрессионный кейс не обобщился. Вернитесь к кластеру и добавьте недостающие поведенческие варианты, вместо того чтобы собирать почти одинаковые транскрипты.
Голден, принятый в набор, хранит вход, исходные трейсы, набор, к которому он относится, метку сбоя, из-за которой он появился, ожидаемые инструменты, аргументы и итоговое состояние, а также того, кто его утвердил. Это поля, которые используют шаги продвижения в репозитории-компаньоне:
{
    "id": "reschedule-date",
    "input": "Reschedule order A-100 for June 19, 2026.",
    "source_trace_ids": ["tr_2417"],
    "split": "regression",
    "failure_modes": ["date_argument_mismatch"],
    "expected_tools": ["lookup_order", "reschedule_delivery"],
    "tool_match": "in_order",
    "expected_arguments": {
        "reschedule_delivery": { "order_id": "A-100", "date": "2026-06-19" }
    },
    "expected_state": {
        "reschedules": [{ "order_id": "A-100", "date": "2026-06-19" }],
        "refunds": []
    },
    "review_status": "approved",
    "reviewed_by": "support-policy-owner"
}
expected_state позволяет тесту оценить состояние магазина после запуска. split не пускает кейс в отложенные наборы, о которых говорится в следующем разделе.
Версионируйте датасет
Версионируйте датасеты так же, как промпты и код. Когда меняется что-то существенное (модель, промпт, схема инструмента, промпт джаджа или поведение приложения), нужно прогнать одну и ту же версию датасета до и после.
Проверка в CI должна фиксировать:
- версию датасета
- версию приложения
- версию промпта
- модель джаджа
- промпт джаджа
- версию кода эвалуатора
- схемы инструментов, политику, конфигурацию харнесса и управления контекстом
- ревизию модели, настройки ризонинга и сэмплирования
- начальную фикстуру окружения и разрешённые внешние эффекты
Если что-то из этого изменилось, вы не поймёте, какое изменение вызвало разницу. Файл goldens-v3.json в git подходит для небольшого масштаба. Нативные снапшоты инструментов в Langfuse, Phoenix, Braintrust или LangSmith помогают, когда датасет становится совместным.
Держите отдельно регрессии для разработки, примеры для калибровки джаджа, отложенную валидацию и выборки для мониторинга. Перед разбиением группируйте связанные сессии, пользователей и задачи, чтобы почти-дубликаты не просочились между наборами. Как только кейс повлиял на промпт или рубрику, считайте его свидетельством для разработки. Набор добытых сбоев тестирует известные регрессии; его среднее не оценивает долю успеха в продакшене.
Сбрасывайте изменяемое состояние для каждой попытки: файлы, строки базы данных, кэши и фикстуры инструментов. Изолируйте учётные данные и внешние эффекты и держите бюджеты кандидата и базовой версии равными. Сообщайте число задач отдельно от числа попыток, вместе со всеми начатыми попытками, таймаутами, падениями и неоцениваемыми исходами. Сравнивайте парные результаты на одних и тех же задачах. Эти решения следуют подходу чистых попыток и оценки результата из руководства Anthropic по оценке.
Фиксируйте версии бенчмарков и сэндбоксов
Цифры tau-bench из первого раздела объясняют надёжность при повторных попытках; это не актуальный рейтинг моделей. Публичные бенчмарки меняют задачи и грейдеры между релизами, а оценки от разных версий грейдера несопоставимы. Поддерживаемый репозиторий tau-bench выпустил такое исправление грейдинга в июле 2026 года. Фиксируйте ревизии задач и грейдера так же, как модель, и пересчитывайте оценки сохранённых траекторий, когда меняется разметка.
Выбирайте бенчмарк, который задействует развёрнутый интерфейс. Текстовые тесты клиентской поддержки не доказывают, что голосовой агент справляется с перебиванием. Задачам на извлечение знаний также нужны корпус, конфигурация поиска и свидетельства, доступные на каждом ходу. Заимствуйте эти формы задач для локальных регрессионных кейсов, а не импортируйте место в публичном рейтинге как критерий релиза.
Сэндбокс — тоже часть теста. Исследование инфраструктуры Anthropic за февраль 2026 года нашло разницу в шесть процентных пунктов на Terminal-Bench 2.0 между строгой и неограниченной настройками ресурсов при той же модели, харнессе и задачах. Дополнительный запас и сократил инфраструктурные сбои, и открыл другие стратегии решения. Записывайте гарантии и лимиты CPU и RAM, таймауты, конкурентность, доступ к сети и обработку инфраструктурных ошибок. Сообщайте об этих сбоях отдельно и не выбрасывайте их молча из знаменателя ожидаемых задач. То же исследование советует с осторожностью относиться к разнице в лидербордах меньше трёх процентных пунктов, пока конфигурация оценки не задокументирована и не согласована; применяйте это правило и к своим сравнениям.
Запускайте эвалы в CI
Релизная проверка должна ронять сборку, когда метрика выходит за согласованный предел. Иначе набор эвалов — просто дашборд.
После восстановления фикстуры кейса в изолированной попытке тест запускает текущего агента на входе голдена. Он не воспроизводит сохранённый неудачный трейс, который лишь показал бы, что старый запуск провалился (набросок; запускаемая версия — evals/test_agent_regression.py, где grade() выполняет все проверки, а не только метки, из-за которых появился кейс):
@pytest.mark.parametrize("golden", GOLDENS, ids=[item["id"] for item in GOLDENS])
def test_agent_regression(golden: dict) -> None:
    answer, fresh_trace = run_agent_and_capture_trace(golden["input"])

    refired = set(flag_failures(fresh_trace)) & set(golden["failure_modes"])
    assert not refired, f"failure mode regressed: {sorted(refired)}"

    assert tool_correctness(
        called=[call["name"] for call in fresh_trace["tool_calls"]],
        expected=golden["expected_tools"],
        mode=golden.get("tool_match", "in_order"),
    ) >= golden.get("tool_threshold", 1.0)
Откалибруйте джаджа, прежде чем ему доверять
LLM-as-judge помогает. Но им легко и обмануть самого себя.
G-Eval заставлял GPT-4 писать шаги рубрики перед оценкой и получил корреляцию Спирмена 0,514 с человеческими оценками на SummEval, выше прежних автоматических метрик. Каждую оценку он взвешивал по вероятности токена; GPT-4 эти вероятности не отдавал, поэтому в статье их оценивали сэмплированием 20 раз. Берите рубрику; не заявляйте о взвешивании, если ваш джадж не возвращает логпробы. Это результаты для суммаризации, а не для траекторий агентов.
MT-Bench показал, что GPT-4 согласуется с человеческими предпочтениями примерно так же часто, как люди друг с другом. Этот результат помог сделать LLM-оценку массовой. Позднейшие работы выявили смещения, каждое из которых требует собственной проверки:
| Смещение | Что происходит | Проверка или смягчение |
|---|---|---|
| Позиция | Попарные промпты отдают предпочтение одному слоту | Измеряйте чувствительность к порядку; меняйте порядок, только если это улучшает решения на отложенной выборке |
| Многословность | Более длинные ответы получают больше баллов при том же качестве | Не засчитывайте лишний текст, который не добавляет верного, подкреплённого содержания |
| Самопредпочтение | Джадж отдаёт предпочтение выходам своего семейства моделей | Сравнивайте джаджей из того же и из другого семейства на отложенных метках (исследование) |
| Угодливость | Джадж засчитывает утверждения, которые трейс не подтверждает | Требуйте в вердикте свидетельства из трейса |
| Дрейф калибровки | Обновление модели или промпта сдвигает оценки | Зафиксируйте модель и промпт джаджа; перекалибруйте при изменении |
JudgeBench построил пары ответов, в которых один ответ объективно неверен, по проверяемым знаниям, ризонингу, математике и коду. С обычным промптом джаджа GPT-4o набрала 50,9%, едва выше подбрасывания монеты; более сильный промпт Arena-Hard из статьи поднял ту же модель лишь до 56,6%. Замена модели при этом более сильном промпте даёт больше: Claude 3.5 Sonnet, лучший из протестированных джаджей общего назначения, достигла 64,3%, а o3-mini с высоким уровнем усилий ризонинга — 80,9%. Уверенные, но неверные ответы остаются трудными для джаджа, который не рассуждает перед оценкой.
Относитесь к джаджу как к измерительному прибору: калибруйте его по человеческим меткам, прежде чем он что-либо оценит, и перепроверяйте, когда меняется его модель или промпт. На рисунке показаны цикл и шаг сравнения: какие ошибки джаджа считаются относительно каких человеческих меток.
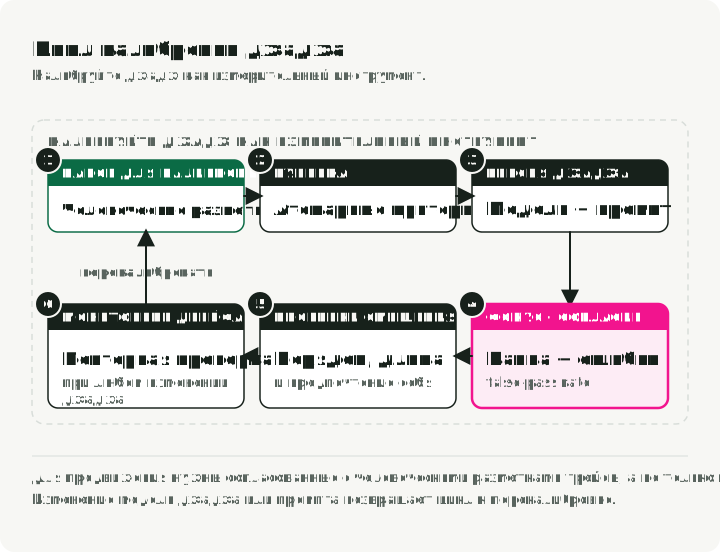
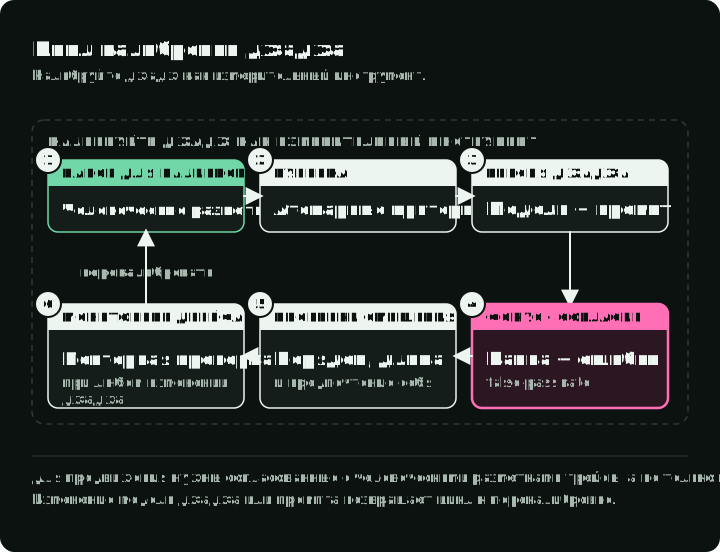
Когда джадж необходим, делайте вердикт структурированным. Schema-Guided Reasoning (SGR) даёт вердикту схему для формы выхода и возможности его проверить. Structured Outputs или constrained decoding могут обеспечить форму объекта, обязательные поля и ограничения значений для таких полей, как evidence, passed_criteria, failed_criteria, failure_mode и passed.
Бинарный вердикт со списками критериев выглядит так; CI сравнивает passed с человеческой меткой:
{
    "type": "object",
    "required": [
        "evidence",
        "passed_criteria",
        "failed_criteria",
        "failure_mode",
        "passed"
    ],
    "properties": {
        "evidence": { "type": "array", "items": { "type": "string" } },
        "passed_criteria": { "type": "array", "items": { "type": "string" } },
        "failed_criteria": { "type": "array", "items": { "type": "string" } },
        "failure_mode": { "type": ["string", "null"] },
        "passed": { "type": "boolean" }
    },
    "additionalProperties": false
}
Ставьте поля со свидетельствами перед вердиктом, если так запись легче изучать. Порядок полей — это представление, а не гарантия ризонинга. Валидный по схеме вердикт всё равно может содержать неподкреплённые свидетельства или неверное значение passed. Проверяйте надёжность джаджа калибровкой по человеческим меткам, детерминированными валидаторами и разбором транскриптов. CI может сравнивать стабильный JSON-объект, но это проверяет возможность изучить вердикт и его форму, а не доказывает, что этапы рубрики были выполнены.
Структурированный вердикт также упрощает тестирование более дешёвого джаджа. Считайте более дешёвую модель кандидатом, а не автоматической заменой. Прогоните её на том же калибровочном наборе с человеческими метками. Сравните её согласие, долю ложных зачётов и долю ложных провалов с более крупным джаджем. Используйте её для рутинных случаев, только если она проходит пороги, заданные вашим приложением. Более крупного джаджа оставьте для расхождений, случаев высокого риска и калибровочных прогонов.
Базовый чек-лист гигиены джаджа:
- По возможности предпочитайте бинарный pass/fail. Пятибалльные шкалы создают ложную точность.
- Разметьте траектории, покрывающие реальные виды сбоев, прежде чем фиксировать рубрику. Размер выборки выбирайте по покрытию и по неопределённости, которую решение может допустить, затем отложите отдельные кейсы для валидации.
- Измеряйте согласие джаджа с людьми через каппу Коэна, матрицу ошибок и recall по положительному и отрицательному классам. Каппа измеряет согласие с поправкой на согласие, ожидаемое случайно; чем выше, тем лучше. Джадж, который всегда говорит «pass», ничего полезного не различает, поэтому каппа может быть нулевой или неопределённой. Решите, что делать, когда она не определена, прежде чем использовать метрику для одобрения релиза.
- Разбивайте грубые критерии. «Проверил ли агент личность перед tool call возврата?» лучше, чем «Была ли траектория хорошей?»
- Выдавайте вердикт через схему SGR со свидетельствами, списками критериев, видом сбоя и полем pass/fail.
- Сравнивайте джаджей из того же и из другого семейства на отложенных человеческих метках; одно лишь разделение семейств не устанавливает надёжность.
- Измеряйте чувствительность попарной оценки к порядку. Оставляйте рандомизацию или агрегацию с обменом порядка, только если они улучшают решения на отложенной выборке; контролируемое исследование 2026 года показало, что обмен мог вредить на состязательных кейсах.
- Не засчитывайте лишний текст, если он не добавляет верного, релевантного, подкреплённого содержания. Более длинный ответ не значит лучший.
- Зафиксируйте модель джаджа, промпт, датасет, схему и версию приложения.
- Перекалибруйте после изменений модели, промпта, инструментов, политики или схемы.
Панель — ещё один кандидат для проверки. PoLL сообщил о лучшем согласии с человеческими оценками, меньшем внутримодельном смещении и меньшей стоимости по сравнению с базовым одиночным GPT-4 на шести датасетах. Эти результаты относятся к его моделям, задачам и историческим ценам. Они не доказывают, что панель безопаснее на вашей задаче. Сравните её ложные зачёты, ложные провалы, стоимость и объём работы по разбору расхождений с одним откалиброванным джаджем на отложенных метках.
Универсального порога каппы, при котором джадж годится для CI, не существует. Сообщайте матрицу ошибок, число меток, долю ложных зачётов среди человеческих провалов и долю ложных провалов среди человеческих зачётов, с неопределённостью. Выбирайте релизные пределы по последствиям этих ошибок. Используйте очереди на ревью, когда свидетельств слишком мало для автоматического принятия, и оставляйте за человеком авторизацию значимых действий там, где этого требует воркфлоу.
Гардрейлы блокируют inline, онлайн-эвалы наблюдают потом
Их путают, потому что оба выдают оценки. Разница в размещении: inline на пути запроса, после ответа или перед релизом. На рисунке три размещения показаны на одной шкале времени вместе с тем, что каждое из них может остановить.
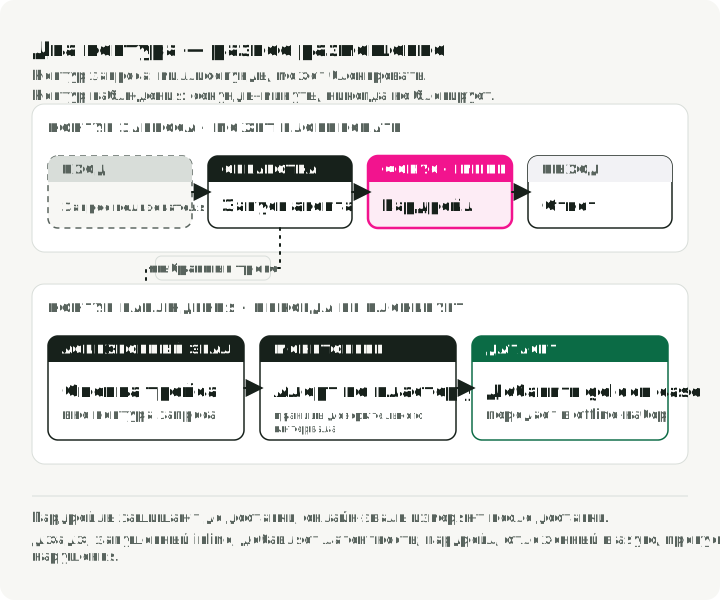
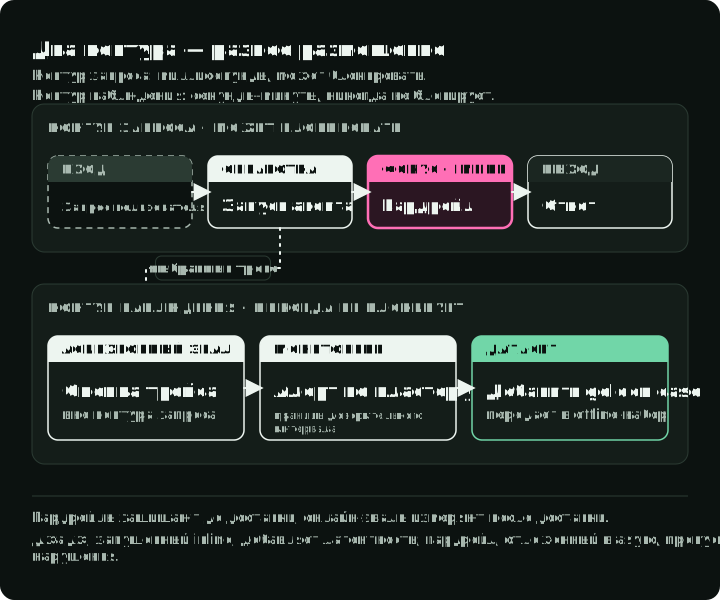
Гардрейлы работают inline. Они быстрые и видны пользователю. Гардрейл может заблокировать tool call, замаскировать PII, отклонить промпт-инъекцию или заставить повторить попытку до того, как ответ покинет вашу систему. Ложное срабатывание — это баг в продакшене. Ложный пропуск тише и хуже, потому что ничто на пути запроса о нём не сообщает. Проверки схемы, диапазонов и политик детерминированы. Детекция инъекций и PII — это классификаторы, поэтому считайте промахи ожидаемыми и держите асинхронный эвал, который следит за тем, что они пропускают.
Онлайн-эвалы работают после ответа, обычно на выборке трафика. Они могут использовать более медленных LLM-джаджей, потому что не стоят на пути латентности. Их задача — обнаруживать дрейф, находить новые кластеры сбоев и пополнять следующий офлайн-датасет.
Офлайн-эвалы работают перед релизом. Они воспроизводимы. Они проверяют промпты, модели, инструменты, ретриверы и политики на фиксированном датасете.
У каждого неверного размещения своя цена:
- Джадж на пути запроса добавляет латентность и новый источник нестабильности.
- Гардрейл, отправленный в асинхронную оценку, пропускает нарушения политик к пользователям.
В тестах безопасности различайте обнаружение атаки, попытку запрещённого действия и действительно успешный вредный эффект. Сообщайте успешные вредные эффекты на одну атакующую попытку, с моделью угроз и бюджетом попыток, рядом с успехом легитимных задач и ложными блокировками на одну безобидную попытку. Одна лишь оценка детектора не доказывает, что данные остались приватными или что запись была предотвращена. Используйте изолированные цели; отчёт Anthropic об инциденте при оценке кибербезопасности документирует, почему эффекты оценки нужно держать в изоляции.
Для систем с большим объёмом оценивайте небольшую выборку более сильным джаджем, а более широкую — более дешёвыми классификаторами. Поднимайте тревогу по кластерам и доверительным границам, а не по одной шумной точечной оценке.
Выбор инструментов
Ни один инструмент не владеет всем циклом. Сравнивайте хранилище трейсов и датасетов и раннер для CI и эвалов по отдельности; один продукт может покрывать оба, но покупать оба у одного вендора не обязательно. Колонка «Покрывает» показывает, какие роли выполняет каждый инструмент.
| Инструмент | Покрывает | Выбирайте, когда… | Ограничение или источник затрат |
|---|---|---|---|
| DeepEval | Раннер | Вы запускаете проверки на Python и pytest; deepeval test run роняет сборку при провале метрики. | Только раннер. Вызовы модели-джаджа стоят токенов; облачная платформа Confident AI тарифицирует хранимые данные трейсов. |
| Inspect AI | Раннер | Вам нужны задачи по безопасности, frontier-задачи или агентные задачи в сэндбоксах. | Только раннер, с открытым кодом. Сэндбоксы и доступ к моделям настраиваете вы; это не хранилище продакшен-трейсов. |
| Phoenix | Хранилище трейсов, датасеты, раннер | Вам нужны self-hosted трейсинг и эвалы с данными в вашей инфраструктуре. | Бесплатно для self-hosting; деплой вы обслуживаете сами. Облачный Arize AX тарифицирует по спанам, хранилищу и сроку хранения. |
| Langfuse | Хранилище трейсов, датасеты, раннер | Вам нужен воркфлоу трейсов, датасетов и экспериментов с открытым кодом, с CI-действием, которое фиксирует версию датасета и падает при регрессии. | При self-hosting вы обслуживаете его стек хранения; для некоторых функций нужна лицензия. Облако тарифицирует по трейсам, наблюдениям и оценкам. |
| LangSmith | Хранилище трейсов, датасеты, раннер | Вы уже используете LangChain/LangGraph и принимаете границы его платформы. | Self-hosting и гибридный хостинг требуют Enterprise. Облако тарифицирует по местам, трейсам и сроку хранения. |
| Braintrust | Хранилище трейсов, датасеты, раннер | Управляемая обратная связь по PR и сопоставимые снапшоты экспериментов важнее self-hosting. | Управляемый сервис; self-hosting требует Enterprise. Тарифицирует по обработанным данным, оценкам и сроку хранения. |
| Promptfoo | Раннер, red team | Регрессии промптов или red-team нужно прогнать перед деплоем. | Раннер и red-team тесты; хранилища трейсов нет. Открытый код; платные планы добавляют red-team пробы и командные функции. |
Вендоры тарифицируют в разных единицах (трейсы, спаны, оценки, места, срок хранения или обработанные данные), поэтому сравнивайте актуальные цены на собственном объёме трейсов. Источники затрат выше сверены со страницами цен в октябре 2026 года.
Выбор инструмента вторичен. Если продакшен-сбои не становятся тестовыми кейсами, вы в основном платите за хранение трейсов.
Практический чек-лист внедрения
Постройте пайплайн свидетельств, прежде чем расширять набор метрик. Начните с решения, откуда будут браться примеры.
-
Сначала соберите исторические запуски. Если агент уже существует, вытащите трейсы, тикеты поддержки, баг-репорты, сессии с дизлайками, транскрипты ручного QA и заметки о dogfooding до изменения реализации. Если агента ещё нет, логируйте каждый запуск прототипа и ручного теста с первого дня.
-
Инструментируйте форму трейса. Фиксируйте сообщения, tool calls, аргументы, выходы инструментов, ошибки, число токенов, латентность, стоимость, отзывы пользователей, версию приложения, версию промпта, версию модели, версию схемы инструментов и итоговое состояние окружения. Используйте конвенции OpenTelemetry GenAI или спаны в стиле OpenInference, если нужна переносимость, и фиксируйте версию конвенции и адаптер. Захватывайте содержимое выборочно: удаляйте секреты и персональные данные, ограничивайте доступ и задавайте срок хранения до продвижения трейсов в датасеты. Используйте Langfuse, LangSmith, Phoenix или Braintrust, если вам сразу нужен UI для трейсов и воркфлоу датасетов.
-
Превратите реальные сбои в начальные кейсы. Прочитайте трейсы, прежде чем резюмировать их моделью. Для каждого полезного сбоя сохраните вход, ID исходного трейса, ожидаемое состояние, ожидаемые инварианты инструментов, вид сбоя, серьёзность и заметку ревьюера. Langfuse умеет связывать элементы датасета с продакшен-трейсами; LangSmith умеет создавать датасеты из трассированных запусков. Сохраняйте ссылку на источник, чтобы кейс оставался проверяемым.
-
Если истории нет, сгенерируйте кейсы для холодного старта. Попросите LLM набросать задачи по продуктовым требованиям, политикам, схемам инструментов, машинам состояний и макросам поддержки. Покройте happy path и сбои вроде неверных прав, отсутствующих проверок личности, устаревших результатов инструментов, неоднозначных дат, повторов после лимитов частоты и противоречивых выходов инструментов.
-
Не доверяйте синтетическим кейсам, пока их не проверил человек. Синтетические примеры полезны для покрытия, но не для истины. Помечайте их
source: syntheticи требуйте, чтобы ревьюер утвердил ожидаемый исход. По возможности прогоняйте заведомо верный эталонный путь и валидируйте сгенерированные ожидания независимо; использование другого семейства моделей эту проверку не заменяет. -
Постройте небольшой сбалансированный датасет. Включите успехи, сбои, отказы, граничные случаи, длинные многоходовые кейсы, кейсы, чувствительные к политикам, и допустимые альтернативные пути. Не делайте голден «точным старым транскриптом». Храните поля из примера голдена в разделе «Дедуплицируйте перед продвижением», включая вид сбоя, из-за которого кейс попал в набор.
-
Сначала добавьте детерминированные проверки. Обязательный порядок инструментов там, где порядок — политика, обязательные аргументы, валидация схемы, диффы итогового состояния, лимиты циклов, потолки токенов и латентности и инварианты конкретной задачи должны выполняться до любого джаджа.
-
Добавьте одного джаджа в форме SGR. Используйте его только для части, которой нужна интерпретация. Откалибруйте его по человеческим меткам и проверьте выбранную рубрику на нетронутых валидационных кейсах. Если он не различает хорошие и плохие примеры на калибровочном наборе, исправьте рубрику, прежде чем подключать его к CI.
-
Замкните цикл. Запускайте небольшой офлайн-набор в CI, больший набор перед релизом, оценивайте выборку продакшен-трафика онлайн и возвращайте повторяющиеся кластеры онлайн-сбоев в офлайн-датасет.
Ваш первый набор эвалов упустит кейсы. Всё равно запустите его, а затем добавляйте повторяющиеся сбои как кейсы. Набор, который запускается каждый день, даёт свидетельства для его улучшения.
Источники
- trace2evals companion demo repository
- LangChain - State of Agent Engineering
- Anthropic - Demystifying Evals for AI Agents
- Hamel Husain - A Field Guide to Rapidly Improving AI Products
- OpenTelemetry semantic conventions for generative AI systems
- DeepEval Tool Correctness
- DeepEval Task Completion
- DeepEval unit testing in CI/CD
- Inspect running evals
- OpenAI Structured model outputs
- Schema-Guided Reasoning: vLLM, xgrammar, and Pydantic
- Phoenix self-hosting
- Langfuse datasets and versioning
- Langfuse experiments in CI/CD
- LangSmith platform setup
- LangSmith - Create and manage datasets programmatically
- Braintrust - Create experiments
- Phoenix LLM evals
- Promptfoo GitHub Action integration
- tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- Why Do Multi-Agent LLM Systems Fail?
- Establishing Best Practices for Building Rigorous Agentic Benchmarks
- G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
- Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models
- JudgeBench: A Benchmark for Evaluating LLM-based Judges
- Self-Preference Bias in LLM-as-a-Judge