Ewaluacja agentów AI na produkcji: od trace’ów do zestawów testów

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten poradnik jest dla inżynierów, którzy oceniają agentów AI korzystających z narzędzi na produkcji. Dowiesz się, jak zamieniać nieudane uruchomienia w powtarzalne testy, sprawdzać działania agenta, a nie tylko jego odpowiedzi, i uruchamiać te testy przed kolejnym wydaniem.
Krótkie porównanie narzędzi znajdziesz w artykule Najlepsze narzędzia do ewaluacji agentów AI.
Dlaczego ewaluacja agentów jest inna
Tradycyjna ewaluacja LLM zwykle ocenia jedną parę wejście–wyjście: trafność, wierność źródłom, poprawność, bezpieczeństwo, czasem styl. Agenci dodają planowanie, wywołania narzędzi, ponowienia i kontrole zakończenia, a każdy krok to kolejne miejsce, w którym coś może się zepsuć.
Weźmy agenta od zwrotów. Transkrypt może kończyć się dobrze, choć trace jest błędny:
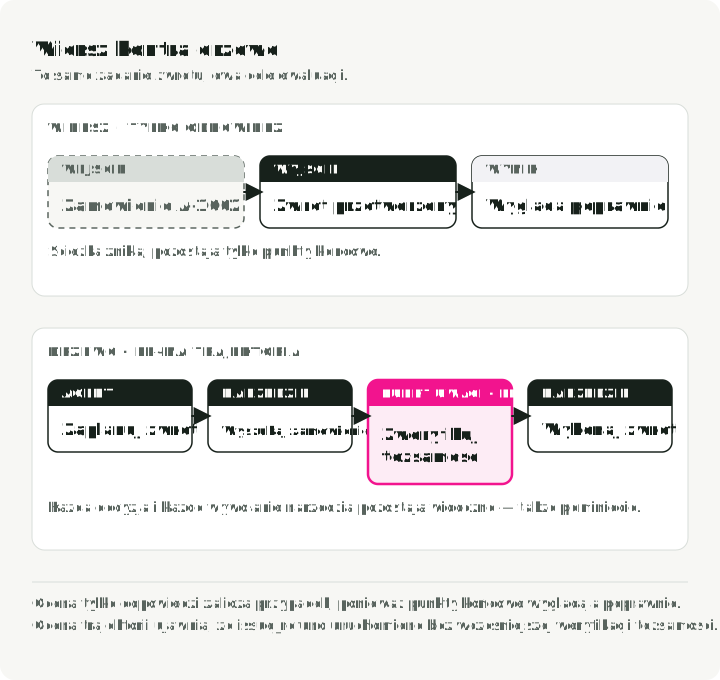
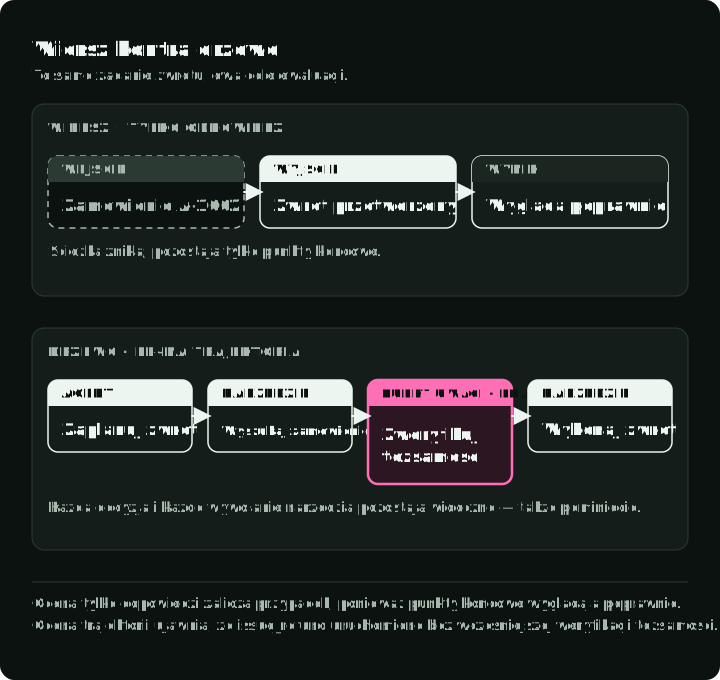
lookup_order -> issue_refund -> final_answerEwaluacja wyniku przechodzi. Ewaluacja trajektorii powinna zawieść, bo verify_identity nigdy się nie wykonało przed issue_refund. W przypadku agentów korzystających z narzędzi ewaluacje samych odpowiedzi mogą wychwycić problemy z jakością treści, ale nie dowodzą, że agent przeszedł poprawną trajektorią ani że wywołał wymagane skutki uboczne.
Lewa karta to wiersz, który czyta ewaluacja samej odpowiedzi; prawa karta to trace, który czyta ewaluacja trajektorii, z pominiętą weryfikacją tożsamości.
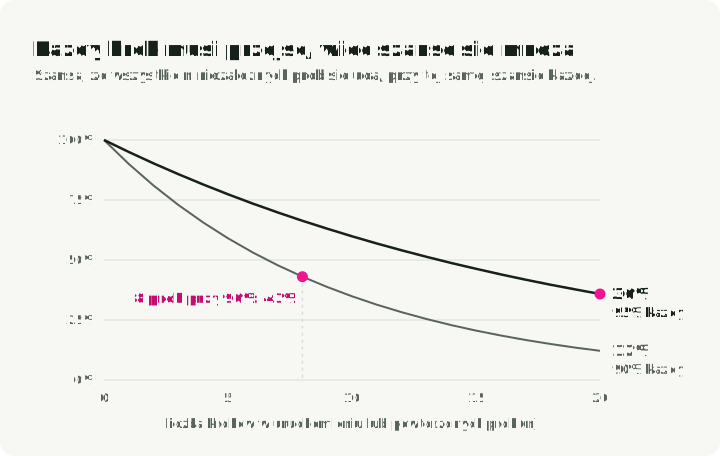
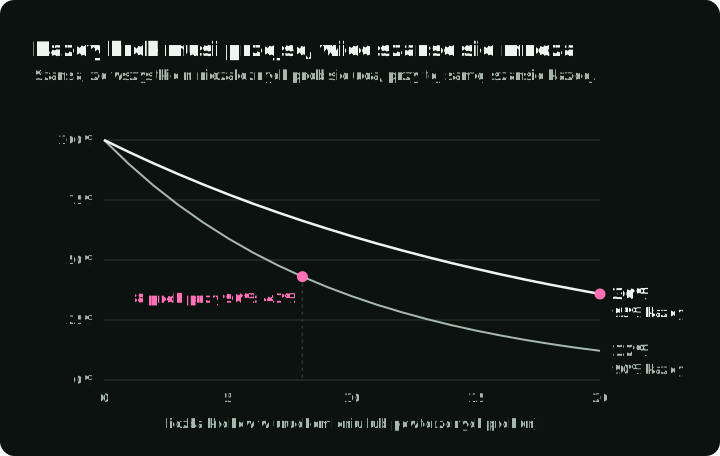
Jest też drugi problem: błędy się kumulują. Jeśli przepływ ma 20 wymaganych kroków, każdy kończy się sukcesem niezależnie od pozostałych i każdy ma tę samą niezawodność 95%, to jego skuteczność od początku do końca wynosi około 36%:
Agent może więc wyglądać solidnie w izolowanych kontrolach, a mimo to zawodzić w większości pełnych uruchomień. Awaria zwykle jest gdzieś w środku, a jej znalezienie wymaga wglądu na poziomie komponentów, a nie kolejnego spojrzenia na odpowiedź.
tau-bench daje agentowi zadania z obsługi klienta linii lotniczej i sklepu. Agent rozmawia z symulowanym użytkownikiem, wywołuje API i musi przestrzegać zasad domeny. Po rozmowie ewaluator sprawdza, czy baza danych osiągnęła oznaczony stan docelowy. Wiarygodny transkrypt z błędnymi wierszami w bazie nadal się nie zalicza.
Przy takiej ocenie GPT-4o rozwiązał tylko 35,2% zadań lotniczych i nieco ponad 60% zadań ze sklepu. Artykuł wprowadził też pass^k: prawdopodobieństwo, że wszystkie k niezależnych prób się powiedzie, uśrednione po zadaniach.
W łatwiejszym podzbiorze, czyli w sklepie, pass^8 było poniżej 25%. Dla losowo wybranego zadania ze sklepu i ośmiu niezależnych prób szansa, że wszystkie osiem uruchomień zakończy się sukcesem, wynosiła mniej niż 25%. Ewaluacja z jednym uruchomieniem nie zmierzy takiej spójności.
Wykres pokazuje oba przypadki: szansa, że przejdzie każdy krok lub każda próba, maleje z każdym dodanym. Przy 90% na krok spadek jest ostrzejszy: jeśli każdy z 20 niezależnych kroków przechodzi w 90% przypadków, wszystkie 20 przejdzie w około 12% przypadków (0.9^20 ≈ 0.12).
MAST bada, dlaczego agenci zawodzą. Autorzy zbudowali taksonomię 14 trybów awarii na podstawie 150 ręcznie opisanych trace’ów, a następnie zastosowali ją do ponad 1600 trace’ów z 7 popularnych frameworków wieloagentowych. Taksonomia obejmuje niejasne definicje ról (projekt systemu), agenta ignorującego to, co zgłosił inny agent (rozbieżność między agentami), i ogłaszanie sukcesu bez sprawdzenia wyniku (brak weryfikacji). Te awarie dotyczą tekstów prompt, logiki orkiestracji i brakujących kontroli w harnessie. Mocniejszy model bazowy nie wykona kroku weryfikacji, którego nikt nie zbudował, więc przedmiotem ewaluacji musi być także harness wokół modelu.
Luka we wdrożeniach
Ankieta LangChain State of Agent Engineering (1340 respondentów, badanie z końca 2025 roku) sugeruje, że wiele zespołów ma już surowiec do lepszych ewaluacji. Według raportu 89% miało jakąś obserwowalność, 52,4% uruchamiało ewaluacje offline, a 37,3% ewaluacje online.
Ankieta podaje też, że 57,3% respondentów ma już agentów na produkcji. Zapytani, co blokuje produkcję, 32% wskazało jakość, a 20% opóźnienia. To ankieta dostawcy przeprowadzona wśród jego respondentów, a nie spis zespołów budujących agentów, ale pokazuje użyteczną lukę między zbieraniem trace’ów a systematyczną ewaluacją.
Zespoły zostają więc w niewygodnym stanie pośrednim: potrafią przeanalizować zły przebieg po fakcie, a mimo to wypuszczają tę samą awarię dwa razy.
Każda zdiagnozowana awaria produkcyjna powinna zostawić po sobie trace, etykietę, wiersz zbioru danych i scorer. Awaria, która się powtarza, należy do zestawu regresyjnego.
Dobieraj metryki do trybu awarii
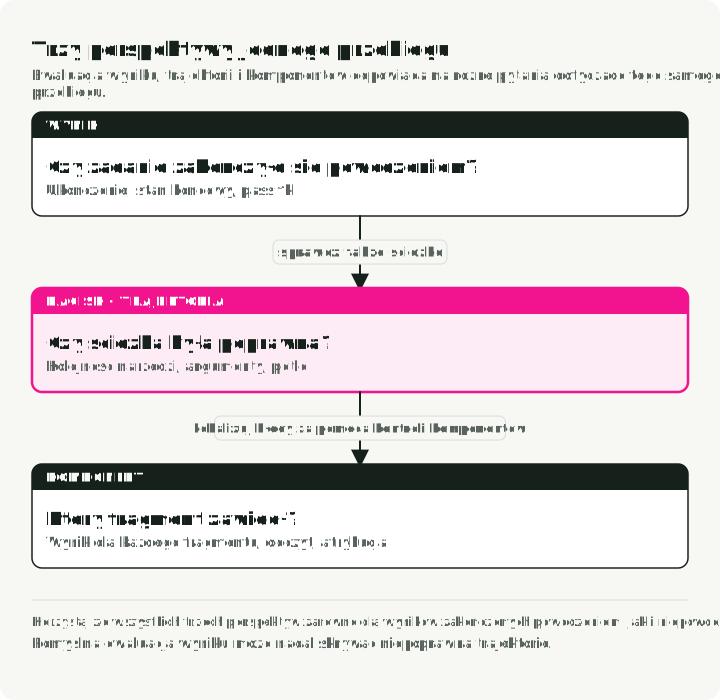
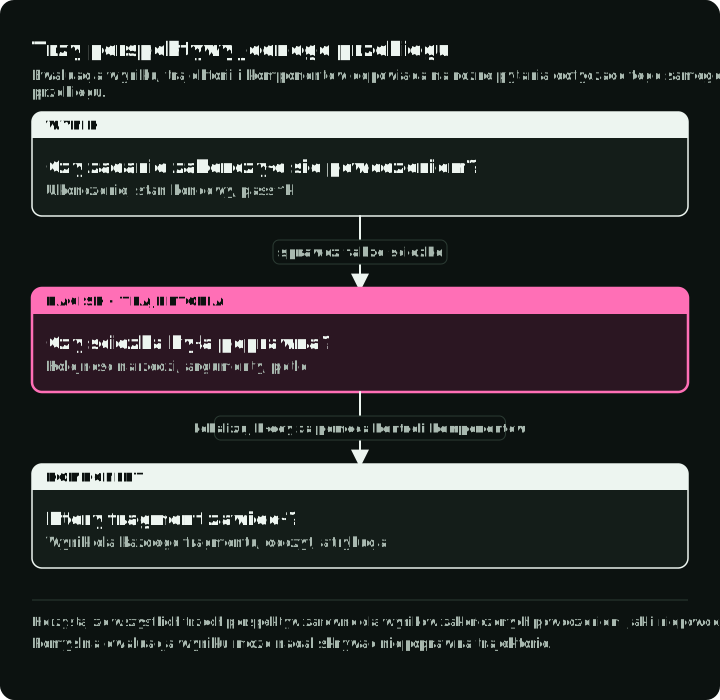
Wybierz metrykę według awarii, którą chcesz wychwycić. Przydatny podział ma trzy poziomy:
- Ewaluacje wyniku odpowiadają, czy zadanie się powiodło.
- Ewaluacje trajektorii odpowiadają, czy ścieżka była poprawna, wydajna i zgodna z polityką.
- Ewaluacje komponentów odpowiadają, które narzędzie, moduł wyszukiwania, pod-agent lub krok decyzyjny się zepsuł.
Rysunek pokazuje, którą część tego samego uruchomienia czyta każdy poziom.
Każdy poziom można uruchamiać offline na stałych, powtarzalnych przypadkach przed wydaniem albo online na próbkowanych trace’ach produkcyjnych po udzieleniu odpowiedzi. Sekcja o guardrails poniżej opisuje ten podział szczegółowo. Ewaluacje offline mogą wymagać wzorców (goldens): zapisanych przypadków, które łączą wejście z wynikiem, niezmiennikami narzędzi i argumentami, jakie musi dać poprawne uruchomienie. Pełny golden znajdziesz w sekcji „Deduplikuj, zanim awansujesz przypadek” poniżej. Ewaluacje online powinny preferować niezmienniki, rozkłady i asynchroniczne kontrole, które nie leżą na ścieżce żądania.
| Pytanie | Rodzina metryk | Kontrakt offline / online | Deterministycznie czy sędzia? | Na co uważać |
|---|---|---|---|---|
| Czy agent wywołał właściwe narzędzia? | Poprawność narzędzi: dopasowanie dokładne, w kolejności lub w dowolnej kolejności | Dokładne goldens offline; wymagane niezmienniki narzędzi i anomalie online | Deterministycznie | Dokładne dopasowanie karze poprawne alternatywne ścieżki |
| Czy wywołał je z właściwymi danymi? | Poprawność argumentów, walidacja schematu, dopasowanie parametrów | Oczekiwane argumenty offline; kontrole schematu, zakresu i polityki online | Oba | Właściwe narzędzie z błędnymi argumentami nadal jest zepsute |
| Czy marnował kroki? | Wydajność kroków, liczba ponowień, wykrywanie pętli, koszt i opóźnienie | Budżety kroków i pętli offline; dryf kosztu i opóźnienia online | W większości deterministycznie | Wysoki odsetek ukończonych zadań może ukrywać kosztowne błądzenie |
| Czy zadanie faktycznie się powiodło? | Ukończenie zadania, ocena wyniku, różnica stanu końcowego | Symulator lub stan wzorcowy offline; stan końcowy, sygnał od użytkownika lub asynchroniczny sędzia online | Sędzia lub kontrola stanu | Oceniaj stan środowiska, gdy to możliwe |
| Czy zachował kontekst między turami? | Wierność w wielu turach, trzymanie się roli, kompletność rozmowy | Skryptowane przypadki o długim horyzoncie offline; próbkowane długie sesje online | Sędzia | Testy jednoturowe nic nie mówią o turze 14 |
| Czy zatrzymał się we właściwym momencie? | Poprawność zakończenia, przedwczesny sukces, niekończąca się praca | Testy scenariuszy offline; monitory pętli, limitów czasu i fałszywego sukcesu online | Oba | „Gotowe” może być halucynowanym stanem |
| Czy poprawnie zinterpretował wyniki narzędzi? | Rozumienie wyników narzędzi, kontrole stanu następczego | Przeciwnicze wyniki narzędzi offline; kontrole stanu następczego i próbkowany przegląd online | Oba | Oceniaj stan następczy, a nie kod wyjścia narzędzia |
Zacznij od metryk deterministycznych. Powtarzają się dla stałych danych wejściowych i kodu, a ich uruchamianie jest tanie. Ich reguły mogą jednak się zestarzeć, gdy zmienią się narzędzia lub polityka, więc wersjonuj scorer razem ze specyfikacją, którą sprawdza.
Sprawdzającego dobieraj według kryterium: kod, gdy kod może to sprawdzić; kolejka przeglądu, dopóki nie ma skalibrowanego sędziego; człowiek, gdy werdykt uruchamia istotne działanie; a w pozostałych przypadkach skalibrowany sędzia LLM.
Poprawność wywołań narzędzi
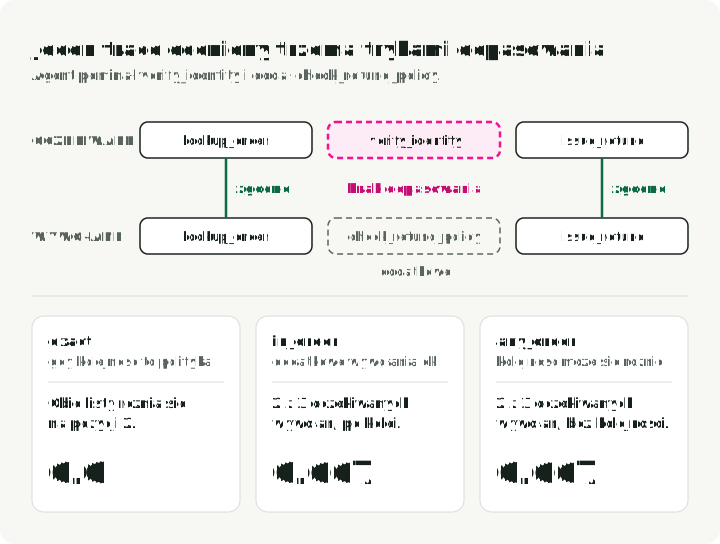
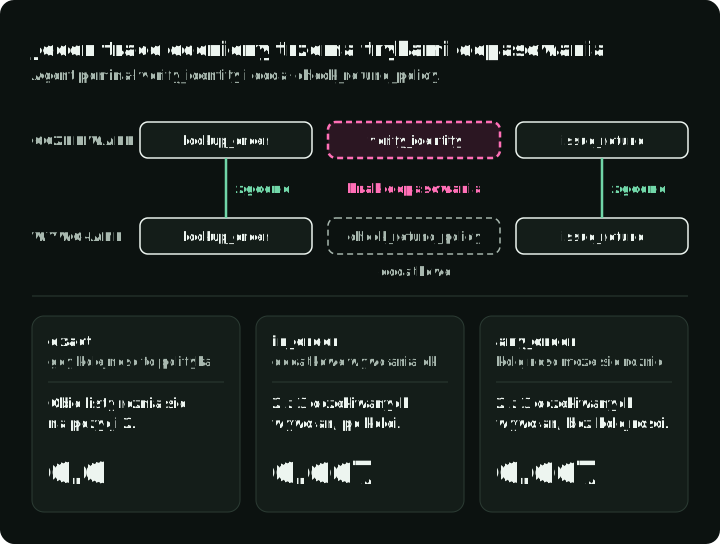
Poprawność narzędzi porównuje wywołane narzędzia z oczekiwanymi. Wybierz rygor świadomie:
- Dopasowanie dokładne: sekwencja musi się zgadzać dokładnie. Używaj, gdy kolejność jest polityką, na przykład
lookup_order -> verify_identity -> issue_refund. - Dopasowanie w kolejności: wymagane narzędzia muszą wystąpić we właściwej kolejności względnej, ale dodatkowe nieszkodliwe wywołania są dozwolone.
- Dopasowanie w dowolnej kolejności: wymagane narzędzia muszą wystąpić, ale kolejność może być dowolna.
Rysunek ocenia jeden trace we wszystkich trzech trybach. Agent pominął verify_identity i wykonał dodatkowe wywołanie check_refund_policy.
Na start wystarczy mały lokalny scorer:
from collections import Counter

def tool_correctness(called: list[str], expected: list[str], mode: str = "in_order") -> float:
    if mode not in {"exact", "in_order", "any_order"}:
        raise ValueError(f"unknown matching mode: {mode}")
    if mode == "exact":
        return float(called == expected)
    if not expected:
        return 1.0
    if mode == "any_order":
        matched = sum((Counter(called) & Counter(expected)).values())
        return matched / len(expected)

    rows = [[0] * (len(expected) + 1) for _ in range(len(called) + 1)]
    for i, tool in enumerate(called):
        for j, wanted in enumerate(expected):
            if tool == wanted:
                rows[i + 1][j + 1] = rows[i][j] + 1
            else:
                rows[i + 1][j + 1] = max(rows[i][j + 1], rows[i + 1][j])
    return rows[-1][-1] / len(expected)

called = ["lookup_order", "check_refund_policy", "issue_refund"]
expected = ["lookup_order", "verify_identity", "issue_refund"]

print(round(tool_correctness(called, expected, "exact"), 3))     # 0.0
print(round(tool_correctness(called, expected, "in_order"), 3))  # 0.667
assert tool_correctness(["issue_refund"], [], "exact") == 0.0
assert tool_correctness([], [], "exact") == 1.0
assert tool_correctness(["a", "b"], ["a", "a", "b"], "any_order") == 2 / 3
try:
    tool_correctness([], [], "typo")
except ValueError:
    pass
else:
    raise AssertionError("unknown modes must fail")
Wynik in_order to recall najdłuższego wspólnego podciągu: jaka część wymaganej sekwencji przetrwała we właściwej kolejności. Zwróć uwagę, czego ten wynik nie widzi. Zbędne wywołania go nie obniżają, więc agent może tu dostać 1.0, wykonując dwa razy więcej wywołań, niż potrzebował. Gdy dodatkowe wywołania kosztują lub zmieniają stan, śledź obok niego precyzję (dopasowane wymagane wywołania podzielone przez wszystkie wywołania) i czytaj oba wyniki razem. Recall wychwytuje brakujący krok, a precyzja błądzenie. Dobry wynik za narzędzia nie czyni dodatkowego zwrotu ani zapisu bezpiecznym. Sprawdzaj każde wywołanie zmieniające stan osobno: uprawnienia, zasób, argumenty i weryfikację, która musi je poprzedzać. Jeśli nie oczekuje się żadnych narzędzi, tylko tryb exact oblewa uruchomienie, które wywołuje narzędzia; pozostałe dwa tryby zwracają 1.0.
Metryka Tool Correctness w DeepEval udostępnia te same ustawienia przez should_consider_ordering i should_exact_match.
Poprawność argumentów
Wywołanie właściwego narzędzia z błędnymi argumentami jest często gorsze niż wywołanie złego narzędzia, bo trace wygląda normalnie.
W prostych przypadkach waliduj JSON Schema i dokładne wartości. W przypadkach semantycznych zapisz oczekiwane argumenty razem z przypadkiem, tak jak robi to pole expected_arguments w golden z sekcji „Deduplikuj, zanim awansujesz przypadek”, i oceniaj różnice. Metryka nazwy narzędzia nie wychwyci 2026-06-17 tam, gdzie polityka wymaga 2026-06-19.
W tym przykładzie z jednym wywołaniem na narzędzie parameter-match to ułamek oczekiwanych trójek (tool, key, value), które agent podał poprawnie. Poniższe słowniki są poprawne tylko wtedy, gdy każde istotne narzędzie ma co najwyżej jedno wywołanie. Nie buduj ich przez nadpisywanie wcześniejszych wywołań o tej samej nazwie: ukryłoby to błędny zwrot, po którym nastąpił poprawny. Przy powtarzanych wywołaniach zachowaj identyfikatory wywołań i kolejność, dopasuj właściwe wywołanie i waliduj każdą mutację osobno.
def argument_correctness(called_args: dict, expected_args: dict) -> float:
    total = matched = 0
    for tool, params in expected_args.items():
        for key, want in params.items():
            total += 1
            if key in called_args.get(tool, {}) and called_args[tool][key] == want:
                matched += 1
    return matched / total if total else 1.0

assert argument_correctness({}, {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {}},
                            {"reschedule_delivery": {"date": None}}) == 0.0
assert argument_correctness({"reschedule_delivery": {"date": None}},
                            {"reschedule_delivery": {"date": None}}) == 1.0
Dokładna równość jest właściwa dla identyfikatorów, enumów i dat znormalizowanych do jednego formatu. Jest błędna dla tekstu swobodnego, liczb zmiennoprzecinkowych i dat w dowolnej postaci, jaką wygenerował model, gdzie == uzna poprawną odpowiedź za błędną. Oceniaj te pola na ich własnych zasadach: znormalizowane porównanie ciągów, parsowanie daty, tolerancja liczbowa. Metryka pozostaje ta sama; zmienia się komparator dla pola.
Wydajność, pętle i ślepe zaułki
Agent, który kończy zadanie po pięciu zbędnych wywołaniach narzędzi, nadal sygnalizuje problem z planowaniem i kosztuje więcej.
Tanie sygnały, od których warto zacząć:
- Odsetek zbędnych wywołań: identyczne wywołania narzędzi z identycznymi argumentami powtórzone więcej niż dwa razy.
- Anomalie kształtu trace’a: nagłe skoki głębokości, liczby wywołań narzędzi, liczby jednostek token, opóźnienia lub kosztu.
- Zbieżność ścieżki: jak blisko uruchomienie jest najkrótszej znanej poprawnej ścieżki dla zadania.
- Poprawność zakończenia: czy agent zatrzymał się za wcześnie, pracował dalej po sukcesie albo ogłosił sukces bez wymaganej zmiany stanu.
- Zgodność z planem: jeśli agent pisze plan przed działaniem, sprawdź, czy trace go zrealizował. Dobry plan zignorowany i zły plan wykonany bezbłędnie zawodzą z przeciwnych powodów, a różnica między planem a trace’em mówi, który to przypadek.
Uruchamiaj je przed sędzią, kiedy tylko się da. Detektor pętli to kilka linii nad trace’em i nie potrzebuje modelu. Ten zlicza najczęściej powtórzone identyczne wywołanie w trace’ie:
import json

def redundant_call_count(tool_calls: list[dict]) -> int:
    seen: dict[str, int] = {}
    for call in tool_calls:
        key = call["name"] + json.dumps(call["arguments"], sort_keys=True)
        seen[key] = seen.get(key, 0) + 1
    return max(seen.values(), default=0)

calls = [{"name": "lookup_order", "arguments": {"order_id": "A-100"}}] * 3
assert redundant_call_count(calls) == 3
assert redundant_call_count([]) == 0
Oznacz trace, gdy wynik jest większy niż 2. Repozytorium towarzyszące stosuje tę samą regułę.
Ukończenie zadania i ocena wyniku
Oceniając wynik, pytamy: „czy użytkownik dostał to, o co prosił?”
Najlepiej działają dwa wzorce:
- Ocena ukończenia zadania bez wzorca: wyodrębnij cel z wejścia i oceń, czy trace wraz z odpowiedzią końcową go osiągnął. Działa to online, bo ruch produkcyjny rzadko ma wzorcowe odpowiedzi.
- Ocena stanu środowiska: porównaj końcowe wiersze bazy, pliki, zgłoszenia, rezerwacje lub rekordy z oznaczonym stanem docelowym. Jest to odporniejsze niż dopasowanie transkryptu, bo agenci potrafią znaleźć poprawne ścieżki, których nie zapisałeś.
Druga opcja jest lepsza, gdy da się ją zbudować. Oceniaj stan końcowy; transkryptu używaj do wyjaśnienia awarii.
Ocena stanu ma dwa ograniczenia. Audyt benchmarków agentowych z 2025 roku wykazał, że tau-bench ocenia niektóre zadania wyłącznie na podstawie stanu bazy danych. W części zadań oznaczony wynik nie wymaga żadnej zmiany stanu ani konkretnego tekstu. Agent, który nic nie robi, może wtedy zaliczyć zadanie: 38% w podzbiorze lotniczym i 6,0% w sklepie, przy dowolnym k. Anthropic opisał uruchomienie Opus 4.5, które „oblało” zadanie rezerwacji w tau2-bench, następcy tego benchmarku. Agent znalazł lukę w polityce, która dała użytkownikowi lepszy wynik. Ocena stanu jest lepsza niż dopasowanie transkryptu, ale stan docelowy to nadal adnotacja, a adnotacje mają błędy. Audytuj przypadki, które przechodzą zbyt łatwo, nie tylko te, które zawodzą.
Ewaluacje komponentów
Metryki wyniku i trajektorii mówią, że uruchomienie zawiodło, i mniej więcej gdzie. Ewaluacje komponentów oceniają jeden span: czy pobrany fragment był trafny, czy pod-agent zwrócił schemat, którego oczekiwał wywołujący, czy odpowiedź samego narzędzia dała się sparsować. Przypisz wynik do spanu, a nie do uruchomienia, wtedy pytanie „które narzędzie pogorszyło się w tym tygodniu” jest zapytaniem, a nie ponownym uruchomieniem.
Większość pokrywają trzy kontrole:
- Ocena per span: uruchom metrykę pasującą do typu spanu. Spany wyszukiwania dostają recall i precyzję względem oznaczonego fragmentu, spany pod-agentów dostają walidację schematu oraz własny wynik poprawności narzędzi, a spany narzędzi dostają odsetek błędów i opóźnienie.
- Interpretacja wyników narzędzi: podaj agentowi poprawny, ale kłopotliwy wynik narzędzia (pustą listę, częściowe dopasowanie, nieaktualny znacznik czasu) i sprawdź, co zrobi dalej. Narzędzie może być poprawne, a agent może źle odczytać jego wynik, i ta awaria wychodzi dwa kroki później.
- Przypisanie awarii: widoczna awaria zwykle leży za właściwą. Przypisz ją do najwcześniejszego spanu, którego wynik był już błędny, a nie do kroku, który zgłosił błąd.
Rysunek pokazuje pięciospanowe uruchomienie zwrotu. Agent planuje znaleźć zamówienie i zwrócić pieniądze. search_orders zwraca stary ID zamówienia, lookup_order pobiera to błędne zamówienie, issue_refund zgłasza błąd, bo zamówienia nie można zwrócić, a final_answer informuje użytkownika, że zwrot się nie udał. Błąd pojawia się w issue_refund (krok 4), ale pierwszy błędny wynik pochodził z search_orders (krok 2), dwa spany wcześniej.
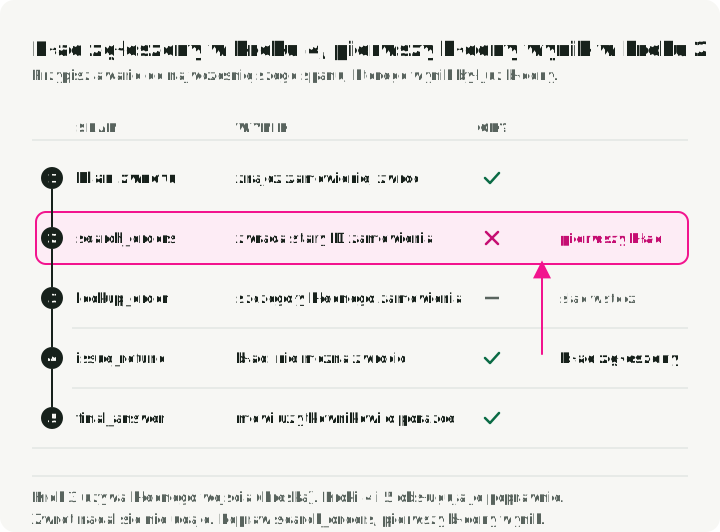
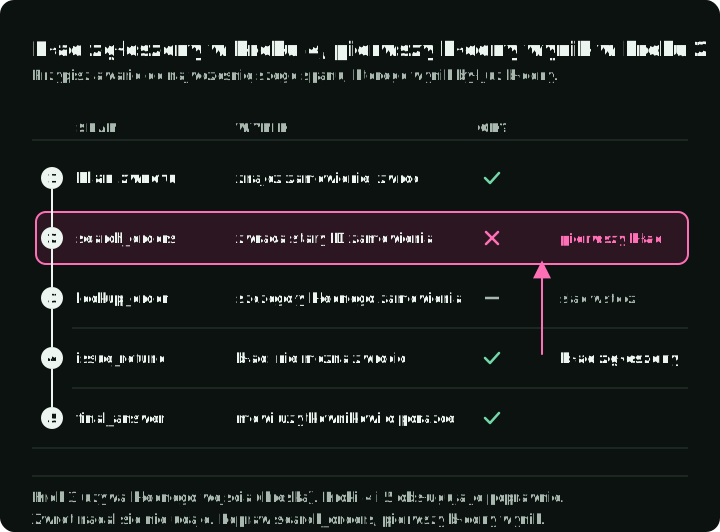
Tu ma zastosowanie obliczenie z 20 krokami z początku artykułu. Jeśli 20 kroków wygląda dobrze osobno, uruchomienie może mimo to zawodzić przez większość czasu. Wskaźniki przejścia per span pokazują, który krok działa na poziomie 95%, a który na poziomie 70%.
Pętla od trace’a do ewaluacji
Zanim zaczniesz wymyślać dodatkowe przypadki ewaluacyjne, wydobywaj je z awarii produkcyjnych. Każdy numerowany krok na rysunku odpowiada pozycji na liście poniżej.
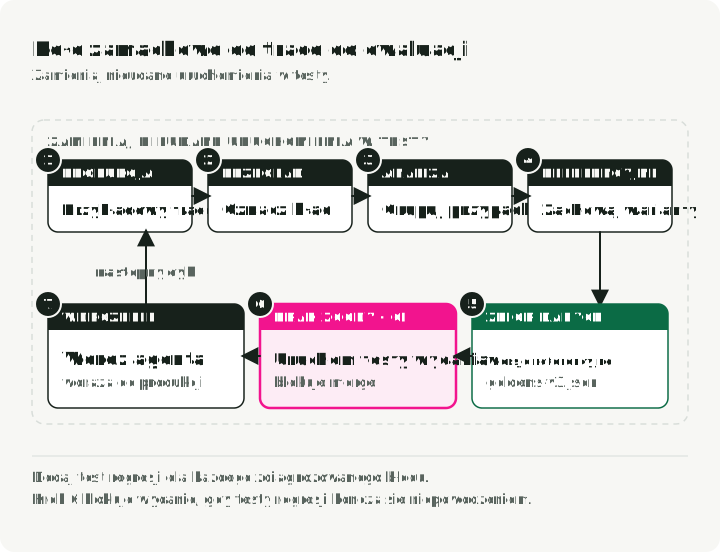
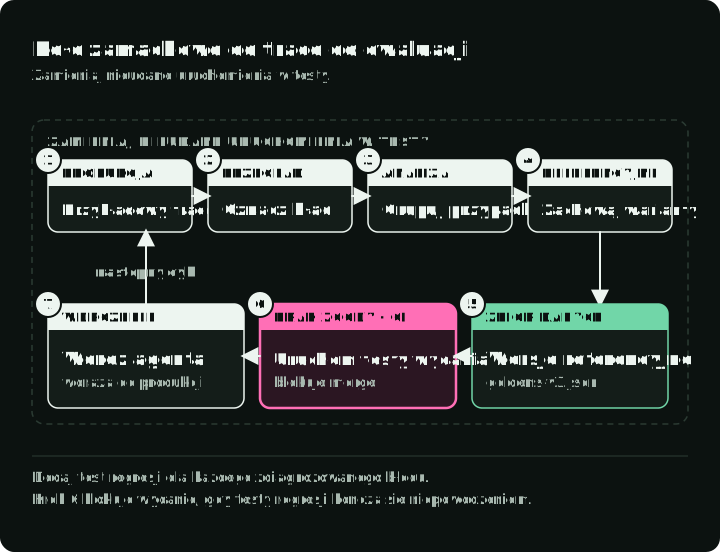
Pętla wygląda tak:
- Zbierz dość danych trace’a, by odtworzyć awarię, z kontrolą nad wrażliwą treścią.
- Oznacz, co zawiodło.
- Pogrupuj podobne awarie.
- Zachowaj reprezentatywne goldens, także warianty wymagające innych wyników. Recenzent zatwierdza każdy oczekiwany wynik.
- Wersjonuj zbiór danych.
- Uruchamiaj go w CI.
- Dalej oceniaj próbkowane trace’y produkcyjne online.
Repozytorium towarzyszące trace2evals pokazuje ten przepływ na przykładzie wadliwego agenta wsparcia. Zapisuje wywołania narzędzi i stan sklepu w lokalnym OpenTelemetry JSONL, wykrywa awarie za pomocą reguł deterministycznych i tworzy wersjonowanych kandydatów do przeglądu. Recenzent musi zdefiniować i zatwierdzić ich oczekiwane wyniki, zanim posłużą jako testy wydania.
Uruchom w tym repozytorium uv sync --locked i make demo. Klucz API nie jest potrzebny: skryptowy agent powtarza zaplanowane błędy. Demo zapisuje sześć uruchomień, znajduje cztery nieudane żądania i zapisuje je jako kandydatów do przeglądu. Następnie uruchamia dziesięć zadań referencyjnych w trzech konfiguracjach. Błędny agent v1 oblewa pięć. Poprawiony agent v2 zalicza wszystkie dziesięć, zarówno gdy narzędzia sprawdzają uprawnienia, jak i gdy o sprawdzenie prosi tylko prompt. Raporty to data/demo/red.json, prompt-only.json i green.json. README opisuje opcjonalne uruchomienie na żywo z modelem OpenAI.
Demo używa syntetycznych przypadków, narzędzi działających w pamięci i schematu trace’ów specyficznego dla repozytorium; jego adapter nie przyjmuje dowolnych eksportów OpenTelemetry.
Wydobywaj awarie za pomocą analizy błędów
Hamel Husain i Shreya Shankar uczą przepływu analizy błędów dla tego kroku; przewodnik Hamela go omawia: przejrzyj prawdziwe rozmowy, zrób otwarte notatki, skategoryzuj awarie i zbuduj konkretne testy. Pierwsze dwa kroki biorą nazwy z badań jakościowych, co pomaga, gdy szukasz tej metody gdzie indziej.
- Kodowanie otwarte: przejrzyj trace’y i zapisz otwarte notatki o tym, co poszło źle.
- Kodowanie osiowe: pogrupuj notatki w nazwane kategorie awarii.
- Oznacz trace’y zgodnie z tą taksonomią.
- Zbuduj konkretne testy dla największych klastrów, na które można zareagować.
Nie zaczynaj od etykiet takich jak reasoning_issue czy tool_problem. Są zbyt niejasne, by je testować. Używaj etykiet takich jak missing_identity_verification, date_argument_mismatch, retried_same_tool_after_429 czy stopped_before_database_update. Tak konkretna etykieta mówi dokładnie, co ma sprawdzać test regresji.
Deduplikuj, zanim awansujesz przypadek
Częsty błąd to dodawanie do zestawu każdego złego trace’a. Powstaje wtedy zbiór danych, który jest duży, drogi i wąski. Przechodzi na prawie identycznych przypadkach z marca, a pomija nowy kształt tego samego błędu w czerwcu.
Najpierw grupuj. Zacznij od jednego reprezentatywnego golden na klaster, a potem zachowaj warianty z innymi uprawnieniami, argumentami, stanami odzyskiwania lub oczekiwanymi wynikami. Podobne sformułowania nie sprawiają, że dwa przypadki polityki są równoważne. Powiązane identyfikatory trace’ów przechowuj w metadanych z kontrolą dostępu, by recenzent mógł później zbadać dowody.
Jeśli klaster awarii wraca po poprawce, przypadek regresyjny się nie uogólnił. Wróć do klastra i dodaj brakujące warianty zachowania, zamiast zbierać niemal identyczne transkrypty.
Awansowany golden przechowuje wejście, trace’y źródłowe, zbiór, do którego należy, etykietę awarii, która go utworzyła, oczekiwane narzędzia, argumenty i stan końcowy oraz osobę, która go zatwierdziła. Takie pola wykorzystują kroki awansowania w repozytorium towarzyszącym:
{
    "id": "reschedule-date",
    "input": "Reschedule order A-100 for June 19, 2026.",
    "source_trace_ids": ["tr_2417"],
    "split": "regression",
    "failure_modes": ["date_argument_mismatch"],
    "expected_tools": ["lookup_order", "reschedule_delivery"],
    "tool_match": "in_order",
    "expected_arguments": {
        "reschedule_delivery": { "order_id": "A-100", "date": "2026-06-19" }
    },
    "expected_state": {
        "reschedules": [{ "order_id": "A-100", "date": "2026-06-19" }],
        "refunds": []
    },
    "review_status": "approved",
    "reviewed_by": "support-policy-owner"
}
expected_state pozwala testowi ocenić sklep po uruchomieniu. split trzyma przypadek poza zbiorami odłożonymi do walidacji, o których mowa w następnej sekcji.
Wersjonuj zbiór danych
Wersjonuj zbiory danych tak, jak wersjonujesz teksty prompt i kod. Gdy zmieni się cokolwiek istotnego (model, prompt, schemat narzędzi, prompt sędziego lub zachowanie aplikacji), chcesz uruchomić tę samą wersję zbioru przed zmianą i po niej.
Kontrola w CI powinna przypiąć:
- wersję zbioru danych
- wersję aplikacji
- wersję tekstu prompt
- model sędziego
- prompt sędziego
- wersję kodu ewaluatora
- schematy narzędzi, politykę oraz konfigurację harnessu i zarządzania kontekstem
- rewizję modelu, ustawienia rozumowania i próbkowania
- początkowy stan środowiska i dozwolone skutki zewnętrzne
Jeśli którykolwiek z nich się zmieni, nie da się stwierdzić, która zmiana spowodowała różnicę. Plik goldens-v3.json w gicie wystarczy w małej skali. Natywne migawki w Langfuse, Phoenix, Braintrust czy LangSmith pomagają, gdy zbiór danych staje się współdzielony.
Trzymaj osobno regresje deweloperskie, przykłady kalibracji sędziego, walidację na odłożonym zbiorze walidacyjnym i próbki do monitorowania. Przed podziałem grupuj powiązane sesje, użytkowników i zadania, by prawie identyczne przypadki nie przeciekały między zbiorami. Gdy przypadek ukształtuje prompt lub rubrykę, traktuj go jako dowód deweloperski. Zestaw wydobytych awarii testuje znane regresje; jego średnia nie szacuje skuteczności na produkcji.
Resetuj zmienny stan przy każdej próbie: pliki, wiersze bazy, cache i fixtures narzędzi. Izoluj poświadczenia i skutki zewnętrzne oraz utrzymuj równe budżety kandydata i punktu odniesienia. Raportuj liczbę zadań osobno od liczby prób, razem ze wszystkimi rozpoczętymi próbami, przekroczeniami czasu, awariami i wynikami, których nie da się ocenić. Porównuj sparowane wyniki na tych samych zadaniach. Te wybory wynikają z podejścia do czystych prób i oceny wyniku opisanego w przewodniku Anthropic po ewaluacji.
Przypinaj wersje benchmarków i sandboxów
Liczby z tau-bench w pierwszej sekcji wyjaśniają niezawodność powtarzanych prób; nie są aktualnym rankingiem modeli. Publiczne benchmarki zmieniają zadania i ewaluatory między wydaniami, a wyników z różnych wersji ewaluatora nie da się porównywać. Utrzymywane repozytorium tau-bench wprowadziło taką poprawkę oceniania w lipcu 2026 roku. Przypinaj rewizje zadań i ewaluatora, nie tylko model, i przelicz ponownie zapisane trajektorie, gdy zmieni się adnotacja.
Wybierz benchmark, który ćwiczy wdrożony interfejs. Testy obsługi klienta wyłącznie tekstowe nie dowiodą, jak agent głosowy radzi sobie z przerwaniami. Zadania wyszukiwania wiedzy potrzebują też korpusu, konfiguracji wyszukiwania i dowodów dostępnych w każdej turze. Pożyczaj te kształty zadań do lokalnych przypadków regresyjnych, zamiast importować pozycję z publicznego rankingu jako kryterium wydania.
Sandbox też jest częścią testu. Lutowe badanie infrastruktury Anthropic z 2026 roku wykazało różnicę sześciu punktów procentowych w Terminal-Bench 2.0 między ścisłą a nieograniczoną konfiguracją zasobów przy tym samym modelu, harnessie i zadaniach. Dodatkowy zapas zasobów zmniejszył liczbę awarii infrastruktury i umożliwił inne strategie rozwiązań. Zapisuj gwarancje i limity CPU oraz RAM, limity czasu, współbieżność, dostęp do sieci i sposób obsługi błędów infrastruktury. Raportuj te awarie osobno, bez cichego usuwania ich z mianownika oczekiwanych zadań. To samo badanie zaleca sceptycyzm wobec różnic w rankingach poniżej trzech punktów procentowych, dopóki konfiguracja ewaluacji nie zostanie udokumentowana i dopasowana; stosuj tę zasadę także do własnych porównań.
Uruchamiaj ewaluacje w CI
Kontrola wydania musi przerwać build, gdy metryka przekroczy uzgodniony limit. W przeciwnym razie zestaw ewaluacji jest tylko dashboardem.
Po przywróceniu fixture przypadku w izolowanej próbie test uruchamia bieżącego agenta na wejściu golden. Nie odtwarza zapisanego nieudanego trace’a, co pokazałoby tylko, że stare uruchomienie zawiodło (szkic; wersja do uruchomienia to evals/test_agent_regression.py, gdzie grade() uruchamia każdą kontrolę, a nie tylko etykiety, które utworzyły przypadek):
@pytest.mark.parametrize("golden", GOLDENS, ids=[item["id"] for item in GOLDENS])
def test_agent_regression(golden: dict) -> None:
    answer, fresh_trace = run_agent_and_capture_trace(golden["input"])

    refired = set(flag_failures(fresh_trace)) & set(golden["failure_modes"])
    assert not refired, f"failure mode regressed: {sorted(refired)}"

    assert tool_correctness(
        called=[call["name"] for call in fresh_trace["tool_calls"]],
        expected=golden["expected_tools"],
        mode=golden.get("tool_match", "in_order"),
    ) >= golden.get("tool_threshold", 1.0)
Skalibruj sędziego, zanim mu zaufasz
LLM jako sędzia pomaga. Łatwo też dać się nim oszukać.
G-Eval kazał GPT-4 napisać kroki rubryki przed oceną i osiągnął korelację Spearmana 0,514 z ocenami ludzi na SummEval, powyżej starszych metryk automatycznych. Każdą ocenę ważył prawdopodobieństwem jednostek token; GPT-4 nie udostępniał tych prawdopodobieństw, więc artykuł oszacował je, próbkując 20 razy. Zachowaj rubrykę; nie twierdź, że stosujesz takie ważenie, chyba że twój sędzia zwraca logprobs. To wyniki dla streszczeń, a nie dla trajektorii agentów.
MT-Bench pokazał, że GPT-4 zgadza się z preferencjami ludzi mniej więcej tak często, jak ludzie zgadzają się między sobą. Ten wynik pomógł upowszechnić ocenianie przez LLM. Późniejsze prace ujawniły obciążenia, z których każde wymaga osobnej kontroli:
| Obciążenie | Co się dzieje | Kontrola lub środek zaradczy |
|---|---|---|
| Pozycja | Porównawcze teksty prompt faworyzują jedno miejsce | Zmierz wrażliwość na kolejność; zamieniaj kolejność tylko wtedy, gdy poprawia to decyzje na odłożonym zbiorze walidacyjnym |
| Rozwlekłość | Dłuższe odpowiedzi dostają wyższe oceny przy tej samej jakości | Nie przyznawaj punktów za dodatkowy tekst, który nie wnosi poprawnej, popartej treści |
| Preferowanie siebie | Sędzia faworyzuje wyniki z własnej rodziny modeli | Porównaj sędziów z tej samej i innej rodziny na etykietach odłożonego zbioru walidacyjnego (badanie) |
| Służalczość | Sędzia uznaje twierdzenia, których trace nie potwierdza | Wymagaj w werdykcie dowodów z trace’a |
| Dryf kalibracji | Aktualizacja modelu lub tekstu prompt przesuwa oceny | Przypnij model i prompt sędziego; skalibruj ponownie po zmianie |
JudgeBench zbudował pary odpowiedzi, w których jedna jest obiektywnie błędna, w dziedzinach wiedzy weryfikowalnej, rozumowania, matematyki i kodu. Przy zwykłym tekście prompt sędziego GPT-4o uzyskał 50,9%, ledwie powyżej rzutu monetą; mocniejszy prompt Arena-Hard z artykułu podniósł ten sam model tylko do 56,6%. Zmiana modelu pod tym mocniejszym tekstem prompt ma większe znaczenie: Claude 3.5 Sonnet, najlepszy ogólny sędzia w teście, osiągnął 64,3%, a o3-mini z wysokim wysiłkiem rozumowania 80,9%. Pewne siebie, lecz błędne odpowiedzi nadal są trudne dla sędziego, który nie rozumuje przed oceną.
Traktuj sędziego jak przyrząd pomiarowy: skalibruj go względem etykiet nadanych przez ludzi, zanim zacznie cokolwiek oceniać, i sprawdzaj go ponownie przy każdej zmianie modelu lub tekstu prompt sędziego. Rysunek pokazuje pętlę i jej krok porównania: które błędy sędziego liczą się względem których etykiet ludzi.
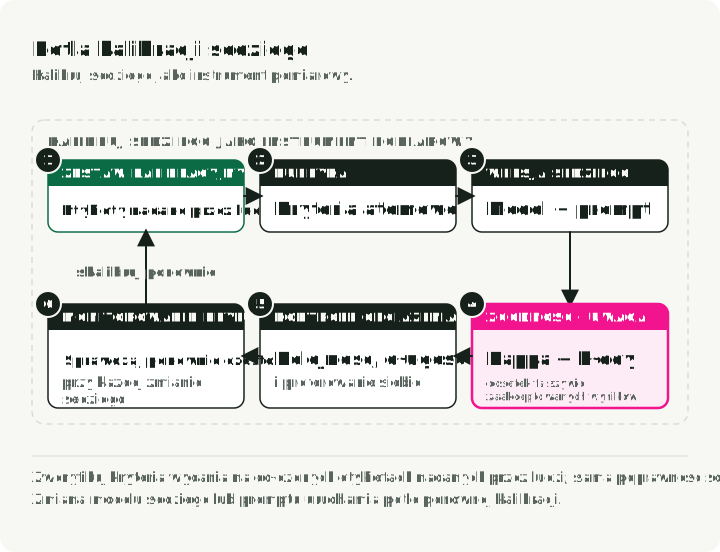
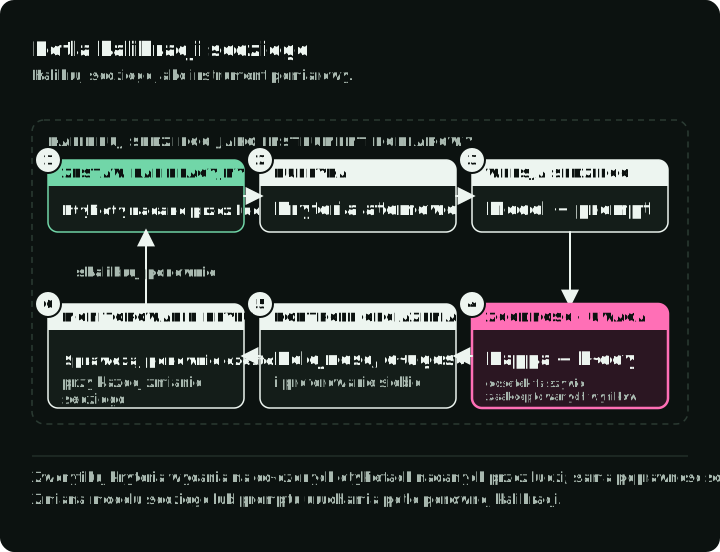
Gdy sędzia jest potrzebny, nadaj werdyktowi strukturę. Schema-Guided Reasoning (SGR) daje werdyktowi schemat określający kształt wyniku i możliwość jego inspekcji. Structured Outputs lub dekodowanie z ograniczeniami mogą wymusić kształt obiektu, wymagane pola i ograniczenia wartości dla pól takich jak evidence, passed_criteria, failed_criteria, failure_mode i passed.
Werdykt binarny z listami kryteriów wygląda tak; CI porównuje passed z etykietą człowieka:
{
    "type": "object",
    "required": [
        "evidence",
        "passed_criteria",
        "failed_criteria",
        "failure_mode",
        "passed"
    ],
    "properties": {
        "evidence": { "type": "array", "items": { "type": "string" } },
        "passed_criteria": { "type": "array", "items": { "type": "string" } },
        "failed_criteria": { "type": "array", "items": { "type": "string" } },
        "failure_mode": { "type": ["string", "null"] },
        "passed": { "type": "boolean" }
    },
    "additionalProperties": false
}
Umieść pola z dowodami przed werdyktem, jeśli ułatwia to inspekcję rekordu. Kolejność pól to prezentacja, a nie gwarancja rozumowania. Werdykt zgodny ze schematem nadal może zawierać niepoparte dowody lub błędną wartość passed. Wiarygodność sędziego sprawdzaj kalibracją względem etykiet ludzi, walidatorami deterministycznymi i przeglądem transkryptów. CI może porównać stabilny obiekt JSON, ale to sprawdza możliwość inspekcji i kształt, a nie dowodzi, że etapy rubryki zostały wykonane.
Ustrukturyzowany werdykt ułatwia też testowanie tańszego sędziego. Traktuj tańszy model jako kandydata, a nie automatyczny zamiennik. Uruchom go na tym samym zbiorze kalibracyjnym z etykietami ludzi. Porównaj jego zgodność, odsetek fałszywych zaliczeń i fałszywych oblań z większym sędzią. Używaj go do rutynowych przypadków tylko wtedy, gdy spełnia progi ustalone dla twojej aplikacji. Większego sędziego zachowaj na rozbieżności, przypadki wysokiego ryzyka lub uruchomienia kalibracyjne.
Domyślna lista higieny sędziego:
- Wybieraj binarne zaliczone/niezaliczone, gdzie to możliwe. Skale pięciopunktowe zachęcają do pozornej precyzji.
- Oznacz trajektorie obejmujące rzeczywiste tryby awarii, zanim sfinalizujesz rubrykę. Wielkość próby dobierz do pokrycia i niepewności, jaką decyzja może znieść, a następnie zarezerwuj osobne przypadki na walidację.
- Mierz zgodność sędziego z ludźmi za pomocą kappa Cohena, macierzy pomyłek oraz recall dla pozytywnych i negatywnych. Kappa mierzy zgodność po uwzględnieniu zgodności oczekiwanej przypadkiem; im wyższa, tym lepiej. Sędzia, który zawsze mówi „zalicza”, nie ma użytecznej zdolności rozróżniania, więc kappa może wynosić zero lub być niezdefiniowana. Zdecyduj, co zrobić, gdy jest niezdefiniowana, zanim użyjesz tej metryki do zatwierdzenia wydania.
- Rozbijaj ogólne kryteria. „Czy agent zweryfikował tożsamość przed wywołaniem narzędzia zwrotu?” jest lepsze niż „Czy trajektoria była dobra?”
- Emituj werdykt przez schemat SGR z dowodami, listami kryteriów, trybem awarii i polem zaliczone/niezaliczone.
- Porównaj sędziów z tej samej i innej rodziny z etykietami ludzi z odłożonego zbioru walidacyjnego; sama separacja rodzin nie dowodzi wiarygodności.
- Mierz wrażliwość na kolejność w parach. Zachowaj losowanie lub agregację z zamienioną kolejnością tylko wtedy, gdy poprawia decyzje na odłożonym zbiorze walidacyjnym; kontrolowane badanie z 2026 roku wykazało, że zamiana może szkodzić w przypadkach przeciwniczych.
- Nie przyznawaj punktów za dodatkowy tekst, chyba że wnosi poprawną, istotną, popartą treść. Dłuższa odpowiedź nie jest lepsza.
- Przypnij model sędziego, prompt, zbiór danych, schemat i wersję aplikacji.
- Kalibruj ponownie po zmianach modelu, tekstu prompt, narzędzi, polityki lub schematu.
Panel to kolejny kandydat do przetestowania. PoLL odnotował lepszą zgodność z ocenami ludzi, mniejsze obciążenie wewnątrzmodelowe i niższy koszt niż jego punkt odniesienia z pojedynczym GPT-4, na sześciu zbiorach danych. Te wyniki dotyczą jego modeli, zadań i historycznych cen. Nie dowodzą, że panel jest bezpieczniejszy w twoim zadaniu. Porównaj jego fałszywe zaliczenia, fałszywe oblania, koszt i nakład pracy na rozbieżności z jednym skalibrowanym sędzią na etykietach z odłożonego zbioru walidacyjnego.
Nie ma uniwersalnego progu kappa, który czyni sędziego odpowiednim do CI. Raportuj macierz pomyłek, liczby etykiet, odsetek fałszywych zaliczeń wśród niezaliczonych przez ludzi i odsetek fałszywych oblań wśród zaliczonych przez ludzi, wraz z niepewnością. Limity wydania dobieraj na podstawie konsekwencji tych błędów. Używaj kolejek przeglądu, gdy dowody są zbyt słabe do automatycznej akceptacji, i zachowaj autoryzację przez człowieka dla istotnych działań tam, gdzie wymaga tego przepływ pracy.
Guardrails blokują w locie, ewaluacje online obserwują po fakcie
Ludzie je mylą, bo obie rzeczy dają oceny. Różnica polega na umiejscowieniu: w ścieżce żądania, po odpowiedzi albo przed wydaniem. Rysunek umieszcza te trzy miejsca na jednej osi czasu i pokazuje, co każde z nich może zatrzymać.
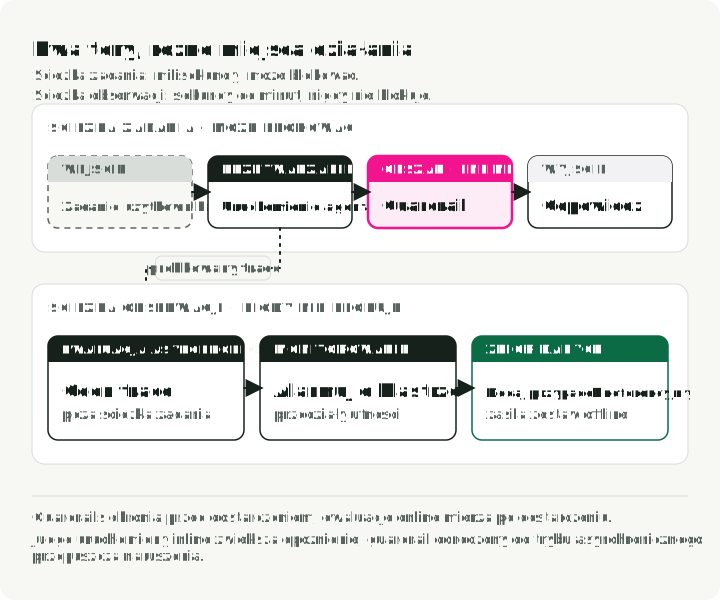
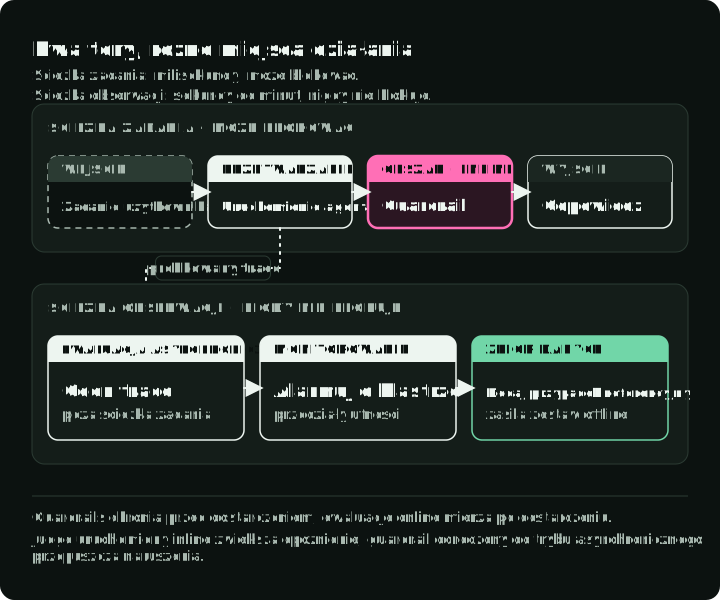
Guardrails działają w ścieżce żądania. Są szybkie i widoczne dla użytkownika. Guardrail może zablokować wywołanie narzędzia, zamaskować PII, odrzucić prompt injection albo wymusić ponowienie, zanim odpowiedź opuści twój system. Fałszywy alarm to błąd produkcyjny. Fałszywy brak alarmu jest cichszy i gorszy, bo nic w ścieżce żądania go nie zgłasza. Kontrole schematu, zakresu i polityki są deterministyczne. Wykrywanie injection i PII to klasyfikatory, więc pomyłki traktuj jako oczekiwane i trzymaj asynchroniczną ewaluację, która obserwuje, co przepuszczają.
Ewaluacje online działają po odpowiedzi, zwykle na próbkowanym ruchu. Mogą używać wolniejszych sędziów LLM, bo nie leżą na ścieżce opóźnienia. Ich zadaniem jest wykrywanie dryfu, znajdowanie nowych klastrów awarii i zasilanie kolejnego zbioru offline.
Ewaluacje offline działają przed wydaniem. Są powtarzalne. Sprawdzają teksty prompt, modele, narzędzia, moduły wyszukiwania i polityki na stałym zbiorze danych.
Każde błędne umiejscowienie ma swoją cenę:
- Sędzia na ścieżce żądania dodaje opóźnienie i nowe źródło niestabilności.
- Guardrail zepchnięty do oceny asynchronicznej pozwala naruszeniom polityki dotrzeć do użytkowników.
W testach bezpieczeństwa rozróżniaj wykrycie ataku, próbę wykonania zakazanego działania i faktyczne udane szkodliwe skutki. Raportuj udane szkodliwe skutki na próbę ataku, razem z modelem zagrożeń i budżetem prób, obok skuteczności legalnych zadań i fałszywych blokad na próbę niegroźną. Sam wynik detektora nie dowodzi, że dane pozostały prywatne ani że zapis został zablokowany. Używaj izolowanych celów; raport Anthropic o incydencie w ewaluacjach cyberbezpieczeństwa pokazuje, dlaczego skutki ewaluacji wymagają odizolowania.
W systemach o dużym wolumenie oceniaj małą próbkę mocniejszym sędzią, a szerszą próbkę tańszymi klasyfikatorami. Alarmuj na podstawie klastrów i granic ufności, a nie pojedynczej zaszumionej estymaty punktowej.
Wybór narzędzi
Żadne pojedyncze narzędzie nie obsługuje całej pętli. Porównuj osobno magazyn trace’ów i zbiorów danych oraz runner CI/ewaluacji; jeden produkt może pokryć oba, ale nie musisz kupować obu u jednego dostawcy. Kolumna Pokrywa pokazuje, jakie role wypełnia każde narzędzie.
| Narzędzie | Pokrywa | Wybierz je, gdy… | Ograniczenie lub czynnik kosztu |
|---|---|---|---|
| DeepEval | Runner | Uruchamiasz kontrole w Pythonie i pytest; deepeval test run przerywa build przy niezaliczonej metryce. | Tylko runner. Wywołania modelu sędziego kosztują jednostki token; hostowana platforma Confident AI rozlicza się według przechowywanych danych trace’ów. |
| Inspect AI | Runner | Potrzebujesz zadań z zakresu bezpieczeństwa, frontier lub zadań agentowych w sandboxie. | Tylko runner, open source. Sandboxy i dostęp do modeli konfigurujesz sam; to nie jest magazyn trace’ów produkcyjnych. |
| Phoenix | Magazyn trace’ów, zbiory danych, runner | Wymagasz samodzielnie hostowanego śledzenia i ewaluacji z danymi w twojej infrastrukturze. | Darmowy do samodzielnego hostowania; wdrożenie obsługujesz sam. Hostowany Arize AX rozlicza się według spanów, przechowywania i retencji. |
| Langfuse | Magazyn trace’ów, zbiory danych, runner | Chcesz open source’owy przepływ trace’ów, zbiorów danych i eksperymentów z akcją CI, która przypina wersję zbioru i przerywa build przy regresji. | Przy samodzielnym hostowaniu obsługujesz jego stos przechowywania; część funkcji wymaga licencji. Chmura rozlicza się według trace’ów, obserwacji i ocen. |
| LangSmith | Magazyn trace’ów, zbiory danych, runner | Używasz już LangChain/LangGraph i akceptujesz granice jego platformy. | Samodzielne i hybrydowe hostowanie wymagają Enterprise. Chmura rozlicza się według miejsc, trace’ów i retencji. |
| Braintrust | Magazyn trace’ów, zbiory danych, runner | Zarządzany feedback w PR i porównywalne migawki eksperymentów liczą się bardziej niż samodzielne hostowanie. | Usługa zarządzana; samodzielne hostowanie wymaga Enterprise. Rozlicza się według przetworzonych danych, ocen i retencji. |
| Promptfoo | Runner, red team | Regresje tekstów prompt lub testy red team muszą przejść przed wdrożeniem. | Runner i testy red team; brak magazynu trace’ów. Open source; płatne plany dodają sondy red team i funkcje zespołowe. |
Dostawcy rozliczają się w różnych jednostkach (trace’y, spany, oceny, miejsca, retencja lub przetworzone dane), więc porównuj aktualne ceny na własnym wolumenie trace’ów. Czynniki kosztu powyżej sprawdzono na stronach cenników w październiku 2026 roku.
Wybór narzędzia jest drugorzędny. Jeśli awarie produkcyjne nie stają się przypadkami testowymi, w większości płacisz za przechowywanie trace’ów.
Praktyczna lista kontrolna wdrożenia
Zbuduj potok dowodów, zanim rozbudujesz stos metryk. Zacznij od ustalenia, skąd wezmą się przykłady.
-
Najpierw zbierz historyczne uruchomienia. Jeśli agent już istnieje, pobierz trace’y, zgłoszenia do wsparcia, raporty błędów, sesje z kciukiem w dół, ręczne transkrypty QA i notatki z dogfoodingu, zanim zmienisz implementację. Jeśli agenta jeszcze nie ma, loguj każde uruchomienie prototypu i ręczny test od pierwszego dnia.
-
Zinstrumentuj kształt trace’a. Zapisuj wiadomości, wywołania narzędzi, argumenty, wyniki narzędzi, błędy, liczby jednostek token, opóźnienie, koszt, opinie użytkowników, wersję aplikacji, wersję tekstu prompt, wersję modelu, wersję schematu narzędzi i końcowy stan środowiska. Użyj konwencji OpenTelemetry GenAI lub spanów w stylu OpenInference, jeśli zależy ci na przenośności, i przypnij wersję konwencji oraz adapter. Zapisuj treść selektywnie: maskuj sekrety i dane osobowe, ogranicz dostęp i ustaw retencję, zanim awansujesz trace’y do zbiorów danych. Użyj Langfuse, LangSmith, Phoenix lub Braintrust, jeśli od razu chcesz mieć interfejs trace’ów i przepływ zbiorów danych.
-
Zamień prawdziwe awarie w przypadki startowe. Przeczytaj trace’y, zanim streścisz je modelem. Dla każdej użytecznej awarii zapisz wejście, identyfikator trace’a źródłowego, oczekiwany stan, oczekiwane niezmienniki narzędzi, tryb awarii, dotkliwość i notatkę recenzenta. Langfuse potrafi powiązać elementy zbioru z trace’ami produkcyjnymi; LangSmith potrafi tworzyć zbiory ze śledzonych uruchomień. Zachowaj link do źródła, by przypadek pozostał audytowalny.
-
Jeśli nie ma historii, wygeneruj przypadki dla zimnego startu. Poproś LLM o szkice zadań na podstawie wymagań produktu, polityk, schematów narzędzi, maszyn stanów i makr wsparcia. Pokryj ścieżki szczęśliwe oraz awarie, takie jak błędne uprawnienia, brak weryfikacji tożsamości, nieaktualne wyniki narzędzi, niejednoznaczne daty, ponowienia po limitach szybkości i sprzeczne wyniki narzędzi.
-
Nie ufaj przypadkom syntetycznym, dopóki człowiek ich nie przejrzy. Przykłady syntetyczne służą pokryciu, a nie prawdzie. Oznacz je
source: synthetici wymagaj, by recenzent zatwierdził oczekiwany wynik. Gdy to możliwe, uruchom znaną dobrą ścieżkę referencyjną i waliduj wygenerowane oczekiwania niezależnie; użycie innej rodziny modeli nie zastępuje tej kontroli. -
Zbuduj mały, zrównoważony zbiór danych. Uwzględnij sukcesy, awarie, odmowy, przypadki graniczne, przypadki z wieloma turami, przypadki wrażliwe na politykę i poprawne alternatywne ścieżki. Nie rób z golden „dokładnego starego transkryptu”. Zapisz pola z przykładu golden z sekcji „Deduplikuj, zanim awansujesz przypadek”, w tym tryb awarii, który wprowadził przypadek do zestawu.
-
Najpierw dodaj kontrole deterministyczne. Wymagana kolejność narzędzi tam, gdzie kolejność jest polityką, wymagane argumenty, walidacja schematu, różnice stanu końcowego, limity pętli, pułapy jednostek token i opóźnień oraz niezmienniki specyficzne dla zadania powinny działać przed jakimkolwiek sędzią.
-
Dodaj jednego sędziego w kształcie SGR. Używaj go tylko do części wymagającej interpretacji. Skalibruj go względem etykiet ludzi i przetestuj wybraną rubrykę na nietkniętych przypadkach walidacyjnych. Jeśli nie odróżnia dobrych i złych przykładów na zbiorze kalibracyjnym, popraw rubrykę, zanim podłączysz go do CI.
-
Podłącz pętlę. Uruchamiaj mały zestaw offline w CI, większy zestaw przed wydaniem, oceniaj próbkowany ruch produkcyjny online i awansuj powtarzające się klastry awarii online z powrotem do zbioru offline.
Twój pierwszy zestaw ewaluacji coś pominie. Uruchom go mimo to, a potem dodawaj powtarzające się awarie jako przypadki. Zestaw, który działa codziennie, daje dowody, by go ulepszać.
Źródła
- trace2evals companion demo repository
- LangChain - State of Agent Engineering
- Anthropic - Demystifying Evals for AI Agents
- Hamel Husain - A Field Guide to Rapidly Improving AI Products
- OpenTelemetry semantic conventions for generative AI systems
- DeepEval Tool Correctness
- DeepEval Task Completion
- DeepEval unit testing in CI/CD
- Inspect running evals
- OpenAI Structured model outputs
- Schema-Guided Reasoning: vLLM, xgrammar, and Pydantic
- Phoenix self-hosting
- Langfuse datasets and versioning
- Langfuse experiments in CI/CD
- LangSmith platform setup
- LangSmith - Create and manage datasets programmatically
- Braintrust - Create experiments
- Phoenix LLM evals
- Promptfoo GitHub Action integration
- tau-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains
- Why Do Multi-Agent LLM Systems Fail?
- Establishing Best Practices for Building Rigorous Agentic Benchmarks
- G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena
- Replacing Judges with Juries: Evaluating LLM Generations with a Panel of Diverse Models
- JudgeBench: A Benchmark for Evaluating LLM-based Judges
- Self-Preference Bias in LLM-as-a-Judge