TypeScript dla inżynierów ML pracujących w Pythonie: budowa serwisu agenta

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Ten przewodnik jest dla doświadczonych inżynierów ML i backendu pracujących w Pythonie, którzy muszą zbudować serwis AI w TypeScript i Node. Zaczyna od koncepcji znanych z serwisów w Pythonie, nie od podstaw programowania ani kodu przeglądarkowego. Na końcu potrafisz zmapować stos serwisu w Pythonie na TypeScript, rozpoznać nawyki z Pythona, które powodują błędy w JavaScripcie, oraz uruchomić i zmienić strumieniowy serwis agenta.
Przykładowy serwis prowadzi żądanie przez walidację, wykonanie narzędzia, strumieniowanie HTTP i zapis danych. Odpowiada na trzy pytania: co się dzieje, gdy argumenty narzędzia przychodzą we fragmentach, gdy strumień kończy się błędem po HTTP 200 albo gdy worker pobiera to samo zadanie dwa razy? Zakres to wyłącznie backend i AI: bez Reacta i bez bundlera przeglądarkowego.
Kod znajduje się w repozytorium slavadubrov/typescript-agent-service. Zawiera dwie implementacje pętli agenta, historię uruchomień w bazie Postgres, workera i serwer MCP. Możesz uruchomić jego demo offline bez klucza API, a potem użyć poniższej mapy Python–TypeScript, żeby czytać i zmieniać serwis. Ciężkie obliczenia numeryczne zostają w Pythonie; ten przewodnik dotyczy orkiestracji, HTTP i strumieniowania.
Najpierw uruchom repozytorium towarzyszące
Zainstaluj Node 24 i pnpm zgodnie z oficjalną instrukcją instalacji pnpm. Potem sklonuj repozytorium towarzyszące i uruchom:
pnpm install
pnpm demo
pnpm check
pnpm demo uruchamia handler HTTP, pętlę agenta i strumień SSE ze skryptowym modelem. Wywołuje też obliczenia runSweep workera. Nie startuje procesu workera ani jego kolejki w bazie danych. Demo nie wymaga klucza API, bazy danych ani Dockera. pnpm check uruchamia sprawdzanie typów, linter, kontrolę formatowania i testy.
Demo wypisuje ramki SSE jednego żądania czatu, a potem sweep workera. Skrócony wynik:
event: tool_call
data: {"type":"tool_call","callId":"call_1","toolName":"estimate_kv_cache","args":{"model":"llama-3.1-8b","seqLen":32768,"batchSize":16}}

event: tool_result
data: {"type":"tool_result","callId":"call_1","toolName":"estimate_kv_cache","ok":true,"result":{"model":"llama-3.1-8b","seqLen":32768,"batchSize":16,"kvCacheGiB":64},"durationMs":0}

event: done
data: {"type":"done","stopReason":"stop","steps":2,"text":"Llama-3.1-8B at 32k context and batch 16 needs 64 GiB of KV cache."}

--- worker: capacity sweep ---
batch=  1  kv_cache=4.0 GiB
batch= 16  kv_cache=64.0 GiB
Każdy blok event:/data: to jedna ramka SSE: model prosi o narzędzie, narzędzie zwraca wynik, a uruchomienie kończy się zdarzeniem done. Ostatnia część to sweep rozmiarów batcha wykonany przez workera.
Aby uruchomić prawdziwe API i workera:
cp .env.example .env          # add OPENAI_API_KEY or an OpenAI-compatible URL
pnpm db:up                    # start Postgres in Docker
pnpm db:push                  # create the database schema
pnpm dev:api                  # API at http://localhost:8080
pnpm dev:worker               # run this in a second terminal
Uruchom agenta ze strumieniowaniem. Odpowiedzią jest seria ramek SSE, takich jak w wyniku demo powyżej:
curl -N -X POST localhost:8080/v1/chat \
  -H 'content-type: application/json' \
  -d '{"message":"How much KV cache for llama-3.1-70b at 32k context, batch 8?"}'
Dodaj do kolejki długie zadanie, a potem odpytaj o nie. Pierwsze wywołanie zwraca 202 z {"id":"...","status":"queued"}. Drugie zwraca zapisany wiersz, z wynikiem, gdy worker skończy pracę:
curl -X POST localhost:8080/v1/sweeps \
  -H 'content-type: application/json' \
  -d '{"model":"llama-3.1-70b","seqLen":32768,"batchSizes":[1,4,16]}'

curl localhost:8080/v1/runs/<id>
Skrypty pnpm powyżej to polecenia, których używam w reszcie artykułu. Repozytorium chowa niskopoziomowe polecenia Node i TypeScript za nazwanymi skryptami pnpm, podobnie jak projekt w Pythonie może chować polecenia uv run za celami make. Nie mieszaj npm install z tym repozytorium pnpm. Używaj pnpm install, żeby pnpm-lock.yaml pozostał jedynym plikiem blokady.
Co robią Node, npm, pnpm, TypeScript i tsx
Podobne nazwy ukrywają osobne zadania:
- JavaScript to język.
- Node.js to środowisko uruchomieniowe, mniej więcej CPython dla JavaScriptu. Zainstaluj Node 24 dla tego projektu.
- Rejestr npm to indeks pakietów, mniej więcej PyPI. Polecenie
npmjest dołączone do Node i potrafi instalować pakiety z tego rejestru. - pnpm to menedżer pakietów wybrany w tym repozytorium. Instaluje z rejestru npm, zarządza przestrzenią roboczą monorepo i uruchamia polecenia zadeklarowane w
package.json. package.jsonto manifest projektu, najbliższypyproject.toml. Jego sekcjascriptsnadaje nazwy, takie jakdemo,checkidev:api, dłuższym poleceniom.- TypeScript to JavaScript ze statycznymi typami. Jego polecenie
tscsprawdza te typy. Repozytorium uruchamia je przezpnpm checklubpnpm typecheck. - tsx uruchamia pliki
.tsbez osobnego kroku budowania. Skrypty deweloperskie używają jego trybuwatch, żeby zrestartować API lub workera po zmianie w źródłach. W tym przewodniku nie wywołujesz go bezpośrednio.
W tym repozytorium uruchamiaj skrypty pnpm. Node jest środowiskiem uruchomieniowym wewnątrz tych skryptów, a dołączony Dockerfile obsługuje produkcję.
Co uruchamia każdy skrypt:
pnpm demouruchamiatsx scripts/demo.ts.pnpm dev:apiuruchamiatsx watch.pnpm checkuruchamiatsc, Biome (linter) i Vitest (narzędzie do testów).- Docker
CMDuruchamianode --import tsx/esm.
Wszystkie działają na Node 24. W pnpm check tsc i Biome tylko czytają pliki; Vitest uruchamia testy w Node.
Stos zmapowany z Pythona
Zod, Hono, Drizzle, Vitest i Biome pokrywają w dużej mierze to samo, co pydantic, FastAPI, SQLAlchemy, pytest i Ruff.
Większość par to bezpośrednie zamienniki. Trzy takie nie są:
| Zagadnienie | Python | TypeScript | Dlaczego to nie jest zamiana 1:1 |
|---|---|---|---|
| Walidacja | pydantic | zod | Źródłem jest schemat. Typ jest z niego generowany, nie odwrotnie |
| Sprawdzanie typów | mypy | TypeScript (pnpm typecheck) | Typy są usuwane, zanim kod się uruchomi. Żadna biblioteka ich nie odczyta, więc walidacja w czasie działania wymaga osobnego schematu (Zod) |
| Kolejka zadań | celery + Redis | bullmq (kolejka oparta na Redisie) lub SQL | Postgres może zaimplementować kolejkę at-least-once. Możesz nie potrzebować brokera |
Repozytorium towarzyszące używa czterech bibliotek, które warto wyjaśnić.
Hono dla warstwy HTTP
Express i Fastify to alternatywy skupione na Node. Hono używa standardowych webowych API Request i Response i udostępnia adaptery dla Node oraz środowisk serverless. Ta przenośność jest przydatna w tym małym strumieniowym API, więc wybrałem Hono. Wybierz Fastify, gdy serwis działa tylko na Node i chcesz mieć jego zestaw wtyczek oraz serializację odpowiedzi opartą na schematach.
Drizzle dla SQL
Drizzle trzyma schemat w TypeScript i nie wymaga kroku generowania klienta. Udostępnia też surowy SQL, gdy konstruktor zapytań nie wyraża czysto jakiejś klauzuli Postgres. Wybrałbym zamiast niego Prismę, gdyby jej wygenerowany klient i otaczające narzędzia lepiej pasowały do zespołu.
Biome do lintowania i formatowania
Biome obsługuje lintowanie, formatowanie i sortowanie importów jednym plikiem binarnym i jednym plikiem konfiguracji. Zostań przy ESLint, gdy projekt zależy od własnych reguł, których Biome nie udostępnia.
Vitest do testów
Vitest uruchamia testy .ts repozytorium towarzyszącego bez osobnej konfiguracji transformacji. Zostań przy Jest w repozytorium, które ma już konfigurację Jest i własne matchery.
Składnia TypeScript używana poniżej
Trzymaj tę tabelę obok przykładów serwisu jako ściągawkę.
| TypeScript | Python / uwaga |
|---|---|
(x) => expression | funkcja anonimowa z ciałem w postaci wyrażenia, podobna do lambda x: expression |
(x) => { statements } | funkcja anonimowa z ciałem w postaci instrukcji |
async (x) => { statements } | asynchroniczna funkcja anonimowa |
const { model, seqLen } = request | wyciąga właściwości model i seqLen z request |
const [first] = xs | first = xs[0]. Dla pustej tablicy daje undefined, nie IndexError |
{ type: "error", message } | {"type": "error", "message": message}. Samo message staje się tym polem |
`text ${x}` | f-string |
cond ? a : b | a if cond else b |
const / let | Oba wiążą nazwę. const zabrania ponownego przypisania, a let na nie pozwala |
export | udostępnia nazwę do importu |
switch / case | match, tyle że przypadki “przechodzą dalej”, jeśli nie kończą się na break lub return |
for await | iterowanie po generatorze asynchronicznym |
i++ | zwiększa wartość i zwraca starą |
/^https?$/ | literał wyrażenia regularnego, bez re.compile |
T[], Map<K, V> | list[T], dict[K, V] |
Używaj const, chyba że wiązanie musi się zmienić. Używaj let dla licznika, akumulatora lub innego wiązania, które przypiszesz ponownie.
Krótkie tłumaczenie enuma
Dla stanów będących ciągami znaków to repozytorium używa obiektu oraz wnioskowanego typu będącego unią ciągów:
const Status = { Queued: "queued", Running: "running" } as const;
type Status = (typeof Status)[keyof typeof Status]; // "queued" | "running"
Obiekt udostępnia Status.Queued podczas działania programu. Linia type dopuszcza tylko "queued" lub "running" podczas sprawdzania typów. Razem pełnią dwie role tej deklaracji w Pythonie:
from enum import Enum

class Status(str, Enum):
    QUEUED = "queued"
    RUNNING = "running"
Wystarczy, że rozpoznasz ten wzorzec. as const zachowuje wartości obiektu jako dokładne ciągi, zamiast poszerzać je do dowolnego string.
Siedem różnic semantycznych, które kosztują czas
Tabela składni pozwala przejść przez przykłady. Te różnice semantyczne to miejsca, w których nawyki z Pythona powodują błędy.
1. Puste tablice i obiekty są prawdziwe
Zasada Pythona, że pusty kontener jest fałszywy, to nawyk, który przenosi się najgorzej. if (results) jest prawdziwe dla pustej tablicy. Pisz if (results.length).
2. null i undefined to różne rzeczy
null zwykle oznacza celowy brak. undefined zwykle oznacza, że wartości brakuje lub nie została przypisana, chociaż kod może przypisać ją jawnie. Kod bibliotek stale zwraca undefined. Różnica ujawnia się, gdy piszesz wartość domyślną. || podstawia prawą stronę za każdym razem, gdy lewa jest fałszywa. Dotyczy to 0, "" i false. ?? podstawia tylko za null i undefined. Zatem 0 || 10 to 10, a 0 ?? 10 to 0. Tak rozmiar batcha równy zero po cichu zmienia się w dziesięć.
3. Blok catch otrzymuje unknown
Nie ma except ValueError:. Jeden blok catch dostaje wszystko. Ponieważ JavaScript pozwala rzucić ciąg znaków, liczbę lub null, TypeScript typuje przechwyconą wartość jako unknown, czyli typ oznaczający “może być dosłownie czymkolwiek” przy strict. Repozytorium towarzyszące włącza strict, a nowe projekty zwykle powinny. Aby zbadać błąd, najpierw zawęź wartość:
try {
    await risky();
} catch (error) {
    // `error` is `unknown` until you prove otherwise. This line is the
    // TypeScript equivalent of `except Exception as e:` and it is not
    // optional.
    const message = error instanceof Error ? error.message : String(error);
}
4. Promisy startują natychmiast
Wywołanie funkcji async zaczyna wykonywać jej ciało i zwraca promisa. Obiekt korutyny w Pythonie nic nie robi, dopóki nie użyjesz na nim await lub nie zaplanujesz go. Promise.all jest zbliżone do asyncio.gather. Promise.allSettled jest zbliżone do gather(..., return_exceptions=True), z tą różnicą, że każdy wynik jest opakowany jako { status, value } lub { status, reason }.
Planowaniem w czasie działania zajmuje się Node. Utrzymuje proces przy życiu, dopóki istnieją aktywne uchwyty lub żądania, takie jak timery i gniazda. Sam zwykły oczekujący promis nie utrzymuje Node przy życiu. Nie opakowujesz programu w asyncio.run. W module ES możesz użyć await na najwyższym poziomie, gdy start musi poczekać na operację asynchroniczną.
5. JavaScript ma jeden zwykły typ liczbowy
Typ number w JavaScripcie przechowuje wartości jako 64-bitowe liczby zmiennoprzecinkowe, mniej więcej tak jak float w Pythonie. Techniczny standard tego formatu nazywa się IEEE 754. Wartości dziesiętne są przybliżone, więc 0.1 + 0.2 nie jest dokładnie 0.3, a liczby całkowite pozostają dokładne tylko do 2**53 - 1, czyli 9,007,199,254,740,991.
Trzymaj 64-bitowe identyfikatory jako ciągi znaków na granicach serwisu. Konwersja bigint z Postgres na number w JavaScripcie może go zaokrąglić. Dla większych dokładnych liczb całkowitych JavaScript udostępnia osobny typ BigInt, który nie miesza się ze zwykłymi liczbami.
6. Użyj Map, gdy potrzebujesz słownika w stylu Pythona
W JavaScripcie {} tworzy obiekt. Obiekty zwykle reprezentują rekordy z nazwanymi polami:
const request = { model: "gpt-5", seqLen: 4096 };
console.log(request.model);
Obiekt nie jest czystą tablicą klucz-wartość jak dict w Pythonie. Dziedziczy część nazw od samego JavaScriptu. Może to dać zaskakujący wynik:
const tools: Record<string, unknown> = {};

tools["constructor"]; // a built-in function, not a missing value
Object.hasOwn(tools, "constructor"); // false
Jeśli zewnętrzny ciąg znaków wybiera pole obiektu, wywołaj Object.hasOwn przed odczytem. Jeśli potrzebujesz słownika ogólnego przeznaczenia, użyj Map. Map jest bliższa dict w Pythonie: klucz istnieje tylko wtedy, gdy dodał go Twój kod.
const tools = new Map<string, unknown>();
tools.get("constructor"); // undefined
7. Dodawaj rozszerzenie w importach względnych
Plik źródłowy JavaScript, który współdzieli kod z innymi plikami, nazywa się modułem. Ten projekt używa nowoczesnego formatu modułów, modułów ES, zwykle skracanych do ESM. ES oznacza ECMAScript, formalną nazwę języka JavaScript. W praktyce ESM to składnia import i export używana w całym projekcie.
Dla importu względnego Node wymaga dokładnej nazwy pliku. Nie zgaduje, czy ./env oznacza ./env.ts, czy ./env.js:
import { loadEnv } from "./env.ts";Importy z zainstalowanych pakietów lub pakietów przestrzeni roboczej nadal używają nazwy pakietu, bez rozszerzenia pliku:
import { z } from "zod";
import { runAgent } from "@agent/core";
Zod: zadeklaruj schemat, wyprowadź typ
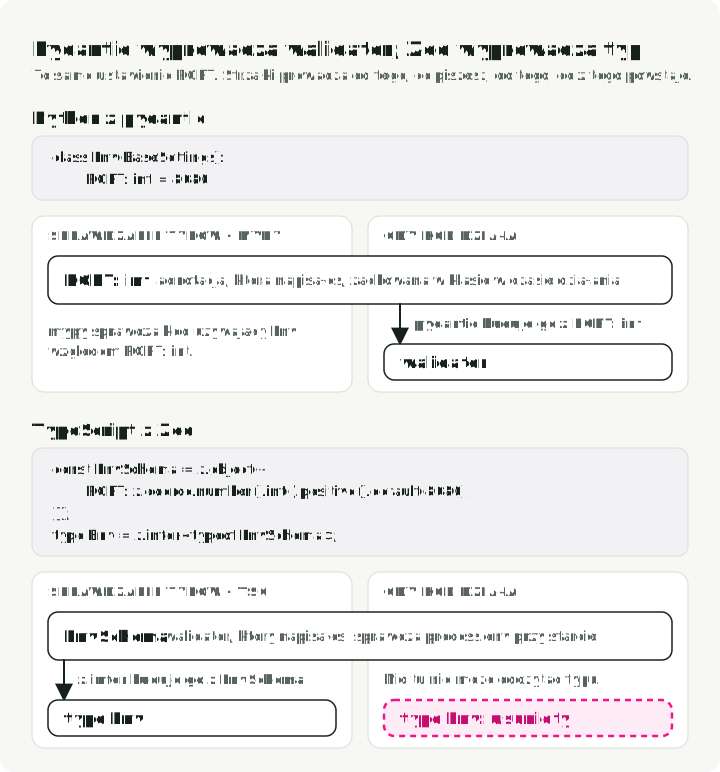
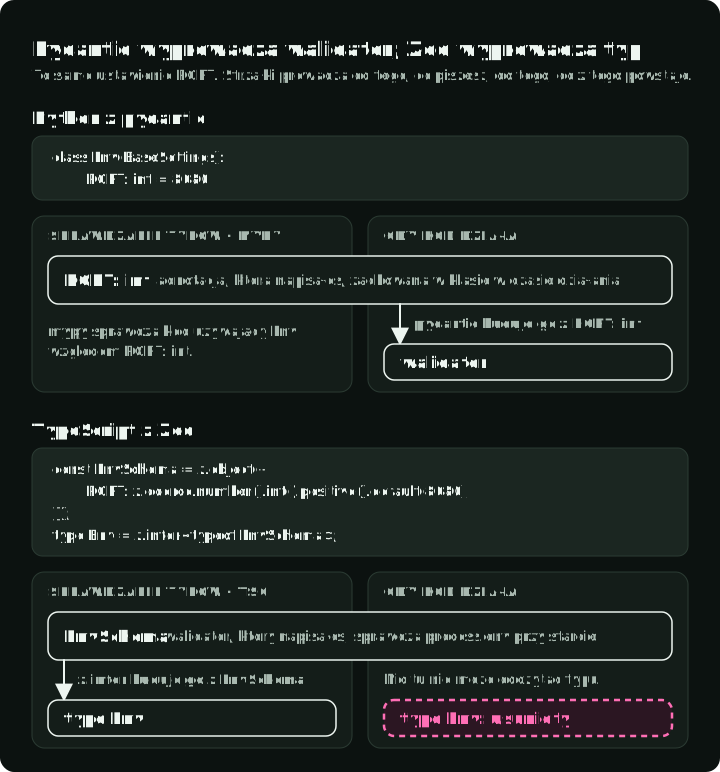
W pydantic deklarujesz klasę i dostajesz walidator. W Zod deklarujesz walidator i wyprowadzasz z niego typ. To samo jedno źródło prawdy, ale w przeciwnym kierunku.
Rysunek pokazuje to samo ustawienie PORT w obu językach oraz to, co zostaje z każdej deklaracji, gdy kod działa.
Z packages/schemas/src/env.ts:
import { z } from "zod"; // `z` is Zod's whole API, the way `pd` is pandas

const EnvSchema = z.object({
    PORT: z.coerce.number().int().positive().default(8080),
    // See the note below: a bare z.url() would accept "localhost:8000".
    OPENAI_BASE_URL: z
        .url({ protocol: /^https?$/ })
        .default("https://api.openai.com/v1"),
    DATABASE_URL: z.string().optional(),
});

export type Env = z.infer<typeof EnvSchema>;
z.infer<typeof EnvSchema> odczytuje typ statyczny ze schematu działającego w czasie działania. z.coerce.number() radzi sobie z tym, że każda zdefiniowana wartość w process.env (odpowiedniku os.environ w Node) jest ciągiem znaków. Pełni tę samą rolę co koercja ustawień liczbowych w pydantic, choć dokładne ciągi akceptowane przez każdą z nich się różnią. Wzorzec odpowiada pydantic-settings i działa raz przy starcie. Nieprawidłowe środowisko daje wtedy czytelny błąd startu zamiast TypeError wewnątrz handlera.
Samo z.url() akceptuje localhost:8000. Standard URL traktuje wszystko przed pierwszym dwukropkiem jako schemat. Odczytuje więc localhost: jako protokół o nazwie “localhost” i akceptuje ciąg. Wartość trafia potem do klienta HTTP i kończy się błędem z mniejszą ilością kontekstu. Walidacja schematu przesuwa błędy wcześniej, ale wymusi także zbyt liberalny schemat, jeśli taki napisałeś.
Zod 4 dostarcza też z.toJSONSchema, więc ten projekt nie potrzebuje zależności zod-to-json-schema, częstej w starszych tutorialach. Ma to znaczenie, gdy jeden schemat musi zasilać trzech odbiorców, czemu poświęcona jest poniższa sekcja “Jedno narzędzie, trzech odbiorców”.
Serwis
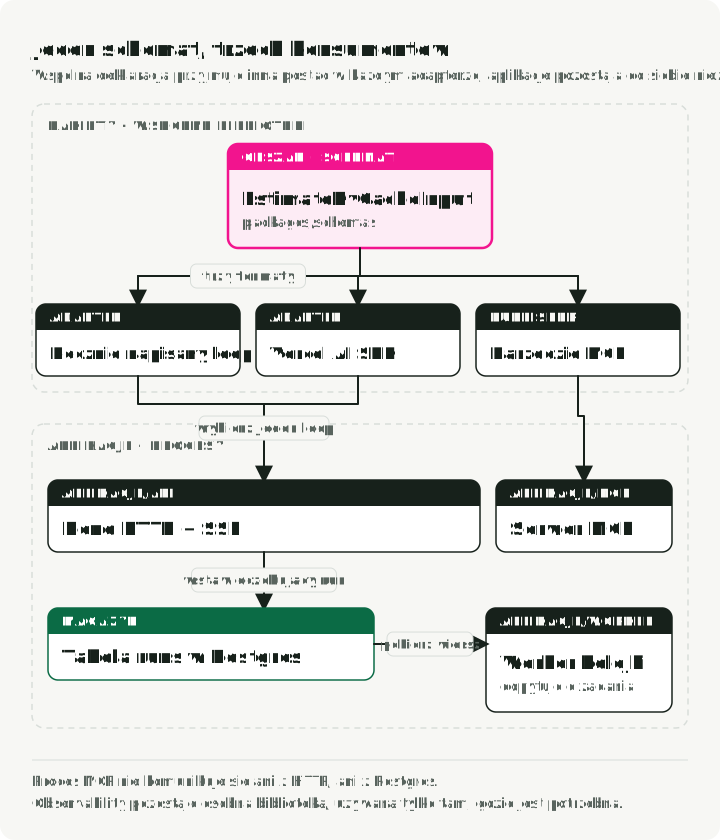
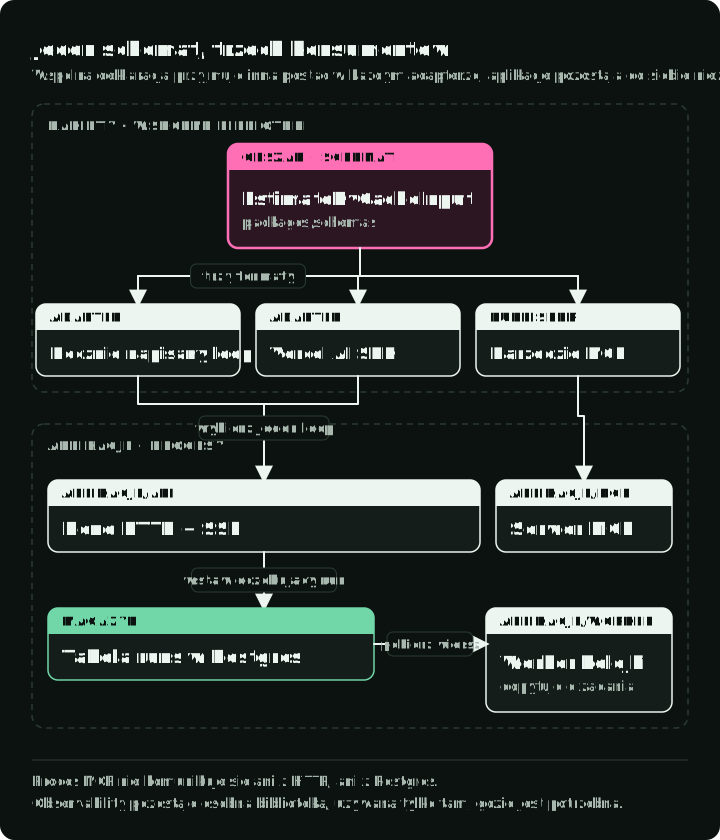
Górny rząd to współdzielony kod w packages/. Pod nim każda aplikacja w apps/ to osobny proces. Tylko API i worker dotykają Postgres, a serwer MCP rozmawia ze swoim klientem przez stdin i stdout.
Serwis demonstracyjny szacuje wielkość wdrożeń LLM. Jedno narzędzie wyszukuje stałe architektury modelu. Drugie szacuje jego zużycie KV cache: pamięci GPU zajmowanej przez klucze i wartości uwagi dla żądań w toku. Oba narzędzia to celowo nudna arytmetyka. Nie potrzebują sieci i zawsze dają tę samą odpowiedź. Dzięki temu serwis da się testować bez klucza API. Estymator KV cache jest też publikowany przez Model Context Protocol (MCP), więc mogą go wywoływać inni klienci AI.
typescript-agent-service/
├── apps/
│   ├── api/           @agent/api: Hono API, streams Server-Sent Events (below)
│   ├── worker/        polls Postgres for long-running jobs
│   └── mcp/           MCP server: exposes one tool to outside AI clients
├── packages/
│   ├── schemas/       package name @agent/schemas: env, API, and tool schemas
│   ├── agent-core/    package name @agent/core: the loop (twice), tools, storage
│   └── observability/ Pino logging, OpenTelemetry tracing
├── pnpm-workspace.yaml
└── package.json
pnpm-workspace.yaml to plik deklarujący przestrzeń roboczą. Pakiety wewnętrzne dostają nazwę z zakresem, taką jak @agent/core, gdzie prefiks @agent/ to konwencja nazewnicza, nie cecha języka. Każdy pakiet deklaruje swój publiczny punkt wejścia w package.json. Ta granica pakietu nie zależy od tego, które polecenie uruchamia aplikację.
Ta prywatna przestrzeń robocza wskazuje te punkty wejścia na źródła .ts, ponieważ każdy odbiorca jest częścią tego samego repozytorium. Publiczne pakiety npm zwykle publikują JavaScript oraz deklaracje typów .d.ts, żeby zwykli użytkownicy Node nie potrzebowali narzędzia do uruchamiania TypeScript ani konfiguracji budowania autora pakietu.
Napisz pętlę narzędzi ręcznie, raz
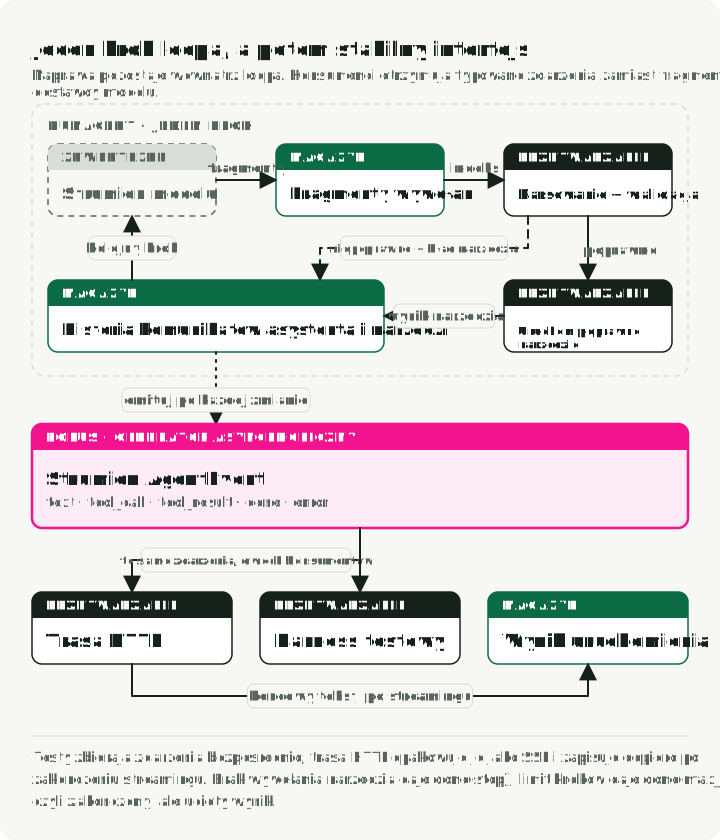
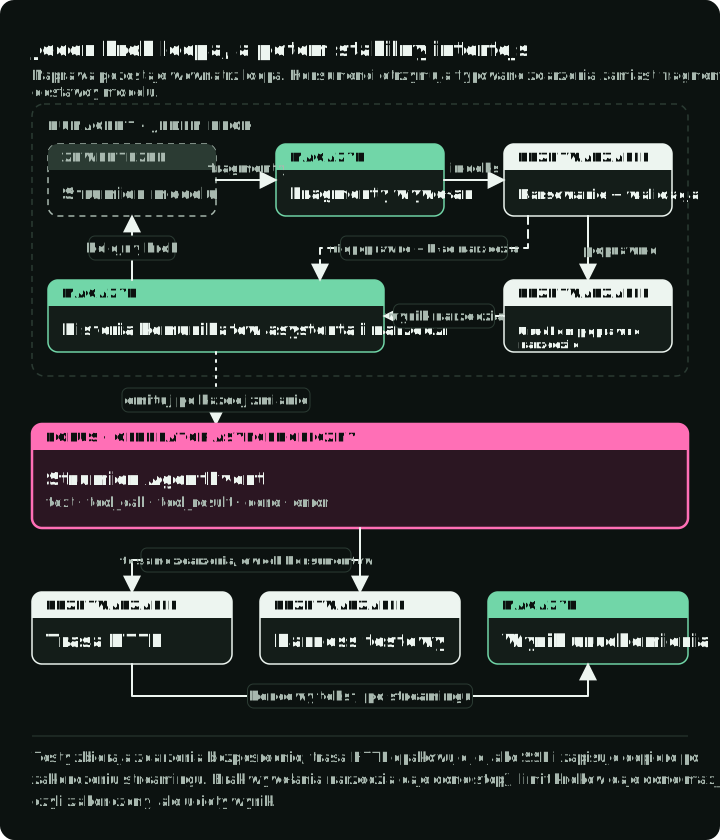
Lewa kolumna to jeden krok modelu. Prawa kolumna to to, co zwraca pętla: poza wyjątkiem, który opuszcza pętlę, te zdarzenia to wszystko, co widzą trasa HTTP i testy.
Frameworki agentów korzystających z narzędzi opakowują tę samą podstawową pętlę:
- Wywołaj model z definicjami narzędzi.
- Zwaliduj i uruchom żądane narzędzia.
- Dołącz wyniki do wiadomości.
- Wywołaj model ponownie.
Napisanie pętli raz sprawia, że widać jej ukryte ścieżki awarii.
Pętla to async function*, generator asynchroniczny, dokładnie taki sam kształt jak async def z yield w Pythonie. Trasa HTTP iteruje po tym generatorze, zamienia każde zdarzenie w ramkę Server-Sent Events i gromadzi tekst. Po zakończeniu strumienia trasa wywołuje storage.createRun raz, z końcowym tekstem. Testy wywołują pętlę osobno i zbierają jej zdarzenia do tablicy. Ramka SSE to jeden fragment długotrwałej odpowiedzi HTTP. Format wyjaśnia kolejna sekcja.
Pętla ma dwa normalne wyjścia. Odpowiedź bez wywołań narzędzi emituje done z stopReason: "stop". Jeśli model wciąż prosi o narzędzia aż do maxSteps, generator mimo to się kończy i emituje done z stopReason: "max_steps". Traktuj ten wynik jako ukończony, ale obcięty: zgromadzony tekst może być niepełny.
Każda wartość emitowana przez pętlę to AgentEvent, unia z tagiem. Skrócone z packages/schemas/src/events.ts:
export const AgentEventSchema = z.discriminatedUnion("type", [
    z.object({ type: z.literal("text"), delta: z.string() }),
    z.object({
        type: z.literal("tool_call"),
        callId: z.string(),
        toolName: z.string(),
        args: z.unknown(),
    }),
    z.object({
        type: z.literal("tool_result"),
        callId: z.string(),
        ok: z.boolean(),
        result: z.unknown() /* ... */,
    }),
    z.object({
        type: z.literal("done"),
        stopReason: z.enum(["stop", "max_steps"]),
        steps: z.number(),
        text: z.string(),
    }),
    z.object({ type: z.literal("error"), message: z.string() }),
]);

export type AgentEvent = z.infer<typeof AgentEventSchema>;
z.discriminatedUnion wybiera wariant na podstawie pola type, podobnie jak match dla klas danych z wyróżnikiem. Wewnątrz if (event.type === "text") kompilator wie, że event.delta istnieje. Dodanie wariantu nie powoduje automatycznie błędu w niekompletnym switch. Aby uzyskać błąd kompilacji dla brakującego wariantu, sprawdź pozostałą wartość względem never w gałęzi default. Reguła lintera sprawdzająca kompletność przypadków również może zgłaszać braki. Zarówno trasa HTTP, jak i poniższa wersja z AI SDK korzystają z zawężonych typów zdarzeń.
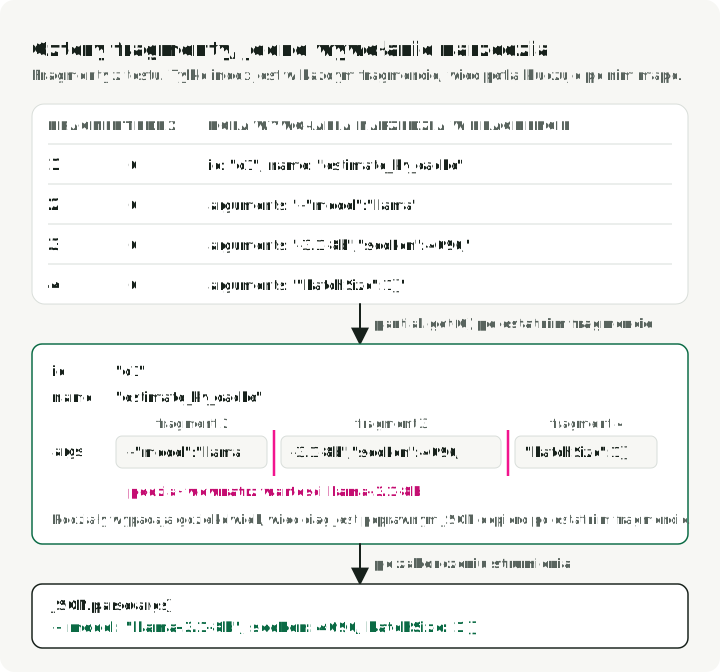
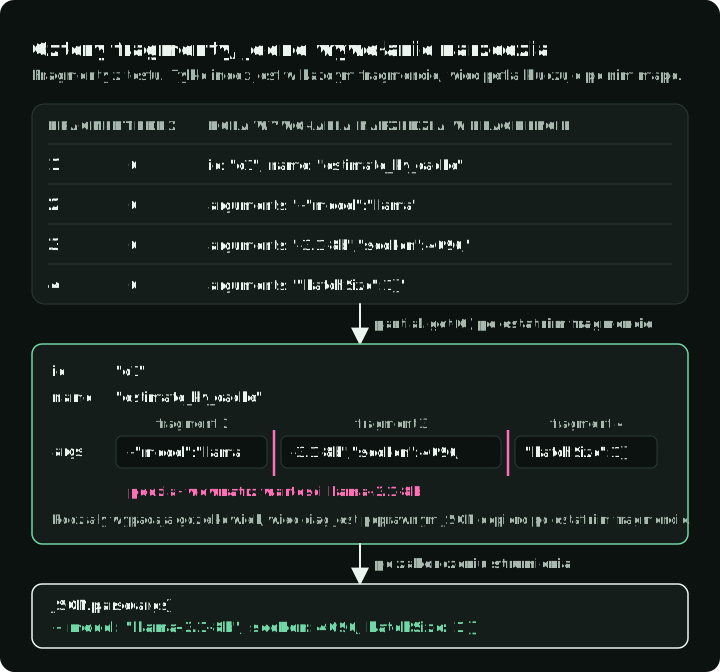
Ciało pętli strumieniuje zdarzenia tekstowe i składa wywołania narzędzi z fragmentów. Z packages/agent-core/src/loop.ts:
let text = ""; // the assistant text produced during this model step
// Keyed by the `index` field, because a streamed response interleaves
// fragments of several parallel tool calls and only `index` is present
// on every fragment. `id` and `name` arrive once, `arguments` arrives
// in pieces. `a?.b` below reads `b` only if `a` exists, and gives back
// `undefined` instead of throwing if it doesn't.
const partial = new Map<number, PartialToolCall>();

for await (const chunk of stream) {
    const choice = chunk.choices[0];
    if (!choice) continue;

    if (choice.delta.content) {
        text += choice.delta.content;
        yield { type: "text", delta: choice.delta.content };
    }

    for (const fragment of choice.delta.tool_calls ?? []) {
        const slot = partial.get(fragment.index) ?? { id: "", name: "", args: "" };
        if (fragment.id) slot.id = fragment.id;
        if (fragment.function?.name) slot.name = fragment.function.name;
        if (fragment.function?.arguments) slot.args += fragment.function.arguments;
        partial.set(fragment.index, slot);
    }
}
Lokalna zmienna pętli text przechowuje jeden krok modelu. Pętla używa jej w wiadomości asystenta dla następnego kroku lub w końcowym zdarzeniu done. To nie jest akumulator na poziomie trasy, który jest później zapisywany.
Mapa partial to część, którą frameworki ukrywają. SDK udostępnia fragmenty ciągów znaków argumentów funkcji, które mogą dzielić serializowany JSON w dowolnych miejscach. Kilka równoległych wywołań może się też przeplatać. Repozytorium ma test, który dzieli {"model":"llama-3.1-8b",...} na cztery fragmenty.
Rysunek śledzi te cztery fragmenty aż do wpisu mapy dla indeksu 0.
Drugą rzeczą wartą napisania samemu jest to, co się dzieje, gdy walidacja się nie uda:
// `tool.parse` is this repo's wrapper, not Zod's. Zod's own `.parse` throws and
// `.safeParse` returns `{ success, data, error }`; this returns
// `{ ok: true, value }` on success and `{ ok: false, error }` on failure, so no
// caller has to catch.
const parsed = tool.parse(raw);
if (!parsed.ok) {
    return {
        ok: false,
        value: { error: `Invalid arguments: ${parsed.error}` },
        parsedArgs: raw,
    };
}
Przed wykonaniem wyszukanie może nie znaleźć narzędzia, JSON.parse może odrzucić argumenty, a Zod może odrzucić ich kształt. Każda taka porażka staje się wiadomością, którą czyta model. Podczas wykonania oczekiwany ToolError też staje się wynikiem narzędzia, żeby model mógł poprawić wywołanie. Nieoczekiwany wyjątek propaguje się do ścieżki błędów HTTP i nie jest przedstawiany jako błąd domenowy. z.prettifyError zamienia drzewo problemów Zod w komunikat, na który model może zareagować, zamiast stack trace’u.
strict: true w definicji funkcji OpenAI prosi dostawcę o ograniczenie dekodowania do schematu. Nie ma związku z flagą strict w tsconfig TypeScript. Przypomina to guided decoding w vLLM, choć obsługiwane schematy i szczegóły wymuszania się różnią. Usuwa jeden rodzaj błędu, ale samodzielnie hostowany endpoint może zignorować flagę. Argumenty muszą też przejść JSON.parse.
Pętla wywołuje /chat/completions, ponieważ repozytorium towarzyszące celuje w serwery zgodne z OpenAI. vLLM, SGLang i Ollama dokumentują ten endpoint, więc OPENAI_BASE_URL może wskazać tego samego klienta na każdy z nich. Pokrycie Responses API jest różne i zmienia się między wydaniami. Jeśli kontrolujesz obie strony, sprawdź aktualną stronę zgodności serwera, zanim wybierzesz między tymi dwoma API.
Potem przejdź na AI SDK i wiedz, co oddajesz
Repozytorium towarzyszące implementuje tego samego agenta także z Vercel AI SDK, żeby można było porównać obie wersje. Obie zwracają wartości AgentEvent, ale obecnie różnią się obsługą błędów kończących wykonanie. Opcjonalny adapter SDK zwraca zdarzenie error z String(part.error) i kończy bez done. Obecna trasa HTTP przekazuje te szczegóły i zapisuje uruchomienie jako succeeded, ponieważ generator zakończył się bez wyjątku. Zanim zastąpisz domyślną pętlę tym adapterem, traktuj error lub strumień zamknięty bez done jako nieudane uruchomienie, usuń poufne szczegóły z komunikatów błędów dla klienta i testuj zapisany status razem ze zdarzeniem końcowym.
Repozytorium używa AI SDK 7. Implementacja z frameworkiem znajduje się w packages/agent-core/src/loop-ai-sdk.ts:
const result = streamText({
    model: provider.chatModel(options.model),
    prompt: options.message,
    tools: aiSdkTools,          // Zod schemas passed straight through
    stopWhen: stepCountIs(options.maxSteps ?? 6),
});

for await (const part of result.fullStream) {
    switch (part.type) {
        case "text-delta": yield { type: "text", delta: part.text }; break;
        case "tool-call":  yield { type: "tool_call", callId: part.toolCallId, /* ... */ }; break;
        // ...
    }
}
SDK usuwa pięć fragmentów kodu aplikacji:
- akumulator fragmentów
JSON.parsei jego ścieżkę błędu- wywołanie, które uruchamia Zod na sparsowanych argumentach
- składanie wiadomości specyficzne dla dostawcy
- licznik kroków
stopWhen przyjmuje kilka warunków, w tym limit kroków lub konkretne wywołanie narzędzia. Pętla for await nie zmienia się, gdy zmienia się polityka zatrzymania.
Tracisz bezpośrednią kontrolę nad niepowodzeniem walidacji. Pętla napisana ręcznie decyduje, co model widzi po odrzuconym wywołaniu. Repozytorium towarzyszące nie ustawia opcji SDK repairToolCall, więc używa wartości domyślnej: gdy dozwolony jest więcej niż jeden krok, AI SDK 7 odsyła nieudane wywołanie do modelu w następnym kroku. Przekaż callback repairToolCall, żeby naprawić wywołanie samodzielnie, na przykład drugim wywołaniem modelu.
Wymiana działa też w drugą stronę. W wersji z SDK zmiana dostawcy jest zlokalizowana w adapterze dostawcy. Nadal wymaga odpowiedniego pakietu dostawcy, poświadczeń, konfiguracji i testów integracyjnych. W surowej pętli obsługa żądań i strumieni specyficzna dla dostawcy to Twój kod do zmiany.
W nowym serwisie zacznij od SDK, chyba że musisz kontrolować te ścieżki awarii. Wersja napisana ręcznie daje małą implementację do przejrzenia i porównania z tym wyborem.
Strumieniowanie przez HTTP: Hono i SSE
Trasy Hono wyglądają jak trasy FastAPI. Jedyny dodatek to zValidator, który robi to, co FastAPI dostaje za darmo z adnotacji typów w sygnaturze handlera. c w poniższym handlerze to kontekst żądania Hono, obiekt, który FastAPI rozdziela na Twoje parametry. deps to zestaw zależności, z którymi tworzona jest aplikacja, zamiast importować je bezpośrednio. runAgent jest jedną z nich, a sekcja o testowaniu pokazuje, co to daje.
Skrócone z apps/api/src/app.ts:
app.post("/v1/chat", zValidator("json", ChatRequestSchema), (c) => {
    const body = c.req.valid("json");
    const log = deps.logger.child({ route: "chat" });

    return streamSSE(c, async (stream) => {
        let text = "";
        let done: Extract<AgentEvent, { type: "done" }> | undefined;
        try {
            // The full route wraps this loop in a `withSpan` tracing span.
            for await (const event of deps.runAgent({
                message: body.message,
                maxSteps: body.maxSteps,
            })) {
                if (event.type === "text") text += event.delta;
                if (event.type === "done") done = event;

                await stream.writeSSE({
                    event: event.type,
                    data: JSON.stringify(event),
                });
            }
        } catch (error) {
            log.error({ err: error }, "agent run failed");
            await stream.writeSSE({
                event: "error",
                data: JSON.stringify({
                    type: "error",
                    message: "Agent run failed",
                }),
            });
            return;
        }

        await deps.storage.createRun({
            kind: "chat",
            status:
                done?.stopReason === "max_steps" ? "truncated" : "succeeded",
            input: { message: body.message },
            output: { text },
        });
    });
});
Trasa zachowuje końcowe zdarzenie done. Pętla, która zatrzymuje się na max_steps, kończy się normalnie, więc trasa zapisuje ją jako truncated, nie succeeded.
zValidator waliduje treść żądania i nadaje c.req.valid("json") typ, który tworzy schemat. Pomiń go, a treść ma typ any, czyli rezygnację z typowania w TypeScript, gdzie każdy dostęp do właściwości się kompiluje i nic nie jest sprawdzane. To wyłącza korzyść z bezpieczeństwa typów, którą daje schemat.
Ta trasa używa Server-Sent Events zamiast WebSocketów. Serwer utrzymuje otwartą odpowiedź HTTP, zapisując ramki event: <name> i data: <json>, a po ostatnim zdarzeniu ją zamyka. Ruch płynie od serwera do klienta, co pasuje do tego strumienia agenta. WebSocket dodałby dwukierunkowe wiadomości i zmianę protokołu, których ta trasa nie potrzebuje.
W domyślnej pętli wyjątek w trakcie strumieniowania zmienia sposób raportowania błędów HTTP. Po wysłaniu pierwszej ramki ze statusem 200 serwer nie może zastąpić tej odpowiedzi statusem 500. Blok catch zapisuje przechwycony błąd w logach, wysyła klientowi zdarzenie błędu ze stałym komunikatem i kończy wykonanie. Ten powrót pomija storage.createRun, więc wyjątek zgłoszony przez generator nie pozostawia wiersza. Ten catch nie wykonuje się, gdy opcjonalny adapter SDK zwraca zdarzenie error i kończy działanie. Aby zachować nieudane uruchomienia do debugowania lub ewaluacji, zapisz w bloku catch wiersz failed z częściowym tekstem.
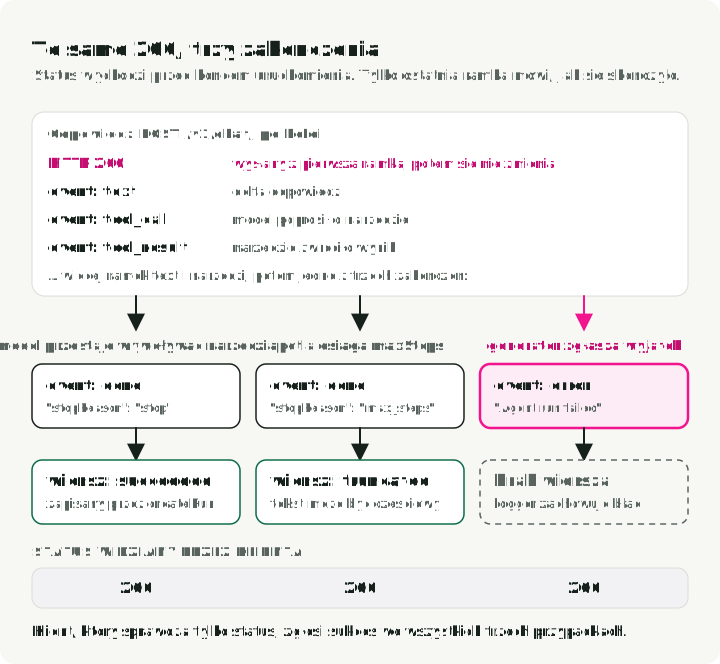
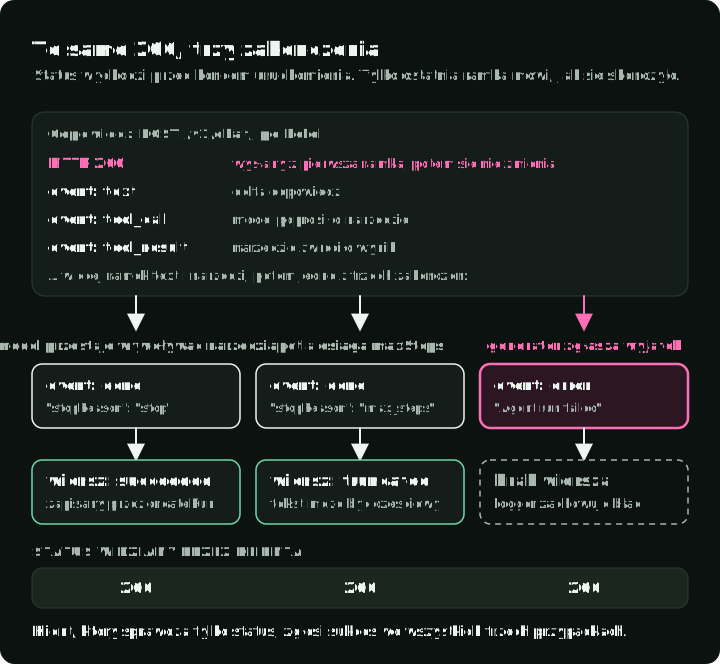
Rysunek śledzi jedno żądanie do trzech zakończeń. Kod statusu jest we wszystkich taki sam, więc rozróżnia je dopiero ostatnia ramka.
Test pokrywa tę ścieżkę. Generator emituje jeden fragment tekstu, a potem zgłasza wyjątek. Odpowiedź pozostaje 200, a jej ostatnia ramka to zdarzenie error ze stałym komunikatem Agent run failed. Logger zachowuje przechwycony błąd do diagnozy po stronie serwera. Każdy klient, który sprawdza tylko kod statusu, zgłosi sukces nieudanego uruchomienia.
app.ts podejmuje dwie mniejsze decyzje warte wyjaśnienia. Traktuje /healthz jako endpoint żywotności (liveness), więc ta trasa celowo nie dotyka Postgres. Awaria liveness podczas awarii bazy mogłaby zrestartować każdą replikę bez naprawy zależności. Dodaj osobne sprawdzenie gotowości (readiness), gdy orkiestrator musi przestać kierować ruch do instancji, która nie sięga Postgres. Ścieżki błędów logują przechwycony błąd, ale zwracają stały ciąg znaków. Wstawianie error.message do treści odpowiedzi to sposób, w jaki connection stringi trafiają do cudzej przeglądarki.
Część w stylu Celery, bez Celery
Długie zadania nie należą do handlera żądania. POST /v1/sweeps waliduje model, długość sekwencji i listę rozmiarów batcha, wstawia wiersz queued i zwraca 202 z identyfikatorem uruchomienia. Worker pobiera wiersz, oblicza rozmiar KV cache dla każdego rozmiaru batcha i zapisuje wynik. GET /v1/runs/:id go odczytuje.
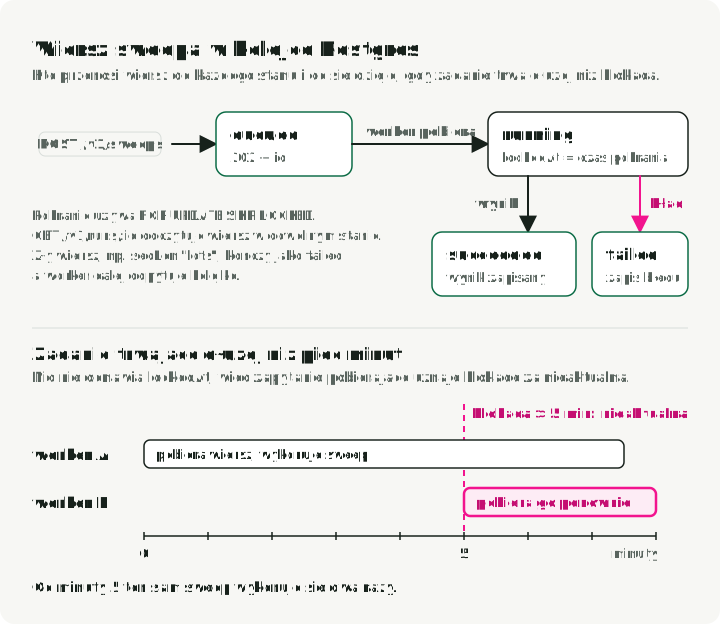
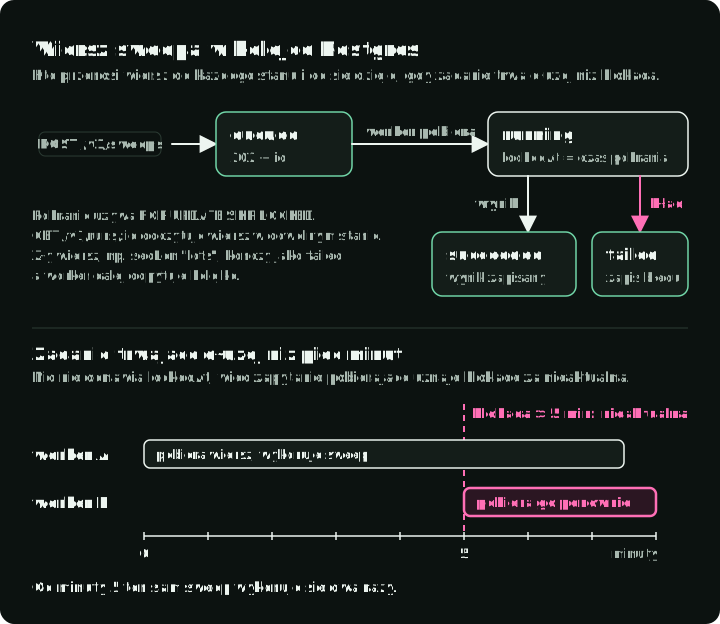
Górna część pokazuje stany, przez które przechodzi wiersz sweepa. Oś czasu pokazuje ponowne pobranie po nieaktualnej blokadzie, wyjaśnione niżej: po pięciu minutach drugi worker pobiera zadanie, które nadal się wykonuje.
Nie ma tu Redisa ani BullMQ. PostgreSQL dokumentuje SKIP LOCKED dla wielu konsumentów tabeli przypominającej kolejkę. Ta klauzula daje temu małemu serwisowi kolejkę at-least-once w jednej tabeli. Jest transakcyjna razem z resztą Twoich zapisów i oznacza o jeden serwis mniej w docker-compose.yml.
Zapytanie pobierające w
packages/agent-core/src/db/storage.ts
wygląda tak:
const [candidate] = await tx
    .select({ id: runs.id })
    .from(runs)
    // The real query also picks up rows whose lock went stale; trimmed here.
    .where(and(eq(runs.kind, kind), eq(runs.status, "queued")))
    .orderBy(runs.createdAt)
    .limit(1)
    // `.for()` adds a locking clause; `{ skipLocked: true }` adds SKIP LOCKED.
    .for("update", { skipLocked: true });
Wiersz jest blokowany na czas transakcji, a każdy równoległy worker wykonujący to samo zapytanie pomija go zamiast czekać. Dwa jednoczesne pobrania nie dostają więc tego samego wiersza, którego blokada nie wygasła. Test integracyjny odpala dwa pobrania naraz przez Promise.all i sprawdza, że zwracają różne wiersze. Naiwna wersja, SELECT ... LIMIT 1 a potem UPDATE, nie przechodzi tego testu: obie transakcje czytają ten sam wiersz, zanim którakolwiek zapisze, więc obie uruchamiają to samo zadanie.
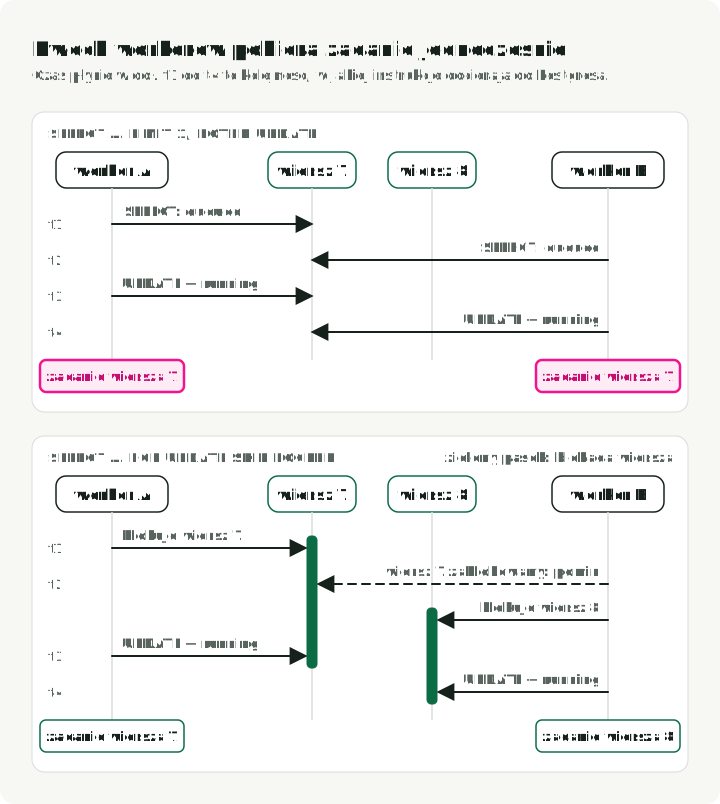
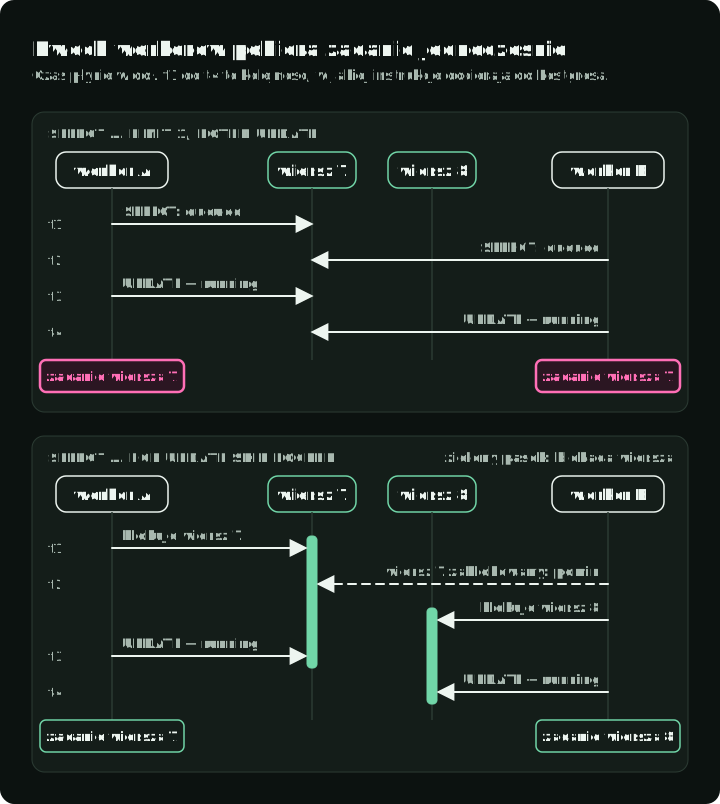
Górny panel to wyścig, który wykrywa test; dolny panel to powyższe zapytanie pobierające.
To wykonanie at-least-once: zadanie może uruchomić się więcej niż raz. Pełne zapytanie pobiera też ponownie wiersz running, gdy jego blokada ma więcej niż pięć minut, a nic nie odnawia tej dzierżawy. Działające zadanie, które trwa dłużej niż pięć minut, może więc zostać pobrane dwa razy. Pisz zadania idempotentne. Dla długotrwałej pracy dodaj heartbeat dzierżawy lub ustaw próg nieaktualnej blokady powyżej maksymalnego czasu działania.
Dodaj BullMQ, gdy potrzebujesz zadań opóźnionych, powtarzalnych harmonogramów, priorytetów, limitów szybkości lub panelu. Odpowiednik w Pythonie to przejście z tabeli w bazie danych na Celery. Do tego czasu Redis to dodatkowy serwis do uruchamiania i monitorowania.
Worker ponownie waliduje to, co czyta z jsonb:
// The row was validated on the way in, but it has been through a database.
// A stored row can outlive the schema version that accepted it.
// The job is a batch-size sweep. Zod's own `.parse` throws; the poll loop
// catches that and marks the run failed.
const input = SweepRequestSchema.parse(run.input);
Zestaw testów podaje też workerowi wiersz sweepa, w którym seqLen to ciąg znaków "lots". Worker oznacza uruchomienie jako nieudane i dalej odpytuje, zamiast się wywrócić i w kółko ponawiać ten sam nieprawidłowy wiersz.
Praca CPU ujawnia kolejne ograniczenie Node. Synchroniczny callback działa w wątku pętli zdarzeń i nie jest wywłaszczany. Pętla for wykonująca arytmetykę przez dwie sekundy blokuje każde żądanie, timer i sprawdzenie liveness w tym procesie na dwie sekundy. Ciasna pętla wewnątrz async def blokuje asyncio w ten sam sposób. W obu środowiskach pracę CPU trzeba wyraźnie przenieść gdzie indziej.
await setTimeout(0) z node:timers/promises (prefiks node: oznacza bibliotekę standardową, więc node:timers jest dla Node tym, czym os dla Pythona) to await asyncio.sleep(0). Sweep oddaje sterowanie po każdym rozmiarze batcha, żeby proces workera mógł obsłużyć timery i inne callbacki. Oddanie sterowania nie czyni pracy CPU równoległą. Node worker_threads potrafi wykonywać JavaScript równolegle. Dla czystej pracy CPU w Pythonie przy zwykłym CPythonie z GIL użyj puli procesów, nie puli wątków. Ten serwis nie używa żadnej z nich. Trzymaj ciężkie obliczenia numeryczne w Pythonie, gdzie żyją już wspierające biblioteki, i przenieś je poza pętlę zdarzeń API.
Jedno narzędzie, trzech odbiorców
EstimateKvCacheInput ma trzech odbiorców:
- Pętla napisana ręcznie konwertuje go przez
z.toJSONSchema. - AI SDK otrzymuje go bez zmian.
- Serwer MCP publikuje jego kształt.
To ponowne użycie jest powodem, dla którego istnieje packages/schemas.
server.registerTool(
    "estimate_kv_cache",
    {
        description: "Estimate KV-cache VRAM in GiB for a served model...",
        // A Zod object schema keeps the map of fields you passed in on
        // `.shape`. This SDK wants that map, not the schema wrapped around it.
        inputSchema: EstimateKvCacheInput.shape,
    },
    async ({ model, seqLen, batchSize }) => {
        /* ... */
    },
);

await server.connect(new StdioServerTransport());
Zanim podłączysz klienta, ważne są dwa szczegóły. Po pierwsze, serwer uruchomiony w ten sposób komunikuje się z klientem przez własne stdin i stdout. Każda linia to wiadomość JSON-RPC. Zabłąkane console.log, odpowiednik print w JavaScripcie, psuje wtedy wiadomość. Klient rozłącza się z błędem parsowania, który nie wskazuje żadnego pliku. Wysyłaj całą diagnostykę na stderr.
Po drugie, błąd domenowy powinien zwracać isError: true z komunikatem. Wywołujący model może wtedy poprawić wywołanie, tak jak po niepoprawnych argumentach narzędzia w pętli agenta.
Możesz sterować serwerem przez printf i potok, co warto zrobić raz, zanim skierujesz na niego prawdziwego klienta:
printf '%s\n' \
  '{"jsonrpc":"2.0","id":1,"method":"initialize","params":{"protocolVersion":"2025-06-18","capabilities":{},"clientInfo":{"name":"probe","version":"1"}}}' \
  '{"jsonrpc":"2.0","method":"notifications/initialized"}' \
  '{"jsonrpc":"2.0","id":2,"method":"tools/call","params":{"name":"estimate_kv_cache","arguments":{"model":"llama-3.1-70b","seqLen":8192,"batchSize":4}}}' \
  | pnpm -s mcp   # -s suppresses pnpm's own output so only JSON-RPC comes back
Ta próba odpowiada wersji protokołu użytej w README repozytorium towarzyszącego. Dla prawdziwego klienta użyj SDK zamiast utrzymywać wiadomości JSON-RPC ręcznie.
Testowanie agenta bez klucza API
Vitest pełni rolę pytesta, ale struktura jest inna. describe grupuje powiązane testy. it i test definiują po jednym przypadku testowym. test.each jest zbliżone do parametrize, beforeEach zapewnia przygotowanie przed każdym testem, vi.fn() tworzy funkcję mock, a describe.skipIf warunkowo pomija grupę.
Testy agenta zależą od jednej decyzji: runAgent przyjmuje klienta OpenAI jako parametr zamiast go tworzyć. Atrapa to obiekt z metodą chat.completions.create, która zwraca skryptowany iterowalny obiekt asynchroniczny:
function fakeClient(scripts: Chunk[][]): OpenAI {
    let call = 0;
    return {
        chat: {
            completions: {
                create: async () => {
                    const script = scripts[call++] ?? [];
                    // Defines an async generator and calls it on the same
                    // line, so `create` hands back something you can
                    // `for await` over, which is the shape a real streaming
                    // response has.
                    return (async function* () {
                        for (const chunk of script) yield chunk;
                    })();
                },
            },
        },
        // TypeScript refuses a direct cast between unrelated shapes, so you
        // cast through `unknown` first. This disables type checking for that
        // value, so keep it to test code.
    } as unknown as OpenAI;
}
Testy dzielą jeden ciąg argumentów JSON na fragmenty i obsługują dwa wywołania narzędzi w jednej odpowiedzi. Pokrywają też niepoprawne batchSize, uszkodzony JSON, nieznane nazwy narzędzi i model, który wywołuje narzędzia, dopóki maxSteps go nie zatrzyma. Plik testowy działa znacznie krócej niż sekundę, bez sieci i bez klucza.
Testy integracyjne z bazą Postgres używają describe.skipIf(!process.env.DATABASE_URL), więc pnpm test działa na świeżym klonie bez uruchomionego Postgres, a CI włącza je, dostarczając zmienną. Repozytorium ma 42 testy. Trzydzieści osiem działa bez bazy Postgres i bez klucza API.
Logowanie strukturalnych zdarzeń z Pino
Pino pełni tę samą rolę co structlog: jeden obiekt JSON na linię, loggery potomne z powiązanymi polami i jawne ukrywanie danych. Repozytorium towarzyszące konfiguruje go w packages/observability/src/logger.ts:
const log = pino({
    redact: {
        paths: [
            "req.headers.authorization",
            "apiKey",
            "OPENAI_API_KEY",
            "*.apiKey",
        ],
        censor: "[redacted]",
    },
});
Bez ukrywania danych log.info({ req }, "...") może skopiować nagłówek Authorization do backendu logów.
Śledzenie pracy aplikacji ręcznymi spanami
Repozytorium towarzyszące używa OpenTelemetry dla trzech spanów na poziomie aplikacji: agent.run, agent.tool i worker.sweep. Nie instaluje automatycznej instrumentacji HTTP ani Postgres. startTracing() w packages/observability/src/tracing.ts tworzy NodeSDK z eksporterem śladów OTLP. Jeśli brakuje OTEL_EXPORTER_OTLP_ENDPOINT, zostawia śledzenie wyłączone.
Samą pracę opakowuje withSpan() z tego samego pliku:
return tracer.startActiveSpan(name, { attributes }, async (span) => {
    try {
        return await fn(span);
    } finally {
        span.end();
    }
});
JavaScript nie ma składni menedżera kontekstu w stylu Pythona. Tutaj callback to blok, który otaczałby menedżer kontekstu w Pythonie. Pełny helper zapisuje też wyjątki i ustawia status spana przed ponownym rzuceniem.
Automatyczne spany HTTP i bazy danych to osobna funkcja. Wymagają odpowiednich pakietów instrumentacji i inicjalizacji przed załadowaniem instrumentowanych modułów. Dodaj to tylko wtedy, gdy te spany będą przydatne, a potem postępuj zgodnie z konfiguracją OpenTelemetry Node SDK dla dokładnych wersji pakietów, które wdrażasz.
Wdrożenie monorepo w Dockerze
Użyj dołączonego Dockerfile. Kontener uruchamia API z loaderem tsx. Nie musisz wybierać ani wywoływać narzędzia do uruchamiania TypeScript, gdy go wdrażasz.
Budowanie używa pnpm fetch, żeby pobrane zależności pozostawały w cache do zmiany pliku blokady. Potem używa pnpm deploy, żeby skopiować API i jego zależności produkcyjne do samodzielnego katalogu. Etap uruchomieniowy działa jako użytkownik node bez uprawnień roota, a jego CMD w formie exec pozwala API odebrać SIGTERM bezpośrednio, co umożliwia łagodne zamknięcie.
Dlaczego Dockerfile ładuje tsx
Node 24 potrafi uruchamiać ograniczony podzbiór TypeScript przez usuwanie adnotacji typów. Nie sprawdza typów w kodzie i nie wykonuje przekształceń, które obsługuje pełne narzędzie do uruchamiania TypeScript. Skrypty pakietów w repozytorium ukrywają ten szczegół. pnpm check wykonuje osobne sprawdzenie statyczne.
Kontener ujawnia kolejne ograniczenie. pnpm deploy kopiuje pakiety przestrzeni roboczej do node_modules, a Node celowo odmawia tam usuwania typów TypeScript (dokumentacja TypeScript w Node). Bez loadera kontener zawodzi przy starcie z ERR_UNSUPPORTED_NODE_MODULES_TYPE_STRIPPING.
Dockerfile ładuje tsx, który obsługuje te pliki .ts, zanim uruchomi je Node. Zespół, który chce mieć w obrazie uruchomieniowym tylko pliki .js, może zamiast tego dodać krok kompilacji. To alternatywny projekt produkcyjny, a nie dodatkowy krok wymagany do uruchomienia tego repozytorium towarzyszącego.
Ścieżka na trzy tygodnie
Doświadczeni inżynierowie Pythona mogą pominąć materiały, które uczą zmiennych i pętli. Ta sekwencja skupia się na częściach różniących się od Pythona. Wykonaj zadanie budowania w każdym wierszu; lektura je wspiera.
| Tydzień | Czytaj | Zbuduj |
|---|---|---|
| 1 | javascript.info: tylko moduły, promisy i obiekty. Trzymaj MDN JS Guide jako materiał pomocniczy. | Przepisz jedno CLI z Pythona na TypeScript. Dodaj skrypt w package.json. Uruchom skrypt i pnpm typecheck. |
| 1-2 | Przeczytaj dokumentację tsconfig TypeScript, darmowe tutoriale Total TypeScript i dokumentację Zod. | Zbuduj moduł konfiguracji walidowany przez Zod i jedną unię z tagiem. Po sprawdzeniu tagu kompilator wie, który wariant zawiera blok. |
| 2 | Przeczytaj dokumentację Hono, Drizzle, Vitest i Biome. | Zbuduj strumieniowe proxy do endpointu zgodnego z OpenAI z logiem opartym na Drizzle. |
| 3 | Przeczytaj dokumentację AI SDK i MCP TypeScript SDK. | Zbuduj agenta korzystającego z narzędzi. Potem zbuduj serwer MCP, który udostępnia jedno z jego narzędzi. |
Zacznij od darmowych tutoriali Total TypeScript. Płać za materiał zaawansowany tylko wtedy, gdy pracujesz z generykami i typami warunkowymi na poziomie bibliotek. Pomiń każdy kurs “wstęp do JavaScriptu” i wszystko, co związane z Reactem, chyba że produkt tego wymaga.
Jako przegląd konwencji produkcyjnych goldbergyoni/nodebestpractices to szeroka lista kontrolna utrzymywana przez społeczność. Porównaj porady, które wpływają na zachowanie w czasie działania lub bezpieczeństwo, z aktualną dokumentacją Node.
Zanim dostosujesz serwis
Testy offline sprawdzają przepływ sterowania serwisu na skryptowych odpowiedziach modelu. Nie wykazują, jak niezawodnie model działający w rzeczywistym serwisie wykona Twoje zadania. Pamiętaj o tej różnicy, gdy zastępujesz narzędzia demo prawdziwymi.
Waliduj każdą wartość wchodzącą z zewnątrz: środowisko, treść HTTP, argumenty narzędzi od modelu i wiersze odczytane z jsonb.
| Wartość | Sprawdza | Gdy sprawdzenie zawiedzie |
|---|---|---|
process.env | EnvSchema, w loadEnv() przy starcie | błąd startu; proces się zatrzymuje |
| Treść HTTP | ChatRequestSchema, przez zValidator | 400; handler się nie uruchamia |
| Argumenty narzędzi | tool.parse, po JSON.parse | błąd narzędzia wysłany do modelu |
runs.input | SweepRequestSchema, w workerze przy każdym pobraniu | uruchomienie oznaczone jako failed; worker dalej odpytuje |
Następnie ustal politykę ukończenia: zdecyduj, czy aplikacja akceptuje, ponawia lub przegląda uruchomienia truncated, i przetestuj razem zdarzenie oraz zapisany status. Jeśli zadania mogą trwać dłużej niż próg nieaktualnej blokady, dodaj heartbeat dzierżawy, zanim dodasz efekty uboczne.
Gdy te zachowania są jawne, dodaj wiersz failed opisany w sekcji o strumieniowaniu i użyj nieudanych oraz obciętych uruchomień do zbudowania osobnego zestawu ewaluacji agenta. Tam testuje się ukończenie zadań; zestaw offline pozostaje szybszym sprawdzeniem zepsutego strumieniowania, walidacji i zapisu.
Źródła
Repozytorium demonstracyjne
- slavadubrov/typescript-agent-service - monorepo użyte w całym artykule: API Hono z SSE, dwie implementacje pętli agenta, storage Drizzle, worker, serwer MCP i 42 testy
Środowisko uruchomieniowe i język
- Uruchamianie TypeScript bezpośrednio w Node.js - ograniczona obsługa TypeScript w Node i jej ograniczenie dla
node_modules - Opcje kompilatora TypeScript -
stricti inne sprawdzenia skonfigurowane w repozytorium towarzyszącym - Przewodnik JavaScript MDN - dokumentacja języka, którą warto mieć otwartą
- javascript.info - nowoczesny tutorial JavaScriptu. Przeczytaj rozdziały o modułach i promisach.
Narzędzia
- pnpm i instalacja pnpm - menedżer pakietów, przestrzenie robocze i konfiguracja
- Biome - lint, format i sortowanie importów w jednym pliku binarnym
- Vitest - narzędzie do testów, które nie wymaga konfiguracji transformacji
- Total TypeScript - darmowe tutoriale oraz płatna ścieżka o typach zaawansowanych
Biblioteki
- Zod - walidacja schematów i wnioskowanie typów. Wersja 4 zawiera
z.toJSONSchema. - Hono - framework HTTP oparty na standardach sieciowych
- Drizzle ORM - ORM TypeScript zorientowany na SQL z migracjami
drizzle-kit - Dokumentacja SELECT w PostgreSQL - klauzula blokady
FOR UPDATE ... SKIP LOCKED - BullMQ - kolejka oparta na Redisie, gdy tabela w bazie nie wystarcza
AI i agenci
- Vercel AI SDK -
streamText,tool,stopWheni adaptery dostawców - openai/openai-node - oficjalny klient TypeScript
- MCP TypeScript SDK i specyfikacja MCP - budowanie serwerów i klientów
Konwencje
- goldbergyoni/nodebestpractices - lista kontrolna konwencji produkcyjnych utrzymywana przez społeczność