Enterprise RAG Challenge 3: Erkenntnisse aus öffentlichen Einreichungen

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Bei der Enterprise RAG Challenge 3 (ERC3) sollten Agents Business-Aufgaben gegen eine simulierte Unternehmens-API erledigen. Das eingefrorene Prize-Leaderboard ist ungewöhnlich nützlich, weil viele Teilnehmer mehr als nur einen Score veröffentlicht haben: Architektur, Model-Mix, Kosten und Hinweise zu Fehlern.
Ich habe diese öffentlichen Beschreibungen ausgewertet, um eine engere Frage zu beantworten: Welche Designentscheidungen tauchten in starken Einreichungen wiederholt auf, und welche davon sind auch außerhalb dieses Benchmarks nützlich?
Dieser Artikel richtet sich an Engineers, die Agents bauen, die Business-APIs aufrufen. Sie sehen fünf Designs aus den öffentlichen Berichten, die Probleme, die jedes davon gelöst hat (Berechtigungen, Pagination, fehlende Links, Context-Größe), und eine Reihenfolge, in der Sie sie in Ihrem eigenen Agent ausprobieren können.
Was ist die Enterprise RAG Challenge?
Die Enterprise RAG Challenge 3 ist ein groß angelegtes, von der Community getragenes Forschungsprojekt, das testet, wie autonome AI Agents komplexe Business-Aufgaben bearbeiten. Anders als statische Benchmarks läuft ERC3 auf der Agentic Enterprise Simulation (AGES), einer Discrete-Event-Simulation, die eine realistische Enterprise-API bereitstellt.
Was der Benchmark testet
In AGES arbeiten Agents in einem fiktiven Unternehmen mit:
- Mitarbeiterprofilen mit bestimmten Skills und Abteilungen
- Projekten mit Teamzuordnungen und Kundenbeziehungen
- Corporate Wiki mit Geschäftsregeln und Berechtigungshierarchien
- Zeiterfassung und Finanzvorgängen
Jeder Task startet eine isolierte Simulation. Das Unternehmens-Wiki wird geteilt, die operativen Datensätze unterscheiden sich jedoch je nach Task. Ein Agent kann die Suite daher nicht lösen, indem er einen einzigen Unternehmenszustand auswendig lernt.
Scores als Momentaufnahme lesen
ERC3 stellt inzwischen sowohl ein eingefrorenes Competition-Leaderboard als auch einen öffentlichen Benchmark bereit, der nach dem Event weiter Runs erhalten hat. Diese Seiten beantworten unterschiedliche Fragen. Die folgenden Zahlen beschreiben das Prize-Leaderboard zum Zeitpunkt des Competition-Cutoffs, nicht spätere Bestleistungen:
| Metrik | Competition-Snapshot |
|---|---|
| Prize-Einreichungen | 38 |
| Task-Set | 103 Business-Tasks |
| Höchster Prize-Score | 0.718 |
| Prize-Cutoff | 9. Dezember 2025, 13:40 MEZ |
Die Live-Benchmark-Seite kann höhere Scores anzeigen, weil sie spätere Runs enthält. Für Aussagen darüber, was den Wettbewerb gewonnen hat, ist daher das eingefrorene Leaderboard die richtige Quelle. Das Ultimate-Leaderboard nimmt den besten Run jedes Accounts ohne Competition-Cutoff. Seine Scores sind deshalb nicht mit Prize-Scores vergleichbar.
Task-Typen
Die Tasks decken mehrere Skill-Bereiche ab:
- Multi-Hop-Reasoning, etwa die Zuordnung von Mitarbeiter-Skills zu Projektzuweisungen.
- Berechtigungsprüfung, etwa das Blockieren nicht autorisierter Gehaltsänderungen oder Datenzugriffe.
- Mehrdeutige Anfragen, darunter mehrsprachige und umformulierte Anfragen.
- Strikte Einhaltung des Output-Formats, einschließlich obligatorischer Entity-Links in Antworten.
Was die Einreichungen nahelegen
Die öffentlichen Berichte stützen kein eindeutiges Urteil wie „Multi-Agent schlägt Single-Agent“. Der Prize-Entry auf Platz vier, MMzXeM, war ein einzelner Agent mit Tools, die 1:1 auf die API-Endpoints abgebildet waren, einem ask_wiki-Tool und einem System Prompt von 320 Tokens. Die Berichte stützen jedoch vier engere Beobachtungen:
- Teams lagerten eine Komponente aus, wenn sie eine Anforderung verantwortete, an der Agents immer wieder scheiterten: eine Berechtigungsprüfung, die Validierung von Schritten, Code-Ausführung oder Entity-Links. Sie teilten nicht nach beliebigen „Agent-Rollen“ auf.
- Die Validierung rückte näher an irreversible Aktionen. Mehrere Systeme prüften Berechtigungen vor der Ausführung, kontrollierten einzelne Schritte oder sicherten die finale Antwort ab.
- Fehlgeschlagene Traces trieben die Änderungen an. Der Prize-Gewinner übersetzte fehlgeschlagene Runs über einen automatisierten Loop in Prompt-Revisionen; andere Teams dokumentierten ähnlich konkrete Fixes an Tools und Prompts.
- Die Context-Policy war eine Architekturentscheidung. Teams erprobten Distillation, Preloading, Retrieval und History Compression. Ihre eigenen Berichte widersprechen sich darin, ob Compression geholfen hat – ein Universalrezept gibt es daher nicht.
Fünf aufschlussreiche Ansätze
Diese Ansätze sind nicht nach Rang sortiert. Ich habe sie ausgewählt, weil ihre öffentlichen Beschreibungen fünf unterschiedliche Wege zeigen, das System zu bauen: automatisierte Prompt-Revision, spezialisierte Stufen, Validierung pro Schritt, Guards für die Antwort und Plan-Execute-Isolation.
| Team | Leaderboard-Kontext | Veröffentlichter Score |
|---|---|---|
| VZS9FL | Prize, 1. | 0.718 |
| Lcnxuy | Prize, 8. | 0.505 |
| NLN7Dw | Prize, 2. | 0.621 |
| J8Gvbi | Prize, 16. | 0.437 |
| 5qsp7i (key_concept_parallel) | Ultimate, 3. | 0.670 |
1. Evolutionäres Prompt Engineering (Team VZS9FL / @aostrikov)
Der Ansatz mit dem höchsten Score automatisierte das Prompt Engineering über einen Self-Improvement-Loop.
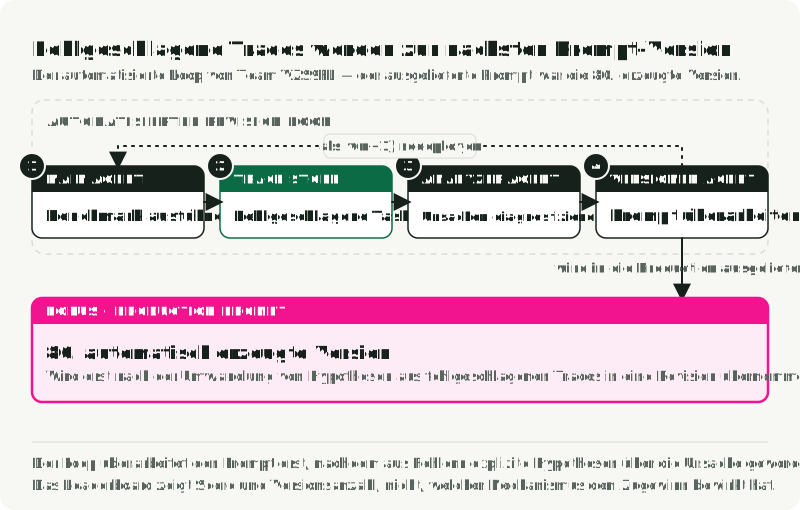
Statt den Production-Prompt von Hand zu optimieren, baute das Team einen Loop aus drei Agents, der aus fehlgeschlagenen Traces Kandidaten für Revisionen erzeugte.
Pipeline aus drei Agents:
| Agent | Rolle |
|---|---|
| Main Agent | Führt den Benchmark aus und protokolliert alle Aktionen und Fehler |
| Analyzer Agent | Prüft fehlgeschlagene Tasks und formuliert Hypothesen zu den Ursachen |
| Versioner Agent | Erzeugt eine neue Prompt-Version, die die Erkenntnisse einarbeitet |
Der Production-Prompt war die 80. automatisch generierte Version. Das Team beschreibt den Loop so: Er analysiert fehlgeschlagene Tasks, schlägt Ursachen vor und entscheidet, welche Vorschläge übernommen werden. Das Leaderboard belegt den finalen Score und die Zahl der Iterationen. Es zeigt nicht, wie viel des Zugewinns auf die Automatisierung entfiel und wie viel auf Models, Tools oder das angesammelte Benchmark-Feedback.
Stack: claude-opus-4.5 mit dem Anthropic Python SDK und nativem Tool Use.
2. Sequenzielle Multi-Agent-Pipeline (Team Lcnxuy / @andrey_aiweapps)
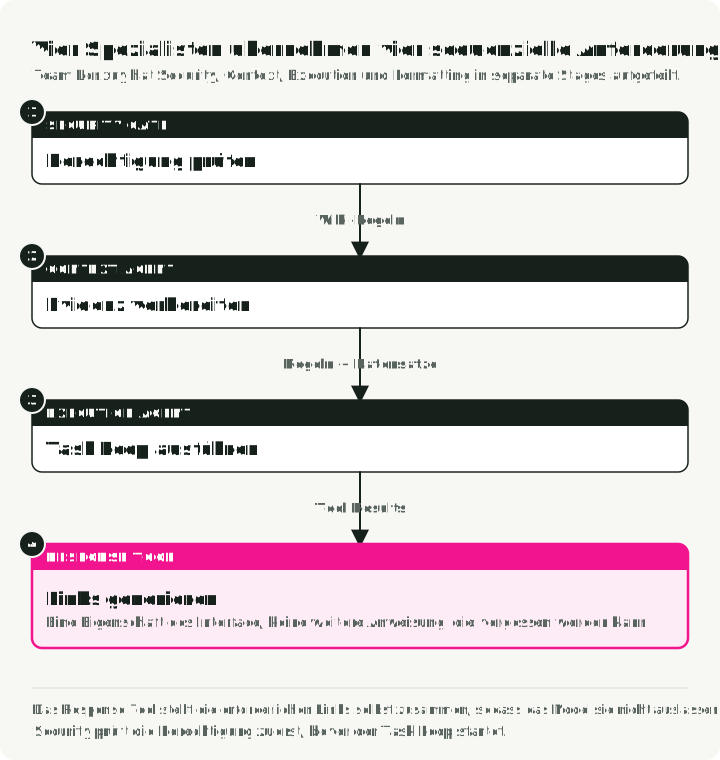
Diese Einreichung baute einen sequenziellen Workflow, in dem spezialisierte Komponenten Security Checks, Context Extraction, Ausführung und die Formatierung der Entity-Links übernahmen.
Die dokumentierten Komponenten:
- Security Gate Agent: Prüfung vor der Ausführung, die Berechtigungen gegen die Wiki-Regeln validiert, bevor der Main Loop läuft.
- Context Extraction Agent: Zieht die entscheidenden Regeln aus System Prompts mit mehr als 500 Zeilen und lädt Nutzer-, Projekt- und Kundendaten vorab.
- Execution Agent: Planning im ReAct-Stil mit 5 internen Phasen (Identität → Bedrohungsprüfung → Informationssammlung → Zugriffsprüfung → Ausführung).
- LinkGeneratorAgent: In das Response-Tool eingebettet; liest den Context und fügt die erforderlichen Entity-Links ein.
Laut dem Bericht des Teams sollte der LinkGeneratorAgent fehlende Links verhindern: Antworten mit richtigem Text, aber ohne die erforderlichen Entity-Links. Das ist der am besten übertragbare Teil. Weil er im Response-Tool sitzt, wird eine Benchmark-Anforderung (obligatorische Entity-Links) zur Eigenschaft der Schnittstelle und nicht zu einer weiteren Anweisung, die das Execution-Model vergessen kann.
Stack: die Frameworks atomic-agents und instructor mit gpt-5.1-codex-max, gpt-4.1 und claude-sonnet-4.5.
3. Schema-Guided Reasoning mit Step-Validierung (Team NLN7Dw / Ilia Ris)
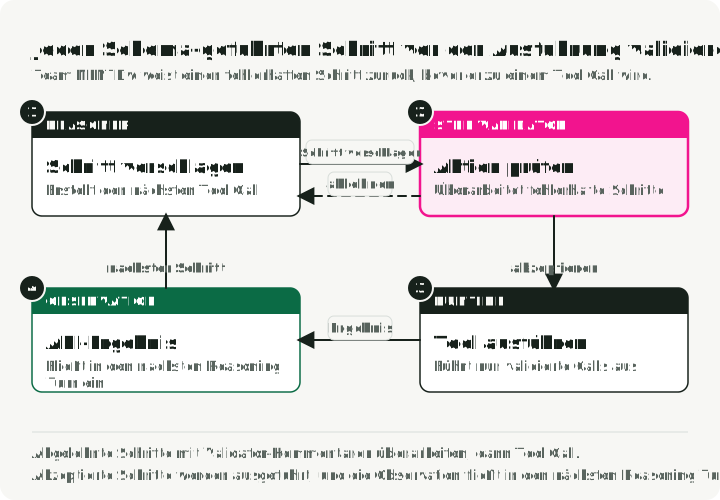
Schema-Guided Reasoning (SGR) lässt das Model bei jedem Schritt ein festes Output-Schema ausfüllen, zum Beispiel mit seinem Reasoning, einem Plan und dem nächsten Tool Call. So kann das Programm jedes Feld lesen und prüfen. Der SGR-Artikel in diesem Blog zeigt, wie sich ein solches Schema mit vLLM durchsetzen lässt. Dieses Team kombinierte SGR mit schneller Inference und einem Validator für jeden vorgeschlagenen Schritt. Das Design macht Korrekturen billig: Ein fehlerhafter Schritt wird abgelehnt, bevor er zum Tool Call wird, und der Main Flow überarbeitet ihn mit den Kommentaren des Validators.
Zentrale Komponenten:
| Komponente | Funktion |
|---|---|
| StepValidator | Prüft jeden vorgeschlagenen Schritt. Stimmt etwas nicht, geht er mit Kommentaren zur Überarbeitung zurück. |
| Context-Verwaltung | Vollständiger Plan aus dem vorigen Turn, dazu komprimierte History für ältere Turns |
| Dynamische Anreicherung | Zieht automatisch Nutzerprofil, Projekte und Kunden; ein LLM filtert, sodass nur aufgabenrelevante Daten einfließen |
| Auto-Pagination-Wrappers | Alle List-Endpoints liefern automatisch vollständige Ergebnisse |
Das Team berichtete, gpt-oss-120b auf Cerebras mit bis zu rund 3.000 Tokens pro Sekunde zu betreiben. Die Kombination aus Validierung und Inference mit hohem Throughput könnte die Latency-Kosten der Validierung gesenkt haben. Das öffentliche Ergebnis zeigt diesen Effekt nicht isoliert.
Stack: ein modifizierter NextStep-Agent, der für ERC3 veröffentlichte SGR-Beispiel-Agent.
4. Enricher- und Guard-System (Team J8Gvbi / @mishka)
Diese Einreichung ergänzte eine SGR-Basis um nicht blockierende Hinweise und ein gestuftes Guard-System. Sobald API-Antworten eintrafen, prüften Enrichers sie und fügten dem späteren Context operative Hinweise hinzu. Die Guards prüften die Antwort des Agents, bevor sie abgeschickt wurde.
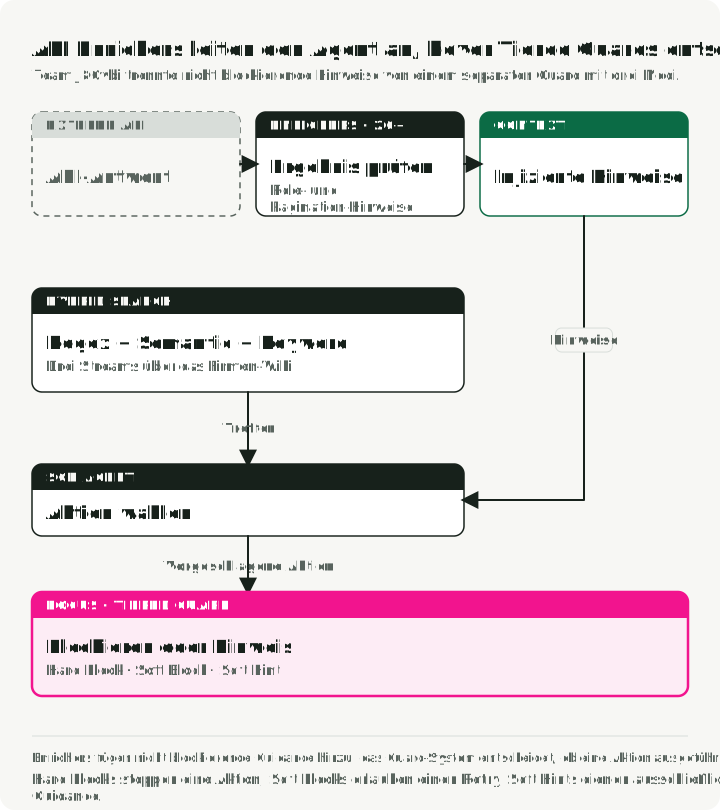
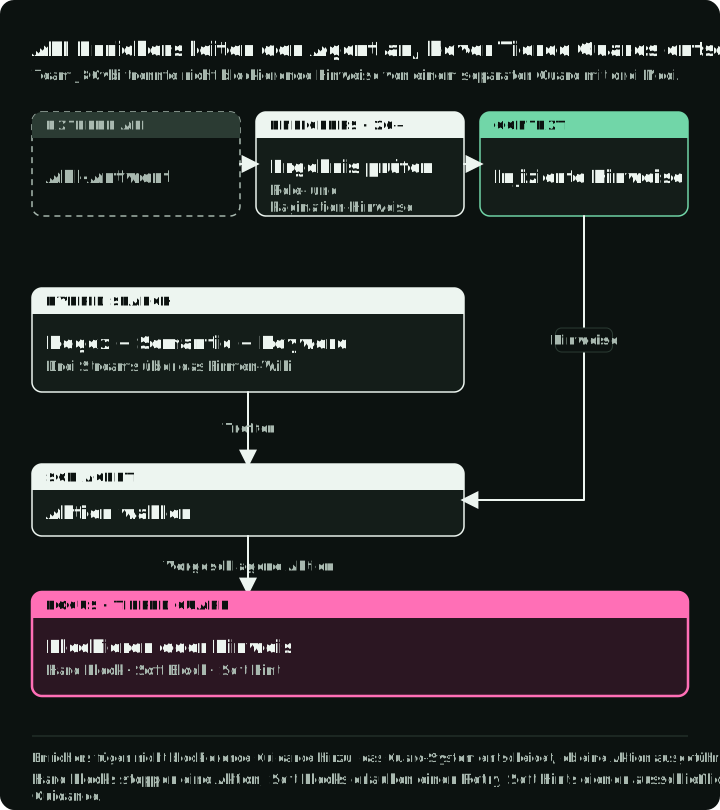
Mehr als 20 Enrichers prüften API-Antworten und fügten kontextbezogene Hinweise ein:
RoleEnricher: "You are LEAD of this project, proceed with update."
PaginationHintEnricher: "next_offset=5 means MORE results! MUST paginate."
Guard-System mit drei Modi:
| Modus | Verhalten |
|---|---|
| Hard Block | Eine Antwort, die laut API-Daten unmöglich ist, etwa weil sie einen Mitarbeiter außerhalb des Projektteams nennt, wird abgelehnt |
| Soft Block | Eine riskante Antwort wird einmal mit einer Warnung abgelehnt und akzeptiert, wenn der Agent sie nach dieser Warnung erneut abschickt |
| Soft Hint | Ein Hinweis wird angehängt, ohne zu blockieren |
Hybrid-RAG-Wiki: Das Team durchsuchte eine lokale Kopie des Unternehmens-Wikis auf drei Wegen: per Regex nach strukturierten Mustern wie salary|privacy, mit Sentence-Transformer-Embeddings für semantische Treffer und per Token-Überlappung als Keyword-Fallback. Meine Lesart, warum drei: Regex findet exakte Feldnamen und Begriffe, und Embeddings finden Regeln, die anders formuliert sind als die Frage.
Stack: qwen/qwen3-235b-a22b-2507 auf dem SGR-Framework von LangChain.
5. Plan-Execute-REPL (Team 5qsp7i / key_concept_parallel)
Diese Architektur hielt Planning und Code-Erzeugung in getrennten Model-Aufrufen. Der erzeugte Python-Code läuft in einer REPL (Read-Eval-Print-Loop): einer Python-Session, die ihre Variablen zwischen den Schritten behält. Der Entry stand im breiteren Ultimate-Leaderboard, nicht in den fünf besten des eingefrorenen Prize-Leaderboards. Seine öffentliche Beschreibung ist trotzdem nützlich, weil sie eine andere Form der Zerlegung zeigt: Isolation nach Ausführungsphase statt nach Geschäftsrolle.
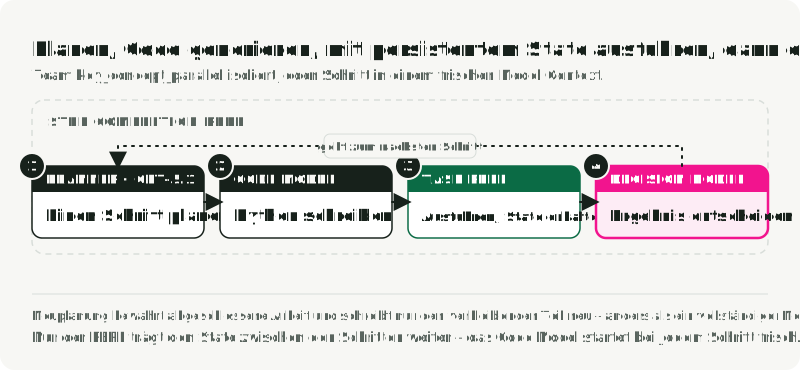
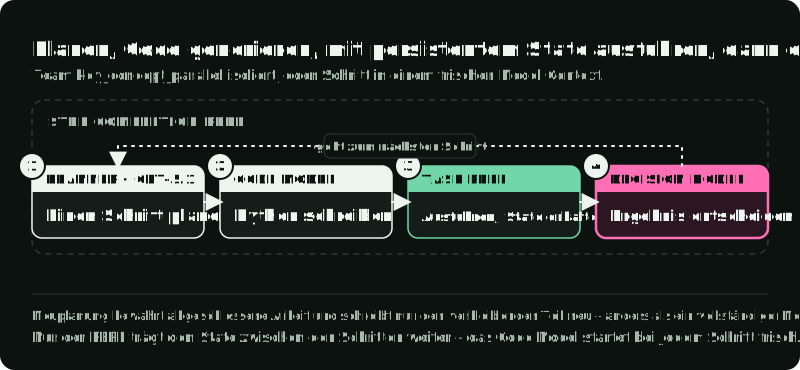
Verschiedene Models übernahmen verschiedene Aufgaben: eines plante, eines schrieb Python, und ein separates Entscheidungs-Model wählte nach jedem Schritt, was als Nächstes geschieht.
Multi-Model-Setup:
| Stufe | Model |
|---|---|
| Planning | openai/gpt-5.1 |
| Code-Erzeugung | deepseek/deepseek-v3.2 |
| Entscheidung je Step | openai/gpt-4.1 |
| Finale Antwort | openai/gpt-4.1 |
Die REPL zum Abschluss eines Schritts:
- Der Planner erstellt einen übergeordneten Schritt.
- Das Code-Generierungs-Model arbeitet in einem frischen Model-Context und schreibt dafür ein Python-Skript.
- Das Skript läuft in einer Task-bezogenen REPL, deren Variablen über Schritte hinweg erhalten bleiben.
- Das Entscheidungs-Model prüft das Ergebnis und wählt eines von vier Resultaten: mit dem nächsten Schritt weitermachen, beenden, weil der Task erledigt ist, abbrechen, weil er gescheitert ist, oder neu planen.
Der Replan-Pfad ist die wiederverwendbare Idee. Zeigt ein Schrittergebnis, dass der Plan nicht mehr passt, kann das Entscheidungs-Model die erledigte Arbeit behalten und nur die verbleibenden Planschritte neu schreiben. Im Diagramm teilen sich „done“ und „failed“ einen Ausgang zur finalen Antwort.
Muster, die sich in den Einreichungen wiederholten
Die Implementierungen unterschieden sich, aber mehrere technische Anliegen tauchten in den öffentlichen Beschreibungen immer wieder auf.
Context-Management war explizit
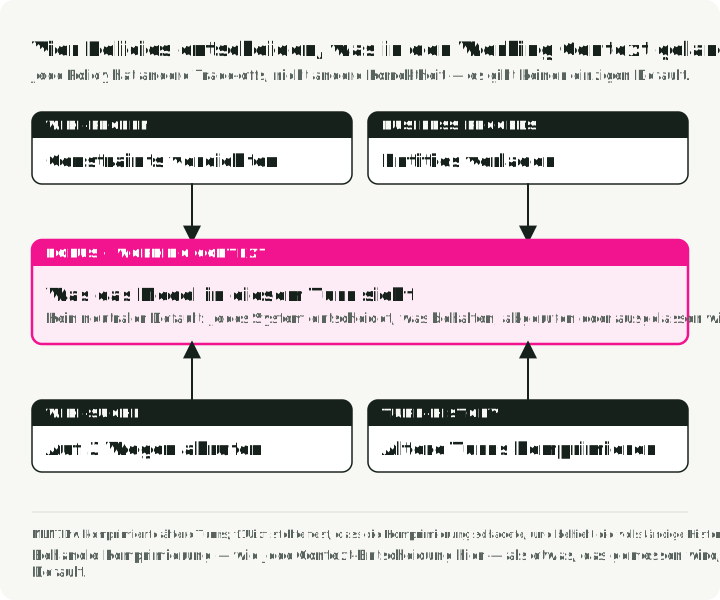
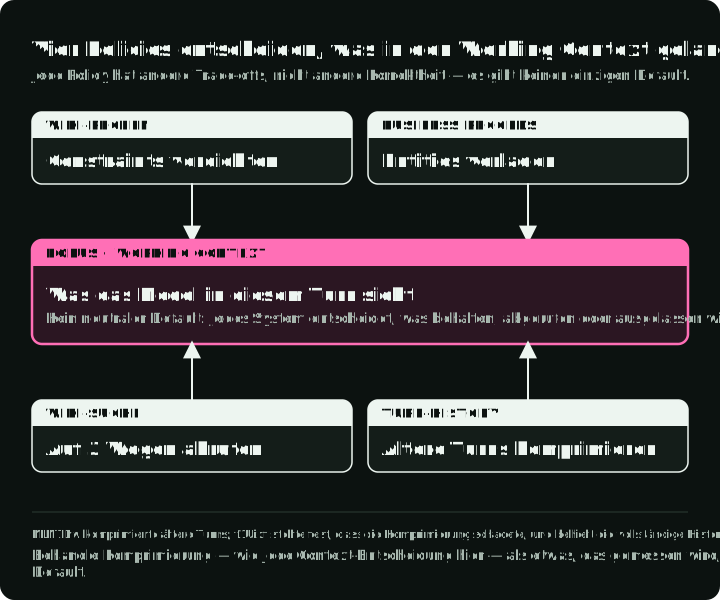
Kein Team konnte dem Model jede Regel, jeden Datensatz und jeden früheren Schritt vorlegen, ohne eine Policy-Entscheidung zu treffen. Die Systeme unterschieden sich darin, wo sie Informationen filterten: vor dem Run, beim Retrieval oder in der History. Das Diagramm teilt den Context des Models in vier Teile auf und zeigt, welche Policy jeden Teil steuert, wann sie läuft und welche Teams sie nutzten.
| Strategie | Ansatz | Am besten für |
|---|---|---|
| Regel-Destillation | Wiki-Regeln zu kompakten Anweisungen vorverarbeiten und dabei Constraints erhalten | Schlanke Prompts, schneller Start |
| Umfassendes Preloading | Nutzer-, Projekt- und Kundendaten vor der Ausführung laden | Weniger Tool Calls |
| Hybrides RAG | Regex-, semantische und Keyword-Suche parallel | Komplexen Retrieval-Bedarf |
| History-Kompression | Aktuelle Turns vollständig behalten, ältere History komprimieren | Lange Konversationen |
Trade-off: NLN7Dw komprimierte ältere Turns, während f1Uixf berichtete, dass History Compression seinen Experimenten schadete, und stattdessen die vollständige Konversation behielt. Behandeln Sie Compression als gemessene Entscheidung, nicht als Standard. Auch bei der Prompt-Größe unterschieden sich starke Einreichungen. Kc7F2N (3. Prize) hielt die eigenen Anweisungen minimal, stützte sich auf destillierte Wiki-Regeln und baute seine Suchtools auf Embeddings auf. MMzXeM (4. Prize) beschränkte den Haupt-Prompt auf 320 Tokens und legte das gesamte Wiki hinter sein
ask_wiki-Tool, das auf Context Caching setzte, um günstig zu bleiben.
Prüfungen vor, während und nach dem Main Loop
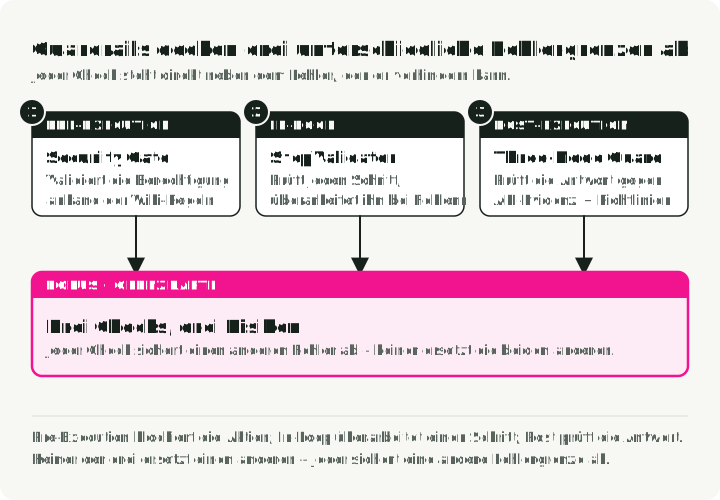
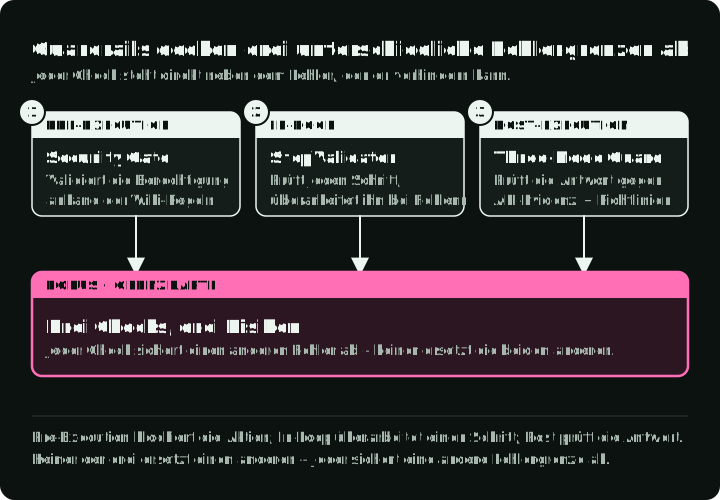
Mehrere Teams platzierten Prüfungen vor, während oder nach dem Main Loop. Diese Prüfungen brauchen in jeder Phase andere Daten. Eine gemeinsame Implementierung kann sie ausführen, wenn sie in jeder Phase die richtigen Eingaben erhält. Ein Critic, der erst für die finale Antwort aufgerufen wird, kann einen früheren nicht autorisierten Tool Call nicht verhindern. Das Diagramm ordnet jede Prüfung auf einer Zeitleiste von der Aufgabe bis zum Grader ein und zeigt, was sie sieht und welchen Fehler sie verhindert.
| Guardrail-Typ | Wann | Beispiel |
|---|---|---|
| Prüfungen vor der Ausführung | Vor dem Start des Main Loop | Der Security Gate Agent validiert Berechtigungen gegen die Wiki-Regeln |
| Validatoren im Loop | Während des Reasonings | StepValidator prüft jede vorgeschlagene Aktion und löst bei Fehlern eine Überarbeitung aus |
| Guards nach der Ausführung | Vor der finalen Abgabe | Das Drei-Modi-Guard-System prüft die Antwort des Agents gegen API-Daten und Policy |
Tool-Wrapper
Mehrere Teams veränderten die Tool-Ebene, die das Model sieht, statt Anweisungen zur rohen API hinzuzufügen:
- Auto-Pagination: NLN7Dw entfernte die Pagination aus jedem Tool. Eine Funktion läuft über alle Seiten und liefert die vollständige Liste.
- Fuzzy-Normalisierung: Die Tool-Parser von J8Gvbi bilden menschliche Formulierungen auf API-Namen ab, sodass „Willingness to travel“ zum Feld
will_travelwird. - Schema-Bereinigung: f1Uixf entfernte ungenutzte Felder aus Tool Schemas und erweiterte die Parameterbeschreibungen. NLN7Dw baute
Req_LogTimeEntryneu, das einzige SDK-Tool, dessen Felder in anderer Reihenfolge kamen, weil diese Reihenfolge das Model verwirrte. - Reasoning-Tools: xoDvsa (7. Prize, 0.515) ergänzte einen einfachen ReAct-Agent um die Tools
plan,thinkundcritic. Das critic-Tool liefert Structured Output mit eigenen Reasoning-Feldern.
Ein Wrapper verbirgt die Paginierung vor dem Model: Der Agent fragt einmal nach einer Liste, und list_all folgt next_offset, bis der Wert -1 ist, der Endwert aus dem offiziellen ERC3-Beispiel. Der Code unten ist eine Skizze für Schritt 1 der Einführungsreihenfolge am Ende dieses Artikels, nicht der Code eines Teams. respond baut die Entity-Links aus IDs, die der Agent abgerufen hat, und lehnt eine ID ab, die er nie gesehen hat. So stammt jeder Link aus Code, und eine erfundene ID scheitert, bevor der Grader sie sieht.
# Stand-in for the benchmark API: 12 projects, 5 per page.
PROJECTS = [{"id": f"proj_{i}", "name": f"Project {i}"} for i in range(12)]

def call_api(endpoint: str, offset: int = 0, limit: int = 5) -> dict:
    page = PROJECTS[offset : offset + limit]
    more = offset + limit < len(PROJECTS)
    return {"items": page, "next_offset": offset + limit if more else -1}

def list_all(endpoint: str) -> list[dict]:
    """Follow next_offset until the API returns the terminal value -1."""
    items, offset = [], 0
    while offset != -1:
        page = call_api(endpoint, offset=offset)
        items.extend(page["items"])
        offset = page["next_offset"]
    return items

def respond(text: str, entity_ids: list[str], fetched: list[dict]) -> dict:
    """Build required links from IDs; refuse IDs the agent never fetched."""
    known = {row["id"] for row in fetched}
    unknown = [i for i in entity_ids if i not in known]
    if unknown:
        raise ValueError(f"unknown entity ids: {unknown}")
    return {"message": text, "links": [{"id": i} for i in entity_ids]}

projects = list_all("/projects/list")
assert len(projects) == 12  # three pages, one list
print(respond("You lead two projects.", ["proj_3", "proj_11"], projects))
Der Agent sieht nie eine Seitengrenze, und proj_11 von der dritten Seite ist ein gültiger Link.
Fehlerbilder und die strukturellen Fixes, die Teams meldeten
Die Berichte erwähnen immer wieder Fehler, bei denen der Agent die API aufruft oder eine Unternehmens-Policy anwendet. Die am besten wiederverwendbaren Fixes verlagerten die Anforderung in Code oder in einen eigenen Validierungsschritt:
| Fehlerbild | Beschreibung | Architektonischer Fix |
|---|---|---|
| Umgehen von Berechtigungen | Eingeschränkte Aktionen ausführen, ohne Nutzerrechte zu prüfen | Security Gate Agent vor der Ausführung; verbindliche Abfolge Identity → Permissions → Execution |
| Fehlende Entity-Links | Textantwort korrekt, aber erforderliche Referenzlinks fehlen | Eingebetteter LinkGeneratorAgent im Response-Tool |
| Pagination-Abbruch | Nur die erste Seite der Listenergebnisse wird verarbeitet | Auto-Pagination-Wrappers für alle List-Endpoints |
| Tool-Calling-Schleifen | Wiederholte Aufrufe mit kleinen Abweichungen | Turn-Limits; klarere Tool Schemas; Model-Wahl am tatsächlichen Workflow getestet |
| Context-Überladung | Context mit irrelevanten Wiki-Abschnitten füllen | Rule Distillation; dynamische Context-Filterung |
Zwei Berichte ergänzen die Zeile zu den Schleifen. f1Uixf sah Tool-Calling-Schleifen mit GPT-5, aber nicht mit dem kleineren Qwen3-Model. NLN7Dw setzte sein Turn-Limit zu niedrig an, und 5 von 103 Tasks wurden nicht fertig. Ein Turn-Limit braucht also Spielraum.
Eine praktische Einführungsreihenfolge
ERC3 ist ein einzelnes simuliertes Unternehmen, keine allgemeine Ablationsstudie für Agents. Nutzen Sie es als Quelle für Design-Hypothesen und testen Sie diese dann an Ihren eigenen Traces. Eine sinnvolle Einführungsreihenfolge ist:
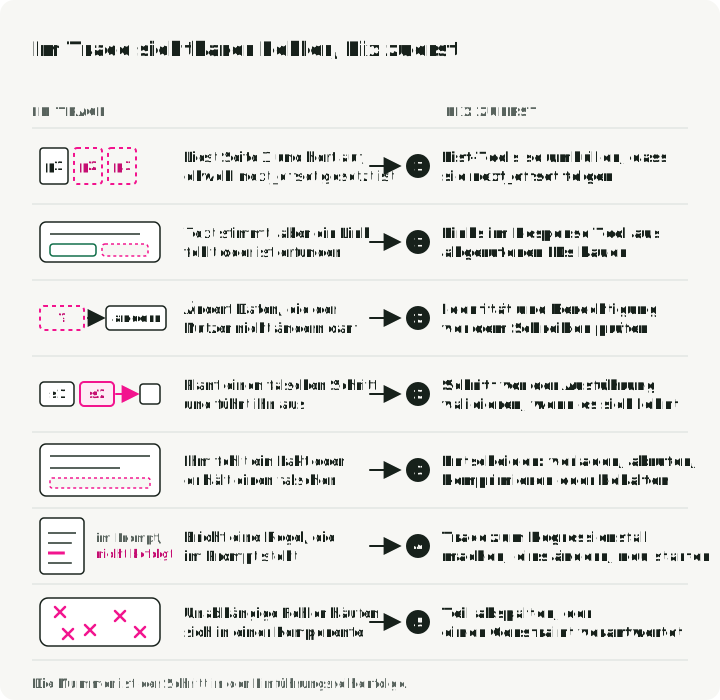
- Zuerst die API-Korrektheit deterministisch machen. Paginieren Sie List-Endpoints automatisch, normalisieren Sie unscharfe Felder, validieren Sie Schemas und erzeugen Sie die erforderlichen Links im Response-Tool.
- Prüfungen dort ergänzen, wo ein Fehler teuer ist. Verifizieren Sie Identität und Berechtigung vor Änderungen; validieren Sie einen Schritt vor der Ausführung nur dann, wenn der zusätzliche Model-Aufruf Fehler abfängt, die seine Kosten wert sind.
- Eine Context-Policy festschreiben. Legen Sie fest, was vorab geladen, abgerufen, komprimiert oder wörtlich behalten wird. Messen Sie die Policy pro Task-Segment, nicht nur anhand der Token-Zahl.
- Fehlgeschlagene Traces in Regressionsfälle verwandeln. Klassifizieren Sie den Fehler, ändern Sie einen Mechanismus und lassen Sie das betroffene Segment erneut laufen. Automatisieren Sie die Prompt-Revision erst, wenn dieser Loop verlässlich ist.
- Zerlegen, wenn die Zuständigkeit klarer wird. Eine eigene Komponente ist gerechtfertigt, wenn sie einen Constraint verantworten, ein anderes Model oder Tool nutzen oder unabhängig getestet werden kann, nicht einfach weil „Multi-Agent“ leistungsfähiger klingt.
Die folgende Abbildung skizziert, wie jeder Fehler in einem Trace aussieht, und verweist auf den Fix, den Sie zuerst ausprobieren. Die Nummern entsprechen den Schritten oben.