Enterprise RAG Challenge 3: уроки публичных решений

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
В Enterprise RAG Challenge 3 (ERC3) агенты выполняли бизнес-задачи через API симулированной компании. Замороженный призовой лидерборд необычно полезен: многие участники опубликовали не только результат, но и архитектуру, набор моделей, стоимость и заметки об ошибках.
Я изучил эти публичные описания, чтобы ответить на более узкий вопрос: какие проектные решения повторялись в сильных работах и какие из них пригодятся за пределами этого бенчмарка?
Статья для инженеров, которые строят агентов, вызывающих корпоративные APIs. Вы увидите пять архитектур из публичных разборов, проблемы, которые каждая решала (права доступа, пагинация, пропущенные ссылки, размер контекста), и порядок, в котором их стоит пробовать в своём агенте.
Что такое Enterprise RAG Challenge?
Enterprise RAG Challenge 3 — это масштабный краудсорсинговый исследовательский проект, который проверяет, как автономные ИИ-агенты справляются со сложными бизнес-задачами. В отличие от статичных бенчмарков, ERC3 работает на Agentic Enterprise Simulation (AGES) — дискретно-событийной симуляции, которая предоставляет реалистичный корпоративный API.
Что проверяет бенчмарк
Через AGES агенты работают внутри вымышленной компании, в которой есть:
- Профили сотрудников с конкретными навыками и отделами
- Проекты с назначенными командами и отношениями с клиентами
- Корпоративная вики с бизнес-правилами и иерархиями прав доступа
- Учёт времени и финансовые операции
Каждая задача запускает изолированную симуляцию. Вики общая, а операционные записи отличаются от задачи к задаче, поэтому агент не может пройти весь набор, запомнив состояние одной компании.
Читайте оценки как снимок
Сейчас ERC3 показывает и замороженный лидерборд соревнования, и публичный бенчмарк, который продолжал принимать запуски после окончания события. Эти страницы отвечают на разные вопросы. Цифры ниже описывают призовой лидерборд на момент закрытия соревнования, а не более поздние лучшие сессии:
| Метрика | Снимок соревнования |
|---|---|
| Призовые решения | 38 |
| Набор задач | 103 бизнес-задачи |
| Максимальный призовой балл | 0.718 |
| Закрытие призового зачёта | 9 декабря 2025, 13:40 CET |
На странице живого бенчмарка могут быть более высокие оценки, потому что она включает поздние запуски. Поэтому для утверждений о том, что победило в соревновании, правильный источник — замороженный лидерборд. Ultimate-лидерборд берёт лучший запуск каждого аккаунта без отсечки соревнования, поэтому его оценки несопоставимы с призовыми.
Типы задач
Задачи охватывают несколько областей навыков:
- Многошаговый ризонинг, например сопоставление навыков сотрудников с назначениями на проекты.
- Проверка прав доступа, например блокировка несанкционированного изменения зарплаты или доступа к данным.
- Неоднозначные запросы, включая многоязычные и перефразированные.
- Строгое соответствие формату ответа, включая обязательные ссылки на сущности в ответах.
Что говорят решения
Публичные разборы не подтверждают однозначный вывод вроде «multi-agent подход лучше одиночного агента». Решение, занявшее четвёртое призовое место, MMzXeM, — это один агент с инструментами, сопоставленными 1:1 с эндпоинтами API, инструментом ask_wiki и системным промптом на 320 токенов. Зато разборы подтверждают четыре более узких наблюдения:
- Команды выделяли отдельный компонент, когда он отвечал за одно требование, которое агенты постоянно проваливали: проверку прав, валидацию шагов, выполнение кода или ссылки на сущности. Они не делили систему на произвольные «роли агентов».
- Валидация сместилась ближе к необратимым действиям. Несколько систем проверяли права до выполнения, проверяли отдельные шаги или защищали финальный ответ.
- Изменениями управляли неудачные трейсы. Победитель превращал неудачные запуски в правки промпта через автоматический цикл; другие команды документировали столь же конкретные исправления инструментов и промптов.
- Политика контекста была архитектурным выбором. Команды пробовали дистилляцию, предзагрузку, retrieval и сжатие истории. Их собственные отчёты расходятся в том, помогло ли сжатие, так что универсального рецепта нет.
Пять показательных подходов
Это не пять лучших по рангу. Я выбрал их, потому что их публичные описания показывают пять разных способов построить систему: автоматическая правка промпта, стадии со специалистами, валидация каждого шага, гарды на ответе и изоляция plan-execute.
| Команда | Контекст лидерборда | Опубликованный балл |
|---|---|---|
| VZS9FL | Призовой, 1-е | 0.718 |
| Lcnxuy | Призовой, 8-е | 0.505 |
| NLN7Dw | Призовой, 2-е | 0.621 |
| J8Gvbi | Призовой, 16-е | 0.437 |
| 5qsp7i (key_concept_parallel) | Ultimate, 3-е | 0.670 |
1. Эволюционный промпт-инжиниринг (команда VZS9FL / @aostrikov)
Самый результативный подход автоматизировал промпт-инжиниринг через цикл самоулучшения.
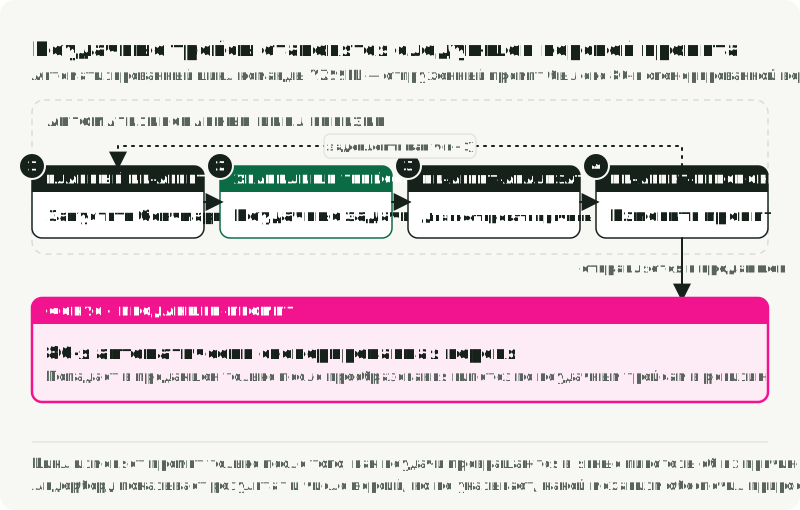
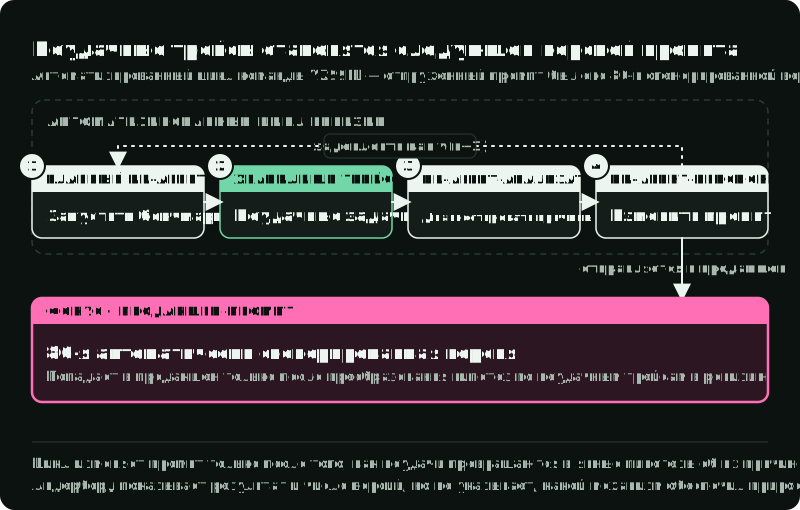
Вместо ручной настройки промпта для прода команда построила цикл из трёх агентов, который превращал неудачные трейсы в кандидаты на новую версию.
Пайплайн из трёх агентов:
| Агент | Роль |
|---|---|
| Main Agent | Запускает бенчмарк, логирует все действия и ошибки |
| Analyzer Agent | Разбирает задачи с ошибками, формулирует гипотезы о первопричинах |
| Versioner Agent | Генерирует новую версию промпта с учётом выводов |
Промпт в проде был 80-й автоматически сгенерированной версией. Команда описывает цикл так: он анализирует задачи с ошибками, предлагает причины и решает, какие предложения учесть. Лидерборд устанавливает итоговый балл и число итераций. Он не показывает, какая часть прироста пришлась на автоматизацию, а какая — на модели, инструменты и накопленную обратную связь от бенчмарка.
Стек: claude-opus-4.5 с Anthropic Python SDK и нативный tool use.
2. Multi-agent последовательный пайплайн (команда Lcnxuy / @andrey_aiweapps)
Это решение построило последовательный воркфлоу, в котором специализированные компоненты отвечали за проверки безопасности, извлечение контекста, выполнение и оформление ссылок на сущности.
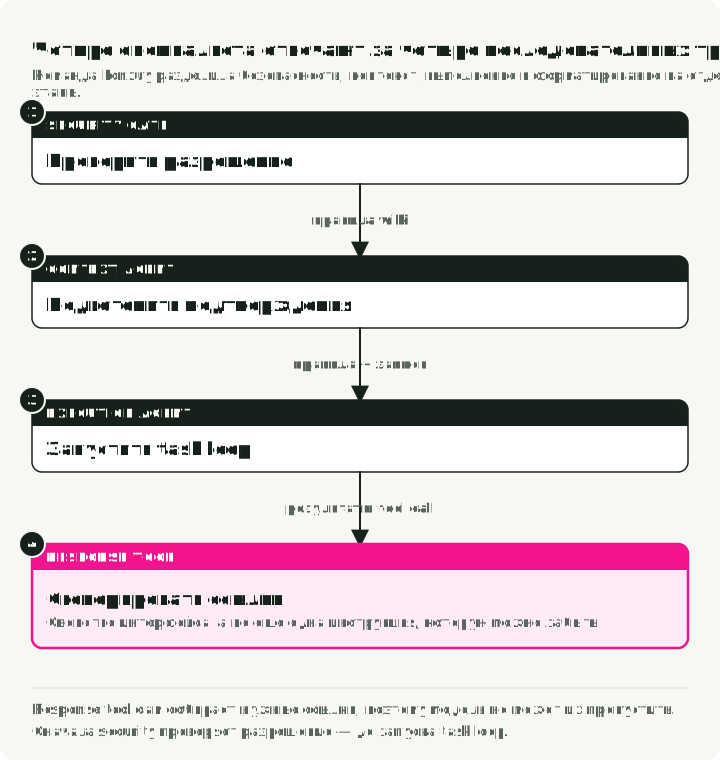
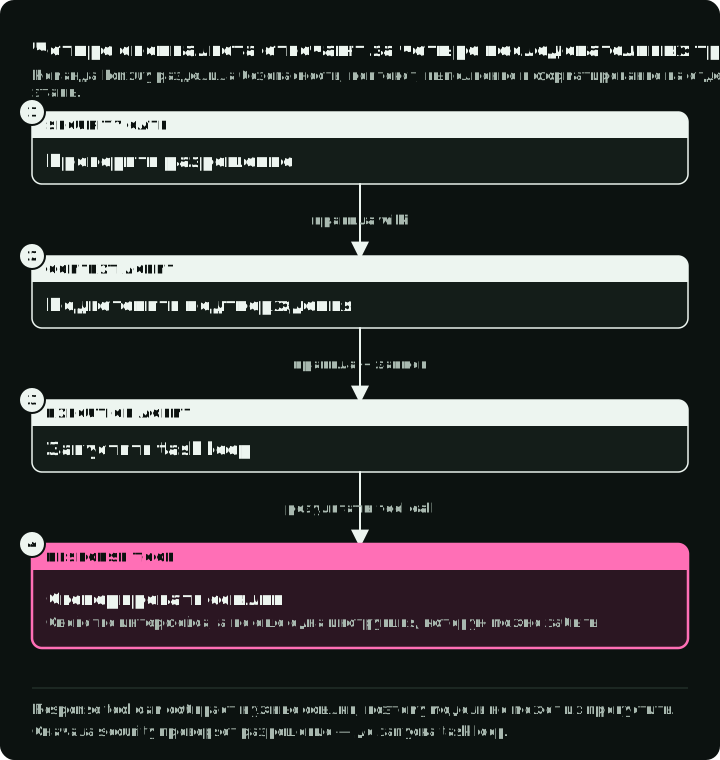
Задокументированные компоненты:
- Security Gate Agent: проверка перед выполнением, которая валидирует права по правилам вики до запуска основного цикла.
- Context Extraction Agent: вытаскивает ключевые правила из системных промптов длиннее 500 строк и предзагружает данные о пользователе, проекте и клиенте.
- Execution Agent: планирование в стиле ReAct с 5 внутренними фазами (Identity → Threat Detection → Info Gathering → Access Validation → Execution).
- LinkGeneratorAgent: встроен в инструмент ответа, разбирает контекст, чтобы добавить обязательные ссылки на сущности.
В разборе команды сказано, что LinkGeneratorAgent нужен был для предотвращения ошибок с пропущенными ссылками: ответов с правильным текстом, но без обязательных ссылок на сущности. Это самая переносимая часть. Если встроить его в инструмент ответа, требование бенчмарка (обязательные ссылки на сущности) становится свойством интерфейса, а не ещё одной инструкцией, которую модель-исполнитель может забыть.
Стек: фреймворки atomic-agents и instructor с gpt-5.1-codex-max, gpt-4.1 и claude-sonnet-4.5.
3. Schema-guided reasoning с валидацией шагов (команда NLN7Dw / Ilia Ris)
Schema-guided reasoning (SGR) заставляет модель на каждом шаге заполнять фиксированную схему вывода, например ризонинг, план и следующий tool call, чтобы программа могла прочитать и проверить каждое поле. Статья про SGR в этом блоге показывает, как навязать такую схему с помощью vLLM. Эта команда совместила SGR с быстрым инференсом и валидатором на каждом предложенном шаге. Такая схема удешевляет исправления: отклонить ошибочный шаг до того, как он станет tool call, и попросить основной поток переделать его с учётом комментариев валидатора.
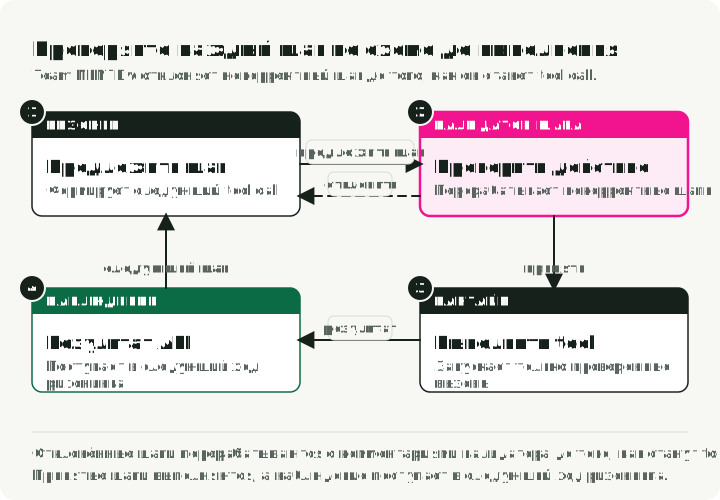
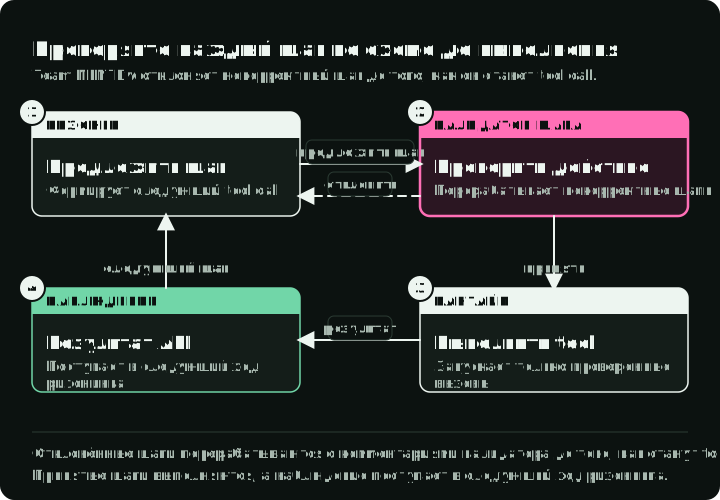
Ключевые компоненты:
| Компонент | Функция |
|---|---|
| StepValidator | Проверяет каждый предложенный шаг. Если что-то не так, возвращает его на доработку с комментариями. |
| Управление контекстом | Полный план с предыдущего хода плюс сжатая история для более старых ходов |
| Динамическое обогащение | Автоматически подтягивает профиль пользователя, проекты, клиентов; LLM фильтрует и подставляет только данные, релевантные задаче |
| Обёртки автоматической пагинации | Все list-эндпоинты автоматически возвращают полный результат |
Команда сообщила, что запускала gpt-oss-120b на Cerebras со скоростью до примерно 3000 токенов в секунду. Команда совместила валидацию с высоким throughput инференса, что, возможно, снизило её цену в латентности. Публичный результат не позволяет выделить этот эффект.
Стек: модифицированный агент NextStep — пример SGR-агента, опубликованный для ERC3.
4. Система enricher и guard (команда J8Gvbi / @mishka)
Это решение добавило к базе на SGR неблокирующие подсказки и многоуровневую систему гардов. По мере поступления ответов API enricher’ы проверяли их и добавляли в последующий контекст операционные указания. Гарды проверяли ответ агента перед отправкой.
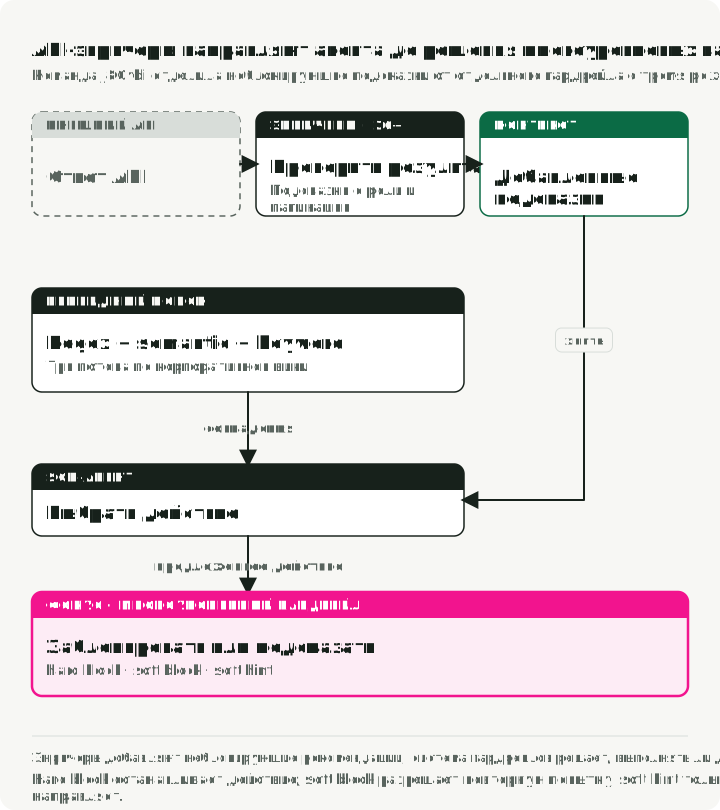
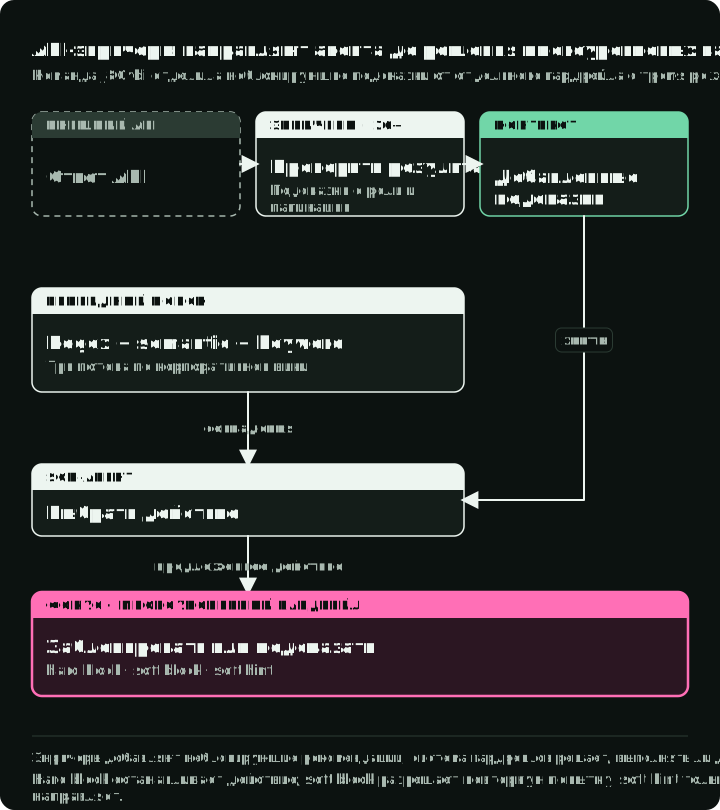
Более 20 компонентов обогащения проверяли ответы API и добавляли контекстные подсказки:
RoleEnricher: "You are LEAD of this project, proceed with update."
PaginationHintEnricher: "next_offset=5 means MORE results! MUST paginate."
Система гардов с тремя режимами:
| Режим | Поведение |
|---|---|
| Hard block | Ответ, который невозможен по данным API, например называет сотрудника вне команды проекта, отклоняется |
| Soft block | Рискованный ответ один раз отклоняется с предупреждением и принимается, если агент отправляет его повторно после этого предупреждения |
| Soft hint | Подсказка добавляется без блокировки |
Гибридная RAG-вики: команда искала по локальной копии корпоративной вики тремя способами: regex для структурированных шаблонов вроде salary|privacy, эмбеддинги sentence-transformer для семантических совпадений и пересечение токенов как запасной поиск по ключевым словам. Моё объяснение, зачем три: regex находит точные имена полей и термины, а эмбеддинги находят правила, сформулированные иначе, чем вопрос.
Стек: qwen/qwen3-235b-a22b-2507 на SGR-фреймворке LangChain.
5. Plan-execute REPL (команда 5qsp7i / key_concept_parallel)
Эта архитектура разделяла планирование и написание кода по разным вызовам модели. Сгенерированный Python выполняется в REPL (read-eval-print loop): сессии Python, которая сохраняет переменные между шагами. Решение попало в более широкий Ultimate-лидерборд, а не в замороженную призовую пятёрку. Его публичное описание всё равно полезно, потому что показывает другую форму декомпозиции: изоляцию по фазе выполнения, а не по бизнес-роли.
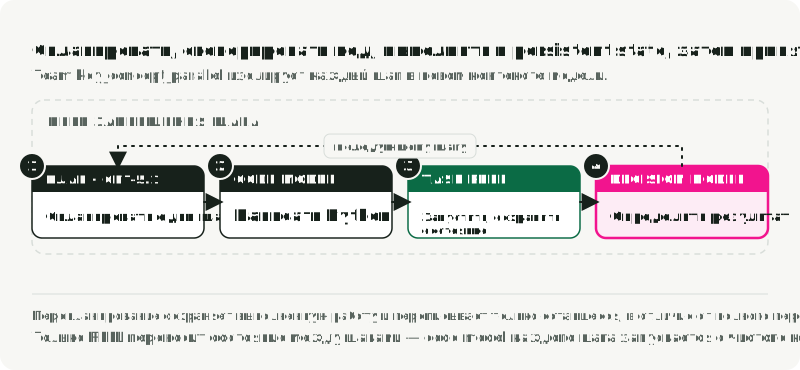
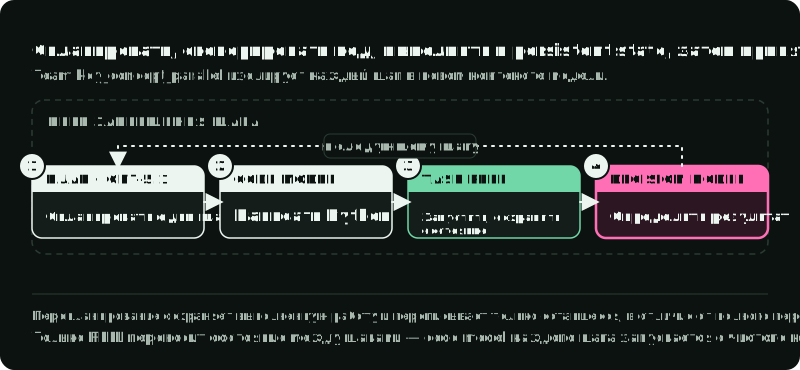
Разные модели занимались разными задачами: одна планировала, другая писала Python, а отдельная модель решений выбирала, что делать после каждого шага.
Мультимодельная конфигурация:
| Стадия | Модель |
|---|---|
| Планирование | openai/gpt-5.1 |
| Генерация кода | deepseek/deepseek-v3.2 |
| Решение после шага | openai/gpt-4.1 |
| Финальный ответ | openai/gpt-4.1 |
REPL завершения шага:
- Планировщик создаёт шаг высокого уровня.
- Модель генерации кода работает в свежем контексте модели и пишет для этого шага скрипт на Python.
- Скрипт выполняется в REPL, привязанном к задаче, переменные которого сохраняются между шагами.
- Модель решений смотрит на результат и выбирает один из четырёх исходов: продолжить со следующим шагом, завершить, потому что задача выполнена, прервать, потому что она провалена, или перепланировать.
Путь перепланирования — это идея, которую можно переиспользовать. Когда результат шага показывает, что план больше не подходит, модель решений может сохранить выполненную работу и переписать только оставшиеся шаги плана. На диаграмме выполнение и провал имеют один общий выход к финальному ответу.
Паттерны, которые повторялись в решениях
Реализации различались, но несколько инженерных задач повторялись в публичных описаниях снова и снова.
Управление контекстом было явным
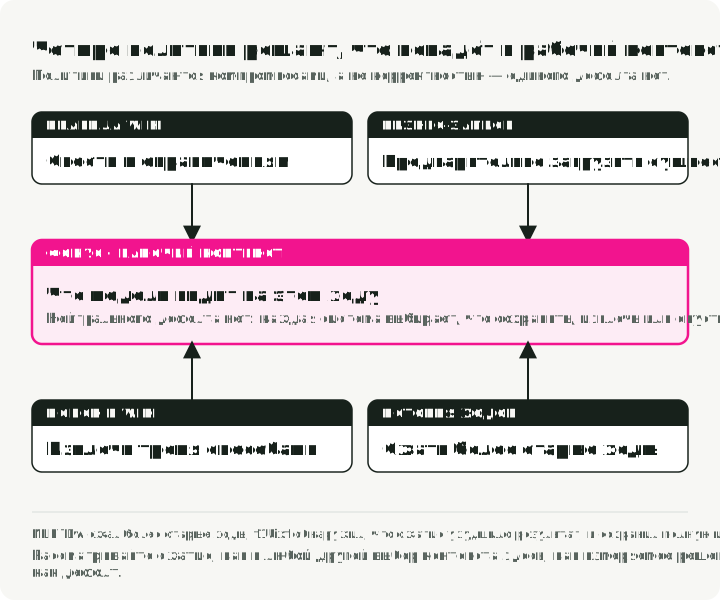
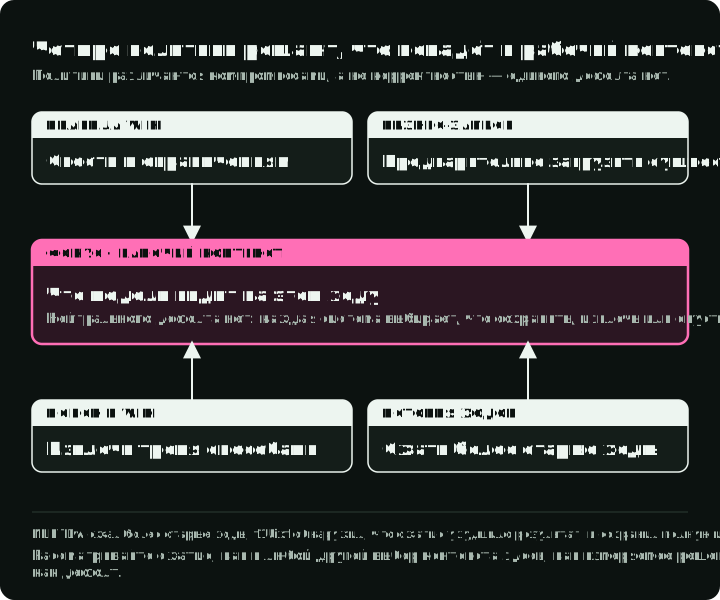
Ни одна команда не могла отдать модели все правила, записи и предыдущие шаги, не сделав выбор политики. Системы различались тем, где они фильтровали информацию: до запуска, при retrieval или в истории. Диаграмма делит контекст модели на четыре части и показывает, какая политика управляет каждой частью, когда она срабатывает и какие команды её использовали.
| Стратегия | Подход | Лучше всего для |
|---|---|---|
| Выделение правил | Предобработка правил вики в компактные инструкции с сохранением ограничений | Компактные промпты, быстрый старт |
| Предварительная загрузка данных | Загрузка данных о пользователе, проекте и клиенте до выполнения | Минимум tool calls |
| Гибридный RAG | Потоки поиска: regex + семантический + по ключевым словам | Сложные задачи retrieval |
| Сжатие истории | Недавние ходы хранятся полностью, старая история сжимается | Длинные диалоги |
Компромисс: NLN7Dw сжимала старые ходы, а f1Uixf сообщила, что сжатие истории ухудшило её эксперименты, и оставила полный диалог. Относитесь к сжатию как к измеряемому выбору, а не как к значению по умолчанию. Сильные решения различались и размером промпта. Kc7F2N (3-е призовое место) свела собственные инструкции к минимуму, опиралась на дистиллированные правила вики и строила инструменты поиска на эмбеддингах. MMzXeM (4-е призовое место) удерживала основной промпт в 320 токенов и спрятала всю вики за инструментом
ask_wiki, который полагался на кэширование контекста, чтобы оставаться дешёвым.
Проверки до, во время и после основного цикла
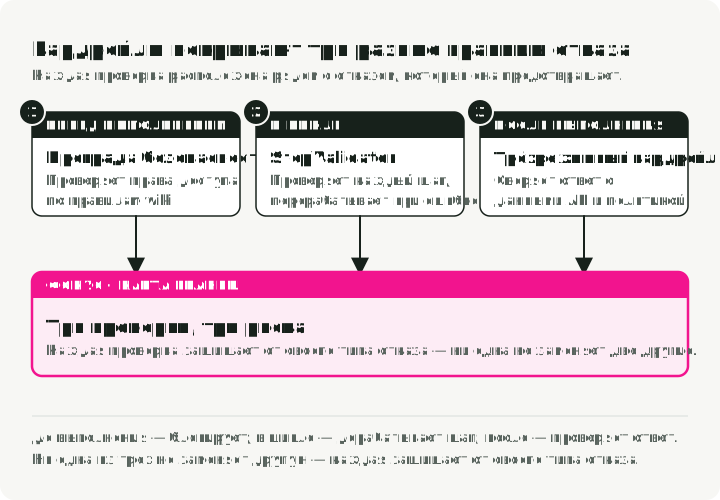
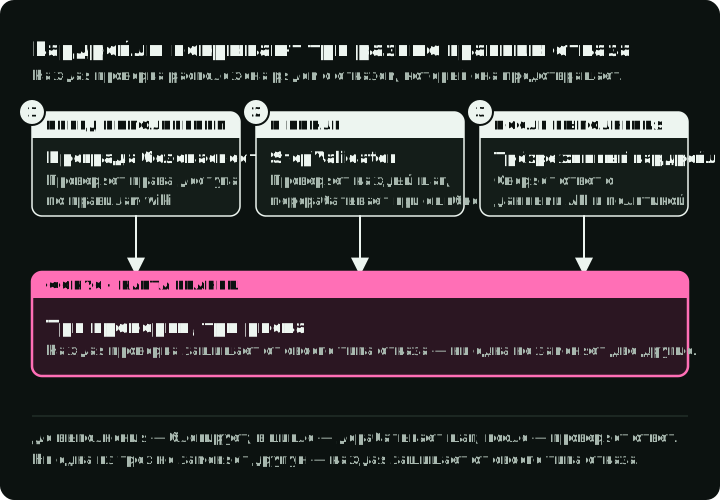
Несколько команд разместили проверки до основного цикла, внутри него или после него. На разных этапах этим проверкам нужны разные данные. Общая реализация может выполнять их, если на каждом этапе получает нужные входные данные. Критик, вызываемый только для финального ответа, не может предотвратить более ранний неавторизованный tool call. Диаграмма размещает каждую проверку на временной шкале от задачи до оценщика и показывает, что она видит и какую ошибку предотвращает.
| Тип гардрейла | Когда | Пример |
|---|---|---|
| Проверки до выполнения | До начала основного цикла | Security Gate Agent валидирует права по правилам вики |
| Валидаторы внутри цикла | Во время ризонинга | StepValidator проверяет каждое предложенное действие и запускает доработку, если оно ошибочно |
| Проверки после выполнения | Перед финальной отправкой | Трёхрежимная система гардов сверяет ответ агента с данными API и политикой |
Обёртки над инструментами
Несколько команд изменили слой инструментов, который видит модель, вместо того чтобы добавлять инструкции про сырой API:
- Автопагинация: NLN7Dw убрала пагинацию из каждого инструмента. Одна функция проходит по всем страницам и возвращает полный список.
- Нечёткая нормализация: парсеры инструментов J8Gvbi сопоставляют человеческие формулировки с именами в API, так что «Willingness to travel» становится полем
will_travel. - Очистка схем: f1Uixf убрала неиспользуемые поля из схем инструментов и расширила описания параметров. NLN7Dw пересобрала
Req_LogTimeEntry— единственный инструмент SDK, у которого поля шли в другом порядке, потому что этот порядок сбивал модель. - Инструменты ризонинга: xoDvsa (7-е призовое место, 0.515) добавила инструменты
plan,thinkиcriticк обычному ReAct-агенту. Инструмент critic возвращает structured output с отдельными полями для ризонинга.
Обёртка скрывает пагинацию от модели: агент запрашивает список один раз, а list_all следует за next_offset, пока значение не станет -1 — признаком конца из официального примера ERC3. Код ниже иллюстрирует шаг 1 порядка внедрения в конце статьи; это не код какой-либо команды. respond строит ссылки на сущности из ID, которые агент получил, и отклоняет ID, которого агент никогда не видел. Поэтому каждая ссылка создаётся кодом, а выдуманный ID отклоняется ещё до того, как его увидит оценщик.
# Stand-in for the benchmark API: 12 projects, 5 per page.
PROJECTS = [{"id": f"proj_{i}", "name": f"Project {i}"} for i in range(12)]

def call_api(endpoint: str, offset: int = 0, limit: int = 5) -> dict:
    page = PROJECTS[offset : offset + limit]
    more = offset + limit < len(PROJECTS)
    return {"items": page, "next_offset": offset + limit if more else -1}

def list_all(endpoint: str) -> list[dict]:
    """Follow next_offset until the API returns the terminal value -1."""
    items, offset = [], 0
    while offset != -1:
        page = call_api(endpoint, offset=offset)
        items.extend(page["items"])
        offset = page["next_offset"]
    return items

def respond(text: str, entity_ids: list[str], fetched: list[dict]) -> dict:
    """Build required links from IDs; refuse IDs the agent never fetched."""
    known = {row["id"] for row in fetched}
    unknown = [i for i in entity_ids if i not in known]
    if unknown:
        raise ValueError(f"unknown entity ids: {unknown}")
    return {"message": text, "links": [{"id": i} for i in entity_ids]}

projects = list_all("/projects/list")
assert len(projects) == 12  # three pages, one list
print(respond("You lead two projects.", ["proj_3", "proj_11"], projects))
Агент никогда не видит границу страниц, а proj_11 с третьей страницы — корректная ссылка.
Типичные сбои и структурные исправления, о которых сообщали команды
В разборах постоянно упоминаются сбои, когда агент вызывает API или применяет политику компании. Самые переиспользуемые исправления переносили требование в код или в отдельный шаг валидации:
| Тип сбоя | Описание | Архитектурное исправление |
|---|---|---|
| Обход прав доступа | Выполнение запрещённых действий без проверки прав пользователя | Pre-execution Security Gate Agent; обязательная последовательность Identity → Permissions → Execution |
| Отсутствующие ссылки на сущности | Правильный текстовый ответ, но без обязательных ссылок | Встроенный LinkGeneratorAgent в инструменте ответа |
| Неполная пагинация | Обработка только первой страницы списка | Обёртки с автопагинацией для всех list-эндпоинтов |
| Повторяющиеся tool calls | Повторные вызовы с небольшими вариациями | Лимиты ходов; более понятные схемы инструментов; выбор модели, проверенный на реальном воркфлоу |
| Избыток контекста | Заполнение контекста нерелевантными разделами вики | Дистилляция правил; динамическая фильтрация контекста |
Два отчёта добавляют деталей к строке про циклы. f1Uixf наблюдала циклы tool calls с GPT-5, но не с меньшей моделью Qwen3. NLN7Dw поставила лимит ходов слишком низким, и 5 из 103 задач не завершились, так что лимиту ходов нужен запас.
Практический порядок внедрения
ERC3 — это одна симулированная компания, а не общее исследование абляций агентов. Используйте его как источник гипотез о дизайне, а затем проверяйте эти гипотезы на собственных трейсах. Разумный порядок внедрения такой:
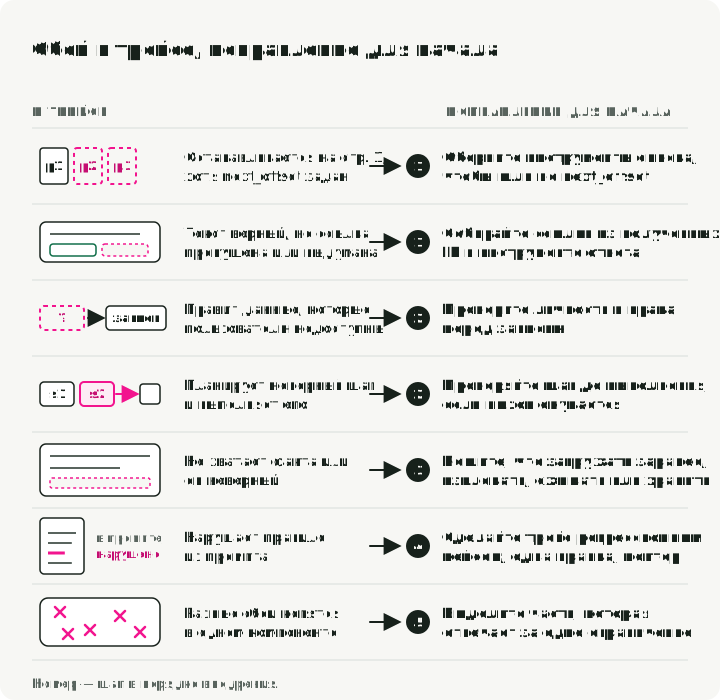
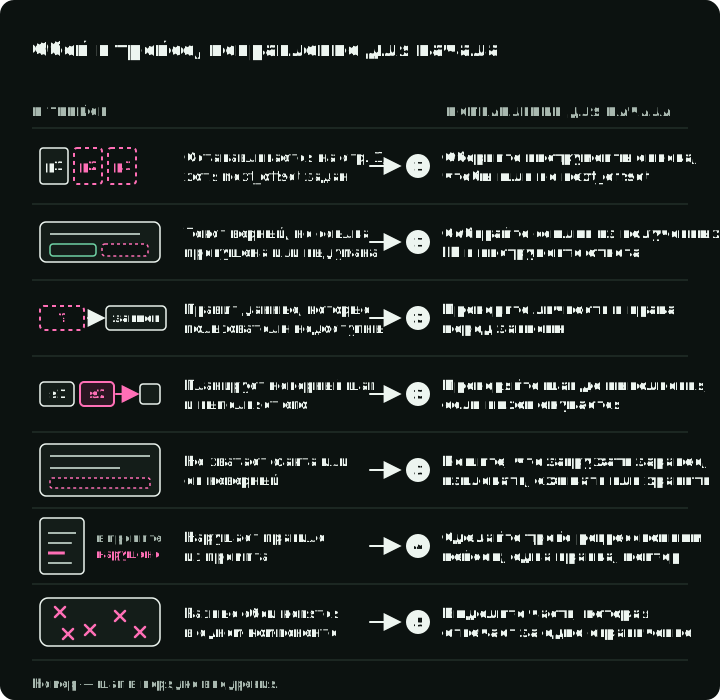
- Сначала сделайте корректность API детерминированной. Автопагинируйте list-эндпоинты, нормализуйте нечёткие поля, валидируйте схемы и генерируйте обязательные ссылки внутри инструмента ответа.
- Добавьте проверки там, где ошибка дорого стоит. Проверяйте личность и права перед изменением; валидируйте шаг до выполнения только тогда, когда дополнительный вызов модели ловит сбои, стоящие своей цены.
- Запишите политику контекста. Решите, что предзагружается, извлекается, сжимается или хранится дословно. Измеряйте политику по срезам задач, а не только по числу токенов.
- Превращайте неудачные трейсы в регрессионные кейсы. Классифицируйте сбой, меняйте один механизм и перезапускайте затронутый срез. Автоматизируйте правку промпта только после того, как этот цикл станет надёжным.
- Декомпозируйте, когда зоны ответственности становятся яснее. Отдельный компонент оправдан, если он может отвечать за ограничение, использовать другую модель или инструмент либо тестироваться независимо, а не просто потому, что «multi-agent» звучит солиднее.
Схема ниже показывает, как выглядит каждый сбой в трейсе, и указывает, какое исправление пробовать первым. Номера совпадают с шагами выше.