Enterprise RAG Challenge 3: lições das submissões públicas

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
O Enterprise RAG Challenge 3 (ERC3) pediu a agentes que concluíssem tarefas empresariais através da API de uma empresa simulada. A tabela de classificação congelada dos prémios é invulgarmente útil, porque muitos participantes publicaram mais do que uma pontuação: arquitetura, combinação de modelos, custo e notas sobre falhas.
Analisei essas descrições públicas para responder a uma pergunta mais restrita: que escolhas de design se repetiram nas submissões fortes, e quais delas são úteis fora deste benchmark?
Este artigo destina-se a engenheiros que constroem agentes que chamam APIs empresariais. Vai ver cinco designs das descrições públicas, os problemas que cada um resolveu (permissões, paginação, links em falta, tamanho do contexto) e uma ordem pela qual os experimentar no seu próprio agente.
O que é o Enterprise RAG Challenge?
O Enterprise RAG Challenge 3 é um projeto de investigação de grande escala, feito em crowdsourcing, que testa como agentes de AI autónomos lidam com tarefas empresariais complexas. Ao contrário dos benchmarks estáticos, o ERC3 corre sobre a Agentic Enterprise Simulation (AGES), uma simulação de eventos discretos que expõe uma API empresarial realista.
O que o benchmark testa
Através da AGES, os agentes trabalham dentro de uma empresa fictícia que tem:
- Perfis de colaboradores com competências e departamentos específicos
- Projetos com atribuições de equipa e relações com clientes
- Wiki corporativa com regras de negócio e hierarquias de permissões
- Registo de tempo e operações financeiras
Cada tarefa inicia uma simulação isolada. A wiki da empresa é partilhada, mas os registos operacionais variam consoante a tarefa, pelo que um agente não consegue resolver o conjunto de tarefas decorando o estado de uma única empresa.
Leia as pontuações como um instantâneo
O ERC3 expõe agora tanto uma tabela de classificação da competição, congelada, como um benchmark público que continuou a receber execuções depois do evento. Essas páginas respondem a perguntas diferentes. Os valores abaixo descrevem a tabela de classificação dos prémios no fecho da competição, não as melhores sessões posteriores:
| Métrica | Instantâneo da competição |
|---|---|
| Submissões a prémio | 38 |
| Conjunto de tarefas | 103 tarefas empresariais |
| Pontuação mais alta | 0,718 |
| Fecho dos prémios | 9 de dezembro de 2025, 13:40 CET |
A página do benchmark ativo pode mostrar pontuações mais altas, porque inclui execuções posteriores. Por isso, a tabela congelada é a fonte certa para afirmações sobre o que ganhou a competição. A tabela Ultimate usa a melhor execução de cada conta sem o fecho da competição, pelo que as suas pontuações não são comparáveis com as dos prémios.
Tipos de tarefas
As tarefas abrangem várias áreas de competência:
- Raciocínio multi-hop, como associar competências de colaboradores a atribuições de projetos.
- Validação de permissões, como bloquear alterações salariais ou acessos a dados não autorizados.
- Consultas ambíguas, incluindo pedidos multilingues e parafraseados.
- Cumprimento estrito do formato de saída, incluindo links obrigatórios para entidades nas respostas.
O que as submissões sugerem
As descrições públicas não sustentam um veredicto simples como “multi-agent vence agente único”. A submissão em quarto lugar nos prémios, a MMzXeM, era um único agente com ferramentas mapeadas 1:1 para os endpoints da API, uma ferramenta ask_wiki e um system prompt de 320 tokens. As descrições sustentam, sim, quatro observações mais restritas:
- As equipas separaram um componente quando ele era responsável por um requisito que os agentes falhavam repetidamente: uma verificação de permissões, a validação de passos, a execução de código ou os links para entidades. Não separaram por “papéis de agente” arbitrários.
- A validação aproximou-se das ações irreversíveis. Vários sistemas verificaram permissões antes da execução, reviram passos individuais ou protegeram a resposta final.
- Os traces falhados orientaram as alterações. O vencedor dos prémios converteu execuções falhadas em revisões do prompt através de um ciclo automático; outras equipas documentaram correções igualmente concretas de ferramentas e prompts.
- A política de contexto foi uma escolha de arquitetura. As equipas experimentaram destilação, pré-carregamento, retrieval e compressão do histórico. Os relatórios delas discordam sobre se a compressão ajudou, pelo que não há uma receita universal.
Cinco abordagens informativas
Estas não são as cinco primeiras por classificação. Escolhi-as porque as descrições públicas mostram cinco formas distintas de construir o sistema: revisão automática de prompts, fases especializadas, validação por passo, guards de resposta e isolamento plan-execute.
| Equipa | Contexto da classificação | Pontuação publicada |
|---|---|---|
| VZS9FL | Prémios, 1.º | 0,718 |
| Lcnxuy | Prémios, 8.º | 0,505 |
| NLN7Dw | Prémios, 2.º | 0,621 |
| J8Gvbi | Prémios, 16.º | 0,437 |
| 5qsp7i (key_concept_parallel) | Ultimate, 3.º | 0,670 |
1. Prompt engineering evolutivo (equipa VZS9FL / @aostrikov)
A abordagem com a pontuação mais alta automatizou o prompt engineering através de um ciclo de auto-melhoria.
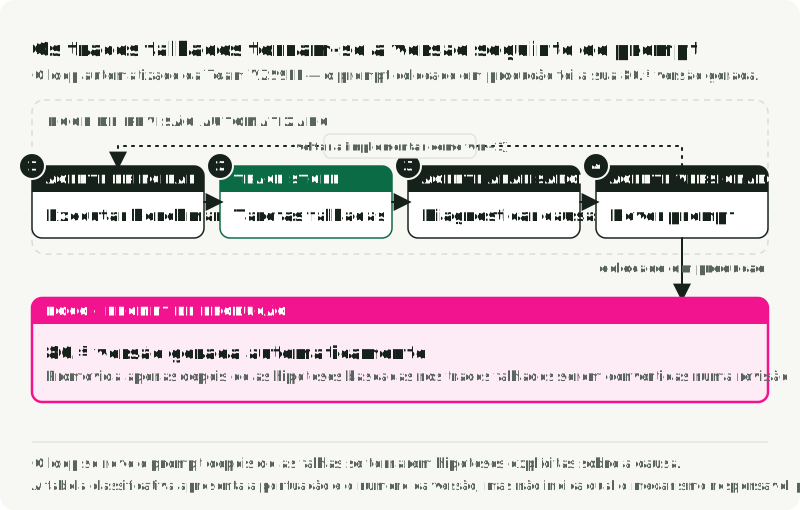
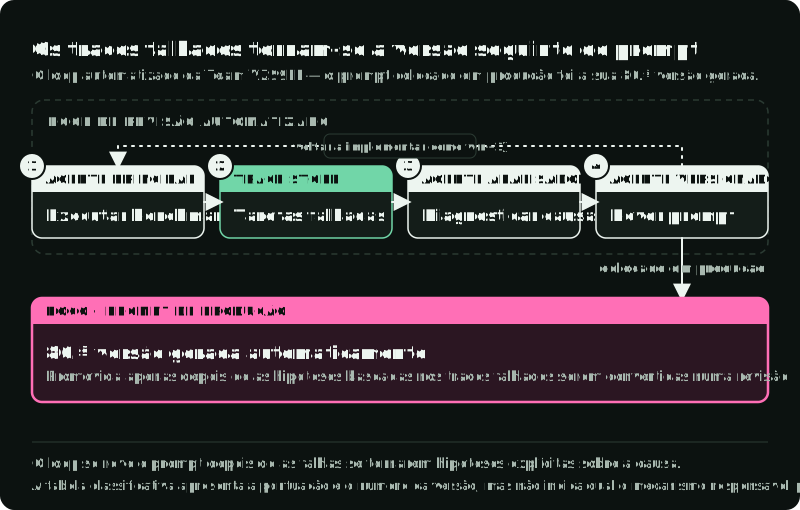
Em vez de afinar à mão o prompt de produção, a equipa construiu um ciclo de três agentes que transformava traces falhados em revisões candidatas.
Pipeline de três agentes:
| Agente | Função |
|---|---|
| Main Agent | Executa o benchmark, regista todas as ações e falhas |
| Analyzer Agent | Revê as tarefas falhadas, formula hipóteses sobre as causas de fundo |
| Versioner Agent | Gera uma nova versão do prompt que incorpora o que foi aprendido |
O prompt de produção foi a 80.ª versão gerada automaticamente. A equipa descreve o ciclo como a análise de tarefas falhadas, a proposta de causas e a decisão sobre quais sugestões incorporar. A tabela de classificação estabelece a pontuação final e o número de iterações. Não isola quanto do ganho veio da automatização e não dos modelos, das ferramentas ou do feedback acumulado do benchmark.
Stack: claude-opus-4.5 com o Anthropic Python SDK e tool use nativo.
2. Pipeline sequencial multi-agent (equipa Lcnxuy / @andrey_aiweapps)
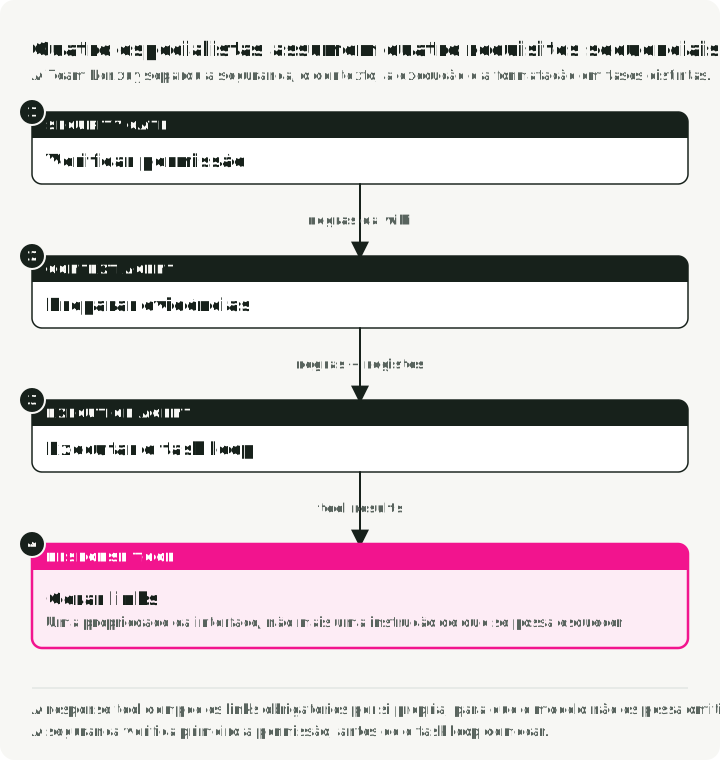
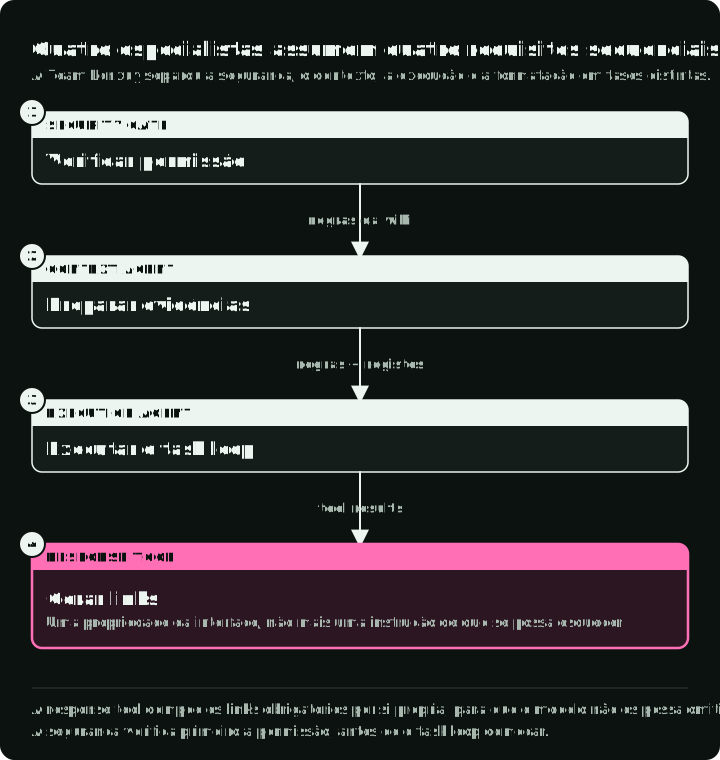
Esta submissão construiu um fluxo sequencial em que componentes especializados tratavam das verificações de segurança, da extração de contexto, da execução e da formatação dos links para entidades.
Os componentes documentados:
- Security Gate Agent: verificação prévia à execução, que valida as permissões face às regras da wiki antes de o ciclo principal começar.
- Context Extraction Agent: extrai as regras críticas de system prompts com mais de 500 linhas e pré-carrega dados de utilizadores, projetos e clientes.
- Execution Agent: planeamento ao estilo ReAct, com 5 fases internas (Identidade → Deteção de ameaças → Recolha de informação → Validação de acesso → Execução).
- LinkGeneratorAgent: embutido na ferramenta de resposta, analisa o contexto para incluir os links obrigatórios para entidades.
O relatório da equipa diz que o LinkGeneratorAgent existia para evitar falhas por links em falta: respostas com o texto certo, mas sem os links obrigatórios para entidades. É a parte mais transferível. Colocá-lo dentro da ferramenta de resposta faz de um requisito do benchmark (links obrigatórios para entidades) uma propriedade da interface, em vez de mais uma instrução que o modelo de execução pode esquecer.
Stack: os frameworks atomic-agents e instructor com gpt-5.1-codex-max, gpt-4.1 e claude-sonnet-4.5.
3. Schema-guided reasoning com validação de passos (equipa NLN7Dw / Ilia Ris)
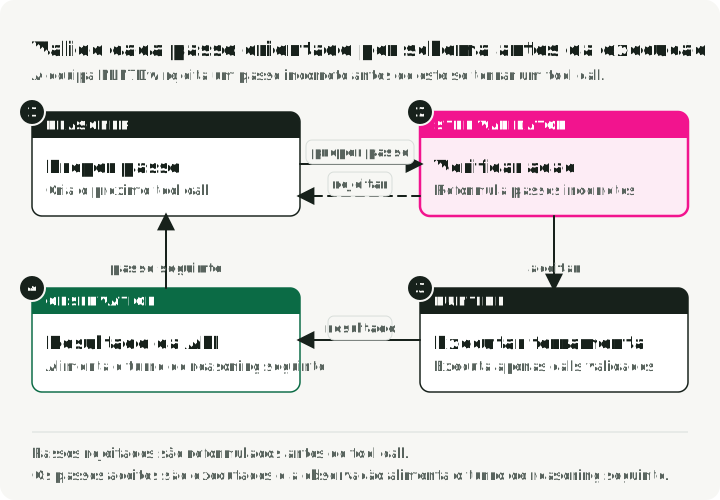
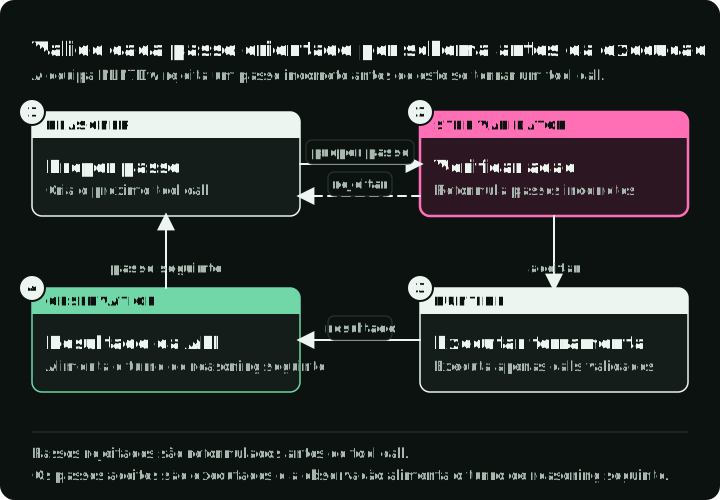
O schema-guided reasoning (SGR) obriga o modelo a preencher, em cada passo, um schema de saída fixo, por exemplo o seu raciocínio, um plano e a tool call seguinte, para que o programa possa ler e verificar cada campo. O artigo sobre SGR deste blogue mostra como impor esse schema com vLLM. Esta equipa combinou o SGR com inferência rápida e um validador em cada passo proposto. O design torna a revisão barata: rejeitar um passo defeituoso antes de ele se tornar uma tool call e pedir ao fluxo principal que o refaça com os comentários do validador.
Componentes principais:
| Componente | Função |
|---|---|
| StepValidator | Inspeciona cada passo proposto. Se algo estiver errado, devolve-o para ser refeito, com comentários. |
| Gestão de contexto | Plano completo do turno anterior, mais histórico comprimido para os turnos mais antigos |
| Enriquecimento dinâmico | Obtém automaticamente perfil de utilizador, projetos e clientes; o LLM filtra para injetar só dados da tarefa |
| Wrappers de paginação automática | Todos os endpoints de listagem devolvem automaticamente resultados completos |
A equipa reportou ter corrido o gpt-oss-120b na Cerebras a até cerca de 3000 tokens por segundo. A equipa combinou a validação com inferência de alto débito, o que pode ter reduzido o custo de latência. O resultado público não isola esse efeito.
Stack: um agente NextStep modificado, o agente de exemplo SGR publicado para o ERC3.
4. Sistema de enrichers e guards (equipa J8Gvbi / @mishka)
Esta submissão acrescentou a uma base SGR dicas não bloqueantes e um sistema de guards por níveis. À medida que as respostas da API chegavam, os enrichers inspecionavam-nas e acrescentavam orientações operacionais ao contexto seguinte. Os guards verificavam a resposta do agente antes de ser submetida.
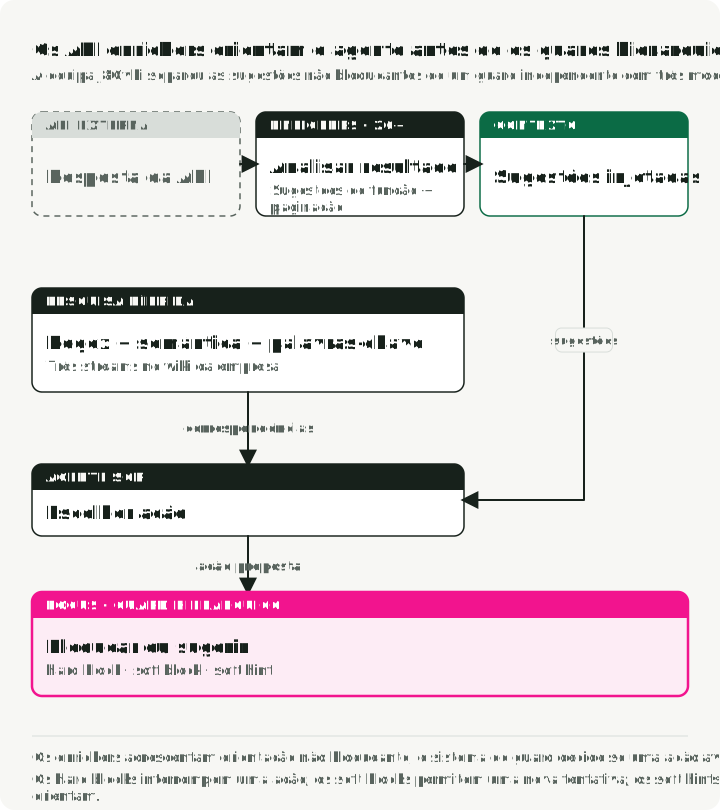
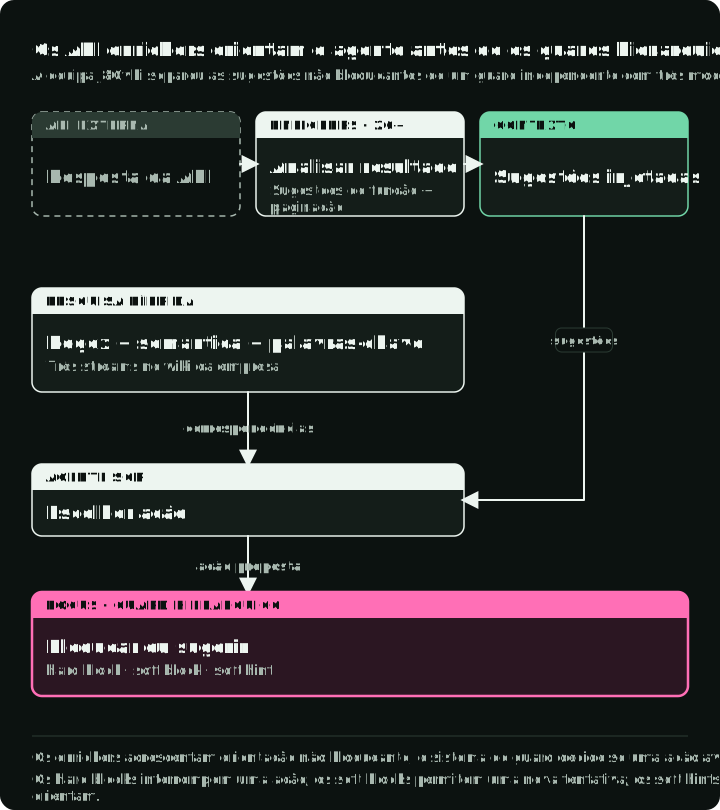
Mais de 20 enrichers inspecionavam as respostas da API e injetavam dicas contextuais:
RoleEnricher: "You are LEAD of this project, proceed with update."
PaginationHintEnricher: "next_offset=5 means MORE results! MUST paginate."
Sistema de guards com três modos:
| Modo | Comportamento |
|---|---|
| Hard block | Uma resposta que os dados da API mostram ser impossível, como uma que nomeia um colaborador fora da equipa do projeto, é rejeitada |
| Soft block | Uma resposta de risco é rejeitada uma vez com um aviso e aceite se o agente a submeter de novo depois desse aviso |
| Soft hint | A orientação é acrescentada sem bloquear |
Wiki com RAG híbrido: a equipa pesquisou uma cópia local da wiki da empresa de três formas: regex para padrões estruturados como salary|privacy, embeddings de sentence-transformer para correspondências semânticas e sobreposição de tokens como alternativa por palavras-chave. A minha leitura de porquê três: o regex encontra nomes de campos e termos exatos, e os embeddings encontram regras formuladas de forma diferente da pergunta.
Stack: qwen/qwen3-235b-a22b-2507 no framework SGR sobre LangChain.
5. REPL plan-execute (equipa 5qsp7i / key_concept_parallel)
Esta arquitetura manteve o planeamento e a escrita de código em chamadas de modelo separadas. O Python gerado corre num REPL (read-eval-print loop): uma sessão de Python que mantém as variáveis entre passos. Apareceu na tabela Ultimate, mais ampla, e não no top cinco congelado dos prémios. A sua descrição pública continua a ser útil, porque mostra uma forma diferente de decomposição: isolamento por fase de execução e não por papel de negócio.
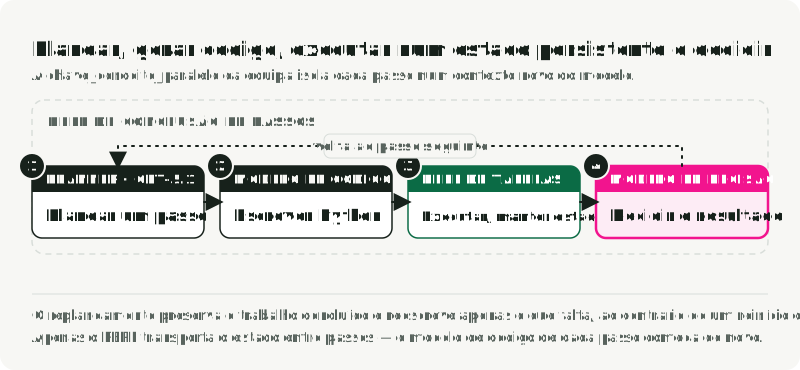
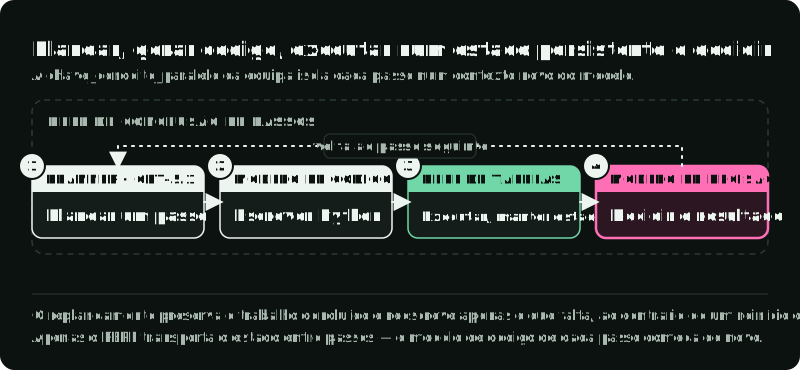
Modelos diferentes ficaram com tarefas diferentes: um planeava, outro escrevia Python e um modelo de decisão separado escolhia o que fazer após cada passo.
Configuração multimodelo:
| Fase | Modelo |
|---|---|
| Planeamento | openai/gpt-5.1 |
| Geração de código | deepseek/deepseek-v3.2 |
| Decisão pós-passo | openai/gpt-4.1 |
| Resposta final | openai/gpt-4.1 |
O REPL de conclusão de passo:
- O planeador cria um passo de alto nível.
- O modelo de geração de código trabalha num contexto de modelo novo e escreve um script Python para esse passo.
- O script é executado num REPL limitado à tarefa, cujas variáveis persistem entre passos.
- O modelo de decisão analisa o resultado e escolhe um de quatro desfechos: continuar com o passo seguinte, terminar porque a tarefa está concluída, abortar porque falhou, ou replanear.
O caminho de replaneamento é a ideia reutilizável. Quando o resultado de um passo mostra que o plano já não serve, o modelo de decisão pode manter o trabalho concluído e reescrever apenas os passos restantes do plano. No diagrama, “concluído” e “falhou” partilham uma única saída para a resposta final.
Padrões que se repetiram nas submissões
As implementações diferiam, mas várias preocupações de engenharia surgiram repetidamente nas descrições públicas.
A gestão de contexto foi explícita
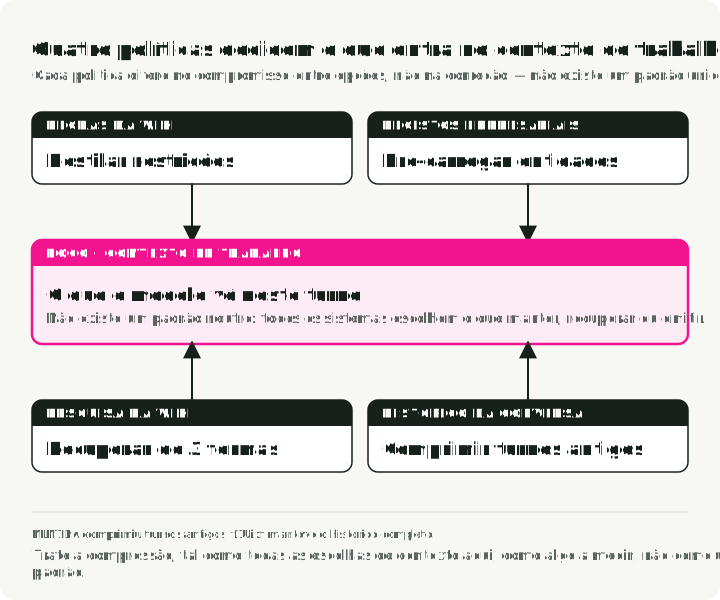
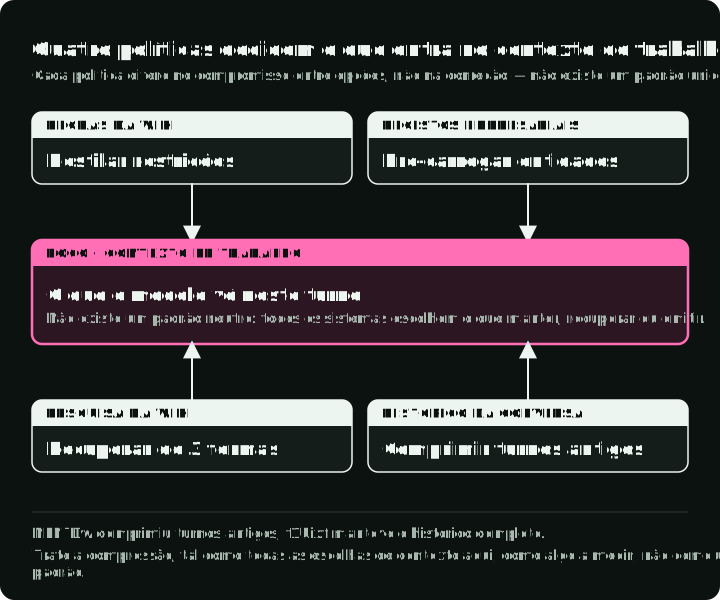
Nenhuma equipa podia dar ao modelo todas as regras, registos e passos anteriores sem fazer uma escolha de política. Os sistemas diferiam no ponto onde filtravam a informação: antes da execução, na pesquisa ou no histórico. O diagrama divide o contexto do modelo em quatro partes e mostra qual política controla cada uma, quando corre e que equipas a usaram.
| Estratégia | Abordagem | Melhor para |
|---|---|---|
| Destilação de regras | Pré-processar as regras da wiki em instruções compactas, preservando as restrições | Prompts compactos, arranque rápido |
| Pré-carregamento intensivo | Carregar dados de utilizador/projeto/cliente antes da execução | Minimizar tool calls |
| RAG híbrido | Fluxos de pesquisa por regex + semântica + palavras-chave | Necessidades de retrieval complexas |
| Compressão do histórico | Manter os turnos recentes completos, comprimir o histórico mais antigo | Conversas longas |
Compromisso: a NLN7Dw comprimiu os turnos mais antigos, enquanto a f1Uixf reportou que a compressão do histórico prejudicou as suas experiências e manteve a conversa completa. Trate a compressão como uma escolha medida, não como predefinição. As submissões fortes também diferiram no tamanho do prompt. A Kc7F2N (3.º lugar nos prémios) manteve as suas instruções mínimas, apoiou-se em regras da wiki destiladas e construiu as suas ferramentas de pesquisa sobre embeddings. A MMzXeM (4.º lugar nos prémios) manteve o prompt principal em 320 tokens e pôs a wiki inteira atrás da sua ferramenta
ask_wiki, que dependia de context caching para ser barata.
Verificações antes, durante e depois do ciclo principal
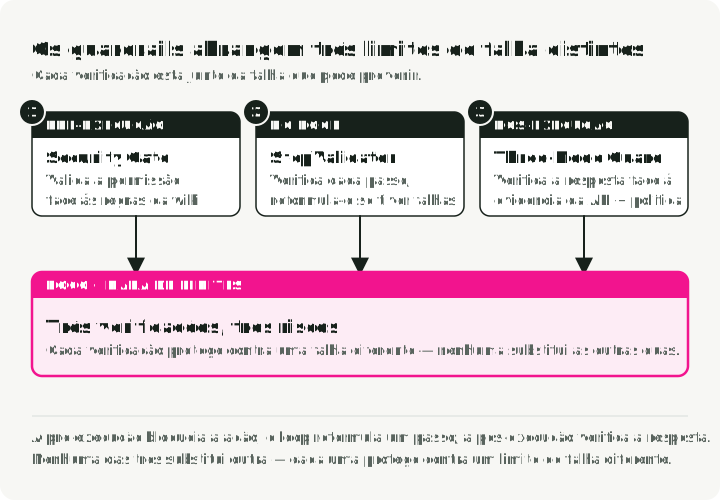
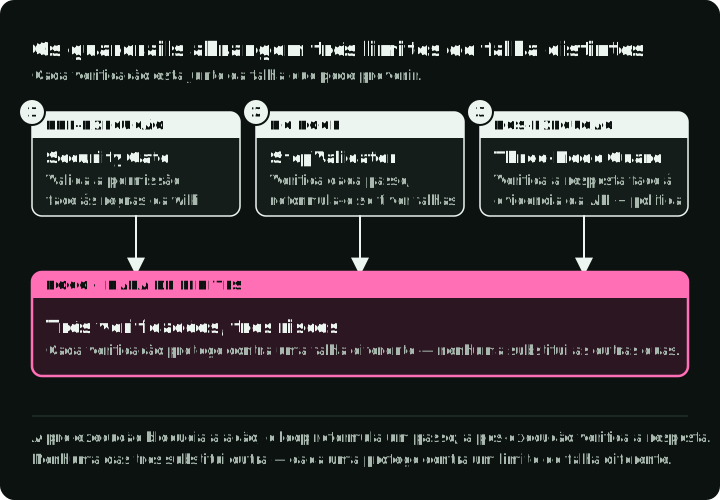
Várias equipas colocaram verificações antes, durante ou depois do ciclo principal. Estas verificações precisam de dados diferentes em cada fase. Uma implementação partilhada pode executá-las se receber os dados de entrada certos em cada fase. Um crítico invocado apenas para a resposta final não pode impedir um tool call não autorizado anterior. O diagrama situa cada verificação numa linha temporal da tarefa ao avaliador e mostra o que vê e a falha que impede.
| Tipo de guardrail | Quando | Exemplo |
|---|---|---|
| Verificações antes da execução | Antes de o ciclo principal começar | O Security Gate Agent valida as permissões face às regras da wiki |
| Validadores no ciclo | Durante o raciocínio | O StepValidator verifica cada ação proposta e pede que seja refeita se estiver errada |
| Verificações após a execução | Antes da submissão final | O sistema de guards de três modos verifica a resposta do agente face aos dados da API e à política |
Wrappers de ferramentas
Várias equipas alteraram a camada de ferramentas que o modelo vê, em vez de acrescentarem instruções sobre a API em bruto:
- Auto-pagination: a NLN7Dw removeu a paginação de todas as ferramentas. Uma função percorre todas as páginas e devolve a lista completa.
- Fuzzy normalization: os parsers de ferramentas da J8Gvbi mapeiam a linguagem humana para nomes da API, pelo que “Willingness to travel” passa a ser o campo
will_travel. - Schema cleanup: a f1Uixf removeu campos não usados dos tool schemas e expandiu as descrições dos parâmetros. A NLN7Dw reconstruiu
Req_LogTimeEntry, a única ferramenta do SDK cujos campos vinham noutra ordem, porque essa ordem confundia o modelo. - Reasoning tools: a xoDvsa (7.º lugar nos prémios, 0,515) acrescentou as ferramentas
plan,thinkecritica um agente ReAct simples. A ferramenta critic devolve structured output com campos de raciocínio dedicados.
Um wrapper oculta a paginação ao modelo: o agente pede uma lista uma vez, e list_all segue next_offset até o valor ser -1, o valor de fim usado no exemplo oficial do ERC3. O código abaixo ilustra o passo 1 da ordem de adoção no fim deste artigo; não é código de nenhuma equipa. respond cria os links para entidades a partir dos IDs obtidos pelo agente e rejeita um ID que nunca tenha visto. Assim, cada link vem do código, e um ID inventado é rejeitado antes de chegar ao avaliador.
# Stand-in for the benchmark API: 12 projects, 5 per page.
PROJECTS = [{"id": f"proj_{i}", "name": f"Project {i}"} for i in range(12)]

def call_api(endpoint: str, offset: int = 0, limit: int = 5) -> dict:
    page = PROJECTS[offset : offset + limit]
    more = offset + limit < len(PROJECTS)
    return {"items": page, "next_offset": offset + limit if more else -1}

def list_all(endpoint: str) -> list[dict]:
    """Follow next_offset until the API returns the terminal value -1."""
    items, offset = [], 0
    while offset != -1:
        page = call_api(endpoint, offset=offset)
        items.extend(page["items"])
        offset = page["next_offset"]
    return items

def respond(text: str, entity_ids: list[str], fetched: list[dict]) -> dict:
    """Build required links from IDs; refuse IDs the agent never fetched."""
    known = {row["id"] for row in fetched}
    unknown = [i for i in entity_ids if i not in known]
    if unknown:
        raise ValueError(f"unknown entity ids: {unknown}")
    return {"message": text, "links": [{"id": i} for i in entity_ids]}

projects = list_all("/projects/list")
assert len(projects) == 12  # three pages, one list
print(respond("You lead two projects.", ["proj_3", "proj_11"], projects))
O agente nunca vê o limite de uma página, e proj_11, da terceira página, é um link válido.
Modos de falha e as correções estruturais reportadas pelas equipas
As descrições mencionam repetidamente falhas em que o agente chama a API ou aplica uma política da empresa. As correções mais reutilizáveis passaram o requisito para o código ou para um passo de validação dedicado:
| Modo de falha | Descrição | Correção arquitetural |
|---|---|---|
| Contorno de permissões | Executar ações restritas sem verificar as permissões do utilizador | Security Gate Agent pré-execução; sequência obrigatória Identidade → Permissões → Execução |
| Ligações a entidades em falta | Resposta de texto correta, mas sem os links de referência obrigatórios | LinkGeneratorAgent embutido na ferramenta de resposta |
| Paginação incompleta | Processar apenas a primeira página dos resultados de uma lista | Wrappers de auto-pagination para todos os endpoints de listagem |
| Ciclos de tool calls | Chamadas repetidas com pequenas variações | Limites de turnos; tool schemas mais claros; modelo escolhido com teste no fluxo de trabalho real |
| Excesso de contexto | Encher o contexto com secções irrelevantes da wiki | Destilação de regras; filtragem dinâmica do contexto |
Dois relatórios acrescentam detalhe à linha dos ciclos. A f1Uixf viu ciclos de tool calling com o GPT-5, mas não com o modelo Qwen3, mais pequeno. A NLN7Dw definiu o limite de turnos demasiado baixo, e 5 de 103 tarefas não terminaram, pelo que um limite de turnos precisa de margem.
Uma ordem prática de adoção
O ERC3 é uma única empresa simulada, não um estudo de ablação geral de agentes. Use-o como fonte de hipóteses de design e depois teste essas hipóteses nos seus próprios traces. Uma ordem de adoção sensata é:
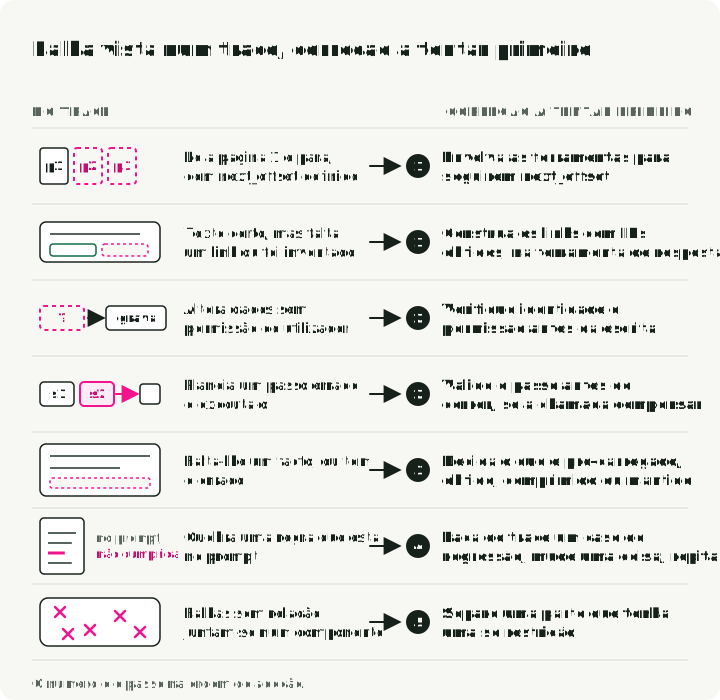
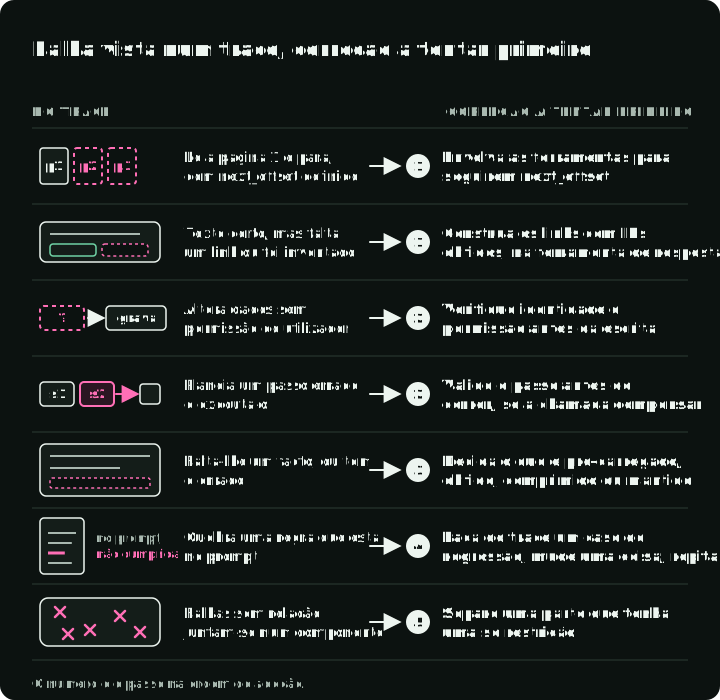
- Torne primeiro determinística a correção da API. Pagine automaticamente os endpoints de listagem, normalize campos aproximados, valide schemas e gere os links obrigatórios dentro da ferramenta de resposta.
- Acrescente verificações onde um erro é caro. Verifique identidade e permissão antes de alterar dados; valide um passo antes da execução apenas quando a chamada extra ao modelo apanha falhas que compensam o seu custo.
- Escreva uma política de contexto. Decida o que é pré-carregado, recuperado, comprimido ou mantido textualmente. Meça a política por fatia de tarefas e não apenas por contagem de tokens.
- Transforme traces falhados em casos de regressão. Classifique a falha, altere um mecanismo e volte a executar a fatia afetada. Automatize a revisão de prompts só depois de esse ciclo ser fiável.
- Decomponha quando a responsabilidade ficar mais clara. Um componente separado justifica-se quando consegue ser responsável por uma restrição, usar outro modelo ou ferramenta, ou ser testado de forma independente, e não apenas porque “multi-agent” soa mais capaz.
A figura abaixo esboça o aspeto de cada falha num trace e aponta para a correção a tentar primeiro. Os números correspondem aos passos acima.