Enterprise RAG Challenge 3: lecciones de las candidaturas públicas

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Enterprise RAG Challenge 3 (ERC3) pidió a agentes completar tareas empresariales contra la API de una empresa simulada. La clasificación congelada de los premios es especialmente útil porque muchos participantes publicaron algo más que una puntuación: arquitectura, combinación de modelos, coste y notas sobre los fallos.
He revisado esas descripciones públicas para responder a una pregunta más concreta: ¿qué decisiones de diseño se repetían en las candidaturas más sólidas y cuáles sirven fuera de este benchmark?
Este artículo es para ingenieros que construyen agentes que llaman a APIs empresariales. Verás cinco diseños tomados de las descripciones públicas, los problemas que resolvió cada uno (permisos, paginación, enlaces ausentes, tamaño del contexto) y un orden para probarlos en tu propio agente.
¿Qué es Enterprise RAG Challenge?
Enterprise RAG Challenge 3 es un proyecto de investigación colaborativo y a gran escala que pone a prueba cómo gestionan los agentes autónomos tareas empresariales complejas. A diferencia de los benchmarks estáticos, ERC3 se ejecuta sobre la Agentic Enterprise Simulation (AGES), una simulación de eventos discretos que expone una API empresarial realista.
Qué evalúa el benchmark
A través de AGES, los agentes trabajan dentro de una empresa ficticia que cuenta con:
- Perfiles de empleados con habilidades y departamentos concretos
- Proyectos con asignaciones de equipo y relaciones con clientes
- Wiki corporativa con reglas de negocio y jerarquías de permisos
- Registro de tiempo y operaciones financieras
Cada tarea inicia una simulación aislada. La wiki de la empresa es común, pero los registros operativos varían de una tarea a otra, así que un agente no puede resolver el conjunto memorizando el estado de una sola empresa.
Interpreta las puntuaciones como una instantánea
ERC3 ofrece ahora una clasificación de competición congelada y un benchmark público que siguió recibiendo ejecuciones después del evento. Esas páginas responden a preguntas distintas. Las cifras siguientes describen la clasificación de premios en el corte de la competición, no las mejores sesiones posteriores:
| Métrica | Instantánea de la competición |
|---|---|
| Candidaturas al premio | 38 |
| Conjunto de tareas | 103 tareas empresariales |
| Mayor puntuación del premio | 0,718 |
| Corte del premio | 9 de diciembre de 2025, 13:40 CET |
La página del benchmark en vivo puede mostrar puntuaciones más altas porque incluye ejecuciones posteriores. Por eso la clasificación congelada es la fuente adecuada para afirmar qué ganó la competición. La clasificación Ultimate toma la mejor ejecución de cada cuenta sin el corte de la competición, de modo que sus puntuaciones no son comparables con las del premio.
Tipos de tareas
Las tareas abarcan varias áreas de habilidad:
- Razonamiento multisalto, como emparejar las habilidades de los empleados con las asignaciones de proyectos.
- Validación de permisos, como bloquear cambios salariales o accesos a datos no autorizados.
- Consultas ambiguas, incluidas peticiones multilingües y parafraseadas.
- Cumplimiento estricto del formato de salida, incluidos los enlaces obligatorios a entidades en las respuestas.
Qué sugieren las candidaturas
Las descripciones públicas no respaldan un veredicto simple como “multi-agent supera a un solo agente”. La candidatura de MMzXeM, cuarta en la clasificación de premios, era un único agente con herramientas asignadas 1:1 a los endpoints de la API, una herramienta ask_wiki y un system prompt de 320 tokens. Las descripciones sí respaldan cuatro observaciones más acotadas:
- Los equipos separaban un componente cuando este se encargaba de un requisito que los agentes incumplían una y otra vez: una comprobación de permisos, la validación de pasos, la ejecución de código o los enlaces a entidades. No dividían por “roles de agente” arbitrarios.
- La validación se acercó a las acciones irreversibles. Varios sistemas comprobaban los permisos antes de ejecutar, revisaban pasos individuales o protegían la respuesta final.
- Las trazas fallidas guiaron los cambios. El ganador del premio convirtió las ejecuciones fallidas en revisiones del prompt mediante un bucle automatizado; otros equipos documentaron correcciones igual de concretas en herramientas y prompts.
- La política de contexto fue una decisión de arquitectura. Los equipos probaron la destilación, la precarga, la recuperación y la compresión del historial. Sus propios informes no coinciden en si la compresión ayudó, así que no hay una receta universal.
Cinco enfoques informativos
No son los cinco primeros por orden de clasificación. Los elegí porque sus descripciones públicas muestran cinco formas distintas de construir el sistema: revisión automática del prompt, etapas especializadas, validación por paso, guards de la respuesta y aislamiento entre planificación y ejecución.
| Equipo | Contexto de la clasificación | Puntuación publicada |
|---|---|---|
| VZS9FL | Premio, 1.º | 0,718 |
| Lcnxuy | Premio, 8.º | 0,505 |
| NLN7Dw | Premio, 2.º | 0,621 |
| J8Gvbi | Premio, 16.º | 0,437 |
| 5qsp7i (key_concept_parallel) | Ultimate, 3.º | 0,670 |
1. Prompt engineering evolutivo (equipo VZS9FL / @aostrikov)
El enfoque con la puntuación más alta automatizó el prompt engineering mediante un bucle de automejora.
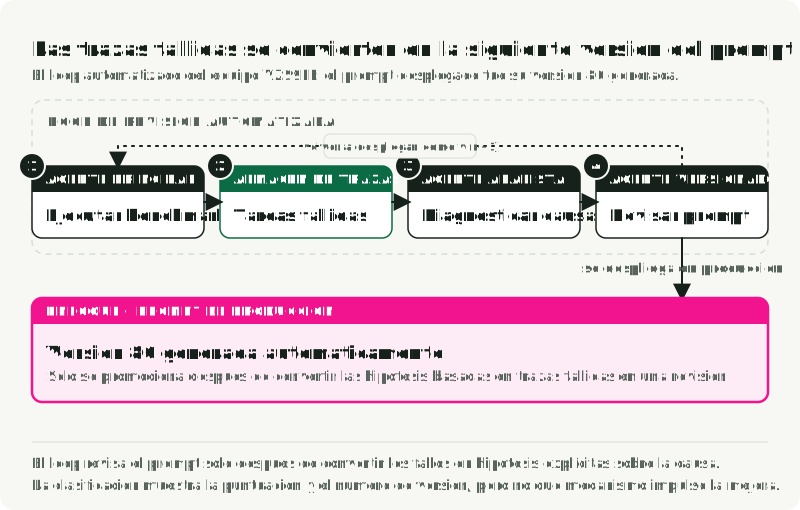
En lugar de ajustar a mano el prompt de producción, el equipo montó un bucle de tres agentes que convertía las trazas fallidas en revisiones candidatas.
Pipeline de tres agentes:
| Agente | Función |
|---|---|
| Main Agent | Ejecuta el benchmark y registra todas las acciones y los fallos |
| Analyzer Agent | Revisa las tareas fallidas y formula hipótesis sobre las causas de fondo |
| Versioner Agent | Genera una nueva versión del prompt que incorpora lo aprendido |
El prompt de producción fue la versión número 80 generada automáticamente. El equipo describe el bucle como el análisis de las tareas fallidas, la propuesta de causas y la decisión de qué sugerencias incorporar. La clasificación establece la puntuación final y el número de iteraciones. No aísla cuánta de la mejora se debió a la automatización y cuánta a los modelos, las herramientas o el feedback acumulado del benchmark.
Stack: claude-opus-4.5 con el SDK de Anthropic para Python y tool use nativo.
2. Pipeline secuencial multi-agent (equipo Lcnxuy / @andrey_aiweapps)
Esta candidatura construyó un flujo secuencial en el que componentes especializados se encargaban de las comprobaciones de seguridad, la extracción de contexto, la ejecución y el formato de los enlaces a entidades.
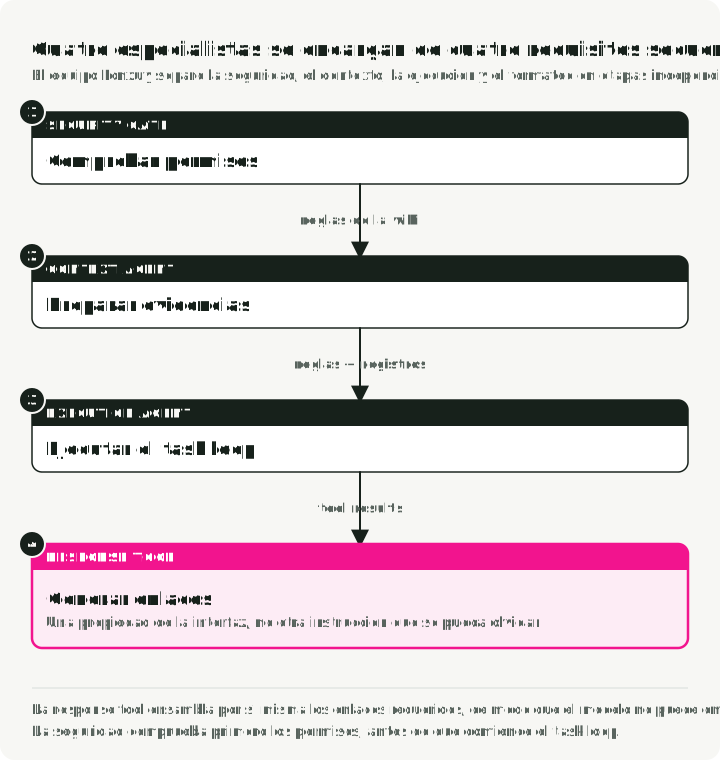
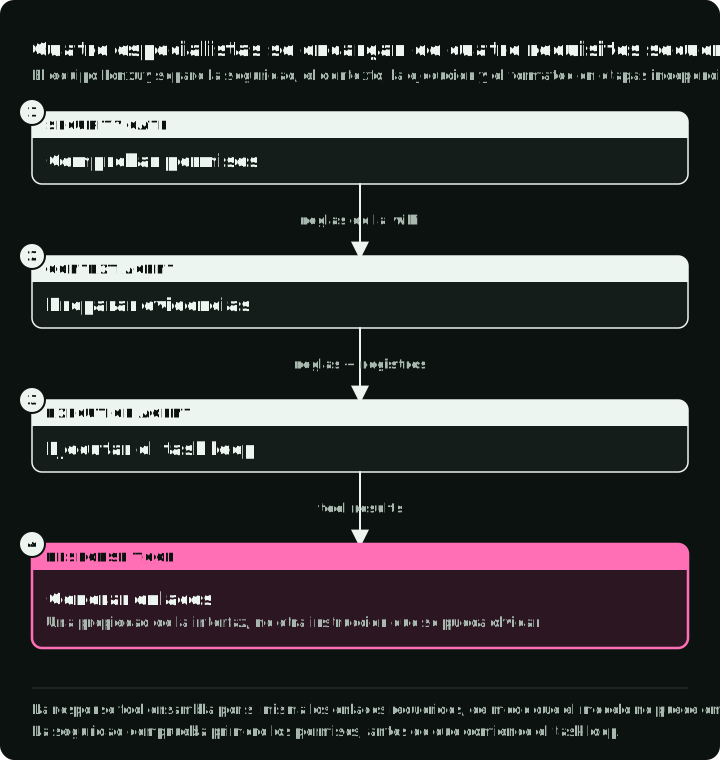
Los componentes documentados:
- Security Gate Agent: comprobación previa a la ejecución que valida los permisos contra las reglas de la wiki antes de que arranque el bucle principal.
- Context Extraction Agent: extrae las reglas críticas de system prompts de más de 500 líneas y precarga los datos de usuario, proyecto y cliente.
- Execution Agent: planificación al estilo ReAct con 5 fases internas (identidad → detección de amenazas → recopilación de información → validación de acceso → ejecución).
- LinkGeneratorAgent: integrado en la herramienta de respuesta, analiza el contexto para incluir los enlaces a entidades requeridos.
La descripción del equipo dice que el LinkGeneratorAgent estaba para evitar los fallos por enlaces ausentes: respuestas con el texto correcto pero sin los enlaces a entidades requeridos. Es la parte más transferible. Al integrarlo en la herramienta de respuesta, un requisito del benchmark (los enlaces obligatorios a entidades) pasa a ser una propiedad de la interfaz y deja de ser una instrucción más que el modelo de ejecución puede olvidar.
Stack: los frameworks atomic-agents e instructor con gpt-5.1-codex-max, gpt-4.1 y claude-sonnet-4.5.
3. Razonamiento guiado por esquema con validación de pasos (equipo NLN7Dw / Ilia Ris)
El razonamiento guiado por esquema (SGR) hace que el modelo rellene en cada paso un esquema de salida fijo, por ejemplo su razonamiento, un plan y la siguiente tool call, de modo que el programa pueda leer y comprobar cada campo. El artículo sobre SGR de este blog muestra cómo imponer un esquema así con vLLM. Este equipo combinó SGR con inferencia rápida y un validador en cada paso propuesto. El diseño abarata la revisión: rechaza un paso defectuoso antes de que se convierta en tool call y pide al flujo principal que lo rehaga con los comentarios del validador.
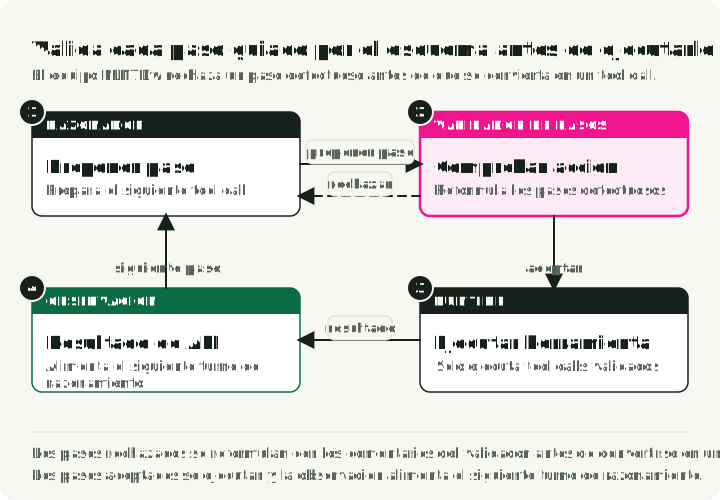
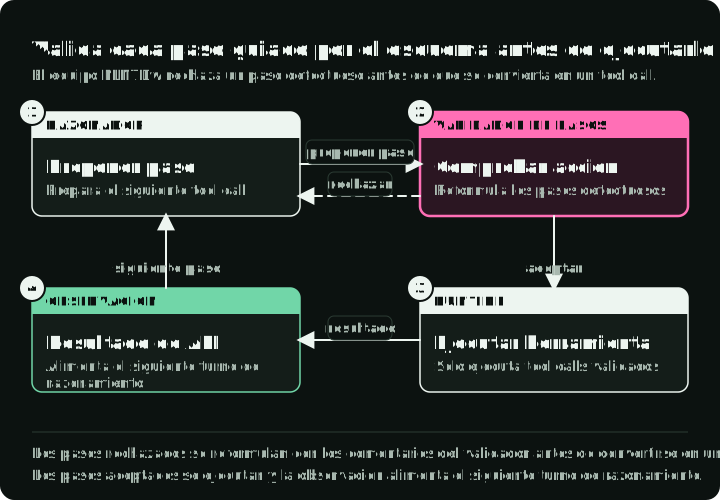
Componentes clave:
| Componente | Función |
|---|---|
| StepValidator | Inspecciona cada paso propuesto. Si algo falla, lo devuelve para que se rehaga, con comentarios. |
| Gestión del contexto | Plan completo del turno anterior, más historial comprimido de los turnos más antiguos |
| Enriquecimiento dinámico | Obtiene automáticamente perfil de usuario, proyectos y clientes; un LLM filtra para inyectar solo los datos relevantes para la tarea |
| Wrappers de paginación automática | Todos los endpoints de listado devuelven resultados completos automáticamente |
El equipo comunicó que ejecutaba gpt-oss-120b en Cerebras a hasta unos 3000 tokens por segundo. Combinó la validación con inferencia de alto rendimiento, lo que pudo reducir su coste en latencia. El resultado público no aísla ese efecto.
Stack: un agente NextStep modificado, el agente de ejemplo de SGR publicado para ERC3.
4. Sistema de enricher y guard (equipo J8Gvbi / @mishka)
Esta candidatura añadió a una base SGR pistas no bloqueantes y un sistema de guards por niveles. Cuando llegaban las respuestas de la API, los enrichers las inspeccionaban y añadían orientación operativa al contexto posterior. Los guards comprobaban la respuesta del agente antes de enviarla.
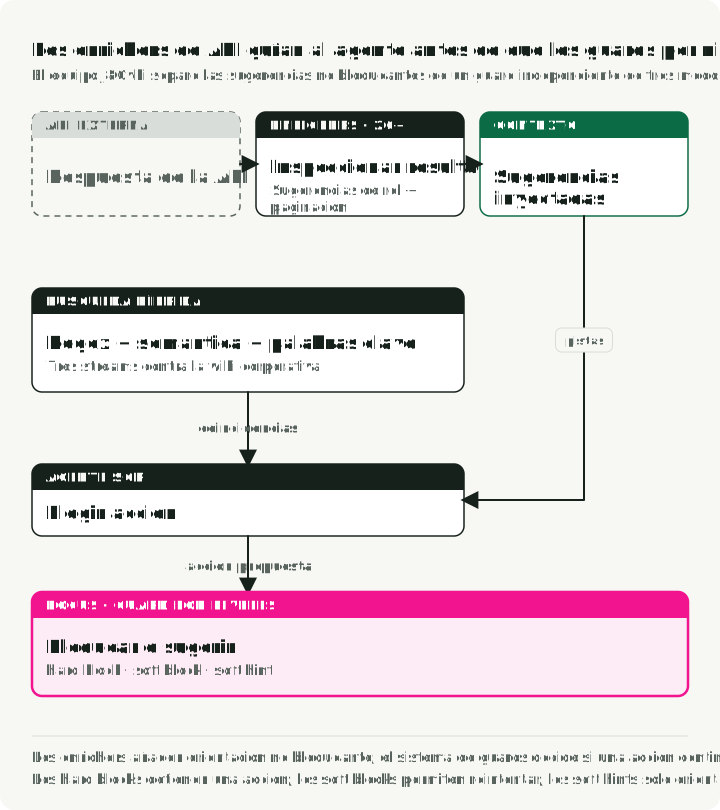
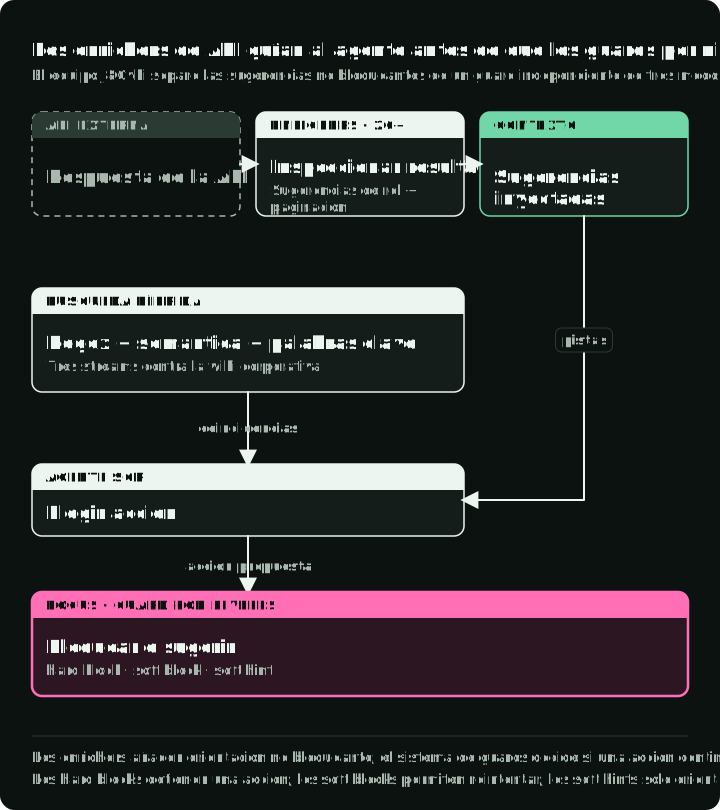
Más de 20 enrichers inspeccionaban las respuestas de la API e inyectaban pistas contextuales:
RoleEnricher: "You are LEAD of this project, proceed with update."
PaginationHintEnricher: "next_offset=5 means MORE results! MUST paginate."
Sistema de guards de tres modos:
| Modo | Comportamiento |
|---|---|
| Hard block | Se rechaza una respuesta que los datos de la API muestran como imposible, por ejemplo una que nombra a un empleado ajeno al equipo del proyecto |
| Soft block | Una respuesta arriesgada se rechaza una vez con una advertencia y se acepta si el agente la vuelve a enviar tras esa advertencia |
| Soft hint | Se añade orientación sin bloquear |
Wiki con RAG híbrido: el equipo buscaba en una copia local de la wiki de la empresa de tres maneras: regex para patrones estructurados como salary|privacy, embeddings de sentence-transformer para coincidencias semánticas y solapamiento de tokens como alternativa por palabras clave. Mi lectura de por qué tres: la regex encuentra nombres de campo y términos exactos, y los embeddings encuentran reglas redactadas de otra forma que la pregunta.
Stack: qwen/qwen3-235b-a22b-2507 sobre el framework SGR de LangChain.
5. REPL de planificación y ejecución (equipo 5qsp7i / key_concept_parallel)
Esta arquitectura mantenía la planificación y la escritura de código en llamadas al modelo separadas. El Python generado se ejecuta en un REPL (read-eval-print loop): una sesión de Python que conserva sus variables entre pasos. Apareció en la clasificación Ultimate, más amplia, no entre los cinco primeros del premio congelado. Su descripción pública sigue siendo útil porque muestra otra forma de descomposición: aislamiento por fase de ejecución en lugar de por rol de negocio.
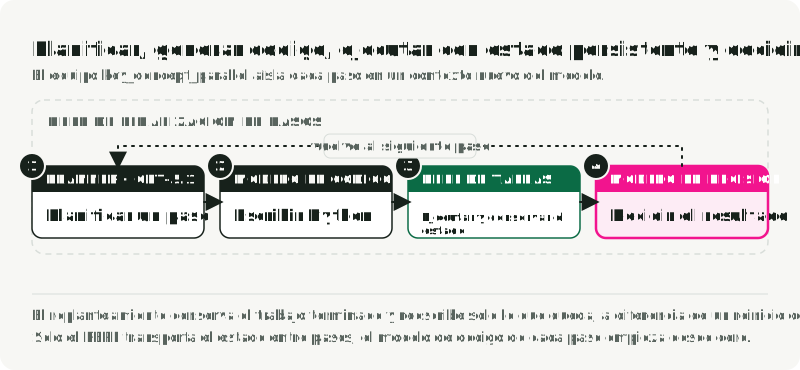
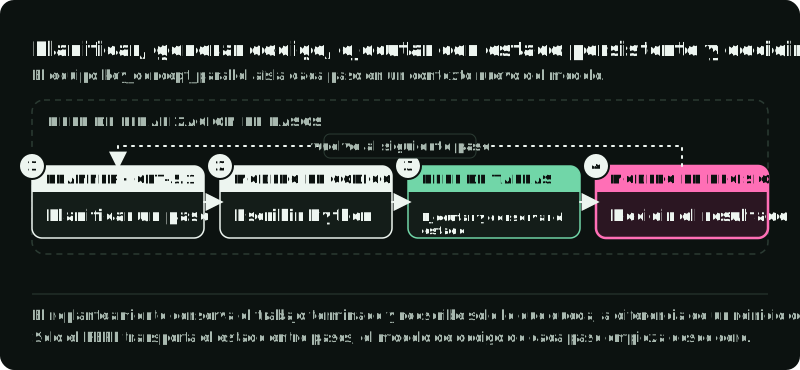
Distintos modelos se encargaban de distintas tareas: uno planificaba, otro escribía Python y un modelo de decisión aparte elegía qué hacer después de cada paso.
Configuración con varios modelos:
| Etapa | Modelo |
|---|---|
| Planificación | openai/gpt-5.1 |
| Generación de código | deepseek/deepseek-v3.2 |
| Decisión tras el paso | openai/gpt-4.1 |
| Respuesta final | openai/gpt-4.1 |
El REPL de finalización de pasos:
- El planificador crea un paso de alto nivel.
- El modelo de generación de código trabaja con un contexto de modelo nuevo y escribe un script de Python para ese paso.
- El script se ejecuta en un REPL acotado a la tarea, cuyas variables persisten entre pasos.
- El modelo de decisión examina el resultado y elige uno de cuatro desenlaces: continuar con el siguiente paso, terminar porque la tarea está hecha, abortar porque ha fallado o replanificar.
La ruta de replanificación es la idea reutilizable. Cuando el resultado de un paso muestra que el plan ya no encaja, el modelo de decisión puede conservar el trabajo completado y reescribir solo los pasos restantes del plan. En el diagrama, hecho y fallido comparten una única salida hacia la respuesta final.
Patrones que se repetían en las candidaturas
Las implementaciones diferían, pero varias preocupaciones de ingeniería aparecían una y otra vez en las descripciones públicas.
La gestión del contexto era explícita
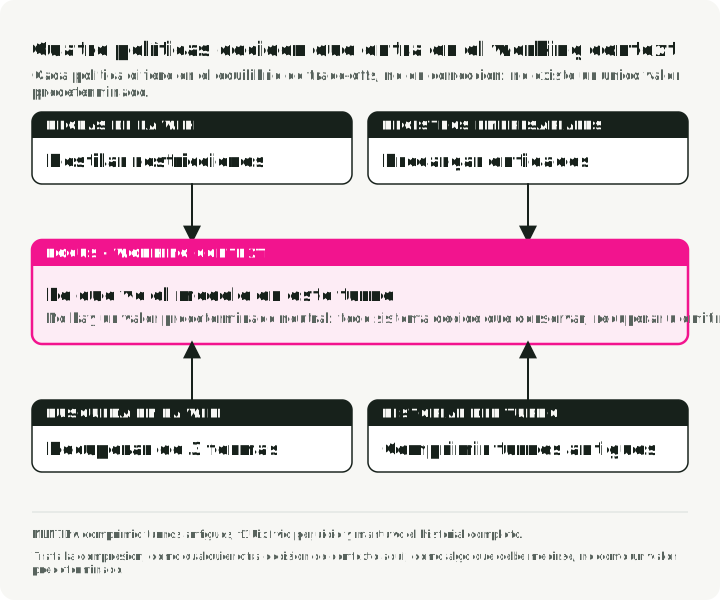
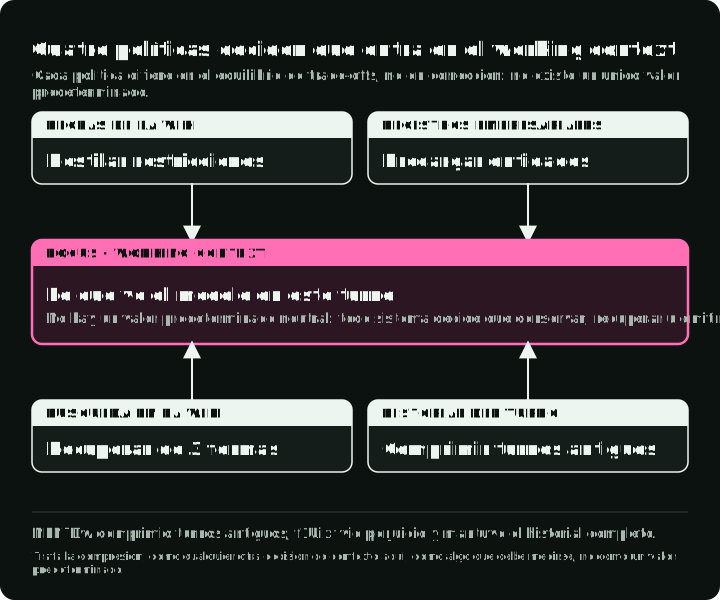
Ningún equipo pudo darle al modelo todas las reglas, registros y pasos anteriores sin tomar una decisión de política. Los sistemas diferían en dónde filtraban la información: antes de la ejecución, en la recuperación o en el historial. El diagrama divide el contexto del modelo en cuatro partes y muestra qué política controla cada una, cuándo se ejecuta y qué equipos la usaron.
| Estrategia | Enfoque | Ideal para |
|---|---|---|
| Destilación de reglas | Preprocesar las reglas de la wiki en instrucciones compactas conservando las restricciones | Prompts ligeros, arranque rápido |
| Precarga intensiva | Cargar los datos de usuario, proyecto y cliente antes de la ejecución | Minimizar las tool calls |
| RAG híbrido | Flujos de búsqueda por regex, semántica y palabras clave | Necesidades de recuperación complejas |
| Compresión del historial | Mantener completos los turnos recientes y comprimir el historial antiguo | Conversaciones largas |
Compromiso: NLN7Dw comprimió los turnos antiguos, mientras que f1Uixf comunicó que la compresión del historial perjudicó sus experimentos y mantuvo la conversación completa. Trata la compresión como una decisión que se mide, no como un valor por defecto. Las candidaturas sólidas también diferían en el tamaño del prompt. Kc7F2N (3.º del premio) mantuvo mínimas sus propias instrucciones, se apoyó en reglas de la wiki destiladas y construyó sus herramientas de búsqueda sobre embeddings. MMzXeM (4.º del premio) limitó el prompt principal a 320 tokens y puso toda la wiki tras su herramienta
ask_wiki, que dependía del context caching para resultar barata.
Comprobaciones antes, durante y después del bucle principal
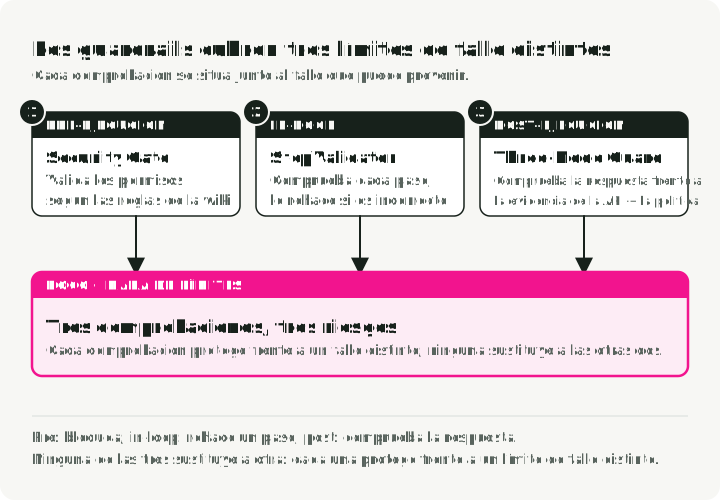
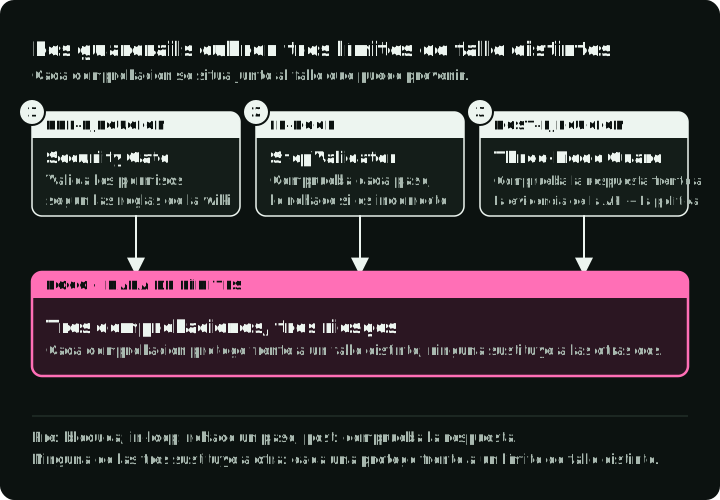
Varios equipos situaron comprobaciones antes, durante o después del bucle principal. Estas comprobaciones necesitan datos distintos en cada fase. Una implementación compartida puede realizarlas si recibe las entradas adecuadas en cada fase. Un crítico que solo se invoca para la respuesta final no puede impedir un tool call no autorizado anterior. El diagrama sitúa cada comprobación en una línea temporal desde la tarea hasta el evaluador y muestra qué ve y qué fallo evita.
| Tipo de guardrail | Cuándo | Ejemplo |
|---|---|---|
| Comprobaciones previas a la ejecución | Antes de que arranque el bucle principal | Security Gate Agent valida los permisos contra las reglas de la wiki |
| Validadores dentro del bucle | Durante el razonamiento | StepValidator comprueba cada acción propuesta y provoca una revisión si es defectuosa |
| Guards posteriores a la ejecución | Antes del envío final | El Three-Mode Guard System comprueba la respuesta del agente contra los datos de la API y la política |
Tool wrappers
Varios equipos cambiaron la capa de herramientas que ve el modelo en lugar de añadir instrucciones sobre la API en bruto:
- Auto-paginación: NLN7Dw eliminó la paginación de todas las herramientas. Una función recorre todas las páginas y devuelve la lista completa.
- Normalización difusa: los parsers de herramientas de J8Gvbi traducen el lenguaje humano a nombres de la API, de modo que “Willingness to travel” se convierte en el campo
will_travel. - Limpieza de esquemas: f1Uixf eliminó los campos sin usar de los tool schemas y amplió las descripciones de los parámetros. NLN7Dw reconstruyó
Req_LogTimeEntry, la única herramienta del SDK cuyos campos llegaban en otro orden, porque ese orden confundía al modelo. - Herramientas de razonamiento: xoDvsa (7.º del premio, 0,515) añadió las herramientas
plan,thinkycritica un agente ReAct sencillo. La herramienta critic devuelve structured output con campos de razonamiento específicos.
Un wrapper oculta la paginación al modelo: el agente pide una lista una sola vez y list_all sigue next_offset hasta que vale -1, el valor de fin utilizado en el ejemplo oficial de ERC3. El código siguiente es un esquema del paso 1 del orden de adopción al final de este artículo, no el código de ningún equipo. respond construye los enlaces a entidades a partir de los IDs que el agente ha obtenido y rechaza cualquier ID que nunca haya visto, de modo que cada enlace procede del código y un ID inventado falla antes de llegar al evaluador.
# Stand-in for the benchmark API: 12 projects, 5 per page.
PROJECTS = [{"id": f"proj_{i}", "name": f"Project {i}"} for i in range(12)]

def call_api(endpoint: str, offset: int = 0, limit: int = 5) -> dict:
    page = PROJECTS[offset : offset + limit]
    more = offset + limit < len(PROJECTS)
    return {"items": page, "next_offset": offset + limit if more else -1}

def list_all(endpoint: str) -> list[dict]:
    """Follow next_offset until the API returns the terminal value -1."""
    items, offset = [], 0
    while offset != -1:
        page = call_api(endpoint, offset=offset)
        items.extend(page["items"])
        offset = page["next_offset"]
    return items

def respond(text: str, entity_ids: list[str], fetched: list[dict]) -> dict:
    """Build required links from IDs; refuse IDs the agent never fetched."""
    known = {row["id"] for row in fetched}
    unknown = [i for i in entity_ids if i not in known]
    if unknown:
        raise ValueError(f"unknown entity ids: {unknown}")
    return {"message": text, "links": [{"id": i} for i in entity_ids]}

projects = list_all("/projects/list")
assert len(projects) == 12  # three pages, one list
print(respond("You lead two projects.", ["proj_3", "proj_11"], projects))
El agente nunca ve un límite de página, y proj_11, de la tercera página, es un enlace válido.
Modos de fallo y correcciones estructurales que comunicaron los equipos
Las descripciones mencionan repetidamente fallos en los que el agente llama a la API o aplica una política de la empresa. Las correcciones más reutilizables trasladaron el requisito al código o a un paso de validación específico:
| Modo de fallo | Descripción | Corrección de arquitectura |
|---|---|---|
| Omisión de permisos | Ejecutar acciones restringidas sin verificar los permisos del usuario | Security Gate Agent previo a la ejecución; secuencia obligatoria identidad → permisos → ejecución |
| Enlaces a entidades ausentes | Respuesta de texto correcta pero sin los enlaces de referencia requeridos | LinkGeneratorAgent integrado en la herramienta de respuesta |
| Paginación incompleta | Procesar solo la primera página de los resultados de un listado | Wrappers de auto-paginación para todos los endpoints de listado |
| Bucles de tool calls | Llamadas repetidas con variaciones menores | Límites de turnos; tool schemas más claros; elección del modelo probada en el flujo real |
| Sobrecarga del contexto | Llenar el contexto con secciones irrelevantes de la wiki | Destilación de reglas; filtrado dinámico del contexto |
Dos informes añaden detalle a la fila de los bucles. f1Uixf observó bucles de tool calling con GPT-5, pero no con el modelo Qwen3, más pequeño. NLN7Dw fijó un límite de turnos demasiado bajo y 5 de las 103 tareas no terminaron, así que un límite de turnos necesita margen.
Un orden práctico de adopción
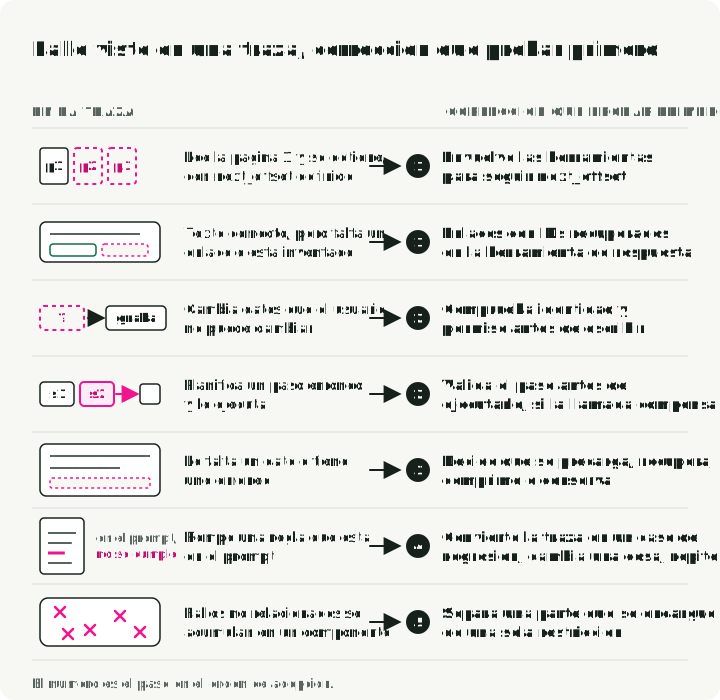
ERC3 es una sola empresa simulada, no un estudio general de ablación de agentes. Úsalo como fuente de hipótesis de diseño y después pruébalas con tus propias trazas. Un orden de adopción razonable es:
- Haz primero determinista la corrección de la API. Auto-pagina los endpoints de listado, normaliza los campos difusos, valida los esquemas y genera los enlaces requeridos dentro de la herramienta de respuesta.
- Añade comprobaciones donde un error sale caro. Verifica la identidad y el permiso antes de modificar datos; valida un paso antes de ejecutarlo solo cuando la llamada extra al modelo detecte fallos que compensen su coste.
- Escribe una política de contexto. Decide qué se precarga, qué se recupera, qué se comprime y qué se conserva literal. Mide la política por segmento de tareas y no solo por número de tokens.
- Convierte las trazas fallidas en casos de regresión. Clasifica el fallo, cambia un solo mecanismo y vuelve a ejecutar el segmento afectado. Automatiza la revisión del prompt solo cuando ese bucle sea fiable.
- Descompón cuando la responsabilidad se vuelva más clara. Un componente separado se justifica cuando puede encargarse de una restricción, usar un modelo o una herramienta distintos, o probarse de forma independiente, no solo porque “multi-agent” suene más capaz.
La figura siguiente esboza qué aspecto tiene cada fallo en una traza y señala la corrección que probar primero. Los números coinciden con los pasos anteriores.