Enterprise RAG Challenge 3: wnioski z publicznych zgłoszeń

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
Enterprise RAG Challenge 3 (ERC3) polegało na tym, że agenci wykonywali zadania biznesowe na symulowanym API firmy. Zamrożona tabela wyników nagrodzonych zgłoszeń jest wyjątkowo przydatna, bo wielu uczestników opublikowało więcej niż wynik: architekturę, zestaw modeli, koszt i uwagi o błędach.
Przejrzałem te publiczne opisy, żeby odpowiedzieć na węższe pytanie: jakie decyzje projektowe powtarzały się w mocnych zgłoszeniach i które z nich przydadzą się poza tym benchmarkiem?
Ten artykuł jest dla inżynierów, którzy budują agentów wywołujących biznesowe APIs. Zobaczysz pięć rozwiązań z publicznych opisów, problemy, które każde z nich rozwiązywało (uprawnienia, paginacja, brakujące linki, rozmiar kontekstu), oraz kolejność, w jakiej warto je wypróbować we własnym agencie.
Czym jest Enterprise RAG Challenge?
Enterprise RAG Challenge 3 to szeroko zakrojony projekt badawczy oparty na zbiorowym udziale, który sprawdza, jak autonomiczni agenci AI radzą sobie ze złożonymi zadaniami biznesowymi. W odróżnieniu od statycznych benchmarków ERC3 działa na Agentic Enterprise Simulation (AGES), symulacji zdarzeń dyskretnych, która udostępnia realistyczne API przedsiębiorstwa.
Co testuje benchmark
W AGES agenci pracują w fikcyjnej firmie, która ma:
- Profile pracowników z konkretnymi umiejętnościami i działami
- Projekty z przydziałem zespołów i relacjami z klientami
- Firmową wiki z regułami biznesowymi i hierarchiami uprawnień
- Rejestrację czasu pracy i operacje finansowe
Każde zadanie uruchamia odizolowaną symulację. Wiki firmy jest wspólna, ale rekordy operacyjne różnią się w zależności od zadania, więc agent nie rozwiąże zestawu, zapamiętując jeden stan firmy.
Wyniki to migawka
ERC3 udostępnia teraz zarówno zamrożoną tabelę wyników konkursu, jak i publiczny benchmark, który przyjmował kolejne uruchomienia po zakończeniu wydarzenia. Te strony odpowiadają na różne pytania. Poniższe liczby opisują tabelę wyników nagrodzonych zgłoszeń w chwili zamknięcia konkursu, a nie późniejsze, lepsze sesje:
| Metryka | Migawka z konkursu |
|---|---|
| Zgłoszenia do nagrody | 38 |
| Zestaw zadań | 103 zadania biznesowe |
| Najwyższy wynik w nagrodzie | 0.718 |
| Zamknięcie konkursu | 9 grudnia 2025, 13:40 CET |
Strona działającego benchmarku może pokazywać wyższe wyniki, bo obejmuje późniejsze uruchomienia. Dlatego zamrożona tabela jest właściwym źródłem dla twierdzeń o tym, co wygrało konkurs. Ultimate leaderboard bierze najlepsze uruchomienie każdego konta bez uwzględniania zamknięcia konkursu, więc jego wyniki nie są porównywalne z wynikami nagrodzonych zgłoszeń.
Rodzaje zadań
Zadania obejmują kilka obszarów umiejętności:
- Rozumowanie wieloetapowe, na przykład dopasowanie umiejętności pracowników do przydziałów w projektach.
- Walidacja uprawnień, na przykład blokowanie nieautoryzowanych zmian wynagrodzenia lub dostępu do danych.
- Niejednoznaczne zapytania, w tym wielojęzyczne i parafrazowane prośby.
- Ścisła zgodność wyjścia z wymaganiami, w tym obowiązkowe linki do encji w odpowiedziach.
Co sugerują zgłoszenia
Publiczne opisy nie pozwalają na jednoznaczny werdykt w rodzaju „multi-agent wygrywa z single-agent”. Zgłoszenie z czwartego miejsca w nagrodach, MMzXeM, było jednym agentem z narzędziami odwzorowanymi 1:1 na endpointy API, narzędziem ask_wiki i system prompt o długości 320 tokens. Opisy potwierdzają jednak cztery węższe obserwacje:
- Zespoły wydzielały komponent, gdy odpowiadał za jedno wymaganie, z którym agenci wciąż sobie nie radzili: sprawdzenie uprawnień, walidację kroków, wykonywanie kodu albo linki do encji. Nie dzieliły systemu według dowolnych „ról agentów”.
- Walidacja przesuwała się bliżej działań nieodwracalnych. Kilka systemów sprawdzało uprawnienia przed wykonaniem, weryfikowało pojedyncze kroki albo chroniło końcową odpowiedź.
- Zmiany napędzały nieudane ślady. Zwycięzca zamieniał nieudane uruchomienia w poprawki w treści prompt w zautomatyzowanej pętli; inne zespoły opisały podobnie konkretne poprawki narzędzi i prompts.
- Polityka kontekstu była decyzją architektoniczną. Zespoły próbowały destylacji, wstępnego ładowania, wyszukiwania i kompresji historii. Ich własne raporty nie zgadzają się co do tego, czy kompresja pomagała, więc nie ma uniwersalnego przepisu.
Pięć pouczających podejść
To nie jest pięć najlepszych w kolejności rankingu. Wybrałem je, bo ich publiczne opisy pokazują pięć różnych sposobów budowy systemu: automatyczne zmiany w treści prompt, wyspecjalizowane etapy, walidację każdego kroku, strażników odpowiedzi i izolację plan-execute.
| Zespół | Kontekst tabeli wyników | Opublikowany wynik |
|---|---|---|
| VZS9FL | Nagroda, 1. miejsce | 0.718 |
| Lcnxuy | Nagroda, 8. miejsce | 0.505 |
| NLN7Dw | Nagroda, 2. miejsce | 0.621 |
| J8Gvbi | Nagroda, 16. miejsce | 0.437 |
| 5qsp7i (key_concept_parallel) | Ultimate, 3. miejsce | 0.670 |
1. Ewolucyjne projektowanie tekstu prompt (zespół VZS9FL / @aostrikov)
Podejście z najwyższym wynikiem zautomatyzowało projektowanie tekstu prompt za pomocą pętli samodoskonalenia.
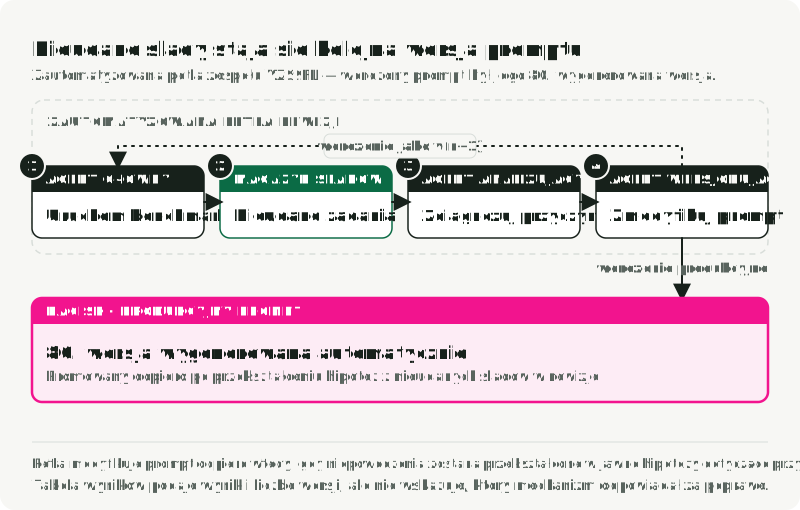
Zamiast ręcznie dostrajać produkcyjny prompt, zespół zbudował pętlę z trzema agentami, która zamieniała nieudane ślady w kandydatów na nowe wersje.
Potok z trzema agentami:
| Agent | Rola |
|---|---|
| Main Agent | Uruchamia benchmark, zapisuje wszystkie działania i błędy |
| Analyzer Agent | Przegląda nieudane zadania, formułuje hipotezy o przyczynach |
| Versioner Agent | Generuje nową wersję tekstu prompt uwzględniającą wnioski |
Produkcyjny prompt był 80. automatycznie wygenerowaną wersją. Zespół opisuje pętlę jako analizę nieudanych zadań, proponowanie przyczyn i decydowanie, które sugestie uwzględnić. Tabela wyników potwierdza końcowy wynik i liczbę iteracji. Nie wyodrębnia, jaka część zysku wynika z automatyzacji, a jaka z modeli, narzędzi lub nagromadzonej informacji zwrotnej z benchmarku.
Stos: claude-opus-4.5 z Anthropic Python SDK i natywnym korzystaniem z narzędzi.
2. Wieloagentowy potok sekwencyjny (zespół Lcnxuy / @andrey_aiweapps)
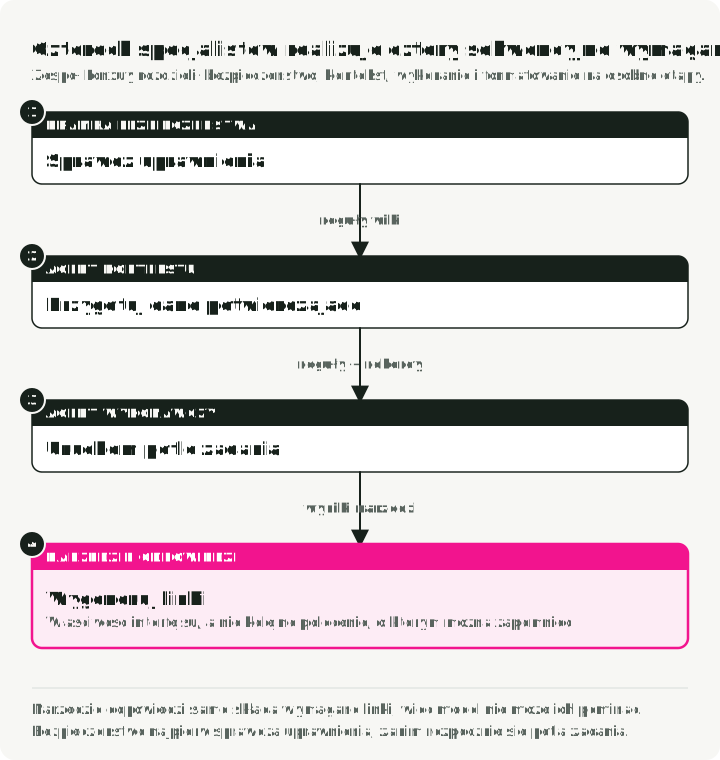
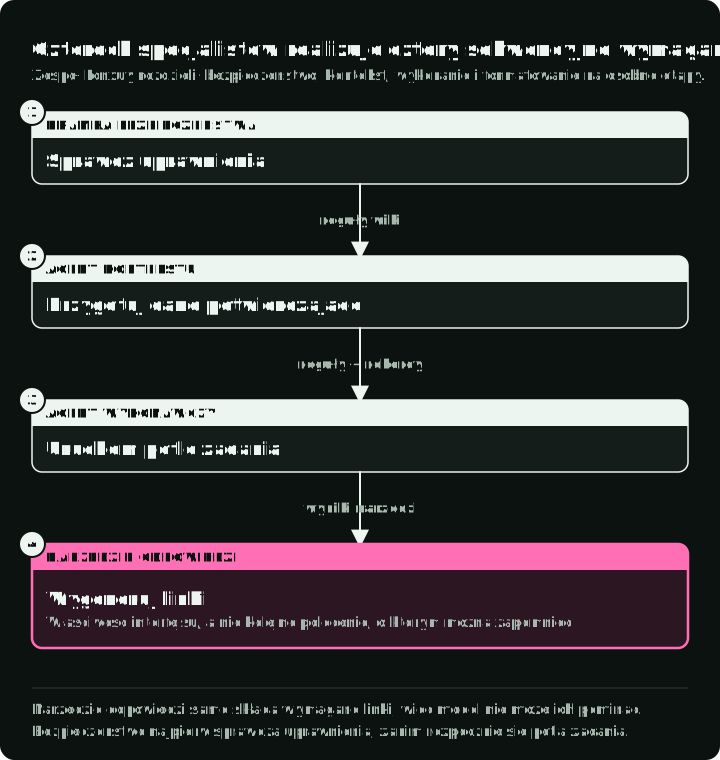
To zgłoszenie zbudowało sekwencyjny przepływ pracy, w którym wyspecjalizowane komponenty odpowiadały za kontrole bezpieczeństwa, wyciąganie kontekstu, wykonanie i formatowanie linków do encji.
Udokumentowane komponenty:
- Security Gate Agent: kontrola przed wykonaniem, która sprawdza uprawnienia względem reguł wiki, zanim ruszy główna pętla.
- Context Extraction Agent: wyciąga kluczowe reguły z system prompts dłuższych niż 500 linii i wstępnie ładuje dane użytkownika, projektu i klienta.
- Execution Agent: planowanie w stylu ReAct z 5 wewnętrznymi fazami (tożsamość → wykrywanie zagrożeń → zbieranie informacji → walidacja dostępu → wykonanie).
- LinkGeneratorAgent: osadzony w narzędziu odpowiedzi, analizuje kontekst, aby dołączyć wymagane linki do encji.
Według opisu zespołu LinkGeneratorAgent miał zapobiegać błędom brakujących linków: odpowiedziom z poprawnym tekstem, ale bez wymaganych linków do encji. To najłatwiejsza do przeniesienia część. Umieszczenie go w narzędziu odpowiedzi czyni wymaganie benchmarku (obowiązkowe linki do encji) własnością interfejsu, a nie kolejną instrukcją, o której model wykonujący może zapomnieć.
Stos: frameworki atomic-agents i instructor z gpt-5.1-codex-max, gpt-4.1 i claude-sonnet-4.5.
3. Schema-guided reasoning z walidacją kroków (zespół NLN7Dw / Ilia Ris)
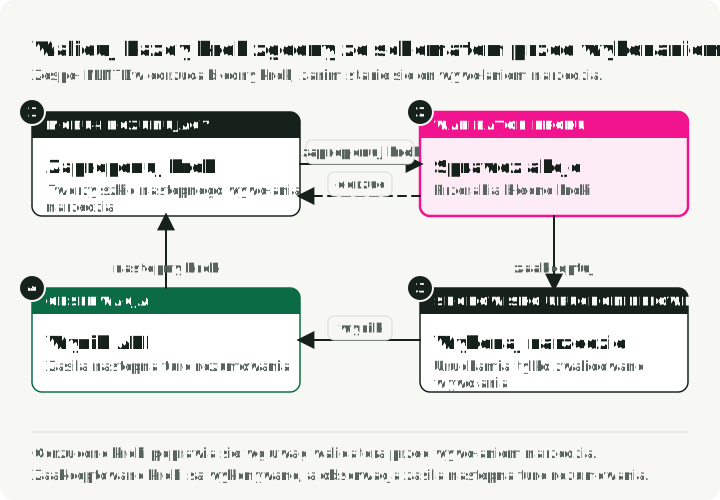
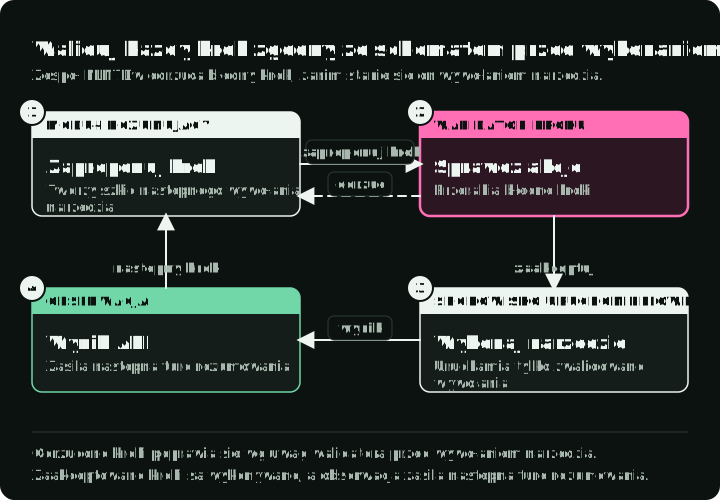
Schema-guided reasoning (SGR) każe modelowi w każdym kroku wypełnić stały schemat wyjścia, na przykład rozumowanie, plan i następne wywołanie narzędzia, dzięki czemu program może odczytać i sprawdzić każde pole. Artykuł o SGR na tym blogu pokazuje, jak wymusić taki schemat w vLLM. Ten zespół połączył SGR z szybką inferencją i walidatorem każdego proponowanego kroku. Taki projekt czyni poprawki tanimi: odrzuć błędny krok, zanim stanie się wywołaniem narzędzia, a potem poproś główny przepływ o jego przeróbkę z uwagami walidatora.
Kluczowe komponenty:
| Komponent | Funkcja |
|---|---|
| StepValidator | Sprawdza każdy proponowany krok. Jeśli coś jest nie tak, odsyła go do przeróbki z uwagami. |
| Zarządzanie kontekstem | Pełny plan z poprzedniej tury plus skompresowana historia starszych tur |
| Dynamiczne wzbogacanie | Automatycznie pobiera profil użytkownika, projekty, klientów; LLM filtruje, by dodać tylko dane istotne dla zadania |
| Wrappery automatycznej paginacji | Wszystkie endpointy list automatycznie zwracają pełne wyniki |
Zespół podał, że uruchamiał gpt-oss-120b na Cerebras z szybkością do około 3000 tokens na sekundę. Zespół połączył walidację z inferencją o wysokiej przepustowości, co mogło zmniejszyć jej koszt w opóźnieniu. Publiczny wynik nie wyodrębnia tego efektu.
Stos: zmodyfikowany agent NextStep, przykładowy agent SGR opublikowany dla ERC3.
4. System wzbogacaczy i strażników (zespół J8Gvbi / @mishka)
To zgłoszenie dodało do bazy SGR nieblokujące podpowiedzi i wielopoziomowy system strażników. Gdy wracały odpowiedzi API, wzbogacacze (enrichers) je analizowały i dodawały do późniejszego kontekstu wskazówki operacyjne. Strażnicy sprawdzali odpowiedź agenta przed jej wysłaniem.
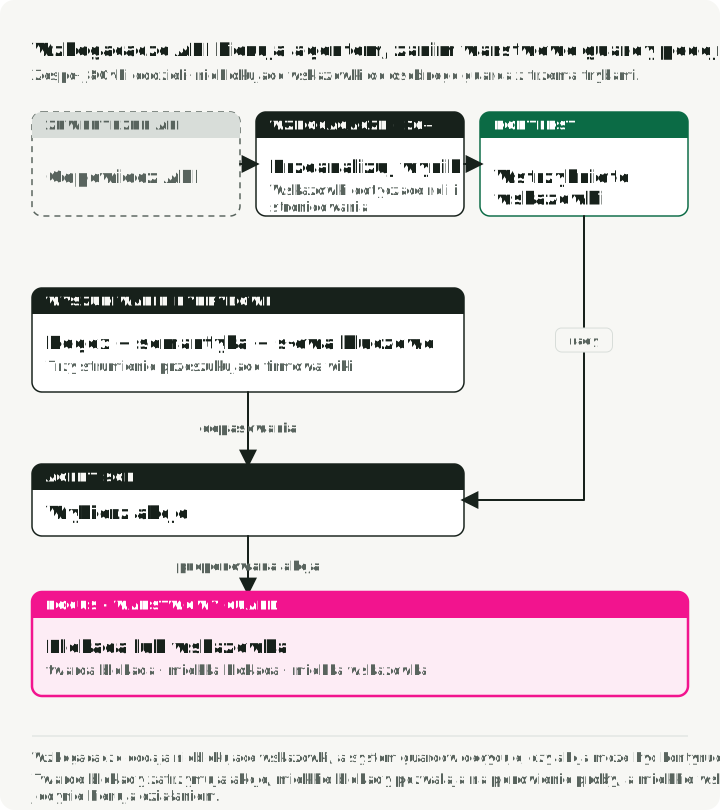
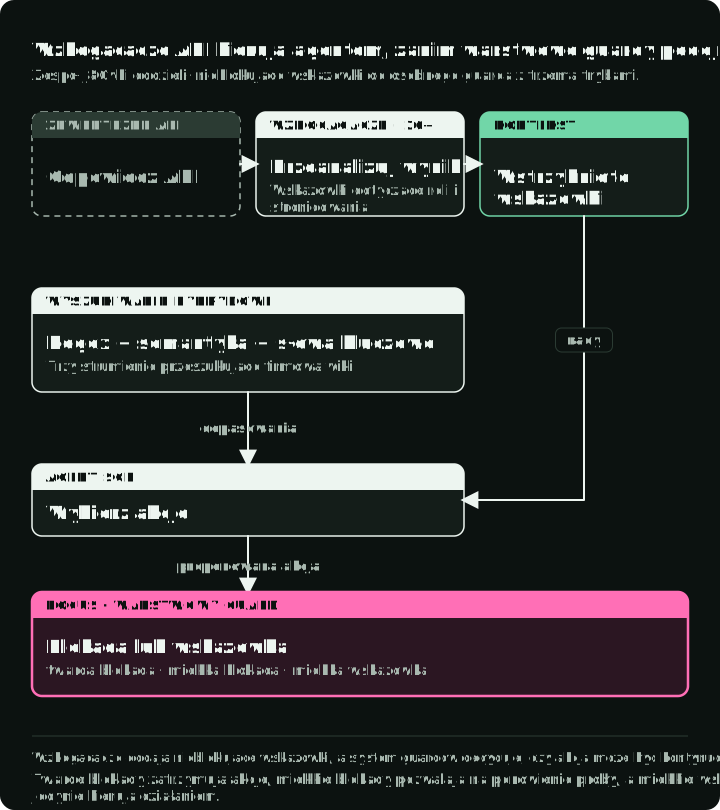
Ponad 20 wzbogacaczy analizowało odpowiedzi API i dodawało podpowiedzi kontekstowe:
RoleEnricher: "You are LEAD of this project, proceed with update."
PaginationHintEnricher: "next_offset=5 means MORE results! MUST paginate."
System strażników z trzema trybami:
| Tryb | Zachowanie |
|---|---|
| Hard block | Odpowiedź, która według danych API jest niemożliwa, na przykład wskazuje pracownika spoza zespołu projektu, zostaje odrzucona |
| Soft block | Ryzykowna odpowiedź zostaje raz odrzucona z ostrzeżeniem i jest przyjmowana, jeśli agent po tym ostrzeżeniu wyśle ją ponownie |
| Soft hint | Wskazówka jest dołączana bez blokowania |
Hybrydowa wiki RAG: zespół przeszukiwał lokalną kopię firmowej wiki na trzy sposoby: regex dla uporządkowanych wzorców, takich jak salary|privacy, embeddings sentence-transformer dla dopasowań semantycznych oraz nakładanie się zbiorów tokens jako awaryjne wyszukiwanie słów kluczowych. Moja interpretacja, dlaczego trzy: regex znajduje dokładne nazwy pól i terminy, a embeddings znajdują reguły sformułowane inaczej niż pytanie.
Stos: qwen/qwen3-235b-a22b-2507 na frameworku SGR opartym na LangChain.
5. Plan-execute REPL (zespół 5qsp7i / key_concept_parallel)
Ta architektura trzymała planowanie i pisanie kodu w osobnych wywołaniach modelu. Wygenerowany kod Pythona działa w REPL (read-eval-print loop), czyli sesji Pythona, która zachowuje zmienne między krokami. Pojawiła się w szerszej tabeli Ultimate, a nie w zamrożonej piątce najlepszych zgłoszeń do nagrody. Jej publiczny opis i tak jest przydatny, bo pokazuje inną formę dekompozycji: izolację według fazy wykonania, a nie według roli biznesowej.
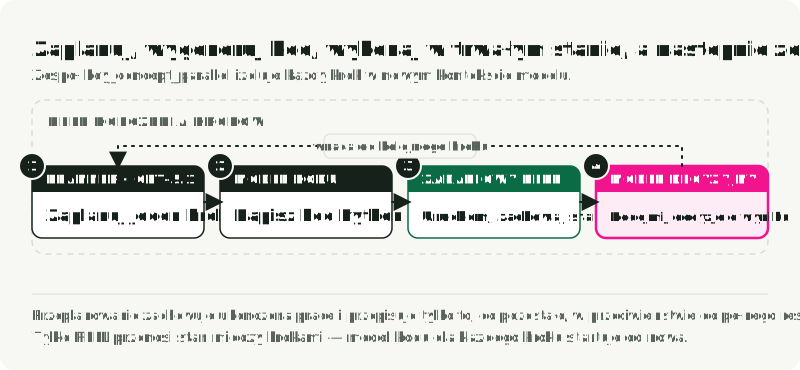
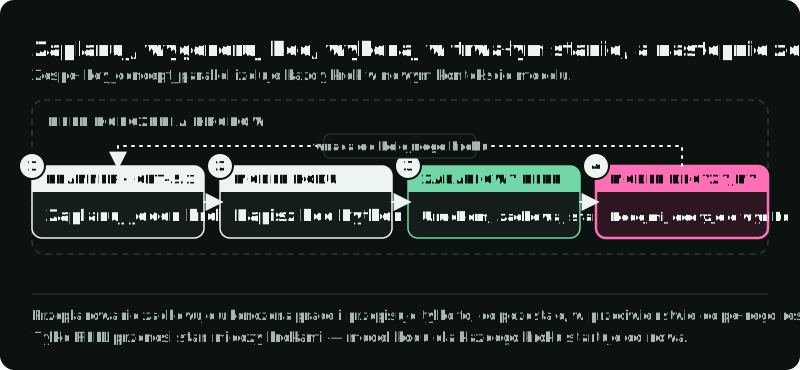
Różne modele wykonywały różne zadania: jeden planował, drugi pisał kod Pythona, a osobny model decyzyjny wybierał, co zrobić po każdym kroku.
Konfiguracja z wieloma modelami:
| Etap | Model |
|---|---|
| Planowanie | openai/gpt-5.1 |
| Generowanie kodu | deepseek/deepseek-v3.2 |
| Decyzja po kroku | openai/gpt-4.1 |
| Odpowiedź końcowa | openai/gpt-4.1 |
REPL ukończenia kroku:
- Planista tworzy krok wysokiego poziomu.
- Model generujący kod pracuje w świeżym kontekście modelu i pisze dla tego kroku skrypt Pythona.
- Skrypt wykonuje się w REPL przypisanym do zadania, którego zmienne są zachowywane między krokami.
- Model decyzyjny patrzy na wynik i wybiera jeden z czterech wyników: kontynuować następnym krokiem, zakończyć, bo zadanie jest wykonane, przerwać, bo się nie udało, albo zaplanować od nowa.
Ścieżka ponownego planowania to pomysł wart ponownego użycia. Gdy wynik kroku pokazuje, że plan już nie pasuje, model decyzyjny może zachować ukończoną pracę i przepisać tylko pozostałe kroki planu. Na diagramie zakończenie sukcesem i porażką mają jedno wspólne wyjście do odpowiedzi końcowej.
Wzorce powtarzające się w zgłoszeniach
Implementacje się różniły, ale kilka kwestii inżynierskich pojawiało się w publicznych opisach wielokrotnie.
Zarządzanie kontekstem było jawne
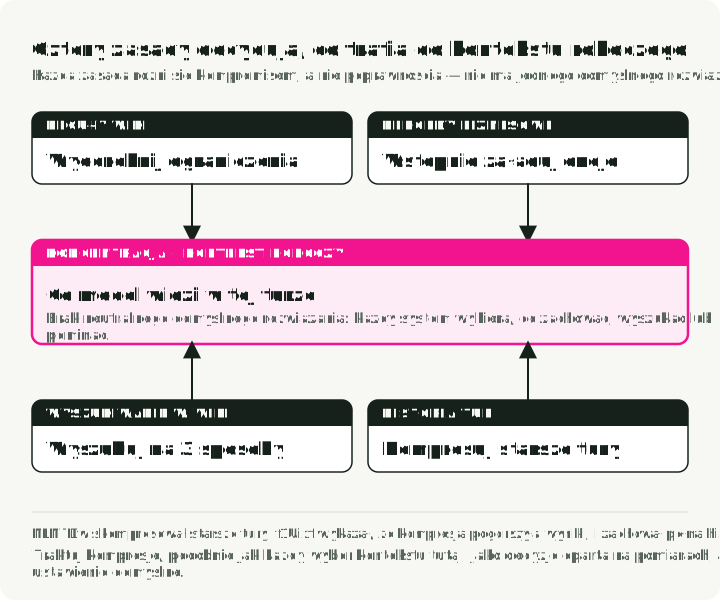
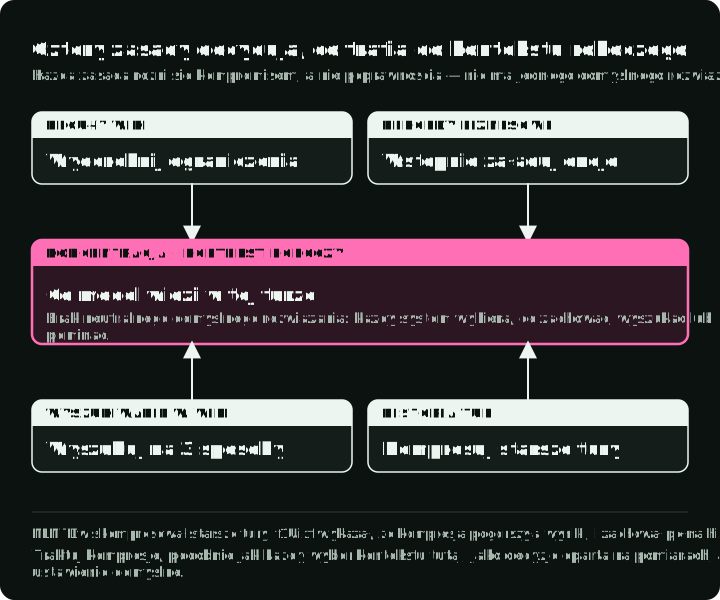
Żaden zespół nie mógł dać modelowi wszystkich reguł, rekordów i poprzednich kroków bez podjęcia decyzji o polityce. Systemy różniły się tym, gdzie filtrowały informacje: przed uruchomieniem, przy wyszukiwaniu albo w historii. Diagram dzieli kontekst modelu na cztery części i pokazuje, która polityka kontroluje każdą część, kiedy działa i które zespoły jej używały.
| Strategia | Podejście | Najlepsza do |
|---|---|---|
| Wyodrębnianie reguł | Wstępne przetworzenie reguł wiki na zwięzłe instrukcje z zachowaniem ograniczeń | Zwięzłych prompts, szybkiego startu |
| Wstępne ładowanie danych | Ładowanie danych użytkownika/projektu/klienta przed wykonaniem | Ograniczania liczby wywołań narzędzi |
| Hybrydowy RAG | Strumienie wyszukiwania: regex + semantyczne + słowa kluczowe | Złożonych potrzeb wyszukiwania |
| Kompresja historii | Ostatnie tury w całości, starsza historia skompresowana | Długich rozmów |
Kompromis: NLN7Dw kompresowało starsze tury, a f1Uixf podało, że kompresja historii szkodziła jego eksperymentom, i zachowało całą rozmowę. Traktuj kompresję jako zmierzony wybór, a nie ustawienie domyślne. Mocne zgłoszenia różniły się też rozmiarem tekstu prompt. Kc7F2N (3. miejsce w nagrodach) zachowało minimalne własne instrukcje, polegało na destylowanych regułach wiki, a narzędzia wyszukiwania zbudowało z użyciem embeddings. MMzXeM (4. miejsce w nagrodach) utrzymało główny prompt na poziomie 320 tokens i schowało całą wiki za narzędziem
ask_wiki, które korzystało z cache’owania kontekstu, by pozostać tanim.
Kontrole przed główną pętlą, w jej trakcie i po niej
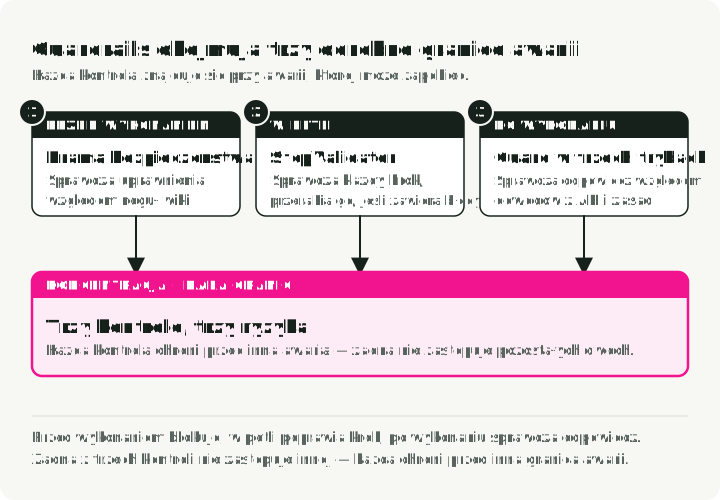
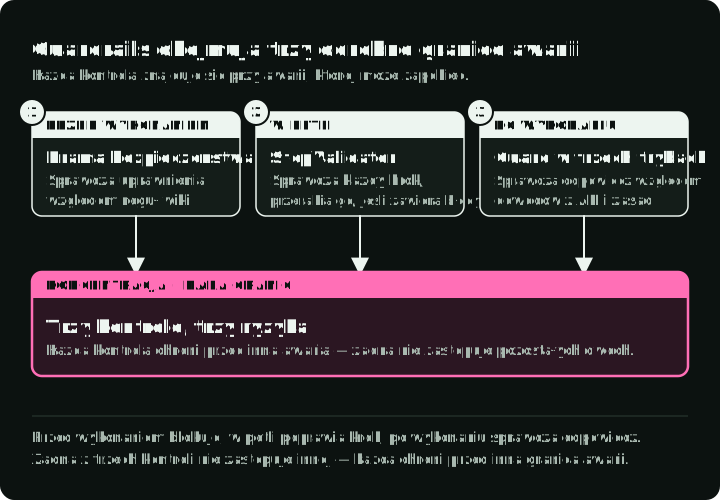
Kilka zespołów umieściło kontrole przed główną pętlą, w jej trakcie lub po niej. Te kontrole potrzebują innych danych na różnych etapach. Wspólna implementacja może je wykonywać, jeśli na każdym etapie otrzymuje właściwe dane wejściowe. Krytyk wywoływany tylko dla końcowej odpowiedzi nie może zapobiec wcześniejszemu nieautoryzowanemu wywołaniu narzędzia. Diagram umieszcza każdą kontrolę na osi czasu od zadania do oceny i pokazuje, co widzi oraz jakiemu błędowi zapobiega.
| Typ guardrail | Kiedy | Przykład |
|---|---|---|
| Kontrole przed wykonaniem | Przed startem głównej pętli | Security Gate Agent sprawdza uprawnienia względem reguł wiki |
| Walidatory w pętli | W trakcie rozumowania | StepValidator sprawdza każde proponowane działanie, w razie błędu wymusza przeróbkę |
| Strażnicy po wykonaniu | Przed końcowym wysłaniem | System strażników z trzema trybami sprawdza odpowiedź agenta względem danych API i polityki |
Wrappery narzędzi
Kilka zespołów zmieniło warstwę narzędzi widzianą przez model zamiast dodawać instrukcje o surowym API:
- Auto-paginacja: NLN7Dw usunęło paginację ze wszystkich narzędzi. Jedna funkcja przechodzi po wszystkich stronach i zwraca pełną listę.
- Rozmyta normalizacja: parsery narzędzi J8Gvbi odwzorowują ludzkie sformułowania na nazwy API, więc „Willingness to travel” staje się polem
will_travel. - Czyszczenie schematów: f1Uixf usunęło nieużywane pola ze schematów narzędzi i rozbudowało opisy parametrów. NLN7Dw przebudowało
Req_LogTimeEntry, jedyne narzędzie SDK, którego pola szły w innej kolejności, bo ta kolejność myliła model. - Narzędzia do rozumowania: xoDvsa (7. miejsce w nagrodach, 0.515) dodało narzędzia
plan,thinkicriticdo zwykłego agenta ReAct. Narzędzie critic zwraca ustrukturyzowane dane wyjściowe z dedykowanymi polami rozumowania.
Wrapper ukrywa paginację przed modelem: agent prosi o listę raz, a list_all podąża za next_offset, aż osiągnie wartość -1, oznaczającą koniec w oficjalnym przykładzie ERC3. Poniższy kod ilustruje krok 1 kolejności wdrażania na końcu tego artykułu; nie jest kodem żadnego zespołu. respond tworzy linki do encji na podstawie identyfikatorów pobranych przez agenta i odrzuca identyfikator, którego agent nigdy nie widział. Każdy link pochodzi więc z kodu, a wymyślony identyfikator zostaje odrzucony przed oceną.
# Stand-in for the benchmark API: 12 projects, 5 per page.
PROJECTS = [{"id": f"proj_{i}", "name": f"Project {i}"} for i in range(12)]

def call_api(endpoint: str, offset: int = 0, limit: int = 5) -> dict:
    page = PROJECTS[offset : offset + limit]
    more = offset + limit < len(PROJECTS)
    return {"items": page, "next_offset": offset + limit if more else -1}

def list_all(endpoint: str) -> list[dict]:
    """Follow next_offset until the API returns the terminal value -1."""
    items, offset = [], 0
    while offset != -1:
        page = call_api(endpoint, offset=offset)
        items.extend(page["items"])
        offset = page["next_offset"]
    return items

def respond(text: str, entity_ids: list[str], fetched: list[dict]) -> dict:
    """Build required links from IDs; refuse IDs the agent never fetched."""
    known = {row["id"] for row in fetched}
    unknown = [i for i in entity_ids if i not in known]
    if unknown:
        raise ValueError(f"unknown entity ids: {unknown}")
    return {"message": text, "links": [{"id": i} for i in entity_ids]}

projects = list_all("/projects/list")
assert len(projects) == 12  # three pages, one list
print(respond("You lead two projects.", ["proj_3", "proj_11"], projects))
Agent nigdy nie widzi granicy strony, a proj_11 z trzeciej strony jest poprawnym linkiem.
Rodzaje awarii i strukturalne poprawki zgłaszane przez zespoły
Opisy wielokrotnie wspominają awarie, w których agent wywołuje API albo stosuje politykę firmy. Najbardziej użyteczne poprawki przenosiły wymaganie do kodu lub do osobnego kroku walidacji:
| Rodzaj awarii | Opis | Poprawka architektoniczna |
|---|---|---|
| Obejście uprawnień | Wykonanie zastrzeżonych działań bez sprawdzenia uprawnień użytkownika | Security Gate Agent przed wykonaniem; obowiązkowa sekwencja tożsamość → uprawnienia → wykonanie |
| Brakujące linki do encji | Poprawna odpowiedź tekstowa, ale bez wymaganych linków referencyjnych | Osadzony LinkGeneratorAgent w narzędziu odpowiedzi |
| Niepełna paginacja | Przetworzenie tylko pierwszej strony wyników listy | Wrappery auto-paginacji dla wszystkich endpointów list |
| Pętle wywołań narzędzi | Powtarzane wywołania z drobnymi zmianami | Limity tur; czytelniejsze schematy narzędzi; wybór modelu przetestowany na rzeczywistym przepływie |
| Przeładowanie kontekstu | Wypełnianie kontekstu nieistotnymi sekcjami wiki | Destylacja reguł; dynamiczne filtrowanie kontekstu |
Dwa raporty uzupełniają wiersz o pętlach. f1Uixf widziało pętle wywołań narzędzi z GPT-5, ale nie z mniejszym modelem Qwen3. NLN7Dw ustawiło zbyt niski limit tur i 5 z 103 zadań nie zostało ukończonych, więc limit tur wymaga zapasu.
Praktyczna kolejność wdrażania
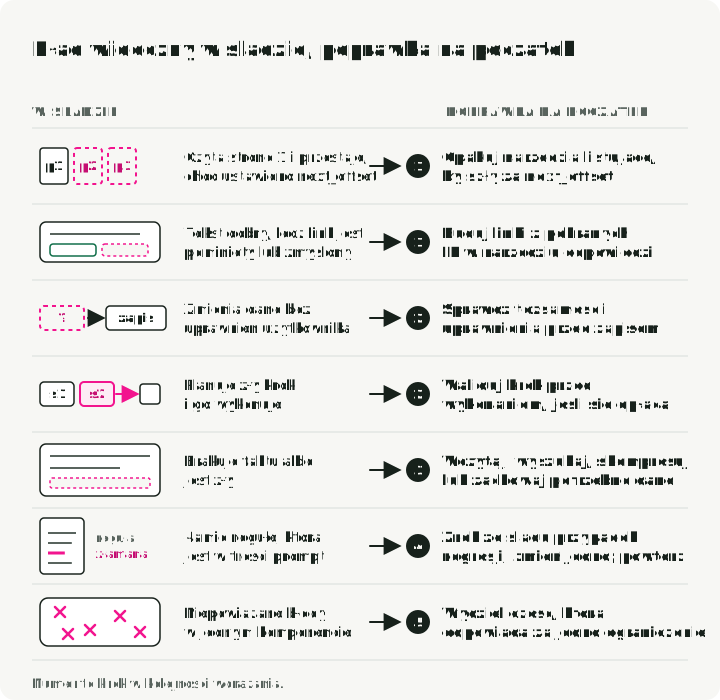
ERC3 to jedna symulowana firma, a nie ogólne badanie ablacyjne agentów. Używaj go jako źródła hipotez projektowych, a następnie testuj je na własnych śladach. Rozsądna kolejność wdrażania to:
- Najpierw zadbaj o deterministyczną poprawność API. Paginuj automatycznie endpointy list, normalizuj rozmyte pola, waliduj schematy i generuj wymagane linki wewnątrz narzędzia odpowiedzi.
- Dodaj kontrole tam, gdzie błąd jest kosztowny. Weryfikuj tożsamość i uprawnienia przed mutacją; waliduj krok przed wykonaniem tylko wtedy, gdy dodatkowe wywołanie modelu wychwytuje błędy warte swojego kosztu.
- Zapisz politykę kontekstu. Zdecyduj, co jest wstępnie ładowane, wyszukiwane, kompresowane albo zachowywane dosłownie. Mierz politykę według wycinków zadań, a nie samą liczbą tokens.
- Zamień nieudane ślady w przypadki regresji. Sklasyfikuj błąd, zmień jeden mechanizm i uruchom ponownie dotknięty wycinek. Automatyzuj zmiany w treści prompt dopiero wtedy, gdy ta pętla jest wiarygodna.
- Dziel na komponenty, gdy własność staje się jaśniejsza. Osobny komponent jest uzasadniony, gdy może odpowiadać za ograniczenie, używać innego modelu lub narzędzia albo być testowany niezależnie, a nie tylko dlatego, że „multi-agent” brzmi bardziej zaawansowanie.
Poniższy diagram zaczyna się od tego, co widać w śladzie, i wskazuje poprawkę do wypróbowania w pierwszej kolejności. Numery odpowiadają krokom powyżej.