Enterprise RAG Challenge 3 : enseignements tirés des soumissions publiques

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
L’Enterprise RAG Challenge 3 (ERC3) demandait à des agents d’accomplir des tâches métier via l’API d’une entreprise simulée. Le classement figé des prix est particulièrement instructif, car de nombreux participants ont publié davantage qu’un score : architecture, combinaison de modèles, coût et notes sur les échecs.
J’ai étudié ces descriptions publiques pour répondre à une question plus précise : quels choix de conception revenaient dans les soumissions performantes, et lesquels sont utiles au-delà de ce benchmark ?
Cet article s’adresse aux ingénieurs qui construisent des agents appelant des APIs métier. Vous y verrez cinq conceptions tirées des comptes rendus publics, les problèmes que chacune résolvait (permissions, pagination, liens manquants, taille du contexte) et un ordre dans lequel les essayer dans votre propre agent.
Qu’est-ce que l’Enterprise RAG Challenge ?
L’Enterprise RAG Challenge 3 est un projet de recherche participatif à grande échelle qui évalue la façon dont des agents AI autonomes gèrent des tâches métier complexes. Contrairement aux benchmarks statiques, ERC3 s’exécute sur l’Agentic Enterprise Simulation (AGES), une simulation à événements discrets qui expose une API d’entreprise réaliste.
Ce que teste le benchmark
Dans AGES, les agents travaillent au sein d’une entreprise fictive qui comprend :
- Des profils d’employés avec des compétences et des services précis
- Des projets avec des affectations d’équipe et des relations clients
- Un wiki d’entreprise avec des règles métier et des hiérarchies de permissions
- Le suivi du temps et les opérations financières
Chaque tâche lance une simulation isolée. Le wiki de l’entreprise est partagé, mais les données opérationnelles varient d’une tâche à l’autre : un agent ne peut donc pas réussir la suite en mémorisant l’état d’une seule entreprise.
Lire les scores comme un instantané
ERC3 expose désormais un classement figé de la compétition et un benchmark public qui a continué de recevoir des exécutions après l’événement. Ces deux pages répondent à des questions différentes. Les chiffres ci-dessous décrivent le classement des prix à la date limite de la compétition, et non les meilleures sessions ultérieures :
| Indicateur | Instantané de la compétition |
|---|---|
| Soumissions aux prix | 38 |
| Jeu de tâches | 103 tâches métier |
| Meilleur score des prix | 0.718 |
| Date limite des prix | 9 décembre 2025, 13 h 40 CET |
La page du benchmark en ligne peut afficher des scores plus élevés, car elle inclut les exécutions ultérieures. Le classement figé est donc la bonne source pour dire ce qui a gagné la compétition. Le classement Ultimate retient la meilleure exécution de chaque compte sans date limite de compétition ; ses scores ne sont donc pas comparables à ceux des prix.
Types de tâches
Les tâches couvrent plusieurs domaines de compétences :
- Le raisonnement multi-sauts, par exemple faire correspondre les compétences des employés aux affectations de projets.
- La validation des permissions, par exemple bloquer les modifications de salaire ou les accès aux données non autorisés.
- Les requêtes ambiguës, y compris les demandes multilingues et reformulées.
- Le respect strict du format de sortie, y compris les liens d’entités obligatoires dans les réponses.
Ce que suggèrent les soumissions
Les comptes rendus publics ne permettent pas de trancher nettement, par exemple en faveur de « multi-agent bat agent unique ». L’entrée classée quatrième aux prix, MMzXeM, était un agent unique avec des outils correspondant 1:1 aux endpoints de l’API, un outil ask_wiki et un system prompt de 320 tokens. En revanche, ces comptes rendus appuient quatre observations plus modestes :
- Les équipes ont isolé un composant lorsqu’il portait une exigence que les agents ratent sans cesse : une vérification de permission, la validation d’étapes, l’exécution de code ou les liens d’entités. Elles ne l’ont pas fait selon des « rôles d’agents » arbitraires.
- La validation s’est rapprochée des actions irréversibles. Plusieurs systèmes vérifiaient les permissions avant l’exécution, relisaient chaque étape ou contrôlaient la réponse finale.
- Les traces en échec ont guidé les changements. Le vainqueur a converti des exécutions échouées en révisions de prompt grâce à une boucle automatisée ; d’autres équipes ont documenté des correctifs d’outils et de prompts tout aussi concrets.
- La politique de contexte était un choix d’architecture. Les équipes ont essayé la distillation, le préchargement, la recherche et la compression de l’historique. Leurs propres rapports ne s’accordent pas sur l’utilité de la compression : il n’existe donc pas de recette universelle.
Cinq approches instructives
Ce ne sont pas les cinq premières dans l’ordre du classement. Je les ai choisies parce que leurs descriptions publiques exposent cinq façons distinctes de construire le système : la révision automatisée du prompt, les étapes spécialisées, la validation à chaque étape, les guards sur la réponse et l’isolation plan-execute.
| Équipe | Contexte du classement | Score publié |
|---|---|---|
| VZS9FL | Prix, 1er | 0.718 |
| Lcnxuy | Prix, 8e | 0.505 |
| NLN7Dw | Prix, 2e | 0.621 |
| J8Gvbi | Prix, 16e | 0.437 |
| 5qsp7i (key_concept_parallel) | Ultimate, 3e | 0.670 |
1. Prompt engineering évolutionnaire (équipe VZS9FL / @aostrikov)
L’approche ayant obtenu le meilleur score a automatisé le prompt engineering grâce à une boucle d’auto-amélioration.
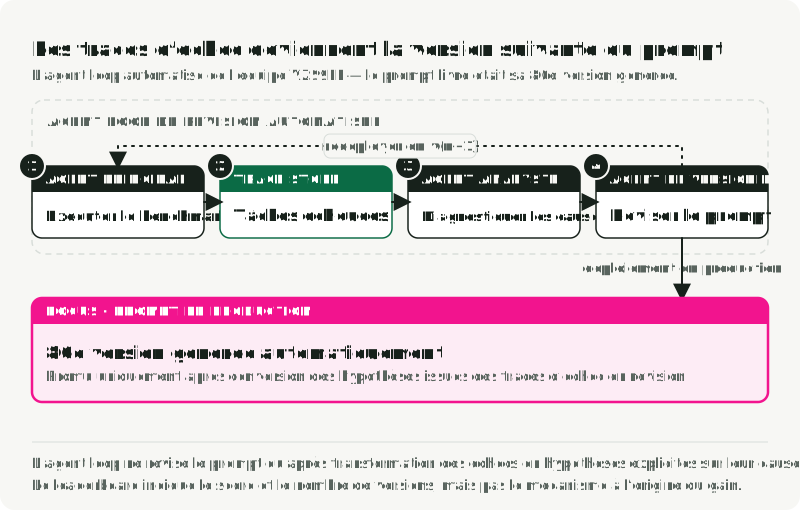
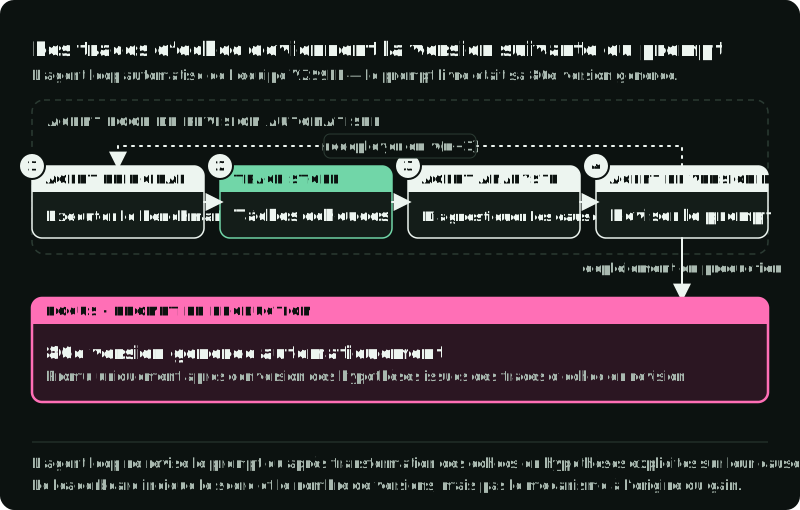
Au lieu d’ajuster à la main le prompt de production, l’équipe a construit une boucle de trois agents qui transformait les traces en échec en révisions candidates.
Pipeline à trois agents :
| Agent | Rôle |
|---|---|
| Agent principal | Exécute le benchmark, journalise toutes les actions et tous les échecs |
| Agent analyseur | Examine les tâches échouées, formule des hypothèses sur les causes profondes |
| Agent versionneur | Génère une nouvelle version du prompt qui intègre les enseignements |
Le prompt de production était la 80e version générée automatiquement. L’équipe décrit la boucle comme l’analyse des tâches échouées, la proposition de causes et le choix des suggestions à intégrer. Le classement établit le score final et le nombre d’itérations. Il n’isole pas la part du gain qui vient de l’automatisation plutôt que des modèles, des outils ou des retours accumulés du benchmark.
Stack : claude-opus-4.5 avec le SDK Python d’Anthropic et le tool use natif.
2. Pipeline séquentiel multi-agent (équipe Lcnxuy / @andrey_aiweapps)
Cette soumission a construit un workflow séquentiel dans lequel des composants spécialisés se chargeaient des contrôles de sécurité, de l’extraction du contexte, de l’exécution et de la mise en forme des liens d’entités.
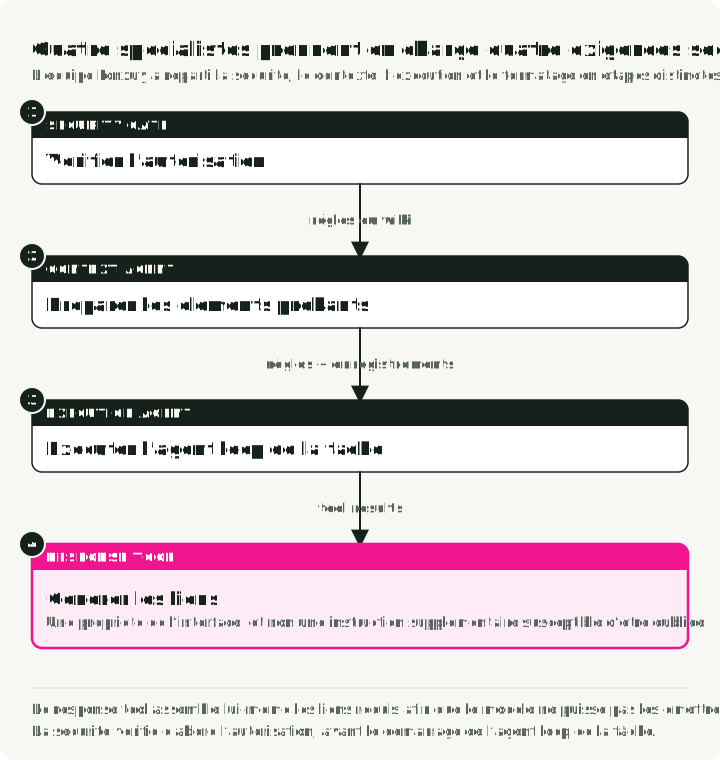
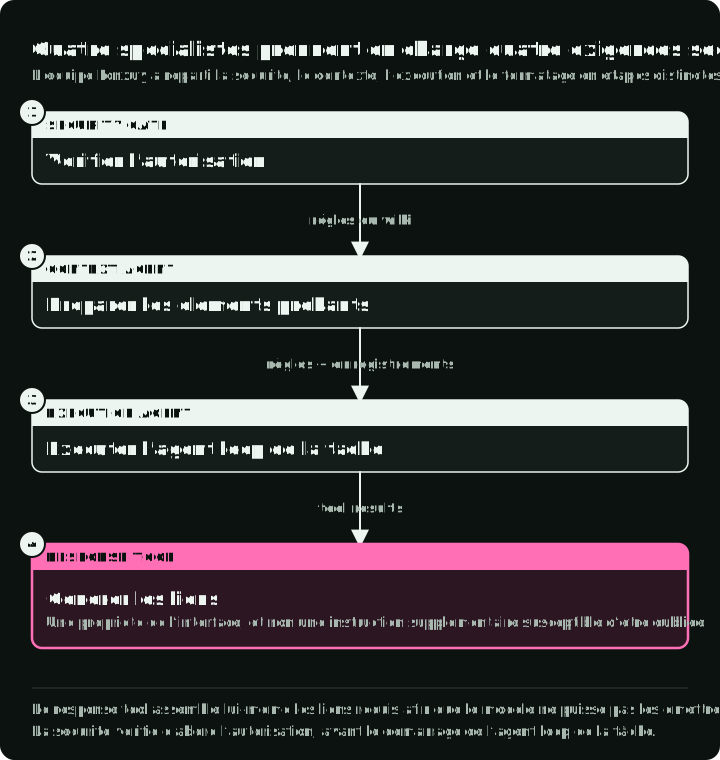
Les composants documentés :
- Security Gate Agent : vérification préalable à l’exécution, qui valide les permissions d’après les règles du wiki avant le lancement de la boucle principale.
- Context Extraction Agent : extrait les règles essentielles de system prompts de plus de 500 lignes et précharge les données de l’utilisateur, du projet et du client.
- Execution Agent : planification de type ReAct en 5 phases internes (Identité → Détection des menaces → Collecte d’informations → Validation des accès → Exécution).
- LinkGeneratorAgent : intégré à l’outil de réponse, il analyse le contexte pour inclure les liens d’entités requis.
Selon le compte rendu de l’équipe, le LinkGeneratorAgent servait à éviter les échecs par liens manquants : des réponses dont le texte était correct, mais sans les liens d’entités requis. C’est la partie la plus transposable. En l’intégrant à l’outil de réponse, on transforme une exigence du benchmark (les liens d’entités obligatoires) en propriété de l’interface, au lieu d’en faire une instruction de plus que le modèle d’exécution peut oublier.
Stack : les frameworks atomic-agents et instructor avec gpt-5.1-codex-max, gpt-4.1 et claude-sonnet-4.5.
3. Raisonnement guidé par schéma avec validation des étapes (équipe NLN7Dw / Ilia Ris)
Le raisonnement guidé par schéma (SGR) oblige le modèle à remplir, à chaque étape, un schéma de sortie fixe, par exemple son raisonnement, un plan et le prochain tool call, afin que le programme puisse lire et vérifier chaque champ. L’article sur le SGR de ce blog montre comment imposer un tel schéma avec vLLM. Cette équipe a associé le SGR à une inférence rapide et à un validateur sur chaque étape proposée. Cette conception rend la révision peu coûteuse : on rejette une étape défectueuse avant qu’elle ne devienne un tool call, puis on demande au flux principal de la retravailler avec les commentaires du validateur.
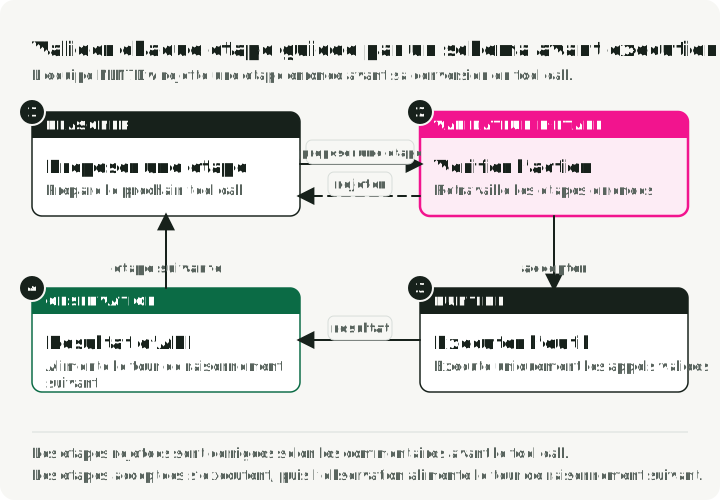
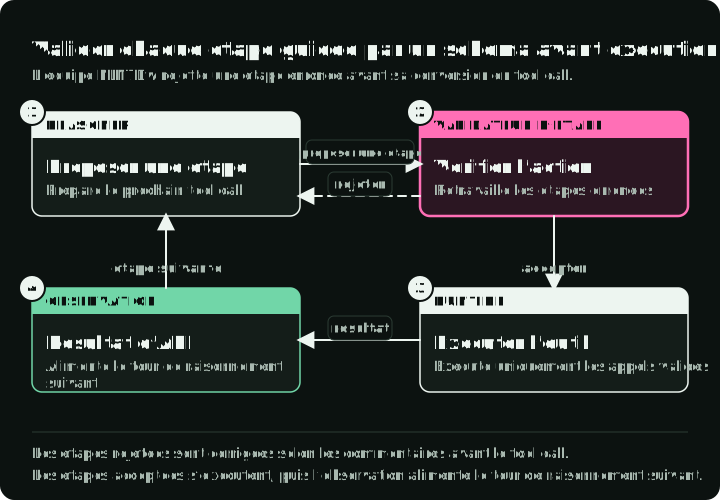
Composants clés :
| Composant | Fonction |
|---|---|
| StepValidator | Inspecte chaque étape proposée. En cas d’anomalie, la renvoie pour révision avec des commentaires. |
| Gestion du contexte | Plan complet du tour précédent, plus un historique compressé pour les tours plus anciens |
| Enrichissement dynamique | Récupère automatiquement profil utilisateur, projets et clients ; un LLM filtre pour n’injecter que l’utile à la tâche |
| Wrappers d’auto-pagination | Tous les endpoints de liste renvoient automatiquement des résultats complets |
L’équipe a indiqué avoir exécuté gpt-oss-120b sur Cerebras à environ 3 000 tokens par seconde au maximum. Elle a associé la validation à une inférence à haut débit, ce qui a peut-être réduit le coût de latence. Le résultat public n’isole pas cet effet.
Stack : un agent NextStep modifié, l’agent d’exemple SGR publié pour ERC3.
4. Système d’enrichissement et de guards (équipe J8Gvbi / @mishka)
Cette soumission a ajouté à une base SGR des indications non bloquantes et un système de guards à plusieurs niveaux. Au fur et à mesure que les réponses de l’API revenaient, des enrichers les inspectaient et ajoutaient des consignes opérationnelles au contexte suivant. Les guards contrôlaient la réponse de l’agent avant son envoi.
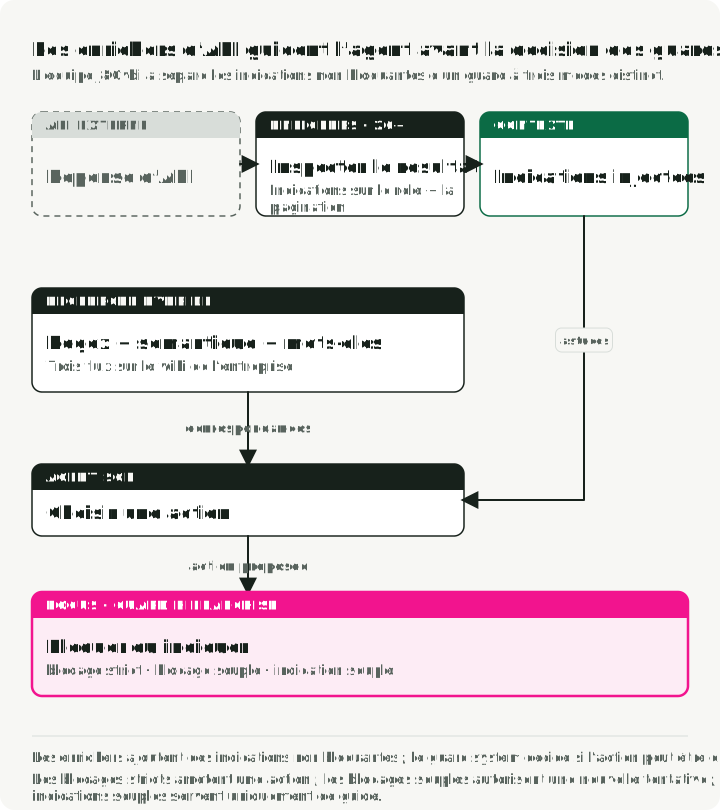
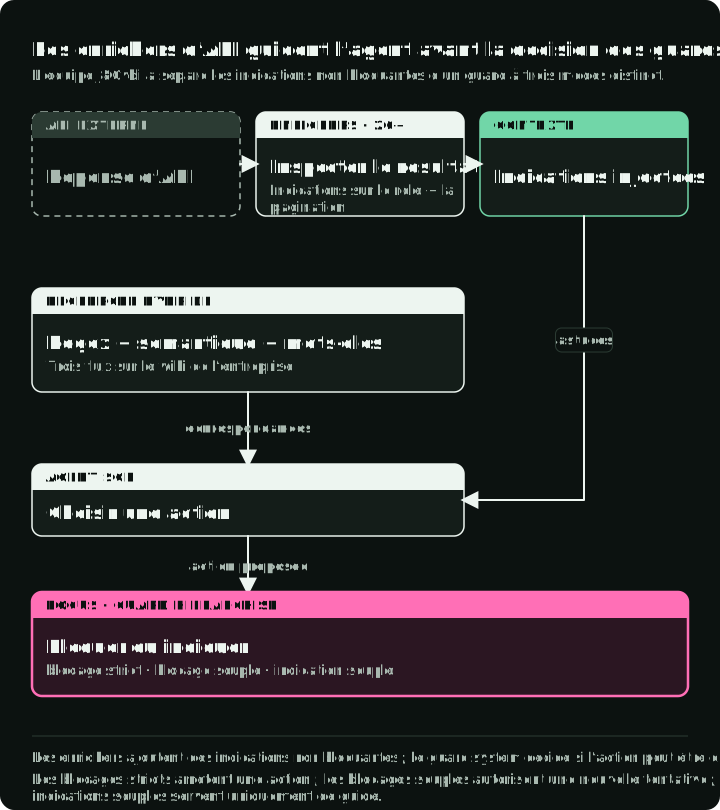
Plus de 20 enrichers inspectaient les réponses de l’API et injectaient des indications contextuelles :
RoleEnricher: "You are LEAD of this project, proceed with update."
PaginationHintEnricher: "next_offset=5 means MORE results! MUST paginate."
Système de guards à trois modes :
| Mode | Comportement |
|---|---|
| Blocage strict | Une réponse que les données de l’API montrent impossible, par exemple qui nomme un employé extérieur à l’équipe du projet, est rejetée |
| Blocage souple | Une réponse risquée est rejetée une fois avec un avertissement, puis acceptée si l’agent la soumet de nouveau après cet avertissement |
| Indication souple | Une consigne est ajoutée sans blocage |
Wiki RAG hybride : l’équipe interrogeait une copie locale du wiki de l’entreprise de trois façons : des regex pour les motifs structurés comme salary|privacy, des embeddings de sentence-transformer pour les correspondances sémantiques et le recoupement de tokens comme recours par mots-clés. Mon interprétation de ces trois voies : les regex trouvent les noms de champs et les termes exacts, et les embeddings trouvent les règles formulées autrement que la question.
Stack : qwen/qwen3-235b-a22b-2507 sur le framework SGR de LangChain.
5. REPL plan-execute (équipe 5qsp7i / key_concept_parallel)
Cette architecture séparait la planification et l’écriture du code dans des appels de modèle distincts. Le Python généré s’exécute dans un REPL (read-eval-print loop) : une session Python qui conserve ses variables d’une étape à l’autre. Elle figure dans le classement Ultimate, plus large, et non dans le top cinq figé des prix. Sa description publique reste utile, car elle montre une autre forme de décomposition : une isolation par phase d’exécution plutôt que par rôle métier.
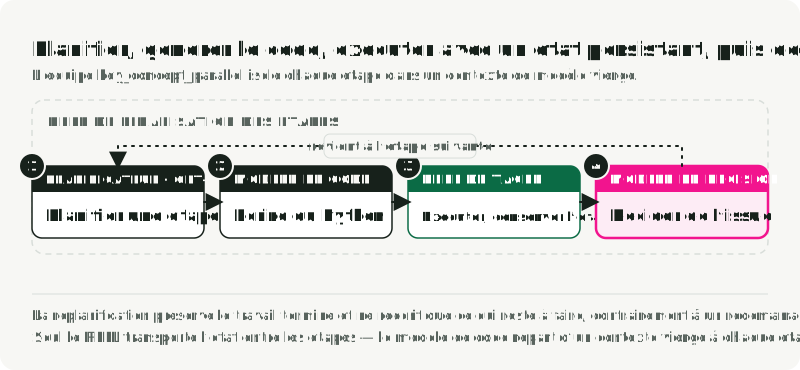
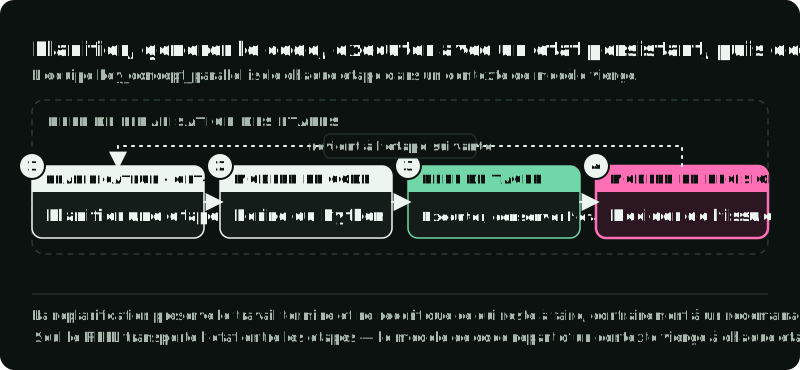
Des modèles différents se partageaient les tâches : l’un planifiait, l’autre écrivait le Python, et un modèle de décision distinct choisissait quoi faire après chaque étape.
Configuration multi-modèle :
| Étape | Modèle |
|---|---|
| Planification | openai/gpt-5.1 |
| Génération de code | deepseek/deepseek-v3.2 |
| Décision après l’étape | openai/gpt-4.1 |
| Réponse finale | openai/gpt-4.1 |
Le REPL de fin d’étape :
- Le planificateur crée une étape de haut niveau.
- Le modèle de génération de code, dans un contexte de modèle neuf, écrit pour elle un script Python.
- Le script s’exécute dans un REPL propre à la tâche, dont les variables persistent d’une étape à l’autre.
- Le modèle de décision examine le résultat et choisit l’une de quatre issues : continuer avec l’étape suivante, terminer parce que la tâche est faite, abandonner parce qu’elle a échoué, ou replanifier.
Le chemin de replanification est l’idée réutilisable. Quand le résultat d’une étape montre que le plan ne convient plus, le modèle de décision peut conserver le travail terminé et réécrire seulement les étapes restantes du plan. Dans le diagramme, « terminé » et « échoué » partagent une même sortie vers la réponse finale.
Les motifs récurrents dans les soumissions
Les implémentations différaient, mais plusieurs préoccupations d’ingénierie revenaient sans cesse dans les descriptions publiques.
La gestion du contexte était explicite
Aucune équipe ne pouvait donner au modèle toutes les règles, tous les enregistrements et toutes les étapes précédentes sans faire un choix de politique. Les systèmes différaient par l’endroit où ils filtraient l’information : avant l’exécution, à la recherche ou dans l’historique. Le diagramme découpe le contexte du modèle en quatre parties et montre quelle politique contrôle chacune, quand elle s’applique et quelles équipes l’ont utilisée.
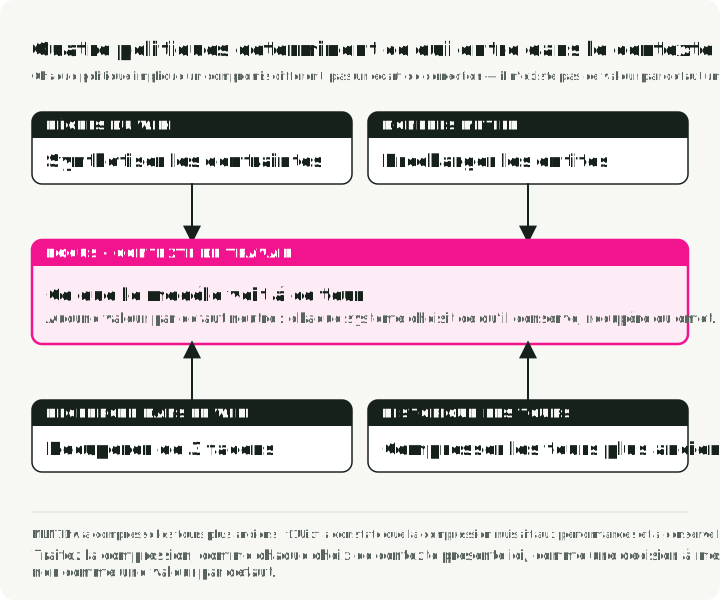
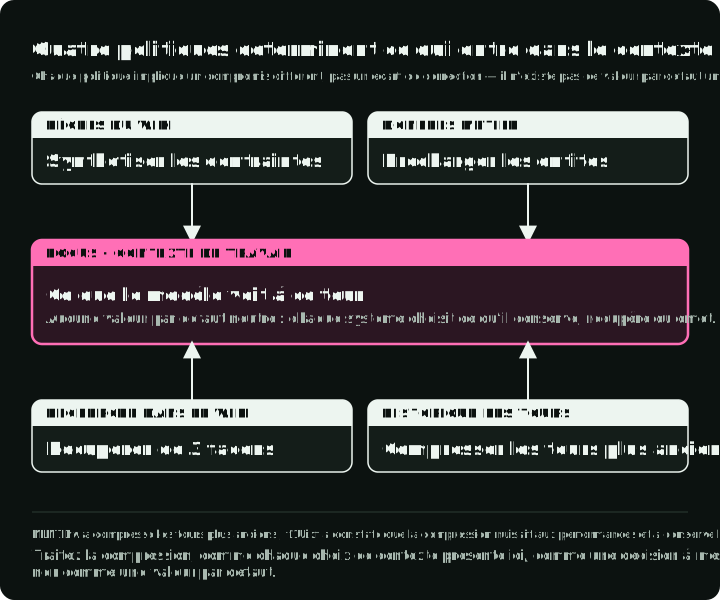
| Stratégie | Approche | Idéale pour |
|---|---|---|
| Distillation des règles | Prétraiter les règles du wiki en instructions compactes en préservant les contraintes | Prompts légers, démarrage rapide |
| Préchargement agressif | Charger les données utilisateur/projet/client avant l’exécution | Minimiser les tool calls |
| RAG hybride | Flux de recherche regex + sémantique + mots-clés | Besoins de recherche complexes |
| Compression de l’historique | Garder les tours récents en entier, compresser l’historique plus ancien | Conversations longues |
Compromis : NLN7Dw a compressé les anciens tours, tandis que f1Uixf a rapporté que la compression de l’historique avait nui à ses expériences et a gardé toute la conversation. Il faut traiter la compression comme un choix mesuré, pas comme un réglage par défaut. Les entrées solides différaient aussi par la taille du prompt. Kc7F2N (3e aux prix) gardait ses propres instructions minimales, s’appuyait sur des règles de wiki distillées et construisait ses outils de recherche sur des embeddings. MMzXeM (4e aux prix) limitait le prompt principal à 320 tokens et plaçait tout le wiki derrière son outil
ask_wiki, qui comptait sur le context caching pour rester peu coûteux.
Des contrôles avant, pendant et après la boucle principale
Plusieurs équipes ont placé des vérifications avant, pendant ou après la boucle principale. Ces vérifications nécessitent des données différentes à chaque étape. Une implémentation commune peut les effectuer si elle reçoit les bonnes entrées à chaque étape. Un critique appelé uniquement pour la réponse finale ne peut pas empêcher un tool call non autorisé survenu plus tôt. Le diagramme situe chaque vérification sur une frise allant de la tâche à l’évaluateur et montre ce qu’elle voit et le défaut qu’elle empêche.
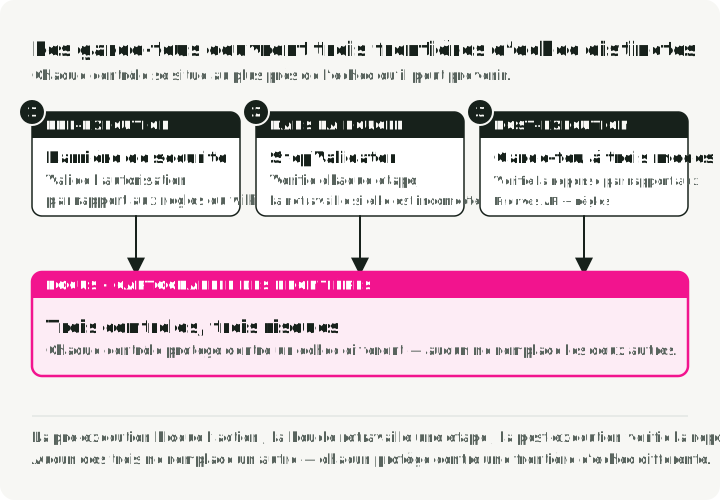
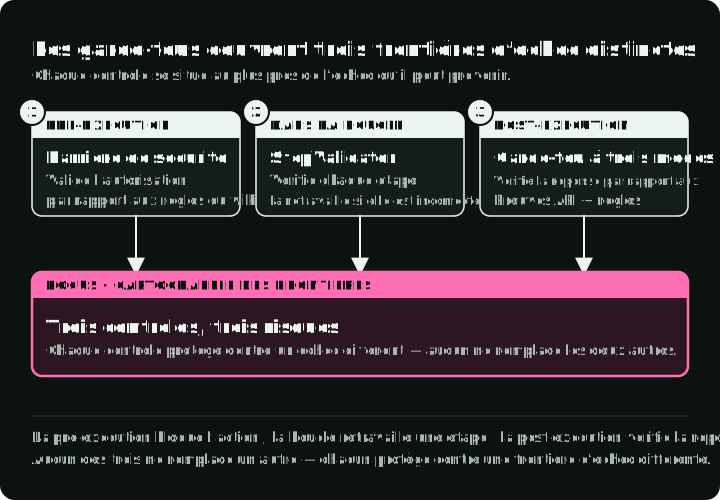
| Type de guardrail | Quand | Exemple |
|---|---|---|
| Contrôles pré-exécution | Avant le début de la boucle | Le Security Gate Agent valide les permissions d’après les règles du wiki |
| Validateurs dans la boucle | Pendant le raisonnement | Le StepValidator vérifie chaque action proposée et déclenche une révision si elle est défectueuse |
| Guards post-exécution | Avant la soumission finale | Le système de guards à trois modes compare la réponse de l’agent aux données de l’API et à la politique |
Wrappers d’outils
Plusieurs équipes ont modifié la couche d’outils que voit le modèle, au lieu d’ajouter des instructions sur l’API brute :
- Auto-pagination : NLN7Dw a retiré la pagination de chaque outil. Une seule fonction parcourt toutes les pages et renvoie la liste complète.
- Normalisation floue : les parseurs d’outils de J8Gvbi associent le vocabulaire humain aux noms de l’API, de sorte que « Willingness to travel » devient le champ
will_travel. - Nettoyage des schémas : f1Uixf a retiré les champs inutilisés des tool schemas et enrichi les descriptions des paramètres. NLN7Dw a reconstruit
Req_LogTimeEntry, le seul outil du SDK dont les champs arrivaient dans un autre ordre, parce que cet ordre troublait le modèle. - Outils de raisonnement : xoDvsa (7e aux prix, 0.515) a ajouté des outils
plan,thinketcriticà un simple agent ReAct. L’outil critic renvoie un structured output avec des champs de raisonnement dédiés.
Un wrapper masque la pagination au modèle : l’agent demande une liste une seule fois, et list_all suit next_offset jusqu’à la valeur -1, la valeur de fin utilisée dans l’exemple officiel ERC3. Le code ci-dessous illustre l’étape 1 de l’ordre d’adoption à la fin de cet article ; ce n’est le code d’aucune équipe. respond construit les liens vers les entités à partir des IDs que l’agent a récupérés et rejette un ID qu’il n’a jamais vu. Chaque lien vient donc du code, et un ID inventé est rejeté avant que l’évaluateur le voie.
# Stand-in for the benchmark API: 12 projects, 5 per page.
PROJECTS = [{"id": f"proj_{i}", "name": f"Project {i}"} for i in range(12)]

def call_api(endpoint: str, offset: int = 0, limit: int = 5) -> dict:
    page = PROJECTS[offset : offset + limit]
    more = offset + limit < len(PROJECTS)
    return {"items": page, "next_offset": offset + limit if more else -1}

def list_all(endpoint: str) -> list[dict]:
    """Follow next_offset until the API returns the terminal value -1."""
    items, offset = [], 0
    while offset != -1:
        page = call_api(endpoint, offset=offset)
        items.extend(page["items"])
        offset = page["next_offset"]
    return items

def respond(text: str, entity_ids: list[str], fetched: list[dict]) -> dict:
    """Build required links from IDs; refuse IDs the agent never fetched."""
    known = {row["id"] for row in fetched}
    unknown = [i for i in entity_ids if i not in known]
    if unknown:
        raise ValueError(f"unknown entity ids: {unknown}")
    return {"message": text, "links": [{"id": i} for i in entity_ids]}

projects = list_all("/projects/list")
assert len(projects) == 12  # three pages, one list
print(respond("You lead two projects.", ["proj_3", "proj_11"], projects))
L’agent ne voit jamais de limite de page, et proj_11, issu de la troisième page, est un lien valide.
Modes d’échec et corrections structurelles rapportées par les équipes
Les comptes rendus mentionnent à répétition des échecs où l’agent appelle l’API ou applique une politique de l’entreprise. Les correctifs les plus réutilisables ont déplacé l’exigence dans le code ou dans une étape de validation dédiée :
| Mode d’échec | Description | Correction architecturale |
|---|---|---|
| Contournement de permission | Exécuter des actions restreintes sans vérifier les permissions de l’utilisateur | Security Gate Agent pré-exécution ; séquence obligatoire Identité → Permissions → Exécution |
| Liens d’entités manquants | Réponse textuelle correcte, mais liens de référence requis absents | LinkGeneratorAgent intégré à l’outil de réponse |
| Pagination inachevée | Ne traiter que la première page des résultats d’une liste | Wrappers d’auto-pagination pour tous les endpoints de liste |
| Boucles de tool calls | Appels répétés avec de légères variations | Limites de tours ; tool schemas plus clairs ; choix du modèle testé sur le workflow réel |
| Surcharge du contexte | Remplir le contexte de sections de wiki sans rapport | Distillation des règles ; filtrage dynamique du contexte |
Deux rapports ajoutent des détails sur la ligne des boucles. f1Uixf a observé des boucles de tool calls avec GPT-5, mais pas avec le modèle Qwen3 plus petit. NLN7Dw a fixé sa limite de tours trop bas, et 5 tâches sur 103 ne se sont pas terminées : une limite de tours demande donc de la marge.
Un ordre d’adoption pratique
ERC3 est une seule entreprise simulée, pas une étude d’ablation générale sur les agents. Utilisez-le comme source d’hypothèses de conception, puis testez ces hypothèses sur vos propres traces. Un ordre d’adoption raisonnable est le suivant :
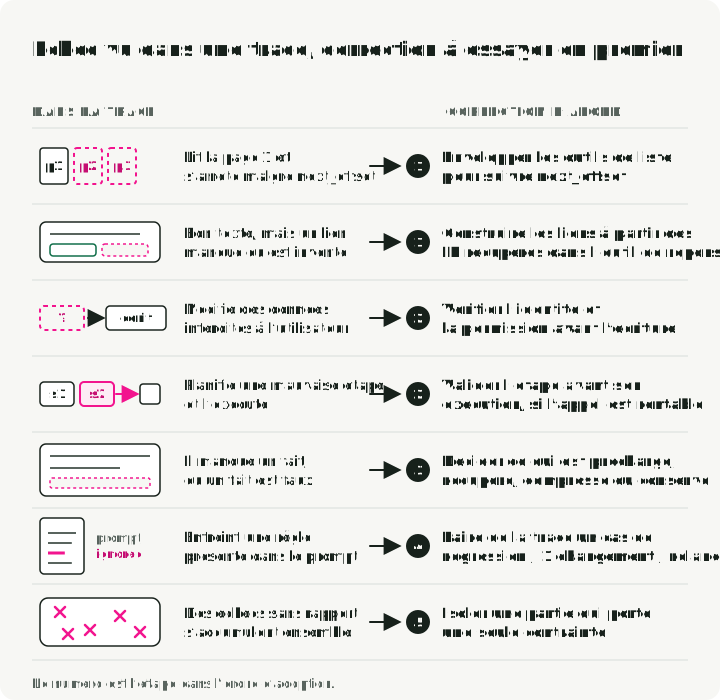
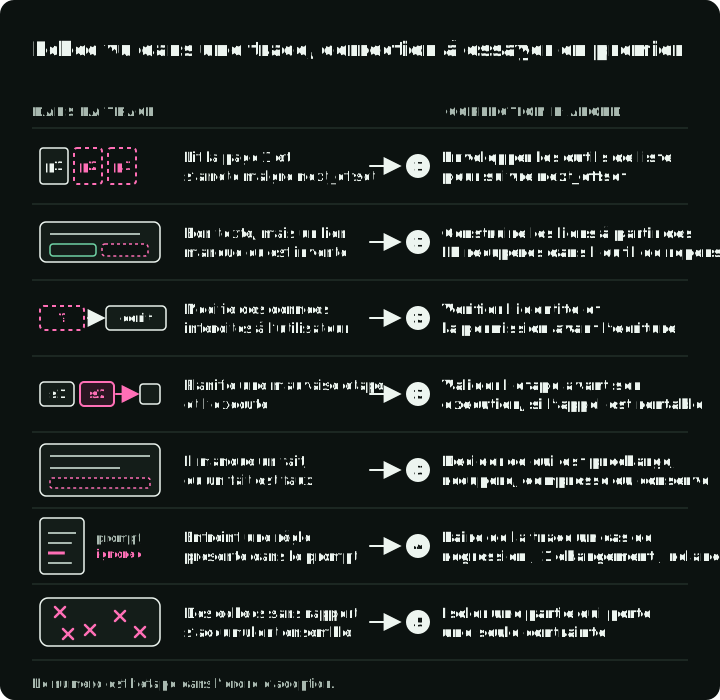
- Rendez d’abord l’exactitude de l’API déterministe. Paginez automatiquement les endpoints de liste, normalisez les champs flous, validez les schémas et générez les liens requis dans l’outil de réponse.
- Ajoutez des contrôles là où une erreur coûte cher. Vérifiez l’identité et la permission avant toute modification ; ne validez une étape avant exécution que si l’appel de modèle supplémentaire détecte des échecs qui valent son coût.
- Écrivez une politique de contexte. Décidez ce qui est préchargé, récupéré, compressé ou conservé tel quel. Mesurez la politique par tranche de tâches plutôt qu’au seul nombre de tokens.
- Transformez les traces en échec en cas de régression. Classez l’échec, changez un seul mécanisme et relancez la tranche concernée. N’automatisez la révision du prompt qu’une fois cette boucle fiable.
- Décomposez quand la responsabilité devient plus claire. Un composant séparé se justifie quand il peut porter une contrainte, utiliser un autre modèle ou outil, ou être testé indépendamment, et non simplement parce que « multi-agent » paraît plus capable.
La figure ci-dessous esquisse à quoi ressemble chaque échec dans une trace et pointe vers la correction à essayer en premier. Les numéros correspondent aux étapes ci-dessus.