Enterprise RAG Challenge 3: lessen uit openbare inzendingen

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Enterprise RAG Challenge 3 (ERC3) vroeg agents om zakelijke taken uit te voeren tegen de API van een gesimuleerd bedrijf. Het bevroren prijsklassement is ongewoon nuttig, omdat veel deelnemers meer publiceerden dan een score: architectuur, modelkeuze, kosten en notities over wat misging.
Ik heb die openbare beschrijvingen doorgenomen om een smallere vraag te beantwoorden: welke ontwerpkeuzes kwamen terug in sterke inzendingen, en welke daarvan zijn ook buiten deze benchmark bruikbaar?
Dit artikel is bedoeld voor engineers die agents bouwen die business-APIs aanroepen. Je ziet vijf ontwerpen uit de openbare verslagen, de problemen die elk ontwerp oploste (rechten, paginering, ontbrekende links, contextgrootte) en een volgorde waarin je ze in je eigen agent kunt uitproberen.
Wat is de Enterprise RAG Challenge?
De Enterprise RAG Challenge 3 is een grootschalig, gecrowdsourcet onderzoeksproject dat test hoe autonome AI agents omgaan met complexe zakelijke taken. In tegenstelling tot statische benchmarks draait ERC3 op de Agentic Enterprise Simulation (AGES), een discrete-eventsimulatie die een realistische bedrijfs-API beschikbaar stelt.
Wat de benchmark test
Via AGES werken agents binnen een nepbedrijf met:
- Medewerkersprofielen met specifieke vaardigheden en afdelingen
- Projecten met teamtoewijzingen en klantrelaties
- Een bedrijfswiki met bedrijfsregels en rechtenhiërarchieën
- Tijdregistratie en financiële handelingen
Elke taak start een geïsoleerde simulatie. De bedrijfswiki wordt gedeeld, maar de operationele gegevens verschillen per taak, dus een agent kan de testset niet oplossen door één bedrijfstoestand uit het hoofd te leren.
Lees de scores als momentopname
ERC3 toont nu zowel een bevroren wedstrijdklassement als een openbare benchmark die ook na het evenement runs bleef ontvangen. Die pagina’s beantwoorden verschillende vragen. De cijfers hieronder beschrijven het prijsklassement op het moment van de afsluiting van de wedstrijd, niet latere sessions met betere resultaten:
| Maatstaf | Momentopname van de wedstrijd |
|---|---|
| Prijsinzendingen | 38 |
| Takenset | 103 zakelijke taken |
| Hoogste prijsscore | 0.718 |
| Sluiting prijsronde | 9 december 2025, 13:40 CET |
De pagina van de live benchmark kan hogere scores tonen, omdat die ook latere runs bevat. Daarom is het bevroren klassement de juiste bron voor beweringen over wat de wedstrijd won. Het Ultimate-klassement neemt de beste run van elk account zonder de afsluiting van de wedstrijd, dus die scores zijn niet vergelijkbaar met prijsscores.
Soorten taken
De taken beslaan meerdere vaardigheidsgebieden:
- Multi-hop reasoning, zoals het koppelen van vaardigheden van medewerkers aan projecttoewijzingen.
- Rechtenvalidatie, zoals het blokkeren van ongeautoriseerde salariswijzigingen of toegang tot gegevens.
- Dubbelzinnige vragen, waaronder meertalige en geparafraseerde verzoeken.
- Strikte naleving van het uitvoerformaat, waaronder verplichte entiteitslinks in antwoorden.
Wat de inzendingen suggereren
De openbare verslagen ondersteunen geen eenduidig oordeel zoals “multi-agent verslaat single-agent”. De inzending op de vierde plaats in het prijsklassement, MMzXeM, was één agent met tools die 1:1 overeenkwamen met de API-endpoints, een ask_wiki-tool en een system prompt van 320 tokens. De verslagen ondersteunen wel vier smallere observaties:
- Teams splitsten een component af wanneer die één eis beheerde waar agents steeds op faalden: een rechtencontrole, stapvalidatie, code-uitvoering of entiteitslinks. Ze splitsten niet op basis van willekeurige “agentrollen”.
- Validatie verschoof naar onomkeerbare acties. Meerdere systemen controleerden rechten vóór de uitvoering, beoordeelden afzonderlijke stappen of bewaakten het eindantwoord.
- Mislukte traces stuurden de wijzigingen aan. De prijswinnaar zette mislukte runs om in prompt-herzieningen via een geautomatiseerde lus; andere teams documenteerden vergelijkbaar concrete verbeteringen aan tools en prompts.
- Contextbeleid was een architectuurkeuze. Teams probeerden distillatie, preloading, retrieval en geschiedeniscompressie. Hun eigen verslagen spreken elkaar tegen over de vraag of compressie hielp, dus er is geen universeel recept.
Vijf leerzame aanpakken
Dit zijn niet de eerste vijf in volgorde van ranglijst. Ik heb ze gekozen omdat hun openbare beschrijvingen vijf verschillende manieren laten zien om het systeem te bouwen: automatische promptherziening, gespecialiseerde stappen, validatie per stap, guards voor het antwoord en plan-execute-isolatie.
| Team | Context in klassement | Gepubliceerde score |
|---|---|---|
| VZS9FL | Prijs, 1e | 0.718 |
| Lcnxuy | Prijs, 8e | 0.505 |
| NLN7Dw | Prijs, 2e | 0.621 |
| J8Gvbi | Prijs, 16e | 0.437 |
| 5qsp7i (key_concept_parallel) | Ultimate, 3e | 0.670 |
1. Evolutionaire prompt engineering (Team VZS9FL / @aostrikov)
De aanpak met de hoogste score automatiseerde prompt engineering met een zelfverbeterende lus.
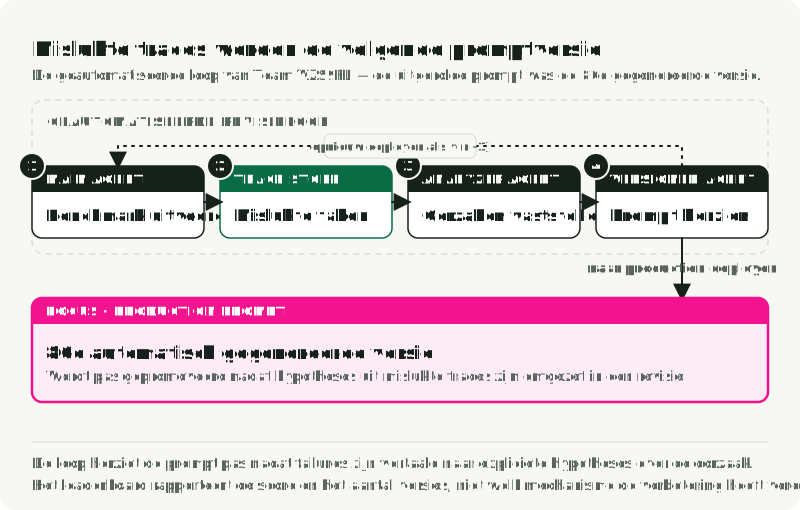
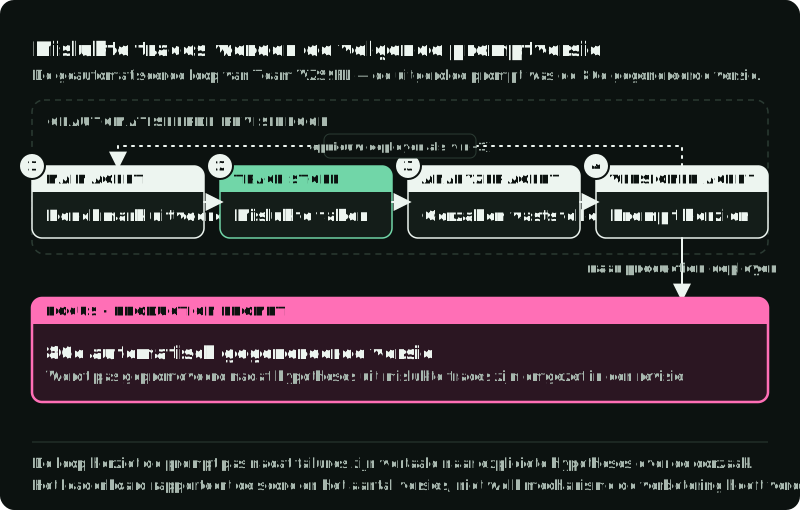
In plaats van de productieprompt met de hand af te stellen, bouwde het team een lus met drie agents die mislukte traces omzette in kandidaat-herzieningen.
Pipeline met drie agents:
| Agent | Rol |
|---|---|
| Main Agent | Draait de benchmark en logt alle acties en fouten |
| Analyzer Agent | Beoordeelt mislukte taken en formuleert hypotheses over de grondoorzaak |
| Versioner Agent | Genereert een nieuwe promptversie met de opgedane inzichten |
De productieprompt was de 80e automatisch gegenereerde versie. Het team beschrijft de lus als het analyseren van mislukte taken, het voorstellen van oorzaken en het beslissen welke suggesties worden overgenomen. Het klassement stelt de eindscore en het aantal iteraties vast. Het scheidt niet hoeveel van de winst kwam van de automatisering in plaats van van de models, de tools of de opgebouwde benchmarkfeedback.
Stack: claude-opus-4.5 met de Anthropic Python SDK en native tool use.
2. Sequentiële multi-agent-pipeline (Team Lcnxuy / @andrey_aiweapps)
Deze inzending bouwde een sequentiële workflow waarin gespecialiseerde componenten de beveiligingscontroles, contextextractie, uitvoering en opmaak van entiteitslinks verzorgden.
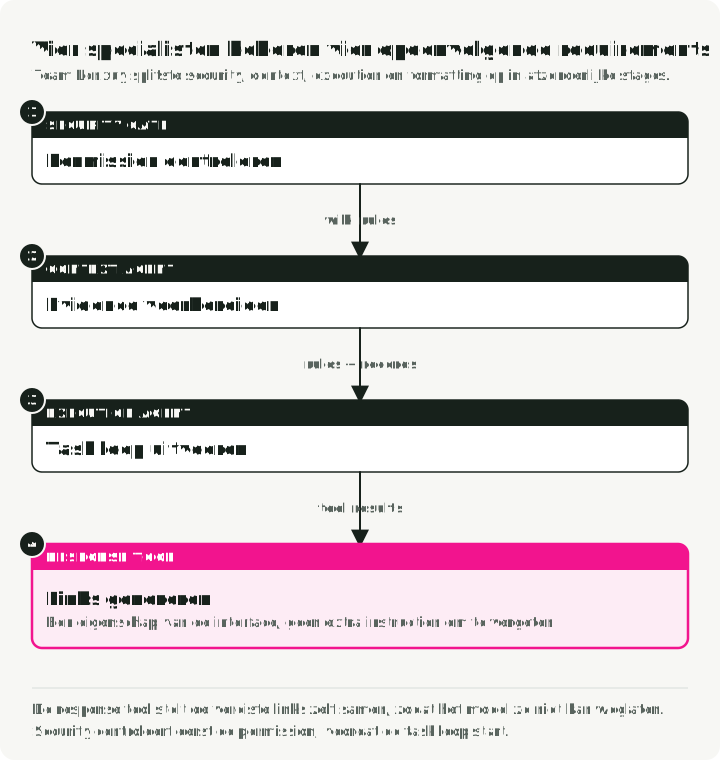
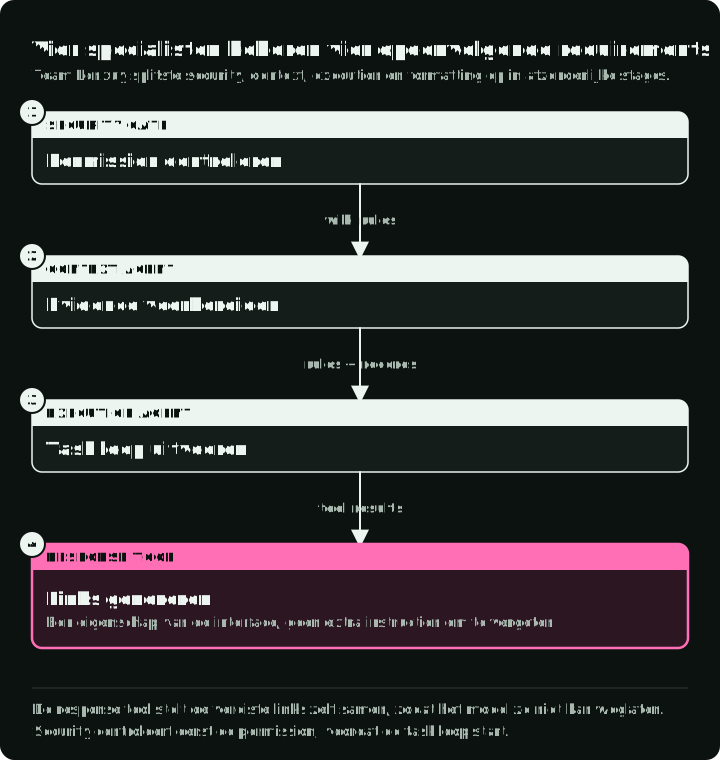
De gedocumenteerde componenten:
- Security Gate Agent: controle vóór de uitvoering die rechten valideert tegen de wikiregels voordat de hoofdlus draait.
- Context Extraction Agent: haalt de kritieke regels uit system prompts van meer dan 500 regels en laadt gebruikers-, project- en klantgegevens vooraf.
- Execution Agent: planning in ReAct-stijl met 5 interne fasen (identiteit → dreigingsdetectie → informatie verzamelen → toegangsvalidatie → uitvoering).
- LinkGeneratorAgent: ingebouwd in de response-tool; parset de context om de vereiste entiteitslinks op te nemen.
Volgens het verslag van het team diende de LinkGeneratorAgent om ontbrekende links te voorkomen: antwoorden met de juiste tekst maar zonder de vereiste entiteitslinks. Dit is het best overdraagbare onderdeel. Door de agent in de response-tool te plaatsen wordt een benchmarkeis (verplichte entiteitslinks) een eigenschap van de interface, in plaats van nog een instructie die het uitvoerende model kan vergeten.
Stack: de frameworks atomic-agents en instructor met gpt-5.1-codex-max, gpt-4.1 en claude-sonnet-4.5.
3. Schema-guided reasoning met stapvalidatie (Team NLN7Dw / Ilia Ris)
Schema-guided reasoning (SGR) laat het model bij elke stap een vast uitvoerschema invullen, bijvoorbeeld de reasoning, een plan en de volgende tool call, zodat het programma elk veld kan lezen en controleren. Het SGR-artikel op deze blog laat zien hoe je zo’n schema afdwingt met vLLM. Dit team combineerde SGR met snelle inference en een validator op elke voorgestelde stap. Dat ontwerp maakt herziening goedkoop: verwerp een gebrekkige stap voordat die een tool call wordt en laat de hoofdstroom hem opnieuw uitwerken met de opmerkingen van de validator.
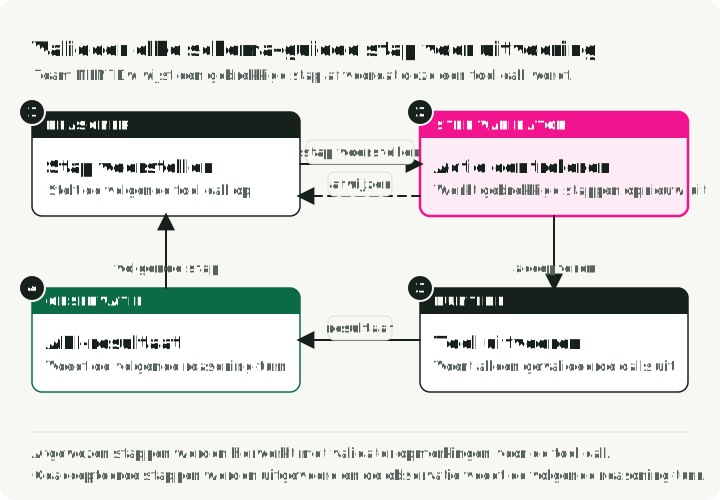
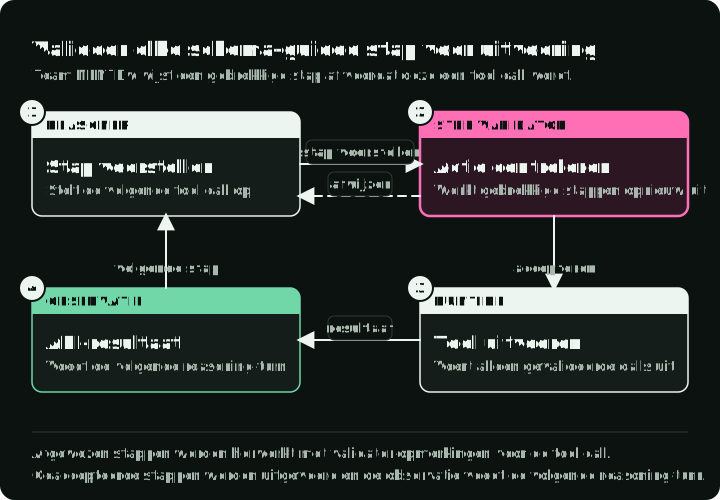
Belangrijkste componenten:
| Component | Functie |
|---|---|
| StepValidator | Inspecteert elke voorgestelde stap. Klopt er iets niet, dan gaat de stap met opmerkingen terug voor herwerking. |
| Contextbeheer | Volledig plan van de vorige beurt, plus gecomprimeerde geschiedenis voor oudere beurten |
| Dynamische verrijking | Haalt automatisch gebruikersprofiel, projecten en klanten op; een LLM filtert zodat alleen taakrelevante gegevens worden toegevoegd |
| Wrappers voor automatische paginering | Alle lijst-endpoints geven automatisch de volledige resultaten terug |
Het team meldde dat het gpt-oss-120b op Cerebras draaide met tot ongeveer 3.000 tokens per seconde. Het team combineerde validatie met inference met hoge throughput, wat de kosten in latency mogelijk heeft verlaagd. Het openbare resultaat scheidt dat effect niet.
Stack: een aangepaste NextStep-agent, de SGR-voorbeeldagent die voor ERC3 is gepubliceerd.
4. Enricher- en guardsysteem (Team J8Gvbi / @mishka)
Deze inzending voegde niet-blokkerende hints en een gelaagd guardsysteem toe aan een SGR-basis. Naarmate API-antwoorden binnenkwamen, inspecteerden enrichers ze en voegden ze operationele aanwijzingen toe aan de latere context. De guards controleerden het antwoord van de agent voordat het werd ingediend.
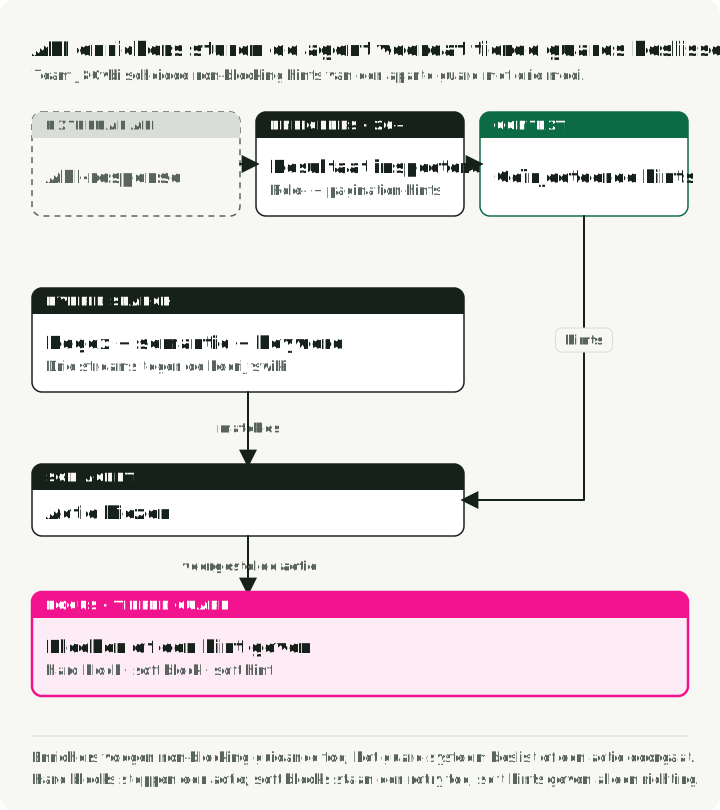
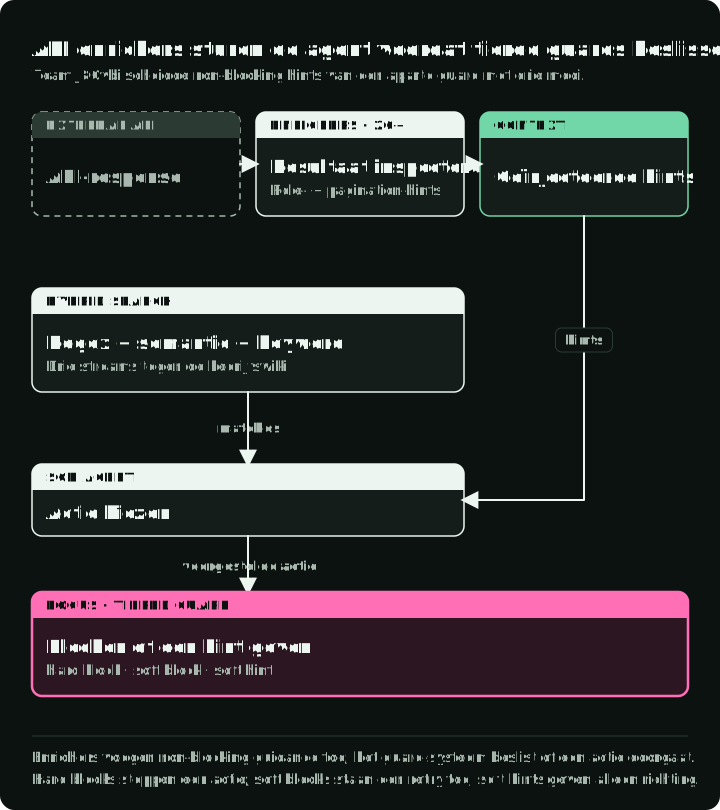
Meer dan 20 enrichers inspecteerden API-antwoorden en voegden contextuele hints toe:
RoleEnricher: "You are LEAD of this project, proceed with update."
PaginationHintEnricher: "next_offset=5 means MORE results! MUST paginate."
Guardsysteem met drie modi:
| Modus | Gedrag |
|---|---|
| Hard block | Een antwoord dat volgens de API-gegevens onmogelijk is, zoals een antwoord dat een medewerker buiten het projectteam noemt, wordt geweigerd |
| Soft block | Een riskant antwoord wordt eenmaal geweigerd met een waarschuwing en geaccepteerd als de agent het na die waarschuwing opnieuw indient |
| Soft hint | Er wordt een aanwijzing toegevoegd zonder te blokkeren |
Hybrid RAG-wiki: het team doorzocht een lokale kopie van de bedrijfswiki op drie manieren: regex voor gestructureerde patronen zoals salary|privacy, sentence-transformer-embeddings voor semantische treffers en tokenoverlap als terugvaloptie op trefwoorden. Mijn lezing van waarom drie: regex vindt exacte veldnamen en termen, en embeddings vinden regels die anders zijn geformuleerd dan de vraag.
Stack: qwen/qwen3-235b-a22b-2507 op het SGR-framework van LangChain.
5. Plan-execute-REPL (Team 5qsp7i / key_concept_parallel)
Deze architectuur hield planning en het schrijven van code gescheiden in aparte modelaanroepen. Gegenereerde Python draait in een REPL (read-eval-print loop): een Python-session die haar variabelen tussen stappen behoudt. De inzending stond in het bredere Ultimate-klassement, niet in de bevroren top vijf van de prijzen. De openbare beschrijving blijft nuttig, omdat ze een andere vorm van opdeling laat zien: isolatie per uitvoeringsfase in plaats van per bedrijfsrol.
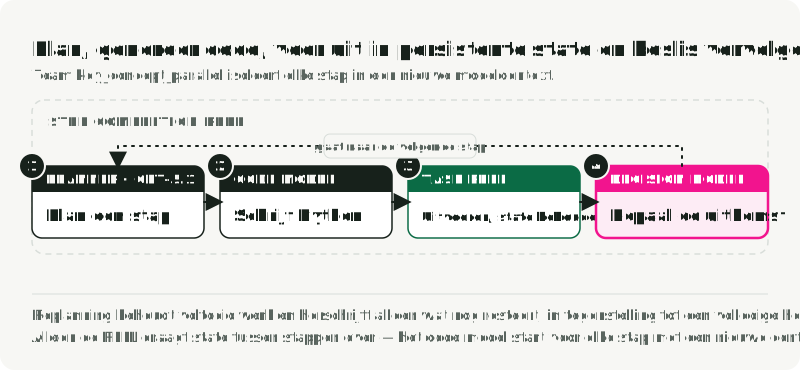
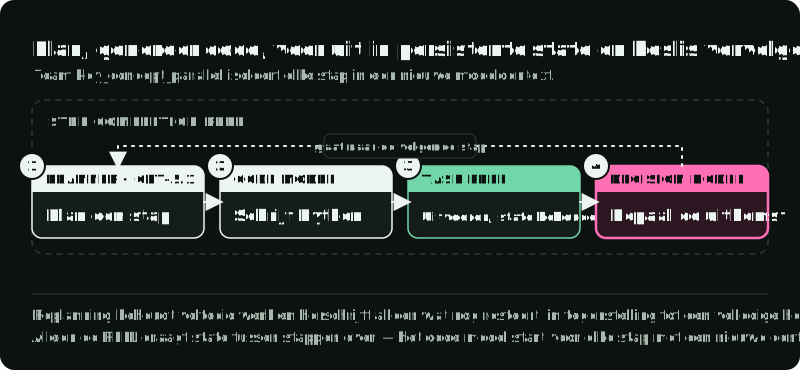
Verschillende models deden verschillende taken: één maakte het plan, één schreef Python en een apart beslismodel koos wat er na elke stap moest gebeuren.
Opzet met meerdere models:
| Fase | Model |
|---|---|
| Planning | openai/gpt-5.1 |
| Codegeneratie | deepseek/deepseek-v3.2 |
| Beslissing na stap | openai/gpt-4.1 |
| Eindantwoord | openai/gpt-4.1 |
De REPL voor het voltooien van een stap:
- De planner maakt een stap op hoog niveau.
- Het codegeneratiemodel werkt in een verse modelcontext en schrijft er een Python-script voor.
- Het script draait in een REPL die aan de taak is gekoppeld en waarvan de variabelen over stappen heen blijven bestaan.
- Het beslismodel bekijkt het resultaat en kiest een van vier uitkomsten: doorgaan met de volgende stap, afronden omdat de taak klaar is, afbreken omdat die is mislukt, of opnieuw plannen.
Het replan-pad is het herbruikbare idee. Als een stapresultaat laat zien dat het plan niet meer past, kan het beslismodel het voltooide werk behouden en alleen de resterende planstappen herschrijven. In het diagram delen klaar en mislukt één uitgang naar het eindantwoord.
Patronen die in meerdere inzendingen terugkwamen
De implementaties verschilden, maar meerdere technische vraagstukken kwamen steeds terug in de openbare beschrijvingen.
Contextbeheer was expliciet
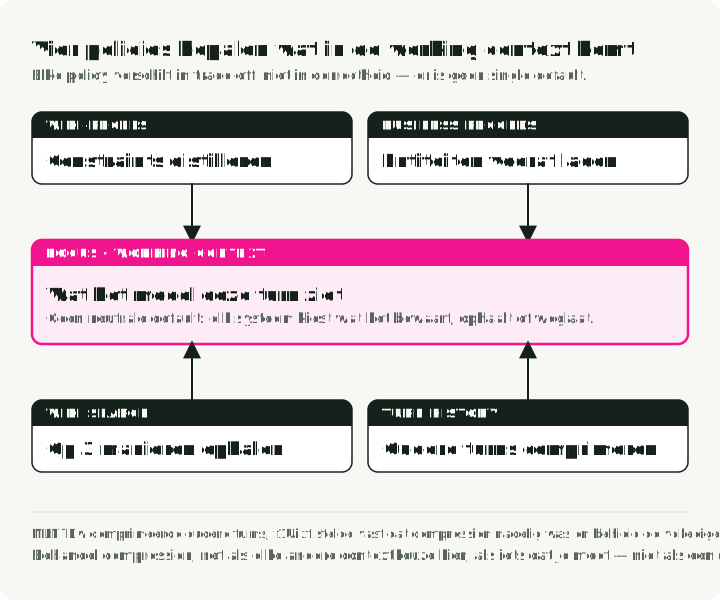
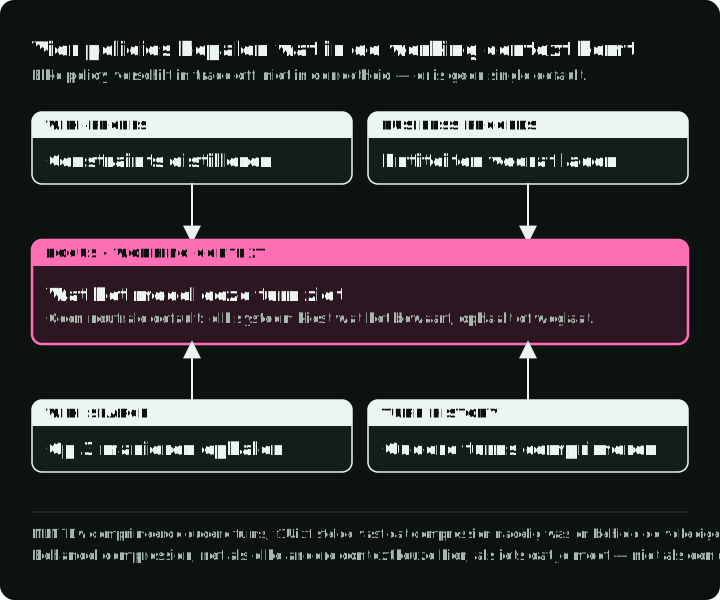
Geen enkel team kon het model elke regel, elk record en elke eerdere stap geven zonder een beleidskeuze te maken. De systemen verschilden in waar ze informatie filterden: vóór de run, bij retrieval of in de geschiedenis. Het diagram verdeelt de context van het model in vier delen en toont welk beleid elk deel bepaalt, wanneer het draait en welke teams het gebruikten.
| Strategie | Aanpak | Het beste voor |
|---|---|---|
| Regeldistillatie | Wikiregels vooraf omzetten in compacte instructies met behoud van de beperkingen | Slanke prompts, snelle start |
| Uitgebreid vooraf laden | Gebruikers-, project- en klantgegevens laden vóór de uitvoering | Minder tool calls |
| Hybride RAG | Zoekstromen met regex, semantiek en trefwoorden | Complexe retrieval-behoeften |
| Geschiedeniscompressie | Recente beurten volledig houden, oudere geschiedenis comprimeren | Lange gesprekken |
Afweging: NLN7Dw comprimeerde oudere beurten, terwijl f1Uixf meldde dat geschiedeniscompressie zijn experimenten schaadde en in plaats daarvan het volledige gesprek bewaarde. Behandel compressie als een gemeten keuze, niet als standaard. Sterke inzendingen verschilden ook in promptgrootte. Kc7F2N (3e prijs) hield zijn eigen instructies minimaal, vertrouwde op gedistilleerde wikiregels en bouwde zijn zoektools op embeddings. MMzXeM (4e prijs) hield de hoofdprompt op 320 tokens en plaatste de hele wiki achter zijn
ask_wiki-tool, die op context caching leunde om goedkoop te blijven.
Controles vóór, tijdens en na de hoofdlus
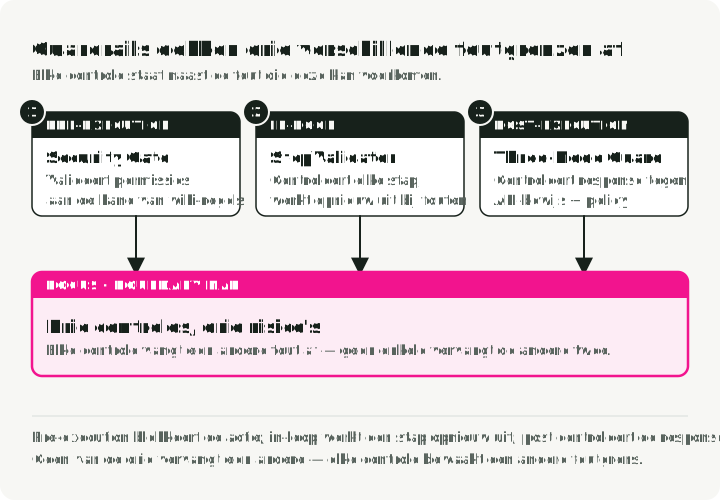
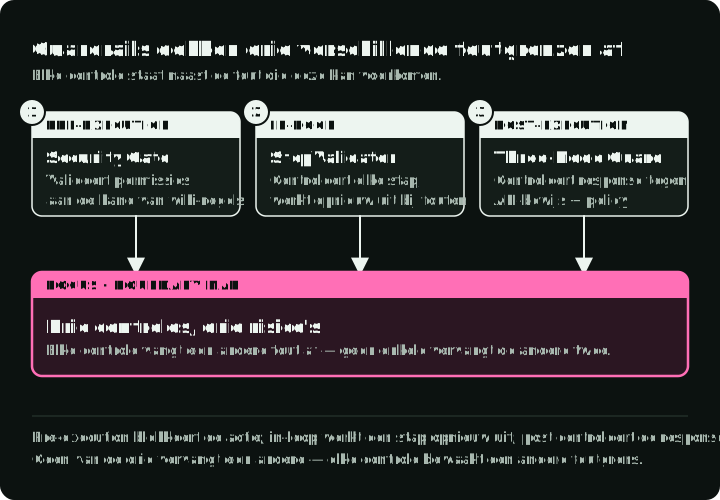
Verschillende teams plaatsten controles vóór, tijdens of na de hoofdlus. Deze controles hebben in elke fase andere gegevens nodig. Eén gedeelde implementatie kan ze uitvoeren als die in elke fase de juiste invoer krijgt. Een critic die alleen voor de eindrespons wordt aangeroepen, kan een eerdere ongeautoriseerde tool call niet voorkomen. Het diagram plaatst elke controle op een tijdlijn van taak tot grader en toont wat de controle ziet en welke fout die voorkomt.
| Type guardrail | Wanneer | Voorbeeld |
|---|---|---|
| Controles vóór uitvoering | Voordat de hoofdlus start | Security Gate Agent valideert rechten tegen de wikiregels |
| Validators in de lus | Tijdens reasoning | StepValidator controleert elke voorgestelde actie en start herwerking bij een gebrek |
| Guards na uitvoering | Vóór de eindindiening | Het guardsysteem met drie modi controleert het antwoord van de agent tegen API-gegevens en beleid |
Tool wrappers
Meerdere teams veranderden de toollaag die het model ziet, in plaats van instructies over de ruwe API toe te voegen:
- Auto-pagination: NLN7Dw haalde paginering uit elke tool. Eén functie doorloopt alle pagina’s en geeft de volledige lijst terug.
- Fuzzy normalization: de toolparsers van J8Gvbi koppelen menselijke formuleringen aan API-namen, zodat “Willingness to travel” het veld
will_travelwordt. - Schema cleanup: f1Uixf verwijderde ongebruikte velden uit tool schemas en breidde de parameterbeschrijvingen uit. NLN7Dw bouwde
Req_LogTimeEntryopnieuw, de ene SDK-tool waarvan de velden in een andere volgorde stonden, omdat die volgorde het model in verwarring bracht. - Reasoning tools: xoDvsa (7e prijs, 0.515) voegde
plan-,think- encritic-tools toe aan een gewone ReAct-agent. De critic-tool geeft structured output terug met eigen velden voor de reasoning.
Een wrapper verbergt paginering voor het model: de agent vraagt één keer om een lijst en list_all volgt next_offset totdat de waarde -1 is, de eindwaarde uit het officiële ERC3-voorbeeld. De code hieronder schetst stap 1 van de invoervolgorde aan het einde van dit artikel en is geen code van een team. respond bouwt de entiteitslinks op uit IDs die de agent heeft opgehaald en weigert een ID die hij nooit heeft gezien. Zo komt elke link uit code en wordt een verzonnen ID afgewezen voordat de grader die ziet.
# Stand-in for the benchmark API: 12 projects, 5 per page.
PROJECTS = [{"id": f"proj_{i}", "name": f"Project {i}"} for i in range(12)]

def call_api(endpoint: str, offset: int = 0, limit: int = 5) -> dict:
    page = PROJECTS[offset : offset + limit]
    more = offset + limit < len(PROJECTS)
    return {"items": page, "next_offset": offset + limit if more else -1}

def list_all(endpoint: str) -> list[dict]:
    """Follow next_offset until the API returns the terminal value -1."""
    items, offset = [], 0
    while offset != -1:
        page = call_api(endpoint, offset=offset)
        items.extend(page["items"])
        offset = page["next_offset"]
    return items

def respond(text: str, entity_ids: list[str], fetched: list[dict]) -> dict:
    """Build required links from IDs; refuse IDs the agent never fetched."""
    known = {row["id"] for row in fetched}
    unknown = [i for i in entity_ids if i not in known]
    if unknown:
        raise ValueError(f"unknown entity ids: {unknown}")
    return {"message": text, "links": [{"id": i} for i in entity_ids]}

projects = list_all("/projects/list")
assert len(projects) == 12  # three pages, one list
print(respond("You lead two projects.", ["proj_3", "proj_11"], projects))
De agent ziet nooit een paginagrens, en proj_11 van de derde pagina is een geldige link.
Faalwijzen en de structurele oplossingen die teams meldden
De verslagen noemen herhaaldelijk fouten waarbij de agent de API aanroept of bedrijfsbeleid toepast. De best herbruikbare oplossingen verplaatsten de eis naar code of naar een aparte validatiestap:
| Faalwijze | Beschrijving | Architectuuroplossing |
|---|---|---|
| Rechten omzeilen | Beperkte acties uitvoeren zonder de rechten van de gebruiker te controleren | Security Gate Agent vóór de uitvoering; verplichte volgorde identiteit → rechten → uitvoering |
| Ontbrekende entiteitslinks | Correct tekstantwoord maar zonder de vereiste verwijzingslinks | Ingebouwde LinkGeneratorAgent in de response-tool |
| Onvolledige paginering | Alleen de eerste pagina van lijstresultaten verwerken | Auto-pagination wrappers voor alle lijst-endpoints |
| Lussen met tool calls | Herhaalde aanroepen met kleine variaties | Beurtlimieten; duidelijkere tool schemas; modelkeuze getest op de werkelijke workflow |
| Te veel context | De context vullen met irrelevante wikisecties | Rule distillation; dynamisch filteren van context |
Twee verslagen voegen detail toe aan de rij over loops. f1Uixf zag tool-calling loops met GPT-5 maar niet met het kleinere Qwen3-model. NLN7Dw stelde zijn beurtlimiet te laag in, waardoor 5 van de 103 taken niet werden afgerond, dus een beurtlimiet heeft ruimte nodig.
Een praktische adoptievolgorde
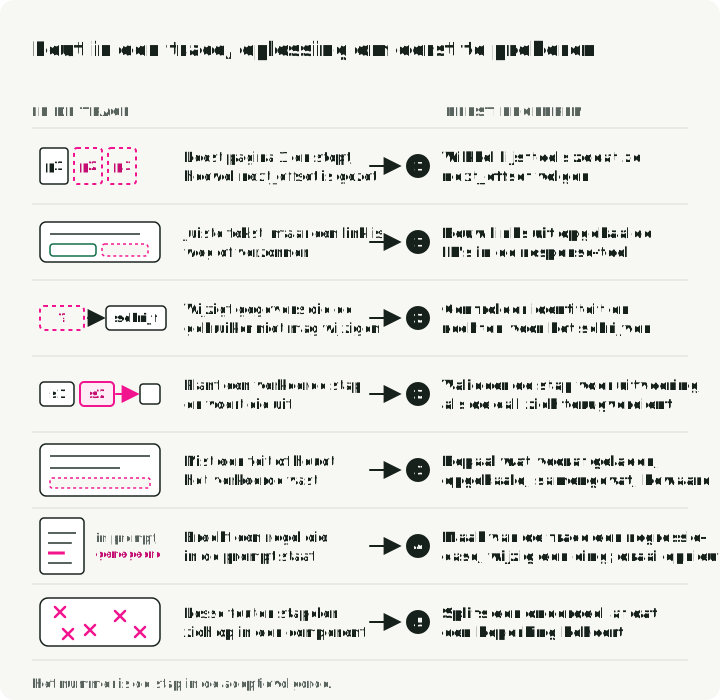
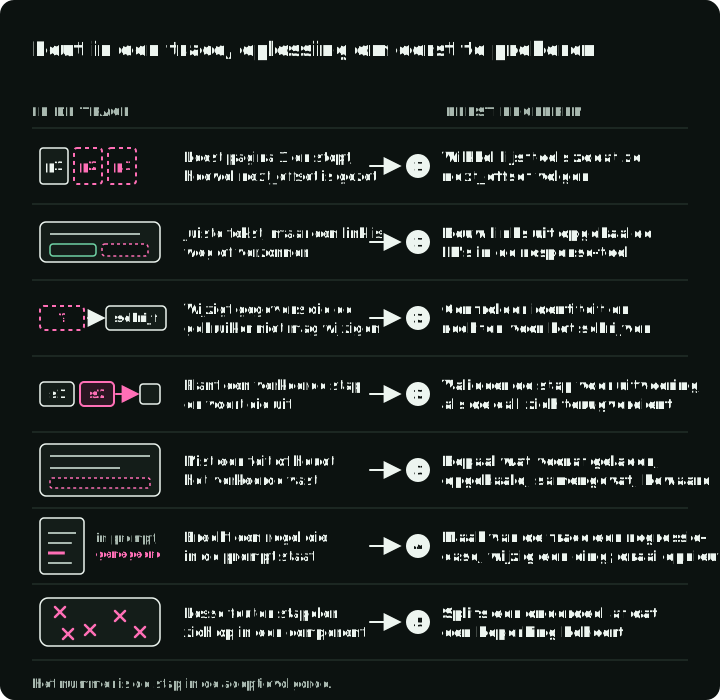
ERC3 is één gesimuleerd bedrijf, geen algemene ablatiestudie voor agents. Gebruik het als bron van ontwerphypotheses en test die hypotheses vervolgens op je eigen traces. Een verstandige adoptievolgorde is:
- Maak eerst de correctheid van de API deterministisch. Pagineer lijst-endpoints automatisch, normaliseer vage velden, valideer schemas en genereer vereiste links in de response-tool.
- Voeg controles toe waar een fout duur is. Controleer identiteit en rechten vóór een mutatie; valideer een stap vóór de uitvoering alleen als de extra modelaanroep fouten vangt die de kosten waard zijn.
- Schrijf een contextbeleid op. Bepaal wat vooraf wordt geladen, opgehaald, gecomprimeerd of letterlijk bewaard. Meet het beleid per taakdeel in plaats van alleen op tokenaantal.
- Zet mislukte traces om in regressietests. Classificeer de fout, verander één mechanisme en draai het getroffen deel opnieuw. Automatiseer promptherziening pas als die lus betrouwbaar is.
- Splits op wanneer het eigenaarschap duidelijker wordt. Een aparte component is gerechtvaardigd wanneer die een beperking kan beheren, een ander model of een andere tool kan gebruiken, of onafhankelijk kan worden getest, niet simpelweg omdat “multi-agent” capabeler klinkt.
De figuur hieronder schetst hoe elk falen er in een trace uitziet en wijst naar de oplossing die je als eerste probeert. De nummers komen overeen met de stappen hierboven.