LLMs locaux sur macOS : Ollama, LM Studio, MLX, llama.cpp

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Les ingénieurs qui exécutent des modèles locaux sur un Mac Apple Silicon doivent dimensionner la charge de travail complète, et pas seulement choisir un modèle qui se télécharge. Apple Silicon peut traiter des prompts courants sans API distante, car le CPU et le GPU partagent une même mémoire unifiée. Mais les poids du modèle se partagent cette mémoire avec le cache qui contient le contexte, les tampons de travail du runtime et macOS lui-même.
Une fois que le modèle, le contexte et la marge mémoire tiennent, choisissez l’outil qui correspond à votre façon de travailler : Ollama pour un service local géré, LM Studio pour explorer des modèles depuis le bureau, llama.cpp pour contrôler directement les options du runtime, ou MLX-LM pour du Python natif Apple. Vous apprendrez à estimer la mémoire, à quoi sert chaque outil, comment lancer chacun d’eux et comment les comparer sur la même charge de travail.
Pour le tableau de décision condensé, voir Outils LLM locaux sur macOS en 2026.
Combien de mémoire un modèle local exige
Quatre termes reviennent dans cet article :
- La quantification stocke les poids du modèle sur moins de bits pour réduire la mémoire. Dans un nom de fichier comme
Llama-3.1-8B-Instruct-Q4_K_M.gguf,Q4indique un schéma sur 4 bits ;Q4_K_Mdonne une moyenne légèrement inférieure à 5 bits par poids une fois comptés les facteurs d’échelle et quelques tenseurs de plus haute précision. - GGUF est le format de modèle en un seul fichier utilisé par llama.cpp et les outils construits dessus. MLX-LM charge à la place des modèles convertis pour MLX : un même modèle est donc distribué en deux téléchargements distincts, GGUF et MLX.
- Le KV cache stocke les clés et les valeurs d’attention de chaque token du contexte. Il grandit avec la longueur du contexte et avec le nombre de requêtes parallèles.
- La famille de checkpoints désigne un modèle de base à une taille donnée, comme Llama 3.1 8B Instruct, quels que soient son format de fichier ou sa quantification.
Le graphique additionne les poids et le KV cache de Llama 3.1 8B en Q4_K_M, avec des contextes de 8K et 32K. Il compare ces sous-totaux à la mémoire de travail GPU recommandée signalée sur un Mac M1 de 16 Go ; l’espace de travail du runtime et macOS demandent de la mémoire supplémentaire.
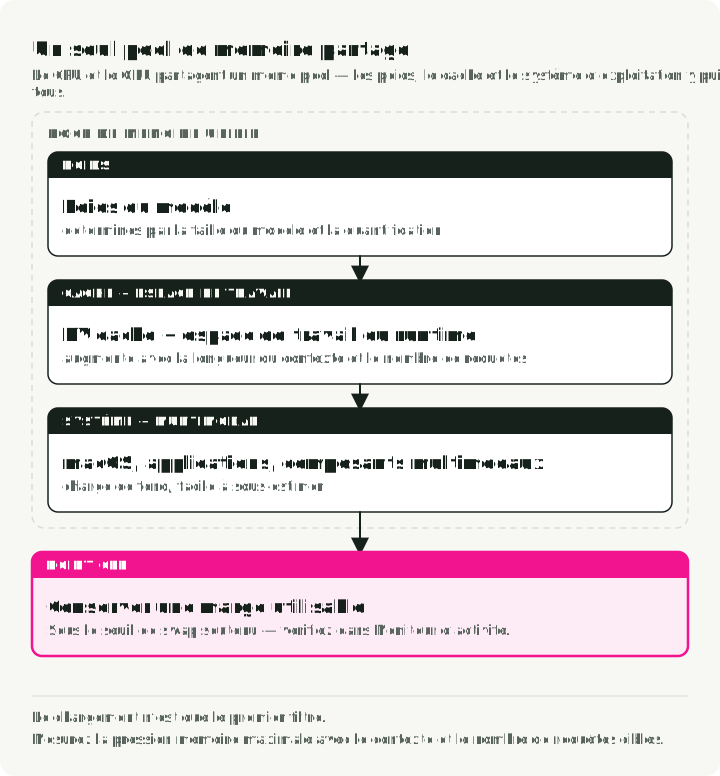
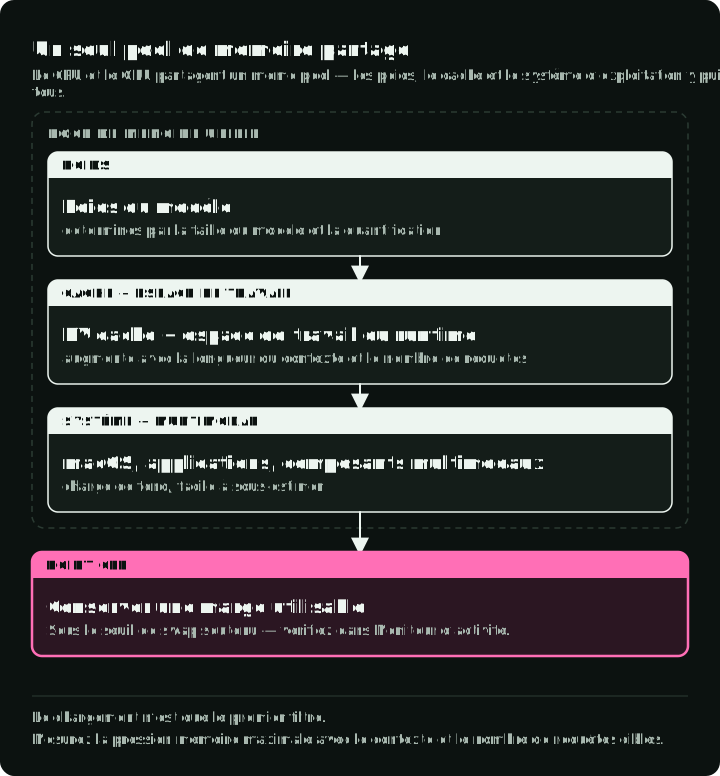
La taille brute des poids quantifiés n’est que le premier terme :
peak memory ≈ model weights
            + KV cache
            + runtime workspace
            + multimodal components
            + application and OS memory
La longueur du contexte, le type de données du cache, les requêtes parallèles et l’architecture du modèle changent le résultat. Le KV cache est le terme que vous contrôlez le plus directement, par la longueur du contexte :
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valuePour Llama 3.1 8B (32 couches, 8 têtes KV, dimension de tête 128) avec un cache en 16 bits, cela donne 2 × 32 × 8 × 128 × 2 = 131 072 octets, soit 128 Kio par token. Un contexte de 8K demande 1 Gio de cache par requête, et un contexte de 32K en demande 4 Gio. Les poids Q4_K_M forment un fichier de 4,9 Go (4,6 Gio). Avant l’espace de travail, le modèle a besoin d’environ 5,6 Gio avec un contexte de 8K et d’environ 8,6 Gio avec un contexte de 32K.
Metal indique une taille de mémoire de travail GPU recommandée, recommendedMaxWorkingSetSize, qui estime combien de mémoire GPU peut être allouée sans affecter les performances du runtime. C’est une recommandation de performance, pas une limite d’allocation imposée. Dans un rapport de 2023 sur un M1 de 16 Go, llama.cpp affichait 10 923 Mo, soit environ 10,7 GiB ou deux tiers de la RAM. Par rapport à cette recommandation, le sous-total à 8K laisse 5,1 GiB pour l’espace de travail et la marge ; celui à 32K laisse 2,1 GiB. Vérifiez la valeur sur votre propre Mac et mesurez la charge complète avant de décider si elle tient en mémoire. Un Mac de 8 Go offre moins de marge : ces poids seuls demandent déjà 4,6 GiB.
Prévoyez aussi l’espace disque. Chaque modèle 7B ou 8B en 4 bits représente 4 à 5 Go à télécharger, et une petite bibliothèque de modèles dans les deux formats occupe 10 à 20 Go.
Utilisez le Moniteur d’activité ou les métriques propres au runtime pendant les tests. Apple définit la pression mémoire à partir de la mémoire libre, du débit de swap, de la mémoire résidente (wired) et des fichiers en cache. Gardez assez de marge pour éviter un swap prolongé : un modèle qui se charge mais pousse le système en pression mémoire ne convient pas à un usage interactif.
Chaque section d’outil ci-dessous indique où régler la longueur du contexte, car ce réglage est celui qui modifie le plus le KV cache.
Les quatre outils répondent à des besoins de workflow différents
| Outil | Interface principale | Format de modèle | Licence | À choisir quand |
|---|---|---|---|---|
| Ollama | CLI et API HTTP locale | Paquets de modèles gérés, surtout GGUF | MIT | Une application a besoin d’un service local géré simple |
| LM Studio | Interface de bureau, CLI, SDKs, API locales | GGUF et MLX | Application propriétaire, gratuite au travail ; SDKs MIT | Une personne doit découvrir, comparer, inspecter et servir des modèles visuellement |
| llama.cpp | CLI, bibliothèque C/C++, serveur local | GGUF | MIT | Vous avez besoin d’options directes, d’outils de conversion et de quantification, ou d’une inférence embarquée |
| MLX-LM | Python et CLI | Poids au format MLX | MIT | Vous écrivez du Python pour Apple Silicon ou effectuez le fine-tuning d’un modèle sur le même Mac |
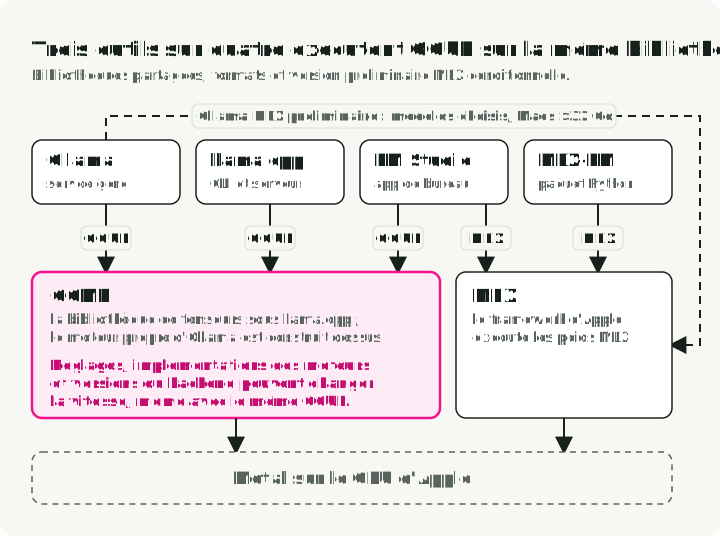
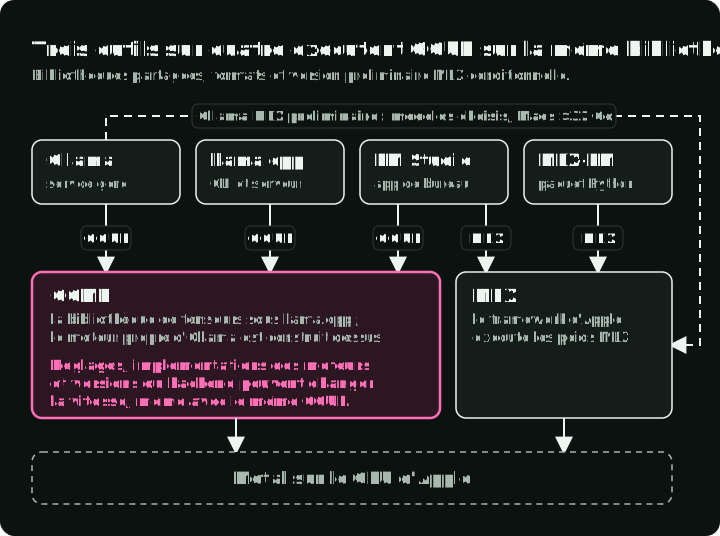
Ce tableau décrit les responsabilités, pas un classement de vitesse. Trois outils partagent une bibliothèque de tenseurs. Ollama exécute les modèles GGUF avec son propre moteur, fondé sur GGML, la bibliothèque sur laquelle repose llama.cpp. La version préliminaire MLX d’Ollama de mars 2026 exécute aussi certains modèles sur des Macs disposant de plus de 32 Go de mémoire. LM Studio exécute les modèles GGUF avec llama.cpp et les modèles MLX avec MLX. Partager GGML ne signifie pas utiliser des moteurs d’inférence identiques. Même avec le même fichier GGUF, les réglages par défaut comme la longueur du contexte et la taille des lots, les implémentations des moteurs et les versions du backend peuvent modifier la vitesse.
Le schéma montre les formats de modèles et les bibliothèques partagées utilisés par chaque outil, y compris le chemin MLX conditionnel d’Ollama.
Si vous ne savez pas encore quel workflow est le vôtre, utilisez la dernière colonne du tableau. Commencez par Ollama si vous voulez simplement quelque chose qui tourne aujourd’hui.
Un cas d’usage échappe aux quatre outils : KoboldCpp, un fork de llama.cpp avec une interface web, est conçu pour la fiction longue et le jeu de rôle. Il est sous licence AGPL, ce qui compte si vous l’embarquez dans un produit.
Une seule API pour les quatre outils
Les quatre outils peuvent servir une API compatible OpenAI sur localhost. Le code applicatif qui utilise le client openai peut changer d’outil en modifiant base_url, et le même client permet de mesurer les quatre.
| Outil | Commande du serveur | base_url par défaut |
|---|---|---|
| Ollama | ollama serve (l’app macOS le lance) | http://localhost:11434/v1 |
| LM Studio | lms server start | http://localhost:1234/v1 |
| llama.cpp | llama-server -hf <repo>:<quant> | http://localhost:8080/v1 |
| MLX-LM | mlx_lm.server --model <repo> | http://localhost:8080/v1 |
Le client exige une valeur de clé API. Utilisez local comme valeur de remplacement quand l’authentification du serveur est désactivée ; utilisez votre jeton configuré quand elle est activée. llama-server et mlx_lm.server utilisent tous deux le port 8080 par défaut ; démarrez l’un avec --port 8081 pour exécuter les deux.
Les exemples Python qui importent openai nécessitent le paquet openai. Le benchmark ci-dessous contient une commande pour exécuter le script enregistré avec cette dépendance.
from openai import OpenAI

# Swap base_url for :1234 (LM Studio) or :8080 (llama.cpp, MLX-LM).
client = OpenAI(base_url="http://localhost:11434/v1", api_key="local")
La section sur les mesures ci-dessous utilise ce client pour chronométrer les quatre outils avec un seul script.
Ollama : un service local géré
Ollama gère les téléchargements de modèles, les templates, le cycle de vie des processus et une API sur localhost. Il est utile quand le code applicatif doit viser un service local stable plutôt que de gérer lui-même les options d’inférence.
MODEL=llama3.2
ollama pull "$MODEL"
ollama show "$MODEL"   # architecture, parameters, context length, quantization
ollama run "$MODEL" "Explain unified memory."

curl http://localhost:11434/api/chat \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "'"$MODEL"'",
      "messages": [{"role": "user", "content": "Explain unified memory."}],
      "options": {"num_ctx": 8192},
      "stream": false
    }'
L’option num_ctx fixe la longueur du contexte pour une seule requête. Pour la fixer pour tout le serveur, démarrez-le avec OLLAMA_CONTEXT_LENGTH=8192 ollama serve ou utilisez le curseur dans les réglages de l’app. Sans l’un ni l’autre, Ollama choisit une valeur par défaut selon la mémoire disponible : 4K tokens quand moins de 24 Gio de mémoire GPU sont disponibles. ollama ps indique le contexte utilisé par chaque modèle chargé.
Un nom court de bibliothèque comme llama3.2 n’identifie pas un fichier fixe ; le même nom peut pointer vers une autre version après une mise à jour. Notez l’ID qu’affiche ollama list, c’est-à-dire le début du digest du modèle, avec chaque évaluation.
Ollama sacrifie une part de visibilité bas niveau au profit de la commodité du cycle de vie. Passez à llama.cpp ou à un autre runtime quand vous devez contrôler directement un fichier GGUF, un template de chat, un réglage du cache ou une nouvelle fonctionnalité du backend.
LM Studio : exploration depuis le bureau et API locales
LM Studio est utile quand la découverte de modèles, la configuration du chargement, l’inspection des conversations et l’évaluation humaine côte à côte doivent tenir dans un même workflow. Il expose des SDKs natifs Python et TypeScript, des endpoints compatibles OpenAI, le structured output, le tool use et un daemon sans interface : c’est donc plus qu’une simple interface graphique de bureau. Sa vue de chat accepte aussi des fichiers .pdf, .docx et .txt joints comme contexte, ce qui couvre les questions simples sur des documents sans écrire de code.
Le SDK Python actuel se connecte à un modèle déjà téléchargé. Démarrez le serveur local de LM Studio, enregistrez ce code sous lmstudio_demo.py et exécutez uv run --with lmstudio python lmstudio_demo.py. Si l’authentification est activée, définissez LM_API_TOKEN ; le SDK le lit automatiquement.
import lmstudio as lms

MODEL_KEY = "ibm/granite-4-micro"

with lms.Client() as client:
    model = client.llm.model(MODEL_KEY)
    response = model.respond("Write one sentence about local inference.")
    print(response)
Démarrez l’API locale depuis l’onglet Developer ou depuis la CLI. lms load fixe la longueur du contexte au chargement d’un modèle, et --estimate-only affiche l’estimation de mémoire sans rien charger :
lms server start
lms load ibm/granite-4-micro --context-length 8192 --estimate-only
lms load ibm/granite-4-micro --context-length 8192
LM Studio peut servir sur localhost ou sur un réseau local, et prend en charge les jetons d’API dans ses réglages d’authentification de l’API. Gardez-le sur l’interface loopback sauf si l’accès distant est voulu. Si vous l’exposez sur un LAN, exigez l’option de jeton d’API documentée, appliquez une règle de pare-feu sur l’hôte et vérifiez les accès des outils et des intégrations.
llama.cpp : exécution directe de GGUF
llama.cpp est l’outil de référence pour les fichiers GGUF quand vous voulez régler vous-même les options du runtime. Il prend en charge Apple Metal, ainsi que le CPU et d’autres backends matériels.
brew install llama.cpp

# Download through the Hugging Face integration and select a quantization.
MODEL_REPO=ggml-org/gemma-3-1b-it-GGUF
QUANT=Q4_K_M
llama-cli -hf "$MODEL_REPO:$QUANT"

# The same model with explicit settings: one turn, then exit.
llama-cli -hf "$MODEL_REPO:$QUANT" \
    -c 8192 -n 256 --temp 0.7 -st \
    -p "Write a Python function that sorts a list."

# Or start an OpenAI-compatible local server with an 8K context.
llama-server -hf "$MODEL_REPO:$QUANT" -c 8192
-c (--ctx-size) fixe la longueur du contexte, et donc la taille du KV cache. -n limite le nombre de tokens générés, --temp fixe la température d’échantillonnage, -st exécute un seul tour puis quitte, et -p donne le prompt.
L’option -hf télécharge aussi le projecteur multimodal correspondant quand le dépôt en contient un. La prise en charge des modèles, les templates et les options de la CLI évoluent vite : épinglez une version connue et conservez la commande de lancement avec le dossier d’évaluation.
Choisissez llama.cpp quand le but est le contrôle direct, et non parce que « plus bas niveau » voudrait automatiquement dire plus rapide. Un outil géré peut choisir de bonnes valeurs par défaut ; des options directes peuvent aussi dégrader les performances.
MLX-LM : du Python natif Apple
MLX-LM s’appuie sur MLX, le framework de tableaux d’Apple. Il prend en charge la génération, le chat, la conversion, la quantification et le fine-tuning économe en paramètres pour les modèles compatibles.
MODEL=mlx-community/Llama-3.2-3B-Instruct-4bit
uv run --with mlx-lm mlx_lm.generate \
    --model "$MODEL" \
    --max-kv-size 8192 \
    --prompt "Explain Metal acceleration in one paragraph."
MLX-LM n’a pas de réglage de contexte fixe : le cache grandit avec le prompt et la sortie. --max-kv-size plafonne le cache à ce nombre de tokens. Au-delà du plafond, MLX-LM supprime les tokens les plus anciens et conserve seulement quelques tokens du début.
Python expose directement le modèle et le tokenizer. Enregistrez ceci sous mlx_demo.py et lancez uv run --with mlx-lm python mlx_demo.py :
from mlx_lm import generate, load

MODEL = "mlx-community/Llama-3.2-3B-Instruct-4bit"

model, tokenizer = load(MODEL)
messages = [{"role": "user", "content": "Give one local-LLM benchmark rule."}]
prompt = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
)
print(generate(model, tokenizer, prompt=prompt, max_tokens=80))
Le serveur HTTP de MLX-LM, mlx_lm.server, est documenté comme un serveur de développement avec des contrôles de sécurité de base, et non comme un service de production. Utilisez-le pour l’expérimentation locale, ou placez devant lui un proxy authentifié ou votre propre service d’API.
Comparer les outils sur la même charge de travail
Testez la même famille de checkpoints avec une quantification comparable quand les formats le permettent. Un fichier GGUF Q4_K_M et un modèle MLX 4 bits du même checkpoint sont comparables, pas identiques.
Utilisez un petit jeu de prompts contenant :
- un prompt interactif court
- un prompt long proche du contexte visé
- du structured output ou des tool calls si l’application en a besoin
- une longueur de génération représentative
- une requête répétée pour distinguer le chargement à froid de l’inférence à chaud
Relevez :
| Métrique | Pourquoi elle compte |
|---|---|
| Résultat de la tâche | Un modèle rapide mais faux est inutile |
| Délai avant le premier token | Réactivité interactive |
| Tokens de sortie par seconde | Débit de génération |
| Pic de mémoire et pression | Si la machine reste utilisable |
| Temps de chargement à froid | Expérience sur le bureau et à la demande |
| Énergie et comportement thermique | Usage soutenu sur un portable |
| Compatibilité API/schéma | Si l’outil convient à l’application |
Chaque outil affiche lui-même les chiffres de vitesse :
- Ollama :
ollama run "$MODEL" --verboseaffiche la durée de chargement, le débit d’évaluation du prompt (prompt eval rate) et le débit d’évaluation (eval rate, soit les tokens de sortie par seconde) après chaque réponse. - llama.cpp :
llama-bench -hf "$MODEL_REPO:$QUANT" -p 512 -n 128mesure le traitement d’un prompt de 512 tokens et la génération de 128 tokens, en tokens par seconde. - MLX-LM :
mlx_lm.generateaffiche les tokens par seconde du prompt et de la génération, ainsi que le pic de mémoire, après chaque exécution. - LM Studio : la vue de chat affiche les tokens par seconde et le délai avant le premier token sous chaque réponse, et l’API REST native renvoie les mêmes valeurs dans son champ
stats.
Pour comparer la latence observée par le client, chronométrez une requête en streaming vers les endpoints compatibles OpenAI de la section « Une seule API pour les quatre outils ». Le script mesure la durée totale de la requête et le délai avant le premier texte visible, puis affiche la réponse pour examen. Le texte visible peut suivre le raisonnement ou la sortie d’un outil ; ce délai ne correspond donc pas forcément au délai du runtime avant le premier token généré.
Démarrez le serveur choisi avec un modèle téléchargé, enregistrez le script sous benchmark.py et exécutez uv run --with openai python benchmark.py. Modifiez BASE_URL et MODEL pour chaque outil. Définissez LOCAL_API_KEY avec votre jeton configuré si l’authentification du serveur est activée ; sinon, le script utilise local comme valeur de remplacement.
import os
import time

from openai import OpenAI

BASE_URL = "http://localhost:11434/v1"
MODEL = "llama3.2"

client = OpenAI(base_url=BASE_URL, api_key=os.environ.get("LOCAL_API_KEY", "local"))

start = time.perf_counter()
first = None
parts = []
stream = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "Explain unified memory in 200 words."}],
    max_tokens=300,
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        if first is None:
            first = time.perf_counter()
        parts.append(chunk.choices[0].delta.content)
end = time.perf_counter()

print(f"request duration: {end - start:.2f} s")
if first is None:
    print("time to first visible text: unavailable (no visible text)")
else:
    print(f"time to first visible text: {first - start:.2f} s")
print("response:", "".join(parts))
Les fragments de texte transmis en streaming ne sont pas des nombres de tokens. Pour obtenir les tokens de sortie par seconde, utilisez les compteurs du runtime cités plus haut et notez s’ils incluent le raisonnement ou la sortie des outils. Par exemple, LM Studio indique séparément les tokens de sortie totaux et ceux de raisonnement. Un stream sans texte visible signale cette absence au lieu d’attribuer une latence de texte ; examinez le raisonnement, les tool calls ou l’état de fin dans l’interface du runtime.
Exécutez chaque requête deux fois : la première peut inclure le chargement du modèle ; la seconde peut réutiliser les poids chargés et l’état du prompt en cache. Notez les versions du runtime et les réglages du cache de prompts pour que les requêtes répétées restent comparables.
Ne comparez pas le modèle 4 bits d’un outil avec le modèle en pleine précision d’un autre pour attribuer l’écart au runtime.
Liste de contrôle sécurité et confidentialité
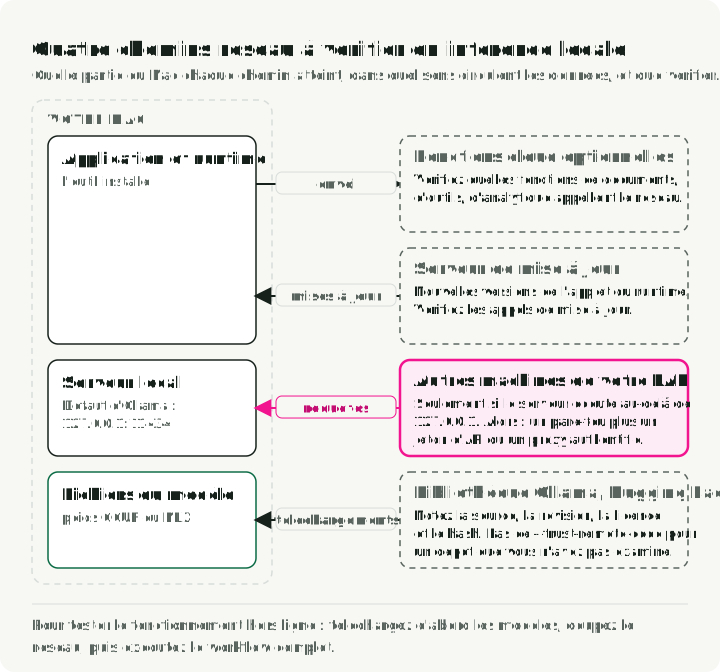
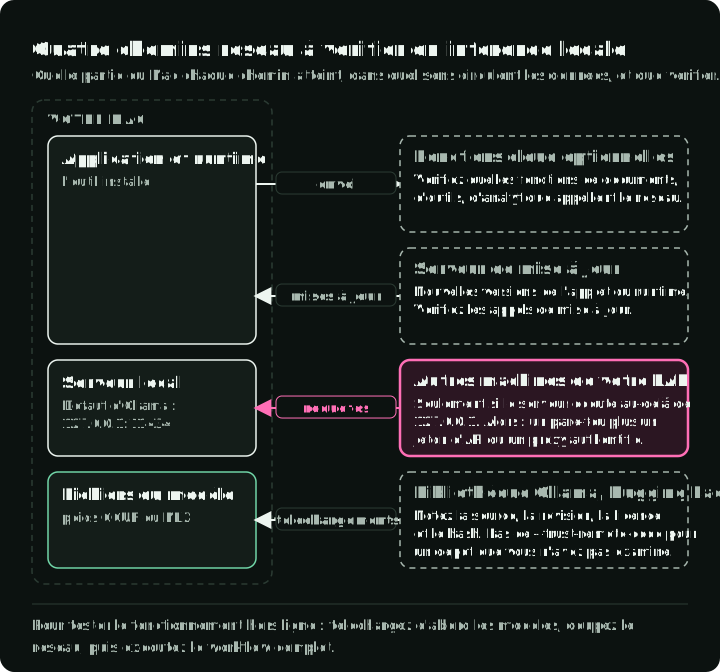
Distinguez l’inférence locale du fonctionnement hors ligne. Les prompts peuvent rester sur la machine alors que l’application accède encore au réseau pour télécharger des modèles, se mettre à jour ou activer des fonctions optionnelles. Ollama documente séparément l’exécution locale, les téléchargements de modèles et les fonctions cloud optionnelles dans sa FAQ. Traitez le fonctionnement hors ligne comme une exigence de workflow à vérifier application par application : téléchargez d’abord les artefacts, coupez le réseau, puis testez le workflow complet.
Le schéma montre quatre chemins réseau à vérifier pendant l’inférence locale : la partie du Mac atteinte, le sens des échanges et les vérifications à effectuer. Les fonctions cloud et l’accès LAN dépendent de la configuration de l’application.
- Liez les API à l’interface loopback sauf si un accès réseau est nécessaire.
- Si un accès LAN est nécessaire, utilisez un pare-feu sur l’hôte, ainsi que l’authentification documentée de l’outil ou un reverse proxy authentifié devant le service. La prise en charge des jetons d’API dépend de l’outil : LM Studio documente les jetons d’API, et
llama-serveraccepte--api-key. Ollama écoute par défaut sur127.0.0.1:11434, etOLLAMA_HOSTchange l’adresse d’écoute. Son API locale n’exige pas d’authentification : placez donc un proxy authentifié devant elle pour un usage sur LAN. - Traitez les fichiers de modèle comme des artefacts tiers ; notez la source, la révision, la licence et le hash.
- Les fichiers GGUF ne contiennent pas de code exécutable. Les modèles au format Hugging Face peuvent embarquer du code Python ; ne passez pas
--trust-remote-codeà MLX-LM ou à Transformers pour un dépôt que vous n’avez pas examiné. - Vérifiez si les fonctions optionnelles de documents, d’outils, de mise à jour ou d’analytique font des appels réseau.
- Ne supposez pas que la génération locale rend sûrs les documents récupérés, les journaux ou les effets de bord des outils.