Lokale LLMs op macOS: Ollama, LM Studio, MLX, llama.cpp

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Wie lokale models draait op een Apple Silicon Mac, moet de volledige workload inschatten en niet alleen een model kiezen dat zich laat downloaden. Apple Silicon kan alledaagse prompts beantwoorden zonder externe API, omdat CPU en GPU één unified memory pool delen. Maar de model weights delen dat geheugen met de cache die de context bevat, de werkbuffers van de runtime en macOS zelf.
Past het model met zijn context en geheugenruimte, kies dan de tool die bij je manier van werken past: Ollama voor een beheerde lokale service, LM Studio om models op het bureaublad te verkennen, llama.cpp voor directe controle over runtime-flags, of MLX-LM voor Apple-native Python. Je leert hoe je geheugen inschat, waarvoor elke tool dient, hoe je elke tool draait en hoe je ze op dezelfde workload vergelijkt.
Een compacte beslistabel vind je in Lokale LLM-tools op macOS in 2026.
Hoeveel geheugen een lokaal model nodig heeft
Vier termen komen in dit artikel steeds terug:
- Quantization slaat model weights op in minder bits om geheugen te besparen. In een bestandsnaam als
Llama-3.1-8B-Instruct-Q4_K_M.ggufstaatQ4voor een 4-bits schema.Q4_K_Mkomt gemiddeld op net onder de 5 bits per weight, als je de schaalfactoren en enkele tensors met hogere precisie meetelt. - GGUF is het enkelvoudige modelbestand dat llama.cpp en de tools erop gebruiken. MLX-LM laadt in plaats daarvan models die voor MLX zijn geconverteerd, dus hetzelfde model komt als aparte GGUF- en MLX-download.
- KV cache bewaart de attention keys en values voor elk token in de context. De cache groeit met de contextlengte en met het aantal parallelle verzoeken.
- Checkpoint family betekent één basismodel in één grootte, zoals Llama 3.1 8B Instruct, ongeacht bestandsformaat of quantization.
De grafiek telt weights en KV cache voor Llama 3.1 8B met Q4_K_M op, bij 8K en 32K context. Hij vergelijkt die subtotalen met de aanbevolen GPU working set die één M1-Mac met 16 GB rapporteerde; de werkruimte van de runtime en macOS hebben extra geheugen nodig.
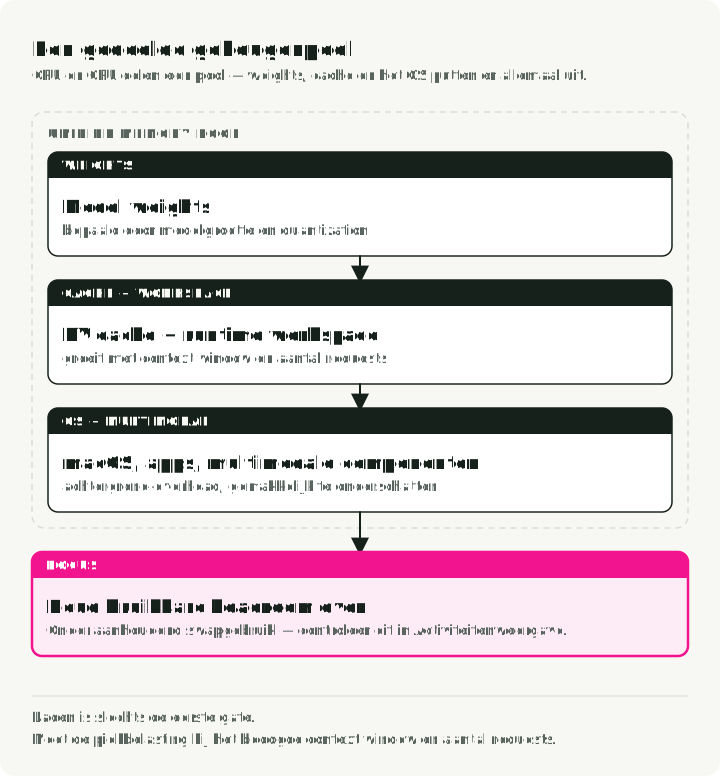
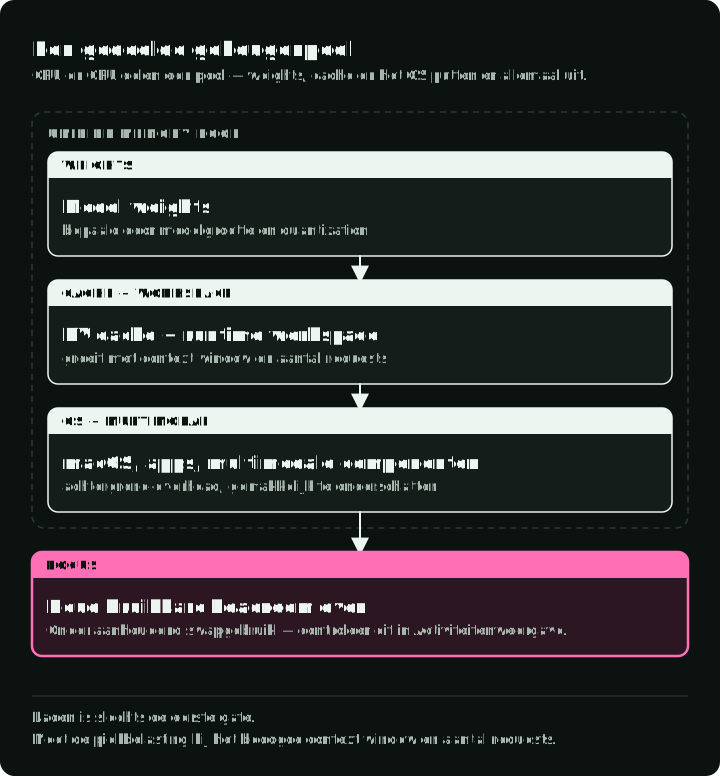
De ruwe grootte van de gequantiseerde weights is slechts de eerste term:
peak memory ≈ model weights
            + KV cache
            + runtime workspace
            + multimodal components
            + application and OS memory
Contextlengte, cache-dtype, parallelle verzoeken en modelarchitectuur veranderen de uitkomst. De KV cache is de term die je het directst stuurt, via de contextlengte:
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valueVoor Llama 3.1 8B (32 lagen, 8 KV heads, head dimension 128) met een 16-bits cache is dat 2 × 32 × 8 × 128 × 2 = 131.072 bytes, oftewel 128 KiB per token. Een context van 8K vraagt 1 GiB cache per verzoek, een context van 32K vraagt 4 GiB. De Q4_K_M-weights zijn een bestand van 4,9 GB (4,6 GiB). Zonder werkruimte heeft het model ongeveer 5,6 GiB nodig bij een context van 8K en ongeveer 8,6 GiB bij 32K.
Metal rapporteert een aanbevolen GPU working set, recommendedMaxWorkingSetSize, die schat hoeveel GPU-geheugen kan worden toegewezen zonder de runtimeprestaties te beïnvloeden. Dit is een prestatieadvies, geen afgedwongen allocatielimiet. In een rapport uit 2023 over één M1 met 16 GB printte llama.cpp 10.923 MB, ongeveer 10,7 GiB of twee derde van het RAM. Ten opzichte van dat advies laat het 8K-subtotaal 5,1 GiB over voor werkruimte en reserve; bij 32K is dat 2,1 GiB. Controleer de waarde op je eigen Mac en meet de volledige belasting voordat je beslist of die past. Een Mac met 8 GB heeft minder reserve; deze weights alleen vragen al 4,6 GiB.
Plan ook schijfruimte. Elk 4-bits 7B- of 8B-model is een download van 4–5 GB, en een kleine bibliotheek met models in beide formaten neemt 10–20 GB in.
Gebruik tijdens het testen Activity Monitor of de eigen metrics van de runtime. Apple definieert geheugendruk aan de hand van vrij geheugen, swapsnelheid, wired memory en gecachete bestanden. Laat genoeg ruimte over om aanhoudend swappen te vermijden. Een model dat laadt maar het systeem onder geheugendruk zet, is geen goede keuze voor interactief gebruik.
Elke toolsectie hieronder laat zien waar je de contextlengte instelt, omdat die instelling de KV cache het sterkst verandert.
De vier tools lossen verschillende workflowproblemen op
| Tool | Primaire interface | Modelformaat | Licentie | Kies het wanneer |
|---|---|---|---|---|
| Ollama | CLI en lokale HTTP API | Beheerde modelbundels, meestal GGUF | MIT | Een applicatie een eenvoudige beheerde lokale service nodig heeft |
| LM Studio | Desktop-UI, CLI, SDKs, lokale API’s | GGUF en MLX | Propriëtaire app, gratis voor werk; MIT SDKs | Iemand models visueel wil ontdekken, vergelijken, inspecteren en serveren |
| llama.cpp | CLI, C/C++-bibliotheek, lokale server | GGUF | MIT | Je directe flags, conversie- en quantization-tools of ingebedde inference nodig hebt |
| MLX-LM | Python en CLI | Weights in MLX-formaat | MIT | Je Python schrijft voor Apple Silicon of een model op dezelfde Mac fine-tunt |
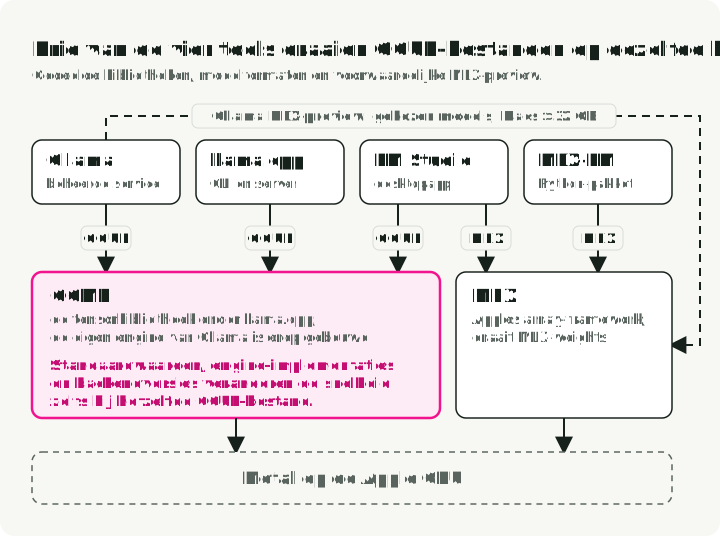
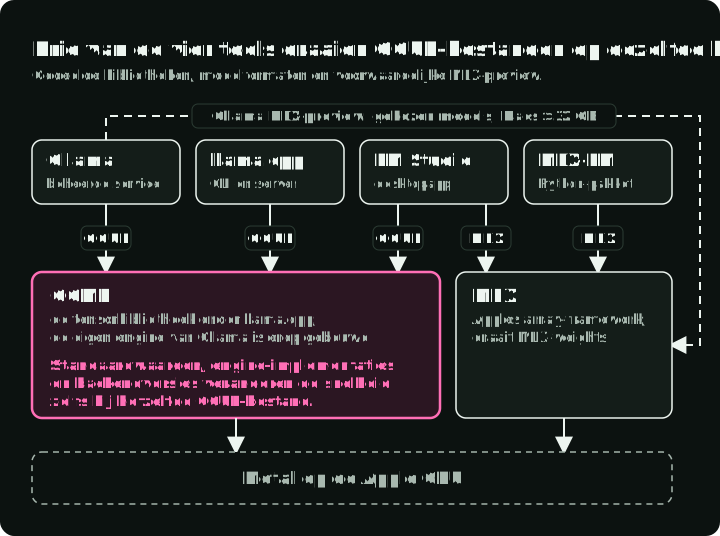
Dit is een tabel met verantwoordelijkheden, geen snelheidsranglijst. Drie tools delen een tensorbibliotheek. Ollama voert GGUF-models uit met zijn eigen engine, die op GGML is gebouwd, de bibliotheek onder llama.cpp. Ollama’s MLX-preview van maart 2026 voert ook geselecteerde models uit op Macs met meer dan 32 GB geheugen. LM Studio voert GGUF-models uit met llama.cpp en MLX-models met MLX. GGML delen betekent geen identieke inference-engines gebruiken. Zelfs bij hetzelfde GGUF-bestand kunnen standaardwaarden zoals contextlengte en batchgrootte, engine-implementaties en backendversies de snelheid beïnvloeden.
Het diagram toont de modelformaten en gedeelde bibliotheken die elke tool gebruikt, inclusief Ollama’s voorwaardelijke MLX-pad.
Weet je nog niet welke workflow je hebt, gebruik dan de laatste kolom van de tabel. Begin met Ollama als je vandaag iets aan de praat wilt krijgen.
Eén taak valt buiten de vier tools: KoboldCpp, een llama.cpp-fork met een webinterface, is gemaakt voor lange fictie en rollenspel. Het heeft een AGPL-licentie, wat telt als je het in een product meelevert.
Eén API voor alle vier de tools
Alle vier de tools kunnen een OpenAI-compatibele API op localhost aanbieden. Applicatiecode die de openai-client gebruikt, wisselt van tool door base_url te veranderen, en dezelfde client kan alle vier benchmarken.
| Tool | Servercommando | Standaard base-URL |
|---|---|---|
| Ollama | ollama serve (de macOS-app start dit) | http://localhost:11434/v1 |
| LM Studio | lms server start | http://localhost:1234/v1 |
| llama.cpp | llama-server -hf <repo>:<quant> | http://localhost:8080/v1 |
| MLX-LM | mlx_lm.server --model <repo> | http://localhost:8080/v1 |
De client vereist een API-keywaarde. Gebruik local als tijdelijke waarde wanneer serverauthenticatie uitstaat; gebruik je ingestelde token wanneer authenticatie aanstaat. llama-server en mlx_lm.server gebruiken allebei standaard poort 8080, dus start één ervan met --port 8081 om beide te draaien.
De Python-voorbeelden die openai importeren, hebben het pakket openai nodig. De benchmark hieronder bevat een opdracht die het opgeslagen script met die dependency uitvoert.
from openai import OpenAI

# Swap base_url for :1234 (LM Studio) or :8080 (llama.cpp, MLX-LM).
client = OpenAI(base_url="http://localhost:11434/v1", api_key="local")
In de benchmarksectie hieronder meet een script met deze client de tijd voor alle vier de tools.
Ollama: beheerde lokale service
Ollama beheert modeldownloads, templates, de levenscyclus van het proces en een localhost-API. Het is handig wanneer applicatiecode een stabiele lokale service moet aanspreken en niet zelf inference-flags hoeft te beheren.
MODEL=llama3.2
ollama pull "$MODEL"
ollama show "$MODEL"   # architecture, parameters, context length, quantization
ollama run "$MODEL" "Explain unified memory."

curl http://localhost:11434/api/chat \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "'"$MODEL"'",
      "messages": [{"role": "user", "content": "Explain unified memory."}],
      "options": {"num_ctx": 8192},
      "stream": false
    }'
De optie num_ctx stelt de contextlengte in voor één verzoek. Om die voor de hele server in te stellen, start je die met OLLAMA_CONTEXT_LENGTH=8192 ollama serve of gebruik je de schuifregelaar in de app-instellingen. Zonder een van beide kiest Ollama een standaardwaarde op basis van beschikbaar geheugen: 4K tokens als er minder dan 24 GiB GPU-geheugen beschikbaar is. ollama ps toont de context die elk geladen model gebruikt.
Een korte bibliotheeknaam zoals llama3.2 verwijst niet naar een vast bestand. Dezelfde naam kan na een update naar een andere build wijzen. Noteer bij elke evaluatie de ID die ollama list toont, het begin van de digest van het model.
Ollama ruilt wat inzicht op laag niveau in voor gemak bij het beheer van de levenscyclus. Stap over op llama.cpp of een andere runtime wanneer je een GGUF-bestand, chattemplate, cache-instelling of nieuwe backend-functie direct wilt aansturen.
LM Studio: verkennen op het bureaublad en lokale API’s
LM Studio is nuttig wanneer modelontdekking, laadconfiguratie, inspectie van chats en menselijke evaluatie naast elkaar in één workflow horen. Het biedt native Python- en TypeScript-SDKs, OpenAI-compatibele endpoints, structured output, tool use en een headless daemon, dus het is meer dan een grafische desktopinterface. In de chatweergave kun je ook .pdf-, .docx- en .txt-bestanden als context toevoegen. Dat dekt eenvoudige vragen over documenten zonder code te schrijven.
De huidige Python-SDK maakt verbinding met een model dat je al hebt gedownload. Start de lokale server van LM Studio, sla dit op als lmstudio_demo.py en voer uv run --with lmstudio python lmstudio_demo.py uit. Stel bij ingeschakelde authenticatie LM_API_TOKEN in; de SDK leest die automatisch.
import lmstudio as lms

MODEL_KEY = "ibm/granite-4-micro"

with lms.Client() as client:
    model = client.llm.model(MODEL_KEY)
    response = model.respond("Write one sentence about local inference.")
    print(response)
Start de lokale API vanaf het tabblad Developer of vanuit de CLI. lms load stelt de contextlengte in bij het laden van een model, en --estimate-only toont de geheugenschatting zonder iets te laden:
lms server start
lms load ibm/granite-4-micro --context-length 8192 --estimate-only
lms load ibm/granite-4-micro --context-length 8192
LM Studio kan op localhost of in een lokaal netwerk serveren en ondersteunt API-tokens in de instellingen voor API-authenticatie. Houd het op loopback, tenzij externe toegang bewust is gekozen. Stel je het bloot op een LAN, vereis dan de gedocumenteerde API-tokenoptie, pas een firewallregel op de host toe en controleer de toegang voor tools en integraties.
llama.cpp: directe GGUF-uitvoering
llama.cpp is de referentietool voor GGUF-bestanden wanneer je de runtime-flags zelf wilt instellen. Het ondersteunt Apple Metal naast CPU en andere hardware-backends.
brew install llama.cpp

# Download through the Hugging Face integration and select a quantization.
MODEL_REPO=ggml-org/gemma-3-1b-it-GGUF
QUANT=Q4_K_M
llama-cli -hf "$MODEL_REPO:$QUANT"

# The same model with explicit settings: one turn, then exit.
llama-cli -hf "$MODEL_REPO:$QUANT" \
    -c 8192 -n 256 --temp 0.7 -st \
    -p "Write a Python function that sorts a list."

# Or start an OpenAI-compatible local server with an 8K context.
llama-server -hf "$MODEL_REPO:$QUANT" -c 8192
-c (--ctx-size) stelt de contextlengte in en daarmee de grootte van de KV cache. -n begrenst het aantal gegenereerde tokens, --temp stelt de sampling-temperatuur in, -st draait één beurt en sluit af, en -p geeft de prompt.
De optie -hf downloadt ook een bijpassende multimodale projector als de repository er een heeft. Modelondersteuning, templates en CLI-flags veranderen snel. Pin dus een bekende build en bewaar het startcommando bij het evaluatieverslag.
Kies llama.cpp wanneer directe controle het doel is, niet omdat “lager niveau” automatisch sneller betekent. Een beheerde tool kan goede standaardwaarden kiezen. Directe flags kunnen de prestaties ook verslechteren.
MLX-LM: Apple-native Python-werk
MLX-LM bouwt voort op Apples array-framework MLX. Het ondersteunt generatie, chat, conversie, quantization en parameter-efficiënte fine-tuning voor compatibele models.
MODEL=mlx-community/Llama-3.2-3B-Instruct-4bit
uv run --with mlx-lm mlx_lm.generate \
    --model "$MODEL" \
    --max-kv-size 8192 \
    --prompt "Explain Metal acceleration in one paragraph."
MLX-LM heeft geen vaste contextinstelling: de cache groeit mee met de prompt en de uitvoer. --max-kv-size begrenst de cache op dat aantal tokens. Voorbij die grens gooit MLX-LM de oudste tokens weg en behoudt het de eerste paar.
Python geeft direct toegang tot het model en de tokenizer. Sla dit op als mlx_demo.py en draai uv run --with mlx-lm python mlx_demo.py:
from mlx_lm import generate, load

MODEL = "mlx-community/Llama-3.2-3B-Instruct-4bit"

model, tokenizer = load(MODEL)
messages = [{"role": "user", "content": "Give one local-LLM benchmark rule."}]
prompt = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
)
print(generate(model, tokenizer, prompt=prompt, max_tokens=80))
De HTTP-server van MLX-LM, mlx_lm.server, is gedocumenteerd als ontwikkelserver met basale beveiligingscontroles, niet als productieservice. Gebruik hem voor lokaal experimenteren, of zet een geauthenticeerde proxy of je eigen API-service ervoor.
Tools vergelijken op dezelfde workload
Test dezelfde checkpoint family en een vergelijkbare quantization, waar de formaten dat toelaten. Een GGUF-bestand Q4_K_M en een MLX 4-bits model van hetzelfde checkpoint zijn vergelijkbaar, niet identiek.
Gebruik een kleine set prompts met:
- één korte interactieve prompt
- één lange prompt in de buurt van de beoogde context
- structured output of tool calls als de applicatie die nodig heeft
- een representatieve generatielengte
- één herhaald verzoek om koud laden te onderscheiden van warme inference
Leg vast:
| Metric | Waarom het ertoe doet |
|---|---|
| Taakresultaat | Een snel verkeerd model is niet bruikbaar |
| Tijd tot eerste token | Responsiviteit bij interactief gebruik |
| Uitvoer-tokens per seconde | Generatie-throughput |
| Piekgeheugen en druk | Of de machine bruikbaar blijft |
| Koude laadtijd | Ervaring op het bureaublad en on demand |
| Energie en thermisch gedrag | Aanhoudend gebruik op een laptop |
| API-/schemacompatibiliteit | Of de tool bij de applicatie past |
Elke tool toont de snelheidscijfers zelf:
- Ollama:
ollama run "$MODEL" --verbosetoont na elk antwoord de laadduur, de prompt eval rate en de eval rate (uitvoer-tokens per seconde). - llama.cpp:
llama-bench -hf "$MODEL_REPO:$QUANT" -p 512 -n 128meet de verwerking van een prompt van 512 tokens en de generatie van 128 tokens, in tokens per seconde. - MLX-LM:
mlx_lm.generatetoont na elke run de tokens per seconde voor prompt en generatie, plus het piekgeheugen. - LM Studio: de chatweergave toont onder elk antwoord de tokens per seconde en de tijd tot het eerste token, en de native REST API geeft dezelfde waarden terug in het veld
stats.
Om de door de client waargenomen latency te vergelijken, meet je een streaming request naar de OpenAI-compatibele endpoints onder ‘Eén API voor alle vier de tools’. Het script meet de totale requestduur en de tijd tot de eerste zichtbare tekst en print daarna de respons ter controle. Zichtbare tekst kan na reasoning of tooluitvoer komen. Deze meting is dus niet noodzakelijk de runtime-tijd tot de eerste gegenereerde token.
Start de gekozen server met een gedownload model, sla het script op als benchmark.py en voer uv run --with openai python benchmark.py uit. Wijzig BASE_URL en MODEL per tool. Stel LOCAL_API_KEY in op je geconfigureerde token als serverauthenticatie aanstaat; anders gebruikt het script local als tijdelijke waarde.
import os
import time

from openai import OpenAI

BASE_URL = "http://localhost:11434/v1"
MODEL = "llama3.2"

client = OpenAI(base_url=BASE_URL, api_key=os.environ.get("LOCAL_API_KEY", "local"))

start = time.perf_counter()
first = None
parts = []
stream = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "Explain unified memory in 200 words."}],
    max_tokens=300,
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        if first is None:
            first = time.perf_counter()
        parts.append(chunk.choices[0].delta.content)
end = time.perf_counter()

print(f"request duration: {end - start:.2f} s")
if first is None:
    print("time to first visible text: unavailable (no visible text)")
else:
    print(f"time to first visible text: {first - start:.2f} s")
print("response:", "".join(parts))
Gestreamde tekststukken zijn geen tokenaantallen. Gebruik voor output-tokens per seconde de runtime-tellers hierboven en noteer of ze reasoning of tooluitvoer meetellen. LM Studio rapporteert bijvoorbeeld totale output-tokens en reasoning-tokens afzonderlijk. Een stream zonder zichtbare tekst meldt dat ontbreken in plaats van een tekstlatency toe te kennen; bekijk reasoning, tool calls of de eindstatus via de runtime-interface.
Voer elke request tweemaal uit: de eerste kan het laden van het model bevatten; de tweede kan geladen weights en gecachte promptstatus hergebruiken. Noteer runtimeversies en instellingen voor prompt caching zodat herhaalde requests vergelijkbaar blijven.
Vergelijk niet het 4-bits model van de ene tool met het model op volle precisie van een andere tool om het verschil aan de runtime toe te schrijven.
Checklist voor beveiliging en privacy
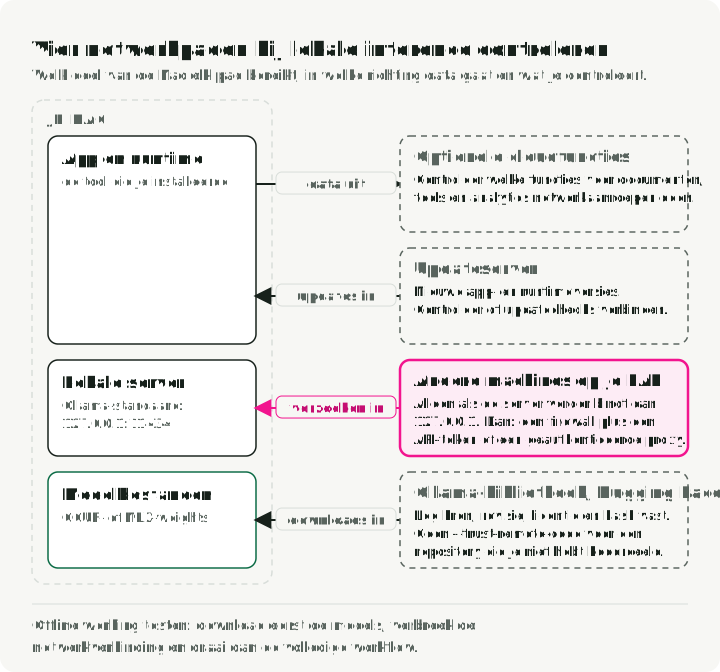
Scheid lokale inference van offline werking. Prompts kunnen op de machine blijven terwijl de applicatie toch het netwerk gebruikt voor modeldownloads, updates of optionele functies. Ollama documenteert lokale uitvoering, modeldownloads en optionele cloudfuncties apart in de FAQ. Zie offline werking als een workflowvereiste die je per applicatie verifieert: download eerst de artefacten, verbreek de netwerkverbinding en test de volledige workflow.
Het diagram toont vier netwerkpaden die je bij lokale inference moet controleren: welk deel van de Mac ze bereiken, in welke richting data beweegt en wat je moet controleren. Cloudfuncties en LAN-toegang hangen af van de applicatieconfiguratie.
- Bind API’s aan loopback, tenzij netwerktoegang nodig is.
- Is LAN-toegang nodig, gebruik dan een firewall op de host en ofwel de gedocumenteerde authenticatie van de tool, ofwel een geauthenticeerde reverse proxy voor de service. Ondersteuning voor API-tokens verschilt per tool: LM Studio documenteert API-tokens en
llama-serveraccepteert--api-key. Ollama luistert standaard op127.0.0.1:11434, enOLLAMA_HOSTwijzigt het bindadres. De lokale API vereist geen authenticatie, dus zet voor LAN-gebruik een geauthenticeerde proxy ervoor. - Behandel modelbestanden als artefacten van derden; leg bron, revisie, licentie en hash vast.
- GGUF-bestanden bevatten geen uitvoerbare code. Models in Hugging Face-formaat kunnen Python-code meeleveren; geef
--trust-remote-codeniet mee aan MLX-LM of Transformers voor een repository die je niet hebt beoordeeld. - Controleer of optionele functies voor documenten, tools, updates of analytics netwerkverzoeken doen.
- Ga er niet van uit dat lokale generatie opgehaalde documenten, logs of neveneffecten van tools veilig maakt.