Локальные LLM на macOS: Ollama, LM Studio, MLX, llama.cpp

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
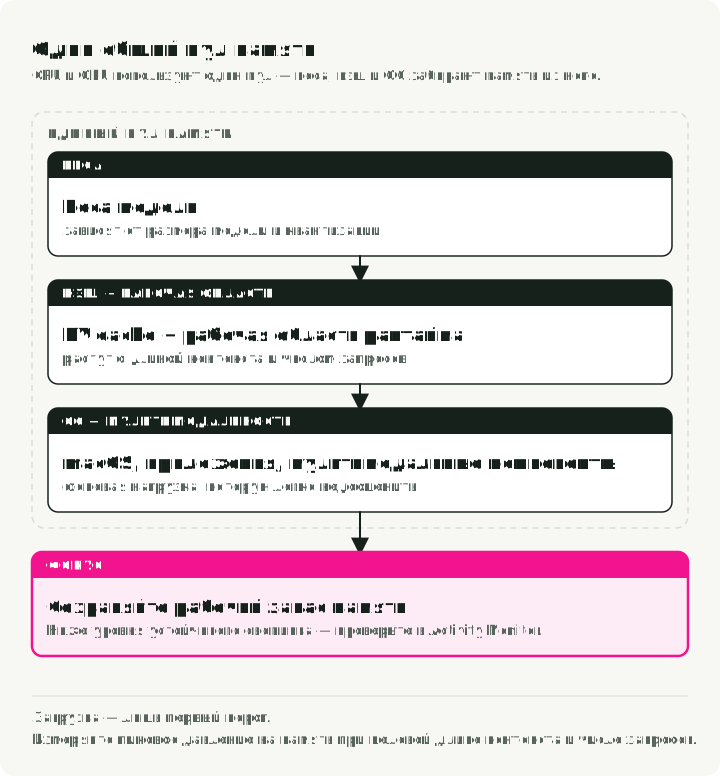
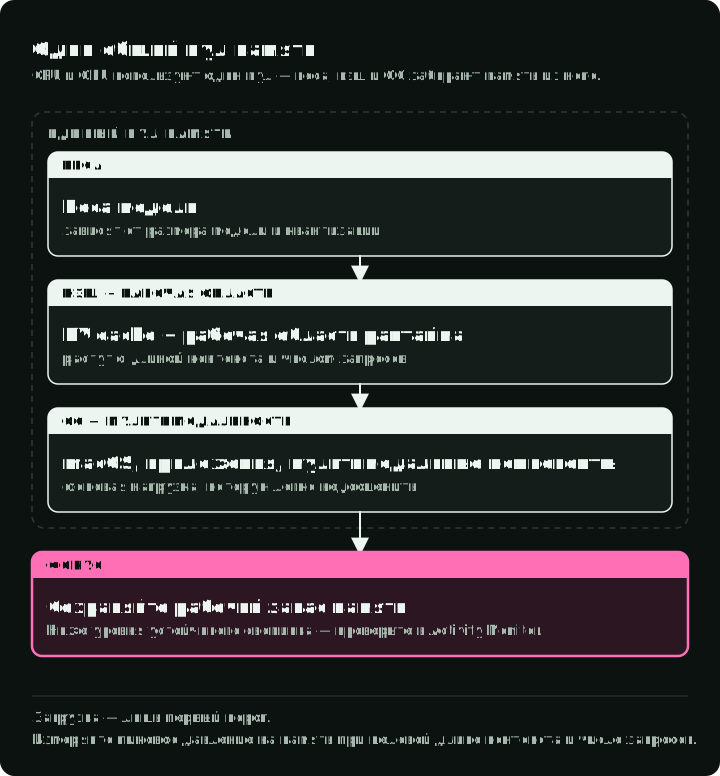
Инженеру, который запускает локальные модели на Mac с Apple Silicon, нужно оценить всю нагрузку целиком, а не просто выбрать модель, которая скачивается. Apple Silicon справляется с обычными промптами без удалённого API: CPU и GPU делят один пул унифицированной памяти. Но веса модели делят эту память с кэшем, который хранит контекст, с рабочими буферами рантайма и с самой macOS.
Когда модель, контекст и запас памяти помещаются, выбирайте инструмент под свой способ работы: Ollama для управляемого локального сервиса, LM Studio для знакомства с моделями в десктопном приложении, llama.cpp для прямого контроля над флагами рантайма, MLX-LM для нативного для Apple Python. Из статьи вы узнаете, как оценить память, для чего нужен каждый инструмент, как его запустить и как сравнить их на одной и той же нагрузке.
Краткую таблицу для выбора смотрите в статье Инструменты для локальных LLM на macOS в 2026 году.
Сколько памяти нужно локальной модели
В статье повторяются четыре термина:
- Квантизация хранит веса модели в меньшем числе бит, чтобы сократить расход памяти. В имени файла вроде
Llama-3.1-8B-Instruct-Q4_K_M.ggufQ4обозначает 4-битную схему;Q4_K_Mв среднем даёт чуть меньше 5 бит на вес, если учесть масштабы и несколько тензоров повышенной точности. - GGUF — однофайловый формат моделей, который используют llama.cpp и построенные на нём инструменты. MLX-LM загружает модели, сконвертированные под MLX, поэтому одна и та же модель поставляется отдельными загрузками в GGUF и в MLX.
- KV cache хранит ключи и значения аттеншна для каждого токена контекста. Он растёт вместе с длиной контекста и числом параллельных запросов.
- Семейство чекпоинтов — это одна базовая модель одного размера, например Llama 3.1 8B Instruct, независимо от формата файла и квантизации.
График складывает веса и KV cache для Llama 3.1 8B в Q4_K_M при контексте 8K и 32K. Эти суммы сравниваются с рекомендованным объёмом рабочей памяти GPU, который сообщил один Mac M1 с 16 ГБ; рабочая область рантайма и macOS требуют дополнительной памяти.
Размер квантизованных весов — только первое слагаемое:
peak memory ≈ model weights
            + KV cache
            + runtime workspace
            + multimodal components
            + application and OS memory
На результат влияют длина контекста, dtype кэша, число параллельных запросов и архитектура модели. Слагаемое, которым проще всего управлять напрямую, — KV cache, через длину контекста:
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valueДля Llama 3.1 8B (32 слоя, 8 KV-голов, размерность головы 128) с 16-битным кэшем получается 2 × 32 × 8 × 128 × 2 = 131 072 байта, то есть 128 КиБ на токен. Контекст 8K требует 1 ГиБ кэша на запрос, контекст 32K — 4 ГиБ. Веса Q4_K_M — это файл на 4,9 ГБ (4,6 ГиБ). До учёта рабочей области модели нужно около 5,6 ГиБ при контексте 8K и около 8,6 ГиБ при 32K.
Metal сообщает рекомендованный объём рабочей памяти GPU, recommendedMaxWorkingSetSize. Он оценивает, сколько памяти GPU можно выделить без ухудшения производительности рантайма. Это рекомендация по производительности, а не принудительный предел выделения памяти. В отчёте 2023 года об одном M1 с 16 ГБ llama.cpp напечатал 10 923 МБ, примерно 10,7 GiB или две трети RAM. Относительно этой рекомендации сумма для 8K оставляет 5,1 GiB на рабочую область и запас, а для 32K — 2,1 GiB. Проверьте значение на своём Mac и измерьте всю нагрузку, прежде чем решать, помещается ли она. У Mac с 8 ГБ меньше запаса: одни эти веса уже требуют 4,6 GiB.
Планируйте и место на диске. Каждая 4-битная модель на 7B или 8B — это загрузка на 4–5 ГБ, а небольшая библиотека моделей в обоих форматах занимает 10–20 ГБ.
Во время тестов следите за Activity Monitor или собственными метриками рантайма. Apple определяет нагрузку на память через свободную память, скорость свопа, wired-память и кэшированные файлы. Оставляйте достаточный запас, чтобы не уходить в долгий своп: модель, которая загрузилась, но загнала систему под нагрузку на память, плохо подходит для интерактивной работы.
В каждом разделе ниже показано, где задать длину контекста, потому что именно эта настройка сильнее всего меняет KV cache.
Четыре инструмента решают разные задачи рабочего процесса
| Инструмент | Основной интерфейс | Формат модели | Лицензия | Выбирайте, когда |
|---|---|---|---|---|
| Ollama | CLI и локальный HTTP API | Управляемые пакеты моделей, в основном GGUF | MIT | Приложению нужен простой управляемый локальный сервис |
| LM Studio | Десктопный UI, CLI, SDK, локальные API | GGUF и MLX | Проприетарное приложение, бесплатно для работы; SDK под MIT | Человеку нужно находить, сравнивать, изучать и запускать модели визуально |
| llama.cpp | CLI, библиотека C/C++, локальный сервер | GGUF | MIT | Нужны прямые флаги, инструменты конвертации и квантизации или встроенный инференс |
| MLX-LM | Python и CLI | Веса в формате MLX | MIT | Вы пишете Python под Apple Silicon или делаете файн-тюнинг модели на том же Mac |
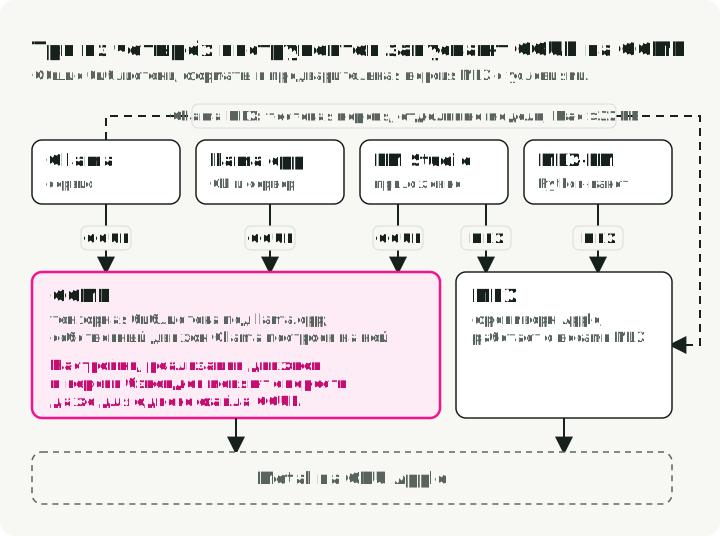
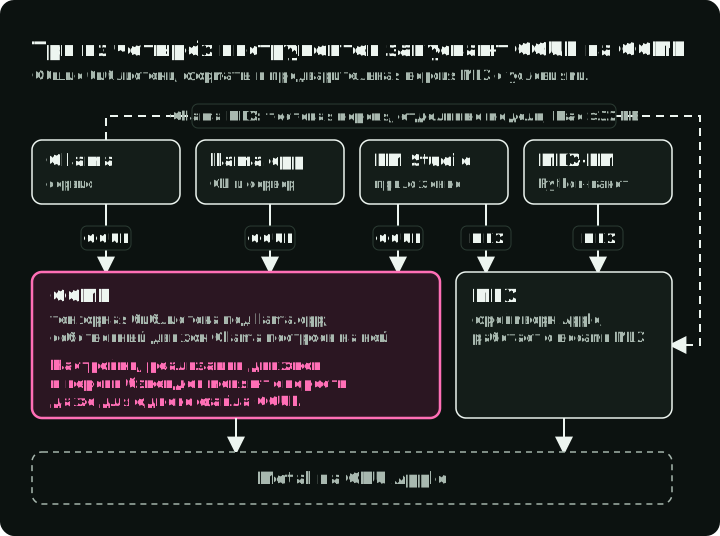
Это таблица назначения инструментов, а не рейтинг скорости. Три инструмента используют общую библиотеку тензоров. Ollama запускает модели GGUF на собственном движке, построенном на GGML — библиотеке, которую использует llama.cpp. Предварительная версия MLX в Ollama от марта 2026 года также запускает отдельные модели на Mac с более чем 32 ГБ памяти. LM Studio запускает модели GGUF через llama.cpp, а модели MLX через MLX. Общая библиотека GGML не означает одинаковые движки инференса. Даже для одного файла GGUF на скорость могут влиять значения по умолчанию, например длина контекста и размер батча, реализации движков и версии бэкендов.
Диаграмма показывает форматы моделей и общие библиотеки каждого инструмента, включая доступный при определённых условиях вариант MLX в Ollama.
Если вы пока не знаете, какой у вас рабочий процесс, используйте последний столбец таблицы. Если хотите просто запустить что-нибудь сегодня, начните с Ollama.
Одна задача выходит за рамки этих четырёх инструментов: KoboldCpp, форк llama.cpp с веб-интерфейсом, создан для длинной художественной прозы и ролевых игр. Он распространяется под AGPL, что важно, если вы поставляете его внутри продукта.
Один API для всех четырёх инструментов
Все четыре инструмента могут поднять совместимый с OpenAI API на localhost. Код приложения, который использует клиент openai, переключается между инструментами сменой base_url, и тем же клиентом можно прогнать бенчмарк всех четырёх.
| Инструмент | Команда запуска сервера | base_url по умолчанию |
|---|---|---|
| Ollama | ollama serve (приложение macOS запускает его само) | http://localhost:11434/v1 |
| LM Studio | lms server start | http://localhost:1234/v1 |
| llama.cpp | llama-server -hf <repo>:<quant> | http://localhost:8080/v1 |
| MLX-LM | mlx_lm.server --model <repo> | http://localhost:8080/v1 |
Клиент требует значение ключа API. Используйте local как заглушку, если аутентификация сервера отключена, и свой настроенный токен, если она включена. llama-server и mlx_lm.server по умолчанию используют порт 8080, поэтому запустите один из них с --port 8081, чтобы работали оба.
Примерам на Python, которые импортируют openai, нужен пакет openai. Бенчмарк ниже содержит команду запуска сохранённого скрипта с этой зависимостью.
from openai import OpenAI

# Swap base_url for :1234 (LM Studio) or :8080 (llama.cpp, MLX-LM).
client = OpenAI(base_url="http://localhost:11434/v1", api_key="local")
В разделе о бенчмарках ниже этот клиент замеряет время всех четырёх инструментов одним скриптом.
Ollama: управляемый локальный сервис
Ollama берёт на себя загрузку моделей, шаблоны, жизненный цикл процесса и API на localhost. Он удобен, когда код приложения должен обращаться к стабильному локальному сервису, а не сам отвечать за флаги инференса.
MODEL=llama3.2
ollama pull "$MODEL"
ollama show "$MODEL"   # architecture, parameters, context length, quantization
ollama run "$MODEL" "Explain unified memory."

curl http://localhost:11434/api/chat \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "'"$MODEL"'",
      "messages": [{"role": "user", "content": "Explain unified memory."}],
      "options": {"num_ctx": 8192},
      "stream": false
    }'
Опция num_ctx задаёт длину контекста для одного запроса. Чтобы задать её для всего сервера, запустите его с OLLAMA_CONTEXT_LENGTH=8192 ollama serve или используйте ползунок в настройках приложения. Если не сделать ни того, ни другого, Ollama выбирает значение по умолчанию по доступной памяти: 4K токенов, если доступно меньше 24 ГиБ памяти GPU. ollama ps показывает контекст, который использует каждая загруженная модель.
Короткое имя из библиотеки, например llama3.2, не указывает на фиксированный файл: после обновления то же имя может вести на другую сборку. В каждой оценке записывайте ID, который печатает ollama list, то есть начало дайджеста модели.
Ollama жертвует частью низкоуровневой видимости ради удобства управления жизненным циклом. Переходите на llama.cpp или другой рантайм, когда нужно напрямую управлять файлом GGUF, шаблоном чата, настройкой кэша или новой возможностью бэкенда.
LM Studio: десктопное знакомство с моделями и локальные API
LM Studio полезен, когда поиск моделей, настройка загрузки, просмотр чата и сравнение моделей людьми бок о бок должны происходить в одном процессе. Он предоставляет нативные SDK для Python и TypeScript, совместимые с OpenAI адреса API, structured output, tool use и headless-демон, так что это не просто десктопный GUI. Его окно чата также принимает прикреплённые файлы .pdf, .docx и .txt в качестве контекста, этого хватает для простых вопросов по документам без написания кода.
Текущий Python SDK подключается к уже скачанной модели. Запустите локальный сервер LM Studio, сохраните код как lmstudio_demo.py и выполните uv run --with lmstudio python lmstudio_demo.py. Если аутентификация включена, задайте LM_API_TOKEN; SDK прочитает его автоматически.
import lmstudio as lms

MODEL_KEY = "ibm/granite-4-micro"

with lms.Client() as client:
    model = client.llm.model(MODEL_KEY)
    response = model.respond("Write one sentence about local inference.")
    print(response)
Запустите локальный API на вкладке Developer или из CLI. lms load задаёт длину контекста при загрузке модели, а --estimate-only печатает оценку памяти, ничего не загружая:
lms server start
lms load ibm/granite-4-micro --context-length 8192 --estimate-only
lms load ibm/granite-4-micro --context-length 8192
LM Studio может работать на localhost или в локальной сети и поддерживает API-токены в настройках аутентификации API. Держите его на loopback, если удалённый доступ не нужен намеренно. Если вы открываете его в LAN, включите описанную в документации опцию API-токена, настройте правило файрвола на хосте и проверьте доступ инструментов и интеграций.
llama.cpp: прямой запуск GGUF
llama.cpp — эталонный инструмент для файлов GGUF, когда вы хотите сами задавать флаги рантайма. Он поддерживает Apple Metal, а также CPU и другие аппаратные бэкенды.
brew install llama.cpp

# Download through the Hugging Face integration and select a quantization.
MODEL_REPO=ggml-org/gemma-3-1b-it-GGUF
QUANT=Q4_K_M
llama-cli -hf "$MODEL_REPO:$QUANT"

# The same model with explicit settings: one turn, then exit.
llama-cli -hf "$MODEL_REPO:$QUANT" \
    -c 8192 -n 256 --temp 0.7 -st \
    -p "Write a Python function that sorts a list."

# Or start an OpenAI-compatible local server with an 8K context.
llama-server -hf "$MODEL_REPO:$QUANT" -c 8192
-c (--ctx-size) задаёт длину контекста, а вместе с ней и размер KV cache. -n ограничивает число генерируемых токенов, --temp задаёт температуру сэмплирования, -st выполняет один ход и завершается, а -p передаёт промпт.
Опция -hf также скачивает подходящий мультимодальный проектор, если он есть в репозитории. Поддержка моделей, шаблоны и флаги CLI быстро меняются, поэтому закрепляйте известную сборку и храните команду запуска вместе с записью об оценке.
Выбирайте llama.cpp, когда цель — прямой контроль, а не потому, что «более низкий уровень» автоматически значит быстрее. Управляемый инструмент может выбрать хорошие значения по умолчанию, а прямые флаги могут и ухудшить производительность.
MLX-LM: нативная для Apple работа на Python
MLX-LM построен на фреймворке Apple MLX для работы с массивами. Он поддерживает генерацию, чат, конвертацию, квантизацию и параметрически эффективный файн-тюнинг для совместимых моделей.
MODEL=mlx-community/Llama-3.2-3B-Instruct-4bit
uv run --with mlx-lm mlx_lm.generate \
    --model "$MODEL" \
    --max-kv-size 8192 \
    --prompt "Explain Metal acceleration in one paragraph."
В MLX-LM нет фиксированной настройки контекста: кэш растёт вместе с промптом и выводом. --max-kv-size ограничивает кэш указанным числом токенов. После достижения предела MLX-LM отбрасывает самые старые токены и сохраняет первые несколько.
Python напрямую даёт доступ к модели и токенизатору. Сохраните этот код как mlx_demo.py и запустите uv run --with mlx-lm python mlx_demo.py:
from mlx_lm import generate, load

MODEL = "mlx-community/Llama-3.2-3B-Instruct-4bit"

model, tokenizer = load(MODEL)
messages = [{"role": "user", "content": "Give one local-LLM benchmark rule."}]
prompt = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
)
print(generate(model, tokenizer, prompt=prompt, max_tokens=80))
HTTP-сервер MLX-LM, mlx_lm.server, в документации назван сервером для разработки с базовыми проверками безопасности, а не продакшен-сервисом. Используйте его для локальных экспериментов или поставьте перед ним прокси с аутентификацией либо собственный API-сервис.
Сравнение инструментов на одной нагрузке
Тестируйте одно семейство чекпоинтов и сопоставимую квантизацию там, где это позволяют форматы. Файл GGUF Q4_K_M и 4-битная модель MLX того же чекпоинта сопоставимы, но не идентичны.
Используйте небольшой набор промптов:
- один короткий интерактивный промпт
- один длинный промпт, близкий к предполагаемому контексту
- structured output или tool calls, если они нужны приложению
- репрезентативная длина генерации
- один повторный запрос, чтобы отличить холодную загрузку от тёплого инференса
Записывайте:
| Метрика | Зачем нужна |
|---|---|
| Результат задачи | Быстрая неправильная модель бесполезна |
| Время до первого токена | Отзывчивость в интерактивной работе |
| Выходных токенов в секунду | Throughput генерации |
| Пиковая память и нагрузка | Остаётся ли машина пригодной для работы |
| Время холодной загрузки | Опыт работы на десктопе и загрузка по запросу |
| Энергопотребление и нагрев | Длительная работа на ноутбуке |
| Совместимость API и схем | Подходит ли инструмент приложению |
Каждый инструмент сам печатает числа скорости:
- Ollama:
ollama run "$MODEL" --verboseпосле каждого ответа печатает время загрузки, скорость обработки промпта и скорость генерации (выходных токенов в секунду). - llama.cpp:
llama-bench -hf "$MODEL_REPO:$QUANT" -p 512 -n 128измеряет обработку промпта из 512 токенов и генерацию 128 токенов в токенах в секунду. - MLX-LM:
mlx_lm.generateпосле каждого запуска печатает скорость обработки промпта и генерации в токенах в секунду, а также пиковую память. - LM Studio: окно чата показывает токены в секунду и время до первого токена под каждым ответом, а нативный REST API возвращает те же значения в поле
stats.
Чтобы сравнить латентность со стороны клиента, замерьте потоковый запрос к совместимым с OpenAI адресам API из раздела «Один API для всех четырёх инструментов». Скрипт измеряет полную длительность запроса и время до первого видимого текста, затем печатает ответ для проверки. Видимый текст может идти после ризонинга или результата инструмента, поэтому это время не обязательно совпадает со временем рантайма до первого сгенерированного токена.
Запустите выбранный сервер со скачанной моделью, сохраните скрипт как benchmark.py и выполните uv run --with openai python benchmark.py. Меняйте BASE_URL и MODEL для каждого инструмента. Задайте LOCAL_API_KEY равным своему настроенному токену, если аутентификация сервера включена; иначе скрипт использует local как заглушку.
import os
import time

from openai import OpenAI

BASE_URL = "http://localhost:11434/v1"
MODEL = "llama3.2"

client = OpenAI(base_url=BASE_URL, api_key=os.environ.get("LOCAL_API_KEY", "local"))

start = time.perf_counter()
first = None
parts = []
stream = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "Explain unified memory in 200 words."}],
    max_tokens=300,
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        if first is None:
            first = time.perf_counter()
        parts.append(chunk.choices[0].delta.content)
end = time.perf_counter()

print(f"request duration: {end - start:.2f} s")
if first is None:
    print("time to first visible text: unavailable (no visible text)")
else:
    print(f"time to first visible text: {first - start:.2f} s")
print("response:", "".join(parts))
Фрагменты текста в потоке — не число токенов. Для выходных токенов в секунду используйте перечисленные выше счётчики рантайма и записывайте, учитывают ли они ризонинг или результаты инструментов. Например, LM Studio отдельно сообщает общее число выходных токенов и токены ризонинга. Поток без видимого текста сообщает о его отсутствии, а не присваивает латентность текста; проверьте ризонинг, tool calls или статус завершения в интерфейсе рантайма.
Выполняйте каждый запрос дважды: первый может включать загрузку модели, второй — повторно использовать загруженные веса и закэшированное состояние промпта. Записывайте версии рантаймов и настройки кэширования промптов, чтобы повторные запросы оставались сопоставимыми.
Не сравнивайте 4-битную модель одного инструмента с моделью полной точности в другом и не приписывайте разницу рантайму.
Чек-лист по безопасности и приватности
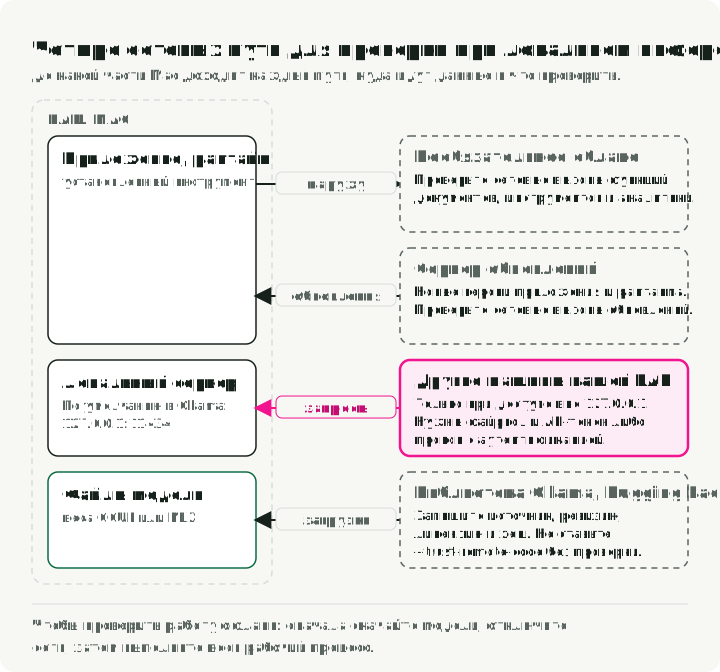
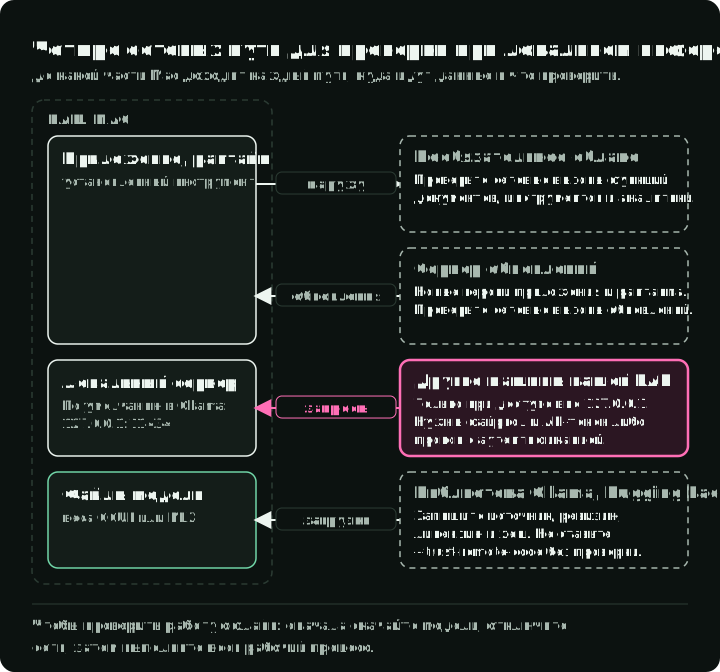
Разделяйте локальный инференс и работу офлайн. Промпты могут оставаться на машине, а приложение при этом обращается к сети за загрузкой моделей, обновлениями или необязательными функциями. Ollama в своём FAQ описывает локальное выполнение, загрузку моделей и необязательные облачные функции отдельно. Считайте работу офлайн требованием к рабочему процессу, которое нужно проверять для каждого приложения: сначала скачайте артефакты, затем отключите сеть и протестируйте весь процесс.
Диаграмма показывает четыре сетевых пути, которые нужно проверить при локальном инференсе: до какой части Mac доходит каждый, куда идут данные и что проверить. Облачные функции и доступ по LAN зависят от конфигурации приложения.
- Привязывайте API к loopback, если сетевой доступ не нужен.
- Если нужен доступ по LAN, используйте файрвол на хосте и либо описанную в документации аутентификацию инструмента, либо обратный прокси с аутентификацией перед сервисом. Поддержка API-токенов зависит от инструмента: LM Studio описывает API-токены, а
llama-serverпринимает--api-key. Ollama по умолчанию слушает127.0.0.1:11434, аOLLAMA_HOSTменяет адрес привязки. Его локальный API не требует аутентификации, поэтому для доступа по LAN поставьте перед ним прокси с аутентификацией. - Относитесь к файлам моделей как к сторонним артефактам: записывайте источник, ревизию, лицензию и хеш.
- Файлы GGUF не содержат исполняемого кода. Модели в формате Hugging Face могут поставляться с кодом на Python: не передавайте
--trust-remote-codeв MLX-LM или Transformers для репозитория, который вы не проверили. - Выясните, делают ли необязательные функции работы с документами, инструментами, обновлений или аналитики сетевые вызовы.
- Не считайте, что локальная генерация делает безопасными найденные документы, логи или побочные эффекты инструментов.