LLMs locais no macOS: Ollama, LM Studio, MLX, llama.cpp

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Quem corre modelos locais num Mac com Apple Silicon precisa de dimensionar a carga de trabalho completa, e não apenas de escolher um modelo que se consiga descarregar. O Apple Silicon consegue executar prompts do dia a dia sem uma API remota, porque o CPU e o GPU partilham uma única memória unificada, mas os pesos do modelo partilham essa memória com a cache que guarda o contexto, com os buffers de trabalho do runtime e com o próprio macOS.
Quando o modelo, o contexto e a margem de memória cabem, escolha a ferramenta que se adequa à sua forma de trabalhar: Ollama para um serviço local gerido, LM Studio para explorar modelos no desktop, llama.cpp para controlo direto das flags do runtime, ou MLX-LM para Python nativo da Apple. Vai aprender a estimar a memória, para que serve cada ferramenta, como executar cada uma e como compará-las na mesma carga de trabalho.
Para a tabela de decisão resumida, veja Ferramentas de LLMs locais no macOS em 2026.
Quanta memória precisa um modelo local
Quatro termos aparecem ao longo deste artigo:
- Quantização guarda os pesos do modelo em menos bits para reduzir a memória. Num nome de ficheiro como
Llama-3.1-8B-Instruct-Q4_K_M.gguf,Q4indica um esquema de 4 bits;Q4_K_Mtem em média pouco menos de 5 bits por peso, depois de contar as escalas e alguns tensores de maior precisão. - GGUF é o formato de modelo num único ficheiro usado pelo llama.cpp e pelas ferramentas construídas sobre ele. O MLX-LM carrega modelos convertidos para MLX, por isso o mesmo modelo é distribuído em downloads separados de GGUF e de MLX.
- KV cache guarda as chaves e os valores de atenção de cada token do contexto. Cresce com o tamanho do contexto e com o número de pedidos em paralelo.
- Família de checkpoint significa um modelo base com um tamanho, como o Llama 3.1 8B Instruct, qualquer que seja o seu formato de ficheiro ou quantização.
O gráfico soma os pesos e a KV cache de Llama 3.1 8B em Q4_K_M, com contextos de 8K e 32K. Compara esses subtotais com o conjunto de trabalho recomendado da GPU indicado num Mac M1 com 16 GB; o espaço de trabalho do runtime e o macOS precisam de memória adicional.
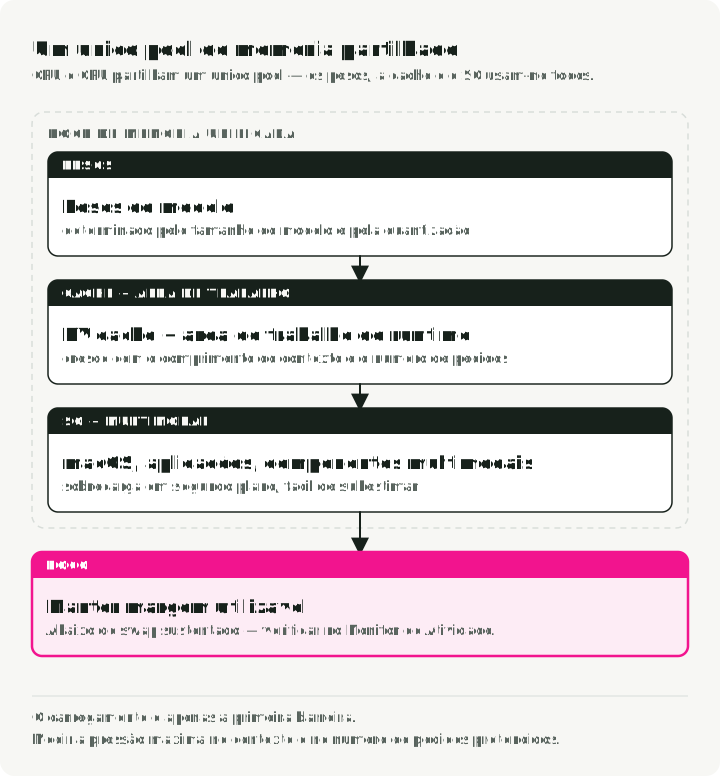
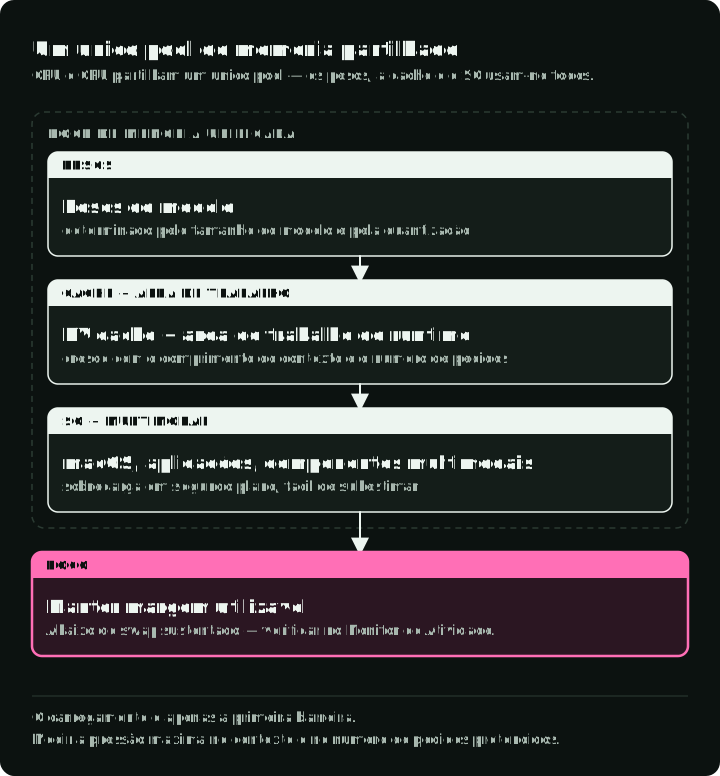
O tamanho bruto dos pesos quantizados é apenas a primeira parcela:
peak memory ≈ model weights
            + KV cache
            + runtime workspace
            + multimodal components
            + application and OS memory
O tamanho do contexto, o dtype da cache, os pedidos em paralelo e a arquitetura do modelo alteram o resultado. A KV cache é a parcela que controla mais diretamente, através do tamanho do contexto:
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valuePara o Llama 3.1 8B (32 camadas, 8 KV heads, dimensão de head 128) com uma cache de 16 bits, isso dá 2 × 32 × 8 × 128 × 2 = 131 072 bytes, ou 128 KiB por token. Um contexto de 8K precisa de 1 GiB de cache por pedido, e um contexto de 32K precisa de 4 GiB. Os pesos Q4_K_M são um ficheiro de 4,9 GB (4,6 GiB). Antes da área de trabalho, o modelo precisa de cerca de 5,6 GiB com contexto de 8K e de cerca de 8,6 GiB com contexto de 32K.
O Metal indica um tamanho recomendado para o conjunto de trabalho da GPU, recommendedMaxWorkingSetSize, que estima quanta memória da GPU pode ser atribuída sem afetar o desempenho do runtime. É uma recomendação de desempenho, não um limite imposto à atribuição. Num relatório de 2023 sobre um M1 com 16 GB, o llama.cpp imprimiu 10 923 MB, cerca de 10,7 GiB ou dois terços da RAM. Face a essa recomendação, o subtotal de 8K deixa 5,1 GiB para o espaço de trabalho e a margem; o de 32K deixa 2,1 GiB. Verifique o valor no seu próprio Mac e meça a carga completa antes de decidir se cabe. Um Mac com 8 GB tem menos margem, e só estes pesos já precisam de 4,6 GiB.
Planeie também o espaço em disco. Cada modelo de 7B ou 8B a 4 bits é um download de 4–5 GB, e uma pequena biblioteca de modelos nos dois formatos ocupa 10–20 GB.
Use o Monitor de Atividade ou as métricas do próprio runtime durante os testes. A Apple define a pressão de memória com base na memória livre, na taxa de swap, na memória wired e nos ficheiros em cache. Deixe margem suficiente para evitar swap prolongado; um modelo que carrega mas leva o sistema a pressão de memória não serve para uso interativo.
Cada secção de ferramenta abaixo mostra onde definir o tamanho do contexto, porque essa definição é a que mais altera a KV cache.
As quatro ferramentas resolvem problemas diferentes de fluxo de trabalho
| Ferramenta | Interface principal | Formato do modelo | Licença | Escolha-a quando |
|---|---|---|---|---|
| Ollama | CLI e API HTTP local | Pacotes de modelos geridos, sobretudo GGUF | MIT | Uma aplicação precisa de um serviço local gerido e simples |
| LM Studio | Interface desktop, CLI, SDKs, APIs locais | GGUF e MLX | Aplicação proprietária, gratuita para trabalho; SDKs MIT | Uma pessoa precisa de descobrir, comparar, inspecionar e servir modelos visualmente |
| llama.cpp | CLI, biblioteca C/C++, servidor local | GGUF | MIT | Precisa de flags diretas, ferramentas de conversão e quantização, ou inferência embebida |
| MLX-LM | Python e CLI | Pesos em formato MLX | MIT | Está a escrever Python para Apple Silicon ou a fazer fine-tuning de um modelo no mesmo Mac |
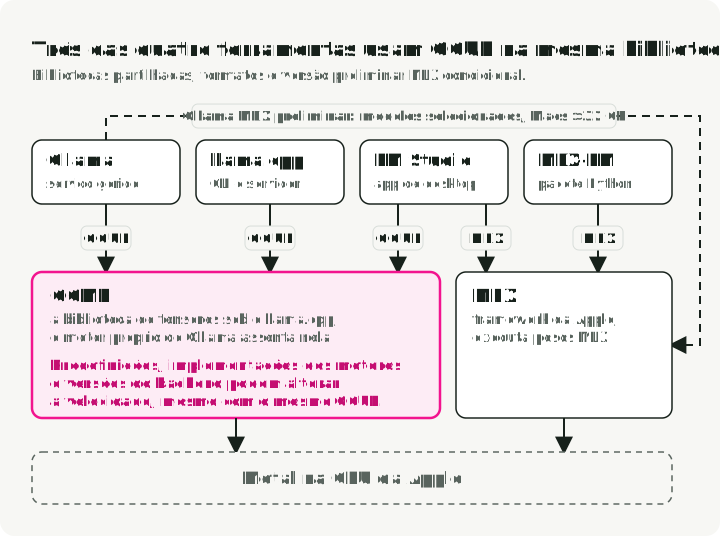
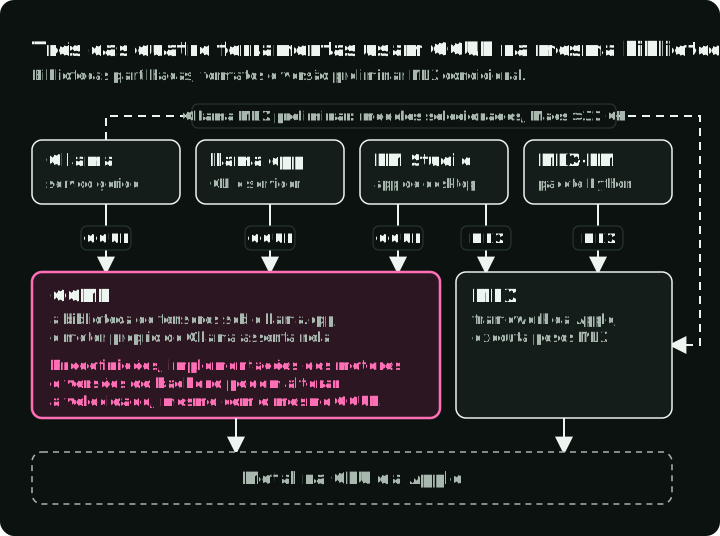
Esta é uma tabela de responsabilidades, não uma classificação de velocidade. Três ferramentas partilham uma biblioteca de tensores. O Ollama executa modelos GGUF com o seu próprio motor, construído sobre GGML, a biblioteca em que assenta o llama.cpp. A versão preliminar MLX do Ollama de março de 2026 também executa modelos selecionados em Macs com mais de 32 GB de memória. O LM Studio executa modelos GGUF com llama.cpp e modelos MLX com MLX. Partilhar GGML não significa usar motores de inferência idênticos. Mesmo com o mesmo ficheiro GGUF, as predefinições, como o comprimento do contexto e o tamanho do lote, as implementações dos motores e as versões do backend podem afetar a velocidade.
O diagrama mostra os formatos de modelos e as bibliotecas partilhadas usadas por cada ferramenta, incluindo o percurso condicional de MLX do Ollama.
Se ainda não sabe qual é o seu fluxo de trabalho, use a última coluna da tabela. Comece pelo Ollama se só quer ter algo a funcionar hoje.
Há um caso fora das quatro ferramentas: o KoboldCpp, um fork do llama.cpp com interface web, foi feito para ficção longa e role-play. Tem licença AGPL, o que importa se o distribuir dentro de um produto.
Uma API para as quatro ferramentas
As quatro ferramentas podem servir uma API compatível com a OpenAI em localhost. O código de aplicação que usa o cliente openai pode mudar de ferramenta alterando base_url, e o mesmo cliente pode fazer o benchmark das quatro.
| Ferramenta | Comando do servidor | base_url por omissão |
|---|---|---|
| Ollama | ollama serve (a app macOS executa-o) | http://localhost:11434/v1 |
| LM Studio | lms server start | http://localhost:1234/v1 |
| llama.cpp | llama-server -hf <repo>:<quant> | http://localhost:8080/v1 |
| MLX-LM | mlx_lm.server --model <repo> | http://localhost:8080/v1 |
O cliente exige um valor de chave API. Use local como valor de substituição quando a autenticação do servidor está desativada; use o seu token configurado quando está ativada. llama-server e mlx_lm.server usam ambos a porta 8080 por predefinição, por isso inicie um deles com --port 8081 para executar ambos.
Os exemplos Python que importam openai precisam do pacote openai. O benchmark abaixo inclui um comando que executa o script guardado com essa dependência.
from openai import OpenAI

# Swap base_url for :1234 (LM Studio) or :8080 (llama.cpp, MLX-LM).
client = OpenAI(base_url="http://localhost:11434/v1", api_key="local")
A secção de benchmark abaixo usa este cliente para medir o tempo das quatro ferramentas com um único script.
Ollama: serviço local gerido
O Ollama gere os downloads de modelos, os templates, o ciclo de vida dos processos e uma API em localhost. É útil quando o código da aplicação deve usar um serviço local estável, em vez de ser ele a controlar as flags de inferência.
MODEL=llama3.2
ollama pull "$MODEL"
ollama show "$MODEL"   # architecture, parameters, context length, quantization
ollama run "$MODEL" "Explain unified memory."

curl http://localhost:11434/api/chat \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "'"$MODEL"'",
      "messages": [{"role": "user", "content": "Explain unified memory."}],
      "options": {"num_ctx": 8192},
      "stream": false
    }'
A opção num_ctx define o tamanho do contexto de um pedido. Para o definir em todo o servidor, inicie-o com OLLAMA_CONTEXT_LENGTH=8192 ollama serve ou use o controlo deslizante nas definições da app. Sem nenhuma das duas, o Ollama escolhe um valor por omissão com base na memória disponível: 4K tokens quando há menos de 24 GiB de memória de GPU disponíveis. ollama ps mostra o contexto que cada modelo carregado usa.
Um nome curto de biblioteca como llama3.2 não identifica um ficheiro fixo; o mesmo nome pode apontar para outra versão depois de uma atualização. Registe o ID que ollama list apresenta, que é o início do digest do modelo, em cada avaliação.
O Ollama troca alguma visibilidade de baixo nível pela conveniência no ciclo de vida. Passe para o llama.cpp ou para outro runtime quando precisar de controlar diretamente um ficheiro GGUF, um template de chat, uma definição da cache ou uma funcionalidade nova do backend.
LM Studio: exploração no desktop e APIs locais
O LM Studio é útil quando a descoberta de modelos, a configuração de carregamento, a inspeção do chat e a avaliação humana lado a lado pertencem ao mesmo fluxo de trabalho. Expõe SDKs nativos de Python e TypeScript, endpoints compatíveis com a OpenAI, structured output, tool use e um daemon headless, por isso é mais do que uma interface gráfica de desktop. A sua vista de chat também aceita ficheiros .pdf, .docx e .txt anexados como contexto, o que cobre perguntas simples sobre documentos sem escrever código.
O SDK Python atual liga-se a um modelo que já descarregou. Inicie o servidor local do LM Studio, guarde este código como lmstudio_demo.py e execute uv run --with lmstudio python lmstudio_demo.py. Se a autenticação estiver ativada, defina LM_API_TOKEN; o SDK lê-o automaticamente.
import lmstudio as lms

MODEL_KEY = "ibm/granite-4-micro"

with lms.Client() as client:
    model = client.llm.model(MODEL_KEY)
    response = model.respond("Write one sentence about local inference.")
    print(response)
Inicie a API local a partir do separador Developer ou da CLI. lms load define o tamanho do contexto ao carregar um modelo, e --estimate-only apresenta a estimativa de memória sem carregar nada:
lms server start
lms load ibm/granite-4-micro --context-length 8192 --estimate-only
lms load ibm/granite-4-micro --context-length 8192
O LM Studio pode servir em localhost ou numa rede local e suporta tokens de API nas suas definições de autenticação da API. Mantenha-o em loopback, a menos que o acesso remoto seja deliberado. Se o expuser numa LAN, exija a opção documentada de token de API, aplique uma regra de firewall no host e reveja o acesso de ferramentas e integrações.
llama.cpp: execução direta de GGUF
O llama.cpp é a ferramenta de referência para ficheiros GGUF quando quer definir as flags do runtime por si. Suporta o Apple Metal, além de CPU e de outros backends de hardware.
brew install llama.cpp

# Download through the Hugging Face integration and select a quantization.
MODEL_REPO=ggml-org/gemma-3-1b-it-GGUF
QUANT=Q4_K_M
llama-cli -hf "$MODEL_REPO:$QUANT"

# The same model with explicit settings: one turn, then exit.
llama-cli -hf "$MODEL_REPO:$QUANT" \
    -c 8192 -n 256 --temp 0.7 -st \
    -p "Write a Python function that sorts a list."

# Or start an OpenAI-compatible local server with an 8K context.
llama-server -hf "$MODEL_REPO:$QUANT" -c 8192
-c (--ctx-size) define o tamanho do contexto e, com ele, o tamanho da KV cache. -n limita o número de tokens gerados, --temp define a temperatura de amostragem, -st executa um único turno e termina, e -p fornece o prompt.
A opção -hf também descarrega um projetor multimodal correspondente quando o repositório tem um. O suporte de modelos, os templates e as flags da CLI mudam depressa, por isso fixe uma build conhecida e guarde o comando de arranque junto do registo da avaliação.
Escolha o llama.cpp quando o objetivo for o controlo direto, e não porque “mais baixo nível” signifique automaticamente mais rápido. Uma ferramenta gerida pode escolher bons valores por omissão; flags diretas também podem piorar o desempenho.
MLX-LM: trabalho em Python nativo da Apple
O MLX-LM assenta no framework de arrays MLX da Apple. Suporta geração, chat, conversão, quantização e fine-tuning eficiente em parâmetros para modelos compatíveis.
MODEL=mlx-community/Llama-3.2-3B-Instruct-4bit
uv run --with mlx-lm mlx_lm.generate \
    --model "$MODEL" \
    --max-kv-size 8192 \
    --prompt "Explain Metal acceleration in one paragraph."
O MLX-LM não tem uma definição fixa de contexto: a cache cresce com o prompt e com a saída. --max-kv-size limita a cache a esse número de tokens. Acima do limite, o MLX-LM descarta os tokens mais antigos e mantém apenas alguns tokens do início.
O Python expõe diretamente o modelo e o tokenizer. Guarde isto como mlx_demo.py e execute uv run --with mlx-lm python mlx_demo.py:
from mlx_lm import generate, load

MODEL = "mlx-community/Llama-3.2-3B-Instruct-4bit"

model, tokenizer = load(MODEL)
messages = [{"role": "user", "content": "Give one local-LLM benchmark rule."}]
prompt = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
)
print(generate(model, tokenizer, prompt=prompt, max_tokens=80))
O servidor HTTP do MLX-LM, mlx_lm.server, está documentado como um servidor de desenvolvimento com verificações de segurança básicas, não como um serviço de produção. Use-o para experimentação local ou coloque à frente dele um proxy autenticado ou a sua própria API.
Comparar ferramentas na mesma carga de trabalho
Teste a mesma família de checkpoint e uma quantização comparável, quando os formatos o permitirem. Um ficheiro GGUF Q4_K_M e um modelo MLX de 4 bits do mesmo checkpoint são comparáveis, não idênticos.
Use um pequeno conjunto de prompts com:
- um prompt interativo curto
- um prompt longo perto do contexto pretendido
- structured output ou tool calls, se a aplicação precisar deles
- um comprimento de geração representativo
- um pedido repetido para distinguir o carregamento a frio da inferência a quente
Registe:
| Métrica | Porque importa |
|---|---|
| Resultado da tarefa | Um modelo rápido e errado não serve |
| Tempo até ao primeiro token | Capacidade de resposta interativa |
| Tokens de saída por segundo | Débito de geração |
| Pico de memória e pressão | Se a máquina continua utilizável |
| Tempo de carregamento a frio | Experiência no desktop e a pedido |
| Comportamento energético e térmico | Uso prolongado em portátil |
| Compatibilidade de API/schema | Se a ferramenta se adequa à aplicação |
Cada ferramenta apresenta os números de velocidade por si:
- Ollama:
ollama run "$MODEL" --verboseapresenta a duração do carregamento, a taxa de avaliação do prompt e a taxa de avaliação (tokens de saída por segundo) depois de cada resposta. - llama.cpp:
llama-bench -hf "$MODEL_REPO:$QUANT" -p 512 -n 128mede o processamento de um prompt de 512 tokens e a geração de 128 tokens, em tokens por segundo. - MLX-LM:
mlx_lm.generateapresenta os tokens por segundo do prompt e da geração e o pico de memória depois de cada execução. - LM Studio: a vista de chat mostra os tokens por segundo e o tempo até ao primeiro token por baixo de cada resposta, e a REST API nativa devolve os mesmos valores no campo
stats.
Para comparar a latência observada pelo cliente, cronometre um pedido em streaming aos endpoints compatíveis com OpenAI indicados em «Uma API para as quatro ferramentas». O script mede a duração total do pedido e o tempo até ao primeiro texto visível, e depois imprime a resposta para inspeção. O texto visível pode surgir depois do raciocínio ou da saída de ferramentas, por isso este tempo não é necessariamente o tempo do runtime até ao primeiro token gerado.
Inicie o servidor escolhido com um modelo descarregado, guarde o script como benchmark.py e execute uv run --with openai python benchmark.py. Altere BASE_URL e MODEL por ferramenta. Defina LOCAL_API_KEY com o seu token configurado se a autenticação do servidor estiver ativada; caso contrário, o script usa local como valor de substituição.
import os
import time

from openai import OpenAI

BASE_URL = "http://localhost:11434/v1"
MODEL = "llama3.2"

client = OpenAI(base_url=BASE_URL, api_key=os.environ.get("LOCAL_API_KEY", "local"))

start = time.perf_counter()
first = None
parts = []
stream = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "Explain unified memory in 200 words."}],
    max_tokens=300,
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        if first is None:
            first = time.perf_counter()
        parts.append(chunk.choices[0].delta.content)
end = time.perf_counter()

print(f"request duration: {end - start:.2f} s")
if first is None:
    print("time to first visible text: unavailable (no visible text)")
else:
    print(f"time to first visible text: {first - start:.2f} s")
print("response:", "".join(parts))
Os fragmentos de texto em streaming não são contagens de tokens. Para obter tokens de saída por segundo, use os contadores do runtime indicados acima e registe se incluem raciocínio ou saída de ferramentas. Por exemplo, o LM Studio apresenta separadamente os tokens de saída totais e os de raciocínio. Um stream sem texto visível indica essa ausência em vez de atribuir uma latência de texto; inspecione o raciocínio, os tool calls ou o estado de conclusão através da interface do runtime.
Execute cada pedido duas vezes: o primeiro pode incluir o carregamento do modelo e o segundo pode reutilizar os pesos carregados e o estado do prompt em cache. Registe as versões do runtime e as definições de cache de prompts para que os pedidos repetidos continuem comparáveis.
Não compare o modelo de 4 bits de uma ferramenta com o modelo de precisão total de outra e atribua a diferença ao runtime.
Checklist de segurança e privacidade
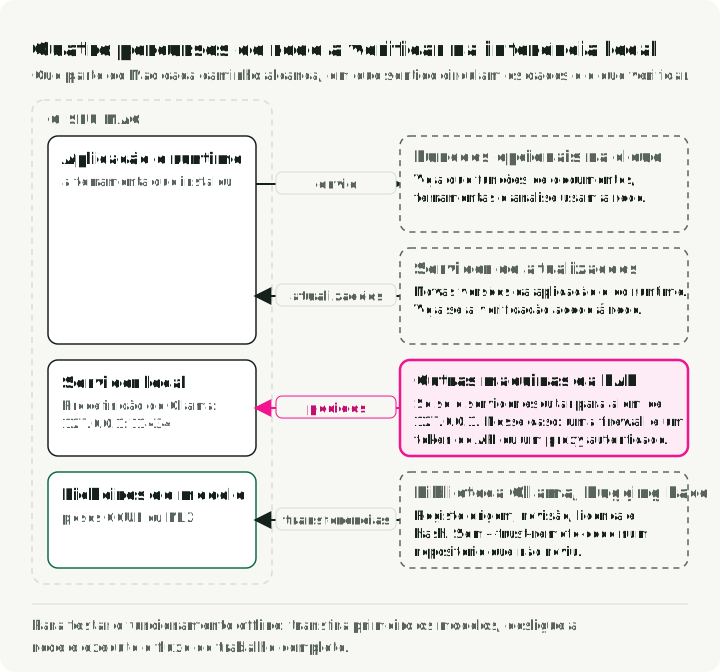
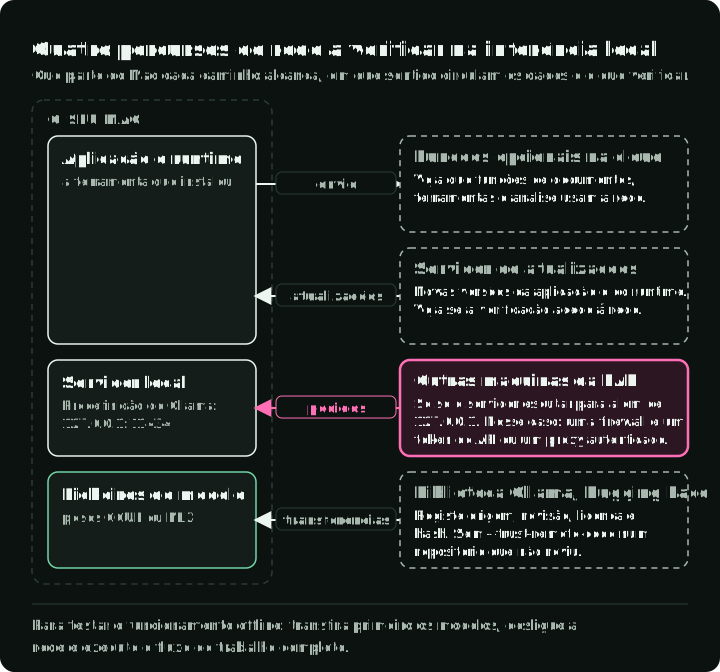
Separe inferência local de funcionamento offline. Os prompts podem ficar na máquina enquanto a aplicação ainda acede à rede para downloads de modelos, atualizações ou funcionalidades opcionais. O Ollama documenta separadamente a execução local, os downloads de modelos e as funcionalidades opcionais na cloud nas suas FAQ. Trate o funcionamento offline como um requisito do fluxo de trabalho a verificar em cada aplicação: descarregue primeiro os artefactos, desligue a rede e teste o fluxo de trabalho completo.
O diagrama mostra quatro percursos de rede a verificar durante a inferência local: que parte do Mac cada um alcança, em que sentido circulam os dados e o que verificar em cada um. As funcionalidades na nuvem e o acesso por LAN dependem da configuração da aplicação.
- Associe as APIs ao loopback, a menos que o acesso por rede seja necessário.
- Se o acesso por LAN for necessário, use uma firewall no host e a autenticação documentada da ferramenta ou um reverse proxy autenticado à frente do serviço. O suporte a tokens de API depende da ferramenta: o LM Studio documenta tokens de API e o
llama-serveraceita--api-key. O Ollama escuta em127.0.0.1:11434por omissão, eOLLAMA_HOSTaltera o endereço de associação. A sua API local não exige autenticação, por isso coloque um proxy autenticado à frente dela para uso em LAN. - Trate os ficheiros de modelo como artefactos de terceiros; registe a origem, a revisão, a licença e o hash.
- Os ficheiros GGUF não contêm código executável. Os modelos em formato Hugging Face podem incluir código Python; não passe
--trust-remote-codeao MLX-LM nem ao Transformers para um repositório que não reviu. - Confirme se funcionalidades opcionais de documentos, ferramentas, atualizações ou analítica fazem chamadas de rede.
- Não assuma que a geração local torna seguros os documentos obtidos, os logs ou os efeitos secundários das ferramentas.