LLMs locales en macOS: Ollama, LM Studio, MLX, llama.cpp

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Quien ejecuta modelos locales en un Mac con Apple Silicon debe dimensionar la carga completa, no solo elegir un modelo que se descargue. Apple Silicon puede ejecutar prompts cotidianos sin una API remota porque la CPU y la GPU comparten un pool de memoria unificada, pero los pesos del modelo comparten esa memoria con la caché que guarda el contexto, los búferes de trabajo del runtime y el propio macOS.
Cuando el modelo, el contexto y el margen de memoria encajan, elige la herramienta que se ajuste a tu forma de trabajar: Ollama para un servicio local gestionado, LM Studio para explorar modelos desde el escritorio, llama.cpp para controlar directamente los flags del runtime, o MLX-LM para Python nativo de Apple. Aprenderás a estimar la memoria, para qué sirve cada herramienta, cómo ejecutarla y cómo compararlas con la misma carga de trabajo.
Para la tabla de decisión resumida, consulta Herramientas de LLMs locales en macOS en 2026.
Cuánta memoria necesita un modelo local
En este artículo aparecen cuatro términos:
- Cuantización guarda los pesos del modelo con menos bits para reducir la memoria. En un nombre de archivo como
Llama-3.1-8B-Instruct-Q4_K_M.gguf,Q4indica un esquema de 4 bits;Q4_K_Mpromedia algo menos de 5 bits por peso una vez contadas las escalas y algunos tensores de mayor precisión. - GGUF es el formato de modelo en un solo archivo que usan llama.cpp y las herramientas construidas sobre él. MLX-LM carga modelos convertidos para MLX, así que el mismo modelo se distribuye en descargas GGUF y MLX distintas.
- KV cache guarda las claves y los valores de atención de cada token del contexto. Crece con la longitud del contexto y con el número de peticiones en paralelo.
- Familia de checkpoints es un modelo base con un tamaño concreto, como Llama 3.1 8B Instruct, sea cual sea su formato de archivo o su cuantización.
El gráfico suma los pesos y la KV cache de Llama 3.1 8B en Q4_K_M con contextos de 8K y 32K. Compara esos subtotales con el conjunto de trabajo de GPU recomendado que indicó un Mac M1 de 16 GB; el espacio de trabajo del runtime y macOS necesitan memoria adicional.
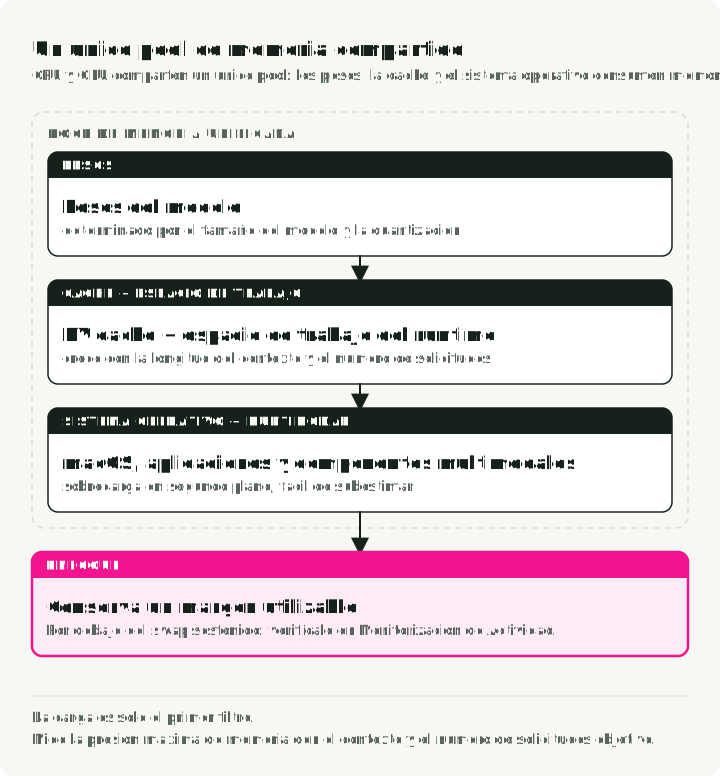
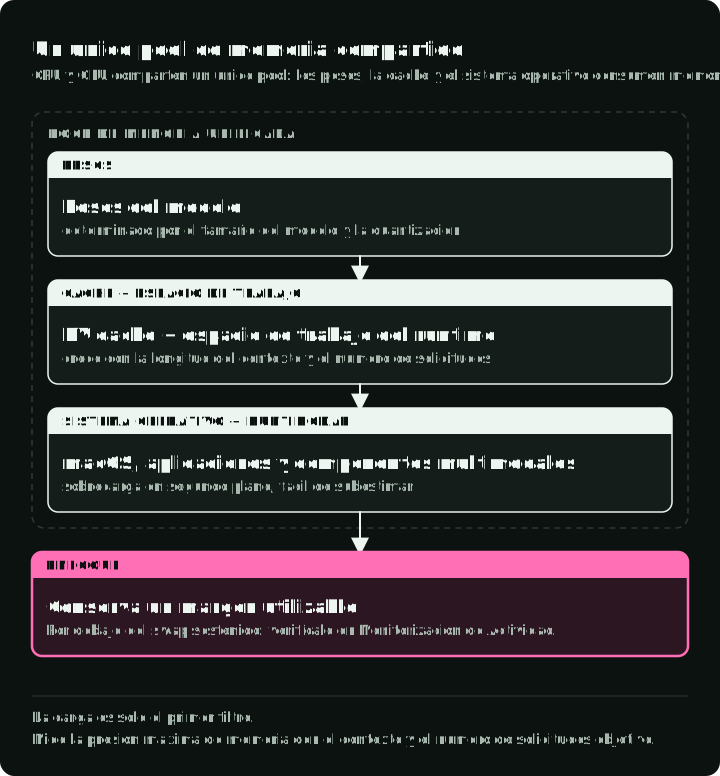
El tamaño de los pesos cuantizados es solo el primer término:
peak memory ≈ model weights
            + KV cache
            + runtime workspace
            + multimodal components
            + application and OS memory
La longitud del contexto, el dtype de la caché, las peticiones en paralelo y la arquitectura del modelo cambian el resultado. La KV cache es el término que controlas más directamente, mediante la longitud del contexto:
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valuePara Llama 3.1 8B (32 capas, 8 cabezas KV, dimensión de cabeza 128) con una caché de 16 bits, son 2 × 32 × 8 × 128 × 2 = 131.072 bytes, es decir, 128 KiB por token. Un contexto de 8K necesita 1 GiB de caché por petición, y uno de 32K necesita 4 GiB. Los pesos Q4_K_M son un archivo de 4,9 GB (4,6 GiB). Antes del espacio de trabajo, el modelo necesita unos 5,6 GiB con un contexto de 8K y unos 8,6 GiB con uno de 32K.
Metal informa de un tamaño de conjunto de trabajo recomendado para la GPU, recommendedMaxWorkingSetSize, que estima cuánta memoria de GPU se puede asignar sin afectar al rendimiento del runtime. Es una recomendación de rendimiento, no un límite de asignación impuesto. En un informe de 2023 sobre un M1 de 16 GB, llama.cpp imprimió 10.923 MB, unos 10,7 GiB o dos tercios de la RAM. Frente a esa recomendación, el subtotal de 8K deja 5,1 GiB para el espacio de trabajo y el margen; el de 32K deja 2,1 GiB. Comprueba el valor en tu propio Mac y mide la carga completa antes de decidir si cabe. Un Mac de 8 GB tiene menos margen, y solo estos pesos ya necesitan 4,6 GiB.
Planifica también el espacio en disco. Cada modelo de 7B u 8B en 4 bits ocupa 4–5 GB de descarga, y una pequeña biblioteca de modelos en ambos formatos ocupa 10–20 GB.
Usa el Monitor de Actividad o las métricas del propio runtime mientras pruebas. Apple define la presión de memoria a partir de la memoria libre, la tasa de swap, la memoria cableada y los archivos en caché. Deja margen suficiente para evitar un swap sostenido; un modelo que carga pero lleva al sistema a presión de memoria no es adecuado para uso interactivo.
Cada sección de herramienta siguiente muestra dónde fijar la longitud del contexto, porque es el ajuste que más cambia la KV cache.
Las cuatro herramientas resuelven problemas de flujo de trabajo distintos
| Herramienta | Interfaz principal | Formato de modelo | Licencia | Elígela cuando |
|---|---|---|---|---|
| Ollama | CLI y API HTTP local | Paquetes de modelos gestionados, sobre todo GGUF | MIT | Una aplicación necesita un servicio local gestionado y sencillo |
| LM Studio | Interfaz de escritorio, CLI, SDKs, APIs locales | GGUF y MLX | Aplicación propietaria, gratis para trabajo; SDKs MIT | Una persona necesita descubrir, comparar, inspeccionar y servir modelos de forma visual |
| llama.cpp | CLI, biblioteca C/C++, servidor local | GGUF | MIT | Necesitas flags directos, herramientas de conversión y cuantización, o inferencia embebida |
| MLX-LM | Python y CLI | Pesos en formato MLX | MIT | Escribes Python para Apple Silicon o haces fine-tuning de un modelo en el mismo Mac |
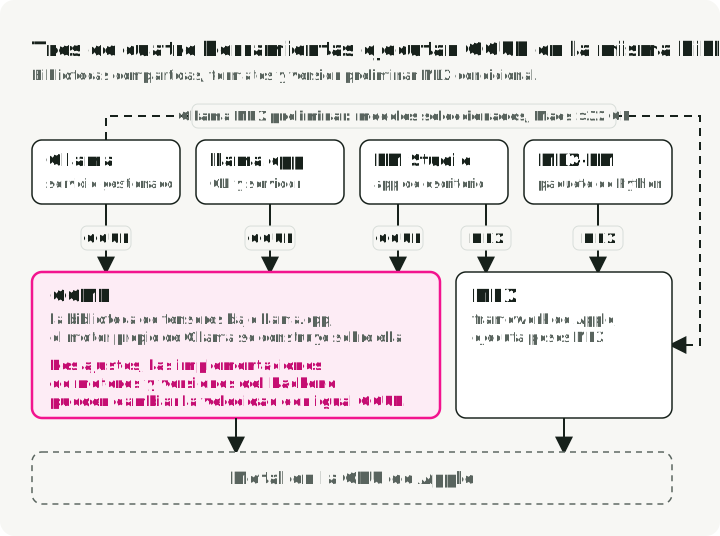
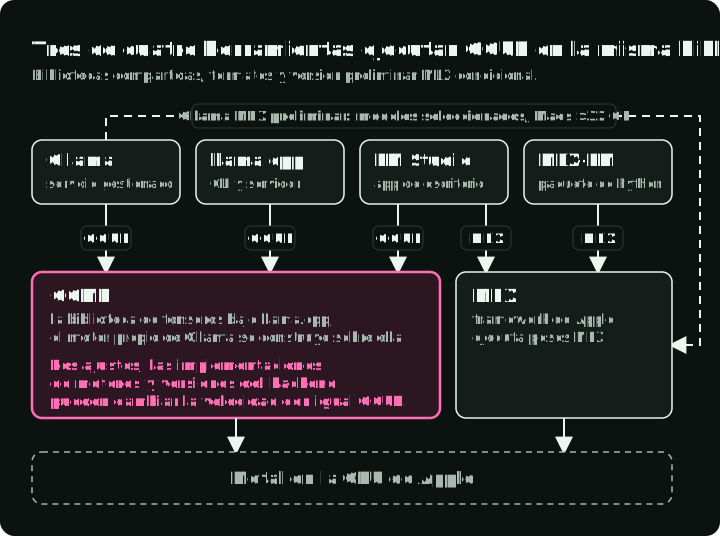
Esta es una tabla de responsabilidades, no una clasificación por velocidad. Tres de las herramientas comparten una biblioteca de tensores. Ollama ejecuta modelos GGUF con su propio motor, construido sobre GGML, la biblioteca en la que se basa llama.cpp. La versión preliminar de MLX de Ollama de marzo de 2026 también ejecuta modelos seleccionados en Macs con más de 32 GB de memoria. LM Studio ejecuta modelos GGUF con llama.cpp y modelos MLX con MLX. Compartir GGML no significa usar motores de inferencia idénticos. Incluso con el mismo archivo GGUF, los valores por defecto, como la longitud del contexto y el tamaño de lote, las implementaciones de los motores y las versiones del backend pueden afectar a la velocidad.
El diagrama muestra los formatos de modelo y las bibliotecas compartidas que utiliza cada herramienta, incluida la ruta condicional de MLX de Ollama.
Si aún no sabes qué flujo de trabajo tienes, usa la última columna de la tabla. Empieza con Ollama si solo quieres tener algo funcionando hoy.
Un caso queda fuera de las cuatro herramientas: KoboldCpp, un fork de llama.cpp con interfaz web, pensado para ficción larga y juegos de rol. Tiene licencia AGPL, algo que importa si lo distribuyes dentro de un producto.
Una API para las cuatro herramientas
Las cuatro herramientas pueden servir una API compatible con OpenAI en localhost. El código de aplicación que usa el cliente openai puede cambiar de herramienta modificando base_url, y el mismo cliente sirve para hacer benchmarks de las cuatro.
| Herramienta | Comando del servidor | base_url por defecto |
|---|---|---|
| Ollama | ollama serve (la app de macOS lo ejecuta) | http://localhost:11434/v1 |
| LM Studio | lms server start | http://localhost:1234/v1 |
| llama.cpp | llama-server -hf <repo>:<quant> | http://localhost:8080/v1 |
| MLX-LM | mlx_lm.server --model <repo> | http://localhost:8080/v1 |
El cliente necesita un valor de clave de API. Usa local como marcador si la autenticación del servidor está desactivada; usa tu token configurado si está activada. llama-server y mlx_lm.server usan el puerto 8080 por defecto, así que inicia uno con --port 8081 para ejecutar ambos.
Los ejemplos de Python que importan openai necesitan el paquete openai. El benchmark siguiente incluye un comando para ejecutar el script guardado con esa dependencia.
from openai import OpenAI

# Swap base_url for :1234 (LM Studio) or :8080 (llama.cpp, MLX-LM).
client = OpenAI(base_url="http://localhost:11434/v1", api_key="local")
La sección de benchmarks siguiente usa este cliente para medir las cuatro herramientas con un solo script.
Ollama: servicio local gestionado
Ollama gestiona las descargas de modelos, las plantillas, el ciclo de vida del proceso y una API en localhost. Resulta útil cuando el código de la aplicación debe apuntar a un servicio local estable en lugar de encargarse de los flags de inferencia.
MODEL=llama3.2
ollama pull "$MODEL"
ollama show "$MODEL"   # architecture, parameters, context length, quantization
ollama run "$MODEL" "Explain unified memory."

curl http://localhost:11434/api/chat \
    -H 'Content-Type: application/json' \
    -d '{
      "model": "'"$MODEL"'",
      "messages": [{"role": "user", "content": "Explain unified memory."}],
      "options": {"num_ctx": 8192},
      "stream": false
    }'
La opción num_ctx fija la longitud del contexto de una petición. Para fijarla en todo el servidor, arráncalo con OLLAMA_CONTEXT_LENGTH=8192 ollama serve o usa el control deslizante de los ajustes de la app. Sin ninguna de las dos, Ollama elige un valor por defecto según la memoria disponible: 4K tokens cuando hay menos de 24 GiB de memoria de GPU disponibles. ollama ps muestra el contexto que usa cada modelo cargado.
Un nombre corto de biblioteca como llama3.2 no identifica un archivo fijo; tras una actualización, el mismo nombre puede apuntar a otra compilación. Anota en cada evaluación el ID que imprime ollama list, que es el comienzo del digest del modelo.
Ollama cambia algo de visibilidad de bajo nivel por comodidad en el ciclo de vida. Pasa a llama.cpp u otro runtime cuando necesites controlar directamente un archivo GGUF, la plantilla de chat, un ajuste de caché o una funcionalidad nueva del backend.
LM Studio: exploración de escritorio y APIs locales
LM Studio es útil cuando el descubrimiento de modelos, la configuración de carga, la inspección del chat y la evaluación humana en paralelo deben formar parte de un mismo flujo de trabajo. Ofrece SDKs nativos de Python y TypeScript, endpoints compatibles con OpenAI, structured output, tool use y un daemon headless, así que es más que una GUI de escritorio. Su vista de chat también acepta archivos .pdf, .docx y .txt adjuntos como contexto, lo que cubre preguntas sencillas sobre documentos sin escribir código.
El SDK actual de Python se conecta a un modelo que ya has descargado. Inicia el servidor local de LM Studio, guarda esto como lmstudio_demo.py y ejecuta uv run --with lmstudio python lmstudio_demo.py. Si la autenticación está activada, define LM_API_TOKEN; el SDK lo lee automáticamente.
import lmstudio as lms

MODEL_KEY = "ibm/granite-4-micro"

with lms.Client() as client:
    model = client.llm.model(MODEL_KEY)
    response = model.respond("Write one sentence about local inference.")
    print(response)
Inicia la API local desde la pestaña Developer o desde la CLI. lms load fija la longitud del contexto al cargar un modelo, y --estimate-only imprime la estimación de memoria sin cargar nada:
lms server start
lms load ibm/granite-4-micro --context-length 8192 --estimate-only
lms load ibm/granite-4-micro --context-length 8192
LM Studio puede servir en localhost o en una red local y admite tokens de API en sus ajustes de autenticación de la API. Mantenlo en loopback salvo que el acceso remoto sea deliberado. Si lo expones en una LAN, exige la opción documentada de token de API, aplica una regla de firewall en el host y revisa el acceso de las herramientas y las integraciones.
llama.cpp: ejecución directa de GGUF
llama.cpp es la herramienta de referencia para archivos GGUF cuando quieres fijar tú mismo los flags del runtime. Admite Apple Metal, además de CPU y otros backends de hardware.
brew install llama.cpp

# Download through the Hugging Face integration and select a quantization.
MODEL_REPO=ggml-org/gemma-3-1b-it-GGUF
QUANT=Q4_K_M
llama-cli -hf "$MODEL_REPO:$QUANT"

# The same model with explicit settings: one turn, then exit.
llama-cli -hf "$MODEL_REPO:$QUANT" \
    -c 8192 -n 256 --temp 0.7 -st \
    -p "Write a Python function that sorts a list."

# Or start an OpenAI-compatible local server with an 8K context.
llama-server -hf "$MODEL_REPO:$QUANT" -c 8192
-c (--ctx-size) fija la longitud del contexto y, con ella, el tamaño de la KV cache. -n limita el número de tokens generados, --temp fija la temperatura de muestreo, -st ejecuta un solo turno y termina, y -p indica el prompt.
La opción -hf también descarga un proyector multimodal compatible cuando el repositorio incluye uno. El soporte de modelos, las plantillas y los flags de la CLI cambian rápido, así que fija una compilación conocida y guarda el comando de lanzamiento junto con el registro de la evaluación.
Elige llama.cpp cuando el objetivo sea el control directo, no porque «más bajo nivel» signifique automáticamente más rápido. Una herramienta gestionada puede elegir buenos valores por defecto; los flags directos también pueden empeorar el rendimiento.
MLX-LM: trabajo con Python nativo de Apple
MLX-LM se apoya en MLX, el framework de arrays de Apple. Admite generación, chat, conversión, cuantización y fine-tuning eficiente en parámetros para los modelos compatibles.
MODEL=mlx-community/Llama-3.2-3B-Instruct-4bit
uv run --with mlx-lm mlx_lm.generate \
    --model "$MODEL" \
    --max-kv-size 8192 \
    --prompt "Explain Metal acceleration in one paragraph."
MLX-LM no tiene un ajuste fijo de contexto: la caché crece con el prompt y la salida. --max-kv-size limita la caché a ese número de tokens. Superado el límite, MLX-LM descarta los tokens más antiguos y conserva solo unos pocos tokens del inicio.
Python expone directamente el modelo y el tokenizador. Guarda esto como mlx_demo.py y ejecuta uv run --with mlx-lm python mlx_demo.py:
from mlx_lm import generate, load

MODEL = "mlx-community/Llama-3.2-3B-Instruct-4bit"

model, tokenizer = load(MODEL)
messages = [{"role": "user", "content": "Give one local-LLM benchmark rule."}]
prompt = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True,
)
print(generate(model, tokenizer, prompt=prompt, max_tokens=80))
El servidor HTTP de MLX-LM, mlx_lm.server, está documentado como un servidor de desarrollo con comprobaciones de seguridad básicas, no como un servicio de producción. Úsalo para experimentar en local, o pon delante un proxy autenticado o tu propio servicio de API.
Comparar las herramientas con la misma carga de trabajo
Prueba la misma familia de checkpoints y una cuantización comparable cuando los formatos lo permitan. Un archivo GGUF Q4_K_M y un modelo MLX de 4 bits del mismo checkpoint son comparables, no idénticos.
Usa un conjunto pequeño de prompts que incluya:
- un prompt interactivo corto
- un prompt largo cercano al contexto previsto
- structured output o tool calls si la aplicación los necesita
- una longitud de generación representativa
- una petición repetida para distinguir la carga en frío de la inferencia en caliente
Registra:
| Métrica | Por qué importa |
|---|---|
| Resultado de la tarea | Un modelo rápido que se equivoca no sirve |
| Tiempo hasta el primer token | Capacidad de respuesta interactiva |
| Tokens de salida por segundo | Throughput de generación |
| Memoria máxima y presión | Si la máquina sigue siendo utilizable |
| Tiempo de carga en frío | Experiencia de escritorio y bajo demanda |
| Consumo de energía y temperatura | Uso sostenido en portátil |
| Compatibilidad de API y esquema | Si la herramienta encaja con la aplicación |
Cada herramienta imprime por sí misma las cifras de velocidad:
- Ollama:
ollama run "$MODEL" --verboseimprime la duración de la carga, la tasa de evaluación del prompt y la tasa de evaluación (tokens de salida por segundo) tras cada respuesta. - llama.cpp:
llama-bench -hf "$MODEL_REPO:$QUANT" -p 512 -n 128mide el procesamiento de un prompt de 512 tokens y la generación de 128 tokens, en tokens por segundo. - MLX-LM:
mlx_lm.generateimprime los tokens por segundo del prompt y de la generación, y la memoria máxima, tras cada ejecución. - LM Studio: la vista de chat muestra los tokens por segundo y el tiempo hasta el primer token bajo cada respuesta, y la REST API nativa devuelve los mismos valores en su campo
stats.
Para comparar la latencia observada por el cliente, cronometra una petición en streaming a los endpoints compatibles con OpenAI de «Una API para las cuatro herramientas». El script mide la duración total de la petición y el tiempo hasta el primer texto visible, y después imprime la respuesta para revisarla. El texto visible puede aparecer después del razonamiento o de la salida de herramientas, por lo que este tiempo no es necesariamente el del runtime hasta el primer token generado.
Inicia el servidor elegido con un modelo descargado, guarda el script como benchmark.py y ejecuta uv run --with openai python benchmark.py. Cambia BASE_URL y MODEL para cada herramienta. Define LOCAL_API_KEY con tu token configurado si la autenticación del servidor está activada; en caso contrario, el script usa local como marcador.
import os
import time

from openai import OpenAI

BASE_URL = "http://localhost:11434/v1"
MODEL = "llama3.2"

client = OpenAI(base_url=BASE_URL, api_key=os.environ.get("LOCAL_API_KEY", "local"))

start = time.perf_counter()
first = None
parts = []
stream = client.chat.completions.create(
    model=MODEL,
    messages=[{"role": "user", "content": "Explain unified memory in 200 words."}],
    max_tokens=300,
    stream=True,
)
for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        if first is None:
            first = time.perf_counter()
        parts.append(chunk.choices[0].delta.content)
end = time.perf_counter()

print(f"request duration: {end - start:.2f} s")
if first is None:
    print("time to first visible text: unavailable (no visible text)")
else:
    print(f"time to first visible text: {first - start:.2f} s")
print("response:", "".join(parts))
Los fragmentos de texto en streaming no son recuentos de tokens. Para obtener los tokens de salida por segundo, usa los contadores del runtime indicados arriba y registra si incluyen razonamiento o salida de herramientas. Por ejemplo, LM Studio informa por separado de los tokens de salida totales y los de razonamiento. Un stream sin texto visible informa de esa ausencia en lugar de asignar una latencia de texto; inspecciona el razonamiento, los tool calls o el estado de finalización desde la interfaz del runtime.
Ejecuta cada petición dos veces: la primera puede incluir la carga del modelo y la segunda puede reutilizar los pesos cargados y el estado del prompt en caché. Registra las versiones del runtime y los ajustes de caché de prompts para que las peticiones repetidas sigan siendo comparables.
No compares el modelo de 4 bits de una herramienta con el modelo de precisión completa de otra y atribuyas la diferencia al runtime.
Lista de comprobación de seguridad y privacidad
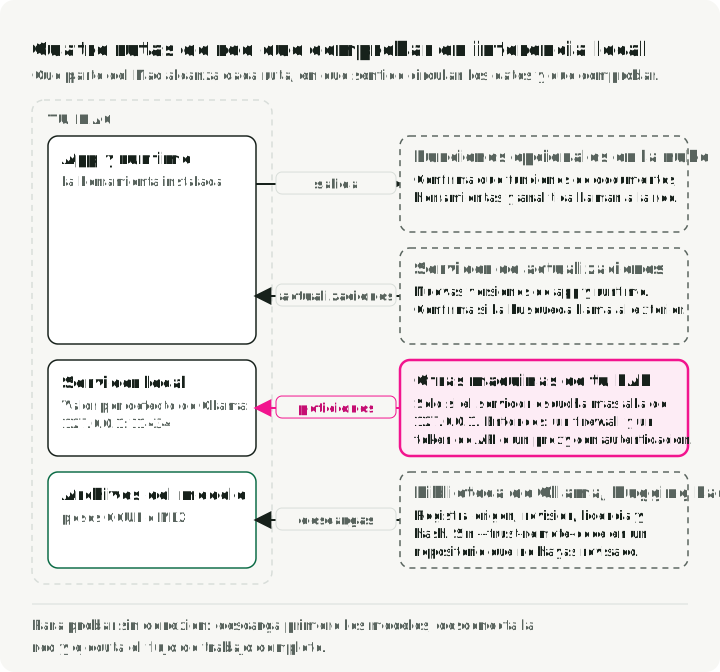
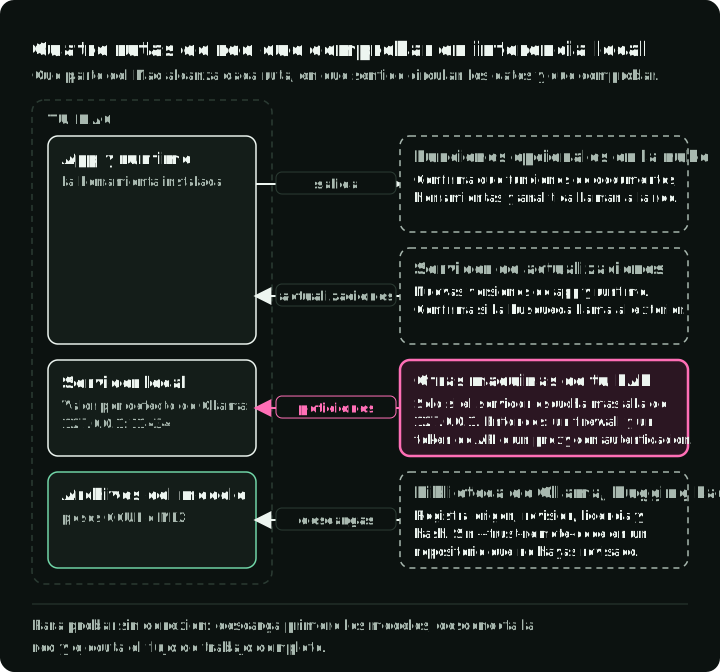
Separa la inferencia local del funcionamiento sin conexión. Los prompts pueden quedarse en la máquina mientras la aplicación sigue accediendo a la red para descargar modelos, actualizarse o usar funciones opcionales. Ollama documenta por separado la ejecución local, las descargas de modelos y las funciones opcionales en la nube en sus preguntas frecuentes. Trata el funcionamiento sin conexión como un requisito del flujo de trabajo que se verifica en cada aplicación: descarga antes los artefactos, desconecta la red y prueba el flujo completo.
El diagrama muestra cuatro rutas de red que debes comprobar durante la inferencia local: qué parte del Mac alcanza cada una, en qué sentido circulan los datos y qué comprobar en cada una. Las funciones en la nube y el acceso por LAN dependen de la configuración de la aplicación.
- Enlaza las APIs a loopback salvo que se necesite acceso por red.
- Si se necesita acceso por LAN, usa un firewall en el host y la autenticación documentada de la herramienta o un proxy inverso autenticado delante del servicio. La compatibilidad con tokens de API depende de cada herramienta: LM Studio documenta tokens de API y
llama-serveracepta--api-key. Ollama escucha por defecto en127.0.0.1:11434, yOLLAMA_HOSTcambia la dirección de enlace. Su API local no exige autenticación, así que pon un proxy autenticado delante cuando la uses en una LAN. - Trata los archivos de modelo como artefactos de terceros; registra el origen, la revisión, la licencia y el hash.
- Los archivos GGUF no contienen código ejecutable. Los modelos en formato Hugging Face pueden incluir código Python; no pases
--trust-remote-codea MLX-LM ni a Transformers con un repositorio que no hayas revisado. - Confirma si las funciones opcionales de documentos, herramientas, actualizaciones o analítica hacen llamadas de red.
- No des por hecho que la generación local vuelve seguros los documentos recuperados, los registros o los efectos secundarios de las herramientas.