LLMs mit Multi-GPU- und Multi-Node-Parallelism skalieren

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
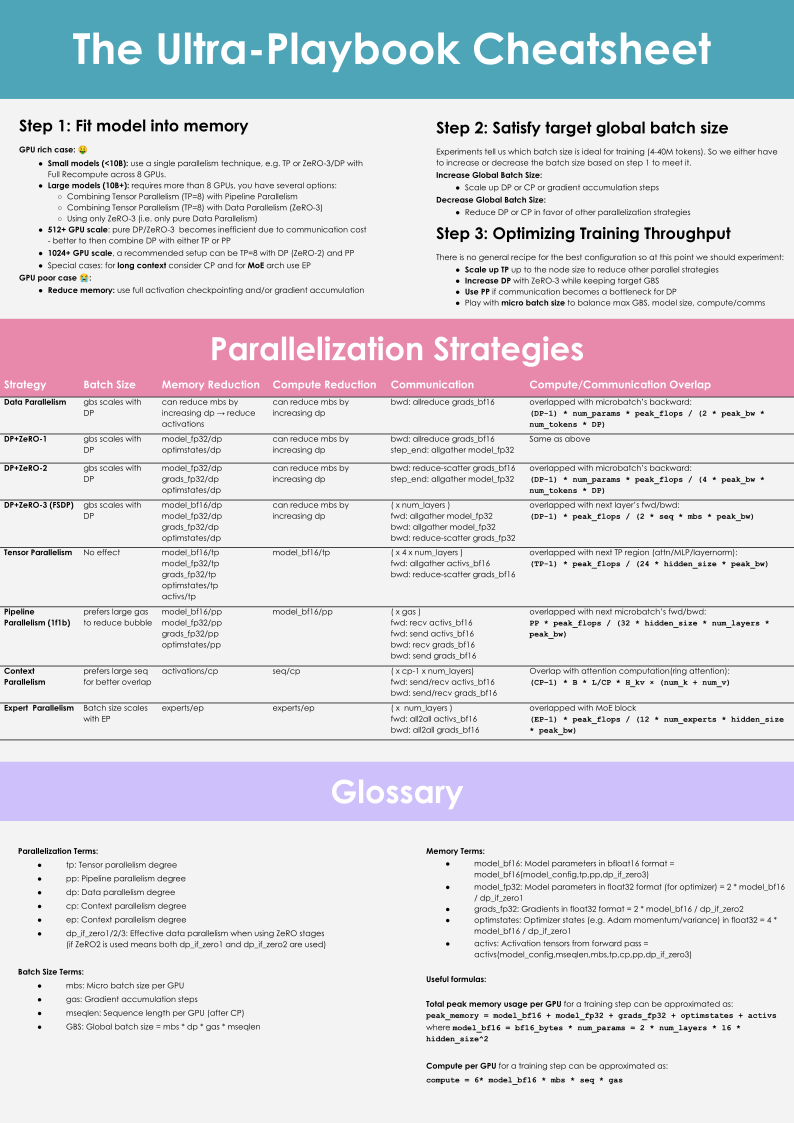
Sie erfahren, was jeder Split einspart, was er kommuniziert, welches Framework ihn implementiert und wie Sie ein erstes Mesh als Kandidaten für Ihren Cluster entwerfen. Dieser Artikel richtet sich an Engineers, die Backpropagation, Transformer-Layer und einen PyTorch-Trainingsloop kennen und jetzt mehr als eine GPU brauchen, um ein Model zu trainieren oder zu betreiben. Er bietet einen praktischen Überblick über die wichtigsten Parallelism-Strategien, ihre Einschränkungen und die Tools, die sie implementieren, gestützt auf das Ultra-Scale Playbook von Hugging Face.
Workloads mit großen Models wachsen aus unterschiedlichen Gründen über eine GPU hinaus. Einem Trainingsjob geht womöglich wegen des Optimizer State der Speicher aus. Einem anderen wegen der Activations langer Sequenzen. Ein Model, das in den Speicher passt, verfehlt vielleicht trotzdem sein Throughput-Ziel. Jedes dieser Probleme verlangt eine andere Aufteilung und ein anderes Kommunikationsmuster.
Memory Budgets für Training und Inference
Training und Inference haben nicht denselben Speicherbedarf.
training peak ≈ parameters
              + gradients
              + optimizer state
              + saved activations
              + temporary buffers
              + communication buffers
              + allocator headroom

inference peak ≈ resident weights
               + key/value (KV) cache
               + runtime workspace
               + communication buffers
               + allocator headroom
Ein Model mit 70 Milliarden Parametern braucht allein für die BF16 Weights mindestens 140 GB (dezimal). Training braucht deutlich mehr. Das ZeRO-Paper rechnet bei Adam mit FP16 Mixed Precision mit etwa 16 Byte Model State pro Parameter: 2 für die FP16 Weights, 2 für die FP16 Gradients und 12 für die FP32 Master Weights und die beiden Adam-Momente. Bei 70B Parametern sind das etwa 1.120 GB, noch ohne Activations. Die Tabelle und das Diagramm unten verwenden diese Aufteilung; die tatsächliche Tensor-Precision und die Behandlung der Master Weights können abweichen.
Replizierte Data Parallelism (DDP) hält diesen gesamten State auf jeder GPU. Sharding verteilt ihn auf die GPUs einer Gruppe, statt ihn zu kopieren. Das ZeRO-Paper definiert drei Stufen: Stufe 1 shardet den Optimizer State, Stufe 2 zusätzlich die Gradients und Stufe 3 zusätzlich die Parameter. Stufe 3 nennt PyTorch Fully Sharded Data Parallelism (FSDP). Für Ψ Parameter auf N GPUs gilt:
model state per GPU (ZeRO paper's FP16 mixed-precision Adam)
DDP      16Ψ
ZeRO-1   4Ψ + 12Ψ / N
ZeRO-2   2Ψ + 14Ψ / N
ZeRO-3   16Ψ / N
Auf 64 GPUs geshardet braucht das 70B-Model mit ZeRO-1 etwa 293 GB pro GPU, mit ZeRO-2 etwa 155 GB und mit ZeRO-3 oder FSDP etwa 17,5 GB.
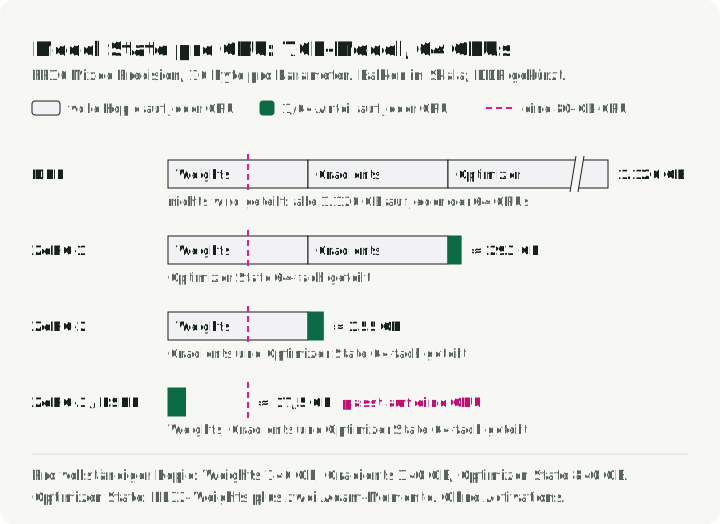
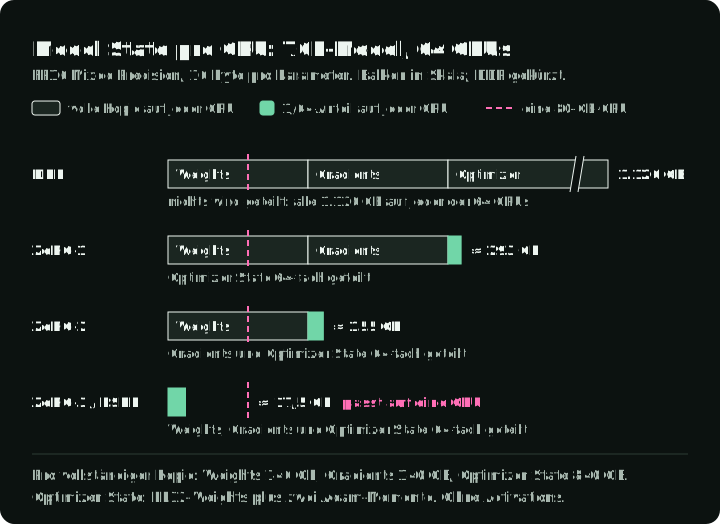
Das Diagramm teilt jeden dieser vier Werte in den Teil, den jede GPU kopiert, und den Teil, den sie sich mit 63 anderen teilt, und stellt sie dem Speicher einer 80-GB-GPU gegenüber: Nur vollständiges Sharding bringt den Model State darunter, und der restliche Platz geht an Activations und Buffer.
Inference hat keine Gradients und keinen Optimizer State, dafür kommt der KV cache hinzu, der mit jedem Token wächst, das der Server im Speicher hält:
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valueDie 2 steht für Keys und Values. Für Llama 3.1 70B in BF16 (80 Layer, 8 KV-Heads, Head-Dimension 128) sind das etwa 0,33 MB pro Token. Eine Sequenz mit 32.768 Tokens belegt also etwa 10,7 GB Cache. Multiplizieren Sie mit der Zahl gleichzeitiger Sequenzen, um einen Server zu dimensionieren. Cache Policy, Sequenzlänge, Concurrency und Quantization verändern diesen Wert.
Die Speicherentlastung ist kein fester Faktor. Die Zahlen oben enthalten keine Activations, keine temporären und Kommunikations-Buffer und keine Allocator-Reserve. Die tatsächliche Entlastung hängt vom Sharding-Grad ab, davon, was repliziert bleibt, von vorübergehend ungeshardetem State, der Activation Policy, Padding, Ungleichgewicht und Buffern.
Profilen Sie die genaue Architektur, Precision, Sequenzlänge, Micro-Batch-Größe, den Optimizer, die Checkpointing Policy und die Runtime. Erfassen Sie den maximal allokierten und reservierten Speicher, Tokens pro Sekunde, die Zeit in Kernels und die Zeit, die in Collectives sichtbar bleibt. torch.cuda.max_memory_allocated() und torch.cuda.max_memory_reserved() liefern die beiden Spitzenwerte; der PyTorch Profiler oder Nsight Systems zeigt die Kernel-Zeit und wie viel NCCL-Zeit nicht von Berechnung überdeckt wird.
Wie Ranks kommunizieren
Ein Rank ist ein Trainingsprozess, der meist eine GPU steuert. Ranks tauschen Tensoren über Collectives und Point-to-Point-Operationen aus, die auf NVIDIA-GPUs die NCCL-Bibliothek implementiert. Fünf kommen in diesem Artikel vor; die Reduktionsbeispiele verwenden Summen:
- All-Reduce: Jeder Rank erhält am Ende die Summe der Tensoren aller Ranks.
- All-Gather: Jeder Rank erhält am Ende die Shards aller Ranks.
- Reduce-Scatter: Jeder Rank erhält am Ende die Summe eines Shards.
- All-to-All: Jeder Rank sendet jedem anderen Rank ein anderes Teilstück.
- Point-to-Point: Ein Rank sendet einen Tensor an genau einen anderen Rank.
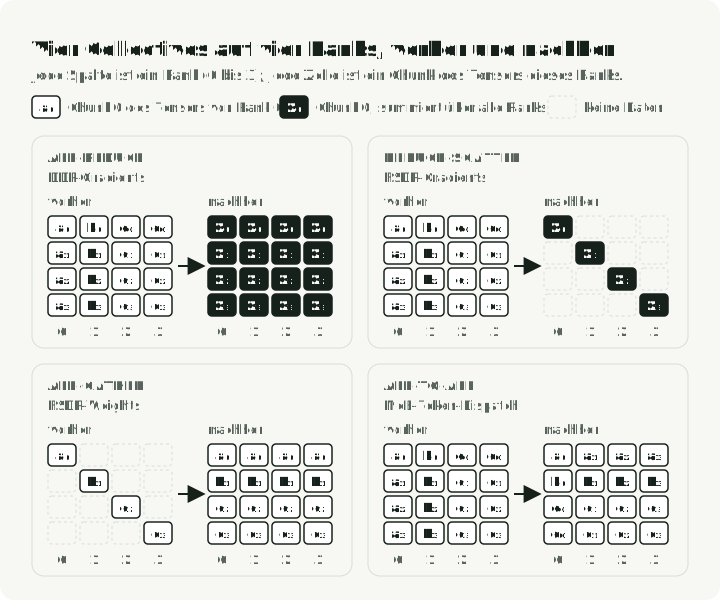
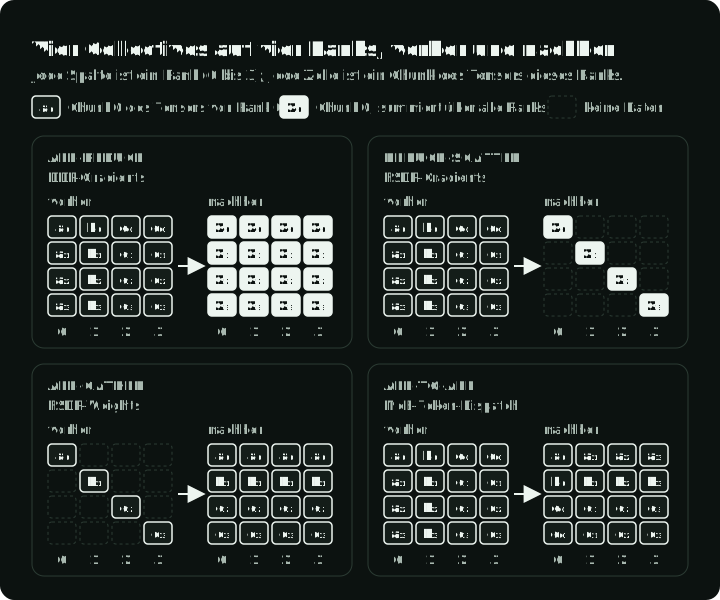
Die Abbildung zeigt vier Ranks vor und nach jeder der ersten vier Operationen, eine Spalte pro Rank und eine Zelle pro Chunk seines Tensors. Vergleichen Sie All-Reduce mit Reduce-Scatter: Beide summieren über die Ranks, aber nach Reduce-Scatter hält jeder Rank nur seinen eigenen Shard der Summe.
Was jede Strategie aufteilt und kommuniziert
Fragen Sie bei jeder Strategie, welche Tensor-Dimension geteilt wird, welcher State repliziert bleibt und welches Collective in den Critical Path gelangt.
| Strategie | Teilt auf | Hauptentlastung | Zusätzliche Kommunikation |
|---|---|---|---|
| Replizierte Data Parallelism (DDP) | Batch | Trainings-Throughput | All-Reduce der Gradients |
| Fully Sharded Data Parallelism (FSDP) | Parameter, Gradients und Optimizer State über eine Data-Parallel-Gruppe (DP) | Speicher für Model State | All-Gather der Parameter, Reduce-Scatter der Gradients |
| Tensor Parallelism (TP) | Matrix- oder Attention-Dimensionen innerhalb der Layer | Layer-Weights und Activations | Collectives innerhalb der Transformer-Blöcke |
| Pipeline Parallelism (PP) | Layer-Gruppen | Model-Tiefe und State pro Stage | Point-to-Point-Activations plus Bubbles durch das Scheduling |
| Context Parallelism (CP) | Sequenzdimension | Activation-Speicher bei langen Sequenzen | Austausch von Keys/Values oder Attention über die Sequenzgruppe |
| Expert Parallelism (EP) | MoE-Experts und geroutete Tokens | Expert-Kapazität pro Rank | Token-Dispatch und -Combine, meist All-to-All |
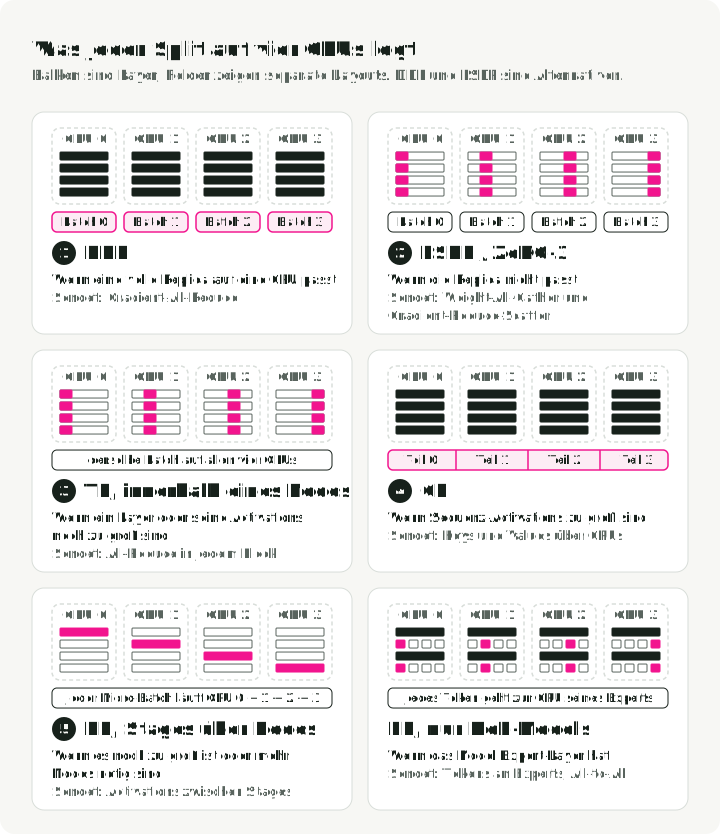
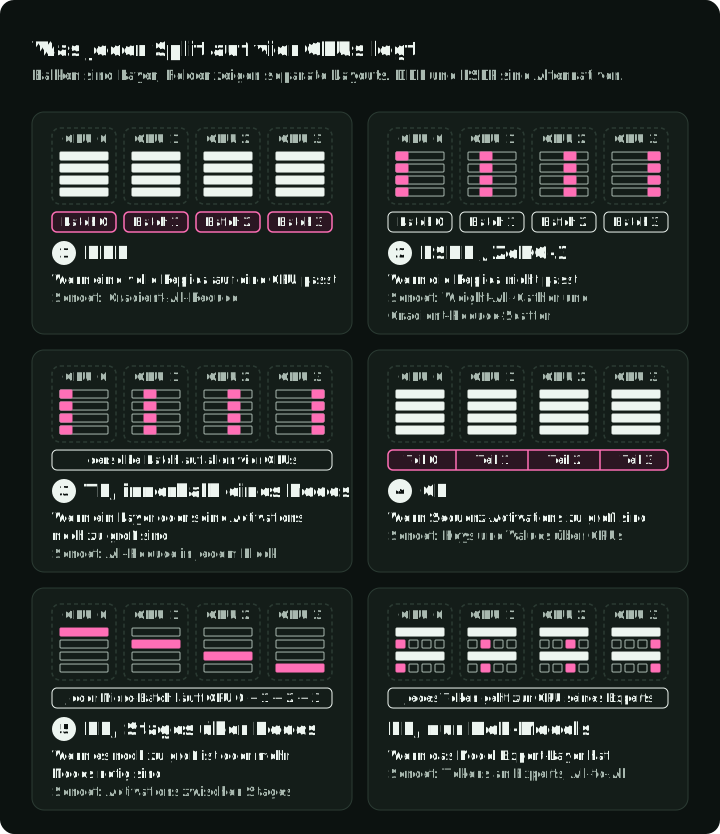
Die Abbildung zeigt sechs separate Layouts auf vier GPUs. Wählen Sie DDP, wenn eine vollständige Trainings-Replica mit Reserve passt, oder FSDP/ZeRO, wenn der Model State geshardet werden muss. Fügen Sie andere Splits nur für die Einschränkungen hinzu, die sie beheben; die Felder zeigen diese Kombinationen nicht. Die folgenden Abschnitte erklären jeden Split.
Data Parallelism (DDP)
Replizierte Data Parallelism, meist Distributed Data Parallel genannt, hält auf jedem Rank eine vollständige Trainings-Replica. Die PyTorch-Dokumentation zu DistributedDataParallel beschreibt dieses Modell aus Replicas und Gradient-Synchronisation. Jeder Rank verarbeitet einen anderen Micro-Batch, und die Gradients werden vor dem Optimizer-Schritt synchronisiert.
Setzen Sie sie ein, wenn der gesamte Trainings-State mit Reserve in den Speicher passt. Jeder neue Rank fügt dem globalen Batch seinen Micro-Batch hinzu. Entweder verträgt Ihr Trainingsrezept also einen größeren globalen Batch, oder Sie reduzieren die Gradient Accumulation, um ihn konstant zu halten. Die wichtigsten Vorteile sind die einfache Semantik und eine ausgereifte Implementierung, die die Backward-Berechnung mit der Gradient-Reduktion in Buckets überlappt.
Mehr Ranks können schaden, wenn der lokale Batch zu klein wird. Sie können auch schaden, wenn das Netzwerk das All-Reduce nicht verbergen kann oder die Eingabedaten nicht schnell genug ankommen. Größere globale Batches können bei höherem Rechenaufwand immer geringere Verbesserungen der Zeit bis zu einem Ziel-Loss bringen. Vergleichen Sie Loss und verstrichene Zeit für Ihr Trainingsrezept.
Die Abbildung zeigt einen Trainingsschritt auf einem Rank. Buckets von Gradients werden per All-Reduce zusammengeführt, während der Backward-Pass läuft, und die GPU wartet nur auf den Teil des All-Reduce, den das Netzwerk nicht verbergen kann.
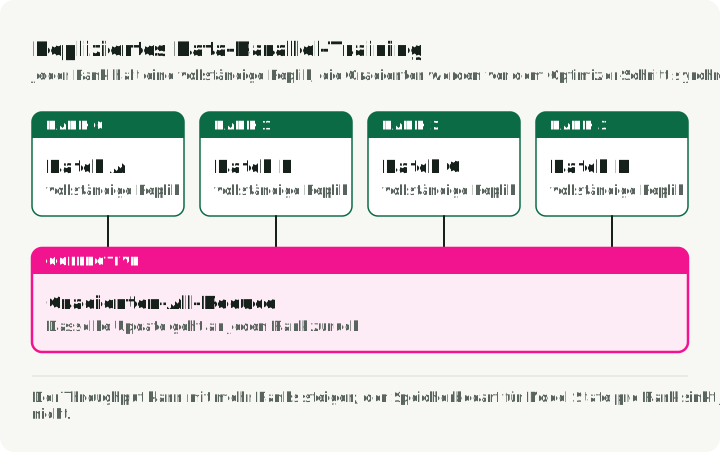
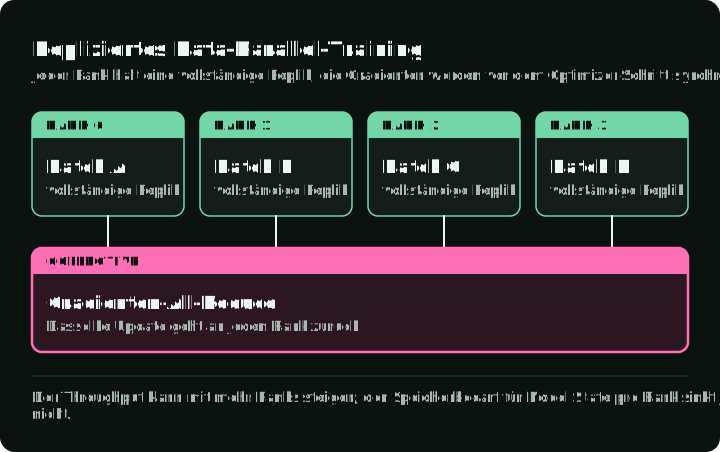
In PyTorch verpacken Sie das Model in DistributedDataParallel und starten mit torchrun einen Prozess pro GPU; der Befehl setzt RANK, LOCAL_RANK und WORLD_SIZE für jeden Prozess. Hugging Face Accelerate startet dasselbe Setup aus einer Konfigurationsdatei.
Fully Sharded Data Parallelism (FSDP, ZeRO)
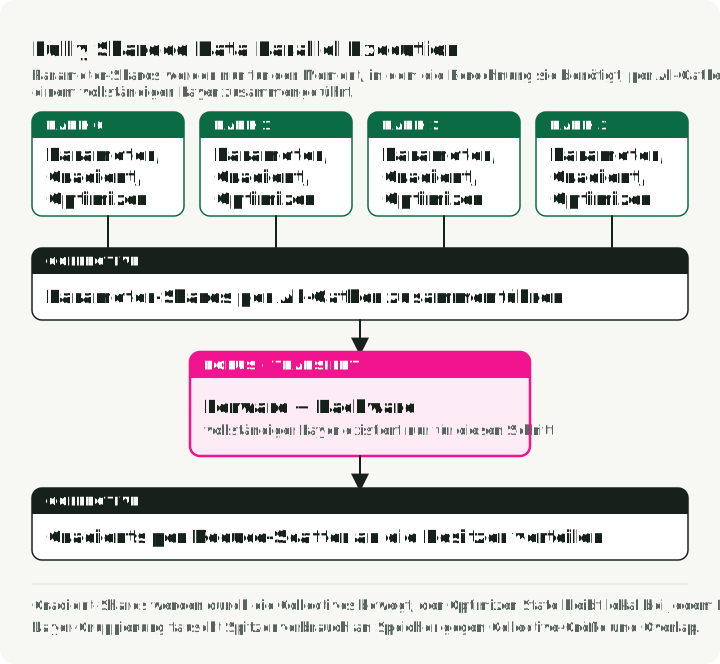
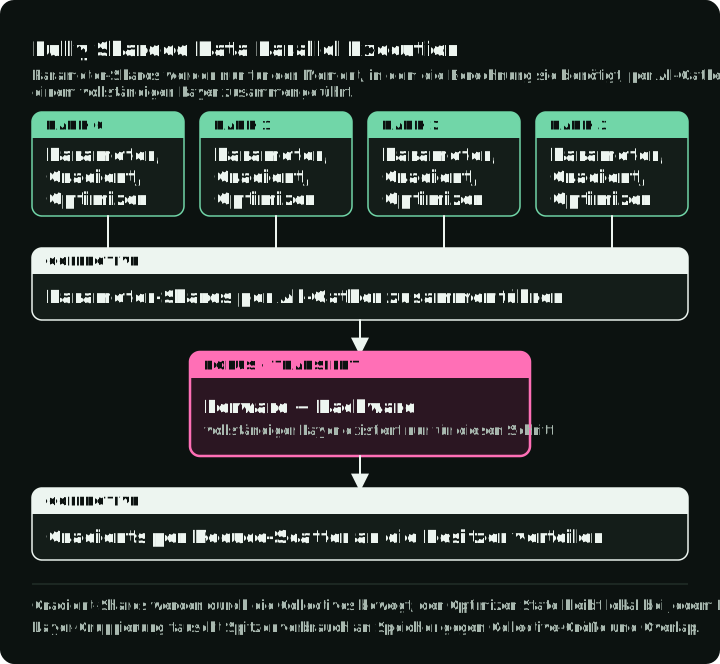
Fully Sharded Data Parallelism speichert Shards von Parametern, Gradients und Optimizer State verteilt über eine Gruppe. Das ZeRO-Paper beschreibt dieses Muster für das Sharding des States, und die FSDP2-API von PyTorch implementiert es. Die Parameter eines Layers werden für die Berechnung per All-Gather zusammengeführt und können danach wieder geshardet werden. Die Gradients gehen per Reduce-Scatter an ihre Besitzer zurück. Die Abbildung folgt einem Layer auf einem von vier Ranks durch einen Trainingsschritt: Der Rank speichert ein Viertel der Weights, Gradients und des Optimizer State, ein All-Gather baut die vollständigen Weights für den Forward-Pass und noch einmal für den Backward-Pass auf, und das Reduce-Scatter lässt dem Rank sein Viertel der Gradients.
Das ZeRO-Paper beziffert die Kosten von Stufe 3 auf etwa das 1,5-Fache des Kommunikationsvolumens von DDP: Die Parameter werden sowohl im Forward- als auch im Backward-Pass per All-Gather zusammengeführt, und die Gradients einmal per Reduce-Scatter verteilt.
Die aktuelle PyTorch-Dokumentation unterscheidet die fully_shard-API in Fully Sharded Data Parallelism Version 2 (FSDP2) vom älteren FullyShardedDataParallel-Wrapper. FSDP2 gruppiert die Kommunikation nach den Modulen, auf die fully_shard angewendet wird, und empfiehlt die Anwendung von unten nach oben, damit Layer-Gruppen Kommunikation und Berechnung überlappen können.
Bei der Reihenfolge der Aufrufe passieren leicht Fehler. Dieser Ausschnitt shardet einen Stapel von Transformer-Layern mit FSDP2:
model = nn.Sequential(*layers).cuda()  # e.g. 24 Transformer layers

for layer in model:  # bottom-up: each layer becomes one communication group
    fully_shard(layer)
fully_shard(model)  # then shard the remaining root parameters

# Build the optimizer after sharding, so it holds the sharded parameters (DTensors).
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
Starten Sie einen Prozess pro GPU mit torchrun --nproc_per_node=8 train.py. Der Spitzenspeicher pro Rank sinkt, je größer die Shard-Gruppe wird, weil jeder Rank einen kleineren Anteil der FP32 Weights, der Gradients und des Adam-States hält. Die Activations schrumpfen nicht, weil jeder Rank weiterhin seinen eigenen Batch verarbeitet. Das FSDP2-Tutorial enthält ein vollständiges Skript mit Mixed Precision und Checkpointing. FSDP2 hat außerdem die Option reshard_after_forward=False, die die Parameter zwischen Forward- und Backward-Pass zusammengeführt hält. Sie verhält sich wie ZeRO-2: weniger All-Gathers, mehr Speicher.
Sharding lohnt sich, wenn der Model State den größten Teil des Speichers ausmacht und die Layer-Berechnung genug Collective-Traffic verbergen kann. Für kleine Models, langsame Verbindungen, winzige Layer oder eine Shard-Gruppe, die sich über ein langsames Netzwerk auf mehrere Nodes erstreckt, kann es ein schlechter Tausch sein. DeepSpeed ZeRO implementiert dieselben Stufen mit expliziter Stufenwahl und optionalem Auslagern des States in CPU- oder NVMe-Speicher.
Tensor Parallelism
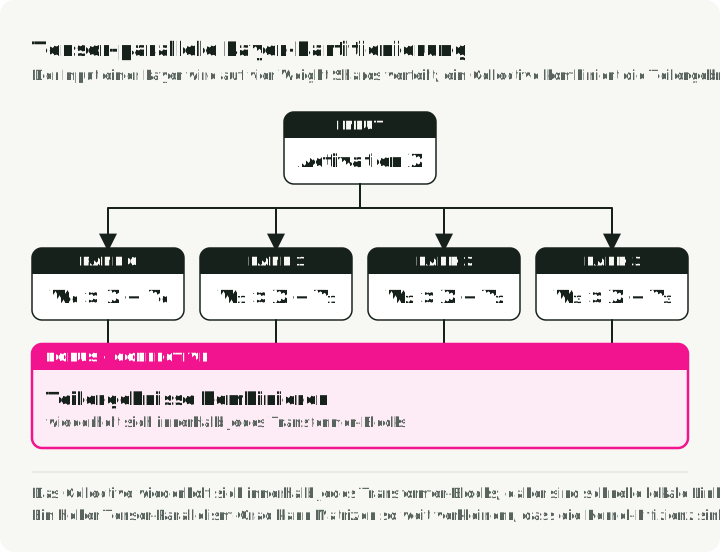
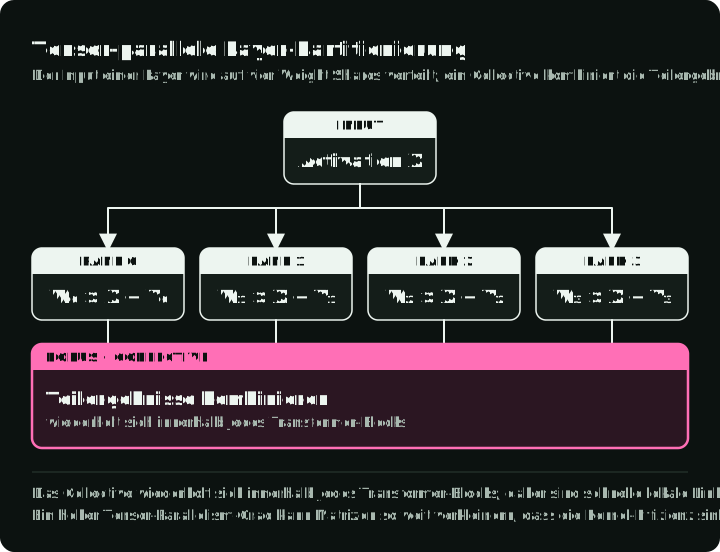
Tensor Parallelism teilt die lineare Algebra innerhalb eines Layers auf. Beispiele sind spalten- und zeilenparallele Projektionen. Der Parallelism-Leitfaden von NVIDIA dokumentiert diesen Split auf Layer-Ebene. Teilergebnisse erfordern Collectives innerhalb der Transformer-Blöcke, deshalb spielen Latency und Bandbreite im Forward- und Backward-Pass immer wieder eine Rolle.
Die Abbildung zeigt den Split, den der Artikel zu Megatron-LM für ein Transformer-MLP auf zwei Ranks verwendet. Die erste Weight-Matrix wird nach Spalten geteilt, sodass jeder Rank GeLU ohne Kommunikation auf seinen eigenen Abschnitt anwendet. Die zweite Matrix wird nach Zeilen geteilt, sodass jeder Rank eine Teilsumme des Outputs erzeugt, und ein All-Reduce addiert sie. Das ist ein All-Reduce pro MLP im Forward-Pass statt eines pro Matrixmultiplikation.
Setzen Sie sie ein, wenn ein Layer oder seine Activations nicht in den Speicher passen oder wenn die Matmuls groß genug sind, dass partitionierte Kernels schneller sind als ein einzelner Rank. Legen Sie die Tensor-Parallel-Gruppe auf die schnellste verfügbare Kommunikationsdomäne und messen Sie dann. Ein hoher Tensor-Parallel-Grad kann jede lokale Matrix so weit verkleinern, dass die Kernel-Effizienz sinkt, während der Collective-Overhead wächst.
Sequence Parallelism im Stil von Megatron teilt die Activations der LayerNorm- und Dropout-Bereiche entlang der Sequenz auf, die reines TP sonst vollständig auf jedem Rank der TP-Gruppe halten würde. Sie arbeitet innerhalb der TP-Gruppe; Context Parallelism teilt die gesamte Sequenz einschließlich der Attention über eine separate Gruppe auf.
Megatron Core implementiert TP und Sequence Parallelism für das Training. vLLM, SGLang und TensorRT-LLM nutzen TP, um ein Model für das Serving zu sharden.
Pipeline Parallelism
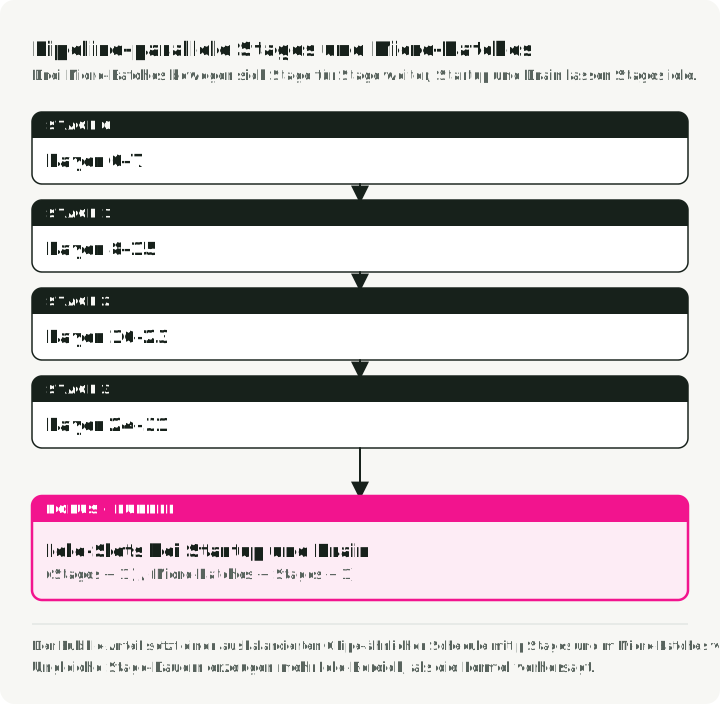
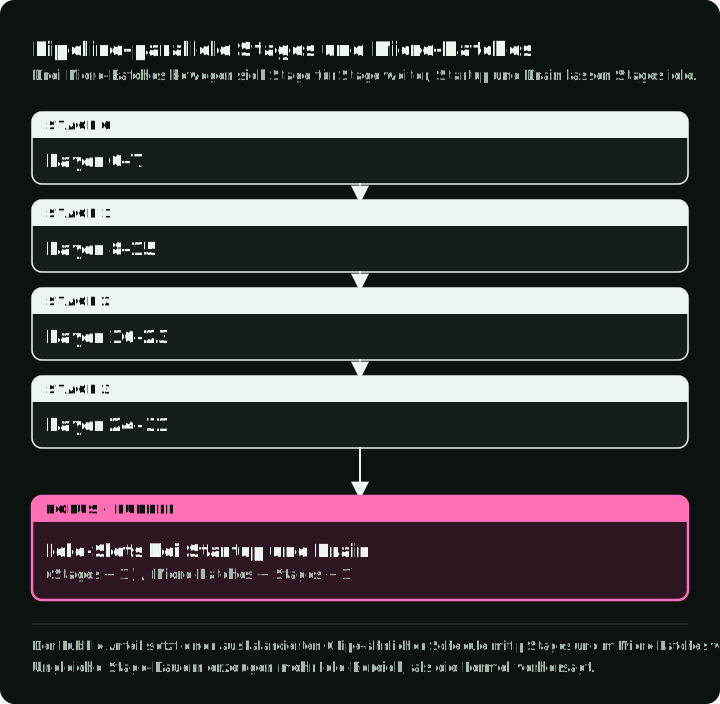
Pipeline Parallelism legt verschiedene Layer-Gruppen auf verschiedene Stages und sendet Activations zwischen ihnen. Micro-Batches sorgen dafür, dass die Stages gleichzeitig arbeiten.
Sie entlastet den Model State pro Stage und kann im Vergleich zu Tensor-Collectives pro Layer das Kommunikationsvolumen über eine langsamere Grenze verringern. Ihre Kosten sind Bubbles, Activation-Transfers, ungleich belastete Stages, komplexeres Scheduling sowie aufwendigere Wiederherstellung und aufwendigeres Checkpointing.
Die Abbildung zeigt den Forward-Pass von vier Stages und vier Micro-Batches über sieben Zeitschritte und darunter den Leerlaufanteil bei mehr Micro-Batches. Jedes leere Feld ist eine Stage ohne Arbeit: Die letzten Stages warten am Anfang, die ersten Stages am Ende. Für einen einfachen, ausgeglichenen Schedule im GPipe-Stil mit p Stages und m Micro-Batches beträgt der idealisierte Bubble-Anteil im Forward-Pass ungefähr:
(p - 1) / (m + p - 1)Bei 4 Stages lassen 4 Micro-Batches 3/7 des Forward-Schedules ungenutzt, etwa 43 %. 16 Micro-Batches lassen 3/19 ungenutzt, etwa 16 %, und 32 lassen 3/35 ungenutzt, etwa 9 %. Mehr Micro-Batches pro globalem Batch verkleinern die Bubble, aber jeder einzelne wird kleiner, sodass die Kernels weniger effizient laufen; messen Sie beides.
Reale Schedules nutzen eventuell One-Forward/One-Backward, Interleaving oder Zero-Bubble-Varianten, und ungleiche Layer-Kosten können die Formel überlagern. Wählen Sie die Stage-Grenzen nach gemessener Zeit und gemessenem Speicher, nicht nach gleicher Layer-Anzahl.
DeepSpeed, Megatron Core und Nanotron implementieren Pipeline-Schedules.
Context Parallelism
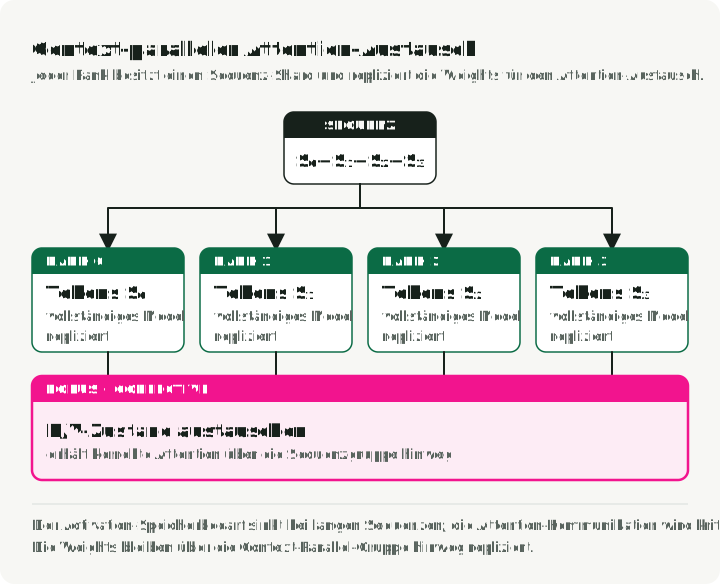
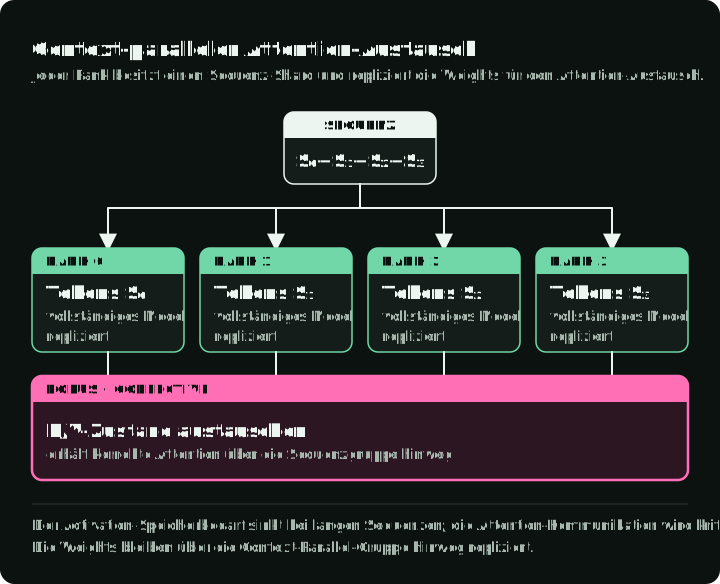
Context Parallelism verteilt die Sequenzdimension. Die Dokumentation von NVIDIA zu Context Parallelism beschreibt den Split der Sequenz und den Austausch von Keys und Values, den die Attention braucht. Jeder Rank besitzt einen Shard der Sequenz, während die Attention die Informationen austauscht, die für die Semantik des vollständigen Kontexts nötig sind. Implementierungen nutzen Point-to-Point-Ringe, All-Gather, All-to-All oder hierarchische Kombinationen.
Sie verringert den Activation-Speicher beim Long-Context-Training, repliziert aber die Weights über die Context-Gruppe und fügt Attention-Kommunikation hinzu. Der Nutzen hängt vom Attention-Typ, kausalem Masking, der Sequenzlänge, Recomputation und davon ab, wie sich Context-Gruppen mit Tensor- und Data-Parallel-Gruppen kombinieren.
Wählen Sie sie nicht nach einer universellen Schwelle von 8K, 32K oder 100K. Ziehen Sie sie in Betracht, wenn die Activations bei Ihrer Zielsequenzlänge nach Activation Checkpointing sowie Tensor und Sequence Parallelism noch immer den Speicher übersteigen und die Weights bereits passen.
Megatron Core implementiert CP für das Training. Picotron enthält eine kleine Implementierung von Data, Tensor, Pipeline und Context Parallelism, an der Sie lernen können, wie sie zusammenpassen.
Expert Parallelism für MoE-Models
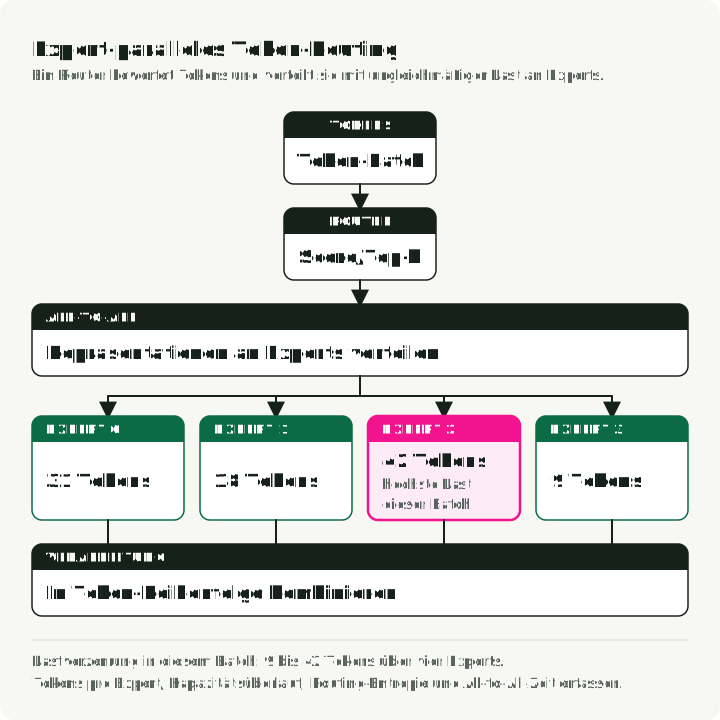
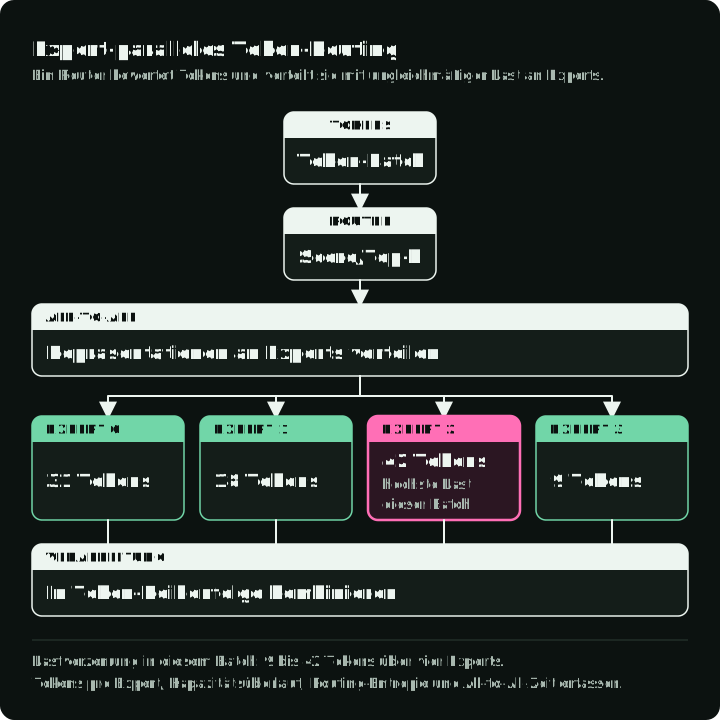
Expert Parallelism verteilt die Experts in Mixture-of-Experts-Layern. Mixtral 8x7B zum Beispiel speichert etwa 46,7B Parameter, nutzt aber nur etwa 12,9B pro Token. Der Parallelism-Leitfaden von NVIDIA dokumentiert diese Platzierung der Experts und ihre Kombination mit anderen Parallelism-Dimensionen. Der Router sendet Token-Repräsentationen an ausgewählte Experts und kombiniert deren Ergebnisse. Für jedes Token rechnen nur die ausgewählten Experts, aber alle Expert-Weights brauchen trotzdem Speicher und einen Platz im Serving.
Expert Parallelism ist kein Optimierungsschalter für ein dichtes Model. Sie ist Teil einer MoE-Architektur. Zu ihren Problemen gehören Lastverteilung, Kapazitätsgrenzen, All-to-All für Tokens, verworfene Tokens, Padding, Auxiliary Losses und ungleich verteilte Ausfälle. Megatrons MoE-Einstellungen unterscheiden das Verwerfen von Zuweisungen über der Expert-Kapazität vom Auffüllen ungenutzter Plätze darunter. Dropless Routing verarbeitet variable Token-Anzahlen. Erfassen Sie Tokens pro Expert, Routing-Entropie, Kapazitätsüberlauf, Kommunikationszeit und Qualität pro Route.
Megatron Core und Nanotron implementieren EP für das Training.
Ein Layout aus der Topologie zusammensetzen
Große Trainingssysteme für dichte Models ohne Expert-Parallel-Gruppe nutzen meist ein Produkt aus den Größen der Data-Parallel-Gruppe (DP), der Tensor-Parallel-Gruppe (TP), der Pipeline-Parallel-Gruppe (PP) und der Context-Parallel-Gruppe (CP):
world size = DP × TP × PP × CPWenn Expert Parallelism (EP) eine eigenständige Gruppe ist, berechnet der Parallelism-Leitfaden von NVIDIA die Gesamtzahl so:
total GPUs = TP × PP × CP × EP × DPPrüfen Sie, welche Reihenfolgen und Größen von Gruppen Ihr Framework unterstützt, bevor Sie die Grade wählen.
Bauen Sie das Layout in dieser Reihenfolge auf:
- Zeichnen Sie die Kommunikationsdomänen: Verbindungen zwischen GPUs, Switches, Grenzen des Non-Uniform Memory Access (NUMA), das Node-Fabric, Überbuchung und den Speicherpfad. Auf den meisten GPU-Servern ist NVLink zwischen den GPUs eines Nodes die schnellste Domäne; die Nodes sind über ein langsameres Netzwerk wie InfiniBand verbunden.
- Legen Sie häufige, latency-empfindliche Collectives, meist TP, in die schnellste geeignete Domäne. Das bedeutet in der Regel, dass jede TP-Gruppe innerhalb eines Nodes bleibt.
- Wählen Sie FSDP- oder replizierte DP-Gruppen nach der verbleibenden Kapazität und Bandbreite.
- Fügen Sie PP hinzu, wenn die Platzierung nach Tiefe oder der Traffic zwischen Domänen davon profitiert, und gleichen Sie gemessene Stage-Zeit und gemessenen Speicher aus.
- Fügen Sie CP nur wegen der Sequenzbeschränkung hinzu und EP nur wegen der Expert-Topologie des Models.
- Prüfen Sie für das Mesh, ob Heads, Hidden-Dimensionen, Layer, Experts, Batch und Sequenz teilbar sind.
- Benchmarken Sie mehrere gültige Meshes. Topologiebewusste Heuristiken wählen Kandidaten aus, keine Gewinner.
Ein Beispielkandidat für ein dichtes 70B-Model mit 32K Kontext auf 64 Nodes mit je 8 GPUs: TP=8 innerhalb jedes Nodes über NVLink, PP=4 über Nodes hinweg, CP=4 für die lange Sequenz und DP=4 für den Rest; 8 × 4 × 4 × 4 = 512 GPUs. Benchmarken Sie es gegen TP=8, PP=8, CP=2, DP=4, bevor Sie sich entscheiden.
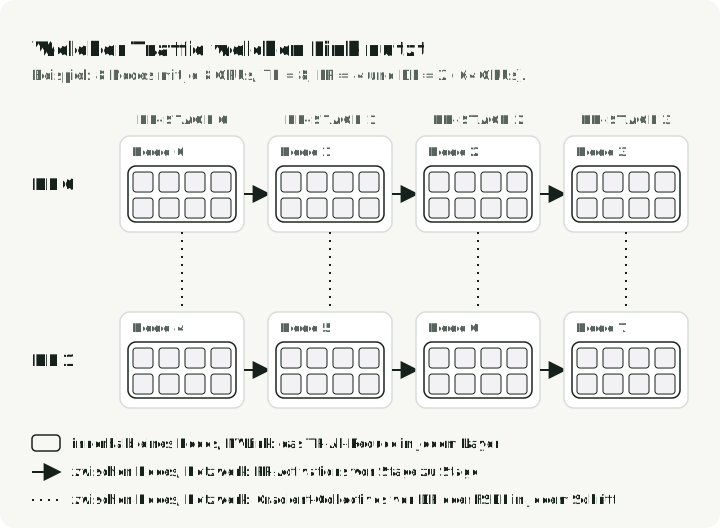
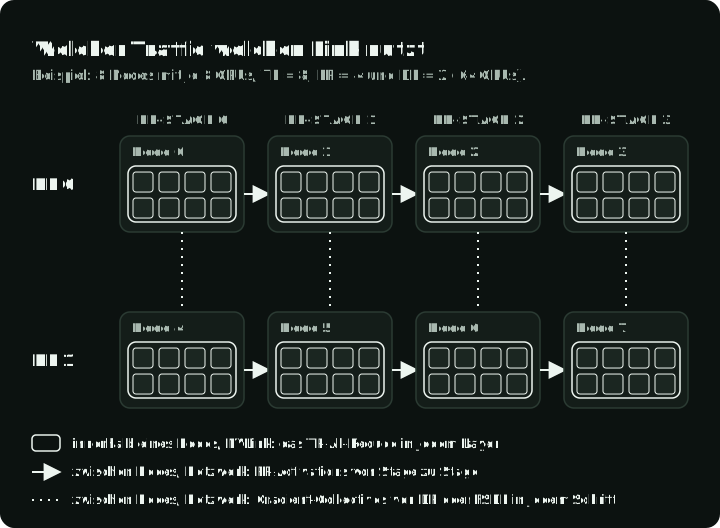
Die Abbildung zeigt, wohin der Traffic jeder Gruppe in einem solchen Layout geht: Das TP-All-Reduce bleibt auf NVLink innerhalb eines Nodes, während die Gradient-Collectives von FSDP oder DP und die PP-Activations über das Netzwerk zwischen den Nodes laufen.
Startkandidaten nach Clustergröße, zum Benchmarken und nicht zum direkten Übernehmen:
- Ein Node, 2–8 GPUs. DDP, wenn eine vollständige Trainings-Replica mit Reserve passt; FSDP2 oder DeepSpeed ZeRO-2/3, wenn der Model State geshardet werden muss. Starten Sie mit
torchrunoder Accelerate. Fügen Sie TP=2 nur hinzu, wenn ein Layer oder seine Activations dann immer noch nicht passen. Bei GPUs, die über PCIe ohne NVLink verbunden sind, halten Sie TP bei 1 oder 2, weil das All-Reduce jedes Layers über PCIe läuft. - 2–16 Nodes. TP innerhalb jedes Nodes (4 oder 8 mit NVLink), FSDP oder DP über Nodes hinweg und PP über Nodes nur, wenn das Model immer noch nicht passt.
- Hunderte GPUs oder mehr. TP × PP × CP × DP wie im Beispiel oben, mit einem Framework, das alle vier implementiert, etwa Megatron Core.
Zwei Cluster mit derselben GPU-Anzahl können unterschiedliche Layouts bevorzugen, weil sich Link-Bandbreite, Switch-Hierarchie, CPU-Anbindung und Netzwerkauslastung unterscheiden.
Welches Framework welchen Split implementiert
Die Splits oben implementiert eine kleine Gruppe von Bibliotheken. Wählen Sie nach den Splits, die Sie brauchen, und danach, wie viel vom Trainingsloop Sie selbst verantworten wollen.
| Tool | Unterstützte Splits | Einsetzen, wenn |
|---|---|---|
| Hugging Face Accelerate | startet DDP, FSDP oder DeepSpeed aus einer Konfigurationsdatei | Sie ein bestehendes PyTorch- oder Transformers-Skript mit wenigen Codeänderungen auf mehreren GPUs ausführen wollen |
| PyTorch DDP und FSDP2 | DDP, FSDP (fully_shard), mit torchrun | Sie ein dichtes Model auf einem oder wenigen Nodes trainieren und reines PyTorch wollen |
| DeepSpeed ZeRO | ZeRO-Stufen 1, 2, 3, Auslagern in CPU und NVMe, PP | Sie die Sharding-Stufe wählen oder State in CPU- oder NVMe-Speicher auslagern wollen |
| Megatron Core | TP, PP, CP, EP, DP und Sequence Parallelism | Sie für große Pretraining-Läufe TP, PP und CP (und EP) zusammen brauchen |
| Nanotron | DP, TP, PP, EP, ZeRO-1 | Sie für 3D-Parallelism und MoE eine kleinere Codebasis als Megatron wollen |
| vLLM, SGLang, TensorRT-LLM | TP und PP für Inference | Sie das Model betreiben; siehe den Abschnitt zum Serving unten |
Um ein bestehendes Skript über Accelerate mit FSDP2 auszuführen, rufen Sie einmal accelerate config auf; der Befehl schreibt die Konfigurationsdatei interaktiv. Diese Einstellungen wählen FSDP2, die Gruppierung nach Decoder-Layern und das Resharding:
fsdp_config:
    fsdp_version: 2
    fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP
    fsdp_transformer_layer_cls_to_wrap: LlamaDecoderLayer
    fsdp_reshard_after_forward: true
Mit fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP benennt fsdp_transformer_layer_cls_to_wrap die Block-Klasse, die zu einer FSDP-Einheit wird, also dieselbe Gruppierung von unten nach oben wie in der fully_shard-Schleife oben. fsdp_reshard_after_forward: true bedeutet vollständiges Sharding; false ist der Modus, der ZeRO-2 ähnelt. Starten Sie den Job mit accelerate launch --config_file fsdp2.yaml train.py. Der FSDP1/FSDP2-Leitfaden erklärt diese versionsabhängigen Einstellungen und den Befehl accelerate to-fsdp2, der eine ältere FSDP1-Konfiguration konvertiert.
Training und Serving brauchen getrennte Entscheidungen
Inference hat meist keine Gradients und keinen Optimizer State, deshalb lassen sich Trainings-Layouts im FSDP-Stil nicht automatisch übertragen.
Prefill verarbeitet den Prompt und speichert die Keys und Values seiner Tokens im KV cache. Decode erzeugt weitere Tokens und verwendet und erweitert dabei diesen Cache.
Fragen Sie für das Serving:
- Passen Weights, KV cache, Workspace und Ziel-Concurrency in eine Replica?
- Ist der Throughput mit mehr unabhängigen Replicas besser oder mit dem Sharding einer Replica?
- Verringert TP den Druck auf Weights und Cache pro Rank genug, um die Kommunikation pro Layer aufzuwiegen?
- Wird PP für das Model und den Request-Scheduler effizient unterstützt?
- Wie unterschiedlich belasten Prefill und Decode Rechenleistung, Speicherbandbreite und Interconnect?
- Was passiert mit der Tail Latency, wenn Requests unterschiedlich lange Prompts und Outputs haben?
Nutzen Sie für die erste Frage die KV-cache-Formel aus dem Abschnitt zum Speicher. Wenn eine Replica mit Platz für den KV cache bei Ihrer Ziel-Concurrency passt, betreiben Sie mehr Replicas; sie brauchen keine Kommunikation zwischen GPUs. Wenn sie nicht passt, sharden Sie sie zuerst mit TP innerhalb eines Nodes und fügen PP über Nodes hinweg nur hinzu, wenn ein Node nicht reicht. In vLLM sind das --tensor-parallel-size und --pipeline-parallel-size; SGLang und TensorRT-LLM haben dieselben zwei Einstellungen.
Benchmarken Sie den vollständigen Server mit Scheduler, Quantization, Kontextverteilung, Batching Policy und Traffic-Profil. Tokens pro Sekunde im Training sagen nichts über die Time to First Token oder die Inter-Token Latency im Serving aus.
Was Sie für jedes Layout erfassen sollten
Erfassen Sie für jeden Kandidaten:
- Identität von Model, Code, Runtime, Kernels und Topologie
- globalen und lokalen Batch, Sequenzverteilung und Token-Anzahl
- Spitzenspeicher nach Kategorie, wo verfügbar
- nützliche Tokens pro Sekunde und die Auslastung der Gleitkommaoperationen des Models (FLOP-Auslastung), wenn konsistent berechnet
- sichtbare Zeit in All-Reduce-, All-Gather-, Reduce-Scatter-, All-to-All- und Point-to-Point-Operationen
- Input-Stalls, Checkpoint-Zeit, Verhalten bei Neustarts und Verteilung der Nachzügler
- Parität von Trainings-Loss oder Serving-Output gegenüber der Baseline
Vergleichen Sie Weak und Strong Scaling bewusst. Strong Scaling hält die Gesamtarbeit konstant, während die Zahl der Ranks steigt. Weak Scaling hält die Arbeit pro Rank konstant, sodass die Gesamtarbeit mit der Zahl der Ranks wächst. Ein Prozentwert mit der Bezeichnung „Scaling-Effizienz“ ist ohne diesen Nenner und diese Baseline bedeutungslos.
Fazit
Parallelism ist eine Zuordnung von einem gemessenen Bottleneck zu einer Tensor-Dimension und einem Kommunikationsmuster. Replikation, Sharding, Partitionierung von Layern, Staging, Partitionierung der Sequenz und Expert Routing entlasten jeweils eine andere Einschränkung und schaffen jeweils eine andere Fehlerquelle.
Erfassen Sie den Workload, zeichnen Sie die Topologie, erzeugen Sie gültige Meshes und profilen Sie sie. Das beste Layout ist das, das mit Reserve passt und die sichtbare Kommunikation für Ihren konkreten Job minimiert.
Referenzen
- PyTorch-FSDP2-Dokumentation zu
fully_shard- Sharding von Parametern auf Modulebene, All-Gathers, Reduce-Scatters und DTensor-Verhalten. - PyTorch-Dokumentation zu DistributedDataParallel - Training mit replizierten Models und synchronisierten Gradients.
- PyTorch-Dokumentation zu
torchrun- Einen Prozess pro GPU mit Umgebungsvariablen für den Rank starten. - Parallelisierungsstrategien von NVIDIA Megatron Core - Data-, Tensor-, Pipeline-, Context-, Expert- und Fully-Sharded-Dimensionen.
- Hugging Face Ultra-Scale Playbook - Interaktiver Überblick über Model Parallelism im großen Maßstab.
- Ultra-Scale Playbook: Kurzreferenz - Zusammenfassung des Playbooks auf einer Seite.
- FSDP-Leitfaden von Hugging Face Accelerate - Konfigurationsschlüssel und Startbefehle für FSDP.
- Anleitung zu DeepSpeed ZeRO - ZeRO-Stufen und Konfiguration des Auslagerns.
- Artikel zu DeepSpeed ZeRO - Sharding von Optimizer States, Gradients und Parametern, um den Speicherbedarf zu senken.
- Artikel zu Megatron-LM - Spalten- und zeilenparallele Transformer-Layer.
- Reducing Activation Recomputation in Large Transformer Models - Sequence Parallelism in Megatron.
- Artikel zu GPipe - Pipeline-Training mit Micro-Batches und Ausführung in Stages.
- Parallelisierung und Skalierung in vLLM - Einstellungen für Tensor- und Pipeline-paralleles Serving.
- Mixtral of experts - Gesamte und aktive Parameterzahl von Mixtral 8x7B.
- NERSC-Dokumentation zur Parallelisierung - Definitionen von Strong und Weak Scaling auf Basis fester Gesamtarbeit oder fester Arbeit pro Rank.