Mise à l'échelle des LLMs avec le parallélisme multi-GPU et multi-nœuds

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
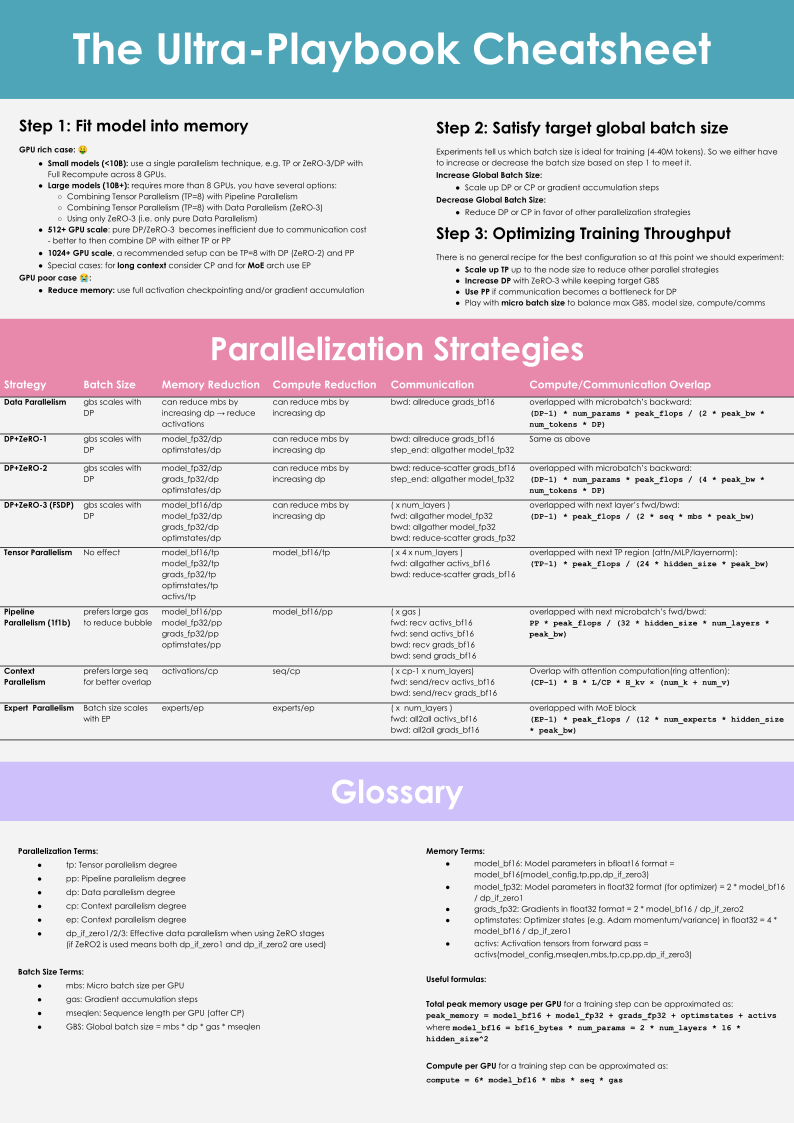
Vous saurez ce que chaque découpage économise, ce qu’il fait communiquer, quel framework l’implémente et comment établir un premier maillage candidat sur votre cluster. Cet article s’adresse aux ingénieurs qui connaissent la rétropropagation, les couches Transformer et une boucle d’entraînement PyTorch, et qui ont désormais besoin de plus d’un GPU pour entraîner ou servir un modèle. C’est un tour d’horizon pratique des principales stratégies de parallélisme, de leurs contraintes et des outils qui les implémentent, inspiré de l’Ultra-Scale Playbook de Hugging Face.
Les charges de travail sur grands modèles dépassent un seul GPU pour des raisons différentes. Un job d’entraînement peut manquer de mémoire à cause de l’état de l’optimiseur. Un autre peut en manquer à cause des activations des séquences longues. Un modèle qui tient en mémoire peut tout de même rater son objectif de débit. Chaque problème appelle un partitionnement et un schéma de communication différents.
Budgets mémoire de l’entraînement et de l’inférence
L’entraînement et l’inférence n’ont pas la même empreinte.
training peak ≈ parameters
              + gradients
              + optimizer state
              + saved activations
              + temporary buffers
              + communication buffers
              + allocator headroom

inference peak ≈ resident weights
               + key/value (KV) cache
               + runtime workspace
               + communication buffers
               + allocator headroom
Un modèle de 70 milliards de paramètres a une borne inférieure décimale de 140 Go pour les seuls poids en BF16. L’entraînement demande beaucoup plus. L’article ZeRO compte environ 16 octets d’état du modèle par paramètre pour Adam en précision mixte FP16 : 2 pour les poids FP16, 2 pour les gradients FP16, et 12 pour les poids maîtres FP32 et les deux moments d’Adam. Pour 70 milliards de paramètres, cela donne environ 1 120 Go avant les activations. Le tableau et le graphique ci-dessous utilisent cette répartition ; la précision réelle des tenseurs et la politique de poids maîtres peuvent différer.
Le parallélisme de données répliqué (DDP) garde tout cet état sur chaque GPU. Le partage (sharding) le répartit entre les GPUs d’un groupe au lieu de le copier. L’article ZeRO définit trois étapes : l’étape 1 partage l’état de l’optimiseur, l’étape 2 partage aussi les gradients, et l’étape 3 partage aussi les paramètres. L’étape 3 correspond à ce que PyTorch appelle le parallélisme de données entièrement partagé (FSDP). Pour Ψ paramètres sur N GPUs :
model state per GPU (ZeRO paper's FP16 mixed-precision Adam)
DDP      16Ψ
ZeRO-1   4Ψ + 12Ψ / N
ZeRO-2   2Ψ + 14Ψ / N
ZeRO-3   16Ψ / N
Partagé sur 64 GPUs, le modèle de 70 milliards de paramètres demande environ 293 Go par GPU avec ZeRO-1, environ 155 Go avec ZeRO-2 et environ 17,5 Go avec ZeRO-3 ou FSDP.
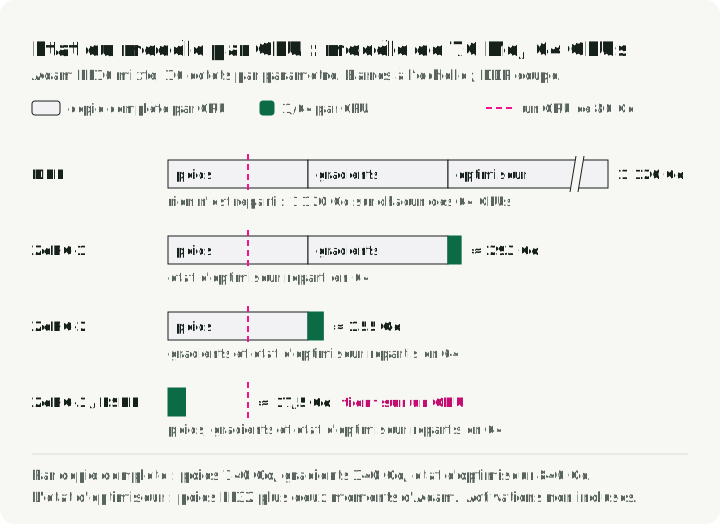
Le graphique sépare chacune de ces quatre valeurs en la part que chaque GPU copie et la part qu’il partage avec 63 autres, à côté de la mémoire d’un GPU de 80 Go : seul le partage complet ramène l’état du modèle en dessous, et l’espace restant sert aux activations et aux buffers.
L’inférence ne porte ni gradients ni état d’optimiseur, mais elle ajoute le KV cache, qui grandit avec chaque token que le serveur garde en mémoire :
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valueLe 2 compte les clés et les valeurs. Pour Llama 3.1 70B en BF16 (80 couches, 8 têtes KV, dimension de tête 128), cela fait environ 0,33 Mo par token, donc une séquence de 32 768 tokens occupe environ 10,7 Go de cache. Multipliez par le nombre de séquences concurrentes pour dimensionner un serveur. La politique de cache, la longueur de séquence, la concurrence et la quantification modifient ce chiffre.
Le gain de mémoire n’est pas un multiplicateur fixe. Les valeurs ci-dessus excluent les activations, les buffers temporaires et de communication, et la marge de l’allocateur. Le gain réel dépend du degré de partage, de ce qui reste répliqué, de l’état temporairement non partagé, de la politique d’activations, du padding, du déséquilibre et des buffers.
Profilez l’architecture, la précision, la longueur de séquence, le micro-batch, l’optimiseur, la politique de checkpointing et le runtime exacts. Relevez la mémoire allouée et réservée au pic, les tokens par seconde, le temps passé dans les kernels et le temps exposé dans les collectives. torch.cuda.max_memory_allocated() et torch.cuda.max_memory_reserved() donnent les deux pics ; le profileur PyTorch ou Nsight Systems montre le temps de kernel et la part du temps NCCL qui n’est pas recouverte par le calcul.
Comment les ranks communiquent
Un rank est un processus d’entraînement, qui pilote généralement un GPU. Les ranks échangent des tenseurs par des opérations collectives et des opérations point à point, qu’implémente la bibliothèque NCCL sur les GPUs NVIDIA. Cinq apparaissent dans cet article ; les exemples de réduction utilisent des sommes :
- All-reduce : chaque rank obtient la somme des tenseurs de tous les ranks.
- All-gather : chaque rank obtient le shard de chaque rank.
- Reduce-scatter : chaque rank obtient la somme d’un seul shard.
- All-to-all : chaque rank envoie un morceau différent à chacun des autres ranks.
- Point à point : un rank envoie un tenseur à un autre rank.
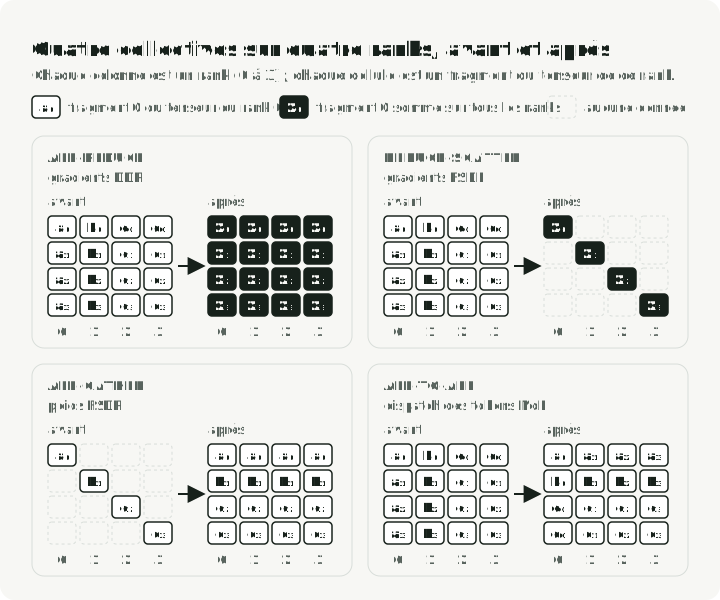
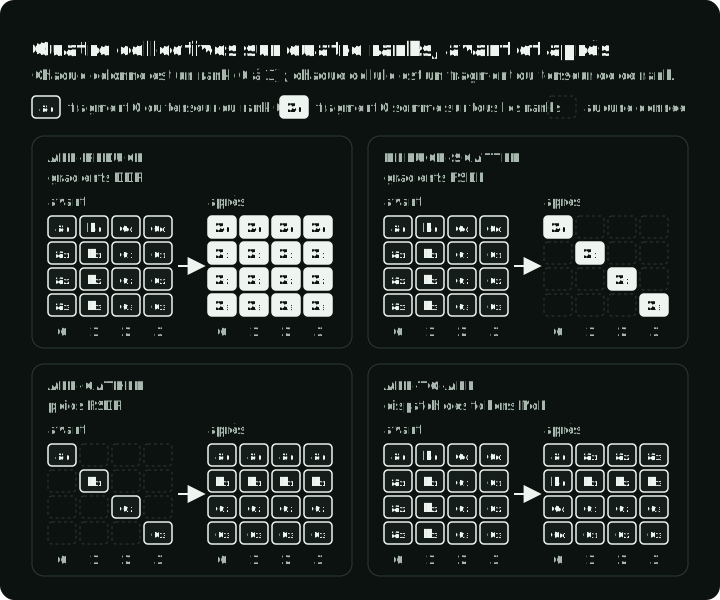
La figure montre quatre ranks avant et après chacune des quatre premières opérations, une colonne par rank et une cellule par fragment de son tenseur. Comparez all-reduce et reduce-scatter : les deux additionnent entre les ranks, mais reduce-scatter ne laisse à chaque rank que son propre shard de la somme.
Ce que chaque stratégie découpe et fait communiquer
Pour chaque stratégie, demandez-vous quelle dimension du tenseur est découpée, quel état reste répliqué et quelle collective entre dans le chemin critique.
| Stratégie | Découpe | Gain principal | Communication introduite |
|---|---|---|---|
| Parallélisme de données répliqué (DDP) | le batch | débit d’entraînement | all-reduce des gradients |
| Parallélisme de données entièrement partagé (FSDP) | paramètres, gradients, état de l’optimiseur au sein d’un groupe data-parallel (DP) | mémoire d’état du modèle | all-gather des paramètres, reduce-scatter des gradients |
| Parallélisme tensoriel (TP) | dimensions des matrices ou de l’attention à l’intérieur des couches | poids et activations des couches | collectives dans les blocs transformer |
| Parallélisme pipeline (PP) | groupes de couches | profondeur du modèle et état par étage | activations point à point et bulles d’ordonnancement |
| Parallélisme de contexte (CP) | dimension de la séquence | mémoire d’activations des longues séquences | échange de clés/valeurs ou d’attention au sein du groupe de séquence |
| Parallélisme d’experts (EP) | experts MoE et tokens routés | capacité d’experts par rank | dispatch et combine des tokens, couramment en all-to-all |
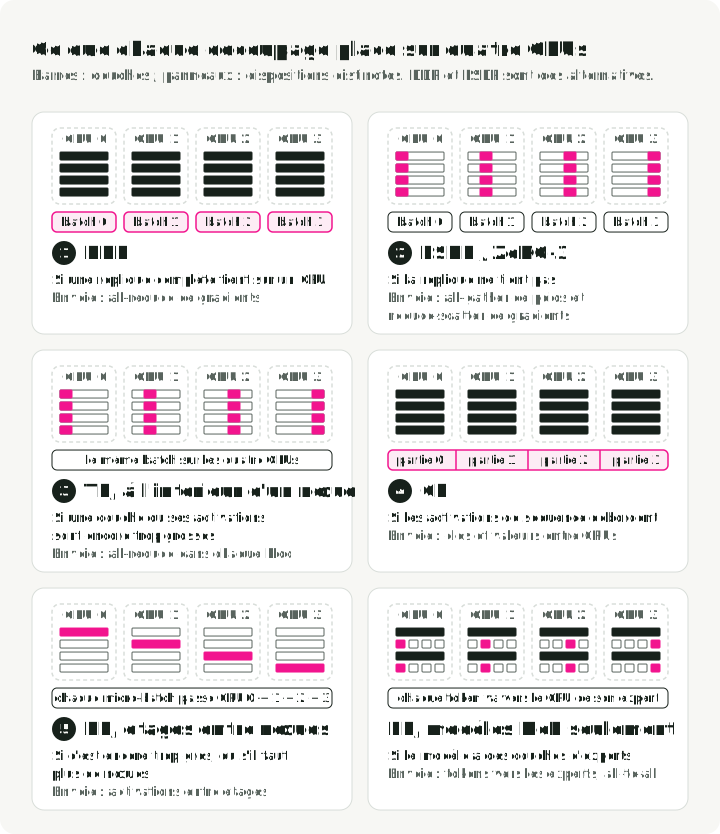
La figure montre six dispositions distinctes sur quatre GPUs. Choisissez DDP quand un réplica d’entraînement complet tient avec de la marge, ou FSDP/ZeRO quand l’état du modèle doit être partagé. N’ajoutez d’autres découpages que pour les contraintes qu’ils résolvent ; les panneaux ne montrent pas ces combinaisons. Les sections suivantes expliquent chaque découpage.
Parallélisme de données (DDP)
Le parallélisme de données répliqué, souvent appelé distributed data parallel, garde un réplica d’entraînement complet sur chaque rank. La documentation de DistributedDataParallel dans PyTorch décrit ce modèle de réplicas avec synchronisation des gradients. Chaque rank traite un micro-batch différent, et les gradients sont synchronisés avant l’étape de l’optimiseur.
Utilisez-le quand tout l’état d’entraînement tient avec de la marge. Chaque nouveau rank ajoute son micro-batch au batch global : soit votre recette d’entraînement tolère un batch global plus grand, soit vous réduisez l’accumulation de gradients pour le garder constant. Ses principaux avantages sont une sémantique simple et une implémentation mature qui recouvre le calcul de la passe arrière par la réduction des gradients en buckets.
Ajouter des ranks peut nuire quand le batch local devient trop petit. Cela peut aussi nuire quand le réseau ne parvient pas à masquer l’all-reduce ou que la livraison des données d’entrée bloque. Des batches globaux plus grands peuvent apporter des gains de plus en plus faibles sur le temps nécessaire pour atteindre une perte cible, tout en consommant plus de calcul. Comparez la perte et le temps écoulé pour votre recette d’entraînement.
La figure montre une étape d’entraînement sur un rank. Des buckets de gradients sont réduits par all-reduce pendant la passe arrière, et le GPU n’attend que la part de l’all-reduce que le réseau ne peut pas masquer.
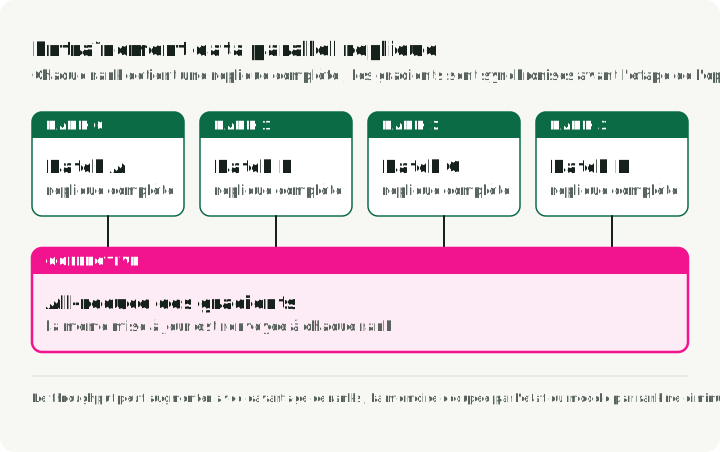
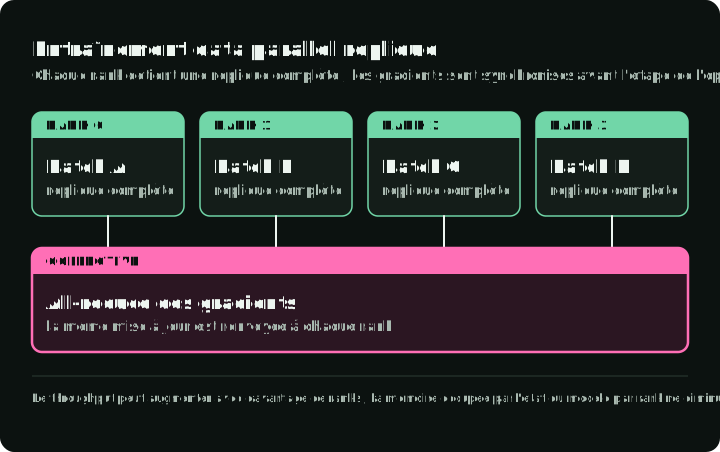
Avec PyTorch, vous enveloppez le modèle dans DistributedDataParallel et vous lancez un processus par GPU avec torchrun, qui définit RANK, LOCAL_RANK et WORLD_SIZE pour chaque processus. Hugging Face Accelerate lance la même configuration à partir d’un fichier de config.
Parallélisme de données entièrement partagé (FSDP, ZeRO)
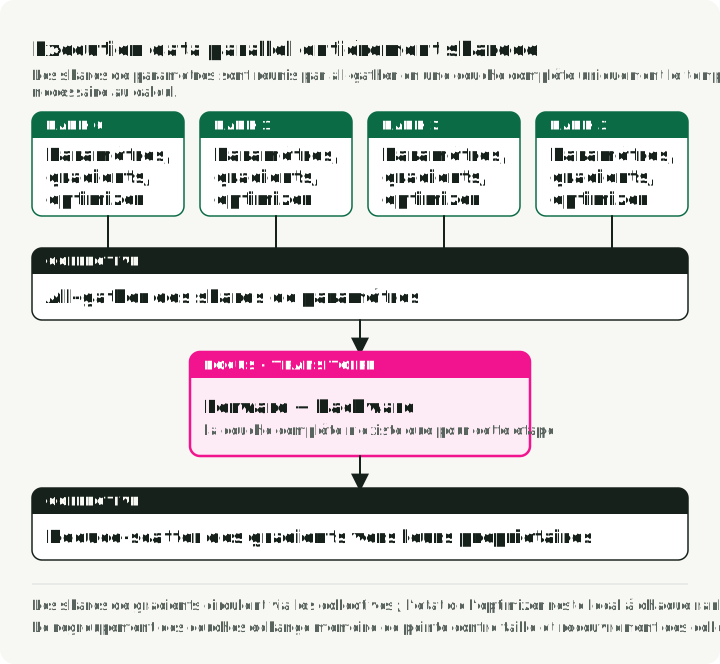
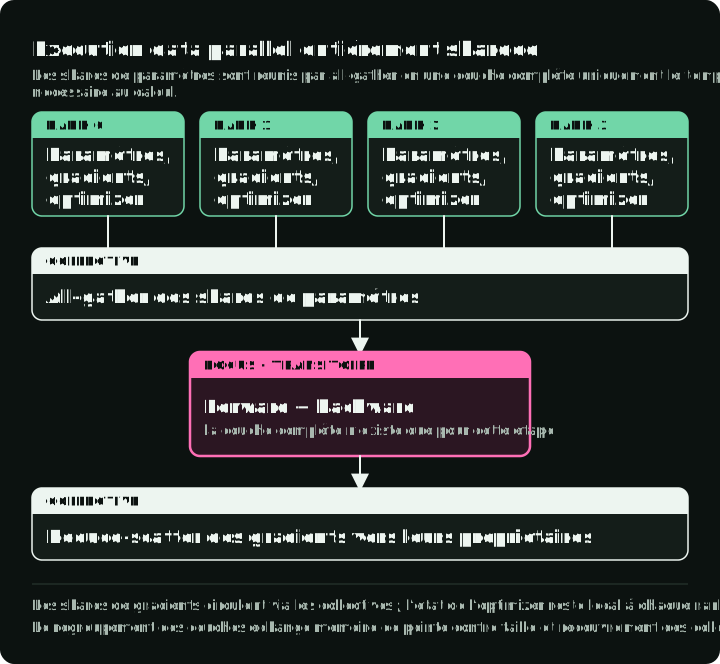
Le parallélisme de données entièrement partagé stocke des shards de paramètres, de gradients et d’état d’optimiseur à travers un groupe. L’article ZeRO décrit ce schéma de partage de l’état, et l’API FSDP2 de PyTorch l’implémente. Les paramètres d’une couche sont rassemblés par all-gather pour le calcul et peuvent être repartagés ensuite. Les gradients sont renvoyés à leurs propriétaires par reduce-scatter. La figure suit une couche sur l’un des quatre ranks pendant une étape d’entraînement : le rank stocke un quart des poids, des gradients et de l’état d’optimiseur, un all-gather reconstruit les poids complets pour la passe avant puis à nouveau pour la passe arrière, et le reduce-scatter laisse au rank son quart des gradients.
L’article ZeRO estime le coût de l’étape 3 à environ 1,5 fois le volume de communication de DDP : les paramètres sont rassemblés par all-gather à la fois dans la passe avant et dans la passe arrière, et les gradients sont répartis une fois par reduce-scatter.
La documentation actuelle de PyTorch distingue l’API fully_shard du parallélisme de données entièrement partagé version 2 (FSDP2) de l’ancien wrapper FullyShardedDataParallel. FSDP2 regroupe la communication selon les modules auxquels fully_shard est appliqué, et recommande de l’appliquer du bas vers le haut pour que les groupes de couches puissent recouvrir communication et calcul.
L’ordre des appels est la partie facile à rater. Cet extrait partage une pile de couches Transformer avec FSDP2 :
model = nn.Sequential(*layers).cuda()  # e.g. 24 Transformer layers

for layer in model:  # bottom-up: each layer becomes one communication group
    fully_shard(layer)
fully_shard(model)  # then shard the remaining root parameters

# Build the optimizer after sharding, so it holds the sharded parameters (DTensors).
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
Lancez un processus par GPU avec torchrun --nproc_per_node=8 train.py. La mémoire de pointe par rank diminue quand le groupe de partage grandit, car chaque rank garde une part plus petite des poids FP32, des gradients et de l’état d’Adam. Les activations ne diminuent pas, car chaque rank traite toujours son propre batch. Le tutoriel FSDP2 propose un script complet avec précision mixte et checkpointing. FSDP2 a aussi une option reshard_after_forward=False qui garde les paramètres rassemblés entre la passe avant et la passe arrière. Elle se comporte comme ZeRO-2 : moins d’all-gathers, plus de mémoire.
Le partage est intéressant quand l’état du modèle occupe la plus grande partie de la mémoire et que le calcul des couches peut masquer assez de trafic collectif. Ce peut être un mauvais compromis pour les petits modèles, les liens lents, les couches minuscules, ou un groupe de partage qui s’étend sur plusieurs nœuds via un réseau lent. DeepSpeed ZeRO implémente les mêmes étapes avec une sélection explicite de l’étape et un déchargement optionnel de l’état vers la mémoire CPU ou NVMe.
Parallélisme tensoriel
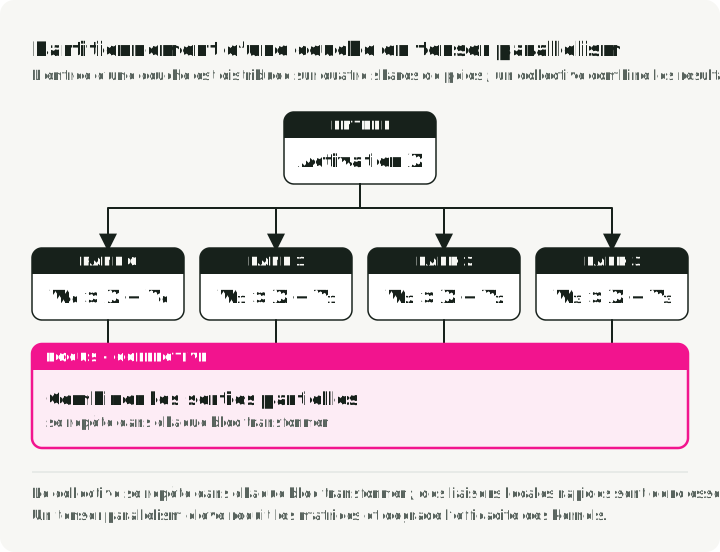
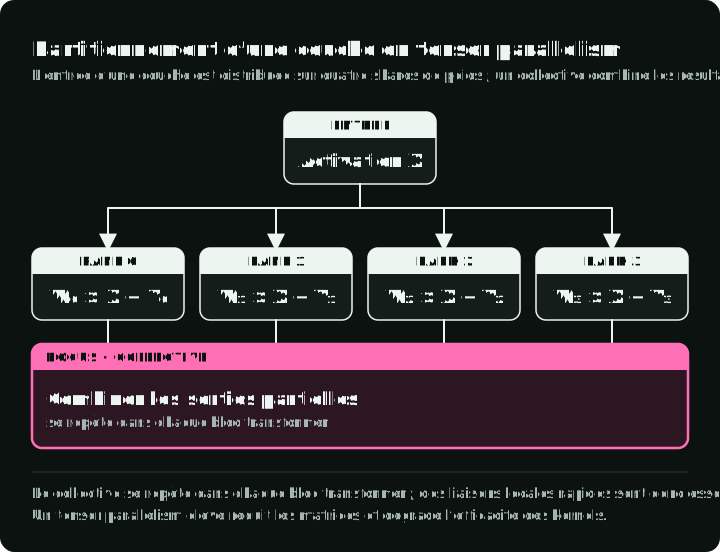
Le parallélisme tensoriel partitionne l’algèbre linéaire à l’intérieur d’une couche. Les projections parallèles par colonnes et par lignes en sont des exemples. Le guide du parallélisme de NVIDIA documente ce découpage au niveau des couches. Les résultats partiels exigent des collectives à l’intérieur des blocs transformer : la latence et la bande passante comptent donc à répétition pendant les passes avant et arrière.
La figure montre le découpage que l’article Megatron-LM utilise pour un MLP Transformer sur deux ranks. La première matrice de poids est découpée par colonnes, donc chaque rank applique GeLU à sa propre tranche sans communication. La seconde matrice est découpée par lignes, donc chaque rank produit une somme partielle de la sortie, et un seul all-reduce les additionne. Cela fait un all-reduce par MLP dans la passe avant, au lieu d’un par multiplication matricielle.
Utilisez-le quand une couche ou ses activations ne tiennent pas, ou quand les multiplications matricielles sont assez grandes pour que des kernels partitionnés surpassent un seul rank. Associez le groupe tensor-parallel au domaine de communication le plus rapide disponible, puis mesurez. Un degré tensor-parallel élevé peut réduire chaque matrice locale jusqu’à ce que l’efficacité des kernels chute alors que le surcoût des collectives augmente.
Le parallélisme de séquence de type Megatron découpe selon la séquence les activations des régions LayerNorm et dropout, que le TP seul garderait en entier sur chaque rank du groupe TP. Il fonctionne à l’intérieur du groupe TP ; le parallélisme de contexte découpe toute la séquence, attention comprise, dans un groupe distinct.
Megatron Core implémente le TP et le parallélisme de séquence pour l’entraînement. vLLM, SGLang et TensorRT-LLM utilisent le TP pour partager un modèle en serving.
Parallélisme pipeline
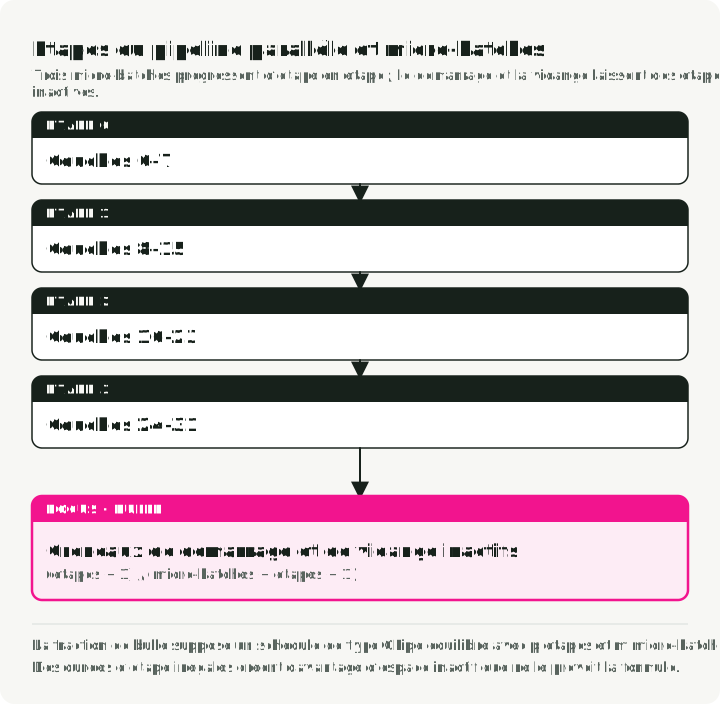
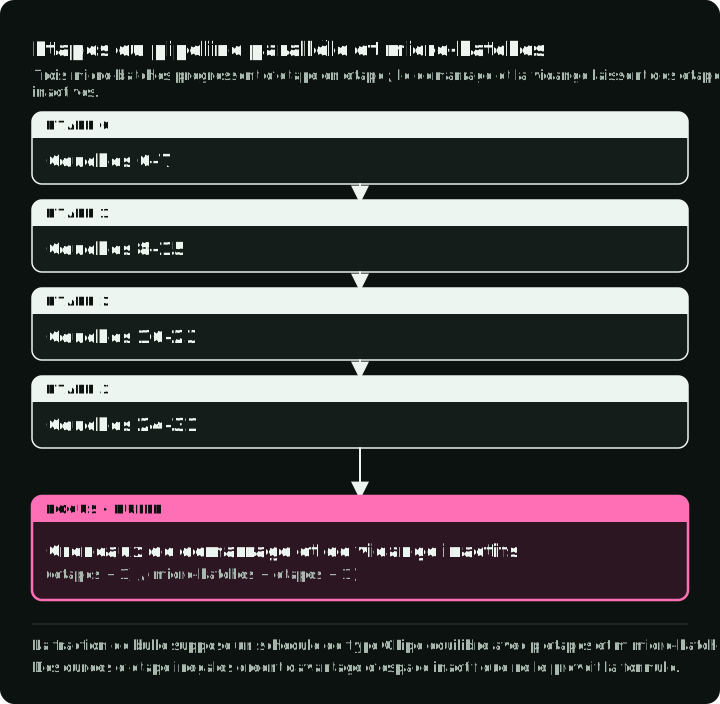
Le parallélisme pipeline place des groupes de couches différents sur des étages différents et envoie les activations de l’un à l’autre. Les micro-batches maintiennent les étages au travail en même temps.
Il allège l’état du modèle par étage et peut réduire le volume de communication qui traverse une frontière plus lente, par comparaison avec les collectives tensorielles de chaque couche. Ses coûts sont les bulles, les transferts d’activations, le déséquilibre entre étages, un ordonnancement plus complexe, et une reprise et un checkpointing plus difficiles.
La figure montre la passe avant de quatre étages et quatre micro-batches sur sept pas de temps, et en dessous la part inactive pour davantage de micro-batches. Chaque case vide est un étage sans travail : les derniers étages attendent au début, et les premiers attendent à la fin. Pour un ordonnancement de type GPipe simple et équilibré avec p étages et m micro-batches, la fraction idéale de bulle de la passe avant vaut approximativement :
(p - 1) / (m + p - 1)Avec 4 étages, 4 micro-batches laissent 3/7, soit environ 43 %, de l’ordonnancement avant inactif. 16 micro-batches en laissent 3/19, environ 16 %, et 32 en laissent 3/35, environ 9 %. Davantage de micro-batches par batch global réduisent la bulle, mais chacun est plus petit, donc les kernels sont moins efficaces ; mesurez les deux.
Les ordonnancements réels peuvent utiliser une passe avant/une passe arrière alternées, l’entrelacement ou des variantes à bulle nulle, et un coût inégal des couches peut dominer la formule. Choisissez les frontières d’étages d’après le temps et la mémoire mesurés, pas d’après un nombre égal de couches.
DeepSpeed, Megatron Core et Nanotron implémentent des ordonnancements pipeline.
Parallélisme de contexte
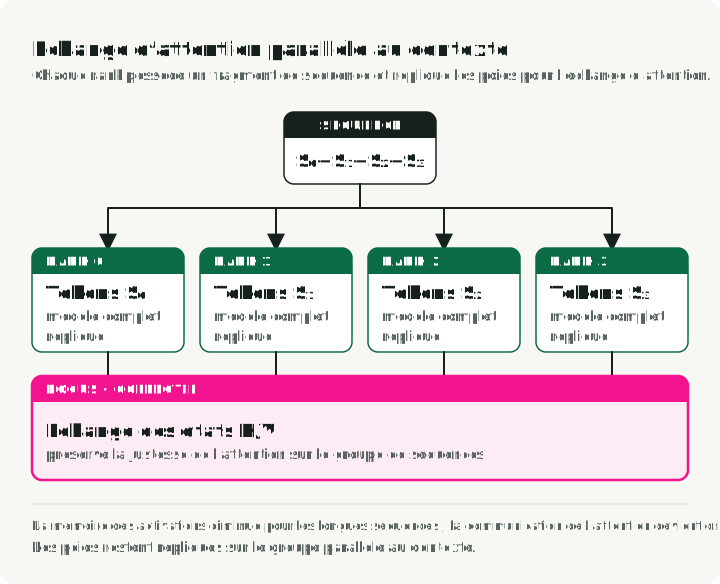
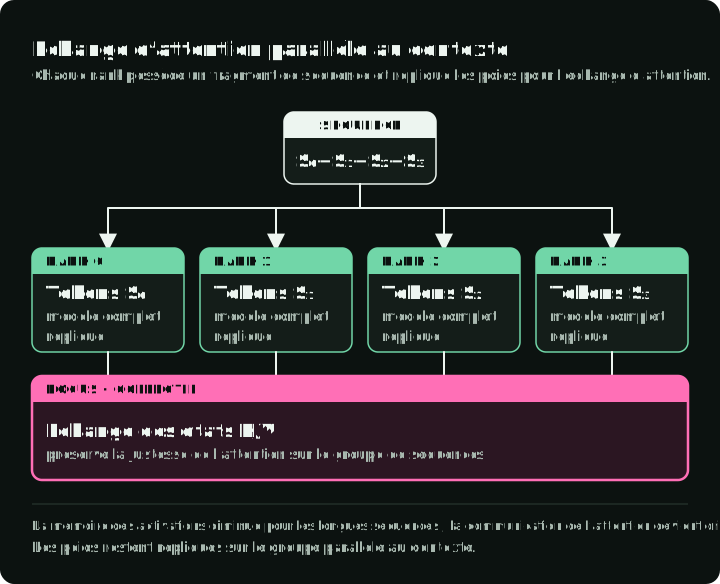
Le parallélisme de contexte répartit la dimension de la séquence. La documentation de NVIDIA sur le parallélisme de contexte décrit le découpage de la séquence et l’échange de clés/valeurs nécessaire à l’attention. Chaque rank possède un shard de la séquence, tandis que l’attention échange les informations nécessaires pour préserver la sémantique du contexte complet. Les implémentations peuvent utiliser des anneaux point à point, all-gather, all-to-all, ou des combinaisons hiérarchiques.
Il réduit la mémoire d’activations pour l’entraînement en contexte long, mais réplique les poids dans le groupe de contexte et introduit de la communication d’attention. Le bénéfice dépend du type d’attention, du masque causal, de la longueur de séquence, du recalcul, et de la manière dont les groupes de contexte se composent avec les groupes tensor-parallel et data-parallel.
Ne le choisissez pas à partir d’un seuil universel de 8K, 32K ou 100K. Envisagez-le quand les activations dépassent encore la mémoire à votre longueur de séquence cible après le checkpointing des activations et le parallélisme tensoriel plus de séquence, et que les poids tiennent déjà.
Megatron Core implémente le CP pour l’entraînement. Picotron propose une petite implémentation des parallélismes de données, tensoriel, pipeline et de contexte pour apprendre comment ils s’articulent.
Parallélisme d’experts pour les modèles MoE
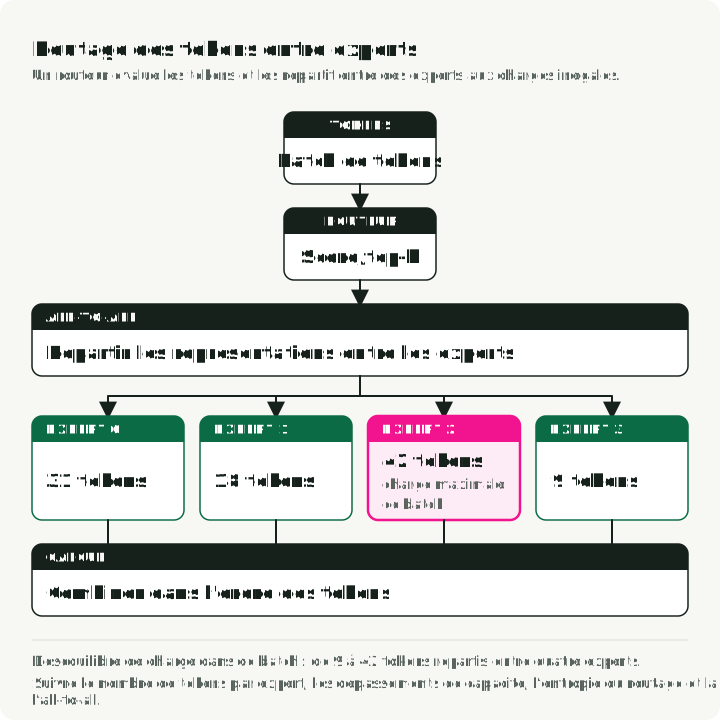
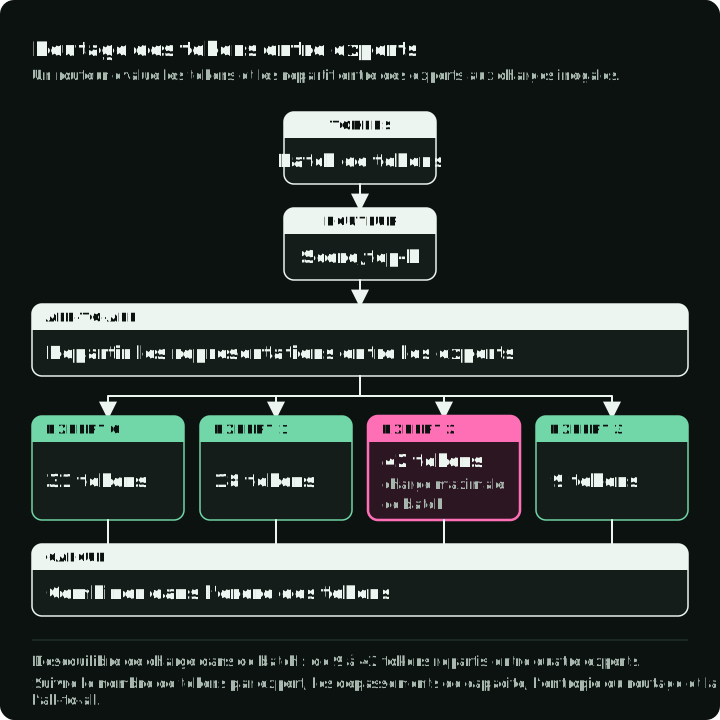
Le parallélisme d’experts répartit les experts des couches de mixture d’experts. Mixtral 8x7B, par exemple, stocke environ 46,7 milliards de paramètres mais en utilise environ 12,9 milliards par token. Le guide du parallélisme de NVIDIA documente ce placement des experts et sa combinaison avec les autres dimensions de parallélisme. Le routeur envoie les représentations des tokens aux experts choisis et combine leurs résultats. Seuls les experts choisis calculent pour chaque token, mais l’ensemble des poids d’experts doit tout de même être stocké et placé pour le serving.
Le parallélisme d’experts n’est pas un réglage d’optimisation pour un modèle dense. Il fait partie d’une architecture MoE. Ses points d’attention sont l’équilibrage de charge, les limites de capacité, l’all-to-all des tokens, les tokens abandonnés, le padding, les pertes auxiliaires et l’asymétrie des pannes. Les réglages MoE de Megatron distinguent l’abandon des affectations qui dépassent la capacité d’un expert du remplissage des emplacements inutilisés en dessous de cette capacité. Le routage sans abandon traite des nombres variables de tokens. Suivez les tokens par expert, l’entropie du routage, les dépassements de capacité, le temps de communication et la qualité par route.
Megatron Core et Nanotron implémentent l’EP pour l’entraînement.
Composer une disposition à partir de la topologie
Les grands systèmes d’entraînement de modèles denses sans groupe expert-parallel utilisent couramment un produit des tailles des groupes data-parallel (DP), tensor-parallel (TP), pipeline-parallel (PP) et context-parallel (CP) :
world size = DP × TP × PP × CPQuand le parallélisme d’experts (EP) forme un groupe indépendant, le guide du parallélisme de NVIDIA calcule le total ainsi :
total GPUs = TP × PP × CP × EP × DPVérifiez quels ordres et quelles tailles de groupes votre framework prend en charge avant de choisir les degrés.
Construisez la disposition dans cet ordre :
- Dessinez les domaines de communication : liens GPU à GPU, switches, frontières d’accès mémoire non uniforme (NUMA), fabric entre nœuds, sursouscription et chemin de stockage. Sur la plupart des serveurs GPU, le domaine le plus rapide est NVLink entre les GPUs d’un même nœud ; les nœuds sont reliés par un réseau plus lent, comme InfiniBand.
- Placez les collectives fréquentes et sensibles à la latence, couramment le TP, dans le domaine adapté le plus rapide. Cela signifie en général garder chaque groupe TP à l’intérieur d’un nœud.
- Choisissez les groupes FSDP ou DP répliqués selon la capacité et la bande passante restantes.
- Ajoutez le PP quand le placement en profondeur ou le trafic entre domaines en profite, en équilibrant le temps et la mémoire mesurés par étage.
- N’ajoutez le CP que pour la contrainte de séquence, et l’EP que pour la topologie d’experts du modèle.
- Vérifiez la divisibilité des têtes, des dimensions cachées, des couches, des experts, du batch et de la séquence pour le maillage candidat.
- Faites un benchmark de plusieurs maillages valides. Les heuristiques sensibles à la topologie choisissent des candidats, pas des vainqueurs.
Exemple de candidat pour un modèle dense de 70 milliards de paramètres avec un contexte de 32K sur 64 nœuds de 8 GPUs : TP=8 dans chaque nœud via NVLink, PP=4 entre les nœuds, CP=4 pour la séquence longue et DP=4 pour le reste ; 8 × 4 × 4 × 4 = 512 GPUs. Comparez-le par benchmark à TP=8, PP=8, CP=2, DP=4 avant de choisir.
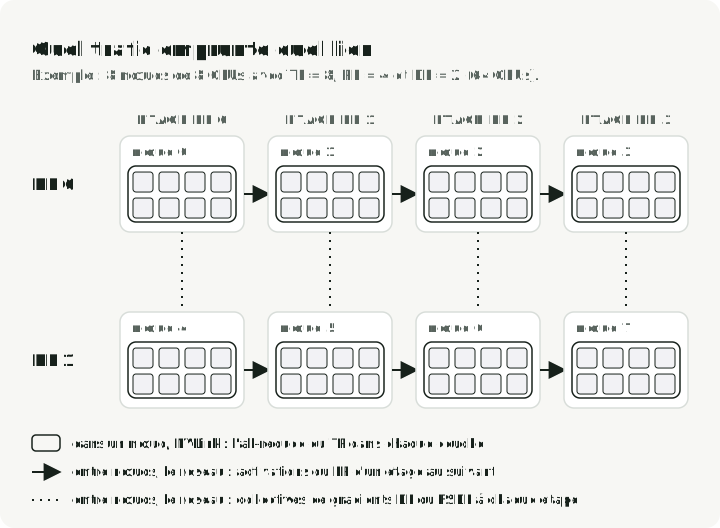
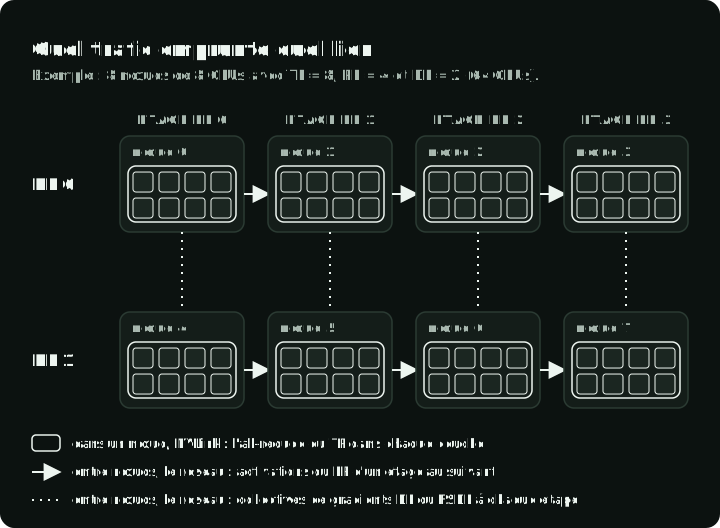
La figure montre où va le trafic de chaque groupe dans ce type de disposition : l’all-reduce du TP reste sur NVLink à l’intérieur d’un nœud, tandis que les collectives de gradients FSDP ou DP et les activations du PP traversent le réseau entre les nœuds.
Candidats de départ selon la taille du cluster, à comparer par benchmark plutôt qu’à adopter tels quels :
- Un nœud, 2 à 8 GPUs. DDP quand un réplica d’entraînement complet tient avec de la marge ; FSDP2 ou DeepSpeed ZeRO-2/3 quand l’état du modèle doit être partagé. Lancez avec
torchrunou Accelerate. N’ajoutez TP=2 que si une couche ou ses activations ne tiennent toujours pas. Sur des GPUs reliés en PCIe sans NVLink, gardez le TP à 1 ou 2, car l’all-reduce de chaque couche traverse le PCIe. - 2 à 16 nœuds. TP à l’intérieur de chaque nœud (4 ou 8 avec NVLink), FSDP ou DP entre les nœuds, et PP entre les nœuds seulement si le modèle ne tient toujours pas.
- Des centaines de GPUs ou plus. TP × PP × CP × DP, comme dans l’exemple ci-dessus, avec un framework qui implémente les quatre, tel que Megatron Core.
Deux clusters avec le même nombre de GPUs peuvent préférer des dispositions différentes, car la bande passante des liens, la hiérarchie des switches, le rattachement des CPUs et la contention réseau diffèrent.
Quel framework implémente quel découpage
Les découpages ci-dessus sont implémentés par un petit ensemble de bibliothèques. Choisissez selon les découpages dont vous avez besoin et la part de la boucle d’entraînement que vous voulez maîtriser.
| Outil | Découpages pris en charge | À utiliser quand |
|---|---|---|
| Hugging Face Accelerate | lance DDP, FSDP ou DeepSpeed à partir d’un fichier de config | vous voulez faire tourner un script PyTorch ou Transformers existant sur plusieurs GPUs avec peu de changements |
| PyTorch DDP et FSDP2 | DDP, FSDP (fully_shard), avec torchrun | vous entraînez un modèle dense sur un ou quelques nœuds et voulez du PyTorch pur |
| DeepSpeed ZeRO | étapes ZeRO 1, 2, 3, déchargement CPU et NVMe, PP | vous voulez choisir l’étape de partage, ou décharger l’état vers la mémoire CPU ou NVMe |
| Megatron Core | TP, PP, CP, EP, DP et parallélisme de séquence | vous avez besoin de TP, PP et CP (et EP) ensemble pour de grands pré-entraînements |
| Nanotron | DP, TP, PP, EP, ZeRO-1 | vous voulez une base de code plus petite que Megatron pour le parallélisme 3D et les MoE |
| vLLM, SGLang, TensorRT-LLM | TP et PP pour l’inférence | vous servez le modèle ; voir la section sur le serving ci-dessous |
Pour exécuter un script existant avec FSDP2 via Accelerate, lancez accelerate config une fois ; il écrit le fichier de config de façon interactive. Ces réglages sélectionnent FSDP2, le regroupement par couches du décodeur et le repartage :
fsdp_config:
    fsdp_version: 2
    fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP
    fsdp_transformer_layer_cls_to_wrap: LlamaDecoderLayer
    fsdp_reshard_after_forward: true
Avec fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP, fsdp_transformer_layer_cls_to_wrap nomme la classe de bloc qui devient une unité FSDP, avec le même regroupement du bas vers le haut que la boucle fully_shard ci-dessus. fsdp_reshard_after_forward: true correspond au partage complet ; false correspond au mode proche de ZeRO-2. Démarrez le job avec accelerate launch --config_file fsdp2.yaml train.py. Le guide FSDP1/FSDP2 explique ces réglages propres à chaque version et la commande accelerate to-fsdp2, qui convertit une ancienne config FSDP1.
L’entraînement et le serving demandent des décisions séparées
L’inférence ne porte généralement ni gradients ni état d’optimiseur, donc les dispositions d’entraînement de type FSDP ne se transposent pas automatiquement.
Le prefill traite le prompt et stocke les clés et les valeurs de ses tokens dans le KV cache. Le décodage génère les tokens suivants en réutilisant et en étendant ce cache.
Pour le serving, demandez-vous :
- Un réplica tient-il avec les poids, le KV cache, l’espace de travail et la concurrence cible ?
- Le débit est-il mieux servi par davantage de réplicas indépendants ou par le partage d’un seul réplica ?
- Le TP réduit-il assez la pression sur les poids et le cache par rank pour rembourser la communication de chaque couche ?
- Le PP est-il pris en charge efficacement pour ce modèle et cet ordonnanceur de requêtes ?
- En quoi le prefill et le decode sollicitent-ils différemment le calcul, la bande passante mémoire et l’interconnexion ?
- Que devient la latence aux percentiles élevés quand les requêtes ont des longueurs de prompt et de sortie différentes ?
Utilisez la formule du KV cache de la section sur la mémoire pour la première question. Si un réplica tient avec de la place pour le KV cache à votre concurrence cible, lancez davantage de réplicas ; ils n’ont besoin d’aucune communication entre GPUs. S’il ne tient pas, partagez-le d’abord avec le TP à l’intérieur d’un nœud, et n’ajoutez le PP entre nœuds que si un nœud ne suffit pas. Dans vLLM, ce sont --tensor-parallel-size et --pipeline-parallel-size ; SGLang et TensorRT-LLM ont les deux mêmes réglages.
Faites un benchmark du serveur complet avec l’ordonnanceur, la quantification, la distribution des contextes, la politique de batching et le profil de trafic. Les tokens par seconde à l’entraînement ne prédisent ni le temps jusqu’au premier token ni la latence entre tokens en serving.
Quoi relever pour chaque disposition candidate
Pour chaque candidat, relevez :
- l’identité du modèle, du code, du runtime, des kernels et de la topologie
- le batch global et local, la distribution des séquences et le nombre de tokens
- la mémoire de pointe par catégorie quand elle est disponible
- les tokens utiles par seconde et l’utilisation des opérations à virgule flottante du modèle (FLOP) quand elle est calculée de façon cohérente
- le temps exposé dans les opérations all-reduce, all-gather, reduce-scatter, all-to-all et point à point
- les blocages sur les données d’entrée, le temps de checkpoint, le comportement au redémarrage et la distribution des stragglers
- la perte d’entraînement ou la parité des sorties en serving par rapport à la référence
Comparez délibérément la mise à l’échelle faible et forte. La mise à l’échelle forte garde le travail total constant quand le nombre de ranks augmente. La mise à l’échelle faible garde constant le travail par rank, donc le travail total croît avec le nombre de ranks. Un pourcentage étiqueté « efficacité de mise à l’échelle » n’a aucun sens sans ce dénominateur et cette référence.
Conclusion
Le parallélisme est une correspondance entre un goulot d’étranglement mesuré, une dimension de tenseur et un schéma de communication. La réplication, le partage, le partitionnement des couches, la mise en étages, le partitionnement de la séquence et le routage d’experts soulagent chacun une contrainte différente et créent un mode de défaillance différent.
Faites l’inventaire de la charge de travail, dessinez la topologie, générez des maillages valides et profilez-les. La disposition gagnante est celle qui tient avec de la marge et qui minimise la communication exposée pour le job que vous exécutez.
Références
- Documentation
fully_shardde PyTorch FSDP2 - Partage des paramètres au niveau des modules, all-gathers, reduce-scatters et comportement de DTensor. - Documentation de PyTorch DistributedDataParallel - Entraînement de modèle répliqué avec gradients synchronisés.
- Documentation de PyTorch
torchrun- Lancement d’un processus par GPU avec des variables d’environnement de rank. - Stratégies de parallélisme de NVIDIA Megatron Core - Dimensions des stratégies de données, tensorielle, pipeline, de contexte, d’experts et entièrement partagée.
- Hugging Face Ultra-Scale Playbook - Vue d’ensemble interactive du parallélisme de modèles à grande échelle.
- Aide-mémoire de l’Ultra-Scale Playbook - Résumé du playbook en une page.
- Guide FSDP de Hugging Face Accelerate - Clés de config et commandes de lancement pour FSDP.
- Tutoriel DeepSpeed ZeRO - Étapes ZeRO et configuration du déchargement.
- Article DeepSpeed ZeRO - Partage des états d’optimiseur, des gradients et des paramètres pour réduire l’usage mémoire.
- Article Megatron-LM - Couches Transformer parallèles par colonnes et par lignes.
- Reducing Activation Recomputation in Large Transformer Models - Parallélisme de séquence de Megatron.
- Article GPipe - Entraînement pipeline avec micro-batches et exécution par étages.
- Parallélisme et mise à l’échelle de vLLM - Réglages de serving tensor-parallel et pipeline-parallel.
- Mixtral of experts - Nombres de paramètres totaux et actifs pour Mixtral 8x7B.
- Documentation NERSC sur le parallélisme - Définitions de la mise à l’échelle forte et faible fondées sur un travail total ou par rank fixe.