Как масштабировать LLM на нескольких GPU и узлах

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
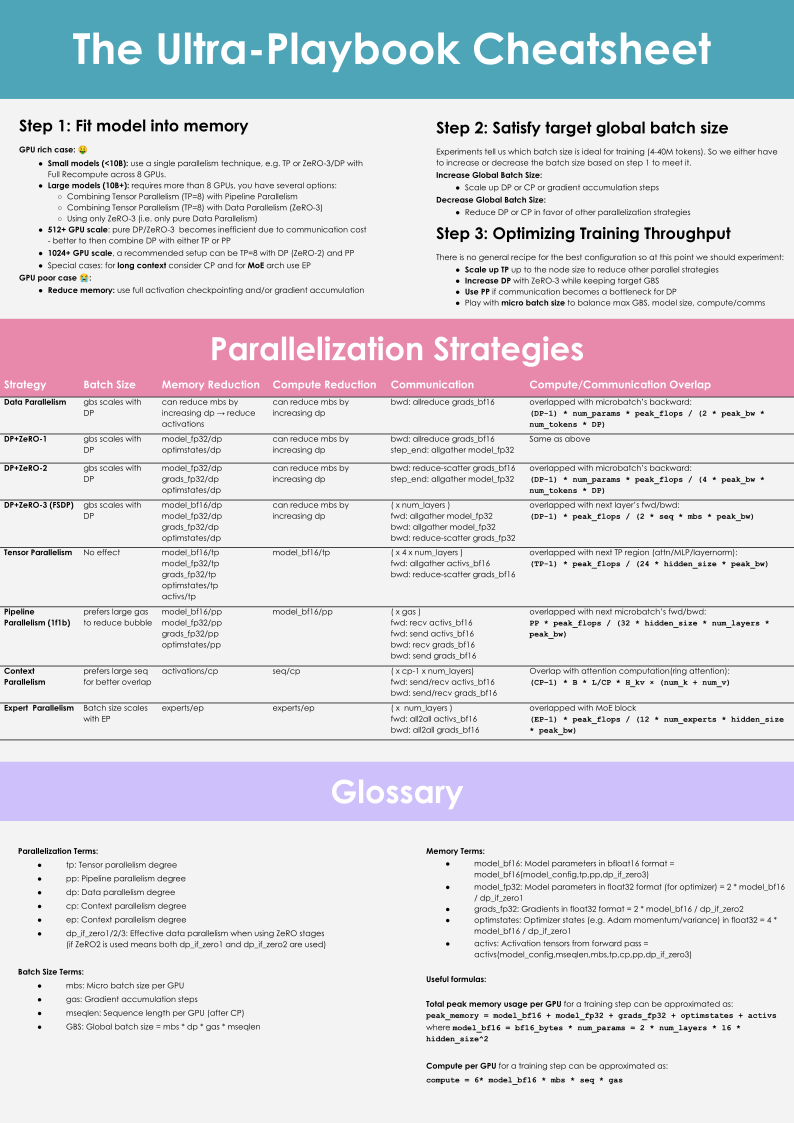
Вы узнаете, что экономит каждое разбиение, что оно передаёт, какой фреймворк его реализует и как собрать первую пробную схему (mesh) для своего кластера. Статья рассчитана на инженеров, которые знают обратное распространение ошибки, слои Transformer и обучающий цикл на PyTorch, а теперь хотят обучать или обслуживать модель на нескольких GPU. Это практический обзор основных стратегий параллелизма, их ограничений и инструментов, которые их реализуют, на основе Ultra-Scale Playbook от Hugging Face.
Большие модели выходят за пределы одной GPU по разным причинам. Обучению может не хватить памяти на состояние оптимизатора. Другому запуску может не хватить памяти на активации длинных последовательностей. Модель, которая помещается в память, всё равно может не дотягивать до целевой пропускной способности. Для каждой проблемы нужны своё разбиение и свой паттерн коммуникации.
Бюджеты памяти при обучении и инференсе
Обучение и инференс занимают память по-разному.
training peak ≈ parameters
              + gradients
              + optimizer state
              + saved activations
              + temporary buffers
              + communication buffers
              + allocator headroom

inference peak ≈ resident weights
               + key/value (KV) cache
               + runtime workspace
               + communication buffers
               + allocator headroom
Для модели на 70 миллиардов параметров одни только веса в BF16 дают нижнюю границу в 140 ГБ (в десятичных единицах). Для обучения нужно намного больше. Статья про ZeRO насчитывает около 16 байт состояния модели на параметр для Adam со смешанной точностью FP16: 2 на веса в FP16, 2 на градиенты в FP16 и 12 на мастер-веса в FP32 и два момента Adam. Для 70B параметров это около 1 120 ГБ ещё до активаций. Таблица и график ниже используют это распределение; фактическая точность тензоров и политика мастер-весов могут отличаться.
Реплицированный параллелизм данных (DDP) хранит всё это состояние на каждой GPU. Шардирование делит его между GPU группы, а не копирует. В статье про ZeRO определены три стадии: стадия 1 шардирует состояние оптимизатора, стадия 2 дополнительно шардирует градиенты, стадия 3 дополнительно шардирует параметры. Стадия 3 в PyTorch называется fully sharded data parallelism (FSDP). Для Ψ параметров на N GPU:
model state per GPU (ZeRO paper's FP16 mixed-precision Adam)
DDP      16Ψ
ZeRO-1   4Ψ + 12Ψ / N
ZeRO-2   2Ψ + 14Ψ / N
ZeRO-3   16Ψ / N
При шардировании на 64 GPU модели на 70B нужно около 293 ГБ на GPU с ZeRO-1, около 155 ГБ с ZeRO-2 и около 17,5 ГБ с ZeRO-3 или FSDP.
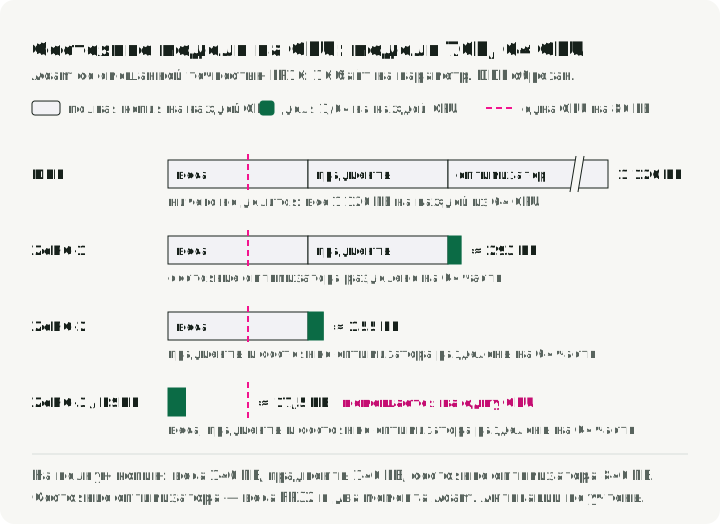
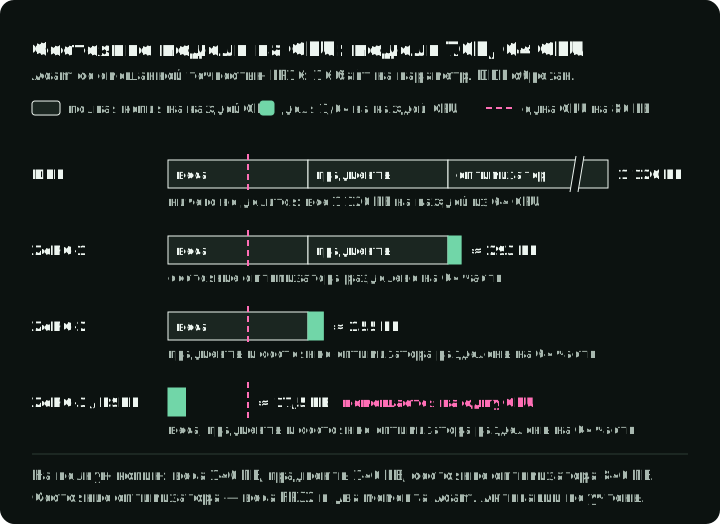
На графике каждое из этих четырёх чисел разделено на часть, которую копирует каждая GPU, и часть, которую она делит с 63 другими, рядом с памятью одной GPU на 80 ГБ: под неё состояние модели опускается только при полном шардировании, а оставшееся место уходит на активации и буферы.
Инференсу не нужны градиенты и состояние оптимизатора, но ему нужен KV cache, который растёт с каждым токеном, остающимся в памяти сервера:
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valueДвойка учитывает ключи и значения. Для Llama 3.1 70B в BF16 (80 слоёв, 8 KV-голов, размер головы 128) это около 0,33 МБ на токен, так что одна последовательность из 32 768 токенов занимает около 10,7 ГБ кэша. Чтобы оценить сервер, умножьте это число на количество параллельных последовательностей. Политика кэша, длина последовательности, число параллельных запросов и квантизация меняют результат.
Экономия памяти не равна фиксированному множителю. Числа выше не включают активации, временные буферы, буферы коммуникации и запас аллокатора. Реальная экономия зависит от степени шардирования, того, что остаётся реплицированным, временно несшардированного состояния, политики активаций, паддинга, дисбаланса и буферов.
Профилируйте конкретную архитектуру, точность, длину последовательности, микробатч, оптимизатор, политику чекпоинтинга и рантайм. Записывайте пиковую выделенную и зарезервированную память, токены в секунду, время в ядрах и время в коллективных операциях, которое не перекрыто вычислениями. torch.cuda.max_memory_allocated() и torch.cuda.max_memory_reserved() дают два пика; профайлер PyTorch или Nsight Systems показывает время ядер и долю времени NCCL, не перекрытую вычислениями.
Как ранги обмениваются данными
Ранг (rank) — это один процесс обучения, обычно управляющий одной GPU. Ранги обмениваются тензорами через коллективные операции и операции point-to-point, которые на GPU NVIDIA реализует библиотека NCCL. В статье встречаются пять; примеры редукции используют суммы:
- All-reduce: у каждого ранга в итоге сумма тензоров всех рангов.
- All-gather: у каждого ранга в итоге шарды всех рангов.
- Reduce-scatter: у каждого ранга в итоге сумма одного шарда.
- All-to-all: каждый ранг отправляет каждому другому рангу свой кусок.
- Point-to-point: один ранг отправляет тензор одному другому рангу.
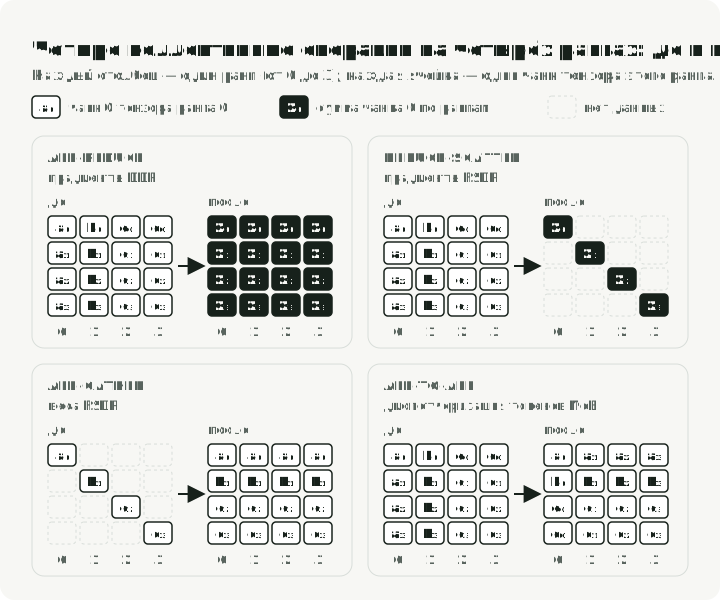
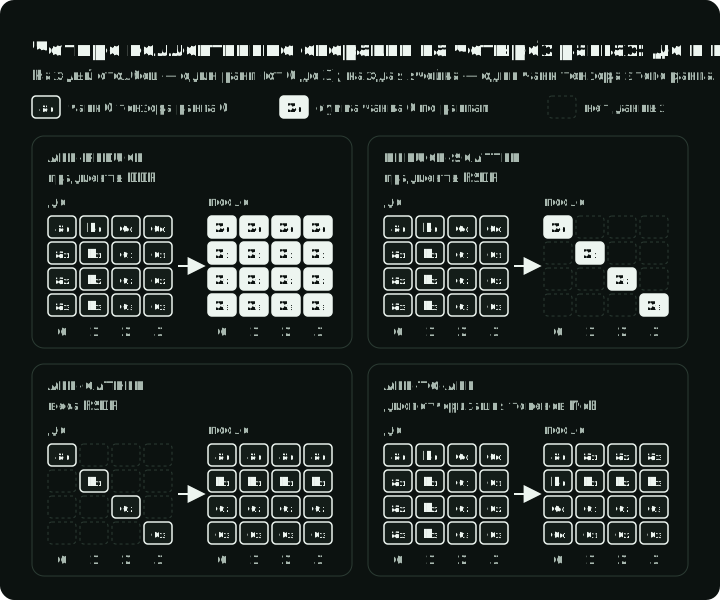
На рисунке показаны четыре ранга до и после каждой из первых четырёх операций: один столбец на ранг и одна ячейка на чанк его тензора. Сравните all-reduce и reduce-scatter: обе суммируют данные по рангам, но reduce-scatter оставляет каждому рангу только его собственный шард суммы.
Что делит и что передаёт каждая стратегия
Для каждой стратегии спрашивайте, какое измерение тензора разделено, какое состояние реплицировано и какая коллективная операция попадает на критический путь.
| Стратегия | Что делит | Основная экономия | Вводимая коммуникация |
|---|---|---|---|
| Реплицированный параллелизм данных (DDP) | батч | пропускная способность обучения | all-reduce градиентов |
| Полностью шардированный параллелизм данных (FSDP) | параметры, градиенты, состояние оптимизатора внутри группы параллелизма данных (DP) | память под состояние модели | all-gather параметров, reduce-scatter градиентов |
| Тензорный параллелизм (TP) | измерения матриц или аттеншн внутри слоёв | веса слоёв и активации | коллективные операции внутри блоков transformer |
| Конвейерный параллелизм (PP) | группы слоёв | глубина модели и состояние стадии | point-to-point передача активаций и пузыри в расписании |
| Контекстный параллелизм (CP) | измерение последовательности | память под активации длинных последовательностей | обмен key/value или аттеншн внутри группы последовательности |
| Экспертный параллелизм (EP) | эксперты MoE и маршрутизируемые токены | ёмкость экспертов на ранг | рассылка и сбор токенов, обычно через all-to-all |
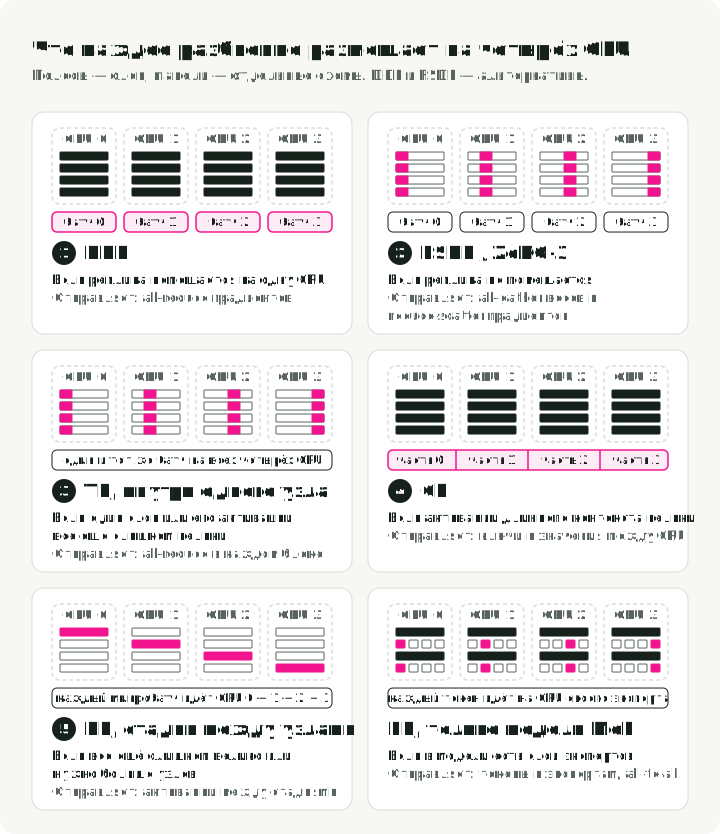
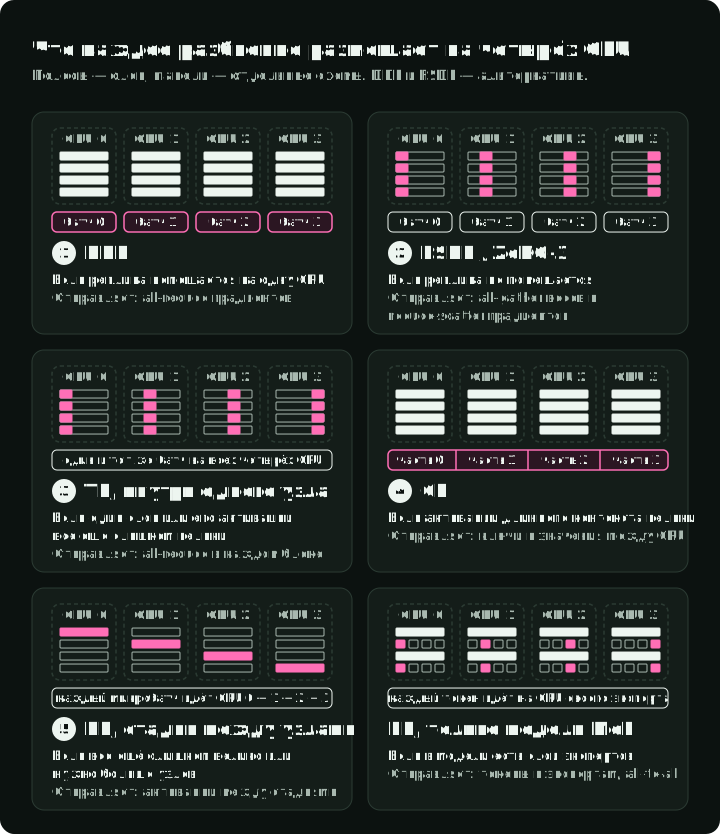
На рисунке показаны шесть отдельных схем на четырёх GPU. Выбирайте DDP, когда полная обучающая реплика помещается с запасом, или FSDP/ZeRO, когда состояние модели нужно шардировать. Добавляйте другие разбиения только для тех ограничений, которые они устраняют; эти комбинации на рисунке не показаны. Ниже каждое разбиение разобрано отдельно.
Параллелизм данных (DDP)
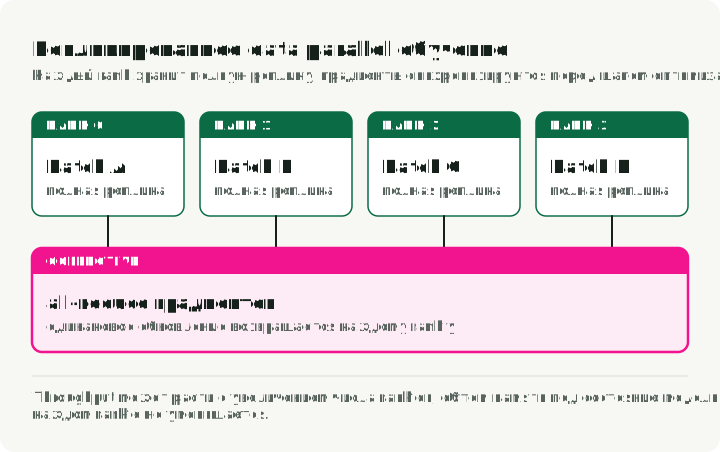
Реплицированный параллелизм данных, обычно называемый distributed data parallel, хранит полную обучающую реплику на каждом ранге. Эту модель с репликами и синхронизацией градиентов описывает документация PyTorch по DistributedDataParallel. Каждый ранг обрабатывает свой микробатч, а градиенты синхронизируются перед шагом оптимизатора.
Используйте его, когда всё обучающее состояние помещается в память с запасом. Каждый новый ранг добавляет свой микробатч к глобальному батчу, поэтому либо ваш рецепт обучения переносит больший глобальный батч, либо вы уменьшаете накопление градиентов, чтобы батч остался прежним. Главные преимущества: простая семантика и зрелая реализация, которая перекрывает вычисление обратного прохода с редукцией градиентов по бакетам.
Добавление рангов может ухудшить результат, когда локальный батч становится слишком мал. То же бывает, когда сеть не успевает скрыть all-reduce или задерживается подача входных данных. Большие глобальные батчи могут давать всё меньшее сокращение времени до целевого значения функции потерь, потребляя больше вычислений. Сравните значение функции потерь и прошедшее время для своего рецепта обучения.
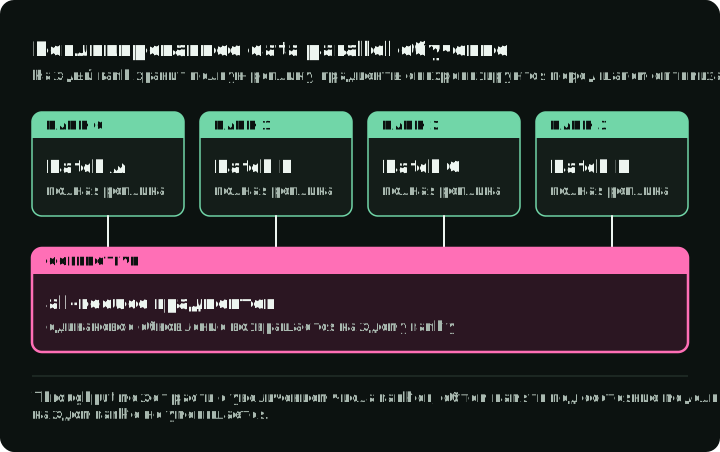
На рисунке показан один шаг обучения на одном ранге. Бакеты градиентов проходят через all-reduce, пока идёт обратный проход, и GPU ждёт только ту часть all-reduce, которую сеть не может скрыть.
В PyTorch вы оборачиваете модель в DistributedDataParallel и запускаете по одному процессу на GPU через torchrun, который задаёт RANK, LOCAL_RANK и WORLD_SIZE для каждого процесса. Hugging Face Accelerate запускает ту же конфигурацию из файла настроек.
Полностью шардированный параллелизм данных (FSDP, ZeRO)
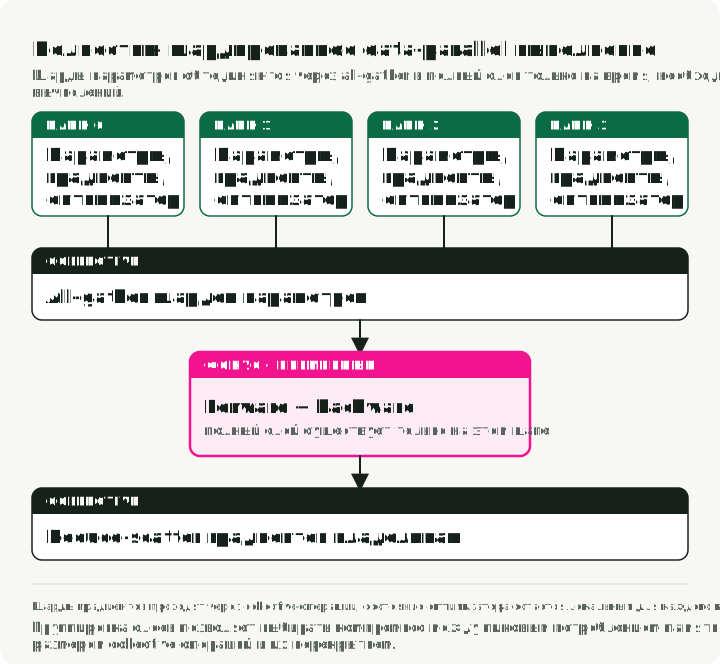
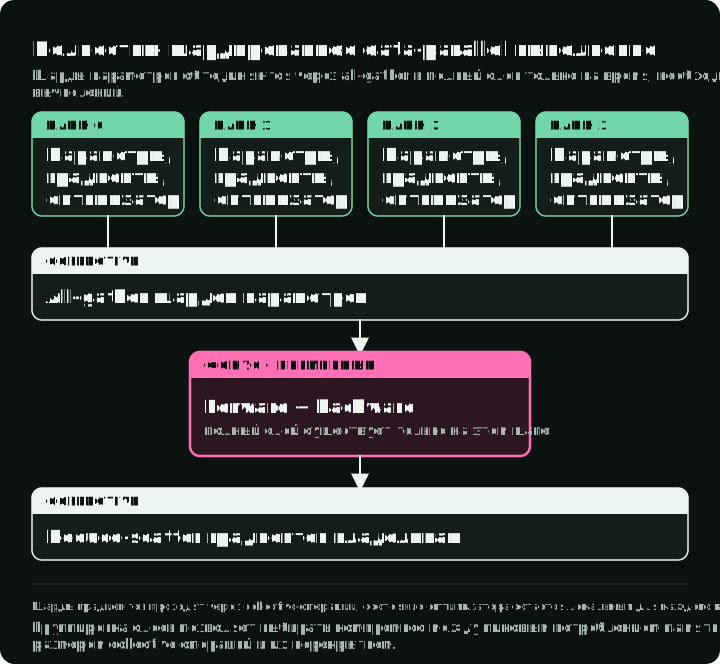
Полностью шардированный параллелизм данных хранит шарды параметров, градиентов и состояния оптимизатора по всей группе. Этот паттерн шардирования состояния описывает статья про ZeRO, а реализует FSDP2 API в PyTorch. Параметры слоя собираются через all-gather для вычисления и после него могут быть снова разбиты на шарды. Градиенты через reduce-scatter возвращаются владельцам. На рисунке один слой прослежен на одном из четырёх рангов в течение шага обучения: ранг хранит четверть весов, градиентов и состояния оптимизатора, all-gather собирает полные веса для прямого прохода и ещё раз для обратного, а reduce-scatter оставляет рангу его четверть градиентов.
По оценке из статьи про ZeRO, стадия 3 передаёт примерно в 1,5 раза больше данных, чем DDP: параметры собираются через all-gather и в прямом, и в обратном проходе, а градиенты проходят reduce-scatter один раз.
Текущая документация PyTorch различает API fully_shard в fully sharded data parallelism версии 2 (FSDP2) и более старую обёртку FullyShardedDataParallel. FSDP2 группирует коммуникацию по модулям, к которым применён fully_shard, и рекомендует применять его снизу вверх, чтобы группы слоёв могли перекрывать коммуникацию и вычисления.
Порядок вызовов — то, в чём легко ошибиться. Этот фрагмент шардирует стек слоёв Transformer с помощью FSDP2:
model = nn.Sequential(*layers).cuda()  # e.g. 24 Transformer layers

for layer in model:  # bottom-up: each layer becomes one communication group
    fully_shard(layer)
fully_shard(model)  # then shard the remaining root parameters

# Build the optimizer after sharding, so it holds the sharded parameters (DTensors).
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
Запускайте по одному процессу на GPU: torchrun --nproc_per_node=8 train.py. Пиковая память на ранг падает по мере роста группы шардирования, потому что каждый ранг хранит меньшую долю весов FP32, градиентов и состояния Adam. Активации не уменьшаются, потому что каждый ранг по-прежнему обрабатывает свой батч. В руководстве по FSDP2 есть полный скрипт со смешанной точностью и чекпоинтингом. У FSDP2 есть также опция reshard_after_forward=False, которая держит параметры собранными между прямым и обратным проходом. Она ведёт себя как ZeRO-2: меньше all-gather, больше памяти.
Шардирование привлекательно, когда состояние модели занимает большую часть памяти, а вычисления слоя могут скрыть достаточно коллективного трафика. Оно может оказаться плохим компромиссом для малых моделей, медленных связей, крошечных слоёв или группы шардирования, которая охватывает несколько узлов по медленной сети. DeepSpeed ZeRO реализует те же стадии с явным выбором стадии и необязательной выгрузкой состояния в память CPU или NVMe.
Тензорный параллелизм
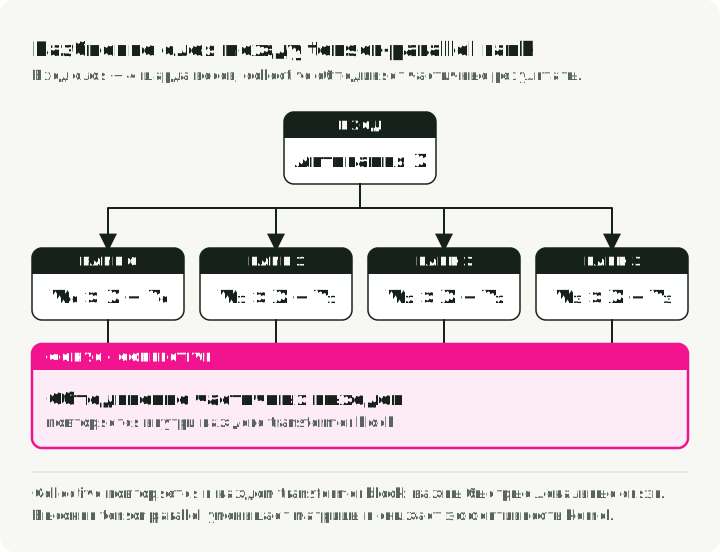
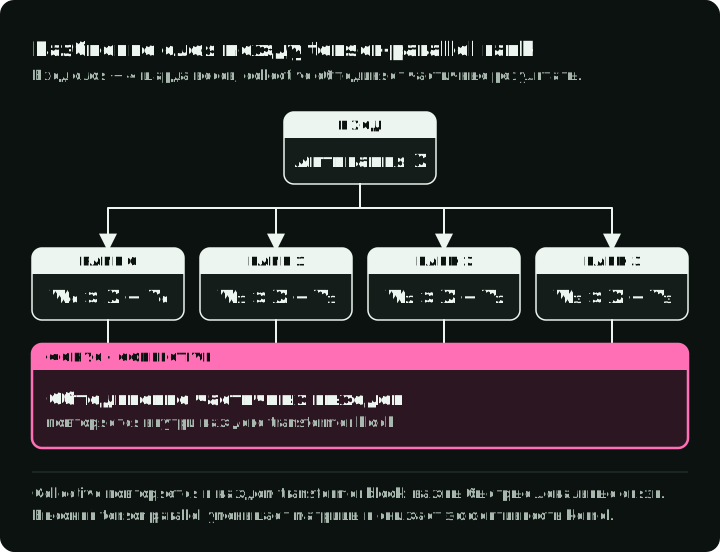
Тензорный параллелизм разбивает линейную алгебру внутри слоя. Примеры: column-parallel и row-parallel проекции. Такое разбиение на уровне слоя описано в руководстве NVIDIA по параллелизму. Частичные результаты требуют коллективных операций внутри блоков transformer, поэтому латентность и пропускная способность сети важны снова и снова в течение всего прямого и обратного прохода.
На рисунке показано разбиение, которое статья про Megatron-LM использует для MLP в Transformer на двух рангах. Первая матрица весов делится по столбцам, поэтому каждый ранг применяет GeLU к своему срезу без коммуникации. Вторая матрица делится по строкам, поэтому каждый ранг получает частичную сумму выхода, и один all-reduce их складывает. Это один all-reduce на MLP в прямом проходе вместо одного на каждое умножение матриц.
Используйте его, когда слой или его активации не помещаются в память либо когда матричные умножения достаточно велики, чтобы разбитые ядра работали быстрее, чем на одном ранге. Привяжите группу тензорного параллелизма к самому быстрому из доступных доменов коммуникации, затем измеряйте. Высокая степень тензорного параллелизма может уменьшить каждую локальную матрицу настолько, что эффективность ядер упадёт, а накладные расходы на коллективные операции вырастут.
Sequence parallelism в стиле Megatron делит вдоль последовательности активации областей LayerNorm и dropout, которые при обычном TP остались бы целиком на каждом ранге группы TP. Он работает внутри группы TP; контекстный параллелизм делит всю последовательность, включая аттеншн, по отдельной группе.
Megatron Core реализует TP и sequence parallelism для обучения. vLLM, SGLang и TensorRT-LLM используют TP, чтобы разделить модель при сервинге.
Конвейерный параллелизм
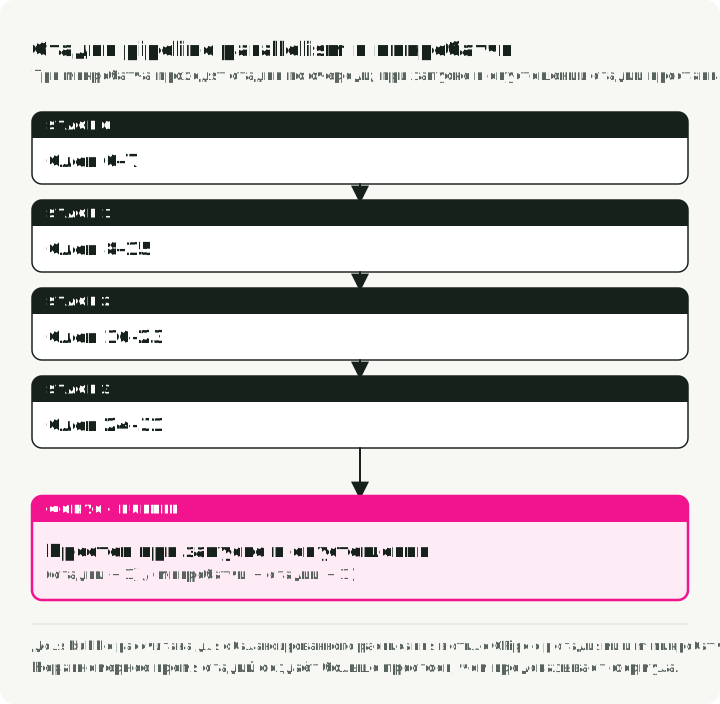
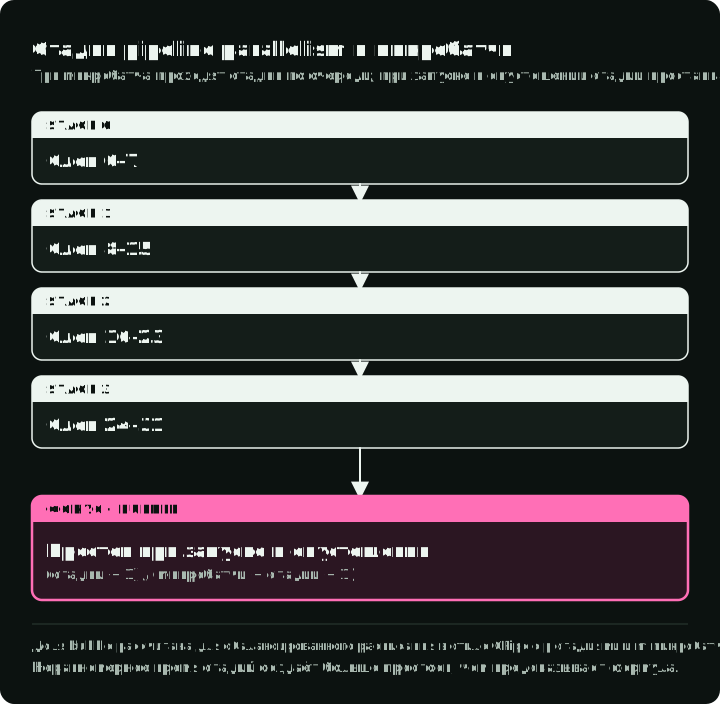
Конвейерный параллелизм размещает разные группы слоёв на разных стадиях и передаёт активации между ними. Микробатчи позволяют стадиям работать одновременно.
Он снижает состояние модели на каждой стадии и может уменьшить объём коммуникации через более медленную границу по сравнению с коллективными операциями тензорного параллелизма на каждом слое. Его цена: пузыри, передача активаций, дисбаланс стадий, более сложное расписание, а также более трудные восстановление и чекпоинтинг.
На рисунке показан прямой проход четырёх стадий и четырёх микробатчей за семь временных шагов, а под ним — доля простоя при большем числе микробатчей. Каждая пустая ячейка — стадия без работы: последние стадии ждут в начале, первые стадии ждут в конце. Для простого сбалансированного расписания в стиле GPipe с p стадиями и m микробатчами идеализированная доля пузыря в прямом проходе приблизительно равна:
(p - 1) / (m + p - 1)При 4 стадиях 4 микробатча оставляют 3/7, около 43%, прямого расписания в простое. 16 микробатчей оставляют 3/19, около 16%, а 32 — 3/35, около 9%. Чем больше микробатчей на глобальный батч, тем меньше пузырь, но каждый из них меньше, и ядра работают менее эффективно; измеряйте оба эффекта.
Реальные расписания могут использовать схему one-forward/one-backward, чередование (interleaving) или варианты zero-bubble, а неравная стоимость слоёв может перевесить формулу. Выбирайте границы стадий по измеренному времени и памяти, а не по равному числу слоёв.
Конвейерные расписания реализуют DeepSpeed, Megatron Core и Nanotron.
Контекстный параллелизм
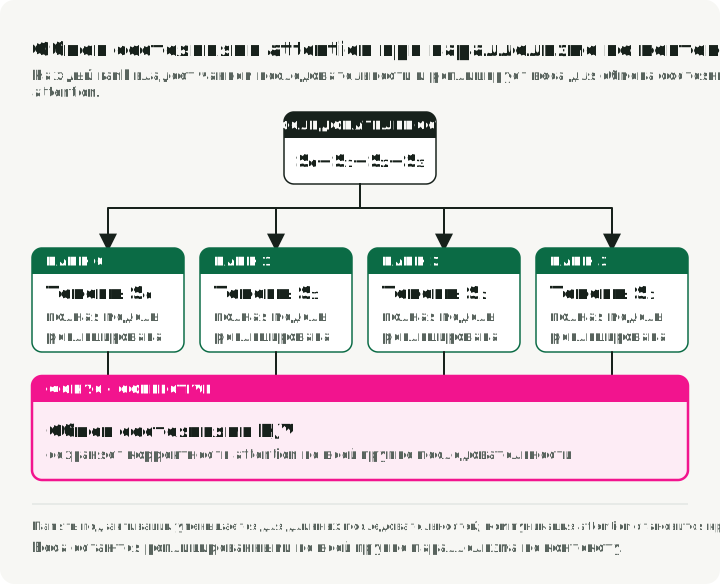
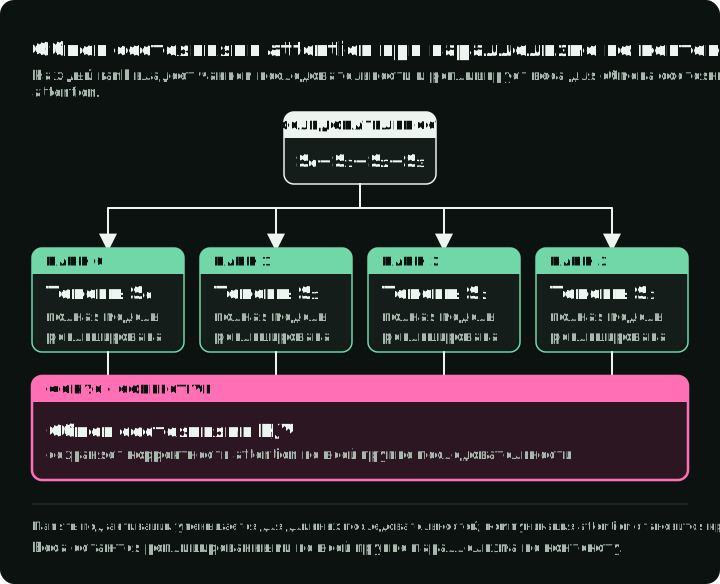
Контекстный параллелизм распределяет измерение последовательности. Документация NVIDIA по контекстному параллелизму описывает разбиение последовательности и обмен key/value, нужный для аттеншн. Каждый ранг владеет шардом последовательности, а аттеншн обменивается информацией, необходимой для сохранения семантики полного контекста. Реализации могут использовать кольца point-to-point, all-gather, all-to-all или иерархические комбинации.
Он снижает память под активации при обучении с длинным контекстом, но реплицирует веса по группе контекста и добавляет коммуникацию для аттеншн. Выигрыш зависит от типа аттеншн, каузальной маски, длины последовательности, перевычисления и того, как группы контекста сочетаются с группами тензорного параллелизма и параллелизма данных.
Не выбирайте его по универсальному порогу в 8K, 32K или 100K. Рассматривайте его, когда при целевой длине последовательности активации всё ещё не помещаются в память после activation checkpointing и тензорного плюс sequence parallelism, а веса уже помещаются.
Megatron Core реализует CP для обучения. В Picotron есть небольшая реализация параллелизма данных, тензорного, конвейерного и контекстного, чтобы разобраться, как они сочетаются.
Экспертный параллелизм для моделей MoE
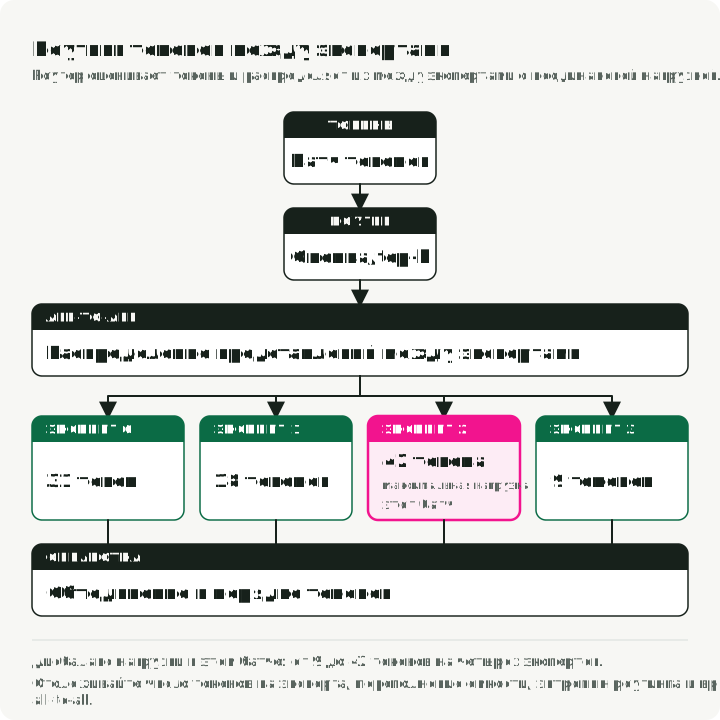
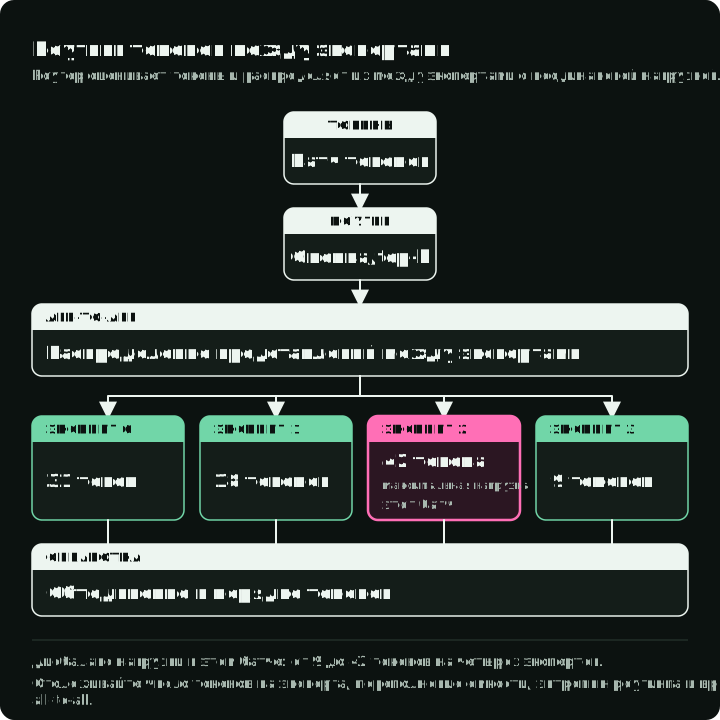
Экспертный параллелизм распределяет экспертов в слоях mixture-of-experts. Например, Mixtral 8x7B хранит около 46,7B параметров, но использует около 12,9B на токен. Такое размещение экспертов и его сочетание с другими измерениями параллелизма описано в руководстве NVIDIA по параллелизму. Роутер отправляет представления токенов выбранным экспертам и объединяет их результаты. Для каждого токена считают только выбранные эксперты, но суммарные веса экспертов всё равно нужно хранить и размещать при сервинге.
Экспертный параллелизм не является настройкой оптимизации для плотной модели. Он часть архитектуры MoE. Его проблемы: баланс нагрузки, лимиты ёмкости, all-to-all по токенам, отброшенные токены, паддинг, вспомогательные функции потерь и перекос при сбоях. Настройки MoE в Megatron различают отбрасывание назначений сверх ёмкости эксперта и заполнение свободных мест ниже неё. Роутинг без отбрасывания обрабатывает переменное число токенов. Отслеживайте токены на эксперта, энтропию роутинга, переполнение ёмкости, время коммуникации и качество по маршрутам.
Megatron Core и Nanotron реализуют EP для обучения.
Как собрать схему из топологии
Системы обучения больших плотных моделей без группы экспертного параллелизма обычно используют произведение размеров групп параллелизма данных (DP), тензорного (TP), конвейерного (PP) и контекстного (CP) параллелизма:
world size = DP × TP × PP × CPКогда экспертный параллелизм (EP) — независимая группа, руководство NVIDIA по параллелизму считает общее число так:
total GPUs = TP × PP × CP × EP × DPПрежде чем выбирать степени, проверьте, какие порядки и размеры групп поддерживает ваш фреймворк.
Собирайте схему в таком порядке:
- Нарисуйте домены коммуникации: связи между GPU, коммутаторы, границы non-uniform memory access (NUMA), сетевую фабрику узлов, oversubscription и путь к хранилищу. На большинстве GPU-серверов самый быстрый домен — NVLink между GPU одного узла; узлы соединяются более медленной сетью, например InfiniBand.
- Размещайте частые, чувствительные к латентности коллективные операции, обычно TP, в самом быстром подходящем домене. Обычно это значит держать каждую группу TP внутри одного узла.
- Выберите группы FSDP или реплицированного DP по оставшейся ёмкости и пропускной способности.
- Добавляйте PP, когда это помогает размещению по глубине или трафику между доменами, балансируя измеренное время и память стадий.
- Добавляйте CP только из-за ограничения по последовательности, а EP только под топологию экспертов модели.
- Для пробной схемы проверьте делимость голов, скрытых измерений, слоёв, экспертов, батча и последовательности.
- Прогоните бенчмарки на нескольких допустимых схемах. Эвристики с учётом топологии выбирают кандидатов, а не победителей.
Пример кандидата для плотной модели 70B с контекстом 32K на 64 узлах по 8 GPU: TP=8 внутри каждого узла по NVLink, PP=4 между узлами, CP=4 для длинной последовательности и DP=4 для остального; 8 × 4 × 4 × 4 = 512 GPU. Прежде чем выбирать, сравните его в бенчмарке с TP=8, PP=8, CP=2, DP=4.
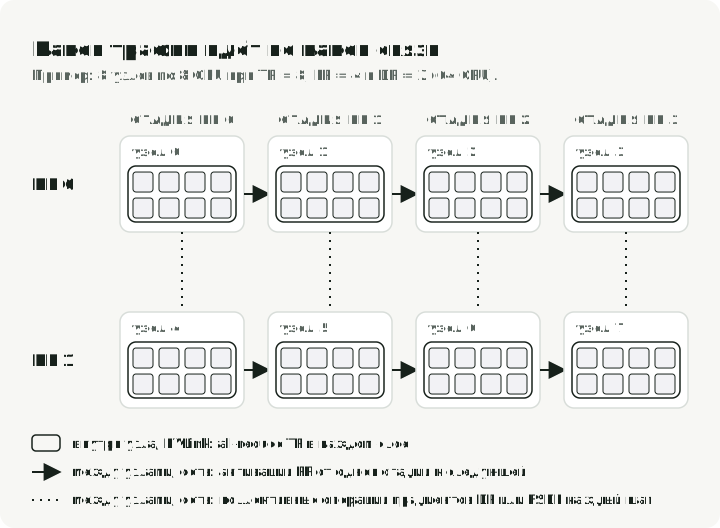
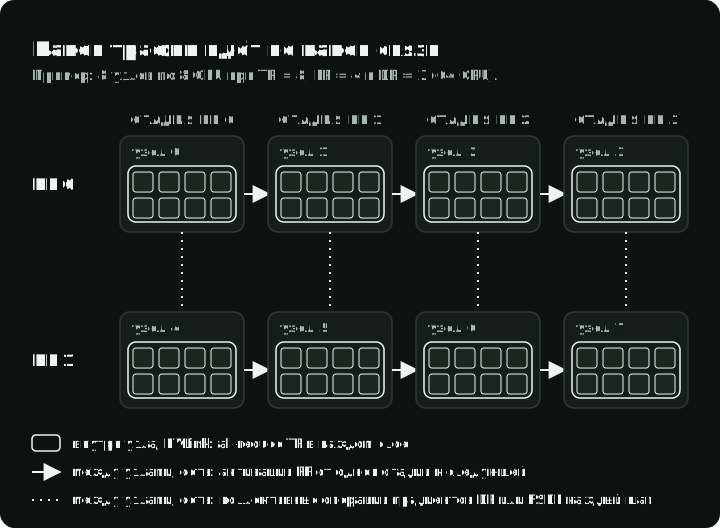
На рисунке видно, куда идёт трафик каждой группы в такой схеме: all-reduce TP остаётся на NVLink внутри узла, а коллективные операции градиентов FSDP или DP и активации PP идут по сети между узлами.
Начальные кандидаты по размеру кластера: их стоит прогнать в бенчмарке, а не принимать как есть:
- Один узел, 2–8 GPU. DDP, когда полная обучающая реплика помещается с запасом; FSDP2 или DeepSpeed ZeRO-2/3, когда состояние модели нужно шардировать. Запускайте через
torchrunили Accelerate. Добавляйте TP=2, только если один слой или его активации всё ещё не помещаются. На GPU, соединённых по PCIe без NVLink, держите TP равным 1 или 2, потому что all-reduce каждого слоя идёт через PCIe. - 2–16 узлов. TP внутри каждого узла (4 или 8 с NVLink), FSDP или DP между узлами, а PP между узлами только если модель всё ещё не помещается.
- Сотни GPU и больше. TP × PP × CP × DP, как в примере выше, с фреймворком, который реализует все четыре, например Megatron Core.
Два кластера с одинаковым числом GPU могут предпочитать разные схемы, потому что пропускная способность связей, иерархия коммутаторов, подключение CPU и конкуренция за сеть у них различаются.
Какой фреймворк реализует какое разбиение
Эти разбиения реализует небольшой набор библиотек. Выбирайте по нужным разбиениям и по тому, какую часть обучающего цикла вы хотите вести сами.
| Инструмент | Какие разбиения поддерживает | Когда использовать |
|---|---|---|
| Hugging Face Accelerate | запускает DDP, FSDP или DeepSpeed из файла настроек | нужно запустить готовый скрипт на PyTorch или Transformers на нескольких GPU с минимумом правок кода |
| PyTorch DDP и FSDP2 | DDP, FSDP (fully_shard), с torchrun | вы обучаете плотную модель на одном или нескольких узлах и хотите обычный PyTorch |
| DeepSpeed ZeRO | стадии ZeRO 1, 2, 3, выгрузка в CPU и NVMe, PP | нужно выбирать стадию шардирования или выгружать состояние в память CPU или NVMe |
| Megatron Core | TP, PP, CP, EP, DP и sequence parallelism | нужны TP, PP и CP (и EP) вместе для больших запусков претрейнинга |
| Nanotron | DP, TP, PP, EP, ZeRO-1 | нужна кодовая база меньше, чем у Megatron, для 3D-параллелизма и MoE |
| vLLM, SGLang, TensorRT-LLM | TP и PP для инференса | вы обслуживаете модель; см. раздел о сервинге ниже |
Чтобы запустить готовый скрипт с FSDP2 через Accelerate, один раз выполните accelerate config; он интерактивно запишет файл настроек. Эти настройки выбирают FSDP2, группировку по слоям декодера и повторное шардирование:
fsdp_config:
    fsdp_version: 2
    fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP
    fsdp_transformer_layer_cls_to_wrap: LlamaDecoderLayer
    fsdp_reshard_after_forward: true
При fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP настройка fsdp_transformer_layer_cls_to_wrap задаёт класс блока, который становится одной единицей FSDP: это та же группировка снизу вверх, что и в цикле fully_shard выше. fsdp_reshard_after_forward: true означает полное шардирование; false — режим, похожий на ZeRO-2. Запустите задачу командой accelerate launch --config_file fsdp2.yaml train.py. Руководство по FSDP1/FSDP2 объясняет эти настройки для разных версий и команду accelerate to-fsdp2, которая преобразует старый конфиг FSDP1.
Обучение и сервинг требуют отдельных решений
Инференсу обычно не нужны градиенты и состояние оптимизатора, поэтому схемы обучения в стиле FSDP не переносятся автоматически.
Префилл обрабатывает промпт и сохраняет ключи и значения его токенов в KV cache. Декодирование генерирует следующие токены, повторно используя и расширяя этот кэш.
Для сервинга спрашивайте:
- Помещаются ли в одну реплику веса, KV cache, рабочая область и целевая параллельная нагрузка?
- Что лучше для пропускной способности: больше независимых реплик или шардирование одной реплики?
- Снижает ли TP нагрузку на веса и кэш на ранг настолько, чтобы оправдать коммуникацию на каждом слое?
- Эффективно ли PP поддерживается для этой модели и планировщика запросов?
- Чем префилл и декодирование по-разному нагружают вычисления, пропускную способность памяти и межсоединение?
- Что происходит с хвостовой латентностью, когда у запросов разная длина промпта и ответа?
Для первого вопроса используйте формулу KV cache из раздела о памяти. Если одна реплика помещается с запасом под KV cache при вашей целевой нагрузке, запускайте больше реплик: им не нужна коммуникация между GPU. Если не помещается, сначала шардируйте её с помощью TP внутри одного узла, а PP между узлами добавляйте, только когда одного узла не хватает. В vLLM это --tensor-parallel-size и --pipeline-parallel-size; в SGLang и TensorRT-LLM есть те же две настройки.
Делайте бенчмарк полного сервера вместе с планировщиком, квантизацией, распределением контекста, политикой батчинга и формой трафика. Токены в секунду при обучении не предскажут ни время до первого токена, ни латентность между токенами при сервинге.
Что записывать для каждой пробной схемы
Для каждого кандидата записывайте:
- модель, код, рантайм, ядра и топологию
- глобальный и локальный батч, распределение последовательностей и число токенов
- пиковую память по категориям, где это возможно
- полезные токены в секунду и утилизацию модельных операций с плавающей точкой (FLOP), если она считается последовательно
- время в all-reduce, all-gather, reduce-scatter, all-to-all и point-to-point, не перекрытое вычислениями
- простои из-за входных данных, время чекпоинта, поведение при перезапуске и распределение отстающих (stragglers)
- значение функции потерь при обучении или совпадение выхода при сервинге с базовой схемой
Сравнивайте слабое и сильное масштабирование осознанно. Сильное масштабирование (strong scaling) сохраняет общий объём работы при росте числа рангов. Слабое масштабирование (weak scaling) сохраняет объём работы на ранг, поэтому общий объём растёт вместе с числом рангов. Процент «эффективности масштабирования» ничего не значит без такого знаменателя и базовой точки.
Заключение
Параллелизм — это отображение измеренного боттлнека на измерение тензора и паттерн коммуникации. Репликация, шардирование, разбиение по слоям, стадии, разбиение последовательности и маршрутизация экспертов снимают разные ограничения и создают разные виды сбоев.
Составьте инвентарь нагрузки, нарисуйте топологию, сгенерируйте допустимые схемы и профилируйте их. Лучшая схема — та, что помещается с запасом и минимизирует не перекрытую коммуникацию для вашей задачи.
Источники
- Документация PyTorch FSDP2
fully_shard- Шардирование параметров на уровне модулей, all-gather, reduce-scatter и поведение DTensor. - Документация PyTorch DistributedDataParallel - Обучение реплицированной модели с синхронизацией градиентов.
- Документация PyTorch
torchrun- Запуск одного процесса на GPU с переменными окружения для рангов. - NVIDIA Megatron Core: стратегии параллелизма - Измерения параллелизма данных, тензорного, конвейерного, контекстного, экспертного и полностью шардированного.
- Hugging Face Ultra-Scale Playbook - Интерактивный обзор параллелизма моделей в большом масштабе.
- Шпаргалка Ultra-Scale Playbook - Краткое изложение playbook на одной странице.
- Руководство Hugging Face Accelerate по FSDP - Ключи конфигурации и команды запуска для FSDP.
- Руководство по DeepSpeed ZeRO - Стадии ZeRO и настройка выгрузки.
- Статья про DeepSpeed ZeRO - Шардирование состояний оптимизатора, градиентов и параметров для снижения расхода памяти.
- Статья про Megatron-LM - Column- и row-parallel слои Transformer.
- Reducing Activation Recomputation in Large Transformer Models - Sequence parallelism в Megatron.
- Статья про GPipe - Конвейерное обучение с микробатчами и поэтапным выполнением.
- vLLM: параллелизм и масштабирование - Настройки тензорного и конвейерного параллелизма при сервинге.
- Mixtral of experts - Общее и активное число параметров Mixtral 8x7B.
- Документация NERSC по параллелизму - Определения сильного и слабого масштабирования через фиксированный общий объём работы или объём на ранг.