LLMs schalen met multi-GPU- en multi-node-parallellisme

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
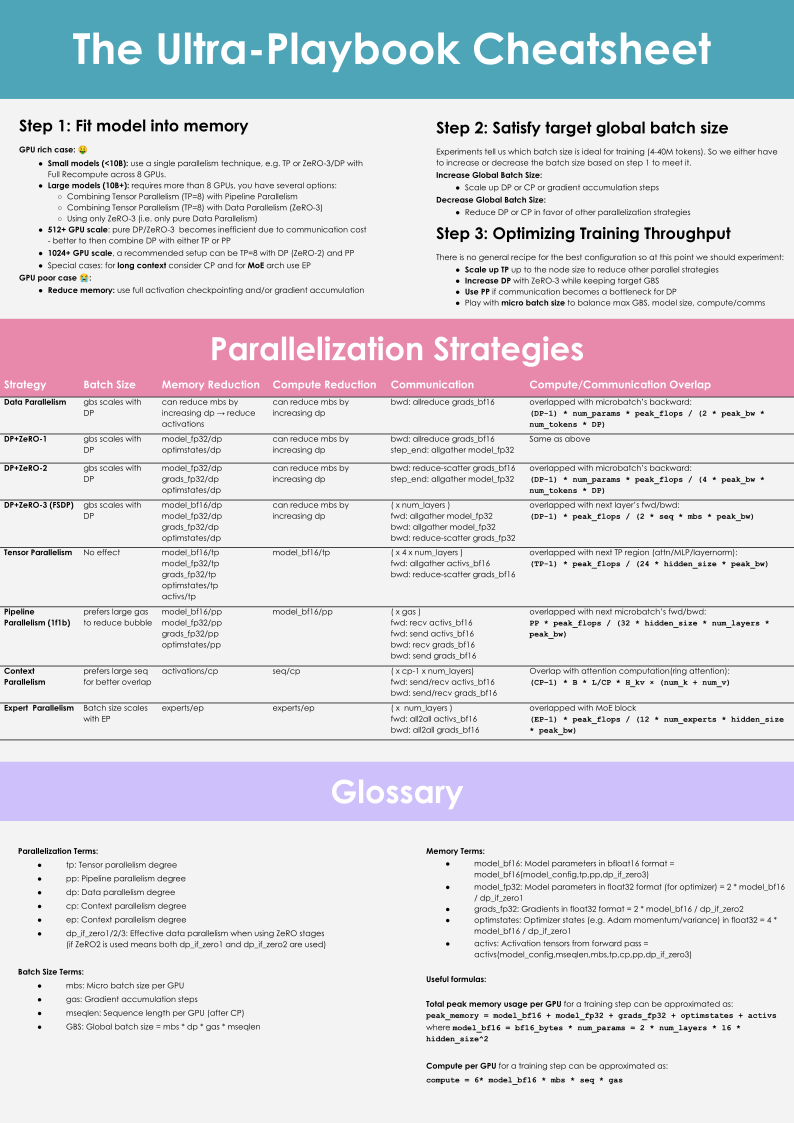
Je leest wat elke splitsing bespaart, wat ze communiceert, welk framework ze implementeert en hoe je een eerste kandidaat-mesh voor je cluster opzet. Dit artikel is bedoeld voor engineers die backpropagation, Transformer-lagen en een PyTorch-trainingsloop kennen en nu meer dan één GPU nodig hebben om een model te trainen of te serven. Het geeft een praktisch overzicht van de belangrijkste parallellismestrategieën, hun beperkingen en de tools die ze implementeren, op basis van de Ultra-Scale Playbook van Hugging Face.
Workloads met grote models groeien om verschillende redenen uit één GPU. Een trainingsjob kan geen geheugen meer hebben door de optimizer state, een andere door de activations van lange sequenties. Een model dat past, kan toch het throughput-doel missen. Elk probleem vraagt om een andere partitie en een ander communicatiepatroon.
Geheugenbudgetten voor training en inference
Training en inference hebben niet dezelfde footprint.
training peak ≈ parameters
              + gradients
              + optimizer state
              + saved activations
              + temporary buffers
              + communication buffers
              + allocator headroom

inference peak ≈ resident weights
               + key/value (KV) cache
               + runtime workspace
               + communication buffers
               + allocator headroom
Een model met 70 miljard parameters heeft alleen al voor BF16-weights een decimale ondergrens van 140 GB. Training vraagt veel meer. Het ZeRO-paper telt voor Adam met FP16 mixed precision ongeveer 16 bytes modelstatus per parameter: 2 voor FP16-weights, 2 voor FP16-gradients en 12 voor de FP32-masterweights en de twee Adam-momenten. Voor 70B parameters is dat ongeveer 1.120 GB, vóór activations. De tabel en grafiek hieronder gebruiken deze verdeling; de werkelijke tensorprecisie en het beleid voor masterweights kunnen verschillen.
Gerepliceerd data-parallellisme (DDP) houdt al die status op elke GPU. Sharding verdeelt haar over de GPUs van een groep in plaats van haar te kopiëren. Het ZeRO-paper definieert drie stages: stage 1 shardt de optimizer state, stage 2 shardt ook de gradients en stage 3 shardt ook de parameters. Stage 3 noemt PyTorch fully sharded data parallelism (FSDP). Voor Ψ parameters op N GPUs:
model state per GPU (ZeRO paper's FP16 mixed-precision Adam)
DDP      16Ψ
ZeRO-1   4Ψ + 12Ψ / N
ZeRO-2   2Ψ + 14Ψ / N
ZeRO-3   16Ψ / N
Verdeeld over 64 GPUs heeft het 70B-model ongeveer 293 GB per GPU nodig met ZeRO-1, ongeveer 155 GB met ZeRO-2 en ongeveer 17,5 GB met ZeRO-3 of FSDP.
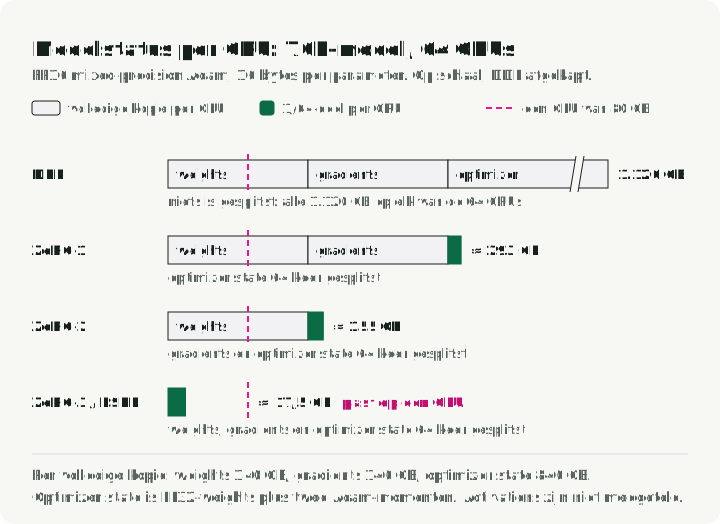
De grafiek splitst elk van die vier getallen in het deel dat elke GPU kopieert en het deel dat ze met 63 andere deelt, naast het geheugen van één GPU van 80 GB: alleen volledige sharding brengt de modelstatus eronder, en de resterende ruimte gaat naar activations en buffers.
Inference heeft geen gradients of optimizer state, maar voegt de KV cache toe, die groeit met elk token dat de server in het geheugen houdt:
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valueDe 2 staat voor keys en values. Voor Llama 3.1 70B in BF16 (80 lagen, 8 KV-heads, head dimension 128) is dat ongeveer 0,33 MB per token, dus één sequentie van 32.768 tokens gebruikt ongeveer 10,7 GB cache. Vermenigvuldig met het aantal gelijktijdige sequenties om een server te dimensioneren. Cachebeleid, sequentielengte, concurrency en quantization veranderen dit getal.
Geheugenwinst is geen vaste vermenigvuldiger. De getallen hierboven laten activations, tijdelijke buffers, communicatiebuffers en allocator-headroom buiten beschouwing. De werkelijke winst hangt af van de shardinggraad, wat gerepliceerd blijft, tijdelijke niet-gesharde status, het activationbeleid, padding, onbalans en buffers.
Profileer de exacte architectuur, precisie, sequentielengte, micro-batch, optimizer, checkpointing-beleid en runtime. Leg het piekgeheugen (allocated en reserved) vast, de tokens per seconde, de tijd in kernels en de tijd die zichtbaar blijft in collectives. torch.cuda.max_memory_allocated() en torch.cuda.max_memory_reserved() geven de twee pieken; de PyTorch-profiler of Nsight Systems toont de kerneltijd en hoeveel NCCL-tijd niet met compute overlapt.
Hoe ranks communiceren
Een rank is één trainingsproces, meestal dat één GPU aanstuurt. Ranks wisselen tensors uit via collectives en point-to-point-operaties, die de NCCL-bibliotheek op NVIDIA-GPUs implementeert. Vijf komen in dit artikel voor; de reductievoorbeelden gebruiken sommen:
- All-reduce: elke rank krijgt de som van de tensors van alle ranks.
- All-gather: elke rank krijgt de shard van elke rank.
- Reduce-scatter: elke rank krijgt de som van één shard.
- All-to-all: elke rank stuurt een ander stuk naar elke andere rank.
- Point-to-point: één rank stuurt een tensor naar één andere rank.
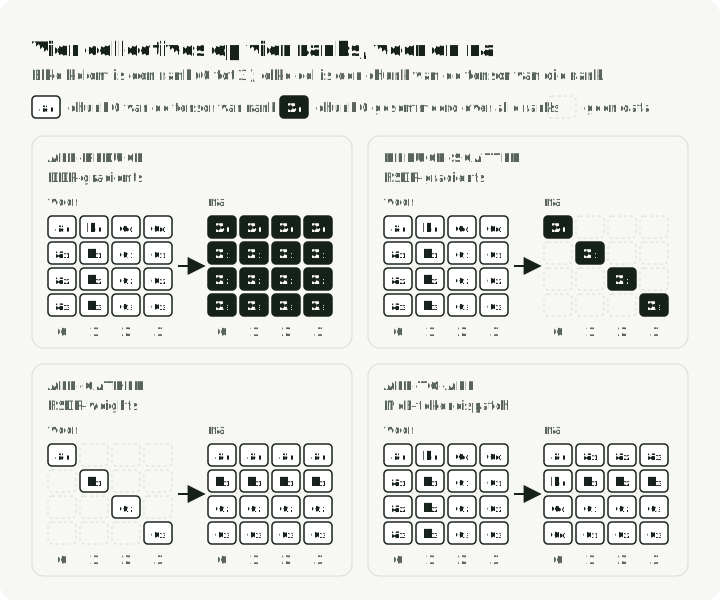
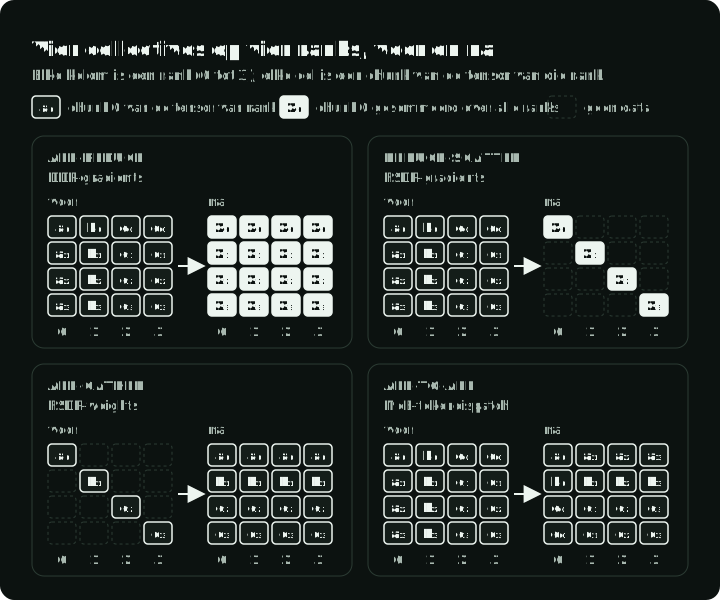
De figuur toont vier ranks vóór en na elk van de eerste vier operaties, met één kolom per rank en één cel per chunk van haar tensor. Vergelijk all-reduce met reduce-scatter: beide sommeren over ranks, maar reduce-scatter laat elke rank alleen haar eigen shard van de som houden.
Wat elke strategie splitst en communiceert
Vraag bij elke strategie welke tensordimensie wordt gesplitst, welke status gerepliceerd blijft en welke collective op het kritieke pad komt.
| Strategie | Splitst | Belangrijkste verlichting | Geïntroduceerde communicatie |
|---|---|---|---|
| Gerepliceerd data-parallellisme (DDP) | batch | trainingsthroughput | gradient-all-reduce |
| Fully sharded data parallelism (FSDP) | parameters, gradients, optimizer state over een data-parallel-groep (DP) | geheugen voor modelstatus | parameter-all-gather, gradient-reduce-scatter |
| Tensor-parallellisme (TP) | matrix- of attention-dimensies binnen lagen | weights en activations van lagen | collectives binnen transformer-blokken |
| Pipeline-parallellisme (PP) | groepen lagen | modeldiepte en status per stage | point-to-point-activations plus scheduling-bubbles |
| Context-parallellisme (CP) | sequentiedimensie | activation-geheugen bij lange sequenties | key/value- of attention-uitwisseling over de sequentiegroep |
| Expert-parallellisme (EP) | MoE-experts en gerouteerde tokens | expertcapaciteit per rank | token-dispatch en -combine, meestal all-to-all |
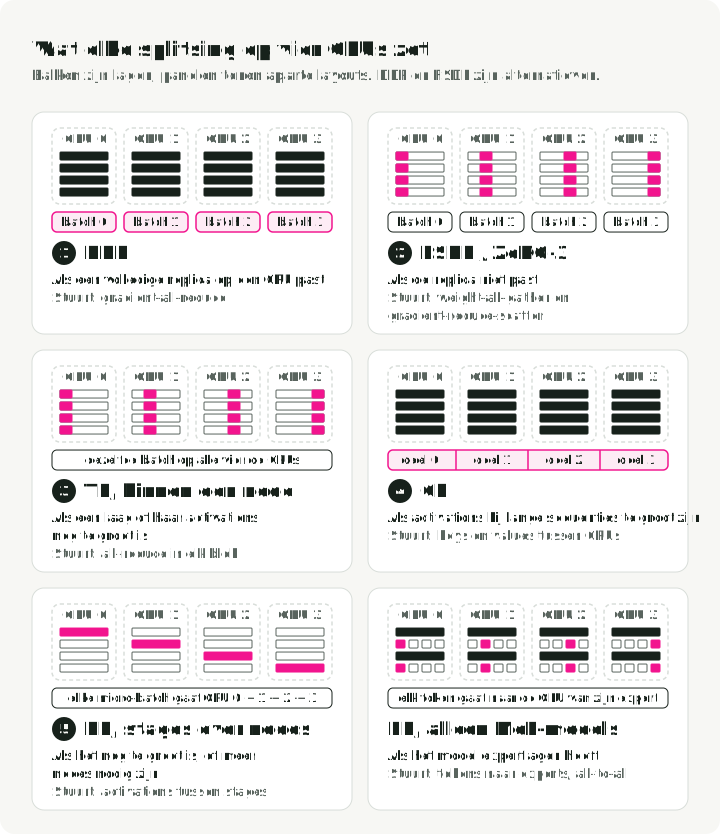
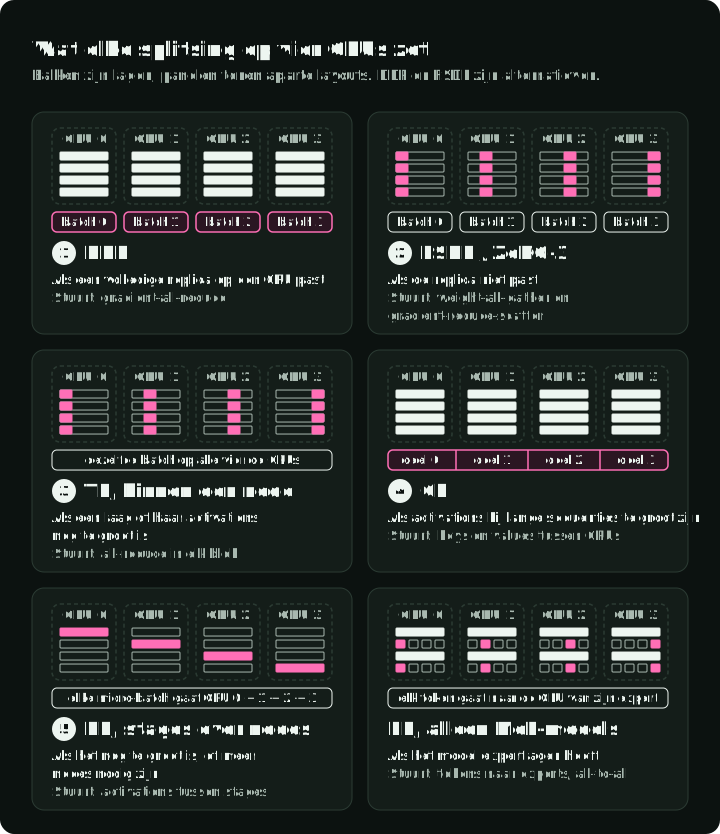
De figuur toont zes afzonderlijke layouts op vier GPUs. Kies DDP als een volledige trainingsreplica met voldoende marge past, of FSDP/ZeRO als de modelstatus moet worden geshard. Voeg andere splitsingen alleen toe voor de beperkingen die ze oplossen; de panelen tonen die combinaties niet. De secties hieronder leggen elke splitsing uit.
Data-parallellisme (DDP)
Gerepliceerd data-parallellisme, meestal distributed data parallel genoemd, houdt een volledige trainingsreplica op elke rank. De documentatie van PyTorch DistributedDataParallel beschrijft dit model van replica’s met gradientsynchronisatie. Elke rank verwerkt een andere micro-batch en de gradients worden gesynchroniseerd vóór de optimizer-stap.
Gebruik het als de volledige trainingsstatus met ruimte te over past. Elke nieuwe rank voegt haar micro-batch toe aan de globale batch, dus je trainingsrecept moet een grotere globale batch verdragen, of je verlaagt de gradient accumulation om hem constant te houden. De belangrijkste voordelen zijn eenvoudige semantiek en een volwassen implementatie die backward-berekening laat overlappen met gebundelde gradient-reductie.
Meer ranks toevoegen kan schaden als de lokale batch te klein wordt. Het kan ook schaden als het netwerk de all-reduce niet kan verbergen of als de invoer stokt. Grotere globale batches kunnen steeds minder tijdwinst tot een doelloss opleveren terwijl ze meer compute verbruiken. Vergelijk loss en verstreken tijd voor je trainingsrecept.
De figuur toont één trainingsstap op één rank. Buckets met gradients worden all-reduced terwijl backward draait, en de GPU wacht alleen op het deel van de all-reduce dat het netwerk niet kan verbergen.
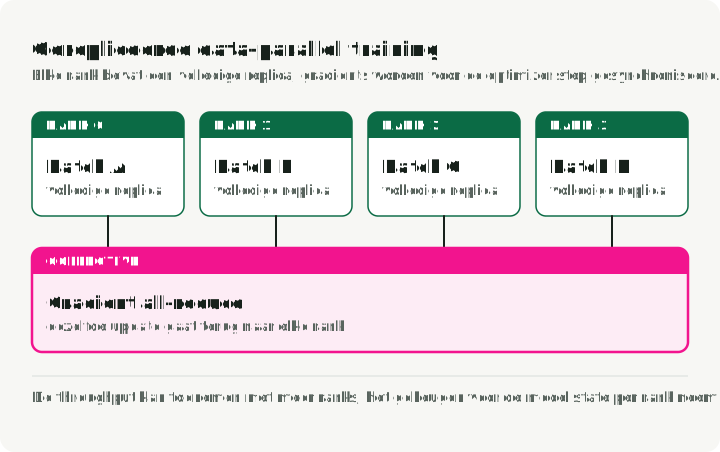
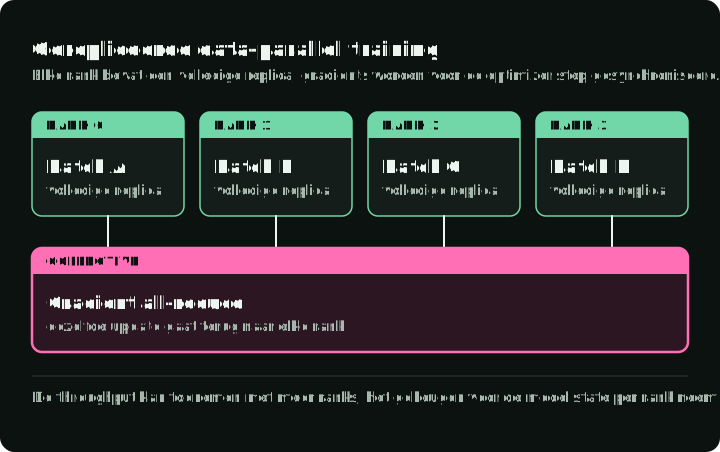
In PyTorch wikkel je het model in DistributedDataParallel en start je één proces per GPU met torchrun, dat RANK, LOCAL_RANK en WORLD_SIZE voor elk proces instelt. Hugging Face Accelerate start dezelfde opzet vanuit een configbestand.
Fully sharded data parallelism (FSDP, ZeRO)
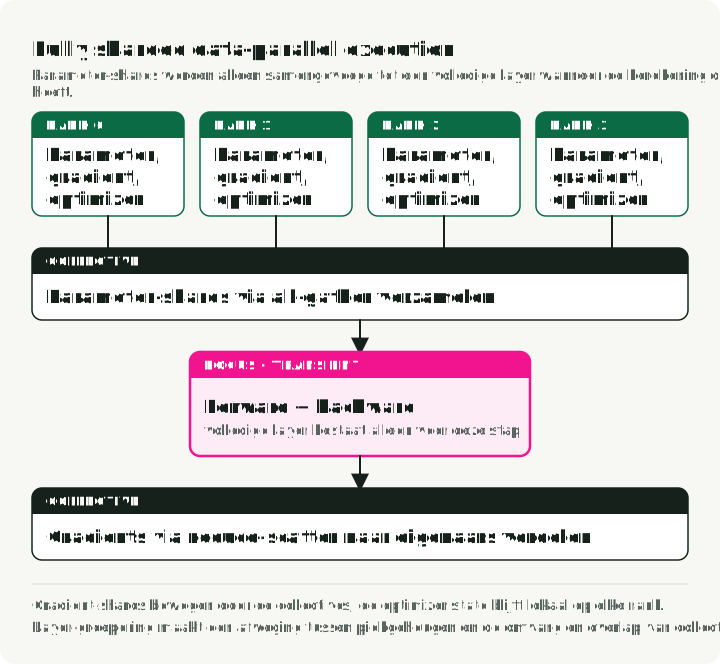
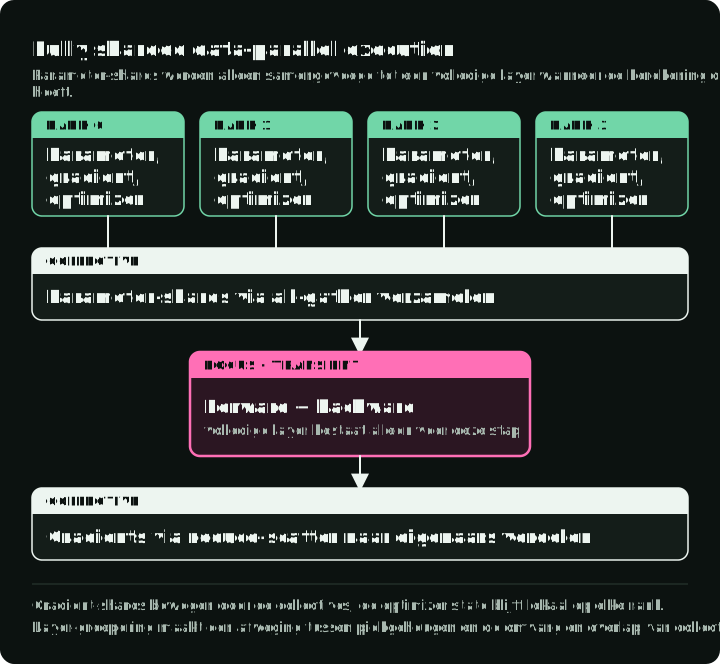
Fully sharded data parallelism slaat shards van parameters, gradients en optimizer state over een groep op. Het ZeRO-paper beschrijft dit patroon van status-sharding en de FSDP2-API van PyTorch implementeert het. De parameters van een laag worden voor de berekening all-gathered en kunnen daarna weer worden geshard. Gradients worden via reduce-scatter teruggestuurd naar hun eigenaars. De figuur volgt één laag op één van vier ranks door een trainingsstap: de rank slaat een kwart van de weights, gradients en optimizer state op, een all-gather bouwt de volledige weights op voor de forward-pass en nogmaals voor de backward-pass, en de reduce-scatter laat de rank haar kwart van de gradients houden.
Het ZeRO-paper schat de kosten van stage 3 op ongeveer 1,5 keer het communicatievolume van DDP: parameters worden zowel in de forward- als in de backward-pass all-gathered en gradients worden één keer reduce-scattered.
De huidige PyTorch-documentatie maakt onderscheid tussen de fully_shard-API in fully sharded data parallelism versie 2 (FSDP2) en de oudere FullyShardedDataParallel-wrapper. FSDP2 groepeert communicatie per module waarop fully_shard is toegepast en raadt aan het bottom-up toe te passen, zodat groepen lagen communicatie en berekening kunnen overlappen.
De volgorde van de aanroepen is het deel dat makkelijk misgaat. Dit fragment shardt een stapel Transformer-lagen met FSDP2:
model = nn.Sequential(*layers).cuda()  # e.g. 24 Transformer layers

for layer in model:  # bottom-up: each layer becomes one communication group
    fully_shard(layer)
fully_shard(model)  # then shard the remaining root parameters

# Build the optimizer after sharding, so it holds the sharded parameters (DTensors).
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
Start één proces per GPU met torchrun --nproc_per_node=8 train.py. Het piekgeheugen per rank daalt naarmate de shardgroep groeit, omdat elke rank een kleiner deel van de FP32-weights, gradients en Adam-status bewaart. Activations worden niet kleiner, want elke rank verwerkt nog steeds haar eigen batch. De FSDP2-tutorial bevat een compleet script met mixed precision en checkpointing. FSDP2 heeft ook een optie reshard_after_forward=False, die parameters tussen de forward- en backward-pass verzameld houdt. Dat werkt als ZeRO-2: minder all-gathers, meer geheugen.
Sharding is aantrekkelijk als de modelstatus het grootste deel van het geheugen is en de laagberekening genoeg collective-verkeer kan verbergen. Het kan een slechte ruil zijn voor kleine models, trage verbindingen, piepkleine lagen of een shardgroep die nodes overspant via een traag netwerk. DeepSpeed ZeRO implementeert dezelfde stages met expliciete stagekeuze en optionele offload van status naar CPU- of NVMe-geheugen.
Tensor-parallellisme
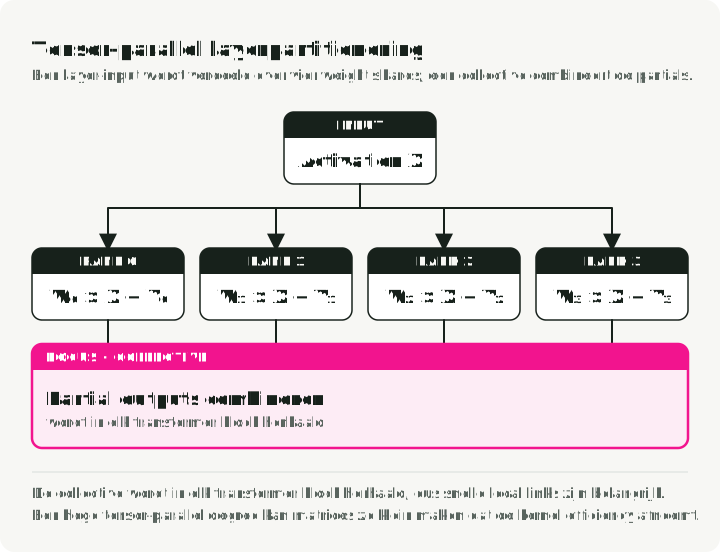
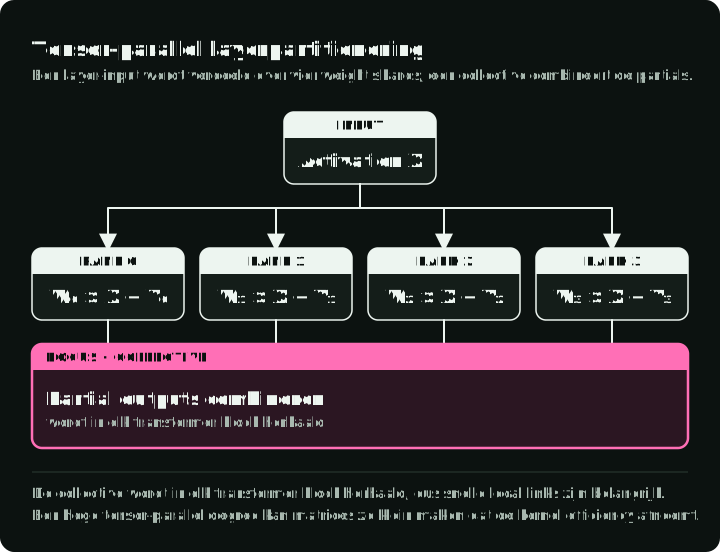
Tensor-parallellisme partitioneert lineaire algebra binnen een laag. Voorbeelden zijn column-parallel en row-parallel projecties. De parallellismegids van NVIDIA beschrijft deze splitsing op laagniveau. Deelresultaten vragen om collectives binnen transformer-blokken, dus latency en bandbreedte tellen telkens opnieuw in de hele forward- en backward-pass.
De figuur toont de splitsing die het Megatron-LM-paper gebruikt voor een Transformer-MLP op twee ranks. De eerste weight-matrix wordt op kolommen gesplitst, dus elke rank past GeLU toe op haar eigen deel zonder communicatie. De tweede matrix wordt op rijen gesplitst, dus elke rank levert een deelsom van de uitvoer en één all-reduce telt ze op. Dat is één all-reduce per MLP in de forward-pass in plaats van één per matrixvermenigvuldiging.
Gebruik het als een laag of zijn activations niet passen, of als de matmuls groot genoeg zijn om met gepartitioneerde kernels beter te presteren dan op één rank. Wijs de tensor-parallelle groep toe aan het snelste beschikbare communicatiedomein en meet dan. Een hoge tensor-parallelle graad kan elke lokale matrix zo ver verkleinen dat de kernel-efficiëntie daalt terwijl de collective-overhead groeit.
Sequence parallelism in Megatron-stijl (paper) splitst de activations van de LayerNorm- en dropout-regio’s langs de sequentie. Gewone TP zou die activations volledig op elke rank van de TP-groep houden. Het werkt binnen de TP-groep; context-parallellisme splitst de hele sequentie, inclusief attention, over een aparte groep.
Megatron Core implementeert TP en sequence parallelism voor training. vLLM, SGLang en TensorRT-LLM gebruiken TP om een model voor serving te shardden.
Pipeline-parallellisme
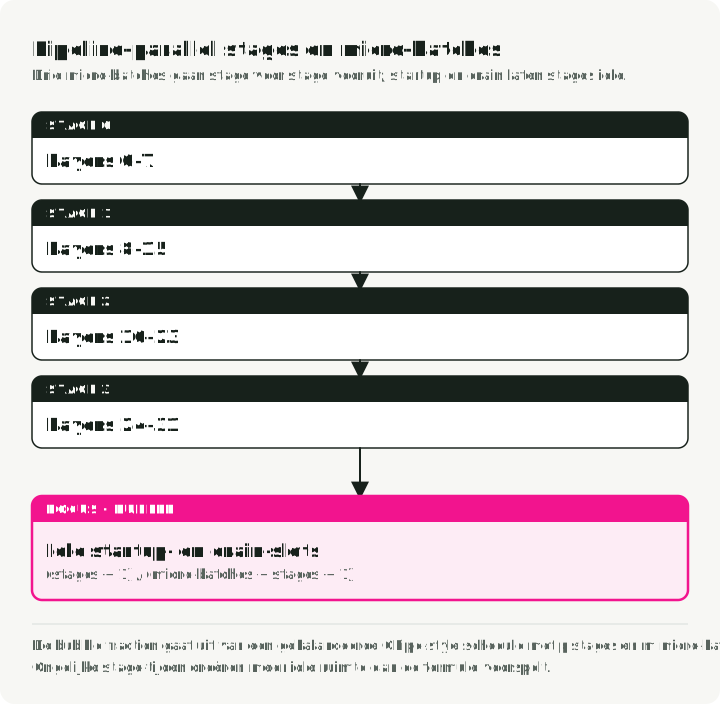
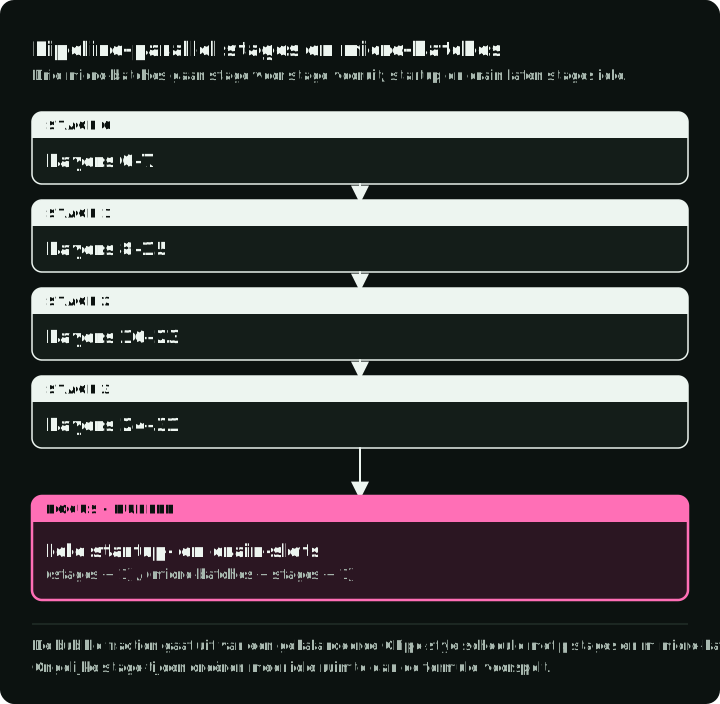
Pipeline-parallellisme plaatst verschillende groepen lagen op verschillende stages en stuurt activations ertussen door. Micro-batches houden de stages gelijktijdig aan het werk.
Het ontlast de modelstatus per stage en kan het communicatievolume over een tragere grens verkleinen vergeleken met tensor-collectives per laag. De kosten zijn bubbles, activation-overdracht, onbalans tussen stages, ingewikkelder scheduling en moeilijker herstel en checkpointing.
De figuur toont de forward-pass van vier stages en vier micro-batches over zeven tijdstappen, en daaronder het lege aandeel bij meer micro-batches. Elke lege cel is een stage zonder werk: de laatste stages wachten aan het begin en de eerste stages wachten aan het einde. Voor een eenvoudig, gebalanceerd schema in GPipe-stijl met p stages en m micro-batches is de geïdealiseerde forward-bubblefractie ongeveer:
(p - 1) / (m + p - 1)Bij 4 stages laten 4 micro-batches 3/7, ongeveer 43%, van het forward-schema leeg. 16 micro-batches laten 3/19 leeg, ongeveer 16%, en 32 laten 3/35 leeg, ongeveer 9%. Meer micro-batches per globale batch verkleinen de bubble, maar elk wordt kleiner, waardoor kernels minder efficiënt draaien; meet beide.
Echte schema’s gebruiken soms one-forward/one-backward, interleaving of zero-bubble-varianten, en ongelijke laagkosten kunnen de formule overheersen. Kies stagegrenzen op basis van gemeten tijd en geheugen, niet op basis van een gelijk aantal lagen.
DeepSpeed, Megatron Core en Nanotron implementeren pipeline-schema’s.
Context-parallellisme
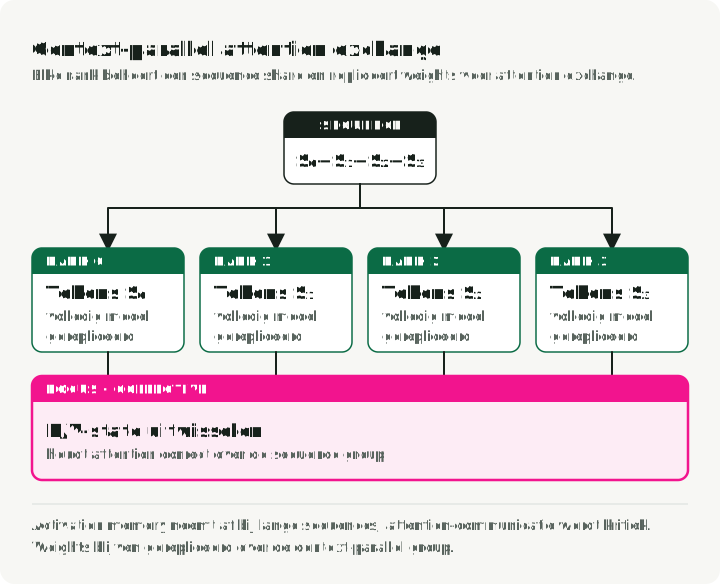
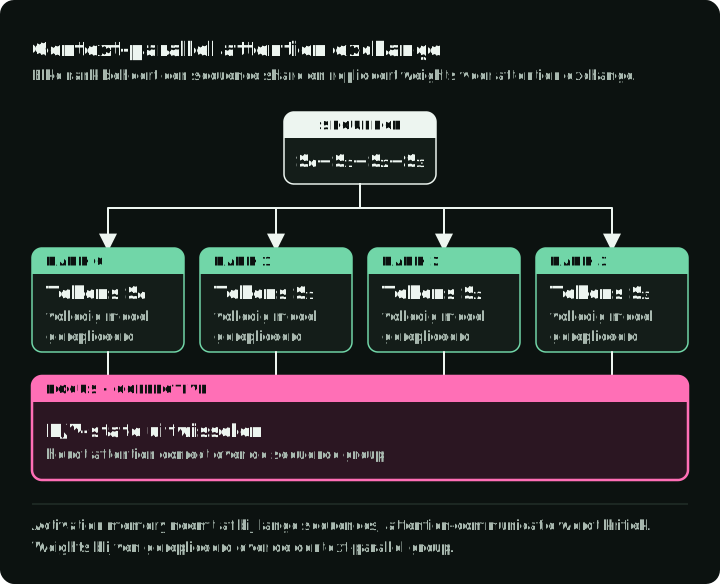
Context-parallellisme verdeelt de sequentiedimensie. De documentatie over context-parallellisme van NVIDIA beschrijft de sequentiesplitsing en de key/value-uitwisseling die attention nodig heeft. Elke rank bezit een sequentie-shard, terwijl attention de informatie uitwisselt die nodig is om de semantiek van de volledige context te behouden. Implementaties kunnen point-to-point-ringen, all-gather, all-to-all of hiërarchische combinaties gebruiken.
Het verlaagt het activation-geheugen bij training met lange context, maar repliceert weights over de contextgroep en introduceert attention-communicatie. Het voordeel hangt af van het type attention, causal masking, sequentielengte, recomputation en hoe contextgroepen samengaan met tensor- en data-parallelle groepen.
Kies het niet op basis van een universele drempel van 8K, 32K of 100K. Overweeg het als de activations bij je doelsequentielengte nog steeds niet in het geheugen passen na activation checkpointing en tensor- plus sequence parallelism, en de weights al passen.
Megatron Core implementeert CP voor training. Picotron heeft een kleine implementatie van data-, tensor-, pipeline- en context-parallellisme om te leren hoe ze in elkaar passen.
Expert-parallellisme voor MoE-models
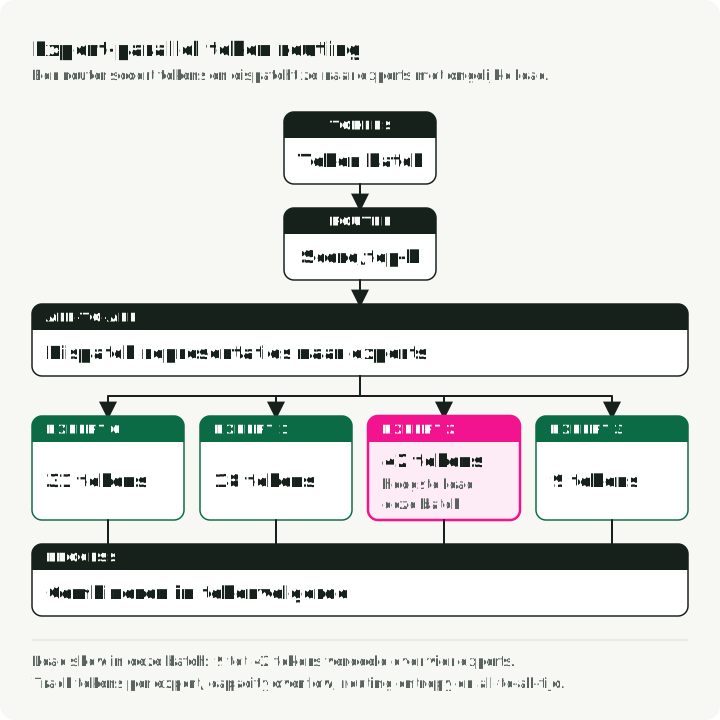
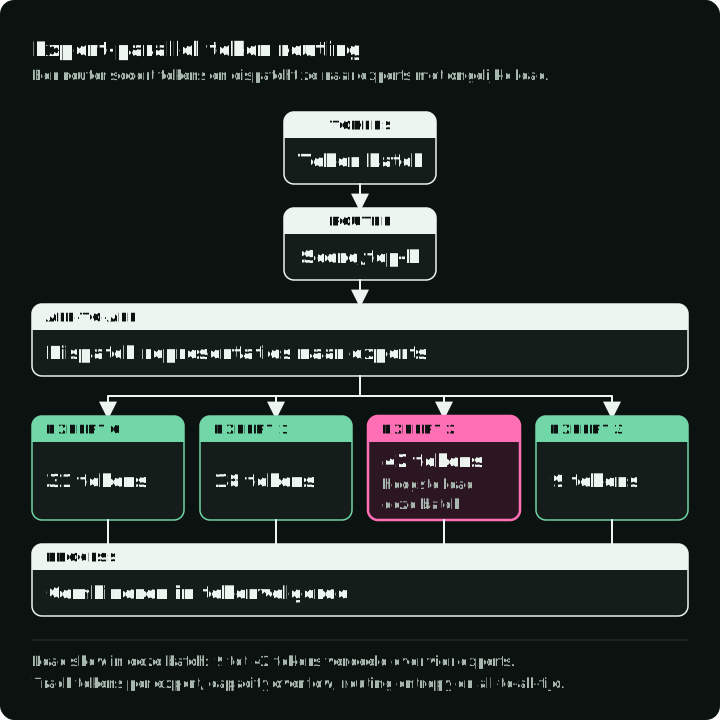
Expert-parallellisme verdeelt experts in mixture-of-experts-lagen. Mixtral 8x7B slaat bijvoorbeeld ongeveer 46,7B parameters op maar gebruikt er ongeveer 12,9B per token. De parallellismegids van NVIDIA beschrijft deze plaatsing van experts en de combinatie met andere parallelle dimensies. De router stuurt tokenrepresentaties naar geselecteerde experts en combineert hun resultaten. Per token rekenen alleen de geselecteerde experts, maar de totale expertweights moeten nog steeds worden opgeslagen en geplaatst voor serving.
Expert-parallellisme is geen optimalisatie-instelling voor een dense model. Het maakt deel uit van een MoE-architectuur. De aandachtspunten zijn load balance, capaciteitslimieten, token-all-to-all, weggegooide tokens, padding, auxiliary losses en ongelijke belasting bij uitval. Megatrons MoE-instellingen onderscheiden het weggooien van toewijzingen boven de expertcapaciteit van het opvullen van ongebruikte plaatsen eronder. Dropless routing verwerkt variabele aantallen tokens. Volg tokens per expert, routing-entropie, capaciteitsoverloop, communicatietijd en kwaliteit per route.
Megatron Core en Nanotron implementeren EP voor training.
Een layout samenstellen vanuit de topologie
Trainingssystemen voor grote dense models zonder expert-parallelle groep gebruiken meestal een product van de groepsgroottes voor data-parallel (DP), tensor-parallel (TP), pipeline-parallel (PP) en context-parallel (CP):
world size = DP × TP × PP × CPAls expert-parallellisme (EP) een onafhankelijke groep is, berekent de parallellismegids van NVIDIA het totaal als:
total GPUs = TP × PP × CP × EP × DPControleer welke groepsvolgordes en -groottes je framework ondersteunt voordat je de graden kiest.
Bouw de layout in deze volgorde:
- Teken de communicatiedomeinen: GPU-naar-GPU-verbindingen, switches, grenzen van non-uniform memory access (NUMA), node-fabric, oversubscription en het opslagpad. Op de meeste GPU-servers is het snelste domein NVLink tussen de GPUs van één node; nodes zijn verbonden via een trager netwerk zoals InfiniBand.
- Plaats frequente, latency-gevoelige collectives, meestal TP, in het snelste geschikte domein. Dat betekent meestal dat je elke TP-groep binnen één node houdt.
- Kies FSDP- of gerepliceerde DP-groepen op basis van de resterende capaciteit en bandbreedte.
- Voeg PP toe als diepteplaatsing of verkeer tussen domeinen ervan profiteert, en balanceer de gemeten stagetijd en het geheugen.
- Voeg CP alleen toe voor de sequentiebeperking en EP alleen voor de expert-topologie van het model.
- Controleer of heads, verborgen dimensies, lagen, experts, batch en sequentie deelbaar zijn voor de kandidaat-mesh.
- Benchmark meerdere geldige meshes. Topologiebewuste heuristieken kiezen kandidaten, geen winnaars.
Een voorbeeldkandidaat voor een dense 70B-model met 32K context op 64 nodes van 8 GPUs: TP=8 binnen elke node over NVLink, PP=4 over nodes, CP=4 voor de lange sequentie en DP=4 voor de rest; 8 × 4 × 4 × 4 = 512 GPUs. Benchmark die tegen TP=8, PP=8, CP=2, DP=4 voordat je kiest.
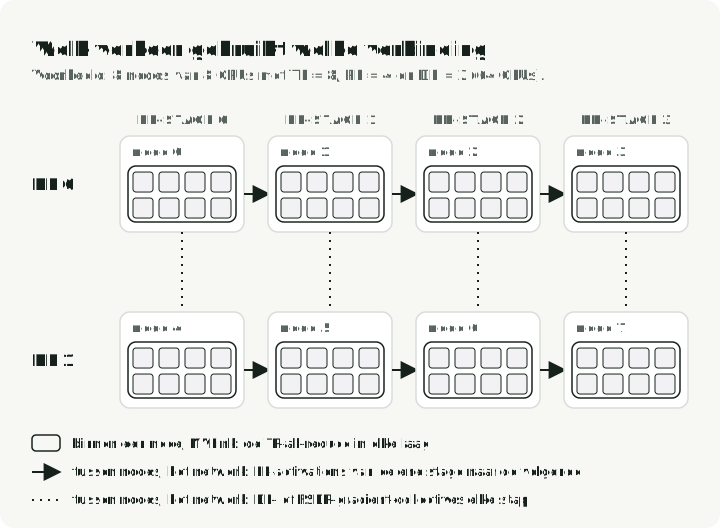
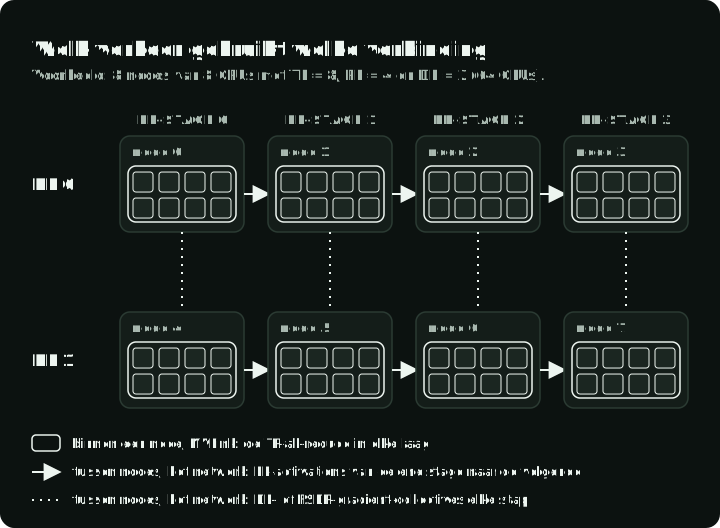
De figuur toont waar het verkeer van elke groep naartoe gaat in zo’n layout: de TP-all-reduce blijft op NVLink binnen een node, terwijl FSDP- of DP-gradient-collectives en PP-activations het netwerk tussen nodes oversteken.
Startkandidaten per clustergrootte, om te benchmarken en niet blind over te nemen:
- Eén node, 2-8 GPUs. DDP als een volledige trainingsreplica met voldoende marge past; FSDP2 of DeepSpeed ZeRO-2/3 als de modelstatus moet worden geshard. Start met
torchrunof Accelerate. Voeg TP=2 alleen toe als één laag of zijn activations nog steeds niet passen. Houd TP op PCIe-verbonden GPUs zonder NVLink op 1 of 2, omdat de all-reduce van elke laag over PCIe loopt. - 2-16 nodes. TP binnen elke node (4 of 8 met NVLink), FSDP of DP over nodes en PP over nodes alleen als het model nog steeds niet past.
- Honderden GPUs of meer. TP × PP × CP × DP, zoals in het voorbeeld hierboven, met een framework dat alle vier implementeert, zoals Megatron Core.
Twee clusters met hetzelfde aantal GPUs kunnen een andere layout verkiezen, omdat de bandbreedte van verbindingen, de switchhiërarchie, de CPU-aansluiting en netwerkcontentie verschillen.
Welk framework welke splitsing implementeert
De splitsingen hierboven worden door een klein aantal bibliotheken geïmplementeerd. Kies op basis van de splitsingen die je nodig hebt en hoeveel van de trainingsloop je zelf wilt beheren.
| Tool | Ondersteunde splitsingen | Gebruik het als |
|---|---|---|
| Hugging Face Accelerate | start DDP, FSDP of DeepSpeed vanuit een configbestand | je een bestaand PyTorch- of Transformers-script met weinig codewijzigingen op meer GPUs wilt draaien |
| PyTorch DDP en FSDP2 | DDP, FSDP (fully_shard), met torchrun | je een dense model op één node of een paar nodes traint en gewoon PyTorch wilt |
| DeepSpeed ZeRO | ZeRO-stages 1, 2, 3, CPU- en NVMe-offload, PP | je de shardingstage zelf wilt kiezen, of status naar CPU- of NVMe-geheugen wilt offloaden |
| Megatron Core | TP, PP, CP, EP, DP en sequence parallelism | je TP, PP en CP (en EP) samen nodig hebt voor grote pretraining-runs |
| Nanotron | DP, TP, PP, EP, ZeRO-1 | je een kleinere codebase dan Megatron wilt voor 3D-parallellisme en MoE |
| vLLM, SGLang, TensorRT-LLM | TP en PP voor inference | je het model serveert; zie de sectie over serving hieronder |
Om een bestaand script via Accelerate met FSDP2 te draaien, voer je één keer accelerate config uit; die schrijft het configbestand interactief. Deze instellingen kiezen FSDP2, groepering per decoderlaag en resharding:
fsdp_config:
    fsdp_version: 2
    fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP
    fsdp_transformer_layer_cls_to_wrap: LlamaDecoderLayer
    fsdp_reshard_after_forward: true
Met fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP geeft fsdp_transformer_layer_cls_to_wrap de blokklasse die één FSDP-eenheid wordt, dezelfde bottom-up groepering als de fully_shard-loop hierboven. fsdp_reshard_after_forward: true is volledige sharding; false is de modus die op ZeRO-2 lijkt. Start de job met accelerate launch --config_file fsdp2.yaml train.py. De FSDP1/FSDP2-gids legt deze versiegebonden instellingen uit en de opdracht accelerate to-fsdp2, die een oudere FSDP1-config converteert.
Training en serving vragen om aparte beslissingen
Inference draagt meestal geen gradients of optimizer state, dus FSDP-achtige trainingslayouts zijn niet automatisch overdraagbaar.
Prefill verwerkt de prompt en slaat de keys en values van zijn tokens op in de KV cache. Decode genereert volgende tokens en hergebruikt en breidt die cache uit.
Vraag bij serving:
- Past één replica met weights, KV cache, workspace en de doelconcurrency?
- Wordt throughput beter bediend door meer onafhankelijke replica’s of door één replica te shardden?
- Verlaagt TP de druk van weights en cache per rank genoeg om de communicatie per laag terug te verdienen?
- Wordt PP efficiënt ondersteund voor het model en de request-scheduler?
- Hoe belasten prefill en decode compute, geheugenbandbreedte en interconnect verschillend?
- Wat gebeurt er met de tail latency als requests verschillende prompt- en uitvoerlengtes hebben?
Gebruik voor de eerste vraag de KV-cache-formule uit de geheugensectie. Als één replica past met ruimte voor de KV cache bij je doelconcurrency, draai dan meer replica’s; die hebben geen communicatie tussen GPUs nodig. Als het niet past, shard het dan eerst met TP binnen één node en voeg PP over nodes alleen toe als één node niet genoeg is. In vLLM zijn dat --tensor-parallel-size en --pipeline-parallel-size; SGLang en TensorRT-LLM hebben dezelfde twee instellingen.
Benchmark de volledige server met de scheduler, quantization, contextverdeling, batchingbeleid en verkeersprofiel. Trainingstokens per seconde kunnen de time to first token of de inter-token latency bij serving niet voorspellen.
Wat je per kandidaat-layout vastlegt
Leg per kandidaat vast:
- identiteit van model, code, runtime, kernels en topologie
- globale en lokale batch, sequentieverdeling en aantal tokens
- piekgeheugen per categorie waar beschikbaar
- bruikbare tokens per seconde en model floating-point operation (FLOP)-utilization, als die consistent wordt berekend
- zichtbare tijd in all-reduce-, all-gather-, reduce-scatter-, all-to-all- en point-to-point-operaties
- input-stalls, checkpointtijd, herstartgedrag en verdeling van stragglers
- trainingsloss of pariteit van de serving-uitvoer met de baseline
Vergelijk weak en strong scaling bewust. Strong scaling houdt het totale werk constant terwijl het aantal ranks toeneemt. Weak scaling houdt het werk per rank constant, zodat het totale werk met het aantal ranks groeit. Een percentage met het label “scaling efficiency” is betekenisloos zonder die noemer en baseline.
Conclusie
Parallellisme is een afbeelding van een gemeten bottleneck op een tensordimensie en een communicatiepatroon. Replicatie, sharding, partitionering van lagen, staging, sequentiepartitionering en expert-routing verlichten elk een andere beperking en creëren een andere faalwijze.
Maak een inventaris van de workload, teken de topologie, genereer geldige meshes en profileer ze. De winnende layout is degene die met ruimte te over past en de zichtbare communicatie minimaliseert voor de job die je draait.
Referenties
- PyTorch FSDP2
fully_shard-documentatie - Parameter-sharding per module, all-gathers, reduce-scatters en DTensor-gedrag. - PyTorch DistributedDataParallel-documentatie - Training met gerepliceerde models en gesynchroniseerde gradients.
- PyTorch
torchrun-documentatie - Eén proces per GPU starten met omgevingsvariabelen voor de rank. - NVIDIA Megatron Core parallellismestrategieën - Dimensies voor data-, tensor-, pipeline-, context-, expert- en fully sharded strategieën.
- Hugging Face Ultra-Scale Playbook - Interactief overzicht van modelparallellisme op grote schaal.
- Ultra-Scale Playbook: naslagblad - Samenvatting van de playbook op één pagina.
- Hugging Face Accelerate FSDP-gids - Configsleutels en startcommando’s voor FSDP.
- DeepSpeed ZeRO-tutorial - ZeRO-stages en offload-configuratie.
- DeepSpeed ZeRO-paper - Optimizer states, gradients en parameters shardden om geheugengebruik te verlagen.
- Megatron-LM-paper - Column- en row-parallelle Transformer-lagen.
- Reducing Activation Recomputation in Large Transformer Models - Sequence parallelism in Megatron.
- GPipe-paper - Pipeline-training met micro-batches en gefaseerde uitvoering.
- Parallellisme en schalen in vLLM - Instellingen voor tensor- en pipeline-parallelle serving.
- Mixtral of experts - Totaal en actief aantal parameters van Mixtral 8x7B.
- NERSC-documentatie over parallellisme - Definities van strong en weak scaling op basis van vast totaal werk of werk per rank.