Skalowanie modeli LLM na wielu GPU i wielu węzłach

Tłumaczenie automatyczne
Ten artykuł został automatycznie przetłumaczony z angielskiego oryginału.
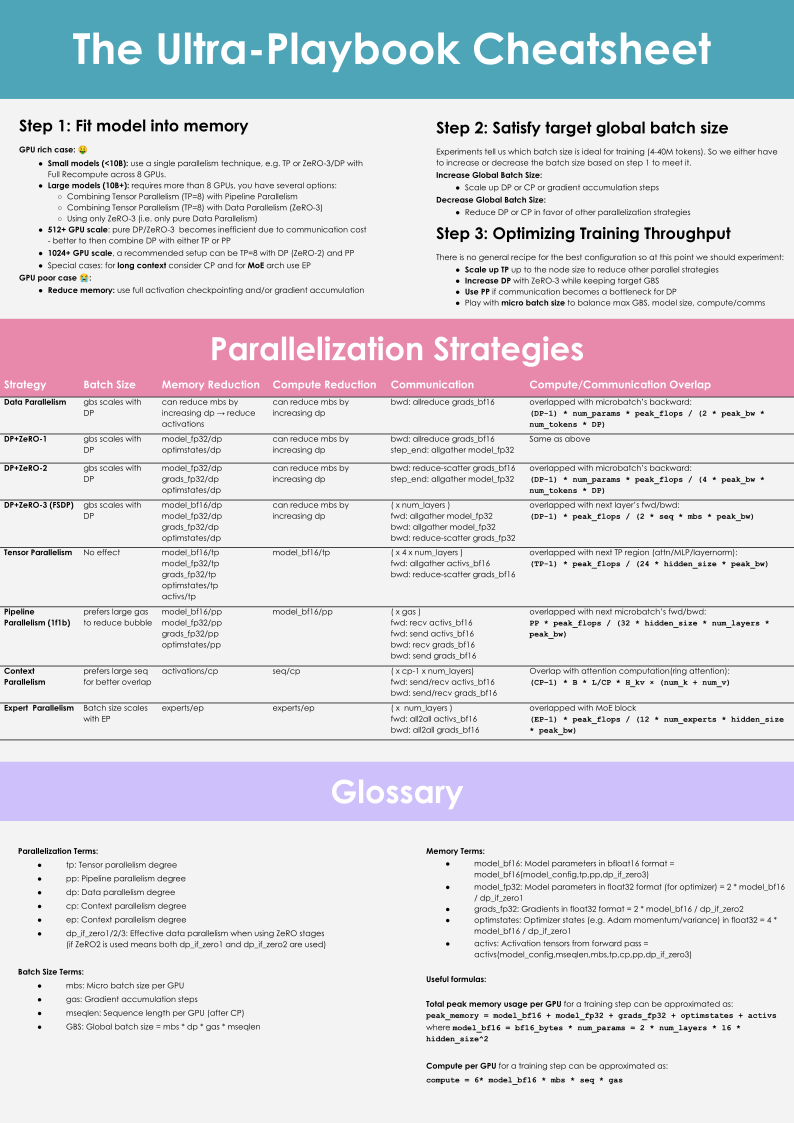
Dowiesz się, co oszczędza każdy podział, co wymaga komunikacji, który framework go implementuje i jak ułożyć pierwszą próbną siatkę (mesh) na swoim klastrze. Ten artykuł jest przeznaczony dla inżynierów, którzy znają propagację wsteczną, warstwy Transformera i pętlę treningową w PyTorch, a teraz potrzebują więcej niż jednego GPU do trenowania lub serwowania modelu. To praktyczny przegląd głównych strategii równoległości, ich ograniczeń i narzędzi, które je implementują, oparty na Ultra-Scale Playbook od Hugging Face.
Obciążenia z dużymi modelami wychodzą poza jedno GPU z różnych powodów. Zadanie treningowe może wyczerpać pamięć na stanie optymalizatora. Inne może ją wyczerpać na aktywacjach długich sekwencji. Model, który się mieści, nadal może nie osiągać docelowej przepustowości. Każdy z tych problemów wymaga innego podziału i innego wzorca komunikacji.
Budżety pamięci w treningu i inferencji
Trening i inferencja nie mają takiego samego zapotrzebowania na pamięć.
training peak ≈ parameters
              + gradients
              + optimizer state
              + saved activations
              + temporary buffers
              + communication buffers
              + allocator headroom

inference peak ≈ resident weights
               + key/value (KV) cache
               + runtime workspace
               + communication buffers
               + allocator headroom
Model o 70 miliardach parametrów ma dziesiętną dolną granicę 140 GB już dla samych wag w BF16. Trening potrzebuje znacznie więcej. Artykuł o ZeRO wylicza około 16 bajtów stanu modelu na parametr dla Adama z mieszaną precyzją FP16: 2 na wagi FP16, 2 na gradienty FP16 i 12 na główne wagi FP32 oraz dwa momenty Adama. Dla 70 mld parametrów daje to około 1120 GB, jeszcze przed aktywacjami. Poniższa tabela i wykres używają tego przydziału; rzeczywista precyzja tensorów i sposób przechowywania głównych wag mogą się różnić.
Replikowana równoległość danych (DDP) trzyma cały ten stan na każdym GPU. Sharding dzieli go między GPU w grupie zamiast go kopiować. Artykuł o ZeRO definiuje trzy etapy: etap 1 shardowuje stan optymalizatora, etap 2 dodatkowo gradienty, a etap 3 dodatkowo parametry. Etap 3 to to, co PyTorch nazywa w pełni shardowaną równoległością danych (FSDP). Dla Ψ parametrów na N GPU:
model state per GPU (ZeRO paper's FP16 mixed-precision Adam)
DDP      16Ψ
ZeRO-1   4Ψ + 12Ψ / N
ZeRO-2   2Ψ + 14Ψ / N
ZeRO-3   16Ψ / N
Przy shardingu na 64 GPU model 70B potrzebuje około 293 GB na GPU z ZeRO-1, około 155 GB z ZeRO-2 i około 17,5 GB z ZeRO-3 lub FSDP.
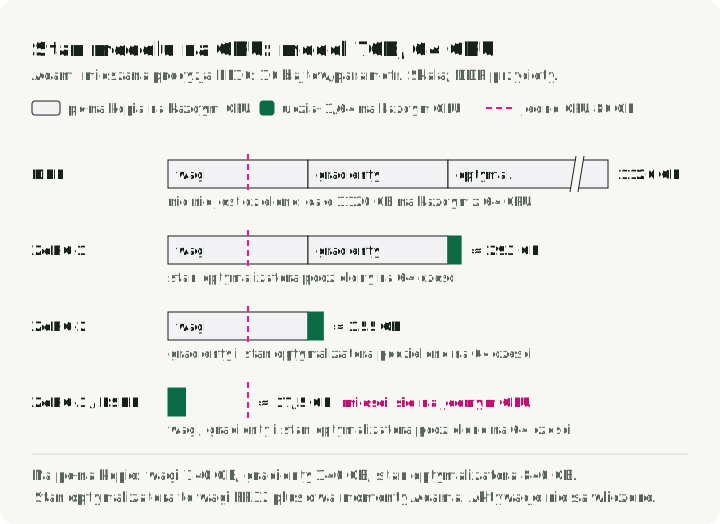
Wykres rozbija każdą z tych czterech liczb na część, którą każde GPU kopiuje, i część, którą dzieli z 63 innymi, i zestawia je z pamięcią jednego GPU o pojemności 80 GB: tylko pełny sharding sprowadza stan modelu poniżej tej wartości, a pozostałe miejsce zajmują aktywacje i bufory.
Inferencja nie ma gradientów ani stanu optymalizatora, ale dodaje KV cache, który rośnie, gdy serwer przechowuje w pamięci kolejny token:
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valueDwójka oznacza klucze i wartości. Dla Llama 3.1 70B w BF16 (80 warstw, 8 głowic KV, wymiar głowicy 128) daje to około 0,33 MB na token, więc jedna sekwencja złożona z 32 768 jednostek token zajmuje w cache około 10,7 GB. Pomnóż to przez liczbę równoczesnych sekwencji, aby dobrać rozmiar serwera. Polityka cache, długość sekwencji, współbieżność i kwantyzacja zmieniają tę liczbę.
Oszczędność pamięci nie ma stałego mnożnika. Powyższe liczby pomijają aktywacje, bufory tymczasowe i komunikacyjne oraz zapas alokatora. Rzeczywista oszczędność zależy od stopnia shardingu, tego, co pozostaje zreplikowane, przejściowego niezshardowanego stanu, polityki aktywacji, paddingu, nierównowagi obciążenia i buforów.
Profiluj dokładnie swoją architekturę, precyzję, długość sekwencji, mikrobatch, optymalizator, politykę checkpointowania i środowisko uruchomieniowe. Zapisuj szczytową pamięć przydzieloną i zarezerwowaną, liczbę jednostek token na sekundę, czas w kernelach oraz czas widoczny w operacjach kolektywnych. torch.cuda.max_memory_allocated() i torch.cuda.max_memory_reserved() dają oba szczyty; profiler PyTorch lub Nsight Systems pokazuje czas kerneli i to, ile czasu NCCL nie nakłada się na obliczenia.
Jak komunikują się rangi
Ranga (rank) to jeden proces treningowy, zwykle obsługujący jedno GPU. Rangi wymieniają tensory za pomocą operacji kolektywnych i operacji point-to-point, które na GPU NVIDIA implementuje biblioteka NCCL. W tym artykule pojawia się pięć; przykłady redukcji używają sum:
- All-reduce: każda ranga kończy z sumą tensorów wszystkich rang.
- All-gather: każda ranga kończy z shardami wszystkich rang.
- Reduce-scatter: każda ranga kończy z sumą jednego sharda.
- All-to-all: każda ranga wysyła inny fragment do każdej innej rangi.
- Point-to-point: jedna ranga wysyła tensor do jednej innej rangi.
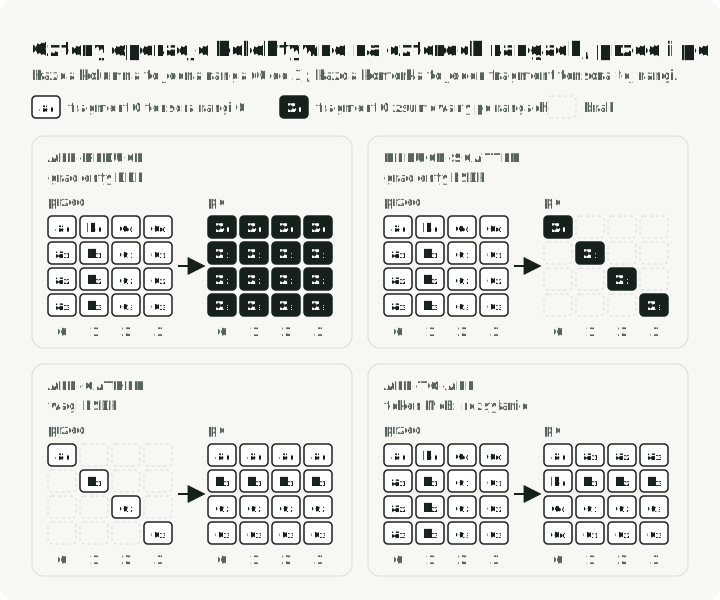
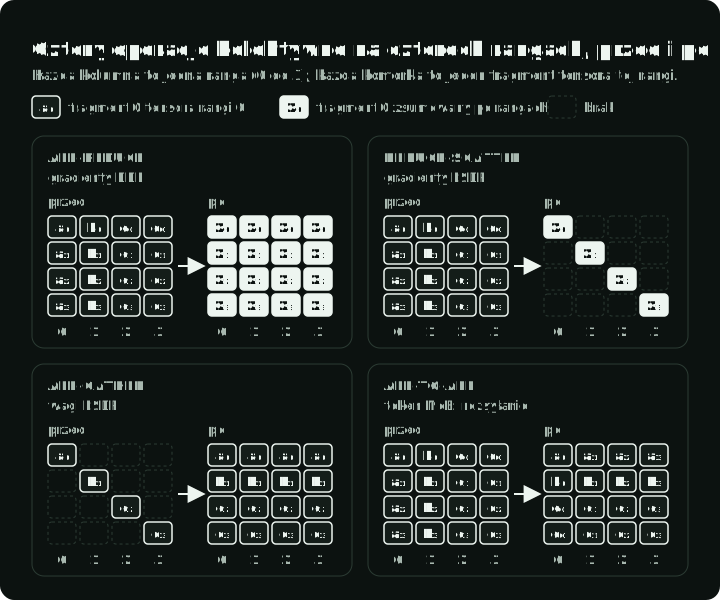
Rysunek pokazuje cztery rangi przed i po każdej z pierwszych czterech operacji, jedna kolumna na rangę i jedna komórka na fragment jej tensora. Porównaj all-reduce z reduce-scatter: obie sumują dane między rangami, ale reduce-scatter zostawia każdej randze tylko jej własny shard sumy.
Co dzieli każda strategia i co wymaga komunikacji
Dla każdej strategii zadaj pytania: który wymiar tensora jest dzielony, jaki stan pozostaje zreplikowany i która operacja kolektywna trafia na ścieżkę krytyczną.
| Strategia | Co dzieli | Główna oszczędność | Wprowadzana komunikacja |
|---|---|---|---|
| Replikowana równoległość danych (DDP) | batch | przepustowość treningu | all-reduce gradientów |
| W pełni shardowana równoległość danych (FSDP) | parametry, gradienty i stan optymalizatora w grupie równoległości danych (DP) | pamięć na stan modelu | all-gather parametrów, reduce-scatter gradientów |
| Równoległość tensorowa (TP) | wymiary macierzy lub attention wewnątrz warstw | wagi warstw i aktywacje | operacje kolektywne wewnątrz bloków transformera |
| Równoległość potokowa (PP) | grupy warstw | głębokość modelu i stan na etap | aktywacje point-to-point oraz bąble w harmonogramie |
| Równoległość kontekstowa (CP) | wymiar sekwencji | pamięć aktywacji długich sekwencji | wymiana kluczy/wartości lub danych attention w grupie sekwencji |
| Równoległość ekspertów (EP) | eksperci MoE i kierowane do nich jednostki token | pojemność ekspertów na rangę | token: rozsyłanie i zbieranie, zwykle przez all-to-all |
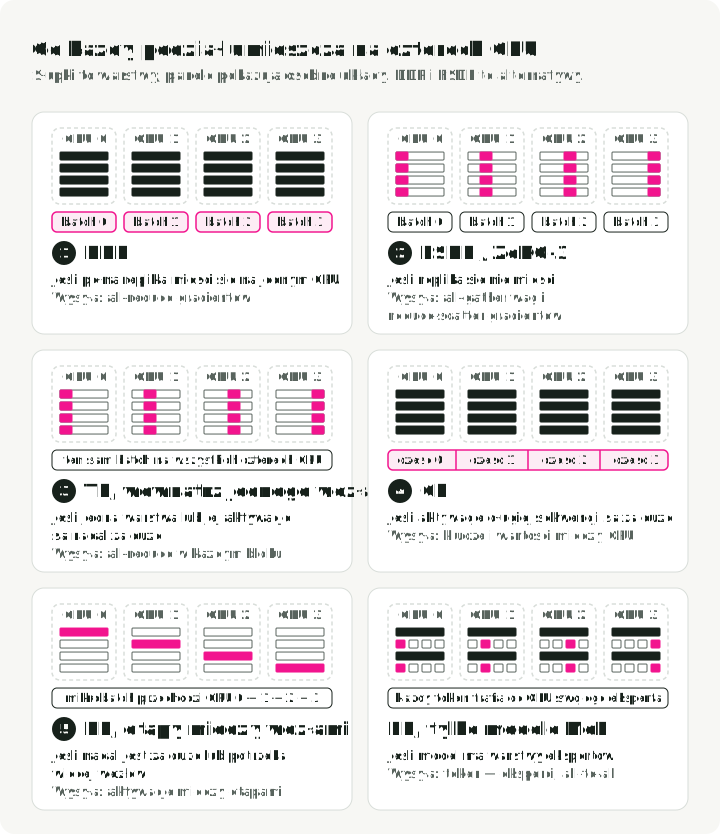
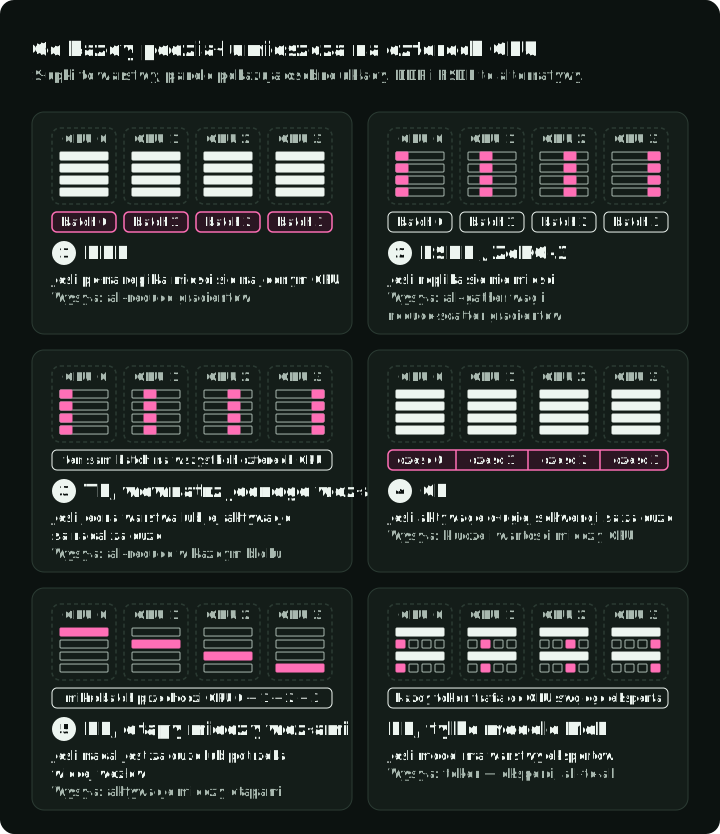
Rysunek pokazuje sześć osobnych układów na czterech GPU. Wybierz DDP, gdy pełna replika treningowa mieści się z zapasem, lub FSDP/ZeRO, gdy stan modelu wymaga shardingu. Dodawaj inne podziały tylko dla ograniczeń, które rozwiązują; panele nie pokazują tych kombinacji. Kolejne sekcje wyjaśniają każdy podział.
Równoległość danych (DDP)
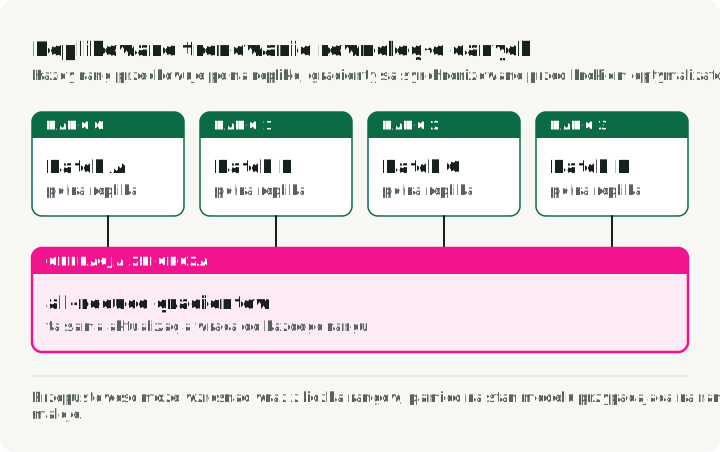
Replikowana równoległość danych, zwykle nazywana distributed data parallel, trzyma pełną replikę treningową na każdej randze. Dokumentacja DistributedDataParallel w PyTorch opisuje ten model repliki i synchronizacji gradientów. Każda ranga przetwarza inny mikrobatch, a gradienty są synchronizowane przed krokiem optymalizatora.
Użyj jej, gdy cały stan treningowy mieści się z zapasem. Każda nowa ranga dodaje swój mikrobatch do globalnego batcha, więc albo twoja receptura treningowa toleruje większy batch globalny, albo zmniejszasz akumulację gradientów, żeby go utrzymać. Główne zalety to prosta semantyka i dojrzała implementacja, która nakłada obliczenia wstecznego przebiegu na redukcję gradientów w paczkach (bucketach).
Dodawanie rang może zaszkodzić, gdy lokalny batch staje się zbyt mały. Może też zaszkodzić, gdy sieć nie potrafi ukryć all-reduce albo dostarczanie danych wejściowych się zacina. Większe batche globalne mogą dawać coraz mniejsze skrócenie czasu do osiągnięcia docelowej straty, zużywając więcej obliczeń. Porównaj stratę i czas wykonania dla swojej receptury treningowej.
Rysunek pokazuje jeden krok treningu na jednej randze. Paczki gradientów są redukowane operacją all-reduce w trakcie przebiegu wstecz, a GPU czeka tylko na tę część all-reduce, której sieć nie potrafi ukryć.
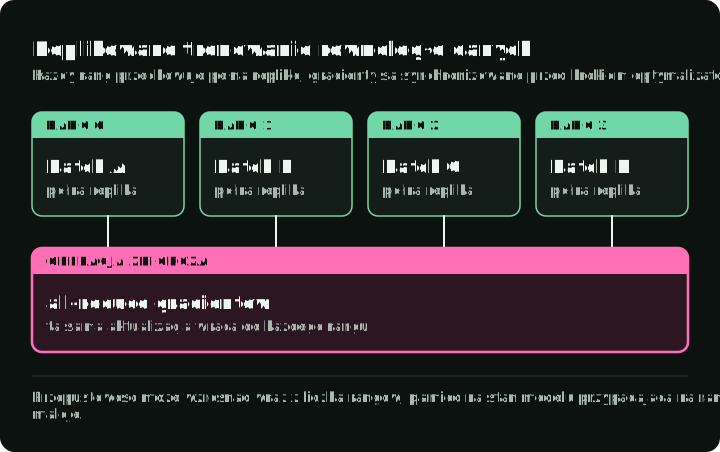
W PyTorch opakowujesz model w DistributedDataParallel i uruchamiasz jeden proces na GPU za pomocą torchrun, który ustawia RANK, LOCAL_RANK i WORLD_SIZE dla każdego procesu. Hugging Face Accelerate uruchamia tę samą konfigurację z pliku konfiguracyjnego.
W pełni shardowana równoległość danych (FSDP, ZeRO)
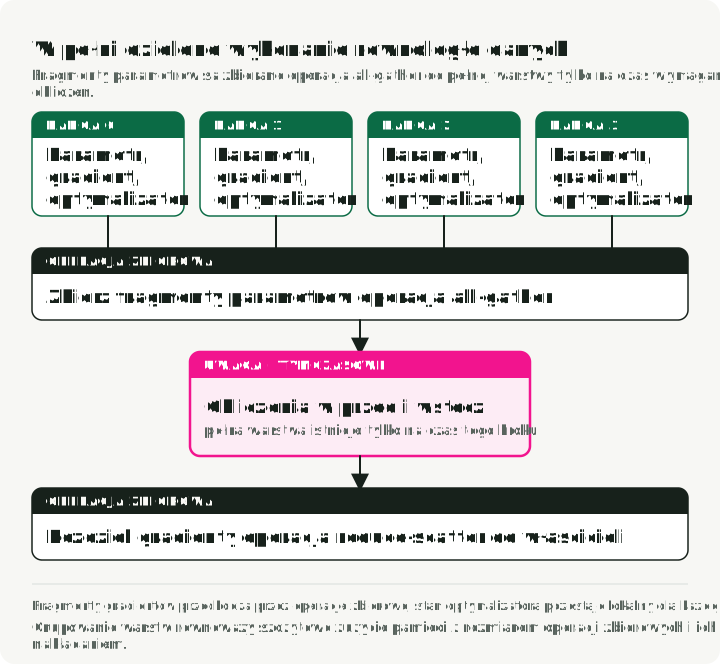
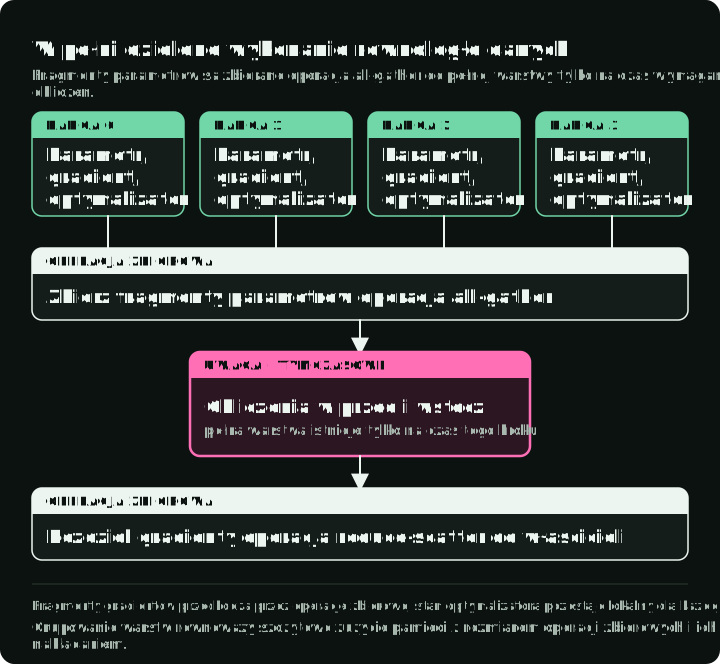
W pełni shardowana równoległość danych przechowuje shardy parametrów, gradientów i stanu optymalizatora w całej grupie. Artykuł o ZeRO opisuje ten wzorzec shardowania stanu, a API FSDP2 w PyTorch go implementuje. Parametry warstwy są zbierane operacją all-gather na czas obliczeń i po nich mogą zostać ponownie podzielone. Gradienty wracają do właścicieli przez reduce-scatter. Rysunek śledzi jedną warstwę na jednej z czterech rang w trakcie kroku treningu: ranga przechowuje ćwiartkę wag, gradientów i stanu optymalizatora, all-gather buduje pełne wagi na przebieg w przód i ponownie na przebieg wstecz, a reduce-scatter zostawia randze jej ćwiartkę gradientów.
Artykuł o ZeRO szacuje koszt etapu 3 na około 1,5 raza większy wolumen komunikacji niż w DDP: parametry są zbierane operacją all-gather zarówno w przebiegu w przód, jak i wstecz, a gradienty są raz redukowane operacją reduce-scatter.
Obecna dokumentacja PyTorch rozróżnia API fully_shard w wersji 2 w pełni shardowanej równoległości danych (FSDP2) od starszego opakowania FullyShardedDataParallel. FSDP2 grupuje komunikację według modułów, do których zastosowano fully_shard, i zaleca stosowanie go od dołu do góry, żeby grupy warstw mogły nakładać komunikację na obliczenia.
Kolejność wywołań to część, w której łatwo o błąd. Ten fragment shardowuje stos warstw Transformera za pomocą FSDP2:
model = nn.Sequential(*layers).cuda()  # e.g. 24 Transformer layers

for layer in model:  # bottom-up: each layer becomes one communication group
    fully_shard(layer)
fully_shard(model)  # then shard the remaining root parameters

# Build the optimizer after sharding, so it holds the sharded parameters (DTensors).
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
Uruchom jeden proces na GPU poleceniem torchrun --nproc_per_node=8 train.py. Szczytowa pamięć na rangę maleje wraz z rozmiarem grupy shardów, bo każda ranga trzyma mniejszą część wag FP32, gradientów i stanu Adama. Aktywacje się nie zmniejszają, ponieważ każda ranga nadal przetwarza własny batch. Samouczek FSDP2 zawiera kompletny skrypt z mieszaną precyzją i checkpointowaniem. FSDP2 ma też opcję reshard_after_forward=False, która trzyma parametry zebrane między przebiegiem w przód a wstecz. Działa jak ZeRO-2: mniej operacji all-gather, więcej pamięci.
Sharding jest atrakcyjny, gdy stan modelu stanowi największą część pamięci, a obliczenia warstw potrafią ukryć wystarczająco dużo ruchu kolektywnego. Może to być zły kompromis dla małych modeli, wolnych łączy, bardzo małych warstw albo grupy shardów obejmującej węzły połączone wolną siecią. DeepSpeed ZeRO implementuje te same etapy z jawnym wyborem etapu i opcjonalnym przenoszeniem stanu do pamięci CPU lub NVMe.
Równoległość tensorowa
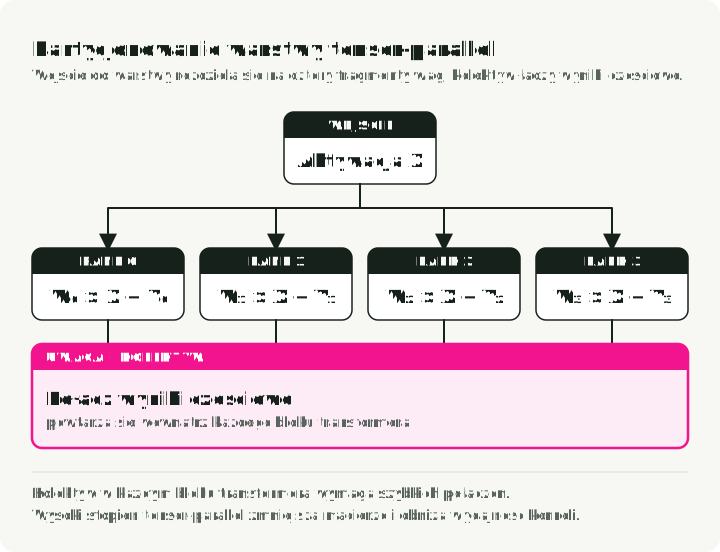
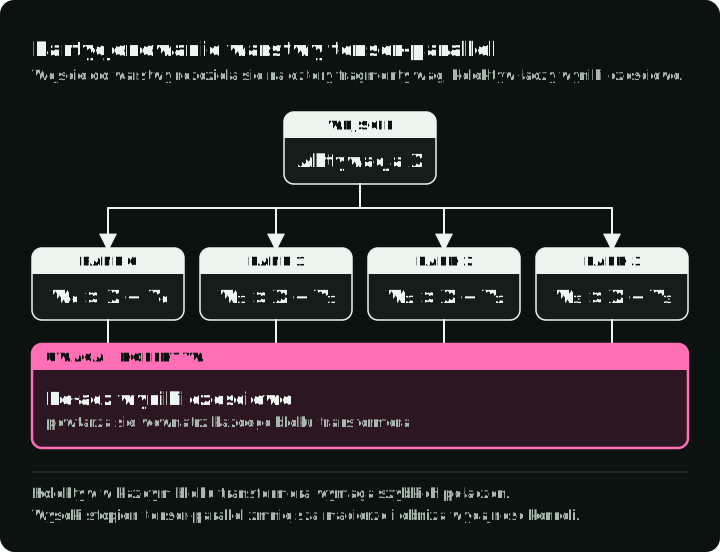
Równoległość tensorowa dzieli algebrę liniową wewnątrz warstwy. Przykładem są projekcje kolumnowo-równoległe i wierszowo-równoległe. Przewodnik NVIDIA po równoległości opisuje ten podział na poziomie warstw. Wyniki częściowe wymagają operacji kolektywnych wewnątrz bloków transformera, więc opóźnienie i przepustowość mają znaczenie wielokrotnie w przebiegach w przód i wstecz.
Rysunek pokazuje podział, którego artykuł o Megatron-LM używa dla MLP Transformera na dwóch rangach. Pierwsza macierz wag jest dzielona według kolumn, więc każda ranga stosuje GeLU do własnego wycinka bez komunikacji. Druga macierz jest dzielona według wierszy, więc każda ranga wytwarza częściową sumę wyniku, a jeden all-reduce je dodaje. To jeden all-reduce na MLP w przebiegu w przód zamiast jednego na każde mnożenie macierzy.
Użyj jej, gdy warstwa lub jej aktywacje się nie mieszczą albo gdy mnożenia macierzy są na tyle duże, że podzielone kernele działają szybciej niż na jednej randze. Przypisz grupę tensorowo-równoległą do najszybszej dostępnej domeny komunikacyjnej, a potem zmierz wynik. Wysoki stopień równoległości tensorowej może zmniejszyć każdą lokalną macierz tak bardzo, że efektywność kerneli spada, a narzut operacji kolektywnych rośnie.
Równoległość sekwencji w stylu Megatron dzieli wzdłuż sekwencji aktywacje obszarów LayerNorm i dropout, które zwykły TP trzymałby w całości na każdej randze grupy TP. Działa wewnątrz grupy TP; równoległość kontekstowa dzieli całą sekwencję, łącznie z attention, w osobnej grupie.
Megatron Core implementuje TP i równoległość sekwencji do treningu. vLLM, SGLang i TensorRT-LLM używają TP do podziału modelu na potrzeby serwowania.
Równoległość potokowa
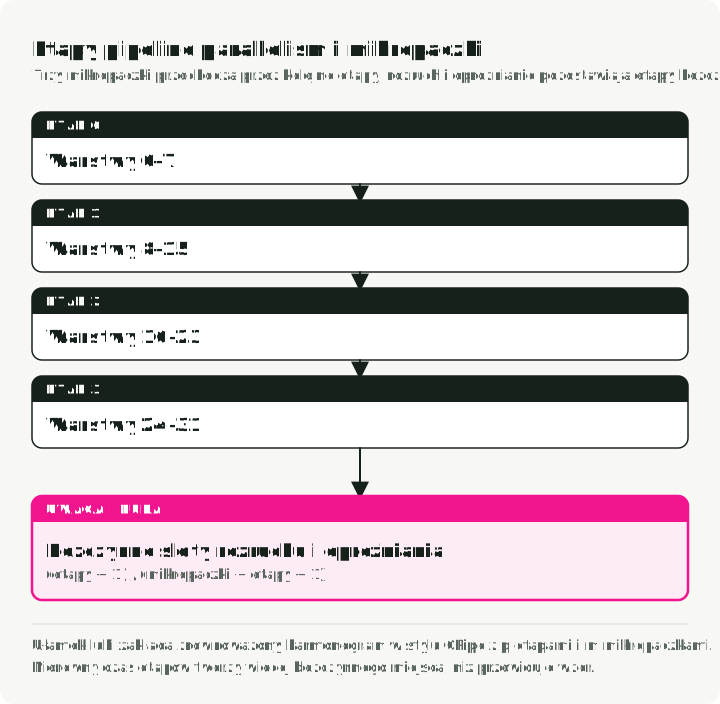
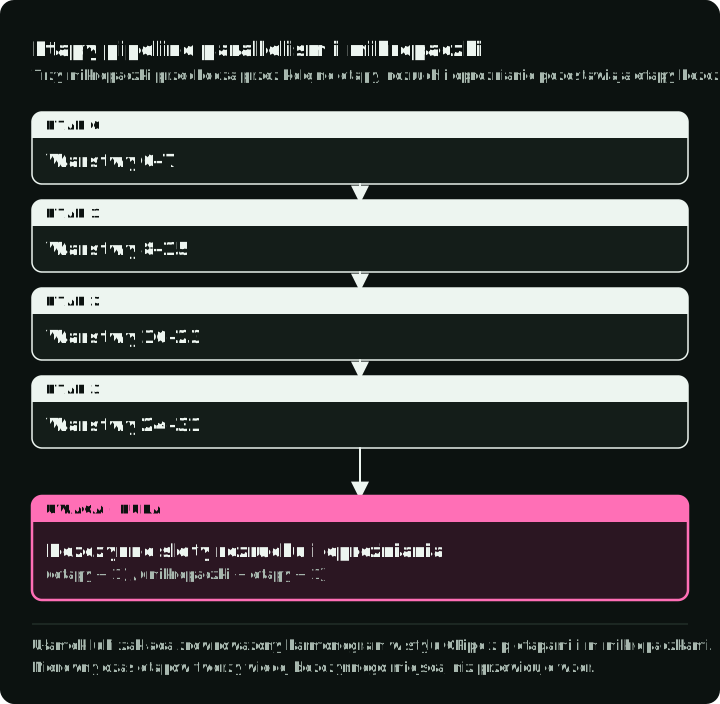
Równoległość potokowa umieszcza różne grupy warstw na różnych etapach i przesyła aktywacje między nimi. Mikrobatche utrzymują równoczesną pracę etapów.
Zmniejsza stan modelu na etap i może zmniejszyć wolumen komunikacji przechodzącej przez wolniejszą granicę w porównaniu z operacjami kolektywnymi TP na każdej warstwie. Jej koszty to bąble, transfery aktywacji, nierównowaga etapów, bardziej złożone harmonogramowanie oraz trudniejsze odtwarzanie i checkpointowanie.
Rysunek pokazuje przebieg w przód dla czterech etapów i czterech mikrobatchy w siedmiu krokach czasu, a pod nim bezczynny udział dla większej liczby mikrobatchy. Każdy pusty slot to etap bez pracy: ostatnie etapy czekają na początku, a pierwsze na końcu. Dla prostego, zrównoważonego harmonogramu w stylu GPipe z p etapami i m mikrobatchami wyidealizowany ułamek bąbla w przebiegu w przód wynosi w przybliżeniu:
(p - 1) / (m + p - 1)Przy 4 etapach 4 mikrobatche zostawiają 3/7, czyli około 43%, harmonogramu przebiegu w przód bez pracy. 16 mikrobatchy zostawia 3/19, około 16%, a 32 zostawiają 3/35, około 9%. Więcej mikrobatchy na batch globalny zmniejsza bąbel, ale każdy z nich jest mniejszy, więc kernele działają mniej efektywnie; zmierz oba efekty.
Rzeczywiste harmonogramy mogą używać schematu jeden-przód/jeden-tył, przeplotu albo wariantów bez bąbli, a nierówny koszt warstw może zdominować wzór. Granice etapów wybieraj na podstawie zmierzonego czasu i pamięci, a nie równej liczby warstw.
DeepSpeed, Megatron Core i Nanotron implementują harmonogramy potokowe.
Równoległość kontekstowa
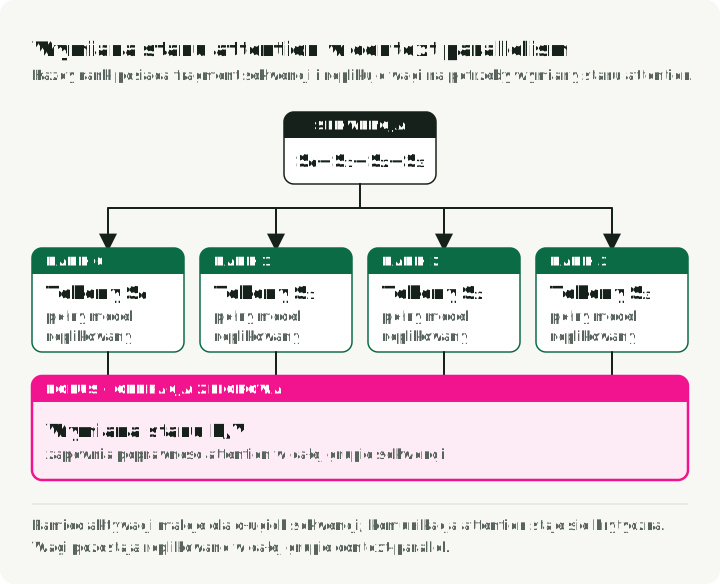
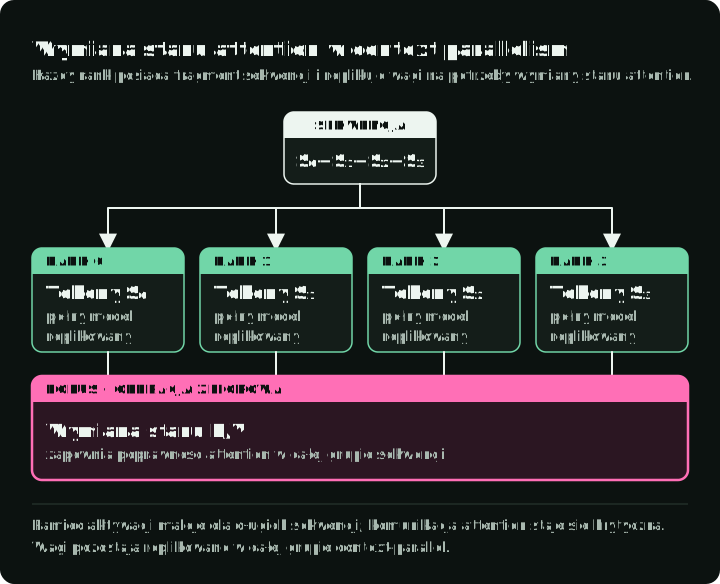
Równoległość kontekstowa rozdziela wymiar sekwencji. Dokumentacja NVIDIA o równoległości kontekstowej opisuje podział sekwencji i wymianę kluczy i wartości potrzebną dla attention. Każda ranga posiada shard sekwencji, a attention wymienia informacje potrzebne do zachowania semantyki pełnego kontekstu. Implementacje mogą używać pierścieni point-to-point, all-gather, all-to-all lub kombinacji hierarchicznych.
Zmniejsza pamięć aktywacji w treningu z długim kontekstem, ale replikuje wagi w grupie kontekstowej i wprowadza komunikację attention. Zysk zależy od typu attention, maski przyczynowej, długości sekwencji, rekomputacji oraz tego, jak grupy kontekstowe łączą się z grupami tensorowymi i danych.
Nie wybieraj jej na podstawie uniwersalnego progu 8K, 32K czy 100K. Rozważ ją, gdy po checkpointowaniu aktywacji oraz równoległości tensorowej i sekwencji aktywacje nadal przekraczają pamięć przy docelowej długości sekwencji, a wagi już się mieszczą.
Megatron Core implementuje CP do treningu. Picotron ma niewielką implementację równoległości danych, tensorowej, potokowej i kontekstowej, przydatną do nauki, jak się ze sobą łączą.
Równoległość ekspertów dla modeli MoE
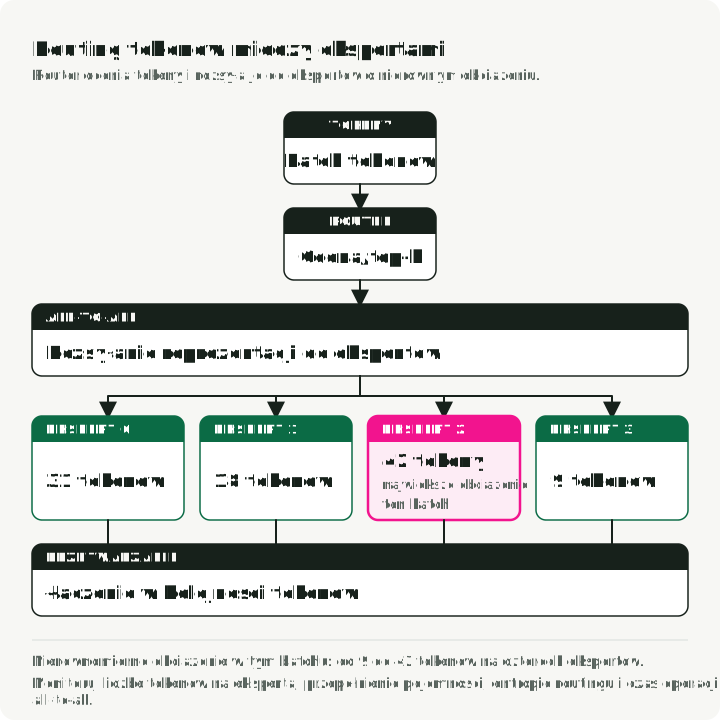
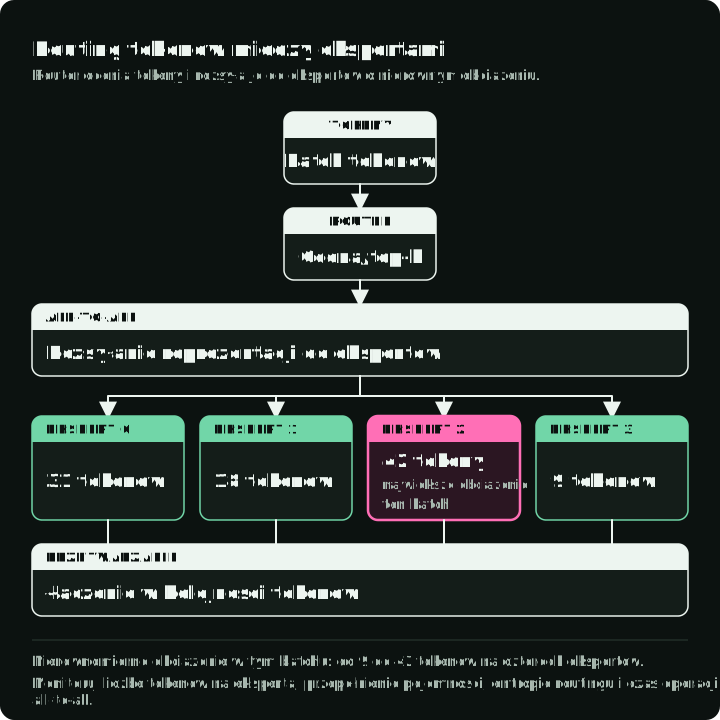
Równoległość ekspertów rozdziela ekspertów w warstwach mixture-of-experts. Mixtral 8x7B na przykład przechowuje około 46,7 mld parametrów, ale na token używa około 12,9 mld. Przewodnik NVIDIA po równoległości opisuje to rozmieszczenie ekspertów i jego łączenie z innymi wymiarami równoległości. Router wysyła reprezentację każdej jednostki token do wybranych ekspertów i łączy ich wyniki. Każdy token przetwarzają tylko wybrani eksperci, ale łączne wagi ekspertów nadal wymagają miejsca w pamięci i rozmieszczenia na etapie serwowania.
Równoległość ekspertów nie jest ustawieniem optymalizacji dla modelu gęstego. Jest częścią architektury MoE. Wiążą się z nią kwestie równowagi obciążenia, limitów pojemności, all-to-all dla jednostek token, odrzucania jednostek token, paddingu, strat pomocniczych i nierównomiernych awarii. Ustawienia MoE w Megatron odróżniają odrzucanie przydziałów ponad pojemność eksperta od dopełniania niewykorzystanych miejsc poniżej niej. Routing bez odrzucania przetwarza zmienną liczbę jednostek token. Śledź liczbę jednostek token na eksperta, entropię routingu, przekroczenia pojemności, czas komunikacji i jakość według trasy.
Megatron Core i Nanotron implementują EP do treningu.
Ułóż układ na podstawie topologii
Duże systemy do trenowania modeli gęstych bez grupy równoległości ekspertów zwykle używają iloczynu rozmiarów grup równoległości danych (DP), tensorowej (TP), potokowej (PP) i kontekstowej (CP):
world size = DP × TP × PP × CPGdy równoległość ekspertów (EP) jest niezależną grupą, przewodnik NVIDIA po równoległości oblicza łączną liczbę GPU jako:
total GPUs = TP × PP × CP × EP × DPZanim wybierzesz stopnie równoległości, sprawdź, jakie kolejności i rozmiary grup obsługuje twój framework.
Układ buduj w tej kolejności:
- Narysuj domeny komunikacyjne: łącza GPU-GPU, przełączniki, granice niejednorodnego dostępu do pamięci (NUMA), sieć węzłów, oversubscription i ścieżkę do magazynu danych. Na większości serwerów GPU najszybszą domeną jest NVLink między GPU jednego węzła; węzły łączą się wolniejszą siecią, taką jak InfiniBand.
- Umieść częste operacje kolektywne wrażliwe na opóźnienia, zwykle TP, w najszybszej odpowiedniej domenie. Zazwyczaj oznacza to trzymanie każdej grupy TP wewnątrz jednego węzła.
- Wybierz grupy FSDP lub replikowane grupy DP na podstawie pozostałej pojemności i przepustowości.
- Dodaj PP, gdy opłaca się rozłożyć model na głębokość albo ograniczyć ruch między domenami, równoważąc zmierzony czas etapów i pamięć.
- Dodaj CP tylko ze względu na ograniczenie sekwencji, a EP tylko ze względu na topologię ekspertów modelu.
- Potwierdź podzielność głowic, wymiarów ukrytych, warstw, ekspertów, batcha i sekwencji dla kandydackiej siatki.
- Zmierz kilka poprawnych siatek. Heurystyki uwzględniające topologię wybierają kandydatów, a nie zwycięzców.
Przykładowy kandydat dla gęstego modelu 70B z kontekstem 32K na 64 węzłach po 8 GPU: TP=8 wewnątrz każdego węzła przez NVLink, PP=4 między węzłami, CP=4 dla długiej sekwencji i DP=4 dla reszty; 8 × 4 × 4 × 4 = 512 GPU. Przed wyborem porównaj go z TP=8, PP=8, CP=2, DP=4.
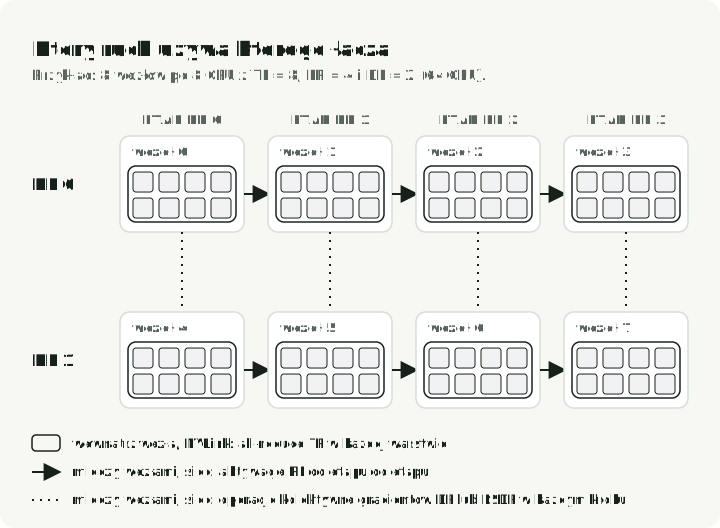
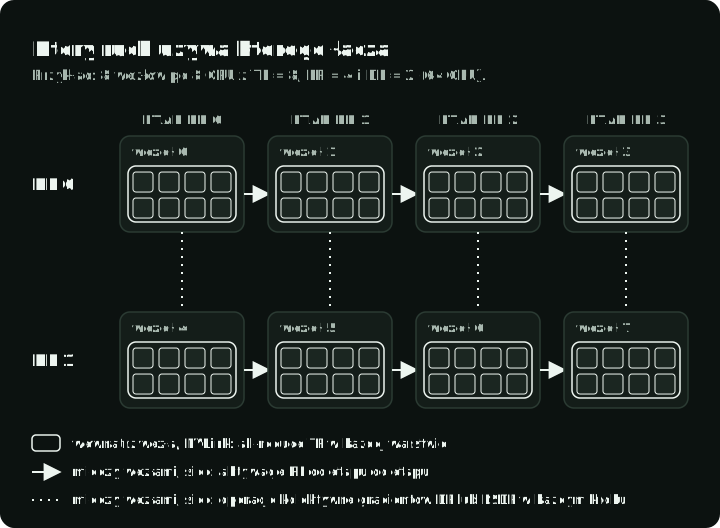
Rysunek pokazuje, dokąd trafia ruch każdej grupy w takim układzie: all-reduce TP zostaje na NVLink wewnątrz węzła, a kolektywy gradientów FSDP lub DP oraz aktywacje PP przechodzą przez sieć między węzłami.
Kandydaci startowi według rozmiaru klastra, do zmierzenia, a nie do bezrefleksyjnego przyjęcia:
- Jeden węzeł, 2–8 GPU. DDP, gdy pełna replika treningowa mieści się z zapasem; FSDP2 lub DeepSpeed ZeRO-2/3, gdy stan modelu wymaga shardingu. Uruchamiaj przez
torchrunlub Accelerate. Dodaj TP=2 tylko wtedy, gdy pojedyncza warstwa lub jej aktywacje nadal się nie mieszczą. Na GPU połączonych przez PCIe bez NVLink trzymaj TP na poziomie 1 lub 2, bo all-reduce każdej warstwy przechodzi przez PCIe. - 2–16 węzłów. TP wewnątrz każdego węzła (4 lub 8 z NVLink), FSDP lub DP między węzłami, a PP między węzłami tylko wtedy, gdy model nadal się nie mieści.
- Setki GPU lub więcej. TP × PP × CP × DP, jak w przykładzie powyżej, z frameworkiem, który implementuje wszystkie cztery, takim jak Megatron Core.
Dwa klastry z taką samą liczbą GPU mogą preferować różne układy, bo przepustowość łączy, hierarchia przełączników, podłączenie CPU i obciążenie sieci się różnią.
Który framework implementuje który podział
Powyższe podziały implementuje niewielki zestaw bibliotek. Wybieraj według potrzebnych podziałów i tego, ile pętli treningowej chcesz mieć na własność.
| Narzędzie | Obsługiwane podziały | Użyj, gdy |
|---|---|---|
| Hugging Face Accelerate | uruchamia DDP, FSDP lub DeepSpeed z pliku konfiguracyjnego | chcesz uruchomić istniejący skrypt PyTorch lub Transformers na kilku GPU przy niewielu zmianach kodu |
| PyTorch DDP i FSDP2 | DDP, FSDP (fully_shard), z torchrun | trenujesz model gęsty na jednym lub kilku węzłach i chcesz czystego PyTorch |
| DeepSpeed ZeRO | etapy ZeRO 1, 2, 3, offload na CPU i NVMe, PP | chcesz wybrać etap shardingu albo przenieść stan do pamięci CPU lub NVMe |
| Megatron Core | TP, PP, CP, EP, DP i równoległość sekwencji | potrzebujesz TP, PP i CP (oraz EP) razem w dużych przebiegach pretreningu |
| Nanotron | DP, TP, PP, EP, ZeRO-1 | chcesz mniejszej bazy kodu niż Megatron do równoległości 3D i MoE |
| vLLM, SGLang, TensorRT-LLM | TP i PP dla inferencji | serwujesz model; zobacz sekcję o serwowaniu poniżej |
Aby uruchomić istniejący skrypt z FSDP2 przez Accelerate, wykonaj raz accelerate config; interaktywnie zapisze plik konfiguracyjny. Te ustawienia wybierają FSDP2, grupowanie według warstw dekodera i ponowny sharding:
fsdp_config:
    fsdp_version: 2
    fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP
    fsdp_transformer_layer_cls_to_wrap: LlamaDecoderLayer
    fsdp_reshard_after_forward: true
Przy fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP ustawienie fsdp_transformer_layer_cls_to_wrap wskazuje klasę bloku, który staje się jedną jednostką FSDP, czyli to samo grupowanie od dołu do góry co w pętli fully_shard powyżej. fsdp_reshard_after_forward: true oznacza pełny sharding; false to tryb zbliżony do ZeRO-2. Uruchom zadanie poleceniem accelerate launch --config_file fsdp2.yaml train.py. Przewodnik FSDP1/FSDP2 wyjaśnia te ustawienia zależne od wersji oraz polecenie accelerate to-fsdp2, które konwertuje starszą konfigurację FSDP1.
Trening i serwowanie wymagają osobnych decyzji
Inferencja zwykle nie ma gradientów ani stanu optymalizatora, więc układy treningowe w stylu FSDP nie przenoszą się automatycznie.
Prefill przetwarza prompt i zapisuje w KV cache klucze oraz wartości każdej jednostki token tego wejścia. Dekodowanie generuje kolejne jednostki token, ponownie wykorzystując i rozszerzając ten cache.
Przy serwowaniu zadaj pytania:
- Czy jedna replika mieści wagi, KV cache, przestrzeń roboczą i docelową współbieżność?
- Czy przepustowość lepiej zapewni większa liczba niezależnych replik, czy sharding jednej repliki?
- Czy TP zmniejsza obciążenie pamięci wag i cache na rangę na tyle, by pokryć koszt komunikacji na każdej warstwie?
- Czy PP jest efektywnie obsługiwane dla modelu i harmonogramu żądań?
- Jak prefill i decode inaczej obciążają obliczenia, przepustowość pamięci i interkonekt?
- Co dzieje się z opóźnieniem ogonowym, gdy żądania mają różną długość wejścia prompt i odpowiedzi?
Dla pierwszego pytania użyj wzoru na KV cache z sekcji o pamięci. Jeśli jedna replika mieści się z miejscem na KV cache przy docelowej współbieżności, uruchom więcej replik; nie potrzebują komunikacji między GPU. Jeśli się nie mieści, najpierw podziel ją przez TP wewnątrz jednego węzła, a PP między węzłami dodaj dopiero wtedy, gdy jeden węzeł nie wystarcza. W vLLM są to --tensor-parallel-size i --pipeline-parallel-size; SGLang i TensorRT-LLM mają te same dwa ustawienia.
Mierz kompletny serwer ze schedulerem, kwantyzacją, rozkładem kontekstu, polityką batchowania i profilem ruchu. Liczba jednostek token na sekundę w treningu nie przewidzi czasu, po którym pojawi się pierwszy token, ani opóźnienia między kolejnymi jednostkami token w serwowaniu.
Co zapisywać dla każdego układu kandydackiego
Dla każdego kandydata zapisz:
- tożsamość modelu, kodu, środowiska uruchomieniowego, kerneli i topologii
- batch globalny i lokalny, rozkład sekwencji oraz liczbę jednostek token
- szczytową pamięć według kategorii, jeśli jest dostępna
- liczbę użytecznych jednostek token na sekundę oraz wykorzystanie operacji zmiennoprzecinkowych modelu (FLOP), jeśli jest liczone spójnie
- czas widoczny w operacjach all-reduce, all-gather, reduce-scatter, all-to-all i point-to-point
- zacięcia wejścia, czas zapisu checkpoint, zachowanie przy restarcie i rozkład maruderów (stragglerów)
- stratę treningową lub zgodność wyników serwowania z punktem odniesienia
Porównuj skalowanie słabe i silne świadomie. Skalowanie silne utrzymuje stałą całkowitą pracę przy rosnącej liczbie rang. Skalowanie słabe utrzymuje stałą pracę na rangę, więc całkowita praca rośnie wraz z liczbą rang. Procent opisany jako „efektywność skalowania” nic nie znaczy bez tego mianownika i punktu odniesienia.
Podsumowanie
Równoległość to odwzorowanie zmierzonego wąskiego gardła na wymiar tensora i wzorzec komunikacji. Replikacja, sharding, podział warstw, etapowanie, podział sekwencji i routing ekspertów odciążają różne ograniczenia i tworzą różne tryby awarii.
Zinwentaryzuj obciążenie, narysuj topologię, wygeneruj poprawne siatki i je sprofiluj. Zwycięski układ to ten, który mieści się z zapasem i minimalizuje widoczną komunikację dla zadania, które uruchamiasz.
Źródła
- Dokumentacja PyTorch FSDP2
fully_shard- Shardowanie parametrów na poziomie modułów, all-gather, reduce-scatter i zachowanie DTensor. - Dokumentacja PyTorch DistributedDataParallel - Trening replikowanego modelu z synchronizowanymi gradientami.
- Dokumentacja PyTorch
torchrun- Uruchamianie jednego procesu na GPU ze zmiennymi środowiskowymi rang. - Strategie równoległości NVIDIA Megatron Core - Wymiary strategii: danych, tensorowa, potokowa, kontekstowa, ekspertów i w pełni shardowana.
- Hugging Face Ultra-Scale Playbook - Interaktywny przegląd równoległości modeli na dużą skalę.
- Skrót Ultra-Scale Playbook - Jednostronicowe podsumowanie playbooka.
- Przewodnik Hugging Face Accelerate po FSDP - Klucze konfiguracji i polecenia uruchamiania dla FSDP.
- Samouczek DeepSpeed ZeRO - Etapy ZeRO i konfiguracja offloadu.
- Artykuł o DeepSpeed ZeRO - Shardowanie stanów optymalizatora, gradientów i parametrów w celu zmniejszenia zużycia pamięci.
- Artykuł o Megatron-LM - Warstwy Transformera równoległe kolumnowo i wierszowo.
- Reducing Activation Recomputation in Large Transformer Models - Równoległość sekwencji w Megatron.
- Artykuł o GPipe - Trening potokowy z mikrobatchami i wykonaniem etapowym.
- Równoległość i skalowanie w vLLM - Ustawienia równoległości tensorowej i potokowej w serwowaniu.
- Mixtral of experts - Łączna i aktywna liczba parametrów dla Mixtral 8x7B.
- Dokumentacja NERSC o równoległości - Definicje skalowania silnego i słabego oparte na stałej pracy całkowitej lub na rangę.