Escalar LLMs com paralelismo multi-GPU e multi-nó

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
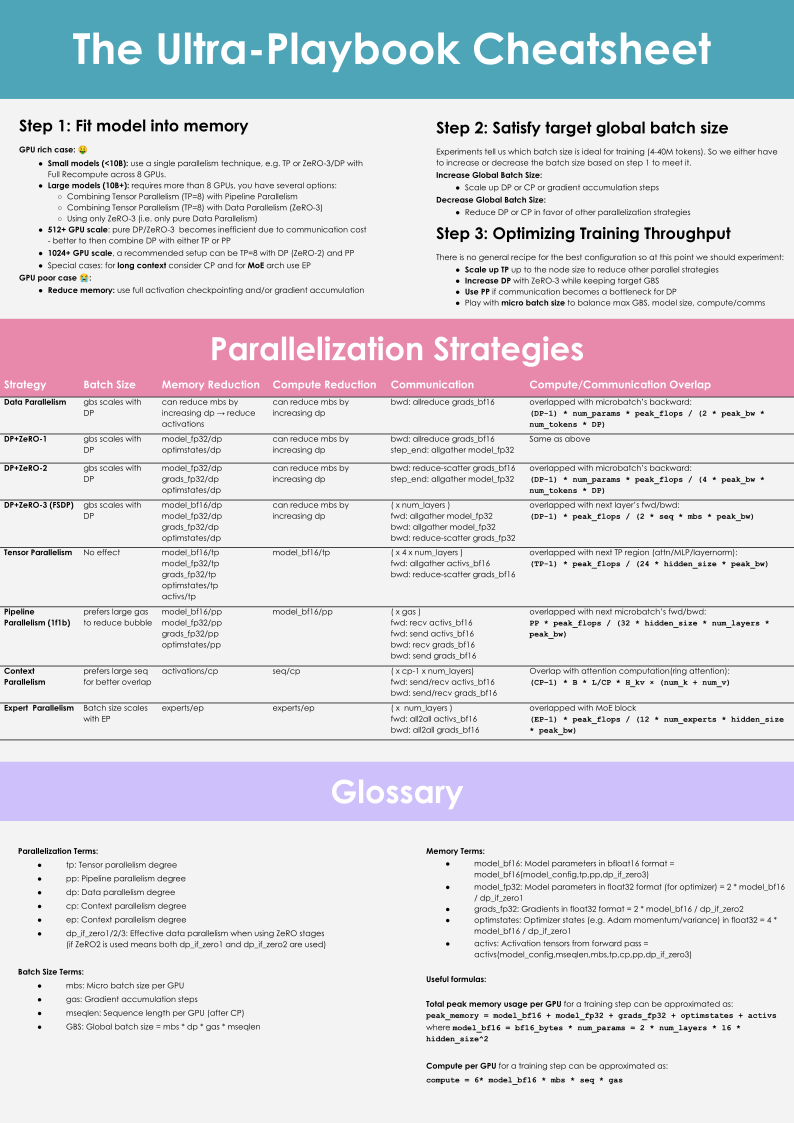
Vai aprender o que cada divisão poupa, o que comunica, que framework a implementa e como montar uma primeira malha candidata no seu cluster. Este artigo destina-se a engenheiros que conhecem backpropagation, camadas Transformer e um ciclo de treino em PyTorch, e que agora precisam de mais do que uma GPU para treinar ou servir um modelo. É um guia prático das principais estratégias de paralelismo, das suas restrições e das ferramentas que as implementam, com base no Ultra-Scale Playbook da Hugging Face.
As cargas de trabalho com modelos grandes deixam de caber numa única GPU por motivos diferentes. Um job de treino pode ficar sem memória por causa do estado do optimizer. Outro pode ficar sem memória por causa das ativações de sequências longas. Um modelo que cabe na memória pode, mesmo assim, não atingir o débito pretendido. Cada problema pede uma partição e um padrão de comunicação diferentes.
Orçamentos de memória no treino e na inferência
O treino e a inferência não têm a mesma ocupação de memória.
training peak ≈ parameters
              + gradients
              + optimizer state
              + saved activations
              + temporary buffers
              + communication buffers
              + allocator headroom

inference peak ≈ resident weights
               + key/value (KV) cache
               + runtime workspace
               + communication buffers
               + allocator headroom
Um modelo com 70 mil milhões de parâmetros tem um limite inferior decimal de 140 GB só para os pesos em BF16. O treino precisa de muito mais. O artigo do ZeRO conta cerca de 16 bytes de estado do modelo por parâmetro para Adam em precisão mista FP16: 2 para os pesos em FP16, 2 para os gradientes em FP16 e 12 para os pesos mestre em FP32 e os dois momentos do Adam. Para 70B de parâmetros, isso dá cerca de 1120 GB antes das ativações. A tabela e o gráfico abaixo usam esta distribuição; a precisão real dos tensores e a política dos pesos mestre podem variar.
O paralelismo de dados replicado (DDP) mantém todo esse estado em cada GPU. A fragmentação (sharding) reparte-o pelas GPUs de um grupo em vez de o copiar. O artigo do ZeRO define três fases: a fase 1 fragmenta o estado do optimizer, a fase 2 fragmenta também os gradientes e a fase 3 fragmenta também os parâmetros. A fase 3 é o que o PyTorch chama paralelismo de dados totalmente fragmentado (FSDP). Para Ψ parâmetros em N GPUs:
model state per GPU (ZeRO paper's FP16 mixed-precision Adam)
DDP      16Ψ
ZeRO-1   4Ψ + 12Ψ / N
ZeRO-2   2Ψ + 14Ψ / N
ZeRO-3   16Ψ / N
Fragmentado por 64 GPUs, o modelo de 70B precisa de cerca de 293 GB por GPU com ZeRO-1, cerca de 155 GB com ZeRO-2 e cerca de 17,5 GB com ZeRO-3 ou FSDP.
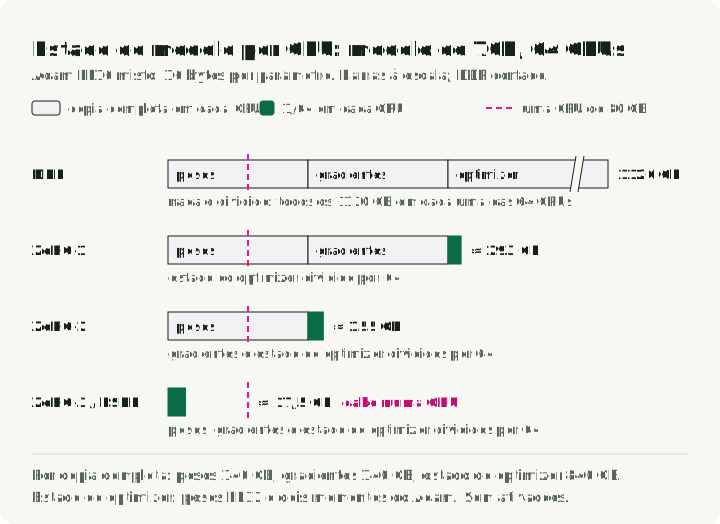
O gráfico divide cada um desses quatro valores na parte que cada GPU copia e na parte que partilha com outras 63, ao lado da memória de uma GPU de 80 GB: só a fragmentação total leva o estado do modelo para baixo desse limite, e o espaço restante fica para ativações e buffers.
A inferência não tem gradientes nem estado do optimizer, mas acrescenta a KV cache, que cresce com cada token que o servidor mantém em memória:
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valueO 2 conta chaves e valores. Para o Llama 3.1 70B em BF16 (80 camadas, 8 cabeças KV, dimensão de cabeça 128), isso dá cerca de 0,33 MB por token, pelo que uma sequência de 32 768 tokens ocupa cerca de 10,7 GB de cache. Multiplique pelo número de sequências em simultâneo para dimensionar um servidor. A política de cache, o comprimento da sequência, a concorrência e a quantização alteram este valor.
O alívio de memória não é um multiplicador fixo. Os valores acima excluem ativações, buffers temporários e de comunicação, e a margem do alocador. O alívio real depende do grau de fragmentação, do que continua replicado, do estado transitório não fragmentado, da política de ativações, do padding, do desequilíbrio e dos buffers.
Faça o profiling da arquitetura, da precisão, do comprimento de sequência, do micro-batch, do optimizer, da política de checkpointing e do runtime exatos. Registe o pico de memória alocada e reservada, os tokens por segundo, o tempo em kernels e o tempo exposto em coletivas. torch.cuda.max_memory_allocated() e torch.cuda.max_memory_reserved() dão os dois picos; o profiler do PyTorch ou o Nsight Systems mostra o tempo de kernels e quanto tempo de NCCL não se sobrepõe à computação.
Como os ranks comunicam
Um rank é um processo de treino, normalmente a controlar uma GPU. Os ranks trocam tensores através de operações coletivas e operações ponto a ponto, que a biblioteca NCCL implementa em GPUs NVIDIA. Cinco aparecem neste artigo; os exemplos de redução usam somas:
- All-reduce: cada rank termina com a soma dos tensores de todos os ranks.
- All-gather: cada rank termina com o fragmento de cada rank.
- Reduce-scatter: cada rank termina com a soma de um fragmento.
- All-to-all: cada rank envia uma parte diferente a todos os outros ranks.
- Ponto a ponto: um rank envia um tensor a um outro rank.
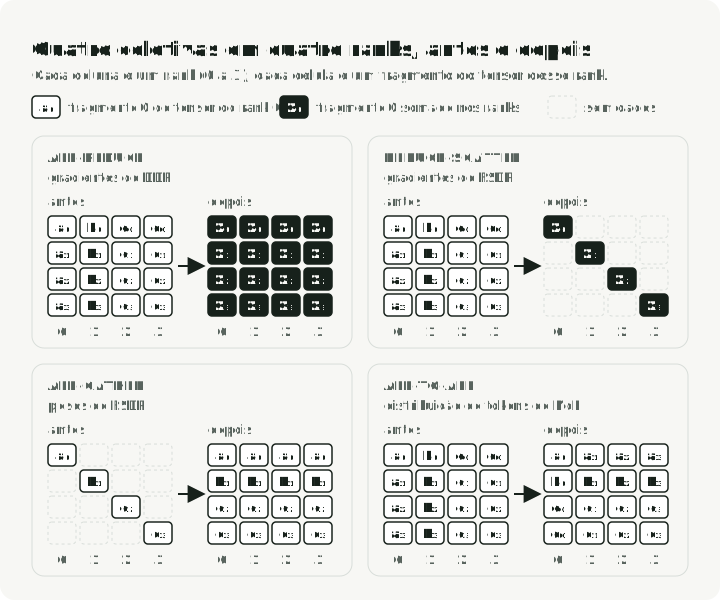
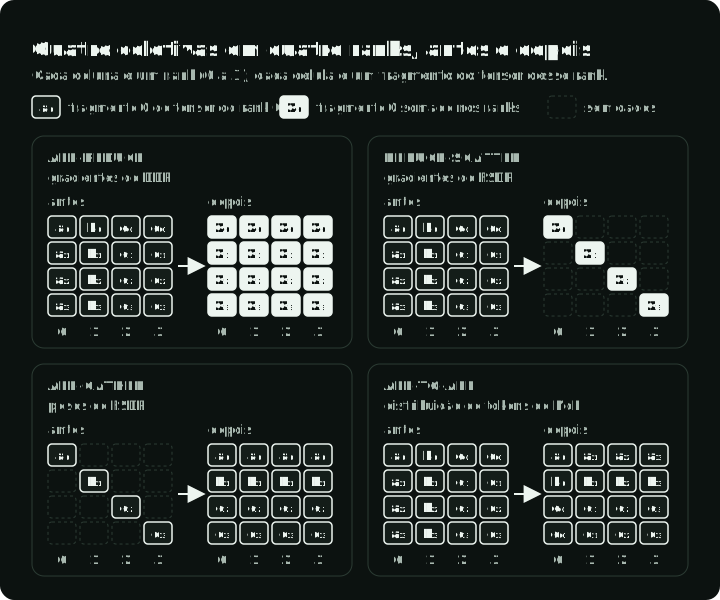
A figura mostra quatro ranks antes e depois de cada uma das primeiras quatro operações, com uma coluna por rank e uma célula por fragmento do seu tensor. Compare o all-reduce com o reduce-scatter: ambos somam entre ranks, mas o reduce-scatter deixa cada rank apenas com o seu fragmento da soma.
O que cada estratégia divide e comunica
Para cada estratégia, pergunte que dimensão do tensor é dividida, que estado fica replicado e que coletiva entra no caminho crítico.
| Estratégia | Divide | Alívio principal | Comunicação introduzida |
|---|---|---|---|
| Paralelismo de dados replicado (DDP) | o batch | débito de treino | all-reduce de gradientes |
| Paralelismo de dados totalmente fragmentado (FSDP) | parâmetros, gradientes e estado do optimizer num grupo de paralelismo de dados (DP) | memória do estado do modelo | all-gather de parâmetros, reduce-scatter de gradientes |
| Paralelismo de tensor (TP) | dimensões de matrizes ou de atenção dentro das camadas | pesos e ativações das camadas | coletivas dentro dos blocos transformer |
| Paralelismo de pipeline (PP) | grupos de camadas | profundidade do modelo e estado por fase | ativações ponto a ponto mais bolhas de escalonamento |
| Paralelismo de contexto (CP) | a dimensão da sequência | memória de ativações de sequências longas | troca de chaves/valores ou de atenção no grupo da sequência |
| Paralelismo de especialistas (EP) | especialistas MoE e tokens encaminhados | capacidade de especialistas por rank | envio e combinação de tokens, normalmente com all-to-all |
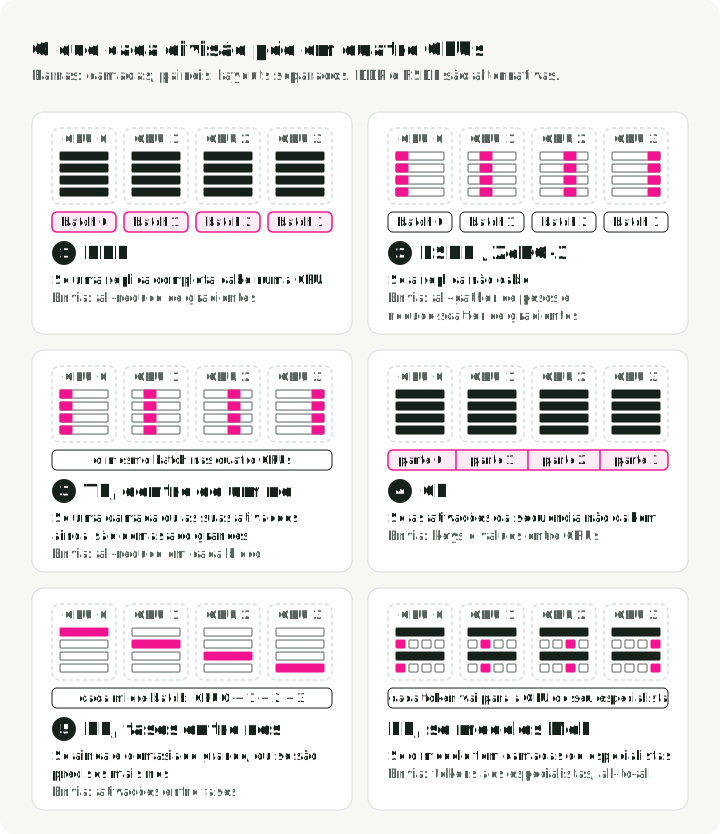
A figura mostra seis layouts separados em quatro GPUs. Escolha DDP quando uma réplica de treino completa cabe com folga, ou FSDP/ZeRO quando o estado do modelo precisa de fragmentação. Acrescente outras divisões apenas para as restrições que resolvem; os painéis não mostram essas combinações. As secções abaixo explicam cada divisão.
Paralelismo de dados (DDP)
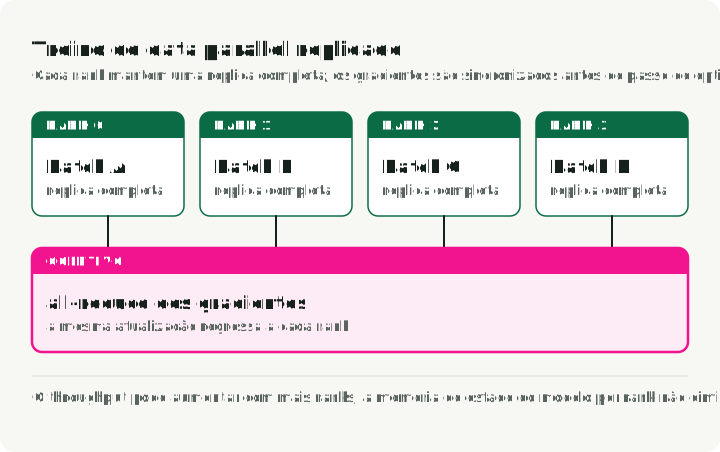
O paralelismo de dados replicado, normalmente chamado distributed data parallel, mantém uma réplica de treino completa em cada rank. A documentação do DistributedDataParallel do PyTorch descreve este modelo de réplica e sincronização de gradientes. Cada rank processa um micro-batch diferente, e os gradientes são sincronizados antes do passo do optimizer.
Use-o quando o estado de treino completo cabe com folga. Cada novo rank acrescenta o seu micro-batch ao batch global, pelo que a receita de treino tem de tolerar um batch global maior, ou então reduz-se a acumulação de gradientes para o manter constante. As suas principais vantagens são a semântica simples e uma implementação madura que sobrepõe a computação do backward à redução de gradientes por buckets.
Acrescentar ranks pode prejudicar quando o batch local fica demasiado pequeno. Também pode prejudicar quando a rede não consegue esconder o all-reduce ou quando a entrega de dados de entrada bloqueia. Batches globais maiores podem dar melhorias cada vez menores no tempo até uma perda pretendida, consumindo mais computação. Compare a perda e o tempo decorrido para a sua receita de treino.
A figura mostra um passo de treino num rank. Os buckets de gradientes passam por all-reduce enquanto o backward corre, e a GPU espera apenas pela parte do all-reduce que a rede não consegue esconder.
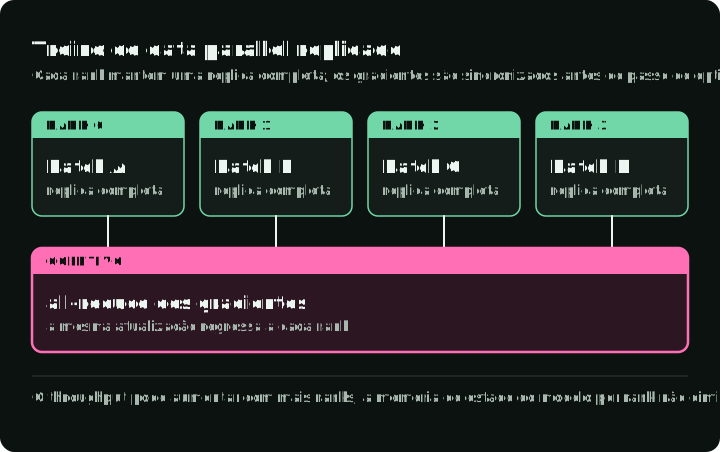
No PyTorch, envolve-se o modelo em DistributedDataParallel e inicia-se um processo por GPU com torchrun, que define RANK, LOCAL_RANK e WORLD_SIZE para cada processo. O Hugging Face Accelerate inicia a mesma configuração a partir de um ficheiro de configuração.
Paralelismo de dados totalmente fragmentado (FSDP, ZeRO)
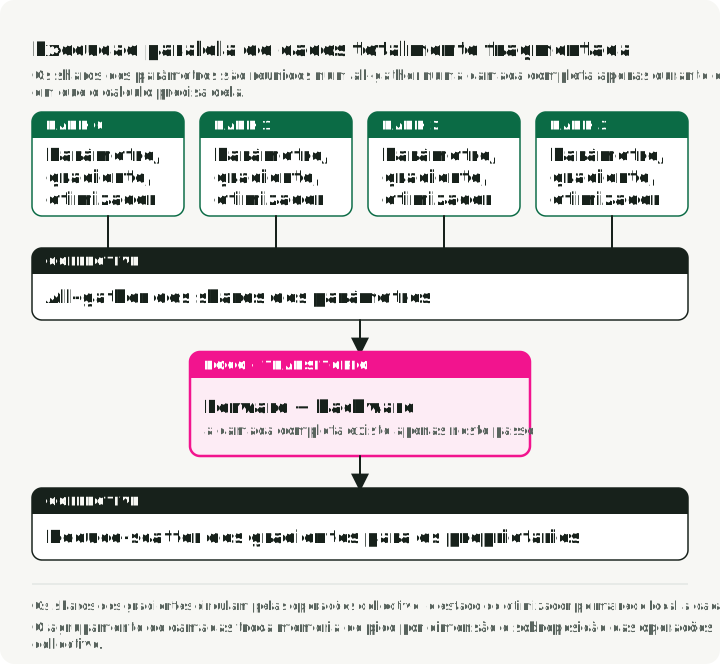
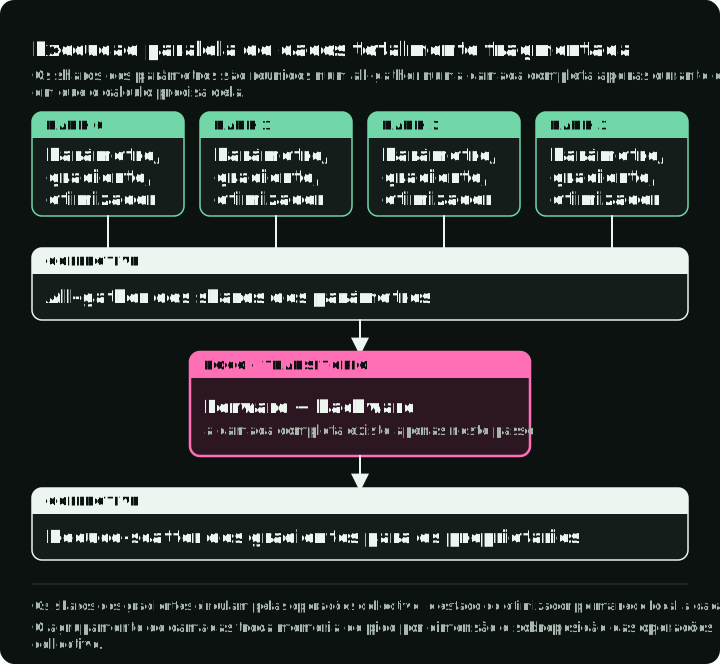
O paralelismo de dados totalmente fragmentado guarda fragmentos de parâmetros, gradientes e estado do optimizer num grupo. O artigo do ZeRO descreve este padrão de fragmentação de estado, e a API FSDP2 do PyTorch implementa-o. Os parâmetros de uma camada são reunidos por all-gather para a computação e podem ser refragmentados depois. Os gradientes são devolvidos aos respetivos donos por reduce-scatter. A figura segue uma camada num de quatro ranks ao longo de um passo de treino: o rank guarda um quarto dos pesos, dos gradientes e do estado do optimizer, um all-gather constrói os pesos completos para o forward e de novo para o backward, e o reduce-scatter deixa ao rank o seu quarto dos gradientes.
O artigo do ZeRO estima o custo da fase 3 em cerca de 1,5 vezes o volume de comunicação do DDP: os parâmetros passam por all-gather no forward e no backward, e os gradientes passam por reduce-scatter uma vez.
A documentação atual do PyTorch distingue a API fully_shard do paralelismo de dados totalmente fragmentado versão 2 (FSDP2) do wrapper FullyShardedDataParallel mais antigo. O FSDP2 agrupa a comunicação pelos módulos a que fully_shard é aplicado e recomenda a aplicação de baixo para cima, para que os grupos de camadas possam sobrepor comunicação e computação.
A ordem das chamadas é a parte fácil de errar. Este excerto fragmenta uma pilha de camadas Transformer com FSDP2:
model = nn.Sequential(*layers).cuda()  # e.g. 24 Transformer layers

for layer in model:  # bottom-up: each layer becomes one communication group
    fully_shard(layer)
fully_shard(model)  # then shard the remaining root parameters

# Build the optimizer after sharding, so it holds the sharded parameters (DTensors).
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
Inicie um processo por GPU com torchrun --nproc_per_node=8 train.py. O pico de memória por rank diminui à medida que o grupo de fragmentação cresce, porque cada rank guarda uma parte menor dos pesos em FP32, dos gradientes e do estado do Adam. As ativações não diminuem, porque cada rank continua a processar o seu próprio batch. O tutorial do FSDP2 tem um script completo com precisão mista e checkpointing. O FSDP2 também tem uma opção reshard_after_forward=False que mantém os parâmetros reunidos entre o passo forward e o backward. Comporta-se como o ZeRO-2: menos all-gathers, mais memória.
A fragmentação é atrativa quando o estado do modelo é a maior parte da memória e a computação das camadas consegue esconder tráfego coletivo suficiente. Pode ser um mau compromisso para modelos pequenos, ligações lentas, camadas minúsculas ou um grupo de fragmentação que atravessa nós numa rede lenta. O DeepSpeed ZeRO implementa as mesmas fases com escolha explícita da fase e descarga opcional do estado para a memória da CPU ou NVMe.
Paralelismo de tensor
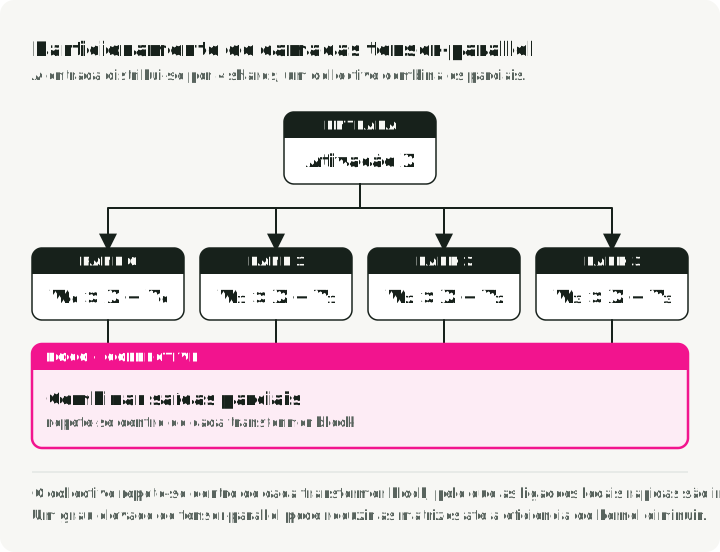
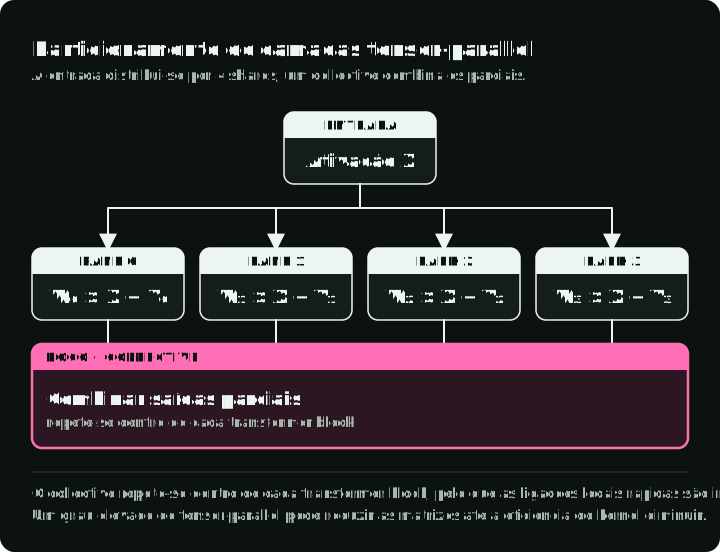
O paralelismo de tensor particiona a álgebra linear dentro de uma camada. Exemplos incluem projeções paralelas por colunas e por linhas. O guia de paralelismo da NVIDIA documenta esta divisão ao nível da camada. Os resultados parciais exigem coletivas dentro dos blocos transformer, pelo que a latência e a largura de banda importam repetidamente ao longo dos passos forward e backward.
A figura mostra a divisão que o artigo do Megatron-LM usa para um MLP de Transformer em dois ranks. A primeira matriz de pesos é dividida por colunas, pelo que cada rank aplica GeLU à sua própria fatia sem comunicação. A segunda matriz é dividida por linhas, pelo que cada rank produz uma soma parcial da saída, e um all-reduce soma-as. Isso é um all-reduce por MLP no passo forward, em vez de um por multiplicação de matrizes.
Use-o quando uma camada ou as suas ativações não cabem, ou quando as multiplicações de matrizes são grandes o suficiente para que os kernels particionados superem um único rank. Mapeie o grupo de paralelismo de tensor para o domínio de comunicação mais rápido disponível e depois meça. Um grau elevado de paralelismo de tensor pode reduzir cada matriz local até a eficiência dos kernels cair enquanto o custo das coletivas aumenta.
O paralelismo de sequência ao estilo Megatron divide ao longo da sequência as ativações das regiões de LayerNorm e dropout, que o TP simples manteria completas em cada rank do grupo TP. Funciona dentro do grupo TP; o paralelismo de contexto divide a sequência inteira, incluindo a atenção, por um grupo separado.
O Megatron Core implementa TP e paralelismo de sequência para treino. O vLLM, o SGLang e o TensorRT-LLM usam TP para fragmentar um modelo no serving.
Paralelismo de pipeline
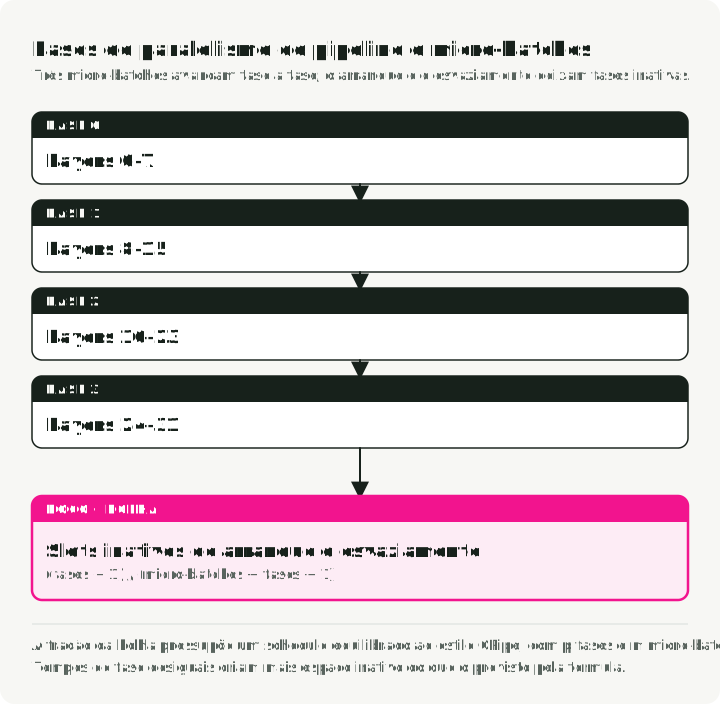
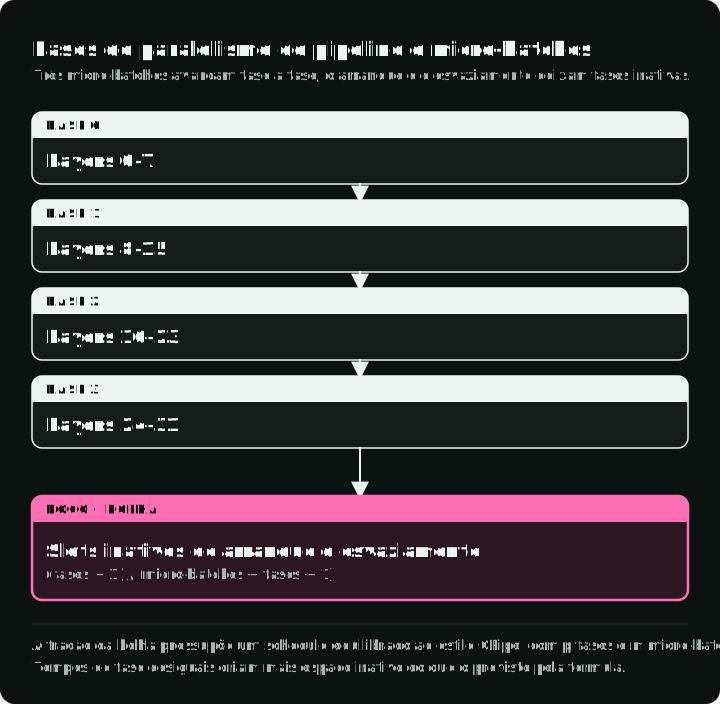
O paralelismo de pipeline coloca grupos de camadas diferentes em fases diferentes e envia ativações entre elas. Os micro-batches mantêm as fases a trabalhar em simultâneo.
Alivia o estado do modelo por fase e pode reduzir o volume de comunicação que atravessa uma fronteira mais lenta, em comparação com as coletivas de tensor por camada. Os seus custos são as bolhas, as transferências de ativações, o desequilíbrio entre fases, um escalonamento mais complexo e uma recuperação e um checkpointing mais difíceis.
A figura mostra o passo forward de quatro fases e quatro micro-batches ao longo de sete passos de tempo e, por baixo, a fração inativa para mais micro-batches. Cada espaço vazio é uma fase sem trabalho: as últimas fases esperam no início e as primeiras fases esperam no fim. Para um escalonamento ao estilo GPipe simples e equilibrado, com p fases e m micro-batches, a fração idealizada da bolha no forward é aproximadamente:
(p - 1) / (m + p - 1)Com 4 fases, 4 micro-batches deixam 3/7, cerca de 43%, do escalonamento forward inativo. 16 micro-batches deixam 3/19, cerca de 16%, e 32 deixam 3/35, cerca de 9%. Mais micro-batches por batch global reduzem a bolha, mas cada um é mais pequeno, pelo que os kernels correm com menos eficiência; meça ambos.
Os escalonamentos reais podem usar uma passagem forward/uma backward alternadas, intercalação ou variantes sem bolhas, e o custo desigual das camadas pode dominar a fórmula. Escolha as fronteiras das fases a partir do tempo e da memória medidos, não de contagens iguais de camadas.
O DeepSpeed, o Megatron Core e o Nanotron implementam escalonamentos de pipeline.
Paralelismo de contexto
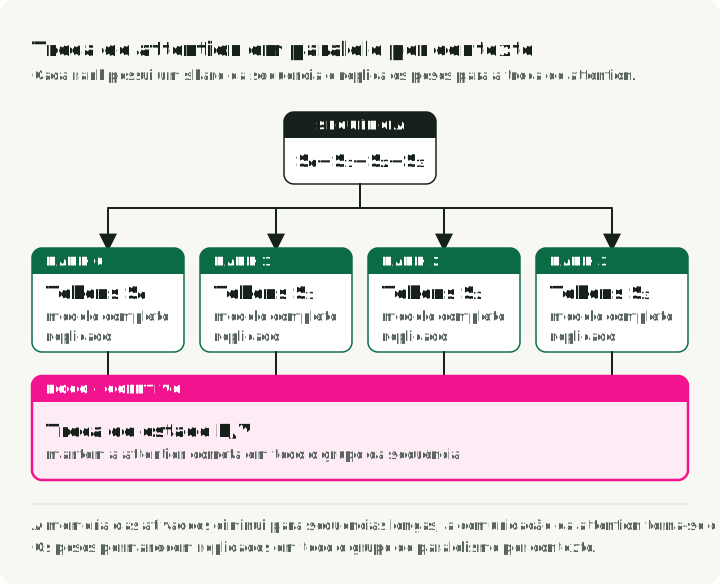
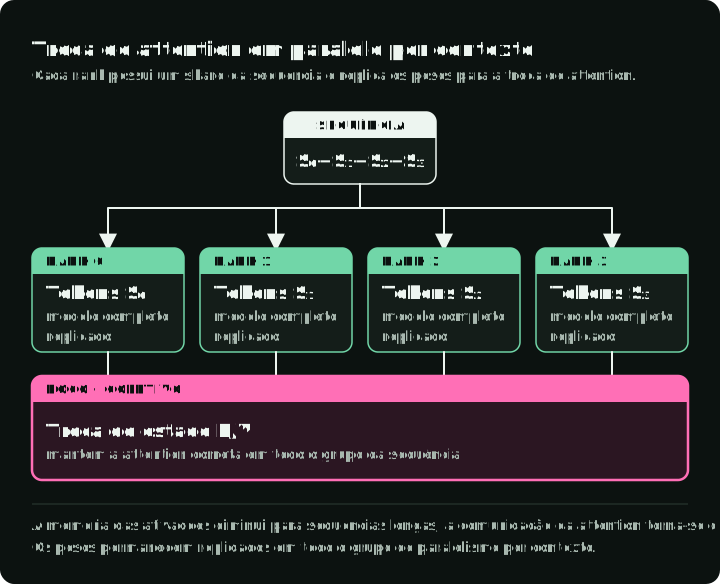
O paralelismo de contexto distribui a dimensão da sequência. A documentação de paralelismo de contexto da NVIDIA descreve a divisão da sequência e a troca de chaves/valores necessária para a atenção. Cada rank é dono de um fragmento da sequência, enquanto a atenção troca a informação necessária para preservar a semântica de contexto completo. As implementações podem usar anéis ponto a ponto, all-gather, all-to-all ou combinações hierárquicas.
Reduz a memória de ativações no treino de contexto longo, mas replica os pesos pelo grupo de contexto e introduz comunicação de atenção. O benefício depende do tipo de atenção, da máscara causal, do comprimento da sequência, da recomputação e de como os grupos de contexto se compõem com os grupos de tensor e de dados.
Não o escolha a partir de um limiar universal de 8K, 32K ou 100K. Considere-o quando as ativações ainda excedem a memória no comprimento de sequência pretendido depois do activation checkpointing e do paralelismo de tensor mais paralelismo de sequência, e os pesos já cabem.
O Megatron Core implementa CP para treino. O Picotron tem uma implementação pequena de paralelismo de dados, tensor, pipeline e contexto, útil para aprender como se encaixam.
Paralelismo de especialistas para modelos MoE
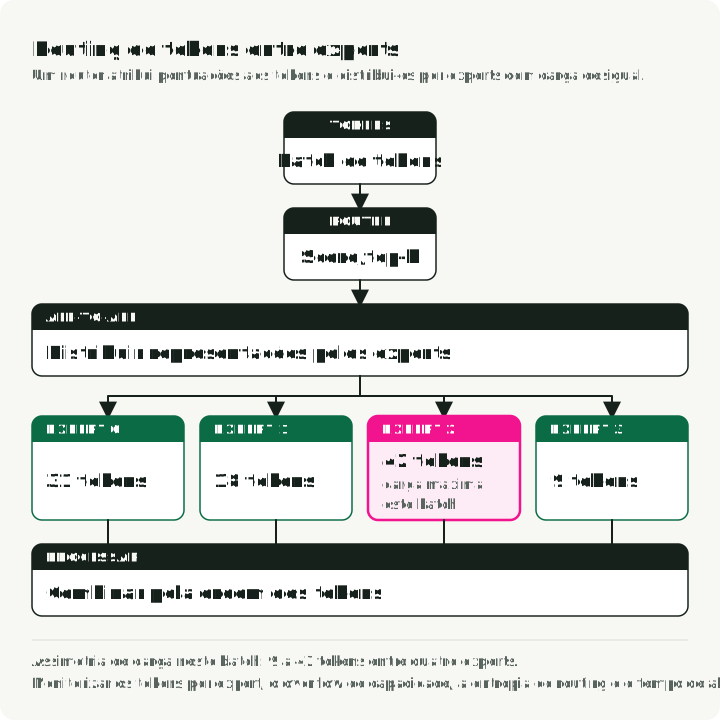
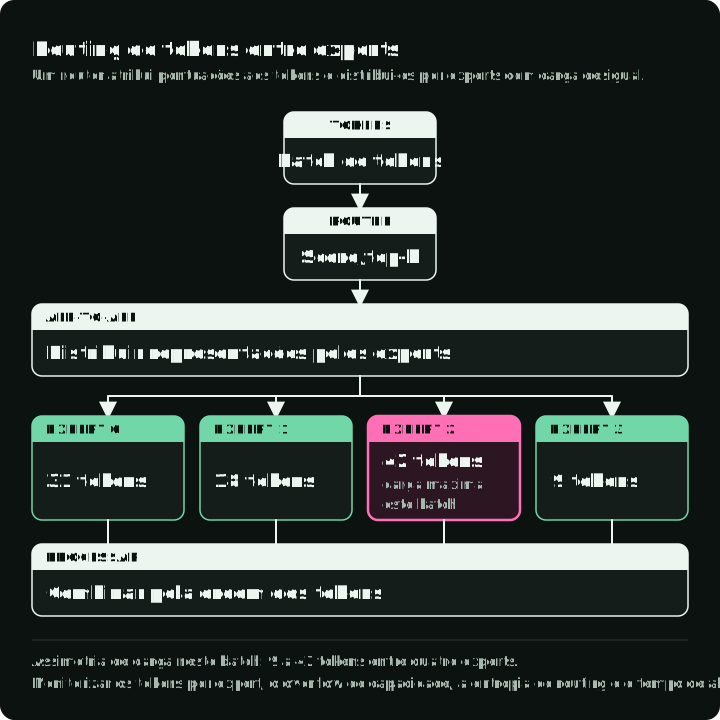
O paralelismo de especialistas distribui os especialistas das camadas de mixture-of-experts. O Mixtral 8x7B, por exemplo, guarda cerca de 46,7B de parâmetros, mas usa cerca de 12,9B por token. O guia de paralelismo da NVIDIA documenta esta colocação de especialistas e a sua combinação com outras dimensões paralelas. O router envia representações de tokens para os especialistas selecionados e combina os resultados. Só os especialistas selecionados computam para cada token, mas o total de pesos dos especialistas continua a exigir armazenamento e colocação no serving.
O paralelismo de especialistas não é uma opção de otimização para um modelo denso. Faz parte de uma arquitetura MoE. As suas preocupações incluem o equilíbrio de carga, os limites de capacidade, o all-to-all de tokens, os tokens descartados, o padding, as perdas auxiliares e o desvio por falhas. As definições MoE do Megatron distinguem o descarte de atribuições acima da capacidade de um especialista do preenchimento de posições não utilizadas abaixo dela. O encaminhamento sem descarte processa quantidades variáveis de tokens. Acompanhe os tokens por especialista, a entropia do encaminhamento, o excesso de capacidade, o tempo de comunicação e a qualidade por rota.
O Megatron Core e o Nanotron implementam EP para treino.
Compor um layout a partir da topologia
Os sistemas de treino de modelos densos de grande escala sem grupo de paralelismo de especialistas usam normalmente um produto dos tamanhos dos grupos de paralelismo de dados (DP), de tensor (TP), de pipeline (PP) e de contexto (CP):
world size = DP × TP × PP × CPQuando o paralelismo de especialistas (EP) é um grupo independente, o guia de paralelismo da NVIDIA calcula o total como:
total GPUs = TP × PP × CP × EP × DPVerifique que ordens e tamanhos de grupos o seu framework suporta antes de escolher os graus.
Construa o layout por esta ordem:
- Desenhe os domínios de comunicação: ligações GPU a GPU, switches, fronteiras de acesso não uniforme à memória (NUMA), fabric entre nós, oversubscription e caminho de armazenamento. Na maioria dos servidores de GPU, o domínio mais rápido é o NVLink entre as GPUs de um nó; os nós ligam-se por uma rede mais lenta, como InfiniBand.
- Coloque as coletivas frequentes e sensíveis à latência, normalmente TP, no domínio adequado mais rápido. Isto significa, em geral, manter cada grupo TP dentro de um nó.
- Escolha grupos FSDP ou DP replicados a partir da capacidade e da largura de banda restantes.
- Acrescente PP quando a colocação em profundidade ou o tráfego entre domínios beneficiar, equilibrando o tempo e a memória medidos por fase.
- Acrescente CP apenas pela restrição da sequência, e EP apenas pela topologia de especialistas do modelo.
- Confirme a divisibilidade de cabeças, dimensões ocultas, camadas, especialistas, batch e sequência para a malha candidata.
- Faça o benchmark de várias malhas válidas. As heurísticas sensíveis à topologia escolhem candidatas, não vencedoras.
Um exemplo de candidata para um modelo denso de 70B com contexto de 32K em 64 nós de 8 GPUs: TP=8 dentro de cada nó sobre NVLink, PP=4 entre nós, CP=4 para a sequência longa e DP=4 para o resto; 8 × 4 × 4 × 4 = 512 GPUs. Compare-a com TP=8, PP=8, CP=2, DP=4 antes de escolher.
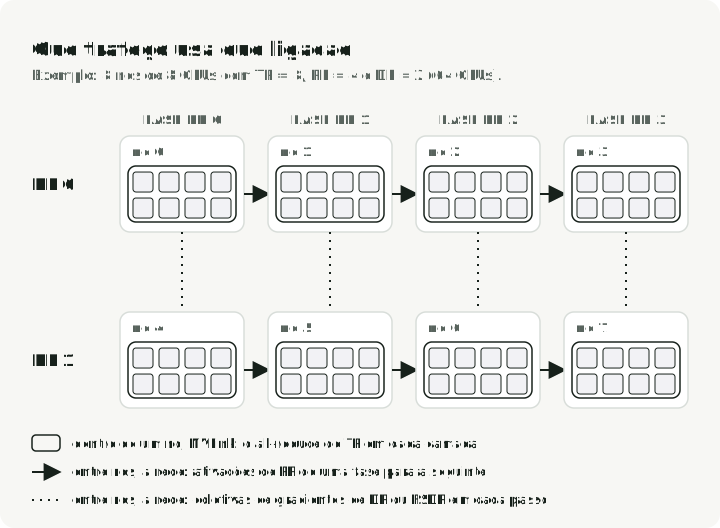
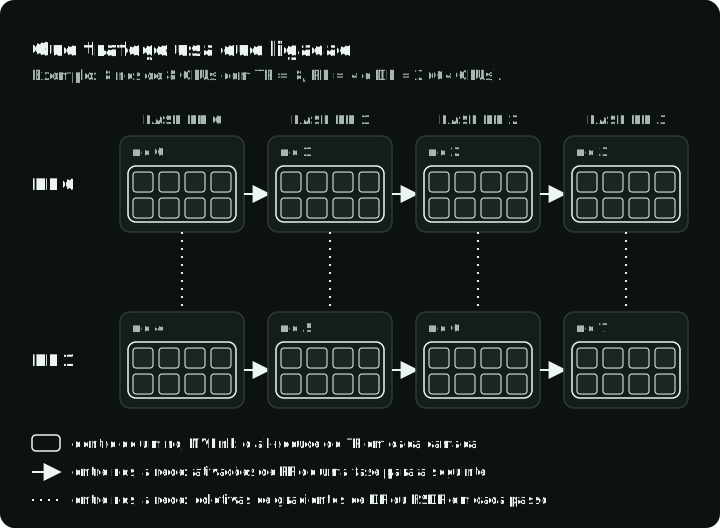
A figura mostra para onde vai o tráfego de cada grupo num layout deste tipo: o all-reduce de TP fica no NVLink dentro de um nó, enquanto as coletivas de gradientes de FSDP ou DP e as ativações de PP atravessam a rede entre nós.
Candidatas iniciais por tamanho de cluster, para fazer benchmark e não para adotar sem mais:
- Um nó, 2–8 GPUs. DDP quando uma réplica de treino completa cabe com folga; FSDP2 ou DeepSpeed ZeRO-2/3 quando o estado do modelo precisa de fragmentação. Inicie com
torchrunou Accelerate. Acrescente TP=2 só se uma camada ou as suas ativações continuarem a não caber. Em GPUs ligadas por PCIe sem NVLink, mantenha o TP em 1 ou 2, porque o all-reduce de cada camada atravessa o PCIe. - 2–16 nós. TP dentro de cada nó (4 ou 8 com NVLink), FSDP ou DP entre nós, e PP entre nós só se o modelo continuar a não caber.
- Centenas de GPUs ou mais. TP × PP × CP × DP, como no exemplo acima, com um framework que implemente os quatro, como o Megatron Core.
Dois clusters com o mesmo número de GPUs podem preferir layouts diferentes, porque a largura de banda das ligações, a hierarquia de switches, a ligação à CPU e a contenção na rede diferem.
Que framework implementa cada divisão
As divisões acima são implementadas por um pequeno conjunto de bibliotecas. Escolha pelas divisões de que precisa e pela parte do ciclo de treino que quer controlar.
| Ferramenta | Divisões que suporta | Use quando |
|---|---|---|
| Hugging Face Accelerate | inicia DDP, FSDP ou DeepSpeed a partir de um ficheiro de configuração | quer levar um script PyTorch ou Transformers existente para várias GPUs com poucas alterações |
| PyTorch DDP e FSDP2 | DDP, FSDP (fully_shard), com torchrun | treina um modelo denso num nó ou em poucos nós e quer PyTorch simples |
| DeepSpeed ZeRO | fases ZeRO 1, 2, 3, descarga para CPU e NVMe, PP | quer escolher a fase de fragmentação, ou descarregar o estado para a memória da CPU ou NVMe |
| Megatron Core | TP, PP, CP, EP, DP e paralelismo de sequência | precisa de TP, PP e CP (e EP) em conjunto para grandes execuções de pré-treino |
| Nanotron | DP, TP, PP, EP, ZeRO-1 | quer uma base de código mais pequena do que o Megatron para paralelismo 3D e MoE |
| vLLM, SGLang, TensorRT-LLM | TP e PP para inferência | serve o modelo; veja a secção de serving abaixo |
Para executar um script existente com FSDP2 através do Accelerate, execute accelerate config uma vez; escreve o ficheiro de configuração de forma interativa. Estas definições selecionam FSDP2, o agrupamento por camadas do descodificador e a refragmentação:
fsdp_config:
    fsdp_version: 2
    fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP
    fsdp_transformer_layer_cls_to_wrap: LlamaDecoderLayer
    fsdp_reshard_after_forward: true
Com fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP, fsdp_transformer_layer_cls_to_wrap indica a classe de bloco que passa a ser uma unidade FSDP, o mesmo agrupamento de baixo para cima do ciclo fully_shard acima. fsdp_reshard_after_forward: true é a fragmentação total; false é o modo semelhante ao ZeRO-2. Inicie o job com accelerate launch --config_file fsdp2.yaml train.py. O guia FSDP1/FSDP2 explica estas definições específicas de cada versão e o comando accelerate to-fsdp2, que converte uma configuração FSDP1 mais antiga.
O treino e o serving exigem decisões separadas
A inferência normalmente não tem gradientes nem estado do optimizer, pelo que os layouts de treino ao estilo FSDP não se transferem automaticamente.
O prefill processa o prompt e guarda as chaves e os valores dos seus tokens na KV cache. A descodificação gera os tokens seguintes, reutilizando e ampliando essa cache.
Para o serving, pergunte:
- Uma réplica comporta os pesos, a KV cache, o workspace e a concorrência pretendida?
- O débito é melhor servido por mais réplicas independentes ou por fragmentar uma réplica?
- O TP reduz o suficiente a pressão de pesos e de cache por rank para compensar a comunicação por camada?
- O PP é suportado de forma eficiente para o modelo e para o escalonador de pedidos?
- Como é que o prefill e o decode pressionam de forma diferente a computação, a largura de banda de memória e a interligação?
- O que acontece à latência de cauda quando os pedidos têm comprimentos de prompt e de saída diferentes?
Use a fórmula da KV cache da secção de memória para a primeira pergunta. Se uma réplica cabe com espaço para a KV cache na concorrência pretendida, execute mais réplicas; não precisam de comunicação entre GPUs. Se não cabe, fragmente-a primeiro com TP dentro de um nó e acrescente PP entre nós só quando um nó não chegar. No vLLM são --tensor-parallel-size e --pipeline-parallel-size; o SGLang e o TensorRT-LLM têm as mesmas duas definições.
Faça o benchmark do servidor completo, com o escalonador, a quantização, a distribuição de contexto, a política de batching e o perfil de tráfego. Os tokens por segundo no treino não permitem prever o tempo até ao primeiro token nem a latência entre tokens no serving.
O que registar para cada layout candidato
Para cada candidato, registe:
- identidade do modelo, do código, do runtime, dos kernels e da topologia
- batch global e local, distribuição de sequências e contagem de tokens
- pico de memória por categoria, quando disponível
- tokens úteis por segundo e utilização de operações de vírgula flutuante (FLOP) do modelo, quando calculada de forma consistente
- tempo exposto em all-reduce, all-gather, reduce-scatter, all-to-all e operações ponto a ponto
- bloqueios de entrada de dados, tempo de checkpoint, comportamento no reinício e distribuição de stragglers
- perda de treino ou paridade da saída no serving face à referência
Compare a escalabilidade fraca e a forte de forma deliberada. A escalabilidade forte mantém constante o trabalho total à medida que o número de ranks aumenta. A escalabilidade fraca mantém constante o trabalho por rank, pelo que o trabalho total cresce com o número de ranks. Uma percentagem rotulada “eficiência de escalabilidade” não tem significado sem esse denominador e essa referência.
Conclusão
O paralelismo é um mapeamento entre um gargalo medido, uma dimensão do tensor e um padrão de comunicação. A replicação, a fragmentação, a partição por camadas, o faseamento, a partição da sequência e o encaminhamento de especialistas aliviam, cada um, uma restrição diferente e criam um modo de falha diferente.
Faça o inventário da carga de trabalho, desenhe a topologia, gere malhas válidas e faça o profiling delas. O layout vencedor é o que cabe com folga e minimiza a comunicação exposta para o job que executa.
Referências
- Documentação
fully_sharddo FSDP2 do PyTorch - Fragmentação de parâmetros por módulo, all-gathers, reduce-scatters e comportamento de DTensor. - Documentação do PyTorch DistributedDataParallel - Treino de modelo replicado com gradientes sincronizados.
- Documentação do
torchrundo PyTorch - Início de um processo por GPU com variáveis de ambiente de rank. - Estratégias de paralelismo do NVIDIA Megatron Core - Dimensões de estratégia de dados, tensor, pipeline, contexto, especialistas e totalmente fragmentada.
- Hugging Face Ultra-Scale Playbook - Visão geral interativa do paralelismo de modelos em grande escala.
- Cheat sheet do Ultra-Scale Playbook - Resumo do playbook numa página.
- Guia de FSDP do Hugging Face Accelerate - Chaves de configuração e comandos de arranque para FSDP.
- Tutorial do DeepSpeed ZeRO - Fases do ZeRO e configuração de descarga.
- Artigo do DeepSpeed ZeRO - Fragmentação de estados do optimizer, gradientes e parâmetros para reduzir o uso de memória.
- Artigo do Megatron-LM - Camadas Transformer paralelas por colunas e por linhas.
- Reducing Activation Recomputation in Large Transformer Models - Paralelismo de sequência do Megatron.
- Artigo do GPipe - Treino em pipeline com micro-batches e execução por fases.
- Paralelismo e escalabilidade no vLLM - Definições de serving com paralelismo de tensor e de pipeline.
- Mixtral of experts - Contagens de parâmetros totais e ativos do Mixtral 8x7B.
- Documentação de paralelismo do NERSC - Definições de escalabilidade forte e fraca com base em trabalho total fixo ou por rank.