Escalado de LLMs con paralelismo multi-GPU y multinodo

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
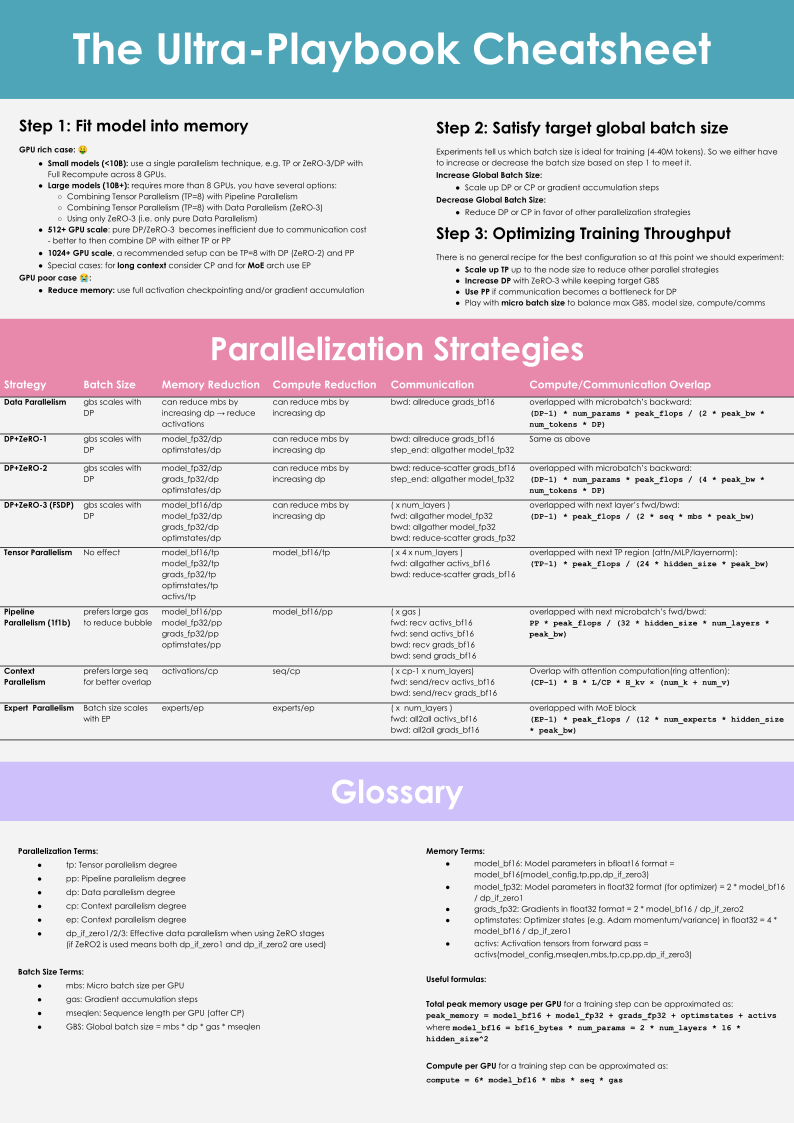
Aprenderás qué ahorra cada partición, qué comunica, qué framework la implementa y cómo plantear una primera malla candidata en tu clúster. Este artículo está pensado para ingenieros que conocen la backpropagation, las capas Transformer y un bucle de entrenamiento de PyTorch, y que ahora necesitan más de una GPU para entrenar o servir un modelo. Es un recorrido práctico por las principales estrategias de paralelismo, sus restricciones y las herramientas que las implementan, basado en el Ultra-Scale Playbook de Hugging Face.
Las cargas de trabajo con modelos grandes superan una sola GPU por motivos distintos. Un trabajo de entrenamiento puede quedarse sin memoria por el estado del optimizador. Otro puede quedarse sin ella por las activaciones de secuencias largas. Un modelo que cabe puede aun así no alcanzar su objetivo de throughput. Cada problema exige una partición y un patrón de comunicación diferentes.
Presupuestos de memoria en entrenamiento e inferencia
El entrenamiento y la inferencia no tienen la misma huella de memoria.
training peak ≈ parameters
              + gradients
              + optimizer state
              + saved activations
              + temporary buffers
              + communication buffers
              + allocator headroom

inference peak ≈ resident weights
               + key/value (KV) cache
               + runtime workspace
               + communication buffers
               + allocator headroom
Un modelo de 70 000 millones de parámetros tiene un límite inferior decimal de 140 GB solo para los pesos en BF16. El entrenamiento necesita mucho más. El artículo de ZeRO cuenta unos 16 bytes de estado del modelo por parámetro para Adam con precisión mixta FP16: 2 para los pesos en FP16, 2 para los gradientes en FP16 y 12 para los pesos maestros en FP32 y los dos momentos de Adam. Para 70B parámetros son unos 1120 GB antes de contar las activaciones. La tabla y el gráfico siguientes usan esta distribución; la precisión real de los tensores y la política de pesos maestros pueden variar.
El paralelismo de datos replicado (DDP) mantiene todo ese estado en cada GPU. La fragmentación lo reparte entre las GPUs de un grupo en lugar de copiarlo. El artículo de ZeRO define tres etapas: la etapa 1 fragmenta el estado del optimizador, la etapa 2 fragmenta además los gradientes y la etapa 3 fragmenta también los parámetros. La etapa 3 es lo que PyTorch llama paralelismo de datos totalmente fragmentado (FSDP). Para Ψ parámetros en N GPUs:
model state per GPU (ZeRO paper's FP16 mixed-precision Adam)
DDP      16Ψ
ZeRO-1   4Ψ + 12Ψ / N
ZeRO-2   2Ψ + 14Ψ / N
ZeRO-3   16Ψ / N
Repartido entre 64 GPUs, el modelo de 70B necesita unos 293 GB por GPU con ZeRO-1, unos 155 GB con ZeRO-2 y unos 17,5 GB con ZeRO-3 o FSDP.
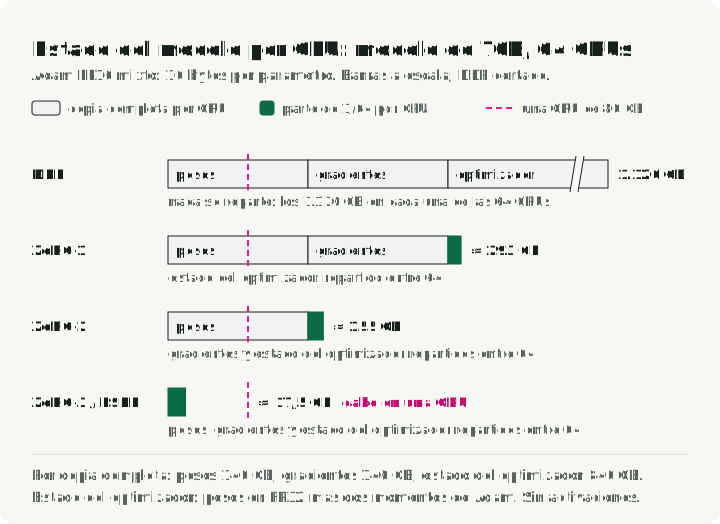
El gráfico divide cada una de esas cuatro cifras en la parte que cada GPU copia y la parte que comparte con otras 63, junto a la memoria de una GPU de 80 GB: solo la fragmentación completa deja el estado del modelo por debajo de ese límite, y el espacio restante se reserva para activaciones y buffers.
La inferencia no lleva gradientes ni estado del optimizador, pero añade la KV cache, que crece con cada token que el servidor mantiene en memoria:
KV bytes per token = 2 × layers × KV heads × head dimension × bytes per valueEl 2 cuenta las claves y los valores. Para Llama 3.1 70B en BF16 (80 capas, 8 cabezas KV, dimensión de cabeza 128), son unos 0,33 MB por token, así que una secuencia de 32 768 tokens ocupa unos 10,7 GB de caché. Multiplica por el número de secuencias concurrentes para dimensionar un servidor. La política de caché, la longitud de secuencia, la concurrencia y la cuantización modifican esta cifra.
El alivio de memoria no es un multiplicador fijo. Las cifras anteriores excluyen las activaciones, los buffers temporales y de comunicación, y el margen del asignador de memoria. El alivio real depende del grado de fragmentación, de lo que sigue replicado, del estado transitorio sin fragmentar, de la política de activaciones, del padding, del desequilibrio y de los buffers.
Perfila la arquitectura, la precisión, la longitud de secuencia, el micro-batch, el optimizador, la política de checkpointing y el runtime exactos. Registra la memoria máxima asignada y reservada, los tokens por segundo, el tiempo en kernels y el tiempo expuesto en operaciones colectivas. torch.cuda.max_memory_allocated() y torch.cuda.max_memory_reserved() dan los dos picos; el profiler de PyTorch o Nsight Systems muestra el tiempo de kernels y cuánto tiempo de NCCL no se solapa con el cómputo.
Cómo se comunican los ranks
Un rank es un proceso de entrenamiento, normalmente asociado a una GPU. Los ranks intercambian tensores mediante operaciones colectivas y operaciones punto a punto, que la biblioteca NCCL implementa en las GPUs de NVIDIA. En este artículo aparecen cinco; los ejemplos de reducción usan sumas:
- All-reduce: cada rank acaba con la suma de los tensores de todos los ranks.
- All-gather: cada rank acaba con el fragmento de cada rank.
- Reduce-scatter: cada rank acaba con la suma de un fragmento.
- All-to-all: cada rank envía una pieza distinta a cada uno de los demás ranks.
- Point-to-point: un rank envía un tensor a otro rank.
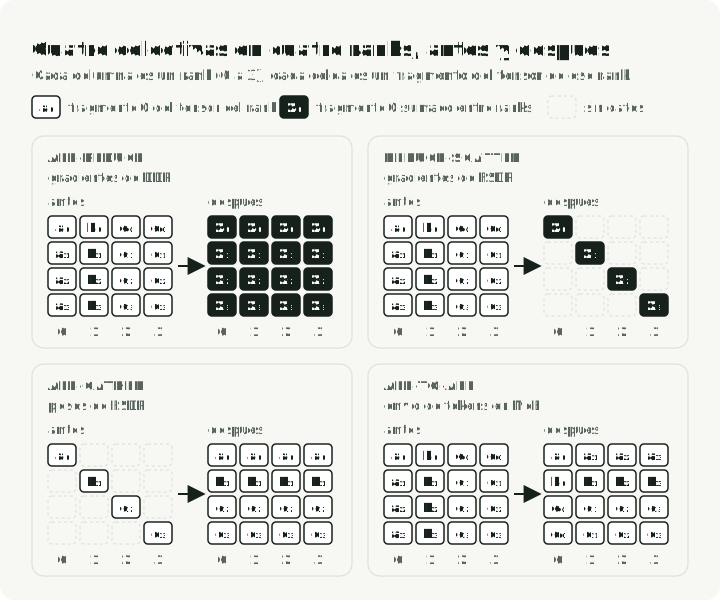
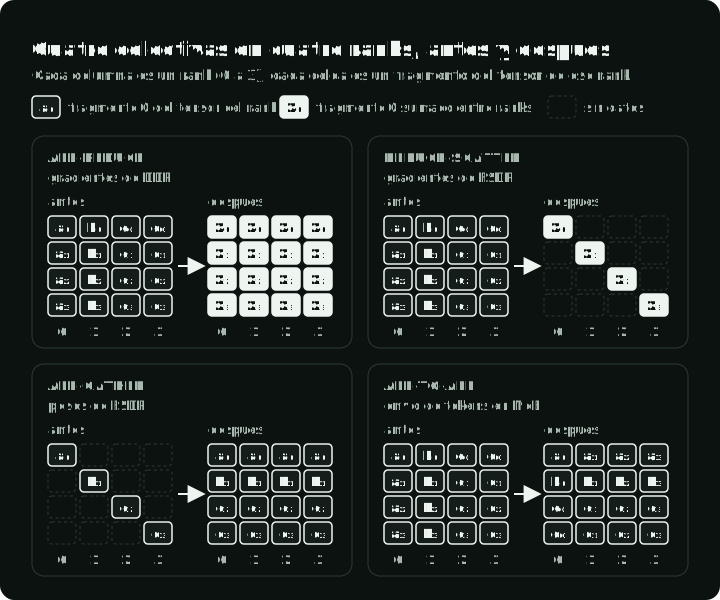
La figura muestra cuatro ranks antes y después de cada una de las cuatro primeras operaciones, con una columna por rank y una celda por fragmento de su tensor. Compara all-reduce con reduce-scatter: ambas suman entre ranks, pero reduce-scatter deja a cada rank solo con su propio fragmento de la suma.
Qué divide y qué comunica cada estrategia
Para cada estrategia, pregunta qué dimensión del tensor se divide, qué estado sigue replicado y qué operación colectiva entra en el camino crítico.
| Estrategia | Qué divide | Alivio principal | Comunicación que introduce |
|---|---|---|---|
| Paralelismo de datos replicado (DDP) | el batch | throughput de entrenamiento | all-reduce de gradientes |
| Paralelismo de datos totalmente fragmentado (FSDP) | parámetros, gradientes y estado del optimizador entre un grupo de paralelismo de datos (DP) | memoria del estado del modelo | all-gather de parámetros, reduce-scatter de gradientes |
| Paralelismo tensorial (TP) | dimensiones de matrices o de atención dentro de las capas | pesos y activaciones de las capas | operaciones colectivas dentro de los bloques transformer |
| Paralelismo de pipeline (PP) | grupos de capas | profundidad del modelo y estado por etapa | activaciones punto a punto y burbujas de planificación |
| Paralelismo de contexto (CP) | la dimensión de secuencia | memoria de activaciones en secuencias largas | intercambio de claves/valores o de atención dentro del grupo de secuencia |
| Paralelismo de expertos (EP) | expertos MoE y tokens enrutados | capacidad de expertos por rank | dispatch y combine de tokens, normalmente con all-to-all |
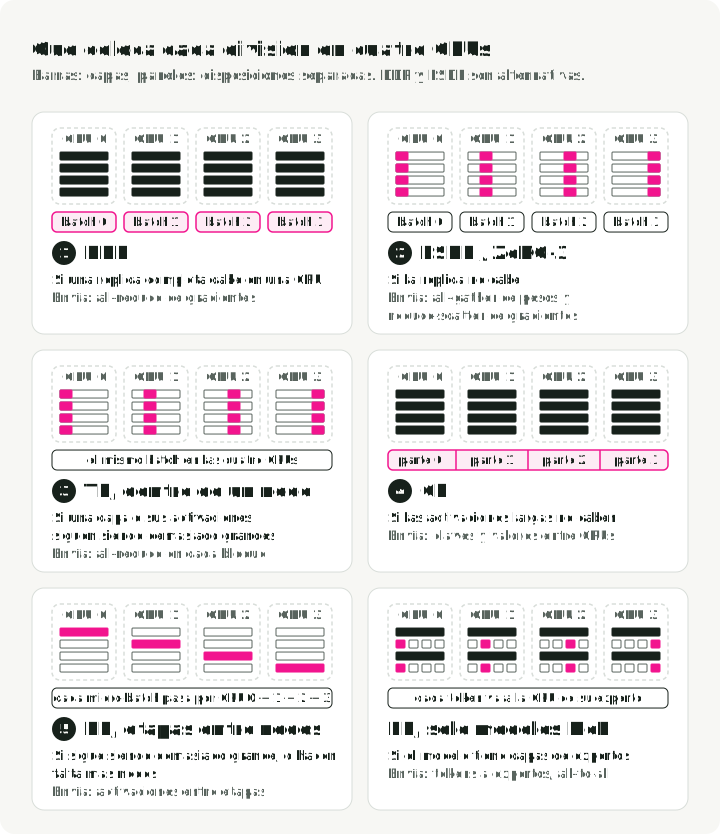
La figura muestra seis disposiciones independientes en cuatro GPUs. Elige DDP cuando cabe una réplica completa de entrenamiento con margen, o FSDP/ZeRO cuando hay que fragmentar el estado del modelo. Añade otras divisiones solo para las restricciones que resuelven; los paneles no muestran esas combinaciones. Las secciones siguientes explican cada división.
Paralelismo de datos (DDP)
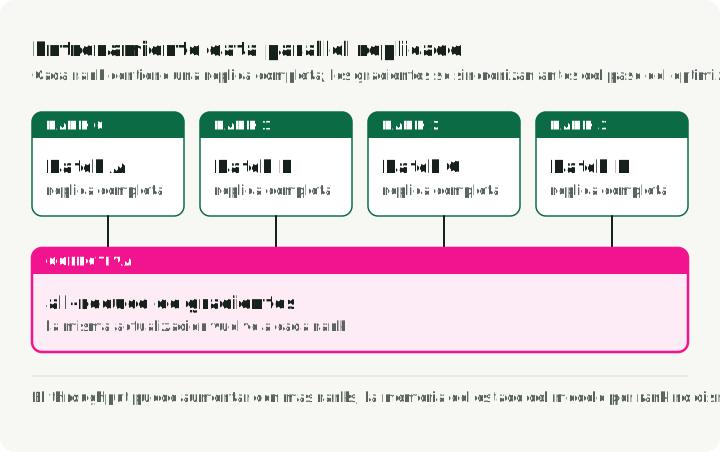
El paralelismo de datos replicado, que suele llamarse distributed data parallel, mantiene una réplica completa del entrenamiento en cada rank. La documentación de DistributedDataParallel de PyTorch describe este modelo de réplica y sincronización de gradientes. Cada rank procesa un micro-batch distinto y los gradientes se sincronizan antes del paso del optimizador.
Úsalo cuando todo el estado de entrenamiento cabe con margen. Cada rank nuevo añade su micro-batch al batch global, así que o tu receta de entrenamiento tolera un batch global mayor, o reduces la acumulación de gradientes para mantenerlo constante. Sus principales ventajas son una semántica simple y una implementación madura que solapa el cálculo del backward con la reducción de gradientes por buckets.
Añadir ranks puede perjudicar cuando el batch local se vuelve demasiado pequeño. También puede perjudicar cuando la red no logra ocultar el all-reduce o cuando la entrega de datos de entrada se retrasa. Los batches globales mayores pueden ofrecer mejoras cada vez menores en el tiempo hasta una pérdida objetivo mientras consumen más cómputo. Compara la pérdida y el tiempo transcurrido para tu receta de entrenamiento.
La figura muestra un paso de entrenamiento en un rank. Los buckets de gradientes se reducen con all-reduce mientras se ejecuta el backward, y la GPU espera solo la parte del all-reduce que la red no logra ocultar.
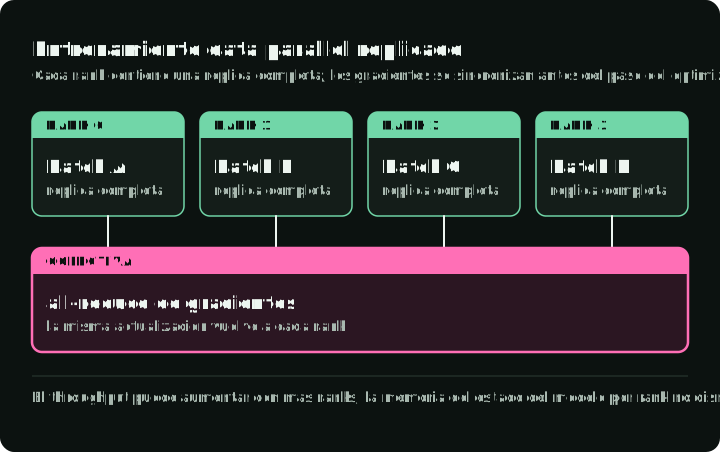
En PyTorch envuelves el modelo en DistributedDataParallel y lanzas un proceso por GPU con torchrun, que define RANK, LOCAL_RANK y WORLD_SIZE para cada proceso. Hugging Face Accelerate lanza la misma configuración desde un archivo de configuración.
Paralelismo de datos totalmente fragmentado (FSDP, ZeRO)
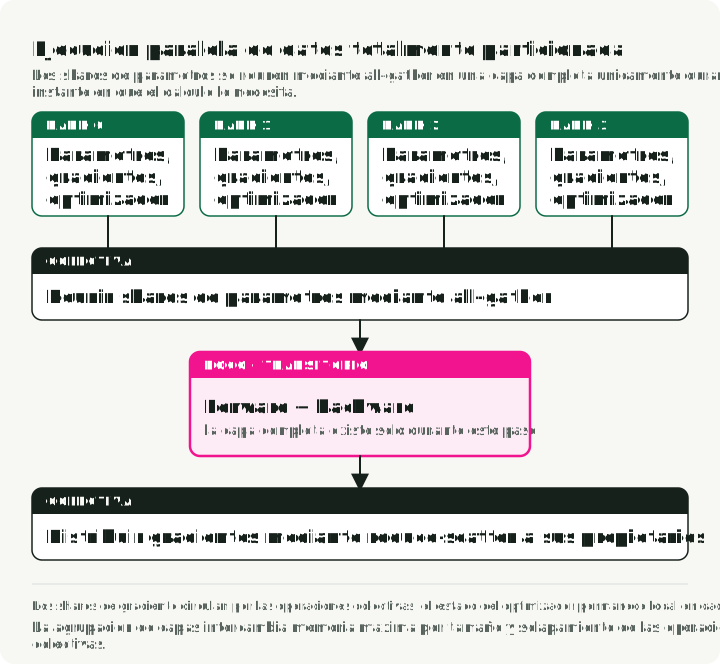
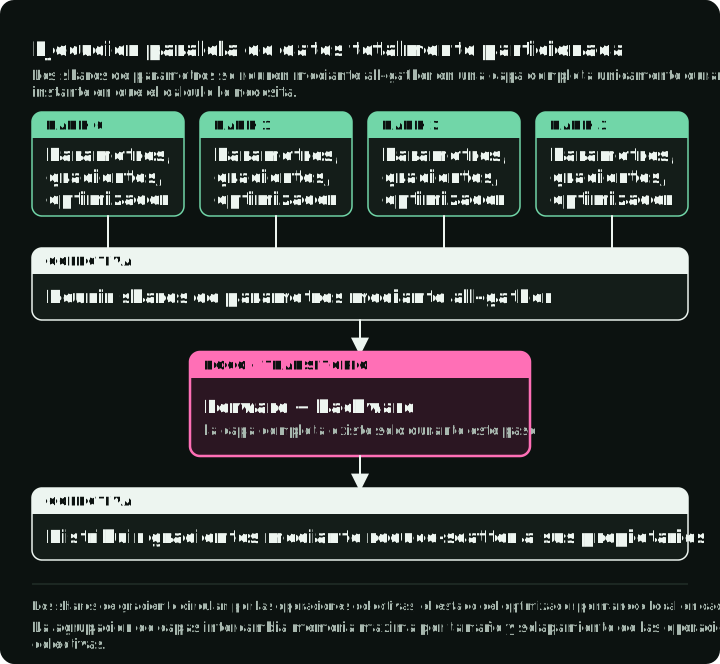
El paralelismo de datos totalmente fragmentado almacena fragmentos de parámetros, gradientes y estado del optimizador repartidos por un grupo. El artículo de ZeRO describe este patrón de fragmentación del estado, y la API FSDP2 de PyTorch lo implementa. Los parámetros de una capa se reúnen con all-gather para el cálculo y pueden volver a fragmentarse después. Los gradientes se reparten con reduce-scatter hacia sus propietarios. La figura sigue una capa en uno de cuatro ranks durante un paso de entrenamiento: el rank almacena una cuarta parte de los pesos, los gradientes y el estado del optimizador, un all-gather reconstruye los pesos completos para el paso forward y otra vez para el backward, y el reduce-scatter deja al rank su cuarta parte de los gradientes.
El artículo de ZeRO sitúa el coste de la etapa 3 en aproximadamente 1,5 veces el volumen de comunicación de DDP: los parámetros se reúnen con all-gather tanto en el forward como en el backward, y los gradientes se reparten con reduce-scatter una vez.
La documentación actual de PyTorch distingue la API fully_shard del paralelismo de datos totalmente fragmentado versión 2 (FSDP2) del wrapper FullyShardedDataParallel, más antiguo. FSDP2 agrupa la comunicación según los módulos a los que se aplica fully_shard y recomienda aplicarlo de abajo arriba, de modo que los grupos de capas puedan solapar comunicación y cómputo.
El orden de las llamadas es la parte fácil de equivocar. Este fragmento fragmenta una pila de capas Transformer con FSDP2:
model = nn.Sequential(*layers).cuda()  # e.g. 24 Transformer layers

for layer in model:  # bottom-up: each layer becomes one communication group
    fully_shard(layer)
fully_shard(model)  # then shard the remaining root parameters

# Build the optimizer after sharding, so it holds the sharded parameters (DTensors).
optimizer = torch.optim.AdamW(model.parameters(), lr=1e-4)
Lanza un proceso por GPU con torchrun --nproc_per_node=8 train.py. La memoria máxima por rank baja a medida que crece el grupo de fragmentación, porque cada rank conserva una parte menor de los pesos en FP32, los gradientes y el estado de Adam. Las activaciones no se reducen, porque cada rank sigue procesando su propio batch. El tutorial de FSDP2 incluye un script completo con precisión mixta y checkpointing. FSDP2 también tiene una opción reshard_after_forward=False que mantiene los parámetros reunidos entre el forward y el backward. Se comporta como ZeRO-2: menos all-gathers, más memoria.
La fragmentación resulta atractiva cuando el estado del modelo es la parte más grande de la memoria y el cómputo de las capas puede ocultar suficiente tráfico colectivo. Puede ser un mal compromiso para modelos pequeños, enlaces lentos, capas diminutas o un grupo de fragmentación que abarca varios nodos a través de una red lenta. DeepSpeed ZeRO implementa las mismas etapas con selección explícita de etapa y descarga opcional del estado a memoria de CPU o NVMe.
Paralelismo tensorial
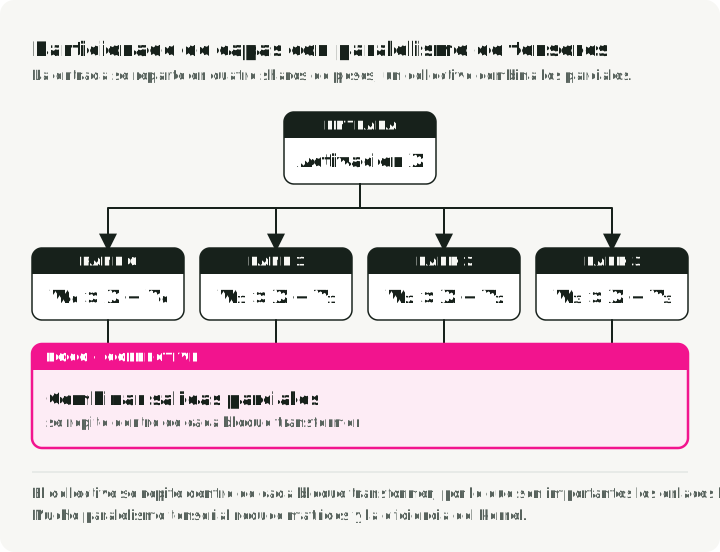
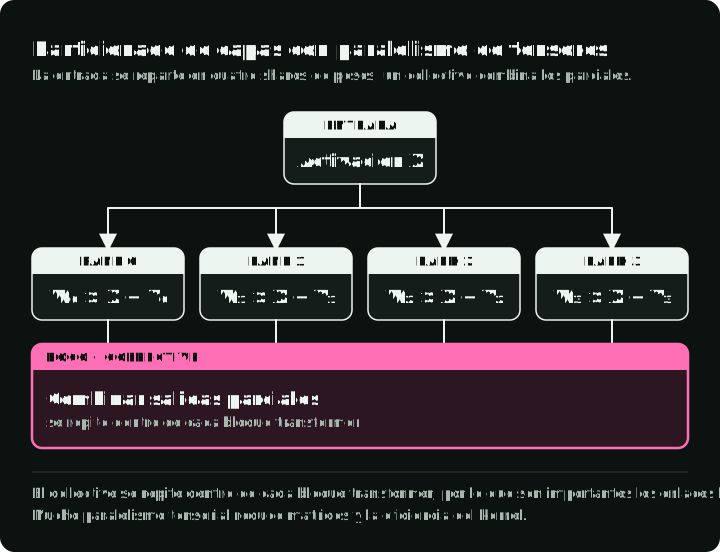
El paralelismo tensorial reparte el álgebra lineal dentro de una capa. Algunos ejemplos son las proyecciones paralelas por columnas y por filas. La guía de paralelismo de NVIDIA documenta esta división a nivel de capa. Los resultados parciales requieren operaciones colectivas dentro de los bloques transformer, así que la latencia y el ancho de banda importan una y otra vez durante los pasos forward y backward.
La figura muestra la división que usa el artículo de Megatron-LM para un MLP de Transformer en dos ranks. La primera matriz de pesos se divide por columnas, de modo que cada rank aplica GeLU a su propio fragmento sin comunicación. La segunda matriz se divide por filas, de modo que cada rank produce una suma parcial de la salida, y un all-reduce las suma. Eso es un all-reduce por MLP en el forward en lugar de uno por cada multiplicación de matrices.
Úsalo cuando una capa o sus activaciones no caben, o cuando los matmuls son lo bastante grandes para que los kernels particionados superen a un solo rank. Asigna el grupo tensorial al dominio de comunicación más rápido disponible y mide. Un grado tensorial alto puede reducir cada matriz local hasta que la eficiencia de los kernels cae mientras crece la sobrecarga de las operaciones colectivas.
El paralelismo de secuencia al estilo Megatron divide a lo largo de la secuencia las activaciones de las regiones de LayerNorm y dropout, que el TP simple mantendría completas en cada rank del grupo TP. Funciona dentro del grupo TP; el paralelismo de contexto divide la secuencia entera, atención incluida, en un grupo aparte.
Megatron Core implementa TP y paralelismo de secuencia para entrenamiento. vLLM, SGLang y TensorRT-LLM usan TP para repartir un modelo en serving.
Paralelismo de pipeline
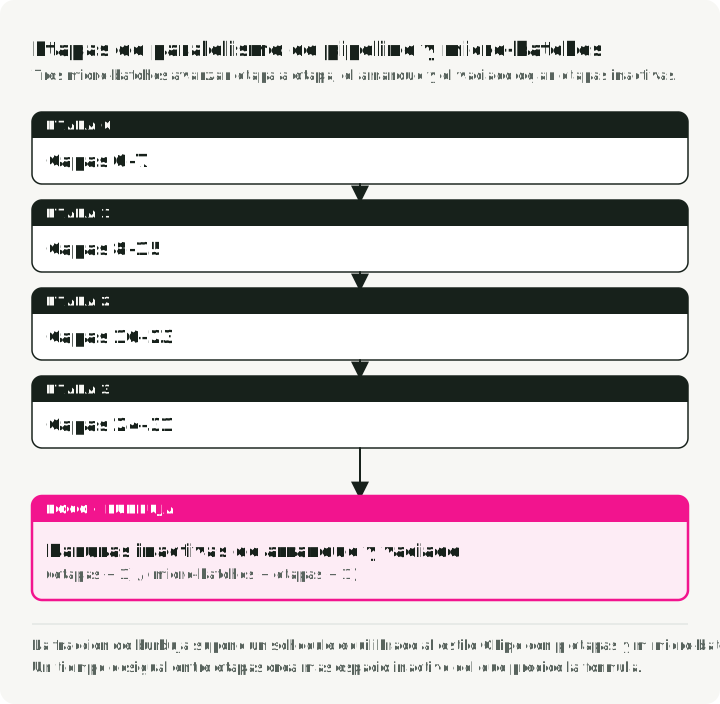
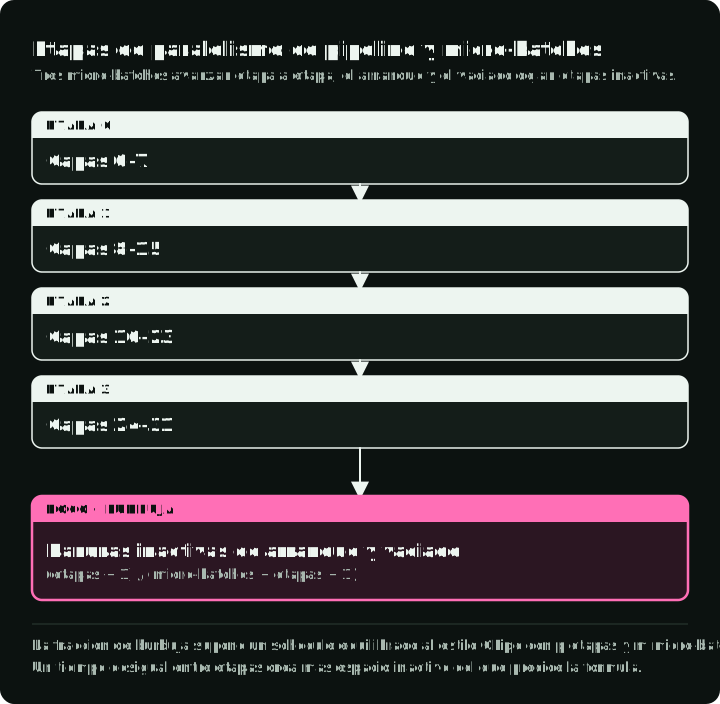
El paralelismo de pipeline coloca distintos grupos de capas en distintas etapas y envía activaciones entre ellas. Los micro-batches mantienen las etapas trabajando de forma concurrente.
Alivia el estado del modelo por etapa y puede reducir el volumen de comunicación que cruza una frontera más lenta, en comparación con las operaciones colectivas tensoriales por capa. Sus costes son las burbujas, las transferencias de activaciones, el desequilibrio entre etapas, una planificación más compleja y una recuperación y un checkpointing más difíciles.
La figura muestra el paso forward de cuatro etapas y cuatro micro-batches a lo largo de siete pasos de tiempo, y debajo la fracción inactiva con más micro-batches. Cada hueco vacío es una etapa sin trabajo: las últimas etapas esperan al principio y las primeras esperan al final. Para una planificación equilibrada simple al estilo GPipe con p etapas y m micro-batches, la fracción idealizada de burbuja en el forward es aproximadamente:
(p - 1) / (m + p - 1)Con 4 etapas, 4 micro-batches dejan inactivos 3/7, un 43 % aproximadamente, de la planificación forward. Con 16 micro-batches quedan 3/19, cerca de un 16 %, y con 32 quedan 3/35, cerca de un 9 %. Más micro-batches por batch global reducen la burbuja, pero cada uno es más pequeño y los kernels se ejecutan con menos eficiencia; mide ambos efectos.
Las planificaciones reales pueden usar one-forward/one-backward, interleaving o variantes zero-bubble, y el coste desigual de las capas puede dominar la fórmula. Elige los límites de las etapas a partir del tiempo y la memoria medidos, no de un número igual de capas.
DeepSpeed, Megatron Core y Nanotron implementan planificaciones de pipeline.
Paralelismo de contexto
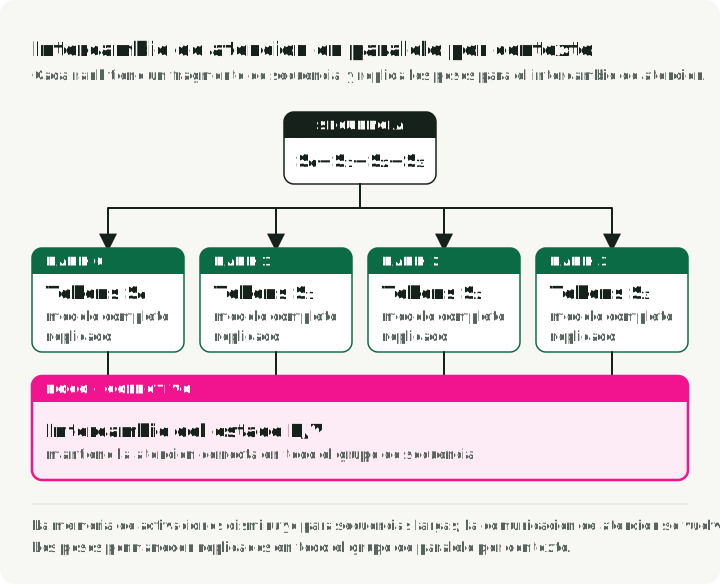
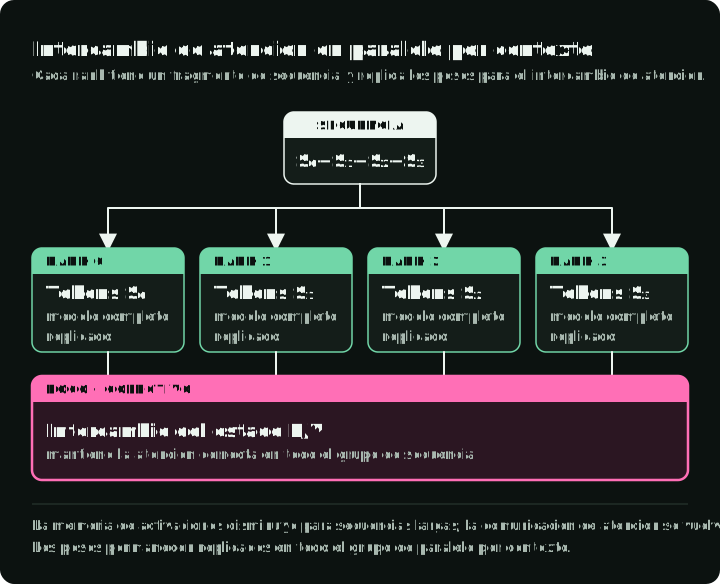
El paralelismo de contexto distribuye la dimensión de secuencia. La documentación de paralelismo de contexto de NVIDIA describe la división de la secuencia y el intercambio de claves y valores que necesita la atención. Cada rank posee un fragmento de la secuencia, y la atención intercambia la información necesaria para conservar la semántica de contexto completo. Las implementaciones pueden usar anillos punto a punto, all-gather, all-to-all o combinaciones jerárquicas.
Reduce la memoria de activaciones en el entrenamiento de contexto largo, pero replica los pesos en todo el grupo de contexto e introduce comunicación de atención. El beneficio depende del tipo de atención, del enmascaramiento causal, de la longitud de secuencia, de la recomputación y de cómo se combinan los grupos de contexto con los grupos tensoriales y de datos.
No lo elijas a partir de un umbral universal de 8K, 32K o 100K. Considéralo cuando las activaciones sigan superando la memoria con tu longitud de secuencia objetivo después del activation checkpointing y del paralelismo tensorial más el de secuencia, y los pesos ya quepan.
Megatron Core implementa CP para entrenamiento. Picotron tiene una implementación pequeña de paralelismo de datos, tensorial, de pipeline y de contexto para aprender cómo encajan entre sí.
Paralelismo de expertos para modelos MoE
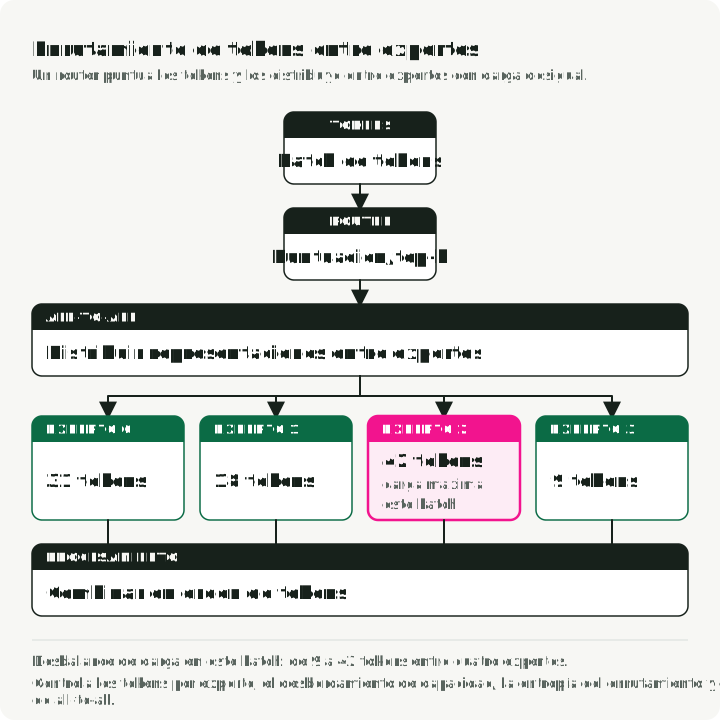
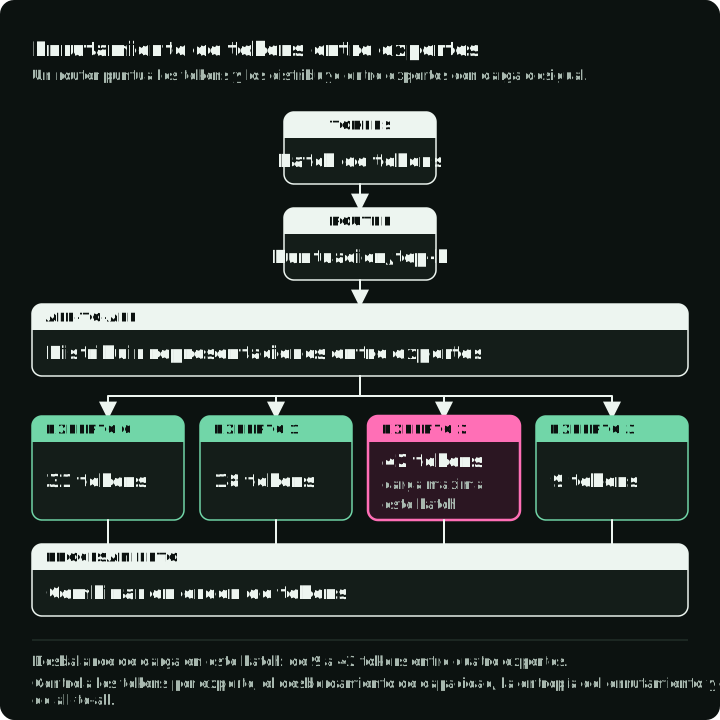
El paralelismo de expertos distribuye los expertos de las capas mixture-of-experts. Mixtral 8x7B, por ejemplo, almacena unos 46,7B parámetros pero usa unos 12,9B por token. La guía de paralelismo de NVIDIA documenta esta colocación de expertos y su combinación con otras dimensiones de paralelismo. El router envía las representaciones de los tokens a los expertos seleccionados y combina sus resultados. Solo los expertos seleccionados calculan para cada token, pero los pesos de todos los expertos siguen necesitando almacenamiento y colocación en serving.
El paralelismo de expertos no es un ajuste de optimización para un modelo denso. Forma parte de una arquitectura MoE. Entre sus problemas están el equilibrio de carga, los límites de capacidad, el all-to-all de tokens, los tokens descartados, el padding, las pérdidas auxiliares y el sesgo ante fallos. Los ajustes MoE de Megatron distinguen entre descartar asignaciones por encima de la capacidad de un experto y rellenar posiciones vacías por debajo de ella. El enrutamiento sin descartes procesa cantidades variables de tokens. Sigue los tokens por experto, la entropía del enrutamiento, el desbordamiento de capacidad, el tiempo de comunicación y la calidad por ruta.
Megatron Core y Nanotron implementan EP para entrenamiento.
Componer una disposición a partir de la topología
Los sistemas de entrenamiento de modelos densos de gran tamaño sin grupo de paralelismo de expertos suelen usar un producto de los tamaños de los grupos de paralelismo de datos (DP), tensorial (TP), de pipeline (PP) y de contexto (CP):
world size = DP × TP × PP × CPCuando el paralelismo de expertos (EP) es un grupo independiente, la guía de paralelismo de NVIDIA calcula el total así:
total GPUs = TP × PP × CP × EP × DPComprueba qué órdenes y tamaños de grupo admite tu framework antes de elegir los grados.
Construye la disposición en este orden:
- Dibuja los dominios de comunicación: enlaces entre GPUs, switches, límites de acceso no uniforme a memoria (NUMA), la red de interconexión de los nodos, la sobresuscripción y la ruta de almacenamiento. En la mayoría de los servidores con GPU, el dominio más rápido es NVLink entre las GPUs de un mismo nodo; los nodos se conectan por una red más lenta, como InfiniBand.
- Coloca las operaciones colectivas frecuentes y sensibles a la latencia, normalmente las de TP, en el dominio adecuado más rápido. Esto suele significar mantener cada grupo TP dentro de un nodo.
- Elige los grupos de FSDP o de DP replicado según la capacidad y el ancho de banda que queden.
- Añade PP cuando la colocación por profundidad o el tráfico entre dominios se beneficien de ello, equilibrando el tiempo y la memoria medidos de cada etapa.
- Añade CP solo por la restricción de secuencia, y EP solo por la topología de expertos del modelo.
- Confirma la divisibilidad de cabezas, dimensiones ocultas, capas, expertos, batch y secuencia para la malla candidata.
- Haz benchmark de varias mallas válidas. Las heurísticas que tienen en cuenta la topología eligen candidatas, no ganadoras.
Un ejemplo de candidata para un modelo denso de 70B con contexto de 32K en 64 nodos de 8 GPUs: TP=8 dentro de cada nodo sobre NVLink, PP=4 entre nodos, CP=4 para la secuencia larga y DP=4 para el resto; 8 × 4 × 4 × 4 = 512 GPUs. Haz benchmark de esa configuración frente a TP=8, PP=8, CP=2, DP=4 antes de decidir.
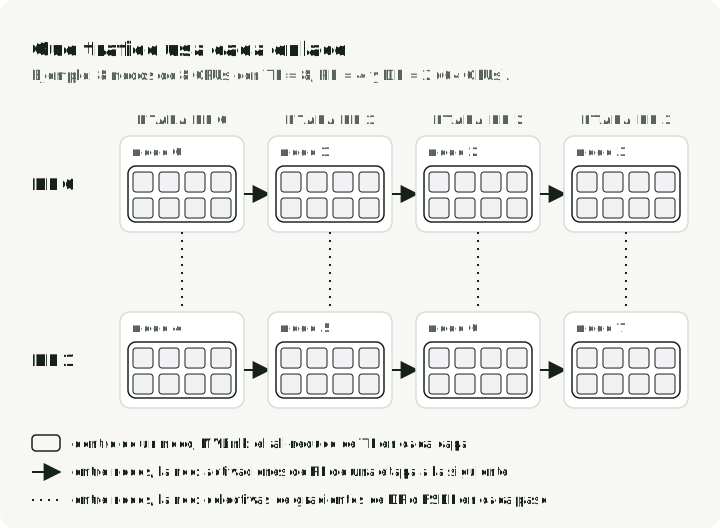
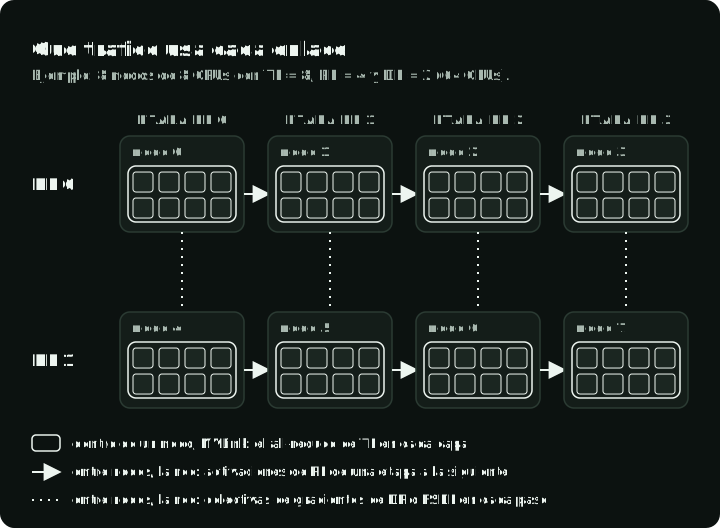
La figura muestra adónde va el tráfico de cada grupo en una disposición de ese tipo: el all-reduce de TP se queda en NVLink dentro de un nodo, mientras que las operaciones colectivas de gradientes de FSDP o DP y las activaciones de PP cruzan la red entre nodos.
Candidatas de partida según el tamaño del clúster, para hacer benchmark y no para adoptar sin más:
- Un nodo, 2–8 GPUs. DDP cuando cabe una réplica completa de entrenamiento con margen; FSDP2 o DeepSpeed ZeRO-2/3 cuando hay que fragmentar el estado del modelo. Lanza con
torchruno Accelerate. Añade TP=2 solo si una capa o sus activaciones siguen sin caber. En GPUs conectadas por PCIe sin NVLink, mantén TP en 1 o 2, porque el all-reduce de cada capa cruza PCIe. - 2–16 nodos. TP dentro de cada nodo (4 u 8 con NVLink), FSDP o DP entre nodos y PP entre nodos solo si el modelo sigue sin caber.
- Cientos de GPUs o más. TP × PP × CP × DP, como en el ejemplo anterior, con un framework que implemente los cuatro, como Megatron Core.
Dos clústeres con el mismo número de GPUs pueden preferir disposiciones distintas, porque difieren el ancho de banda de los enlaces, la jerarquía de switches, la conexión de la CPU y la contención de la red.
Qué framework implementa cada división
Las divisiones anteriores las implementa un pequeño conjunto de bibliotecas. Elige según las divisiones que necesitas y cuánto del bucle de entrenamiento quieres controlar.
| Herramienta | Divisiones que admite | Úsala cuando |
|---|---|---|
| Hugging Face Accelerate | lanza DDP, FSDP o DeepSpeed desde un archivo de configuración | quieres ejecutar un script existente de PyTorch o Transformers en varias GPUs con pocos cambios de código |
| PyTorch DDP y FSDP2 | DDP, FSDP (fully_shard), con torchrun | entrenas un modelo denso en un nodo o en pocos nodos y quieres PyTorch puro |
| DeepSpeed ZeRO | etapas ZeRO 1, 2 y 3, descarga a CPU y NVMe, PP | quieres elegir la etapa de fragmentación o descargar el estado a memoria de CPU o NVMe |
| Megatron Core | TP, PP, CP, EP, DP y paralelismo de secuencia | necesitas TP, PP y CP (y EP) juntos para pre-entrenamientos grandes |
| Nanotron | DP, TP, PP, EP, ZeRO-1 | quieres una base de código más pequeña que la de Megatron para paralelismo 3D y MoE |
| vLLM, SGLang, TensorRT-LLM | TP y PP para inferencia | sirves el modelo; consulta la sección de serving más abajo |
Para ejecutar un script existente con FSDP2 mediante Accelerate, ejecuta accelerate config una vez; escribe el archivo de configuración de forma interactiva. Estos ajustes seleccionan FSDP2, la agrupación por capas del decodificador y la refragmentación:
fsdp_config:
    fsdp_version: 2
    fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP
    fsdp_transformer_layer_cls_to_wrap: LlamaDecoderLayer
    fsdp_reshard_after_forward: true
Con fsdp_auto_wrap_policy: TRANSFORMER_BASED_WRAP, fsdp_transformer_layer_cls_to_wrap nombra la clase de bloque que se convierte en una unidad FSDP, la misma agrupación de abajo arriba que el bucle fully_shard anterior. fsdp_reshard_after_forward: true es la fragmentación completa; false es el modo parecido a ZeRO-2. Inicia el trabajo con accelerate launch --config_file fsdp2.yaml train.py. La guía de FSDP1/FSDP2 explica estos ajustes específicos de cada versión y el comando accelerate to-fsdp2, que convierte una configuración antigua de FSDP1.
El entrenamiento y el serving requieren decisiones distintas
La inferencia normalmente no lleva gradientes ni estado del optimizador, así que las disposiciones de entrenamiento al estilo FSDP no se trasladan automáticamente.
El prefill procesa el prompt y almacena las claves y los valores de sus tokens en la KV cache. La decodificación genera los tokens siguientes mientras reutiliza y amplía esa caché.
Para el serving, pregúntate:
- ¿Una réplica admite los pesos, la KV cache, el espacio de trabajo y la concurrencia objetivo?
- ¿El throughput se atiende mejor con más réplicas independientes o fragmentando una réplica?
- ¿El TP reduce lo bastante la presión de pesos y caché por rank como para compensar la comunicación por capa?
- ¿El PP es eficiente para el modelo y el planificador de peticiones?
- ¿En qué se diferencian las exigencias de prefill y decode sobre el cómputo, el ancho de banda de memoria y la interconexión?
- ¿Qué ocurre con la latencia en los percentiles altos cuando las peticiones tienen distintas longitudes de prompt y de salida?
Usa la fórmula de la KV cache de la sección de memoria para la primera pregunta. Si una réplica cabe con espacio para la KV cache a tu concurrencia objetivo, ejecuta más réplicas; no necesitan comunicación entre GPUs. Si no cabe, fragméntala primero con TP dentro de un nodo y añade PP entre nodos solo cuando un nodo no baste. En vLLM son --tensor-parallel-size y --pipeline-parallel-size; SGLang y TensorRT-LLM tienen los mismos dos ajustes.
Haz benchmark del servidor completo, con el planificador, la cuantización, la distribución del contexto, la política de batching y el perfil de tráfico. Los tokens por segundo de entrenamiento no permiten predecir el tiempo hasta el primer token ni la latencia entre tokens en serving.
Qué registrar para cada disposición candidata
Para cada candidata, registra:
- la identidad del modelo, el código, el runtime, los kernels y la topología
- el batch global y local, la distribución de secuencias y el número de tokens
- la memoria máxima por categoría, cuando esté disponible
- los tokens útiles por segundo y la utilización de operaciones de coma flotante (FLOP) del modelo, cuando se calcule de forma consistente
- el tiempo expuesto en operaciones all-reduce, all-gather, reduce-scatter, all-to-all y punto a punto
- los bloqueos de entrada, el tiempo de checkpoint, el comportamiento en los reinicios y la distribución de stragglers
- la pérdida de entrenamiento o la paridad de la salida en serving respecto a la línea base
Compara el escalado débil y el fuerte de forma deliberada. El escalado fuerte mantiene constante el trabajo total al aumentar el número de ranks. El escalado débil mantiene constante el trabajo por rank, de modo que el trabajo total crece con el número de ranks. Un porcentaje etiquetado como «eficiencia de escalado» no significa nada sin ese denominador y esa línea base.
Conclusión
El paralelismo es una correspondencia entre un cuello de botella medido, una dimensión del tensor y un patrón de comunicación. La replicación, la fragmentación, la partición por capas, las etapas, la partición de la secuencia y el enrutamiento de expertos alivian cada uno una restricción distinta y crean un modo de fallo distinto.
Haz el inventario de la carga de trabajo, dibuja la topología, genera mallas válidas y perfílalas. La disposición ganadora es la que cabe con margen y minimiza la comunicación expuesta para el trabajo que ejecutas.
Referencias
- Documentación de
fully_shardde PyTorch FSDP2 - Fragmentación de parámetros por módulo, all-gathers, reduce-scatters y comportamiento de DTensor. - Documentación de PyTorch DistributedDataParallel - Entrenamiento de un modelo replicado con gradientes sincronizados.
- Documentación de
torchrunde PyTorch - Lanzamiento de un proceso por GPU con variables de entorno de rank. - Estrategias de paralelismo de NVIDIA Megatron Core - Dimensiones de las estrategias de datos, tensorial, pipeline, contexto, expertos y totalmente fragmentada.
- Ultra-Scale Playbook de Hugging Face - Panorama interactivo del paralelismo de modelos a gran escala.
- Hoja de referencia del Ultra-Scale Playbook - Resumen del playbook en una página.
- Guía de FSDP de Hugging Face Accelerate - Claves de configuración y comandos de lanzamiento para FSDP.
- Tutorial de DeepSpeed ZeRO - Etapas de ZeRO y configuración de la descarga.
- Artículo de DeepSpeed ZeRO - Fragmentación de estados del optimizador, gradientes y parámetros para reducir el uso de memoria.
- Artículo de Megatron-LM - Capas Transformer paralelas por columnas y por filas.
- Reducing Activation Recomputation in Large Transformer Models - Paralelismo de secuencia de Megatron.
- Artículo de GPipe - Entrenamiento con pipeline mediante micro-batches y ejecución por etapas.
- Paralelismo y escalado en vLLM - Ajustes de serving con paralelismo tensorial y de pipeline.
- Mixtral of experts - Recuentos de parámetros totales y activos de Mixtral 8x7B.
- Documentación de paralelismo de NERSC - Definiciones de escalado fuerte y débil basadas en trabajo total fijo o por rank.