LLM-Varianten mit offenen Weights: Formate und Quantization

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Namen wie Acme-32B-A3B-Instruct-AWQ wirken dicht, weil sie mehrere unabhängige Entscheidungen verbinden: Familie und Größe, Architektur, Training-Rolle und Quantization. Ein Repository kann diese Weights als geshardete Safetensors bereitstellen, während eine Community-Konvertierung desselben Checkpoints als Q4_K_M.gguf erscheint.
Diese Bezeichnungen gehören nicht zu einer gemeinsamen Kategorie: GPTQ und AWQ sind Quantization-Methoden, GGUF ist ein Container und ein Runtime-Ökosystem, und MoE ist eine Architektur. Wer die Ebenen getrennt liest, trifft die Download-Entscheidung leichter.
Dieser Leitfaden richtet sich an Engineers, die ein Open-Weight-Modell für lokale Inference oder GPU-Serving auswählen. Du lernst, jeden Teil eines Modellnamens zu lesen, eine Runtime zu wählen und zu prüfen, ob eine Datei in deinen Speicher passt, bevor du sie benchmarkst.
Die kompakte Deployment-Entscheidung findest du unter Quantization-Formate für LLMs.
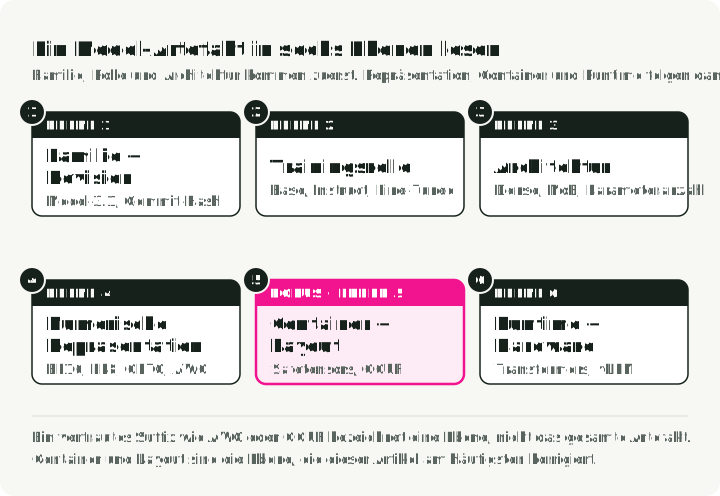
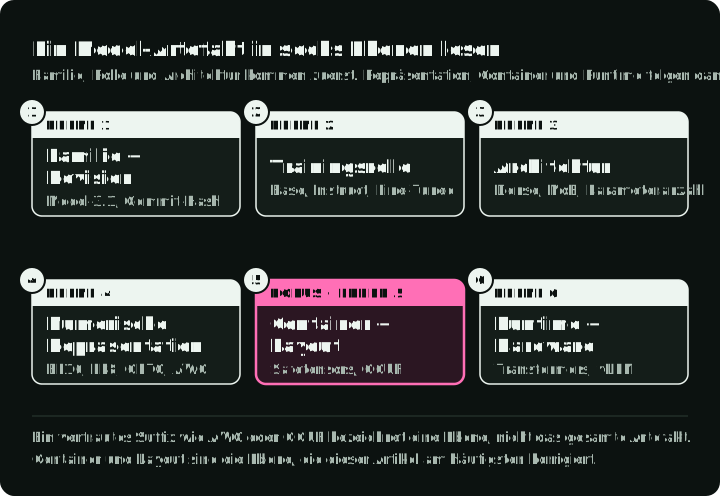
Ein Modellartefakt in sechs Ebenen lesen
| Ebene | Beispiel | Welche Frage sie beantwortet |
|---|---|---|
| Familie und Revision | Model-3.1, Commit-Hash | Welche Weights und welcher Tokenizer-Vertrag? |
| Training-Rolle | Base, Instruct, Reasoning-tuned | Welches Verhalten wurde optimiert? |
| Architektur | Dense, MoE, gesamte und aktive Parameter | Welche Kernels und welches Speicherlayout sind nötig? |
| Numerische Darstellung | BF16, FP8, GPTQ 4-Bit, AWQ 4-Bit | Wie werden Tensoren dargestellt oder quantisiert? |
| Container und Layout | Safetensors-Shards, GGUF | Wie werden Tensoren und Metadaten verpackt? |
| Runtime | Transformers, vLLM, llama.cpp | Welcher Loader und welcher Hardware-Pfad führen es aus? |
Die Abbildung unten teilt zwei Beispielnamen in Teile auf und ordnet jeden Teil seiner Ebene zu. Beide Namen nennen die Familie, die Training-Rolle, die Architektur und die numerische Darstellung. Nur die GGUF-Datei nennt ihren Container, und keiner der Namen nennt die Runtime.
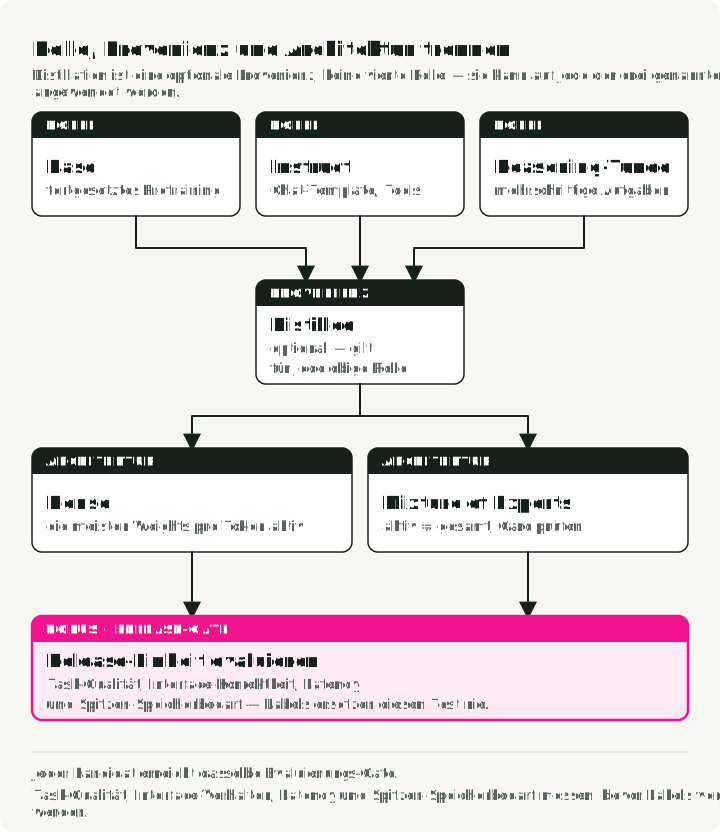
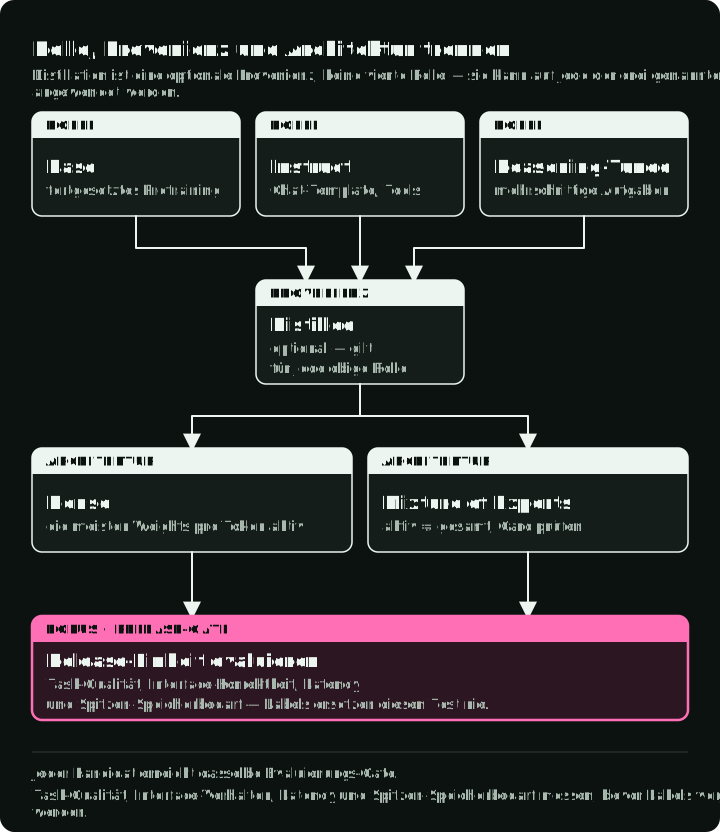
Manche Labels beschreiben, wie das Modell trainiert wurde, und nicht einen Teil der Datei. Distill (trainiert, um ein größeres Teacher-Modell nachzuahmen) und QAT (Quantization-Aware Training) sind zwei davon. Ein Checkpoint kann gleichzeitig destilliert, instruction-tuned, reasoning-tuned und MoE sein.
Das Label „Open Source” braucht eine eigene Prüfung. Wenn ein Modell nur herunterladbare Weights veröffentlicht, nimm nicht an, dass seine Lizenz einer Open-Source-Definition entspricht oder deinen Anwendungsfall erlaubt. Lies die Model Card und die Lizenz, bevor du Architekturen oder Benchmarks vergleichst.
Training-Rollen: Base, Instruct, Reasoning, Distilled
Base
Ein Base-Checkpoint ist vor allem auf Next-Token-Prediction trainiert. Er eignet sich für fortgesetztes Pretraining, kontrollierte Forschung oder Anpassungen, bei denen du das Instruktionsverhalten selbst festlegen willst. Er setzt einen Prompt eventuell fort, statt ihn zu beantworten. Frage ihn „Was ist die Hauptstadt von Frankreich?”, und er fährt womöglich mit „Was ist die Hauptstadt von Deutschland?” fort, weil der Prompt wie der Anfang einer Fragenliste aussieht.
Nimm nicht an, dass jedes Fine-Tuning von Base ausgehen sollte. Ein Instruct-Checkpoint kann die bessere Initialisierung sein, wenn sein vorhandenes Verhalten zum Ziel passt. Bestätige mit deiner Evaluation, dass das vorhandene Verhalten nicht gegen das neue Ziel arbeitet.
Instruct oder Chat
Diese Checkpoints durchlaufen ein Post-Training, das Instruktionsbefolgung und Konversation verbessern soll. Das genaue Rezept kann Supervised Fine-Tuning, Preference Optimization, Reinforcement Learning, Distillation oder eine Kombination enthalten. Es ist nicht zwingend Supervised Fine-Tuning gefolgt von RLHF.
Nutze einen Instruct-Checkpoint als erste Assistenten-Baseline. Prüfe sein Chat-Template, das unterstützte Tool-Call-Format, das Verhalten bei System-Nachrichten und die Ablehnungsmerkmale. Die Dokumentation zu Chat-Templates in Transformers erklärt, warum das genaue Nachrichtenformat wichtig ist. „Instruct” allein garantiert kein zuverlässiges JSON und kein zuverlässiges Tool Use.
Reasoning-tuned
Reasoning-orientierte Checkpoints sind auf Aufgaben oder Trajektorien optimiert, die mehrstufiges Problemlösen belohnen. Manche geben den Reasoning-Text aus, manche trennen ihn über einen Serving-Parser ab, und manche liefern nur eine Antwort. Längere Generierung garantiert weder nachvollziehbares Reasoning noch weniger Hallucinations.
Setze einen solchen Checkpoint ein, wenn er die schwierigen Evaluations-Slices verbessert, nachdem du Output-Tokens, Latency und Verifikation eingerechnet hast. Routinemäßige Extraktion oder Klassifikation kann langsamer werden, ohne besser zu werden.
Distilled
Distillation überträgt Verhalten von einem Teacher oder von Teacher-generierten Daten auf ein anderes Modell. Der Student kann kleiner, gleich groß oder strukturell anders sein. Es gibt keine feste Regel „70–80 % der Qualität bei halber Größe”: Die erhaltene Qualität hängt von Teacher, Daten, Zielfunktion, Kapazität des Students und Evaluation ab. Auch das ursprüngliche Paper zur Knowledge Distillation von Hinton, Vinyals und Dean behauptet kein festes Qualitätsverhältnis.
Behandle Distill als Herkunftsangabe zum Training und benchmarke den Checkpoint dann wie jeden anderen.
Die Abbildung unten schickt einen Prompt an alle drei Rollen und zeigt, was jede zurückgibt, wofür man sie auswählt und was sie kostet. Herkunftslabels wie Distill und QAT können auf jede davon zutreffen.
Dense- und MoE-Modelle
Die Training-Rolle sagt, welches Verhalten der Checkpoint hat. Die Architektur sagt, wie die Weights organisiert sind, und das bestimmt Speicherbedarf und Runtime-Unterstützung.
Dense-Modelle
Die meisten Parameter nehmen am Forward Pass jedes Tokens teil. Die Parameterzahl ist ein grober Anhaltspunkt für den Speicher der Weights. Der Speicher zur Laufzeit umfasst außerdem KV cache, Activations oder Workspace, Allocator-Overhead und manchmal duplizierten oder gesharteten Zustand.
Mixture of Experts
Eine MoE-Schicht leitet jedes Token an eine Teilmenge von Expert-Feed-Forward-Netzen weiter. Das Switch-Transformer-Paper beschreibt ein solches Routing-Design; andere Familien leiten Tokens anders. Namen wie A3B bedeuten oft, dass ungefähr drei Milliarden Parameter pro Token aktiv sind, doch die Namenskonventionen sind familienspezifisch. Lies die Model Card für gesamte Parameter, aktive Parameter, Expert-Anzahl und Routing-Design.
Die Zahl der aktiven Parameter beschreibt geroutete Rechenlast, nicht die Platzierung der Weights. Zum Beispiel verteilt vLLM Expert Parallelism die Expert-Schichten auf Expert-Parallel-Ranks und leitet die Expert-Zuteilung jedes Ranks aus der gesamten Expert-Anzahl ab. Andere Runtimes platzieren oder lagern Weights eventuell anders aus. Ein Modell mit 30B gesamten und 3B aktiven Parametern passt daher nicht automatisch wie ein Dense-Modell mit 3B.
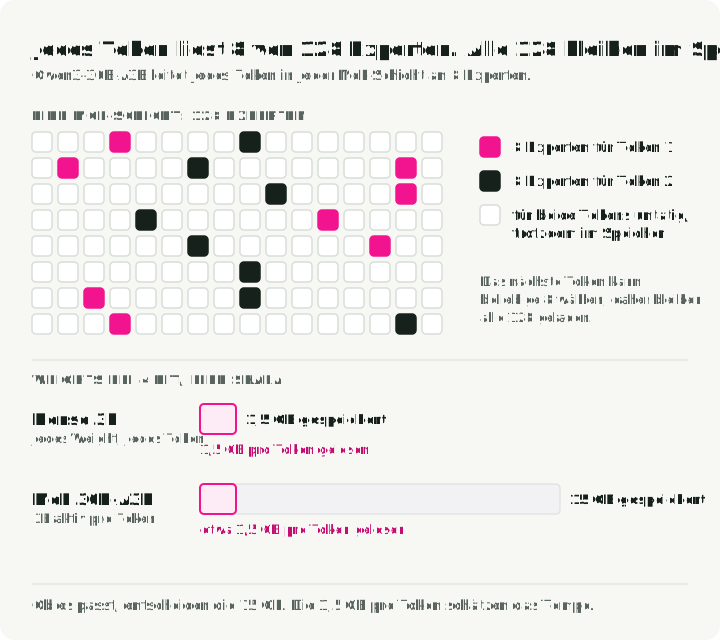
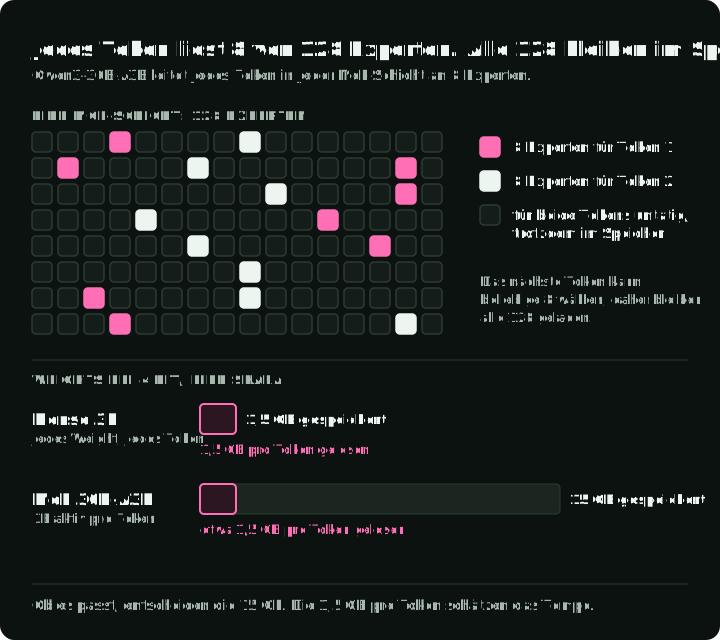
Die Abbildung unten zeigt eine MoE-Schicht von Qwen3-30B-A3B: Jedes Token nutzt 8 ihrer 128 Experten, das nächste Token kann beliebige andere 8 nutzen, daher bleiben alle im Speicher. Die Balken zeigen ein Dense-Modell mit 3B und das 30B-A3B-Modell bei 4 Bit auf einer Skala. Das MoE-Modell speichert zehnmal so viele Weights, aber jedes Token liest nur die 3B aktiven Parameter, etwa 1,5 GB.
Auch die Runtime-Unterstützung ist architekturspezifisch. Prüfe vor dem Download die Modellimplementierung, die Unterstützung für Expert Parallelism oder Tensor Parallelism, die Quantization-Kernels und den maximalen Kontext.
Container und Quantization-Methoden
Die Architektur legt fest, welche Tensoren existieren. Der Container bestimmt, wie diese Tensoren auf der Festplatte gespeichert werden, und die Quantization-Methode bestimmt, wie viele Bits jeder davon belegt.
Safetensors
Safetensors ist ein sicheres Serialisierungsformat für Tensoren, das in Hugging Face-Repositories häufig verwendet wird. Ein Modell kann mehrere .safetensors-Shards sowie Konfigurations-, Tokenizer- und Generierungsdateien umfassen. Diese Tensoren können BF16/FP16 sein oder mit einer Methode wie GPTQ oder AWQ vorquantisiert. Transformers liest die Methode aus einem quantization_config-Eintrag und lädt das passende Backend, wie es der Quantization-Workflow beschreibt.
Die Dateiendung allein verrät weder Präzision noch Runtime-Kompatibilität. Prüfe config.json, die Quantization-Konfiguration, die Model Card, den Tensor-Dtype und die Runtime-Dokumentation. Der Abschnitt „Ein Name im Detail” weiter unten zeigt ein kurzes Skript, das genau das tut.
GGUF
GGUF verpackt Tensoren und Metadaten für das ggml/llama.cpp-Ökosystem. llama.cpp lädt GGUF und unterstützt Backends wie Metal, CUDA, HIP, Vulkan und CPU-Pfade. Modellarchitektur und Konvertierungsqualität bestimmen weiterhin die Kompatibilität.
GGUF ist ein Container. Er kann Tensoren mit hoher Präzision oder quantisierte Tensoren enthalten. Multimodale Modelle brauchen eventuell zusätzlich eine eigene Projector- oder Encoder-Datei. „Eine GGUF-Datei enthält alles” ist keine allgemeingültige Regel.
GPTQ und AWQ
GPTQ und AWQ sind Post-Training-Methoden zur Weight-Quantization, keine Dateiendungen. Ihre Artefakte nutzen üblicherweise Safetensors plus methodenspezifische Konfiguration. Serving-Engines brauchen Kernels, die zur Methode, zur Bitbreite, zur Group Size, zur Modellarchitektur und zur Hardware passen.
Keine der beiden Methoden ist universell die qualitativ beste. Calibration Data, Implementierung, Kernel-Pfad und Aufgabe spielen eine Rolle. Die Runtime-Unterstützung ändert sich, also prüfe das genaue Artefakt gegen die Version, die du festlegst. Sieh dir bei dieser Entscheidung die offiziellen Seiten zu Transformers Quantization und vLLM Quantization an.
FP8 und QAT
Zwei weitere Labels tauchen in Repository-Namen auf. FP8 ist ein Zahlenformat, keine Quantization-Methode: Jedes Weight wird als 8-Bit-Gleitkommawert gespeichert. Es läuft nur dann schnell, wenn GPU und Runtime es beide unterstützen. Zum Beispiel führt vLLM FP8-Weights und -Activations auf NVIDIA Ada, Hopper und Blackwell aus und fällt auf Turing und Ampere auf Weight-only-FP8 zurück. Prüfe die Hardware-Tabelle der Runtime, bevor du ein -FP8-Repository wählst.
Ein QAT-Checkpoint (Quantization-Aware Training) wurde darauf trainiert, ein bestimmtes Schema mit niedriger Bitbreite zu vertragen, zum Beispiel eine -qat-q4_0-GGUF-Datei. Beginne mit dem vom Herausgeber vorgesehenen Format. Ein anderes Quantization-Schema kann den Nutzen von QAT verringern; evaluiere das konvertierte Artefakt erneut. Der Leitfaden zu Model Quantization behandelt PTQ und QAT sowie Zahlenformate ausführlicher.
Runtimes und wann man welche nutzt
Die Runtime ist das Programm, das die Datei lädt und auf deiner Hardware ausführt. Jede Runtime lädt nur bestimmte Dateitypen, also bestimmt die Runtime-Wahl auch, welche Datei du herunterlädst.
| Runtime | Dateien, die sie lädt | Hardware | Nutze sie, wenn |
|---|---|---|---|
llama.cpp | GGUF | CPU, Metal, CUDA, HIP, Vulkan | du direkte Kontrolle über lokale Inference willst oder ein kleines oder ungewöhnliches Ziel hast |
| Ollama | GGUF; unterstützte Safetensors-Importe (ein MLX-Pfad ist auf Apple Silicon in der Preview) | macOS, Linux, Windows | du einen verwalteten lokalen Service mit HTTP-API auf einem Laptop oder einer Workstation willst |
| LM Studio | GGUF; MLX auf Apple Silicon | macOS, Windows, Linux | du eine GUI willst, um Modelle zu durchsuchen, herunterzuladen und auszuprobieren |
| MLX-LM | Für MLX konvertierte Safetensors, Apples Array-Framework | Apple Silicon | du auf einem Mac in Python arbeitest, einschließlich LoRA-Fine-Tuning |
| vLLM, SGLang | Safetensors in BF16, FP8, AWQ, GPTQ und anderen Methoden | NVIDIA- und AMD-GPUs, andere Beschleuniger | du viele Nutzer bedienst und Batching, Throughput und eine OpenAI-artige API brauchst |
| Hugging Face Transformers | Safetensors, bei Quantization mit einer quantization_config | CPU und GPU | du forschst, Fine-Tuning betreibst oder bei moderater Last servierst; nutze vLLM oder SGLang für Produktion im großen Maßstab |
Text Generation Inference (TGI) ist für neue Deployments keine Option mehr. Hugging Face hat es in den Maintenance-Modus versetzt, das Repository inzwischen archiviert und verweist Nutzer auf vLLM und SGLang. Mehr zu Laptop-Tools findest du in Lokale LLMs auf macOS.
Speicherbedarf abschätzen
Sobald Runtime und Dateityp feststehen, lautet die nächste Frage, ob die Datei passt. Für Weight-Parameter bei Bit beträgt der rohe Speicher für die Weights ungefähr:
Ein 13B-Modell mit nominell Vier-Bit-Weights beginnt daher bei etwa 6,5 GB. Dasselbe Modell in BF16 braucht etwa 26 GB, und ein 70B-Modell in BF16 braucht etwa 140 GB. Die 6,5 GB sind eine Untergrenze: Das Modell läuft nicht zwangsläufig in 6,5 GB. Scales, Zero Points, Tensoren mit höherer Präzision, Embeddings, Metadaten, Runtime-Puffer, KV cache und Fragmentierung brauchen zusätzlichen Speicher.
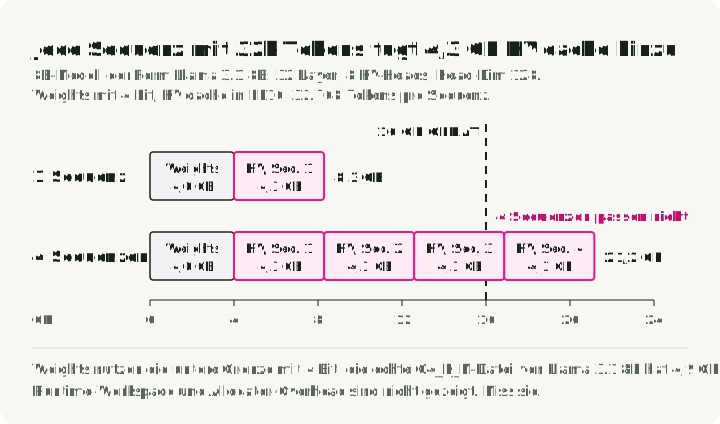
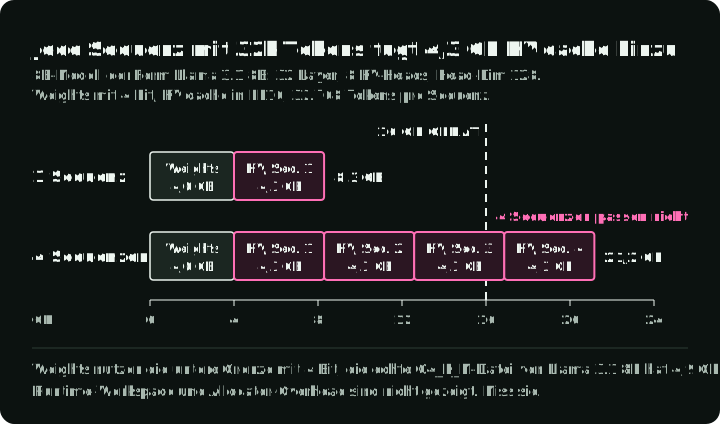
Der KV cache entscheidet oft über den Unterschied zwischen „lädt” und „serviert”. In einem Transformer mit Full Attention und konventionellem K/V-Cache speichert er die Attention-Keys und -Values jedes Tokens im Kontext und wächst daher mit der Kontextlänge und mit der Zahl der gleichzeitig bedienten Sequenzen. Ein 8B-Modell mit 32 Schichten, 8 KV-Heads und Head-Dimension 128 (die Form von Llama 3.1 8B) speichert für eine Sequenz mit 32.768 Tokens etwa 4,3 GB FP16-KV-cache: 2 × 32 × 8 × 128 × 32.768 × 2 Bytes. Bei 4 Bit belegen seine Weights etwa 4 GB. Das Diagramm unten addiert beides und zeigt, dass vier solche Sequenzen nicht mehr auf ein 16-GB-Gerät passen.
Die Funktion unten schätzt rohe Weights und den konventionellen K/V-Cache bei Full Attention, wie in Llama 3.1. Entnimm Schichtanzahl, KV-Head-Anzahl und Head-Dimension der config.json des Modells. Schichten mit Sliding-Window- oder Chunked Attention lassen ihren Cache nur bis zur Fenster- oder Chunk-Größe wachsen. Hybride Architekturen oder solche mit komprimiertem Cache brauchen ebenfalls die Cache-Berechnung ihrer Runtime.
def estimate_gb(params_b, bits, layers, kv_heads, head_dim, context, batch=1, kv_bytes=2):
    """Raw weights and conventional full-attention K/V cache, in GB (10**9 bytes)."""
    weights = params_b * 1e9 * bits / 8
    # Keys and values (2) for every layer, KV head, position, and sequence.
    kv_cache = 2 * layers * kv_heads * head_dim * context * batch * kv_bytes
    return round(weights / 1e9, 1), round(kv_cache / 1e9, 1)

# An 8B model shaped like Llama 3.1 8B, 4-bit weights, FP16 KV cache.
print(estimate_gb(8, 4, 32, 8, 128, 32_768))  # (4.0, 4.3)
print(estimate_gb(8, 4, 32, 8, 128, 32_768, batch=4))  # (4.0, 17.2)
Dies sind Schätzungen für rohe Weights und Cache, kein vollständiges Runtime-Budget. Das echte Q4_K_M-GGUF von Llama 3.1 8B hat 4,9 GB, nicht 4,0 GB, weil manche Tensoren mehr Bits behalten. Der Runtime-Workspace kommt obendrauf. Miss den Spitzenspeicher mit der echten maximalen Sequenz, der Batch-Policy, dem Cache-Dtype und der Parallelisierung. Der Abschnitt zum Serving-Speicher im Quantization-Guide behandelt die vollständige Formel, einschließlich KV-cache-Quantization.
Quantization kann den Speicherbedarf senken und manchmal die Geschwindigkeit verbessern, doch Kernels mit niedriger Bitbreite können auf nicht unterstützter Hardware auch langsamer sein. Vergleiche Aufgabenqualität und End-to-End-Throughput, nicht allein die Dateigröße.
GGUF-Quantization-Namen
Ein GGUF-Repository bietet meist eine Datei pro Quantization-Stufe an: Q3_K_M, Q4_K_M, Q5_K_M, Q6_K, Q8_0, IQ4_XS und weitere. Der Name verrät den Haupttyp und die Mischung:
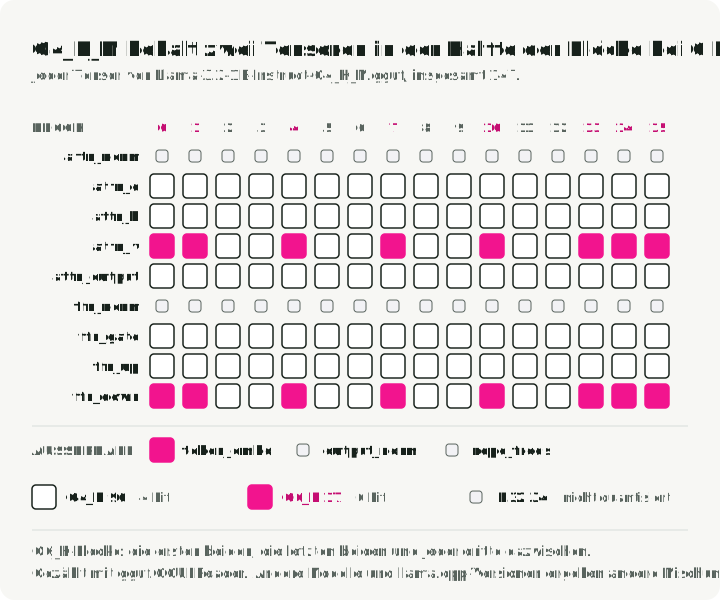
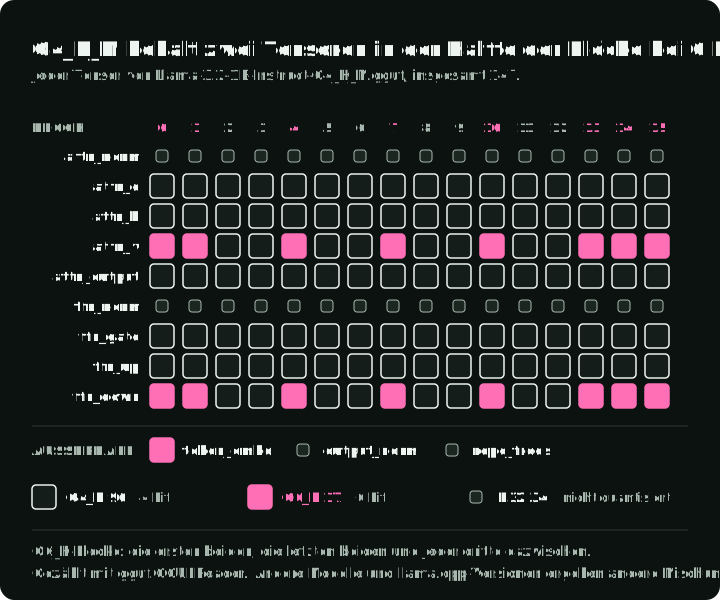
Q4ist die Bitbreite, die für die meisten Tensoren gilt.Kist das K-Quant-Blockschema.S,MundLstehen für kleine, mittlere und große Mischungen. Eine größere Mischung hält mehr Tensoren auf einem Typ mit höherer Präzision. BeiQ4_K_Msetzt der Quantizer die Weights für Attention-Value (attn_v) und Feed-Forward-Ausgabe (ffn_down) in etwa der Hälfte der Schichten aufQ6_K.Q4_K_Shebt weniger davon an, und nur aufQ5_K.Q8_0ist ein einfacher 8-Bit-Typ, der für fast jede Weight-Matrix verwendet wird.IQ-Namen, etwaIQ4_XS, sind i-Quants. Sie stützen sich meist auf eine Importance Matrix, die festhält, welche Weights bei Beispieltext am wichtigsten sind.
Das Raster unten ordnet jeden Tensor einer echten Datei nach Typ zu. Von den 147 Tensoren in Llama-3.2-1B-Instruct-Q4_K_M.gguf sind 96 Q4_K, 17 Q6_K und 34 nicht quantisierte F32-Tensoren, überwiegend Norms. Die Zeilen attn_v und ffn_down zeigen, welche Blöcke Q6_K bekommen.
Um eine Datei selbst zu prüfen, lade eine Quantization-Stufe herunter und zähle ihre Tensortypen mit dem gguf-Paket aus dem llama.cpp-Projekt:
hf download bartowski/Llama-3.2-1B-Instruct-GGUF Llama-3.2-1B-Instruct-Q4_K_M.gguf --local-dir .from collections import Counter
from gguf import GGUFReader
reader = GGUFReader("Llama-3.2-1B-Instruct-Q4_K_M.gguf")
print(Counter(t.tensor_type.name for t in reader.tensors))
# Counter({'Q4_K': 96, 'F32': 34, 'Q6_K': 17})
for t in reader.tensors:
if t.tensor_type.name == "Q6_K":
print(t.name) # token_embd.weight, blk.0.attn_v.weight, blk.0.ffn_down.weight, ...Die Mischungen variieren je nach Architektur und llama.cpp-Version. Behandle das Suffix daher als Rezeptnamen von llama.cpp und nicht als portable Angabe der Bitbreite. Die aktuelle Liste steht im Quantization-Guide von llama.cpp.
Nutze diese Angaben als Ausgangspunkte, nicht als Antworten:
Q4_K_Mist der übliche erste Versuch.Q5_K_ModerQ6_K, wenn der Speicher es erlaubt.Q3_K_Moder eineIQ3-Datei nur, um ein größeres Modell unterzubringen, und nur nach einer Qualitätsprüfung.
Vermeide pauschale Behauptungen, Q4_K_M sei von BF16 nicht zu unterscheiden oder ein größeres Q3-Modell schlage immer ein kleineres Q8-Modell. Nutze für den genauen Checkpoint eine kurze Vergleichsreihe:
- ein Referenzartefakt mit hoher Präzision oder ein vertrauenswürdiges Referenzartefakt
- ein Kandidat nahe an der Speichergrenze
- ein kleinerer Kandidat mit mehr Reserve
Führe auf allen dreien dieselben Prompts, Structured-Output-Prüfungen, Long-Context-Fälle und denselben Latency-Test aus.
Auswahl-Workflow
Die Abschnitte oben behandeln jeweils eine Ebene. Der Workflow bringt sie in eine Reihenfolge, und eine Änderung an irgendeiner Eingabe schickt dich erneut durch die Schritte.
1. Den Aufgabenvertrag festlegen
Definiere Sprache, Modalität, Kontextlänge, Tool- oder Schema-Schnittstelle, Sicherheitsanforderungen, Lizenzanforderungen und Evaluations-Slices. Vergleiche Checkpoints in einer Darstellung, die genau genug ist, damit die Quantization die erste Runde nicht entscheidet.
2. Den Checkpoint auswählen
Wähle den kleinsten Checkpoint, der deine Qualitäts- und Verhaltensprüfungen besteht. Halte das genaue Repository und die Revision, den Tokenizer, das Chat-Template und einen eventuell nötigen Reasoning-Parser fest.
3. Die Runtime auswählen
Wähle eine Runtime aus der Runtime-Tabelle. Prüfe dann für das genaue Artefakt die Architekturunterstützung, das Hardware-Backend, die Parallelisierung, die Quantization-Kernels, Structured Output und Adapter.
4. Ein gemessenes Speicherbudget aufstellen
Rechne Weights, KV cache, Runtime-Workspace, erwartete Concurrency und Reserve für das Betriebssystem oder gemeinsam laufende Prozesse ein. Dass eine Datei in RAM oder VRAM passt, ist notwendig, aber nicht ausreichend.
5. Eine Darstellung wählen und validieren
Bevorzuge Artefakte des Herausgebers mit dokumentierter Calibration und Herkunft. Wenn du eine Community-Konvertierung nutzt, halte Quell-Revision, Konverter-Revision, Quantization-Rezept, Calibration- oder Importance-Daten und Hashes fest.
6. Die Release-Einheit benchmarken
Miss Aufgabenqualität, Korrektheit von Schema und Tool Calls, Time to First Token, Output-Throughput, Spitzenspeicher und Fehler bei Ziel-Kontext und Ziel-Concurrency. Wiederhole die Messung nach jeder Änderung an Checkpoint, Runtime, Kernel oder Quantization-Einstellung.
Ausgangspunkte für typische Setups
Das sind erste Kandidaten, die du mit dem obigen Workflow benchmarkst, keine endgültigen Antworten.
| Setup | Erster Kandidat | Prüfen, bevor du dich festlegst |
|---|---|---|
| Chat-Assistent auf einem 16-GB-MacBook | 7B–8B Instruct, Q4_K_M GGUF, in Ollama oder LM Studio | Der Spitzenspeicher bei deiner Kontextlänge lässt Platz für OS und andere Apps |
| RAG-Service auf einer 24-GB-GPU | 7B–14B Instruct, AWQ oder FP8 Safetensors, auf vLLM | Weights plus KV cache bleiben bei deiner Concurrency unter 24 GB |
| Domain-Fine-Tuning auf einer Cloud-GPU | Base- oder Instruct-Checkpoint in BF16 Safetensors, mit Transformers | Ob das Instruct-Verhalten deinem Trainingsziel hilft oder entgegenwirkt |
| API für viele Nutzer | Instruct in BF16, FP8 oder AWQ, auf vLLM oder SGLang | Throughput und Time to First Token bei Ziel-Concurrency |
Ein Name im Detail
Angenommen, ein Repository heißt Acme-32B-A3B-Instruct-AWQ. Jeder Teil wirft eine Frage auf, und jede Antwort steht an einer bestimmten Stelle:
| Teil | Frage | Wo du nachsiehst |
|---|---|---|
Acme | Welche Familie, Lizenz und Revision? | Model Card (README.md), LICENSE, der Commit-Hash, den du festlegst |
32B | Gesamte Weights oder eine andere Konvention des Herausgebers? | Model Card; config.json |
A3B | Wie viele Experts, und wie viele pro Token? | config.json: num_experts oder num_local_experts, num_experts_per_tok |
Instruct | Welches Chat-Template und welches Tool-Call-Format? | chat_template in tokenizer_config.json; Model Card |
AWQ | Welche Bitbreite, Group Size und Calibration? | quantization_config in config.json; Model Card für die Calibration Data |
| (nicht im Namen) | Unterstützt die Runtime diese Architektur und diese Quantization? | Die Dokumentation der Runtime-Version, die du festlegst |
Das Skript unten liest die config.json zweier öffentlicher Repositories und gibt die Felder aus der Tabelle aus. Es lädt nur die Konfigurationsdatei herunter, nicht die Weights.
import json

from huggingface_hub import hf_hub_download

def describe(repo_id: str, revision: str = "main") -> None:
    path = hf_hub_download(repo_id, "config.json", revision=revision)
    config = json.load(open(path))
    quant = config.get("quantization_config", {})
    experts = config.get("num_experts") or config.get("num_local_experts")
    print(repo_id)
    print("  architecture:", config.get("architectures"))
    print("  quantization:", quant.get("quant_method"), quant.get("bits"), quant.get("group_size"))
    print("  experts:", experts, "per token:", config.get("num_experts_per_tok"))

describe("Qwen/Qwen2.5-7B-Instruct-AWQ")  # quantization: awq 4 128; experts: None
describe("Qwen/Qwen3-30B-A3B")  # quantization: None; experts: 128 per token: 8
Fazit
Die Modellauswahl wird weniger verwirrend, sobald Labels nicht mehr eine Kategorie teilen. Die Training-Rolle sagt, welches Verhalten optimiert wurde. Die Architektur sagt, wie die Berechnung organisiert ist. Runtimes bestimmen, was auf deiner Hardware effizient läuft, Container, wie Artefakte gespeichert werden, und die Quantization, wie manche Tensoren approximiert wurden.
Wähle zuerst den Checkpoint, dann die Runtime, dann die Datei. Halte die genaue Herkunft fest und lass eine Aufgaben-Evaluation die Release-Artefakte vergleichen. Als nächsten Schritt führe den Vergleich mit drei Dateien aus dem GGUF-Abschnitt mit deinen eigenen Prompts aus.
Referenzen
- Chat-Templates in Transformers - Nachrichtenformatierung für Base- und instruction-tuned Causal-Language-Modelle.
- Distilling the Knowledge in a Neural Network - Das ursprüngliche Distillation-Paper von Hinton, Vinyals und Dean.
- Switch Transformers - Die Sparse-Expert-Routing-Architektur von Fedus, Zoph und Shazeer.
- GGUF-Spezifikation und Quantization-Leitfaden von llama.cpp
- Quellcode des llama.cpp-Quantizers - Die Regeln für den Typ pro Tensor bei jedem GGUF-Rezept.
- Quantization-Konzepte in Hugging Face Transformers
- GPTQ-Paper
- AWQ-Paper
- Quantization-Dokumentation von vLLM
- Quantization-Dokumentation von SGLang
- Text-Generation-Inference-Repository - Hinweis zum Maintenance-Modus.