Варианты open-weight LLM, форматы и квантизация

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Названия вроде Acme-32B-A3B-Instruct-AWQ выглядят сложными, потому что объединяют несколько независимых решений: семейство и размер, архитектуру, роль обучения и квантизацию. Репозиторий может упаковать эти веса в шардированный Safetensors, а конверсия от сообщества того же чекпоинта появится как Q4_K_M.gguf.
Эти метки относятся к разным категориям: GPTQ и AWQ — методы квантизации, GGUF — контейнер и экосистема рантаймов, MoE — архитектура. Если читать слои по отдельности, выбрать, что скачивать, проще.
Руководство для инженеров, которые выбирают open-weight модель для локального инференса или GPU-сервинга. Вы научитесь читать каждую часть названия модели, выбирать рантайм и проверять, что файл помещается в память, прежде чем запускать бенчмарк.
Краткий выбор для деплоя смотрите в Форматы квантизации LLM.
Читайте артефакт модели по шести слоям
| Слой | Пример | На какой вопрос отвечает |
|---|---|---|
| Семейство и ревизия | Model-3.1, хэш коммита | Какие веса и какой контракт токенизатора? |
| Роль обучения | Base, Instruct, настроенные на ризонинг | Какое поведение оптимизировали? |
| Архитектура | Dense, MoE, общие и активные параметры | Какие ядра и какая раскладка памяти нужны? |
| Числовое представление | BF16, FP8, GPTQ 4-bit, AWQ 4-bit | Как представлены или квантизованы тензоры? |
| Контейнер и раскладка | Шарды Safetensors, GGUF | Как упакованы тензоры и метаданные? |
| Рантайм | Transformers, vLLM, llama.cpp | Какой загрузчик и какой путь по железу исполняют модель? |
На рисунке ниже два примера названий разложены на части, и каждая часть стоит под своим слоем. Оба названия указывают семейство, роль обучения, архитектуру и числовое представление. Контейнер называет только файл GGUF, а рантайм не называет ни одно из них.
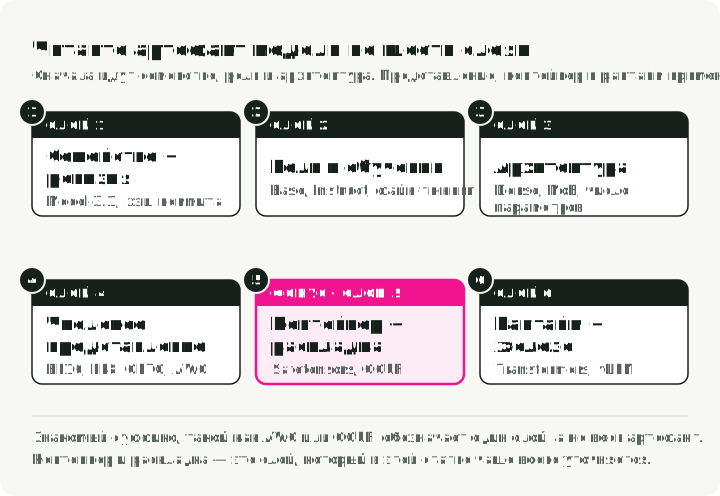
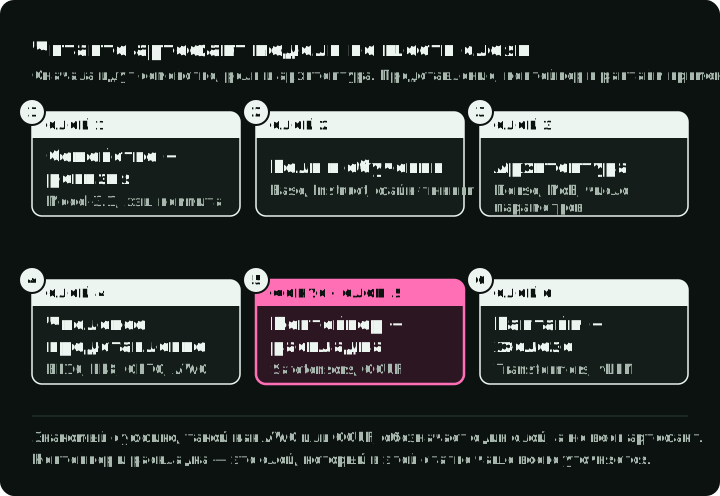
Некоторые метки описывают, как модель обучали, а не часть файла. Две из них: Distill (обучена повторять более крупную модель-учителя) и QAT (quantization-aware training, обучение с учётом квантизации). Чекпоинт может быть одновременно дистиллированным, настроенным на инструкции, настроенным на ризонинг и MoE.
Метка “open-source” требует отдельной проверки. Если модель лишь публикует скачиваемые веса, не считайте, что её лицензия соответствует определению open source или разрешает ваш сценарий. Прочитайте карточку модели и лицензию раньше, чем сравнивать архитектуры и бенчмарки.
Роли обучения: Base, Instruct, ризонинг, дистилляция
Base
Base-чекпоинт обучен главным образом предсказывать следующий токен. Он полезен для продолжения претрейнинга, контролируемых исследований или адаптации, когда вы хотите сами задавать поведение в ответ на инструкции. Он может продолжить промпт, а не ответить на него. Спросите его “Какая столица Франции?”, и он может продолжить фразой “Какая столица Германии?”, потому что промпт похож на начало списка вопросов.
Не считайте, что любой файн-тюнинг нужно начинать с base. Instruct-чекпоинт может быть лучшей инициализацией, если его текущее поведение совпадает с целевым. Проверьте на своём эвале, что текущее поведение не мешает новой цели.
Instruct или чат
Такие чекпоинты проходят пост-трейнинг, который должен улучшить следование инструкциям и ведение диалога. Точный рецепт может включать файн-тюнинг с учителем, оптимизацию предпочтений, обучение с подкреплением, дистилляцию или их сочетание. Это не обязательно файн-тюнинг с учителем с последующим RLHF.
Берите instruct-чекпоинт как первый базовый вариант ассистента. Проверьте его чат-шаблон, поддерживаемый формат tool call, обработку системных сообщений и характер отказов. Документация Transformers по чат-шаблонам объясняет, почему важен точный формат сообщений. Одной метки “Instruct” недостаточно, чтобы гарантировать надёжный JSON или tool use.
Настроенные на ризонинг
Ориентированные на ризонинг чекпоинты оптимизируют на задачах или траекториях, которые поощряют многошаговое решение. Одни показывают текст ризонинга, другие отделяют его через парсер в сервинге, третьи выдают только ответ. Более длинная генерация не гарантирует достоверный ризонинг или меньше галлюцинаций.
Берите такой чекпоинт, когда он улучшает сложные срезы эвала с учётом выходных токенов, латентности и верификации. Рутинное извлечение данных или классификация могут стать медленнее, но не лучше.
Дистиллированные
Дистилляция переносит поведение учителя или данные, сгенерированные учителем, в другую модель. Ученик может быть меньше, того же размера или иметь другую структуру. Стабильного правила “70–80% качества при половине размера” нет: сохранённое качество зависит от учителя, данных, цели, ёмкости ученика и оценки. В оригинальной статье о дистилляции знаний Хинтона, Виньялса и Дина тоже нет утверждения о фиксированной доле качества.
Считайте Distill сведением о происхождении обучения, а затем прогоняйте чекпоинт через бенчмарк, как любой другой.
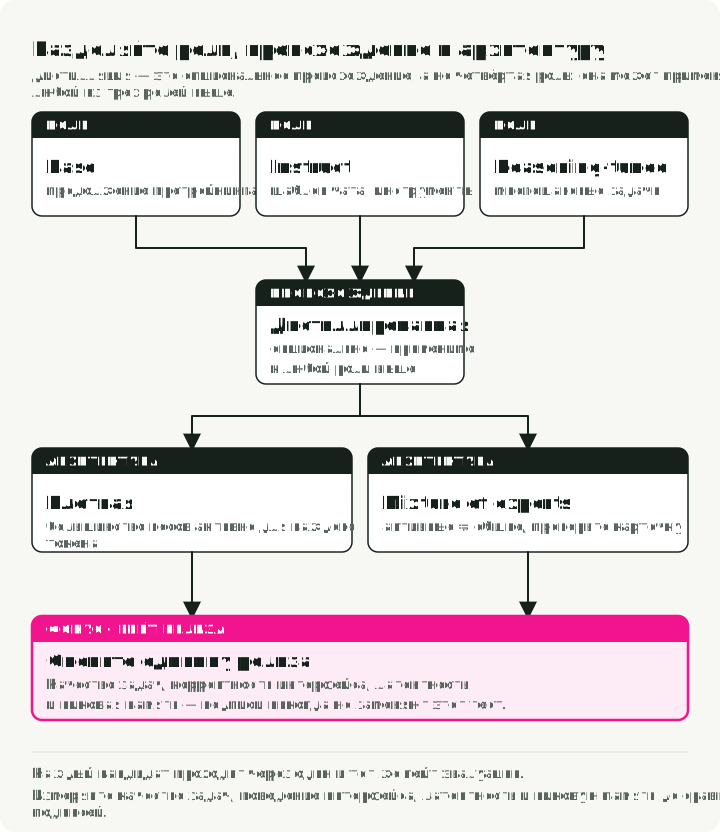
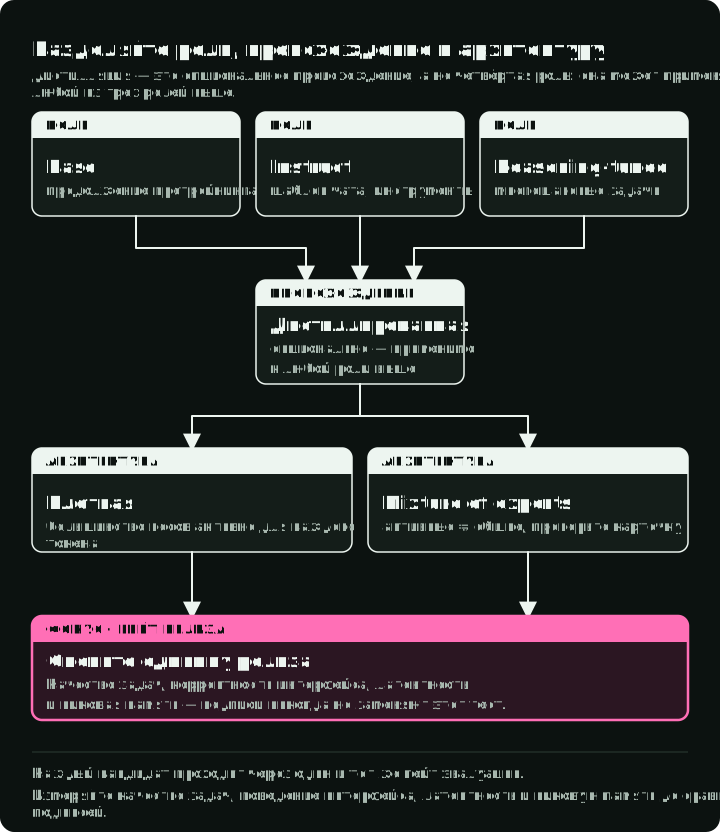
На рисунке ниже один промпт отправлен всем трём ролям, и видно, что возвращает каждая, зачем её выбирают и чего она стоит. Метки происхождения вроде Distill и QAT могут относиться к любой из них.
Dense- и MoE-модели
Роль обучения говорит, какое поведение есть у чекпоинта. Архитектура говорит, как организованы веса, а от этого зависят память и поддержка рантаймами.
Dense-модели
В прямом проходе каждого токена участвует большинство параметров. Число параметров приблизительно показывает объём хранения весов. Память во время работы включает ещё KV cache, активации или рабочее пространство, накладные расходы аллокатора, а иногда дублированное или шардированное состояние.
Mixture of Experts
Слой MoE направляет каждый токен в подмножество экспертных feed-forward сетей. Статья о Switch Transformer описывает один из вариантов такого роутинга, другие семейства направляют токены иначе. Названия вроде A3B часто означают, что на токен активно примерно три миллиарда параметров, но соглашения об именах зависят от семейства. Общее число параметров, число активных параметров, число экспертов и схему роутинга смотрите в карточке модели.
Число активных параметров описывает вычисления, которые задействует роутинг, а не размещение весов. Например, expert parallelism в vLLM раскладывает экспертные слои по рангам expert-parallel и вычисляет долю экспертов каждого ранга из общего числа экспертов. Другие рантаймы могут размещать или выгружать веса иначе. Поэтому модель с 30B параметров всего и 3B активных не обязана помещаться так же, как dense-модель на 3B.
На рисунке ниже показан один MoE-слой Qwen3-30B-A3B: каждый токен использует 8 из 128 экспертов, а следующий токен может использовать любые другие 8, поэтому в памяти остаются все. Столбцы показывают dense-модель на 3B и модель 30B-A3B в одном масштабе в 4 битах. MoE-модель хранит в десять раз больше весов, но на каждый токен читает только 3B активных параметров, около 1,5 GB.
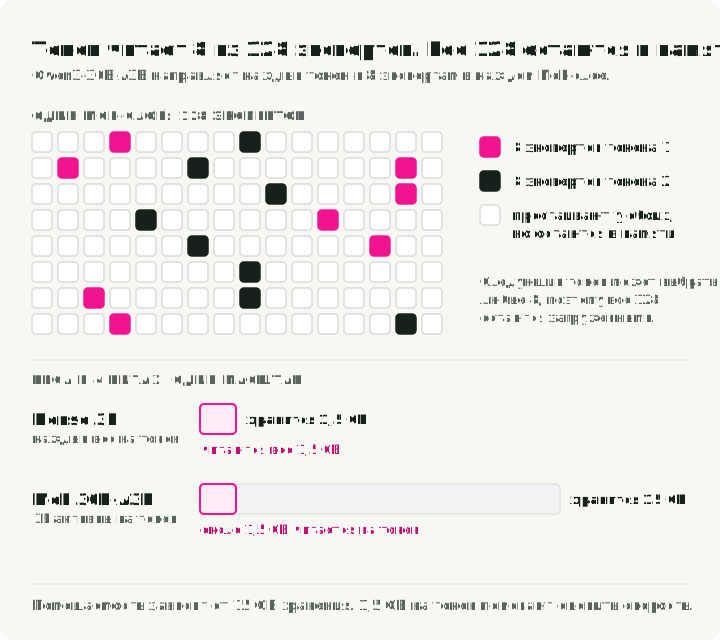
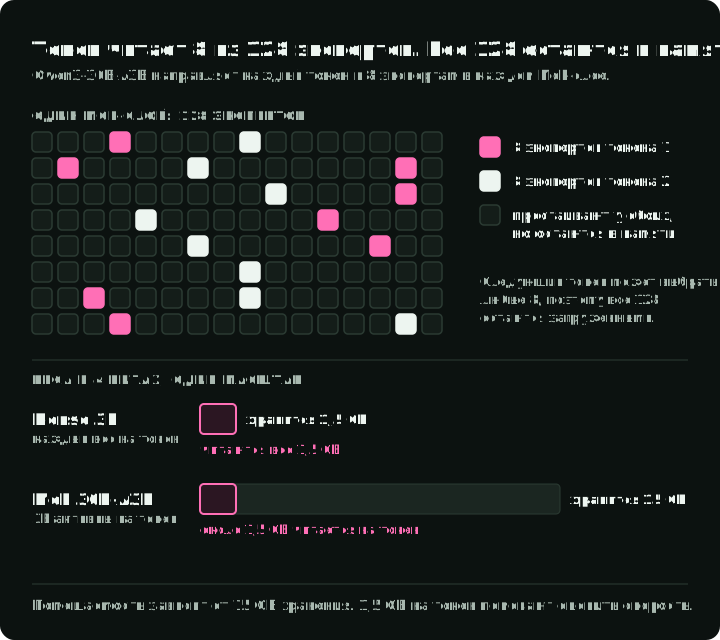
Поддержка рантаймов тоже зависит от архитектуры. Перед загрузкой проверьте реализацию модели, поддержку expert-parallel или tensor-parallel, ядра квантизации и максимальный контекст.
Контейнеры и методы квантизации
Архитектура определяет, какие тензоры существуют. Контейнер определяет, как эти тензоры хранятся на диске, а метод квантизации определяет, сколько бит приходится на каждый из них.
Safetensors
Safetensors — безопасный формат сериализации тензоров, который обычно используют в репозиториях Hugging Face. У модели может быть несколько шардов .safetensors, а также файлы конфигурации, токенизатора и генерации. Эти тензоры могут быть в BF16/FP16 или заранее квантизованы методом вроде GPTQ или AWQ. Transformers читает метод из записи quantization_config и загружает подходящий бэкенд, как описывает его процесс квантизации.
Одно расширение не говорит ни о точности, ни о совместимости с рантаймом. Проверьте config.json, конфигурацию квантизации, карточку модели, dtype тензоров и документацию рантайма. Короткий скрипт, который это делает, есть в разделе “Разбор названия” ниже.
GGUF
GGUF упаковывает тензоры и метаданные для экосистемы ggml/llama.cpp. llama.cpp загружает GGUF и поддерживает бэкенды Metal, CUDA, HIP, Vulkan и пути для CPU. Совместимость по-прежнему определяют архитектура модели и качество конверсии.
GGUF — это контейнер. Он может хранить тензоры и высокой точности, и квантизованные. Мультимодальным моделям может понадобиться отдельный файл проектора или энкодера. Правило “один файл GGUF содержит всё” не универсально.
GPTQ и AWQ
GPTQ и AWQ — методы пост-трейнинг квантизации весов, а не расширения файлов. Их артефакты обычно используют Safetensors плюс конфигурацию, специфичную для метода. Движкам сервинга нужны ядра, совместимые с методом, разрядностью, размером группы, архитектурой модели и железом.
Ни один из методов не побеждает по качеству всегда и везде. Важны калибровочные данные, реализация, путь ядра и задача. Поддержка в рантаймах меняется, поэтому проверяйте конкретный артефакт на той версии, которую вы закрепили. Рядом с этим решением сверяйтесь с официальными страницами квантизации в Transformers и квантизации в vLLM.
FP8 и QAT
В названиях репозиториев встречаются ещё две метки. FP8 — числовой формат, а не метод квантизации: каждый вес хранится как 8-битное число с плавающей точкой. Он работает быстро, только если его поддерживают и GPU, и рантайм. Например, vLLM запускает веса и активации FP8 на GPU NVIDIA Ada, Hopper и Blackwell, а на Turing и Ampere переходит на FP8 только для весов (weight-only). Прежде чем выбирать репозиторий с -FP8, проверьте таблицу железа в документации рантайма.
Чекпоинт QAT (обучение с учётом квантизации) обучен работать с целевой низкобитной схемой, например с файлом GGUF -qat-q4_0. Начните с формата, предусмотренного издателем. Смена схемы квантизации может уменьшить пользу QAT; заново оцените сконвертированный артефакт. Руководство по квантизации моделей подробнее разбирает PTQ и QAT и числовые форматы.
Рантаймы и когда какой использовать
Рантайм — это программа, которая загружает файл и запускает его на вашем железе. Каждый рантайм загружает фиксированный набор типов файлов, поэтому выбор рантайма заодно определяет, какой файл скачивать.
| Рантайм | Какие файлы загружает | Железо | Когда использовать |
|---|---|---|---|
llama.cpp | GGUF | CPU, Metal, CUDA, HIP, Vulkan | Нужен прямой контроль над локальным инференсом либо небольшая или необычная целевая платформа |
| Ollama | GGUF; поддерживаемые импорты Safetensors (путь MLX на Apple Silicon в превью) | macOS, Linux, Windows | Нужен управляемый локальный сервис с HTTP API на ноутбуке или рабочей станции |
| LM Studio | GGUF; MLX на Apple Silicon | macOS, Windows, Linux | Нужен GUI, чтобы просматривать, скачивать и пробовать модели |
| MLX-LM | Safetensors, сконвертированные для MLX, фреймворка массивов от Apple | Apple Silicon | Вы работаете на Python на Mac, в том числе с файн-тюнингом LoRA |
| vLLM, SGLang | Safetensors в BF16, FP8, AWQ, GPTQ и других методах | GPU NVIDIA и AMD, другие ускорители | Вы обслуживаете много пользователей и вам нужны батчинг, throughput и OpenAI-совместимый API |
| Hugging Face Transformers | Safetensors, с quantization_config для квантизованных | CPU и GPU | Вы занимаетесь исследованиями, файн-тюнингом или сервингом при умеренной нагрузке; для крупного продакшена используйте vLLM или SGLang |
Text Generation Inference (TGI) больше не вариант для новых деплоев. Hugging Face перевела его в режим поддержки, затем архивировала репозиторий и направляет пользователей к vLLM и SGLang. Об инструментах для ноутбука подробнее — в статье Локальные LLM на macOS.
Оценка памяти
Когда рантайм и тип файла известны, остаётся вопрос, помещается ли файл. Для параметров весов при битах сырое хранение весов составляет примерно:
Поэтому модель на 13B с номинальными четырёхбитными весами начинается примерно с 6,5 GB. Та же модель в BF16 требует около 26 GB, а модель на 70B в BF16 — около 140 GB. Цифра 6,5 GB — нижняя граница: модель не обязательно запустится в 6,5 GB. Память добавляют масштабы, нулевые точки, тензоры более высокой точности, эмбеддинги, метаданные, буферы рантайма, KV cache и фрагментация.
Именно KV cache часто решает, “загрузится” модель или “будет обслуживать запросы”. В Transformer с полным аттеншном и обычным K/V-кэшем он хранит ключи и значения аттеншна для каждого токена контекста, поэтому растёт с длиной контекста и с числом одновременно обслуживаемых последовательностей. Модель на 8B с 32 слоями, 8 KV-головами и размерностью головы 128 (так устроена Llama 3.1 8B) хранит около 4,3 GB KV cache в FP16 для одной последовательности из 32 768 токенов: 2 × 32 × 8 × 128 × 32 768 × 2 байта. Её веса в 4 битах занимают около 4 GB. График ниже складывает эти два числа и показывает, что четыре такие последовательности уже не помещаются в устройство на 16 GB.
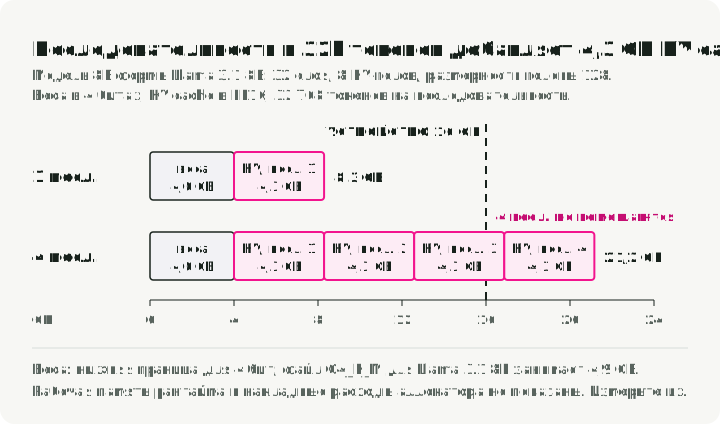
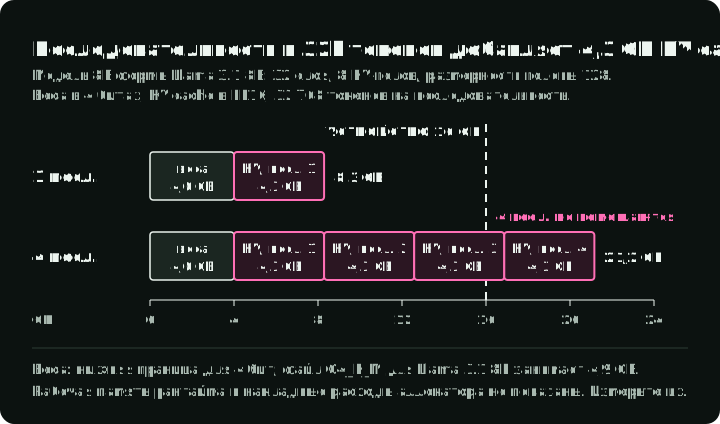
Функция ниже оценивает сырые веса и обычный K/V-кэш для полного аттеншна, как в Llama 3.1. Число слоёв, число KV-голов и размерность головы берите из config.json модели. Слои со скользящим окном или блочным аттеншном перестают увеличивать кэш при достижении размера окна или блока. Для гибридных архитектур и архитектур со сжатым кэшем тоже нужен расчёт кэша из их рантайма.
def estimate_gb(params_b, bits, layers, kv_heads, head_dim, context, batch=1, kv_bytes=2):
    """Raw weights and conventional full-attention K/V cache, in GB (10**9 bytes)."""
    weights = params_b * 1e9 * bits / 8
    # Keys and values (2) for every layer, KV head, position, and sequence.
    kv_cache = 2 * layers * kv_heads * head_dim * context * batch * kv_bytes
    return round(weights / 1e9, 1), round(kv_cache / 1e9, 1)

# An 8B model shaped like Llama 3.1 8B, 4-bit weights, FP16 KV cache.
print(estimate_gb(8, 4, 32, 8, 128, 32_768))  # (4.0, 4.3)
print(estimate_gb(8, 4, 32, 8, 128, 32_768, batch=4))  # (4.0, 17.2)
Это оценки сырых весов и кэша, а не полный бюджет рантайма. Настоящий Q4_K_M GGUF модели Llama 3.1 8B весит 4,9 GB, а не 4,0 GB, потому что часть тензоров сохраняет больше бит. К этому добавляется рабочее пространство рантайма. Измеряйте пиковую память при реальной максимальной длине последовательности, политике батчинга, dtype кэша и параллелизме. Раздел о памяти при сервинге в руководстве по квантизации даёт полную формулу, включая квантизацию KV cache.
Квантизация может уменьшить память и иногда ускорить работу, но низкобитные ядра на неподдерживаемом железе могут и замедлить её. Сравнивайте качество на задаче и сквозной throughput, а не один размер файла.
Названия квантизаций GGUF
Репозиторий GGUF обычно предлагает по одному файлу на каждый уровень квантизации: Q3_K_M, Q4_K_M, Q5_K_M, Q6_K, Q8_0, IQ4_XS и другие. Название сообщает основной тип и состав смеси:
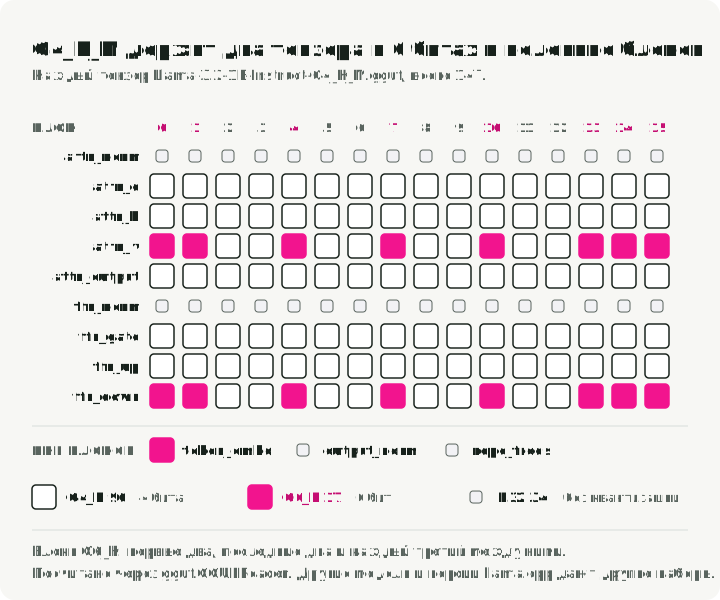
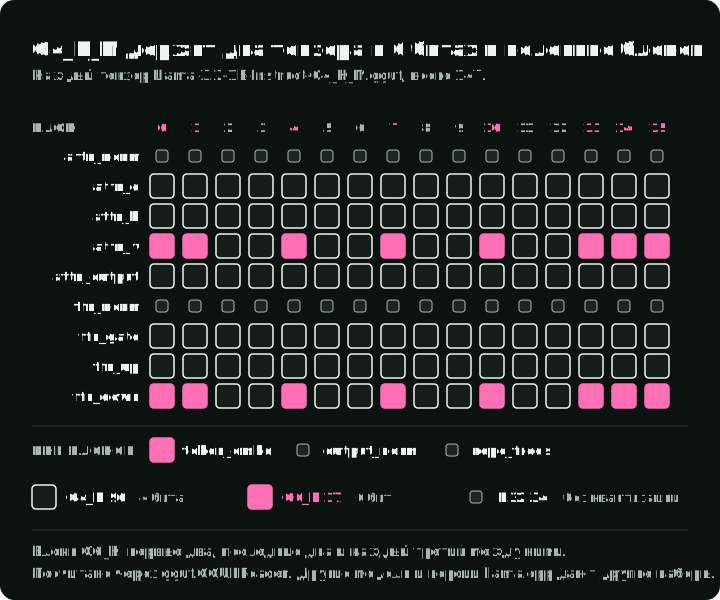
Q4— разрядность, которую используют для большинства тензоров.K— схема блоков K-quant.S,MиL— малая, средняя и большая смесь. Чем больше смесь, тем больше тензоров хранится в типе более высокой точности. ВQ4_K_Mквантизатор переводит веса значений аттеншна (attn_v) и выхода feed-forward (ffn_down) вQ6_Kпримерно в половине слоёв.Q4_K_Sповышает меньше таких тензоров и только доQ5_K.Q8_0— простой 8-битный тип, который используют почти для всех матриц весов.- Названия
IQ, напримерIQ4_XS, — это i-quants. Они обычно опираются на матрицу важности (importance matrix), которая фиксирует, какие веса важнее всего на примере текста.
Сетка ниже показывает все тензоры реального файла по типам. Из 147 тензоров в Llama-3.2-1B-Instruct-Q4_K_M.gguf 96 имеют тип Q4_K, 17 — Q6_K, а 34 — неквантизованные тензоры F32, в основном нормализации. По строкам attn_v и ffn_down видно, какие блоки получают Q6_K.
Чтобы проверить файл самостоятельно, скачайте один уровень квантизации и посчитайте типы его тензоров пакетом gguf из проекта llama.cpp:
hf download bartowski/Llama-3.2-1B-Instruct-GGUF Llama-3.2-1B-Instruct-Q4_K_M.gguf --local-dir .from collections import Counter
from gguf import GGUFReader
reader = GGUFReader("Llama-3.2-1B-Instruct-Q4_K_M.gguf")
print(Counter(t.tensor_type.name for t in reader.tensors))
# Counter({'Q4_K': 96, 'F32': 34, 'Q6_K': 17})
for t in reader.tensors:
if t.tensor_type.name == "Q6_K":
print(t.name) # token_embd.weight, blk.0.attn_v.weight, blk.0.ffn_down.weight, ...Смеси различаются по архитектурам и версиям llama.cpp, поэтому считайте суффикс названием рецепта llama.cpp, а не переносимой спецификацией разрядности. Актуальный список смотрите в руководстве по квантизации llama.cpp.
Используйте их как отправные точки, а не как ответы:
Q4_K_M— обычная первая попытка.Q5_K_MилиQ6_K, когда позволяет память.Q3_K_Mили файлIQ3только чтобы уместить более крупную модель, и только после проверки качества.
Избегайте универсальных утверждений, что Q4_K_M неотличим от BF16 или что более крупная модель в Q3 всегда лучше меньшей в Q8. Используйте короткое сравнение для конкретного чекпоинта:
- артефакт высокой точности или проверенный эталонный артефакт
- один кандидат около предела памяти
- один кандидат поменьше с большим запасом
Прогоните на всех трёх одни и те же промпты, проверки structured output, случаи с длинным контекстом и тест латентности.
Порядок выбора
Каждый из разделов выше охватывает один слой. Порядок выбора расставляет их по очереди, а изменение любого входного условия возвращает вас к началу шагов.
1. Зафиксируйте контракт задачи
Определите язык, модальность, длину контекста, интерфейс инструментов или схемы, ограничения безопасности, требования к лицензии и срезы эвала. Сравнивайте чекпоинты в представлении, достаточно точном, чтобы квантизация не решала исход первого раунда.
2. Выберите чекпоинт
Берите наименьший чекпоинт, который проходит ваши проверки качества и поведения. Запишите точный репозиторий и ревизию, токенизатор, чат-шаблон и нужный парсер ризонинга.
3. Выберите рантайм
Выберите рантайм по таблице рантаймов. Затем проверьте для конкретного артефакта поддержку архитектуры, бэкенд железа, параллелизм, ядра квантизации, structured output и адаптеры.
4. Составьте измеренный бюджет памяти
Учтите веса, KV cache, рабочее пространство рантайма, ожидаемую конкурентность и запас для операционной системы или соседних процессов. Если файл помещается в RAM или VRAM, это необходимое, но недостаточное условие.
5. Выберите и проверьте представление
Предпочитайте артефакты от издателя с документированной калибровкой и происхождением. Если используете конверсию от сообщества, запишите ревизию источника, ревизию конвертера, рецепт квантизации, данные калибровки или важности и хэши.
6. Прогоните бенчмарк единицы релиза
Измерьте качество на задаче, корректность схемы и tool call, время до первого токена, выходной throughput, пиковую память и сбои на целевом контексте и конкурентности. Повторяйте после смены любого чекпоинта, рантайма, ядра или настройки квантизации.
Отправные точки для типичных конфигураций
Это первые кандидаты для бенчмарка по порядку выбора выше, а не окончательные ответы.
| Конфигурация | Первый кандидат | Что проверить перед решением |
|---|---|---|
| Чат-ассистент на MacBook с 16 GB | 7B–8B Instruct, Q4_K_M GGUF, в Ollama или LM Studio | Пиковая память при вашей длине контекста оставляет место для ОС и других приложений |
| RAG-сервис на одном GPU с 24 GB | 7B–14B Instruct, Safetensors в AWQ или FP8, на vLLM | Веса плюс KV cache при вашей конкурентности укладываются в 24 GB |
| Доменный файн-тюнинг на облачном GPU | Чекпоинт Base или Instruct в BF16 Safetensors, с Transformers | Помогает ли поведение instruct вашей цели обучения или мешает ей |
| API для многих пользователей | Instruct в BF16, FP8 или AWQ, на vLLM или SGLang | Throughput и время до первого токена при целевой конкурентности |
Разбор названия
Допустим, репозиторий называется Acme-32B-A3B-Instruct-AWQ. Каждая часть задаёт вопрос, и ответ на каждый лежит в определённом месте:
| Часть | Вопрос | Где проверить |
|---|---|---|
Acme | Какое семейство, лицензия и ревизия? | Карточка модели (README.md), LICENSE, хэш коммита, который вы закрепляете |
32B | Общее число весов или другое соглашение издателя? | Карточка модели; config.json |
A3B | Сколько всего экспертов и сколько на токен? | config.json: num_experts или num_local_experts, num_experts_per_tok |
Instruct | Какой чат-шаблон и какой формат tool call? | chat_template в tokenizer_config.json; карточка модели |
AWQ | Какая разрядность, размер группы и калибровка? | quantization_config в config.json; карточка модели для данных калибровки |
| (нет в названии) | Поддерживает ли рантайм эту архитектуру и квантизацию? | Документация версии рантайма, которую вы закрепляете |
Скрипт ниже читает config.json двух публичных репозиториев и печатает поля из таблицы. Он скачивает только файл конфигурации, а не веса.
import json

from huggingface_hub import hf_hub_download

def describe(repo_id: str, revision: str = "main") -> None:
    path = hf_hub_download(repo_id, "config.json", revision=revision)
    config = json.load(open(path))
    quant = config.get("quantization_config", {})
    experts = config.get("num_experts") or config.get("num_local_experts")
    print(repo_id)
    print("  architecture:", config.get("architectures"))
    print("  quantization:", quant.get("quant_method"), quant.get("bits"), quant.get("group_size"))
    print("  experts:", experts, "per token:", config.get("num_experts_per_tok"))

describe("Qwen/Qwen2.5-7B-Instruct-AWQ")  # quantization: awq 4 128; experts: None
describe("Qwen/Qwen3-30B-A3B")  # quantization: None; experts: 128 per token: 8
Заключение
Выбор модели становится понятнее, когда метки перестают делить одну категорию. Роль обучения говорит, какое поведение оптимизировали. Архитектура говорит, как организованы вычисления. Рантаймы говорят, что эффективно исполняется на вашем железе, контейнеры — как хранятся артефакты, а квантизация — как были приближены некоторые тензоры.
Сначала выберите чекпоинт, затем рантайм, затем файл. Сохраняйте точное происхождение и дайте одному эвалу на вашей задаче сравнить артефакты релиза. В качестве следующего шага прогоните сравнение трёх файлов из раздела про GGUF на своих промптах.
Ссылки
- Шаблоны чата Transformers - Форматирование сообщений для базовых и instruction-tuned каузальных языковых моделей.
- Distilling the Knowledge in a Neural Network - Оригинальная статья Хинтона, Виньялса и Дина о дистилляции.
- Switch Transformers - Архитектура разреженного роутинга экспертов Федуса, Зофа и Шазира.
- Спецификация GGUF и Руководство по квантизации llama.cpp
- Исходный код квантизатора llama.cpp - Правила выбора типа для каждого тензора в каждом рецепте GGUF.
- Основы квантизации в Hugging Face Transformers
- Статья о GPTQ
- Статья об AWQ
- Документация по квантизации vLLM
- Документация по квантизации SGLang
- Репозиторий Text Generation Inference - Уведомление о режиме поддержки.