Variantes, formatos e quantização de LLMs com pesos abertos

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Nomes como Acme-32B-A3B-Instruct-AWQ parecem densos porque combinam várias decisões independentes: família e dimensão, arquitetura, função no treino e quantização. Um repositório pode empacotar esses pesos como Safetensors fragmentados, enquanto uma conversão da comunidade do mesmo checkpoint surge como Q4_K_M.gguf.
Estas etiquetas não pertencem todas à mesma categoria: GPTQ e AWQ são métodos de quantização, GGUF é um contentor e um ecossistema de runtime, e MoE é uma arquitetura. Ler as camadas separadamente facilita a escolha do que descarregar.
Este guia destina-se a engenheiros que escolhem um modelo de pesos abertos para inferência local ou serving em GPU. Vai aprender a ler cada parte do nome de um modelo, a escolher um runtime e a confirmar que um ficheiro cabe na sua memória antes de fazer o benchmark.
Para a escolha de implementação em resumo, consulte Formatos de quantização de LLMs.
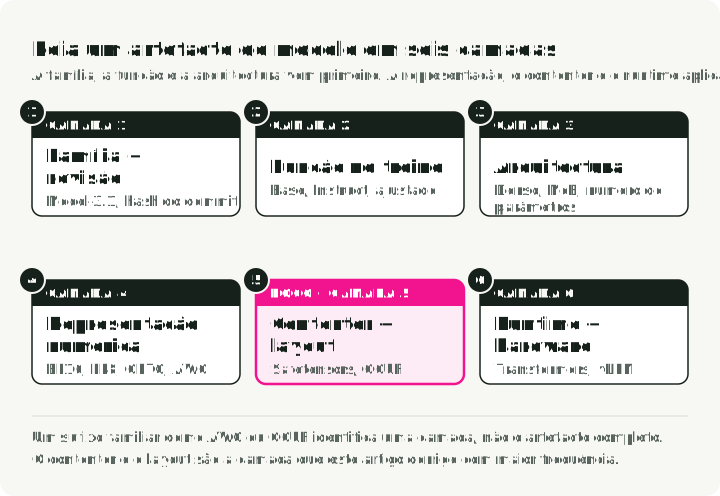
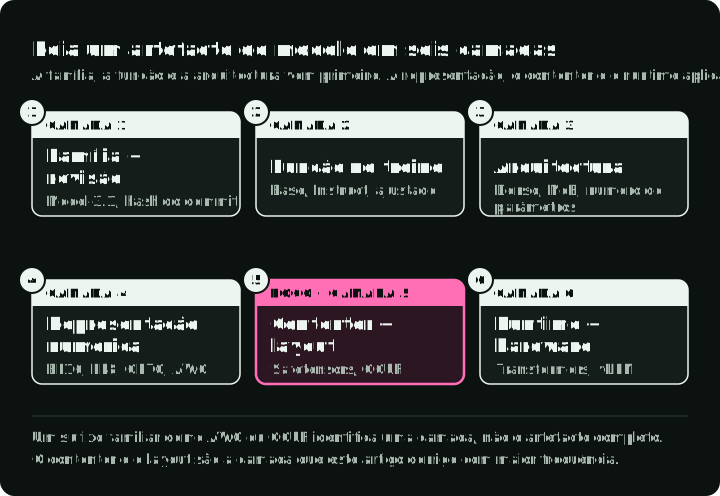
Ler um artefacto de modelo em seis camadas
| Camada | Exemplo | Pergunta a que responde |
|---|---|---|
| Família e revisão | Model-3.1, hash do commit | Que pesos e que contrato de tokenizer? |
| Função no treino | Base, Instruct, afinado para raciocínio | Que comportamento foi otimizado? |
| Arquitetura | Densa, MoE, parâmetros totais e ativos | Que kernels e que organização de memória exige? |
| Representação numérica | BF16, FP8, GPTQ 4 bits, AWQ 4 bits | Como são representados ou quantizados os tensores? |
| Contentor e organização | Fragmentos Safetensors, GGUF | Como são empacotados os tensores e os metadados? |
| Runtime | Transformers, vLLM, llama.cpp | Que carregador e que caminho de hardware o executam? |
A figura abaixo divide dois nomes de exemplo em partes e coloca cada parte sob a sua camada. Ambos os nomes indicam a família, a função no treino, a arquitetura e a representação numérica. Só o ficheiro GGUF indica o contentor, e nenhum indica o runtime.
Algumas etiquetas descrevem como o modelo foi treinado, e não uma parte do ficheiro. Distill (treinado para copiar um modelo professor maior) e QAT (treino com consciência de quantização) são duas delas. Um checkpoint pode ser destilado, afinado para instruções, afinado para raciocínio e MoE ao mesmo tempo.
A etiqueta «código aberto» exige uma verificação própria. Se um modelo apenas publica pesos descarregáveis, não presuma que a licença cumpre uma definição de código aberto ou permite o seu caso de utilização. Leia o cartão do modelo e a licença antes de comparar arquiteturas ou benchmarks.
Funções no treino: Base, Instruct, raciocínio, destilado
Base
Um checkpoint base é treinado principalmente para prever o token seguinte. É útil para pré-treino contínuo, investigação controlada ou adaptação em que quer controlar o comportamento perante instruções. Pode completar um prompt em vez de lhe responder. Pergunte-lhe «Qual é a capital de França?» e ele pode continuar com «Qual é a capital da Alemanha?», porque o prompt se parece com o início de uma lista de perguntas.
Não presuma que todo o fine-tuning deve partir do base. Um checkpoint instruct pode ser a melhor inicialização quando o seu comportamento atual está alinhado com o objetivo. Confirme com a sua avaliação que o comportamento existente não entra em conflito com o novo objetivo.
Instruct ou chat
Estes checkpoints recebem um pós-treino pensado para melhorar o seguimento de instruções e a conversação. A receita exata pode incluir fine-tuning supervisionado, otimização de preferências, aprendizagem por reforço, destilação ou uma combinação destas. Não é necessariamente fine-tuning supervisionado seguido de RLHF.
Use um checkpoint instruct como primeira referência de assistente. Confirme o seu chat template, o formato de tool call suportado, o comportamento perante mensagens de sistema e as características de recusa. A documentação de chat templates do Transformers explica porque é que o formato exato das mensagens importa. «Instruct» por si só não garante JSON nem tool use fiáveis.
Afinado para raciocínio
Os checkpoints orientados para o raciocínio são otimizados em tarefas ou trajetórias que premeiam a resolução de problemas em vários passos. Alguns expõem o texto do raciocínio, outros separam-no através de um parser do serving e outros apresentam apenas uma resposta. Uma geração mais longa não garante um raciocínio fiel nem menos alucinações.
Adote um quando melhorar os segmentos difíceis da avaliação, depois de contar os tokens de saída, a latência e a verificação. Uma extração ou classificação de rotina pode ficar mais lenta sem ficar melhor.
Destilado
A destilação transfere o comportamento de um modelo professor, ou de dados gerados por ele, para outro modelo. O aluno pode ser menor, do mesmo tamanho ou estruturalmente diferente. Não existe uma regra estável de «70–80 % da qualidade com metade do tamanho»: a qualidade retida depende do professor, dos dados, do objetivo, da capacidade do aluno e da avaliação. O artigo original sobre destilação de conhecimento, de Hinton, Vinyals e Dean, também não afirma nenhuma razão fixa de qualidade.
Trate Distill como proveniência do treino e depois faça o benchmark como a qualquer outro checkpoint.
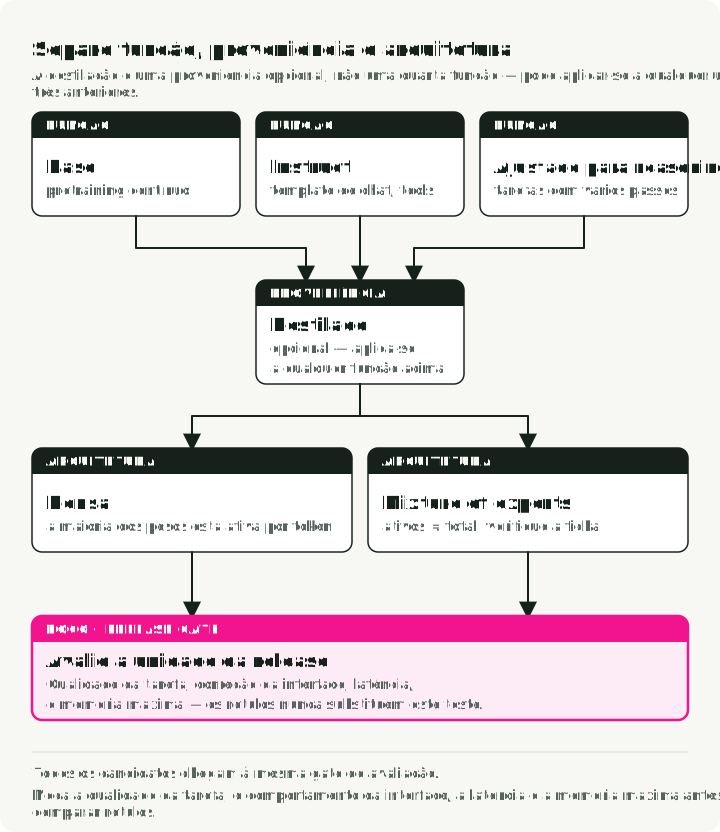
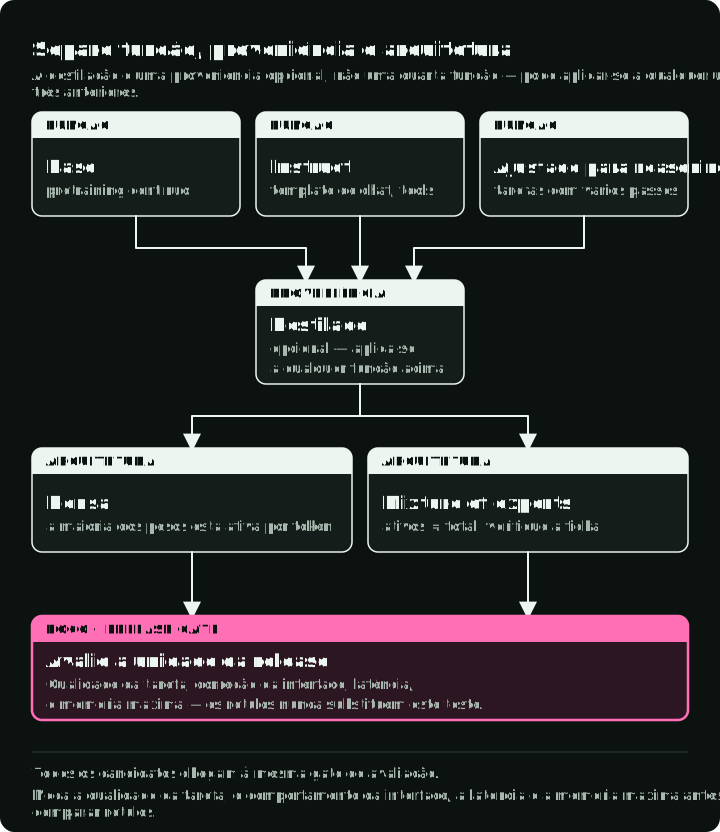
A figura abaixo envia um mesmo prompt aos três tipos de checkpoint e mostra o que cada um devolve, para que se escolhe e quanto custa. Etiquetas de proveniência como Distill e QAT podem aplicar-se a qualquer um deles.
Modelos densos e MoE
A função no treino diz que comportamento o checkpoint tem. A arquitetura diz como os pesos estão organizados, o que determina a memória e o suporte de runtime.
Modelos densos
A maioria dos parâmetros participa na passagem direta de cada token. O número de parâmetros é um indicador aproximado do armazenamento dos pesos. A memória em execução inclui ainda a KV cache, as ativações ou o espaço de trabalho, a sobrecarga do alocador e, por vezes, estado duplicado ou fragmentado.
Mixture of Experts
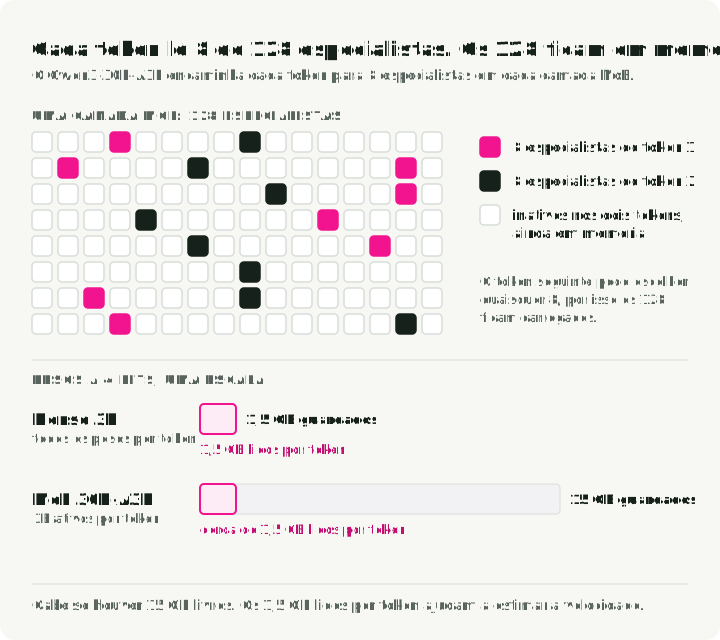
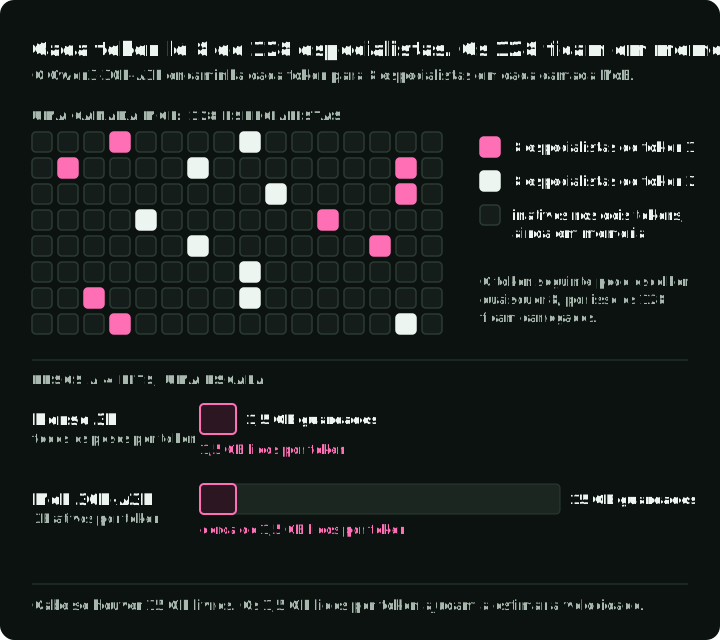
Uma camada MoE encaminha cada token para um subconjunto de redes feed-forward especialistas. O artigo do Switch Transformer descreve um desses desenhos de encaminhamento; outras famílias encaminham os tokens de forma diferente. Nomes como A3B costumam significar que cerca de três mil milhões de parâmetros estão ativos por token, mas as convenções de nomenclatura dependem da família. Leia o cartão do modelo para ver os parâmetros totais, os parâmetros ativos, o número de especialistas e o desenho do encaminhamento.
O número de parâmetros ativos descreve a computação encaminhada, não a colocação dos pesos. Por exemplo, o expert parallelism do vLLM reparte as camadas de especialistas pelos ranks de expert parallelism e deriva a atribuição de especialistas de cada rank a partir do número total de especialistas. Outros runtimes podem colocar ou descarregar os pesos de outra forma. Um modelo com 30B no total e 3B ativos não cabe, por isso, automaticamente como um modelo denso de 3B.
A figura abaixo mostra uma camada MoE do Qwen3-30B-A3B: cada token usa 8 dos seus 128 especialistas, e o token seguinte pode usar outros 8 quaisquer, por isso todos ficam em memória. As barras colocam um modelo denso de 3B e o modelo 30B-A3B na mesma escala, a 4 bits. O modelo MoE guarda dez vezes mais pesos, mas cada token lê apenas os 3B de parâmetros ativos, cerca de 1,5 GB.
O suporte de runtime também depende da arquitetura. Confirme a implementação do modelo, o suporte de expert parallelism ou tensor parallelism, os kernels de quantização e o contexto máximo antes de descarregar.
Contentores e métodos de quantização
A arquitetura fixa que tensores existem. O contentor decide como esses tensores são guardados em disco, e o método de quantização decide quantos bits cada um usa.
Safetensors
Safetensors é um formato seguro de serialização de tensores, muito usado nos repositórios do Hugging Face. Um modelo pode ter vários fragmentos .safetensors, além de ficheiros de configuração, de tokenizer e de geração. Esses tensores podem estar em BF16/FP16 ou pré-quantizados com um método como GPTQ ou AWQ. O Transformers lê o método a partir de uma entrada quantization_config e carrega o backend correspondente, como descreve o seu fluxo de quantização.
A extensão, por si só, não indica a precisão nem a compatibilidade com o runtime. Inspecione config.json, a configuração de quantização, o cartão do modelo, o dtype dos tensores e a documentação do runtime. A secção «Um nome analisado» mais abaixo mostra um pequeno script que faz isto.
GGUF
GGUF empacota tensores e metadados para o ecossistema ggml/llama.cpp. O llama.cpp carrega GGUF e suporta backends como Metal, CUDA, HIP, Vulkan e caminhos de CPU. A arquitetura do modelo e a qualidade da conversão continuam a determinar a compatibilidade.
GGUF é um contentor. Pode conter tensores de alta precisão ou quantizados. Os modelos multimodais podem precisar também de um ficheiro separado com o projetor ou o codificador. «Um ficheiro GGUF contém tudo» não é uma regra universal.
GPTQ e AWQ
GPTQ e AWQ são métodos de quantização de pesos pós-treino, não extensões de ficheiro. Os seus artefactos usam normalmente Safetensors com uma configuração específica do método. Os motores de serving precisam de kernels compatíveis com o método, a largura em bits, o tamanho do grupo, a arquitetura do modelo e o hardware.
Nenhum dos métodos é um vencedor universal em qualidade. Os dados de calibração, a implementação, o caminho do kernel e a tarefa contam. O suporte de runtime muda, por isso verifique o artefacto exato na versão que fixar. Consulte as páginas oficiais de quantização do Transformers e de quantização do vLLM ao lado desta decisão.
FP8 e QAT
Mais duas etiquetas surgem nos nomes dos repositórios. FP8 é um formato numérico, não um método de quantização: cada peso é guardado como um valor de vírgula flutuante de 8 bits. Só corre depressa quando a GPU e o runtime o suportam. Por exemplo, o vLLM executa pesos e ativações em FP8 em GPUs NVIDIA Ada, Hopper e Blackwell, e recorre a FP8 apenas nos pesos em Turing e Ampere. Consulte a tabela de hardware do runtime antes de escolher um repositório -FP8.
Um checkpoint QAT (treino com consciência de quantização) foi treinado para tolerar um esquema de poucos bits específico, por exemplo um ficheiro GGUF -qat-q4_0. Comece pelo formato previsto pelo publicador. Alterar o esquema de quantização pode reduzir o benefício de QAT; volte a avaliar o artefacto convertido. O Guia de Quantização de Modelos aborda PTQ e QAT e os formatos numéricos com mais profundidade.
Runtimes e quando usar cada um
O runtime é o programa que carrega o ficheiro e o executa no seu hardware. Cada runtime carrega um conjunto fixo de tipos de ficheiro, pelo que a escolha do runtime decide também que ficheiro descarrega.
| Runtime | Ficheiros que carrega | Hardware | Use-o quando |
|---|---|---|---|
llama.cpp | GGUF | CPU, Metal, CUDA, HIP, Vulkan | Quer controlo direto da inferência local, ou um alvo pequeno ou invulgar |
| Ollama | GGUF; importações de Safetensors suportadas (um caminho MLX está em pré-visualização no Apple Silicon) | macOS, Linux, Windows | Quer um serviço local gerido, com uma API HTTP, num portátil ou numa estação de trabalho |
| LM Studio | GGUF; MLX no Apple Silicon | macOS, Windows, Linux | Quer uma interface gráfica para procurar, descarregar e experimentar modelos |
| MLX-LM | Safetensors convertidos para MLX, a framework de arrays da Apple | Apple Silicon | Trabalha em Python num Mac, incluindo fine-tuning com LoRA |
| vLLM, SGLang | Safetensors em BF16, FP8, AWQ, GPTQ e outros métodos | GPUs NVIDIA e AMD, outros aceleradores | Serve muitos utilizadores e precisa de batching, débito e uma API ao estilo OpenAI |
| Hugging Face Transformers | Safetensors, com quantization_config quando quantizados | CPU e GPU | Faz investigação, fine-tuning ou serving com carga moderada; use vLLM ou SGLang para produção em grande escala |
O Text Generation Inference (TGI) já não é uma opção para novas implementações. O Hugging Face colocou-o em modo de manutenção, entretanto arquivou o repositório e remete os utilizadores para o vLLM e o SGLang. Para mais detalhe sobre as ferramentas para portátil, consulte LLMs locais no macOS.
Estimar a memória
Quando o runtime e o tipo de ficheiro estão definidos, a pergunta seguinte é se o ficheiro cabe. Para parâmetros de pesos com bits, o armazenamento bruto dos pesos é aproximadamente:
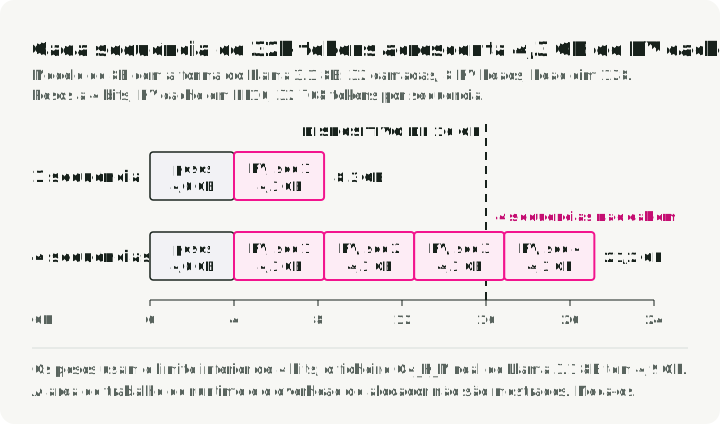
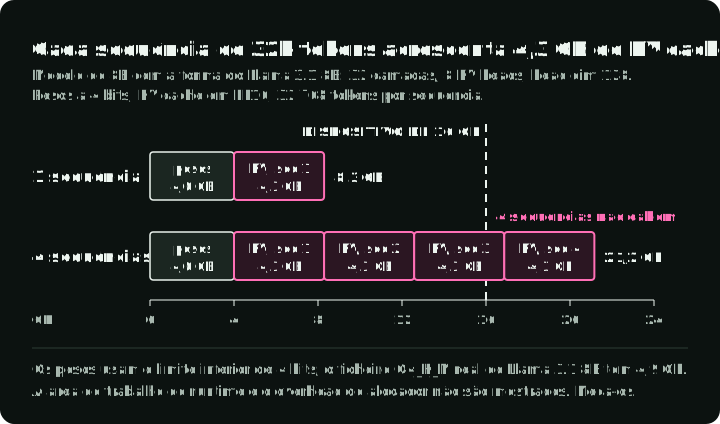
Um modelo de 13B com pesos nominais de quatro bits começa, portanto, perto de 6,5 GB. O mesmo modelo em BF16 precisa de cerca de 26 GB, e um modelo de 70B em BF16 precisa de cerca de 140 GB. Os 6,5 GB são um limite inferior: o modelo não vai necessariamente correr em 6,5 GB. As escalas, os pontos zero, os tensores de maior precisão, os embeddings, os metadados, os buffers do runtime, a KV cache e a fragmentação acrescentam memória.
A KV cache decide muitas vezes a diferença entre «carrega» e «serve». Num Transformer com atenção completa e uma cache K/V convencional, guarda as chaves e os valores de atenção de cada token do contexto, pelo que cresce com o comprimento do contexto e com o número de sequências servidas em simultâneo. Um modelo de 8B com 32 camadas, 8 KV heads e dimensão de head 128 (a forma do Llama 3.1 8B) guarda cerca de 4,3 GB de KV cache em FP16 para uma sequência de 32 768 tokens: 2 × 32 × 8 × 128 × 32 768 × 2 bytes. Com 4 bits, os seus pesos ocupam cerca de 4 GB. O gráfico abaixo soma os dois e mostra que quatro sequências assim já não cabem num dispositivo de 16 GB.
A função abaixo estima os pesos brutos e a cache K/V convencional com atenção completa, como no Llama 3.1. Obtenha o número de camadas, o número de KV heads e a dimensão de head a partir do config.json do modelo. As camadas de atenção com janela deslizante ou por blocos deixam de aumentar a cache quando atingem o tamanho da janela ou do bloco. As arquiteturas híbridas ou com cache comprimida também precisam do cálculo de cache próprio do seu runtime.
def estimate_gb(params_b, bits, layers, kv_heads, head_dim, context, batch=1, kv_bytes=2):
    """Raw weights and conventional full-attention K/V cache, in GB (10**9 bytes)."""
    weights = params_b * 1e9 * bits / 8
    # Keys and values (2) for every layer, KV head, position, and sequence.
    kv_cache = 2 * layers * kv_heads * head_dim * context * batch * kv_bytes
    return round(weights / 1e9, 1), round(kv_cache / 1e9, 1)

# An 8B model shaped like Llama 3.1 8B, 4-bit weights, FP16 KV cache.
print(estimate_gb(8, 4, 32, 8, 128, 32_768))  # (4.0, 4.3)
print(estimate_gb(8, 4, 32, 8, 128, 32_768, batch=4))  # (4.0, 17.2)
Estas são estimativas dos pesos brutos e da cache, não um orçamento completo do runtime. O GGUF Q4_K_M real do Llama 3.1 8B tem 4,9 GB, e não 4,0 GB, porque alguns tensores mantêm mais bits. O espaço de trabalho do runtime é acrescentado. Meça o pico de memória com a sequência máxima real, a política de batching, o dtype da cache e o paralelismo. A secção sobre memória de serving do guia de quantização aborda a fórmula completa, incluindo a quantização da KV cache.
A quantização pode reduzir a memória e, por vezes, melhorar a velocidade, mas os kernels de poucos bits também podem ser mais lentos em hardware não suportado. Compare a qualidade na tarefa e o débito de ponta a ponta, não apenas o tamanho do ficheiro.
Nomes de quantização GGUF
Um repositório GGUF oferece normalmente um ficheiro por nível de quantização: Q3_K_M, Q4_K_M, Q5_K_M, Q6_K, Q8_0, IQ4_XS, entre outros. O nome indica o tipo principal e a mistura:
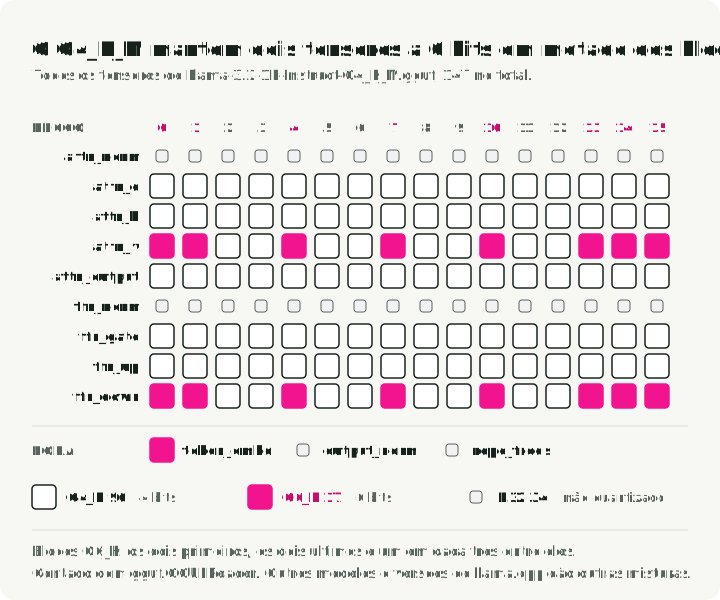
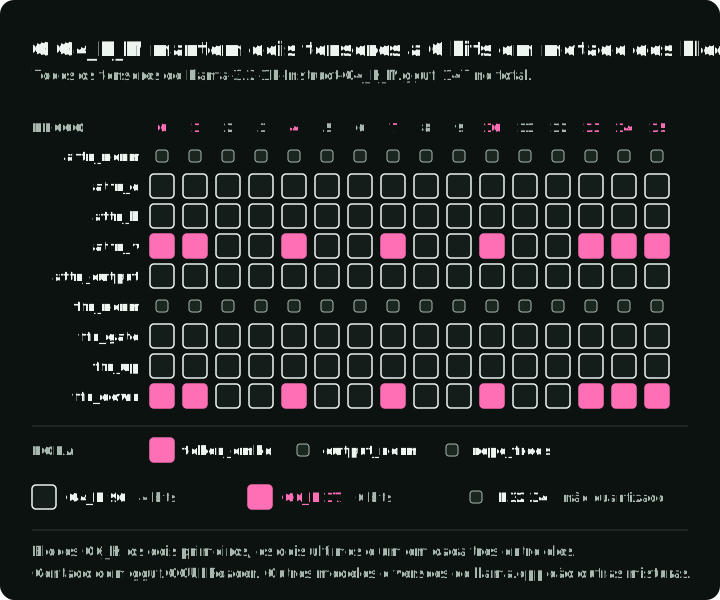
Q4é a largura em bits usada na maioria dos tensores.Ké o esquema de blocos K-quant.S,MeLsão misturas pequena, média e grande. Uma mistura maior mantém mais tensores num tipo de maior precisão. EmQ4_K_M, o quantizador passa os pesos de valor de atenção (attn_v) e de saída feed-forward (ffn_down) paraQ6_Kem cerca de metade das camadas.Q4_K_Seleva menos desses pesos, e apenas paraQ5_K.Q8_0é um tipo simples de 8 bits usado em quase todas as matrizes de pesos.- Os nomes
IQ, comoIQ4_XS, são i-quants. Costumam basear-se numa matriz de importância que regista que pesos mais contam num texto de amostra.
A grelha abaixo mapeia todos os tensores de um ficheiro real por tipo. Dos 147 tensores de Llama-3.2-1B-Instruct-Q4_K_M.gguf, 96 são Q4_K, 17 são Q6_K e 34 são tensores F32 não quantizados, sobretudo normalizações. Veja as linhas attn_v e ffn_down para saber que blocos recebem Q6_K.
Para verificar um ficheiro por si, descarregue um nível de quantização e conte os tipos de tensor com o pacote gguf do projeto llama.cpp:
hf download bartowski/Llama-3.2-1B-Instruct-GGUF Llama-3.2-1B-Instruct-Q4_K_M.gguf --local-dir .from collections import Counter
from gguf import GGUFReader
reader = GGUFReader("Llama-3.2-1B-Instruct-Q4_K_M.gguf")
print(Counter(t.tensor_type.name for t in reader.tensors))
# Counter({'Q4_K': 96, 'F32': 34, 'Q6_K': 17})
for t in reader.tensors:
if t.tensor_type.name == "Q6_K":
print(t.name) # token_embd.weight, blk.0.attn_v.weight, blk.0.ffn_down.weight, ...As misturas variam consoante a arquitetura e a versão do llama.cpp, pelo que deve tratar o sufixo como o nome de uma receita do llama.cpp, e não como uma especificação portátil de largura em bits. Consulte o guia de quantização do llama.cpp para ver a lista atual.
Use estes valores como pontos de partida, não como respostas:
Q4_K_Mé a primeira tentativa habitual.Q5_K_MouQ6_Kquando a memória o permitir.Q3_K_Mou um ficheiroIQ3só para caber um modelo maior, e só depois de verificar a qualidade.
Evite afirmações universais de que Q4_K_M é indistinguível de BF16 ou de que um modelo Q3 maior vence sempre um modelo Q8 menor. Use uma comparação breve para o checkpoint exato:
- um artefacto de referência de alta precisão ou de confiança
- um candidato perto do limite de memória
- um candidato mais pequeno com mais margem
Execute os mesmos prompts, verificações de structured output, casos de contexto longo e teste de latência nos três.
Fluxo de seleção
Cada uma das secções anteriores trata de uma camada. O fluxo coloca-as por ordem, e uma alteração em qualquer entrada obriga a repetir os passos.
1. Fixar o contrato da tarefa
Defina o idioma, a modalidade, o comprimento do contexto, a interface de tools ou de schema, as restrições de segurança, os requisitos de licença e os segmentos de avaliação. Compare os checkpoints numa representação suficientemente exata para que a quantização não decida a primeira ronda.
2. Escolher o checkpoint
Escolha o menor checkpoint que passe as suas verificações de qualidade e de comportamento. Registe o repositório e a revisão exatos, o tokenizer, o chat template e qualquer parser de raciocínio necessário.
3. Escolher o runtime
Escolha um runtime a partir da tabela de runtimes. Depois, verifique o suporte da arquitetura, o backend de hardware, o paralelismo, os kernels de quantização, o structured output e os adaptadores para o artefacto exato.
4. Estabelecer um orçamento de memória medido
Inclua os pesos, a KV cache, o espaço de trabalho do runtime, a concorrência esperada e a margem para o sistema operativo ou para processos que partilham a máquina. Um ficheiro caber na RAM ou na VRAM é necessário, mas não suficiente.
5. Escolher e validar uma representação
Prefira artefactos fornecidos pelo publicador, com calibração e proveniência documentadas. Se usar uma conversão da comunidade, registe a revisão de origem, a revisão do conversor, a receita de quantização, os dados de calibração ou de importância e os hashes.
6. Fazer o benchmark da unidade de release
Meça a qualidade na tarefa, a correção do schema e das tool calls, o tempo até ao primeiro token, o débito de saída, o pico de memória e as falhas no contexto e na concorrência alvo. Repita depois de alterar qualquer checkpoint, runtime, kernel ou definição de quantização.
Pontos de partida para configurações comuns
Estes são primeiros candidatos para fazer o benchmark com o fluxo acima, não respostas finais.
| Configuração | Primeiro candidato | Verifique antes de se comprometer |
|---|---|---|
| Assistente de chat num MacBook de 16 GB | Instruct de 7B–8B, GGUF Q4_K_M, no Ollama ou no LM Studio | O pico de memória no seu comprimento de contexto deixa espaço para o SO e outras aplicações |
| Serviço RAG numa GPU de 24 GB | Instruct de 7B–14B, Safetensors AWQ ou FP8, no vLLM | Os pesos mais a KV cache na sua concorrência ficam abaixo de 24 GB |
| Fine-tuning de domínio numa GPU na cloud | Checkpoint Base ou Instruct em Safetensors BF16, com Transformers | Se o comportamento instruct ajuda ou entra em conflito com o seu objetivo de treino |
| API para muitos utilizadores | Instruct em BF16, FP8 ou AWQ, no vLLM ou no SGLang | O débito e o tempo até ao primeiro token na concorrência alvo |
Um nome analisado
Imagine um repositório chamado Acme-32B-A3B-Instruct-AWQ. Cada parte levanta uma pergunta, e cada resposta está num sítio concreto:
| Parte | Pergunta | Onde verificar |
|---|---|---|
Acme | Que família, licença e revisão? | Cartão do modelo (README.md), LICENSE, o hash do commit que fixar |
32B | Pesos totais ou outra convenção do publicador? | Cartão do modelo; config.json |
A3B | Quantos especialistas, e quantos por token? | config.json: num_experts ou num_local_experts, num_experts_per_tok |
Instruct | Que chat template e que formato de tool call? | chat_template em tokenizer_config.json; cartão do modelo |
AWQ | Que largura em bits, tamanho de grupo e calibração? | quantization_config em config.json; cartão do modelo para os dados de calibração |
| (não consta do nome) | O runtime suporta esta arquitetura e esta quantização? | A documentação da versão do runtime que fixar |
O script abaixo lê o config.json de dois repositórios públicos e imprime os campos da tabela. Descarrega apenas o ficheiro de configuração, não os pesos.
import json

from huggingface_hub import hf_hub_download

def describe(repo_id: str, revision: str = "main") -> None:
    path = hf_hub_download(repo_id, "config.json", revision=revision)
    config = json.load(open(path))
    quant = config.get("quantization_config", {})
    experts = config.get("num_experts") or config.get("num_local_experts")
    print(repo_id)
    print("  architecture:", config.get("architectures"))
    print("  quantization:", quant.get("quant_method"), quant.get("bits"), quant.get("group_size"))
    print("  experts:", experts, "per token:", config.get("num_experts_per_tok"))

describe("Qwen/Qwen2.5-7B-Instruct-AWQ")  # quantization: awq 4 128; experts: None
describe("Qwen/Qwen3-30B-A3B")  # quantization: None; experts: 128 per token: 8
Conclusão
A escolha de modelos torna-se menos confusa quando as etiquetas deixam de partilhar uma única categoria. A função no treino diz que comportamento foi otimizado. A arquitetura diz como a computação está organizada. Os runtimes dizem o que é executado com eficiência no seu hardware, os contentores como os artefactos são guardados e a quantização como alguns tensores foram aproximados.
Escolha primeiro o checkpoint, depois o runtime, depois o ficheiro. Preserve a proveniência exata e deixe que uma única avaliação da tarefa compare os artefactos de release. Como passo seguinte, execute a comparação de três ficheiros da secção sobre GGUF com os seus próprios prompts.
Referências
- Chat templates do Transformers - Formatação de mensagens para modelos de linguagem causais base e afinados para instruções.
- Distilling the Knowledge in a Neural Network - O artigo original de destilação de Hinton, Vinyals e Dean.
- Switch Transformers - A arquitetura de encaminhamento esparso de especialistas de Fedus, Zoph e Shazeer.
- Especificação GGUF e guia de quantização do llama.cpp
- Código-fonte do quantizador do llama.cpp - As regras de tipo por tensor para cada receita GGUF.
- Conceitos de quantização do Hugging Face Transformers
- Artigo do GPTQ
- Artigo do AWQ
- Documentação de quantização do vLLM
- Documentação de quantização do SGLang
- Repositório do Text Generation Inference - Aviso de modo de manutenção.