Open-weight LLM-varianten, formaten en quantization

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Namen zoals Acme-32B-A3B-Instruct-AWQ ogen ingewikkeld omdat ze meerdere onafhankelijke keuzes combineren: familie en grootte, architectuur, trainingsrol en quantization. Een repository kan die weights verpakken als gesharde Safetensors, terwijl een community-conversie van hetzelfde checkpoint verschijnt als Q4_K_M.gguf.
Die labels vallen niet onder één categorie: GPTQ en AWQ zijn quantization-methoden, GGUF is een container en runtime-ecosysteem, en MoE is een architectuur. Als je de lagen apart leest, wordt de keuze van de download eenvoudiger.
Deze gids is bedoeld voor engineers die een open-weight model kiezen voor lokale inference of GPU-serving. Je leert elk onderdeel van een modelnaam te lezen, een runtime te kiezen en te controleren of een bestand in je geheugen past voordat je het benchmarkt.
Voor de compacte deploymentkeuze zie je Quantization-formaten voor LLMs.
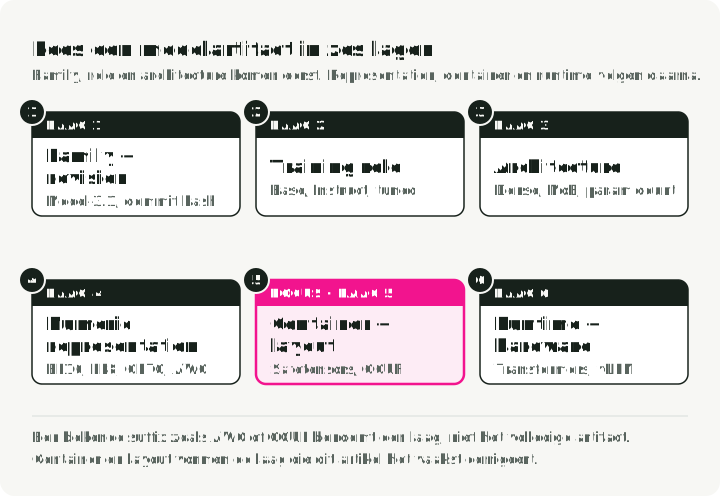
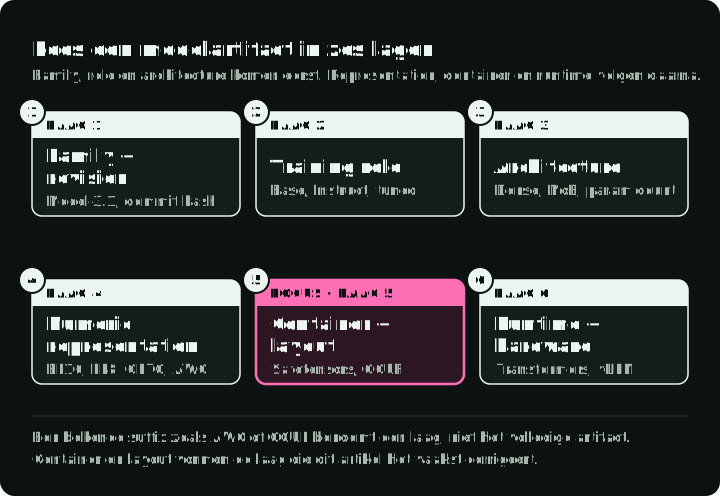
Lees een modelartefact in zes lagen
| Laag | Voorbeeld | Vraag die de laag beantwoordt |
|---|---|---|
| Familie en revisie | Model-3.1, commit-hash | Welke weights en welk tokenizer-contract? |
| Trainingsrol | Base, Instruct, reasoning-tuned | Welk gedrag is geoptimaliseerd? |
| Architectuur | Dense, MoE, totale en actieve parameters | Welke kernels en welke geheugenindeling zijn nodig? |
| Numerieke representatie | BF16, FP8, GPTQ 4-bit, AWQ 4-bit | Hoe zijn tensors weergegeven of gequantiseerd? |
| Container en indeling | Safetensors-shards, GGUF | Hoe zijn tensors en metadata verpakt? |
| Runtime | Transformers, vLLM, llama.cpp | Welke loader en hardwareroute voeren het uit? |
De figuur hieronder splitst twee voorbeeldnamen in delen en zet elk deel onder zijn laag. Beide namen geven de familie, de trainingsrol, de architectuur en de numerieke representatie. Alleen het GGUF-bestand noemt zijn container, en geen van beide noemt de runtime.
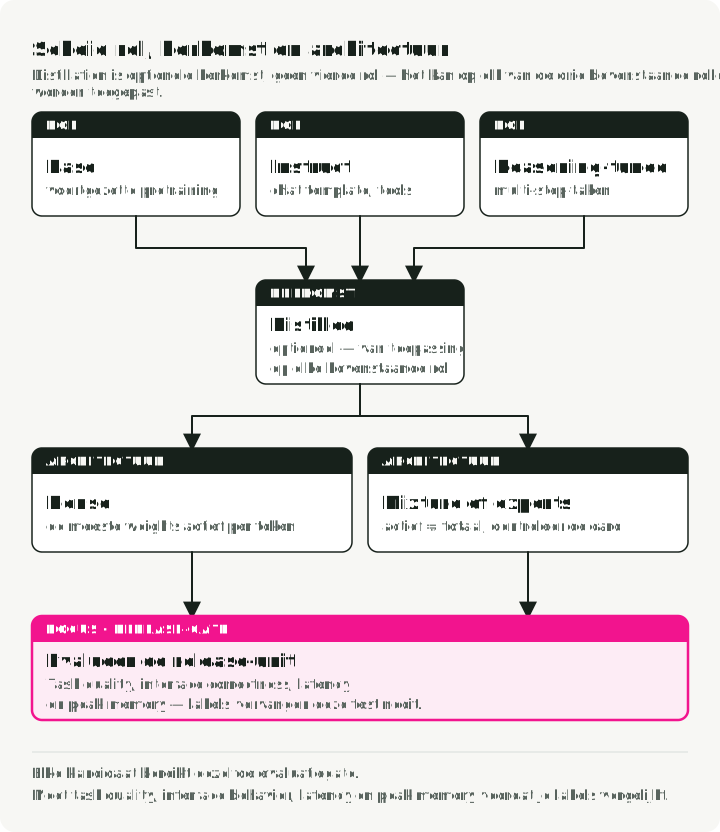
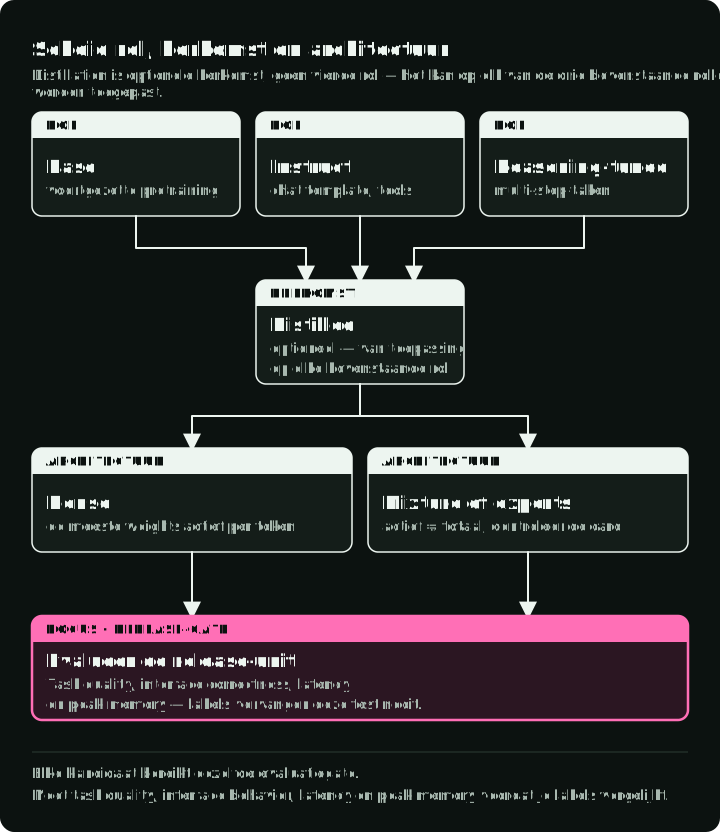
Sommige labels beschrijven hoe het model is getraind, niet een onderdeel van het bestand. Distill (getraind om een groter teacher-model na te bootsen) en QAT (quantization-aware training) zijn er twee van. Een checkpoint kan tegelijk gedistilleerd, instruction-tuned, reasoning-tuned en MoE zijn.
Het label “open-source” vraagt om een eigen controle. Als een model alleen downloadbare weights publiceert, ga er dan niet van uit dat de licentie voldoet aan een open-sourcedefinitie of jouw gebruik toestaat. Lees de modelkaart en de licentie voordat je architecturen of benchmarks vergelijkt.
Trainingsrollen: Base, Instruct, reasoning, distilled
Base
Een base-checkpoint is vooral getraind op het voorspellen van het volgende token. Het is nuttig voor voortgezette pretraining, gecontroleerd onderzoek of aanpassing waarbij je het instructiegedrag zelf wilt bepalen. Het kan een prompt aanvullen in plaats van beantwoorden. Vraag het “Wat is de hoofdstad van Frankrijk?” en het kan doorgaan met “Wat is de hoofdstad van Duitsland?”, omdat de prompt eruitziet als het begin van een lijst met vragen.
Ga er niet van uit dat elke fine-tune bij base moet beginnen. Een instruct-checkpoint kan de betere startpositie zijn wanneer het bestaande gedrag aansluit bij het doel. Controleer met je evaluatie dat het bestaande gedrag het nieuwe doel niet tegenwerkt.
Instruct of chat
Deze checkpoints krijgen post-training die instructies volgen en gesprekken moet verbeteren. Het precieze recept kan bestaan uit supervised fine-tuning, preference optimization, reinforcement learning, distillation of een combinatie. Het is niet per se supervised fine-tuning gevolgd door RLHF.
Gebruik een instruct-checkpoint als eerste assistent-baseline. Controleer de chat template, het ondersteunde tool call-formaat, het gedrag bij system messages en de weigeringskenmerken. De documentatie over chat templates van Transformers legt uit waarom het exacte berichtformaat ertoe doet. “Instruct” alleen garandeert geen betrouwbare JSON of tool use.
Reasoning-tuned
Reasoning-gerichte checkpoints zijn geoptimaliseerd op taken of trajecten die meerstapsprobleemoplossing belonen. Sommige tonen de reasoning-tekst, sommige scheiden die via een serving-parser en sommige geven alleen een antwoord. Langere generatie garandeert geen betrouwbare reasoning en ook niet minder hallucinations.
Kies er een wanneer het de moeilijke evaluatieslices verbetert, rekening houdend met outputtokens, latency en verificatie. Routinematige extractie of classificatie kan trager worden zonder beter te worden.
Distilled
Distillation draagt gedrag over van een teacher, of van door de teacher gegenereerde data, naar een ander model. De student kan kleiner zijn, even groot of structureel anders. Er is geen vaste regel van “70–80% kwaliteit bij de helft van de grootte”: de behouden kwaliteit hangt af van teacher, data, doelfunctie, capaciteit van de student en evaluatie. Ook het oorspronkelijke knowledge-distillation-paper van Hinton, Vinyals en Dean doet geen bewering over een vaste kwaliteitsverhouding.
Behandel Distill als herkomstinformatie over de training en benchmark het daarna zoals elk ander checkpoint.
De figuur hieronder stuurt één prompt naar alle drie de rollen en toont wat elk ervan teruggeeft, waarvoor je het kiest en wat het kost. Herkomstlabels zoals Distill en QAT kunnen op elk van de drie van toepassing zijn.
Dense en MoE models
De trainingsrol zegt welk gedrag het checkpoint heeft. De architectuur zegt hoe de weights zijn georganiseerd, en dat bepaalt geheugengebruik en runtime-ondersteuning.
Dense models
De meeste parameters doen mee in de forward pass van elk token. Het aantal parameters is een ruwe indicator van de opslag voor weights. Runtime-geheugen omvat ook KV cache, activations of workspace, allocator-overhead en soms gedupliceerde of gesharde state.
Mixture of Experts
Een MoE-laag stuurt elk token naar een deelverzameling van expert-feed-forward-netwerken. Het Switch Transformer-paper beschrijft één zo’n routingontwerp; andere families routeren tokens anders. Namen zoals A3B betekenen vaak dat ongeveer drie miljard parameters per token actief zijn, maar naamconventies verschillen per familie. Lees de modelkaart voor het totale aantal parameters, het aantal actieve parameters, het aantal experts en het routingontwerp.
Het aantal actieve parameters beschrijft gerouteerde rekenkracht, niet waar de weights staan. vLLM expert parallelism verdeelt bijvoorbeeld expertlagen over expert-parallel ranks en leidt de expertallocatie van elke rank af uit het totale aantal experts. Andere runtimes kunnen weights anders plaatsen of offloaden. Een model met 30B totaal en 3B actief past dus niet automatisch zoals een dense 3B-model.
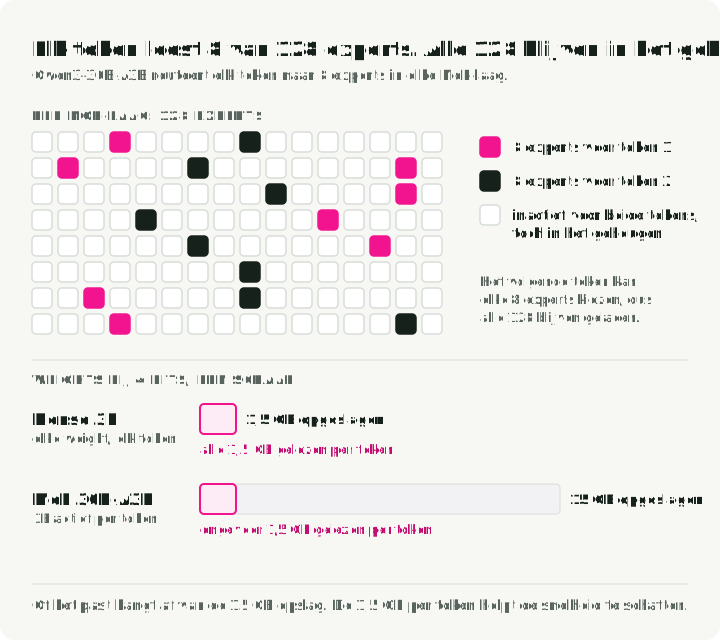
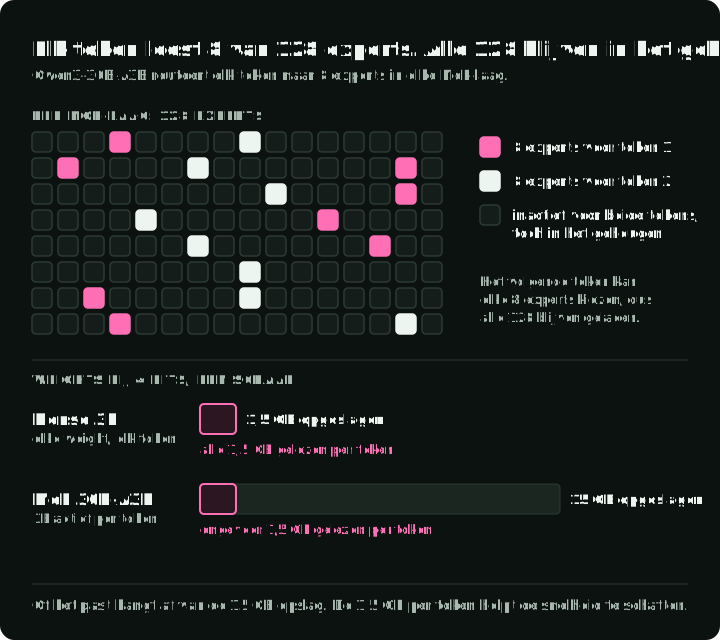
De figuur hieronder toont één MoE-laag van Qwen3-30B-A3B: elk token gebruikt 8 van de 128 experts, en het volgende token kan er 8 andere gebruiken, dus alle experts blijven in het geheugen. De balken zetten een dense 3B-model en het 30B-A3B-model op één schaal bij 4 bits. Het MoE-model slaat tien keer zoveel weights op, maar elk token leest alleen de 3B actieve parameters, ongeveer 1,5 GB.
Ook runtime-ondersteuning is architectuurspecifiek. Controleer vóór het downloaden de modelimplementatie, ondersteuning voor expert-parallel of tensor-parallel, quantization-kernels en de maximale context.
Containers en quantization-methoden
De architectuur bepaalt welke tensors bestaan. De container bepaalt hoe die tensors op schijf staan, en de quantization-methode bepaalt hoeveel bits elke tensor gebruikt.
Safetensors
Safetensors is een veilig serialisatieformaat voor tensors dat veel wordt gebruikt in Hugging Face-repositories. Een model kan meerdere .safetensors-shards hebben, plus configuratie-, tokenizer- en generatiebestanden. Die tensors kunnen BF16/FP16 zijn of vooraf gequantiseerd met een methode zoals GPTQ of AWQ. Transformers leest de methode uit een quantization_config-item en laadt de bijbehorende backend, zoals de quantization-workflow beschrijft.
De extensie alleen vertelt je niets over precisie of runtime-compatibiliteit. Bekijk config.json, de quantization-configuratie, de modelkaart, de dtype van de tensors en de runtime-documentatie. De sectie “Een naam uitgewerkt” hieronder toont een kort script dat dit doet.
GGUF
GGUF verpakt tensors en metadata voor het ggml/llama.cpp-ecosysteem. llama.cpp laadt GGUF en ondersteunt backends waaronder Metal, CUDA, HIP, Vulkan en CPU-routes. De modelarchitectuur en de kwaliteit van de conversie bepalen nog steeds de compatibiliteit.
GGUF is een container. Hij kan tensors met hoge precisie of gequantiseerde tensors bevatten. Multimodale models kunnen bovendien een apart projector- of encoderbestand nodig hebben. “Eén GGUF-bestand bevat alles” is geen universele regel.
GPTQ en AWQ
GPTQ en AWQ zijn post-training-methoden voor weight-quantization, geen bestandsextensies. Hun artefacten gebruiken meestal Safetensors plus methodespecifieke configuratie. Serving-engines hebben kernels nodig die compatibel zijn met de methode, de bitbreedte, de groepsgrootte, de modelarchitectuur en de hardware.
Geen van beide methoden is een universele winnaar in kwaliteit. Calibration data, implementatie, kernelroute en taak spelen een rol. Runtime-ondersteuning verandert, dus controleer het exacte artefact tegen de versie die je vastzet. Raadpleeg bij die beslissing de officiële pagina’s over Transformers quantization en vLLM quantization.
FP8 en QAT
Twee andere labels komen voor in repositorynamen. FP8 is een getalformaat, geen quantization-methode: elke weight wordt opgeslagen als een 8-bit floating-point-waarde. Het draait alleen snel wanneer zowel de GPU als de runtime het ondersteunen. vLLM draait bijvoorbeeld FP8-weights en -activations op GPUs van NVIDIA Ada, Hopper en Blackwell, en valt op Turing en Ampere terug op weight-only FP8. Bekijk de hardwaretabel van de runtime voordat je een -FP8-repository kiest.
Een QAT-checkpoint (quantization-aware training) is getraind om een bepaald low-bit-schema te verdragen, bijvoorbeeld een -qat-q4_0 GGUF-bestand. Begin met het formaat dat de uitgever bedoelt. Een ander quantization-schema kan het voordeel van QAT verkleinen; evalueer het geconverteerde artefact opnieuw. De Gids voor modelquantization behandelt PTQ en QAT en getalformaten uitgebreider.
Runtimes en wanneer je welke gebruikt
De runtime is het programma dat het bestand laadt en op je hardware uitvoert. Elke runtime laadt een vaste set bestandstypen, dus de keuze van de runtime bepaalt ook welk bestand je downloadt.
| Runtime | Bestanden die hij laadt | Hardware | Gebruik hem wanneer |
|---|---|---|---|
llama.cpp | GGUF | CPU, Metal, CUDA, HIP, Vulkan | Je directe controle wilt over lokale inference, of een klein of ongewoon doelplatform hebt |
| Ollama | GGUF; ondersteunde Safetensors-imports (een MLX-route is in preview op Apple Silicon) | macOS, Linux, Windows | Je een beheerde lokale service met een HTTP API wilt op een laptop of workstation |
| LM Studio | GGUF; MLX op Apple Silicon | macOS, Windows, Linux | Je een GUI wilt om models te zoeken, te downloaden en uit te proberen |
| MLX-LM | Safetensors geconverteerd voor MLX, het array-framework van Apple | Apple Silicon | Je in Python op een Mac werkt, inclusief LoRA fine-tuning |
| vLLM, SGLang | Safetensors in BF16, FP8, AWQ, GPTQ en andere methoden | GPUs van NVIDIA en AMD, andere accelerators | Je veel gebruikers bedient en batching, throughput en een OpenAI-achtige API nodig hebt |
| Hugging Face Transformers | Safetensors, met een quantization_config indien gequantiseerd | CPU en GPU | Je onderzoek of fine-tuning doet, of bij matige belasting serveert; gebruik vLLM of SGLang voor grootschalige productie |
Text Generation Inference (TGI) is geen keuze meer voor nieuwe deployments. Hugging Face heeft het in onderhoudsmodus gezet, de repository inmiddels gearchiveerd en verwijst gebruikers naar vLLM en SGLang. Voor meer detail over laptoptools zie je Lokale LLMs op macOS.
Geheugen schatten
Zodra runtime en bestandstype vaststaan, is de volgende vraag of het bestand past. Voor weight-parameters met bits is de ruwe opslag voor weights bij benadering:
Een 13B-model met weights van nominaal 4 bits begint dus rond 6,5 GB. Hetzelfde model in BF16 heeft ongeveer 26 GB nodig en een 70B-model in BF16 ongeveer 140 GB. Het getal van 6,5 GB is een ondergrens: het model draait niet per se in 6,5 GB. Scales, zero points, tensors met hogere precisie, embeddings, metadata, runtime-buffers, KV cache en fragmentatie voegen geheugen toe.
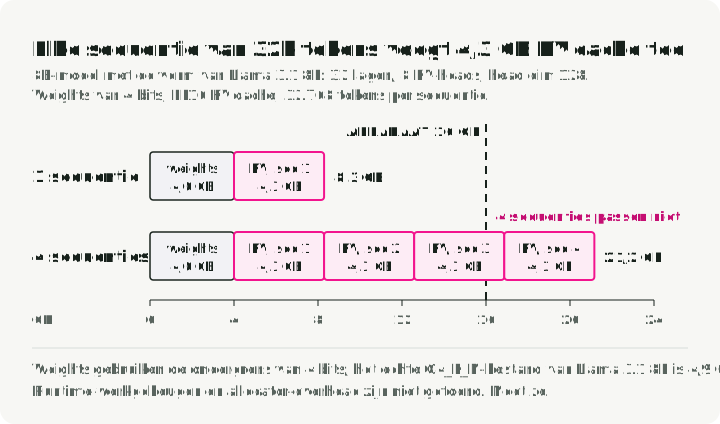
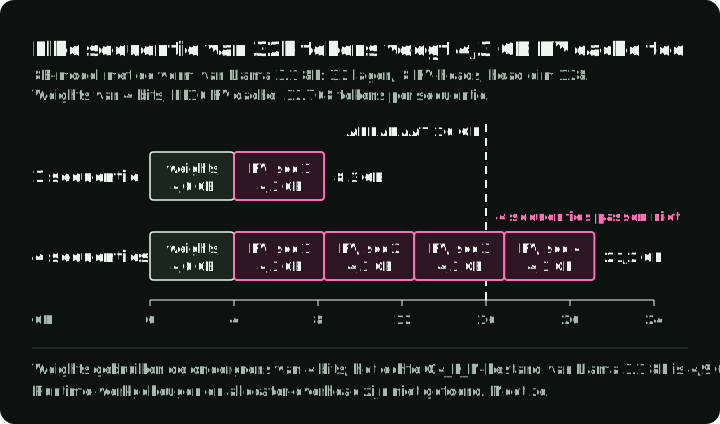
De KV cache bepaalt vaak het verschil tussen “laadt” en “serveert”. In een Transformer met volledige attention en een conventionele K/V-cache slaat hij de attention-keys en -values van elk token in de context op, dus hij groeit met de contextlengte en met het aantal sequenties dat tegelijk wordt bediend. Een 8B-model met 32 lagen, 8 KV-heads en head dimension 128 (de vorm van Llama 3.1 8B) slaat ongeveer 4,3 GB FP16 KV cache op voor één sequentie van 32.768 tokens: 2 × 32 × 8 × 128 × 32.768 × 2 bytes. Bij 4 bits zijn de weights ongeveer 4 GB. De grafiek hieronder telt die twee op en laat zien dat vier van zulke sequenties niet meer op een apparaat van 16 GB passen.
De functie hieronder schat ruwe weights en de conventionele K/V-cache bij volledige attention, zoals in Llama 3.1. Neem het aantal lagen, het aantal KV-heads en de head dimension uit de config.json van het model. Lagen met sliding-window of chunked attention laten hun cache niet verder groeien dan de venster- of chunkgrootte. Hybride architecturen of architecturen met een gecomprimeerde cache hebben ook de eigen cacheberekening van hun runtime nodig.
def estimate_gb(params_b, bits, layers, kv_heads, head_dim, context, batch=1, kv_bytes=2):
    """Raw weights and conventional full-attention K/V cache, in GB (10**9 bytes)."""
    weights = params_b * 1e9 * bits / 8
    # Keys and values (2) for every layer, KV head, position, and sequence.
    kv_cache = 2 * layers * kv_heads * head_dim * context * batch * kv_bytes
    return round(weights / 1e9, 1), round(kv_cache / 1e9, 1)

# An 8B model shaped like Llama 3.1 8B, 4-bit weights, FP16 KV cache.
print(estimate_gb(8, 4, 32, 8, 128, 32_768))  # (4.0, 4.3)
print(estimate_gb(8, 4, 32, 8, 128, 32_768, batch=4))  # (4.0, 17.2)
Dit zijn schattingen van ruwe weights en cache, geen volledig runtimebudget. De echte Q4_K_M GGUF van Llama 3.1 8B is 4,9 GB, niet 4,0 GB, omdat sommige tensors meer bits houden. Runtime-workspace komt daar nog bovenop. Meet het piekgeheugen met de echte maximale sequentie, batchstrategie, cache-dtype en parallelisme. De sectie over serving-geheugen in de quantization-gids behandelt de volledige formule, inclusief KV cache-quantization.
Quantization kan geheugen besparen en soms de snelheid verbeteren, maar low-bit-kernels kunnen op niet-ondersteunde hardware ook trager zijn. Vergelijk taakkwaliteit en end-to-end throughput, niet alleen de bestandsgrootte.
GGUF-quantization-namen
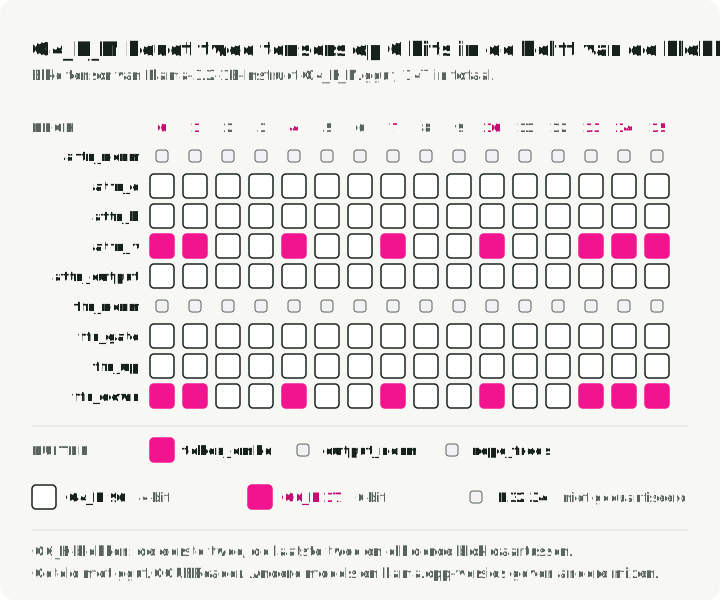
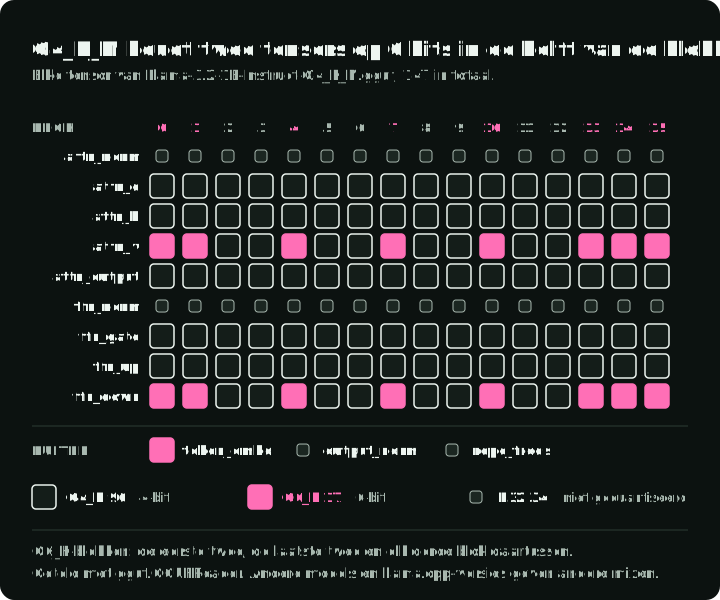
Een GGUF-repository biedt meestal één bestand per quantization-niveau: Q3_K_M, Q4_K_M, Q5_K_M, Q6_K, Q8_0, IQ4_XS en andere. De naam vertelt je het hoofdtype en de mix:
Q4is de bitbreedte die voor de meeste tensors wordt gebruikt.Kis het K-quant-blokschema.S,MenLzijn kleine, middelgrote en grote mixen. Een grotere mix houdt meer tensors op een type met hogere precisie. BijQ4_K_Mzet de quantizer de weights voor attention value (attn_v) en feed-forward-output (ffn_down) in ongeveer de helft van de lagen om naarQ6_K.Q4_K_Sverhoogt er minder, en alleen naarQ5_K.Q8_0is een eenvoudig 8-bittype dat voor bijna elke weight-matrix wordt gebruikt.IQ-namen, zoalsIQ4_XS, zijn i-quants. Ze steunen meestal op een importance matrix die vastlegt welke weights het zwaarst wegen op voorbeeldtekst.
Het raster hieronder toont elke tensor van een echt bestand per type. Van de 147 tensors in Llama-3.2-1B-Instruct-Q4_K_M.gguf zijn er 96 Q4_K, 17 Q6_K en 34 ongequantiseerde F32-tensors, meestal norms. Kijk naar de rijen attn_v en ffn_down om te zien welke blokken Q6_K krijgen.
Om een bestand zelf te controleren, download je één quantization-niveau en tel je de tensortypen met het gguf-pakket van het llama.cpp-project:
hf download bartowski/Llama-3.2-1B-Instruct-GGUF Llama-3.2-1B-Instruct-Q4_K_M.gguf --local-dir .from collections import Counter
from gguf import GGUFReader
reader = GGUFReader("Llama-3.2-1B-Instruct-Q4_K_M.gguf")
print(Counter(t.tensor_type.name for t in reader.tensors))
# Counter({'Q4_K': 96, 'F32': 34, 'Q6_K': 17})
for t in reader.tensors:
if t.tensor_type.name == "Q6_K":
print(t.name) # token_embd.weight, blk.0.attn_v.weight, blk.0.ffn_down.weight, ...Mixen verschillen per architectuur en llama.cpp-versie, dus zie het achtervoegsel als de naam van een llama.cpp-recept, niet als een overdraagbare specificatie van de bitbreedte. Zie de quantization-gids van llama.cpp voor de actuele lijst.
Gebruik deze als startpunt, niet als antwoord:
Q4_K_Mis de gebruikelijke eerste poging.Q5_K_MofQ6_Kwanneer het geheugen het toelaat.Q3_K_Mof eenIQ3-bestand alleen om een groter model te laten passen, en pas nadat je de kwaliteit hebt gecontroleerd.
Vermijd universele beweringen dat Q4_K_M niet van BF16 te onderscheiden is of dat een groter Q3-model altijd een kleiner Q8-model verslaat. Gebruik een korte vergelijking voor het exacte checkpoint:
- een referentieartefact met hoge precisie of een vertrouwd referentieartefact
- één kandidaat vlak bij de geheugenlimiet
- één kleinere kandidaat met meer marge
Draai dezelfde prompts, structured output-controles, long-context-cases en latencytests op alle drie.
Selectieworkflow
De secties hierboven behandelen elk één laag. De workflow zet ze op volgorde, en een wijziging in een van de invoeren stuurt je opnieuw door de stappen.
1. Leg het taakcontract vast
Definieer taal, modaliteit, contextlengte, tool- of schema-interface, veiligheidseisen, licentie-eisen en evaluatieslices. Vergelijk checkpoints in een representatie die nauwkeurig genoeg is, zodat quantization de eerste ronde niet beslist.
2. Kies het checkpoint
Kies het kleinste checkpoint dat je kwaliteits- en gedragscontroles doorstaat. Leg de exacte repository en revisie vast, plus de tokenizer, de chat template en een eventueel vereiste reasoning-parser.
3. Kies de runtime
Kies een runtime uit de runtimetabel. Controleer daarna voor het exacte artefact de ondersteuning voor de architectuur, de hardware-backend, parallelisme, quantization-kernels, structured output en adapters.
4. Stel een gemeten geheugenbudget vast
Neem weights, KV cache, runtime-workspace, verwachte concurrency en marge voor het besturingssysteem of processen op dezelfde machine mee. Een bestand dat in RAM of VRAM past is noodzakelijk, niet voldoende.
5. Kies en valideer een representatie
Geef de voorkeur aan artefacten van de uitgever met gedocumenteerde calibration en herkomst. Leg bij een community-conversie de bronrevisie, de revisie van de converter, het quantization-recept, de calibration- of importance-data en de hashes vast.
6. Benchmark de release-eenheid
Meet taakkwaliteit, juistheid van schema’s en tool calls, time to first token, outputthroughput, piekgeheugen en fouten bij de beoogde context en concurrency. Draai opnieuw nadat je een checkpoint, runtime, kernel of quantization-instelling hebt gewijzigd.
Startpunten voor veelvoorkomende opstellingen
Dit zijn eerste kandidaten om met de workflow hierboven te benchmarken, geen eindantwoorden.
| Opstelling | Eerste kandidaat | Controleer voordat je je vastlegt |
|---|---|---|
| Chatassistent op een 16 GB MacBook | 7B–8B Instruct, Q4_K_M GGUF, in Ollama of LM Studio | Piekgeheugen bij jouw contextlengte laat ruimte voor het OS en andere apps |
| RAG-service op één GPU van 24 GB | 7B–14B Instruct, AWQ of FP8 Safetensors, op vLLM | Weights plus KV cache blijven bij jouw concurrency onder 24 GB |
| Domein-fine-tuning op een cloud-GPU | Base- of Instruct-checkpoint in BF16 Safetensors, met Transformers | Of het instruct-gedrag je trainingsdoel helpt of tegenwerkt |
| API voor veel gebruikers | Instruct in BF16, FP8 of AWQ, op vLLM of SGLang | Throughput en time to first token bij de beoogde concurrency |
Een naam uitgewerkt
Stel dat een repository Acme-32B-A3B-Instruct-AWQ heet. Elk onderdeel roept een vraag op, en elk antwoord staat op een vaste plek:
| Onderdeel | Vraag | Waar je het controleert |
|---|---|---|
Acme | Welke familie, licentie en revisie? | Modelkaart (README.md), LICENSE, de commit-hash die je vastzet |
32B | Totale weights of een andere conventie van de uitgever? | Modelkaart; config.json |
A3B | Hoeveel experts, en hoeveel per token? | config.json: num_experts of num_local_experts, num_experts_per_tok |
Instruct | Welke chat template en welk tool call-formaat? | chat_template in tokenizer_config.json; modelkaart |
AWQ | Welke bitbreedte, groepsgrootte en calibration? | quantization_config in config.json; modelkaart voor calibration data |
| (niet in de naam) | Ondersteunt de runtime deze architectuur en quantization? | De documentatie van de runtimeversie die je vastzet |
Het script hieronder leest config.json van twee publieke repositories en print de velden uit de tabel. Het downloadt alleen het configbestand, niet de weights.
import json

from huggingface_hub import hf_hub_download

def describe(repo_id: str, revision: str = "main") -> None:
    path = hf_hub_download(repo_id, "config.json", revision=revision)
    config = json.load(open(path))
    quant = config.get("quantization_config", {})
    experts = config.get("num_experts") or config.get("num_local_experts")
    print(repo_id)
    print("  architecture:", config.get("architectures"))
    print("  quantization:", quant.get("quant_method"), quant.get("bits"), quant.get("group_size"))
    print("  experts:", experts, "per token:", config.get("num_experts_per_tok"))

describe("Qwen/Qwen2.5-7B-Instruct-AWQ")  # quantization: awq 4 128; experts: None
describe("Qwen/Qwen3-30B-A3B")  # quantization: None; experts: 128 per token: 8
Conclusie
Modelselectie wordt minder verwarrend zodra labels niet meer onder één categorie vallen. De trainingsrol vertelt welk gedrag is geoptimaliseerd. De architectuur vertelt hoe de berekening is georganiseerd. Runtimes vertellen wat efficiënt draait op jouw hardware, containers hoe artefacten zijn opgeslagen en quantization hoe sommige tensors zijn benaderd.
Kies eerst het checkpoint, dan de runtime en dan het bestand. Leg de exacte herkomst vast en laat één taakevaluatie de releaseartefacten vergelijken. Als volgende stap draai je de vergelijking van drie bestanden uit de GGUF-sectie op je eigen prompts.
Referenties
- Chat templates in Transformers - Berichtopmaak voor causale models voor taal, zowel base als instruction-tuned.
- Distilling the Knowledge in a Neural Network - Het oorspronkelijke distillation-paper van Hinton, Vinyals en Dean.
- Switch Transformers - De sparse expert-routingarchitectuur van Fedus, Zoph en Shazeer.
- GGUF-specificatie en Quantization-gids van llama.cpp
- Broncode van de llama.cpp-quantizer - De per-tensor-typeregels voor elk GGUF-recept.
- Quantization-concepten in Hugging Face Transformers
- GPTQ-paper
- AWQ-paper
- Quantization-documentatie van vLLM
- Quantization-documentatie van SGLang
- Text Generation Inference-repository - Melding over onderhoudsmodus.