Variantes, formats et quantification des LLM open-weight

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Des noms comme Acme-32B-A3B-Instruct-AWQ paraissent denses, car ils combinent plusieurs décisions indépendantes : famille et taille, architecture, rôle d’entraînement et quantification. Un dépôt peut distribuer ces poids en Safetensors fragmentés, tandis qu’une conversion communautaire du même checkpoint apparaît sous la forme Q4_K_M.gguf.
Ces étiquettes n’appartiennent pas à la même catégorie : GPTQ et AWQ sont des méthodes de quantification, GGUF est un conteneur et un écosystème de runtime, et MoE est une architecture. Lire les couches séparément facilite le choix du fichier à télécharger.
Ce guide s’adresse aux ingénieurs qui choisissent un modèle open-weight pour l’inférence locale ou le serving sur GPU. Vous apprendrez à lire chaque partie d’un nom de modèle, à choisir un runtime et à vérifier qu’un fichier tient dans votre mémoire avant de le passer en benchmark.
Pour un choix de déploiement condensé, consultez Formats de quantification des LLM.
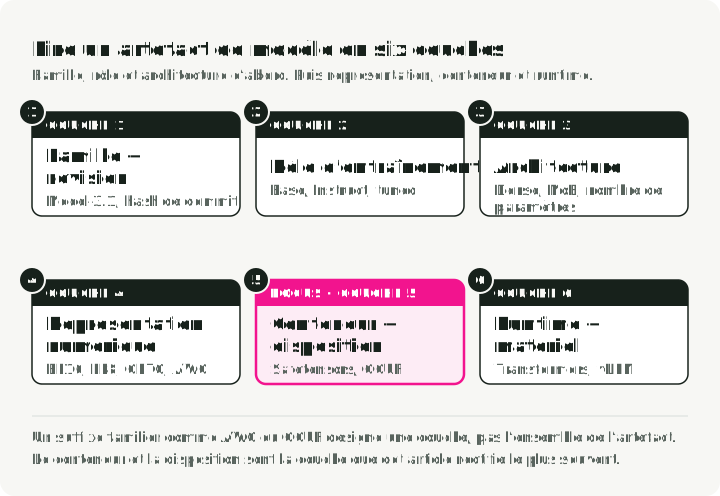
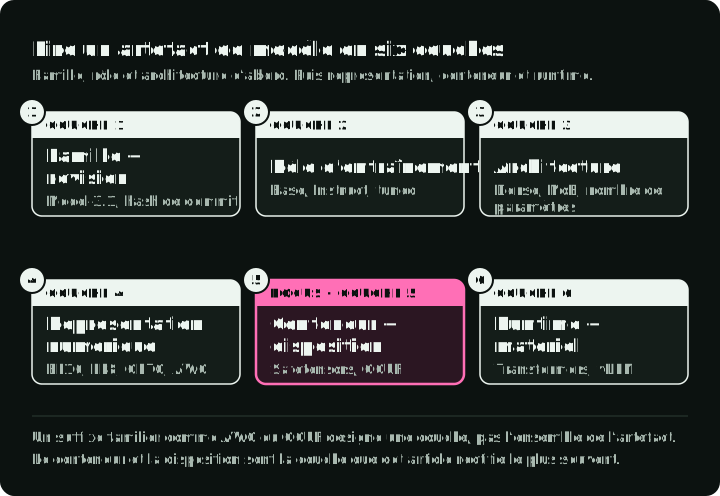
Lire un artefact de modèle en six couches
| Couche | Exemple | Question à laquelle elle répond |
|---|---|---|
| Famille et révision | Model-3.1, hash de commit | Quels poids et quel contrat de tokenizer ? |
| Rôle d’entraînement | Base, Instruct, optimisé pour le raisonnement | Quel comportement a été optimisé ? |
| Architecture | Dense, MoE, paramètres totaux et actifs | Quels kernels et quelle disposition mémoire sont requis ? |
| Représentation numérique | BF16, FP8, GPTQ 4 bits, AWQ 4 bits | Comment les tenseurs sont-ils représentés ou quantifiés ? |
| Conteneur et organisation | Fragments Safetensors, GGUF | Comment tenseurs et métadonnées sont-ils empaquetés ? |
| Runtime | Transformers, vLLM, llama.cpp | Quel chargeur et quel chemin matériel l’exécutent ? |
La figure ci-dessous découpe deux exemples de noms en parties et place chaque partie sous sa couche. Les deux noms indiquent la famille, le rôle d’entraînement, l’architecture et la représentation numérique. Seul le fichier GGUF nomme son conteneur, et aucun des deux ne nomme le runtime.
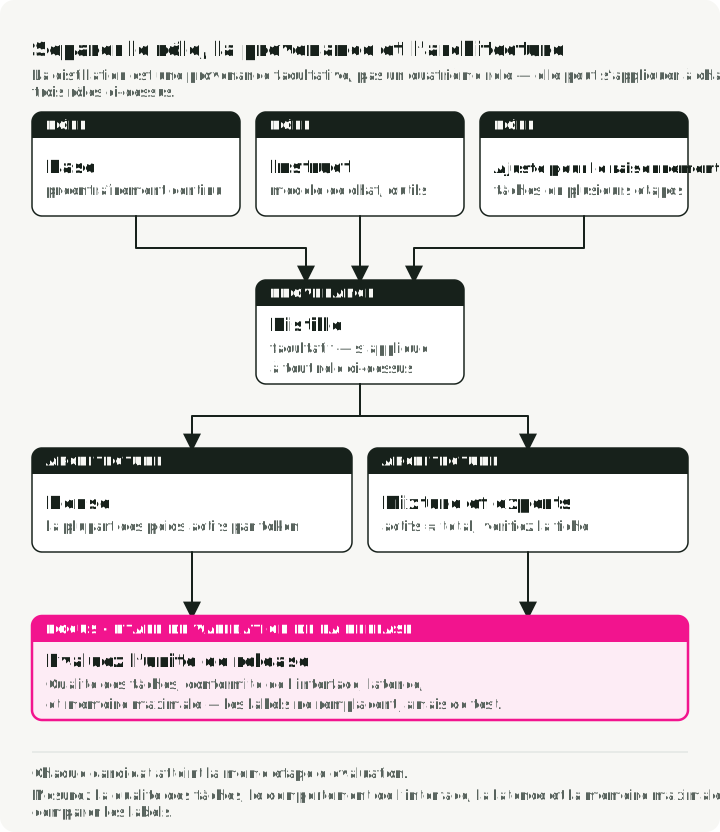
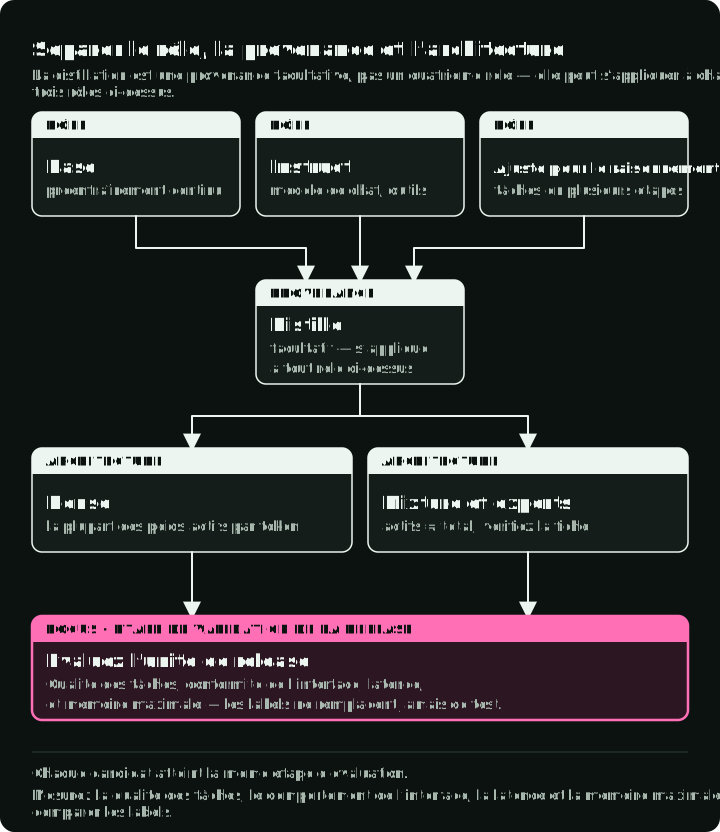
Certaines étiquettes décrivent la manière dont le modèle a été entraîné, et non une partie du fichier. Distill (entraîné à imiter un modèle enseignant plus grand) et QAT (quantization-aware training, entraînement conscient de la quantification) en sont deux exemples. Un checkpoint peut être à la fois distillé, ajusté pour suivre des instructions, optimisé pour le raisonnement et MoE.
L’étiquette « open-source » demande sa propre vérification. Si un modèle publie seulement des poids téléchargeables, ne supposez pas que sa licence respecte une définition de l’open source ou autorise votre usage. Lisez la fiche du modèle et la licence avant de comparer architectures ou benchmarks.
Rôles d’entraînement : Base, Instruct, raisonnement, distillé
Base
Un checkpoint base est entraîné principalement à prédire le token suivant. Il sert au pré-entraînement continu, à la recherche contrôlée ou à l’adaptation lorsque vous voulez maîtriser le comportement face aux instructions. Il peut compléter un prompt au lieu d’y répondre. Demandez-lui « Quelle est la capitale de la France ? » et il peut enchaîner avec « Quelle est la capitale de l’Allemagne ? », car le prompt ressemble au début d’une liste de questions.
Ne partez pas du principe que tout fine-tuning doit démarrer d’un modèle base. Un checkpoint instruct peut être une meilleure initialisation lorsque son comportement actuel correspond à la cible. Vérifiez par votre évaluation que ce comportement ne s’oppose pas au nouvel objectif.
Instruct ou chat
Ces checkpoints reçoivent un post-entraînement destiné à améliorer le respect des instructions et la conversation. La recette exacte peut combiner fine-tuning supervisé, optimisation des préférences, apprentissage par renforcement, distillation, ou plusieurs de ces éléments. Ce n’est pas forcément un fine-tuning supervisé suivi de RLHF.
Utilisez un checkpoint instruct comme première base de référence pour un assistant. Vérifiez son chat template, le format de tool call pris en charge, le comportement face aux system prompts et ses caractéristiques de refus. La documentation des chat templates de Transformers explique pourquoi le format exact des messages compte. « Instruct » seul ne garantit pas un JSON ou un tool use fiables.
Optimisé pour le raisonnement
Les checkpoints orientés raisonnement sont optimisés sur des tâches ou des trajectoires qui récompensent la résolution de problèmes en plusieurs étapes. Certains exposent le texte du raisonnement, d’autres le séparent via un parseur côté serving, d’autres ne présentent qu’une réponse. Une génération plus longue ne garantit ni un raisonnement fidèle ni moins d’hallucinations.
Adoptez-en un lorsqu’il améliore les tranches difficiles de l’évaluation, après prise en compte des tokens de sortie, de la latence et de la vérification. Une extraction ou une classification de routine peut devenir plus lente sans devenir meilleure.
Distillé
La distillation transfère le comportement d’un enseignant, ou des données générées par lui, vers un autre modèle. L’élève peut être plus petit, de même taille ou structurellement différent. Il n’existe pas de règle stable du type « 70 à 80 % de la qualité pour la moitié de la taille » : la qualité conservée dépend de l’enseignant, des données, de l’objectif, de la capacité de l’élève et de l’évaluation. L’article original sur la distillation de connaissances de Hinton, Vinyals et Dean ne revendique pas non plus de rapport de qualité fixe.
Considérez Distill comme une information de provenance sur l’entraînement, puis passez-le en benchmark comme tout autre checkpoint.
La figure ci-dessous envoie un même prompt aux trois rôles et montre ce que chacun renvoie, pourquoi on le choisit et ce qu’il coûte. Les étiquettes de provenance comme Distill et QAT peuvent s’appliquer à n’importe lequel d’entre eux.
Modèles denses et MoE
Le rôle d’entraînement dit quel comportement le checkpoint possède. L’architecture dit comment les poids sont organisés, ce qui détermine la mémoire et la prise en charge par le runtime.
Modèles denses
La plupart des paramètres participent à la passe avant de chaque token. Le nombre de paramètres donne une indication approximative du stockage des poids. La mémoire à l’exécution inclut aussi le KV cache, les activations ou l’espace de travail, la surcharge de l’allocateur et parfois un état dupliqué ou fragmenté.
Mixture of Experts
Une couche MoE route chaque token vers un sous-ensemble de réseaux feed-forward experts. L’article sur Switch Transformer décrit une conception de routage de ce type ; d’autres familles routent les tokens différemment. Des noms comme A3B signifient souvent qu’environ trois milliards de paramètres sont actifs par token, mais les conventions de nommage dépendent de la famille. Lisez la fiche du modèle pour connaître les paramètres totaux, les paramètres actifs, le nombre d’experts et la conception du routage.
Le nombre de paramètres actifs décrit le calcul routé, pas l’emplacement des poids. Par exemple, le parallélisme d’experts de vLLM répartit les couches d’experts entre les rangs de parallélisme d’experts et déduit l’allocation d’experts de chaque rang du nombre total d’experts. D’autres runtimes peuvent placer ou décharger les poids autrement. Un modèle de 30B au total et 3B actifs ne tient donc pas automatiquement comme un modèle dense de 3B.
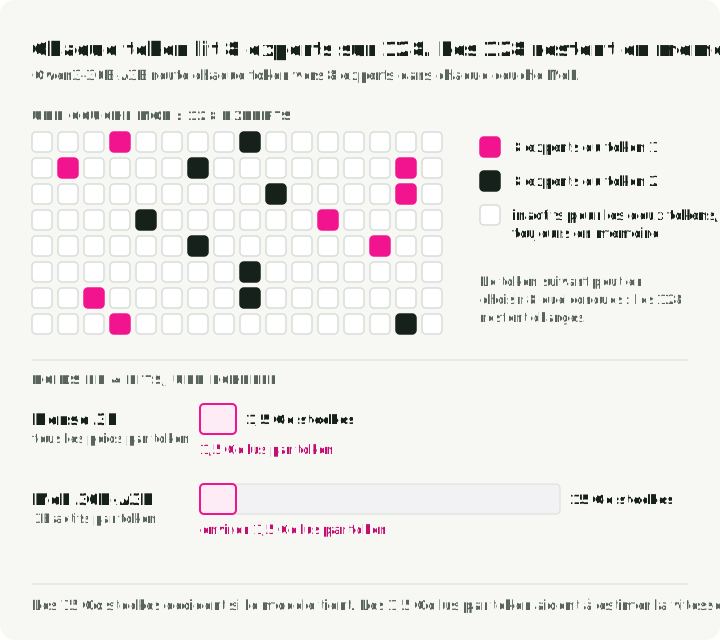
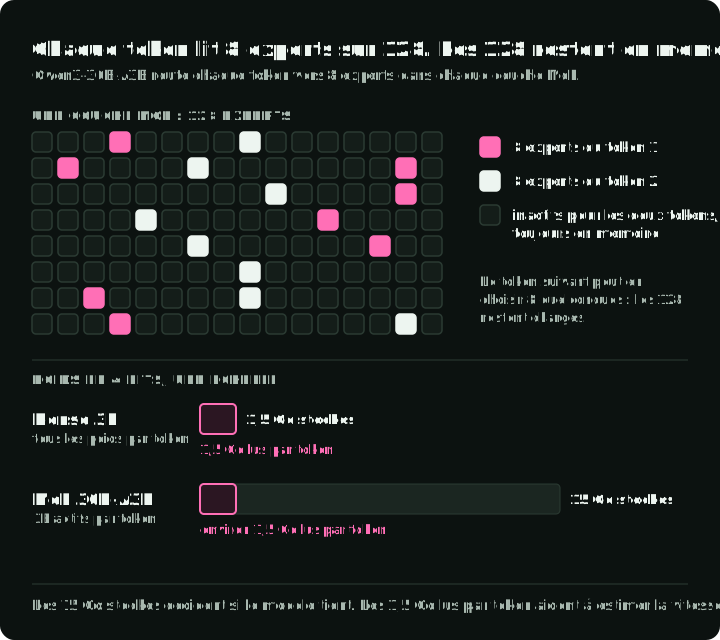
La figure ci-dessous montre une couche MoE de Qwen3-30B-A3B : chaque token utilise 8 de ses 128 experts, et le token suivant peut en utiliser 8 autres, donc tous restent en mémoire. Les barres placent un modèle dense de 3B et le modèle 30B-A3B sur une même échelle, en 4 bits. Le modèle MoE stocke dix fois plus de poids, mais chaque token ne lit que les 3B paramètres actifs, soit environ 1,5 Go.
La prise en charge par le runtime dépend aussi de l’architecture. Vérifiez l’implémentation du modèle, la prise en charge du parallélisme d’experts ou de tenseurs, les kernels de quantification et le contexte maximal avant de télécharger.
Conteneurs et méthodes de quantification
L’architecture fixe les tenseurs qui existent. Le conteneur décide de la manière dont ces tenseurs sont stockés sur disque, et la méthode de quantification décide du nombre de bits de chacun.
Safetensors
Safetensors est un format de sérialisation sûr de tenseurs, couramment utilisé dans les dépôts Hugging Face. Un modèle peut avoir plusieurs fragments .safetensors ainsi que des fichiers de configuration, de tokenizer et de génération. Ces tenseurs peuvent être en BF16/FP16 ou pré-quantifiés avec une méthode comme GPTQ ou AWQ. Transformers lit la méthode dans une entrée quantization_config et charge le backend correspondant, comme le décrit son workflow de quantification.
L’extension seule n’indique ni la précision ni la compatibilité avec un runtime. Inspectez config.json, la configuration de quantification, la fiche du modèle, le dtype des tenseurs et la documentation du runtime. La section « Un nom décortiqué » plus bas montre un court script qui le fait.
GGUF
GGUF empaquette tenseurs et métadonnées pour l’écosystème ggml/llama.cpp. llama.cpp charge le GGUF et prend en charge des backends comme Metal, CUDA, HIP, Vulkan et des chemins CPU. L’architecture du modèle et la qualité de la conversion déterminent toujours la compatibilité.
GGUF est un conteneur. Il peut contenir des tenseurs en haute précision ou quantifiés. Les modèles multimodaux peuvent aussi exiger un fichier séparé de projecteur ou d’encodeur. « Un seul fichier GGUF contient tout » n’est pas une règle universelle.
GPTQ et AWQ
GPTQ et AWQ sont des méthodes de quantification des poids après entraînement, pas des extensions de fichier. Leurs artefacts utilisent couramment Safetensors avec une configuration propre à la méthode. Les moteurs de serving ont besoin de kernels compatibles avec la méthode, la largeur en bits, la taille de groupe, l’architecture du modèle et le matériel.
Aucune des deux méthodes n’est gagnante en qualité dans tous les cas. Les données de calibration, l’implémentation, le chemin du kernel et la tâche comptent. La prise en charge par les runtimes évolue : vérifiez l’artefact exact avec la version que vous figez. Consultez les pages officielles quantification dans Transformers et quantification dans vLLM à côté de cette décision.
FP8 et QAT
Deux autres étiquettes apparaissent dans les noms de dépôts. FP8 est un format numérique, pas une méthode de quantification : chaque poids est stocké comme valeur à virgule flottante sur 8 bits. Il n’est rapide que si le GPU et le runtime le prennent tous deux en charge. Par exemple, vLLM exécute les poids et activations FP8 sur les GPU NVIDIA Ada, Hopper et Blackwell, et se rabat sur du FP8 pour les poids seuls sur Turing et Ampere. Consultez le tableau matériel du runtime avant de choisir un dépôt -FP8.
Un checkpoint QAT (entraînement conscient de la quantification) a été entraîné pour tolérer un schéma cible à faible nombre de bits, par exemple un fichier GGUF -qat-q4_0. Commencez par le format prévu par l’éditeur. Changer le schéma de quantification peut réduire le bénéfice de QAT ; évaluez à nouveau l’artefact converti. Le Guide de la quantification des modèles détaille PTQ et QAT et les formats numériques.
Runtimes et quand utiliser chacun
Le runtime est le programme qui charge le fichier et l’exécute sur votre matériel. Chaque runtime charge un ensemble fixe de types de fichiers : le choix du runtime décide donc aussi du fichier à télécharger.
| Runtime | Fichiers chargés | Matériel | À utiliser quand |
|---|---|---|---|
llama.cpp | GGUF | CPU, Metal, CUDA, HIP, Vulkan | Vous voulez un contrôle direct de l’inférence locale, ou une cible petite ou inhabituelle |
| Ollama | GGUF ; imports Safetensors pris en charge (une voie MLX est en préversion sur Apple Silicon) | macOS, Linux, Windows | Vous voulez un service local géré avec une API HTTP sur un portable ou une station de travail |
| LM Studio | GGUF ; MLX sur Apple Silicon | macOS, Windows, Linux | Vous voulez une interface graphique pour parcourir, télécharger et essayer des modèles |
| MLX-LM | Safetensors convertis pour MLX, le framework de tableaux d’Apple | Apple Silicon | Vous travaillez en Python sur un Mac, y compris pour le fine-tuning LoRA |
| vLLM, SGLang | Safetensors en BF16, FP8, AWQ, GPTQ et d’autres méthodes | GPU NVIDIA et AMD, autres accélérateurs | Vous servez de nombreux utilisateurs et avez besoin de batching, de débit et d’une API de style OpenAI |
| Hugging Face Transformers | Safetensors, avec un quantization_config s’ils sont quantifiés | CPU et GPU | Vous faites de la recherche, du fine-tuning ou du serving à charge modérée ; utilisez vLLM ou SGLang pour la production à grande échelle |
Text Generation Inference (TGI) n’est plus un choix pour les nouveaux déploiements. Hugging Face l’a placé en mode maintenance, a depuis archivé le dépôt et oriente les utilisateurs vers vLLM et SGLang. Pour les outils sur portable en détail, consultez LLM locaux sur macOS.
Estimer la mémoire
Une fois le runtime et le type de fichier connus, la question suivante est de savoir si le fichier tient. Pour paramètres de poids sur bits, le stockage brut des poids vaut approximativement :
Un modèle de 13B avec des poids nominaux sur quatre bits démarre donc autour de 6,5 Go. Le même modèle en BF16 demande environ 26 Go, et un modèle de 70B en BF16 environ 140 Go. Le chiffre de 6,5 Go est une borne inférieure : le modèle ne tournera pas forcément dans 6,5 Go. Les échelles, les points zéro, les tenseurs de plus haute précision, les embeddings, les métadonnées, les buffers du runtime, le KV cache et la fragmentation ajoutent de la mémoire.
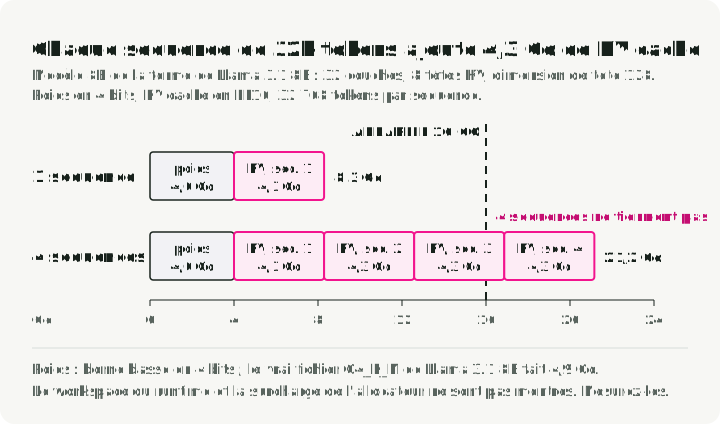
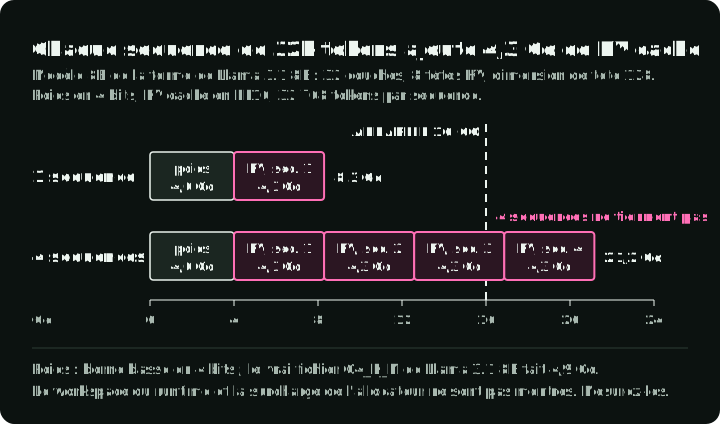
Le KV cache fait souvent la différence entre « se charge » et « sert ». Dans un Transformer à attention complète avec un cache K/V conventionnel, il stocke les clés et les valeurs d’attention de chaque token du contexte : il croît donc avec la longueur du contexte et avec le nombre de séquences servies simultanément. Un modèle de 8B avec 32 couches, 8 têtes KV et une dimension de tête de 128 (la forme de Llama 3.1 8B) stocke environ 4,3 Go de KV cache en FP16 pour une séquence de 32 768 tokens : 2 × 32 × 8 × 128 × 32 768 × 2 octets. En 4 bits, ses poids pèsent environ 4 Go. Le graphique ci-dessous additionne les deux et montre que quatre séquences de ce type ne tiennent plus sur un appareil de 16 Go.
La fonction ci-dessous estime les poids bruts et le cache K/V conventionnel à attention complète, comme dans Llama 3.1. Prenez le nombre de couches, le nombre de têtes KV et la dimension de tête dans le config.json du modèle. Les couches à attention par fenêtre glissante ou par blocs cessent d’agrandir leur cache à la taille de la fenêtre ou du bloc. Les architectures hybrides ou à cache compressé ont aussi besoin du calcul de cache propre à leur runtime.
def estimate_gb(params_b, bits, layers, kv_heads, head_dim, context, batch=1, kv_bytes=2):
    """Raw weights and conventional full-attention K/V cache, in GB (10**9 bytes)."""
    weights = params_b * 1e9 * bits / 8
    # Keys and values (2) for every layer, KV head, position, and sequence.
    kv_cache = 2 * layers * kv_heads * head_dim * context * batch * kv_bytes
    return round(weights / 1e9, 1), round(kv_cache / 1e9, 1)

# An 8B model shaped like Llama 3.1 8B, 4-bit weights, FP16 KV cache.
print(estimate_gb(8, 4, 32, 8, 128, 32_768))  # (4.0, 4.3)
print(estimate_gb(8, 4, 32, 8, 128, 32_768, batch=4))  # (4.0, 17.2)
Ce sont des estimations des poids bruts et du cache, pas un budget complet du runtime. Le vrai GGUF Q4_K_M de Llama 3.1 8B pèse 4,9 Go, et non 4,0 Go, car certains tenseurs conservent plus de bits. L’espace de travail du runtime s’y ajoute. Mesurez la mémoire de pointe avec la séquence maximale réelle, la politique de batch, le dtype du cache et le parallélisme. La section sur la mémoire de serving du guide de quantification donne la formule complète, y compris la quantification du KV cache.
La quantification peut réduire la mémoire et parfois améliorer la vitesse, mais les kernels à faible nombre de bits peuvent aussi être plus lents sur du matériel non pris en charge. Comparez la qualité sur la tâche et le débit de bout en bout, pas seulement la taille du fichier.
Noms de quantification GGUF
Un dépôt GGUF propose généralement un fichier par niveau de quantification : Q3_K_M, Q4_K_M, Q5_K_M, Q6_K, Q8_0, IQ4_XS et d’autres. Le nom indique le type principal et le mélange :
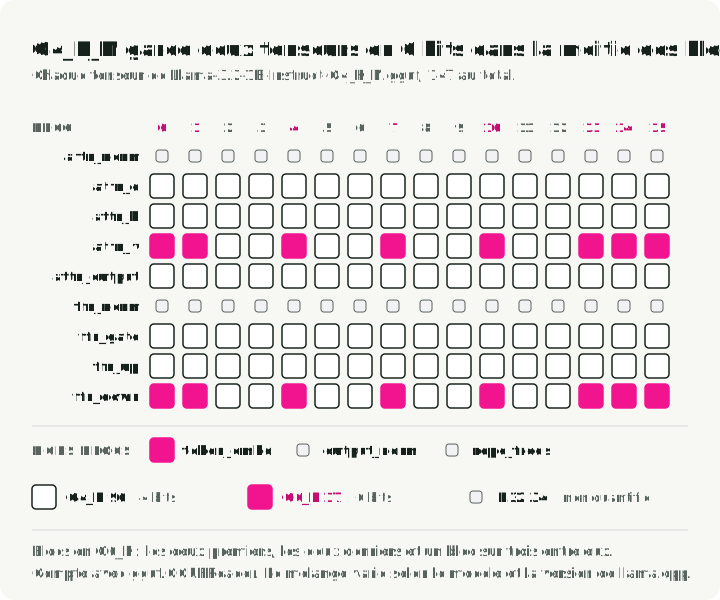
Q4est la largeur en bits utilisée pour la plupart des tenseurs.Kdésigne le schéma de blocs K-quant.S,MetLdésignent des mélanges petits, moyens et grands. Un mélange plus grand garde plus de tenseurs dans un type de plus haute précision. DansQ4_K_M, le quantificateur fait passer les poids de la valeur d’attention (attn_v) et de la sortie feed-forward (ffn_down) enQ6_Kdans environ la moitié des couches.Q4_K_Sen relève moins, et seulement enQ5_K.Q8_0est un type simple sur 8 bits utilisé pour presque toutes les matrices de poids.- Les noms
IQ, commeIQ4_XS, sont des i-quants. Ils s’appuient en général sur une matrice d’importance qui enregistre quels poids comptent le plus sur un texte d’exemple.
La grille ci-dessous classe par type chaque tenseur d’un vrai fichier. Sur les 147 tenseurs de Llama-3.2-1B-Instruct-Q4_K_M.gguf, 96 sont en Q4_K, 17 en Q6_K et 34 sont des tenseurs F32 non quantifiés, surtout des normes. Regardez les lignes attn_v et ffn_down pour voir quels blocs reçoivent du Q6_K.
Pour vérifier un fichier vous-même, téléchargez un niveau de quantification et comptez ses types de tenseurs avec le paquet gguf du projet llama.cpp :
hf download bartowski/Llama-3.2-1B-Instruct-GGUF Llama-3.2-1B-Instruct-Q4_K_M.gguf --local-dir .from collections import Counter
from gguf import GGUFReader
reader = GGUFReader("Llama-3.2-1B-Instruct-Q4_K_M.gguf")
print(Counter(t.tensor_type.name for t in reader.tensors))
# Counter({'Q4_K': 96, 'F32': 34, 'Q6_K': 17})
for t in reader.tensors:
if t.tensor_type.name == "Q6_K":
print(t.name) # token_embd.weight, blk.0.attn_v.weight, blk.0.ffn_down.weight, ...Les mélanges varient selon l’architecture et la version de llama.cpp : considérez donc le suffixe comme le nom d’une recette de llama.cpp, et non comme une spécification portable de largeur en bits. Consultez le guide de quantification de llama.cpp pour la liste actuelle.
Prenez-les comme points de départ, pas comme réponses :
Q4_K_Mest le premier essai courant.Q5_K_MouQ6_Klorsque la mémoire le permet.Q3_K_Mou un fichierIQ3seulement pour faire tenir un modèle plus grand, et seulement après avoir vérifié la qualité.
Évitez les affirmations universelles selon lesquelles Q4_K_M serait indiscernable du BF16 ou un modèle Q3 plus grand battrait toujours un modèle Q8 plus petit. Utilisez une courte comparaison pour le checkpoint exact :
- un artefact de référence en haute précision ou de confiance
- un candidat proche de la limite de mémoire
- un candidat plus petit avec plus de marge
Exécutez les mêmes prompts, les mêmes vérifications de structured output, les mêmes cas de long contexte et le même test de latence sur les trois.
Démarche de sélection
Les sections précédentes couvrent chacune une couche. La démarche les met dans l’ordre, et un changement de n’importe quelle entrée vous renvoie à travers les étapes.
1. Fixer le contrat de la tâche
Définissez la langue, la modalité, la longueur de contexte, l’interface d’outils ou de schéma, les contraintes de sécurité, les exigences de licence et les tranches d’évaluation. Comparez les checkpoints dans une représentation assez précise pour que la quantification ne décide pas du premier tour.
2. Choisir le checkpoint
Choisissez le plus petit checkpoint qui passe vos vérifications de qualité et de comportement. Notez le dépôt et la révision exacts, le tokenizer, le chat template et tout parseur de raisonnement requis.
3. Choisir le runtime
Choisissez un runtime dans le tableau des runtimes. Vérifiez ensuite, pour l’artefact exact, la prise en charge de l’architecture, le backend matériel, le parallélisme, les kernels de quantification, le structured output et les adaptateurs.
4. Établir un budget mémoire mesuré
Incluez les poids, le KV cache, l’espace de travail du runtime, la concurrence attendue et une marge pour le système d’exploitation ou les processus colocalisés. Un fichier qui tient en RAM ou en VRAM est nécessaire, pas suffisant.
5. Choisir et valider une représentation
Préférez les artefacts fournis par l’éditeur, avec calibration et provenance documentées. Si vous utilisez une conversion communautaire, notez la révision source, la révision du convertisseur, la recette de quantification, les données de calibration ou d’importance, et les hashes.
6. Passer l’unité de release en benchmark
Mesurez la qualité sur la tâche, la justesse des schémas et des tool calls, le temps jusqu’au premier token, le débit de sortie, la mémoire de pointe et les échecs au contexte et à la concurrence cibles. Recommencez après tout changement de checkpoint, de runtime, de kernel ou de réglage de quantification.
Points de départ pour les configurations courantes
Ce sont de premiers candidats à passer en benchmark avec la démarche ci-dessus, pas des réponses définitives.
| Configuration | Premier candidat | À vérifier avant de s’engager |
|---|---|---|
| Assistant de chat sur un MacBook 16 Go | Instruct 7B–8B, GGUF Q4_K_M, dans Ollama ou LM Studio | La mémoire de pointe à votre longueur de contexte laisse de la place à l’OS et aux autres applications |
| Service RAG sur un GPU de 24 Go | Instruct 7B–14B, Safetensors AWQ ou FP8, sur vLLM | Poids plus KV cache à votre concurrence restent sous 24 Go |
| Fine-tuning de domaine sur un GPU cloud | Checkpoint Base ou Instruct en Safetensors BF16, avec Transformers | Le comportement instruct aide-t-il ou s’oppose-t-il à votre objectif d’entraînement ? |
| API pour de nombreux utilisateurs | Instruct en BF16, FP8 ou AWQ, sur vLLM ou SGLang | Débit et temps jusqu’au premier token à la concurrence cible |
Un nom décortiqué
Supposons qu’un dépôt s’appelle Acme-32B-A3B-Instruct-AWQ. Chaque partie soulève une question, et chaque réponse se trouve à un endroit précis :
| Partie | Question | Où vérifier |
|---|---|---|
Acme | Quelle famille, quelle licence et quelle révision ? | Fiche du modèle (README.md), LICENSE, le hash de commit que vous figez |
32B | Poids totaux ou autre convention de l’éditeur ? | Fiche du modèle ; config.json |
A3B | Combien d’experts, et combien par token ? | config.json : num_experts ou num_local_experts, num_experts_per_tok |
Instruct | Quel chat template et quel format de tool call ? | chat_template dans tokenizer_config.json ; fiche du modèle |
AWQ | Quelle largeur en bits, quelle taille de groupe, quelle calibration ? | quantization_config dans config.json ; fiche du modèle pour les données de calibration |
| (absent du nom) | Le runtime prend-il en charge cette architecture et cette quantification ? | La documentation de la version du runtime que vous figez |
Le script ci-dessous lit config.json pour deux dépôts publics et affiche les champs du tableau. Il ne télécharge que le fichier de configuration, pas les poids.
import json

from huggingface_hub import hf_hub_download

def describe(repo_id: str, revision: str = "main") -> None:
    path = hf_hub_download(repo_id, "config.json", revision=revision)
    config = json.load(open(path))
    quant = config.get("quantization_config", {})
    experts = config.get("num_experts") or config.get("num_local_experts")
    print(repo_id)
    print("  architecture:", config.get("architectures"))
    print("  quantization:", quant.get("quant_method"), quant.get("bits"), quant.get("group_size"))
    print("  experts:", experts, "per token:", config.get("num_experts_per_tok"))

describe("Qwen/Qwen2.5-7B-Instruct-AWQ")  # quantization: awq 4 128; experts: None
describe("Qwen/Qwen3-30B-A3B")  # quantization: None; experts: 128 per token: 8
Conclusion
Le choix d’un modèle devient moins confus dès que les étiquettes cessent de partager une seule catégorie. Le rôle d’entraînement dit quel comportement a été optimisé. L’architecture dit comment le calcul est organisé. Les runtimes disent ce qui s’exécute efficacement sur votre matériel, les conteneurs comment les artefacts sont stockés, et la quantification comment certains tenseurs ont été approximés.
Choisissez d’abord le checkpoint, puis le runtime, puis le fichier. Conservez la provenance exacte et laissez une seule évaluation de tâche comparer les artefacts de release. Pour la suite, exécutez la comparaison de trois fichiers de la section GGUF sur vos propres prompts.
Références
- Chat templates de Transformers - Formatage des messages pour les modèles de langage causaux de base et ajustés aux instructions.
- Distilling the Knowledge in a Neural Network - L’article original de Hinton, Vinyals et Dean sur la distillation.
- Switch Transformers - L’architecture de routage parcimonieux d’experts de Fedus, Zoph et Shazeer.
- Spécification GGUF et guide de quantification de llama.cpp
- Code source du quantificateur de llama.cpp - Les règles de type par tenseur pour chaque recette GGUF.
- Concepts de quantification de Hugging Face Transformers
- Article GPTQ
- Article AWQ
- Documentation de quantification de vLLM
- Documentation de quantification de SGLang
- Dépôt Text Generation Inference - Avis de mode maintenance.