Guide de la quantification des modèles : des fondamentaux au serving en production

Traduction automatique
Cet article a été traduit automatiquement depuis la version originale en anglais.
Ce guide de quantification s’adresse aux ingénieurs qui déploient des modèles de langage et doivent réduire l’utilisation de la mémoire ou accélérer le serving. Vous apprendrez à choisir ce qu’il faut compresser, à associer un format numérique à votre matériel et à votre runtime, et à comparer la mémoire, la latence et la qualité des sorties avant le déploiement. Il couvre aussi les vérifications distinctes dont ont besoin les modèles de diffusion pour l’image.
La quantification réduit le nombre de bits utilisés pour les poids, les activations ou le KV cache. Les poids sont les paramètres du modèle appris pendant l’entraînement. Les activations sont les valeurs intermédiaires calculées à partir de chaque entrée. Le cache key-value (KV) conserve les valeurs des tokens précédents pour les réutiliser pendant la génération. Compresser les poids peut permettre à un modèle de tenir dans la mémoire du GPU, mais laisser trop peu de place pour une longue conversation. La cible que vous compressez et le code GPU qui l’exécute déterminent la limite que vous relâchez.
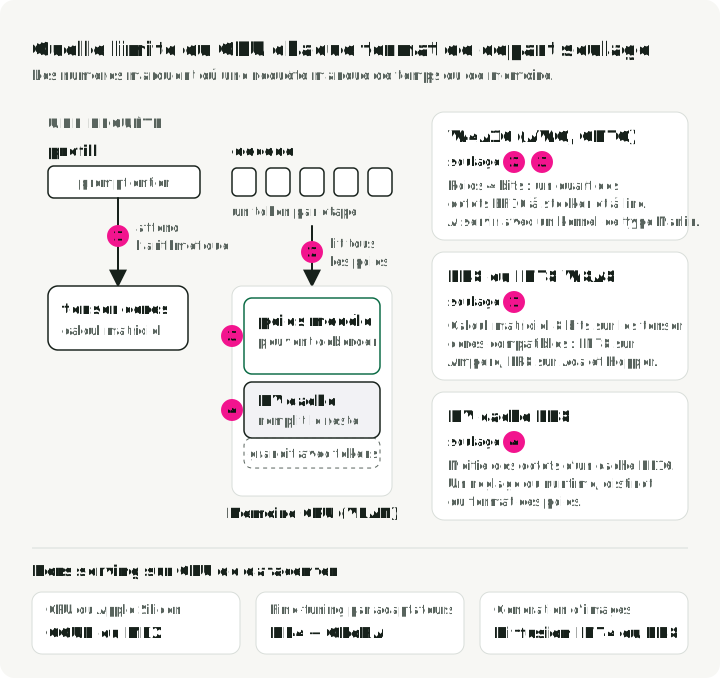
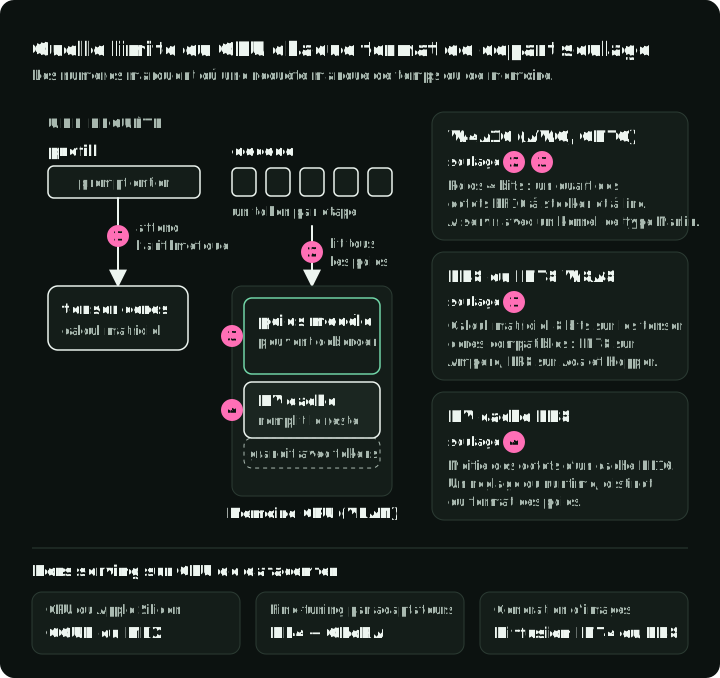
Commencez par identifier ce qui rend la requête lente ou trop volumineuse. Le traitement du prompt d’entrée s’appelle le prefill ; la génération de la réponse, un token à la fois, s’appelle le decode. Le prefill peut être limité par l’arithmétique du GPU, tandis que le decode peut l’être par la vitesse de chargement des poids depuis la mémoire. Les poids du modèle et le KV cache, qui grossit au fil de la génération, peuvent aussi saturer la mémoire du GPU. Le premier tableau associe ces problèmes à des solutions possibles ; les sections suivantes expliquent l’arithmétique et les vérifications à faire avant le déploiement.
Une largeur de bits plus faible n’est qu’une piste. La décision exige à la fois des résultats de qualité sur la tâche et des mesures de serving pour le modèle, le runtime et le trafic que vous utiliserez. Les benchmarks présentés ici sont des résultats publiés par d’autres équipes, plus une courte exécution du dépôt compagnon.
Pour une comparaison courte des artefacts et des méthodes, voir LLM Quantization Formats.
1. Goulots d’étranglement et formats de départ
Demandez-vous ce qui limite la charge de travail avant de choisir une largeur de bits. La cause peut être la mémoire des poids du modèle, le calcul du prefill, la bande passante du decode ou le KV cache, plutôt que la précision numérique elle-même.
Notation utilisée dans les recettes de serving
- W4A16 stocke les poids sur 4 bits et garde les activations en précision 16 bits. Plus généralement, W{x}A{y} nomme la précision utilisée pour les poids et les activations dans les opérations prises en charge, en général la multiplication matricielle. W8A8 utilise des poids et des activations sur 8 bits dans ces opérations, mais cela ne définit pas automatiquement le type de données stocké de chaque tenseur du runtime.
- FP8, INT8, INT4, NF4 sont des formats numériques. Ils déterminent les valeurs qu’on peut représenter.
- GPTQ, AWQ, SmoothQuant, QuaRot sont des algorithmes. Ils déterminent comment convertir un modèle entraîné vers un format de plus faible précision.
- GGUF est un format de fichier qui stocke des tenseurs et des métadonnées pour GGML et les runtimes de type
llama.cpp. Un fichier GGUF peut contenir des types de tenseurs non quantifiés commeF16,BF16ouF32, ainsi que des encodages quantifiés. Les préréglages incluentQ4_K_M,Q5_K_M,Q8_0,IQ*,TQ*etMXFP4. C’est l’encodage des tenseurs qui détermine le choix de quantification.GGUFseul ne décrit pas une recette de serving FP8 W8A8 de type CUDA. - Le KV cache est le cache d’attention utilisé pendant la génération. Il stocke les keys et values précédentes pour que le modèle ne recalcule pas toute la conversation à chaque token.
- La KV-cache quantization stocke les tenseurs d’activation key/value mis en cache dans un format de cache de plus faible précision, comme FP8, INT8, INT4 ou INT2, selon la prise en charge du runtime. Elle diffère du prefix caching, de PagedAttention ou de l’offload, qui décident si les entrées du cache sont réutilisées, comment elles sont allouées ou où elles résident.
- GEMM signifie general matrix multiply (multiplication matricielle générale). L’essentiel du temps d’inférence d’un transformer est consacré aux multiplications matricielles.
Ce qui est quantifié
Une recette choisit les tenseurs à compresser. Voici les choix habituels :
| Tenseur | Généralement quantifié ? | Pourquoi |
|---|---|---|
| Poids des couches linéaires | Oui, dans les recettes W4A16 et W8A8 | Les poids sont fixes après l’entraînement, donc leurs échelles se calculent hors ligne. |
| Activations | Seulement dans les recettes W8A8, W4A8 ou W4A4 | Elles changent à chaque entrée, donc elles ont besoin d’échelles calibrées ou calculées à l’exécution. |
| KV cache | Optionnel, un réglage distinct du runtime | Il grossit avec le contexte et le batch ; la section 6 le traite. |
Embeddings et lm_head | Généralement conservés en 16 bits | Les recettes LLM Compressor listent lm_head dans ignore ; la section 8 mentionne cette exclusion. |
| VAE de diffusion et text encoders | Conservés en 16 bits pour le premier test | La section 10 les teste séparément du réseau de débruitage. |
Goulots d’étranglement et point de départ
Le tableau associe les goulots d’étranglement courants à un format de départ. Il utilise la notation ci-dessus.
| Si le problème est le suivant | Commencez ici | Outils courants | À vérifier avant le déploiement |
|---|---|---|---|
| Les poids du modèle ne tiennent pas dans la VRAM | W4A16 weight-only quantization | AWQ ou GPTQ avec llm-compressor ou GPTQModel | Perplexité, code, raisonnement, respect des instructions |
| Le serving à haut débit est limité par le calcul | FP8 ou INT8 W8A8 | FP8 PTQ, SmoothQuant, TensorRT-LLM, vLLM | Débit, time to first token (TTFT), exactitude sur la tâche |
| Le contexte long ou la forte concurrence remplit le GPU | KV-cache quantization | vLLM, TensorRT-LLM ou Transformers QuantizedCache | Récupération en contexte long, latence, sécurité et qualité |
| Inférence locale sur CPU, Apple Silicon ou poste de travail | Fichiers GGUF avec encodages de tenseurs locaux | llama.cpp, Ollama, LM Studio, MLX | Latence du prompt, utilisation de la RAM, encodage de tenseurs choisi, qualité subjective des sorties |
| Le fine-tuning par adapter doit tenir sur un seul GPU | NF4 / QLoRA | bitsandbytes, peft | Loss du fine-tuning et qualité du modèle fusionné |
| Le pipeline de génération d’images est trop volumineux ou trop lent | INT4 ou FP8 propres à la diffusion | SVDQuant, Nunchaku, torchao, NVIDIA ModelOpt | Artefacts visuels, adéquation au prompt, latence, VRAM |
La figure indique où une requête manque de temps ou de mémoire sur un GPU de serving et quel format de départ soulage chaque limite. La ligne du bas couvre les cas qui ne relèvent pas du serving sur GPU de datacenter.
2. La quantification est un arrondi contrôlé
La quantification fait correspondre des valeurs de haute précision à un ensemble plus petit de valeurs représentables. C’est la définition de base que donnent à la fois Hugging Face Optimum et TensorRT-LLM. Vous économisez de la mémoire et de la bande passante. Vous introduisez aussi une erreur d’arrondi.
L’INT4 ne fournit que 16 valeurs discrètes : projeter des poids BF16 (16 bits) sur cette grille crée donc une erreur d’arrondi. Les méthodes de quantification jugent l’arrondi à l’aune de ce qu’il change dans la sortie d’une couche, pas poids par poids. GPTQ estime comment les choix d’arrondi affectent cette sortie et ajuste les poids restants pour réduire l’erreur. AWQ s’appuie sur les activations observées pour repérer les groupes de poids importants, appelés canaux, et les remet à l’échelle avant l’arrondi. Une bonne projection économise de la mémoire avec peu de perte de qualité. Une mauvaise dégrade le raisonnement, le respect des instructions ou la fidélité visuelle.
Mapping symétrique et asymétrique
En suivant le mapping affine utilisé dans les guides de quantification courants, la quantification fait correspondre une valeur flottante continue à une grille discrète.
- et sont les bornes inférieure et supérieure choisies en virgule flottante.
- est la valeur d’origine de haute précision.
- est la valeur quantifiée.
- est l’échelle, ou pas de quantification.
- est le point zéro, l’emplacement entier qui représente
0.0. - est la plage entière cible. Cet exemple symétrique utilise , qui compte 15 valeurs et représente exactement zéro. D’autres formats INT4 signés utilisent les 16 valeurs, par exemple .
La quantification symétrique centre la grille autour de zéro et fixe :
C’est adapté au matériel, car le calcul à l’exécution n’a pas besoin de soustraire un décalage de point zéro. La pile de quantification de PyTorch expose ces choix affines d’échelle et de point zéro comme paramètres de quantification primitifs dans torchao.
La quantification asymétrique décale la grille pour couvrir des plages dissymétriques :
Cette grille décalée peut mieux préserver des activations uniquement positives, mais le décalage ajoute du travail, sauf si le kernel le gère bien.
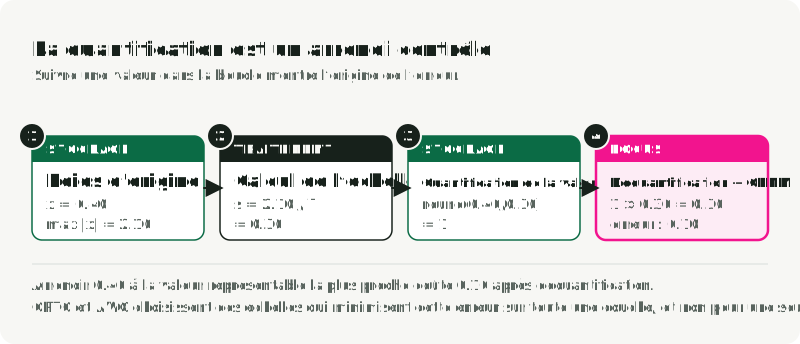
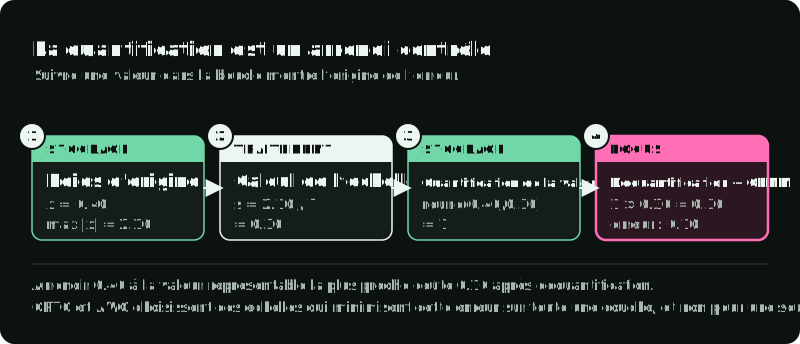
La figure déroule le cas symétrique : une magnitude maximale de 2,10 donne une échelle de 0,30, donc le poids 0,40 est arrondi à l’entier 1. La déquantification multiplie cet entier stocké par l’échelle pour retrouver une valeur approchée, 0,30. L’écart avec 0,40 est l’erreur d’arrondi.
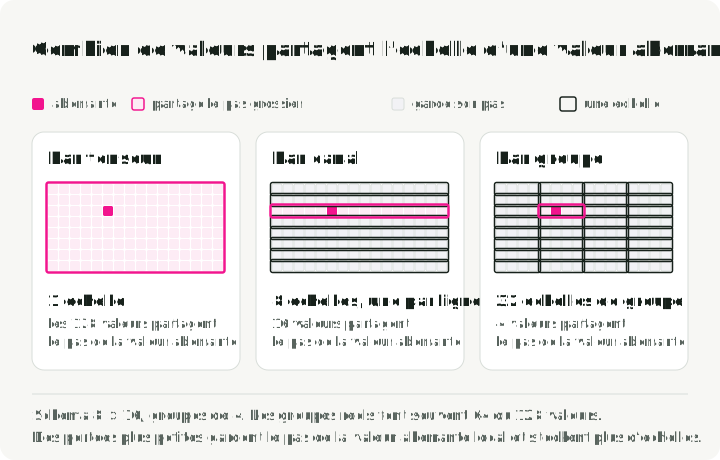
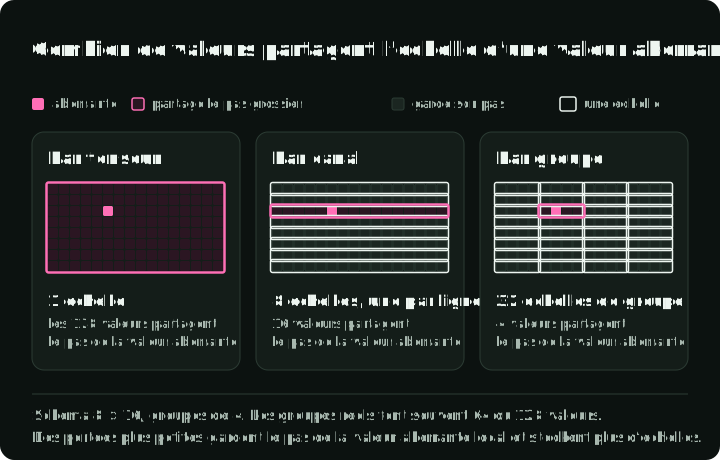
Granularité de l’échelle : tenseur, canal, groupe
Le facteur d’échelle peut couvrir un tenseur de poids entier, un canal ou un petit groupe de valeurs. La documentation FP8 du KV cache de vLLM reprend la même distinction entre les stratégies d’échelle par tenseur et par tête d’attention. Les groupes plus petits préservent en général mieux la qualité, mais exigent plus de métadonnées d’échelle.
| Granularité de l’échelle | Ce qui partage une échelle | Effet sur la qualité et l’exécution |
|---|---|---|
| Par tenseur | La matrice de poids entière | Stocke peu de métadonnées, mais une valeur aberrante peut étirer la grille et réduire la précision sur toute la couche. |
| Par canal | Une ligne de sortie | Évite que des canaux à plage étroite partagent la plage plus large d’un autre canal. De nombreux chemins de poids sur 8 bits utilisent cette granularité. |
| Par groupe | Un bloc dans une ligne, souvent 64 ou 128 valeurs | Confine une valeur aberrante à un petit bloc, au prix de davantage d’échelles. AutoGPTQ utilise group_size=128 dans ses exemples GPTQ. |
La figure place une valeur aberrante dans une petite matrice d’illustration et compte combien de valeurs partagent son échelle selon chaque choix.
Les poids sont statiques, donc leurs échelles peuvent être calculées hors ligne avant de charger le modèle. Les activations changent à chaque token, ce qui rend leurs plages dépendantes de la charge de travail.
| Mise à l’échelle des activations | Quand le runtime choisit l’échelle | Avantage | Mode de défaillance ou coût |
|---|---|---|---|
| Statique | Hors ligne, à partir d’un dataset de calibration | Évite le calcul de l’échelle pendant l’inférence. | Des prompts hors de la longueur ou de la distribution calibrée peuvent écrêter les pics d’activation et dégrader la sortie. |
| Dynamique | À chaque passe avant | S’adapte aux valeurs d’activation courantes et au mélange de prompts. | Calculer les plages à chaque couche ajoute du travail et exige des kernels optimisés. |
Le KV cache se situe entre ces deux cas : les keys et values sont des activations calculées à l’exécution, puis conservées pour les tokens suivants, et elles ont donc leurs propres échelles. La section 6 explique comment les runtimes les stockent.
PTQ et QAT interviennent à des étapes différentes
La quantification post-entraînement, ou PTQ, compresse un modèle déjà entraîné. L’entraînement conscient de la quantification (quantization-aware training), ou QAT, expose le modèle au bruit de quantification pendant l’entraînement pour qu’il s’y adapte.
| Méthode | Quand les plages sont apprises | À utiliser quand | Coût à payer |
|---|---|---|---|
| PTQ weight-only | Hors ligne, pour des poids statiques | Le modèle ne tient pas ou le decode est limité par la bande passante | Les activations restent en 16 bits |
| PTQ statique | Hors ligne, à partir de prompts de calibration | Vous voulez un serving W8A8 rapide | Les données de calibration doivent ressembler à la production |
| PTQ dynamique | À l’exécution, par batch ou par chemin d’activation | Les distributions d’entrée varient beaucoup | Travail supplémentaire à l’exécution et prise en charge matérielle plus étroite |
| QAT | Pendant l’entraînement | Le PTQ dégrade la qualité d’un modèle sensible | Infrastructure d’entraînement complète et bien plus de calcul |
Les données de calibration doivent ressembler au trafic que vous allez servir. Le chemin de calibration du KV cache de vLLM, par exemple, utilise un dataset sélectionné via llm-compressor. Si les prompts de production sont de longues traces RAG, de courts paragraphes de Wikipédia peuvent manquer les plages d’activation que ces traces produisent. Pour les échelles statiques des activations ou du cache, la calibration choisit les plages. Pour GPTQ et AWQ, les activations de calibration décident aussi de la façon dont chaque poids est arrondi ou remis à l’échelle : une calibration sur des textes courts peut donc façonner les poids stockés. De vrais prompts en contexte long peuvent produire d’autres motifs d’activation. Les évaluations de quantification en contexte long mesurent directement ce risque.
3. Les formats numériques imposent les exigences matérielles
Le format numérique définit les valeurs que le modèle peut représenter en mémoire. Un calcul efficace exige des kernels de runtime et un matériel qui prennent en charge la même largeur de bits et le même format. TensorRT-LLM documente à la fois la liste des recettes et la matrice de prise en charge matérielle.
| Format | Stockage par valeur | Bon choix par défaut pour | Point de vigilance principal |
|---|---|---|---|
| BF16 / FP16 | 2 octets | Inférence de référence et serving compatible avec l’entraînement | Forte utilisation de la VRAM et fort trafic sur la bande passante mémoire |
| FP8 | 1 octet | Serving W8A8 à haut débit sur Ada, Hopper, Blackwell | Exige des tensor cores FP8 natifs et la prise en charge du runtime |
| INT8 | 1 octet | Serving W8A8 sur du matériel plus ancien ou non NVIDIA | Valeurs aberrantes des activations et sensibilité à la calibration statique |
| INT4 | 0,5 octet | W4A16 quand la mémoire des poids est la limite principale | Perte de qualité sur les modèles plus petits ou orientés raisonnement |
| FP4 / NVFP4 | ~0,5 octet | Expériences de l’ère Blackwell et premières voies de serving | Exigences de compilateur et de runtime propres au matériel |
| Encodages / préréglages GGUF de llama.cpp | Variable | Inférence locale sur CPU, Apple Silicon, poste de travail et edge | GGUF est le conteneur. L’encodage des tenseurs est le choix de quantification. |
| NF4 | 0,5 octet | Entraînement d’adapters QLoRA | En général un mauvais format d’export pour le serving en production |
BF16 et FP16 utilisent tous deux 16 bits, mais ils répartissent la précision différemment et échouent donc différemment. Le BF16 garde la plage d’exposant sur 8 bits du FP32 et déborde plus difficilement. Le FP16 a plus de bits de mantisse et une plage d’exposant plus étroite : les pics d’activation demandent donc plus de soin. L’évaluation de Kurtic et al. utilise explicitement le BF16 comme référence pour comparer les formats de serving FP8, INT8 et INT4.
Le FP8 a deux variantes courantes. Le E4M3 offre plus de précision et sert en général pour les poids et les activations de la passe avant. Le E5M2 offre plus de plage dynamique et convient mieux aux gradients ou aux chemins d’activation instables. vLLM expose les deux types FP8 E4M3 et E5M2 pour le KV cache. Dans l’étude ACL 2025 de Kurtic et al., « Give Me BF16 or Give Me Death », le FP8 W8A8 était pratiquement sans perte sur la famille Llama-3.1, sur plus de 500 000 évaluations. Ce résultat couvre cette famille de modèles, cette suite d’évaluation et cette configuration de serving. Chaque déploiement a besoin de sa propre vérification de qualité avant la mise en production.
Blackwell ajoute des formats à micro-échelle (microscaling) tels que MXFP8 et NVFP4. Au lieu d’une seule échelle pour un tenseur ou une ligne entière, le microscaling utilise de minuscules blocs. L’explication de NVIDIA sur le NVFP4 décrit des valeurs flottantes sur 4 bits en blocs de 16, avec des facteurs d’échelle FP8 et une échelle FP32 de niveau supérieur. Cette approche vise une empreinte proche de l’INT4 avec un comportement en virgule flottante. Elle exige toutefois une architecture matérielle, un compilateur et un runtime compatibles, ce qui explique pourquoi TensorRT-LLM liste la prise en charge de FP4 et FP8 par génération de GPU.
4. Weight-only contre quantification poids-activations
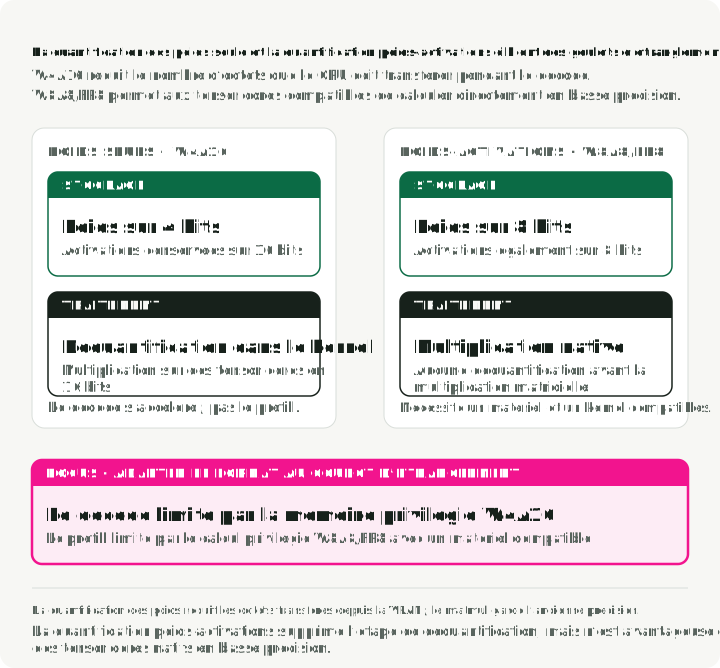
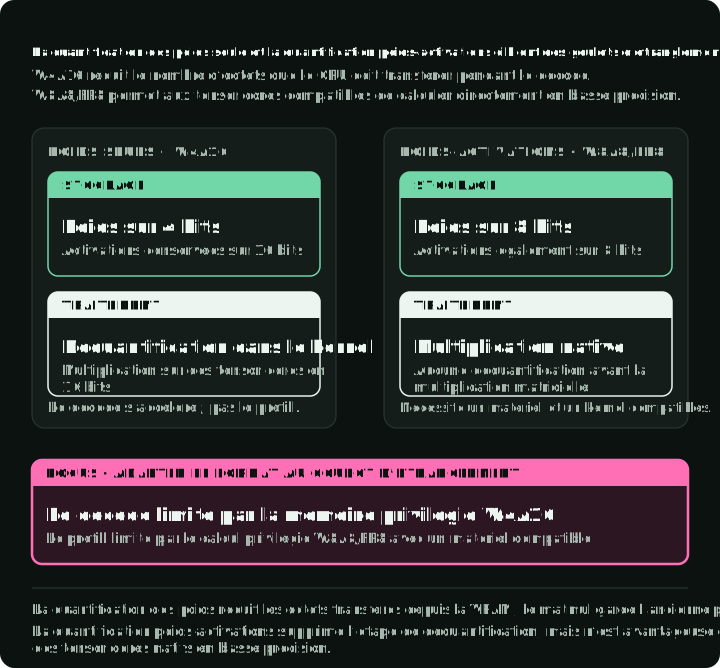
La notation WxAy décrit la précision des poids et des activations, qui sollicitent le GPU de manières différentes pendant l’inférence. La figure suit les poids depuis la VRAM, à travers le kernel, jusqu’aux tensor cores pour BF16, W4A16 et W8A8.
Pendant le prefill, le modèle traite le prompt d’entrée. Cette phase est en général limitée par le calcul, car le GPU effectue de grandes multiplications matricielles, d’où l’intérêt des recettes W8A8 FP8/INT8 pour un serving orienté débit.
Pendant le decode, le modèle génère un token à la fois. Cette phase est souvent limitée par la bande passante mémoire, car le GPU recharge sans cesse les poids depuis la VRAM pour produire le token suivant. Des articles weight-only comme GPTQ et AWQ ciblent cette contrainte en réduisant le nombre d’octets de poids.
Le W4A16 compresse les poids et garde les activations en BF16 ou FP16. Le GPU charge moins d’octets de poids, puis les déquantifie vers une forme de précision plus élevée pour la multiplication. Cela aide pour le decode et pour les problèmes de tenue en mémoire. Le prefill, limité par le calcul, peut y gagner peu, car les calculs matriciels restent en 16 bits.
Le W8A8 compresse les poids et les tenseurs d’activation utilisés par les kernels matmul pris en charge. Si le matériel dispose de tensor cores natifs à faible précision, le moteur de serving peut exécuter directement les calculs matriciels en FP8 ou INT8. Le FP8 peut donc aider le serving à haut débit en réduisant le trafic mémoire et en utilisant une arithmétique plus rapide. Le KV cache a son propre réglage de stockage : vérifiez donc séparément le type de cache ou l’implémentation du cache du runtime.
Dans l’exécution versionnée du dépôt compagnon (RTX 4090, vLLM 0.23.0, une seule répétition de 64 tokens générés), Qwen3-8B avec la quantification dynamique FP8 en ligne de vLLM a généré 122 tok/s contre 85 tok/s en BF16 et a chargé 8,8 GiB de poids au lieu de 15,3 GiB. L’ajout d’un KV cache FP8 a fait tomber le débit à 49 tok/s. Cette exécution est trop courte pour fixer la capacité, mais elle montre que chaque réglage demande sa propre mesure.
5. Algorithmes contre kernels du runtime
Les algorithmes de quantification (comme GPTQ ou AWQ) définissent comment les poids du modèle sont convertis vers une précision plus faible. Les kernels du runtime (comme Marlin ou les kernels personnalisés de vLLM) sont le code GPU de bas niveau qui exécute la multiplication matricielle. Un modèle très compressé ne tourne vite que s’il existe un kernel optimisé pour son format de quantification précis.
Une recette de serving nomme un élément de chaque couche : un algorithme (GPTQ, AWQ), un format de checkpoint (compressed-tensors, GGUF), un runtime (vLLM, llama.cpp) et un kernel (Marlin). Un même checkpoint AWQ peut tourner à des vitesses très différentes selon le kernel.
Le graphique associe chaque checkpoint 4 bits avec et sans le kernel Marlin dans un benchmark publié. Le tableau ci-dessous ajoute la perplexité et le TTFT.
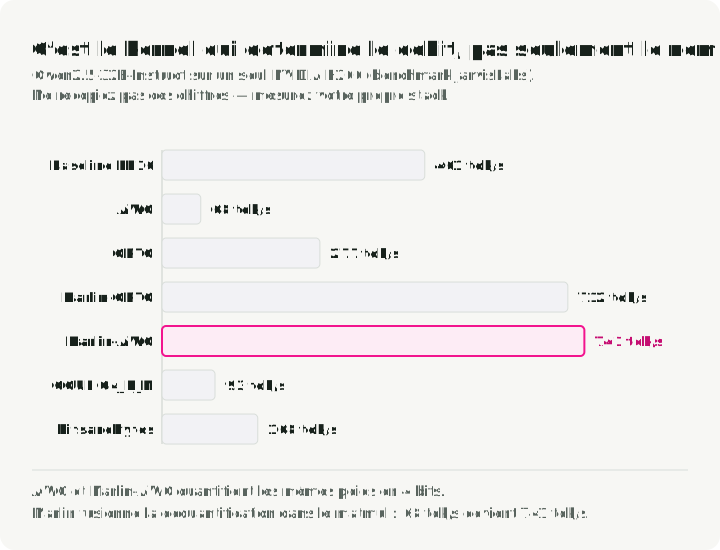
Le benchmark vLLM de JarvisLabs a fait tourner Qwen2.5-32B-Instruct sur un NVIDIA H200. La perplexité mesure la qualité avec laquelle le modèle prédit le texte de test ; plus elle est basse, mieux c’est. Le HumanEval pass@1 mesure la réussite sur des tâches de code avec une seule solution générée. Les tokens de sortie/s mesurent le débit de génération, tandis que le TTFT moyen mesure l’attente moyenne avant le premier token de sortie :
| Quantification / kernel | Perplexité Wikitext-2 ↓ | HumanEval pass@1 ↑ | Tokens de sortie/s | TTFT moyen |
|---|---|---|---|---|
| FP16 de référence | 6,56 | 56,1 % | 461 tok/s | 57,7 ms |
| AWQ | 6,84 | 51,8 % | 68 tok/s | 277,8 ms |
| GPTQ | 6,90 | 46,3 % | 277 tok/s | 107,1 ms |
| Marlin-GPTQ | 6,97 | 45,7 % | 712 tok/s | 51,9 ms |
| Marlin-AWQ | 6,84 | 51,8 % | 741 tok/s | 73,5 ms |
| GGUF Q4_K_M | 6,74 | 51,8 % | 93 tok/s | 958,0 ms |
| bitsandbytes | 6,67 | 51,8 % | 168 tok/s | 135,3 ms |
Le test de vitesse de l’éditeur utilise 200 prompts ShareGPT, une concurrence maximale de 10 et la graine 42. La qualité provient d’exécutions distinctes sur Wikitext-2 et HumanEval. Le rapport ne fixe ni la version de vLLM ni les révisions des modèles : ce sont donc des résultats déclarés par l’éditeur, pas une comparaison reproduite de façon indépendante. Ils montrent un point plus restreint : le nom de l’algorithme inscrit sur le checkpoint ne dit pas à quelle vitesse tournera le serving.
Par exemple, AWQ et Marlin-AWQ utilisent les mêmes poids sur 4 bits. L’implémentation Marlin est bien plus rapide, car son kernel CUDA fusionne la déquantification et la multiplication matricielle en une seule opération GPU très optimisée.
Pour votre propre comparaison, créez ou obtenez d’abord un checkpoint AWQ compatible avec vLLM au chemin ci-dessous ; ces commandes ne quantifient pas le modèle. Installez une version de vLLM prise en charge par votre GPU, puis lancez le serveur dans un terminal :
vllm serve ./outputs/Qwen2.5-32B-Instruct-AWQ-W4A16 \
  --served-model-name qwen2.5-32b-awq \
  --host 127.0.0.1 \
  --port 8000
Laissez ce serveur tourner. Dans un second terminal, utilisez vllm bench serve avec le vrai tokenizer, distinct de l’alias de modèle de l’API :
vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model qwen2.5-32b-awq \
  --tokenizer Qwen/Qwen2.5-32B-Instruct \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Il s’agit d’un test de charge synthétique visant 1 024 tokens d’entrée et 256 tokens de sortie par requête, pas d’une reproduction du tableau ShareGPT ni d’un test de qualité. Répétez-le pour la référence et pour chaque checkpoint préparé, avec le même tokenizer, les mêmes longueurs, la même graine et la même concurrence. Notez les nombres réels de tokens et la version de vLLM installée. Ces exemples de commandes exigent le checkpoint préparé et le GPU cible.
Suivez le débit, le TTFT, la latence inter-token (le délai entre deux tokens successifs), l’utilisation de la mémoire et la qualité sur la tâche. Quand certaines de ces mesures évoluent en sens opposés, c’est ce compromis qu’il faut voir avant de livrer.
Comparaison des algorithmes de quantification
Ces méthodes résolvent des problèmes de compression différents :
| Algorithme | Format courant | Ce qu’il cherche à préserver | Coût principal |
|---|---|---|---|
| GPTQ | W4A16 | La sortie de la couche, via des estimations hessiennes de l’effet des poids sur l’erreur de sortie | Calibration lente et traitement plus complexe |
| AWQ | W4A16 / W4A8 | Les canaux d’activation importants | Exige une calibration et des kernels de serving fusionnés |
| SmoothQuant | W8A8 | Le comportement des activations INT8, en déplaçant l’échelle des valeurs aberrantes vers les poids | Réglage des échelles propre à chaque modèle |
| QuaRot / SpinQuant | W4A4 / W4A8 | Une moindre pression des valeurs aberrantes d’activation, grâce à des rotations | Complexité des rotations à l’exécution |
| HQQ | W4A16 / W2A16 | Une compression weight-only rapide, sans calibration | La qualité exige des vérifications en aval à très faible largeur de bits |
| QLoRA (NF4) | NF4 | La mémoire d’entraînement des adapters | Pas un bon choix par défaut pour le serving |
| K-quants / IQ-quants GGUF de llama.cpp | Encodages de tenseurs mixtes à faible nombre de bits | La qualité de l’inférence locale par octet | Non conçu pour le serving en batch dans le cloud |
| RTN (round-to-nearest, arrondi au plus proche) | W8A16 / FP8 | Rien au-delà de l’échelle ; pas de données de calibration | Forte perte de qualité à 4 bits ; à utiliser comme référence |
| FP8 dynamique | W8A8 FP8 | La plage des activations par token à l’exécution ; pas de données de calibration | Exige des tensor cores FP8 ; les GPU plus anciens peuvent ne voir aucun gain |
AutoGPTQ a été archivé en avril 2025, et AutoAWQ a été archivé et officiellement déclaré obsolète en mai 2025. Pour les nouveaux checkpoints compressed-tensors consommés par vLLM, commencez par llm-compressor. Utilisez GPTQModel quand vous avez besoin de la voie GPTQ activement maintenue avec Marlin, Machete, les options mémoire pour MoE ou l’offload sur disque.
L’élagage et la distillation réduisent aussi le coût de serving, par des workflows distincts. La sparsité structurée 2:4 supprime des poids selon un motif que les tensor cores creux de NVIDIA savent exploiter. La distillation entraîne un modèle élève plus petit à imiter un modèle plus grand, ce qui peut bien fonctionner pour des tâches étroites. N’ajoutez l’une ou l’autre de ces voies à la liste restreinte que si le projet peut supporter le travail supplémentaire d’élagage ou d’entraînement.
6. La mémoire de serving ne se limite pas aux poids
Le checkpoint compressé n’est qu’une partie de l’empreinte mémoire du serving. Dimensionnez le runtime complet avant de décider si la quantification des poids suffit. PagedAttention identifie le KV cache comme un poste majeur de la mémoire de serving.
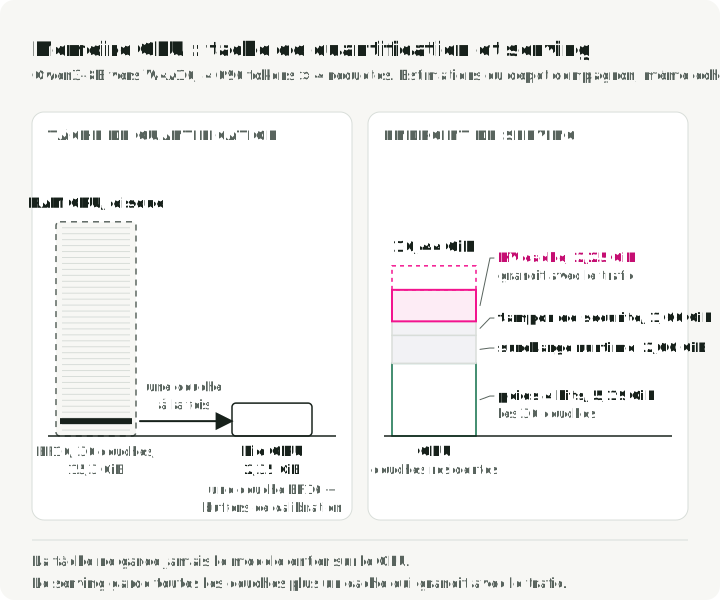
La quantification hors ligne peut se faire couche par couche. Des outils comme llm-compressor peuvent charger un bloc transformer, exécuter la calibration et les calculs de quantification, écrire le bloc compressé, puis passer au suivant. Le pic de mémoire GPU reste ainsi proche de la plus grande couche active plus les buffers de calibration. Il vous faut toujours de la RAM CPU et du disque pour le checkpoint source, mais le GPU ne contient pas toujours le modèle BF16 complet.
Le pic de mémoire GPU pendant la quantification hors ligne peut ressembler à ceci :
La figure dessine les deux budgets à la même échelle avec l’estimation W4A16 de Qwen3-8B du dépôt compagnon, section 9. Le panneau de gauche montre la tâche hors ligne ; celui de droite, ce qui doit rester sur le GPU pendant le serving.
Pour un serving entièrement résident sur GPU, tous les poids compressés doivent tenir sur les GPU de serving, avec le KV cache et les buffers du runtime. L’offload des poids réduit la résidence sur GPU au prix de transferts. Le KV cache croît avec la longueur du contexte et la taille du batch actif. Pour des couches d’attention uniformes et des requêtes de longueur égale, la taille de son tenseur est approximativement :
Cette estimation exclut le surcoût de l’allocateur, les métadonnées d’échelle du cache et les préfixes partagés. Pour des requêtes de longueurs différentes, remplacez par la somme de leurs longueurs en cache.
Où :
- est le nombre de couches.
- est le nombre de têtes d’attention key-value. L’attention par groupes de requêtes le réduit en faisant partager moins de têtes KV à de nombreuses têtes de requête.
- est la dimension de chaque tête, souvent 128 ou 256.
- est le nombre de tokens du prompt plus celui des tokens générés.
- est le batch de serving actif.
- vaut 2 pour BF16 ou FP16 et 1 pour FP8 ou INT8. Le mode KV cache FP8 de vLLM est l’exemple de pile de serving que cet article utilise.
La KV-cache quantization modifie le stockage, tandis que la réutilisation modifie l’allocation
Le KV cache peut être quantifié pendant l’inférence. Chaque étape de decode produit des tenseurs d’activation K et V pour le nouveau token. Un modèle W8A8 peut déjà utiliser FP8 ou INT8 pour les calculs de projection pris en charge, mais le cache reste un objet de stockage distinct.
De nombreuses piles de serving gardent cet objet dans le type du modèle ou du cache. Pour le changer, activez un type de KV cache, utilisez un checkpoint avec des échelles de cache, ou choisissez une implémentation de cache quantifié.
Quand la KV-cache quantization est activée, le moteur écrit les entrées sous forme d’une représentation de plus faible précision accompagnée d’échelles. L’attention suivante déquantifie ensuite le cache dans son kernel ou, sur certains backends, effectue une partie de l’opération d’attention dans le domaine quantifié.
La documentation stable du KV cache quantifié de vLLM l’expose directement avec kv_cache_dtype="fp8" ou --kv-cache-dtype fp8. vLLM prend en charge les formats de cache FP8 E4M3 et E5M2, ainsi que des stratégies d’échelle par tenseur et par tête d’attention. Il peut utiliser des échelles par défaut ou une calibration sur dataset via llm-compressor. Avec FlashAttention 3, vLLM peut aussi exécuter les opérations d’attention dans le domaine FP8 en quantifiant les queries en plus des keys et des values. Pour activer le cache FP8 d’un modèle :
vllm serve Qwen/Qwen3-8B --kv-cache-dtype fp8 --max-model-len 32768TensorRT-LLM expose le KV cache FP8 via KvCacheConfig(dtype='fp8') et liste le KV cache FP8 et le KV cache NVFP4 comme des recettes de quantification distinctes de la quantification des poids et des activations. Hugging Face Transformers propose aussi une voie QuantizedCache via cache_implementation="quantized", avec hqq qui prend en charge les formats de cache int2, int4 et int8, et quanto qui prend en charge int2 et int4.
Le KV caching ordinaire stocke les keys et values précédentes pour éviter de les recalculer. Le prefix caching réutilise des blocs de cache entre des requêtes qui partagent le même préfixe. PagedAttention réduit la fragmentation et améliore l’allocation, tandis que l’offload du KV déplace des blocs de cache entre des niveaux de mémoire. Ces combinaisons dépendent du runtime. Le QuantizedCache de Hugging Face ne prend pas en charge l’offload. vLLM documente son KV cache quantifié séparément du prefix caching et des autres fonctions de gestion du cache. Vérifiez chaque combinaison dans le runtime que vous déployez.
Le risque pour la qualité diffère aussi de celui du PTQ weight-only. La KV-cache quantization injecte de l’erreur dans l’état d’attention relu à chaque étape de decode suivante. Testez séparément la récupération en contexte long, le comportement multi-tours, la sécurité et les refus, le format des tool calls et la latence de sortie. KVQuant, KIVI et l’étude vLLM sur le KV cache FP8 évaluent tous la KV-cache quantization comme un problème à part entière.
Un exemple chiffré montre quand le cache devient plus grand que les poids. Prenons Llama-3.1-70B (80 couches, 8 têtes KV, dimension de tête 128) servant 8 requêtes de 32 768 tokens :
def kv_cache_gb(layers, kv_heads, head_dim, tokens, batch, bytes_per_value):
    return 2 * layers * kv_heads * head_dim * tokens * batch * bytes_per_value / 1e9

# Llama-3.1-70B: 80 layers, 8 KV heads, head dimension 128
for name, nbytes in [("BF16", 2), ("FP8", 1)]:
    print(name, round(kv_cache_gb(80, 8, 128, 32_768, 8, nbytes), 1), "GB")
Il affiche BF16 85.9 GB et FP8 42.9 GB. Avec cette charge, le cache BF16 (86 GB) est plus grand que les poids INT4 : environ 40 GB une fois comptés les échelles de groupe et les embeddings en 16 bits, contre les 35 GB que le tableau de la section 7 donne pour les seules valeurs sur 4 bits. Le cache FP8 économise 43 GB ; passer les poids de BF16 à INT4 en économise environ 100. Ici, la quantification des poids passe en premier, et le cache est le plus gros poste restant. Le graphique empile les poids et le cache après chaque étape.
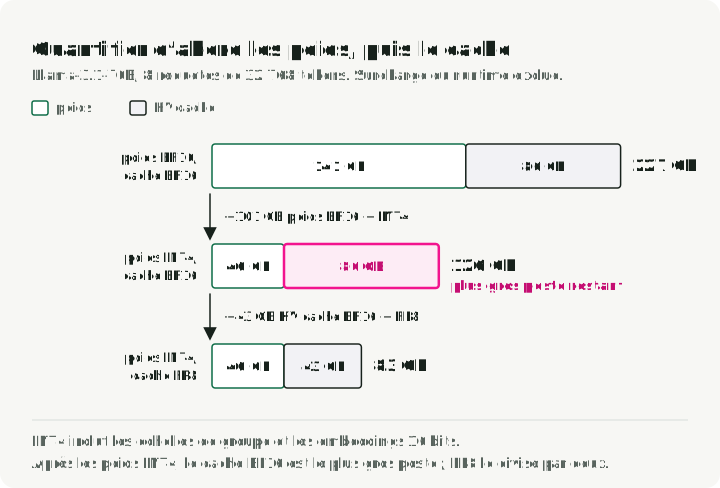
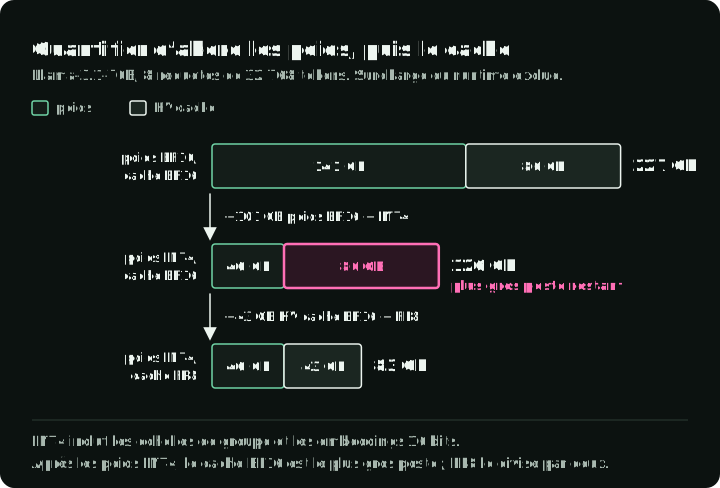
Comparez la mémoire qu’économiserait chaque changement pour votre propre modèle. Utilisez l’équation du cache ci-dessus avec le même batch et la même longueur de contexte pour le type de cache actuel et le type proposé. Soustrayez la taille proposée de la taille actuelle. Faites de même pour les deux formats de poids que vous envisagez. Comparez par exemple l’économie du passage de BF16 à un cache FP8 avec celle du passage de BF16 à des poids INT4. Testez d’abord l’option dont l’économie estimée est la plus grande, si le runtime la prend en charge. Mesurez ensuite l’utilisation réelle de la mémoire et la qualité ; aucune des deux estimations n’inclut toutes les allocations du runtime.
7. Taille des poids et prise en charge par les GPU
L’empreinte des poids s’estime facilement à partir du nombre de paramètres et de la précision de stockage, selon le même principe de dimensionnement que dans les discussions sur la mémoire de serving autour du KV cache :
| Taille du modèle | Poids BF16 | Poids FP8 / INT8 | Poids INT4 |
|---|---|---|---|
| 7B / 8B | ~14-16 GB | ~7-8 GB | ~3,5-4 GB |
| 14B | ~28 GB | ~14 GB | ~7 GB |
| 32B / 34B | ~64-68 GB | ~32-34 GB | ~16-17 GB |
| 70B | ~140 GB | ~70 GB | ~35 GB |
| 109B MoE | ~218 GB au total | ~109 GB | ~55 GB |
La colonne INT4 ne compte que les valeurs sur 4 bits. Les échelles de groupe ajoutent quelques pour cent, et les embeddings et lm_head conservés en 16 bits en ajoutent davantage. Pour Qwen3-8B, ces deux matrices font environ 1,2 GB chacune en BF16. L’estimation W4A16 du dépôt compagnon, 5,19 GiB, garde 12 % des paramètres en 16 bits pour les couvrir.
À budget mémoire fixe, un modèle plus grand en 4 bits peut battre un modèle plus petit en 16 bits. Dettmers et Zettlemoyer ont trouvé que la précision de 4 bits est presque universellement optimale pour l’exactitude zero-shot par bit total du modèle, sur des modèles BLOOM, OPT, Pythia et GPT-2 de 19M à 176B de paramètres. L’étude n’a mesuré que l’exactitude zero-shot : testez donc vos propres tâches avant de choisir.
Les modèles mixture-of-experts peuvent activer moins de paramètres par token, mais l’ensemble des poids doit tout de même résider quelque part, sauf si le runtime prend en charge l’offload. La matrice de prise en charge de la quantification de TensorRT-LLM traite les familles de modèles MoE comme des cibles de déploiement avec leurs propres recettes prises en charge.
Votre matériel de déploiement restreint les formats de quantification viables :
- Le serving sur CPU dépend d’instructions vectorielles comme AVX-512 ou AMX. Un fichier GGUF chargé via
llama.cppest la voie pratique. - Apple Silicon utilise une mémoire unifiée : les modèles locaux peuvent donc exploiter un grand pool de RAM partagée au lieu d’une VRAM dédiée. GGUF et
llama.cpprestent la voie courante des runtimes locaux, car le GGUF est conçu pour les exécuteurs GGML. MLX est l’autre voie courante :mlx_lm.convert --model <model> -qécrit par défaut un modèle MLX 4 bits, et--q-bits 8en écrit un 8 bits. Comparez la vitesse et la qualité sur les mêmes prompts avant de choisir. - NVIDIA Ampere prend en charge les voies de serving INT8 sur tensor cores, mais pas le calcul FP8 W8A8 natif sur tensor cores. Les choix courants sont la quantification W4A16 weight-only ou l’INT8 statique, conformément à la matrice de prise en charge matérielle de TensorRT-LLM.
- NVIDIA Ada et Hopper prennent en charge les voies de serving FP8 dans TensorRT-LLM. Le serving FP8 W8A8 vaut la peine d’être testé sur ces GPU.
- NVIDIA Blackwell ajoute la prise en charge de NVFP4 et du microscaling, mais la voie logicielle reste déterminante. Considérez les premières piles à virgule flottante basse précision comme sensibles aux versions.
8. Calibration et évaluation avant le déploiement
Un modèle qui se charge a seulement passé un smoke test. Le déploiement exige des vérifications de qualité et de serving sur la charge de travail cible. Des évaluations récentes de la quantification rapportent des résultats différents pour le serving de LLM, les tâches en contexte long et les modèles orientés raisonnement.
La figure montre où vont les échantillons de calibration et les échantillons d’évaluation réservés.
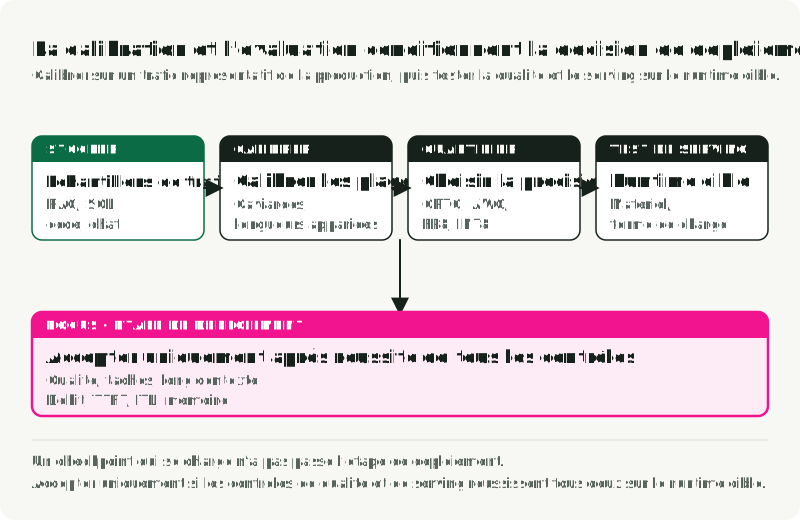
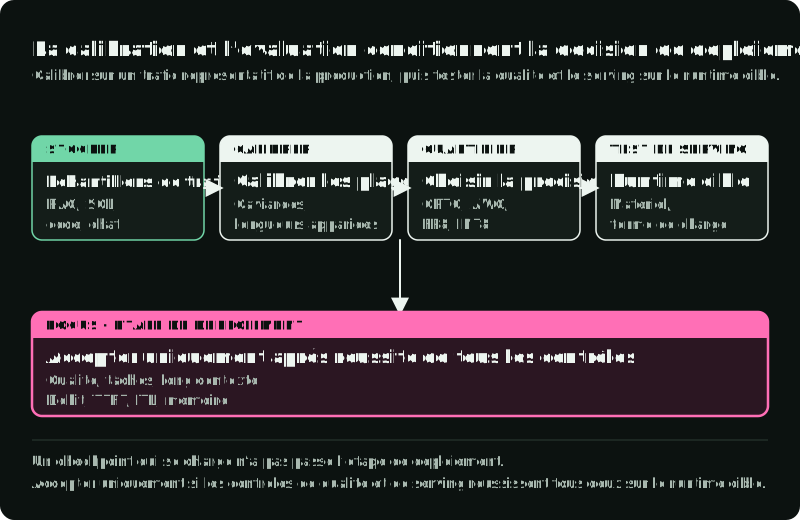
Choisissez d’abord la recette. Quand elle exige une calibration, utilisez des prompts qui ressemblent à la production. HQQ et FP8 dynamique, par exemple, n’ont besoin d’aucun dataset de calibration : la figure montre donc un chemin qui saute la calibration. Gardez les exemples d’évaluation séparés des échantillons de calibration, pour que la comparaison finale teste un comportement sur des données réservées. Pour les recettes qui exigent une calibration :
- Incluez des traces RAG, des requêtes SQL, des historiques d’agents, des tâches de code, des payloads de tool calls et des system prompts issus de la charge de travail cible. Le PTQ statique dépend de données de calibration qui correspondent à la distribution de production.
- Faites correspondre les longueurs de séquence. De courts prompts à un seul tour n’exposeront pas le comportement des activations en contexte long.
- Gardez
embed_tokensetlm_headen précision plus élevée si la méthode ou le runtime le permet, un motif d’exclusion courant dans les recettes LLM Compressor. - Utilisez assez d’échantillons pour stabiliser les plages d’activation. L’exemple de KV cache de vLLM fixe
NUM_CALIB_SAMPLES = 512. Voyez-y un exemple documenté, pas un nombre universel. Le bon nombre d’échantillons dépend de la méthode, du modèle, de la longueur de séquence et de la charge de production. - Masquez les secrets et les données privées des utilisateurs avant d’utiliser des logs de production.
Pour l’évaluation, testez à la fois la qualité du langage et le comportement en serving :
- La perplexité sur un corpus standard détecte une dégradation générale du langage, mais le benchmark JarvisLabs rappelle utilement que perplexité et débit peuvent évoluer différemment.
- Les tâches de domaine détectent des défaillances que la perplexité masque. Utilisez HumanEval pour le code, MMLU pour les connaissances générales, et AIME ou MATH-500 pour le raisonnement mathématique quand ces domaines comptent.
- Les vérifications de format comptent pour les systèmes agentic. Testez la conformité au JSON Schema, la sortie markdown, la forme des tool calls et le comportement de refus, car les évaluations de modèles quantifiés peuvent manquer des défaillances au niveau de l’application même quand l’exactitude agrégée sur les benchmarks paraît stable.
- Les tests en contexte long détectent les dégâts de la KV-cache quantization. L’aiguille dans une botte de foin est un test grossier, mais les résultats de quantification en contexte long montrent pourquoi ces vérifications doivent précéder le déploiement.
- Les tests de charge doivent rapporter le débit, le TTFT, la latence inter-token, la concurrence soutenable et le pic de mémoire GPU.
vllm bench servemesure le débit et la latence. Collectez la mémoire GPU séparément avec la télémétrie GPU/serveur. Balayez la concurrence face à des limites de latence et d’erreurs explicites pour trouver un niveau soutenable ; la concurrence observée lors d’une seule exécution n’établit pas la capacité.
Pour une application RAG, gardez fixes les questions et les éléments de preuve récupérés quand vous comparez le générateur de référence et le générateur quantifié. Cette comparaison isole le changement du générateur. Exécutez ensuite le pipeline complet pour vérifier le résultat de serving, en vous aidant du guide d’évaluation du RAG pour distinguer les échecs de récupération des réponses non étayées. Pour un agent, vérifiez si les mêmes tâches aboutissent avec des tool calls valides et des effets de bord acceptables. Un checkpoint plus petit ne répond à aucune de ces questions.
Testez les modèles de raisonnement sur des tâches à plusieurs étapes. Une quantification sous 4 bits ou W4A4 sans rotation peut nuire à l’exactitude du raisonnement même quand la perplexité de référence paraît stable, ce qui est l’avertissement central de l’étude sur les modèles de raisonnement quantifiés.
9. Workflow du dépôt compagnon
Le dépôt compagnon, slavadubrov/model-compression-demo, rend le processus de décision reproductible. Il utilise uv et se concentre sur la planification, les recettes, les dry runs et les configurations de benchmark, fondés sur les mêmes sources que cet article : vLLM, LLM Compressor, TensorRT-LLM et les articles sur les algorithmes.
Clonez-le et inspectez les algorithmes pris en charge :
git clone https://github.com/slavadubrov/model-compression-demo.git
cd model-compression-demo
git checkout 62da4539793ac3a93e94e8551a063c7681561099
uv run python demo.py list-algorithms
Ces commandes de planification n’utilisent que la bibliothèque standard de Python. Commencez par la planification et le dimensionnement :
uv run python demo.py plan \
  --model-preset qwen3-8b \
  --goal fit-memory \
  --hardware ampere \
  --context 4096 \
  --concurrency 4

uv run python demo.py estimate \
  --model-preset qwen3-8b \
  --scheme w4a16 \
  --context 4096 \
  --concurrency 4
Pour cet objectif, plan choisit GPTQ W4A16 et affiche les deux budgets de la section 6 : une cible de serving de 10,44 GiB et un pic GPU de 2,35 GiB pour la tâche de quantification couche par couche. estimate détaille la cible de serving :
Architecture:     Qwen3 8B (built-in preset from official Hugging Face config)
Layers/hidden/KV: 36 / 4096 / 0.250
Note:             Causal text-generation checkpoint suitable for the text-only harness.
Scheme:           w4a16
Weights:          5.19 GiB
KV cache:         2.25 GiB
Runtime overhead: 2.00 GiB
Safety buffer:    1.00 GiB
Total target:     10.44 GiB
Weights et KV cache sont les deux premiers termes de l’équation de mémoire de serving de la section 6. Runtime overhead et Safety buffer sont la marge que le dépôt compagnon prévoit pour les activations et le surcoût du moteur. La ligne du KV cache applique la formule du cache aux 36 couches, 8 têtes KV et dimension de tête 128 de Qwen3-8B, avec 4 096 tokens et 4 requêtes simultanées.
Affichez ensuite la recette et prévisualisez la quantification avant de dépenser du temps GPU :
uv run python demo.py recipe --algorithm gptq-w4a16

uv run python demo.py quantize \
  --algorithm gptq-w4a16 \
  --model Qwen/Qwen3-8B \
  --dry-run
La commande recipe affiche le code llm-compressor qu’exécute l’étape de quantification :
from llmcompressor import oneshot
from llmcompressor.modifiers.quantization import GPTQModifier

recipe = GPTQModifier(
    scheme="W4A16",
    targets="Linear",
    ignore=["lm_head"],
)

oneshot(
    model="Qwen/Qwen3-8B",
    dataset="wikitext",
    dataset_config_name="wikitext-2-raw-v1",
    recipe=recipe,
    output_dir="outputs/Qwen3-8B-W4A16",
    max_seq_length=4096,
    num_calibration_samples=256,
)
targets et ignore décident quelles couches reçoivent des poids sur 4 bits ; num_calibration_samples et max_seq_length sont les choix de calibration de la section 8. WikiText est la valeur par défaut du smoke test ; passez --calibration-file avec des prompts proches de la production pour un vrai checkpoint.
La recette GPTQ écrit un checkpoint compressed-tensors. GPTQ est l’algorithme, pas le format du checkpoint : vLLM détecte donc le format à partir du checkpoint sans option --quantization, comme dans son exemple W4A16 officiel.
Pour quantifier, exécutez make install-compression. vLLM a besoin de son propre environnement, car ses dépendances entrent en conflit avec llm-compressor : exécutez make install-serving, puis utilisez .venv-vllm/bin/vllm pour les commandes serve et bench.
Servez et mesurez chaque checkpoint face à la référence RTN W8A16 du tableau des algorithmes. Exécutez quantize sans --dry-run pour gptq-w4a16 et rtn-w8a16 afin d’écrire outputs/Qwen3-8B-W4A16 et outputs/Qwen3-8B-W8A16. La commande benchmark-plan du dépôt compagnon écrit dans un fichier JSON une commande serve et une commande benchmark pour chaque checkpoint. Pour lancer la comparaison à la main, démarrez le serveur W4A16 dans un terminal :
.venv-vllm/bin/vllm serve outputs/Qwen3-8B-W4A16 --host 127.0.0.1 --port 8000Dans un second terminal, exécutez la même charge synthétique que dans la section 5 :
.venv-vllm/bin/vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model outputs/Qwen3-8B-W4A16 \
  --tokenizer Qwen/Qwen3-8B \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Arrêtez le serveur, puis relancez les deux commandes avec outputs/Qwen3-8B-W8A16, la référence RTN W8A16, à la place de outputs/Qwen3-8B-W4A16.
Enfin, comparez le modèle de base et le modèle compressé à des seuils explicites :
uv run python demo.py quality-eval \
  --base-model Qwen/Qwen3-8B \
  --compressed-model outputs/Qwen3-8B-W4A16 \
  --mode all \
  --lm-eval-task hellaswag \
  --lm-eval-limit 50 \
  --max-perplexity-delta-pct 5 \
  --output-json reports/qwen3-8b-w4a16-quality.json
Faites le travail dans l’ordre : planifier la cible, estimer la mémoire, tester la recette en dry run, mesurer le serving, puis comparer la qualité aux seuils. Cette séquence reprend la séparation de cet article entre dimensionnement de la mémoire, benchmark du runtime et évaluation de la qualité.
10. Les modèles de diffusion nécessitent une voie distincte
Les pipelines de diffusion et de diffusion-transformer ont un comportement d’activation différent de celui des LLM autorégressifs. SVDQuant traite la quantification des modèles de diffusion comme un problème distinct de valeurs aberrantes d’activation.
Les LLM autorégressifs génèrent un token à la fois. Les modèles de diffusion exécutent des étapes de débruitage répétées, et leurs distributions d’activation évoluent pendant ce processus, comme le rapporte Q-Diffusion pour les sorties du réseau de débruitage au fil des pas de temps. Une passe de quantification 4 bits standard pour LLM peut économiser de la mémoire sur un modèle de diffusion tout en introduisant de sévères artefacts visuels. Des méthodes centrées sur la diffusion, comme SVDQuant / Nunchaku et la quantification de diffusion de NVIDIA ModelOpt, traitent ce motif d’activation différent.
Dans un pipeline de diffusion latente, le text encoder représente le prompt. Un réseau de débruitage, tel qu’un diffusion transformer (DiT) ou un U-Net, met à jour de façon répétée une représentation compressée de l’image appelée latent. L’autoencodeur variationnel (VAE) convertit entre ces représentations latentes et les images. Ces composants ont des rôles différents : testez donc leur précision séparément.
Utilisez ce qui suit comme des heuristiques prudentes, pas comme des valeurs par défaut universelles. Le pipeline, le composant, le modèle et le runtime demandent chacun des tests séparés :
- Gardez le VAE en 16 bits pour la première comparaison. Ne testez une précision plus faible que si la méthode et le pipeline cible la valident.
- Essayez d’abord le backbone DiT ou U-Net, car il détient souvent la plus grande part des paramètres. Vérifiez la mémoire, la latence et la qualité d’image pour le pipeline cible. Les méthodes de quantification pour la diffusion adoptent la même approche par composant.
- Traitez les text encoders séparément. Quantifier T5-XXL ou CLIP peut affecter l’adéquation au prompt ou le rendu du texte dans un pipeline donné : évaluez-les donc indépendamment plutôt que de supposer le comportement d’un transformer générique.
- Utilisez des méthodes adaptées à la diffusion, comme SVDQuant, quand les valeurs aberrantes d’activation sont le problème principal.
- Évaluez avec des images, pas avec des métriques textuelles. Vérifiez le respect du prompt, le rendu du texte, les teintes de peau, l’équilibre des couleurs, les détails fins, la latence et la VRAM. Pour comparer avec le pipeline 16 bits, mesurez la LPIPS ou le PSNR entre des images appariées (même graine), et le score CLIP ou ImageReward pour l’adéquation au prompt, comme le fait l’évaluation de SVDQuant. Passez ensuite en revue les cas difficiles à l’œil.
Si le jeu d’évaluation ne contient que des prompts simples ou courants, vous manquerez les défaillances sur les cas limites. Incluez des cas difficiles : petit texte, mains, objets répétés, mises en page structurées et prompts avec contraintes négatives, car les défaillances de la quantification en diffusion se voient dans l’image, pas dans la perplexité d’un modèle de langage.
11. Valeurs par défaut en production
La figure place le premier essai pour chaque type de déploiement sur un axe de largeur de bits, avec le test suivant et sa condition. Chacun demande encore les vérifications de la section 8.
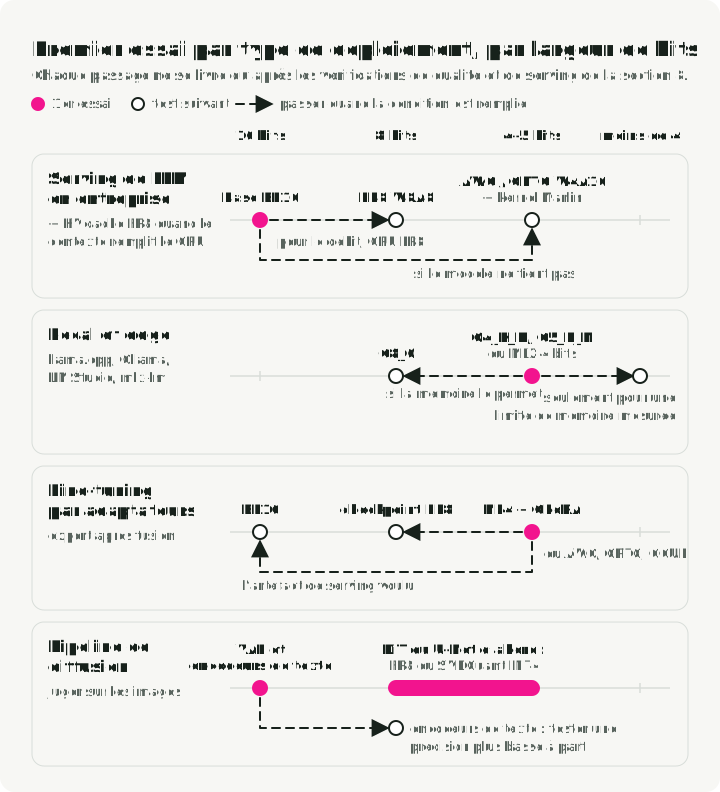
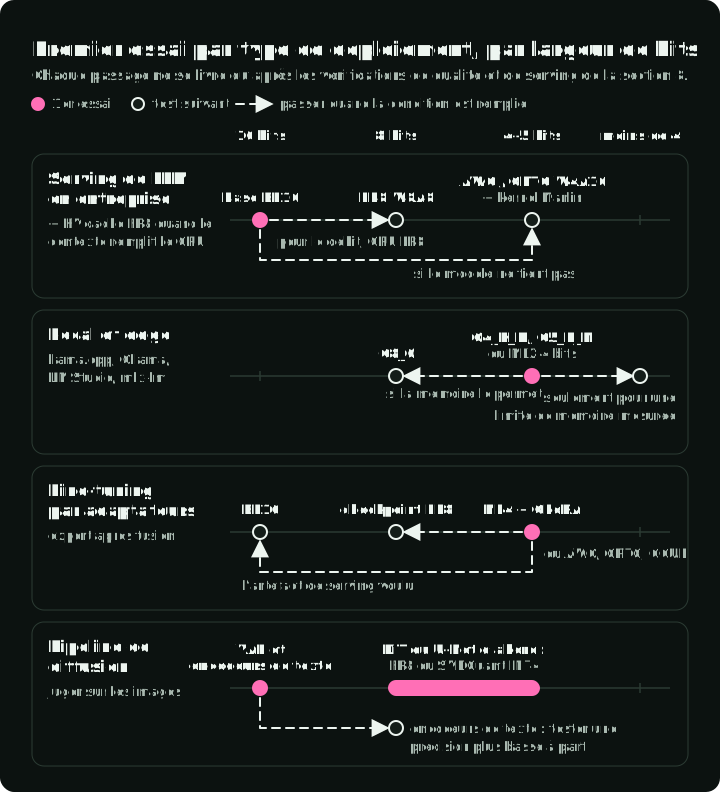
Pour le serving de LLM en entreprise, partez d’une référence BF16 dans le moteur de serving exact que vous prévoyez d’utiliser. Si l’objectif est le débit et que le GPU le permet, testez le FP8 W8A8. Si le modèle ne tient pas, testez AWQ ou GPTQ W4A16 avec des kernels de classe Marlin. Si un contexte long ou la concurrence remplit le GPU, testez un KV cache FP8. Ne déployez la version compressée que si les vérifications de qualité et de serving passent toutes deux.
Pour l’inférence locale et edge, partez d’un fichier GGUF en Q4_K_M ou Q5_K_M, ou d’un modèle MLX 4 bits sur un Mac. Passez à Q8_0 quand la mémoire le permet et comparez la qualité sur la tâche. N’utilisez des encodages sous 4 bits que pour une limite de mémoire mesurée.
Pour le fine-tuning, utilisez NF4 avec QLoRA pour entraîner des adapters avec moins de mémoire. Évaluez l’adapter dans l’application avant de le fusionner. Après la fusion, exportez et évaluez l’artefact de serving dont vous avez besoin : un fichier GGUF compatible llama.cpp, un checkpoint AWQ/GPTQ/compressed-tensors, un checkpoint FP8 ou du BF16.
Pour la diffusion, quantifiez d’abord le débruiteur, gardez le VAE en 16 bits et testez les text encoders séparément, comme à la section 10. Comparez des images appariées issues de la même graine et passez en revue les prompts difficiles à l’œil.
12. Lancer la comparaison suivante
Gardez la référence BF16 et comparez un candidat compressé pris en charge sur les mêmes tâches d’évaluation réservées et le même trafic. Notez la perte de qualité et la latence que vous pouvez accepter avant de lancer l’essai. Mesurez le pic de mémoire autant que la vitesse : le résultat utile est de savoir si le candidat supprime votre goulot d’étranglement dans ces limites.
Références
- JarvisLabs vLLM Benchmarks : JarvisLabs, vLLM Quantization Complete Guide and Benchmarks, 2026. JarvisLabs.
- Hugging Face Optimum Quantization Guide : Hugging Face, Quantization conceptual guide. Documentation.
- vLLM Quantization Docs : projet vLLM, Quantization. Documentation.
- vLLM Quantized KV Cache Docs : projet vLLM, Quantized KV Cache. Documentation.
- vLLM Benchmark Docs : projet vLLM, vllm bench serve. Documentation.
- LLM Compressor Docs : projet vLLM, LLM Compressor. Documentation.
- GPTQModel : ModelCloud, GPTQModel. GitHub.
- TensorRT-LLM Quantization : NVIDIA, TensorRT-LLM Quantization. Documentation.
- NVIDIA NVFP4 : NVIDIA, Introducing NVFP4 for Efficient and Accurate Low-Precision Inference. Blog.
- Hugging Face QuantizedCache : Hugging Face, Cache strategies: Quantized cache. Documentation.
- NVIDIA Model Optimizer : NVIDIA, Model Optimizer. GitHub.
- torchao Quantization : PyTorch, torchao quantization overview. Documentation.
- bitsandbytes Quantization : Hugging Face, bitsandbytes. Documentation.
- HQQ : Dropbox, Half-Quadratic Quantization. GitHub.
- PEFT : Hugging Face, Parameter-Efficient Fine-Tuning. Documentation.
- Ollama : runtime local de modèles Ollama. Site web.
- LM Studio : runtime local d’IA LM Studio. Site web.
- Statut d’AutoGPTQ : dépôt AutoGPTQ, archivé en avril 2025. GitHub.
- Statut d’AutoAWQ : dépôt AutoAWQ, archivé et déprécié en mai 2025. GitHub.
- GPTQ : Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, ICLR 2023. arXiv:2210.17323.
- Marlin : Frantar et al., MARLIN: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models, arXiv:2408.11743. arXiv:2408.11743.
- AWQ : Lin et al., AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, MLSys 2024. arXiv:2306.00978.
- SmoothQuant : Xiao et al., SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, ICML 2023. arXiv:2211.10438.
- QuaRot : Ashkboos et al., QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs, NeurIPS 2024. arXiv:2404.00456.
- SpinQuant : Meta AI Research, SpinQuant: LLM Quantization with Learned Rotations, arXiv:2405.16406. arXiv:2405.16406.
- QLoRA / NF4 : Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, NeurIPS 2023. arXiv:2305.14314.
- SVDQuant / Nunchaku : MIT HAN Lab, SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models, ICLR 2025. arXiv:2411.05007, Nunchaku.
- vLLM PagedAttention : Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023. arXiv:2309.06180.
- Grouped-Query Attention : Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, EMNLP 2023. arXiv:2305.13245.
- vLLM FP8 KV Cache : Kubler, Kurtic, Wilkinson et al., The State of FP8 KV-Cache and Attention Quantization in vLLM, blog vLLM, avril 2026. vLLM Blog.
- KIVI : Liu et al., KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache, ICML 2024. arXiv:2402.02750.
- KVQuant : Hooper et al., KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization, NeurIPS 2024. arXiv:2401.18079.
- LLM Serving Evaluation : Kurtic et al., “Give Me BF16 or Give Me Death”? Accuracy-Performance Trade-Offs in LLM Quantization, ACL 2025. arXiv:2411.02355.
- Long-context Quantization Evaluation : Mekala et al., Does quantization affect models’ performance on long-context tasks?, arXiv:2505.20276. arXiv:2505.20276.
- Reasoning Evaluation : Quantization Hurts Reasoning? An Empirical Study on Quantized Reasoning Models, arXiv:2504.04823. arXiv:2504.04823.
- 2:4 Sparsity : Mishra et al., Accelerating Sparse Deep Neural Networks, arXiv:2104.08378. arXiv:2104.08378.
- k-bit Scaling Laws : Dettmers and Zettlemoyer, The case for 4-bit precision: k-bit Inference Scaling Laws, ICML 2023. arXiv:2212.09720.
- Q-Diffusion : Li et al., Q-Diffusion: Quantizing Diffusion Models, ICCV 2023. arXiv:2302.04304.
- MLX LM : Apple ml-explore, mlx-lm. GitHub.
- HumanEval : OpenAI, HumanEval. GitHub.
- MMLU : Hendrycks et al., Measuring Massive Multitask Language Understanding. arXiv:2009.03300.
- MATH-500 : Hugging Face H4, MATH-500. Dataset.
- GGUF et llama.cpp : ggml-org, GGUF file format et llama.cpp. GGUF, llama.cpp.
- Documentation GGUF de Hugging Face : Hugging Face, GGUF. Documentation.
- Dépôt de référence : slavadubrov/model-compression-demo.