Guía de cuantización de modelos: de los fundamentos al serving en producción

Traducción automática
Este artículo se tradujo automáticamente a partir de la versión original en inglés.
Esta guía de cuantización es para ingenieros que despliegan modelos de lenguaje y necesitan reducir el uso de memoria o mejorar la velocidad de serving. Aprenderás a elegir qué comprimir, a ajustar un formato numérico a tu hardware y a tu runtime, y a comparar memoria, latencia y calidad de salida antes del despliegue. También cubre las comprobaciones aparte que necesitan los modelos de difusión de imágenes.
La cuantización reduce los bits que se usan para los pesos, las activaciones o la KV cache. Los pesos son los parámetros del modelo aprendidos durante el entrenamiento. Las activaciones son valores intermedios que se calculan a partir de cada entrada. La KV cache (caché de clave-valor) guarda los valores de los tokens anteriores para reutilizarlos durante la generación. Comprimir los pesos puede hacer que un modelo quepa en la memoria de la GPU y dejar muy poco espacio para una conversación larga. Lo que comprimes y el código de GPU que lo ejecuta determinan qué límite alivias.
Empieza por saber qué hace que la petición sea lenta o demasiado grande. Procesar el prompt de entrada se llama prefill; generar la respuesta token a token se llama decode. El prefill puede estar limitado por la aritmética de la GPU, mientras que el decode puede estar limitado por la rapidez con que se cargan los pesos desde la memoria. Los pesos del modelo y la KV cache, que no deja de crecer, también pueden agotar la memoria de la GPU. La primera tabla asigna posibles soluciones a estos problemas; las secciones siguientes explican la aritmética y las comprobaciones necesarias antes del despliegue.
Un menor número de bits es solo un candidato. La decisión necesita tanto resultados de calidad en la tarea como mediciones de serving del modelo, el runtime y el tráfico que vayas a usar. Los benchmarks de esta guía son resultados publicados por otros equipos, más una ejecución corta del repositorio complementario.
Para una comparación breve de artefactos y métodos, consulta LLM Quantization Formats.
1. Cuellos de botella y formatos de partida
Antes de elegir un número de bits, pregunta qué limita la carga de trabajo. La respuesta puede ser la memoria de los pesos del modelo, el cómputo del prefill, el ancho de banda del decode o la KV cache, y no la precisión numérica en sí.
Notación usada en las recetas de serving
- W4A16 guarda los pesos en 4 bits y mantiene las activaciones en 16 bits. En general, W{x}A{y} indica la precisión que se usa para los pesos y las activaciones en las operaciones admitidas, normalmente la multiplicación de matrices. W8A8 usa pesos y activaciones de 8 bits en esas operaciones, pero no define automáticamente el tipo de dato almacenado de cada tensor del runtime.
- FP8, INT8, INT4, NF4 son formatos numéricos. Deciden qué valores se pueden representar.
- GPTQ, AWQ, SmoothQuant, QuaRot son algoritmos. Deciden cómo convertir un modelo entrenado a un formato de menor precisión.
- GGUF es un formato de archivo que guarda tensores y metadatos para GGML y los runtimes al estilo de
llama.cpp. Un archivo GGUF puede contener tipos de tensor sin cuantizar, comoF16,BF16oF32, además de codificaciones cuantizadas. Entre los presets estánQ4_K_M,Q5_K_M,Q8_0,IQ*,TQ*yMXFP4. La codificación del tensor determina la elección de cuantización.GGUFpor sí solo no describe una receta de serving FP8 W8A8 al estilo de CUDA. - KV cache es la caché de atención que se usa durante la generación. Guarda las claves y los valores anteriores para que el modelo no recalcule toda la conversación en cada token.
- Cuantización de la KV cache guarda los tensores de activación de clave y valor de la caché en un formato de menor precisión, como FP8, INT8, INT4 o INT2, según lo que admita el runtime. No es lo mismo que el prefix caching, PagedAttention o el offload, que deciden si se reutilizan las entradas de la caché, cómo se asignan o dónde residen.
- GEMM significa multiplicación general de matrices (general matrix multiply). Casi todo el tiempo de inferencia de un transformer se va en multiplicar matrices.
Qué se cuantiza
Una receta elige qué tensores comprimir. Estas son las opciones habituales:
| Tensor | ¿Se cuantiza normalmente? | Por qué |
|---|---|---|
| Pesos de las capas lineales | Sí, en las recetas W4A16 y W8A8 | Los pesos son fijos tras el entrenamiento, así que sus escalas se pueden calcular offline. |
| Activaciones | Solo en las recetas W8A8, W4A8 o W4A4 | Cambian con cada entrada, así que necesitan escalas calibradas o calculadas en runtime. |
| KV cache | Opcional, un ajuste del runtime aparte | Crece con el contexto y el lote; la sección 6 la trata. |
Embeddings y lm_head | Normalmente se dejan en 16 bits | Las recetas de LLM Compressor incluyen lm_head en ignore; la sección 8 recoge esta exclusión. |
| VAE de difusión y text encoders | Se dejan en 16 bits en la primera prueba | La sección 10 los prueba por separado del eliminador de ruido. |
Cuellos de botella y por dónde empezar
La tabla asigna a cada cuello de botella común un formato de partida. Usa la notación anterior.
| Si el problema es | Empieza por | Herramientas habituales | Comprobar antes del despliegue |
|---|---|---|---|
| Los pesos del modelo no caben en la VRAM | Cuantización W4A16 solo de pesos | AWQ o GPTQ con llm-compressor o GPTQModel | Perplejidad, código, razonamiento, seguimiento de instrucciones |
| El serving de alto throughput está limitado por el cómputo | W8A8 en FP8 o INT8 | PTQ en FP8, SmoothQuant, TensorRT-LLM, vLLM | Throughput, tiempo hasta el primer token (TTFT), precisión en la tarea |
| El contexto largo o la alta concurrencia llenan la GPU | Cuantización de la KV cache | vLLM, TensorRT-LLM o Transformers QuantizedCache | Recuperación en contexto largo, latencia, seguridad y calidad |
| Inferencia local en CPU, Apple Silicon o escritorio | Archivos GGUF con codificaciones de tensor locales | llama.cpp, Ollama, LM Studio, MLX | Latencia del prompt, uso de RAM, codificación de tensor elegida y calidad subjetiva de la salida |
| El fine-tuning con adaptadores debe caber en una GPU | NF4 / QLoRA | bitsandbytes, peft | Pérdida del fine-tuning y calidad del modelo fusionado |
| El pipeline de generación de imágenes es demasiado grande o lento | INT4 o FP8 específicos para difusión | SVDQuant, Nunchaku, torchao, NVIDIA ModelOpt | Artefactos visuales, ajuste al prompt, latencia, VRAM |
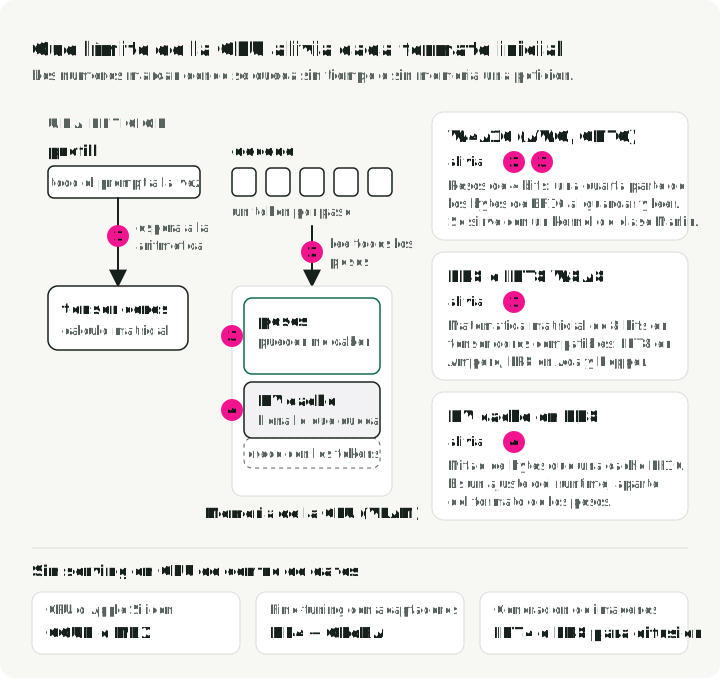
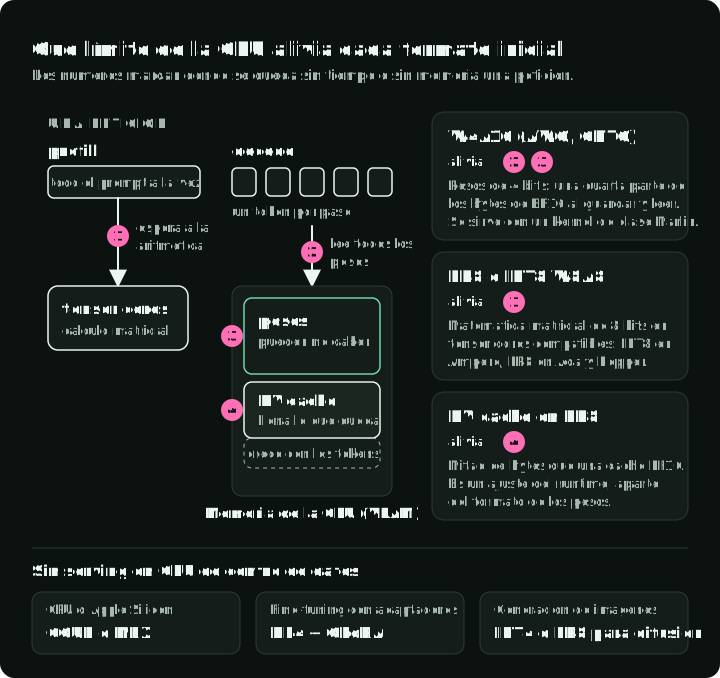
La figura marca dónde se queda sin tiempo o sin memoria una petición en una GPU de serving y qué formato inicial alivia cada límite. La fila inferior cubre los casos que no son serving en GPU de centro de datos.
2. La cuantización es un redondeo controlado
La cuantización asigna valores de alta precisión a un conjunto menor de valores representables, que es la definición básica que usan tanto Hugging Face Optimum como TensorRT-LLM. Ahorras memoria y ancho de banda. También introduces error de redondeo.
INT4 ofrece solo 16 valores discretos, así que convertir pesos BF16 de 16 bits a esa cuadrícula crea error de redondeo. Los métodos de cuantización juzgan el redondeo por cuánto cambia la salida de una capa, no solo cada peso individual. GPTQ estima cómo afectan las decisiones de redondeo a esa salida y ajusta los pesos restantes para reducir el error. AWQ usa las activaciones observadas para identificar grupos importantes de pesos, llamados canales, y los reescala antes de redondear. Una buena asignación ahorra memoria con poca pérdida de calidad. Una mala daña el razonamiento, el seguimiento de instrucciones o la fidelidad visual.
Mapeo simétrico y asimétrico
Siguiendo el mapeo afín de las guías de cuantización habituales, la cuantización asigna un valor flotante continuo a una cuadrícula discreta.
- y son los límites inferior y superior en coma flotante que se eligen.
- es el valor original de alta precisión.
- es el valor cuantizado.
- es la escala, o tamaño de paso.
- es el punto cero, la posición entera que representa
0.0. - es el rango entero de destino. Este ejemplo simétrico usa , que tiene 15 valores y representa el cero con exactitud. Otros formatos INT4 con signo usan los 16 valores, por ejemplo .
La cuantización simétrica centra la cuadrícula en cero y fija :
Esto favorece al hardware porque las operaciones del runtime no tienen que restar un desplazamiento de punto cero. La pila de cuantización de PyTorch expone estas opciones afines de escala y punto cero como parámetros primitivos de cuantización en torchao.
La cuantización asimétrica desplaza la cuadrícula para cubrir rangos sesgados:
Esa cuadrícula desplazada puede conservar mejor las activaciones solo positivas, pero el desplazamiento añade trabajo salvo que el kernel lo gestione bien.
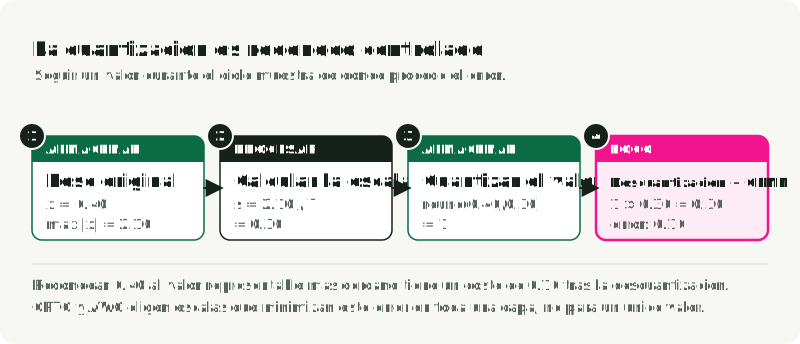
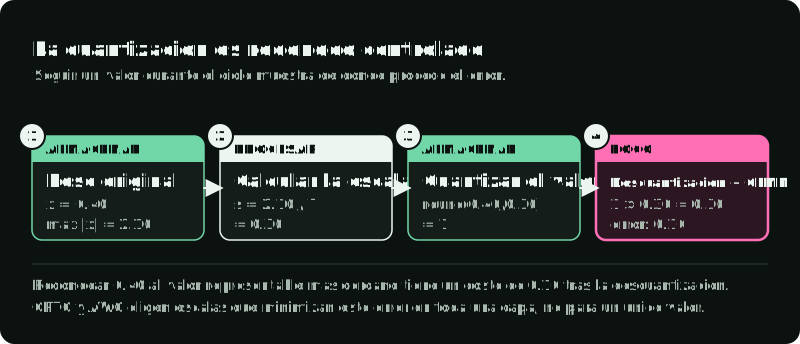
La figura resuelve el caso simétrico: una magnitud máxima de 2,10 da una escala de 0,30, así que el peso 0,40 se redondea al entero 1. La descuantización multiplica ese entero almacenado por la escala para recuperar un valor aproximado, 0,30. La diferencia con 0,40 es el error de redondeo.
Granularidad de la escala: tensor, canal, grupo
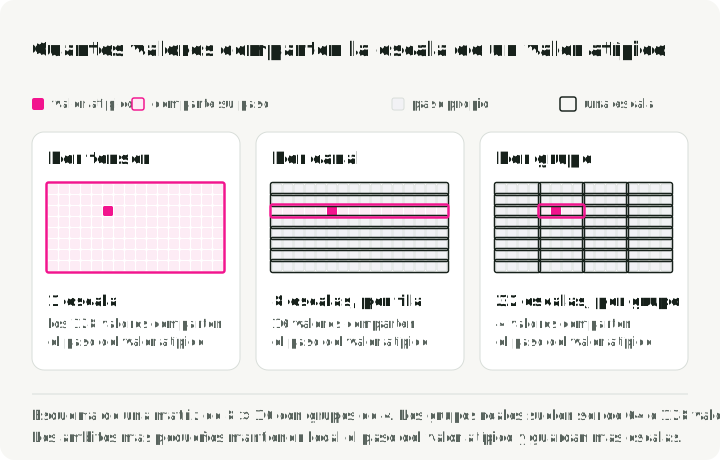
El factor de escala puede cubrir un tensor de pesos entero, un canal o un grupo pequeño de valores. Los documentos de la KV cache FP8 de vLLM usan la misma distinción entre estrategias de escala por tensor y por cabeza de atención. Los grupos más pequeños suelen conservar mejor la calidad, pero requieren más metadatos de escala.
| Granularidad de la escala | Qué comparte una escala | Efecto en la calidad y en la ejecución |
|---|---|---|
| Por tensor | Toda la matriz de pesos | Guarda pocos metadatos, pero un valor atípico puede estirar la cuadrícula y reducir la precisión en toda la capa. |
| Por canal | Una fila de salida | Evita que los canales con rangos estrechos compartan el rango más amplio de otro canal. Muchas rutas de pesos de 8 bits usan esta granularidad. |
| Por grupo | Un bloque dentro de una fila, a menudo de 64 o 128 valores | Limita un valor atípico a un bloque pequeño a costa de más escalas. AutoGPTQ usa group_size=128 en sus ejemplos de GPTQ. |
La figura coloca un valor atípico en una matriz de ejemplo pequeña y cuenta cuántos valores comparten su escala con cada opción.
Los pesos son estáticos, así que sus escalas se pueden calcular offline antes de cargar el modelo. Las activaciones cambian con cada token, lo que hace que sus rangos dependan de la carga de trabajo.
| Escalado de activaciones | Cuándo elige la escala el runtime | Ventaja | Modo de fallo o coste |
|---|---|---|---|
| Estático | Offline, a partir de un dataset de calibración | Evita calcular la escala durante la inferencia. | Los prompts fuera de la longitud o la distribución calibradas pueden recortar picos de activación y dañar la salida. |
| Dinámico | En cada pasada hacia delante | Se adapta a los valores de activación actuales y a la mezcla de prompts. | Calcular rangos en cada capa añade trabajo y necesita kernels optimizados. |
La KV cache está entre ambos casos: las claves y los valores son activaciones calculadas en runtime y luego guardadas para los tokens posteriores, así que necesitan sus propias escalas. La sección 6 explica cómo las guardan los runtimes.
PTQ y QAT ocurren en etapas distintas
La cuantización posterior al entrenamiento, o PTQ, comprime un modelo ya entrenado. La cuantización consciente del entrenamiento, o QAT, expone el modelo al ruido de cuantización durante el entrenamiento para que se adapte.
| Método | Cuándo se aprenden los rangos | Úsalo cuando | Coste que pagas |
|---|---|---|---|
| PTQ solo de pesos | Offline, para pesos estáticos | El modelo no cabe o el decode está limitado por el ancho de banda | Las activaciones siguen ejecutándose en 16 bits |
| PTQ estático | Offline, a partir de prompts de calibración | Quieres serving W8A8 rápido | Los datos de calibración deben parecerse a producción |
| PTQ dinámico | En runtime, por lote o ruta de activación | Las distribuciones de entrada varían mucho | Trabajo extra en runtime y menos hardware compatible |
| QAT | Durante el entrenamiento | El PTQ rompe la calidad en un modelo sensible | Infraestructura completa de entrenamiento y mucho más cómputo |
Los datos de calibración tienen que parecerse al tráfico que vas a servir. Por ejemplo, la ruta de calibración de la KV cache de vLLM usa un dataset seleccionado mediante llm-compressor. Si los prompts de producción son trazas largas de RAG, los párrafos cortos de Wikipedia pueden no recoger los rangos de activación que producen esas trazas. En las escalas estáticas de activaciones o de la caché, la calibración elige los rangos. En GPTQ y AWQ, las activaciones de calibración también deciden cómo se redondea o reescala cada peso, así que una calibración con textos cortos puede moldear los pesos almacenados. Los prompts reales de contexto largo pueden producir patrones de activación distintos. Las evaluaciones de cuantización en contexto largo miden este riesgo directamente.
3. Los formatos numéricos dictan los requisitos de hardware
El formato numérico define qué valores puede representar el modelo en memoria. Para calcular con eficiencia hacen falta kernels de runtime y hardware compatibles con el mismo ancho de bits y el mismo formato. TensorRT-LLM documenta tanto la lista de recetas como la matriz de compatibilidad de hardware.
| Formato | Almacenamiento por valor | Buena opción por defecto para | Punto principal de atención |
|---|---|---|---|
| BF16 / FP16 | 2 bytes | Inferencia base y serving compatible con el entrenamiento | Alto uso de VRAM y mucho tráfico de ancho de banda de memoria |
| FP8 | 1 byte | Serving W8A8 de alto throughput en Ada, Hopper y Blackwell | Necesita tensor cores FP8 nativos y compatibilidad del runtime |
| INT8 | 1 byte | Serving W8A8 en hardware más antiguo o que no es de NVIDIA | Valores atípicos en las activaciones y sensibilidad a la calibración estática |
| INT4 | 0,5 bytes | W4A16 cuando la memoria de los pesos es el límite principal | Pérdida de calidad en modelos pequeños o centrados en el razonamiento |
| FP4 / NVFP4 | ~0,5 bytes | Experimentos de la era Blackwell y primeras rutas de serving | Requisitos de compilador y runtime específicos del hardware |
| Codificaciones / presets GGUF de llama.cpp | Variable | Inferencia local en CPU, Apple Silicon, escritorio y edge | GGUF es el contenedor. La codificación del tensor es la elección de cuantización. |
| NF4 | 0,5 bytes | Entrenamiento de adaptadores con QLoRA | Normalmente es un mal formato de exportación para serving en producción |
BF16 y FP16 usan ambos 16 bits, pero reparten la precisión de forma distinta y por eso fallan de forma distinta. BF16 conserva el rango de exponente de 8 bits de FP32 y es más difícil que se desborde. FP16 tiene más bits de mantisa y un rango de exponente más estrecho, así que los picos de activación exigen más cuidado. La evaluación de Kurtic et al. usa explícitamente BF16 como referencia al comparar los formatos de serving FP8, INT8 e INT4.
FP8 tiene dos variantes comunes. E4M3 da más precisión y suele usarse para pesos y activaciones en la pasada hacia delante. E5M2 da más rango dinámico y resulta más útil para gradientes o rutas de activación volátiles. vLLM expone ambos tipos de datos de KV cache FP8, E4M3 y E5M2. En el estudio de Kurtic et al. en ACL 2025, «Give Me BF16 or Give Me Death», FP8 W8A8 resultó prácticamente sin pérdidas en la familia Llama-3.1 con más de 500 000 evaluaciones. El resultado abarca esa familia de modelos, esa suite de evaluación y esa configuración de serving. Cada despliegue necesita su propia comprobación de calidad antes de salir a producción.
Blackwell añade formatos de microescalado como MXFP8 y NVFP4. En lugar de una escala para todo un tensor o una fila, el microescalado usa bloques diminutos. La explicación de NVIDIA sobre NVFP4 describe valores de coma flotante de 4 bits en bloques de 16, con factores de escala FP8 y una escala de nivel superior en FP32. Este enfoque busca ofrecer una huella casi de INT4 con comportamiento de coma flotante. Sin embargo, requiere una arquitectura de hardware, un compilador y un runtime compatibles, y por eso TensorRT-LLM enumera la compatibilidad con FP4 y FP8 por generación de GPU.
4. Cuantización solo de pesos frente a cuantización de pesos y activaciones
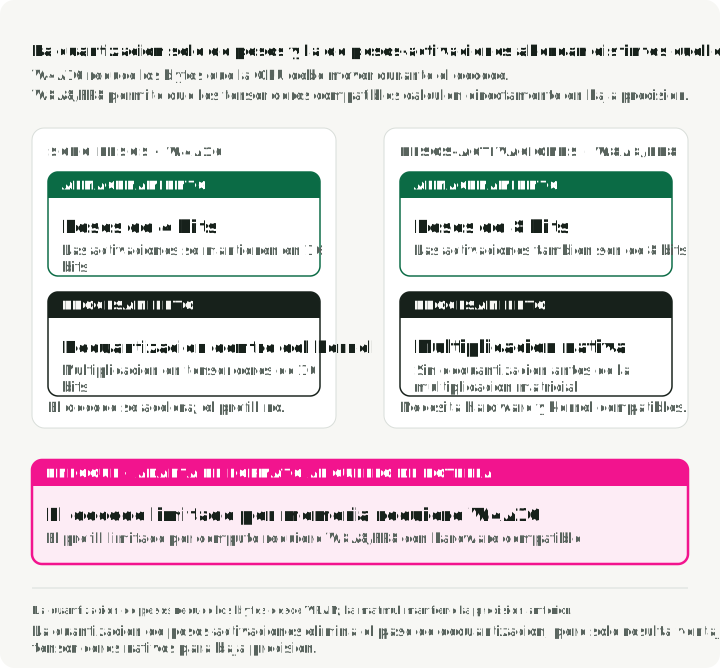
La notación WxAy describe la precisión de los pesos y de las activaciones, que exigen cosas distintas a la GPU durante la inferencia. La figura sigue los pesos desde la VRAM, a través del kernel, hasta los tensor cores para BF16, W4A16 y W8A8.
Durante el prefill, el modelo procesa el prompt de entrada. Esta fase suele estar limitada por el cómputo, porque la GPU hace multiplicaciones de matrices grandes, y por eso las recetas W8A8 en FP8/INT8 importan en el serving orientado al throughput.
Durante el decode, el modelo genera un token cada vez. Esta fase suele estar limitada por el ancho de banda de memoria, porque la GPU carga los pesos desde la VRAM una y otra vez para producir el siguiente token. Los artículos de cuantización solo de pesos, como GPTQ y AWQ, atacan esa presión reduciendo los bytes de los pesos.
W4A16 comprime los pesos y mantiene las activaciones en BF16 o FP16. La GPU carga menos bytes de pesos y luego los descuantiza a una forma de mayor precisión para la multiplicación. Esto ayuda con el decode y con los problemas de ajuste a la memoria. El prefill limitado por el cómputo puede notar poca mejora, porque las operaciones de matrices siguen ejecutándose en 16 bits.
W8A8 comprime los pesos y los tensores de activación que usan los kernels de matmul compatibles. Si el hardware tiene tensor cores nativos de baja precisión, el motor de serving puede ejecutar las operaciones de matrices directamente en FP8 o INT8. Por eso FP8 puede ayudar al serving de alto throughput: reduce el tráfico de memoria y usa aritmética más rápida. La KV cache tiene su propio ajuste de almacenamiento, así que comprueba por separado el dtype de la caché o la implementación de la caché del runtime.
En la ejecución incluida en el repositorio complementario (RTX 4090, vLLM 0.23.0, una repetición de 64 tokens generados), Qwen3-8B con la cuantización dinámica FP8 online de vLLM generó 122 tok/s frente a los 85 tok/s de BF16 y cargó 8,8 GiB de pesos en lugar de 15,3 GiB. Al añadir una KV cache FP8, bajó a 49 tok/s. La ejecución es demasiado corta para fijar la capacidad, pero muestra que cada ajuste necesita su propia medición.
5. Algoritmos frente a kernels de runtime
Los algoritmos de cuantización (como GPTQ o AWQ) definen cómo se asignan los pesos del modelo a una precisión menor. Los kernels de runtime (como Marlin o los kernels propios de vLLM) son el código de GPU de bajo nivel que ejecuta la multiplicación de matrices. Un modelo muy comprimido solo se ejecutará rápido si existe un kernel optimizado para su formato de cuantización concreto.
Una receta de serving nombra un elemento de cada capa: un algoritmo (GPTQ, AWQ), un formato de checkpoint (compressed-tensors, GGUF), un runtime (vLLM, llama.cpp) y un kernel (Marlin). El mismo checkpoint AWQ puede ejecutarse a velocidades muy distintas según el kernel.
El gráfico empareja cada checkpoint de 4 bits con y sin el kernel Marlin en un benchmark publicado. La tabla siguiente añade la perplejidad y el TTFT.
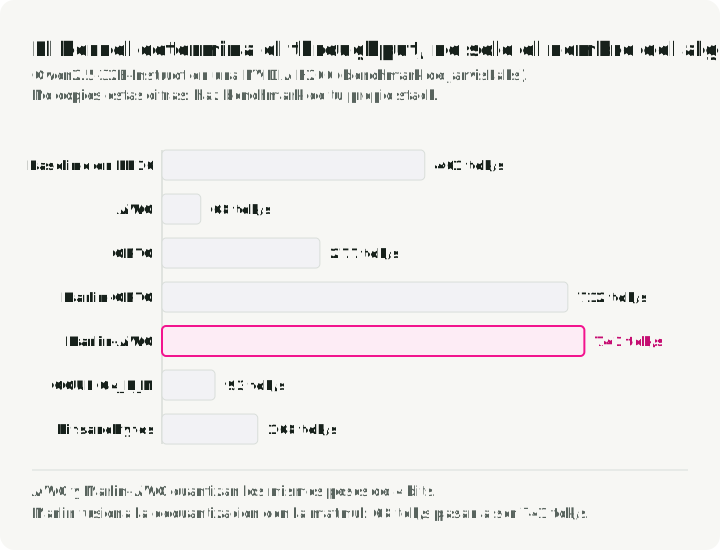
El benchmark de vLLM de JarvisLabs ejecutó Qwen2.5-32B-Instruct en una NVIDIA H200. La perplejidad mide lo bien que el modelo predice el texto de prueba; cuanto menor, mejor. HumanEval pass@1 mide el éxito en tareas de código con una sola solución generada. Los tokens de salida por segundo miden el throughput de generación, y el TTFT medio mide la espera media hasta el primer token de salida:
| Cuantización / kernel | Perplejidad en Wikitext-2 ↓ | HumanEval pass@1 ↑ | Tokens de salida/s | TTFT medio |
|---|---|---|---|---|
| FP16 de referencia | 6,56 | 56,1 % | 461 tok/s | 57,7 ms |
| AWQ | 6,84 | 51,8 % | 68 tok/s | 277,8 ms |
| GPTQ | 6,90 | 46,3 % | 277 tok/s | 107,1 ms |
| Marlin-GPTQ | 6,97 | 45,7 % | 712 tok/s | 51,9 ms |
| Marlin-AWQ | 6,84 | 51,8 % | 741 tok/s | 73,5 ms |
| GGUF Q4_K_M | 6,74 | 51,8 % | 93 tok/s | 958,0 ms |
| bitsandbytes | 6,67 | 51,8 % | 168 tok/s | 135,3 ms |
La prueba de velocidad del proveedor usa 200 prompts de ShareGPT, concurrencia máxima de 10 y semilla 42. La calidad procede de ejecuciones separadas de Wikitext-2 y HumanEval. El informe no fija la versión de vLLM ni las revisiones de los modelos, así que son resultados comunicados por el proveedor y no una comparación reproducida de forma independiente. Muestran algo más acotado: el nombre del algoritmo que lleva el checkpoint no dice a qué velocidad hará serving.
Por ejemplo, AWQ y Marlin-AWQ usan los mismos pesos de 4 bits. La implementación de Marlin es mucho más rápida porque su kernel CUDA fusiona la descuantización y la multiplicación de matrices en una sola operación de GPU muy optimizada.
Para tu propia comparación, primero crea u obtén un checkpoint AWQ compatible con vLLM en la ruta indicada abajo; estos comandos no cuantizan el modelo. Instala una build de vLLM compatible con tu GPU y arranca el servidor en una terminal:
vllm serve ./outputs/Qwen2.5-32B-Instruct-AWQ-W4A16 \
  --served-model-name qwen2.5-32b-awq \
  --host 127.0.0.1 \
  --port 8000
Deja ese servidor en marcha. En una segunda terminal, usa vllm bench serve con el tokenizador real, separado del alias del modelo de la API:
vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model qwen2.5-32b-awq \
  --tokenizer Qwen/Qwen2.5-32B-Instruct \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Es una prueba de carga sintética con 1024 tokens de entrada y 256 de salida por petición como objetivo; no reproduce la tabla de ShareGPT ni es una prueba de calidad. Repítela para la referencia y para cada checkpoint preparado con el mismo tokenizador, las mismas longitudes, la misma semilla y la misma concurrencia. Registra el número real de tokens y la versión de vLLM instalada. Estos comandos de ejemplo requieren el checkpoint preparado y la GPU de destino.
Mide el throughput, el TTFT, la latencia entre tokens (el retardo entre tokens consecutivos), el uso de memoria y la calidad en la tarea. Cuando algunas de estas métricas se muevan en direcciones opuestas, ese compromiso es lo que necesitas ver antes de desplegar.
Comparación de algoritmos de cuantización
Estos métodos resuelven problemas de compresión distintos:
| Algoritmo | Formato habitual | Qué intenta conservar | Coste principal |
|---|---|---|---|
| GPTQ | W4A16 | La salida de la capa, usando estimaciones con el Hessiano de cómo afecta el cambio de pesos al error de salida | Calibración lenta y procesamiento más complejo |
| AWQ | W4A16 / W4A8 | Los canales de activación importantes | Necesita calibración y kernels de serving fusionados |
| SmoothQuant | W8A8 | El comportamiento de las activaciones INT8, moviendo la escala de los valores atípicos a los pesos | Ajuste de escalas por modelo |
| QuaRot / SpinQuant | W4A4 / W4A8 | Menor presión de valores atípicos en las activaciones mediante rotaciones | Complejidad de rotación en runtime |
| HQQ | W4A16 / W2A16 | Compresión rápida solo de pesos sin calibración | La calidad necesita comprobaciones posteriores con muy pocos bits |
| QLoRA (NF4) | NF4 | Memoria para entrenar adaptadores | No es una buena opción por defecto para serving |
| K-quants / IQ-quants GGUF de llama.cpp | Codificaciones de tensor mixtas de pocos bits | Calidad de la inferencia local por byte | No está pensado para serving por lotes en la nube |
| RTN (redondeo al más cercano) | W8A16 / FP8 | Nada más allá de la escala; no usa datos de calibración | Gran pérdida de calidad con 4 bits; úsalo como referencia |
| FP8 dinámico | W8A8 FP8 | El rango de activación por token en runtime; no usa datos de calibración | Necesita tensor cores FP8; las GPU antiguas pueden no acelerar |
AutoGPTQ se archivó en abril de 2025, y AutoAWQ se archivó y se declaró oficialmente obsoleto en mayo de 2025. Para checkpoints compressed-tensors nuevos que consuma vLLM, empieza por llm-compressor. Usa GPTQModel cuando necesites la ruta GPTQ activa con Marlin, Machete, opciones de memoria para MoE u offload a disco.
La poda y la destilación también reducen el coste de serving mediante flujos de trabajo distintos. La esparsidad estructurada 2:4 elimina pesos siguiendo un patrón que pueden aprovechar los sparse tensor cores de NVIDIA. La destilación entrena un modelo alumno más pequeño para que copie a uno mayor, lo que puede funcionar bien en tareas acotadas. Incluye cualquiera de las dos rutas en la lista corta solo si el proyecto puede asumir el trabajo extra de poda o de entrenamiento.
6. La memoria de serving es más que los pesos
El checkpoint comprimido es solo una parte de la huella de memoria de serving. Dimensiona el runtime completo antes de decidir si basta con cuantizar los pesos. PagedAttention identifica la KV cache como un término importante de la memoria de serving.
La cuantización offline puede acotarse por capa. Herramientas como llm-compressor pueden cargar un bloque del transformer, ejecutar la calibración y los cálculos de cuantización, escribir el bloque comprimido y pasar al siguiente. Así, el pico de memoria de GPU se queda más cerca de la capa activa más grande más los búferes de calibración. Sigues necesitando RAM de CPU y disco para el checkpoint de origen, pero la GPU no siempre contiene el modelo BF16 completo.
El pico de memoria de GPU durante la cuantización offline puede parecerse más a esto:
La figura dibuja ambos presupuestos a la misma escala con la estimación de la sección 9 para Qwen3-8B en W4A16 del repositorio complementario. El panel izquierdo es el trabajo offline; el derecho es lo que debe permanecer en la GPU durante el serving.
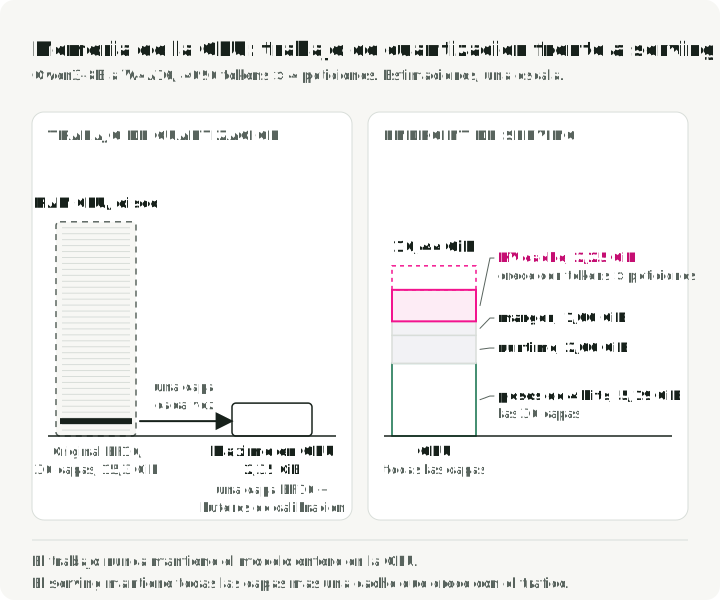
Para un serving que resida por completo en la GPU, todos los pesos comprimidos deben caber en las GPU de serving junto con la KV cache y los búferes del runtime. El offload de pesos reduce lo que reside en la GPU a costa de transferencias. La KV cache crece con la longitud del contexto y el tamaño del lote activo. Para capas de atención uniformes y peticiones de igual longitud, su carga de tensores es aproximadamente:
Esta estimación excluye la sobrecarga del asignador, los metadatos de escalas de la caché y los prefijos compartidos. Para peticiones de distinta longitud, sustituye por la suma de sus longitudes en caché.
Donde:
- es el número de capas.
- es el número de cabezas de atención de clave-valor. La atención de consulta agrupada lo reduce haciendo que muchas cabezas de consulta compartan menos cabezas KV.
- es la dimensión de cada cabeza, a menudo 128 o 256.
- son los tokens del prompt más los tokens generados.
- es el lote de serving activo.
- es 2 para BF16 o FP16 y 1 para FP8 o INT8. El modo de KV cache FP8 de vLLM es el ejemplo de pila de serving que usa este artículo.
La cuantización de la KV cache cambia el almacenamiento; la reutilización cambia la asignación
La KV cache se puede cuantizar durante la inferencia. Cada paso de decode produce tensores de activación K y V para el nuevo token. Un modelo W8A8 puede usar ya FP8 o INT8 en las proyecciones compatibles, pero la caché sigue siendo un objeto de almacenamiento aparte.
Muchas pilas de serving guardan ese objeto en el dtype del modelo o de la caché. Para cambiarlo, activa un dtype de KV cache, usa un checkpoint con escalas de caché o elige una implementación de caché cuantizada.
Cuando la cuantización de la KV cache está activada, el motor escribe las entradas como una representación de menor precisión más escalas. Después, la atención descuantiza la caché dentro de su kernel o, en algunos backends, ejecuta parte de la operación de atención en el dominio cuantizado.
Los documentos de la KV cache cuantizada de vLLM (versión estable) lo exponen directamente con kv_cache_dtype="fp8" o --kv-cache-dtype fp8. vLLM admite los formatos de caché FP8 E4M3 y E5M2, además de estrategias de escala por tensor y por cabeza de atención. Puede usar escalas por defecto o calibración con un dataset mediante llm-compressor. Con FlashAttention 3, vLLM también puede ejecutar operaciones de atención en el dominio FP8 cuantizando las consultas además de las claves y los valores. Para activar la caché FP8 en un modelo:
vllm serve Qwen/Qwen3-8B --kv-cache-dtype fp8 --max-model-len 32768TensorRT-LLM expone la KV cache FP8 mediante KvCacheConfig(dtype='fp8') y enumera la KV cache FP8 y la KV cache NVFP4 como recetas de cuantización distintas de la cuantización de pesos y activaciones. Hugging Face Transformers también tiene una ruta QuantizedCache mediante cache_implementation="quantized", en la que hqq admite formatos de caché int2, int4 e int8 y quanto admite int2 e int4.
El KV caching ordinario guarda las claves y los valores anteriores para no recalcularlos. El prefix caching reutiliza bloques de caché entre peticiones con el mismo prefijo. PagedAttention reduce la fragmentación y mejora la asignación, mientras que el offload de la KV cache mueve bloques entre niveles de memoria. Estas combinaciones dependen del runtime. La QuantizedCache de Hugging Face no admite offload. vLLM documenta su KV cache cuantizada por separado del prefix caching y de otras funciones de gestión de la caché. Verifica cada combinación en el runtime que vayas a desplegar.
El riesgo para la calidad también es distinto del PTQ solo de pesos. La cuantización de la KV cache introduce error en el estado de atención que se lee en cada paso de decode posterior. Prueba por separado la recuperación en contexto largo, el comportamiento multivuelta, la seguridad y las negativas, el formato del tool use y la latencia de salida. KVQuant, KIVI y el estudio de la KV cache FP8 de vLLM evalúan la cuantización de la KV cache como un problema propio.
Un ejemplo resuelto muestra cuándo la caché pasa a ser mayor que los pesos. Toma Llama-3.1-70B (80 capas, 8 cabezas KV, dimensión de cabeza 128) sirviendo 8 peticiones de 32 768 tokens:
def kv_cache_gb(layers, kv_heads, head_dim, tokens, batch, bytes_per_value):
    return 2 * layers * kv_heads * head_dim * tokens * batch * bytes_per_value / 1e9

# Llama-3.1-70B: 80 layers, 8 KV heads, head dimension 128
for name, nbytes in [("BF16", 2), ("FP8", 1)]:
    print(name, round(kv_cache_gb(80, 8, 128, 32_768, 8, nbytes), 1), "GB")
Imprime BF16 85.9 GB y FP8 42.9 GB. Con esta carga, la caché BF16 (86 GB) es mayor que los pesos INT4: unos 40 GB una vez contadas las escalas de grupo y los embeddings de 16 bits, frente a los 35 GB que da la tabla de la sección 7 solo para los valores de 4 bits. La caché FP8 ahorra 43 GB; pasar los pesos de BF16 a INT4 ahorra unos 100 GB. Aquí la cuantización de pesos va primero, y la caché es el mayor término restante. El gráfico apila pesos y caché después de cada paso.
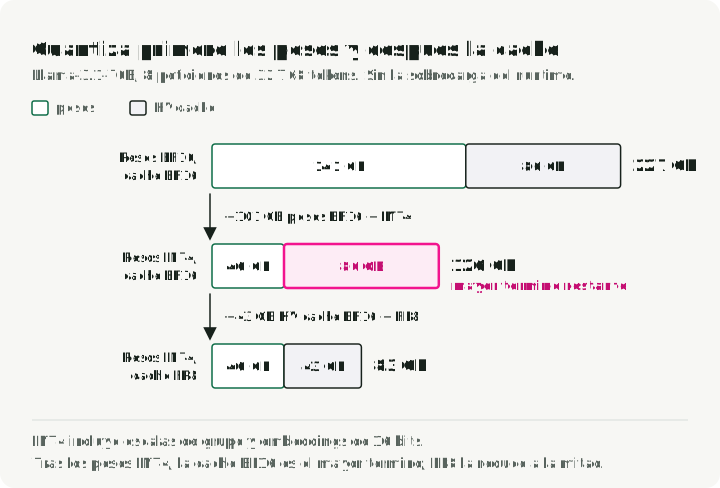
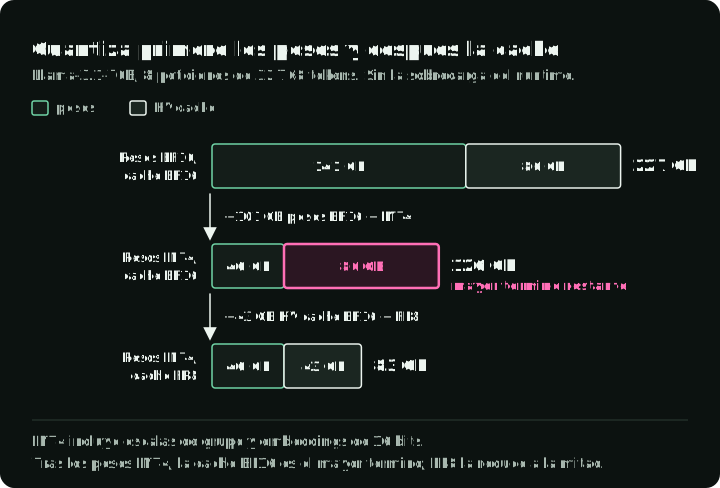
Compara cuánta memoria ahorraría cada cambio en tu propio modelo. Usa la ecuación de la caché de arriba con el mismo lote y la misma longitud de contexto para el dtype de caché actual y el propuesto. Resta el tamaño propuesto al actual. Haz lo mismo con los dos formatos de pesos que estés considerando. Por ejemplo, compara el ahorro de pasar de BF16 a caché FP8 con el de pasar los pesos de BF16 a INT4. Prueba primero la opción con mayor ahorro estimado, siempre que el runtime la admita. Después mide el uso real de memoria y la calidad; ninguna de las dos estimaciones incluye todas las asignaciones que hace el runtime.
7. Tamaño de los pesos y compatibilidad de GPU
El tamaño de los pesos es fácil de estimar a partir del número de parámetros y la precisión de almacenamiento, la misma idea de dimensionamiento que se usa en los análisis de memoria de serving sobre la KV cache:
| Tamaño del modelo | Pesos BF16 | Pesos FP8 / INT8 | Pesos INT4 |
|---|---|---|---|
| 7B / 8B | ~14-16 GB | ~7-8 GB | ~3,5-4 GB |
| 14B | ~28 GB | ~14 GB | ~7 GB |
| 32B / 34B | ~64-68 GB | ~32-34 GB | ~16-17 GB |
| 70B | ~140 GB | ~70 GB | ~35 GB |
| 109B MoE | ~218 GB en total | ~109 GB | ~55 GB |
La columna INT4 cuenta solo los valores de 4 bits. Las escalas de grupo añaden unos pocos puntos porcentuales, y los embeddings y el lm_head que se dejan en 16 bits añaden más. En Qwen3-8B, estas dos matrices ocupan unos 1,2 GB cada una en BF16. La estimación W4A16 del repositorio complementario, de 5,19 GiB, mantiene el 12 % de los parámetros en 16 bits para cubrirlas.
Con un presupuesto de memoria fijo, un modelo mayor en 4 bits puede superar a uno menor en 16 bits. Dettmers y Zettlemoyer encontraron que la precisión de 4 bits es casi universalmente óptima para la precisión zero-shot por bit total del modelo, en modelos BLOOM, OPT, Pythia y GPT-2 de 19M a 176B parámetros. El estudio midió solo la precisión zero-shot, así que prueba tus propias tareas antes de elegir.
Los modelos de mezcla de expertos pueden activar menos parámetros por token, pero el conjunto completo de pesos tiene que residir en algún sitio, salvo que el runtime admita offload. La matriz de compatibilidad de cuantización de TensorRT-LLM trata las familias de modelos MoE como destinos de despliegue con sus propias recetas compatibles.
Tu hardware de despliegue restringe qué formatos de cuantización son viables:
- El serving en CPU depende de instrucciones vectoriales como AVX-512 o AMX. Un archivo GGUF cargado con
llama.cppes la ruta práctica. - Apple Silicon usa memoria unificada, así que los modelos locales pueden aprovechar un gran conjunto de RAM compartida en lugar de VRAM dedicada. GGUF y
llama.cppsiguen siendo la ruta habitual de runtime local porque GGUF está pensado para ejecutores GGML. MLX es la otra ruta habitual:mlx_lm.convert --model <model> -qescribe por defecto un modelo MLX de 4 bits, y--q-bits 8escribe uno de 8 bits. Compara velocidad y calidad con los mismos prompts antes de elegir. - NVIDIA Ampere admite rutas de serving INT8 con tensor cores, pero no cálculo W8A8 FP8 nativo en tensor cores. Las opciones habituales son la cuantización W4A16 solo de pesos o INT8 estático, de acuerdo con la matriz de compatibilidad de hardware de TensorRT-LLM.
- NVIDIA Ada y Hopper admiten rutas de serving FP8 en TensorRT-LLM. Merece la pena probar el serving FP8 W8A8 en estas GPU.
- NVIDIA Blackwell añade compatibilidad con NVFP4 y microescalado, pero la ruta de software sigue importando. Trata las primeras pilas de coma flotante de pocos bits como sensibles a la versión.
8. Calibración y evaluación antes del despliegue
Un modelo que carga solo ha pasado una prueba inicial. El despliegue requiere comprobaciones de calidad y de serving para la carga de trabajo de destino. Las evaluaciones recientes de cuantización informan de resultados distintos para el serving de LLM, las tareas de contexto largo y los modelos centrados en el razonamiento.
La figura muestra adónde van las muestras de calibración y las de evaluación reservadas.
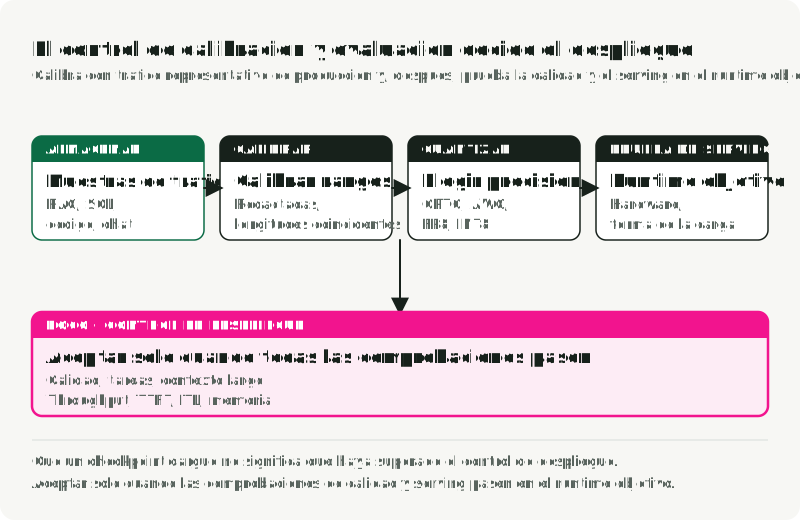
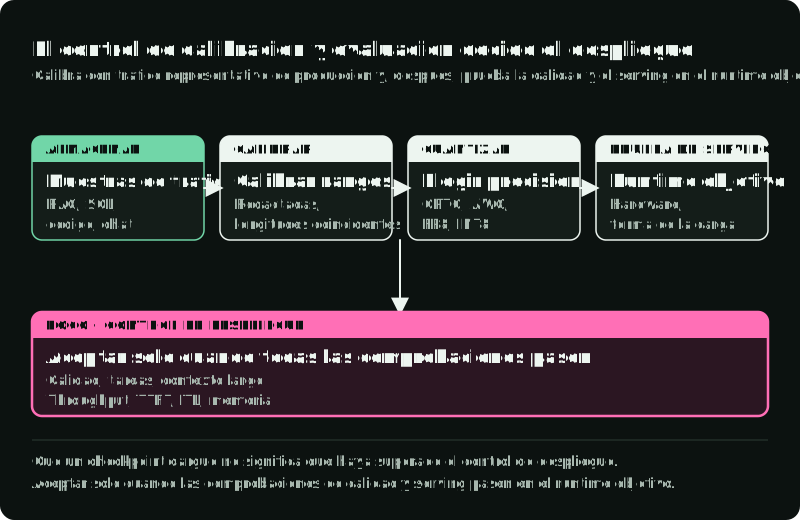
Elige primero la receta. Cuando requiera calibración, usa prompts que se parezcan a los de producción. HQQ y FP8 dinámico, por ejemplo, no necesitan dataset de calibración, así que la figura muestra una ruta que se salta la calibración. Mantén los ejemplos de evaluación separados de las muestras de calibración para que la comparación final pruebe el comportamiento con datos no vistos. Para las recetas que necesitan calibración:
- Incluye trazas de RAG, consultas SQL, historiales de agentes, tareas de código, cargas útiles de tool calls y system prompts de la carga de trabajo de destino. El PTQ estático depende de que los datos de calibración coincidan con la distribución de producción.
- Ajusta las longitudes de secuencia. Los prompts cortos de un solo turno no revelarán el comportamiento de las activaciones en contexto largo.
- Mantén
embed_tokensylm_headen mayor precisión si el método o el runtime lo permiten, un patrón de exclusión habitual en las recetas de LLM Compressor. - Usa suficientes muestras para estabilizar los rangos de activación. El ejemplo de KV cache de vLLM fija
NUM_CALIB_SAMPLES = 512. Trátalo como un ejemplo documentado, no como un número universal. El número adecuado de muestras depende del método, el modelo, la longitud de secuencia y la carga de trabajo de producción. - Elimina los secretos y los datos privados de los usuarios antes de usar los logs de producción.
Para la evaluación, prueba tanto la calidad del lenguaje como el comportamiento de serving:
- La perplejidad en un corpus estándar detecta la degradación general del lenguaje, pero el benchmark de JarvisLabs recuerda que la perplejidad y el throughput pueden moverse de forma distinta.
- Las tareas de dominio detectan fallos que la perplejidad oculta. Usa HumanEval para código, MMLU para conocimiento general y AIME o MATH-500 para razonamiento matemático cuando esos dominios importen.
- Las comprobaciones de formato importan en los sistemas agentic. Prueba el cumplimiento del JSON Schema, la salida en markdown, la forma de las tool calls y el comportamiento de rechazo, porque las evaluaciones de modelos cuantizados pueden pasar por alto fallos a nivel de aplicación incluso cuando la precisión agregada en los benchmarks parece estable.
- Las pruebas de contexto largo detectan el daño de la cuantización de la KV cache. El needle-in-a-haystack es una prueba tosca, pero los resultados de cuantización en contexto largo muestran por qué esas comprobaciones van antes del despliegue.
- Las pruebas de carga deben informar del throughput, el TTFT, la latencia entre tokens, la concurrencia sostenible y el pico de memoria de GPU.
vllm bench servemide el throughput y la latencia. Recoge la memoria de GPU aparte, con la telemetría de la GPU o del servidor. Barre la concurrencia frente a límites declarados de latencia y de errores para encontrar un nivel sostenible; la concurrencia observada en una sola ejecución no establece la capacidad.
En una aplicación RAG, mantén fijas las preguntas y la evidencia recuperada al comparar el generador de referencia con el cuantizado. Esa comparación aísla el cambio del generador. Después, ejecuta el pipeline completo para comprobar el resultado del serving, y usa la guía de evaluación de RAG para separar los fallos de recuperación de las respuestas sin respaldo. En un agente, comprueba si las mismas tareas terminan con tool calls válidas y efectos secundarios aceptables. Un checkpoint más pequeño, por sí solo, no responde a ninguna de estas preguntas.
Prueba los modelos de razonamiento en tareas de varios pasos. La cuantización por debajo de 4 bits o W4A4 sin rotación puede dañar la precisión del razonamiento aunque la perplejidad de referencia parezca estable, que es la advertencia central del estudio sobre modelos de razonamiento cuantizados.
9. Flujo de trabajo del repositorio complementario
El repositorio complementario, slavadubrov/model-compression-demo, hace reproducible el proceso de decisión. Usa uv y se centra en la planificación, las recetas, las ejecuciones en seco y las configuraciones de benchmark basadas en las mismas fuentes que se usan aquí: vLLM, LLM Compressor, TensorRT-LLM y los artículos de los algoritmos.
Clónalo e inspecciona los algoritmos admitidos:
git clone https://github.com/slavadubrov/model-compression-demo.git
cd model-compression-demo
git checkout 62da4539793ac3a93e94e8551a063c7681561099
uv run python demo.py list-algorithms
Estos comandos de planificación usan solo la biblioteca estándar de Python. Empieza por la planificación y el dimensionamiento:
uv run python demo.py plan \
  --model-preset qwen3-8b \
  --goal fit-memory \
  --hardware ampere \
  --context 4096 \
  --concurrency 4

uv run python demo.py estimate \
  --model-preset qwen3-8b \
  --scheme w4a16 \
  --context 4096 \
  --concurrency 4
plan elige GPTQ W4A16 para este objetivo e imprime los dos presupuestos de la sección 6: un objetivo de serving de 10,44 GiB y un pico de GPU de 2,35 GiB para el trabajo de cuantización capa por capa. estimate desglosa el objetivo de serving:
Architecture:     Qwen3 8B (built-in preset from official Hugging Face config)
Layers/hidden/KV: 36 / 4096 / 0.250
Note:             Causal text-generation checkpoint suitable for the text-only harness.
Scheme:           w4a16
Weights:          5.19 GiB
KV cache:         2.25 GiB
Runtime overhead: 2.00 GiB
Safety buffer:    1.00 GiB
Total target:     10.44 GiB
Weights y KV cache son los dos primeros términos de la ecuación de memoria de serving de la sección 6. Runtime overhead y Safety buffer son el margen que reserva el repositorio complementario para las activaciones y la sobrecarga del motor. La línea de la KV cache es la fórmula de la caché con las 36 capas, las 8 cabezas KV y la dimensión de cabeza 128 de Qwen3-8B, con 4096 tokens y 4 peticiones concurrentes.
Después, imprime la receta y obtén una vista previa de la cuantización antes de gastar tiempo de GPU:
uv run python demo.py recipe --algorithm gptq-w4a16

uv run python demo.py quantize \
  --algorithm gptq-w4a16 \
  --model Qwen/Qwen3-8B \
  --dry-run
El comando recipe imprime el código de llm-compressor que ejecuta el paso de cuantización:
from llmcompressor import oneshot
from llmcompressor.modifiers.quantization import GPTQModifier

recipe = GPTQModifier(
    scheme="W4A16",
    targets="Linear",
    ignore=["lm_head"],
)

oneshot(
    model="Qwen/Qwen3-8B",
    dataset="wikitext",
    dataset_config_name="wikitext-2-raw-v1",
    recipe=recipe,
    output_dir="outputs/Qwen3-8B-W4A16",
    max_seq_length=4096,
    num_calibration_samples=256,
)
targets e ignore deciden qué capas reciben pesos de 4 bits; num_calibration_samples y max_seq_length son las decisiones de calibración de la sección 8. WikiText es el valor por defecto de la prueba inicial; pasa --calibration-file con prompts parecidos a los de producción para un checkpoint real.
La receta GPTQ escribe un checkpoint compressed-tensors. GPTQ es el algoritmo, no el formato del checkpoint, así que vLLM detecta el formato a partir del checkpoint sin necesidad del flag --quantization, como en su ejemplo oficial de W4A16.
Para cuantizar, ejecuta make install-compression. vLLM necesita su propio entorno porque sus dependencias entran en conflicto con llm-compressor: ejecuta make install-serving y usa .venv-vllm/bin/vllm para los comandos serve y bench.
Haz serving y benchmark de cada checkpoint frente a la referencia RTN W8A16 de la tabla de algoritmos. Ejecuta quantize sin --dry-run para gptq-w4a16 y rtn-w8a16 para escribir outputs/Qwen3-8B-W4A16 y outputs/Qwen3-8B-W8A16. El comando benchmark-plan del repositorio complementario escribe en un archivo JSON un comando de serve y otro de benchmark para cada checkpoint. Para ejecutar la comparación a mano, arranca el servidor W4A16 en una terminal:
.venv-vllm/bin/vllm serve outputs/Qwen3-8B-W4A16 --host 127.0.0.1 --port 8000En una segunda terminal, ejecuta la misma carga sintética que en la sección 5:
.venv-vllm/bin/vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model outputs/Qwen3-8B-W4A16 \
  --tokenizer Qwen/Qwen3-8B \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Detén el servidor y vuelve a ejecutar los dos comandos con outputs/Qwen3-8B-W8A16, la referencia RTN W8A16, en lugar de outputs/Qwen3-8B-W4A16.
Por último, compara el modelo base y el comprimido con umbrales explícitos:
uv run python demo.py quality-eval \
  --base-model Qwen/Qwen3-8B \
  --compressed-model outputs/Qwen3-8B-W4A16 \
  --mode all \
  --lm-eval-task hellaswag \
  --lm-eval-limit 50 \
  --max-perplexity-delta-pct 5 \
  --output-json reports/qwen3-8b-w4a16-quality.json
Haz el trabajo en orden: planifica el objetivo, estima la memoria, ejecuta la receta en seco, haz benchmark del serving y compara la calidad con los umbrales. Esa secuencia refleja la separación que hace este artículo entre el dimensionamiento de memoria, el benchmark del runtime y la evaluación de calidad.
10. Los modelos de difusión necesitan una ruta aparte
Los pipelines de difusión y de transformers de difusión tienen un comportamiento de activaciones distinto al de los LLM autorregresivos. SVDQuant trata la cuantización de difusión como un problema aparte de valores atípicos en las activaciones.
Los LLM autorregresivos generan un token cada vez. Los modelos de difusión ejecutan pasos repetidos de eliminación de ruido, y sus distribuciones de activación cambian durante el proceso, como indica Q-Diffusion para las salidas del eliminador de ruido a lo largo de los pasos de tiempo. Una pasada estándar de cuantización de LLM a 4 bits puede ahorrar memoria en un modelo de difusión e introducir artefactos visuales graves. Los métodos centrados en difusión, como SVDQuant / Nunchaku y la cuantización de difusión de NVIDIA ModelOpt, abordan ese patrón de activaciones distinto.
En un pipeline de difusión latente, el text encoder representa el prompt. Un eliminador de ruido, como un transformer de difusión (DiT) o una U-Net, actualiza una y otra vez una representación comprimida de la imagen llamada latente. El autoencoder variacional (VAE) convierte entre esas representaciones latentes y las imágenes. Estos componentes tienen funciones distintas, así que prueba su precisión por separado.
Usa lo siguiente como heurísticas prudentes, no como valores por defecto universales. Cada pipeline, componente, modelo y runtime necesita sus propias pruebas:
- Mantén el VAE en 16 bits en la primera comparación. Prueba una precisión menor solo cuando el método y el pipeline de destino la validen.
- Prueba primero el backbone DiT o U-Net, porque suele concentrar la mayor parte de los parámetros. Verifica la memoria, la latencia y la calidad de imagen en el pipeline de destino. Los métodos de cuantización de difusión siguen el mismo enfoque por componentes.
- Trata los text encoders por separado. Cuantizar T5-XXL o CLIP puede afectar al ajuste al prompt o al renderizado de texto en un pipeline concreto, así que evalúalos de forma independiente en lugar de suponer el comportamiento de un transformer genérico.
- Usa métodos adaptados a la difusión, como SVDQuant, cuando los valores atípicos de las activaciones sean el problema principal.
- Evalúa con imágenes, no con métricas de texto. Comprueba el ajuste al prompt, el renderizado de texto, los tonos de piel, el equilibrio de color, el detalle fino, la latencia y la VRAM. Para comparar con el pipeline de 16 bits, mide LPIPS o PSNR entre imágenes emparejadas (misma semilla), y la puntuación CLIP o ImageReward para el ajuste al prompt, como hace la evaluación de SVDQuant. Después, revisa a ojo los casos difíciles.
Si el conjunto de evaluación solo contiene prompts simples o comunes, no verás los fallos en casos límite. Incluye casos difíciles: texto pequeño, manos, objetos repetidos, composiciones estructuradas y prompts con restricciones negativas, porque los fallos de la cuantización de difusión se ven en las imágenes y no en la perplejidad de los modelos de lenguaje.
11. Valores por defecto en producción
La figura sitúa la primera prueba para cada tipo de despliegue en un eje de ancho de bits, con la siguiente prueba y la condición para hacerla. Cada uno sigue necesitando las comprobaciones de la sección 8.
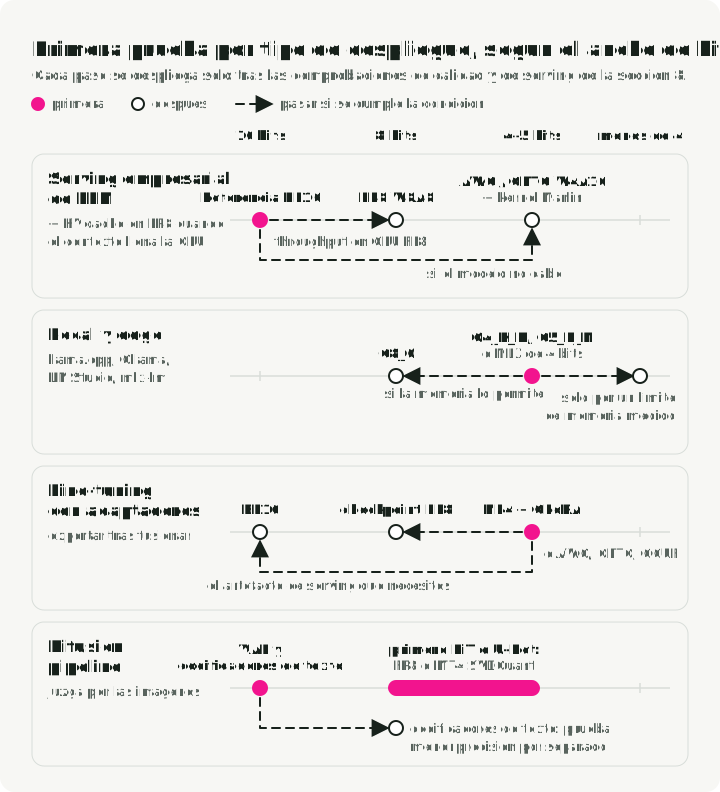
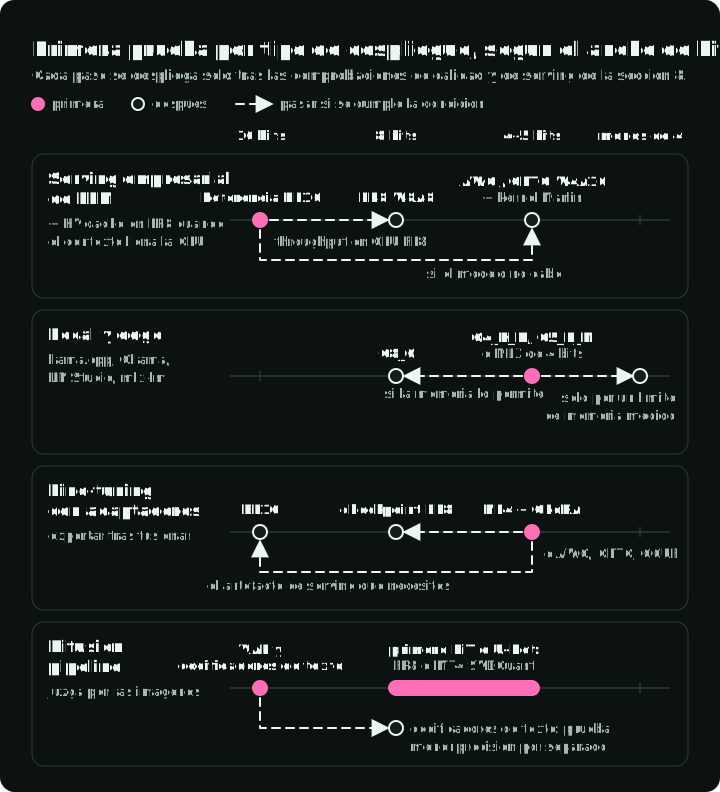
Para el serving empresarial de LLM, empieza con una referencia BF16 en el motor de serving exacto que planeas usar. Si el objetivo es el throughput y la GPU lo admite, prueba FP8 W8A8. Si el modelo no cabe, prueba AWQ o GPTQ W4A16 con kernels de la clase Marlin. Si el contexto largo o la concurrencia llenan la GPU, prueba una KV cache FP8. Despliega la versión comprimida solo cuando pasen tanto las comprobaciones de calidad como las de serving.
Para la inferencia local y en edge, empieza con un archivo GGUF con Q4_K_M o Q5_K_M, o con un modelo MLX de 4 bits en un Mac. Pasa a Q8_0 cuando la memoria lo permita y compara la calidad en la tarea. Usa codificaciones de menos de 4 bits solo ante un límite de memoria medido.
Para el fine-tuning, usa NF4 con QLoRA para entrenar adaptadores con menos memoria. Evalúa el adaptador en la aplicación antes de fusionarlo. Tras la fusión, exporta y evalúa el artefacto de serving que necesites: un archivo GGUF compatible con llama.cpp, un checkpoint AWQ/GPTQ/compressed-tensors, un checkpoint FP8 o BF16.
Para la difusión, cuantiza primero el eliminador de ruido, mantén el VAE en 16 bits y prueba los text encoders por separado, como en la sección 10. Compara imágenes emparejadas con la misma semilla y revisa a ojo los prompts difíciles.
12. Haz la siguiente comparación
Conserva la referencia BF16 y compara un candidato comprimido compatible con las mismas tareas de evaluación no vistas y el mismo tráfico. Anota antes de ejecutarlo la pérdida de calidad y la latencia que puedes aceptar. Mide el pico de memoria además de la velocidad: el resultado útil es si el candidato elimina tu cuello de botella dentro de esos límites.
Referencias
- JarvisLabs vLLM Benchmarks: JarvisLabs, vLLM Quantization Complete Guide and Benchmarks, 2026. JarvisLabs.
- Hugging Face Optimum Quantization Guide: Hugging Face, Quantization conceptual guide. Documentación.
- vLLM Quantization Docs: proyecto vLLM, Quantization. Documentación.
- vLLM Quantized KV Cache Docs: proyecto vLLM, Quantized KV Cache. Documentación.
- vLLM Benchmark Docs: proyecto vLLM, vllm bench serve. Documentación.
- LLM Compressor Docs: proyecto vLLM, LLM Compressor. Documentación.
- GPTQModel: ModelCloud, GPTQModel. GitHub.
- TensorRT-LLM Quantization: NVIDIA, TensorRT-LLM Quantization. Documentación.
- NVIDIA NVFP4: NVIDIA, Introducing NVFP4 for Efficient and Accurate Low-Precision Inference. Blog.
- Hugging Face QuantizedCache: Hugging Face, Cache strategies: Quantized cache. Documentación.
- NVIDIA Model Optimizer: NVIDIA, Model Optimizer. GitHub.
- torchao Quantization: PyTorch, torchao quantization overview. Documentación.
- bitsandbytes Quantization: Hugging Face, bitsandbytes. Documentación.
- HQQ: Dropbox, Half-Quadratic Quantization. GitHub.
- PEFT: Hugging Face, Parameter-Efficient Fine-Tuning. Documentación.
- Ollama: runtime de Ollama para modelos locales. Sitio web.
- LM Studio: runtime de LM Studio para IA local. Sitio web.
- Estado de AutoGPTQ: repositorio AutoGPTQ, archivado en abril de 2025. GitHub.
- Estado de AutoAWQ: repositorio AutoAWQ, archivado y declarado obsoleto en mayo de 2025. GitHub.
- GPTQ: Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, ICLR 2023. arXiv:2210.17323.
- Marlin: Frantar et al., MARLIN: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models, arXiv:2408.11743. arXiv:2408.11743.
- AWQ: Lin et al., AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, MLSys 2024. arXiv:2306.00978.
- SmoothQuant: Xiao et al., SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, ICML 2023. arXiv:2211.10438.
- QuaRot: Ashkboos et al., QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs, NeurIPS 2024. arXiv:2404.00456.
- SpinQuant: Meta AI Research, SpinQuant: LLM Quantization with Learned Rotations, arXiv:2405.16406. arXiv:2405.16406.
- QLoRA / NF4: Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, NeurIPS 2023. arXiv:2305.14314.
- SVDQuant / Nunchaku: MIT HAN Lab, SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models, ICLR 2025. arXiv:2411.05007, Nunchaku.
- vLLM PagedAttention: Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023. arXiv:2309.06180.
- Grouped-Query Attention: Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, EMNLP 2023. arXiv:2305.13245.
- vLLM FP8 KV Cache: Kubler, Kurtic, Wilkinson et al., The State of FP8 KV-Cache and Attention Quantization in vLLM, blog de vLLM, abril de 2026. vLLM Blog.
- KIVI: Liu et al., KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache, ICML 2024. arXiv:2402.02750.
- KVQuant: Hooper et al., KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization, NeurIPS 2024. arXiv:2401.18079.
- LLM Serving Evaluation: Kurtic et al., “Give Me BF16 or Give Me Death”? Accuracy-Performance Trade-Offs in LLM Quantization, ACL 2025. arXiv:2411.02355.
- Long-context Quantization Evaluation: Mekala et al., Does quantization affect models’ performance on long-context tasks?, arXiv:2505.20276. arXiv:2505.20276.
- Reasoning Evaluation: Quantization Hurts Reasoning? An Empirical Study on Quantized Reasoning Models, arXiv:2504.04823. arXiv:2504.04823.
- 2:4 Sparsity: Mishra et al., Accelerating Sparse Deep Neural Networks, arXiv:2104.08378. arXiv:2104.08378.
- k-bit Scaling Laws: Dettmers and Zettlemoyer, The case for 4-bit precision: k-bit Inference Scaling Laws, ICML 2023. arXiv:2212.09720.
- Q-Diffusion: Li et al., Q-Diffusion: Quantizing Diffusion Models, ICCV 2023. arXiv:2302.04304.
- MLX LM: Apple ml-explore, mlx-lm. GitHub.
- HumanEval: OpenAI, HumanEval. GitHub.
- MMLU: Hendrycks et al., Measuring Massive Multitask Language Understanding. arXiv:2009.03300.
- MATH-500: Hugging Face H4, MATH-500. Dataset.
- GGUF y llama.cpp: ggml-org, GGUF file format y llama.cpp. GGUF, llama.cpp.
- Hugging Face GGUF Docs: Hugging Face, GGUF. Documentación.
- Repositorio de referencia: slavadubrov/model-compression-demo.