Handleiding voor model quantization: van fundamenten tot serving in productie

Automatische vertaling
Dit artikel is automatisch vertaald vanuit de oorspronkelijke Engelse versie.
Deze quantization-handleiding is voor engineers die language models in productie brengen en het geheugengebruik willen verlagen of de serving willen versnellen. Je leert hoe je kiest wat je comprimeert, hoe je een getalformaat afstemt op je hardware en runtime, en hoe je geheugengebruik, latency en uitvoerkwaliteit vergelijkt vóór de deployment. Ook de aparte controles voor diffusion-beeldmodellen komen aan bod.
Quantization verlaagt het aantal bits voor weights, activations of de KV cache. Weights zijn de modelparameters die tijdens de training zijn geleerd. Activations zijn tussenwaarden die uit elke invoer worden berekend. De key-value (KV) cache bewaart waarden van eerdere tokens, zodat ze tijdens het genereren opnieuw kunnen worden gebruikt. Als je weights comprimeert, past het model misschien in het GPU-geheugen, maar blijft er te weinig ruimte over voor een lang gesprek. Wat je comprimeert en welke GPU-code dat uitvoert, bepaalt welke limiet je verlicht.
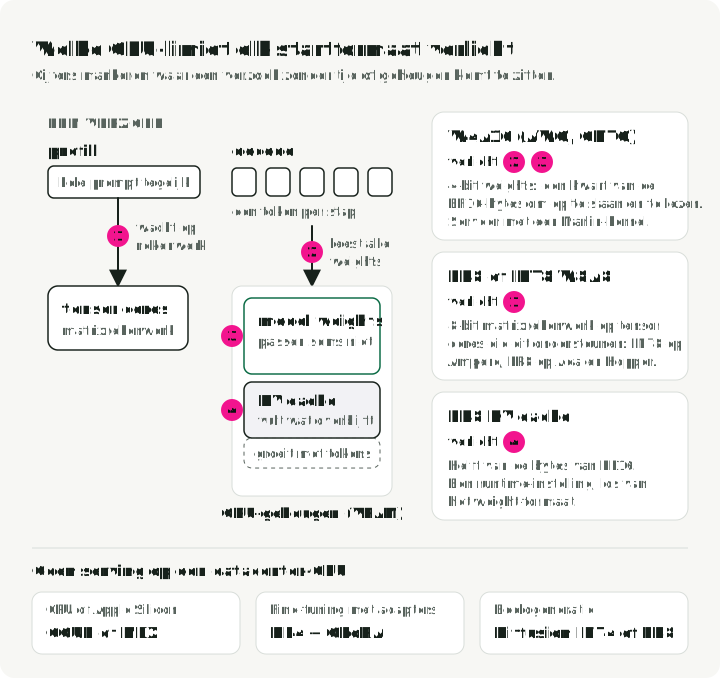
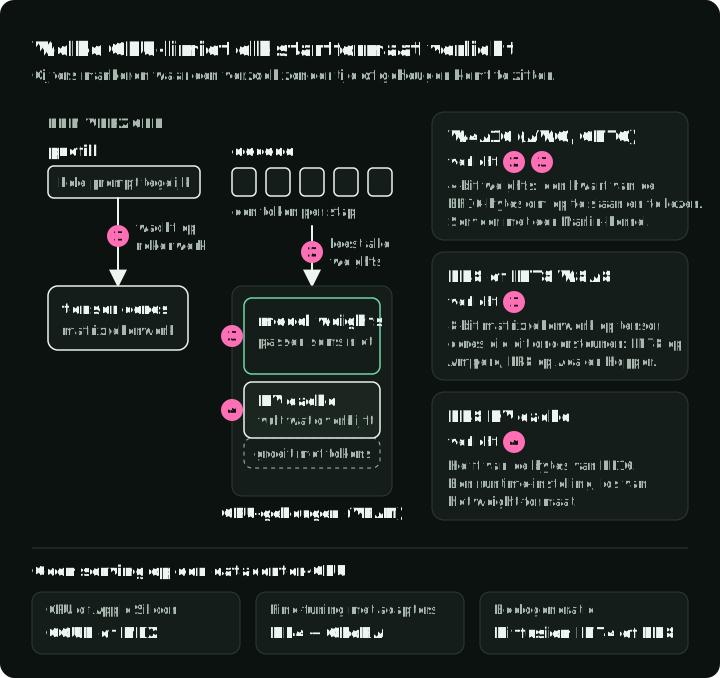
Begin met de vraag wat het verzoek traag of te groot maakt. Het verwerken van de invoerprompt heet prefill; het antwoord token voor token genereren heet decode. Prefill kan worden begrensd door de rekenkracht van de GPU, terwijl decode kan worden begrensd door hoe snel weights uit het geheugen worden geladen. Ook de weights van het model en de groeiende KV cache kunnen het GPU-geheugen vullen. De eerste tabel koppelt deze problemen aan mogelijke oplossingen; latere secties leggen de rekensommen en de controles uit die je vóór de deployment nodig hebt.
Een lagere bit-breedte is alleen een kandidaat. Voor de beslissing heb je zowel taakkwaliteit als serving-metingen nodig, voor het model, de runtime en het verkeer dat je gaat gebruiken. De benchmarks hier zijn gepubliceerde resultaten van andere teams, plus één korte run uit de companion-repository.
Voor de korte vergelijking van formaten en methoden, zie LLM Quantization Formats.
1. Bottlenecks en startformaten
Vraag je af wat de workload begrenst voordat je een bit-breedte kiest. Het antwoord kan het geheugen voor model weights zijn, de rekenkracht van prefill, de bandbreedte van decode of de KV cache, en niet de numerieke precisie zelf.
Notatie in serving-recepten
- W4A16 slaat weights op in 4-bit en houdt activations in 16-bit precisie. Algemener geeft W{x}A{y} de precisie aan van weights en activations in ondersteunde bewerkingen, meestal matrixvermenigvuldiging. W8A8 gebruikt in die bewerkingen 8-bit weights en activations, maar bepaalt niet automatisch het opgeslagen datatype van elke runtime-tensor.
- FP8, INT8, INT4, NF4 zijn getalformaten. Ze bepalen welke waarden je kunt weergeven.
- GPTQ, AWQ, SmoothQuant, QuaRot zijn algoritmen. Ze bepalen hoe je een getraind model omzet naar een formaat met lagere precisie.
- GGUF is een bestandsformaat dat tensors en metadata opslaat voor GGML en runtimes in de stijl van
llama.cpp. Een GGUF-bestand kan niet-gekwantiseerde tensortypen bevatten, zoalsF16,BF16ofF32, naast gekwantiseerde coderingen. Presets zijn onder meerQ4_K_M,Q5_K_M,Q8_0,IQ*,TQ*enMXFP4. De tensorcodering bepaalt de quantization-keuze.GGUFalleen beschrijft geen FP8 W8A8 serving-recept in CUDA-stijl. - KV cache is de attention-cache die tijdens het genereren wordt gebruikt. Ze bewaart eerdere keys en values, zodat het model niet bij elk token het hele gesprek opnieuw hoeft te berekenen.
- KV-cache quantization bewaart de key/value-activation-tensors in de cache in een formaat met lagere precisie, zoals FP8, INT8, INT4 of INT2, afhankelijk van wat de runtime ondersteunt. Dat is iets anders dan prefix caching, PagedAttention of offload. Die bepalen of cache-items worden hergebruikt, hoe ze worden toegewezen of waar ze staan.
- GEMM staat voor general matrix multiply. Het grootste deel van de inference-tijd van een transformer gaat op aan matrixvermenigvuldiging.
Wat wordt gekwantiseerd
Een recept bepaalt welke tensors worden gecomprimeerd. Dit zijn de gebruikelijke keuzes:
| Tensor | Meestal gekwantiseerd? | Waarom |
|---|---|---|
| Weights van lineaire lagen | Ja, in W4A16- en W8A8-recepten | Weights liggen na de training vast, dus hun scales zijn offline te berekenen. |
| Activations | Alleen in W8A8-, W4A8- of W4A4-recepten | Ze veranderen bij elke invoer, dus ze hebben gekalibreerde scales of scales tijdens runtime nodig. |
| KV cache | Optioneel, een aparte runtime-instelling | Ze groeit mee met context en batch; sectie 6 behandelt dit. |
Embeddings en lm_head | Meestal in 16-bit gehouden | LLM Compressor-recepten zetten lm_head in ignore; sectie 8 noemt deze uitzondering. |
| Diffusion-VAE en tekstencoders | In de eerste test in 16-bit gehouden | Sectie 10 test ze apart van het denoising-netwerk. |
Bottlenecks en waar je begint
De tabel koppelt veelvoorkomende bottlenecks aan een startformaat. Ze gebruikt de notatie hierboven.
| Als dit het probleem is | Begin hier | Gebruikelijke tools | Controleer vóór de deployment |
|---|---|---|---|
| Model weights passen niet in VRAM | W4A16 weight-only quantization | AWQ of GPTQ met llm-compressor of GPTQModel | Perplexity, coderen, reasoning, het opvolgen van instructies |
| High-throughput serving wordt begrensd door rekenwerk | FP8 of INT8 W8A8 | FP8 PTQ, SmoothQuant, TensorRT-LLM, vLLM | Throughput, time to first token (TTFT), taaknauwkeurigheid |
| Lange context of hoge concurrency vult de GPU | KV-cache quantization | vLLM, TensorRT-LLM of Transformers QuantizedCache | Retrieval over lange context, latency, veiligheid en kwaliteit |
| Lokale inference op CPU, Apple Silicon of desktop | GGUF-bestanden met lokale tensorcoderingen | llama.cpp, Ollama, LM Studio, MLX | Prompt-latency, RAM-gebruik, gekozen tensorcodering en subjectieve uitvoerkwaliteit |
| Adapter-fine-tuning moet op één GPU passen | NF4 / QLoRA | bitsandbytes, peft | Fine-tuning-loss en kwaliteit van het samengevoegde model |
| De pipeline voor beeldgeneratie is te groot of te traag | Diffusion-specifieke INT4 of FP8 | SVDQuant, Nunchaku, torchao, NVIDIA ModelOpt | Visuele artefacten, aansluiting op de prompt, latency, VRAM |
De figuur markeert waar één verzoek op een serving-GPU zonder tijd of geheugen komt te zitten en welk startformaat elke limiet verlicht. De onderste rij dekt de gevallen die geen serving op een datacenter-GPU zijn.
2. Quantization is gecontroleerd afronden
Quantization zet waarden met hoge precisie om in een kleinere verzameling waarden die je kunt weergeven. Dat is de kerndefinitie van zowel Hugging Face Optimum als TensorRT-LLM. Je bespaart geheugen en bandbreedte. Je krijgt er ook afrondingsfouten bij.
INT4 biedt maar 16 afzonderlijke waarden, dus als je 16-bit BF16 weights op dat raster afbeeldt, ontstaat afrondingsfout. Quantization-methoden beoordelen het afronden aan de hand van hoeveel de uitvoer van een laag verandert, niet aan de hand van losse weights. GPTQ schat in hoe afrondingskeuzes die uitvoer beïnvloeden en past de overige weights aan om de fout te verkleinen. AWQ gebruikt waargenomen activations om belangrijke groepen weights, channels genoemd, te herkennen en schaalt ze op vóór het afronden. Een goede afbeelding bespaart geheugen met weinig kwaliteitsverlies. Een slechte beschadigt reasoning, het opvolgen van instructies of visuele getrouwheid.
Symmetrische en asymmetrische afbeelding
Volgens de affiene afbeelding uit gangbare quantization-gidsen zet quantization een continue float-waarde om naar een discreet raster.
- en zijn de gekozen onder- en bovengrens van de floating-point-waarden.
- is de oorspronkelijke waarde met hoge precisie.
- is de gekwantiseerde waarde.
- is de scale, oftewel de stapgrootte.
- is het nulpunt, de gehele waarde die
0.0voorstelt. - is het gehele doelbereik. Dit symmetrische voorbeeld gebruikt : 15 waarden, waarbij nul exact wordt weergegeven. Andere INT4-formaten met teken gebruiken alle 16 waarden, bijvoorbeeld .
Symmetrische quantization centreert het raster rond nul en stelt :
Dit is gunstig voor hardware, omdat de rekenkunde tijdens runtime geen nulpunt-offset hoeft af te trekken. De quantization-stack van PyTorch biedt deze keuzes voor scale en nulpunt aan als primitieve quantization-parameters in torchao.
Asymmetrische quantization verschuift het raster zodat het scheve bereiken dekt:
Dat verschoven raster kan activations die alleen positief zijn beter bewaren, maar de offset kost extra werk, tenzij de kernel die goed afhandelt.
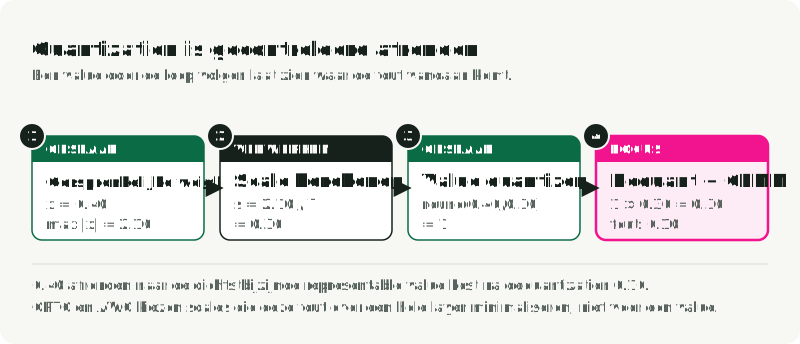
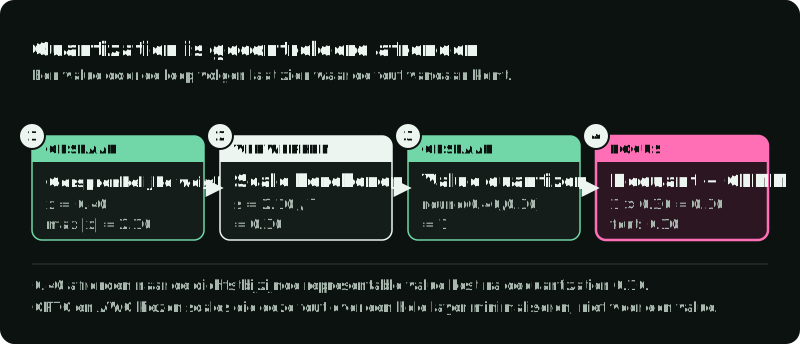
De figuur werkt het symmetrische geval uit: een maximale grootte van 2.10 geeft een scale van 0.30, dus het weight 0.40 wordt afgerond naar het gehele getal 1. Dequantization vermenigvuldigt dat opgeslagen gehele getal met de scale om een benaderde waarde terug te krijgen, 0.30. Het verschil met 0.40 is de afrondingsfout.
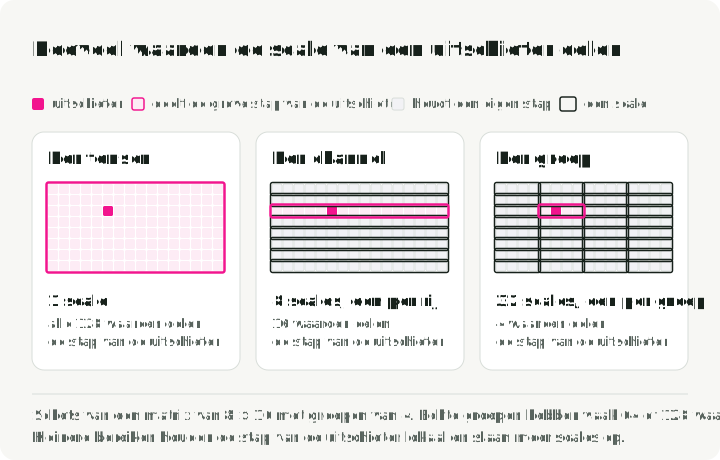
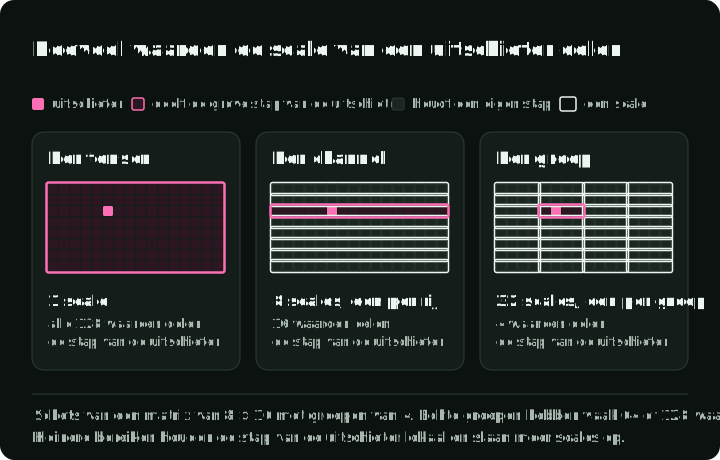
Granulariteit van de scale: tensor, channel, groep
De scale kan een hele weight-tensor beslaan, één channel of een kleine groep waarden. De FP8 KV-cache-documentatie van vLLM maakt hetzelfde onderscheid tussen scale-strategieën per tensor en per attention head. Kleinere groepen behouden meestal meer kwaliteit, maar vragen meer metadata voor de scales.
| Granulariteit van de scale | Wat één scale deelt | Effect op kwaliteit en uitvoering |
|---|---|---|
| Per tensor | De hele weight-matrix | Slaat weinig metadata op, maar één uitschieter kan het raster oprekken en de precisie in de hele laag verlagen. |
| Per channel | Eén uitvoerrij | Voorkomt dat channels met een smal bereik het bredere bereik van een ander channel delen. Veel 8-bit weight-paden gebruiken deze granulariteit. |
| Per groep | Een blok binnen een rij, vaak 64 of 128 waarden | Beperkt een uitschieter tot een klein blok, ten koste van meer scales. AutoGPTQ gebruikt group_size=128 in zijn GPTQ-voorbeelden. |
De figuur zet één uitschieter in een kleine voorbeeldmatrix en telt hoeveel waarden onder elke keuze zijn scale delen.
Weights zijn statisch, dus hun scales kun je offline berekenen voordat je het model laadt. Activations veranderen bij elk token, waardoor hun bereik afhangt van de workload.
| Scaling van activations | Wanneer de runtime de scale kiest | Voordeel | Faalwijze of kosten |
|---|---|---|---|
| Statisch | Offline, uit een calibration-dataset | Geen berekening van scales tijdens inference. | Prompts buiten de gekalibreerde lengte of verdeling kunnen pieken in activations afkappen en de uitvoer beschadigen. |
| Dynamisch | Tijdens elke forward pass | Past zich aan de actuele activation-waarden en prompt-mix aan. | Het berekenen van bereiken in elke laag kost extra werk en vraagt geoptimaliseerde kernels. |
De KV cache zit tussen deze gevallen in: keys en values zijn activations die tijdens runtime worden berekend en daarna voor latere tokens worden bewaard, dus ze hebben eigen scales nodig. Sectie 6 behandelt hoe runtimes ze opslaan.
PTQ en QAT vinden in verschillende fasen plaats
Post-training quantization, of PTQ, comprimeert een getraind model achteraf. Quantization-aware training, of QAT, laat het model tijdens de training quantization-ruis ervaren, zodat het zich kan aanpassen.
| Methode | Wanneer bereiken worden geleerd | Gebruik het wanneer | Prijs die je betaalt |
|---|---|---|---|
| Weight-only PTQ | Offline, voor statische weights | Het model past niet of decode wordt begrensd door bandbreedte | Activations draaien nog steeds in 16-bit |
| Statische PTQ | Offline, uit calibration-prompts | Je wilt snelle W8A8-serving | Calibration data moet bij productie passen |
| Dynamische PTQ | Tijdens runtime, per batch of activation-pad | Invoerverdelingen verschillen sterk | Extra werk tijdens runtime en beperktere hardware-ondersteuning |
| QAT | Tijdens de training | PTQ breekt de kwaliteit van een gevoelig model | Volledige trainingsinfrastructuur en veel meer rekenkracht |
Calibration data moet lijken op het verkeer dat je gaat bedienen. Het calibration-pad van vLLM voor de KV cache gebruikt bijvoorbeeld een samengestelde dataset via llm-compressor. Als productieprompts lange RAG-traces zijn, missen korte Wikipedia-alinea’s mogelijk de bereiken van activations die die traces opleveren. Bij statische scales voor activations of cache kiest calibration de bereiken. Bij GPTQ en AWQ bepalen de calibration-activations ook hoe elk weight wordt afgerond of opgeschaald, dus calibration met korte tekst kan de opgeslagen weights beïnvloeden. Echte prompts met lange context kunnen andere patronen in activations opleveren. Evaluaties van quantization bij lange context meten dit risico rechtstreeks.
3. Getalformaten bepalen de hardware-eisen
Het getalformaat bepaalt welke waarden het model in het geheugen kan weergeven. Efficiënt rekenen vraagt runtime-kernels en hardware-ondersteuning voor dezelfde bit-breedte en hetzelfde formaat. TensorRT-LLM documenteert zowel de lijst met recepten als de matrix met hardware-ondersteuning.
| Formaat | Opslag per waarde | Goede standaard voor | Belangrijkste aandachtspunt |
|---|---|---|---|
| BF16 / FP16 | 2 bytes | Baseline-inference en serving die compatibel is met training | Hoog VRAM-gebruik en veel verkeer over de geheugenbandbreedte |
| FP8 | 1 byte | High-throughput W8A8-serving op Ada, Hopper, Blackwell | Vraagt native FP8-tensor-cores en runtime-ondersteuning |
| INT8 | 1 byte | W8A8-serving op oudere of niet-NVIDIA-hardware | Uitschieters in activations en gevoeligheid voor statische calibration |
| INT4 | 0.5 byte | W4A16 wanneer weight-geheugen de belangrijkste limiet is | Kwaliteitsverlies bij kleinere models of models die veel reasoning doen |
| FP4 / NVFP4 | ~0.5 byte | Experimenten voor Blackwell en vroege serving-paden | Compiler- en runtime-eisen die per hardware verschillen |
| llama.cpp GGUF-coderingen / presets | Variabel | Lokale inference op CPU, Apple Silicon, desktop en edge | GGUF is de container. De tensorcodering is de quantization-keuze. |
| NF4 | 0.5 byte | QLoRA-adaptertraining | Meestal het verkeerde exportformaat voor serving in productie |
BF16 en FP16 gebruiken allebei 16 bits, maar ze verdelen de precisie anders en gaan daardoor anders fout. BF16 behoudt het 8-bit exponentbereik van FP32 en loopt minder snel over. FP16 heeft meer mantissa-bits en een smaller exponentbereik, dus pieken in activations vragen meer zorg. De evaluatie van Kurtic et al. gebruikt expliciet BF16 als baseline bij het vergelijken van de serving-formaten FP8, INT8 en INT4.
FP8 heeft twee gangbare varianten. E4M3 geeft meer precisie en wordt meestal gebruikt voor weights en activations in de forward pass. E5M2 geeft meer dynamisch bereik en is nuttiger voor gradiënten of onstabiele paden van activations. vLLM ondersteunt beide FP8 E4M3- en E5M2-dtypes voor de KV cache. In de ACL 2025-studie “Give Me BF16 or Give Me Death” van Kurtic et al. was FP8 W8A8 in feite verliesvrij op de Llama-3.1-familie, over meer dan 500,000 evaluaties. Het resultaat geldt voor die modelfamilie, die evaluatiesuite en die serving-opzet. Elke deployment heeft vóór release een eigen kwaliteitscontrole nodig.
Blackwell voegt microscaling-formaten toe, zoals MXFP8 en NVFP4. In plaats van één scale voor een hele tensor of rij gebruikt microscaling kleine blokken. NVIDIA’s uitleg over NVFP4 beschrijft 4-bit floating-point-waarden in blokken van 16, met FP8-scalefactoren en een FP32-scale op een hoger niveau. Deze aanpak wil een footprint bieden die bij INT4 in de buurt komt, met het gedrag van floating point. Daarvoor zijn wel een passende hardware-architectuur, compiler en runtime-ondersteuning nodig. Daarom vermeldt TensorRT-LLM FP4- en FP8-ondersteuning per GPU-generatie.
4. Weight-only versus weight-activation quantization
De notatie WxAy beschrijft de precisie van weights en activations, die de GPU tijdens inference op verschillende manieren belasten. De figuur volgt de weights van de VRAM via de kernel naar de tensor cores voor BF16, W4A16 en W8A8.
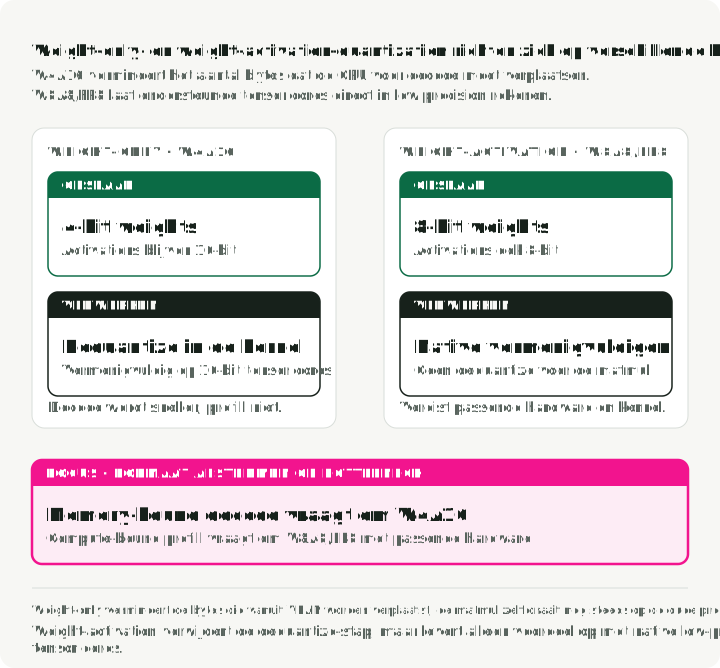
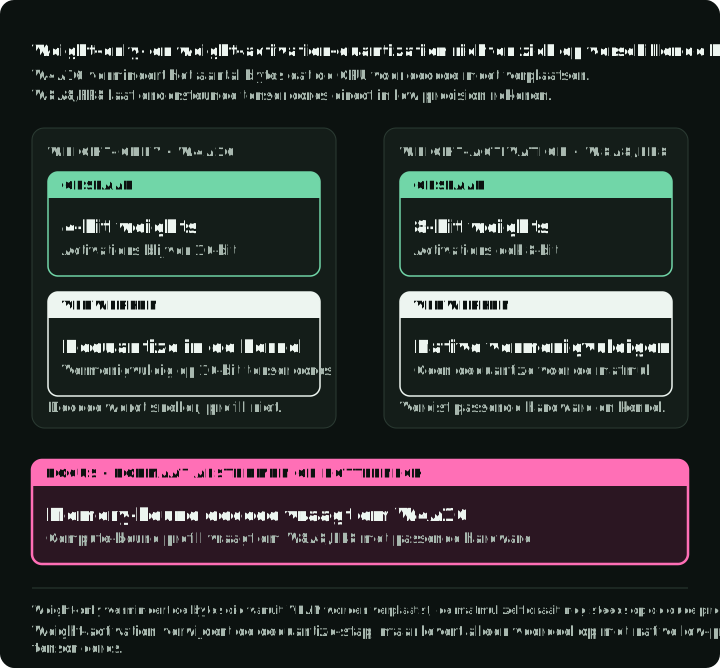
Tijdens prefill verwerkt het model de invoerprompt. Deze fase wordt meestal begrensd door rekenwerk, omdat de GPU grote matrixvermenigvuldigingen uitvoert. Daarom zijn W8A8 FP8/INT8-recepten van belang voor serving die op throughput mikt.
Tijdens decode genereert het model één token tegelijk. Deze fase wordt vaak begrensd door geheugenbandbreedte, omdat de GPU steeds weights uit VRAM laadt om het volgende token te maken. Weight-only-papers zoals GPTQ en AWQ pakken die druk aan door het aantal bytes aan weights te verkleinen.
W4A16 comprimeert weights en houdt activations in BF16 of FP16. De GPU laadt minder bytes aan weights en zet ze voor de vermenigvuldiging terug naar een vorm met hogere precisie. Dat helpt bij decode en bij problemen met passen in het geheugen. Prefill, dat door rekenwerk wordt begrensd, kan er weinig baat bij hebben, omdat de matrixberekening nog steeds in 16-bit draait.
W8A8 comprimeert weights en de activation-tensors die ondersteunde matmul-kernels gebruiken. Als de hardware native tensor-cores met lage precisie heeft, kan de serving-engine de matrixberekening direct in FP8 of INT8 uitvoeren. FP8 kan daardoor high-throughput serving helpen, doordat het geheugenverkeer afneemt en sneller wordt gerekend. De KV cache heeft een eigen opslaginstelling, dus controleer het cache-dtype of de cache-implementatie van de runtime apart.
In de ingecheckte run van de companion (RTX 4090, vLLM 0.23.0, één herhaling van 64 gegenereerde tokens) genereerde Qwen3-8B met de online FP8 dynamic quantization van vLLM 122 tok/s, tegen 85 tok/s voor BF16, en laadde het 8.8 GiB aan weights in plaats van 15.3 GiB. Met een FP8 KV cache erbij zakte het naar 49 tok/s. De run is te kort om capaciteit vast te stellen, maar hij laat zien dat elke instelling een eigen meting nodig heeft.
5. Algoritmen versus runtime-kernels
Quantization-algoritmen (zoals GPTQ of AWQ) bepalen hoe de weights van het model worden afgebeeld op lagere precisie. Runtime-kernels (zoals Marlin of de eigen kernels van vLLM) zijn de GPU-code op laag niveau die de matrixvermenigvuldiging uitvoert. Een sterk gecomprimeerd model draait alleen snel als er een geoptimaliseerde kernel bestaat voor zijn specifieke quantization-formaat.
Een serving-recept noemt één onderdeel per laag: een algoritme (GPTQ, AWQ), een checkpoint-formaat (compressed-tensors, GGUF), een runtime (vLLM, llama.cpp) en een kernel (Marlin). Hetzelfde AWQ-checkpoint kan sterk uiteenlopende snelheden halen, afhankelijk van de kernel.
De grafiek zet elk 4-bit checkpoint met en zonder de Marlin-kernel naast elkaar in één gepubliceerde benchmark. De tabel eronder voegt perplexity en TTFT toe.
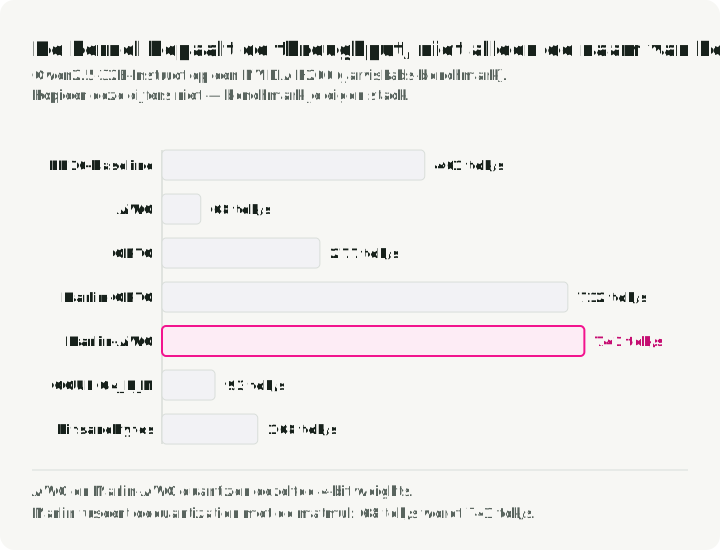
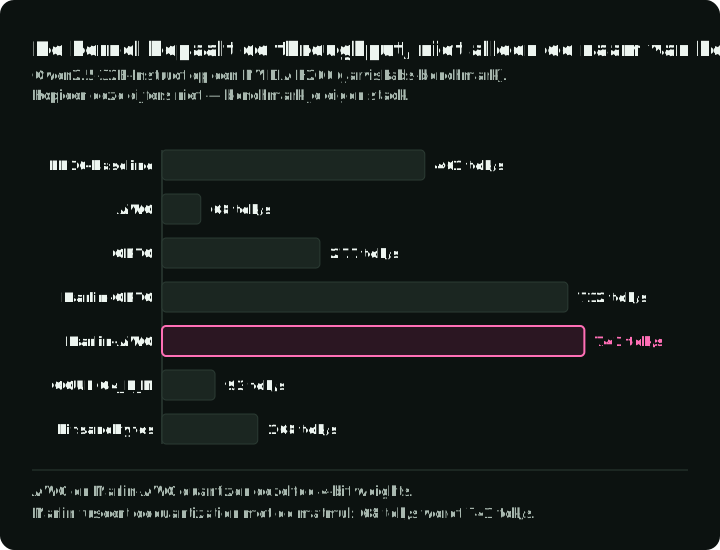
De vLLM-benchmark van JarvisLabs draaide Qwen2.5-32B-Instruct op een NVIDIA H200. Perplexity meet hoe goed het model de testtekst voorspelt; lager is beter. HumanEval pass@1 meet het succes op codeertaken met één gegenereerde oplossing. Output tokens/s meet de generation-throughput, en mean TTFT meet de gemiddelde wachttijd op het eerste uitvoertoken:
| Quantization / kernel | Wikitext-2-perplexity ↓ | HumanEval pass@1 ↑ | Output tokens/s | Mean TTFT |
|---|---|---|---|---|
| FP16 baseline | 6.56 | 56.1% | 461 tok/s | 57.7 ms |
| AWQ | 6.84 | 51.8% | 68 tok/s | 277.8 ms |
| GPTQ | 6.90 | 46.3% | 277 tok/s | 107.1 ms |
| Marlin-GPTQ | 6.97 | 45.7% | 712 tok/s | 51.9 ms |
| Marlin-AWQ | 6.84 | 51.8% | 741 tok/s | 73.5 ms |
| GGUF Q4_K_M | 6.74 | 51.8% | 93 tok/s | 958.0 ms |
| bitsandbytes | 6.67 | 51.8% | 168 tok/s | 135.3 ms |
De snelheidstest van de leverancier gebruikt 200 ShareGPT-prompts, een maximale concurrency van 10 en seed 42. De kwaliteit komt uit aparte runs op Wikitext-2 en HumanEval. Het rapport legt de vLLM-versie en de modelrevisies niet vast, dus dit zijn door de leverancier gerapporteerde resultaten en geen onafhankelijk gereproduceerde vergelijking. Ze laten een beperkter punt zien: de naam van het algoritme op het checkpoint zegt niet hoe snel de serving wordt.
AWQ en Marlin-AWQ gebruiken bijvoorbeeld dezelfde 4-bit weights. De Marlin-implementatie is veel sneller, omdat de CUDA-kernel dequantization en matrixvermenigvuldiging samenvoegt tot één sterk geoptimaliseerde GPU-bewerking.
Voor je eigen vergelijking maak of verkrijg je eerst een AWQ-checkpoint dat compatibel is met vLLM, op het pad hieronder; deze commando’s quantizen het model niet. Installeer een vLLM-build die je GPU ondersteunt en start de server in één terminal:
vllm serve ./outputs/Qwen2.5-32B-Instruct-AWQ-W4A16 \
  --served-model-name qwen2.5-32b-awq \
  --host 127.0.0.1 \
  --port 8000
Laat die server draaien. Gebruik in een tweede terminal vllm bench serve, met de echte tokenizer los van de API-modelalias:
vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model qwen2.5-32b-awq \
  --tokenizer Qwen/Qwen2.5-32B-Instruct \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Dit is een synthetische load test met 1,024 invoertokens en 256 uitvoertokens per verzoek. Het is geen reproductie van de ShareGPT-tabel en ook geen kwaliteitstest. Herhaal hem voor de baseline en voor elk voorbereid checkpoint met dezelfde tokenizer, lengtes, seed en concurrency. Noteer het werkelijke aantal tokens en de geïnstalleerde vLLM-versie. Voor deze voorbeeldcommando’s zijn het voorbereide checkpoint en de doel-GPU nodig.
Volg throughput, TTFT, inter-token latency (de vertraging tussen opeenvolgende tokens), geheugengebruik en taakkwaliteit. Als sommige daarvan in tegengestelde richting bewegen, is die afweging precies wat je vóór de release moet zien.
Quantization-algoritmen vergeleken
Deze methoden lossen verschillende compressieproblemen op:
| Algoritme | Gangbaar formaat | Wat het probeert te behouden | Belangrijkste kosten |
|---|---|---|---|
| GPTQ | W4A16 | De uitvoer van de laag, met Hessian-schattingen van hoe weight-wijzigingen de fout beïnvloeden | Trage calibration en complexere verwerking |
| AWQ | W4A16 / W4A8 | Belangrijke activation-channels | Vraagt calibration en samengevoegde serving-kernels |
| SmoothQuant | W8A8 | Het INT8-gedrag van activations, door uitschieters naar de weights te verschuiven | Scales per model afstellen |
| QuaRot / SpinQuant | W4A4 / W4A8 | Minder druk door uitschieters in activations, via rotaties | Complexiteit van rotaties tijdens runtime |
| HQQ | W4A16 / W2A16 | Snelle weight-only compressie zonder calibration | Kwaliteit vraagt downstream-controles bij zeer lage bit-breedtes |
| QLoRA (NF4) | NF4 | Geheugen voor adaptertraining | Geen sterke standaard voor serving |
| llama.cpp GGUF K-quants / IQ-quants | Gemengde tensorcoderingen met lage bit-breedte | Kwaliteit van lokale inference per byte | Niet ontworpen voor cloud-batch-serving |
| RTN (round-to-nearest) | W8A16 / FP8 | Niets buiten de scale; geen calibration data | Groot kwaliteitsverlies bij 4 bits; gebruik als baseline |
| FP8 dynamic | W8A8 FP8 | Het bereik van activations per token tijdens runtime; geen calibration data | Vraagt FP8-tensor-cores; oudere GPU’s zien mogelijk geen versnelling |
AutoGPTQ is in april 2025 gearchiveerd en AutoAWQ is in mei 2025 gearchiveerd en officieel verouderd verklaard. Begin voor nieuwe compressed-tensors-checkpoints die vLLM gebruikt met llm-compressor. Gebruik GPTQModel wanneer je het actieve GPTQ-pad nodig hebt met Marlin, Machete, geheugenopties voor MoE of disk offload.
Pruning en distillation verlagen de serving-kosten ook, via aparte workflows. 2:4 structured sparsity verwijdert weights in een patroon dat NVIDIA’s sparse tensor-cores kunnen benutten. Distillation traint een kleiner student-model om een groter model na te bootsen, wat voor smalle taken goed kan werken. Neem een van beide paden alleen op in de shortlist als het project het extra werk voor pruning of training kan dragen.
6. Serving-geheugen is meer dan weights
Het gecomprimeerde checkpoint is maar een deel van het serving-geheugen. Bepaal de omvang van de hele runtime voordat je besluit of weight quantization genoeg is. PagedAttention wijst de KV cache aan als een belangrijke term in het serving-geheugen.
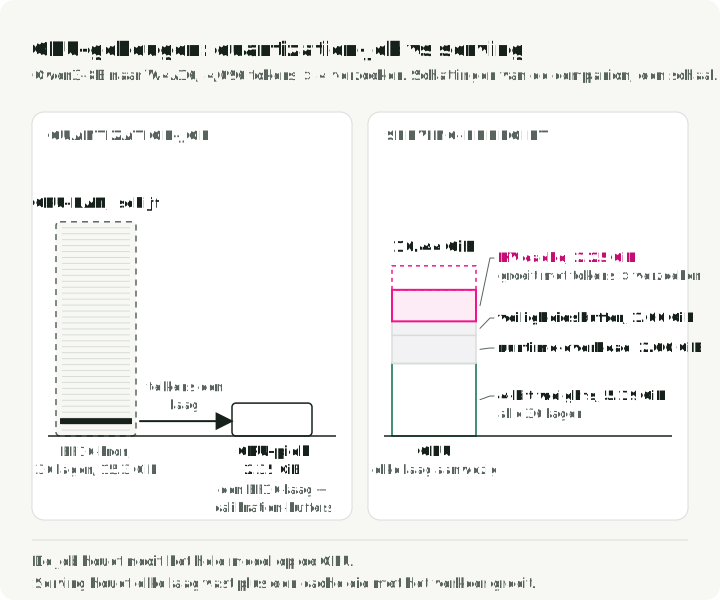
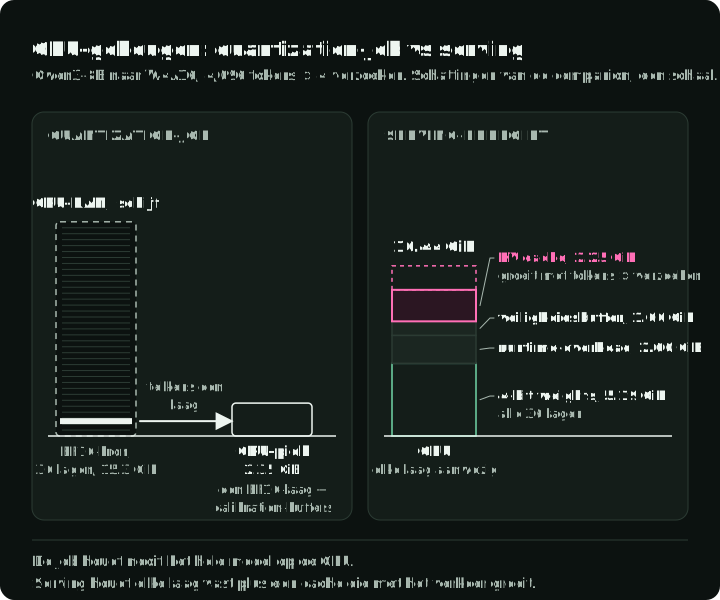
Offline quantization kan per laag worden begrensd. Tools zoals llm-compressor kunnen één transformer-blok laden, de calibration en quantization uitvoeren, het gecomprimeerde blok wegschrijven en doorgaan. Zo blijft de piek in GPU-geheugen dichter bij de grootste actieve laag plus de calibration-buffers. Je hebt nog wel CPU-RAM en schijfruimte nodig voor het bron-checkpoint, maar de GPU hoeft niet altijd het volledige BF16-model te bevatten.
De piek in GPU-geheugen tijdens offline quantization kan er zo uitzien:
De figuur tekent beide budgetten op dezelfde schaal met de schatting voor Qwen3-8B W4A16 uit sectie 9 van de companion. Het linkerpaneel is de offline job; het rechterpaneel is wat tijdens de serving op de GPU moet blijven staan.
Voor serving die volledig op de GPU draait, moeten alle gecomprimeerde weights over de serving-GPU’s passen, naast de KV cache en de runtime-buffers. Weight offload verlaagt het gebruik van GPU-geheugen ten koste van overdrachten. De KV cache groeit met de contextlengte en de actieve batchgrootte. Bij uniforme attention-lagen en verzoeken van gelijke lengte is de omvang van de tensor-data bij benadering:
Deze schatting laat overhead van de allocator, scale-metadata van de cache en gedeelde prefixen buiten beschouwing. Vervang bij verzoeken van verschillende lengte door de som van hun gecachete lengtes.
Hierin geldt:
- is het aantal lagen.
- is het aantal key-value attention heads. Grouped-query attention verlaagt dit door veel query-heads minder KV-heads te laten delen.
- is de dimensie van elke head, vaak 128 of 256.
- is de prompt-tokens plus de gegenereerde tokens.
- is de actieve serving-batch.
- is 2 voor BF16 of FP16 en 1 voor FP8 of INT8. De FP8 KV-cache-modus van vLLM is het voorbeeld van een serving-stack dat dit artikel gebruikt.
KV-cache quantization verandert de opslag, hergebruik verandert de toewijzing
De KV cache kan tijdens inference worden gekwantiseerd. Elke decode-stap levert K- en V-activation-tensors op voor het nieuwe token. Een W8A8-model gebruikt misschien al FP8 of INT8 voor ondersteunde projectieberekeningen, maar de cache blijft een apart opslagobject.
Veel serving-stacks houden dat object in het dtype van het model of van de cache. Om dat te veranderen schakel je een KV-cache-dtype in, gebruik je een checkpoint met cache-scales of kies je een gekwantiseerde cache-implementatie.
Als KV-cache quantization aanstaat, schrijft de engine items weg als een representatie met lagere precisie plus scales. Later dequantiseert attention de cache binnen zijn kernel, of voert op sommige backends een deel van de attention-bewerking uit in het gekwantiseerde domein.
De stabiele documentatie over Quantized KV Cache van vLLM biedt dit direct aan met kv_cache_dtype="fp8" of --kv-cache-dtype fp8. vLLM ondersteunt de cache-formaten FP8 E4M3 en E5M2, plus scale-strategieën per tensor en per attention head. Het kan standaardscales gebruiken of calibration met een dataset via llm-compressor. Met FlashAttention 3 kan vLLM attention-bewerkingen ook in het FP8-domein uitvoeren, door naast keys en values ook queries te kwantiseren. Zo schakel je de FP8-cache voor een model in:
vllm serve Qwen/Qwen3-8B --kv-cache-dtype fp8 --max-model-len 32768TensorRT-LLM biedt FP8 KV cache aan via KvCacheConfig(dtype='fp8') en noemt FP8 KV cache en NVFP4 KV cache als aparte quantization-recepten naast weight/activation quantization. Hugging Face Transformers heeft ook een QuantizedCache-pad via cache_implementation="quantized", waarbij hqq de cache-formaten int2, int4 en int8 ondersteunt en quanto int2 en int4.
Gewone KV caching bewaart eerdere keys en values om herberekening te vermijden. Prefix caching hergebruikt cache-blokken over verzoeken heen die dezelfde prefix hebben. PagedAttention beperkt fragmentatie en verbetert de toewijzing, terwijl KV offload cache-blokken tussen geheugenniveaus verplaatst. Deze combinaties hangen van de runtime af. De QuantizedCache van Hugging Face ondersteunt geen offloading. vLLM beschrijft zijn quantized KV cache apart van prefix caching en andere functies voor cachebeheer. Controleer elke combinatie in de runtime die je uitrolt.
Het kwaliteitsrisico verschilt ook van weight-only PTQ. KV-cache quantization brengt fout in de attention-state die bij elke latere decode-stap wordt gelezen. Test retrieval over lange context, gedrag over meerdere beurten, veiligheid en weigeringen, de opmaak van tool use en de uitvoerlatency apart. KVQuant, KIVI en de FP8 KV-cache-studie van vLLM evalueren KV-cache quantization allemaal als een probleem op zich.
Een uitgewerkt voorbeeld laat zien wanneer de cache groter wordt dan de weights. Neem Llama-3.1-70B (80 lagen, 8 KV-heads, head-dimensie 128) die 8 verzoeken van 32,768 tokens bedient:
def kv_cache_gb(layers, kv_heads, head_dim, tokens, batch, bytes_per_value):
    return 2 * layers * kv_heads * head_dim * tokens * batch * bytes_per_value / 1e9

# Llama-3.1-70B: 80 layers, 8 KV heads, head dimension 128
for name, nbytes in [("BF16", 2), ("FP8", 1)]:
    print(name, round(kv_cache_gb(80, 8, 128, 32_768, 8, nbytes), 1), "GB")
Het script drukt BF16 85.9 GB en FP8 42.9 GB af. Bij deze belasting is de BF16-cache (86 GB) groter dan de INT4-weights: ongeveer 40 GB als je de group-scales en de 16-bit embeddings meetelt, tegenover de 35 GB die de tabel in sectie 7 voor alleen de 4-bit waarden geeft. De FP8-cache bespaart 43 GB; BF16-naar-INT4 voor de weights bespaart ongeveer 100 GB. Weight quantization komt hier eerst, en de cache is de grootste overgebleven term. De grafiek stapelt weights en cache na elke stap.
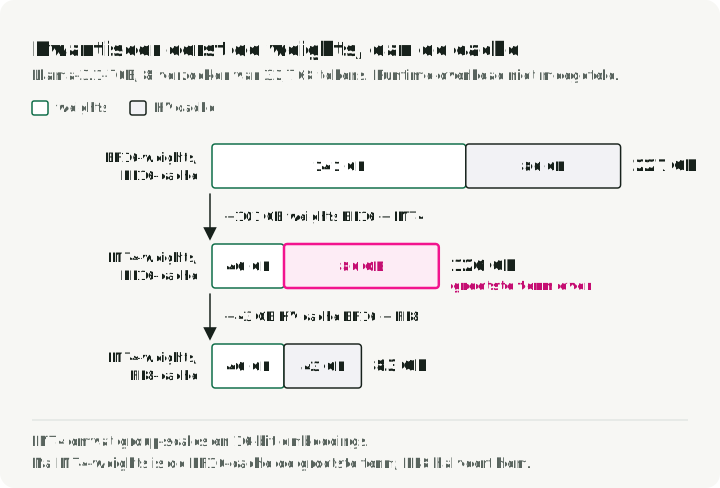
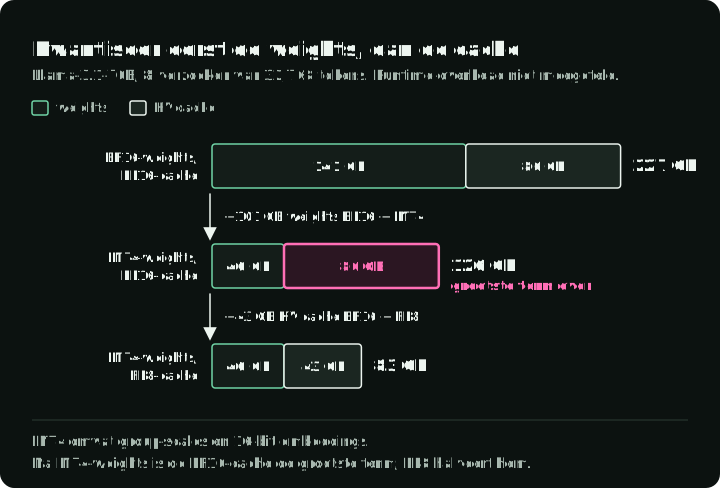
Vergelijk hoeveel geheugen elke wijziging voor jouw eigen model zou besparen. Gebruik de cache-formule hierboven met dezelfde batch en contextlengte voor het huidige en het voorgestelde cache-dtype. Trek de voorgestelde omvang af van de huidige. Doe hetzelfde voor de twee weight-formaten die je overweegt. Vergelijk bijvoorbeeld de besparing van BF16-naar-FP8-cache met die van BF16-naar-INT4-weights. Test eerst de optie met de grootste geschatte besparing, mits de runtime die ondersteunt. Meet daarna het werkelijke geheugengebruik en de kwaliteit; geen van beide schattingen omvat elke toewijzing die de runtime maakt.
7. Omvang van weights en GPU-ondersteuning
De footprint van weights is eenvoudig te schatten uit het aantal parameters en de opslagprecisie, met dezelfde rekenwijze als in besprekingen van serving-geheugen rond de KV cache:
| Modelgrootte | BF16-weights | FP8 / INT8-weights | INT4-weights |
|---|---|---|---|
| 7B / 8B | ~14-16 GB | ~7-8 GB | ~3.5-4 GB |
| 14B | ~28 GB | ~14 GB | ~7 GB |
| 32B / 34B | ~64-68 GB | ~32-34 GB | ~16-17 GB |
| 70B | ~140 GB | ~70 GB | ~35 GB |
| 109B MoE | ~218 GB totaal | ~109 GB | ~55 GB |
De INT4-kolom telt alleen de 4-bit waarden mee. Group-scales voegen een paar procent toe, en embeddings en lm_head die in 16-bit blijven nog meer. Bij Qwen3-8B zijn deze twee matrices in BF16 elk ongeveer 1.2 GB. De W4A16-schatting van 5.19 GiB in de companion houdt 12% van de parameters in 16-bit om ze te dekken.
Bij een vast geheugenbudget kan een groter model in 4-bit beter presteren dan een kleiner model in 16-bit. Dettmers en Zettlemoyer vonden 4-bit precisie vrijwel overal optimaal voor zero-shot-nauwkeurigheid per totaal aantal modelbits, bij BLOOM-, OPT-, Pythia- en GPT-2-models van 19M tot 176B parameters. De studie mat alleen zero-shot-nauwkeurigheid, dus test je eigen taken voordat je kiest.
Mixture-of-experts-models activeren misschien minder parameters per token, maar de volledige set weights moet nog steeds ergens staan, tenzij de runtime offload ondersteunt. De ondersteuningsmatrix voor quantization van TensorRT-LLM behandelt MoE-modelfamilies als deployment-doelen met eigen ondersteunde recepten.
Je deployment-hardware bepaalt welke quantization-formaten haalbaar zijn:
- CPU-serving hangt af van vectorinstructies zoals AVX-512 of AMX. Een GGUF-bestand dat via
llama.cppwordt geladen, is het praktische pad. - Apple Silicon gebruikt unified memory, dus lokale models kunnen een grote gedeelde RAM-pool gebruiken in plaats van speciaal VRAM. GGUF en
llama.cppblijven het gangbare pad voor lokale runtimes, omdat GGUF is gebouwd voor GGML-executors. MLX is het andere gangbare pad:mlx_lm.convert --model <model> -qschrijft standaard een 4-bit MLX-model en--q-bits 8een 8-bit model. Vergelijk snelheid en kwaliteit op dezelfde prompts voordat je kiest. - NVIDIA Ampere ondersteunt INT8-serving-paden met tensor-cores, maar geen native FP8 W8A8-berekeningen op tensor-cores. Gangbare keuzes zijn W4A16 weight-only quantization of statische INT8, in lijn met de hardware-ondersteuningsmatrix van TensorRT-LLM.
- NVIDIA Ada en Hopper ondersteunen FP8-serving-paden in TensorRT-LLM. FP8 W8A8-serving is op deze GPU’s het testen waard.
- NVIDIA Blackwell voegt NVFP4- en microscaling-ondersteuning toe, maar het softwarepad blijft van belang. Behandel vroege stacks met floating point op lage bit-breedte als versiegevoelig.
8. Calibration en evaluatie vóór de deployment
Een model dat laadt, heeft alleen een smoke test doorstaan. Voor deployment zijn kwaliteits- en serving-controles nodig voor de doelworkload. Recente evaluaties van quantization rapporteren verschillende uitkomsten voor LLM-serving, taken met lange context en models die veel reasoning doen.
De figuur toont waar calibration-samples en achtergehouden evaluatiesamples terechtkomen.
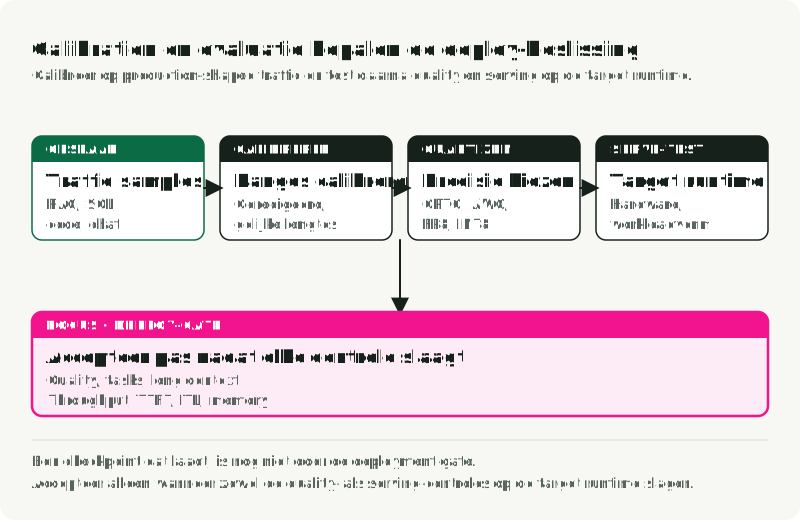
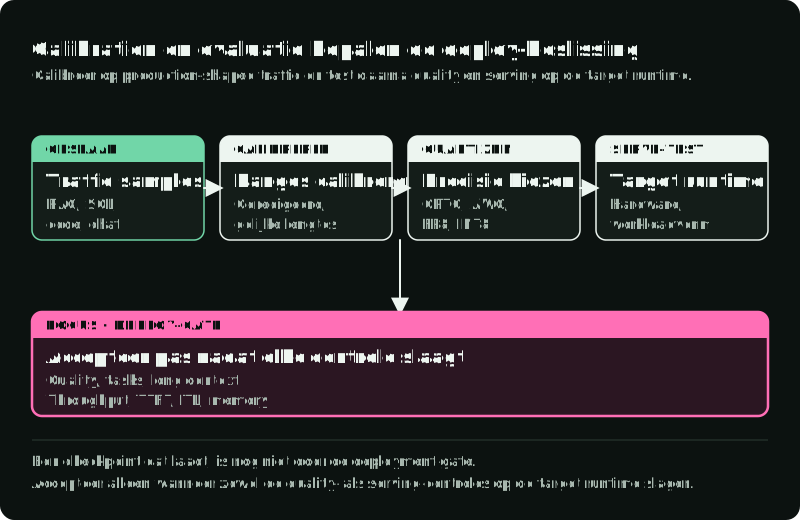
Kies eerst het recept. Als het calibration vereist, gebruik dan prompts die op productie lijken. HQQ en FP8 dynamic hebben bijvoorbeeld geen calibration-dataset nodig, dus de figuur toont een pad dat calibration overslaat. Houd evaluatievoorbeelden gescheiden van calibration-samples, zodat de eindvergelijking gedrag op achtergehouden data test. Voor recepten die calibration nodig hebben:
- Neem RAG-traces, SQL-queries, agent-geschiedenissen, codeertaken, payloads van tool calls en system prompts uit de doelworkload op. Statische PTQ hangt ervan af dat de calibration data overeenkomt met de productieverdeling.
- Gebruik dezelfde sequentielengtes. Korte prompts van één beurt leggen het gedrag van activations bij lange context niet bloot.
- Houd
embed_tokensenlm_headin hogere precisie als de methode of runtime dat toelaat, een gangbaar uitsluitingspatroon in LLM Compressor-recepten. - Gebruik genoeg samples om de bereiken van activations te stabiliseren. Het KV-cache-voorbeeld van vLLM stelt
NUM_CALIB_SAMPLES = 512in. Zie dat als één gedocumenteerd voorbeeld, niet als een algemeen aantal. Het juiste aantal samples hangt af van de methode, het model, de sequentielengte en de productieworkload. - Redigeer geheimen en privégegevens van gebruikers weg voordat je productielogs gebruikt.
Test voor de evaluatie zowel de taalkwaliteit als het serving-gedrag:
- Perplexity op een standaardcorpus vangt brede achteruitgang van taal op, maar de JarvisLabs-benchmark herinnert er nuttig aan dat perplexity en throughput verschillend kunnen bewegen.
- Domeintaken vangen fouten op die perplexity verbergt. Gebruik HumanEval voor coderen, MMLU voor brede kennis en AIME of MATH-500 voor wiskundige reasoning wanneer die domeinen ertoe doen.
- Formaatcontroles zijn belangrijk voor agentic systemen. Test naleving van JSON Schema, markdown-uitvoer, de vorm van tool calls en weigergedrag, omdat evaluaties van gekwantiseerde models fouten op applicatieniveau kunnen missen, zelfs als de totale benchmarknauwkeurigheid stabiel lijkt.
- Tests met lange context vangen schade door KV-cache quantization op. Needle-in-a-haystack is grof, maar resultaten over quantization bij lange context laten zien waarom die controles vóór de deployment horen.
- Load tests moeten throughput, TTFT, inter-token latency, houdbare concurrency en piek-GPU-geheugen rapporteren.
vllm bench servemeet throughput en latency. Verzamel het GPU-geheugen apart met GPU-/servertelemetrie. Doorloop concurrency-niveaus tegen vastgestelde latency- en foutlimieten om een houdbaar niveau te vinden; de concurrency die in één run is waargenomen, stelt de capaciteit niet vast.
Houd voor een RAG-toepassing de vragen en het opgehaalde bewijs vast bij het vergelijken van de baseline en de gekwantiseerde generator. Die vergelijking isoleert de wijziging aan de generator. Draai daarna de volledige pipeline om het serving-resultaat te controleren, en gebruik de gids voor RAG-evaluatie om retrieval-fouten te scheiden van antwoorden zonder onderbouwing. Neem voor een agent op of dezelfde taken eindigen met geldige tool calls en acceptabele bijeffecten. Een kleiner checkpoint alleen beantwoordt geen van die vragen.
Test reasoning-models op taken met meerdere stappen. Quantization onder 4 bits, of W4A4 zonder rotatie, kan de nauwkeurigheid van reasoning schaden, zelfs als de baseline-perplexity stabiel lijkt. Dat is de kernwaarschuwing in de studie naar gekwantiseerde reasoning-models.
9. Workflow met de companion-repository
De companion-repository, slavadubrov/model-compression-demo, maakt het beslisproces reproduceerbaar. Ze gebruikt uv en richt zich op planning, recepten, dry runs en benchmark-configuraties die zijn gebaseerd op dezelfde bronnen als dit artikel: vLLM, LLM Compressor, TensorRT-LLM en de papers over de algoritmen.
Kloon haar en bekijk de ondersteunde algoritmen:
git clone https://github.com/slavadubrov/model-compression-demo.git
cd model-compression-demo
git checkout 62da4539793ac3a93e94e8551a063c7681561099
uv run python demo.py list-algorithms
Deze planningscommando’s gebruiken alleen de standaardbibliotheek van Python. Begin met planning en dimensionering:
uv run python demo.py plan \
  --model-preset qwen3-8b \
  --goal fit-memory \
  --hardware ampere \
  --context 4096 \
  --concurrency 4

uv run python demo.py estimate \
  --model-preset qwen3-8b \
  --scheme w4a16 \
  --context 4096 \
  --concurrency 4
plan kiest GPTQ W4A16 voor dit doel en toont de twee budgetten uit sectie 6: een serving-doel van 10.44 GiB en een GPU-piek van 2.35 GiB voor de quantization-job die laag voor laag werkt. estimate splitst het serving-doel op:
Architecture:     Qwen3 8B (built-in preset from official Hugging Face config)
Layers/hidden/KV: 36 / 4096 / 0.250
Note:             Causal text-generation checkpoint suitable for the text-only harness.
Scheme:           w4a16
Weights:          5.19 GiB
KV cache:         2.25 GiB
Runtime overhead: 2.00 GiB
Safety buffer:    1.00 GiB
Total target:     10.44 GiB
Weights en KV cache zijn de eerste twee termen van de serving-geheugenformule in sectie 6. Runtime overhead en Safety buffer zijn de marge die de companion rekent voor activations en overhead van de engine. De regel over de KV cache is de cache-formule met de 36 lagen, 8 KV-heads en head-dimensie 128 van Qwen3-8B, bij 4,096 tokens en 4 gelijktijdige verzoeken.
Toon daarna het recept en bekijk een voorbeeld van de quantization voordat je GPU-tijd uitgeeft:
uv run python demo.py recipe --algorithm gptq-w4a16

uv run python demo.py quantize \
  --algorithm gptq-w4a16 \
  --model Qwen/Qwen3-8B \
  --dry-run
Het recipe-commando toont de llm-compressor-code die de quantize-stap uitvoert:
from llmcompressor import oneshot
from llmcompressor.modifiers.quantization import GPTQModifier

recipe = GPTQModifier(
    scheme="W4A16",
    targets="Linear",
    ignore=["lm_head"],
)

oneshot(
    model="Qwen/Qwen3-8B",
    dataset="wikitext",
    dataset_config_name="wikitext-2-raw-v1",
    recipe=recipe,
    output_dir="outputs/Qwen3-8B-W4A16",
    max_seq_length=4096,
    num_calibration_samples=256,
)
targets en ignore bepalen welke lagen 4-bit weights krijgen; num_calibration_samples en max_seq_length zijn de calibration-keuzes uit sectie 8. WikiText is de standaard voor de smoke test; geef voor een echt checkpoint --calibration-file mee met prompts die op productie lijken.
Het GPTQ-recept schrijft een compressed-tensors-checkpoint. GPTQ is het algoritme, niet het checkpoint-formaat, dus vLLM herkent het formaat aan het checkpoint zonder --quantization-vlag, zoals in zijn officiële W4A16-voorbeeld.
Om te quantizen draai je make install-compression. vLLM heeft een eigen omgeving nodig, omdat zijn dependencies botsen met llm-compressor: draai make install-serving en gebruik daarna .venv-vllm/bin/vllm voor de serve- en bench-commando’s.
Serve en benchmark elk checkpoint tegen de RTN W8A16-baseline uit de algoritmetabel. Draai quantize zonder --dry-run voor gptq-w4a16 en rtn-w8a16 om outputs/Qwen3-8B-W4A16 en outputs/Qwen3-8B-W8A16 te schrijven. Het benchmark-plan-commando van de companion schrijft voor elk checkpoint een serve- en een benchmark-commando naar een JSON-bestand. Om de vergelijking met de hand uit te voeren, start je de W4A16-server in één terminal:
.venv-vllm/bin/vllm serve outputs/Qwen3-8B-W4A16 --host 127.0.0.1 --port 8000Draai in een tweede terminal dezelfde synthetische belasting als in sectie 5:
.venv-vllm/bin/vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model outputs/Qwen3-8B-W4A16 \
  --tokenizer Qwen/Qwen3-8B \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Stop de server en draai beide commando’s opnieuw met outputs/Qwen3-8B-W8A16, de RTN W8A16-baseline, in plaats van outputs/Qwen3-8B-W4A16.
Vergelijk ten slotte het basismodel en de gecomprimeerde models met expliciete drempels:
uv run python demo.py quality-eval \
  --base-model Qwen/Qwen3-8B \
  --compressed-model outputs/Qwen3-8B-W4A16 \
  --mode all \
  --lm-eval-task hellaswag \
  --lm-eval-limit 50 \
  --max-perplexity-delta-pct 5 \
  --output-json reports/qwen3-8b-w4a16-quality.json
Voer het werk in deze volgorde uit: plan het doel, schat het geheugen, doe een dry run van het recept, benchmark de serving en vergelijk dan de kwaliteit met drempels. Die volgorde volgt de scheiding in dit artikel tussen geheugendimensionering, runtime-benchmarking en kwaliteitsevaluatie.
10. Diffusion-models vragen een apart pad
Diffusion- en diffusion-transformer-pipelines hebben ander activation-gedrag dan autoregressieve LLMs. SVDQuant behandelt quantization van diffusion als een apart probleem met uitschieters in activations.
Autoregressieve LLMs genereren één token tegelijk. Diffusion-models voeren herhaalde denoising-stappen uit, en hun verdelingen van activations verschuiven tijdens dat proces, zoals Q-Diffusion rapporteert voor de uitvoer van het denoising-netwerk over tijdstappen heen. Een standaard 4-bit quantization-ronde voor LLMs kan geheugen van een diffusion-model besparen en tegelijk ernstige visuele artefacten veroorzaken. Methoden die op diffusion zijn gericht, zoals SVDQuant / Nunchaku en quantization van diffusion in NVIDIA ModelOpt, pakken dat andere activation-patroon aan.
In een latent-diffusion-pipeline stelt de tekstencoder de prompt voor. Een denoising-netwerk, zoals een diffusion transformer (DiT) of U-Net, werkt herhaaldelijk een gecomprimeerde beeldrepresentatie bij, een latent genoemd. De variational autoencoder (VAE) zet om tussen die latent-representaties en beelden. Deze componenten hebben verschillende taken, dus test hun precisie apart.
Gebruik het volgende als voorzichtige vuistregels, niet als algemene standaarden. De pipeline, het component, het model en de runtime hebben elk aparte tests nodig:
- Houd de VAE bij de eerste vergelijking in 16-bit. Test lagere precisie alleen als de methode en de doelpipeline dat valideren.
- Probeer eerst de DiT- of U-Net-backbone, omdat die vaak het grootste deel van de parameters bevat. Controleer geheugen, latency en beeldkwaliteit voor de doelpipeline. Quantization-methoden voor diffusion volgen dezelfde aanpak per component.
- Behandel tekstencoders apart. Het kwantiseren van T5-XXL of CLIP kan in een gegeven pipeline de aansluiting op de prompt of het weergeven van tekst beïnvloeden. Evalueer ze dus onafhankelijk in plaats van uit te gaan van algemeen transformer-gedrag.
- Gebruik methoden die diffusion kennen, zoals SVDQuant, wanneer uitschieters in activations het hoofdprobleem zijn.
- Evalueer met beelden, niet met tekstmetrics. Controleer aansluiting op de prompt, tekstweergave, huidtinten, kleurbalans, fijn detail, latency en VRAM. Om met de 16-bit pipeline te vergelijken meet je LPIPS of PSNR tussen gepaarde beelden (dezelfde seed), en de CLIP-score of ImageReward voor de aansluiting op de prompt, zoals de evaluatie van SVDQuant doet. Beoordeel daarna de moeilijke gevallen met het oog.
Als de evaluatieset alleen eenvoudige of veelvoorkomende prompts bevat, mis je fouten in randgevallen. Neem moeilijke gevallen op: kleine tekst, handen, herhaalde objecten, gestructureerde lay-outs en prompts met negatieve beperkingen. Fouten door quantization van diffusion zie je namelijk visueel, niet in de perplexity van language models.
11. Standaarden voor productie
De figuur plaatst de eerste poging voor elk type deployment op een bitbreedte-as, met de volgende test en de voorwaarde daarvoor. Elk type heeft nog steeds de controles uit sectie 8 nodig.
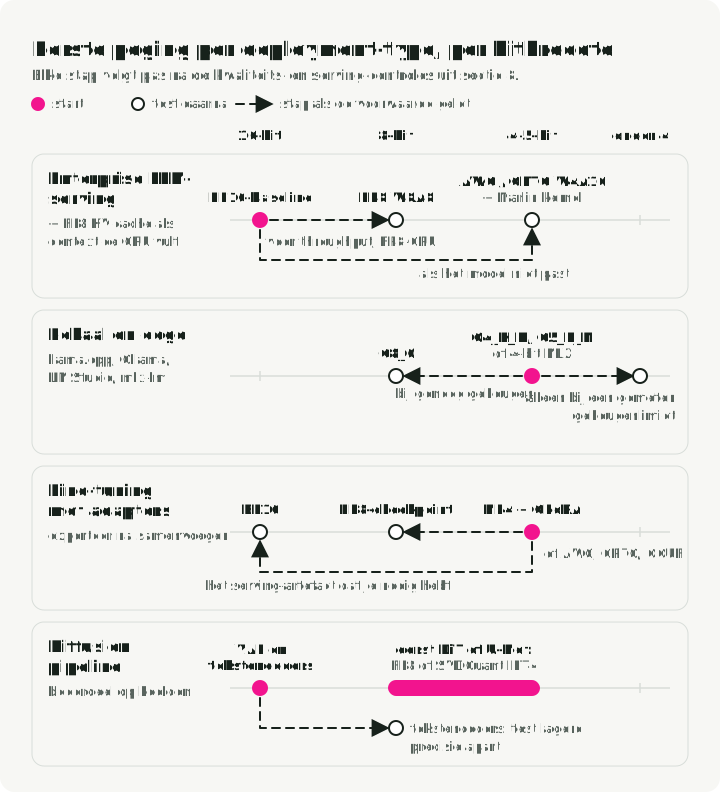
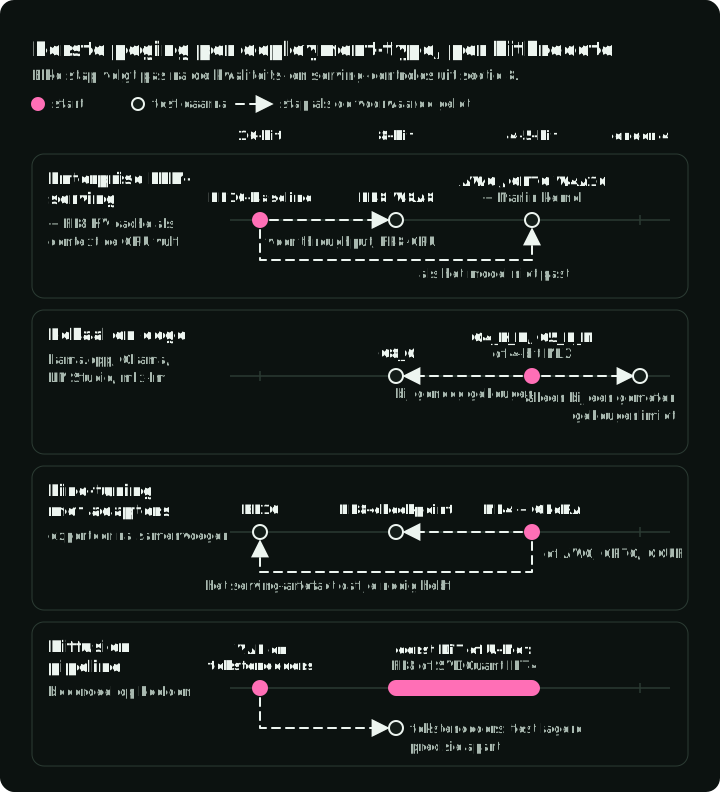
Begin voor enterprise LLM-serving met een BF16-baseline in precies de serving-engine die je wilt gebruiken. Test FP8 W8A8 als throughput het doel is en de GPU het ondersteunt. Test AWQ of GPTQ W4A16 met kernels van de Marlin-klasse als het model niet past. Test een FP8 KV cache als lange context of concurrency de GPU vult. Rol de gecomprimeerde versie alleen uit als zowel de kwaliteits- als de serving-controles slagen.
Begin voor lokale en edge-inference met een GGUF-bestand met Q4_K_M of Q5_K_M, of met een 4-bit MLX-model op een Mac. Ga over op Q8_0 als het geheugen het toelaat en vergelijk de taakkwaliteit. Gebruik coderingen onder 4 bits alleen bij een gemeten geheugenlimiet.
Gebruik voor fine-tuning NF4 met QLoRA om adapters met minder geheugen te trainen. Evalueer de adapter in de toepassing voordat je hem samenvoegt. Exporteer en evalueer na het samenvoegen het serving-artefact dat je nodig hebt: een llama.cpp-compatibel GGUF-bestand, een AWQ/GPTQ/compressed-tensors-checkpoint, een FP8-checkpoint of BF16.
Kwantiseer voor diffusion eerst de denoiser, houd de VAE in 16-bit en test tekstencoders apart, zoals in sectie 10. Vergelijk gepaarde beelden met dezelfde seed en beoordeel moeilijke prompts met het oog.
12. Draai de volgende vergelijking
Houd de BF16-baseline aan en vergelijk één ondersteunde gecomprimeerde kandidaat op dezelfde achtergehouden taken en hetzelfde verkeer. Schrijf op welk kwaliteitsverlies en welke latency je accepteert voordat je begint. Meet naast snelheid ook het piekgeheugen: het nuttige resultaat is of de kandidaat je bottleneck binnen die grenzen wegneemt.
Referenties
- JarvisLabs vLLM Benchmarks: JarvisLabs, vLLM Quantization Complete Guide and Benchmarks, 2026. JarvisLabs.
- Hugging Face Optimum Quantization Guide: Hugging Face, Quantization conceptual guide. Documentatie.
- vLLM Quantization Docs: vLLM-project, Quantization. Documentatie.
- vLLM Quantized KV Cache Docs: vLLM-project, Quantized KV Cache. Documentatie.
- vLLM Benchmark Docs: vLLM-project, vllm bench serve. Documentatie.
- LLM Compressor Docs: vLLM-project, LLM Compressor. Documentatie.
- GPTQModel: ModelCloud, GPTQModel. GitHub.
- TensorRT-LLM Quantization: NVIDIA, TensorRT-LLM Quantization. Documentatie.
- NVIDIA NVFP4: NVIDIA, Introducing NVFP4 for Efficient and Accurate Low-Precision Inference. Blog.
- Hugging Face QuantizedCache: Hugging Face, Cache strategies: Quantized cache. Documentatie.
- NVIDIA Model Optimizer: NVIDIA, Model Optimizer. GitHub.
- torchao Quantization: PyTorch, torchao quantization overview. Documentatie.
- bitsandbytes Quantization: Hugging Face, bitsandbytes. Documentatie.
- HQQ: Dropbox, Half-Quadratic Quantization. GitHub.
- PEFT: Hugging Face, Parameter-Efficient Fine-Tuning. Documentatie.
- Ollama: Ollama, lokale runtime voor models. Website.
- LM Studio: LM Studio, lokale AI-runtime. Website.
- AutoGPTQ status: AutoGPTQ-repository, gearchiveerd in april 2025. GitHub.
- AutoAWQ status: AutoAWQ-repository, gearchiveerd en verouderd verklaard in mei 2025. GitHub.
- GPTQ: Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, ICLR 2023. arXiv:2210.17323.
- Marlin: Frantar et al., MARLIN: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models, arXiv:2408.11743. arXiv:2408.11743.
- AWQ: Lin et al., AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, MLSys 2024. arXiv:2306.00978.
- SmoothQuant: Xiao et al., SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, ICML 2023. arXiv:2211.10438.
- QuaRot: Ashkboos et al., QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs, NeurIPS 2024. arXiv:2404.00456.
- SpinQuant: Meta AI Research, SpinQuant: LLM Quantization with Learned Rotations, arXiv:2405.16406. arXiv:2405.16406.
- QLoRA / NF4: Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, NeurIPS 2023. arXiv:2305.14314.
- SVDQuant / Nunchaku: MIT HAN Lab, SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models, ICLR 2025. arXiv:2411.05007, Nunchaku.
- vLLM PagedAttention: Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023. arXiv:2309.06180.
- Grouped-Query Attention: Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, EMNLP 2023. arXiv:2305.13245.
- vLLM FP8 KV Cache: Kubler, Kurtic, Wilkinson et al., The State of FP8 KV-Cache and Attention Quantization in vLLM, vLLM Blog, april 2026. vLLM Blog.
- KIVI: Liu et al., KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache, ICML 2024. arXiv:2402.02750.
- KVQuant: Hooper et al., KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization, NeurIPS 2024. arXiv:2401.18079.
- LLM Serving Evaluation: Kurtic et al., “Give Me BF16 or Give Me Death”? Accuracy-Performance Trade-Offs in LLM Quantization, ACL 2025. arXiv:2411.02355.
- Long-context Quantization Evaluation: Mekala et al., Does quantization affect models’ performance on long-context tasks?, arXiv:2505.20276. arXiv:2505.20276.
- Reasoning Evaluation: Quantization Hurts Reasoning? An Empirical Study on Quantized Reasoning Models, arXiv:2504.04823. arXiv:2504.04823.
- 2:4 Sparsity: Mishra et al., Accelerating Sparse Deep Neural Networks, arXiv:2104.08378. arXiv:2104.08378.
- k-bit Scaling Laws: Dettmers en Zettlemoyer, The case for 4-bit precision: k-bit Inference Scaling Laws, ICML 2023. arXiv:2212.09720.
- Q-Diffusion: Li et al., Q-Diffusion: Quantizing Diffusion Models, ICCV 2023. arXiv:2302.04304.
- MLX LM: Apple ml-explore, mlx-lm. GitHub.
- HumanEval: OpenAI, HumanEval. GitHub.
- MMLU: Hendrycks et al., Measuring Massive Multitask Language Understanding. arXiv:2009.03300.
- MATH-500: Hugging Face H4, MATH-500. Dataset.
- GGUF en llama.cpp: ggml-org, GGUF file format en llama.cpp. GGUF, llama.cpp.
- Hugging Face GGUF Docs: Hugging Face, GGUF. Documentatie.
- Referentierepository: slavadubrov/model-compression-demo.