Гайд по квантизации моделей: от основ до продакшен-сервинга

Автоматический перевод
Эта статья была автоматически переведена с оригинальной английской версии.
Этот гайд по квантизации написан для инженеров, которые деплоят языковые модели и хотят сократить расход памяти или ускорить сервинг. Вы узнаете, как выбрать, что сжимать, как подобрать числовой формат под свое железо и рантайм и как сравнить память, латентность и качество ответов до деплоя. Отдельно разобраны проверки для диффузионных моделей изображений.
Квантизация уменьшает число бит, которыми хранятся веса, активации или KV cache. Веса — это параметры модели, выученные при обучении. Активации — промежуточные значения, которые вычисляются для каждого входа. Key-value (KV) cache хранит значения предыдущих токенов, чтобы переиспользовать их при генерации. Сжатие весов может уместить модель в память GPU, но оставить слишком мало места для длинного диалога. Какой лимит вы снимете, зависит от того, что вы сжимаете, и от GPU-кода, который это выполняет.
Начните с того, что делает запрос медленным или слишком большим. Обработка входного промпта называется префиллом; генерация ответа по одному токену — декодом. Префилл может упираться в арифметику GPU, а декод — в скорость загрузки весов из памяти. Веса модели и растущий KV cache тоже могут исчерпать память GPU. Первая таблица сопоставляет эти проблемы с возможными решениями; следующие разделы объясняют расчеты и проверки, которые нужны до деплоя.
Меньшая разрядность — лишь кандидат. Для решения нужны и результаты по качеству на задаче, и замеры сервинга для той модели, того рантайма и того трафика, которые вы будете использовать. Бенчмарки здесь — опубликованные результаты других команд и один короткий прогон из репозитория-компаньона.
Краткое сравнение артефактов и методов смотрите в статье LLM Quantization Formats.
1. Боттлнеки и стартовые форматы
Прежде чем выбирать разрядность, выясните, что ограничивает нагрузку. Это может быть память под веса модели, вычисления на префилле, пропускная способность памяти при декоде или KV cache, а не сама числовая точность.
Обозначения в рецептах сервинга
- W4A16 хранит веса в 4-битном виде, а активации оставляет в 16-битной точности. В общем случае W{x}A{y} задает точность весов и активаций в поддерживаемых операциях, обычно в матричном умножении. W8A8 использует 8-битные веса и активации в этих операциях, но не определяет автоматически тип данных, в котором хранится каждый тензор рантайма.
- FP8, INT8, INT4, NF4 — числовые форматы. Они определяют, какие значения можно представить.
- GPTQ, AWQ, SmoothQuant, QuaRot — алгоритмы. Они определяют, как отобразить обученную модель в формат с меньшей точностью.
- GGUF — файловый формат, который хранит тензоры и метаданные для GGML и рантаймов в стиле
llama.cpp. Файл GGUF может содержать неквантизованные типы тензоров, такие какF16,BF16илиF32, а также квантизованные кодировки. Среди пресетов естьQ4_K_M,Q5_K_M,Q8_0,IQ*,TQ*иMXFP4. Выбор квантизации определяет кодировка тензора. Одно лишьGGUFне описывает рецепт сервинга FP8 W8A8 в стиле CUDA. - KV cache — кэш аттеншна, который используется при генерации. Он хранит прошлые ключи и значения, чтобы модель не пересчитывала весь диалог на каждом токене.
- Квантизация KV cache хранит закэшированные тензоры активаций key/value в кэше с меньшей точностью, например FP8, INT8, INT4 или INT2, в зависимости от поддержки рантайма. Это не то же самое, что prefix caching, PagedAttention или offload: они решают, переиспользуются ли записи кэша, как они размещаются и где хранятся.
- GEMM — general matrix multiply, то есть общее матричное умножение. Большую часть времени инференса трансформера занимает именно оно.
Что квантизуется
Рецепт выбирает, какие тензоры сжимать. Обычно выбирают так:
| Тензор | Обычно квантизуется? | Почему |
|---|---|---|
| Веса линейных слоев | Да, в рецептах W4A16 и W8A8 | Веса не меняются после обучения, поэтому их масштабы можно вычислить офлайн. |
| Активации | Только в рецептах W8A8, W4A8 или W4A4 | Они меняются с каждым входом, поэтому нужны откалиброванные или рантайм-масштабы. |
| KV cache | Опционально, отдельная настройка рантайма | Он растет с контекстом и батчем; разбираем в разделе 6. |
Эмбеддинги и lm_head | Обычно остаются в 16 бит | В рецептах LLM Compressor lm_head указан в ignore; это исключение описано в разделе 8. |
| VAE и текстовые энкодеры диффузии | Для первого теста остаются в 16 бит | Раздел 10 проверяет их отдельно от денойзинговой сети. |
Боттлнеки и с чего начинать
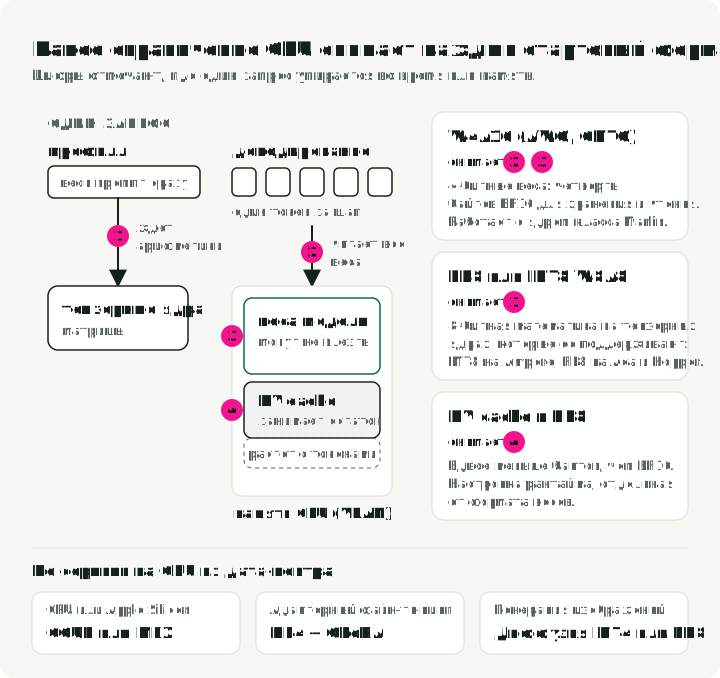
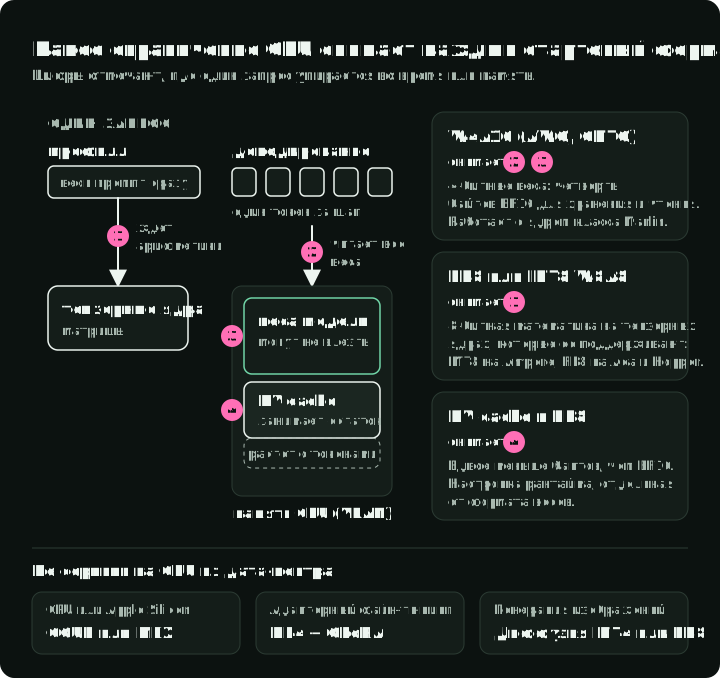
Таблица сопоставляет типичные боттлнеки со стартовым форматом. Она использует обозначения выше.
| Если проблема в этом | Начните с | Типичные инструменты | Что проверить перед деплоем |
|---|---|---|---|
| Веса модели не помещаются в VRAM | Weight-only квантизация W4A16 | AWQ или GPTQ через llm-compressor или GPTQModel | Перплексию, кодинг, ризонинг, следование инструкциям |
| Высоконагруженный сервинг упирается в вычисления | FP8 или INT8 W8A8 | FP8 PTQ, SmoothQuant, TensorRT-LLM, vLLM | Throughput, время до первого токена (TTFT), точность на задачах |
| Длинный контекст или высокая конкурентность заполняют GPU | Квантизация KV cache | vLLM, TensorRT-LLM или Transformers QuantizedCache | Retrieval на длинном контексте, латентность, безопасность и качество |
| Локальный инференс на CPU, Apple Silicon или десктопе | Файлы GGUF с локальными кодировками тензоров | llama.cpp, Ollama, LM Studio, MLX | Латентность промпта, расход RAM, выбранную кодировку тензоров и субъективное качество ответов |
| Файн-тюнинг адаптеров должен уместиться на одном GPU | NF4 / QLoRA | bitsandbytes, peft | Loss при файн-тюнинге и качество смерженной модели |
| Пайплайн генерации изображений слишком большой или медленный | INT4 или FP8 для диффузионных моделей | SVDQuant, Nunchaku, torchao, NVIDIA ModelOpt | Визуальные артефакты, соответствие промпту, латентность, VRAM |
Рисунок показывает, где один запрос на сервинговом GPU упирается во время или память и какой начальный формат снимает каждое ограничение. Нижняя строка покрывает случаи, не относящиеся к сервингу на GPU из дата-центра.
2. Квантизация — это контролируемое округление
Квантизация отображает значения высокой точности в меньший набор представимых значений. Это базовое определение и у Hugging Face Optimum, и у TensorRT-LLM. Вы экономите память и пропускную способность, но получаете ошибку округления.
INT4 дает всего 16 дискретных значений, поэтому отображение 16-битных весов BF16 на такую сетку создает ошибку округления. Методы квантизации оценивают округление по тому, как оно меняет выход слоя, а не отдельные веса. GPTQ оценивает, как решения об округлении влияют на этот выход, и подстраивает оставшиеся веса, чтобы уменьшить ошибку. AWQ по наблюдаемым активациям находит важные группы весов, называемые каналами, и масштабирует их перед округлением. Хорошее отображение экономит память почти без потери качества. Плохое портит ризонинг, следование инструкциям или визуальную точность.
Симметричное и асимметричное отображение
Следуя аффинному отображению из распространенных руководств по квантизации, квантизация отображает непрерывное значение с плавающей точкой на дискретную сетку.
- и — выбранные нижняя и верхняя границы в формате с плавающей точкой.
- — исходное значение высокой точности.
- — квантизованное значение.
- — масштаб, или размер шага.
- — нулевая точка (zero point), целое число, которое представляет
0.0. - — целевой целочисленный диапазон. В этом симметричном примере взят : в нем 15 значений, и ноль представляется точно. Другие знаковые форматы INT4 используют все 16 значений, например .
Симметричная квантизация центрирует сетку вокруг нуля и задает :
Это удобно для железа: в рантайме не нужно вычитать смещение нулевой точки. Стек квантизации PyTorch предоставляет эти аффинные варианты масштаба и нулевой точки как примитивные параметры квантизации в torchao.
Асимметричная квантизация сдвигает сетку, чтобы покрыть смещенные диапазоны:
Сдвинутая сетка может лучше сохранять активации, которые принимают только положительные значения, но смещение добавляет работы, если ядро не обрабатывает его эффективно.
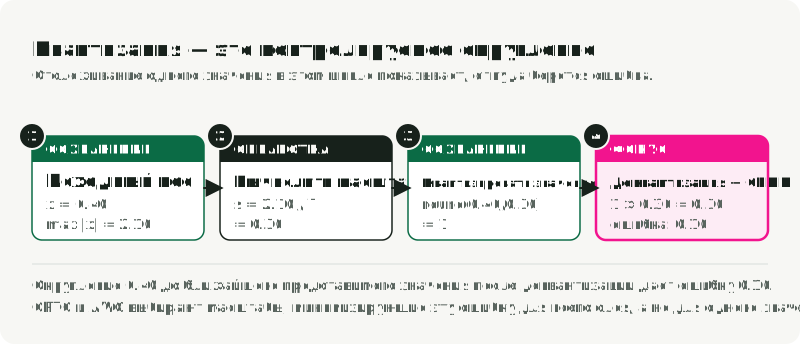
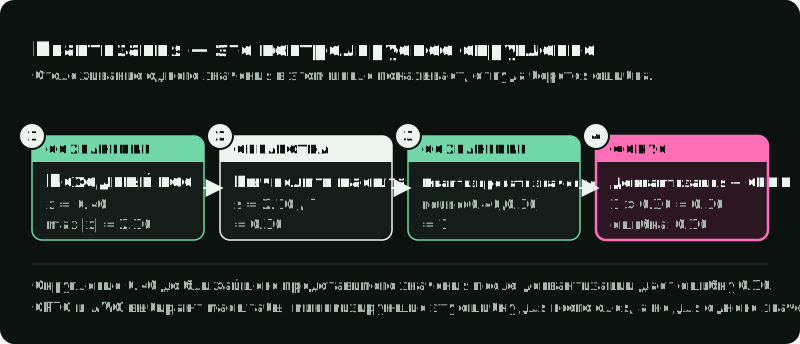
На рисунке разобран симметричный случай: максимальная величина 2.10 дает масштаб 0.30, поэтому вес 0.40 округляется до целого 1. Деквантизация умножает это сохраненное целое на масштаб и возвращает приближенное значение 0.30. Разница с 0.40 и есть ошибка округления.
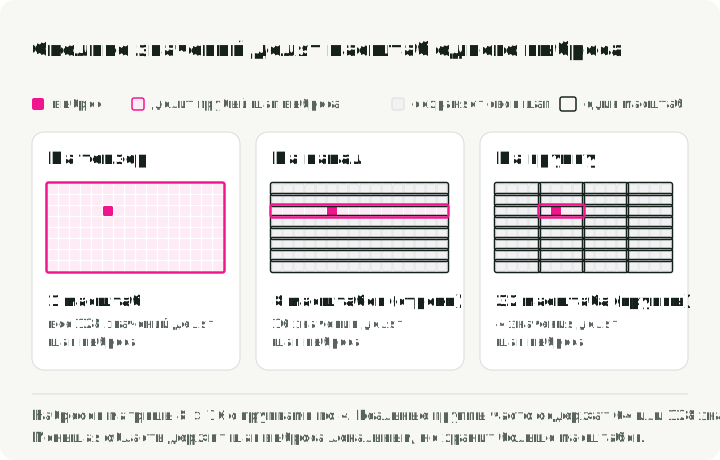
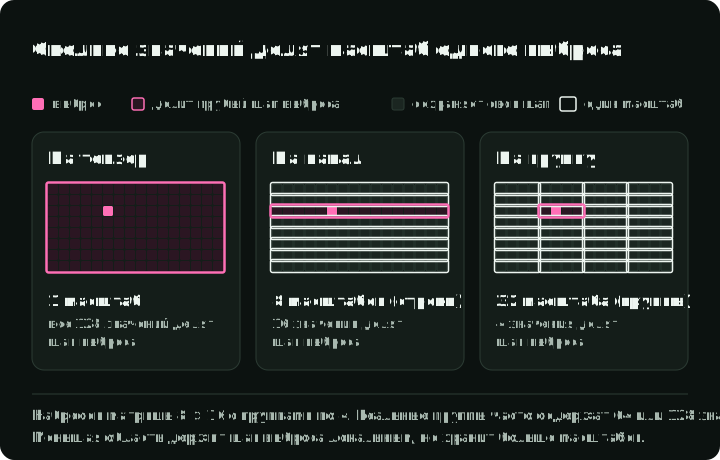
Гранулярность масштаба: тензор, канал, группа
Один масштаб может покрывать весь тензор весов, один канал или небольшую группу значений. Документация vLLM по FP8 KV cache проводит то же различие между стратегиями масштаба на тензор и на attention head. Меньшие группы обычно лучше сохраняют качество, но требуют больше метаданных масштабов.
| Гранулярность масштаба | Что делит один масштаб | Влияние на качество и выполнение |
|---|---|---|
| На тензор | Вся матрица весов | Хранит мало метаданных, но один выброс может растянуть сетку и снизить точность во всем слое. |
| На канал | Одна выходная строка | Не дает каналам с узким диапазоном делить более широкий диапазон другого канала. Многие 8-битные пути для весов используют эту гранулярность. |
| На группу | Блок внутри строки, часто 64 или 128 значений | Ограничивает выброс небольшим блоком ценой большего числа масштабов. AutoGPTQ использует group_size=128 в своих примерах GPTQ. |
Рисунок помещает один выброс в небольшую матрицу-набросок и считает, сколько значений делят его масштаб при каждом выборе.
Веса статичны, поэтому их масштабы можно вычислить офлайн, до загрузки модели. Активации меняются с каждым токеном, поэтому их диапазоны зависят от нагрузки.
| Масштабирование активаций | Когда рантайм выбирает масштаб | Преимущество | Сбой или цена |
|---|---|---|---|
| Статическое | Офлайн, по калибровочному датасету | Не требует вычислять масштаб во время инференса. | Промпты вне калиброванной длины или распределения могут обрезать пики активаций и испортить вывод. |
| Динамическое | При каждом прямом проходе | Подстраивается под текущие значения активаций и смесь промптов. | Вычисление диапазонов на каждом слое добавляет работы и требует оптимизированных ядер. |
KV cache стоит между этими случаями: ключи и значения — это активации, вычисленные в рантайме и затем сохраненные для следующих токенов, поэтому им нужны собственные масштабы. Как рантаймы их хранят, описано в разделе 6.
PTQ и QAT выполняются на разных этапах
Post-training quantization, или PTQ, сжимает уже обученную модель. Quantization-aware training, или QAT, подвергает модель шуму квантизации во время обучения, чтобы она могла к нему адаптироваться.
| Метод | Когда определяются диапазоны | Когда использовать | Цена |
|---|---|---|---|
| Weight-only PTQ | Офлайн, для статичных весов | Модель не помещается или декод упирается в пропускную способность | Активации по-прежнему считаются в 16 бит |
| Статический PTQ | Офлайн, по калибровочным промптам | Нужен быстрый сервинг W8A8 | Калибровочные данные должны совпадать с продакшеном |
| Динамический PTQ | В рантайме, на батч или путь активации | Распределения входов сильно меняются | Дополнительная работа в рантайме и более узкая поддержка железа |
| QAT | Во время обучения | PTQ ломает качество чувствительной модели | Полная инфраструктура обучения и намного больше вычислений |
Калибровочные данные должны быть похожи на трафик, который вы будете обслуживать. Например, путь калибровки KV cache в vLLM использует курируемый датасет через llm-compressor. Если продакшен-промпты — это длинные трейсы RAG, короткие абзацы из Wikipedia могут не покрыть диапазоны активаций, которые дают эти трейсы. Для статических масштабов активаций и кэша диапазоны выбирает калибровка. В GPTQ и AWQ калибровочные активации еще и определяют, как округляется или масштабируется каждый вес, поэтому калибровка на коротких текстах может повлиять на сохраненные веса. Реальные промпты с длинным контекстом могут давать другие паттерны активаций. Этот риск напрямую измеряют оценки квантизации на длинном контексте.
3. Числовые форматы определяют требования к железу
Числовой формат определяет, какие значения модель может представить в памяти. Для эффективных вычислений нужны рантайм-ядра и железо, которые поддерживают ту же разрядность и тот же формат. TensorRT-LLM документирует и список рецептов, и матрицу поддержки железа.
| Формат | Хранение на значение | Хороший выбор по умолчанию для | Главное, за чем следить |
|---|---|---|---|
| BF16 / FP16 | 2 байта | Базовый инференс и сервинг, совместимый с обучением | Большой расход VRAM и высокий трафик по пропускной способности памяти |
| FP8 | 1 байт | Высоконагруженный сервинг W8A8 на Ada, Hopper, Blackwell | Нужны нативные FP8 tensor cores и поддержка рантайма |
| INT8 | 1 байт | Сервинг W8A8 на старом или не-NVIDIA железе | Выбросы активаций и чувствительность к статической калибровке |
| INT4 | 0.5 байта | W4A16, когда главный лимит — память под веса | Потеря качества на небольших моделях и моделях с тяжелым ризонингом |
| FP4 / NVFP4 | ~0.5 байта | Эксперименты эпохи Blackwell и ранние пути сервинга | Требования к компилятору и рантайму, привязанные к железу |
| Кодировки / пресеты llama.cpp GGUF | Переменное | Локальный инференс на CPU, Apple Silicon, десктопе и edge | GGUF — это контейнер. Выбор квантизации — это кодировка тензора. |
| NF4 | 0.5 байта | Обучение адаптеров QLoRA | Обычно неподходящий формат экспорта для продакшен-сервинга |
BF16 и FP16 занимают по 16 бит, но распределяют точность по-разному и поэтому по-разному ломаются. BF16 сохраняет 8-битный диапазон экспоненты FP32 и труднее переполняется. У FP16 больше бит мантиссы и уже диапазон экспоненты, поэтому пики активаций требуют большего внимания. В оценке Kurtic et al. при сравнении форматов сервинга FP8, INT8 и INT4 BF16 явно взят как базовая линия.
У FP8 два распространенных варианта. E4M3 дает больше точности и обычно используется для весов и активаций на прямом проходе. E5M2 дает больший динамический диапазон и полезнее для градиентов или нестабильных путей активаций. vLLM поддерживает оба варианта: dtype FP8 E4M3 и E5M2 для KV cache. В исследовании Kurtic et al. на ACL 2025 «Give Me BF16 or Give Me Death» FP8 W8A8 оказался практически без потерь на семействе Llama-3.1 по итогам более чем 500 000 оценок. Результат относится к этому семейству моделей, набору оценок и конфигурации сервинга. Каждому деплою нужна своя проверка качества перед релизом.
Blackwell добавляет микромасштабируемые (microscaling) форматы, такие как MXFP8 и NVFP4. Вместо одного масштаба на весь тензор или строку микромасштабирование использует крошечные блоки. Разбор NVFP4 от NVIDIA описывает 4-битные значения с плавающей точкой в блоках по 16, с масштабами FP8 и масштабом FP32 более высокого уровня. Такой подход стремится дать размер, близкий к INT4, и поведение чисел с плавающей точкой. Но он требует подходящей архитектуры железа, компилятора и поддержки рантайма, поэтому TensorRT-LLM перечисляет поддержку FP4 и FP8 по поколениям GPU.
4. Weight-only и weight-activation квантизация
Обозначение WxAy описывает точность весов и активаций, которые по-разному нагружают GPU при инференсе. Рисунок прослеживает путь весов из VRAM через ядро к тензорным ядрам для BF16, W4A16 и W8A8.
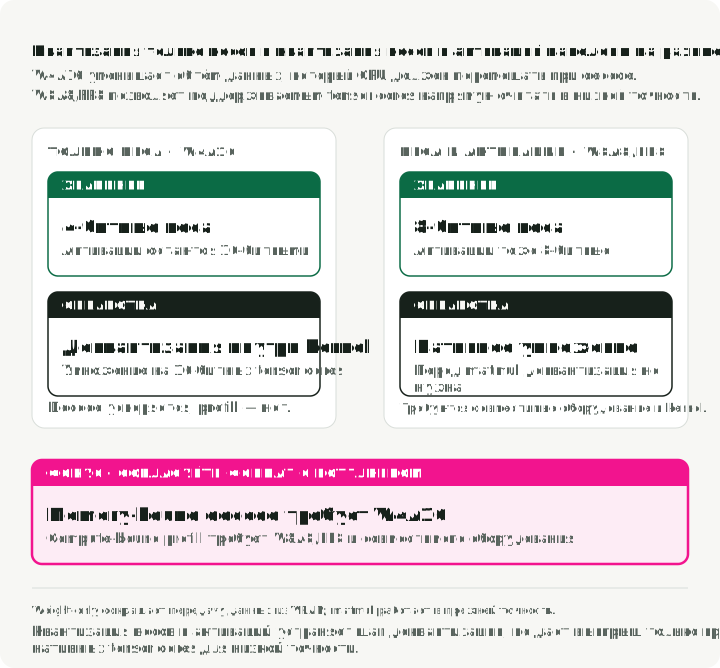
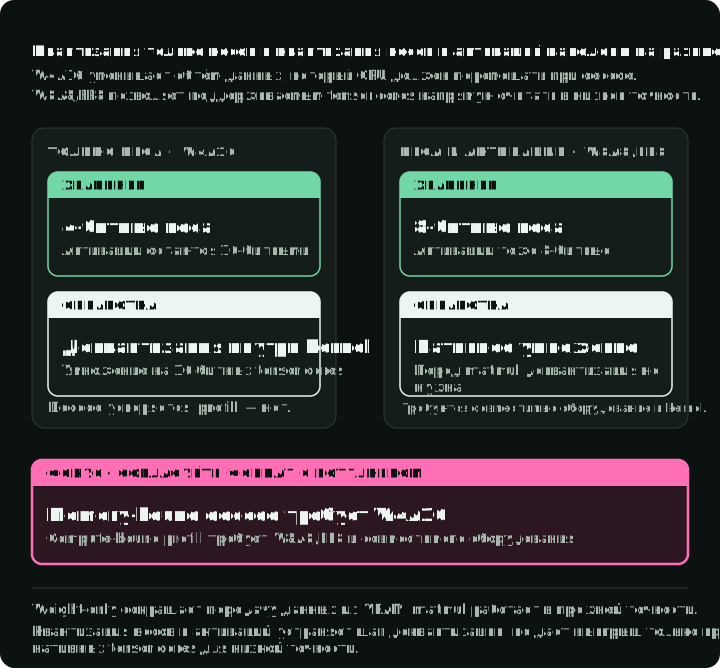
На префилле модель обрабатывает входной промпт. Эта фаза обычно упирается в вычисления, потому что GPU выполняет большие матричные умножения; поэтому рецепты W8A8 FP8/INT8 важны для сервинга, нацеленного на throughput.
На декоде модель генерирует по одному токену. Эта фаза часто упирается в пропускную способность памяти, потому что GPU постоянно загружает веса из VRAM, чтобы получить следующий токен. Weight-only работы, такие как GPTQ и AWQ, снижают эту нагрузку, уменьшая число байт весов.
W4A16 сжимает веса и оставляет активации в BF16 или FP16. GPU загружает меньше байт весов, а затем деквантизует их обратно в форму с большей точностью для умножения. Это помогает при декоде и когда модель не помещается в память. Префилл, упирающийся в вычисления, может почти не выиграть, потому что матричная математика все равно идет в 16 бит.
W8A8 сжимает веса и тензоры активаций, которые используют поддерживаемые matmul-ядра. Если у железа есть нативные tensor cores низкой точности, движок сервинга может выполнять матричную математику сразу в FP8 или INT8. Поэтому FP8 может ускорить высоконагруженный сервинг: он уменьшает трафик памяти и использует более быструю арифметику. У KV cache своя настройка хранения, поэтому dtype кэша или реализацию кэша в рантайме нужно проверять отдельно.
В закоммиченном прогоне репозитория-компаньона (RTX 4090, vLLM 0.23.0, один повтор по 64 сгенерированных токена) Qwen3-8B с онлайн-динамической квантизацией FP8 в vLLM выдала 122 tok/s против 85 tok/s у BF16 и загрузила 8.8 GiB весов вместо 15.3 GiB. Добавление FP8 KV cache снизило скорость до 49 tok/s. Прогон слишком короткий, чтобы определять по нему емкость, но он показывает, что каждую настройку нужно измерять отдельно.
5. Алгоритмы и рантайм-ядра
Алгоритмы квантизации (например, GPTQ или AWQ) определяют, как веса модели отображаются в меньшую точность. Рантайм-ядра (например, Marlin или собственные ядра vLLM) — это низкоуровневый GPU-код, который выполняет матричное умножение. Сильно сжатая модель будет работать быстро, только если для ее конкретного формата квантизации есть оптимизированное ядро.
Рецепт сервинга называет по одному элементу из каждого слоя: алгоритм (GPTQ, AWQ), формат чекпоинта (compressed-tensors, GGUF), рантайм (vLLM, llama.cpp) и ядро (Marlin). Один и тот же чекпоинт AWQ может работать с очень разной скоростью в зависимости от ядра.
График сопоставляет каждый 4-битный чекпоинт с ядром Marlin и без него в одном опубликованном бенчмарке. Таблица ниже добавляет перплексию и TTFT.
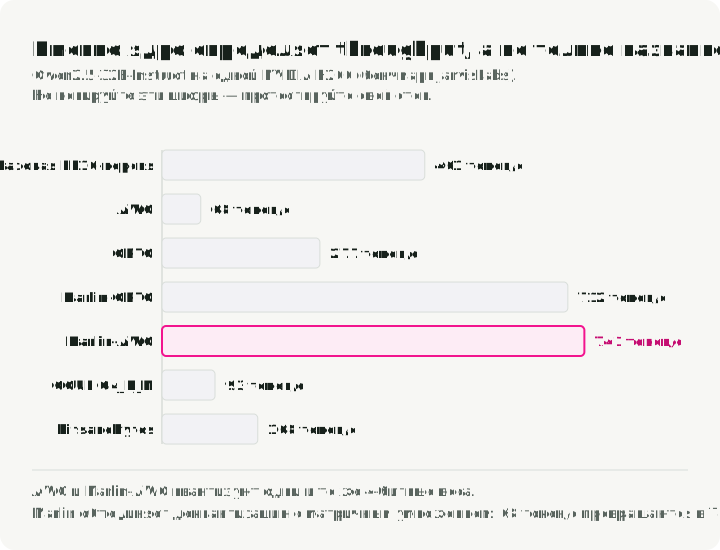
Бенчмарк vLLM от JarvisLabs прогнал Qwen2.5-32B-Instruct на NVIDIA H200. Перплексия показывает, насколько хорошо модель предсказывает тестовый текст; чем ниже, тем лучше. HumanEval pass@1 измеряет успешность решения задач по коду с одним сгенерированным решением. Output tokens/s — это throughput генерации, а mean TTFT — среднее ожидание первого выходного токена:
| Квантизация / ядро | Перплексия Wikitext-2 ↓ | HumanEval pass@1 ↑ | Output tokens/s | Mean TTFT |
|---|---|---|---|---|
| FP16 baseline | 6.56 | 56.1% | 461 tok/s | 57.7 ms |
| AWQ | 6.84 | 51.8% | 68 tok/s | 277.8 ms |
| GPTQ | 6.90 | 46.3% | 277 tok/s | 107.1 ms |
| Marlin-GPTQ | 6.97 | 45.7% | 712 tok/s | 51.9 ms |
| Marlin-AWQ | 6.84 | 51.8% | 741 tok/s | 73.5 ms |
| GGUF Q4_K_M | 6.74 | 51.8% | 93 tok/s | 958.0 ms |
| bitsandbytes | 6.67 | 51.8% | 168 tok/s | 135.3 ms |
Тест скорости вендора использует 200 промптов ShareGPT, максимальную конкурентность 10 и seed 42. Качество получено в отдельных прогонах на Wikitext-2 и HumanEval. Отчет не фиксирует версию vLLM и ревизии моделей, поэтому это результаты, о которых сообщил вендор, а не независимо воспроизведенное сравнение. Они показывают более узкую вещь: по названию алгоритма на чекпоинте нельзя понять, насколько быстрым будет сервинг.
Например, AWQ и Marlin-AWQ используют одни и те же 4-битные веса. Реализация Marlin намного быстрее, потому что ее CUDA-ядро сливает деквантизацию и матричное умножение в одну сильно оптимизированную операцию на GPU.
Для собственного сравнения сначала создайте или получите совместимый с vLLM чекпоинт AWQ по указанному ниже пути; эти команды модель не квантизуют. Установите сборку vLLM, которую поддерживает ваш GPU, и запустите сервер в одном терминале:
vllm serve ./outputs/Qwen2.5-32B-Instruct-AWQ-W4A16 \
  --served-model-name qwen2.5-32b-awq \
  --host 127.0.0.1 \
  --port 8000
Оставьте сервер работать. Во втором терминале запустите vllm bench serve, указав настоящий токенизатор отдельно от алиаса модели в API:
vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model qwen2.5-32b-awq \
  --tokenizer Qwen/Qwen2.5-32B-Instruct \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Это синтетический load test с целевыми 1 024 входными и 256 выходными токенами на запрос. Он не воспроизводит таблицу на ShareGPT и не проверяет качество. Повторите его для базовой линии и каждого подготовленного чекпоинта с тем же токенизатором, длинами, seed и конкурентностью. Записывайте фактическое число токенов и установленную версию vLLM. Для этих примеров команд нужны подготовленный чекпоинт и целевой GPU.
Отслеживайте throughput, TTFT, межтокенную латентность (задержку между последовательными токенами), расход памяти и качество на задачах. Когда часть этих показателей меняется в противоположные стороны, именно этот компромисс нужно увидеть до релиза.
Сравнение алгоритмов квантизации
Эти методы решают разные задачи сжатия:
| Алгоритм | Типичный формат | Что старается сохранить | Главная цена |
|---|---|---|---|
| GPTQ | W4A16 | Выход слоя, используя оценки Гессиана влияния изменения весов на ошибку выхода | Медленная калибровка и более сложная обработка |
| AWQ | W4A16 / W4A8 | Важные каналы активаций | Нужны калибровка и fused-ядра для сервинга |
| SmoothQuant | W8A8 | Поведение активаций INT8: масштаб выбросов переносится в веса | Подбор масштабов под каждую модель |
| QuaRot / SpinQuant | W4A4 / W4A8 | Меньшее влияние выбросов активаций за счет поворотов | Сложность поворотов в рантайме |
| HQQ | W4A16 / W2A16 | Быстрое weight-only сжатие без калибровки | Качество нужно проверять на целевых задачах при очень малой разрядности |
| QLoRA (NF4) | NF4 | Память при обучении адаптеров | Не лучший выбор по умолчанию для сервинга |
| llama.cpp GGUF K-quants / IQ-quants | Смешанные низкобитные кодировки тензоров | Качество локального инференса на байт | Не рассчитаны на облачный батч-сервинг |
| RTN (round-to-nearest) | W8A16 / FP8 | Ничего, кроме масштаба; калибровочные данные не нужны | Большая потеря качества на 4 битах; годится как базовая линия |
| FP8 dynamic | W8A8 FP8 | Диапазон активаций на токен в рантайме; калибровочные данные не нужны | Нужны FP8 tensor cores; на старых GPU ускорения может не быть |
AutoGPTQ был архивирован в апреле 2025 года, а AutoAWQ — архивирован и официально объявлен устаревшим в мае 2025 года. Для новых чекпоинтов compressed-tensors, которые читает vLLM, начинайте с llm-compressor. Используйте GPTQModel, когда нужен активно поддерживаемый путь GPTQ с Marlin, Machete, опциями памяти для MoE или дисковым offload.
Прунинг и дистилляция тоже снижают стоимость сервинга, но в отдельных процессах. Структурная разреженность 2:4 удаляет веса по шаблону, который могут использовать разреженные tensor cores NVIDIA. Дистилляция обучает меньшую модель-студента копировать большую, что может хорошо работать для узких задач. Рассматривайте любой из этих путей, только если проект может позволить себе дополнительную работу по прунингу или обучению.
6. Память при сервинге — это не только веса
Сжатый чекпоинт — лишь часть памяти, которую занимает сервинг. Оцените весь рантайм, прежде чем решать, хватит ли квантизации весов. PagedAttention называет KV cache одной из главных статей расхода памяти при сервинге.
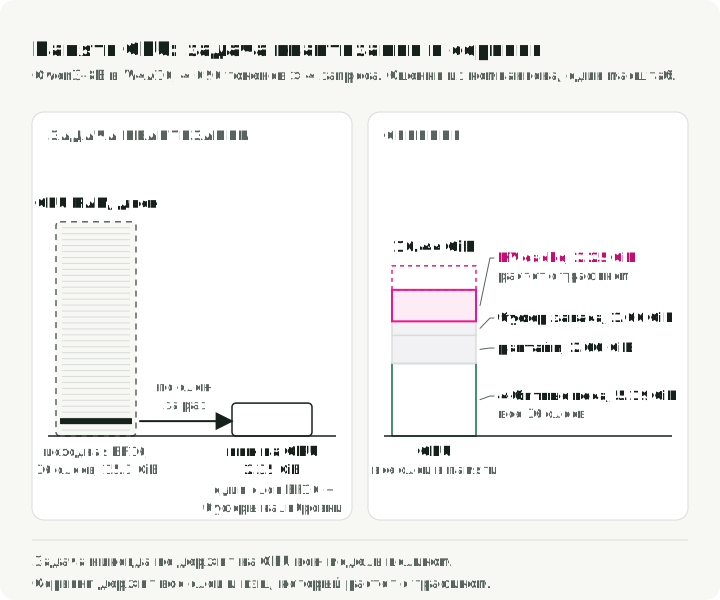
Офлайн-квантизация может быть ограничена размером слоя. Инструменты вроде llm-compressor умеют загрузить блок трансформера, выполнить калибровку и математику квантизации, записать сжатый блок и перейти к следующему. Тогда пиковая память GPU ближе к самому большому активному слою плюс буферы калибровки. CPU RAM и диск под исходный чекпоинт все равно нужны, но GPU не всегда хранит всю модель в BF16.
Пик памяти GPU при офлайн-квантизации может выглядеть так:
Рисунок рисует оба бюджета в одном масштабе на примере оценки из компаньона для Qwen3-8B W4A16 из раздела 9. Левая панель — это офлайн-задача; правая — то, что должно оставаться на GPU при сервинге.
Для сервинга, целиком размещенного на GPU, все сжатые веса должны поместиться на GPU сервинга вместе с KV cache и буферами рантайма. Weight offload снижает расход памяти GPU ценой передач данных. KV cache растет с длиной контекста и размером активного батча. Для однородных слоев аттеншна и запросов одинаковой длины размер его тензоров примерно равен:
Эта оценка не учитывает накладные расходы аллокатора, метаданные масштабов кэша и общие префиксы. Для запросов разной длины замените на сумму их закэшированных длин.
Здесь:
- — число слоев.
- — число key-value attention heads. Grouped-query attention уменьшает его: много query heads делят меньшее число KV heads.
- — размерность каждой головы, часто 128 или 256.
- — токены промпта плюс сгенерированные токены.
- — активный батч сервинга.
- равно 2 для BF16 или FP16 и 1 для FP8 или INT8. Режим FP8 KV cache в vLLM — пример стека сервинга, который использует эта статья.
Квантизация KV cache меняет хранение, а переиспользование меняет размещение
KV cache можно квантизовать во время инференса. Каждый шаг декода порождает тензоры активаций K и V для нового токена. Модель W8A8 уже может использовать FP8 или INT8 для поддерживаемой математики проекций, но кэш остается отдельным объектом хранения.
Многие стеки сервинга хранят этот объект в dtype модели или кэша. Чтобы его изменить, включите dtype KV cache, используйте чекпоинт с масштабами кэша или выберите реализацию квантизованного кэша.
Когда квантизация KV cache включена, движок записывает элементы как представление с меньшей точностью плюс масштабы. Затем аттеншн либо деквантизует кэш внутри своего ядра, либо, на некоторых бэкендах, выполняет часть операции аттеншна прямо в квантизованной области.
Стабильная документация vLLM по Quantized KV Cache показывает это напрямую через kv_cache_dtype="fp8" или --kv-cache-dtype fp8. vLLM поддерживает форматы кэша FP8 E4M3 и E5M2, а также стратегии масштаба на тензор и на attention head. Он может использовать масштабы по умолчанию или калибровку по датасету через llm-compressor. С FlashAttention 3 vLLM может также выполнять операции аттеншна в области FP8, квантизуя не только ключи и значения, но и запросы. Чтобы включить FP8 кэш для модели:
vllm serve Qwen/Qwen3-8B --kv-cache-dtype fp8 --max-model-len 32768TensorRT-LLM поддерживает FP8 KV cache через KvCacheConfig(dtype='fp8') и перечисляет FP8 KV cache и NVFP4 KV cache как рецепты квантизации, отдельные от квантизации весов и активаций. У Hugging Face Transformers тоже есть путь QuantizedCache через cache_implementation="quantized": hqq поддерживает форматы кэша int2, int4 и int8, а quanto — int2 и int4.
Обычное KV-кэширование хранит прошлые ключи и значения, чтобы не пересчитывать их. Prefix caching переиспользует блоки кэша между запросами с одним и тем же префиксом. PagedAttention уменьшает фрагментацию и улучшает размещение, а KV offload перемещает блоки кэша между уровнями памяти. Допустимость этих комбинаций зависит от рантайма. QuantizedCache в Hugging Face не поддерживает offload. vLLM документирует свой квантизованный KV cache отдельно от prefix caching и других функций управления кэшем. Проверяйте каждую комбинацию в том рантайме, который вы деплоите.
Риск для качества тоже отличается от weight-only PTQ. Квантизация KV cache вносит ошибку в состояние аттеншна, которое читается на каждом последующем шаге декода. Тестируйте отдельно retrieval на длинном контексте, поведение в многоходовых диалогах, безопасность и отказы, формат tool use и латентность вывода. KVQuant, KIVI и исследование FP8 KV cache в vLLM рассматривают квантизацию KV cache как самостоятельную задачу.
Рабочий пример показывает, когда кэш становится больше весов. Возьмем Llama-3.1-70B (80 слоев, 8 KV heads, размерность головы 128), которая обслуживает 8 запросов по 32 768 токенов:
def kv_cache_gb(layers, kv_heads, head_dim, tokens, batch, bytes_per_value):
    return 2 * layers * kv_heads * head_dim * tokens * batch * bytes_per_value / 1e9

# Llama-3.1-70B: 80 layers, 8 KV heads, head dimension 128
for name, nbytes in [("BF16", 2), ("FP8", 1)]:
    print(name, round(kv_cache_gb(80, 8, 128, 32_768, 8, nbytes), 1), "GB")
Он выводит BF16 85.9 GB и FP8 42.9 GB. При такой нагрузке кэш в BF16 (86 GB) больше весов INT4: около 40 GB с учетом масштабов групп и 16-битных эмбеддингов, против 35 GB, которые таблица из раздела 7 дает только для 4-битных значений. FP8 кэш экономит 43 GB; переход весов с BF16 на INT4 экономит около 100 GB. Здесь сначала идет квантизация весов, а кэш остается самой большой из оставшихся статей. На графике после каждого шага складываются веса и кэш.
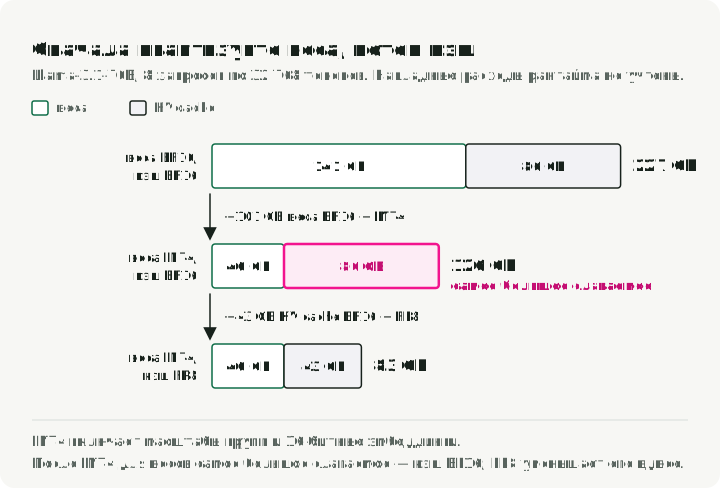
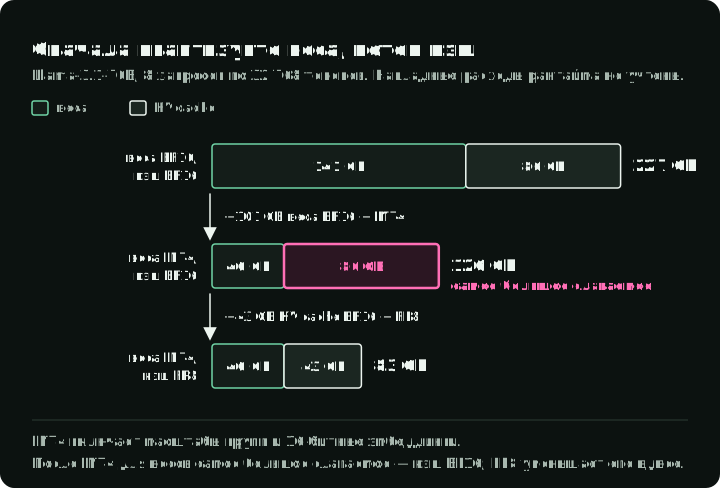
Сравните, сколько памяти сэкономит каждое изменение для вашей модели. Используйте приведенное выше уравнение кэша с одинаковыми батчем и длиной контекста для текущего и предлагаемого dtype кэша. Вычтите предлагаемый размер из текущего. Сделайте то же самое для двух форматов весов, которые вы рассматриваете. Например, сравните экономию от перехода кэша с BF16 на FP8 с экономией от перехода весов с BF16 на INT4. Сначала проверьте вариант с большей расчетной экономией, если рантайм его поддерживает. Затем измерьте реальный расход памяти и качество: ни одна из оценок не включает все выделения памяти, которые делает рантайм.
7. Размер весов и поддержка GPU
Объем весов легко оценить по числу параметров и точности хранения — тот же подход к оценке размера используется в обсуждениях памяти при сервинге вокруг KV cache:
| Размер модели | Веса BF16 | Веса FP8 / INT8 | Веса INT4 |
|---|---|---|---|
| 7B / 8B | ~14-16 GB | ~7-8 GB | ~3.5-4 GB |
| 14B | ~28 GB | ~14 GB | ~7 GB |
| 32B / 34B | ~64-68 GB | ~32-34 GB | ~16-17 GB |
| 70B | ~140 GB | ~70 GB | ~35 GB |
| 109B MoE | ~218 GB всего | ~109 GB | ~55 GB |
Столбец INT4 учитывает только 4-битные значения. Масштабы групп добавляют несколько процентов, а эмбеддинги и lm_head, которые остаются в 16 бит, добавляют еще. В Qwen3-8B эти две матрицы занимают в BF16 примерно по 1.2 GB каждая. Оценка W4A16 в репозитории-компаньоне, 5.19 GiB, держит в 16 бит 12% параметров, чтобы их учесть.
При фиксированном бюджете памяти более крупная модель в 4 бита может превзойти меньшую модель в 16 бит. Dettmers и Zettlemoyer обнаружили, что 4-битная точность почти всегда оптимальна по zero-shot точности на общее число бит модели, на моделях BLOOM, OPT, Pythia и GPT-2 от 19M до 176B параметров. Исследование измеряло только zero-shot точность, поэтому перед выбором проверьте свои задачи.
Модели mixture-of-experts могут активировать меньше параметров на токен, но весь набор весов все равно должен где-то находиться, если рантайм не поддерживает offload. Матрица поддержки квантизации TensorRT-LLM рассматривает семейства MoE-моделей как целевые платформы деплоя со своими поддерживаемыми рецептами.
Железо для деплоя ограничивает, какие форматы квантизации применимы:
- Сервинг на CPU зависит от векторных инструкций, таких как AVX-512 или AMX. Практический путь — файл GGUF, загруженный через
llama.cpp. - Apple Silicon использует унифицированную память, поэтому локальные модели могут занимать большой общий пул RAM вместо выделенной VRAM. GGUF и
llama.cppостаются распространенным путем для локального рантайма, потому что GGUF создан для исполнителей GGML. Другой распространенный путь — MLX:mlx_lm.convert --model <model> -qпо умолчанию записывает 4-битную модель MLX, а--q-bits 8— 8-битную. Прежде чем выбирать, сравните скорость и качество на одних и тех же промптах. - NVIDIA Ampere поддерживает пути сервинга INT8 на tensor cores, но не нативную математику FP8 W8A8 на tensor cores. Обычный выбор — weight-only квантизация W4A16 или статический INT8, что соответствует матрице поддержки железа TensorRT-LLM.
- NVIDIA Ada и Hopper поддерживают пути сервинга FP8 в TensorRT-LLM. Сервинг FP8 W8A8 стоит проверить на этих GPU.
- NVIDIA Blackwell добавляет поддержку NVFP4 и микромасштабирования, но программный путь по-прежнему важен. Относитесь к ранним стекам с низкобитными форматами с плавающей точкой как к чувствительным к версиям.
8. Калибровка и оценка перед деплоем
Модель, которая загрузилась, прошла лишь smoke-тест. Для деплоя нужны проверки качества и сервинга на целевой нагрузке. Недавние оценки квантизации сообщают разные результаты для сервинга LLM, задач с длинным контекстом и моделей с тяжелым ризонингом.
Рисунок показывает, куда попадают калибровочные и отложенные оценочные выборки.
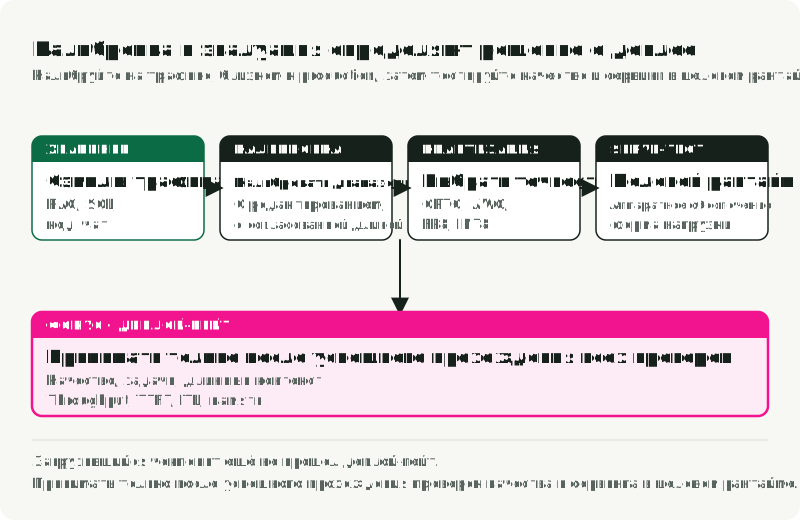
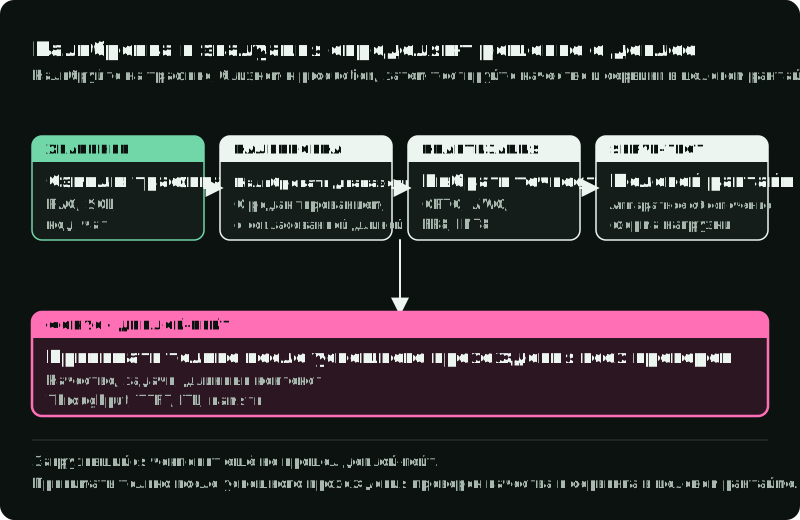
Сначала выберите рецепт. Если он требует калибровки, используйте промпты, похожие на продакшен. HQQ и FP8 dynamic, например, не требуют калибровочного датасета, поэтому на рисунке есть путь, который пропускает калибровку. Держите примеры для оценки отдельно от калибровочных образцов, чтобы итоговое сравнение проверяло поведение на отложенных данных. Для рецептов, которым нужна калибровка:
- Включите трейсы RAG, SQL-запросы, истории агентов, задачи по коду, payload’ы tool calls и системные промпты из целевой нагрузки. Статический PTQ зависит от того, совпадают ли калибровочные данные с продакшен-распределением.
- Подберите длины последовательностей. Короткие одноходовые промпты не покажут поведение активаций на длинном контексте.
- Оставьте
embed_tokensиlm_headв более высокой точности, если метод или рантайм это позволяет; это частый паттерн исключений в рецептах LLM Compressor. - Используйте достаточно образцов, чтобы стабилизировать диапазоны активаций. В примере vLLM для KV cache задано
NUM_CALIB_SAMPLES = 512. Считайте это одним документированным примером, а не универсальным числом. Нужное число образцов зависит от метода, модели, длины последовательности и продакшен-нагрузки. - Перед использованием продакшен-логов удалите из них секреты и приватные данные пользователей.
Для оценки проверяйте и качество языка, и поведение сервинга:
- Перплексия на стандартном корпусе ловит общую деградацию языка, но бенчмарк JarvisLabs напоминает, что перплексия и throughput могут меняться по-разному.
- Доменные задачи ловят сбои, которые перплексия скрывает. Используйте HumanEval для кода, MMLU для широких знаний и AIME или MATH-500 для математического ризонинга, если эти области важны.
- Проверки формата важны для агентных систем. Тестируйте соответствие JSON Schema, markdown-вывод, форму tool call и поведение при отказах: оценки квантизованных моделей могут пропускать сбои на уровне приложения, даже когда агрегированная точность на бенчмарках выглядит стабильной.
- Тесты на длинном контексте ловят ущерб от квантизации KV cache. Needle-in-a-haystack груб, но результаты по квантизации на длинном контексте показывают, почему такие проверки нужны до деплоя.
- Load tests должны сообщать throughput, TTFT, межтокенную латентность, устойчивую конкурентность и пиковую память GPU.
vllm bench serveизмеряет throughput и латентность. Память GPU собирайте отдельно, через телеметрию GPU или сервера. Прогоните разную конкурентность при заданных пределах латентности и ошибок, чтобы найти устойчивый уровень: конкурентность из одного прогона емкость не определяет.
Для RAG-приложения зафиксируйте вопросы и найденные свидетельства, когда сравниваете базовый и квантизованный генератор. Так сравнение изолирует изменение генератора. Затем прогоните весь пайплайн, чтобы проверить результат сервинга, и по руководству по оценке RAG отделите сбои retrieval от неподкрепленных ответов. Для агента проверьте, завершаются ли те же задачи с корректными tool calls и приемлемыми побочными эффектами. Один лишь меньший чекпоинт не отвечает ни на один из этих вопросов.
Тестируйте модели с ризонингом на многошаговых задачах. Квантизация ниже 4 бит или W4A4 без поворотов может ухудшить точность ризонинга, даже когда базовая перплексия выглядит стабильной; это главное предупреждение исследования квантизованных моделей с ризонингом.
9. Рабочий процесс с репозиторием-компаньоном
Репозиторий-компаньон slavadubrov/model-compression-demo делает процесс принятия решений воспроизводимым. Он использует uv и сосредоточен на планировании, рецептах, пробных запусках (dry run) и конфигурациях бенчмарков, основанных на тех же источниках, что и эта статья: vLLM, LLM Compressor, TensorRT-LLM и статьи об алгоритмах.
Клонируйте его и посмотрите поддерживаемые алгоритмы:
git clone https://github.com/slavadubrov/model-compression-demo.git
cd model-compression-demo
git checkout 62da4539793ac3a93e94e8551a063c7681561099
uv run python demo.py list-algorithms
Эти команды планирования используют только стандартную библиотеку Python. Начните с планирования и оценки размера:
uv run python demo.py plan \
  --model-preset qwen3-8b \
  --goal fit-memory \
  --hardware ampere \
  --context 4096 \
  --concurrency 4

uv run python demo.py estimate \
  --model-preset qwen3-8b \
  --scheme w4a16 \
  --context 4096 \
  --concurrency 4
plan выбирает для этой цели GPTQ W4A16 и печатает два бюджета из раздела 6: целевой объем для сервинга 10.44 GiB и пик GPU 2.35 GiB для послойной задачи квантизации. estimate раскладывает целевой объем для сервинга по статьям:
Architecture:     Qwen3 8B (built-in preset from official Hugging Face config)
Layers/hidden/KV: 36 / 4096 / 0.250
Note:             Causal text-generation checkpoint suitable for the text-only harness.
Scheme:           w4a16
Weights:          5.19 GiB
KV cache:         2.25 GiB
Runtime overhead: 2.00 GiB
Safety buffer:    1.00 GiB
Total target:     10.44 GiB
Weights и KV cache — первые два члена уравнения памяти при сервинге из раздела 6. Runtime overhead и Safety buffer — запас репозитория-компаньона на активации и накладные расходы движка. Строка KV cache — это формула кэша для Qwen3-8B: 36 слоев, 8 KV heads и размерность головы 128 при 4 096 токенах и 4 одновременных запросах.
Затем выведите рецепт и посмотрите квантизацию в пробном режиме, прежде чем тратить время GPU:
uv run python demo.py recipe --algorithm gptq-w4a16

uv run python demo.py quantize \
  --algorithm gptq-w4a16 \
  --model Qwen/Qwen3-8B \
  --dry-run
Команда recipe печатает код llm-compressor, который запускает шаг quantize:
from llmcompressor import oneshot
from llmcompressor.modifiers.quantization import GPTQModifier

recipe = GPTQModifier(
    scheme="W4A16",
    targets="Linear",
    ignore=["lm_head"],
)

oneshot(
    model="Qwen/Qwen3-8B",
    dataset="wikitext",
    dataset_config_name="wikitext-2-raw-v1",
    recipe=recipe,
    output_dir="outputs/Qwen3-8B-W4A16",
    max_seq_length=4096,
    num_calibration_samples=256,
)
targets и ignore определяют, какие слои получат 4-битные веса; num_calibration_samples и max_seq_length — выбор параметров калибровки из раздела 8. WikiText — значение по умолчанию для smoke-теста; для настоящего чекпоинта передайте --calibration-file с промптами, похожими на продакшен.
Рецепт GPTQ записывает чекпоинт compressed-tensors. GPTQ — это алгоритм, а не формат чекпоинта, поэтому vLLM определяет формат по самому чекпоинту без флага --quantization, как в его официальном примере W4A16.
Чтобы квантизовать, выполните make install-compression. Для vLLM нужно отдельное окружение, потому что его зависимости конфликтуют с llm-compressor: выполните make install-serving, затем используйте .venv-vllm/bin/vllm для команд serve и bench.
Запустите сервинг и бенчмарк каждого чекпоинта и сравните с базовой линией RTN W8A16 из таблицы алгоритмов. Выполните quantize без --dry-run для gptq-w4a16 и rtn-w8a16, чтобы записать outputs/Qwen3-8B-W4A16 и outputs/Qwen3-8B-W8A16. Команда benchmark-plan из репозитория-компаньона записывает в файл JSON команды serve и benchmark для каждого чекпоинта. Чтобы выполнить сравнение вручную, запустите сервер W4A16 в одном терминале:
.venv-vllm/bin/vllm serve outputs/Qwen3-8B-W4A16 --host 127.0.0.1 --port 8000Во втором терминале запустите ту же синтетическую нагрузку, что и в разделе 5:
.venv-vllm/bin/vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model outputs/Qwen3-8B-W4A16 \
  --tokenizer Qwen/Qwen3-8B \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Остановите сервер и снова выполните обе команды с outputs/Qwen3-8B-W8A16, базовой линией RTN W8A16, вместо outputs/Qwen3-8B-W4A16.
Наконец, сравните базовую и сжатую модели по явным порогам:
uv run python demo.py quality-eval \
  --base-model Qwen/Qwen3-8B \
  --compressed-model outputs/Qwen3-8B-W4A16 \
  --mode all \
  --lm-eval-task hellaswag \
  --lm-eval-limit 50 \
  --max-perplexity-delta-pct 5 \
  --output-json reports/qwen3-8b-w4a16-quality.json
Выполняйте работу по порядку: спланируйте цель, оцените память, прогоните рецепт в пробном режиме, измерьте сервинг, затем сравните качество с порогами. Эта последовательность повторяет разделение, принятое в статье, между оценкой памяти, бенчмаркингом рантайма и оценкой качества.
10. Для диффузионных моделей нужен отдельный путь
У диффузионных моделей и диффузионных трансформеров поведение активаций отличается от авторегрессионных LLM. SVDQuant рассматривает квантизацию диффузионных моделей как отдельную задачу о выбросах активаций.
Авторегрессионные LLM генерируют по одному токену. Диффузионные модели выполняют повторяющиеся шаги денойзинга, и распределения их активаций меняются по ходу процесса, о чем сообщает Q-Diffusion для выходов денойзинговой сети на разных шагах. Стандартный проход 4-битной квантизации для LLM может сэкономить память диффузионной модели, но внести сильные визуальные артефакты. Методы, ориентированные на диффузию, такие как SVDQuant / Nunchaku и квантизация диффузионных моделей в NVIDIA ModelOpt, работают с этим другим паттерном активаций.
В пайплайне латентной диффузии текстовый энкодер представляет промпт. Денойзинговая сеть, такая как diffusion transformer (DiT) или U-Net, многократно обновляет сжатое представление изображения, называемое латентом. Вариационный автоэнкодер (VAE) преобразует эти латентные представления в изображения и обратно. У этих компонентов разные задачи, поэтому проверяйте их точность отдельно.
Считайте следующее консервативными эвристиками, а не универсальными значениями по умолчанию. Пайплайн, компонент, модель и рантайм нужно тестировать отдельно:
- Для первого сравнения оставьте VAE в 16 бит. Проверяйте меньшую точность, только если метод и целевой пайплайн ее подтверждают.
- Сначала попробуйте бэкбон DiT или U-Net, потому что в нем часто сосредоточена наибольшая доля параметров. Проверьте память, латентность и качество изображений для целевого пайплайна. Методы квантизации диффузионных моделей применяют тот же подход на уровне компонентов.
- Текстовые энкодеры рассматривайте отдельно. Квантизация T5-XXL или CLIP может повлиять на соответствие промпту или отрисовку текста в конкретном пайплайне, поэтому оценивайте их независимо, а не предполагайте поведение обычного трансформера.
- Используйте методы, учитывающие диффузию, такие как SVDQuant, когда главная проблема — выбросы активаций.
- Оценивайте по изображениям, а не по текстовым метрикам. Проверьте следование промпту, отрисовку текста, оттенки кожи, цветовой баланс, мелкие детали, латентность и VRAM. Чтобы сравнить с 16-битным пайплайном, измерьте LPIPS или PSNR между парными изображениями (с одним seed), а для соответствия промпту — CLIP score или ImageReward, как это делает оценка в SVDQuant. Затем просмотрите сложные случаи глазами.
Если оценочный набор содержит только простые или обычные промпты, вы пропустите сбои на краевых случаях. Включите сложные случаи: мелкий текст, руки, повторяющиеся объекты, структурированные макеты и промпты с негативными ограничениями, потому что сбои квантизации диффузионных моделей проявляются визуально, а не в перплексии языковых моделей.
11. Рекомендации для продакшена
Рисунок размещает первую попытку для каждого типа деплоя на оси разрядности вместе со следующим тестом и условием для него. Каждому из них все равно нужны проверки из раздела 8.
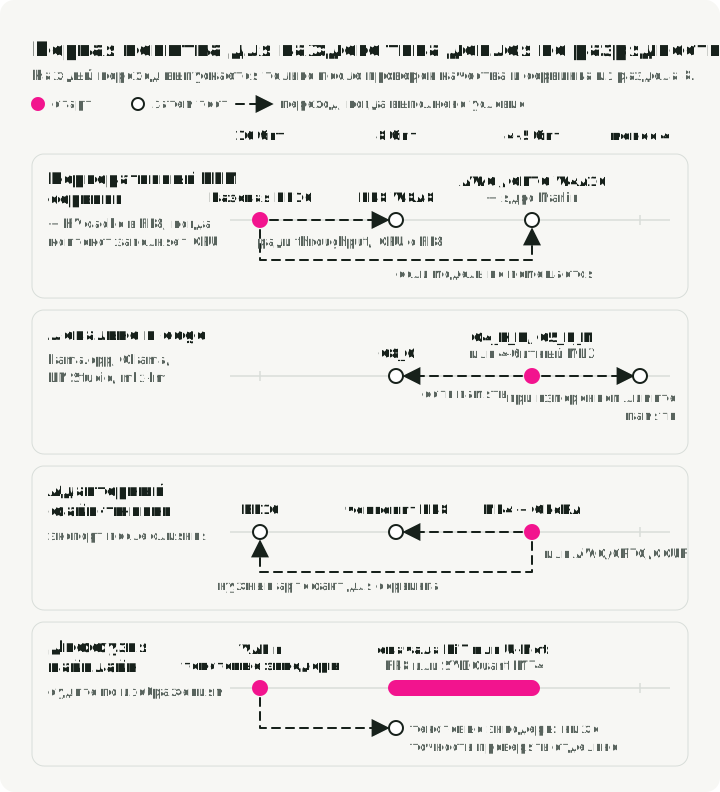
Для корпоративного сервинга LLM начните с базовой линии BF16 в том самом движке сервинга, который вы планируете использовать. Если цель — throughput и GPU это поддерживает, проверьте FP8 W8A8. Если модель не помещается, проверьте W4A16 на AWQ или GPTQ с ядрами класса Marlin. Если GPU заполняют длинный контекст или конкурентность, проверьте FP8 KV cache. Деплойте сжатую версию, только когда пройдены и проверки качества, и проверки сервинга.
Для локального и edge-инференса начните с файла GGUF в Q4_K_M или Q5_K_M либо с 4-битной модели MLX на Mac. Переходите на Q8_0, когда позволяет память, и сравнивайте качество на задачах. Кодировки меньше 4 бит используйте только при измеренном ограничении по памяти.
Для файн-тюнинга используйте NF4 с QLoRA, чтобы обучать адаптеры с меньшим расходом памяти. Оцените адаптер в приложении перед слиянием. После слияния экспортируйте и оцените тот артефакт сервинга, который вам нужен: файл GGUF, совместимый с llama.cpp, чекпоинт AWQ/GPTQ/compressed-tensors, чекпоинт FP8 или BF16.
Для диффузии сначала квантизуйте денойзер, оставьте VAE в 16 бит и проверяйте текстовые энкодеры отдельно, как в разделе 10. Сравнивайте парные изображения с одним seed и просматривайте сложные промпты глазами.
12. Проведите следующее сравнение
Сохраните базовую линию BF16 и сравните один поддерживаемый сжатый кандидат на тех же отложенных задачах и том же трафике. Прежде чем запускать его, запишите, какую потерю качества и какую латентность вы готовы принять. Измеряйте пиковую память, а не только скорость: полезный результат — убирает ли кандидат ваш боттлнек в этих пределах.
Источники
- JarvisLabs vLLM Benchmarks: JarvisLabs, vLLM Quantization Complete Guide and Benchmarks, 2026. JarvisLabs.
- Hugging Face Optimum Quantization Guide: Hugging Face, Quantization conceptual guide. Документация.
- vLLM Quantization Docs: проект vLLM, Quantization. Документация.
- vLLM Quantized KV Cache Docs: проект vLLM, Quantized KV Cache. Документация.
- vLLM Benchmark Docs: проект vLLM, vllm bench serve. Документация.
- LLM Compressor Docs: проект vLLM, LLM Compressor. Документация.
- GPTQModel: ModelCloud, GPTQModel. GitHub.
- TensorRT-LLM Quantization: NVIDIA, TensorRT-LLM Quantization. Документация.
- NVIDIA NVFP4: NVIDIA, Introducing NVFP4 for Efficient and Accurate Low-Precision Inference. Blog.
- Hugging Face QuantizedCache: Hugging Face, Cache strategies: Quantized cache. Документация.
- NVIDIA Model Optimizer: NVIDIA, Model Optimizer. GitHub.
- torchao Quantization: PyTorch, torchao quantization overview. Документация.
- bitsandbytes Quantization: Hugging Face, bitsandbytes. Документация.
- HQQ: Dropbox, Half-Quadratic Quantization. GitHub.
- PEFT: Hugging Face, Parameter-Efficient Fine-Tuning. Документация.
- Ollama: Ollama, локальный рантайм моделей. Сайт.
- LM Studio: LM Studio, локальный рантайм AI. Сайт.
- Статус AutoGPTQ: Репозиторий AutoGPTQ, архивирован в апреле 2025 года. GitHub.
- Статус AutoAWQ: Репозиторий AutoAWQ, архивирован и объявлен устаревшим в мае 2025 года. GitHub.
- GPTQ: Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, ICLR 2023. arXiv:2210.17323.
- Marlin: Frantar et al., MARLIN: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models, arXiv:2408.11743. arXiv:2408.11743.
- AWQ: Lin et al., AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, MLSys 2024. arXiv:2306.00978.
- SmoothQuant: Xiao et al., SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, ICML 2023. arXiv:2211.10438.
- QuaRot: Ashkboos et al., QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs, NeurIPS 2024. arXiv:2404.00456.
- SpinQuant: Meta AI Research, SpinQuant: LLM Quantization with Learned Rotations, arXiv:2405.16406. arXiv:2405.16406.
- QLoRA / NF4: Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, NeurIPS 2023. arXiv:2305.14314.
- SVDQuant / Nunchaku: MIT HAN Lab, SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models, ICLR 2025. arXiv:2411.05007, Nunchaku.
- vLLM PagedAttention: Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023. arXiv:2309.06180.
- Grouped-Query Attention: Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, EMNLP 2023. arXiv:2305.13245.
- vLLM FP8 KV Cache: Kubler, Kurtic, Wilkinson et al., The State of FP8 KV-Cache and Attention Quantization in vLLM, блог vLLM, апрель 2026. vLLM Blog.
- KIVI: Liu et al., KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache, ICML 2024. arXiv:2402.02750.
- KVQuant: Hooper et al., KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization, NeurIPS 2024. arXiv:2401.18079.
- LLM Serving Evaluation: Kurtic et al., “Give Me BF16 or Give Me Death”? Accuracy-Performance Trade-Offs in LLM Quantization, ACL 2025. arXiv:2411.02355.
- Long-context Quantization Evaluation: Mekala et al., Does quantization affect models’ performance on long-context tasks?, arXiv:2505.20276. arXiv:2505.20276.
- Reasoning Evaluation: Quantization Hurts Reasoning? An Empirical Study on Quantized Reasoning Models, arXiv:2504.04823. arXiv:2504.04823.
- 2:4 Sparsity: Mishra et al., Accelerating Sparse Deep Neural Networks, arXiv:2104.08378. arXiv:2104.08378.
- k-bit Scaling Laws: Dettmers and Zettlemoyer, The case for 4-bit precision: k-bit Inference Scaling Laws, ICML 2023. arXiv:2212.09720.
- Q-Diffusion: Li et al., Q-Diffusion: Quantizing Diffusion Models, ICCV 2023. arXiv:2302.04304.
- MLX LM: Apple ml-explore, mlx-lm. GitHub.
- HumanEval: OpenAI, HumanEval. GitHub.
- MMLU: Hendrycks et al., Measuring Massive Multitask Language Understanding. arXiv:2009.03300.
- MATH-500: Hugging Face H4, MATH-500. Dataset.
- GGUF и llama.cpp: ggml-org, GGUF file format и llama.cpp. GGUF, llama.cpp.
- Hugging Face GGUF Docs: Hugging Face, GGUF. Документация.
- Репозиторий-компаньон: slavadubrov/model-compression-demo.