Guia de Quantização de Modelos: dos Fundamentos ao Serving em Produção

Tradução automática
Este artigo foi traduzido automaticamente a partir da versão original em inglês.
Este guia de quantização destina-se a engenheiros que fazem o deployment de modelos de linguagem e precisam de reduzir o uso de memória ou de melhorar a velocidade de serving. Vai aprender a escolher o que comprimir, a ajustar um formato numérico ao seu hardware e ao seu runtime, e a comparar memória, latência e qualidade das respostas antes do deployment. O guia cobre também as verificações separadas de que os modelos de imagem de difusão precisam.
A quantização reduz o número de bits usados para pesos, ativações ou o KV cache. Os pesos são os parâmetros do modelo aprendidos durante o treino. As ativações são valores intermédios calculados a partir de cada entrada. O key-value (KV) cache guarda valores de tokens anteriores para os reutilizar durante a geração. Comprimir os pesos pode fazer com que um modelo caiba na memória da GPU e, ao mesmo tempo, deixar pouco espaço para uma conversa longa. O alvo que comprime e o código da GPU que o executa determinam que limite consegue aliviar.
Comece por identificar o que torna o pedido lento ou demasiado grande. O processamento do prompt de entrada chama-se prefill; a geração da resposta, um token de cada vez, chama-se decode. O prefill pode ser limitado pela aritmética da GPU, enquanto o decode pode ser limitado pela velocidade a que os pesos são carregados da memória. Os pesos do modelo e o KV cache, que não para de crescer, também podem esgotar a memória da GPU. A primeira tabela associa estes problemas a possíveis soluções; as secções seguintes explicam as contas e as verificações necessárias antes do deployment.
Uma largura de bits mais baixa é apenas uma candidata. A decisão exige resultados de qualidade da tarefa e medições de serving para o modelo, o runtime e o tráfego que vai utilizar. Os benchmarks aqui apresentados são resultados publicados por outras equipas, mais uma execução curta do repositório complementar.
Para uma comparação curta de artefactos e métodos, consulte LLM Quantization Formats.
1. Bottlenecks e formatos de partida
Pergunte o que limita a carga de trabalho antes de escolher uma largura de bits. A resposta pode ser a memória dos pesos do modelo, o cálculo do prefill, a largura de banda do decode ou o KV cache, e não a precisão numérica em si.
Notação usada nas receitas de serving
- W4A16 guarda os pesos em 4 bits e mantém as ativações com precisão de 16 bits. De forma mais geral, W{x}A{y} indica a precisão usada para os pesos e para as ativações nas operações suportadas, normalmente a multiplicação de matrizes. W8A8 usa pesos e ativações de 8 bits nessas operações, mas não define automaticamente o tipo de dados guardado de cada tensor do runtime.
- FP8, INT8, INT4, NF4 são formatos numéricos. Decidem que valores podem ser representados.
- GPTQ, AWQ, SmoothQuant, QuaRot são algoritmos. Decidem como converter um modelo treinado para um formato de menor precisão.
- GGUF é um formato de ficheiro que guarda tensores e metadados para runtimes ao estilo de GGML e
llama.cpp. Um ficheiro GGUF pode conter tipos de tensor não quantizados, comoF16,BF16ouF32, e também codificações quantizadas. Os presets incluemQ4_K_M,Q5_K_M,Q8_0,IQ*,TQ*eMXFP4. A codificação do tensor determina a escolha de quantização. SóGGUFnão descreve uma receita de serving FP8 W8A8 ao estilo CUDA. - KV cache é a cache de atenção usada durante a geração. Guarda as chaves e os valores anteriores, para que o modelo não recalcule a conversa inteira a cada token.
- quantização do KV cache guarda os tensores de ativação de chave/valor da cache num formato de cache de menor precisão, como FP8, INT8, INT4 ou INT2, consoante o suporte do runtime. É diferente de prefix caching, de PagedAttention ou de offload, que decidem se as entradas da cache são reutilizadas, como são alocadas ou onde residem.
- GEMM significa general matrix multiply (multiplicação geral de matrizes). A maior parte do tempo de inferência de um transformer é gasta em multiplicação de matrizes.
O que é quantizado
Uma receita escolhe que tensores comprimir. Estas são as escolhas habituais:
| Tensor | Costuma ser quantizado? | Porquê |
|---|---|---|
| Pesos das camadas lineares | Sim, nas receitas W4A16 e W8A8 | Os pesos ficam fixos depois do treino, por isso as suas escalas podem ser calculadas offline. |
| Ativações | Só nas receitas W8A8, W4A8 ou W4A4 | Mudam a cada entrada, por isso precisam de escalas calibradas ou calculadas em runtime. |
| KV cache | Opcional, uma definição separada do runtime | Cresce com o contexto e com o batch; a secção 6 trata dela. |
Embeddings e lm_head | Costumam ficar em 16 bits | As receitas do LLM Compressor listam lm_head em ignore; a secção 8 lista esta exclusão. |
| VAE de difusão e codificadores de texto | Ficam em 16 bits no primeiro teste | A secção 10 testa-os separadamente da rede de remoção de ruído. |
Bottlenecks e por onde começar
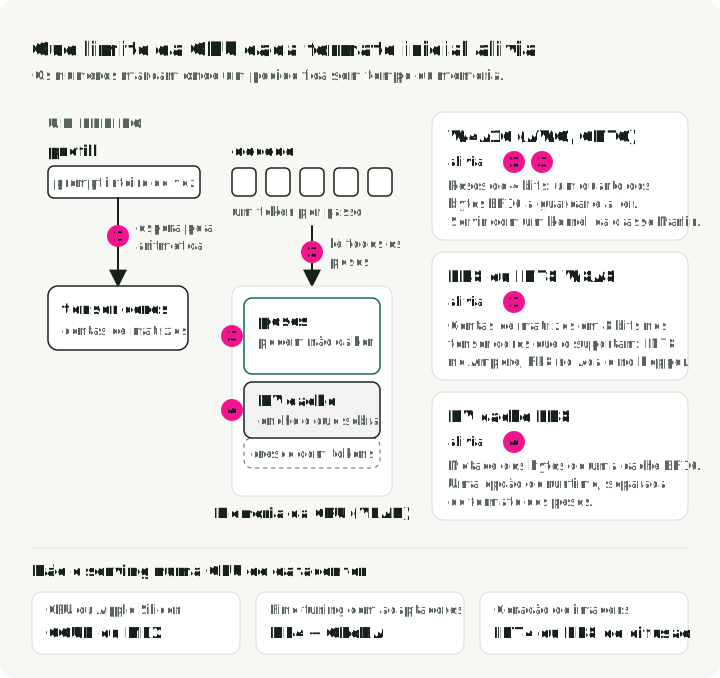
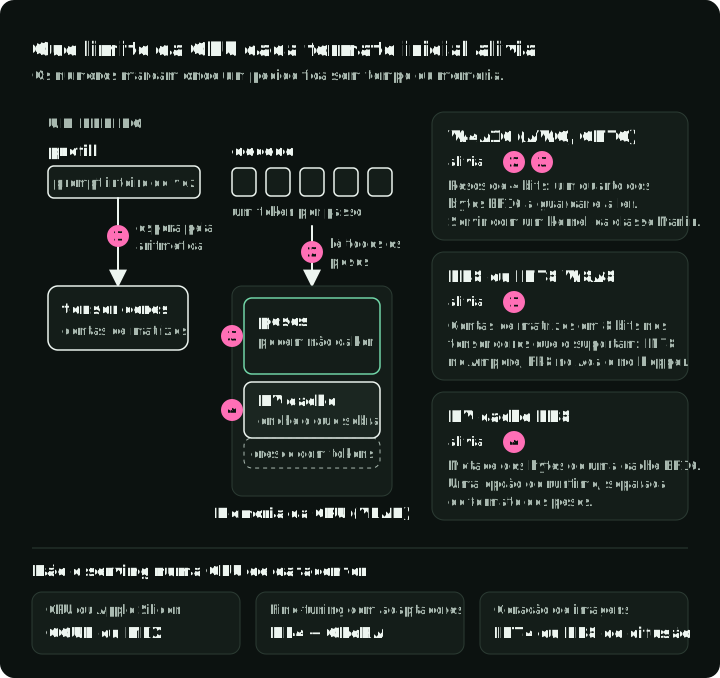
A tabela associa bottlenecks comuns a um formato de partida. Use a notação acima.
| Se este for o problema | Comece aqui | Ferramentas típicas | Verificar antes do deployment |
|---|---|---|---|
| Os pesos do modelo não cabem na VRAM | Quantização weight-only W4A16 | AWQ ou GPTQ com llm-compressor ou GPTQModel | Perplexidade, programação, raciocínio, seguimento de instruções |
| O serving de alto débito é limitado pelo cálculo | FP8 ou INT8 W8A8 | FP8 PTQ, SmoothQuant, TensorRT-LLM, vLLM | Débito, tempo até ao primeiro token (TTFT), precisão da tarefa |
| Contexto longo ou muita concorrência enchem a GPU | quantização do KV cache | vLLM, TensorRT-LLM ou Transformers QuantizedCache | Recuperação em contexto longo, latência, segurança e qualidade |
| Inferência local em CPU, Apple Silicon ou computador | Ficheiros GGUF com codificações de tensor locais | llama.cpp, Ollama, LM Studio, MLX | Latência do prompt, uso de RAM, codificação de tensor escolhida e qualidade subjetiva |
| O fine-tuning com adaptadores tem de caber numa só GPU | NF4 / QLoRA | bitsandbytes, peft | Loss do fine-tuning e qualidade do modelo após o merge |
| O pipeline de geração de imagens é demasiado grande ou lento | INT4 ou FP8 específicos para difusão | SVDQuant, Nunchaku, torchao, NVIDIA ModelOpt | Artefactos visuais, alinhamento com o prompt, latência, VRAM |
A figura marca onde um pedido fica sem tempo ou memória numa GPU de serving e que formato inicial alivia cada limite. A linha inferior cobre os casos que não são serving em GPU de datacenter.
2. A quantização é arredondamento controlado
A quantização converte valores de alta precisão num conjunto menor de valores representáveis, que é a definição central usada tanto pelo Hugging Face Optimum como pelo TensorRT-LLM. Poupa memória e largura de banda. Também introduz erro de arredondamento.
O INT4 só oferece 16 valores discretos, por isso converter pesos BF16 de 16 bits para essa grelha cria erro de arredondamento. Os métodos de quantização avaliam o arredondamento pela forma como altera a saída de uma camada, e não apenas cada peso. O GPTQ estima como as escolhas de arredondamento afetam essa saída e ajusta os pesos restantes para reduzir o erro. O AWQ usa as ativações observadas para identificar grupos de pesos importantes, chamados canais, e reescala-os antes do arredondamento. Uma boa conversão poupa memória com pouca perda de qualidade. Uma má prejudica o raciocínio, o seguimento de instruções ou a fidelidade visual.
Mapeamento simétrico e assimétrico
Seguindo o mapeamento afim usado em guias de quantização comuns, a quantização converte um valor float contínuo numa grelha discreta.
- e são os limites inferior e superior em vírgula flutuante escolhidos.
- é o valor original de alta precisão.
- é o valor quantizado.
- é a escala, ou tamanho do passo.
- é o zero point, a posição inteira que representa
0.0. - é o intervalo inteiro de destino. Este exemplo simétrico usa , que tem 15 valores e representa o zero com exatidão. Outros formatos INT4 com sinal usam os 16 valores, por exemplo .
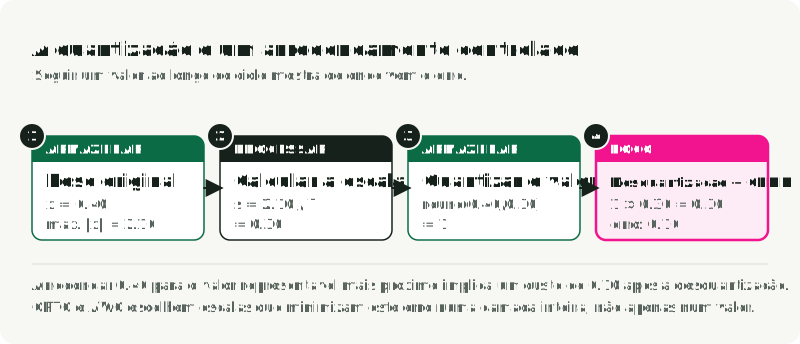
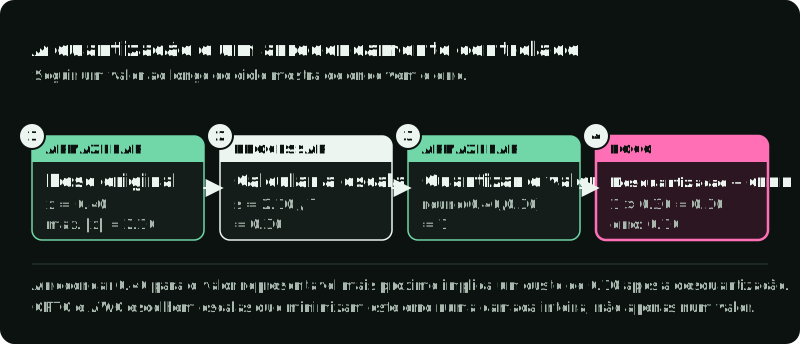
A quantização simétrica centra a grelha em zero e define :
Isto é favorável ao hardware porque as contas do runtime não precisam de subtrair um desvio de zero point. A stack de quantização do PyTorch expõe estas escolhas afins de escala e zero point como parâmetros primitivos de quantização no torchao.
A quantização assimétrica desloca a grelha para cobrir intervalos enviesados:
Essa grelha deslocada pode preservar melhor ativações só positivas, mas o desvio acrescenta trabalho, a menos que o kernel o trate bem.
A figura percorre o caso simétrico: uma magnitude máxima de 2.10 dá uma escala de 0.30, por isso o peso 0.40 é arredondado para o inteiro 1. A desquantização multiplica esse inteiro guardado pela escala para recuperar um valor aproximado, 0.30. A diferença para 0.40 é o erro de arredondamento.
Granularidade da escala: tensor, canal, grupo
O fator de escala pode cobrir um tensor de pesos inteiro, um canal ou um pequeno grupo de valores. A documentação de FP8 KV cache do vLLM usa a mesma distinção entre estratégias de escala por tensor e por cabeça de atenção. Grupos mais pequenos costumam preservar melhor a qualidade, mas exigem mais metadados de escala.
| Granularidade da escala | O que partilha uma escala | Efeito na qualidade e na execução |
|---|---|---|
| Por tensor | A matriz de pesos inteira | Guarda poucos metadados, mas um único outlier pode esticar a grelha e reduzir a precisão em toda a camada. |
| Por canal | Uma linha de saída | Evita que canais com intervalos estreitos partilhem o intervalo mais largo de outro canal. Muitos percursos de pesos de 8 bits usam esta granularidade. |
| Por grupo | Um bloco dentro de uma linha, muitas vezes de 64 ou 128 valores | Confina um outlier a um bloco pequeno, à custa de mais escalas. O AutoGPTQ usa group_size=128 nos seus exemplos de GPTQ. |
A figura põe um outlier numa pequena matriz de exemplo e conta quantos valores partilham a sua escala em cada escolha.
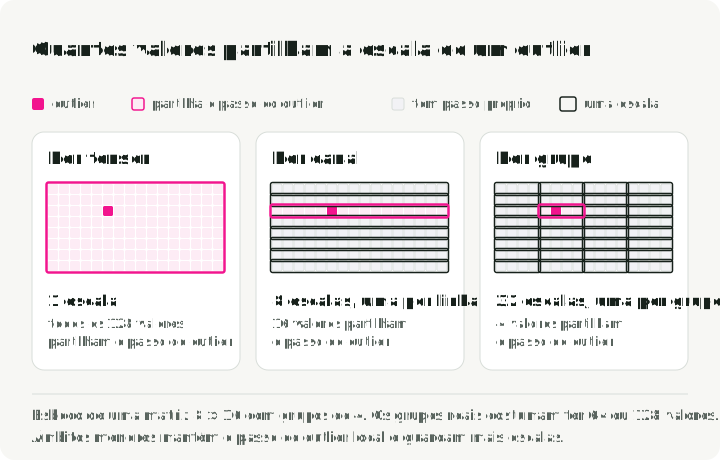
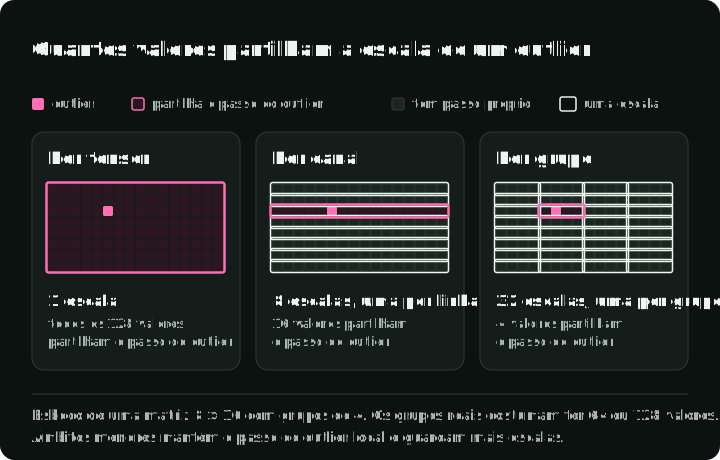
Os pesos são estáticos, por isso as suas escalas podem ser calculadas offline antes de carregar o modelo. As ativações mudam a cada token, o que faz com que os seus intervalos dependam da carga de trabalho.
| Escalonamento das ativações | Quando o runtime escolhe a escala | Vantagem | Modo de falha ou custo |
|---|---|---|---|
| Estático | Offline, a partir de um dataset de calibração | Evita o cálculo da escala durante a inferência. | Prompts fora do comprimento ou da distribuição calibrados podem cortar picos de ativação e prejudicar a saída. |
| Dinâmico | Durante cada forward pass | Adapta-se aos valores de ativação atuais e à mistura de prompts. | Calcular intervalos em cada camada acrescenta trabalho e exige kernels otimizados. |
O KV cache fica entre estes casos: as chaves e os valores são ativações calculadas em runtime e guardadas para os tokens seguintes, por isso precisam das suas próprias escalas. A secção 6 explica como os runtimes os guardam.
PTQ e QAT ocorrem em fases diferentes
A quantização pós-treino, ou PTQ, comprime um modelo já treinado. O treino com simulação de quantização, ou QAT, expõe o modelo a ruído de quantização durante o treino para que se possa adaptar.
| Método | Quando os intervalos são aprendidos | Use quando | Custo que paga |
|---|---|---|---|
| PTQ weight-only | Offline, para pesos estáticos | O modelo não cabe ou o decode é limitado pela largura de banda | As ativações continuam a correr em 16 bits |
| PTQ estático | Offline, a partir de prompts de calibração | Quer serving W8A8 rápido | Os dados de calibração têm de corresponder à produção |
| PTQ dinâmico | Em runtime, por batch ou percurso de ativação | As distribuições de entrada variam muito | Trabalho extra em runtime e suporte de hardware mais restrito |
| QAT | Durante o treino | O PTQ degrada a qualidade de um modelo sensível | Infraestrutura de treino completa e muito mais cálculo |
Os dados de calibração têm de se parecer com o tráfego que vai servir. O percurso de calibração de KV cache do vLLM, por exemplo, usa um dataset selecionado através do llm-compressor. Se os prompts de produção forem traces longos de RAG, parágrafos curtos da Wikipédia podem não cobrir os intervalos de ativação que esses traces produzem. Nas escalas estáticas de ativações ou de cache, a calibração escolhe os intervalos. No GPTQ e no AWQ, as ativações de calibração também decidem como cada peso é arredondado ou reescalado, pelo que uma calibração com texto curto pode moldar os pesos guardados. Prompts reais de contexto longo podem produzir padrões de ativação diferentes. As avaliações de quantização em contexto longo medem este risco diretamente.
3. Os formatos numéricos determinam os requisitos de hardware
O formato numérico define que valores o modelo consegue representar em memória. Para calcular de forma eficiente, são necessários kernels de runtime e hardware que suportem a mesma largura de bits e o mesmo formato. O TensorRT-LLM documenta tanto a lista de receitas como a matriz de suporte de hardware.
| Formato | Armazenamento por valor | Bom ponto de partida para | Principal ponto de atenção |
|---|---|---|---|
| BF16 / FP16 | 2 bytes | Inferência de referência e serving compatível com o treino | Uso elevado de VRAM e muito tráfego de largura de banda de memória |
| FP8 | 1 byte | Serving W8A8 de alto débito em Ada, Hopper, Blackwell | Precisa de tensor cores FP8 nativos e de suporte do runtime |
| INT8 | 1 byte | Serving W8A8 em hardware mais antigo ou não NVIDIA | Outliers de ativação e sensibilidade à calibração estática |
| INT4 | 0.5 bytes | W4A16 quando a memória dos pesos é o principal limite | Perda de qualidade em modelos mais pequenos ou centrados em raciocínio |
| FP4 / NVFP4 | ~0.5 bytes | Experiências da era Blackwell e primeiros percursos de serving | Requisitos de compilador e de runtime específicos do hardware |
| Codificações / presets GGUF do llama.cpp | Variável | Inferência local em CPU, Apple Silicon, computador e edge | O GGUF é o contentor. A codificação do tensor é a escolha de quantização. |
| NF4 | 0.5 bytes | Treino de adaptadores QLoRA | Normalmente o formato de exportação errado para serving em produção |
O BF16 e o FP16 usam ambos 16 bits, mas distribuem a precisão de forma diferente e, por isso, falham de forma diferente. O BF16 mantém o intervalo de expoente de 8 bits do FP32 e é mais difícil de levar a overflow. O FP16 tem mais bits de mantissa e um intervalo de expoente mais estreito, pelo que os picos de ativação exigem mais cuidado. A avaliação de Kurtic et al. usa explicitamente o BF16 como referência ao comparar os formatos de serving FP8, INT8 e INT4.
O FP8 tem duas variantes comuns. O E4M3 dá mais precisão e costuma ser usado nos pesos e nas ativações do forward. O E5M2 dá mais intervalo dinâmico e é mais útil para gradientes ou percursos de ativação voláteis. O vLLM expõe ambos os dtypes de KV cache FP8 E4M3 e E5M2. No estudo de Kurtic et al. na ACL 2025, “Give Me BF16 or Give Me Death”, o FP8 W8A8 foi praticamente sem perdas na família Llama-3.1, em mais de 500 000 avaliações. O resultado cobre essa família de modelos, esse conjunto de avaliação e essa configuração de serving. Cada deployment precisa da sua própria verificação de qualidade antes do lançamento.
O Blackwell acrescenta formatos de microscaling, como o MXFP8 e o NVFP4. Em vez de uma única escala para um tensor ou uma linha inteira, o microscaling usa blocos minúsculos. A explicação da NVIDIA sobre o NVFP4 descreve valores de vírgula flutuante de 4 bits em blocos de 16, com fatores de escala FP8 e uma escala FP32 de nível superior. Esta abordagem pretende dar uma pegada próxima da do INT4 com comportamento de vírgula flutuante. No entanto, exige uma arquitetura de hardware, um compilador e um suporte de runtime compatíveis, e é por isso que o TensorRT-LLM lista o suporte de FP4 e FP8 por geração de GPU.
4. Quantização weight-only versus weight-activation
A notação WxAy descreve a precisão dos pesos e das ativações, que sobrecarregam a GPU de formas diferentes durante a inferência. A figura segue os pesos desde a VRAM, passando pelo kernel, até aos tensor cores, para BF16, W4A16 e W8A8.
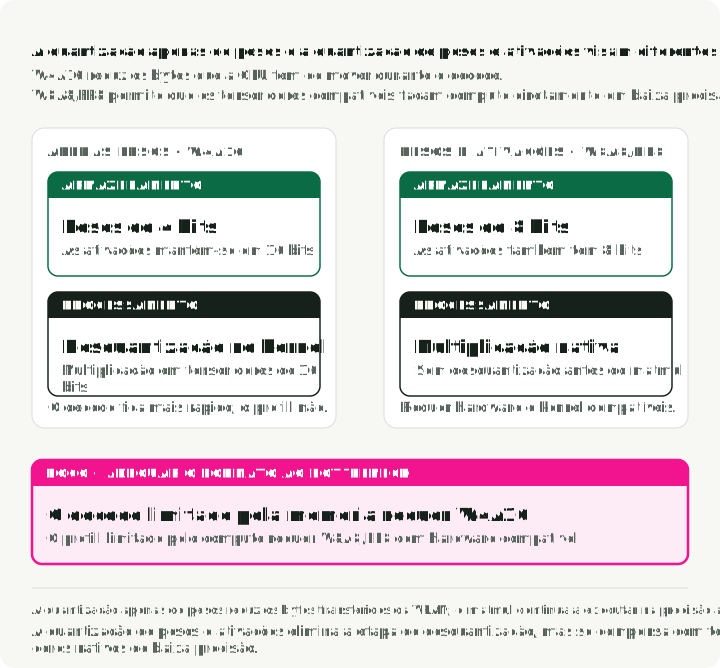
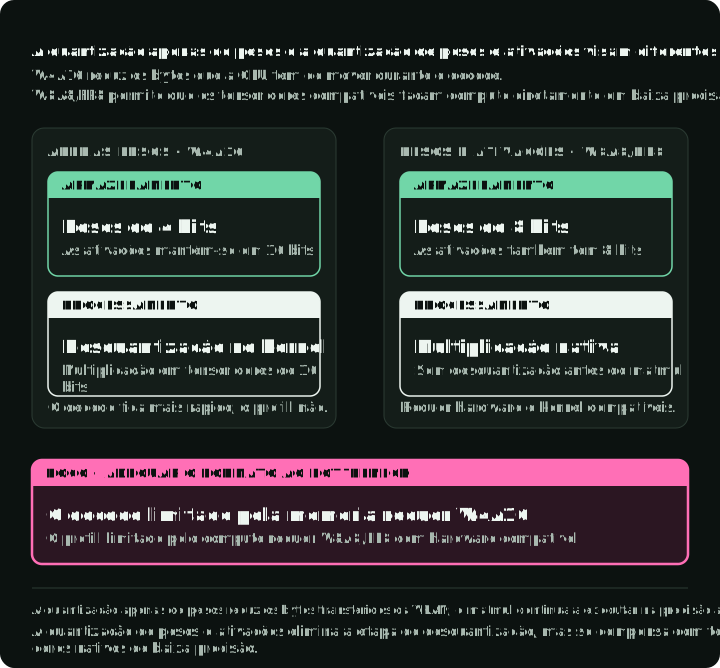
Durante o prefill, o modelo processa o prompt de entrada. Esta fase costuma ser limitada pelo cálculo, porque a GPU faz grandes multiplicações de matrizes, e é por isso que as receitas W8A8 FP8/INT8 importam para o serving orientado ao débito.
Durante o decode, o modelo gera um token de cada vez. Esta fase é muitas vezes limitada pela largura de banda de memória, porque a GPU continua a carregar pesos da VRAM para produzir o token seguinte. Artigos weight-only como o GPTQ e o AWQ atacam essa pressão reduzindo os bytes dos pesos.
O W4A16 comprime os pesos e mantém as ativações em BF16 ou FP16. A GPU carrega menos bytes de pesos e depois desquantiza-os de volta para uma forma de maior precisão para a multiplicação. Isto ajuda nos problemas de decode e de ajuste à memória. O prefill limitado pelo cálculo pode ganhar pouco, porque a matemática das matrizes continua a correr em 16 bits.
O W8A8 comprime os pesos e os tensores de ativação usados pelos kernels de matmul suportados. Se o hardware tiver tensor cores nativos de baixa precisão, o motor de serving pode executar a matemática das matrizes diretamente em FP8 ou INT8. O FP8 pode, por isso, ajudar o serving de alto débito, reduzindo o tráfego de memória e usando aritmética mais rápida. O KV cache tem a sua própria definição de armazenamento, por isso verifique em separado o dtype da cache ou a implementação da cache do runtime.
Na execução registada do repositório complementar (RTX 4090, vLLM 0.23.0, uma repetição de 64 tokens gerados), o Qwen3-8B com a quantização dinâmica FP8 online do vLLM gerou 122 tok/s contra 85 tok/s em BF16 e carregou 8.8 GiB de pesos em vez de 15.3 GiB. Ao acrescentar um KV cache FP8, desceu para 49 tok/s. A execução é demasiado curta para definir capacidade, mas mostra que cada definição precisa da sua própria medição.
5. Algoritmos versus kernels de runtime
Os algoritmos de quantização (como o GPTQ ou o AWQ) definem como os pesos do modelo são convertidos para menor precisão. Os kernels de runtime (como o Marlin ou os kernels personalizados do vLLM) são o código de baixo nível da GPU que executa a multiplicação de matrizes. Um modelo muito comprimido só corre depressa se existir um kernel otimizado para o seu formato de quantização específico.
Uma receita de serving nomeia um item de cada camada: um algoritmo (GPTQ, AWQ), um formato de checkpoint (compressed-tensors, GGUF), um runtime (vLLM, llama.cpp) e um kernel (Marlin). O mesmo checkpoint AWQ pode correr a velocidades muito diferentes consoante o kernel.
O gráfico emparelha cada checkpoint de 4 bits com e sem o kernel Marlin num benchmark publicado. A tabela abaixo acrescenta a perplexidade e o TTFT.
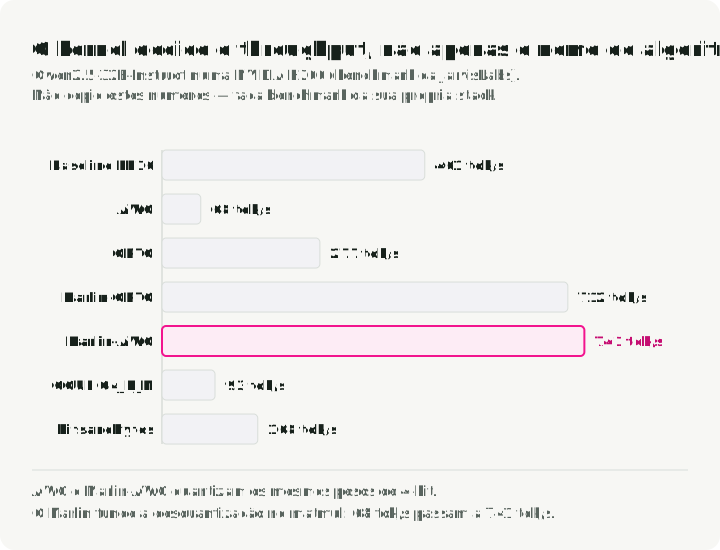
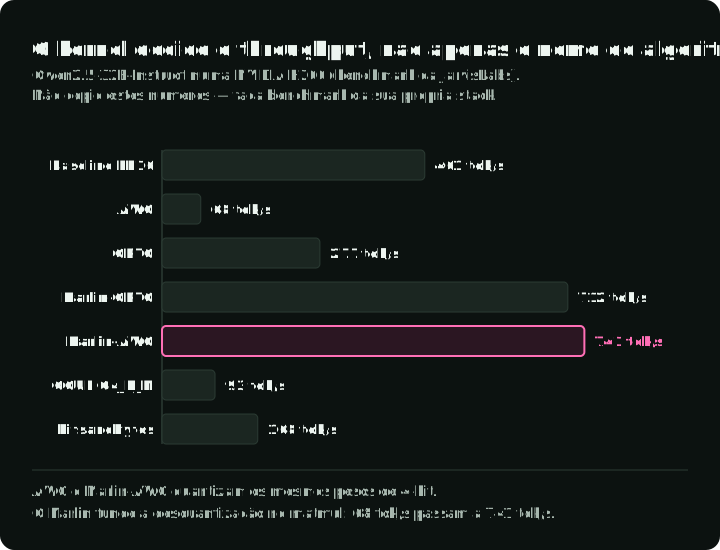
O benchmark de vLLM da JarvisLabs executou o Qwen2.5-32B-Instruct numa NVIDIA H200. A perplexidade mede o quão bem o modelo prevê o texto de teste; quanto mais baixa, melhor. O HumanEval pass@1 mede o sucesso em tarefas de código com uma única solução gerada. Os output tokens/s medem o débito de geração, enquanto o mean TTFT mede a espera média pelo primeiro token de saída:
| Quantização / kernel | Perplexidade Wikitext-2 ↓ | HumanEval pass@1 ↑ | Output tokens/s | Mean TTFT |
|---|---|---|---|---|
| FP16 de referência | 6.56 | 56.1% | 461 tok/s | 57.7 ms |
| AWQ | 6.84 | 51.8% | 68 tok/s | 277.8 ms |
| GPTQ | 6.90 | 46.3% | 277 tok/s | 107.1 ms |
| Marlin-GPTQ | 6.97 | 45.7% | 712 tok/s | 51.9 ms |
| Marlin-AWQ | 6.84 | 51.8% | 741 tok/s | 73.5 ms |
| GGUF Q4_K_M | 6.74 | 51.8% | 93 tok/s | 958.0 ms |
| bitsandbytes | 6.67 | 51.8% | 168 tok/s | 135.3 ms |
O teste de velocidade do fornecedor usa 200 prompts do ShareGPT, concorrência máxima de 10 e seed 42. A qualidade vem de execuções separadas de Wikitext-2 e HumanEval. O relatório não fixa a versão do vLLM nem as revisões dos modelos, pelo que estes são resultados comunicados pelo fornecedor e não uma comparação reproduzida de forma independente. Mostram uma conclusão mais estreita: o nome do algoritmo no checkpoint não diz a que velocidade o serving vai correr.
Por exemplo, o AWQ e o Marlin-AWQ usam ambos os mesmos pesos de 4 bits. A implementação Marlin é muito mais rápida porque o seu kernel CUDA funde a desquantização e a multiplicação de matrizes numa única operação de GPU altamente otimizada.
Para a sua própria comparação, crie ou obtenha primeiro um checkpoint AWQ compatível com o vLLM no caminho abaixo; estes comandos não quantizam o modelo. Instale uma build do vLLM suportada pela sua GPU e arranque o servidor num terminal:
vllm serve ./outputs/Qwen2.5-32B-Instruct-AWQ-W4A16 \
  --served-model-name qwen2.5-32b-awq \
  --host 127.0.0.1 \
  --port 8000
Mantenha esse servidor a correr. Num segundo terminal, use vllm bench serve com o tokenizer real, separado do alias de modelo da API:
vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model qwen2.5-32b-awq \
  --tokenizer Qwen/Qwen2.5-32B-Instruct \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Este é um teste de carga sintético com 1024 tokens de entrada e 256 tokens de saída por pedido como alvo; não reproduz a tabela do ShareGPT nem é um teste de qualidade. Repita-o para a referência e para cada checkpoint preparado com o mesmo tokenizer, os mesmos comprimentos, a mesma seed e a mesma concorrência. Registe as contagens reais de tokens e a versão instalada do vLLM. Estes exemplos de comandos exigem o checkpoint preparado e a GPU de destino.
Acompanhe o débito, o TTFT, a latência entre tokens (o intervalo entre tokens consecutivos), o uso de memória e a qualidade da tarefa. Quando alguns destes valores se movem em sentidos opostos, esse compromisso é o que precisa de ver antes de lançar.
Algoritmos de quantização comparados
Estes métodos resolvem problemas de compressão diferentes:
| Algoritmo | Formato comum | O que tenta preservar | Custo principal |
|---|---|---|---|
| GPTQ | W4A16 | A saída da camada, usando estimativas Hessianas de como a alteração dos pesos afeta o erro de saída | Calibração lenta e processamento mais complexo |
| AWQ | W4A16 / W4A8 | Canais de ativação importantes | Precisa de calibração e de kernels de serving fundidos |
| SmoothQuant | W8A8 | O comportamento das ativações INT8, passando a escala dos outliers para os pesos | Ajuste da escala por modelo |
| QuaRot / SpinQuant | W4A4 / W4A8 | Menor pressão de outliers de ativação através de rotações | Complexidade das rotações em runtime |
| HQQ | W4A16 / W2A16 | Compressão weight-only rápida, sem calibração | A qualidade exige verificações downstream em larguras de bits muito baixas |
| QLoRA (NF4) | NF4 | Memória de treino de adaptadores | Não é uma boa escolha por omissão para serving |
| K-quants / IQ-quants GGUF do llama.cpp | Codificações de tensor mistas de poucos bits | Qualidade da inferência local por byte | Não foi concebido para serving em lote na cloud |
| RTN (round-to-nearest) | W8A16 / FP8 | Nada além da escala; sem dados de calibração | Grande perda de qualidade a 4 bits; use como referência |
| FP8 dinâmico | W8A8 FP8 | O intervalo de ativação por token em runtime; sem dados de calibração | Precisa de tensor cores FP8; GPUs mais antigas podem não ganhar velocidade |
O AutoGPTQ foi arquivado em abril de 2025 e o AutoAWQ foi arquivado e oficialmente descontinuado em maio de 2025. Para novos checkpoints compressed-tensors consumidos pelo vLLM, comece pelo llm-compressor. Use o GPTQModel quando precisar do percurso GPTQ ativo com Marlin, Machete, opções de memória para MoE ou offload para disco.
A poda e a distilação também reduzem o custo de serving, através de fluxos de trabalho separados. A esparsidade estruturada 2:4 remove pesos segundo um padrão que os tensor cores esparsos da NVIDIA conseguem aproveitar. A distilação treina um modelo estudante mais pequeno para copiar um maior, o que pode funcionar bem em tarefas restritas. Inclua qualquer um dos caminhos na lista de candidatos apenas quando o projeto aguentar o trabalho extra de poda ou de treino.
6. A memória de serving é mais do que os pesos
O checkpoint comprimido é apenas parte da pegada de memória do serving. Dimensione o runtime completo antes de decidir se a quantização dos pesos chega. O PagedAttention identifica o KV cache como um termo importante da memória de serving.
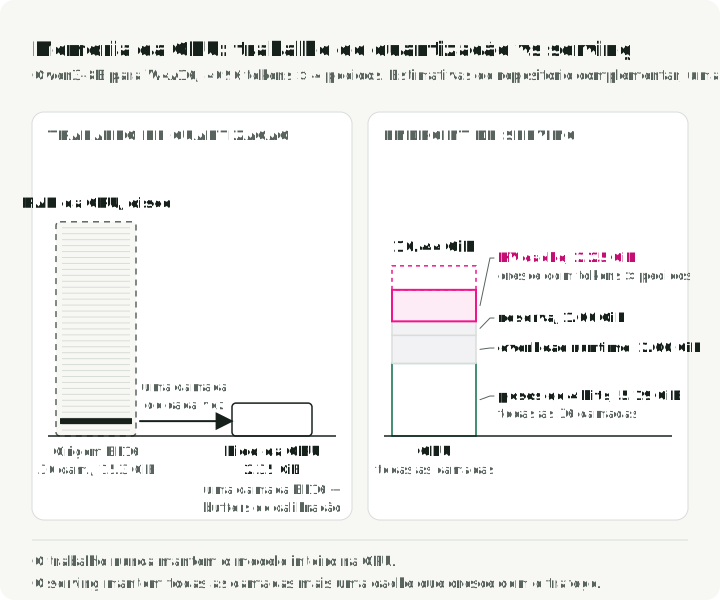
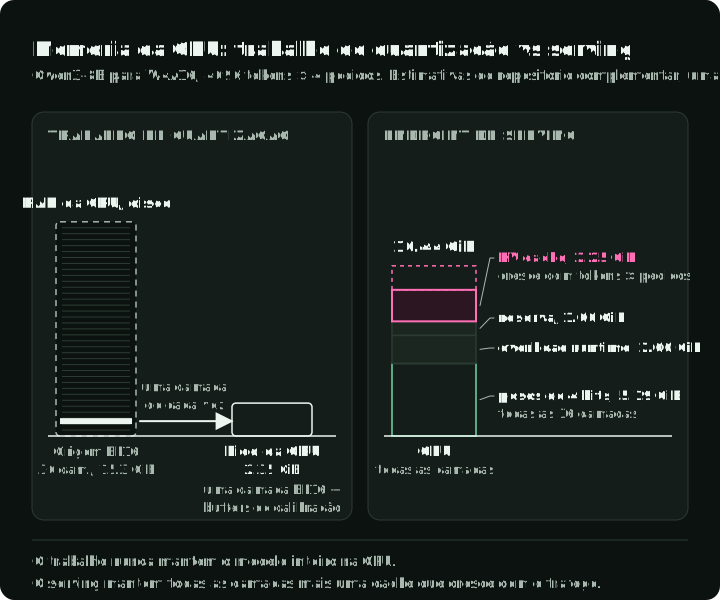
A quantização offline pode ser limitada por camada. Ferramentas como o llm-compressor conseguem carregar um bloco do transformer, executar a calibração e a matemática de quantização, escrever o bloco comprimido e seguir em frente. Assim, o pico de memória da GPU fica mais perto da maior camada ativa mais os buffers de calibração. Continua a precisar de RAM da CPU e de disco para o checkpoint de origem, mas a GPU nem sempre tem de guardar o modelo BF16 completo.
O pico de memória da GPU durante a quantização offline pode parecer-se mais com isto:
A figura desenha os dois orçamentos à mesma escala, com a estimativa W4A16 do Qwen3-8B do repositório complementar, da secção 9. O painel da esquerda é o trabalho offline; o painel da direita é o que tem de ficar na GPU durante o serving.
Para um serving totalmente residente na GPU, todos os pesos comprimidos têm de caber nas GPUs de serving juntamente com o KV cache e os buffers do runtime. O offload de pesos reduz a residência na GPU à custa de transferências. O KV cache cresce com o comprimento do contexto e com o tamanho do batch ativo. Para camadas de atenção uniformes e pedidos de igual comprimento, o seu payload de tensores é aproximadamente:
Esta estimativa exclui o overhead do alocador, os metadados de escala da cache e os prefixos partilhados. Para pedidos com comprimentos diferentes, substitua pela soma dos seus comprimentos em cache.
Onde:
- é o número de camadas.
- é o número de cabeças de atenção key-value. A grouped-query attention reduz este valor ao deixar muitas cabeças de query partilharem menos cabeças de KV.
- é a dimensão de cada cabeça, muitas vezes 128 ou 256.
- são os tokens do prompt mais os tokens gerados.
- é o batch de serving ativo.
- é 2 para BF16 ou FP16 e 1 para FP8 ou INT8. O modo de KV cache FP8 do vLLM é o exemplo de stack de serving que este artigo usa.
A quantização do KV cache altera o armazenamento, enquanto a reutilização altera a alocação
O KV cache pode ser quantizado durante a inferência. Cada passo de decode produz tensores de ativação K e V para o novo token. Um modelo W8A8 pode já usar FP8 ou INT8 na matemática de projeção suportada, mas a cache continua a ser um objeto de armazenamento separado.
Muitas stacks de serving guardam esse objeto no dtype do modelo ou da cache. Para o alterar, ative um dtype de KV cache, use um checkpoint com escalas de cache ou escolha uma implementação de cache quantizada.
Quando a quantização do KV cache está ativa, o motor escreve as entradas como uma representação de menor precisão mais escalas. Mais tarde, a atenção desquantiza a cache dentro do seu kernel ou, em alguns backends, executa parte da operação de atenção no domínio quantizado.
A documentação estável de Quantized KV Cache do vLLM expõe isto diretamente com kv_cache_dtype="fp8" ou --kv-cache-dtype fp8. O vLLM suporta os formatos de cache FP8 E4M3 e E5M2, além de estratégias de escala por tensor e por cabeça de atenção. Pode usar escalas por omissão ou calibração com dataset através do llm-compressor. Com a FlashAttention 3, o vLLM também consegue executar operações de atenção no domínio FP8, quantizando as queries além das chaves e dos valores. Para ativar a cache FP8 num modelo:
vllm serve Qwen/Qwen3-8B --kv-cache-dtype fp8 --max-model-len 32768O TensorRT-LLM expõe o KV cache FP8 através de KvCacheConfig(dtype='fp8') e lista o KV cache FP8 e o KV cache NVFP4 como receitas de quantização separadas da quantização de pesos/ativações. O Hugging Face Transformers também tem um caminho QuantizedCache através de cache_implementation="quantized", com o hqq a suportar formatos de cache int2, int4 e int8 e o quanto a suportar int2 e int4.
O KV caching comum guarda as chaves e os valores anteriores para evitar recalculá-los. O Prefix caching reutiliza blocos de cache entre pedidos com o mesmo prefixo. O PagedAttention reduz a fragmentação e melhora a alocação, enquanto o KV offload move blocos de cache entre níveis de memória. Estas combinações dependem do runtime. O QuantizedCache do Hugging Face não suporta offload. O vLLM documenta o seu KV cache quantizado em separado do prefix caching e de outras funcionalidades de gestão de cache. Verifique cada combinação no runtime que vai usar em produção.
O risco para a qualidade também difere do PTQ weight-only. A quantização do KV cache injeta erro no estado de atenção lido em cada passo de decode seguinte. Teste separadamente a recuperação em contexto longo, o comportamento em várias interações, a segurança e as recusas, o formato do tool use e a latência de saída. O KVQuant, o KIVI e o estudo de KV cache FP8 do vLLM avaliam todos a quantização do KV cache como um problema à parte.
Um exemplo concreto mostra quando a cache passa a ser maior do que os pesos. Considere o Llama-3.1-70B (80 camadas, 8 cabeças de KV, dimensão de cabeça 128) a servir 8 pedidos de 32 768 tokens:
def kv_cache_gb(layers, kv_heads, head_dim, tokens, batch, bytes_per_value):
    return 2 * layers * kv_heads * head_dim * tokens * batch * bytes_per_value / 1e9

# Llama-3.1-70B: 80 layers, 8 KV heads, head dimension 128
for name, nbytes in [("BF16", 2), ("FP8", 1)]:
    print(name, round(kv_cache_gb(80, 8, 128, 32_768, 8, nbytes), 1), "GB")
Imprime BF16 85.9 GB e FP8 42.9 GB. Com esta carga, a cache BF16 (86 GB) é maior do que os pesos INT4: cerca de 40 GB quando se contam as escalas de grupo e os embeddings de 16 bits, contra os 35 GB que a tabela da secção 7 indica só para os valores de 4 bits. A cache FP8 poupa 43 GB; passar os pesos de BF16 para INT4 poupa cerca de 100 GB. Aqui, a quantização dos pesos vem primeiro, e a cache é o maior termo restante. O gráfico empilha pesos e cache após cada passo.
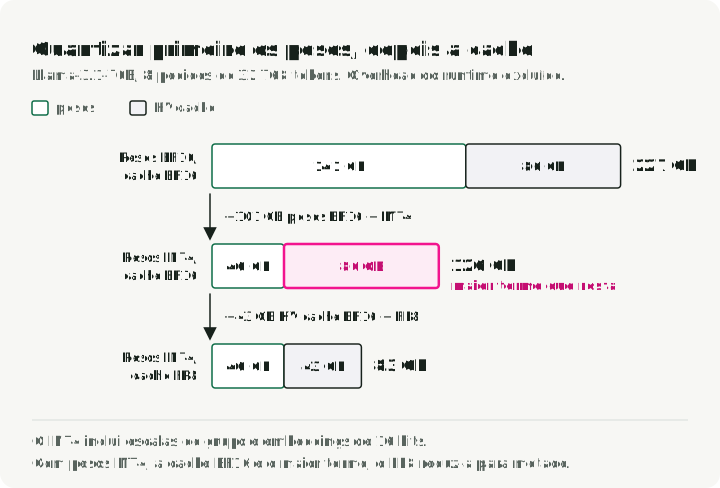
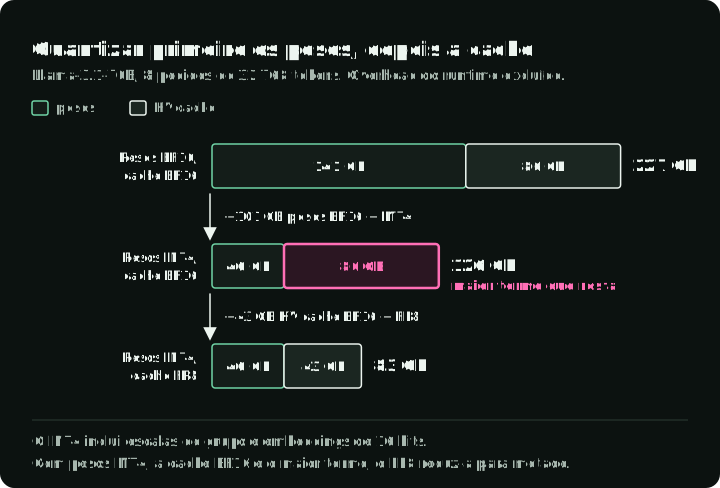
Compare quanta memória cada alteração pouparia no seu próprio modelo. Use a equação da cache acima, com o mesmo batch e o mesmo comprimento de contexto, para o dtype de cache atual e para o proposto. Subtraia o tamanho proposto ao tamanho atual. Faça o mesmo para os dois formatos de pesos que está a considerar. Por exemplo, compare a poupança de BF16 para cache FP8 com a poupança de BF16 para pesos INT4. Teste primeiro a opção com a maior poupança estimada, desde que o runtime a suporte. Depois meça o uso real de memória e a qualidade; nenhuma das estimativas inclui todas as alocações que o runtime faz.
7. Tamanho dos pesos e suporte de GPU
A pegada dos pesos é fácil de estimar a partir do número de parâmetros e da precisão de armazenamento, a mesma ideia de dimensionamento usada nas discussões de memória de serving em torno do KV cache:
| Tamanho do modelo | Pesos BF16 | Pesos FP8 / INT8 | Pesos INT4 |
|---|---|---|---|
| 7B / 8B | ~14-16 GB | ~7-8 GB | ~3.5-4 GB |
| 14B | ~28 GB | ~14 GB | ~7 GB |
| 32B / 34B | ~64-68 GB | ~32-34 GB | ~16-17 GB |
| 70B | ~140 GB | ~70 GB | ~35 GB |
| 109B MoE | ~218 GB no total | ~109 GB | ~55 GB |
A coluna INT4 conta apenas os valores de 4 bits. As escalas de grupo acrescentam alguns pontos percentuais, e os embeddings e o lm_head mantidos em 16 bits acrescentam mais. No Qwen3-8B, estas duas matrizes têm cerca de 1.2 GB cada em BF16. A estimativa W4A16 de 5.19 GiB do repositório complementar mantém 12% dos parâmetros em 16 bits para as cobrir.
Para um orçamento de memória fixo, um modelo maior a 4 bits pode superar um modelo mais pequeno a 16 bits. Dettmers e Zettlemoyer concluíram que a precisão de 4 bits é quase universalmente ótima para a precisão zero-shot por bit total do modelo, em modelos BLOOM, OPT, Pythia e GPT-2 de 19M a 176B de parâmetros. O estudo mediu apenas a precisão zero-shot, por isso teste as suas próprias tarefas antes de escolher.
Os modelos mixture-of-experts podem ativar menos parâmetros por token, mas o conjunto completo de pesos continua a ter de estar algures, a menos que o runtime suporte offload. A matriz de suporte de quantização do TensorRT-LLM trata as famílias de modelos MoE como alvos de deployment com as suas próprias receitas suportadas.
O hardware de deployment restringe os formatos de quantização viáveis:
- O serving em CPU depende de instruções vetoriais como AVX-512 ou AMX. Um ficheiro GGUF carregado através do
llama.cppé o caminho prático. - O Apple Silicon usa memória unificada, por isso os modelos locais podem usar um grande conjunto de RAM partilhada em vez de VRAM dedicada. O GGUF e o
llama.cppcontinuam a ser o caminho comum de runtime local porque o GGUF foi construído para executores GGML. O MLX é o outro caminho comum:mlx_lm.convert --model <model> -qescreve por omissão um modelo MLX de 4 bits, e--q-bits 8escreve um de 8 bits. Compare a velocidade e a qualidade com os mesmos prompts antes de escolher. - A NVIDIA Ampere suporta percursos de serving INT8 em tensor cores, mas não matemática W8A8 FP8 nativa em tensor cores. As escolhas comuns são a quantização weight-only W4A16 ou INT8 estático, de acordo com a matriz de suporte de hardware do TensorRT-LLM.
- A NVIDIA Ada e Hopper suportam percursos de serving FP8 no TensorRT-LLM. O serving FP8 W8A8 vale a pena testar nestas GPUs.
- A NVIDIA Blackwell acrescenta NVFP4 e suporte de microscaling, mas o percurso de software continua a importar. Trate as primeiras stacks de vírgula flutuante de poucos bits como sensíveis à versão.
8. Calibração e avaliação antes do deployment
Um modelo que carrega só passou num smoke test. O deployment exige verificações de qualidade e de serving para a carga de trabalho de destino. As avaliações de quantização recentes relatam resultados diferentes para serving de LLMs, tarefas de contexto longo e modelos centrados em raciocínio.
A figura mostra para onde vão as amostras de calibração e as amostras de avaliação reservadas.
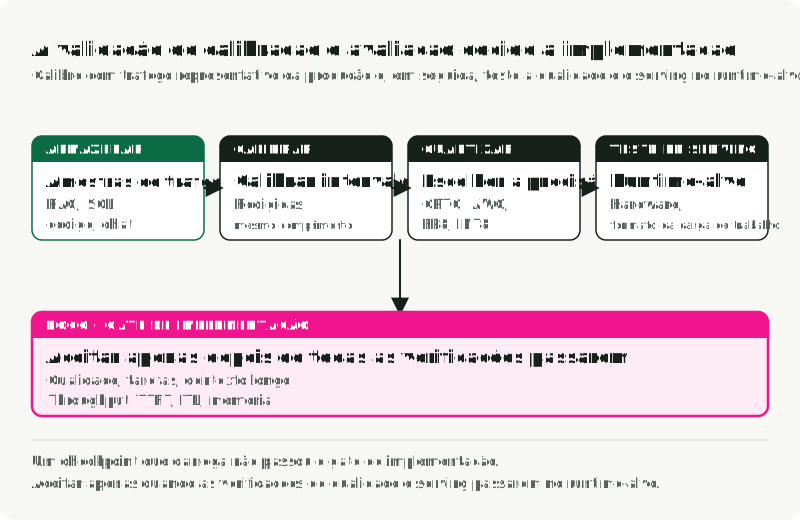
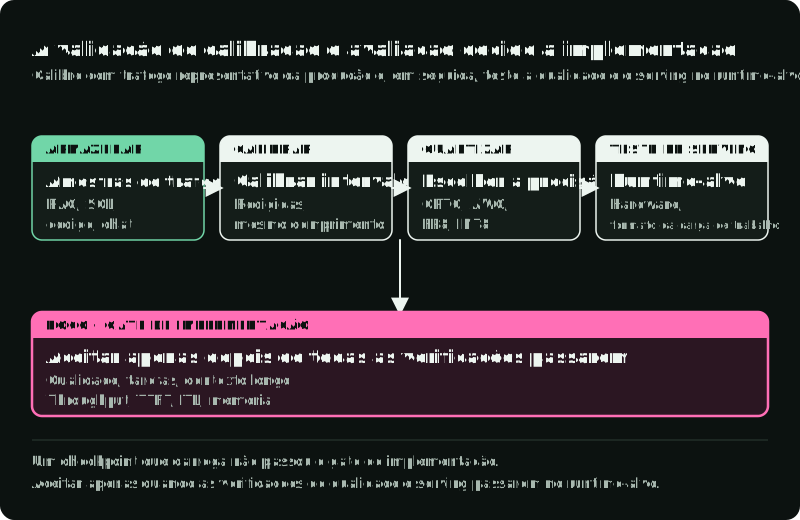
Escolha primeiro a receita. Quando ela exigir calibração, use prompts que se pareçam com a produção. O HQQ e o FP8 dinâmico, por exemplo, não precisam de dataset de calibração, por isso a figura mostra um caminho que dispensa a calibração. Mantenha os exemplos de avaliação separados das amostras de calibração, para que a comparação final teste comportamento em dados não vistos. Para receitas que precisam de calibração:
- Inclua traces de RAG, consultas SQL, históricos de agentes, tarefas de código, payloads de tool calls e system prompts da carga de trabalho de destino. O PTQ estático depende de os dados de calibração corresponderem à distribuição de produção.
- Faça corresponder os comprimentos de sequência. Prompts curtos de um só turno não expõem o comportamento das ativações em contexto longo.
- Mantenha
embed_tokenselm_headem maior precisão, se o método ou o runtime o permitirem, um padrão de exclusão comum nas receitas do LLM Compressor. - Use amostras suficientes para estabilizar os intervalos de ativação. O exemplo de KV cache do vLLM define
NUM_CALIB_SAMPLES = 512. Trate isto como um exemplo documentado, não como um número universal. O número certo de amostras depende do método, do modelo, do comprimento das sequências e da carga de trabalho de produção. - Retire segredos e dados privados de utilizadores antes de usar logs de produção.
Na avaliação, teste tanto a qualidade da linguagem como o comportamento de serving:
- A perplexidade num corpus padrão deteta a degradação geral da linguagem, mas o benchmark da JarvisLabs lembra de forma útil que a perplexidade e o débito podem mover-se de maneira diferente.
- As tarefas de domínio detetam falhas que a perplexidade esconde. Use o HumanEval para programação, o MMLU para conhecimento geral e o AIME ou o MATH-500 para raciocínio matemático, quando esses domínios importarem.
- As verificações de formato importam para sistemas agentic. Teste a conformidade com JSON Schema, a saída em markdown, o formato dos tool calls e o comportamento de recusa, porque as avaliações de modelos quantizados podem não detetar falhas ao nível da aplicação, mesmo quando a precisão agregada dos benchmarks parece estável.
- Os testes de contexto longo detetam danos da quantização do KV cache. O needle-in-a-haystack é rudimentar, mas os resultados de quantização em contexto longo mostram porque é que essas verificações pertencem à fase anterior ao deployment.
- Os testes de carga devem reportar o débito, o TTFT, a latência entre tokens, a concorrência sustentável e o pico de memória da GPU. O
vllm bench servemede o débito e a latência. Recolha a memória da GPU em separado, com telemetria da GPU/do servidor. Varie a concorrência face a limites declarados de latência e de erros para encontrar um nível sustentável; a concorrência observada numa execução não estabelece a capacidade.
Numa aplicação RAG, mantenha fixas as perguntas e a evidência recuperada ao comparar o gerador de referência com o quantizado. Essa comparação isola a alteração do gerador. Depois execute o pipeline completo para verificar o resultado do serving, usando o guia de avaliação de RAG para separar falhas de recuperação de respostas sem suporte. Num agente, inclua se as mesmas tarefas terminam com tool calls válidos e efeitos secundários aceitáveis. Um checkpoint mais pequeno, por si só, não responde a nenhuma destas perguntas.
Teste os modelos de raciocínio em tarefas de vários passos. A quantização abaixo de 4 bits ou a W4A4 sem rotações pode prejudicar a precisão do raciocínio mesmo quando a perplexidade de referência parece estável, o que é o aviso central do estudo sobre modelos de raciocínio quantizados.
9. Fluxo de trabalho do repositório complementar
O repositório complementar, slavadubrov/model-compression-demo, torna o processo de decisão reproduzível. Usa o uv e concentra-se em planeamento, receitas, dry runs e configurações de benchmark baseadas nas mesmas fontes usadas aqui: vLLM, LLM Compressor, TensorRT-LLM e os artigos dos algoritmos.
Clone-o e inspecione os algoritmos suportados:
git clone https://github.com/slavadubrov/model-compression-demo.git
cd model-compression-demo
git checkout 62da4539793ac3a93e94e8551a063c7681561099
uv run python demo.py list-algorithms
Estes comandos de planeamento usam apenas a biblioteca padrão do Python. Comece pelo planeamento e pelo dimensionamento:
uv run python demo.py plan \
  --model-preset qwen3-8b \
  --goal fit-memory \
  --hardware ampere \
  --context 4096 \
  --concurrency 4

uv run python demo.py estimate \
  --model-preset qwen3-8b \
  --scheme w4a16 \
  --context 4096 \
  --concurrency 4
O plan escolhe GPTQ W4A16 para este objetivo e imprime os dois orçamentos da secção 6: um alvo de serving de 10.44 GiB e um pico de GPU de 2.35 GiB para o trabalho de quantização camada a camada. O estimate detalha o alvo de serving:
Architecture:     Qwen3 8B (built-in preset from official Hugging Face config)
Layers/hidden/KV: 36 / 4096 / 0.250
Note:             Causal text-generation checkpoint suitable for the text-only harness.
Scheme:           w4a16
Weights:          5.19 GiB
KV cache:         2.25 GiB
Runtime overhead: 2.00 GiB
Safety buffer:    1.00 GiB
Total target:     10.44 GiB
Weights e KV cache são os dois primeiros termos da equação de memória de serving da secção 6. Runtime overhead e Safety buffer são a margem que o repositório complementar reserva para as ativações e o overhead do motor. A linha do KV cache é a fórmula da cache com as 36 camadas, 8 cabeças de KV e dimensão de cabeça 128 do Qwen3-8B, com 4096 tokens e 4 pedidos concorrentes.
Depois imprima a receita e pré-visualize a quantização antes de gastar tempo de GPU:
uv run python demo.py recipe --algorithm gptq-w4a16

uv run python demo.py quantize \
  --algorithm gptq-w4a16 \
  --model Qwen/Qwen3-8B \
  --dry-run
O comando recipe imprime o código do llm-compressor que o passo de quantização executa:
from llmcompressor import oneshot
from llmcompressor.modifiers.quantization import GPTQModifier

recipe = GPTQModifier(
    scheme="W4A16",
    targets="Linear",
    ignore=["lm_head"],
)

oneshot(
    model="Qwen/Qwen3-8B",
    dataset="wikitext",
    dataset_config_name="wikitext-2-raw-v1",
    recipe=recipe,
    output_dir="outputs/Qwen3-8B-W4A16",
    max_seq_length=4096,
    num_calibration_samples=256,
)
targets e ignore decidem que camadas recebem pesos de 4 bits; num_calibration_samples e max_seq_length são as escolhas de calibração da secção 8. O WikiText é o valor por omissão para smoke tests; passe --calibration-file com prompts semelhantes aos de produção para um checkpoint a sério.
A receita GPTQ escreve um checkpoint compressed-tensors. O GPTQ é o algoritmo, não o formato do checkpoint, por isso o vLLM deteta o formato a partir do checkpoint sem a flag --quantization, como no seu exemplo oficial de W4A16.
Para quantizar, execute make install-compression. O vLLM precisa do seu próprio ambiente porque as suas dependências entram em conflito com as do llm-compressor: execute make install-serving e depois use .venv-vllm/bin/vllm para os comandos serve e bench.
Faça o serving e o benchmark de cada checkpoint face à referência RTN W8A16 da tabela de algoritmos. Execute quantize sem --dry-run para gptq-w4a16 e rtn-w8a16, para escrever outputs/Qwen3-8B-W4A16 e outputs/Qwen3-8B-W8A16. O comando benchmark-plan do repositório complementar escreve num ficheiro JSON um comando de serve e um de benchmark para cada checkpoint. Para executar a comparação à mão, arranque o servidor W4A16 num terminal:
.venv-vllm/bin/vllm serve outputs/Qwen3-8B-W4A16 --host 127.0.0.1 --port 8000Num segundo terminal, execute a mesma carga sintética da secção 5:
.venv-vllm/bin/vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model outputs/Qwen3-8B-W4A16 \
  --tokenizer Qwen/Qwen3-8B \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Pare o servidor e execute de novo os dois comandos com outputs/Qwen3-8B-W8A16, a referência RTN W8A16, no lugar de outputs/Qwen3-8B-W4A16.
Por fim, compare o modelo base e os modelos comprimidos com limiares explícitos:
uv run python demo.py quality-eval \
  --base-model Qwen/Qwen3-8B \
  --compressed-model outputs/Qwen3-8B-W4A16 \
  --mode all \
  --lm-eval-task hellaswag \
  --lm-eval-limit 50 \
  --max-perplexity-delta-pct 5 \
  --output-json reports/qwen3-8b-w4a16-quality.json
Execute o trabalho por ordem: planeie o alvo, estime a memória, faça o dry run da receita, faça o benchmark do serving e depois compare a qualidade com os limiares. Essa sequência reflete a separação que este artigo faz entre dimensionamento de memória, benchmarking de runtime e avaliação de qualidade.
10. Os modelos de difusão precisam de um percurso separado
Os pipelines de difusão e de diffusion transformers têm um comportamento de ativações diferente do dos LLMs autorregressivos. O SVDQuant trata a quantização de difusão como um problema separado de outliers de ativação.
Os LLMs autorregressivos geram um token de cada vez. Os modelos de difusão executam passos repetidos de remoção de ruído, e as suas distribuições de ativação mudam ao longo do processo, como o Q-Diffusion reporta para as saídas da rede de remoção de ruído ao longo dos passos de tempo. Uma passagem de quantização de 4 bits típica de LLMs pode poupar memória num modelo de difusão e, ao mesmo tempo, introduzir artefactos visuais graves. Métodos centrados em difusão, como o SVDQuant / Nunchaku e a quantização de difusão do NVIDIA ModelOpt, tratam esse padrão de ativação diferente.
Num pipeline de difusão latente, o codificador de texto representa o prompt. Uma rede de remoção de ruído, como um diffusion transformer (DiT) ou uma U-Net, atualiza repetidamente uma representação comprimida da imagem, chamada latente. O variational autoencoder (VAE) converte entre essas representações latentes e as imagens. Estes componentes têm funções diferentes, por isso teste a precisão de cada um separadamente.
Use o que se segue como heurísticas conservadoras, não como valores por omissão universais. O pipeline, o componente, o modelo e o runtime precisam cada um de testes separados:
- Mantenha o VAE em 16 bits na primeira comparação. Teste precisões mais baixas apenas quando o método e o pipeline de destino as validarem.
- Experimente primeiro o backbone DiT ou U-Net, porque muitas vezes concentra a maior parte dos parâmetros. Verifique a memória, a latência e a qualidade de imagem no pipeline de destino. Os métodos de quantização de difusão seguem a mesma abordagem por componente.
- Trate os codificadores de texto em separado. Quantizar o T5-XXL ou o CLIP pode afetar o alinhamento com o prompt ou a renderização de texto num dado pipeline, por isso avalie-os de forma independente, em vez de assumir o comportamento genérico de um transformer.
- Use métodos conscientes da difusão, como o SVDQuant, quando os outliers de ativação forem o problema principal.
- Avalie com imagens, não com métricas de texto. Verifique a adesão ao prompt, a renderização de texto, os tons de pele, o equilíbrio de cor, o detalhe fino, a latência e a VRAM. Para comparar com o pipeline de 16 bits, meça o LPIPS ou o PSNR entre imagens emparelhadas (mesma seed) e o CLIP score ou o ImageReward para o alinhamento com o prompt, como faz a avaliação do SVDQuant. Depois reveja os casos difíceis à vista.
Se o conjunto de avaliação só tiver prompts simples ou comuns, vai deixar escapar as falhas em casos limite. Inclua casos difíceis: texto pequeno, mãos, objetos repetidos, layouts estruturados e prompts com restrições negativas, porque as falhas da quantização de difusão aparecem visualmente e não na perplexidade de modelos de linguagem.
11. Predefinições de produção
A figura coloca a primeira tentativa para cada tipo de deployment num eixo de largura de bits, com o teste seguinte e a condição para o fazer. Cada uma continua a precisar das verificações da secção 8.
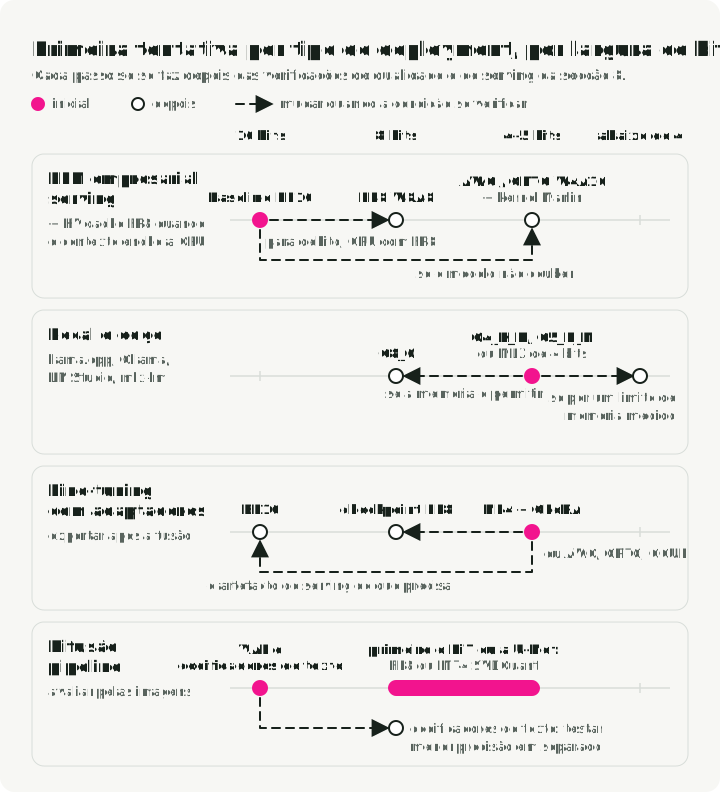
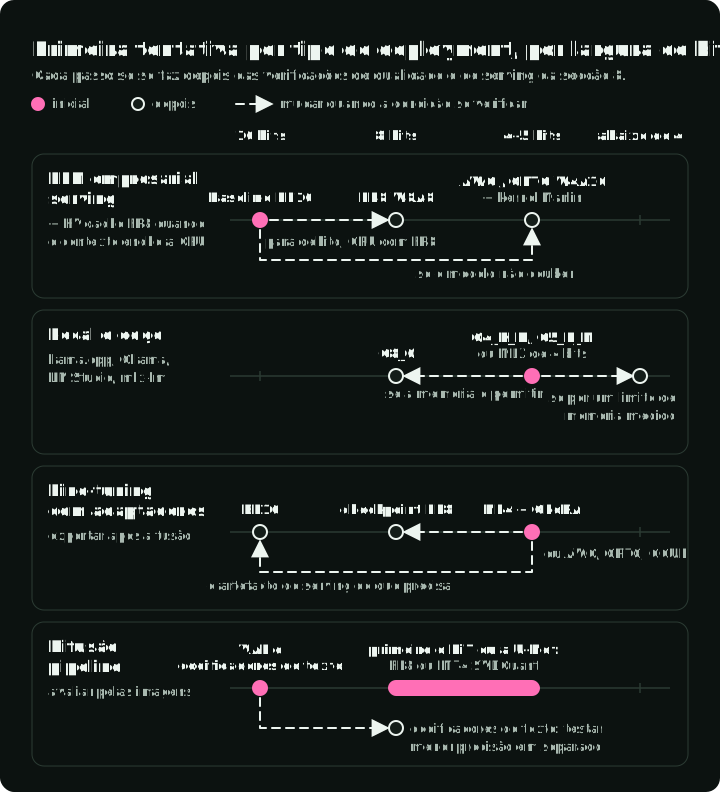
Para serving empresarial de LLMs, comece com uma referência BF16 no motor de serving exato que pretende usar. Se o objetivo for o débito e a GPU o suportar, teste FP8 W8A8. Se o modelo não couber, teste AWQ ou GPTQ W4A16 com kernels da classe Marlin. Se o contexto longo ou a concorrência encherem a GPU, teste um KV cache FP8. Faça o deployment da versão comprimida apenas quando as verificações de qualidade e de serving passarem ambas.
Para inferência local e edge, comece com um ficheiro GGUF em Q4_K_M ou Q5_K_M, ou com um modelo MLX de 4 bits num Mac. Passe para Q8_0 quando a memória o permitir e compare a qualidade da tarefa. Use codificações abaixo de 4 bits apenas perante um limite de memória medido.
Para fine-tuning, use NF4 com QLoRA para treinar adaptadores com menos memória. Avalie o adaptador na aplicação antes do merge. Depois do merge, exporte e avalie o artefacto de serving de que precisa: um ficheiro GGUF compatível com o llama.cpp, um checkpoint AWQ/GPTQ/compressed-tensors, um checkpoint FP8 ou BF16.
Para difusão, quantize primeiro o denoiser, mantenha o VAE em 16 bits e teste os codificadores de texto em separado, como na secção 10. Compare imagens emparelhadas da mesma seed e reveja à vista os prompts difíceis.
12. Execute a próxima comparação
Mantenha a referência BF16 e compare um candidato comprimido suportado nas mesmas tarefas não vistas e no mesmo tráfego. Escreva a perda de qualidade e a latência que consegue aceitar antes de o executar. Meça o pico de memória e também a velocidade: o resultado útil é saber se o candidato elimina o seu bottleneck dentro desses limites.
Referências
- JarvisLabs vLLM Benchmarks: JarvisLabs, vLLM Quantization Complete Guide and Benchmarks, 2026. JarvisLabs.
- Hugging Face Optimum Quantization Guide: Hugging Face, Quantization conceptual guide. Documentação.
- vLLM Quantization Docs: projeto vLLM, Quantization. Documentação.
- vLLM Quantized KV Cache Docs: projeto vLLM, Quantized KV Cache. Documentação.
- vLLM Benchmark Docs: projeto vLLM, vllm bench serve. Documentação.
- LLM Compressor Docs: projeto vLLM, LLM Compressor. Documentação.
- GPTQModel: ModelCloud, GPTQModel. GitHub.
- TensorRT-LLM Quantization: NVIDIA, TensorRT-LLM Quantization. Documentação.
- NVIDIA NVFP4: NVIDIA, Introducing NVFP4 for Efficient and Accurate Low-Precision Inference. Blog.
- Hugging Face QuantizedCache: Hugging Face, Cache strategies: Quantized cache. Documentação.
- NVIDIA Model Optimizer: NVIDIA, Model Optimizer. GitHub.
- torchao Quantization: PyTorch, torchao quantization overview. Documentação.
- bitsandbytes Quantization: Hugging Face, bitsandbytes. Documentação.
- HQQ: Dropbox, Half-Quadratic Quantization. GitHub.
- PEFT: Hugging Face, Parameter-Efficient Fine-Tuning. Documentação.
- Ollama: Ollama, runtime local de modelos. Sítio.
- LM Studio: LM Studio, runtime local de AI. Sítio.
- Estado do AutoGPTQ: Repositório AutoGPTQ, arquivado em abril de 2025. GitHub.
- Estado do AutoAWQ: Repositório AutoAWQ, arquivado e descontinuado em maio de 2025. GitHub.
- GPTQ: Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, ICLR 2023. arXiv:2210.17323.
- Marlin: Frantar et al., MARLIN: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models, arXiv:2408.11743. arXiv:2408.11743.
- AWQ: Lin et al., AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, MLSys 2024. arXiv:2306.00978.
- SmoothQuant: Xiao et al., SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, ICML 2023. arXiv:2211.10438.
- QuaRot: Ashkboos et al., QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs, NeurIPS 2024. arXiv:2404.00456.
- SpinQuant: Meta AI Research, SpinQuant: LLM Quantization with Learned Rotations, arXiv:2405.16406. arXiv:2405.16406.
- QLoRA / NF4: Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, NeurIPS 2023. arXiv:2305.14314.
- SVDQuant / Nunchaku: MIT HAN Lab, SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models, ICLR 2025. arXiv:2411.05007, Nunchaku.
- vLLM PagedAttention: Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023. arXiv:2309.06180.
- Grouped-Query Attention: Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, EMNLP 2023. arXiv:2305.13245.
- vLLM FP8 KV Cache: Kubler, Kurtic, Wilkinson et al., The State of FP8 KV-Cache and Attention Quantization in vLLM, blog do vLLM, abril de 2026. vLLM Blog.
- KIVI: Liu et al., KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache, ICML 2024. arXiv:2402.02750.
- KVQuant: Hooper et al., KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization, NeurIPS 2024. arXiv:2401.18079.
- LLM Serving Evaluation: Kurtic et al., “Give Me BF16 or Give Me Death”? Accuracy-Performance Trade-Offs in LLM Quantization, ACL 2025. arXiv:2411.02355.
- Long-context Quantization Evaluation: Mekala et al., Does quantization affect models’ performance on long-context tasks?, arXiv:2505.20276. arXiv:2505.20276.
- Reasoning Evaluation: Quantization Hurts Reasoning? An Empirical Study on Quantized Reasoning Models, arXiv:2504.04823. arXiv:2504.04823.
- 2:4 Sparsity: Mishra et al., Accelerating Sparse Deep Neural Networks, arXiv:2104.08378. arXiv:2104.08378.
- Leis de escala em k bits: Dettmers and Zettlemoyer, The case for 4-bit precision: k-bit Inference Scaling Laws, ICML 2023. arXiv:2212.09720.
- Q-Diffusion: Li et al., Q-Diffusion: Quantizing Diffusion Models, ICCV 2023. arXiv:2302.04304.
- MLX LM: Apple ml-explore, mlx-lm. GitHub.
- HumanEval: OpenAI, HumanEval. GitHub.
- MMLU: Hendrycks et al., Measuring Massive Multitask Language Understanding. arXiv:2009.03300.
- MATH-500: Hugging Face H4, MATH-500. Dataset.
- GGUF e llama.cpp: ggml-org, GGUF file format e llama.cpp. GGUF, llama.cpp.
- Hugging Face GGUF Docs: Hugging Face, GGUF. Documentação.
- Repositório complementar: slavadubrov/model-compression-demo.