Leitfaden zur Model Quantization: Von den Grundlagen bis zum Production Serving

Automatische Übersetzung
Dieser Artikel wurde automatisch aus der englischen Originalversion übersetzt.
Dieser Leitfaden zur Quantization richtet sich an Engineers, die Language Models deployen und dabei den Speicherbedarf senken oder die Serving-Geschwindigkeit verbessern müssen. Sie lernen, wie Sie entscheiden, was komprimiert wird, wie Sie ein Zahlenformat auf Hardware und Runtime abstimmen und wie Sie Speicherbedarf, Latency und Output-Qualität vor dem Deployment vergleichen. Außerdem behandelt der Leitfaden die separaten Checks für Diffusion-Image-Models.
Quantization reduziert die Anzahl der Bits für Weights, Activations oder den KV cache. Weights sind die Model-Parameter, die beim Training gelernt werden. Activations sind Zwischenwerte, die für jeden Input berechnet werden. Der Key-Value-Cache (KV cache) hält Werte früherer Tokens für die Wiederverwendung während der Generierung vor. Werden nur die Weights komprimiert, passt ein Model zwar in den GPU-Speicher, es bleibt aber womöglich zu wenig Platz für eine lange Konversation. Welches Limit Sie entlasten, hängt davon ab, was Sie komprimieren und welcher GPU-Code es ausführt.
Beginnen Sie damit, was den Request langsam oder zu groß macht. Die Verarbeitung des Input-Prompts heißt Prefill; die Generierung der Antwort Token für Token heißt Decode. Prefill kann durch die GPU-Arithmetik begrenzt sein, Decode dagegen dadurch, wie schnell Weights aus dem Speicher geladen werden. Auch Model Weights und der wachsende KV cache können den GPU-Speicher erschöpfen. Die erste Tabelle ordnet diese Probleme möglichen Lösungen zu; die späteren Abschnitte erklären die Berechnungen und Checks, die vor dem Deployment nötig sind.
Eine geringere Bitbreite ist nur ein Kandidat. Die Entscheidung braucht sowohl Ergebnisse zur Task-Qualität als auch Serving-Messungen für das Model, die Runtime und den Traffic, die Sie einsetzen. Die Benchmarks hier sind veröffentlichte Ergebnisse anderer Teams sowie ein kurzer Lauf aus dem Companion-Repository.
Einen kurzen Vergleich der Artefakte und Methoden finden Sie unter LLM Quantization Formats.
1. Bottlenecks und Startformate
Fragen Sie vor der Wahl einer Bitbreite, was den Workload begrenzt. Die Antwort kann der Speicherbedarf der Model Weights, die Prefill-Rechenleistung, die Decode-Bandbreite oder der KV cache sein, nicht die numerische Präzision allein.
In Serving-Rezepten verwendete Notation
- W4A16 speichert Weights in 4-Bit-Form und behält Activations in 16-Bit-Präzision. Allgemeiner benennt W{x}A{y} die Präzision von Weights und Activations in unterstützten Operationen, meist der Matrixmultiplikation. W8A8 verwendet in diesen Operationen 8-Bit-Weights und -Activations, legt aber nicht automatisch den gespeicherten Datentyp jedes Runtime-Tensors fest.
- FP8, INT8, INT4, NF4 sind Zahlenformate. Sie bestimmen, welche Werte darstellbar sind.
- GPTQ, AWQ, SmoothQuant, QuaRot sind Algorithmen. Sie bestimmen, wie ein trainiertes Model in ein Format mit geringerer Präzision überführt wird.
- GGUF ist ein Dateiformat, das Tensoren und Metadaten für GGML- und
llama.cpp-artige Runtimes speichert. Eine GGUF-Datei kann nicht quantisierte Tensor-Typen wieF16,BF16oderF32enthalten, ebenso quantisierte Kodierungen. Zu den Presets gehörenQ4_K_M,Q5_K_M,Q8_0,IQ*,TQ*undMXFP4. Die Tensor-Kodierung bestimmt die Quantization-Wahl.GGUFallein beschreibt kein FP8-W8A8-Serving-Rezept im CUDA-Stil. - KV cache ist der Attention-Cache, der während der Generierung verwendet wird. Er speichert frühere Keys und Values, damit das Model nicht bei jedem Token die gesamte Konversation neu berechnen muss.
- KV-cache quantization speichert die gecachten Key-/Value-Activation-Tensoren in einem Cache-Format mit geringerer Präzision, etwa FP8, INT8, INT4 oder INT2, je nach Unterstützung der Runtime. Das unterscheidet sich von Prefix Caching, PagedAttention oder Offload. Diese entscheiden, ob Cache-Einträge wiederverwendet werden, wie sie allokiert werden oder wo sie liegen.
- GEMM steht für General Matrix Multiply. Der Großteil der Transformer-Inference-Zeit entfällt auf Matrixmultiplikation.
Was quantisiert wird
Ein Rezept legt fest, welche Tensoren komprimiert werden. Üblich sind diese Entscheidungen:
| Tensor | Üblicherweise quantisiert? | Warum |
|---|---|---|
| Weights der Linear-Layer | Ja, in W4A16- und W8A8-Rezepten | Weights sind nach dem Training fest, daher lassen sich ihre Scales offline berechnen. |
| Activations | Nur in W8A8-, W4A8- oder W4A4-Rezepten | Sie ändern sich mit jedem Input und brauchen daher kalibrierte Scales oder Scales zur Laufzeit. |
| KV cache | Optional, eine separate Runtime-Einstellung | Er wächst mit Context und Batch; Abschnitt 6 behandelt ihn. |
Embeddings und lm_head | Meist in 16-Bit belassen | LLM-Compressor-Rezepte führen lm_head unter ignore; Abschnitt 8 nennt diesen Ausschluss. |
| Diffusion-VAE und Text-Encoder | Im ersten Test in 16-Bit belassen | Abschnitt 10 testet sie getrennt vom Denoising-Netzwerk. |
Bottlenecks und Startpunkt
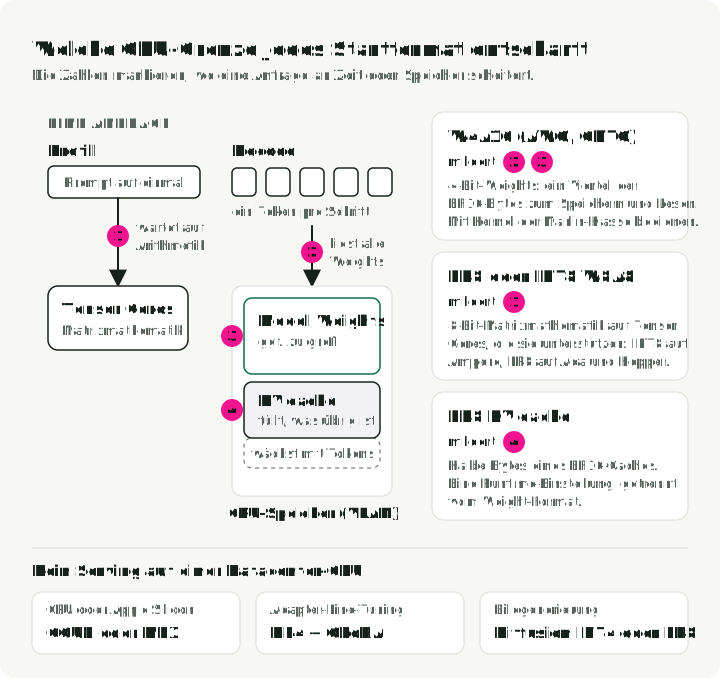
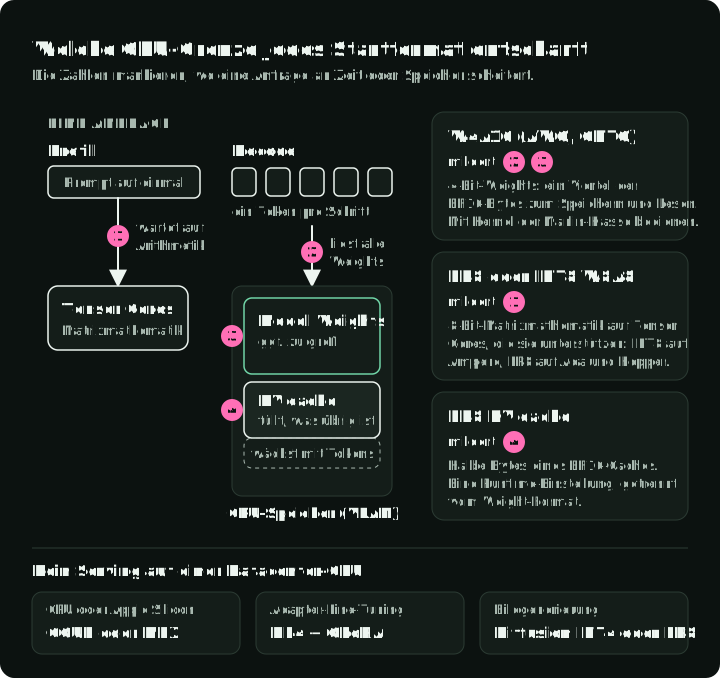
Die Tabelle ordnet gängige Bottlenecks einem Startformat zu. Sie verwendet die obige Notation.
| Wenn das Problem ist | Hier beginnen | Typische Tools | Check vor dem Deployment |
|---|---|---|---|
| Model Weights passen nicht in den VRAM | W4A16 Weight-only Quantization | AWQ oder GPTQ mit llm-compressor oder GPTQModel | Perplexity, Coding, Reasoning, Instruction Following |
| Serving mit hohem Durchsatz ist compute-bound | FP8 oder INT8 W8A8 | FP8 PTQ, SmoothQuant, TensorRT-LLM, vLLM | Throughput, Time to First Token (TTFT), Task-Genauigkeit |
| Langer Context oder hohe Concurrency füllt die GPU | KV-cache quantization | vLLM, TensorRT-LLM oder Transformers QuantizedCache | Retrieval im langen Context, Latency, Safety und Qualität |
| Lokale Inference auf CPU, Apple Silicon oder Desktop | GGUF-Dateien mit lokalen Tensor-Kodierungen | llama.cpp, Ollama, LM Studio, MLX | Prompt-Latency, RAM-Verbrauch, gewählte Tensor-Kodierung und subjektive Output-Qualität |
| Adapter-Fine-Tuning muss auf eine GPU passen | NF4 / QLoRA | bitsandbytes, peft | Fine-Tuning-Loss und Qualität des gemergten Models |
| Die Pipeline für Bildgenerierung ist zu groß oder zu langsam | Diffusion-spezifisches INT4 oder FP8 | SVDQuant, Nunchaku, torchao, NVIDIA ModelOpt | Visuelle Artefakte, Prompt-Treue, Latency, VRAM |
Die Abbildung zeigt, wo eine einzelne Anfrage auf einer Serving-GPU an Zeit oder Speicher scheitert und welches Startformat jede Grenze entschärft. Die untere Zeile deckt die Fälle ab, die kein Datacenter-GPU-Serving sind.
2. Quantization ist kontrolliertes Runden
Quantization bildet hochpräzise Werte auf eine kleinere Menge darstellbarer Werte ab. Das ist die Kerndefinition sowohl von Hugging Face Optimum als auch von TensorRT-LLM. Sie sparen Speicher und Bandbreite. Zugleich führen Sie einen Rundungsfehler ein.
INT4 bietet nur 16 diskrete Werte, daher erzeugt die Abbildung von 16-Bit-BF16-Weights auf dieses Raster einen Rundungsfehler. Quantization-Methoden bewerten das Runden danach, wie stark es den Output einer Layer verändert, nicht nur einzelne Weights. GPTQ schätzt, wie Rundungsentscheidungen diesen Output beeinflussen, und passt die verbleibenden Weights an, um den Fehler zu verringern. AWQ nutzt beobachtete Activations, um wichtige Weight-Gruppen, sogenannte Channels, zu erkennen, und skaliert sie vor dem Runden um. Eine gute Abbildung spart Speicher bei geringem Qualitätsverlust. Eine schlechte schädigt Reasoning, Instruction Following oder die visuelle Treue.
Symmetrische und asymmetrische Abbildung
Nach der affinen Abbildung aus gängigen Quantization-Leitfäden bildet Quantization einen kontinuierlichen Float-Wert auf ein diskretes Raster ab.
- und sind die gewählte untere und obere Gleitkomma-Grenze.
- ist der ursprüngliche hochpräzise Wert.
- ist der quantisierte Wert.
- ist die Scale oder Schrittweite.
- ist der Zero Point, die ganzzahlige Position, die
0.0darstellt. - ist der ganzzahlige Zielbereich. Dieses symmetrische Beispiel verwendet , das 15 Werte hat und die Null exakt darstellt. Andere vorzeichenbehaftete INT4-Formate nutzen alle 16 Werte, zum Beispiel .
Symmetrische Quantization zentriert das Raster um null und setzt :
Das ist hardwarefreundlich, weil die Runtime-Rechnung keinen Zero-Point-Offset abziehen muss. Der Quantization-Stack von PyTorch stellt diese affinen Scale- und Zero-Point-Optionen in torchao als primitive Quantization-Parameter bereit.
Asymmetrische Quantization verschiebt das Raster, um schiefe Wertebereiche abzudecken:
Das verschobene Raster kann rein positive Activations besser erhalten, doch der Offset verursacht Mehraufwand, sofern der Kernel ihn nicht gut behandelt.
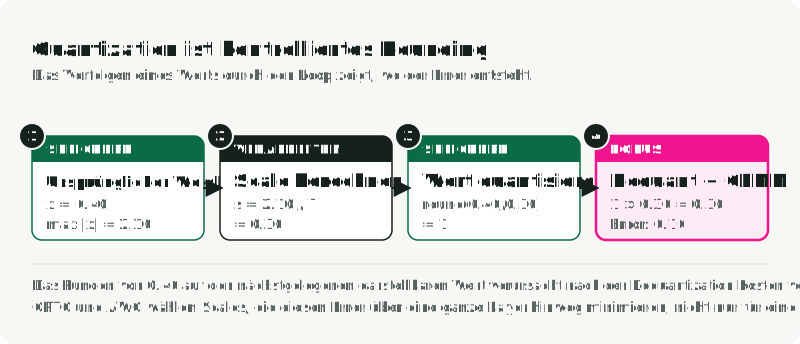
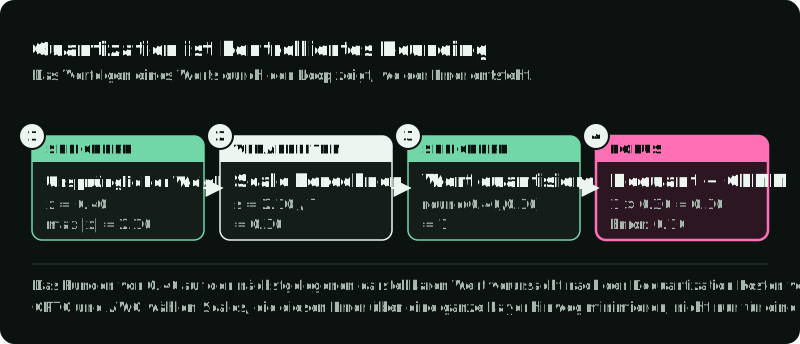
Die Abbildung rechnet den symmetrischen Fall durch: Eine maximale Magnitude von 2.10 ergibt eine Scale von 0.30, daher wird das Weight 0.40 auf die Ganzzahl 1 gerundet. Die Dequantization multipliziert diese gespeicherte Ganzzahl mit der Scale und liefert einen Näherungswert, 0.30. Die Differenz zu 0.40 ist der Rundungsfehler.
Scale-Granularität: Tensor, Channel, Group
Die Scale kann einen ganzen Weight-Tensor, einen Channel oder eine kleine Gruppe von Werten abdecken. Die FP8-KV-cache-Dokumentation von vLLM nutzt dieselbe Unterscheidung zwischen Scale-Strategien pro Tensor und pro Attention Head. Kleinere Gruppen erhalten meist die Qualität besser, benötigen aber mehr Scale-Metadaten.
| Scale-Granularität | Was sich eine Scale teilt | Auswirkung auf Qualität und Ausführung |
|---|---|---|
| Per Tensor | Die gesamte Weight-Matrix | Speichert wenig Metadaten, aber ein Outlier kann das Raster strecken und die Präzision über die ganze Layer verringern. |
| Per Channel | Eine Output-Zeile | Verhindert, dass Channels mit engem Wertebereich den weiteren Wertebereich eines anderen Channels mitnutzen. Viele 8-Bit-Weight-Pfade nutzen diese Granularität. |
| Per Group | Ein Block innerhalb einer Zeile, oft 64 oder 128 Werte | Beschränkt einen Outlier auf einen kleinen Block, kostet aber mehr Scales. AutoGPTQ verwendet group_size=128 in seinen GPTQ-Beispielen. |
Die Abbildung legt einen Outlier in eine kleine Beispielmatrix und zählt, wie viele Werte sich bei jeder Wahl seine Scale teilen.
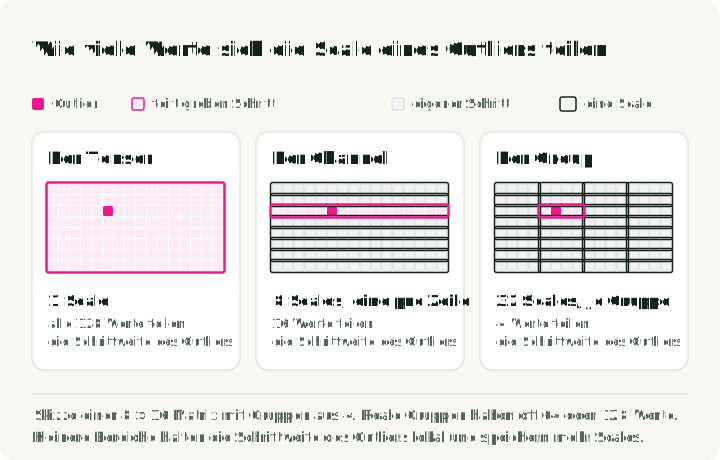
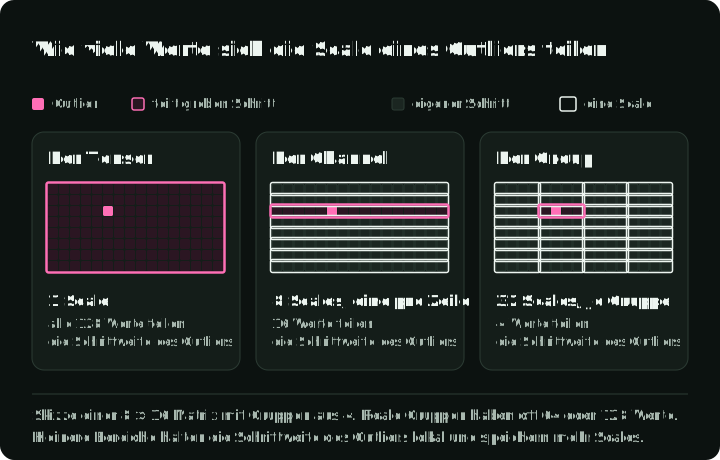
Weights sind statisch, daher lassen sich ihre Scales offline berechnen, bevor Sie das Model laden. Activations ändern sich mit jedem Token, daher hängen ihre Wertebereiche vom Workload ab.
| Activation Scaling | Wann die Runtime die Scale wählt | Vorteil | Fehlerfall oder Kosten |
|---|---|---|---|
| Static | Offline aus einem Calibration-Dataset | Vermeidet die Scale-Berechnung während der Inference. | Prompts außerhalb der kalibrierten Länge oder Verteilung können Activation-Spikes abschneiden (Clipping) und den Output schädigen. |
| Dynamic | Bei jedem Forward Pass | Passt sich den aktuellen Activation-Werten und dem Prompt-Mix an. | Die Berechnung der Wertebereiche in jeder Layer verursacht Mehraufwand und braucht optimierte Kernels. |
Der KV cache liegt zwischen diesen Fällen: Keys und Values sind Activations, die zur Laufzeit berechnet und dann für spätere Tokens aufbewahrt werden, daher brauchen sie eigene Scales. Abschnitt 6 behandelt, wie Runtimes sie speichern.
PTQ und QAT finden in unterschiedlichen Phasen statt
Post-Training Quantization, kurz PTQ, komprimiert ein trainiertes Model nachträglich. Quantization-Aware Training, kurz QAT, setzt das Model während des Trainings dem Quantization-Rauschen aus, damit es sich anpassen kann.
| Methode | Wann die Wertebereiche gelernt werden | Einsatz, wenn | Kosten |
|---|---|---|---|
| Weight-only PTQ | Offline, für statische Weights | Das Model nicht passt oder Decode bandbreitenbegrenzt ist | Activations laufen weiterhin in 16-Bit |
| Static PTQ | Offline, aus Calibration-Prompts | Sie schnelles W8A8-Serving wollen | Calibration Data muss zur Produktion passen |
| Dynamic PTQ | Zur Laufzeit, pro Batch oder Activation-Pfad | Die Input-Verteilungen stark variieren | Zusätzlicher Runtime-Aufwand und engere Hardware-Unterstützung |
| QAT | Während des Trainings | PTQ die Qualität eines empfindlichen Models zerstört | Vollständige Trainingsinfrastruktur und deutlich mehr Compute |
Calibration Data muss dem Traffic ähneln, den Sie bedienen. Der KV-cache-Calibration-Pfad von vLLM nutzt zum Beispiel ein kuratiertes Dataset über llm-compressor. Bestehen die Production-Prompts aus langen RAG-Traces, erfassen kurze Wikipedia-Absätze womöglich nicht die Activation-Wertebereiche, die diese Traces erzeugen. Bei statischen Activation- oder Cache-Scales legt die Calibration die Wertebereiche fest. Bei GPTQ und AWQ entscheiden die Calibration-Activations zusätzlich, wie jedes Weight gerundet oder umskaliert wird, sodass eine Calibration mit kurzen Texten die gespeicherten Weights prägen kann. Echte Prompts mit langem Context können andere Activation-Muster erzeugen. Evaluationen zur Quantization bei langem Context messen dieses Risiko direkt.
3. Zahlenformate bestimmen die Hardwareanforderungen
Das Zahlenformat legt fest, welche Werte das Model im Speicher darstellen kann. Effiziente Berechnung erfordert Runtime-Kernels und Hardware-Unterstützung für dieselbe Bitbreite und dasselbe Format. TensorRT-LLM dokumentiert sowohl die Rezeptliste als auch die Hardware-Support-Matrix.
| Format | Speicher pro Wert | Guter Standard für | Haupt-Stolperstein |
|---|---|---|---|
| BF16 / FP16 | 2 Byte | Baseline-Inference und trainingskompatibles Serving | Hoher VRAM-Verbrauch und hoher Speicherbandbreiten-Traffic |
| FP8 | 1 Byte | W8A8-Serving mit hohem Throughput auf Ada, Hopper, Blackwell | Braucht native FP8-Tensor-Cores und Runtime-Unterstützung |
| INT8 | 1 Byte | W8A8-Serving auf älterer oder Nicht-NVIDIA-Hardware | Activation-Outlier und Empfindlichkeit gegenüber statischer Calibration |
| INT4 | 0,5 Byte | W4A16, wenn der Weight-Speicher das Hauptlimit ist | Qualitätsverlust bei kleineren oder Reasoning-lastigen Models |
| FP4 / NVFP4 | ~0,5 Byte | Experimente der Blackwell-Ära und frühe Serving-Pfade | Hardwarespezifische Compiler- und Runtime-Anforderungen |
| llama.cpp-GGUF-Kodierungen / -Presets | Variabel | Lokale Inference auf CPU, Apple Silicon, Desktop und Edge | GGUF ist der Container. Die Tensor-Kodierung ist die Quantization-Wahl. |
| NF4 | 0,5 Byte | QLoRA-Adapter-Training | Meist das falsche Exportformat für Production Serving |
BF16 und FP16 nutzen beide 16 Bit, verteilen die Präzision aber unterschiedlich und versagen daher unterschiedlich. BF16 behält den 8-Bit-Exponentenbereich von FP32 und läuft seltener über. FP16 hat mehr Mantissenbits und einen engeren Exponentenbereich, daher erfordern Activation-Spikes mehr Sorgfalt. Die Evaluation von Kurtic et al. verwendet ausdrücklich BF16 als Baseline, wenn sie FP8-, INT8- und INT4-Serving-Formate vergleicht.
FP8 hat zwei gängige Varianten. E4M3 bietet mehr Präzision und wird meist für Forward-Weights und -Activations genutzt. E5M2 bietet mehr Dynamikumfang und eignet sich besser für Gradienten oder volatile Activation-Pfade. vLLM stellt beide bereit: FP8-E4M3- und -E5M2-KV-cache-Dtypes. In der ACL-2025-Studie „Give Me BF16 or Give Me Death“ von Kurtic et al. war FP8 W8A8 praktisch verlustfrei auf der Llama-3.1-Familie über mehr als 500.000 Evaluationen. Das Ergebnis gilt für diese Model-Familie, diese Evaluationssuite und dieses Serving-Setup. Jedes Deployment braucht vor dem Release eine eigene Qualitätsprüfung.
Blackwell ergänzt Microscaling-Formate wie MXFP8 und NVFP4. Statt einer Scale für einen ganzen Tensor oder eine ganze Zeile nutzt Microscaling winzige Blöcke. NVIDIAs NVFP4-Erklärung beschreibt 4-Bit-Gleitkommawerte in Blöcken zu 16, mit FP8-Scale-Faktoren und einer übergeordneten FP32-Scale. Dieser Ansatz soll einen Footprint nahe INT4 mit dem Verhalten von Gleitkommazahlen verbinden. Er erfordert jedoch eine passende Hardware-Architektur sowie Compiler- und Runtime-Unterstützung, weshalb TensorRT-LLM FP4- und FP8-Unterstützung nach GPU-Generation aufführt.
4. Weight-only versus Weight-Activation Quantization
Die Notation WxAy beschreibt die Präzision von Weights und Activations, die die GPU bei der Inference unterschiedlich belasten. Die Abbildung verfolgt die Weights vom VRAM über den Kernel bis zu den Tensor Cores für BF16, W4A16 und W8A8.
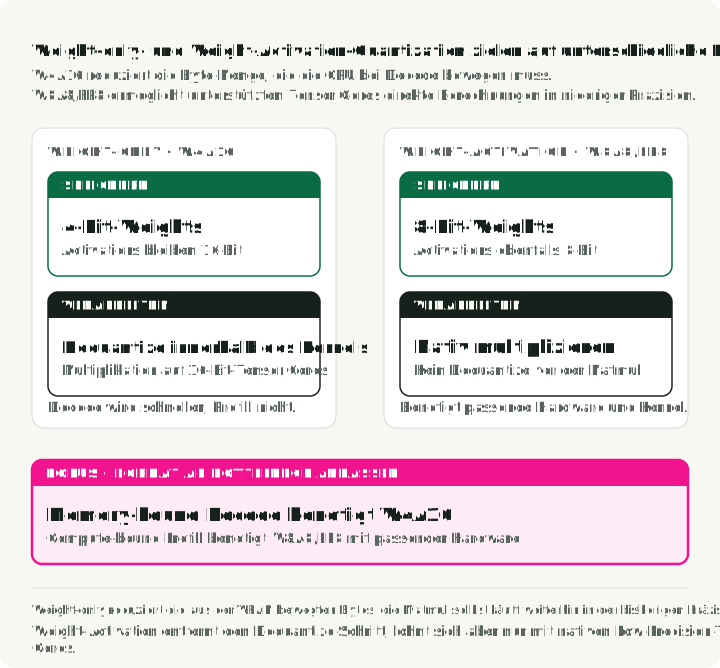
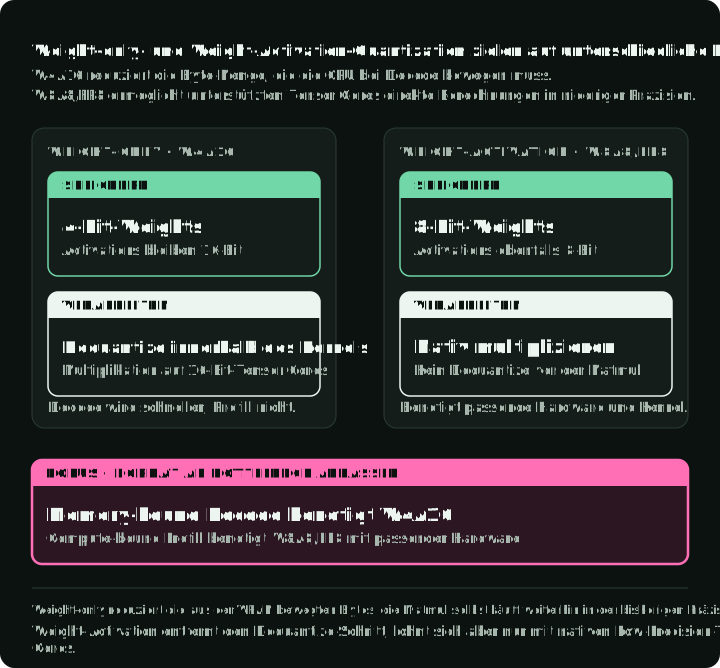
Beim Prefill verarbeitet das Model den Input-Prompt. Diese Phase ist meist compute-bound, weil die GPU große Matrixmultiplikationen ausführt. Deshalb sind W8A8-FP8/INT8-Rezepte für Serving mit Fokus auf Throughput wichtig.
Beim Decode generiert das Model ein Token nach dem anderen. Diese Phase ist oft speicherbandbreitenbegrenzt, weil die GPU für das nächste Token immer wieder Weights aus dem VRAM lädt. Weight-only-Arbeiten wie GPTQ und AWQ zielen auf diesen Engpass, indem sie die Weight-Bytes reduzieren.
W4A16 komprimiert Weights und behält Activations in BF16 oder FP16. Die GPU lädt weniger Weight-Bytes und dequantisiert sie dann für die Multiplikation zurück in eine Form mit höherer Präzision. Das hilft bei Decode und bei Problemen mit dem Speicherbedarf. Compute-bound Prefill profitiert womöglich kaum, weil die Matrixmathematik weiterhin in 16-Bit läuft.
W8A8 komprimiert Weights und die Activation-Tensoren, die unterstützte Matmul-Kernels verwenden. Hat die Hardware native Low-Precision-Tensor-Cores, kann die Serving-Engine die Matrixmathematik direkt in FP8 oder INT8 ausführen. FP8 kann deshalb Serving mit hohem Throughput unterstützen, indem es Speicher-Traffic senkt und schnellere Arithmetik nutzt. Der KV cache hat eine eigene Speichereinstellung, prüfen Sie daher den Cache-Dtype oder die Cache-Implementierung der Runtime separat.
Im eingecheckten Lauf des Companions (RTX 4090, vLLM 0.23.0, eine Wiederholung mit 64 generierten Tokens) erzeugte Qwen3-8B mit der dynamischen Online-FP8-Quantization von vLLM 122 tok/s gegenüber 85 tok/s bei BF16 und lud 8,8 GiB Weights statt 15,3 GiB. Mit zusätzlichem FP8 KV cache fiel der Wert auf 49 tok/s. Der Lauf ist zu kurz, um die Kapazität zu bestimmen, zeigt aber, dass jede Einstellung eine eigene Messung braucht.
5. Algorithmen versus Runtime-Kernels
Quantization-Algorithmen (wie GPTQ oder AWQ) legen fest, wie die Weights des Models auf geringere Präzision abgebildet werden. Runtime-Kernels (wie Marlin oder vLLMs eigene Kernels) sind der GPU-Code auf niedriger Ebene, der die Matrixmultiplikation ausführt. Ein stark komprimiertes Model läuft nur dann schnell, wenn es einen optimierten Kernel für sein spezifisches Quantization-Format gibt.
Ein Serving-Rezept nennt je ein Element aus jeder Schicht: einen Algorithmus (GPTQ, AWQ), ein Checkpoint-Format (compressed-tensors, GGUF), eine Runtime (vLLM, llama.cpp) und einen Kernel (Marlin). Derselbe AWQ-Checkpoint kann je nach Kernel sehr unterschiedlich schnell laufen.
Das Diagramm stellt jeden 4-Bit-Checkpoint mit und ohne Marlin-Kernel in einem veröffentlichten Benchmark gegenüber. Die Tabelle darunter ergänzt Perplexity und TTFT.
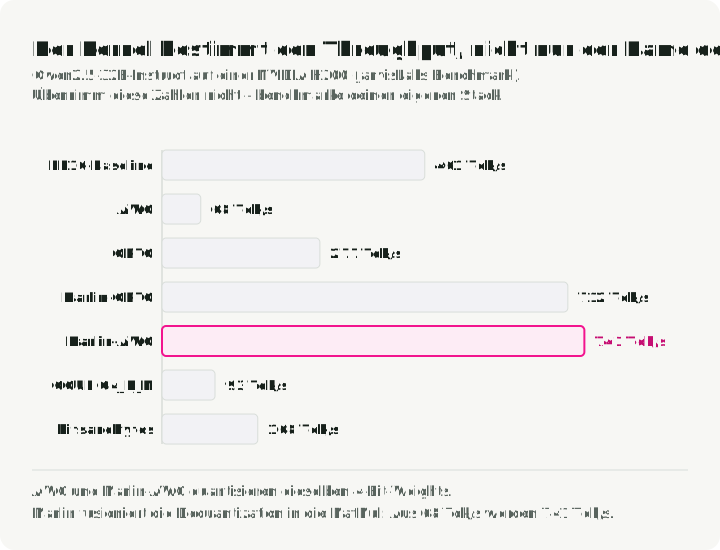
Der vLLM-Benchmark von JarvisLabs ließ Qwen2.5-32B-Instruct auf einer NVIDIA H200 laufen. Perplexity misst, wie gut das Model den Testtext vorhersagt; niedriger ist besser. HumanEval pass@1 misst den Erfolg bei Coding-Aufgaben mit einer einzigen generierten Lösung. Output tokens/s misst den Generierungs-Throughput, während mean TTFT die durchschnittliche Wartezeit bis zum ersten Output-Token misst:
| Quantization / Kernel | Wikitext-2-Perplexity ↓ | HumanEval pass@1 ↑ | Output tokens/s | Mean TTFT |
|---|---|---|---|---|
| FP16-Baseline | 6.56 | 56.1% | 461 tok/s | 57.7 ms |
| AWQ | 6.84 | 51.8% | 68 tok/s | 277.8 ms |
| GPTQ | 6.90 | 46.3% | 277 tok/s | 107.1 ms |
| Marlin-GPTQ | 6.97 | 45.7% | 712 tok/s | 51.9 ms |
| Marlin-AWQ | 6.84 | 51.8% | 741 tok/s | 73.5 ms |
| GGUF Q4_K_M | 6.74 | 51.8% | 93 tok/s | 958.0 ms |
| bitsandbytes | 6.67 | 51.8% | 168 tok/s | 135.3 ms |
Der Speed-Test des Anbieters nutzt 200 ShareGPT-Prompts, eine maximale Concurrency von 10 und Seed 42. Die Qualität stammt aus separaten Läufen auf Wikitext-2 und HumanEval. Der Bericht legt weder die vLLM-Version noch die Model-Revisionen fest, daher sind dies vom Anbieter berichtete Ergebnisse und kein unabhängig reproduzierter Vergleich. Sie belegen einen engeren Punkt: Der Algorithmus-Name auf dem Checkpoint verrät nicht, wie schnell das Serving sein wird.
AWQ und Marlin-AWQ verwenden zum Beispiel dieselben 4-Bit-Weights. Die Marlin-Implementierung ist viel schneller, weil ihr CUDA-Kernel Dequantization und Matrixmultiplikation zu einer einzigen, hochoptimierten GPU-Operation verschmilzt.
Für Ihren eigenen Vergleich erstellen oder beschaffen Sie zuerst einen vLLM-kompatiblen AWQ-Checkpoint am Pfad unten; diese Befehle quantisieren das Model nicht. Installieren Sie einen vLLM-Build, den Ihre GPU unterstützt, und starten Sie dann den Server in einem Terminal:
vllm serve ./outputs/Qwen2.5-32B-Instruct-AWQ-W4A16 \
  --served-model-name qwen2.5-32b-awq \
  --host 127.0.0.1 \
  --port 8000
Lassen Sie diesen Server laufen. Verwenden Sie in einem zweiten Terminal vllm bench serve mit dem echten Tokenizer, getrennt vom API-Model-Alias:
vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model qwen2.5-32b-awq \
  --tokenizer Qwen/Qwen2.5-32B-Instruct \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Das ist ein synthetischer Load Test mit 1.024 Input-Tokens und 256 Output-Tokens pro Request, keine Reproduktion der ShareGPT-Tabelle und kein Qualitätstest. Wiederholen Sie ihn für die Baseline und jeden vorbereiteten Checkpoint mit demselben Tokenizer, denselben Längen, demselben Seed und derselben Concurrency. Notieren Sie die tatsächlichen Token-Zahlen und die installierte vLLM-Version. Diese Befehlsbeispiele setzen den vorbereiteten Checkpoint und die Ziel-GPU voraus.
Verfolgen Sie Throughput, TTFT, Inter-Token-Latency (die Verzögerung zwischen aufeinanderfolgenden Tokens), Speicherverbrauch und Task-Qualität. Entwickeln sich einige davon gegenläufig, müssen Sie diesen Zielkonflikt vor dem Release kennen.
Quantization-Algorithmen im Vergleich
Diese Methoden lösen unterschiedliche Kompressionsprobleme:
| Algorithmus | Übliches Format | Was er zu erhalten versucht | Hauptkosten |
|---|---|---|---|
| GPTQ | W4A16 | Layer-Output, mithilfe von Hessian-Schätzungen, wie Weight-Änderungen den Output-Fehler beeinflussen | Langsame Calibration und aufwendigere Verarbeitung |
| AWQ | W4A16 / W4A8 | Wichtige Activation-Channels | Braucht Calibration und fusionierte Serving-Kernels |
| SmoothQuant | W8A8 | INT8-Activation-Verhalten, indem Outlier-Scale in die Weights verschoben wird | Scale-Tuning pro Model |
| QuaRot / SpinQuant | W4A4 / W4A8 | Geringerer Outlier-Druck bei Activations durch Rotationen | Komplexität der Rotation zur Laufzeit |
| HQQ | W4A16 / W2A16 | Schnelle Weight-only-Kompression ohne Calibration | Bei sehr geringer Bitbreite braucht die Qualität Downstream-Checks |
| QLoRA (NF4) | NF4 | Speicherbedarf beim Adapter-Training | Kein guter Standard für Serving |
| llama.cpp GGUF K-quants / IQ-quants | Gemischte Low-Bit-Tensor-Kodierungen | Qualität der lokalen Inference pro Byte | Nicht für Cloud-Batch-Serving ausgelegt |
| RTN (Round-to-Nearest) | W8A16 / FP8 | Nichts außer der Scale; keine Calibration Data | Großer Qualitätsverlust bei 4 Bit; als Baseline nutzen |
| FP8 dynamic | W8A8 FP8 | Activation-Wertebereich pro Token zur Laufzeit; keine Calibration Data | Braucht FP8-Tensor-Cores; ältere GPUs sehen womöglich keinen Speedup |
AutoGPTQ wurde im April 2025 archiviert, und AutoAWQ wurde im Mai 2025 archiviert und offiziell als veraltet markiert. Beginnen Sie für neue compressed-tensors-Checkpoints, die vLLM verarbeitet, mit llm-compressor. Nutzen Sie GPTQModel, wenn Sie den aktiv gepflegten GPTQ-Pfad mit Marlin, Machete, MoE-Speicheroptionen oder Disk-Offload brauchen.
Auch Pruning und Distillation senken die Serving-Kosten, über separate Workflows. 2:4 Structured Sparsity entfernt Weights in einem Muster, das NVIDIA-Sparse-Tensor-Cores nutzen können. Distillation trainiert ein kleineres Student-Model, das ein größeres nachahmt, was bei eng gefassten Aufgaben gut funktionieren kann. Nehmen Sie einen der beiden Pfade nur dann in die Auswahl auf, wenn das Projekt den zusätzlichen Pruning- oder Trainingsaufwand tragen kann.
6. Serving-Speicher umfasst mehr als Weights
Der komprimierte Checkpoint ist nur ein Teil des Serving-Speicherbedarfs. Dimensionieren Sie die gesamte Runtime, bevor Sie entscheiden, ob Weight Quantization genügt. PagedAttention benennt den KV cache als wesentlichen Posten im Serving-Speicher.
Offline-Quantization kann auf Layer-Ebene begrenzt sein. Tools wie llm-compressor können einen Transformer-Block laden, Calibration und Quantization-Rechnung ausführen, den komprimierten Block schreiben und zum nächsten übergehen. So bleibt der GPU-Spitzenspeicher näher an der größten aktiven Layer plus Calibration-Puffern. Sie brauchen weiterhin CPU-RAM und Festplatte für den Quell-Checkpoint, aber die GPU hält nicht immer das vollständige BF16-Model.
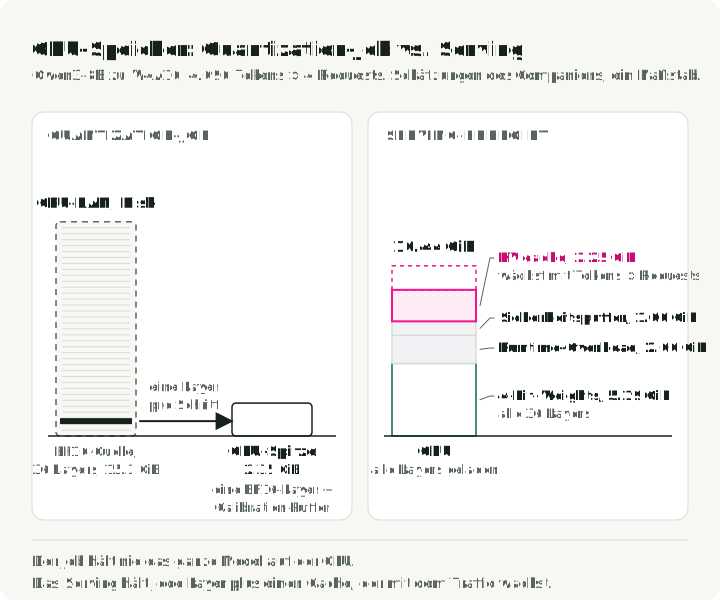
Der GPU-Spitzenspeicher bei der Offline-Quantization kann so aussehen:
Die Abbildung zeichnet beide Budgets im selben Maßstab mit der Qwen3-8B-W4A16-Schätzung des Companions aus Abschnitt 9. Das linke Panel zeigt den Offline-Job; das rechte zeigt, was beim Serving auf der GPU bleiben muss.
Bei Serving, das vollständig auf der GPU läuft, müssen alle komprimierten Weights zusammen mit dem KV cache und den Runtime-Puffern auf die Serving-GPUs passen. Weight-Offload verringert die Belegung der GPU, kostet aber Transfers. Der KV cache wächst mit der Context-Länge und der Größe des aktiven Batches. Für gleichförmige Attention-Layer und gleich lange Requests beträgt seine Tensor-Nutzlast ungefähr:
Diese Schätzung schließt Allocator-Overhead, Cache-Scale-Metadaten und geteilte Prefixe aus. Bei Requests unterschiedlicher Länge ersetzen Sie durch die Summe ihrer gecachten Längen.
Dabei gilt:
- ist die Anzahl der Layer.
- ist die Anzahl der Key-Value-Attention-Heads. Grouped-Query Attention verringert sie, indem viele Query-Heads sich weniger KV-Heads teilen.
- ist die Dimension jedes Heads, oft 128 oder 256.
- sind die Prompt-Tokens plus die generierten Tokens.
- ist der aktive Serving-Batch.
- ist 2 für BF16 oder FP16 und 1 für FP8 oder INT8. Der FP8-KV-cache-Modus von vLLM ist das Serving-Stack-Beispiel, das dieser Artikel verwendet.
KV-cache Quantization ändert den Speicher, Wiederverwendung ändert die Allokation
Der KV cache lässt sich während der Inference quantisieren. Jeder Decode-Schritt erzeugt K- und V-Activation-Tensoren für das neue Token. Ein W8A8-Model nutzt womöglich bereits FP8 oder INT8 für unterstützte Projektionsmathematik, doch der Cache bleibt ein separates Speicherobjekt.
Viele Serving-Stacks halten dieses Objekt im Model- oder Cache-Dtype. Um das zu ändern, aktivieren Sie einen KV-cache-Dtype, verwenden einen Checkpoint mit Cache-Scales oder wählen eine quantisierte Cache-Implementierung.
Ist die KV-cache Quantization aktiviert, schreibt die Engine Einträge als Darstellung mit geringerer Präzision plus Scales. Spätere Attention dequantisiert den Cache entweder im Kernel oder führt auf manchen Backends einen Teil der Attention-Operation im quantisierten Bereich aus.
Die Dokumentation zum stabilen Quantized KV Cache von vLLM macht das direkt über kv_cache_dtype="fp8" oder --kv-cache-dtype fp8 zugänglich. vLLM unterstützt die Cache-Formate FP8 E4M3 und E5M2 sowie Scale-Strategien pro Tensor und pro Attention Head. Es kann Default-Scales oder die Calibration anhand eines Datasets über llm-compressor nutzen. Mit FlashAttention 3 kann vLLM Attention-Operationen auch im FP8-Bereich ausführen, indem es zusätzlich zu Keys und Values auch Queries quantisiert. So aktivieren Sie den FP8-Cache für ein Model:
vllm serve Qwen/Qwen3-8B --kv-cache-dtype fp8 --max-model-len 32768TensorRT-LLM stellt den FP8 KV cache über KvCacheConfig(dtype='fp8') bereit und führt FP8 KV cache und NVFP4 KV cache als eigene Quantization-Rezepte neben der Weight-/Activation-Quantization auf. Hugging Face Transformers hat ebenfalls einen QuantizedCache-Pfad über cache_implementation="quantized", wobei hqq die Cache-Formate int2, int4 und int8 unterstützt und quanto int2 und int4.
Gewöhnliches KV Caching speichert frühere Keys und Values, um ihre Neuberechnung zu vermeiden. Prefix Caching verwendet Cache-Blöcke über Requests mit demselben Prefix hinweg wieder. PagedAttention verringert die Fragmentierung und verbessert die Allokation, während KV-Offload Cache-Blöcke zwischen Speicherebenen verschiebt. Welche Kombinationen funktionieren, hängt von der Runtime ab. Der QuantizedCache von Hugging Face unterstützt kein Offloading. vLLM dokumentiert seinen quantisierten KV cache getrennt von Prefix Caching und anderen Funktionen der Cache-Verwaltung. Prüfen Sie jede Kombination in der Runtime, die Sie einsetzen.
Auch das Qualitätsrisiko unterscheidet sich von Weight-only PTQ. KV-cache Quantization bringt Fehler in den Attention-State ein, der bei jedem späteren Decode-Schritt gelesen wird. Testen Sie Retrieval im langen Context, Multi-Turn-Verhalten, Safety und Ablehnungen, das Format von Tool Use und die Output-Latency getrennt. KVQuant, KIVI und die FP8-KV-cache-Studie von vLLM bewerten KV-cache Quantization alle als eigenes Problem.
Ein durchgerechnetes Beispiel zeigt, wann der Cache größer wird als die Weights. Nehmen Sie Llama-3.1-70B (80 Layer, 8 KV-Heads, Head-Dimension 128), das 8 Requests mit je 32.768 Tokens bedient:
def kv_cache_gb(layers, kv_heads, head_dim, tokens, batch, bytes_per_value):
    return 2 * layers * kv_heads * head_dim * tokens * batch * bytes_per_value / 1e9

# Llama-3.1-70B: 80 layers, 8 KV heads, head dimension 128
for name, nbytes in [("BF16", 2), ("FP8", 1)]:
    print(name, round(kv_cache_gb(80, 8, 128, 32_768, 8, nbytes), 1), "GB")
Das Skript gibt BF16 85.9 GB und FP8 42.9 GB aus. Bei dieser Last ist der BF16-Cache (86 GB) größer als die INT4-Weights: etwa 40 GB, wenn man Group-Scales und 16-Bit-Embeddings einrechnet, gegenüber den 35 GB, die die Tabelle in Abschnitt 7 allein für die 4-Bit-Werte nennt. Der FP8-Cache spart 43 GB; der Wechsel der Weights von BF16 zu INT4 spart etwa 100 GB. Weight Quantization kommt hier zuerst, und der Cache ist danach der größte verbleibende Posten. Das Diagramm stapelt Weights und Cache nach jedem Schritt.
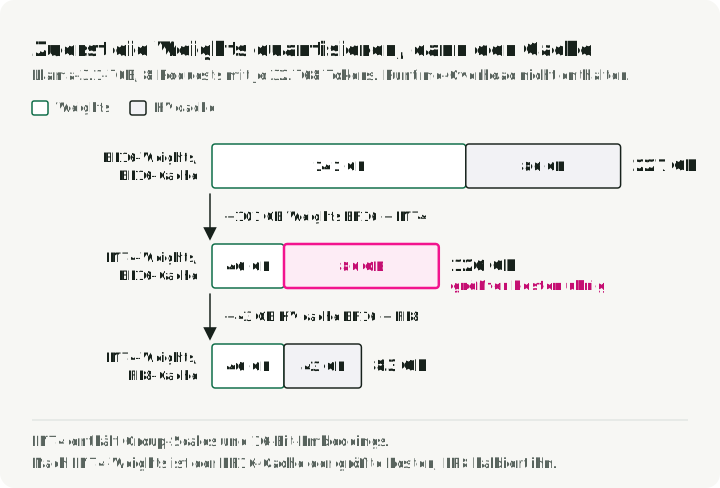
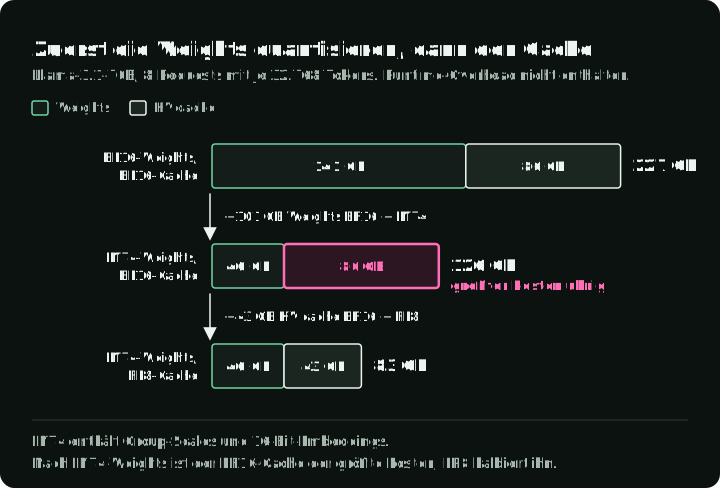
Vergleichen Sie für Ihr eigenes Model, wie viel Speicher jede Änderung sparen würde. Nutzen Sie die obige Cache-Gleichung mit demselben Batch und derselben Context-Länge für den aktuellen und den vorgeschlagenen Cache-Dtype. Ziehen Sie die vorgeschlagene Größe von der aktuellen ab. Verfahren Sie ebenso mit den beiden Weight-Formaten, die Sie erwägen. Vergleichen Sie zum Beispiel die Ersparnis von BF16 zu FP8-Cache mit der Ersparnis von BF16 zu INT4-Weights. Testen Sie zuerst die Option mit der größeren geschätzten Ersparnis, sofern die Runtime sie unterstützt. Messen Sie dann den tatsächlichen Speicherverbrauch und die Qualität; keine der beiden Schätzungen enthält jede Allokation der Runtime.
7. Weight-Größe und GPU-Unterstützung
Den Weight-Footprint können Sie leicht aus Parameterzahl und Speicherpräzision schätzen, nach derselben Größenlogik wie in Diskussionen zum Serving-Speicher rund um den KV cache:
| Model-Größe | BF16-Weights | FP8- / INT8-Weights | INT4-Weights |
|---|---|---|---|
| 7B / 8B | ~14-16 GB | ~7-8 GB | ~3,5-4 GB |
| 14B | ~28 GB | ~14 GB | ~7 GB |
| 32B / 34B | ~64-68 GB | ~32-34 GB | ~16-17 GB |
| 70B | ~140 GB | ~70 GB | ~35 GB |
| 109B MoE | ~218 GB gesamt | ~109 GB | ~55 GB |
Die INT4-Spalte zählt nur die 4-Bit-Werte. Group-Scales kommen mit einigen Prozent hinzu, und in 16-Bit belassene Embeddings und lm_head machen mehr aus. Bei Qwen3-8B sind diese beiden Matrizen in BF16 jeweils etwa 1,2 GB groß. Die W4A16-Schätzung von 5,19 GiB im Companion belässt 12 % der Parameter in 16-Bit, um sie abzudecken.
Bei festem Speicherbudget kann ein größeres Model mit 4 Bit ein kleineres mit 16 Bit übertreffen. Dettmers und Zettlemoyer fanden 4-Bit-Präzision fast durchgängig optimal für die Zero-Shot-Genauigkeit pro Gesamt-Bit des Models, über BLOOM-, OPT-, Pythia- und GPT-2-Models mit 19M bis 176B Parametern. Die Studie hat nur die Zero-Shot-Genauigkeit gemessen; testen Sie also Ihre eigenen Aufgaben, bevor Sie sich entscheiden.
Mixture-of-Experts-Models aktivieren pro Token womöglich weniger Parameter, doch der gesamte Satz an Weights muss trotzdem irgendwo liegen, sofern die Runtime keinen Offload unterstützt. Die Quantization-Support-Matrix von TensorRT-LLM behandelt MoE-Model-Familien als Deployment-Ziele mit eigenen unterstützten Rezepten.
Ihre Deployment-Hardware schränkt ein, welche Quantization-Formate infrage kommen:
- CPU-Serving hängt von Vektorbefehlen wie AVX-512 oder AMX ab. Eine GGUF-Datei, die über
llama.cppgeladen wird, ist der praktische Weg. - Apple Silicon nutzt Unified Memory, sodass lokale Models einen großen gemeinsamen RAM-Pool statt dedizierten VRAM nutzen können. GGUF und
llama.cppbleiben die gängige lokale Runtime, weil GGUF für GGML-Executors gebaut ist. MLX ist der andere verbreitete Weg:mlx_lm.convert --model <model> -qschreibt standardmäßig ein 4-Bit-MLX-Model,--q-bits 8ein 8-Bit-Model. Vergleichen Sie Geschwindigkeit und Qualität mit denselben Prompts, bevor Sie sich entscheiden. - NVIDIA Ampere unterstützt INT8-Tensor-Core-Serving-Pfade, aber keine native FP8-W8A8-Tensor-Core-Mathematik. Gängige Optionen sind W4A16 Weight-only Quantization oder statisches INT8, passend zur Hardware-Support-Matrix von TensorRT-LLM.
- NVIDIA Ada und Hopper unterstützen FP8-Serving-Pfade in TensorRT-LLM. FP8-W8A8-Serving lohnt sich auf diesen GPUs zu testen.
- NVIDIA Blackwell ergänzt NVFP4 und Microscaling-Unterstützung, aber der Software-Pfad bleibt entscheidend. Behandeln Sie frühe Low-Bit-Gleitkomma-Stacks als versionsabhängig.
8. Calibration und Evaluation vor dem Deployment
Ein Model, das lädt, hat einen Smoke Test bestanden. Das Deployment verlangt Qualitäts- und Serving-Checks für den Ziel-Workload. Jüngere Quantization-Evaluationen berichten unterschiedliche Ergebnisse für LLM-Serving, Aufgaben mit langem Context und Reasoning-lastige Models.
Die Abbildung zeigt, wohin Calibration-Samples und zurückgehaltene Evaluation-Samples gehen.
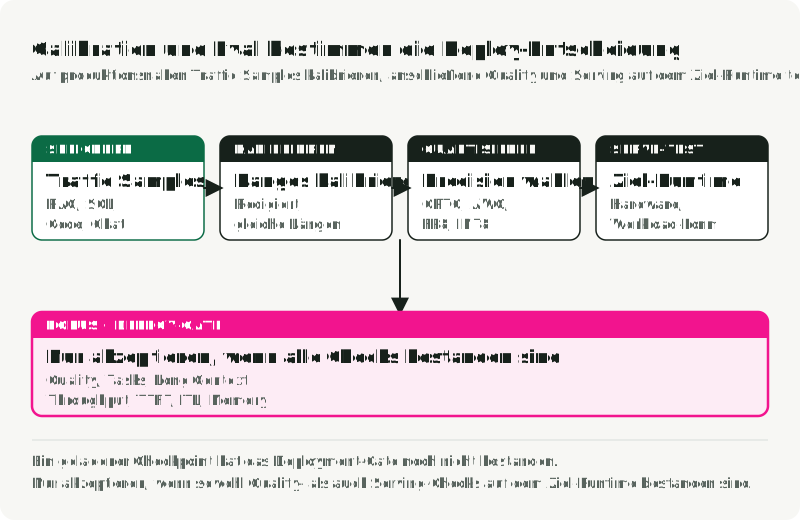
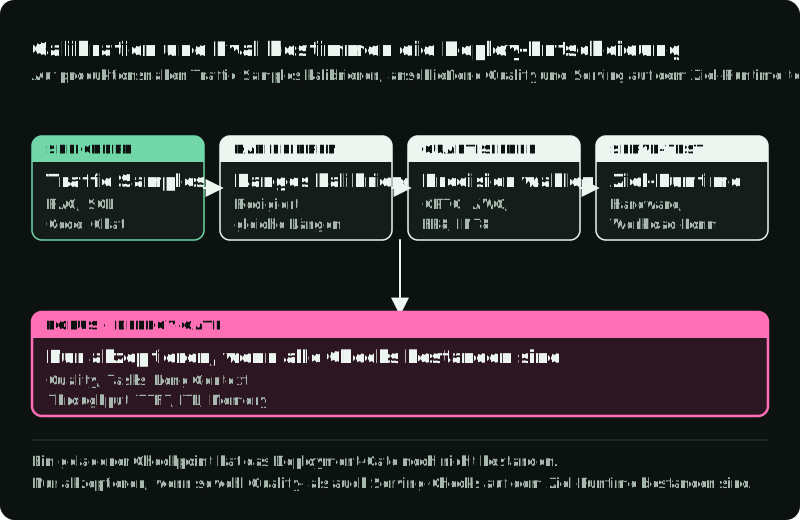
Wählen Sie zuerst das Rezept. Verlangt es Calibration, verwenden Sie Prompts, die der Produktion ähneln. HQQ und FP8 dynamic brauchen zum Beispiel kein Calibration-Dataset, daher zeigt die Abbildung einen Pfad, der die Calibration überspringt. Halten Sie Evaluationsbeispiele getrennt von den Calibration-Samples, damit der abschließende Vergleich zurückgehaltenes Verhalten testet. Für Rezepte, die Calibration brauchen:
- Nehmen Sie RAG-Traces, SQL-Queries, Agent-Verläufe, Coding-Aufgaben, Tool-Call-Payloads und System Prompts aus dem Ziel-Workload auf. Static PTQ hängt davon ab, dass die Calibration Data zur Verteilung in der Produktion passt.
- Passen Sie die Sequenzlängen an. Kurze einzelne Prompts legen das Activation-Verhalten bei langem Context nicht offen.
- Behalten Sie
embed_tokensundlm_headin höherer Präzision, wenn Methode oder Runtime es erlauben. Das ist ein gängiges Ausschlussmuster in LLM-Compressor-Rezepten. - Nutzen Sie genug Samples, um die Activation-Wertebereiche zu stabilisieren. Das KV-cache-Beispiel von vLLM setzt
NUM_CALIB_SAMPLES = 512. Betrachten Sie das als ein dokumentiertes Beispiel, nicht als allgemeingültige Zahl. Die richtige Sample-Anzahl hängt von Methode, Model, Sequenzlänge und Production-Workload ab. - Schwärzen Sie Secrets und private Nutzerdaten, bevor Sie Production-Logs verwenden.
Testen Sie bei der Evaluation sowohl die Sprachqualität als auch das Serving-Verhalten:
- Perplexity auf einem Standardkorpus erkennt breite Verschlechterung der Sprache, aber der JarvisLabs-Benchmark erinnert nützlich daran, dass sich Perplexity und Throughput unterschiedlich entwickeln können.
- Domänenaufgaben erkennen Fehler, die Perplexity verbirgt. Nutzen Sie HumanEval für Coding, MMLU für breites Wissen und AIME oder MATH-500 für mathematisches Reasoning, wenn diese Domänen wichtig sind.
- Format-Checks sind für agentic Systeme wichtig. Testen Sie JSON-Schema-Konformität, Markdown-Output, die Form von Tool Calls und das Ablehnungsverhalten, weil Evaluationen quantisierter Models Fehler auf Anwendungsebene übersehen können, selbst wenn die aggregierte Benchmark-Genauigkeit stabil aussieht.
- Tests mit langem Context erkennen Schäden durch KV-cache Quantization. Needle-in-a-Haystack ist grob, aber Ergebnisse zur Quantization bei langem Context zeigen, warum solche Checks vor das Deployment gehören.
- Load Tests sollten Throughput, TTFT, Inter-Token-Latency, tragfähige Concurrency und den GPU-Spitzenspeicher ausweisen.
vllm bench servemisst Throughput und Latency. Erfassen Sie den GPU-Speicher getrennt über GPU-/Server-Telemetrie. Variieren Sie die Concurrency gegen festgelegte Latency- und Fehlergrenzen, um ein tragfähiges Niveau zu finden; die in einem Lauf beobachtete Concurrency belegt keine Kapazität.
Halten Sie bei einer RAG-Anwendung die Fragen und die abgerufene Evidenz fest, wenn Sie die Baseline mit dem quantisierten Generator vergleichen. Dieser Vergleich isoliert die Änderung am Generator. Führen Sie danach die gesamte Pipeline aus, um das Serving-Ergebnis zu prüfen, und trennen Sie mithilfe des RAG-Evaluation-Leitfadens Retrieval-Fehler von nicht belegten Antworten. Prüfen Sie bei einem Agent zusätzlich, ob dieselben Aufgaben mit gültigen Tool Calls und akzeptablen Nebenwirkungen abgeschlossen werden. Ein kleinerer Checkpoint allein beantwortet keine dieser Fragen.
Testen Sie Reasoning-Models mit mehrstufigen Aufgaben. Quantization unter 4 Bit oder W4A4 ohne Rotation kann die Reasoning-Genauigkeit beeinträchtigen, selbst wenn die Baseline-Perplexity stabil aussieht. Das ist die zentrale Warnung der Studie zu quantisierten Reasoning-Models.
9. Workflow für das Companion-Repository
Das Companion-Repository slavadubrov/model-compression-demo macht den Entscheidungsprozess reproduzierbar. Es nutzt uv und konzentriert sich auf Planung, Rezepte, Dry Runs und Benchmark-Konfigurationen, die auf denselben Quellen beruhen wie dieser Artikel: vLLM, LLM Compressor, TensorRT-LLM und die Algorithmus-Papers.
Klonen Sie es und sehen Sie sich die unterstützten Algorithmen an:
git clone https://github.com/slavadubrov/model-compression-demo.git
cd model-compression-demo
git checkout 62da4539793ac3a93e94e8551a063c7681561099
uv run python demo.py list-algorithms
Diese Planungsbefehle nutzen nur die Python-Standardbibliothek. Beginnen Sie mit Planung und Dimensionierung:
uv run python demo.py plan \
  --model-preset qwen3-8b \
  --goal fit-memory \
  --hardware ampere \
  --context 4096 \
  --concurrency 4

uv run python demo.py estimate \
  --model-preset qwen3-8b \
  --scheme w4a16 \
  --context 4096 \
  --concurrency 4
plan wählt für dieses Ziel GPTQ W4A16 und gibt die beiden Budgets aus Abschnitt 6 aus: ein Serving-Ziel von 10,44 GiB und einen GPU-Spitzenwert von 2,35 GiB für den schichtweisen Quantization-Job. estimate schlüsselt das Serving-Ziel auf:
Architecture:     Qwen3 8B (built-in preset from official Hugging Face config)
Layers/hidden/KV: 36 / 4096 / 0.250
Note:             Causal text-generation checkpoint suitable for the text-only harness.
Scheme:           w4a16
Weights:          5.19 GiB
KV cache:         2.25 GiB
Runtime overhead: 2.00 GiB
Safety buffer:    1.00 GiB
Total target:     10.44 GiB
Weights und KV cache sind die ersten beiden Terme der Serving-Speicher-Gleichung aus Abschnitt 6. Runtime overhead und Safety buffer sind der Spielraum des Companions für Activations und Engine-Overhead. Die KV-cache-Zeile ist die Cache-Formel mit den 36 Layern, 8 KV-Heads und der Head-Dimension 128 von Qwen3-8B bei 4.096 Tokens und 4 gleichzeitigen Requests.
Geben Sie dann das Rezept aus und sehen Sie sich die Quantization vorab an, bevor Sie GPU-Zeit aufwenden:
uv run python demo.py recipe --algorithm gptq-w4a16

uv run python demo.py quantize \
  --algorithm gptq-w4a16 \
  --model Qwen/Qwen3-8B \
  --dry-run
Der Befehl recipe gibt den llm-compressor-Code aus, den der Quantize-Schritt ausführt:
from llmcompressor import oneshot
from llmcompressor.modifiers.quantization import GPTQModifier

recipe = GPTQModifier(
    scheme="W4A16",
    targets="Linear",
    ignore=["lm_head"],
)

oneshot(
    model="Qwen/Qwen3-8B",
    dataset="wikitext",
    dataset_config_name="wikitext-2-raw-v1",
    recipe=recipe,
    output_dir="outputs/Qwen3-8B-W4A16",
    max_seq_length=4096,
    num_calibration_samples=256,
)
targets und ignore bestimmen, welche Layer 4-Bit-Weights erhalten; num_calibration_samples und max_seq_length sind die Calibration-Entscheidungen aus Abschnitt 8. WikiText ist der Standard für den Smoke Test; übergeben Sie für einen echten Checkpoint --calibration-file mit Prompts, die der Produktion ähneln.
Das GPTQ-Rezept schreibt einen compressed-tensors-Checkpoint. GPTQ ist der Algorithmus, nicht das Checkpoint-Format, daher erkennt vLLM das Format am Checkpoint ohne --quantization-Flag, wie in seinem offiziellen W4A16-Beispiel.
Zum Quantisieren führen Sie make install-compression aus. vLLM braucht eine eigene Umgebung, weil seine Abhängigkeiten mit llm-compressor kollidieren: Führen Sie make install-serving aus und nutzen Sie dann .venv-vllm/bin/vllm für die Befehle serve und bench.
Servieren Sie jeden Checkpoint und benchmarken Sie ihn gegen die RTN-W8A16-Baseline aus der Algorithmus-Tabelle. Führen Sie quantize ohne --dry-run für gptq-w4a16 und rtn-w8a16 aus, um outputs/Qwen3-8B-W4A16 und outputs/Qwen3-8B-W8A16 zu schreiben. Der Befehl benchmark-plan des Companions schreibt für jeden Checkpoint einen Serve- und einen Benchmark-Befehl in eine JSON-Datei. Um den Vergleich von Hand auszuführen, starten Sie den W4A16-Server in einem Terminal:
.venv-vllm/bin/vllm serve outputs/Qwen3-8B-W4A16 --host 127.0.0.1 --port 8000Führen Sie in einem zweiten Terminal dieselbe synthetische Last aus wie in Abschnitt 5:
.venv-vllm/bin/vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8000 \
  --endpoint /v1/completions \
  --model outputs/Qwen3-8B-W4A16 \
  --tokenizer Qwen/Qwen3-8B \
  --dataset-name random \
  --num-prompts 200 \
  --random-input-len 1024 \
  --random-output-len 256 \
  --random-range-ratio 0 \
  --max-concurrency 10 \
  --seed 42
Stoppen Sie den Server und führen Sie dann beide Befehle erneut mit outputs/Qwen3-8B-W8A16, der RTN-W8A16-Baseline, anstelle von outputs/Qwen3-8B-W4A16 aus.
Vergleichen Sie schließlich das Basis-Model und die komprimierten Models anhand expliziter Schwellenwerte:
uv run python demo.py quality-eval \
  --base-model Qwen/Qwen3-8B \
  --compressed-model outputs/Qwen3-8B-W4A16 \
  --mode all \
  --lm-eval-task hellaswag \
  --lm-eval-limit 50 \
  --max-perplexity-delta-pct 5 \
  --output-json reports/qwen3-8b-w4a16-quality.json
Gehen Sie der Reihe nach vor: das Ziel planen, den Speicher schätzen, das Rezept als Dry Run ausführen, das Serving benchmarken und dann die Qualität gegen Schwellenwerte vergleichen. Diese Abfolge spiegelt die Trennung dieses Artikels zwischen Speicherdimensionierung, Runtime-Benchmarking und Qualitätsevaluation wider.
10. Diffusion-Models benötigen einen separaten Pfad
Diffusion- und Diffusion-Transformer-Pipelines verhalten sich bei Activations anders als autoregressive LLMs. SVDQuant behandelt die Diffusion-Quantization als eigenes Problem mit Activation-Outliern.
Autoregressive LLMs generieren ein Token nach dem anderen. Diffusion-Models führen wiederholte Denoising-Schritte aus, und ihre Activation-Verteilungen verschieben sich während des Prozesses, wie Q-Diffusion für die Outputs des Denoising-Netzwerks über die Zeitschritte berichtet. Ein Standard-4-Bit-Quantization-Durchlauf für LLMs kann Speicher bei Diffusion-Models sparen, aber starke visuelle Artefakte erzeugen. Diffusion-fokussierte Methoden wie SVDQuant / Nunchaku und die NVIDIA-ModelOpt-Diffusion-Quantization adressieren dieses andere Activation-Muster.
In einer Latent-Diffusion-Pipeline repräsentiert der Text-Encoder den Prompt. Ein Denoising-Netzwerk, etwa ein Diffusion Transformer (DiT) oder U-Net, aktualisiert wiederholt eine komprimierte Bilddarstellung, den Latent. Der Variational Autoencoder (VAE) wandelt zwischen diesen Latent-Darstellungen und Bildern um. Diese Komponenten haben unterschiedliche Aufgaben; testen Sie ihre Präzision daher getrennt.
Verwenden Sie Folgendes als vorsichtige Heuristiken, nicht als universelle Standardwerte. Pipeline, Komponente, Model und Runtime brauchen jeweils eigene Tests:
- Belassen Sie den VAE im ersten Vergleich in 16-Bit. Testen Sie geringere Präzision nur, wenn Methode und Ziel-Pipeline sie validieren.
- Probieren Sie zuerst das DiT- oder U-Net-Backbone, weil es oft den größten Parameteranteil hält. Prüfen Sie Speicher, Latency und Bildqualität für die Ziel-Pipeline. Diffusion-Quantization-Methoden gehen auf Komponentenebene ebenso vor.
- Behandeln Sie Text-Encoder separat. Die Quantization von T5-XXL oder CLIP kann in einer gegebenen Pipeline die Prompt-Treue oder das Text-Rendering beeinflussen. Bewerten Sie sie daher unabhängig, statt generisches Transformer-Verhalten anzunehmen.
- Nutzen Sie Diffusion-bewusste Methoden wie SVDQuant, wenn Activation-Outlier das Hauptproblem sind.
- Evaluieren Sie mit Bildern, nicht mit Textmetriken. Prüfen Sie Prompt-Treue, Text-Rendering, Hauttöne, Farbbalance, feine Details, Latency und VRAM. Für den Vergleich mit der 16-Bit-Pipeline messen Sie LPIPS oder PSNR zwischen gepaarten Bildern (gleicher Seed) sowie CLIP Score oder ImageReward für die Prompt-Treue, wie es die Evaluation von SVDQuant tut. Prüfen Sie die schwierigen Fälle danach per Auge.
Enthält das Evaluationsset nur einfache oder häufige Prompts, übersehen Sie Fehler in Randfällen. Nehmen Sie schwierige Fälle auf: kleine Schrift, Hände, wiederholte Objekte, strukturierte Layouts und Prompts mit negativen Vorgaben, denn Fehler der Diffusion-Quantization zeigen sich visuell und nicht in der Perplexity von Language Models.
11. Production-Standards
Die Abbildung ordnet den ersten Versuch für jeden Deployment-Typ auf einer Bit-Width-Achse an, mit dem nächsten Test und der Bedingung dafür. Jeder braucht weiterhin die Checks aus Abschnitt 8.
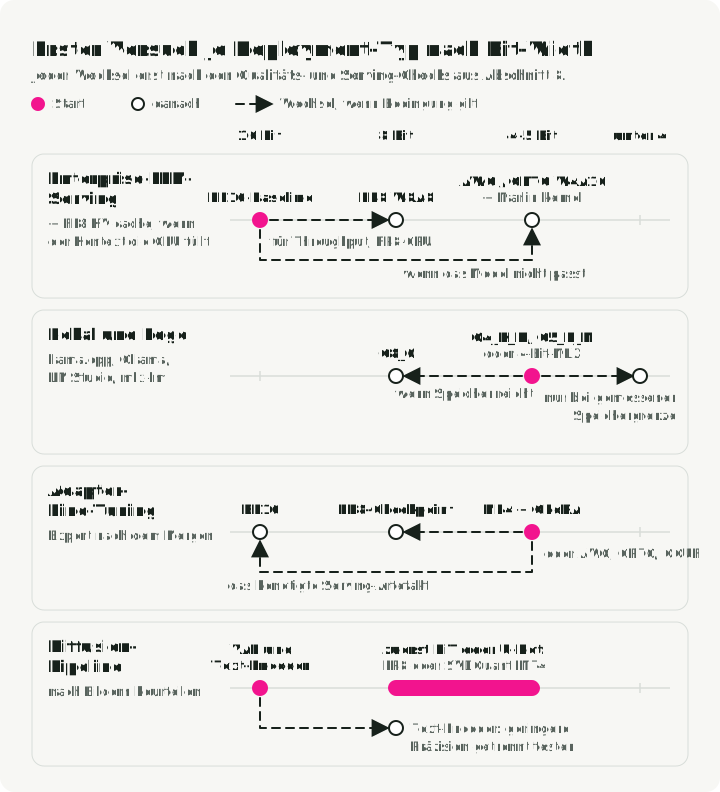
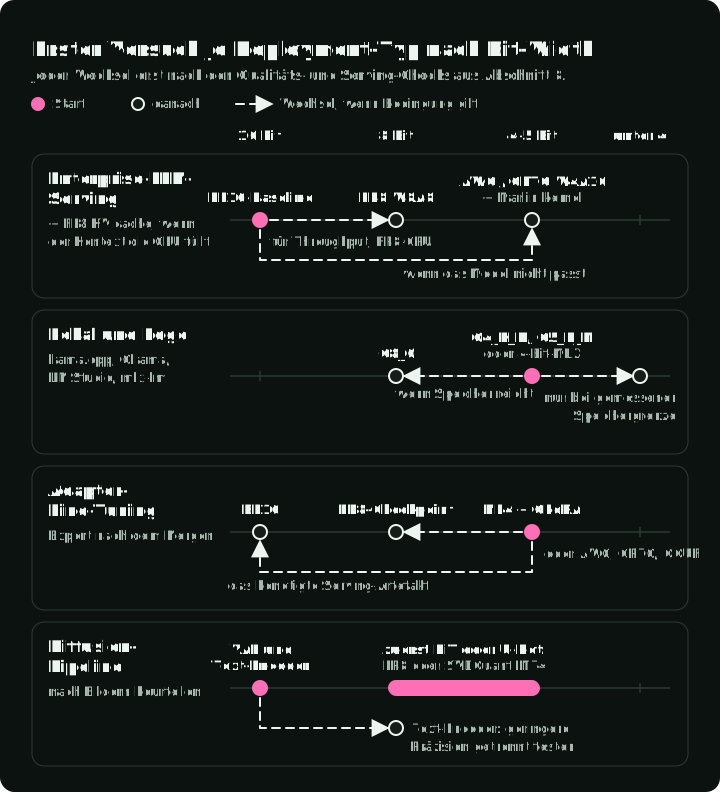
Beginnen Sie bei Enterprise-LLM-Serving mit einer BF16-Baseline in genau der Serving-Engine, die Sie einsetzen wollen. Wenn Throughput das Ziel ist und die GPU es unterstützt, testen Sie FP8 W8A8. Passt das Model nicht, testen Sie AWQ oder GPTQ W4A16 mit Kernels der Marlin-Klasse. Füllt langer Context oder Concurrency die GPU, testen Sie einen FP8 KV cache. Deployen Sie die komprimierte Version nur, wenn Qualitäts- und Serving-Checks beide bestehen.
Beginnen Sie bei lokaler und Edge-Inference mit einer GGUF-Datei mit Q4_K_M oder Q5_K_M oder auf einem Mac mit einem 4-Bit-MLX-Model. Wechseln Sie zu Q8_0, wenn der Speicher es zulässt, und vergleichen Sie die Task-Qualität. Nutzen Sie Kodierungen unter 4 Bit nur bei einem gemessenen Speicherlimit.
Nutzen Sie beim Fine-Tuning NF4 mit QLoRA, um Adapter mit weniger Speicher zu trainieren. Evaluieren Sie den Adapter in der Anwendung, bevor Sie ihn mergen. Exportieren und evaluieren Sie nach dem Merge das Serving-Artefakt, das Sie brauchen: eine llama.cpp-kompatible GGUF-Datei, einen AWQ-/GPTQ-/compressed-tensors-Checkpoint, einen FP8-Checkpoint oder BF16.
Quantisieren Sie bei Diffusion zuerst den Denoiser, belassen Sie den VAE in 16-Bit und testen Sie Text-Encoder separat, wie in Abschnitt 10. Vergleichen Sie gepaarte Bilder mit demselben Seed und prüfen Sie schwierige Prompts per Auge.
12. Den nächsten Vergleich durchführen
Behalten Sie die BF16-Baseline und vergleichen Sie einen unterstützten komprimierten Kandidaten mit denselben zurückgehaltenen Aufgaben und demselben Traffic. Legen Sie vor dem Lauf fest, welchen Qualitätsverlust und welche Latency Sie akzeptieren können. Messen Sie neben der Geschwindigkeit auch den Spitzenspeicher: Das nützliche Ergebnis ist, ob der Kandidat Ihren Bottleneck innerhalb dieser Grenzen beseitigt.
Referenzen
- JarvisLabs vLLM Benchmarks: JarvisLabs, vLLM Quantization Complete Guide and Benchmarks, 2026. JarvisLabs.
- Hugging Face Optimum Quantization Guide: Hugging Face, Quantization conceptual guide. Dokumentation.
- vLLM Quantization Docs: vLLM-Projekt, Quantization. Dokumentation.
- vLLM Quantized KV Cache Docs: vLLM-Projekt, Quantized KV Cache. Dokumentation.
- vLLM Benchmark Docs: vLLM-Projekt, vllm bench serve. Dokumentation.
- LLM Compressor Docs: vLLM-Projekt, LLM Compressor. Dokumentation.
- GPTQModel: ModelCloud, GPTQModel. GitHub.
- TensorRT-LLM Quantization: NVIDIA, TensorRT-LLM Quantization. Dokumentation.
- NVIDIA NVFP4: NVIDIA, Introducing NVFP4 for Efficient and Accurate Low-Precision Inference. Blog.
- Hugging Face QuantizedCache: Hugging Face, Cache strategies: Quantized cache. Dokumentation.
- NVIDIA Model Optimizer: NVIDIA, Model Optimizer. GitHub.
- torchao Quantization: PyTorch, torchao quantization overview. Dokumentation.
- bitsandbytes Quantization: Hugging Face, bitsandbytes. Dokumentation.
- HQQ: Dropbox, Half-Quadratic Quantization. GitHub.
- PEFT: Hugging Face, Parameter-Efficient Fine-Tuning. Dokumentation.
- Ollama: Ollama-Runtime für lokale Modelle. Webseite.
- LM Studio: LM Studio-Runtime für lokale KI. Webseite.
- AutoGPTQ-Status: AutoGPTQ-Repository, im April 2025 archiviert. GitHub.
- AutoAWQ-Status: AutoAWQ-Repository, im Mai 2025 archiviert und als veraltet markiert. GitHub.
- GPTQ: Frantar et al., GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers, ICLR 2023. arXiv:2210.17323.
- Marlin: Frantar et al., MARLIN: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models, arXiv:2408.11743. arXiv:2408.11743.
- AWQ: Lin et al., AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration, MLSys 2024. arXiv:2306.00978.
- SmoothQuant: Xiao et al., SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models, ICML 2023. arXiv:2211.10438.
- QuaRot: Ashkboos et al., QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs, NeurIPS 2024. arXiv:2404.00456.
- SpinQuant: Meta AI Research, SpinQuant: LLM Quantization with Learned Rotations, arXiv:2405.16406. arXiv:2405.16406.
- QLoRA / NF4: Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, NeurIPS 2023. arXiv:2305.14314.
- SVDQuant / Nunchaku: MIT HAN Lab, SVDQuant: Absorbing Outliers by Low-Rank Components for 4-Bit Diffusion Models, ICLR 2025. arXiv:2411.05007, Nunchaku.
- vLLM PagedAttention: Kwon et al., Efficient Memory Management for Large Language Model Serving with PagedAttention, SOSP 2023. arXiv:2309.06180.
- Grouped-Query Attention: Ainslie et al., GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints, EMNLP 2023. arXiv:2305.13245.
- vLLM FP8 KV Cache: Kubler, Kurtic, Wilkinson et al., The State of FP8 KV-Cache and Attention Quantization in vLLM, vLLM-Blog, April 2026. vLLM Blog.
- KIVI: Liu et al., KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache, ICML 2024. arXiv:2402.02750.
- KVQuant: Hooper et al., KVQuant: Towards 10 Million Context Length LLM Inference with KV Cache Quantization, NeurIPS 2024. arXiv:2401.18079.
- LLM Serving Evaluation: Kurtic et al., “Give Me BF16 or Give Me Death”? Accuracy-Performance Trade-Offs in LLM Quantization, ACL 2025. arXiv:2411.02355.
- Long-context Quantization Evaluation: Mekala et al., Does quantization affect models’ performance on long-context tasks?, arXiv:2505.20276. arXiv:2505.20276.
- Reasoning Evaluation: Quantization Hurts Reasoning? An Empirical Study on Quantized Reasoning Models, arXiv:2504.04823. arXiv:2504.04823.
- 2:4 Sparsity: Mishra et al., Accelerating Sparse Deep Neural Networks, arXiv:2104.08378. arXiv:2104.08378.
- k-bit Scaling Laws: Dettmers and Zettlemoyer, The case for 4-bit precision: k-bit Inference Scaling Laws, ICML 2023. arXiv:2212.09720.
- Q-Diffusion: Li et al., Q-Diffusion: Quantizing Diffusion Models, ICCV 2023. arXiv:2302.04304.
- MLX LM: Apple ml-explore, mlx-lm. GitHub.
- HumanEval: OpenAI, HumanEval. GitHub.
- MMLU: Hendrycks et al., Measuring Massive Multitask Language Understanding. arXiv:2009.03300.
- MATH-500: Hugging Face H4, MATH-500. Dataset.
- GGUF und llama.cpp: ggml-org, GGUF file format und llama.cpp. GGUF, llama.cpp.
- Hugging Face GGUF Docs: Hugging Face, GGUF. Dokumentation.
- Referenz-Repository: slavadubrov/model-compression-demo.